跳转到主要内容

1 - 身份认证指南

etcd 身份认证与基于角色的访问控制指南

1.1 - 身份认证

etcd 集群身份认证指南

auth、user、role 用于身份认证:

export ETCDCTL_API=3
ENDPOINTS=localhost:2379

etcdctl --endpoints=${ENDPOINTS} role add root
etcdctl --endpoints=${ENDPOINTS} role get root

etcdctl --endpoints=${ENDPOINTS} user add root
etcdctl --endpoints=${ENDPOINTS} user grant-role root root
etcdctl --endpoints=${ENDPOINTS} user get root

etcdctl --endpoints=${ENDPOINTS} role add role0
etcdctl --endpoints=${ENDPOINTS} role grant-permission role0 readwrite foo
etcdctl --endpoints=${ENDPOINTS} user add user0
etcdctl --endpoints=${ENDPOINTS} user grant-role user0 role0

etcdctl --endpoints=${ENDPOINTS} auth enable
# now all client requests go through auth

etcdctl --endpoints=${ENDPOINTS} --user=user0:123 put foo bar
etcdctl --endpoints=${ENDPOINTS} get foo
# permission denied, user name is empty because the request does not issue an authentication request
etcdctl --endpoints=${ENDPOINTS} --user=user0:123 get foo
# user0 can read the key foo
etcdctl --endpoints=${ENDPOINTS} --user=user0:123 get foo1

注意:

本文仅为示例,需补充并更新关于身份认证的更多信息。上述文本仅为代码示例。

1.2 - 基于角色的访问控制

一个基于角色的基本身份认证和访问控制指南

概述

身份认证功能自 etcd 2.1 版本起引入。etcd v3 API 对身份认证功能的 API 和用户界面进行了轻微调整,以更好地适配新的数据模型。本文旨在帮助用户在 etcd v3 中设置基本的身份认证和基于角色的访问控制。

特殊用户和角色

有一个特殊用户 root,以及一个特殊角色 root。

用户 root

root 用户在激活身份认证前必须先创建,该用户拥有对 etcd 的完全访问权限。root 用户的设计初衷是用于系统管理:管理角色和普通用户。root 用户必须拥有 root 角色,并被允许修改 etcd 内的任意内容。

角色 root

角色 root 可授予任意用户,包括根用户。拥有 root 角色的用户具备全局读写权限,并可更新集群的身份认证配置。此外,root 角色授予用户执行常规集群维护的权限,包括修改集群成员关系、整理碎片以及创建快照。

使用用户

user 子命令用于 etcdctl,负责处理与用户账户相关的所有事项。

用户列表可通过以下方式获取:

$ etcdctl user list

创建用户的方法如下:

$ etcdctl user add myusername

创建新用户时将提示输入新密码。当提供选项 --interactive=false 时,可从标准输入提供密码。也可使用 --new-user-password 来提供密码。

创建无法通过密码认证的用户也是可行的,方法如下:

$ etcdctl user add myusername --no-password

此类用户只能通过 TLS 通用名称 进行认证 。

说明

etcd 不支持通过 --user username: 使用空密码进行身份认证。例如,使用空密码创建的用户,如 etcdctl user add anonymous:'',无法通过用户名/密码请求进行身份认证,类似 etcdctl --user anonymous: get foo 的请求将失败并返回 user name is empty。

用户的角色可使用以下方式授予或撤销:

$ etcdctl user grant-role myusername foo
$ etcdctl user revoke-role myusername bar

用户设置可通过以下方式检查:

$ etcdctl user get myusername

用户密码可通过以下方式更改:

$ etcdctl user passwd myusername

更改密码后,将再次提示输入新密码。当提供选项 --interactive=false 时,密码可从标准输入提供。

使用以下命令删除账户:

$ etcdctl user delete myusername

使用角色

role 子命令用于 etcdctl,负责处理与特定角色访问控制相关的所有事项,这些权限已授予个别用户。

列出角色:

$ etcdctl role list

创建新角色,使用:

$ etcdctl role add myrolename

角色无密码;它仅用于定义一组新的访问权限。

角色被授予对单个键或键范围的访问权限。

范围可指定为区间 [起始键、结束键),其中起始键在字典序上应小于结束键。

访问权限可授予为读取、写入或两者兼有,例如以下示例所示:

# Give read access to a key /foo
$ etcdctl role grant-permission myrolename read /foo

# Give read access to keys with a prefix /foo/. The prefix is equal to the range [/foo/, /foo0)
$ etcdctl role grant-permission myrolename --prefix=true read /foo/

# Give write-only access to the key at /foo/bar
$ etcdctl role grant-permission myrolename write /foo/bar

# Give full access to keys in a range of [key1, key5)
$ etcdctl role grant-permission myrolename readwrite key1 key5

# Give full access to keys with a prefix /pub/
$ etcdctl role grant-permission myrolename --prefix=true readwrite /pub/

要查看已授予的权限,可随时查看角色:

$ etcdctl role get myrolename

权限撤销以相同逻辑方式进行:

$ etcdctl role revoke-permission myrolename /foo/bar

如移除角色本身:

$ etcdctl role delete myrolename

启用身份认证

启用身份认证的最小步骤如下。系统管理员可根据偏好,在启用身份认证之前或之后设置用户和角色。

确保已创建 root 用户:

$ etcdctl user add root
Password of root:

启用身份认证:

$ etcdctl auth enable

此后,etcd 已启用身份认证运行。如需出于任何原因禁用身份认证,请使用对应的反向命令:

$ etcdctl --user root:rootpw auth disable

身份认证的安全范围

当启用身份认证 etcdctl auth enable 时,可保护 V3 gRPC API 操作(get、put、delete、watch 等)。

/metrics 和 /health HTTP 端点使用独立的处理器,不受 V3 RBAC 身份认证保护。此设计允许 Prometheus 和负载均衡器在无需 gRPC 身份认证的情况下抓取指标,同时仍可保护键值数据。

为保障可观测性端点的安全:

  • 使用 --cert-file、--key-file 和 --client-cert-auth 启用 mTLS
  • 或通过 --listen-metrics-urls 将指标绑定到私有接口
  • 或使用网络策略/防火墙规则限制访问

使用 etcdctl 进行身份认证

etcdctl 支持与 curl 类似的身份认证标志。

$ etcdctl --user user:password get foo

密码可从提示中获取:

$ etcdctl --user user get foo

密码也可以从命令行标志 --password 获取:

$ etcdctl --user user --password password get foo

否则,所有 etcdctl 命令保持不变。用户和角色仍可创建和修改,但需由具备根角色的用户进行身份认证。

使用 TLS 共用名称

从 v3.2 版本起,若 etcd 服务器以选项 --client-cert-auth=true 启动,则客户端 TLS 证书中的通用名称(CN)字段将用作 etcd 用户。在此情况下,通用名称用于身份认证,客户端无需提供密码。请注意,若同时满足以下两个条件:1. --client-cert-auth=true 被传递且客户端提供了通用名称,以及 2. 客户端提供了用户名和密码,则基于用户名和密码的身份认证将被优先使用。请注意,此功能无法与 gRPC-proxy 或 gRPC-gateway 一同使用。这是因为 gRPC-proxy 会终止来自其客户端的 TLS 连接,导致所有客户端共享代理的证书。gRPC-gateway 内部使用 TLS 连接将 HTTP 请求转换为 gRPC 请求,因此存在相同的限制。因此,客户端无法正确向服务器提供其通用名称。若给定证书的通用名称非空,gRPC-proxy 将报错并停止运行。gRPC-proxy 返回错误,提示客户端证书中包含非空的通用名称。

密码强度说明

etcdctl 和 etcd API 在用户创建或更新用户密码操作期间不强制要求特定密码长度。系统管理能力应负责实施此类要求。为避免与密码强度相关的安全风险,可使用 TLS Common Name 基于的身份认证 ,或通过 --no-password 选项创建的用户。

2 - 配置选项

etcd 配置文件、命令行标志和环境变量

可以通过以下方式配置 etcd:

  • 命令行标志
  • 环境变量:每个标志都有一个对应的环境变量,其名称与标志相同,但前缀为 ETCD_,并以全大写和 [蛇形命名法][] 格式化。例如,--some-flag 对应 ETCD_SOME_FLAG。
  • 配置文件
警告

请注意:如果混合使用配置选项,则以下规则适用。

  • 命令行标志优先于环境变量。
  • 如果提供了 配置文件,则所有命令行标志和环境变量均被 忽略。

命令行标志

以下以 --flag-name DEFAULT_VALUE 格式展示命令行标志。

以下提供的标志列表可能因持续开发变更而未能保持最新。如需获取最新可用的标志,请运行 etcd --help 或查阅 etcd help 。

说明

注意:有关 v3.7 版本新增、更新和已弃用标志的详细信息,请参阅 CHANGELOG-3.7.md 。

成员

--name 'default'
  Human-readable name for this member.
--data-dir '${name}.etcd'
  Path to the data directory.
--wal-dir ''
  Path to the dedicated wal directory.
--snapshot-count '10000'
  Number of committed transactions to trigger a snapshot to disk.
--heartbeat-interval '100'
  Time (in milliseconds) of a heartbeat interval.
--election-timeout '1000'
  Time (in milliseconds) for an election to timeout. See tuning documentation for details.
--initial-election-tick-advance 'true'
  Whether to fast-forward initial election ticks on boot for faster election.
--listen-peer-urls 'http://localhost:2380'
  List of URLs to listen on for peer traffic.
--listen-client-urls 'http://localhost:2379'
  List of URLs to listen on for client grpc traffic and http as long as --listen-client-http-urls is not specified.
--listen-client-http-urls ''
  List of URLs to listen on for http only client traffic. Enabling this flag removes http services from --listen-client-urls.
--max-snapshots '5'
  Maximum number of snapshot files to retain (0 is unlimited).
--max-wals '5'
  Maximum number of wal files to retain (0 is unlimited).
--memory-mlock
  Enable to enforce etcd pages (in particular bbolt) to stay in RAM.
--quota-backend-bytes '0'
  Raise alarms when backend size exceeds the given quota (0 defaults to low space quota).
--backend-bbolt-freelist-type 'map'
  BackendFreelistType specifies the type of freelist that boltdb backend uses(array and map are supported types).
--backend-batch-interval ''
  BackendBatchInterval is the maximum time before commit the backend transaction.
--backend-batch-limit '0'
  BackendBatchLimit is the maximum operations before commit the backend transaction.
--max-txn-ops '128'
  Maximum number of operations permitted in a transaction.
--max-request-bytes '1572864'
  Maximum client request size in bytes the server will accept.
--grpc-keepalive-min-time '5s'
  Minimum duration interval that a client should wait before pinging server.
--grpc-keepalive-interval '2h'
  Frequency duration of server-to-client ping to check if a connection is alive (0 to disable).
--grpc-keepalive-timeout '20s'
  Additional duration of wait before closing a non-responsive connection (0 to disable).
--socket-reuse-port 'false'
  Enable to set socket option SO_REUSEPORT on listeners allowing rebinding of a port already in use.
--socket-reuse-address 'false'
  Enable to set socket option SO_REUSEADDR on listeners allowing binding to an address in TIME_WAIT state.

集群管理

--initial-advertise-peer-urls 'http://localhost:2380'
  List of this member's peer URLs to advertise to the rest of the cluster.
--initial-cluster 'default=http://localhost:2380'
  Initial cluster configuration for bootstrapping.
--initial-cluster-state 'new'
  Initial cluster state ('new' or 'existing').
--initial-cluster-token 'etcd-cluster'
  Initial cluster token for the etcd cluster during bootstrap.
  Specifying this can protect you from unintended cross-cluster interaction when running multiple clusters.
--advertise-client-urls 'http://localhost:2379'
  List of this member's client URLs to advertise to the public.
  The client URLs advertised should be accessible to machines that talk to etcd cluster. etcd client libraries parse these URLs to connect to the cluster.
--discovery ''
  Discovery URL used to bootstrap the cluster.
--discovery-fallback 'proxy'
  Expected behavior ('exit' or 'proxy') when discovery services fails.
  "proxy" supports v2 API only.
--discovery-proxy ''
  HTTP proxy to use for traffic to discovery service.
--discovery-srv ''
  DNS srv domain used to bootstrap the cluster.
--discovery-srv-name ''
  Suffix to the dns srv name queried when bootstrapping.
--strict-reconfig-check 'true'
  Reject reconfiguration requests that would cause quorum loss.
--pre-vote 'true'
  Enable the raft Pre-Vote algorithm to prevent disruption when a node that has been partitioned away rejoins the cluster.
--auto-compaction-retention '0'
  Auto compaction retention length. 0 means disable auto compaction.
--auto-compaction-mode 'periodic'
  Interpret 'auto-compaction-retention' one of: periodic|revision. 'periodic' for duration based retention, defaulting to hours if no time unit is provided (e.g. '5m'). 'revision' for revision number based retention.
--enable-v2 'false'
  Accept etcd V2 client requests. Deprecated and to be decommissioned in v3.6.
--v2-deprecation 'not-yet'
  Phase of v2store deprecation. Allows to opt-in for higher compatibility mode.
  Supported values:
    'not-yet'                // Issues a warning if v2store have meaningful content (default in v3.5)
    'write-only'             // Custom v2 state is not allowed (default in v3.6 and v3.7)
    'write-only-skip-check'  // Custom v2 state is not supported and, if present, will be ignored (available in v3.5.32+, v3.6.13+, and v3.7.0+). Use this option at your own risk.
    'write-only-drop-data'   // Custom v2 state will get DELETED ! (planned default in v3.8)
    'gone'                   // v2store is not maintained any longer.

安全

--cert-file ''
  Path to the client server TLS cert file.
--key-file ''
  Path to the client server TLS key file.
--client-cert-auth 'false'
  Enable client cert authentication.
  It's recommended to enable client cert authentication to prevent attacks from unauthenticated clients (e.g. CVE-2023-44487), especially when running etcd as a public service.
--client-crl-file ''
  Path to the client certificate revocation list file.
--client-cert-allowed-hostname ''
  Comma-separated list of SAN hostnames for client cert authentication.
--trusted-ca-file ''
  Path to the client server TLS trusted CA cert file.
  Note setting this parameter will also automatically enable client cert authentication no matter what value is set for `--client-cert-auth`.
--auto-tls 'false'
  Client TLS using generated certificates.
--peer-cert-file ''
  Path to the peer server TLS cert file.
--peer-key-file ''
  Path to the peer server TLS key file.
--peer-client-cert-auth 'false'
  Enable peer client cert authentication.
  It's recommended to enable peer client cert authentication to prevent attacks from unauthenticated forged peers (e.g. CVE-2023-44487).
--peer-trusted-ca-file ''
  Path to the peer server TLS trusted CA file.
--peer-cert-allowed-cn ''
  Comma-separated list of allowed CNs for inter-peer TLS authentication.
--peer-cert-allowed-hostname ''
  Comma-separated list of allowed SAN hostnames for inter-peer TLS authentication.
--peer-auto-tls 'false'
  Peer TLS using self-generated certificates if --peer-key-file and --peer-cert-file are not provided.
--self-signed-cert-validity '1'
  The validity period of the client and peer certificates that are automatically generated by etcd when you specify ClientAutoTLS and PeerAutoTLS, the unit is year, and the default is 1.
--peer-crl-file ''
  Path to the peer certificate revocation list file.
--cipher-suites ''
  Comma-separated list of supported TLS cipher suites between client/server and peers (empty will be auto-populated by Go).
--cors '*'
  Comma-separated whitelist of origins for CORS, or cross-origin resource sharing, (empty or * means allow all).
--host-whitelist '*'
  Acceptable hostnames from HTTP client requests, if server is not secure (empty or * means allow all).
--tls-min-version 'TLS1.2'
  Minimum TLS version supported by etcd.
--tls-max-version ''
  Maximum TLS version supported by etcd (empty will be auto-populated by Go).

认证

--auth-token 'simple'
  Specify a v3 authentication token type and its options ('simple' or 'jwt').
--bcrypt-cost 10
  Specify the cost / strength of the bcrypt algorithm for hashing auth passwords. Valid values are between 4 and 31.
--auth-token-ttl 300
  Time (in seconds) of the auth-token-ttl.

性能分析和监控

--enable-pprof 'false'
  Enable runtime profiling data via HTTP server. Address is at client URL + "/debug/pprof/"
--metrics 'basic'
  Set level of detail for exported metrics, specify 'extensive' to include server side grpc histogram metrics.
--listen-metrics-urls ''
  List of URLs to listen on for the metrics and health endpoints.

日志记录

--logger 'zap'
  Currently only supports 'zap' for structured logging.
--log-outputs 'default'
  Specify 'stdout' or 'stderr' to skip journald logging even when running under systemd, or list of comma separated output targets.
--log-level 'info'
  Configures log level. Only supports debug, info, warn, error, panic, or fatal.
--log-format 'json'
  Configures log format. Only supports json, console.
--enable-log-rotation 'false'
  Enable log rotation of a single log-outputs file target.
--log-rotation-config-json '{"maxsize": 100, "maxage": 0, "maxbackups": 0, "localtime": false, "compress": false}'
  Configures log rotation if enabled with a JSON logger config. MaxSize(MB), MaxAge(days,0=no limit), MaxBackups(0=no limit), LocalTime(use computers local time), Compress(gzip)".
--warning-unary-request-duration '300ms'
  Set time duration after which a warning is logged if a unary request takes more than this duration.
说明

注意:在 v3.7 中,多个 --experimental-* 标志已被提升或重命名。 请务必用下文列出的稳定对应标志替换已弃用的标志。

分布式跟踪

--enable-distributed-tracing 'false'
  Enable distributed tracing.
--distributed-tracing-address 'localhost:4317'
  Distributed tracing collector address.
--distributed-tracing-service-name 'etcd'
  Distributed tracing service name, must be the same across all etcd instances.
--distributed-tracing-instance-id ''
  Distributed tracing instance ID, must be unique for each etcd instance.
--distributed-tracing-sampling-rate '0'
  Number of samples to collect per million spans for distributed tracing.

v2 代理

警告

注意:标志位将在 v3.6 中被弃用。

--proxy 'off'
  Proxy mode setting ('off', 'readonly' or 'on').
--proxy-failure-wait 5000
  Time (in milliseconds) an endpoint will be held in a failed state.
--proxy-refresh-interval 30000
  Time (in milliseconds) of the endpoints refresh interval.
--proxy-dial-timeout 1000
  Time (in milliseconds) for a dial to timeout.
--proxy-write-timeout 5000
  Time (in milliseconds) for a write to timeout.
--proxy-read-timeout 0
  Time (in milliseconds) for a read to timeout.

功能

--corrupt-check-time '0s'
  Duration of time between cluster corruption check passes.
--compact-hash-check-time '1m'
  Duration of time between leader checks followers compaction hashes.
--compaction-batch-limit 1000
  CompactionBatchLimit sets the maximum revisions deleted in each compaction batch.
--peer-skip-client-san-verification 'false'
  Skip verification of SAN field in client certificate for peer connections.
--watch-progress-notify-interval '10m'
  Duration of periodical watch progress notification.
--warning-apply-duration '100ms'
  Warning is generated if requests take more than this duration.
--bootstrap-defrag-threshold-megabytes
  Enable the defrag during etcd server bootstrap on condition that it will free at least the provided threshold of disk space. Needs to be set to non-zero value to take effect.
--max-learners '1'
  Set the max number of learner members allowed in the cluster membership.
--compaction-sleep-interval
  Sets the sleep interval between each compaction batch.
--downgrade-check-time
  Duration of time between two downgrade status checks.
--snapshot-catchup-entries
  Number of entries for a slow follower to catch up after compacting the raft storage entries.

功能门控

--feature-gates=AllAlpha=true|false
  Enables or disables all alpha features. Default is false.
--feature-gates=AllBeta=true|false
  Enables or disables all beta features. Default is false.
--feature-gates=CompactHashCheck=true
  Enables leader to periodically check follower compaction hashes.
  Replaces: --experimental-compact-hash-check-enabled
--feature-gates=InitialCorruptCheck=true
  Enables corruption check before serving client/peer traffic.
  Replaces: --experimental-initial-corrupt-check
--feature-gates=LeaseCheckpoint=true
  ExperimentalEnableLeaseCheckpoint enables primary lessor to persist lease remainingTTL to prevent indefinite auto-renewal of long lived leases.
  Replaces: --experimental-enable-lease-checkpoint
--feature-gates=LeaseCheckpointPersist=true
  Enable persisting remainingTTL to prevent indefinite auto-renewal of long lived leases. Always enabled in v3.6. Should be used to ensure smooth upgrade from v3.5 clusters with this feature enabled.
  Replaces: --experimental-enable-lease-checkpoint-persist
--feature-gates=SetMemberLocalAddr=true
  Allows setting a member’s local address.
--feature-gates=StopGRPCServiceOnDefrag=true
  Enable etcd gRPC service to stop serving client requests on defragmentation.
  Replaces: --experimental-stop-grpc-service-on-defrag
--feature-gates=TxnModeWriteWithSharedBuffer=true
  Enable the write transaction to use a shared buffer in its readonly check operations.
  Replaces: --experimental-txn-mode-write-with-shared-buffer

不安全功能

警告

警告:使用不安全功能可能会破坏共识协议所提供的保证!

--force-new-cluster 'false'
  Force to create a new one-member cluster.
--unsafe-no-fsync 'false'
  Disables fsync, unsafe, will cause data loss.

配置文件

etcd 配置文件由一个 YAML 映射组成,其键为命令行标志名称,值为标志的取值。 为使用此文件,请将文件路径作为 --config-file 标志的值或 ETCD_CONFIG_FILE 环境变量的值指定。

有关示例,请参见 [etcd.conf.yml 样本][]。

说明

诸如 --grpc-keepalive-min-time、--grpc-keepalive-interval、--grpc-keepalive-timeout、--backend-batch-interval、--corrupt-check-time、--compact-hash-check-time、--compaction-sleep-interval、--watch-progress-notify-interval、--warning-apply-duration、--warning-unary-request-duration 及 --downgrade-check-time 等持续时间字段在作为命令行标志传入时可接受人类可读的字符串(例如 10m、5s),但在配置文件中仅接受 以纳秒表示的整数值。这是 Go 标准库的一个已知限制 ,其中 time.Duration 被反序列化为普通整数。

例如,在配置文件中设置 10 分钟的监听进度通知间隔:

# 正确:以纳秒表示的 10 分钟
watch-progress-notify-interval: 600000000000

# 错误:将导致反序列化错误
watch-progress-notify-interval: '10m'

3 - 传输安全模型

确保数据传输安全

etcd 支持自动 TLS,以及通过客户端证书实现的客户端到服务器和对等成员(服务器到服务器 / 集群)通信的身份认证。请注意,etcd 默认不启用 基于 RBAC 的身份认证 或传输层的身份认证功能,以降低用户入门时的使用门槛。此外,更改此默认设置将对该项目造成破坏性变更,该项目自 2013 年确立以来一直保持该设定。未启用安全功能的 etcd 集群可能使数据暴露于任意客户端。

要快速上手,请先准备一个 CA 证书以及一个成员的已签名密钥对。建议为集群中的每个成员创建并签署新的密钥对。

为方便起见,cfssl 工具提供了便捷的证书生成接口,我们在此提供一个使用该工具的示例 here 。或者,可参考此 指南以生成自签名密钥对 。

以下提供的标志列表可能因持续开发变更而未能保持最新。如需获取最新可用的标志,请运行 etcd --help 或查阅 etcd help 。

基本配置

etcd 支持多个与证书相关的配置选项,可通过命令行标志或环境变量进行设置:

客户端到服务器通信:

--cert-file=<path>:用于与 etcd 建立 SSL/TLS 连接的证书。设置此选项后,advertise-client-urls 可使用 HTTPS 方案。

--key-file=<path>:证书的键。必须为未加密的。

--client-cert-auth:启用此选项后,etcd 将检查所有传入的 HTTPS 请求,确保其包含由受信任 CA 签发的客户端证书;未提供有效客户端证书的请求将失败。若 身份认证 已启用,证书中的通用名称(Common Name)字段将提供用户的用户名凭证。

--trusted-ca-file=<path>:受信任的证书颁发机构。

--auto-tls:对与客户端的 TLS 连接使用自动生成的自签名证书。

对等通信(服务器间/集群):

对等成员选项的工作方式与客户端到服务器选项相同:

--peer-cert-file=<path>:用于对等成员之间 SSL/TLS 连接的证书。该证书将同时用于在对等成员地址上监听以及向其他对等成员发送请求。

--peer-key-file=<path>:证书的键。必须为未加密的。

--peer-client-cert-auth:启用后,etcd 将检查来自集群的所有对等成员请求,确保其客户端证书由指定的 CA 签发。

--peer-trusted-ca-file=<path>:受信任的证书颁发机构。

--peer-auto-tls:对等成员之间的 TLS 连接使用自动生成的自签名证书。

若提供客户端到服务器证书或对等成员证书,则必须同时设置密钥。所有这些配置选项也可通过环境变量 ETCD_CA_FILE、ETCD_PEER_CA_FILE 等进行设置。

常用选项:

--cipher-suites:服务器/客户端与对等成员之间支持的 TLS 密码套件列表,以逗号分隔(空值将由 Go 自动填充)。

--tls-min-version=<version> 设置 etcd 支持的最低 TLS 版本。

--tls-max-version=<version> 设置 etcd 支持的最大 TLS 版本。若未设置,则使用 Go 支持的最大版本。

TLS 证书 keyUsage 和 extendedKeyUsage

在为 etcd 传输层安全生成 X.509 证书时,证书应根据其角色包含适当的 keyUsage 和 extendedKeyUsage 字段。etcd 依赖 Go 的 crypto/tls 和 crypto/x509 库进行证书验证,这些库会在 TLS 握手过程中强制执行这些用途。

下表总结了常见证书角色的推荐用法:

证书角色keyUsageextendedKeyUsage
服务器(客户端到服务器)digitalSignature, keyEnciphermentserverAuth
客户端digitalSignature, keyEnciphermentclientAuth
对等成员(服务器到服务器)digitalSignature, keyEnciphermentserverAuth, clientAuth

注意事项:

  • 当启用 --peer-client-cert-auth 时,对等成员之间使用证书进行双向 TLS,因此必须同时配置 serverAuth 和 clientAuth。
  • 与 --client-cert-auth 一起使用的客户端证书应包含 clientAuth。

示例 1: 使用 HTTPS 的客户端到服务器传输安全

为此,请准备好 CA 证书(ca.crt)以及已签名的密钥对(server.crt、server.key)。

请逐步配置 etcd 以提供简单的 HTTPS 传输安全:

$ etcd --name infra0 --data-dir infra0 \
  --cert-file=/path/to/server.crt --key-file=/path/to/server.key \
  --advertise-client-urls=https://127.0.0.1:2379 --listen-client-urls=https://127.0.0.1:2379

这应能正常启动,可通过向 etcd 发送 HTTPS 请求来测试配置:

$ curl --cacert /path/to/ca.crt https://127.0.0.1:2379/v2/keys/foo -XPUT -d value=bar -v

该命令应显示握手成功。由于我们使用自签名证书并采用自有的证书颁发机构,因此必须通过 --cacert 选项将 CA 传递给 curl。另一种方法是将 CA 证书添加至系统的受信任证书目录(通常位于 /etc/pki/tls/certs 或 /etc/ssl/certs)。

OSX 10.9+ 用户:OSX 10.9+ 上的 curl 7.30.0 不支持在命令行中传递证书。

请将 dummy ca.crt 直接导入钥匙串,或向 curl 添加 -k 标志以忽略错误。

若要不使用 -k 标志进行测试,请运行 open ./tests/fixtures/ca/ca.crt 并按照提示操作。

测试完成后请删除该证书!

如有可行的变通方法,请告知我们。

示例 2:使用 HTTPS 客户端证书进行客户端到服务器的身份认证

目前,etcd 客户端已具备验证服务器身份并提供传输安全的能力。然而,我们还可以使用客户端证书来防止未经授权的访问。

客户端将向服务器提供其证书,服务器将检查该证书是否由提供的 CA 签发,并据此决定是否响应请求。

与第一个示例中提到的文件相同,本例也需要一个由同一证书颁发机构签名的客户端密钥对(client.crt、client.key)。

$ etcd --name infra0 --data-dir infra0 \
  --client-cert-auth --trusted-ca-file=/path/to/ca.crt --cert-file=/path/to/server.crt --key-file=/path/to/server.key \
  --advertise-client-urls https://127.0.0.1:2379 --listen-client-urls https://127.0.0.1:2379

现在以相同请求尝试此服务器:

$ curl --cacert /path/to/ca.crt https://127.0.0.1:2379/v2/keys/foo -XPUT -d value=bar -v

请求应被服务器拒绝:

...
routines:SSL3_READ_BYTES:sslv3 alert bad certificate
...

为使操作成功,需将由 CA 签署的客户端证书提供给服务器:

$ curl --cacert /path/to/ca.crt --cert /path/to/client.crt --key /path/to/client.key \
  -L https://127.0.0.1:2379/v2/keys/foo -XPUT -d value=bar -v

输出应包含:

...
SSLv3, TLS handshake, CERT verify (15):
...
TLS handshake, Finished (20)

同时,服务器的响应如下:

{
    "action": "set",
    "node": {
        "createdIndex": 12,
        "key": "/foo",
        "modifiedIndex": 12,
        "value": "bar"
    }
}

指定要阻止的加密套件 弱 TLS 加密套件 。

当客户端使用无效的加密套件请求 Client Hello 时,TLS 握手将失败。

例如:

$ etcd \
  --cert-file ./server.crt \
  --key-file ./server.key \
  --trusted-ca-file ./ca.crt \
  --cipher-suites TLS_ECDHE_RSA_WITH_AES_128_GCM_SHA256,TLS_ECDHE_RSA_WITH_AES_256_GCM_SHA384

然后,客户端请求必须指定服务器中指定的加密套件之一:

# valid cipher suite
$ curl \
  --cacert /path/to/ca.crt \
  --cert /path/to/client.crt \
  --key /path/to/client.key \
  -L [CLIENT-URL]/metrics \
  --ciphers ECDHE-RSA-AES128-GCM-SHA256

# request succeeds
etcd_server_version{server_version="3.2.22"} 1
...
# invalid cipher suite
$ curl \
  --cacert /path/to/ca.crt \
  --cert /path/to/client.crt \
  --key /path/to/client.key \
  -L [CLIENT-URL]/metrics \
  --ciphers ECDHE-RSA-DES-CBC3-SHA

# request fails with
(35) error:14094410:SSL routines:ssl3_read_bytes:sslv3 alert handshake failure

示例 3:集群中的传输安全与客户端证书

etcd 支持与上述相同的模型用于 对等成员通信,即集群中 etcd 成员之间的通信。

假设我们已拥有 ca.crt,以及两个分别使用该 CA 签署其密钥对的成员(member1.crt 与 member1.key,member2.crt 与 member2.key),则按如下方式启动 etcd:

DISCOVERY_URL=... # from https://discovery.etcd.io/new

# member1
$ etcd --name infra1 --data-dir infra1 \
  --peer-client-cert-auth --peer-trusted-ca-file=/path/to/ca.crt --peer-cert-file=/path/to/member1.crt --peer-key-file=/path/to/member1.key \
  --initial-advertise-peer-urls=https://10.0.1.10:2380 --listen-peer-urls=https://10.0.1.10:2380 \
  --discovery ${DISCOVERY_URL}

# member2
$ etcd --name infra2 --data-dir infra2 \
  --peer-client-cert-auth --peer-trusted-ca-file=/path/to/ca.crt --peer-cert-file=/path/to/member2.crt --peer-key-file=/path/to/member2.key \
  --initial-advertise-peer-urls=https://10.0.1.11:2380 --listen-peer-urls=https://10.0.1.11:2380 \
  --discovery ${DISCOVERY_URL}

etcd 成员将组成一个集群,集群内成员之间的所有通信均将使用客户端证书进行加密和身份认证。etcd 的输出将显示其连接的地址使用 HTTPS。

示例 4:自动生成的自签名传输安全

警告

指定 ClientAutoTLS 和 PeerAutoTLS 时,etcd 自动生成的客户端证书和对等成员证书的有效期仅为 1 年。可以指定 –self-signed-cert-validity 标志来设置证书的有效期(以年为单位)。

当仅需通信加密而无需身份认证时,etcd 支持使用自动生成的自签名证书对消息进行加密。此举简化了部署流程,无需在 etcd 外部管理证书和密钥。

通过标志 --auto-tls 和 --peer-auto-tls 配置 etcd,使其对客户端和对等成员连接使用自签名证书:

DISCOVERY_URL=... # from https://discovery.etcd.io/new

# member1
$ etcd --name infra1 --data-dir infra1 \
  --auto-tls --peer-auto-tls \
  --initial-advertise-peer-urls=https://10.0.1.10:2380 --listen-peer-urls=https://10.0.1.10:2380 \
  --discovery ${DISCOVERY_URL}

# member2
$ etcd --name infra2 --data-dir infra2 \
  --auto-tls --peer-auto-tls \
  --initial-advertise-peer-urls=https://10.0.1.11:2380 --listen-peer-urls=https://10.0.1.11:2380 \
  --discovery ${DISCOVERY_URL}

自签名证书无法验证身份,因此 curl 会返回错误:

curl: (60) SSL certificate problem: Invalid certificate chain

要禁用证书链检查,请使用 -k 标志调用 curl:

$ curl -k https://127.0.0.1:2379/v2/keys/foo -Xput -d value=bar -v

DNS SRV 服务记录说明

自 v3.1.0 版本起(v3.2.9 除外),发现 SRV 引导通过 ServerName 的根域名来认证 --discovery-srv 标志指定的域名。此举旨在防止中间人证书攻击,要求证书的 Subject Alternative Name(SAN)字段中必须包含与根域名匹配的条目。例如,etcd --discovery-srv=etcd.local 仅在提供的证书中包含根域名 etcd.local 作为 SAN 字段条目时,才会认证对等成员/客户端。

etcd 代理使用说明

etcd 代理在连接安全时终止来自客户端的 TLS,并使用在 --peer-key-file 和 --peer-cert-file 中指定的代理自身密钥/证书与 etcd 成员通信。

代理通过给定成员的 --advertise-client-urls 和 --advertise-peer-urls 与 etcd 成员通信。它将客户端请求转发至 etcd 成员的已通告客户端 URL,同时通过 etcd 成员的已通告对等成员 URL 同步初始集群配置。

当为 etcd 成员启用客户端身份认证时,系统管理员必须确保代理的 --peer-cert-file 选项中指定的对等成员证书适用于该身份认证。如果启用了对等成员身份认证,则代理的对等成员证书也必须适用于对等成员身份认证。

TLS 身份认证注意事项

自 v3.2.0 起,客户端每次连接时都会重新加载 TLS 证书 。此机制在无需停止 etcd 服务器的情况下替换过期证书时非常有用;可通过用新证书覆盖旧证书来实现。每次连接时刷新证书的开销不应过大,但未来可通过引入缓存层进一步优化。示例测试可参见 这里 。

自 v3.2.0 起,服务器拒绝包含错误 IP 地址的对等成员证书 SAN 。例如,若对等成员证书的 Subject Alternative Name (SAN) 字段中包含任何 IP 地址,服务器仅在远程 IP 地址与其中任一 IP 地址匹配时才认证该对等成员。此举旨在防止未经授权的端点加入集群。例如,对等成员 B 的 CSR(含 cfssl)为:

{
  "CN": "etcd peer",
  "hosts": [
    "*.example.default.svc",
    "*.example.default.svc.cluster.local",
    "10.138.0.27"
  ],
  "key": {
    "algo": "rsa",
    "size": 2048
  },
  "names": [
    {
      "C": "US",
      "L": "CA",
      "ST": "San Francisco"
    }
  ]
}

当对等成员 B 的实际 IP 地址为 10.138.0.2 时,而非 10.138.0.27。当对等成员 B 尝试加入集群时,对等成员 A 将以错误 x509: certificate is valid for 10.138.0.27, not 10.138.0.2 拒绝 B 的加入请求,因为 B 的远程 IP 地址与 Subject Alternative Name (SAN) 字段中的地址不匹配。

自 v3.2.0 起,服务器在检查 SAN 时会解析 TLS DNSNames。例如,若对等成员证书的 Subject Alternative Name(SAN)字段中仅包含 DNS 名称(无 IP 地址),则服务器仅在对这些 DNS 名称执行正向查找(dig b.com)并确认其解析出的 IP 地址与远程 IP 地址匹配时,才完成对等成员的身份认证。例如,对等成员 B 的 CSR(含 cfssl)为:

{
  "CN": "etcd peer",
  "hosts": [
    "b.com"
  ],

当对等成员 B 的远程 IP 地址为 10.138.0.2 时。当对等成员 B 尝试加入集群时,对等成员 A 会查找入站主机 b.com 以获取 IP 地址列表(例如 dig b.com)。如果该列表不包含 IP 10.138.0.2,则拒绝 B 的加入请求,并返回错误 tls: 10.138.0.2 does not match any of DNSNames ["b.com"]。

自 v3.2.2 起,服务器在 IP 地址匹配时接受连接,不再检查 DNS 条目 。例如,若对等成员证书中的 Subject Alternative Name (SAN) 字段包含 IP 地址和 DNS 名称,且远程 IP 地址与其中任一 IP 地址匹配,服务器将直接接受连接,不再进一步验证 DNS 名称。例如,对等成员 B 的 CSR(含 cfssl)为:

{
  "CN": "etcd peer",
  "hosts": [
    "invalid.domain",
    "10.138.0.2"
  ],

当对等成员 B 的远程 IP 地址为 10.138.0.2 且 invalid.domain 为无效主机时,对等成员 B 尝试加入集群,对等成员 A 可成功对 B 进行身份认证,因为主题备用名称(SAN)字段包含有效的匹配 IP 地址。详情请参见 issue#8206 。

自 v3.2.5 起,服务器支持对通配符 DNS 的反向查找 SAN 。例如,若对等成员证书中的 Subject Alternative Name(SAN)字段仅包含 DNS 名称(无 IP 地址),服务器首先对远程 IP 地址执行反向查找,以获取映射到该地址的一组名称(例如 nslookup IPADDR)。若这些名称中存在与对等成员证书中 DNS 名称匹配的名称(通过精确匹配或通配符匹配),则接受连接。若无匹配项,服务器将对证书中的每个 DNS 条目执行正向查找(例如,当条目为 *.example.default.svc 时,查找 example.default.svc),仅当主机解析出的地址中包含与对等成员远程 IP 地址匹配的 IP 地址时,才接受连接。例如,对等成员 B 的 CSR(含 cfssl)为:

{
  "CN": "etcd peer",
  "hosts": [
    "*.example.default.svc",
    "*.example.default.svc.cluster.local"
  ],

当对等成员 B 的远程 IP 地址为 10.138.0.2 时。对等成员 B 尝试加入集群,对等成员 A 会反向查找 IP 10.138.0.2 以获取主机名列表,并将主机名与对等成员 B 证书中 Subject Alternative Name (SAN) 字段的 DNS 名称进行精确匹配或通配符匹配。若反向或正向查找均失败,将返回错误 "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"]。详情请参见 issue#8268 。

v3.3.0 引入 etcd --peer-cert-allowed-cn 标志,以支持对等成员间连接的 基于 CN(通用名称)的身份认证 。Kubernetes TLS 引导机制涉及为 etcd 成员及其他系统组件(例如 API 服务器、kubelet 等)生成动态证书。为每个组件维护不同的 CA 可提供对 etcd 集群更严格的访问控制,但通常较为繁琐。当指定 –peer-cert-allowed-cn 标志时,节点仅能以匹配的通用名称加入集群,即使使用共享 CA 亦然。匹配方式为与证书的通用名称(CN)字段进行精确字符串比较——不支持通配符或前缀匹配。对于基于主机名的过滤,使用 –peer-cert-allowed-hostname 或 –client-cert-allowed-hostname 时,匹配采用 Go 的 x509.Certificate.VerifyHostname() 函数,支持精确主机名及通配符条目(例如 *.example.com)。例如,三节点集群中每个成员使用 CSRs(通过 cfssl)配置如下:

{
  "CN": "etcd.local",
  "hosts": [
    "m1.etcd.local",
    "127.0.0.1",
    "localhost"
  ],
{
  "CN": "etcd.local",
  "hosts": [
    "m2.etcd.local",
    "127.0.0.1",
    "localhost"
  ],
{
  "CN": "etcd.local",
  "hosts": [
    "m3.etcd.local",
    "127.0.0.1",
    "localhost"
  ],

若提供了 --peer-cert-allowed-cn etcd.local,则仅对等成员中 Common Name 匹配的才会被认证。若证书签名请求(CSR)中的 CN 不同,或 --peer-cert-allowed-cn 不同,则节点将被拒绝:

$ etcd --peer-cert-allowed-cn m1.etcd.local

I | embed: rejected connection from "127.0.0.1:48044" (error "CommonName authentication failed", ServerName "m1.etcd.local")
I | embed: rejected connection from "127.0.0.1:55702" (error "remote error: tls: bad certificate", ServerName "m3.etcd.local")

每个进程应以以下方式启动:

etcd --peer-cert-allowed-cn etcd.local

I | pkg/netutil: resolving m3.etcd.local:32380 to 127.0.0.1:32380
I | pkg/netutil: resolving m2.etcd.local:22380 to 127.0.0.1:22380
I | pkg/netutil: resolving m1.etcd.local:2380 to 127.0.0.1:2380
I | etcdserver: published {Name:m3 ClientURLs:[https://m3.etcd.local:32379]} to cluster 9db03f09b20de32b
I | embed: ready to serve client requests
I | etcdserver: published {Name:m1 ClientURLs:[https://m1.etcd.local:2379]} to cluster 9db03f09b20de32b
I | embed: ready to serve client requests
I | etcdserver: published {Name:m2 ClientURLs:[https://m2.etcd.local:22379]} to cluster 9db03f09b20de32b
I | embed: ready to serve client requests
I | embed: serving client requests on 127.0.0.1:32379
I | embed: serving client requests on 127.0.0.1:22379
I | embed: serving client requests on 127.0.0.1:2379

v3.2.19 和 v3.3.4 修复了当 证书 SAN 字段仅包含 IP 地址而无域名 时的 TLS 重载问题。例如,成员使用如下 CSRs(含 cfssl)进行配置:

{
  "CN": "etcd.local",
  "hosts": [
    "127.0.0.1"
  ],

在 Go 中,仅当服务器的 (*tls.Config).Certificates 字段非空,或客户端提供了有效 SNI 且 (*tls.ClientHelloInfo).ServerName 非空时,服务器才会调用 (*tls.Config).GetCertificate 以重新加载 TLS。此前,etcd 始终在初始客户端 TLS 握手时填充 (*tls.Config).Certificates(非空)。因此,客户端始终需提供匹配的 SNI,以通过 TLS 验证并触发 (*tls.Config).GetCertificate 重新加载 TLS 资产。

不过,如果证书的 SAN 字段 不包含任何域名而只有 IP 地址 ,请求中的 *tls.ClientHelloInfo 会带有空的 ServerName 字段,导致初始 TLS 握手无法触发 TLS 重载;需要在线替换过期证书时,这就会成为问题。

现在,(*tls.Config).Certificates 在初始 TLS 客户端握手时被创建为空,首先用于触发 (*tls.Config).GetCertificate,然后在每次新的 TLS 连接时填充其余证书,即使客户端 SNI 为空(例如,证书仅包含 IP 地址)。

主机白名单说明

etcd --host-whitelist 标志指定可接受的 HTTP 客户端请求主机名。客户端来源策略可防范针对不安全 etcd 服务器的 “DNS 重绑定” 攻击。即,任何网站均可创建一个合法的 DNS 名称,并将 DNS 指向 "localhost"(或其他任意地址)。随后,监听在 "localhost" 上的 etcd 服务器所有 HTTP 端点均可能被访问,从而面临 DNS 重绑定攻击。详情请参见 CVE-2018-5702 。

客户端来源策略的工作方式如下:

  1. 若客户端通过 HTTPS 安全连接,则允许任意主机名。
  2. 若客户端连接不安全且 "HostWhitelist" 非空,则仅允许 Host 字段在白名单中的 HTTP 请求。

请注意,无论是否启用身份认证,客户端来源策略均会被强制执行,以实现更严格的控制。

默认情况下,etcd --host-whitelist 和 embed.Config.HostWhitelist 被设置为 空,以允许所有主机名。请注意,指定主机名时,环回地址不会自动添加。如需允许环回接口,应手动将其添加至白名单(例如 "localhost"、"127.0.0.1" 等)。

常见问题解答

我在使用 TLS 客户端身份认证时遇到 SSLv3 握手失败错误?

crypto/tls 包中的 golang 在使用证书公钥前会检查其键用途。 要使用证书公钥进行客户端认证,创建证书公钥时需在 clientAuth 中添加 Extended Key Usage。

操作方法如下:

在 OpenSSL.cnf 中添加以下章节:

[ ssl_client ]
...
  extendedKeyUsage = clientAuth
...

生成证书时,请确保在 -extensions 标志中引用该证书:

$ openssl ca -config openssl.cnf -policy policy_anything -extensions ssl_client -out certs/machine.crt -infiles machine.csr

使用对等证书身份认证时,我收到“证书有效域名是 127.0.0.1,不是$MY_IP”

请确保使用成员的公网 IP 地址作为证书的主体名称(Subject Name)进行签名。例如,etcd-ca 工具为 new-cert 命令提供了 --ip= 选项。

证书需在成员的完全限定域名(FQDN)作为其主题名称(Subject Name)时进行签名,使用主题备用名称(IP SANs)添加 IP 地址。etcd-ca 工具为 new-cert 命令提供 --domain= 选项,OpenSSL 也可实现 it 。

etcd 是否对磁盘上存储的数据进行加密?

etcd 不会对存储在磁盘驱动器上的键值数据进行加密。若用户需要对存储在 etcd 中的数据进行加密,可选择以下方案:

  • 由客户端应用程序负责对数据进行加密和解密
  • 使用底层存储系统的加密功能,例如 dm-crypt

当 etcd 创建某些新目录时,会将文件权限设置为 700,以尽可能防止非特权访问。然而,如果用户已使用自定义偏好创建了目录,etcd 将使用现有目录,并在权限与 700 不同时记录警告消息。

4 - 集群指南

配置 etcd 集群:静态配置、etcd 发现和 DNS 发现

概述

静态启动 etcd 集群要求每个成员均知晓集群中的其他成员。在某些情况下,集群成员的 IP 地址可能无法提前确定。在这些情况下,可以借助发现服务来引导启动 etcd 集群。

一旦 etcd 集群启动并运行,添加或移除成员需通过 运行时重配置 完成。为更好地理解运行时重配置的设计原理,建议阅读 运行时配置设计文档 。

本文将介绍用于引导 etcd 集群的以下机制:

每个引导机制将用于创建一个由三台机器组成的 etcd 集群,具体细节如下:

名称地址主机名
infra010.0.1.10infra0.example.com
infra110.0.1.11infra1.example.com
infra210.0.1.12infra2.example.com

静态

如已知晓集群成员、其地址及集群规模,可在启动前通过设置 initial-cluster 标志使用离线引导配置。每台机器将获取以下任一环境变量或命令行参数:

ETCD_INITIAL_CLUSTER="infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380"
ETCD_INITIAL_CLUSTER_STATE=new
--initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
--initial-cluster-state new

请注意,initial-cluster 中指定的 URL 是 已通告的对等成员 URL,即它们应与相应节点上 initial-advertise-peer-urls 的值匹配。

若为测试目的而启动多个集群(或创建并销毁单个集群),强烈建议为每个集群分配一个唯一的 initial-cluster-token。通过此操作,即使各集群配置完全相同,etcd 仍可为各集群生成唯一的集群 ID 和成员 ID。此举可防止集群间相互干扰,避免造成集群数据损坏。

etcd 在 listen-client-urls 监听以接收客户端流量。etcd 成员会向其他成员、代理和客户端通告 advertise-client-urls 中指定的 URL。请注意,advertise-client-urls 必须对目标客户端可达。常见错误是将 advertise-client-urls 设置为 localhost,或在远程客户端需访问 etcd 时未更改默认值。

在每台机器上,使用以下标志启动 etcd:

$ etcd --name infra0 --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-state new
$ etcd --name infra1 --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --listen-client-urls http://10.0.1.11:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-state new
$ etcd --name infra2 --initial-advertise-peer-urls http://10.0.1.12:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --listen-client-urls http://10.0.1.12:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.12:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-state new

以 --initial-cluster 开头的命令行参数在 etcd 的后续运行中将被忽略。引导过程完成后,可自由移除环境变量或命令行标志。如需后续修改配置(例如向集群中添加或移除成员),请参阅 runtime configuration 指南。

TLS

etcd 通过 TLS 协议支持加密通信。TLS 通道可用于对等成员之间的集群内部加密通信,也可用于客户端流量的加密。本节提供配置启用对等成员和客户端 TLS 的集群示例。有关 etcd TLS 支持的更多详细信息,请参阅 security guide 。

自签名证书

使用自签名证书的集群可同时实现流量加密和连接身份认证。要启动使用自签名证书的集群,每个集群成员应拥有唯一的密钥对(member.crt、member.key),并由共享的集群 CA 证书(ca.crt)分别对对等成员连接和客户端连接的证书进行签名。证书可通过参考 etcd TLS 设置 示例生成。

在每台机器上,etcd 将使用以下标志启动:

$ etcd --name infra0 --initial-advertise-peer-urls https://10.0.1.10:2380 \
  --listen-peer-urls https://10.0.1.10:2380 \
  --listen-client-urls https://10.0.1.10:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.10:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --client-cert-auth --trusted-ca-file=/path/to/ca-client.crt \
  --cert-file=/path/to/infra0-client.crt --key-file=/path/to/infra0-client.key \
  --peer-client-cert-auth --peer-trusted-ca-file=ca-peer.crt \
  --peer-cert-file=/path/to/infra0-peer.crt --peer-key-file=/path/to/infra0-peer.key
$ etcd --name infra1 --initial-advertise-peer-urls https://10.0.1.11:2380 \
  --listen-peer-urls https://10.0.1.11:2380 \
  --listen-client-urls https://10.0.1.11:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.11:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --client-cert-auth --trusted-ca-file=/path/to/ca-client.crt \
  --cert-file=/path/to/infra1-client.crt --key-file=/path/to/infra1-client.key \
  --peer-client-cert-auth --peer-trusted-ca-file=ca-peer.crt \
  --peer-cert-file=/path/to/infra1-peer.crt --peer-key-file=/path/to/infra1-peer.key
$ etcd --name infra2 --initial-advertise-peer-urls https://10.0.1.12:2380 \
  --listen-peer-urls https://10.0.1.12:2380 \
  --listen-client-urls https://10.0.1.12:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.12:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --client-cert-auth --trusted-ca-file=/path/to/ca-client.crt \
  --cert-file=/path/to/infra2-client.crt --key-file=/path/to/infra2-client.key \
  --peer-client-cert-auth --peer-trusted-ca-file=ca-peer.crt \
  --peer-cert-file=/path/to/infra2-peer.crt --peer-key-file=/path/to/infra2-peer.key

自动证书管理

如果集群需要加密通信但不需要身份认证连接,etcd 可配置为自动为其生成密钥。在初始化时,每个成员会根据其通告的 IP 地址和主机名自动生成一组密钥。

在每台机器上,etcd 将使用以下标志启动:

$ etcd --name infra0 --initial-advertise-peer-urls https://10.0.1.10:2380 \
  --listen-peer-urls https://10.0.1.10:2380 \
  --listen-client-urls https://10.0.1.10:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.10:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --auto-tls \
  --peer-auto-tls
$ etcd --name infra1 --initial-advertise-peer-urls https://10.0.1.11:2380 \
  --listen-peer-urls https://10.0.1.11:2380 \
  --listen-client-urls https://10.0.1.11:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.11:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --auto-tls \
  --peer-auto-tls
$ etcd --name infra2 --initial-advertise-peer-urls https://10.0.1.12:2380 \
  --listen-peer-urls https://10.0.1.12:2380 \
  --listen-client-urls https://10.0.1.12:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://10.0.1.12:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster infra0=https://10.0.1.10:2380,infra1=https://10.0.1.11:2380,infra2=https://10.0.1.12:2380 \
  --initial-cluster-state new \
  --auto-tls \
  --peer-auto-tls

错误案例

在以下示例中,我们未将新主机包含在已枚举节点的列表中。如果这是一个新集群,该节点必须添加到初始集群成员列表中。

$ etcd --name infra1 --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls https://10.0.1.11:2380 \
  --listen-client-urls http://10.0.1.11:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380 \
  --initial-cluster-state new
etcd: infra1 not listed in the initial cluster config
exit 1

在此示例中,我们尝试将一个节点(infra0)映射到与其在集群列表中枚举的地址(10.0.1.10:2380)不同的地址(127.0.0.1:2380)。如果该节点需监听多个地址,则所有地址 必须 在 “initial-cluster” 配置指令中反映出来。

$ etcd --name infra0 --initial-advertise-peer-urls http://127.0.0.1:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-state=new
etcd: error setting up initial cluster: infra0 has different advertised URLs in the cluster and advertised peer URLs list
exit 1

如果对等成员使用了不同的配置参数集并尝试加入此集群,etcd 将报告集群 ID 不匹配并退出。

$ etcd --name infra3 --initial-advertise-peer-urls http://10.0.1.13:2380 \
  --listen-peer-urls http://10.0.1.13:2380 \
  --listen-client-urls http://10.0.1.13:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.13:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra3=http://10.0.1.13:2380 \
  --initial-cluster-state=new
etcd: conflicting cluster ID to the target cluster (c6ab534d07e8fcc4 != bc25ea2a74fb18b0). Exiting.
exit 1

发现

在多种情况下,集群对等成员的 IP 地址可能无法提前知晓。这在使用云服务提供商或网络采用 DHCP 时较为常见。在这种情况下,应避免指定静态配置,而是利用现有的 etcd 集群来引导新集群。此过程称为“发现”。

有两种可用于发现的方法:

  • etcd 发现服务
  • DNS SRV 记录

etcd 发现

为更好地理解发现服务协议的设计,建议阅读发现服务协议 documentation 。

发现 URL 的生命周期

发现 URL 用于标识一个唯一的 etcd 集群。每个 etcd 实例应共享一个新的发现 URL,以引导新集群,而非复用现有的发现 URL。

此外,发现 URL 仅可用于集群的初始引导。若需在集群运行后更改集群成员关系,请参阅 运行时重配置 指南。

自定义 etcd 发现服务

发现机制通过现有的集群来引导自身。若使用私有 etcd 集群,请按如下方式创建 URL:

$ curl -X PUT https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83/_config/size -d value=3

通过将 size 键设置为 URL,可创建一个预期集群大小为 3 的发现 URL。

此情况下使用的 URL 为 https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83,etcd 成员在启动时将使用 https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 目录进行注册。

每个成员必须指定不同的名称标志。Hostname 或 machine-id 是不错的选择。否则,由于名称重复,发现将失败。

现在我们为每个成员启动 etcd,并设置相关标志:

$ etcd --name infra0 --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --discovery https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83
$ etcd --name infra1 --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --listen-client-urls http://10.0.1.11:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --discovery https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83
$ etcd --name infra2 --initial-advertise-peer-urls http://10.0.1.12:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --listen-client-urls http://10.0.1.12:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.12:2379 \
  --discovery https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83

这将导致每个成员向自定义的 etcd 发现服务注册自身,并在所有机器完成注册后启动集群。

公共 etcd 发现服务

如果无可用的现有集群,可使用托管在 discovery.etcd.io 的公共发现服务。若要使用“new”端点创建私有发现 URL,请使用以下命令:

$ curl https://discovery.etcd.io/new?size=3
https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de

这将创建一个初始大小为 3 个成员的集群。若未指定大小,则默认使用 3。

ETCD_DISCOVERY=https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de
--discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de

每个成员必须指定不同的名称标志,否则由于名称重复,发现将失败。Hostname 或 machine-id 是不错的选择。

现在我们为每个成员启动 etcd,并设置相关标志:

$ etcd --name infra0 --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de
$ etcd --name infra1 --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --listen-client-urls http://10.0.1.11:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de
$ etcd --name infra2 --initial-advertise-peer-urls http://10.0.1.12:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --listen-client-urls http://10.0.1.12:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.12:2379 \
  --discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de

这将导致每个成员向发现服务注册自身,并在所有成员注册完成后启动集群。

使用环境变量 ETCD_DISCOVERY_PROXY 可使 etcd 通过 HTTP 代理连接发现服务。

错误和警告情况

发现服务器错误
$ etcd --name infra0 --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de
etcd: error: the cluster doesn’t have a size configuration value in https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de/_config
exit 1
警告

这是一个无害的警告,表示此机器将忽略发现 URL。

$ etcd --name infra0 --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --listen-client-urls http://10.0.1.10:2379,http://127.0.0.1:2379 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --discovery https://discovery.etcd.io/3e86b59982e49066c5d813af1c2e2579cbf573de
etcdserver: discovery token ignored since a cluster has already been initialized. Valid log found at /var/lib/etcd

DNS 发现

DNS SRV 记录 可用作发现机制。--discovery-srv 标志可用于设置发现 SRV 记录所在的 DNS 域名。 设置 --discovery-srv example.com 会导致按列出的顺序查找 DNS SRV 记录:

  • _etcd-server-ssl._tcp.example.com
  • _etcd-server._tcp.example.com

如果发现 _etcd-server-ssl._tcp.example.com,etcd 将尝试通过 TLS 执行引导过程。

为帮助客户端发现 etcd 集群,将按以下顺序查找下列 DNS SRV 记录:

  • _etcd-client._tcp.example.com
  • _etcd-client-ssl._tcp.example.com

如果发现 _etcd-client-ssl._tcp.example.com,客户端将尝试通过 SSL/TLS 与 etcd 集群通信。

如果 etcd 使用 TLS,发现 SRV 记录(例如 example.com)必须包含在 SSL 证书的 DNS SAN 中,且需与主机名一同列出,否则集群化将失败,并出现如下日志消息:

[...] rejected connection from "10.0.1.11:53162" (error "remote error: tls: bad certificate", ServerName "example.com")

如果 etcd 使用 TLS 但未使用自定义证书颁发机构,则发现域名(例如 example.com)必须与 SRV 记录域名(例如 infra1.example.com)匹配。此举旨在防范伪造 SRV 记录指向其他域名的攻击;若域名匹配,即使该域名在 PKI 下拥有有效证书,也不会被未知第三方控制。

-discovery-srv-name 标志还可配置在发现过程中查询的 SRV 名称后缀。 使用此标志可在同一域名下区分多个 etcd 集群。 例如,若 discovery-srv=example.com 和 -discovery-srv-name=foo 均已设置,则会执行以下 DNS SRV 查询:

  • _etcd-server-ssl-foo._tcp.example.com
  • _etcd-server-foo._tcp.example.com

创建 DNS SRV 记录

$ dig +noall +answer SRV _etcd-server._tcp.example.com
_etcd-server._tcp.example.com. 300 IN  SRV  0 0 2380 infra0.example.com.
_etcd-server._tcp.example.com. 300 IN  SRV  0 0 2380 infra1.example.com.
_etcd-server._tcp.example.com. 300 IN  SRV  0 0 2380 infra2.example.com.
$ dig +noall +answer SRV _etcd-client._tcp.example.com
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra0.example.com.
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra1.example.com.
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra2.example.com.
$ dig +noall +answer infra0.example.com infra1.example.com infra2.example.com
infra0.example.com.  300  IN  A  10.0.1.10
infra1.example.com.  300  IN  A  10.0.1.11
infra2.example.com.  300  IN  A  10.0.1.12

使用 DNS 引导 etcd 集群

etcd 集群成员可通告域名或 IP 地址,引导过程将解析 DNS A 记录。 自 3.2 版本起(3.1 版本会打印警告)--listen-peer-urls 和 --listen-client-urls 将拒绝为网络接口绑定使用域名。

--initial-advertise-peer-urls 中解析出的地址必须与 SRV 目标中的任一解析地址匹配。etcd 成员会读取解析地址,以判断其是否属于 SRV 记录中定义的集群。

$ etcd --name infra0 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://infra0.example.com:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://infra0.example.com:2379 \
--listen-client-urls http://0.0.0.0:2379 \
--listen-peer-urls http://0.0.0.0:2380
$ etcd --name infra1 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://infra1.example.com:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://infra1.example.com:2379 \
--listen-client-urls http://0.0.0.0:2379 \
--listen-peer-urls http://0.0.0.0:2380
$ etcd --name infra2 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://infra2.example.com:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://infra2.example.com:2379 \
--listen-client-urls http://0.0.0.0:2379 \
--listen-peer-urls http://0.0.0.0:2380

集群也可使用 IP 地址而非域名进行引导:

$ etcd --name infra0 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://10.0.1.10:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://10.0.1.10:2379 \
--listen-client-urls http://10.0.1.10:2379 \
--listen-peer-urls http://10.0.1.10:2380
$ etcd --name infra1 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://10.0.1.11:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://10.0.1.11:2379 \
--listen-client-urls http://10.0.1.11:2379 \
--listen-peer-urls http://10.0.1.11:2380
$ etcd --name infra2 \
--discovery-srv example.com \
--initial-advertise-peer-urls http://10.0.1.12:2380 \
--initial-cluster-token etcd-cluster-1 \
--initial-cluster-state new \
--advertise-client-urls http://10.0.1.12:2379 \
--listen-client-urls http://10.0.1.12:2379 \
--listen-peer-urls http://10.0.1.12:2380

自 v3.1.0 版本起(v3.2.9 除外),当 etcd --discovery-srv=example.com 配置了 TLS 时,服务器仅在提供的证书中包含根域名 example.com 作为主题备用名称(SAN)字段的条目时,才会对对等成员/客户端进行身份认证。参见 DNS SRV 说明 。

网关

etcd 网关是一个简单的 TCP 代理,用于将网络数据转发至 etcd 集群。请参阅 网关指南 以获取更多信息。

代理

当设置 --proxy 标志时,etcd 以 代理模式 运行。该代理模式仅支持 etcd v2 API;目前无计划支持 v3 API。对于 v3 API 支持,将在 etcd 3.0 发布后推出具备增强功能的新代理。

要使用 v2 API 代理搭建 etcd 集群,请阅读 etcd 2.3 版本发布中的 集群化文档 。

5 - 以 Kubernetes StatefulSet 运行 etcd 集群

以 Kubernetes StatefulSet 运行 etcd

以下演示如何作为 Kubernetes StatefulSet 执行 静态引导过程 。

示例 Manifest

本文档包含用于在 Kubernetes 中部署静态 etcd 集群的服务和有状态集(StatefulSet)配置。

如果将清单内容复制到名为 etcd.yaml 的文件中,可使用以下命令将其应用到集群。

$ kubectl apply --filename etcd.yaml

应用后,请等待 Pod 进入就绪状态。

$ kubectl get pods
NAME     READY   STATUS    RESTARTS   AGE
etcd-0   1/1     Running   0          24m
etcd-1   1/1     Running   0          24m
etcd-2   1/1     Running   0          24m

示例中使用的容器包含 etcdctl,可直接在 Pod 内调用。

$ kubectl exec -it etcd-0 -- etcdctl member list -wtable
+------------------+---------+--------+-------------------------+-------------------------+------------+
|        ID        | STATUS  |  NAME  |       PEER ADDRS        |      CLIENT ADDRS       | IS LEARNER |
+------------------+---------+--------+-------------------------+-------------------------+------------+
| 4f98c3545405a0b0 | started | etcd-2 | http://etcd-2.etcd:2380 | http://etcd-2.etcd:2379 |      false |
| a394e0ee91773643 | started | etcd-0 | http://etcd-0.etcd:2380 | http://etcd-0.etcd:2379 |      false |
| d10297b8d2f01265 | started | etcd-1 | http://etcd-1.etcd:2380 | http://etcd-1.etcd:2379 |      false |
+------------------+---------+--------+-------------------------+-------------------------+------------+

使用自签名证书部署时,请参考以 ## TLS 开头的注释配置标题,查找可取消注释的配置项。使用 cert-manager 生成证书的额外说明包含在下方章节中。

# file: etcd.yaml
---
apiVersion: v1
kind: Service
metadata:
  name: etcd
  namespace: default
spec:
  type: ClusterIP
  clusterIP: None
  selector:
    app: etcd
  ##
  ## Ideally we would use SRV records to do peer discovery for initialization.
  ## Unfortunately discovery will not work without logic to wait for these to
  ## populate in the container. This problem is relatively easy to overcome by
  ## making changes to prevent the etcd process from starting until the records
  ## have populated. The documentation on statefulsets briefly talk about it.
  ##   https://kubernetes.io/docs/concepts/workloads/controllers/statefulset/#stable-network-id
  publishNotReadyAddresses: true
  ##
  ## The naming scheme of the client and server ports match the scheme that etcd
  ## uses when doing discovery with SRV records.
  ports:
  - name: etcd-client
    port: 2379
  - name: etcd-server
    port: 2380
  - name: etcd-metrics
    port: 8080
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  namespace: default
  name: etcd
spec:
  ##
  ## The service name is being set to leverage the service headlessly.
  ## https://kubernetes.io/docs/concepts/services-networking/service/#headless-services
  serviceName: etcd
  ##
  ## If you are increasing the replica count of an existing cluster, you should
  ## also update the --initial-cluster-state flag as noted further down in the
  ## container configuration.
  replicas: 3
  ##
  ## For initialization, the etcd pods must be available to eachother before
  ## they are "ready" for traffic. The "Parallel" policy makes this possible.
  podManagementPolicy: Parallel
  ##
  ## To ensure availability of the etcd cluster, the rolling update strategy
  ## is used. For availability, there must be at least 51% of the etcd nodes
  ## online at any given time.
  updateStrategy:
    type: RollingUpdate
  ##
  ## This is label query over pods that should match the replica count.
  ## It must match the pod template's labels. For more information, see the
  ## following documentation:
  ##   https://kubernetes.io/docs/concepts/overview/working-with-objects/labels/#label-selectors
  selector:
    matchLabels:
      app: etcd
  ##
  ## Pod configuration template.
  template:
    metadata:
      ##
      ## The labeling here is tied to the "matchLabels" of this StatefulSet and
      ## "affinity" configuration of the pod that will be created.
      ##
      ## This example's labeling scheme is fine for one etcd cluster per
      ## namespace, but should you desire multiple clusters per namespace, you
      ## will need to update the labeling schema to be unique per etcd cluster.
      labels:
        app: etcd
      annotations:
        ##
        ## This gets referenced in the etcd container's configuration as part of
        ## the DNS name. It must match the service name created for the etcd
        ## cluster. The choice to place it in an annotation instead of the env
        ## settings is because there should only be 1 service per etcd cluster.
        serviceName: etcd
    spec:
      ##
      ## Configuring the node affinity is necessary to prevent etcd servers from
      ## ending up on the same hardware together.
      ##
      ## See the scheduling documentation for more information about this:
      ##   https://kubernetes.io/docs/concepts/scheduling-eviction/assign-pod-node/#node-affinity
      affinity:
        ## The podAntiAffinity is a set of rules for scheduling that describe
        ## when NOT to place a pod from this StatefulSet on a node.
        podAntiAffinity:
          ##
          ## When preparing to place the pod on a node, the scheduler will check
          ## for other pods matching the rules described by the labelSelector
          ## separated by the chosen topology key.
          requiredDuringSchedulingIgnoredDuringExecution:
          ## This label selector is looking for app=etcd
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - etcd
            ## This topology key denotes a common label used on nodes in the
            ## cluster. The podAntiAffinity configuration essentially states
            ## that if another pod has a label of app=etcd on the node, the
            ## scheduler should not place another pod on the node.
            ##   https://kubernetes.io/docs/reference/labels-annotations-taints/#kubernetesiohostname
            topologyKey: "kubernetes.io/hostname"
      ##
      ## Containers in the pod
      containers:
      ## This example only has this etcd container.
      - name: etcd
        image: quay.io/coreos/etcd:v3.7.0
        imagePullPolicy: IfNotPresent
        ports:
        - name: etcd-client
          containerPort: 2379
        - name: etcd-server
          containerPort: 2380
        - name: etcd-metrics
          containerPort: 8080
        ##
        ## These probes will fail over TLS for self-signed certificates, so etcd
        ## is configured to deliver metrics over port 8080 further down.
        ##
        ## As mentioned in the "Monitoring etcd" page, /readyz and /livez were
        ## added in v3.5.12. Prior to this, monitoring required extra tooling
        ## inside the container to make these probes work.
        ##
        ## The values in this readiness probe should be further validated, it
        ## is only an example configuration.
        readinessProbe:
          httpGet:
            path: /readyz
            port: 8080
          initialDelaySeconds: 10
          periodSeconds: 5
          timeoutSeconds: 5
          successThreshold: 1
          failureThreshold: 30
        ## The values in this liveness probe should be further validated, it
        ## is only an example configuration.
        livenessProbe:
          httpGet:
            path: /livez
            port: 8080
          initialDelaySeconds: 15
          periodSeconds: 10
          timeoutSeconds: 5
          failureThreshold: 3
        env:
        ##
        ## Environment variables defined here can be used by other parts of the
        ## container configuration. They are interpreted by Kubernetes, instead
        ## of in the container environment.
        ##
        ## These env vars pass along information about the pod.
        - name: K8S_NAMESPACE
          valueFrom:
            fieldRef:
             fieldPath: metadata.namespace
        - name: HOSTNAME
          valueFrom:
            fieldRef:
             fieldPath: metadata.name
        - name: SERVICE_NAME
          valueFrom:
            fieldRef:
              fieldPath: metadata.annotations['serviceName']
        ##
        ## Configuring etcdctl inside the container to connect to the etcd node
        ## in the container reduces confusion when debugging.
        - name: ETCDCTL_ENDPOINTS
          value: $(HOSTNAME).$(SERVICE_NAME):2379
        ##
        ## TLS client configuration for etcdctl in the container.
        ## These files paths are part of the "etcd-client-certs" volume mount.
        # - name: ETCDCTL_KEY
        #   value: /etc/etcd/certs/client/tls.key
        # - name: ETCDCTL_CERT
        #   value: /etc/etcd/certs/client/tls.crt
        # - name: ETCDCTL_CACERT
        #   value: /etc/etcd/certs/client/ca.crt
        ##
        ## Use this URI_SCHEME value for non-TLS clusters.
        - name: URI_SCHEME
          value: "http"
        ## TLS: Use this URI_SCHEME for TLS clusters.
        # - name: URI_SCHEME
        # value: "https"
        ##
        ## If you're using a different container, the executable may be in a
        ## different location. This example uses the full path to help remove
        ## ambiguity to you, the reader.
        ## Often you can just use "etcd" instead of "/usr/local/bin/etcd" and it
        ## will work because the $PATH includes a directory containing "etcd".
        command:
        - /usr/local/bin/etcd
        ##
        ## Arguments used with the etcd command inside the container.
        args:
        ##
        ## Configure the name of the etcd server.
        - --name=$(HOSTNAME)
        ##
        ## Configure etcd to use the persistent storage configured below.
        - --data-dir=/data
        ##
        ## In this example we're consolidating the WAL into sharing space with
        ## the data directory. This is not ideal in production environments and
        ## should be placed in it's own volume.
        - --wal-dir=/data/wal
        ##
        ## URL configurations are parameterized here and you shouldn't need to
        ## do anything with these.
        - --listen-peer-urls=$(URI_SCHEME)://0.0.0.0:2380
        - --listen-client-urls=$(URI_SCHEME)://0.0.0.0:2379
        - --advertise-client-urls=$(URI_SCHEME)://$(HOSTNAME).$(SERVICE_NAME):2379
        ##
        ## This must be set to "new" for initial cluster bootstrapping. To scale
        ## the cluster up, this should be changed to "existing" when the replica
        ## count is increased. If set incorrectly, etcd makes an attempt to
        ## start but fail safely.
        - --initial-cluster-state=new
        ##
        ## Token used for cluster initialization. The recommendation for this is
        ## to use a unique token for every cluster. This example parameterized
        ## to be unique to the namespace, but if you are deploying multiple etcd
        ## clusters in the same namespace, you should do something extra to
        ## ensure uniqueness amongst clusters.
        - --initial-cluster-token=etcd-$(K8S_NAMESPACE)
        ##
        ## The initial cluster flag needs to be updated to match the number of
        ## replicas configured. When combined, these are a little hard to read.
        ## Here is what a single parameterized peer looks like:
        ##   etcd-0=$(URI_SCHEME)://etcd-0.$(SERVICE_NAME):2380
        - --initial-cluster=etcd-0=$(URI_SCHEME)://etcd-0.$(SERVICE_NAME):2380,etcd-1=$(URI_SCHEME)://etcd-1.$(SERVICE_NAME):2380,etcd-2=$(URI_SCHEME)://etcd-2.$(SERVICE_NAME):2380
        ##
        ## The peer urls flag should be fine as-is.
        - --initial-advertise-peer-urls=$(URI_SCHEME)://$(HOSTNAME).$(SERVICE_NAME):2380
        ##
        ## This avoids probe failure if you opt to configure TLS.
        - --listen-metrics-urls=http://0.0.0.0:8080
        ##
        ## These are some configurations you may want to consider enabling, but
        ## should look into further to identify what settings are best for you.
        # - --auto-compaction-mode=periodic
        # - --auto-compaction-retention=10m
        ##
        ## TLS client configuration for etcd, reusing the etcdctl env vars.
        # - --client-cert-auth
        # - --trusted-ca-file=$(ETCDCTL_CACERT)
        # - --cert-file=$(ETCDCTL_CERT)
        # - --key-file=$(ETCDCTL_KEY)
        ##
        ## TLS server configuration for etcdctl in the container.
        ## These files paths are part of the "etcd-server-certs" volume mount.
        # - --peer-client-cert-auth
        # - --peer-trusted-ca-file=/etc/etcd/certs/server/ca.crt
        # - --peer-cert-file=/etc/etcd/certs/server/tls.crt
        # - --peer-key-file=/etc/etcd/certs/server/tls.key
        ##
        ## This is the mount configuration.
        volumeMounts:
        - name: etcd-data
          mountPath: /data
        ##
        ## TLS client configuration for etcdctl
        # - name: etcd-client-tls
        #   mountPath: "/etc/etcd/certs/client"
        #   readOnly: true
        ##
        ## TLS server configuration
        # - name: etcd-server-tls
        #   mountPath: "/etc/etcd/certs/server"
        #   readOnly: true
      volumes:
      ##
      ## TLS client configuration
      # - name: etcd-client-tls
      #   secret:
      #     secretName: etcd-client-tls
      #     optional: false
      ##
      ## TLS server configuration
      # - name: etcd-server-tls
      #   secret:
      #     secretName: etcd-server-tls
      #     optional: false
  ##
  ## This StatefulSet will uses the volumeClaimTemplate field to create a PVC in
  ## the cluster for each replica. These PVCs can not be easily resized later.
  volumeClaimTemplates:
  - metadata:
      name: etcd-data
    spec:
      accessModes: ["ReadWriteOnce"]
      ##
      ## In some clusters, it is necessary to explicitly set the storage class.
      ## This example will end up using the default storage class.
      # storageClassName: ""
      resources:
        requests:
          storage: 1Gi

生成证书

在本节中,使用 Helm 安装名为 cert-manager 的操作符。

在集群中安装 cert-manager 后,可在集群内生成自签名证书。生成的证书将存放在一个 Secret 对象中,该对象可作为文件挂载到容器中。

本文是用于安装 cert-manager 的 Helm 命令。

$ helm upgrade --install --create-namespace --namespace cert-manager cert-manager cert-manager --repo https://charts.jetstack.io --set crds.enabled=true

本文档提供了一个用于生成自签名证书的 ClusterIssuer 配置示例。

# file: issuer.yaml
apiVersion: cert-manager.io/v1
kind: ClusterIssuer
metadata:
  name: selfsigned
spec:
  selfSigned: {}

本清单为客户端和服务器证书创建 Certificate 对象,引用 ClusterIssuer “selfsigned”。dnsNames 应为 cert-manager 所创建证书的有效主机名的完整列表。

# file: certificates.yaml
---
apiVersion: cert-manager.io/v1
kind: Certificate
metadata:
  name: etcd-server
  namespace: default
spec:
  secretName: etcd-server-tls
  issuerRef:
    name: selfsigned
    kind: ClusterIssuer
  commonName: etcd
  dnsNames:
  - etcd
  - etcd.default
  - etcd.default.svc.cluster.local
  - etcd-0
  - etcd-0.etcd
  - etcd-0.etcd.default
  - etcd-0.etcd.default.svc
  - etcd-0.etcd.default.svc.cluster.local
  - etcd-1
  - etcd-1.etcd
  - etcd-1.etcd.default
  - etcd-1.etcd.default.svc
  - etcd-1.etcd.default.svc.cluster.local
  - etcd-2
  - etcd-2.etcd
  - etcd-2.etcd.default
  - etcd-2.etcd.default.svc
  - etcd-2.etcd.default.svc.cluster.local
---
apiVersion: cert-manager.io/v1
kind: Certificate
metadata:
  name: etcd-client
  namespace: default
spec:
  secretName: etcd-client-tls
  issuerRef:
    name: selfsigned
    kind: ClusterIssuer
  commonName: etcd
  dnsNames:
  - etcd
  - etcd.default
  - etcd.default.svc.cluster.local
  - etcd-0
  - etcd-0.etcd
  - etcd-0.etcd.default
  - etcd-0.etcd.default.svc
  - etcd-0.etcd.default.svc.cluster.local
  - etcd-1
  - etcd-1.etcd
  - etcd-1.etcd.default
  - etcd-1.etcd.default.svc
  - etcd-1.etcd.default.svc.cluster.local
  - etcd-2
  - etcd-2.etcd
  - etcd-2.etcd.default
  - etcd-2.etcd.default.svc
  - etcd-2.etcd.default.svc.cluster.local

6 - 在容器中运行 etcd 集群

使用静态引导在 Docker 中运行 etcd

本文指南展示了如何使用 Docker 以 静态引导过程 运行 etcd。

Docker

为使 Docker 主机外部的客户端能够访问 etcd API,请使用容器的主机 IP 地址。有关获取 IP 地址的详细信息,请参见 docker inspect 。或者,可向 docker run 命令指定 --net=host 标志,以跳过将容器置于独立网络栈中的操作。

运行单节点 etcd

配置 etcd 时,请使用主机 IP 地址:

export NODE1=192.168.1.21

配置 Docker 卷以存储 etcd 数据:

docker volume create --name etcd-data
export DATA_DIR="etcd-data"

运行最新版本的 etcd(v3.7.0,撰写本文时的版本):

ETCD_VERSION=v3.7.0
REGISTRY=quay.io/coreos/etcd
# available from v3.2.5
REGISTRY=gcr.io/etcd-development/etcd

docker run \
  -p 2379:2379 \
  -p 2380:2380 \
  --volume=${DATA_DIR}:/etcd-data \
  --name etcd ${REGISTRY}:${ETCD_VERSION} \
  /usr/local/bin/etcd \
  --data-dir=/etcd-data --name node1 \
  --initial-advertise-peer-urls http://${NODE1}:2380 --listen-peer-urls http://0.0.0.0:2380 \
  --advertise-client-urls http://${NODE1}:2379 --listen-client-urls http://0.0.0.0:2379 \
  --initial-cluster node1=http://${NODE1}:2380

列出集群成员:

etcdctl --endpoints=http://${NODE1}:2379 member list

运行一个 3 节点 etcd 集群

REGISTRY=quay.io/coreos/etcd
# available from v3.2.5
REGISTRY=gcr.io/etcd-development/etcd

# For each machine
ETCD_VERSION=v3.7.0
TOKEN=my-etcd-token
CLUSTER_STATE=new
NAME_1=etcd-node-0
NAME_2=etcd-node-1
NAME_3=etcd-node-2
HOST_1=10.20.30.1
HOST_2=10.20.30.2
HOST_3=10.20.30.3
CLUSTER=${NAME_1}=http://${HOST_1}:2380,${NAME_2}=http://${HOST_2}:2380,${NAME_3}=http://${HOST_3}:2380
DATA_DIR=/var/lib/etcd

# For node 1
THIS_NAME=${NAME_1}
THIS_IP=${HOST_1}
docker run \
  -p 2379:2379 \
  -p 2380:2380 \
  --volume=${DATA_DIR}:/etcd-data \
  --name etcd ${REGISTRY}:${ETCD_VERSION} \
  /usr/local/bin/etcd \
  --data-dir=/etcd-data --name ${THIS_NAME} \
  --initial-advertise-peer-urls http://${THIS_IP}:2380 --listen-peer-urls http://0.0.0.0:2380 \
  --advertise-client-urls http://${THIS_IP}:2379 --listen-client-urls http://0.0.0.0:2379 \
  --initial-cluster ${CLUSTER} \
  --initial-cluster-state ${CLUSTER_STATE} --initial-cluster-token ${TOKEN}

# For node 2
THIS_NAME=${NAME_2}
THIS_IP=${HOST_2}
docker run \
  -p 2379:2379 \
  -p 2380:2380 \
  --volume=${DATA_DIR}:/etcd-data \
  --name etcd ${REGISTRY}:${ETCD_VERSION} \
  /usr/local/bin/etcd \
  --data-dir=/etcd-data --name ${THIS_NAME} \
  --initial-advertise-peer-urls http://${THIS_IP}:2380 --listen-peer-urls http://0.0.0.0:2380 \
  --advertise-client-urls http://${THIS_IP}:2379 --listen-client-urls http://0.0.0.0:2379 \
  --initial-cluster ${CLUSTER} \
  --initial-cluster-state ${CLUSTER_STATE} --initial-cluster-token ${TOKEN}

# For node 3
THIS_NAME=${NAME_3}
THIS_IP=${HOST_3}
docker run \
  -p 2379:2379 \
  -p 2380:2380 \
  --volume=${DATA_DIR}:/etcd-data \
  --name etcd ${REGISTRY}:${ETCD_VERSION} \
  /usr/local/bin/etcd \
  --data-dir=/etcd-data --name ${THIS_NAME} \
  --initial-advertise-peer-urls http://${THIS_IP}:2380 --listen-peer-urls http://0.0.0.0:2380 \
  --advertise-client-urls http://${THIS_IP}:2379 --listen-client-urls http://0.0.0.0:2379 \
  --initial-cluster ${CLUSTER} \
  --initial-cluster-state ${CLUSTER_STATE} --initial-cluster-token ${TOKEN}

使用 API 版本 3 运行 etcdctl:

docker exec etcd /usr/local/bin/etcdctl put foo bar

裸金属

要在裸金属上部署一个由 3 个节点组成的 etcd 集群,可参考 baremetal 仓库 中的示例。

挂载证书卷

etcd 发行版容器不包含默认的根证书。如需使用由根证书机构信任的证书(例如用于发现),请将证书目录挂载到 etcd 容器中:

ETCD_VERSION=v3.7.0
REGISTRY=quay.io/coreos/etcd
# available from v3.2.5
REGISTRY=docker://gcr.io/etcd-development/etcd

rkt run \
  --insecure-options=image \
  --volume etcd-ssl-certs-bundle,kind=host,source=/etc/ssl/certs/ca-certificates.crt \
  --mount volume=etcd-ssl-certs-bundle,target=/etc/ssl/certs/ca-certificates.crt \
  ${REGISTRY}:${ETCD_VERSION} -- --name my-name \
  --initial-advertise-peer-urls http://localhost:2380 --listen-peer-urls http://localhost:2380 \
  --advertise-client-urls http://localhost:2379 --listen-client-urls http://localhost:2379 \
  --discovery https://discovery.etcd.io/c11fbcdc16972e45253491a24fcf45e1
ETCD_VERSION=v3.7.0
REGISTRY=quay.io/coreos/etcd
# available from v3.2.5
REGISTRY=gcr.io/etcd-development/etcd

docker run \
  -p 2379:2379 \
  -p 2380:2380 \
  --volume=/etc/ssl/certs/ca-certificates.crt:/etc/ssl/certs/ca-certificates.crt \
  ${REGISTRY}:${ETCD_VERSION} \
  /usr/local/bin/etcd --name my-name \
  --initial-advertise-peer-urls http://localhost:2380 --listen-peer-urls http://localhost:2380 \
  --advertise-client-urls http://localhost:2379 --listen-client-urls http://localhost:2379 \
  --discovery https://discovery.etcd.io/86a9ff6c8cb8b4c4544c1a2f88f8b801

7 - 故障模式

不同类型的故障及 etcd 的容错能力

在大规模机器部署中,故障是常见现象。当硬件或软件发生故障时,机器会失效。若出现断电或网络问题,多台机器可能同时失效。多种类型的故障也可能同时发生;几乎无法穷举所有可能的故障场景。

本节列举各类故障,并讨论 etcd 的设计如何容忍这些故障。大多数用户(若非全部)均可将特定故障归入某一类故障。为应对罕见或 不可恢复的故障 ,务必 备份 etcd 集群。

次要跟随者故障

当少于一半的跟随者发生故障时,etcd 集群仍可接受请求并持续进展,不会出现重大中断。例如,五个成员的 etcd 集群中发生两个跟随者故障,不会影响集群的正常运行。然而,客户端将与故障成员失去连接。客户端库应通过自动重连至其他成员,隐藏读请求的中断对用户的影响。系统管理员应预期其他成员的系统负载因重连而增加。

领导者故障排查

当领导者发生故障时,etcd 集群会自动选举新的领导者。领导者故障后,选举不会立即发生。由于故障检测机制基于超时,因此需要大约一个选举超时时间才能完成新领导者的选举。

在选举领导者期间,集群无法处理任何写入操作。选举期间发送的写入请求将被暂存,直到新领导者被选出。

已发送至旧领导者但尚未提交的写入操作可能会丢失。新领导者有权重写前任领导者的所有未提交条目。从用户角度看,新领导者选举后,部分写入请求可能会超时。然而,已提交的写入操作绝不会丢失。

新领导者会自动延长所有租约的超时时间。此机制确保即使租约由旧领导者授予,其有效期也不会在授予的 TTL 到期前终止。

多数节点故障

当集群的多数成员发生故障时,etcd 集群将失效,无法接受更多写入操作。

etcd 集群仅在多数成员恢复可用后,方可完成恢复。若多数成员无法恢复上线,则操作员必须启动 灾难恢复 以恢复集群。

一旦多数成员正常工作,etcd 集群将自动选举出新的领导者,并恢复到健康状态。新的领导者会自动延长所有租约的超时时间。该机制确保因服务器端不可用而导致的租约过期问题不会发生。

网络分区

网络分区与少数跟随者故障或领导者故障类似。网络分区会将 etcd 集群划分为两部分:一部分拥有成员多数,另一部分拥有成员少数。多数侧成为可用集群,少数侧则不可用。etcd 中不存在“脑裂”现象,因为集群成员的增删均需显式操作,且每次变更必须获得当前多数成员的批准。

如果领导者位于多数方,那么从多数方的视角来看,此次故障属于少数跟随者故障。如果领导者位于少数方,则属于领导者故障。位于少数方的领导者将主动降级,多数方将选举出新的领导者。

网络分区解除后,少数方会自动识别多数方的领导者,并恢复其状态。

启动过程中失败

集群引导仅在所有必需成员均成功启动时才能成功。若引导过程中发生任何故障,请删除所有成员上的数据目录,并使用新的集群令牌或新的发现令牌重新引导集群。

当然,可以像恢复运行中的集群一样恢复已启动失败的集群。然而,恢复该集群通常需要比启动新集群更多的时间和资源,因为无需恢复任何数据。

8 - 灾难恢复

etcd v3 快照与恢复功能

etcd 设计用于抵御机器故障。etcd 集群可自动从临时故障(例如机器重启)中恢复,并能容忍最多 (N−1)/2 个成员的永久性故障,适用于由 N 个成员组成的集群。当某个成员发生永久性故障(无论是硬件故障还是磁盘损坏)时,该成员将失去对集群的访问权限。若集群永久性丢失超过 (N−1)/2 个成员,则将发生灾难性故障,法定人数不可逆地丢失。一旦法定人数丢失,集群将无法达成共识,因而无法继续接受更新。

为从灾难性故障中恢复,etcd v3 提供了快照与恢复功能,可在不丢失 v3 键数据的情况下重建集群。如需恢复 v2 键,请参阅 v2 管理指南 。

键空间快照

恢复集群首先需要从 etcd 成员获取键空间的快照。快照可通过以下方式获取:使用 etcdctl snapshot save 命令从运行中的成员获取,或从 etcd 数据目录中复制 member/snap/db 文件。例如,以下命令将 $ENDPOINT 提供的键空间快照保存至文件 snapshot.db:

$ ETCDCTL_API=3 etcdctl --endpoints $ENDPOINT snapshot save snapshot.db

请注意,从 member/snap/db 文件获取快照可能会丢失尚未写入但已包含在 wal(预写日志)文件夹中的数据。

快照状态

要了解某个快照所包含的修订版本和哈希值,可以使用 etcdutl snapshot status 命令:

$ etcdutl snapshot status snapshot.db -w table
+---------+----------+------------+------------+
|  HASH   | REVISION | TOTAL KEYS | TOTAL SIZE |
+---------+----------+------------+------------+
| 7ef846e |   485261 |      11642 |      94 MB |
+---------+----------+------------+------------+

恢复集群

修订版本差异

在恢复集群时,现有客户端可能会感知到修订版本倒退数百甚至数千个。这是因为特定快照仅包含截至其创建时刻的数据版本历史,而当前状态可能已向前推进得更远。

当使用 etcd 运行 Kubernetes 时,此问题尤为突出,控制器和操作员可能使用所谓的 informers 作为本地缓存,并通过监听机制获取更新通知。恢复到较早的修订版本可能无法正确刷新缓存,导致控制器出现不可预测且不一致的行为。

在从快照恢复的场景下,例如已知的监听 API 消费者、etcd 数据的本地缓存副本,或在一般情况下使用 Kubernetes 时,强烈建议使用以下“修订版本提升”方式进行恢复。

从快照恢复

要恢复集群,仅需一个快照“db”文件即可。使用 etcdutl snapshot restore 执行集群恢复时,会创建新的 etcd 数据目录;所有成员应使用相同的快照进行恢复。恢复操作会覆盖部分快照元数据(特别是成员 ID 和集群 ID);成员将失去原有身份。此元数据覆盖可防止新成员意外加入现有集群。因此,要从快照启动集群,恢复操作必须启动一个新的逻辑集群。

简单的恢复操作可按如下方式执行:

$ etcdutl snapshot restore snapshot.db --data-dir output-dir

完整性检查

快照完整性可在恢复时选择性地进行验证。若快照是使用 etcdctl snapshot save 创建的,则会包含完整性哈希,该哈希由 etcdutl snapshot restore 进行校验。若快照是从数据目录复制的,则不包含完整性哈希,只能通过 --skip-hash-check 恢复。

使用修订版本恢复

为确保恢复后修订版本永不递减,可提供 --bump-revision 选项。该选项接受一个 64 位整数,表示在快照当前修订版本基础上增加的修订版本数。由于每次向 etcd 写入都会使修订版本加一,因此只要 etcd 每秒写入次数少于 1500 次,即可通过增加 1'000'000'000 个修订版本来覆盖一周前的快照。

在 Kubernetes 控制器的上下文中,还应使用 --mark-compacted 标记所有修订版本,包括版本递增操作,以执行压缩。这可确保所有监听操作被终止,且 etcd 不再响应关于快照创建后发生的修订版本的请求——从而有效使 informer 缓存失效。

完整调用示例如下:

$ etcdutl snapshot restore snapshot.db --bump-revision 1000000000 --mark-compacted --data-dir output-dir

使用更新后的成员信息恢复

etcd 集群的成员信息存储在 etcd 自身中,并通过 Raft 共识算法进行维护。当完全失去法定人数时,应重新考虑新集群的组建位置和方式,例如在一组全新的成员上进行组建。

从快照恢复时,可直接将新的成员信息提供给数据存储,如下所示:

$ etcdutl snapshot restore snapshot.db \
  --name m1 \
  --data-dir m1.etcd \
  --initial-cluster m1=http://host1:2380,m2=http://host2:2380,m3=http://host3:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-advertise-peer-urls http://host1:2380

这确保了新构建的集群仅与具有指定令牌的其他已恢复成员连接,而不会连接到可能仍处于活跃状态的旧成员。

另一种做法是在启动 etcd 时提供 --force-new-cluster,在保留现有应用数据的同时覆盖集群成员关系。强烈不建议采用此方法;如果旧集群的其他成员仍在运行,etcd 将发生 panic。务必定期保存快照。

全流程示例

使用以下命令从运行中的集群获取快照:

$ etcdctl snapshot save snapshot.db

接续上一示例,以下为三成员集群创建新的 etcd 数据目录(m1.etcd、m2.etcd、m3.etcd):

$ etcdutl snapshot restore snapshot.db \
  --name m1 \
  --data-dir m1_data_dir.etcd \
  --initial-cluster m1=http://host1:2380,m2=http://host2:2380,m3=http://host3:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-advertise-peer-urls http://host1:2380
$ etcdutl snapshot restore snapshot.db \
  --name m2 \
  --data-dir m2_data_dir.etcd \
  --initial-cluster m1=http://host1:2380,m2=http://host2:2380,m3=http://host3:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-advertise-peer-urls http://host2:2380
$ etcdutl snapshot restore snapshot.db \
  --name m3 \
  --data-dir m3_data_dir.etcd \
  --initial-cluster m1=http://host1:2380,m2=http://host2:2380,m3=http://host3:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-advertise-peer-urls http://host3:2380

接下来,使用新的数据目录启动 etcd:

$ etcd \
  --name m1 \
  --data-dir m1_data_dir.etcd \
  --listen-client-urls http://host1:2379 \
  --advertise-client-urls http://host1:2379 \
  --listen-peer-urls http://host1:2380 &
$ etcd \
  --name m2 \
  --data-dir m2_data_dir.etcd \
  --listen-client-urls http://host2:2379 \
  --advertise-client-urls http://host2:2379 \
  --listen-peer-urls http://host2:2380 &
$ etcd \
  --name m3 \
  --data-dir m3_data_dir.etcd \
  --listen-client-urls http://host3:2379 \
  --advertise-client-urls http://host3:2379 \
  --listen-peer-urls http://host3:2380 &

现在,已恢复的 etcd 集群应已可用,并开始提供快照中的键空间服务。

从 etcd v3.6 开始,用户只能使用 etcdctl 将数据保存为快照,而必须使用 etcdutl 从快照恢复数据。若未指定 --data-dir,则默认 --data-dir 值为 <name>.etcd(其中 <name> 为 --name 的值)。例如,若未提供 --data-dir,且成员名称为 m1、m2 和 m3,则 --data-dir 目录分别为 m1.etcd、m2.etcd 和 m3.etcd。

9 - etcd 网关

etcd 网关的使用场景及配置方法

etcd 网关是什么

etcd 网关是一个简单的 TCP 代理,负责将网络数据转发至 etcd 集群。网关为无状态且透明的;它既不检查客户端请求,也不干扰集群响应。网关不会终止 TLS 连接,不会代表客户端执行 TLS 握手,也不会验证连接是否已加密。

网关支持多个 etcd 服务器端点,并采用简单的轮询策略。它仅将请求路由至可用端点,并向客户端隐藏故障。未来可能支持其他重试策略,例如加权轮询。

何时使用 etcd 网关

每个访问 etcd 的应用程序都必须首先知晓 etcd 集群客户端端点的地址。如果同一服务器上的多个应用程序访问同一个 etcd 集群,每个应用程序仍需知晓 etcd 集群的通告客户端端点。如果 etcd 集群重新配置为使用不同的端点,每个应用程序也可能需要更新其端点列表。这种大规模的重新配置既繁琐又容易出错。

etcd 网关通过作为稳定的本地端点来解决此问题。典型的 etcd 网关配置中,每台机器上运行一个监听本地地址的网关,每个 etcd 应用程序连接到其本地网关。结果是,只需更新网关的端点,而无需逐一更新每个应用程序。

综上所述,为自动传播集群端点变更,etcd 网关需在每台运行多个访问同一 etcd 集群的应用程序的机器上运行。

何时不应使用 etcd 网关

  • 提升性能

网关并非用于提升 etcd 集群性能。它不提供缓存、监听合并或批处理功能。etcd 团队正在开发一种用于提升集群可扩展性的缓存代理。

  • 在集群管理系统上运行

高级集群管理系统(如 Kubernetes)原生支持服务发现。应用程序可通过系统管理的 DNS 名称或虚拟 IP 地址访问 etcd 集群。例如,kube-proxy 相当于 etcd 网关。

启动 etcd 网关

考虑一个具有以下静态端点的 etcd 集群:

名称地址主机名端口
infra010.0.1.10infra0.example.com2379
infra110.0.1.11infra1.example.com2379
infra210.0.1.12infra2.example.com2379

使用以下命令启动 etcd 网关,以通过静态端点进行访问:

$ etcd gateway start --endpoints=infra0.example.com:2379,infra1.example.com:2379,infra2.example.com:2379
2016-08-16 11:21:18.867350 I | tcpproxy: ready to proxy client requests to [...]

或者,若使用 DNS 进行服务发现,请考虑使用 DNS SRV 记录:

$ dig +noall +answer SRV _etcd-client._tcp.example.com
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra0.example.com.
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra1.example.com.
_etcd-client._tcp.example.com. 300 IN SRV 0 0 2379 infra2.example.com.
$ dig +noall +answer infra0.example.com infra1.example.com infra2.example.com
infra0.example.com.  300  IN  A  10.0.1.10
infra1.example.com.  300  IN  A  10.0.1.11
infra2.example.com.  300  IN  A  10.0.1.12

使用以下命令启动 etcd 网关,从 DNS SRV 条目中获取端点:

$ etcd gateway start --discovery-srv=example.com
2016-08-16 11:21:18.867350 I | tcpproxy: ready to proxy client requests to [...]

配置标志

etcd 集群

–endpoints

  • 用逗号分隔的 etcd 服务器端点列表,用于转发客户端连接。
  • 默认值:127.0.0.1:2379
  • 必须包含端口。
  • 无效示例:https://127.0.0.1:2379(网关不终止 TLS)。请注意,网关不会验证 HTTP 协议模式或检查请求内容,仅将请求转发至指定端点。

–discovery-srv

  • 用于通过 SRV 记录引导集群端点的 DNS 域名。
  • 默认值:未设置

网络

–listen-addr

  • 用于接收客户端请求的接口和端口。
  • 默认值:127.0.0.1:23790

–retry-delay

  • 重试连接已失败端点前的延迟时长。
  • 默认值:1m0s
  • 无效示例:“123”(期望以时间单位格式提供)

安全

–insecure-discovery

  • 接受不安全或易受中间人攻击的 SRV 记录。
  • 默认值:false

–trusted-ca-file

  • 客户端 TLS CA 文件路径,用于 etcd 集群验证 SRV 发现返回的端点。请注意,该设置仅用于认证发现的端点,而非用于数据传输的连接建立。网关不会终止 TLS 连接,也不会代表客户端创建 TLS 连接。
  • 默认值:未设置

10 - gRPC 代理

一个无状态的 etcd 代理,运行在 gRPC 层

gRPC 代理是运行在 gRPC 层(L7)的无状态 etcd 反向代理。该代理旨在降低核心 etcd 集群的总体处理负载。为实现横向扩展,代理会合并监听和租约 API 请求。为防止恶意客户端对集群造成影响,代理会缓存键范围请求。

gRPC 代理支持多个 etcd 服务器端点。代理启动时,会随机选择一个 etcd 服务器端点使用。该端点将处理所有请求,直至代理检测到端点故障。若 gRPC 代理检测到端点故障,且存在其他可用端点,则会切换至其他端点,以向客户端隐藏故障。未来可能支持其他重试策略,例如加权轮询。

可扩展的监听 API

gRPC 代理将同一键或范围上的多个客户端监听器(c-watchers)合并为一个连接到 etcd 服务器的监听器(s-watcher)。代理将 s-watcher 的所有事件广播给其 c-watchers。

假设有 N 个客户端监听同一个键,一个 gRPC 代理可将 etcd 服务器的监听负载从 N 降低至 1。用户可部署多个 gRPC 代理以进一步分摊服务器负载。

在以下示例中,三个客户端监听键 A。gRPC 代理将这三个监听器合并为一个监听器,该监听器连接到 etcd 服务器。

            +-------------+
            | etcd server |
            +------+------+
                   ^ watch key A (s-watcher)
                   |
           +-------+-----+
           | gRPC proxy  | <-------+
           |             |         |
           ++-----+------+         |watch key A (c-watcher)
watch key A ^     ^ watch key A    |
(c-watcher) |     | (c-watcher)    |
    +-------+-+  ++--------+  +----+----+
    |  client |  |  client |  |  client |
    |         |  |         |  |         |
    +---------+  +---------+  +---------+

限制

为有效将多个客户端监听器合并为单一监听器,gRPC 代理在可能的情况下会将新的 c-watchers 合并至现有的 s-watcher。由于网络延迟或缓冲未送达的事件,该合并后的 s-watcher 可能与 etcd 服务器不同步。当监听修订版本未指定时,gRPC 代理不能保证 c-watcher 会从最新的存储修订版本开始监听。例如,若客户端从修订版本为 1000 的 etcd 服务器进行监听,该监听器将从修订版本 1000 开始。若客户端从 gRPC 代理进行监听,可能从修订版本 990 开始监听。

取消操作也存在类似的限制。当监听器被取消时,etcd 服务器的修订版本可能大于取消响应的修订版本。

上述两项限制通常不会对大多数使用场景造成影响。未来可能会增加额外选项,以强制监听器绕过 gRPC 代理,从而获得更精确的修订版本响应。

可扩展的租约 API

为保持租约有效,客户端必须至少建立一个 gRPC 流至 etcd 服务器,以发送周期性心跳。若 etcd 工作负载涉及大量租约操作且分布于多个客户端,这些流可能导致 CPU 利用率过高。为减少核心集群上的总流数,代理支持租约流合并。

假设有 N 个客户端在更新租约,单个 gRPC 代理可将 etcd 服务器的流负载从 N 降低至 1。部署中可增加额外的 gRPC 代理,以进一步将流分布到多个代理上。

在以下示例中,三个客户端分别更新三个独立的租约(L1、L2 和 L3)。gRPC 代理将这三个客户端的租约流(c-streams)合并为一个附加到 etcd 服务器的租约保活流(s-stream)。代理将客户端侧租约心跳从 c-流转发至 s-流,随后将响应返回至对应的 c-流。

          +-------------+
          | etcd server |
          +------+------+
                 ^
                 | heartbeat L1, L2, L3
                 | (s-stream)
                 v
         +-------+-----+
         | gRPC proxy  +<-----------+
         +---+------+--+            | heartbeat L3
             ^      ^               | (c-stream)
heartbeat L1 |      | heartbeat L2  |
(c-stream)   v      v (c-stream)    v
      +------+-+  +-+------+  +-----+--+
      | client |  | client |  | client |
      +--------+  +--------+  +--------+

客户端滥用防护

gRPC 代理在不违反一致性要求的前提下,会缓存请求的响应。这可以防止在紧密循环中运行的恶意客户端对 etcd 服务器造成过载。

启动 etcd gRPC 代理

考虑一个具有以下静态端点的 etcd 集群:

名称地址主机名
infra010.0.1.10infra0.example.com
infra110.0.1.11infra1.example.com
infra210.0.1.12infra2.example.com

使用以下命令启动 etcd gRPC 代理,以通过这些静态端点进行访问:

$ etcd grpc-proxy start --endpoints=infra0.example.com,infra1.example.com,infra2.example.com --listen-addr=127.0.0.1:2379

etcd gRPC 代理启动并在端口 2379 上监听。它将客户端请求转发至上述三个端点中的一个。

通过代理发送请求:

$ ETCDCTL_API=3 etcdctl --endpoints=127.0.0.1:2379 put foo bar
OK
$ ETCDCTL_API=3 etcdctl --endpoints=127.0.0.1:2379 get foo
foo
bar

客户端端点同步与名称解析

代理支持将端点注册至用户定义的发现端点,以供发现。此举具有两个目的。首先,它允许客户端将其端点与一组代理端点同步,以实现高可用性。其次,它是 etcd gRPC 命名 的端点提供者。

通过提供用户自定义前缀来注册代理:

$ etcd grpc-proxy start --endpoints=localhost:2379 \
  --listen-addr=127.0.0.1:23790 \
  --advertise-client-url=127.0.0.1:23790 \
  --resolver-prefix="___grpc_proxy_endpoint" \
  --resolver-ttl=60

$ etcd grpc-proxy start --endpoints=localhost:2379 \
  --listen-addr=127.0.0.1:23791 \
  --advertise-client-url=127.0.0.1:23791 \
  --resolver-prefix="___grpc_proxy_endpoint" \
  --resolver-ttl=60

代理将列出其所有成员的成员列表:

ETCDCTL_API=3 etcdctl --endpoints=http://localhost:23790 member list --write-out table

+----+---------+--------------------------------+------------+-----------------+
| ID | STATUS  |              NAME              | PEER ADDRS |  CLIENT ADDRS   |
+----+---------+--------------------------------+------------+-----------------+
|  0 | started | Gyu-Hos-MBP.sfo.coreos.systems |            | 127.0.0.1:23791 |
|  0 | started | Gyu-Hos-MBP.sfo.coreos.systems |            | 127.0.0.1:23790 |
+----+---------+--------------------------------+------------+-----------------+

这使得客户端可通过 Sync 自动发现代理端点:

cli, err := clientv3.New(clientv3.Config{
    Endpoints: []string{"http://localhost:23790"},
})
if err != nil {
    log.Fatal(err)
}
defer cli.Close()

// fetch registered grpc-proxy endpoints
if err := cli.Sync(context.Background()); err != nil {
    log.Fatal(err)
}

请注意,如果配置代理时未指定解析器前缀,

$ etcd grpc-proxy start --endpoints=localhost:2379 \
  --listen-addr=127.0.0.1:23792 \
  --advertise-client-url=127.0.0.1:23792

成员列表 API 通过 gRPC 代理返回其自身的 advertise-client-url:

ETCDCTL_API=3 etcdctl --endpoints=http://localhost:23792 member list --write-out table

+----+---------+--------------------------------+------------+-----------------+
| ID | STATUS  |              NAME              | PEER ADDRS |  CLIENT ADDRS   |
+----+---------+--------------------------------+------------+-----------------+
|  0 | started | Gyu-Hos-MBP.sfo.coreos.systems |            | 127.0.0.1:23792 |
+----+---------+--------------------------------+------------+-----------------+

命名空间

假设某个应用需要完全控制整个键空间,但 etcd 集群与其他应用共享。为使所有应用能够互不干扰地运行,代理可对 etcd 键空间进行分区,使客户端看似拥有对完整键空间的访问权限。当代理收到标志 --namespace 时,所有进入代理的客户端请求都会被转换,使键带上用户自定义的前缀。对 etcd 集群的访问将基于该前缀,而代理返回的响应会移除前缀;对客户端而言,似乎根本不存在前缀。

要为代理命名空间,请使用 --namespace 启动它:

$ etcd grpc-proxy start --endpoints=localhost:2379 \
  --listen-addr=127.0.0.1:23790 \
  --namespace=my-prefix/

对代理的访问现在已透明地在 etcd 集群上添加前缀:

$ ETCDCTL_API=3 etcdctl --endpoints=localhost:23790 put my-key abc
# OK
$ ETCDCTL_API=3 etcdctl --endpoints=localhost:23790 get my-key
# my-key
# abc
$ ETCDCTL_API=3 etcdctl --endpoints=localhost:2379 get my-prefix/my-key
# my-prefix/my-key
# abc

TLS 终止

通过 gRPC 代理终止安全 etcd 集群的 TLS,通过提供一个未加密的本地端点。

尝试操作,请使用客户端 HTTPS 启动单成员 etcd 集群:

$ etcd --listen-client-urls https://localhost:2379 --advertise-client-urls https://localhost:2379 --cert-file=peer.crt --key-file=peer.key --trusted-ca-file=ca.crt --client-cert-auth

确认客户端端口正在提供 HTTPS 服务:

# fails
$ ETCDCTL_API=3 etcdctl --endpoints=http://localhost:2379 endpoint status
# works
$ ETCDCTL_API=3 etcdctl --endpoints=https://localhost:2379 --cert=client.crt --key=client.key --cacert=ca.crt endpoint status

接下来,在 localhost:12379 上启动一个 gRPC 代理,通过客户端证书连接到 etcd 端点 https://localhost:2379:

$ etcd grpc-proxy start --endpoints=https://localhost:2379 --listen-addr localhost:12379 --cert client.crt --key client.key --cacert=ca.crt --insecure-skip-tls-verify &

最后,通过使用 HTTP 向代理写入键来测试 TLS 终止:

$ ETCDCTL_API=3 etcdctl --endpoints=http://localhost:12379 put abc def
# OK

指标与健康状况

gRPC 代理为 --endpoints 定义的 etcd 成员暴露 /health 和 Prometheus /metrics 端点。可另定义一个额外的 URL,该 URL 将对 /metrics 和 /health 端点响应,并设置 --metrics-addr 标志。

$ etcd grpc-proxy start \
  --endpoints https://localhost:2379 \
  --metrics-addr https://0.0.0.0:4443 \
  --listen-addr 127.0.0.1:23790 \
  --key client.key \
  --key-file proxy-server.key \
  --cert client.crt \
  --cert-file proxy-server.crt \
  --cacert ca.pem \
  --trusted-ca-file proxy-ca.pem

已知问题

代理的主要接口同时支持 HTTP/2 和 HTTP/1.1。若如上例所示配置了 TLS,当使用 cURL 等客户端访问监听接口时,必须在请求中显式设置协议为 HTTP/1.1,才能返回 /metrics 或 /health。通过使用 --metrics-addr 标志,次要接口将不再具有此要求。

 $ curl --cacert proxy-ca.pem --key proxy-client.key --cert proxy-client.crt https://127.0.0.1:23790/metrics --http1.1

11 - 硬件推荐

etcd 集群的硬件指南

etcd 在资源有限的开发或测试环境中通常运行良好;在笔记本电脑或廉价云主机上开发 etcd 是常见做法。然而,在生产环境中运行 etcd 集群时,遵循一些硬件建议有助于实现有效的系统管理。这些建议并非硬性规定,而是构建稳健生产部署的良好起点。和往常一样,部署前应使用模拟工作负载进行测试。

处理器核心

极少有 etcd 部署需要大量 CPU 资源。典型集群只需两到四个核心即可平稳运行。

高负载的 etcd 部署(例如每秒服务数千个客户端或数万个请求)通常受 CPU 限制,因为 etcd 可以从内存中提供请求服务。此类高负载部署通常需要八到十六个专用核心。

内存

etcd 的内存占用相对较小,但其性能仍依赖于充足的内存。etcd 服务器会积极缓存键值数据,并将大部分其他内存用于跟踪监听器。通常 8GB 内存已足够。对于拥有数千个监听器和数百万个键的高负载部署,应相应分配 16GB 至 64GB 内存。

磁盘

快速磁盘是影响 etcd 部署性能和稳定性的最关键因素。

慢速磁盘会增加 etcd 请求延迟,并可能影响集群稳定性。由于 etcd 的共识协议依赖于将元数据持久化存储到日志中,集群中多数成员必须将每个请求写入磁盘。此外,etcd 还会将状态增量式地进行快照并写入磁盘,以便截断该日志。若这些写入操作耗时过长,心跳可能超时并触发选举,从而破坏集群稳定性。通常,可通过基准测试工具如 fio 判断磁盘是否足够快以满足 etcd 需求。请参阅 here 了解示例。

etcd 对磁盘写入延迟非常敏感。通常需要 50 个顺序 IOPS(例如,7200 RPM 磁盘)。对于负载较高的集群,建议使用 500 个顺序 IOPS(例如,典型的本地 SSD 或高性能虚拟化块设备)。请注意,大多数云服务提供商公布的都是并发 IOPS 而非顺序 IOPS;公布的并发 IOPS 可能是顺序 IOPS 的 10 倍。为测量实际的顺序 IOPS,建议使用磁盘基准测试工具,例如 diskbench 或 fio 。

etcd 对磁盘带宽的要求较低,但更高的磁盘带宽可在成员故障后快速追上集群时显著缩短恢复时间。通常,10 MB/s 的带宽可在 15 秒内完成 100 MB 数据的恢复。对于大规模集群,建议使用 100 MB/s 或更高的带宽,以在 15 秒内完成 1 GB 数据的恢复。

在可能的情况下,使用 SSD 作为 etcd 存储的后端。SSD 通常比传统旋转磁盘提供更低的写入延迟,并且延迟波动更小,从而提升 etcd 的稳定性和可靠性。若使用旋转磁盘,应选择转速尽可能高的磁盘(例如 15,000 RPM)。使用 RAID 0 也是提升磁盘速度的有效方式,适用于旋转磁盘和 SSD。当集群中至少有三个成员时,RAID 的镜像或奇偶校验等冗余模式不再必要,因为 etcd 的一致性复制已提供高可用性。

网络

多成员 etcd 部署得益于快速且可靠的网络。为确保 etcd 在一致性和分区容错性方面表现良好,不可靠且存在分区故障的网络会导致可用性下降。低延迟可确保 etcd 成员之间通信迅速。高带宽可缩短故障成员恢复所需时间。对于常见的 etcd 部署,1GbE 网络已足够。对于大型 etcd 集群,采用 10GbE 网络可进一步降低平均恢复时间。

在可能的情况下,将 etcd 成员部署于单一数据中心,以避免延迟开销并降低分区事件的发生概率。若需在其他数据中心设置故障域,请选择与现有数据中心更近的数据中心。请同时阅读 tuning 文档,以获取关于跨数据中心部署的更多信息。

示例硬件配置

以下是 AWS 和 GCE 环境中的一些典型硬件配置示例。如前所述,尽管必须反复强调,系统管理员在将 etcd 部署投入生产环境前,应使用模拟工作负载进行测试。

请注意,这些配置假设这些机器完全专用于 etcd。在这些机器上同时运行其他应用程序可能导致资源争用,进而引发集群不稳定。

小型集群

小型集群支持的客户端数量少于 100 个,每秒请求数少于 200 次,存储数据量不超过 100MB。

示例应用工作负载:一个包含 50 个节点的 Kubernetes 集群

提供商类型vCPU 数量内存 (GB)最大并发 IOPS磁盘带宽 (MB/s)
AWSm4.large28360056.25
GCEn1-standard-2 + 50GB PD SSD27.5150025

中等规模集群

一个中等规模的集群支持的客户端少于 500 个,每秒请求数少于 1,000 次,存储数据量不超过 500MB。

示例应用负载:一个包含 250 个节点的 Kubernetes 集群

提供商类型vCPU 数量内存 (GB)最大并发 IOPS磁盘带宽 (MB/s)
AWSm4.xlarge416600093.75
GCEn1-standard-4 + 150GB PD SSD415450075

大规模集群

大规模集群支持的客户端数量少于 1,500 个,每秒请求数少于 10,000 次,存储数据量不超过 1 GB。

示例应用负载:1,000 节点的 Kubernetes 集群

提供商类型vCPU 数量内存 (GB)最大并发 IOPS磁盘带宽 (MB/s)
AWSm4.2xlarge8328000125
GCEn1-standard-8 + 250GB PD SSD8307500125

大规模集群

一个 xLarge 集群可支持超过 1,500 个客户端,每秒处理超过 10,000 个请求,并存储超过 1 GB 的数据。

示例应用负载:一个包含 3,000 个节点的 Kubernetes 集群

提供商类型vCPU 数量内存 (GB)最大并发 IOPS磁盘带宽 (MB/s)
AWSm4.4xlarge166416,000250
GCEn1-standard-16 + 500GB PD SSD166015,000250

12 - 维护

周期性集群维护指南

概述

etcd 集群需要定期维护以保持可靠性。根据 etcd 应用的需求,此类维护通常可以自动化执行,且无需停机或显著降低性能。

本文所述的 etcd 维护操作均用于管理 etcd 键空间所占用的存储资源。若未能充分控制键空间大小,系统将通过存储空间配额进行防护;当 etcd 成员可用空间不足时,配额将触发集群范围的告警,使系统进入受限操作的维护模式。为避免键空间写入空间耗尽,必须对 etcd 键空间历史数据执行压缩。存储空间本身可通过整理碎片来回收。此外,定期对 etcd 成员状态进行快照备份,可实现对因操作失误导致的意外逻辑数据丢失或数据损坏的恢复。

Raft 日志保留

etcd --snapshot-count 配置在执行压缩前需在内存中保留的已应用 Raft 条目数量。当 --snapshot-count 达到时,服务器会先将快照数据持久化到磁盘,然后截断旧的条目。当慢速跟随者请求的日志索引早于已压缩的索引时,领导者会发送快照,强制跟随者覆盖其状态。

较高的 --snapshot-count 会在生成快照前将更多 Raft 条目保留在内存中,从而导致 内存使用量持续较高 。由于领导者会更长时间保留最新的 Raft 条目,缓慢的跟随者有更多时间在领导者生成快照前完成追赶。--snapshot-count 是较高内存使用与缓慢跟随者更高可用性之间的权衡。

自 v3.2 起,--snapshot-count 的默认值已 从 10,000 改为 100,000 。

从性能角度而言,--snapshot-count 超过 100,000 可能会影响写入吞吐量。内存中对象数量过多会减慢 Go GC 标记阶段 runtime.scanobject ,且内存回收不频繁会导致分配变慢。性能表现因工作负载和系统环境而异。然而,通常情况下,压缩过于频繁会影响集群可用性及写入吞吐量;压缩过于稀疏同样有害,会向 Go 垃圾回收器施加过大压力。更多研究结果请参见 Understanding Performance Aspects of etcd and Raft 。

历史压缩:v3 API 键值数据库

由于 etcd 会保留键空间的完整历史记录,因此应定期执行压缩以避免性能下降及最终存储空间耗尽。执行压缩操作会丢弃指定键空间修订版本之前所有被覆盖键的相关信息。这些键所占用的空间随后将可用于键空间的额外写入操作。

键空间可通过 etcd 的时间窗口历史保留策略自动执行压缩,或通过 etcdctl 手动执行压缩。etcdctl 方法可对压缩过程提供细粒度控制,而自动压缩适用于仅需保留一段时间键历史的应用场景。

etcdctl 执行压缩的过程如下:

# compact up to revision 3
$ etcdctl compact 3

执行压缩后的修订版本之前的所有修订版本将变得不可访问:

$ etcdctl get --rev=2 somekey
Error:  rpc error: code = 11 desc = etcdserver: mvcc: required revision has been compacted

自动压缩

etcd 可通过设置 --auto-compaction-mode 和 --auto-compaction-retention 选项自动对键空间执行压缩。压缩模式有两种:periodic(默认)和 revision。

周期性压缩

周期性压缩保留基于时间的键空间历史窗口:

# keep one hour of history
$ etcd --auto-compaction-retention=1h

保留值指定要保留的历史记录量。一条记录在创建后约经过该时长才会被压缩。这确保了慢速监听器仍能在保留窗口内完成追赶。

当保留周期大于 1 小时时,etcd 每小时执行一次压缩,同时保持完整的保留窗口。当保留周期为 1 小时或更短时,etcd 按保留周期间隔执行压缩。

例如,使用 --auto-compaction-retention=10h 时,etcd 首次压缩前等待 10 小时,之后每隔一小时执行一次压缩:

0hr  (rev = 1)
1hr  (rev = 10)
...
8hr  (rev = 80)
9hr  (rev = 90)
10hr (rev = 100, Compact(1))
11hr (rev = 110, Compact(10))
...

推荐值取决于具体使用场景:

  • 对同一键频繁更新:较短周期,例如 1h 或 30m
  • 更新频率较低:较长周期,例如 24h、48h 或 72h
  • 通用默认值:10h

修订版本压缩

修订版本压缩保留固定数量的修订版本:

# keep 1000 revisions
$ etcd --auto-compaction-mode=revision --auto-compaction-retention=1000

etcd 每 5 分钟检查一次,并对 "latest revision" - 1000 执行压缩。例如,当最新修订版本为 30000 时,它将对修订版本 29000 执行压缩。

碎片整理

执行键空间压缩后,后端数据库可能会出现内部碎片。内部碎片是指后端数据库中虽已空闲但仍在占用存储空间的区域。压缩旧版修订版本会通过在后端数据库中留下空隙,导致 etcd 出现内部碎片。这些碎片空间可供 etcd 使用,但对主机文件系统不可用。换句话说,删除应用数据不会释放磁盘空间。

碎片整理过程会将这部分存储空间释放回文件系统。碎片整理按成员分别执行,以避免引发集群范围内的延迟峰值。

要整理 etcd 成员的碎片,请使用 etcdctl defrag 命令:

$ etcdctl defrag
Finished defragmenting etcd member[127.0.0.1:2379]
警告

请注意,对运行中的成员执行碎片整理会阻塞系统读写数据,直至其状态重建完成

警告

请注意,碎片整理请求不会在集群中复制。也就是说,该请求仅应用于本地节点。请在 --endpoints 标志或 --cluster 标志中指定所有成员,以自动发现集群中的所有成员。

对与默认端点关联的集群中的所有端点执行碎片整理操作:

$ etcdctl defrag --cluster
Finished defragmenting etcd member[http://127.0.0.1:2379]
Finished defragmenting etcd member[http://127.0.0.1:22379]
Finished defragmenting etcd member[http://127.0.0.1:32379]

要直接对 etcd 数据目录进行碎片整理,且 etcd 未运行时,请使用以下命令:

etcdutl defrag --data-dir <path-to-etcd-data-dir>

空间配额

etcd 中的存储配额确保集群以可靠方式运行。若无存储配额,当键空间过度增长时,etcd 可能出现性能下降,或直接耗尽存储空间,导致集群行为不可预测。若任一成员的键空间后端数据库超过存储配额,etcd 将触发集群级告警,使集群进入仅接受键读取和删除操作的维护模式。只有在键空间中释放足够空间、完成后端数据库碎片整理,并清除存储配额告警后,集群方可恢复常规运行。

默认情况下,etcd 设置了一个适用于大多数应用的保守空间配额,但可通过命令行以字节为单位进行配置:

# set a very small 16 MiB quota
$ etcd --quota-backend-bytes=$((16*1024*1024))

空间配额可由循环触发:

# fill keyspace
$ while [ 1 ]; do dd if=/dev/urandom bs=1024 count=1024  | ETCDCTL_API=3 etcdctl put key  || break; done
...
Error:  rpc error: code = 8 desc = etcdserver: mvcc: database space exceeded
# confirm quota space is exceeded
$ ETCDCTL_API=3 etcdctl --write-out=table endpoint status
+----------------+------------------+-----------+---------+-----------+-----------+------------+
|    ENDPOINT    |        ID        |  VERSION  | DB SIZE | IS LEADER | RAFT TERM | RAFT INDEX |
+----------------+------------------+-----------+---------+-----------+-----------+------------+
| 127.0.0.1:2379 | bf9071f4639c75cc | 2.3.0+git | 18 MB   | true      |         2 |       3332 |
+----------------+------------------+-----------+---------+-----------+-----------+------------+
# confirm alarm is raised
$ ETCDCTL_API=3 etcdctl alarm list
memberID:13803658152347727308 alarm:NOSPACE

删除过多的键空间数据并整理后端数据库,可使集群恢复至配额限制范围内:

# get current revision
$ rev=$(ETCDCTL_API=3 etcdctl --endpoints=:2379 endpoint status --write-out="json" | egrep -o '"revision":[0-9]*' | egrep -o '[0-9].*')
# compact away all old revisions
$ ETCDCTL_API=3 etcdctl compact $rev
compacted revision 1516
# defragment away excessive space
$ ETCDCTL_API=3 etcdctl defrag
Finished defragmenting etcd member[127.0.0.1:2379]
# disarm alarm
$ ETCDCTL_API=3 etcdctl alarm disarm
memberID:13803658152347727308 alarm:NOSPACE
# test puts are allowed again
$ ETCDCTL_API=3 etcdctl put newkey 123
OK

指标 etcd_mvcc_db_total_size_in_use_in_bytes 表示执行历史压缩后的实际数据库使用量,而 etcd_debugging_mvcc_db_total_size_in_bytes 显示包含待整理碎片的空闲空间在内的数据库大小。后者仅在前者接近其值时增加,这意味着当这两个指标均接近配额时,必须执行历史压缩以避免触发空间配额限制。

etcd_debugging_mvcc_db_total_size_in_bytes 从 v3.4 版本起重命名为 etcd_mvcc_db_total_size_in_bytes。

警告

对于 Put/Txn/LeaseGrant 请求,可能会收到 ErrGRPCNoSpace 错误,但写入请求仍可能在后端数据库中成功,因为 etcd 在 API 层和内部 Apply 层均检查空间配额,而 Apply 层仅会触发 NOSPACE 告警,不会阻塞事务的继续执行。

快照备份

定期对 etcd 集群进行快照,可为 etcd 键空间提供持久化备份。通过定期对 etcd 成员的后端数据库进行快照,etcd 集群可恢复至某个时间点且状态已知良好的状态。

使用 etcdctl 执行快照操作:

$ etcdctl snapshot save backup.db
$ etcdutl --write-out=table snapshot status backup.db
+----------+----------+------------+------------+
|   HASH   | REVISION | TOTAL KEYS | TOTAL SIZE |
+----------+----------+------------+------------+
| fe01cf57 |       10 |          7 | 2.1 MB     |
+----------+----------+------------+------------+

13 - 监控 etcd

监控 etcd 系统健康状况并调试集群

每个 etcd 服务器通过其客户端端口上的 HTTP 端点提供本地监控信息。监控数据对于系统健康检查和集群调试均具有实用价值。

调试端点

若设置 --log-level=debug,etcd 服务器将在其客户端端口的 /debug 路径下导出调试信息。设置 --log-level=debug 时需谨慎,因为会导致性能下降和日志输出过于 verbose。

/debug/pprof 端点是标准的 Go 运行时性能分析端点。该端点可用于分析 CPU、堆、互斥锁和协程的使用情况。例如,以下命令通过 go tool pprof 获取 etcd 花费时间最多的前 10 个函数:

$ go tool pprof http://localhost:2379/debug/pprof/profile
Fetching profile from http://localhost:2379/debug/pprof/profile
Please wait... (30s)
Saved profile in /home/etcd/pprof/pprof.etcd.localhost:2379.samples.cpu.001.pb.gz
Entering interactive mode (type "help" for commands)
(pprof) top10
310ms of 480ms total (64.58%)
Showing top 10 nodes out of 157 (cum >= 10ms)
    flat  flat%   sum%        cum   cum%
   130ms 27.08% 27.08%      130ms 27.08%  runtime.futex
    70ms 14.58% 41.67%       70ms 14.58%  syscall.Syscall
    20ms  4.17% 45.83%       20ms  4.17%  github.com/coreos/etcd/vendor/golang.org/x/net/http2/hpack.huffmanDecode
    20ms  4.17% 50.00%       30ms  6.25%  runtime.pcvalue
    20ms  4.17% 54.17%       50ms 10.42%  runtime.schedule
    10ms  2.08% 56.25%       10ms  2.08%  github.com/coreos/etcd/vendor/github.com/coreos/etcd/etcdserver.(*EtcdServer).AuthInfoFromCtx
    10ms  2.08% 58.33%       10ms  2.08%  github.com/coreos/etcd/vendor/github.com/coreos/etcd/etcdserver.(*EtcdServer).Lead
    10ms  2.08% 60.42%       10ms  2.08%  github.com/coreos/etcd/vendor/github.com/coreos/etcd/pkg/wait.(*timeList).Trigger
    10ms  2.08% 62.50%       10ms  2.08%  github.com/coreos/etcd/vendor/github.com/prometheus/client_golang/prometheus.(*MetricVec).hashLabelValues
    10ms  2.08% 64.58%       10ms  2.08%  github.com/coreos/etcd/vendor/golang.org/x/net/http2.(*Framer).WriteHeaders

端点 /debug/requests 通过网页浏览器提供 gRPC 跟踪信息和性能统计数据。例如,以下是一个针对键 abc 的 Range 请求:

When	Elapsed (s)
2017/08/18 17:34:51.999317 	0.000244 	/etcdserverpb.KV/Range
17:34:51.999382 	 .    65 	... RPC: from 127.0.0.1:47204 deadline:4.999377747s
17:34:51.999395 	 .    13 	... recv: key:"abc"
17:34:51.999499 	 .   104 	... OK
17:34:51.999535 	 .    36 	... sent: header:<cluster_id:14841639068965178418 member_id:10276657743932975437 revision:15 raft_term:17 > kvs:<key:"abc" create_revision:6 mod_revision:14 version:9 value:"asda" > count:1

指标端点

每个 etcd 服务器在其客户端端口上通过 /metrics 路径导出指标,并可选地通过 --listen-metrics-urls 指定的位置导出。

指标可通过 curl 获取:

$ curl -L http://localhost:2379/metrics | grep -v debugging # ignore unstable debugging metrics

# HELP etcd_disk_backend_commit_duration_seconds The latency distributions of commit called by backend.
# TYPE etcd_disk_backend_commit_duration_seconds histogram
etcd_disk_backend_commit_duration_seconds_bucket{le="0.002"} 72756
etcd_disk_backend_commit_duration_seconds_bucket{le="0.004"} 401587
etcd_disk_backend_commit_duration_seconds_bucket{le="0.008"} 405979
etcd_disk_backend_commit_duration_seconds_bucket{le="0.016"} 406464
...

健康检查

自 v3.3.0 起,除了响应 /metrics 端点外,任何由 --listen-metrics-urls 指定的位置也将响应 /health 端点。若标准端点配置了双向(客户端) TLS 身份认证,但负载均衡器或监控服务仍需访问健康检查时,此功能可提供便利。

从 v3.4 版本起,新增了两个端点 /livez 和 /readyz。

  • /livez 端点反映进程是否正常运行,或是否需要重启。
  • /readyz 端点反映进程是否已就绪,可接收流量。

端点的设计细节在 KEP 中有详细记录。

每个端点包含多个独立的健康检查,可以使用 verbose 参数打印出检查详情及其状态,例如

curl -k http://localhost:2379/readyz?verbose

将看到类似以下的响应:

[+]data_corruption ok
[+]serializable_read ok
[+]linearizable_read ok
ok

HTTP API 还支持排除特定检查,例如

curl -k http://localhost:2379/readyz?exclude=data_corruption

Prometheus

运行 Prometheus 监控服务是采集和记录 etcd 指标最简便的方式。

首先,安装 Prometheus:

PROMETHEUS_VERSION="2.0.0"
wget https://github.com/prometheus/prometheus/releases/download/v$PROMETHEUS_VERSION/prometheus-$PROMETHEUS_VERSION.linux-amd64.tar.gz -O /tmp/prometheus-$PROMETHEUS_VERSION.linux-amd64.tar.gz
tar -xvzf /tmp/prometheus-$PROMETHEUS_VERSION.linux-amd64.tar.gz --directory /tmp/ --strip-components=1
/tmp/prometheus -version

将 Prometheus 的抓取器配置为指向 etcd 集群端点:

cat > /tmp/test-etcd.yaml <<EOF
global:
  scrape_interval: 10s
scrape_configs:
  - job_name: test-etcd
    static_configs:
    - targets: ['10.240.0.32:2379','10.240.0.33:2379','10.240.0.34:2379']
EOF
cat /tmp/test-etcd.yaml

设置 Prometheus 处理程序:

nohup /tmp/prometheus \
    -config.file /tmp/test-etcd.yaml \
    -web.listen-address ":9090" \
    -storage.local.path "test-etcd.data" >> /tmp/test-etcd.log  2>&1 &

现在 Prometheus 每 10 秒采集一次 etcd 指标。

告警

etcd v3 集群为 Prometheus 提供了一组 默认告警 。

说明

请注意,job 标签可能需要根据特定需求进行调整。规则编写时仅适用于单个集群,因此建议选择仅属于特定集群的标签。

Grafana

Grafana 内置了 Prometheus 支持;只需添加一个 Prometheus 数据源:

Name:   test-etcd
Type:   Prometheus
Url:    http://localhost:9090
Access: proxy

然后导入默认的 etcd dashboard template 并进行自定义。例如,若 Prometheus 数据源名称为 my-etcd,则 JSON 中的 datasource 字段值也需相应设置为 my-etcd。

示例仪表板:

分布式跟踪

在 v3.5 版本中,etcd 已添加对使用 OpenTelemetry 的分布式追踪支持。

说明

该功能仍处于实验阶段,可能随时更改。

要启用此实验性功能,请向 etcd 服务器传递 --experimental-enable-distributed-tracing=true,并配合 --experimental-distributed-tracing-sampling-rate=<number> 标志以选择每百万跨度收集的采样数量,默认采样率为 0。

通过以下可选标志启动 etcd 服务器,以配置分布式追踪:

  • --experimental-distributed-tracing-address - (可选) - “localhost:4317” - 跟踪收集器的地址。

  • --experimental-distributed-tracing-service-name - (可选) - “etcd” - 分布式追踪服务名称,所有 etcd 实例之间必须保持一致。

  • --experimental-distributed-tracing-instance-id - (可选) - 实例 ID,虽然可选,但强烈建议设置,每个 etcd 实例必须唯一。

启用分布式追踪前,请确保已配置 OpenTelemetry 端点。若该地址与默认值不同,请使用 --experimental-distributed-tracing-address 标志进行覆盖。由于 OpenTelemetry 存在多种运行方式,请参阅 collector 文档 以获取更多信息。

说明

与任何可观测性信号一样,存在资源开销。根据我们的初步测量,该开销可能在 2% 至 4% 的 CPU 开销之间。

14 - 性能

理解性能:延迟与吞吐量

理解性能

etcd 提供稳定、持续的高性能。性能由两个因素决定:延迟和吞吐量。延迟是指完成操作所需的时间。吞吐量是指在一定时间周期内完成的总操作数。通常情况下,当 etcd 接受并发客户端请求时,平均延迟会随着整体吞吐量的增加而上升。在常见的云环境(如 Google Compute Engine (GCE) 上的标准 n-4 实例,或 AWS 上相当的机器类型)中,三成员 etcd 集群在轻负载下请求完成时间小于 1 毫秒,重负载下每秒可完成超过 30,000 次请求。

etcd 使用 Raft 共识算法在成员之间复制请求并达成一致。共识性能,尤其是提交延迟,受限于两个物理因素:网络 I/O 延迟和磁盘 I/O 延迟。完成一次 etcd 请求所需的最短时间,是成员之间的网络往返时间(RTT),加上 fdatasync 将数据提交至持久存储所需的时间。数据中心内部的 RTT 可能长达数百微秒。美国境内的典型 RTT 约为 50ms,跨洲际的 RTT 可能慢至 400ms。传统旋转磁盘的典型 fdatasync 延迟约为 10ms。对于 SSD,延迟通常低于 1ms。为提升吞吐量,etcd 将多个请求批量处理并提交至 Raft。该批处理策略使 etcd 即便在高负载下也能实现高吞吐量。

其他子系统也会影响 etcd 的整体性能。每个序列化的 etcd 请求都必须经过基于 boltdb 的 MVCC 存储引擎处理,通常需要数十微秒完成。etcd 会周期性地对其最近应用的请求进行增量快照,并将其与之前的磁盘快照合并。此过程可能导致延迟突增。尽管在 SSD 上通常不是问题,但在 HDD 上可能导致观测到的延迟翻倍。同样,正在进行的压缩操作也可能影响 etcd 的性能。幸运的是,影响通常不显著,因为压缩操作是分阶段执行的,不会与常规请求争用资源。gRPC 作为 RPC 系统,为 etcd 提供了定义明确且可扩展的 API,但也引入了额外延迟,尤其在本地读取时更为明显。

基准测试

使用 etcd 自带的 benchmark 命令行工具可对 etcd 性能进行基准测试。

针对一些基准性能数据,我们以具有以下硬件配置的三成员 etcd 集群为例:

  • Google Cloud Compute Engine
  • 3 台 8 个 vCPU + 16GB 内存 + 50GB SSD 的机器
  • 1 台客户端机器(16 个 vCPU + 30GB 内存 + 50GB SSD)
  • Ubuntu 17.04
  • etcd 3.2.0,go 1.8.3

使用此配置时,etcd 大约可写入:

键数量键大小(字节)值大小(字节)连接数客户端数目标 etcd 服务器平均写入 QPS平均每次请求延迟平均服务器 RSS
10,000825611仅领导者5831.6ms48 MB
100,00082561001000仅领导者44,34122ms124 MB
100,00082561001000所有成员50,10420ms126 MB

示例命令如下:

# write to leader
benchmark --endpoints=${HOST_1} --target-leader --conns=1 --clients=1 \
    put --key-size=8 --sequential-keys --total=10000 --val-size=256
benchmark --endpoints=${HOST_1} --target-leader  --conns=100 --clients=1000 \
    put --key-size=8 --sequential-keys --total=100000 --val-size=256

# write to all members
benchmark --endpoints=${HOST_1},${HOST_2},${HOST_3} --conns=100 --clients=1000 \
    put --key-size=8 --sequential-keys --total=100000 --val-size=256

线性一致读取请求需通过集群成员的法定人数达成共识,以获取最新数据。可串行化读取比线性一致读取成本更低,因为其可由任意单个 etcd 成员提供服务,而非需经过成员法定人数,但可能提供过时数据作为代价。etcd 可执行以下读取操作:

请求次数键大小(字节)值大小(字节)连接数客户端数线性一致性平均读取 QPS每次请求的平均延迟
10,000825611线性一致1,3530.7ms
10,000825611可串行化2,9090.3ms
100,00082561001000线性一致141,5785.5ms
100,00082561001000可串行化185,7582.2ms

示例命令如下:

# Single connection read requests
benchmark --endpoints=${HOST_1},${HOST_2},${HOST_3} --conns=1 --clients=1 \
    range YOUR_KEY --consistency=l --total=10000
benchmark --endpoints=${HOST_1},${HOST_2},${HOST_3} --conns=1 --clients=1 \
    range YOUR_KEY --consistency=s --total=10000

# Many concurrent read requests
benchmark --endpoints=${HOST_1},${HOST_2},${HOST_3} --conns=100 --clients=1000 \
    range YOUR_KEY --consistency=l --total=100000
benchmark --endpoints=${HOST_1},${HOST_2},${HOST_3} --conns=100 --clients=1000 \
    range YOUR_KEY --consistency=s --total=100000

建议在新环境中首次搭建 etcd 集群时运行基准测试,以确保集群达到足够的性能;集群延迟和吞吐量可能对环境的微小差异较为敏感。

15 - 运行时重配置设计

etcd 运行时重配置命令的设计

运行时重配置是分布式系统中最为复杂且最容易出错的功能之一,尤其是在基于共识的系统(如 etcd)中。

继续阅读以了解 etcd 运行时重配置命令的设计原理,以及我们如何解决这些问题。

两阶段配置变更确保集群安全

在 etcd 中,每次运行时重配置都必须出于安全考虑,经过 两个阶段 。例如,添加成员时,需先通知集群新配置,再启动新成员。

1 - 通知集群新配置

要将成员添加到 etcd 集群,需通过 API 调用请求将新成员加入集群。这是向现有集群添加新成员的唯一方式。API 调用将在集群就配置变更达成一致后返回。

2 阶段 - 启动新成员

要将新的 etcd 成员加入现有集群,需指定正确的 initial-cluster,并将 initial-cluster-state 设置为 existing。成员启动时,会首先联系现有集群,并验证当前集群配置是否与 initial-cluster 中指定的预期配置一致。当新成员成功启动后,集群即达到预期配置。

通过将流程分为两个独立阶段,用户必须明确指定集群成员关系的变更。这实际上为用户提供了更大的灵活性,也使问题更容易理解。例如,若尝试向 etcd 集群添加一个 ID 与现有成员相同的成员,该操作将在第一阶段立即失败,且不会影响正在运行的集群。类似保护机制可防止因误操作而添加新成员。若新的 etcd 成员在集群尚未接受配置变更前尝试加入集群,该成员将不会被集群接受。

若未明确指定集群成员关系的管理流程,etcd 将面临意外的集群成员关系变更风险。例如,若 etcd 在 systemd 等初始化系统下运行,当通过成员关系 API 移除某个成员后,etcd 会被重启,并在启动时尝试重新加入集群。若 systemd 配置为在失败后重启 etcd,每当通过 API 移除成员时,此循环便会重复发生,这是不符合预期的行为。

我们预计运行时重配置应为低频操作。为确保配置安全并始终在明确控制下平稳运行,我们决定将其保持为显式且由用户驱动。

永久失去法定人数需要新建集群

如果集群永久性地丢失了多数成员,需从旧的数据目录启动新集群,以恢复之前的状态。

完全有可能强制从现有集群中移除故障成员以实现恢复。然而,我们决定不支持此方法,因为它绕过了正常的共识提交阶段,存在安全隐患。如果要移除的成员实际上并未宕机,或在同一个集群中通过不同成员强制移除,etcd 将导致集群出现分叉,且集群 ID 相同。这种情况非常危险,后续难以排查或修复。

在正确部署的情况下,永久性多数节点失联的可能性极低。但该问题严重程度足以引起特别关注。强烈建议阅读 灾难恢复文档 ,并在将 etcd 投入生产环境前,做好应对永久性多数节点失联的准备。

不要使用公共发现服务进行运行时重配置

公共发现服务仅可用于引导集群启动。如需将成员加入现有集群,请使用运行时重配置 API。

发现服务专为在云环境中引导启动 etcd 集群而设计,适用于所有成员的 IP 地址事先未知的情况。成功引导启动集群后,所有成员的 IP 地址均已被知晓。从技术上讲,此时发现服务便不再需要。

使用公共发现服务进行运行时重配置似乎是一种便捷的方式,毕竟发现服务已掌握集群的全部配置信息。然而,依赖公共发现服务会带来诸多问题:

  1. 它为集群的整个生命周期引入了外部依赖,而不仅仅是引导阶段。如果集群与公共发现服务之间存在网络问题,集群将受到影响。

  2. 公共发现服务必须在其生命周期内准确反映集群的运行时配置。该服务需提供安全机制以防止恶意行为,实现难度较高。

  3. 公共发现服务必须维护数以万计的集群配置。我们的公共发现服务后端尚未准备好应对此类工作负载。

要实现支持运行时重配置的发现服务,最佳选择是自行构建私有服务。

16 - 运行时重配置

etcd 增量运行时重配置支持

etcd 支持增量式运行时重配置,允许用户在运行时更新集群成员。

重新配置请求仅在集群多数成员正常运行时才能处理。生产环境中强烈建议始终将集群规模设置为大于二。从两成员集群中移除成员是不安全的。两成员集群的多数为两个。若在移除过程中发生故障,集群可能无法继续推进,需 从多数故障中重启 。

为更好地理解运行时重配置的设计原理,请阅读 运行时重配置文档 。

重新配置用例

本节将介绍集群重新配置的一些常见原因。大多数情况仅涉及添加或移除成员的组合操作,具体说明如下,详见 集群重新配置操作 。

批量升级多台机器

如果多个集群成员需因计划内维护(如硬件升级、网络中断等)而迁移,建议逐个修改成员。

安全移除领导者是可行的,但选举过程期间会有一段短暂的停机时间。如果集群中存储的 v2 数据超过 50MB,建议对 成员的数据目录 执行迁移。

修改集群规模

增加集群规模可提升 故障容忍度 ,并提供更优的读取性能。由于客户端可从任意成员读取,增加成员数量可提升整体序列化读取吞吐量。

减小集群规模可提升集群的写入性能,但会降低其容错能力。写入操作在被确认为已提交前,需复制到集群中多数成员。减小集群规模会降低所需的多数成员数,从而使每次写入更快地被提交。

替换故障节点

如果某台机器因硬件故障、数据目录损坏或其他严重情况而发生故障,应尽快予以替换。尚未移除的故障机器会负面影响法定人数,并降低系统对额外故障的容错能力。

要替换机器,请按照 从集群中移除成员 的操作说明执行,然后 添加新成员 以替代原成员。如果集群数据量超过 50MB,建议在原成员数据目录仍可访问的情况下 迁移该成员的数据目录 。

从多数节点故障重启集群

如果集群的多数节点丢失,或所有节点的 IP 地址均发生变更,则必须通过手动操作来安全恢复。恢复过程的基本步骤包括 使用旧数据创建新集群 、强制单个成员作为领导者,最后通过运行时配置逐个 添加新成员 至该新集群。

从少数派失败中恢复集群

若某个特定成员丢失,则相当于替换一台故障机器。具体步骤请参见 Replace a failed machine 。

集群重新配置操作

考虑到这些使用场景,每种相关操作均可予以描述。

在进行任何更改之前,必须有 etcd 成员的简单多数(法定人数)可用。这与向 etcd 执行任何写操作的基本要求相同。

对集群的所有更改必须按顺序执行:

  • 若要更新单个成员的 peerURLs,请执行更新操作
  • 若要替换健康的单个成员,请先移除旧成员,再添加新成员
  • 若要从 3 个成员增加到 5 个成员,请执行两次添加操作
  • 若要从 5 个成员减少到 3 个成员,请执行两次移除操作

所有示例均使用 etcd 自带的 etcdctl 命令行工具。如需在不使用 etcdctl 的情况下更改成员关系,请使用 v2 HTTP members API 或 v3 gRPC members API 。

更新成员

更新广告客户端 URL

要更新成员的通告客户端 URL,只需使用更新后的客户端 URL 标志(--advertise-client-urls)或环境变量(ETCD_ADVERTISE_CLIENT_URLS)重启该成员。重启后的成员将自动发布更新后的 URL。错误更新的客户端 URL 不会影响 etcd 集群的健康状态。

更新对等成员广告 URL

要更新成员的通告对等成员 URL,需先通过 member 命令显式更新,然后重启该成员。由于更新对等成员 URL 会更改集群范围的配置,可能影响 etcd 集群的健康状态,因此需要额外执行此操作。

要更新通告的对等成员 URL,首先需找到目标成员的 ID。列出所有成员的命令如下:etcdctl

$ etcdctl member list
6e3bd23ae5f1eae0: name=node2 peerURLs=http://localhost:23802 clientURLs=http://127.0.0.1:23792
924e2e83e93f2560: name=node3 peerURLs=http://localhost:23803 clientURLs=http://127.0.0.1:23793
a8266ecf031671f3: name=node1 peerURLs=http://localhost:23801 clientURLs=http://127.0.0.1:23791

本示例将 update a8266ecf031671f3 成员 ID,并将其 peerURLs 值更改为 http://10.0.1.10:2380:

$ etcdctl member update a8266ecf031671f3 --peer-urls=http://10.0.1.10:2380
Updated member with ID a8266ecf031671f3 in cluster

移除成员

假设要移除的成员 ID 为 a8266ecf031671f3。使用 remove 命令执行移除操作:

$ etcdctl member remove a8266ecf031671f3
Removed member a8266ecf031671f3 from cluster

目标成员将在此时自行停止,并在日志中输出移除信息:

etcd: this member has been permanently removed from the cluster. Exiting.

安全移除领导者是可行的,但在此期间集群将处于不可用状态,直到新的领导者被选举出来。该持续时间通常为选举超时时间加上投票过程所需时间。

添加新成员

添加成员是一个两步过程:

  • 通过 HTTP 成员 API 、gRPC 成员 API 或 etcdctl member add 命令将新成员添加至集群。
  • 使用包含更新后成员列表(现有成员 + 新成员)的新集群配置启动新成员。

etcdctl 通过指定成员的 名称 和 已通告的对等成员 URL ,将新成员添加到集群中:

$ etcdctl member add infra3 --peer-urls=http://10.0.1.13:2380
added member 9bf1b35fc7761a23 to cluster

ETCD_NAME="infra3"
ETCD_INITIAL_CLUSTER="infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380,infra3=http://10.0.1.13:2380"
ETCD_INITIAL_CLUSTER_STATE=existing

etcdctl 已向集群通报了新成员,并打印出成功启动该成员所需的环境变量。现在请使用新成员的相关标志启动新的 etcd 进程:

$ export ETCD_NAME="infra3"
$ export ETCD_INITIAL_CLUSTER="infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380,infra3=http://10.0.1.13:2380"
$ export ETCD_INITIAL_CLUSTER_STATE=existing
$ etcd --listen-client-urls http://10.0.1.13:2379 --advertise-client-urls http://10.0.1.13:2379 --listen-peer-urls http://10.0.1.13:2380 --initial-advertise-peer-urls http://10.0.1.13:2380 --data-dir %data_dir%

新成员将作为集群的一部分运行,并立即开始追赶集群中其他成员的进度。

若添加多个成员,最佳实践是逐个配置成员,并在添加更多新成员前验证每个成员是否已正确启动。若向单成员集群添加新成员,在新成员启动前,集群无法推进,因为达成共识需要多数成员(即至少两个成员)达成一致。此行为仅发生在 etcdctl member add 通知集群新成员存在,且新成员成功与现有成员建立连接之间的时段。

添加一个学习者成员

从 v3.4 版本开始,etcd 支持以学习者成员 / 非投票成员身份添加新成员。 其设计动机与架构详情请参见 设计文档 。 为使添加新成员的过程更加安全,并在添加新成员时降低集群停机时间,建议将新成员以学习者成员身份加入集群,直至其完成数据同步。该过程可描述为三个步骤:

  • 通过 gRPC members API 或 etcdctl member add --learner 命令,将新成员添加为学习者成员。

  • 使用新的集群配置启动新成员,配置中包含更新后的成员列表(现有成员 + 新成员)。 此步骤与之前完全相同。

  • 通过 gRPC members API 或 etcdctl member promote 命令,将新添加的学习者成员提升为投票成员。etcd 服务器会验证提升请求,以确保操作安全。 只有当学习者成员的 Raft 日志已追赶上领导者时,才能将其提升为投票成员。 若学习者成员尚未追赶上领导者的 Raft 日志,成员提升请求将失败(详见[提升成员时的错误情况]一节获取更多细节)。 在此情况下,应等待片刻后重试。

在 v3.4 版本中,etcd 服务器将集群可拥有的学习者成员数量限制为一个。主要考虑是减少因将数据从领导者传播到学习者成员而给领导者带来的额外负载。

使用 etcdctl member add 并配合标志 --learner,可将新成员作为学习者成员添加至集群。

$ etcdctl member add infra3 --peer-urls=http://10.0.1.13:2380 --learner
Member 9bf1b35fc7761a23 added to cluster a7ef944b95711739

ETCD_NAME="infra3"
ETCD_INITIAL_CLUSTER="infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380,infra3=http://10.0.1.13:2380"
ETCD_INITIAL_CLUSTER_STATE=existing

新添加的学习者成员启动新的 etcd 进程后,使用 etcdctl member promote 将该学习者成员提升为投票成员。

$ etcdctl member promote 9bf1b35fc7761a23
Member 9e29bbaa45d74461 promoted in cluster a7ef944b95711739
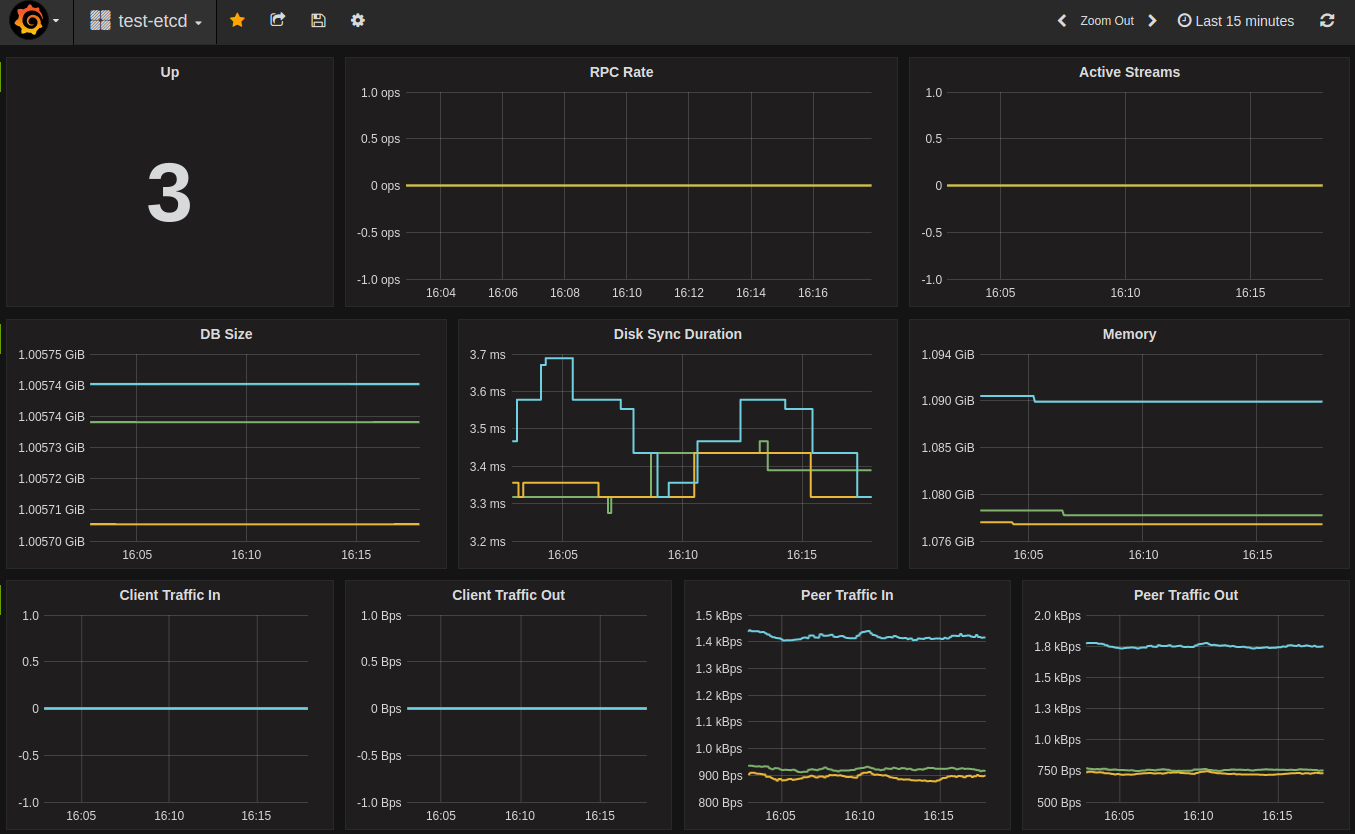
添加成员时的错误情况

在以下情况下,新主机未包含在已枚举节点的列表中。如果这是一个新集群,必须将该节点添加到初始集群成员列表中。

$ etcd --name infra3 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-state existing
etcdserver: assign ids error: the member count is unequal
exit 1

在这种情况下,请使用与加入集群时不同的地址(10.0.1.14:2380),而非用于加入集群的地址(10.0.1.13:2380):

$ etcd --name infra4 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380,infra4=http://10.0.1.14:2380 \
  --initial-cluster-state existing
etcdserver: assign ids error: unmatched member while checking PeerURLs
exit 1

如果 etcd 启动时使用了已移除成员的数据目录,且连接到集群中的任何活跃成员,则 etcd 会自动退出:

$ etcd
etcd: this member has been permanently removed from the cluster. Exiting.
exit 1

添加学习者成员时的错误情况

如果集群中已存在 1 个学习者成员,则无法再添加学习者成员(v3.4)。

$ etcdctl member add infra4 --peer-urls=http://10.0.1.14:2380 --learner
Error: etcdserver: too many learner members in cluster

晋升学习者成员时的错误情况

学习者成员只有在与领导者同步后,才能被提升为投票成员。

$ etcdctl member promote 9bf1b35fc7761a23
Error: etcdserver: can only promote a learner member which is in sync with leader

提升非学习者成员将失败。

$ etcdctl member promote 9bf1b35fc7761a23
Error: etcdserver: can only promote a learner member

提升集群中不存在的成员将失败。

$ etcdctl member promote 12345abcde
Error: etcdserver: member not found

严格重新配置检查模式 (-strict-reconfig-check)

如上所述,添加新成员的最佳实践是每次仅配置一个成员,并在添加更多新成员前验证其是否正确启动。逐步进行此操作至关重要,因为如果新添加的成员配置不正确(例如对等成员 URL 错误),集群可能失去法定人数。法定人数丢失的原因在于,即使新添加的成员无法与其他现有成员通信,该成员仍会被计入法定人数。此外,若存在连接问题或操作问题,也可能导致法定人数丢失。

为避免此问题,etcd 提供了选项 -strict-reconfig-check。若将此选项传递给 etcd,则当重新配置后已启动的成员数量将少于重新配置后集群的法定人数时,etcd 会拒绝该重新配置请求。

默认启用。

17 - 支持的平台

etcd 支持常见架构与操作系统

支持层级

etcd 可在不同平台上运行,但其提供的保证取决于平台的支持级别:

  • Tier 1:由 [etcd 维护者][] 完全支持;etcd 保证通过所有测试,包括功能测试和健壮性测试。
  • Tier 2:etcd 保证通过集成测试和端到端测试,但不保证通过功能测试或健壮性测试。
  • Tier 3:etcd 保证可构建,可能仅进行轻度测试(或未测试),因此应视为 不稳定。

当前支持

下表列出了当前支持的平台及其对应的 etcd 支持级别:

架构操作系统支持层级维护者
AMD64Linux1etcd maintainers
ARM64Linux1etcd maintainers
AMD64Darwin3
ARM64Darwin3
AMD64Windows3
ppc64leLinux3
s390xLinux3

未列出的平台不受支持。

支持新平台

希望作为新平台的“官方”维护者参与 etcd 贡献?除承诺支持该平台外,还必须设置 etcd 持续集成(CI),满足以下要求,具体取决于支持层级:

etcd 持续集成Tier 1Tier 2Tier 3
构建通过✓✓✓
单元测试通过✓✓
集成与端到端测试通过✓✓
健壮性测试通过✓

有关为 ARM64 设置二级 CI 的示例,请参见 etcd PR #12928 。

不支持的平台

为避免意外在不支持的平台上运行 etcd 服务器,除非环境变量 ETCD_UNSUPPORTED_ARCH 被设置为目标架构,否则 etcd 会打印警告信息并立即退出。

警告

32 位系统 由于 Go 运行时存在缺陷,etcd 在 32 位系统上存在已知问题。 详细信息请参见 Go 问题 #599 以及 atomic 包缺陷说明 。

18 - 版本管理

etcd 的版本支持

本文描述了 etcd 项目所支持的版本。

服务版本管理与支持版本

etcd 版本号采用 x.y.z 格式,其中 x 表示主版本号,y 表示次版本号,z 表示补丁版本号,遵循 语义化版本控制 规范。 新次版本号可能向 API 添加额外功能。

etcd 项目为当前版本及前一个版本维护发布分支。例如,当 v3.5 为当前版本时,v3.4 仍受支持。当 v3.6 发布后,v3.4 即停止支持。

根据严重性和可行性,适用于这两个发布分支的修复(包括安全修复)可能被回溯应用。 必要时,将从这些分支中发布补丁版本。

项目 Maintainers 拥有此决策权。

可以使用 etcdctl 检查正在运行的 etcd 集群版本:

etcdctl --endpoints=127.0.0.1:2379 endpoint status

API 版本管理

v3 API 的响应结果在 3.0.0 版本发布后不应发生变化,但后续将陆续增加新功能。

19 - 数据损坏

etcd 数据损坏和恢复

etcd 内置了自动数据损坏检测机制,以防止成员状态发生不一致。

启用数据损坏检测

数据损坏检测可通过以下方式执行:

  • 初始检查,通过 --experimental-initial-corrupt-check 标志启用。
  • 定期检查包括:
    • 已压缩的修订版本哈希,通过 --experimental-compact-hash-check-enabled 标志启用。
    • 最新修订版本哈希,通过 --experimental-corrupt-check-time 标志启用。

引导过程中将执行初始检查。 成员将比较其持久化状态与其他成员的状态,若发现不匹配则退出。

两个周期性检查将在已运行的集群中由领导者执行。 领导者将比较其持久化状态与其他成员的状态,若发现不一致则触发 CORRUPT ALARM。 两项检查目的相同,但均建议启用,以在性能与检测时间之间取得平衡。

  • 压缩修订版本哈希检查 - 需要定期执行压缩,性能开销极小,可处理缓慢的跟随者。
  • 最新修订版本哈希检查 - 性能开销较高,无法处理缓慢的跟随者或频繁的压缩。

压缩修订版本哈希检查

启用 --experimental-compact-hash-check-enabled 标志后,每分钟执行一次检查。 可使用 --experimental-compact-hash-check-time 标志调整检查频率,格式为:1m - 每分钟,1h - 每小时。 该检查将压缩功能扩展为同时计算校验和,以便在集群成员之间进行比对。 不会引起额外的数据库扫描,因此开销极低,但要求集群定期执行压缩。

最新修订版本哈希校验

通过 --experimental-corrupt-check-time 标志启用,需以如下格式提供执行周期:1m —— 每分钟,1h —— 每小时。 由于性能开销较高,建议周期为数小时。 运行检查需在指定修订版本下扫描整个 etcd 内容以计算校验和。

恢复受损成员

恢复损坏成员有三种方法:

  • 清除成员持久化状态
  • 替换成员
  • 恢复整个集群

成员恢复后,可移除 CORRUPT ALARM 告警。

清除成员持久化状态

可按以下步骤清除成员状态:

  1. 停止 etcd 实例。
  2. 备份 etcd 数据目录。
  3. 将 etcd 数据目录中的 snap 子目录移出。
  4. 使用 --initial-cluster-state=existing 启动 etcd,并在 --initial-cluster 中列出集群成员。

预计 etcd 成员将从领导者下载最新的快照。

替换成员

可按以下步骤替换成员:

  1. 停止 etcd 实例。
  2. 备份 etcd 数据目录。
  3. 删除数据目录。
  4. 运行 etcdctl member remove 从集群中移除该成员。
  5. 运行 etcdctl member add 将其重新添加。
  6. 使用 --initial-cluster-state=existing 启动 etcd,并在 --initial-cluster 中列出集群成员。

恢复整个集群

可通过从当前领导者保存快照,并将快照恢复到所有成员来恢复集群。 对领导者执行 etcdctl snapshot save,并参照 恢复集群过程 。