这是本节的多页打印视图。 .
学习
- 1: 数据模型
- 2: etcd 客户端设计
- 3: etcd 学习者成员设计
- 4: etcd v3 身份认证设计
- 5: etcd API
- 6: etcd 持久化存储文件
- 7: etcd API 保证
- 8: etcd 与其它键值存储系统比较
- 9: 术语表
1 - 数据模型
etcd 旨在可靠地存储更新频率较低的数据,并提供可靠的监听查询。etcd 通过暴露键值对的旧版本,支持低成本的快照和监听历史事件(“时间旅行查询”)。持久化、多版本、并发控制的数据模型非常适合这些应用场景。
etcd 将数据存储在多版本 持久化 键值存储中。当键值对的值被新数据覆盖时,持久化键值存储会保留该键值对的先前版本。键值存储本质上是不可变的;其操作不会就地更新结构,而是始终生成新的已更新结构。在修改后,所有历史版本的键仍可访问并可被监听。为防止数据存储随时间无限增长并避免长期保留旧版本,可对存储执行压缩以移除被覆盖数据的最旧版本。
逻辑视图
存储系统的逻辑视图是一个扁平的二进制键空间。键空间在字节字符串键上具有字典序排序的索引,因此范围查询的开销较低。
键空间维护多个修订版本。创建存储时,初始修订版本为 1。每次原子性修改操作(例如,事务操作可能包含多个操作)都会在键空间中创建一个新的修订版本。所有先前修订版本持有的数据保持不变。通过先前的修订版本仍可访问键的旧版本。同样,修订版本也进行了索引;通过监听器遍历修订版本的效率很高。若对存储执行压缩以节省空间,压缩修订版本之前的修订版本将被删除。在集群的生命周期内,修订版本单调递增。
键的生命周期跨越一个版本周期,从创建到删除。每个键可能拥有一个或多个版本周期。创建键会使其版本号递增,若该键在当前修订版本中不存在,则版本号从 1 开始。删除键会生成一个键墓碑,通过将版本号重置为 0 来结束该键的当前版本周期。对键的每次修改都会使其版本号递增;因此,在一个键的版本周期内,版本号单调递增。一旦执行压缩,所有在压缩修订版本之前结束的版本周期将被移除,且在压缩修订版本之前设置的值(除最新一个外)也将被移除。
物理视图
etcd 将物理数据以键值对的形式存储在持久化的 b+tree 中。存储系统状态的每个修订版本仅包含相对于前一修订版本的增量,以提高效率。单个修订版本可能对应树中的多个键。
键值对的键是一个三元组(主版本、子版本、类型)。主版本表示持有该键的存储修订版本。子版本用于区分同一修订版本内的不同键。类型是可选后缀,用于标识特殊值(例如,t 表示值中包含墓碑标记)。键值对的值包含相对于前一修订版本的修改内容,因此仅包含与前一修订版本的差异。B+ 树按键以字节序的字典序进行排序。对修订版本差异范围的查询操作快速;这使得能够快速定位从某一特定修订版本到另一修订版本的修改。压缩操作会移除过期的键值对。
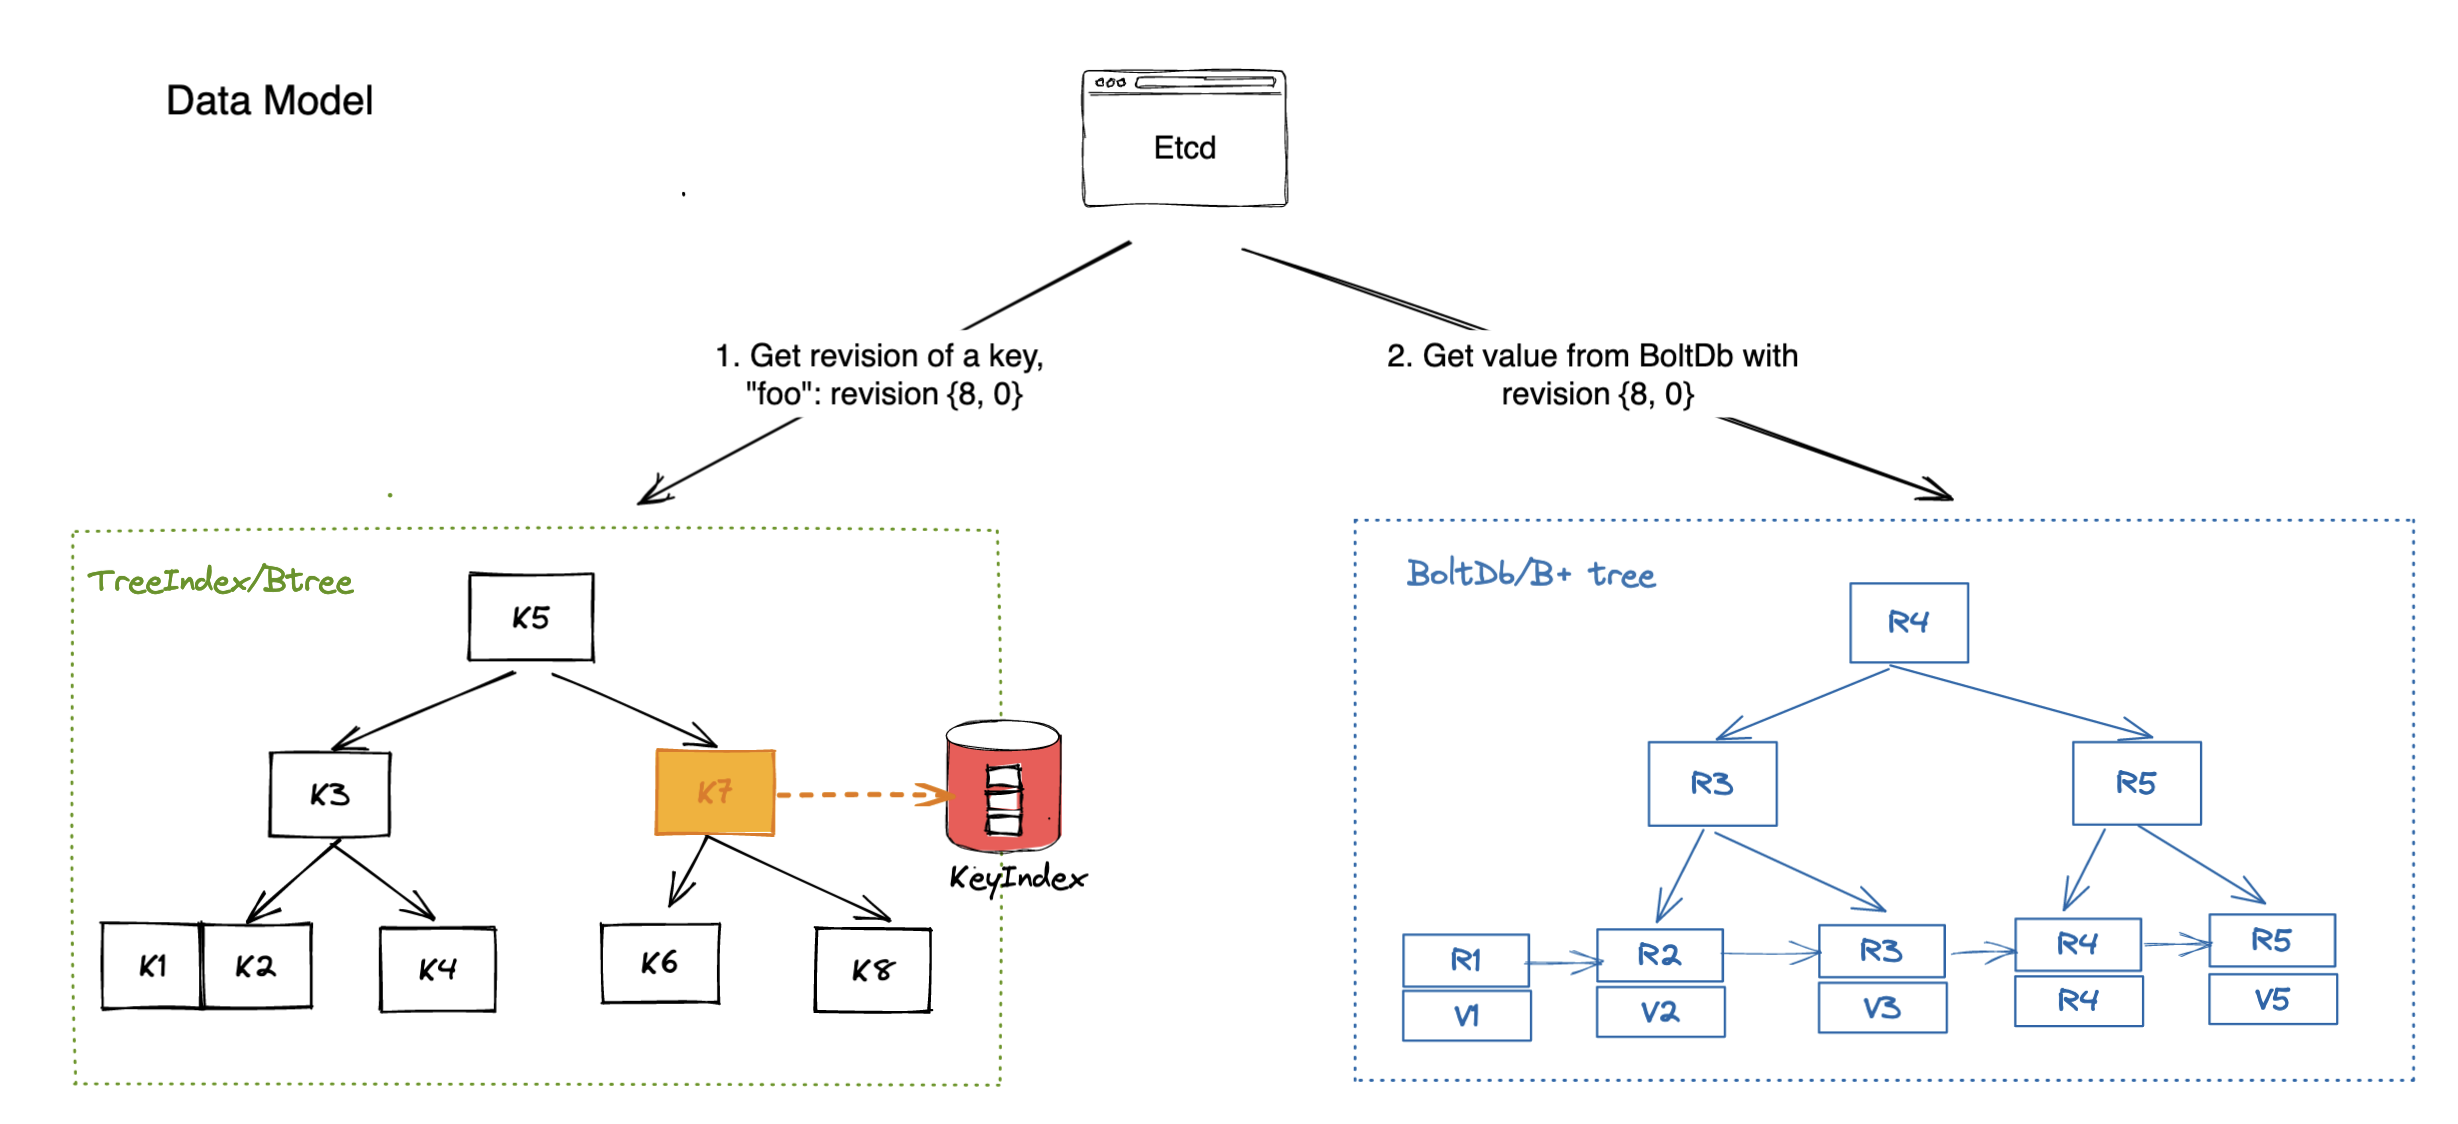
etcd 还维护一个二级内存中的 btree 索引,以加速对键的范围查询。btree 索引中的键为存储系统向用户暴露的键。值为指向持久化 b+tree 修改记录的指针。执行压缩时会移除无效指针。
总体而言,etcd 从 btree 获取修订版本信息,然后使用该修订版本作为键,从 b+tree 中获取值(如下图所示)。
2 - etcd 客户端设计
etcd 客户端设计
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
简介
etcd 服务器通过多年的故障注入测试验证了其稳健性。大多数复杂的应用逻辑已由 etcd 服务器及其数据存储处理(例如,集群成员关系对客户端透明,提案通过 Raft 层转发至领导者)。尽管服务器组件本身正确,但其与客户端的组合需采用一组复杂的协议,以确保在故障条件下仍能保证正确性和高可用性。理想情况下,etcd 服务器为多台物理机器提供单一逻辑集群视图,客户端则实现副本间的自动故障转移。本文档描述客户端的架构决策及其具体实现细节。
术语表
clientv3:etcd v3 API 的官方 Go 客户端。
clientv3-grpc1.0:官方客户端实现,包含 grpc-go v1.0.x
,在最新版 etcd v3.1 中使用。
clientv3-grpc1.7:官方客户端实现,包含 grpc-go v1.7.x
,用于最新版 etcd v3.2 和 v3.3。
clientv3-grpc1.23:官方客户端实现,包含 grpc-go v1.23.x
,在最新版 etcd v3.4 中使用。
负载均衡器:etcd 客户端负载均衡器,实现重试和故障转移机制。etcd 客户端应能自动在多个端点之间均衡负载。
端点:客户端可连接的 etcd 服务器端点列表。通常为 etcd 集群的 3 个或 5 个客户端 URL。
固定端点:当配置多个端点时,v3.3 及更早版本的客户端负载均衡器仅选择一个端点建立 TCP 连接,以减少与 etcd 集群的总连接数。在 v3.4 版本中,负载均衡器对固定端点采用轮询策略,每个请求均轮询不同端点,从而实现更均衡的负载分布。
客户端连接:通过 gRPC Dial 建立的与 etcd 服务器的 TCP 连接。
子连接:gRPC SubConn 接口。每个子连接包含一个地址列表。负载均衡器根据解析后的地址列表创建子连接。gRPC 客户端连接可以映射到多个子连接(例如,example.com 解析为 10.10.10.1 和 10.10.10.2 两个子连接)。etcd v3.4 负载均衡器采用内部解析器,为每个端点建立一个子连接。
瞬时断开连接:当 gRPC 服务器返回状态错误 code Unavailable
时。
客户端要求
正确性。在服务器发生故障时,请求可能会失败。然而,这绝不会违反一致性保证:全局顺序性、永不写入损坏数据、可变操作的至多一次语义、监听不会观察到部分事件等。
存活性。服务器可能会短暂地发生故障或断开连接。客户端应能在这两种情况下均继续推进。客户端应 永不发生死锁 ,等待服务器从离线状态恢复,除非已配置为如此。理想情况下,客户端通过 HTTP/2 ping 检测不可用的服务器,并向其他节点进行故障转移,同时提供明确的错误信息。
有效性。客户端应以最少资源高效运行:在端点切换后,先前的 TCP 连接应 优雅关闭 。故障转移机制应能有效预测下一个要连接的副本,避免对已失败节点进行无谓重试。
可移植性。官方客户端应有清晰的文档说明,其实现应适用于其他语言绑定。不同语言绑定之间的错误处理应保持一致。由于 etcd 完全致力于 gRPC,实现应与 gRPC 长期设计目标紧密对齐(例如,可插拔重试策略应与 gRPC retry 兼容)。两个客户端版本之间的升级应为非中断式。
客户端概述
etcd 客户端实现了以下组件:
- 用于与 etcd 集群建立 gRPC 连接的负载均衡器,
- 用于向 etcd 服务器发送 RPC 的 API 客户端,以及
- 决定是否重试失败请求或切换端点的错误处理程序。
不同语言在建立初始连接(例如配置 TLS)、编码并发送 Protocol Buffer 消息至服务器、处理流式 RPC 等方面可能存在差异。然而,etcd 服务器返回的错误将保持一致。因此,错误处理和重试策略也应保持一致。
例如,etcd 服务器可能返回 "rpc error: code = Unavailable desc = etcdserver: request timed out",该错误为瞬态错误,应进行重试。或返回 rpc error: code = InvalidArgument desc = etcdserver: key is not provided,表示请求无效,不应重试。Go 客户端可使用 google.golang.org/grpc/status.FromError 解析错误,Java 客户端可使用 io.grpc.Status.fromThrowable。
clientv3-grpc1.0:负载均衡器概述
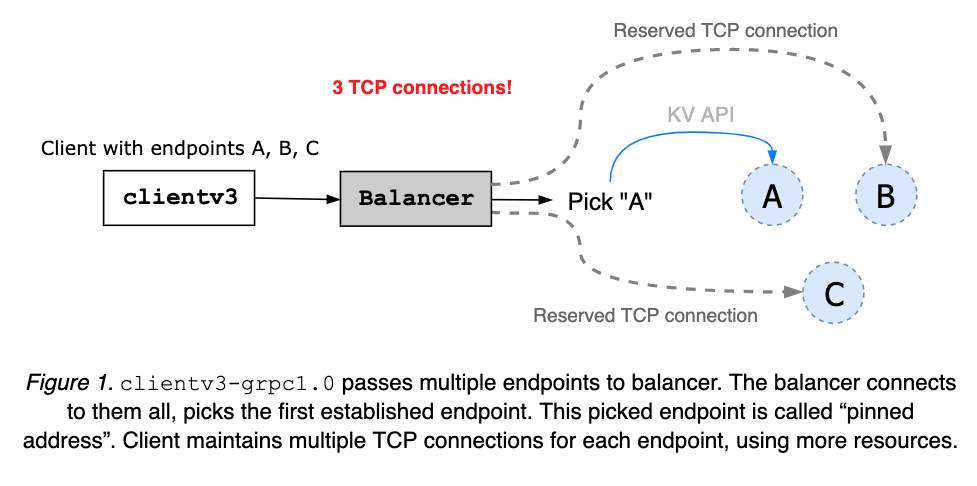
clientv3-grpc1.0 在配置多个 etcd 端点时,会维持多个 TCP 连接。随后选择一个地址,并使用该地址发送所有客户端请求。所固定的地址会一直保持,直至客户端对象关闭(参见 图 1)。当客户端收到错误时,会随机选择另一个地址并重试。
clientv3-grpc1.0:负载均衡器限制
clientv3-grpc1.0 同时打开多个 TCP 连接可提供更快的负载均衡器故障转移,但需要更多资源。负载均衡器不了解节点的健康状态或集群成员关系,因此可能出现负载均衡器卡在某个已失败或分区的节点上的情况。
clientv3-grpc1.7:负载均衡器概述
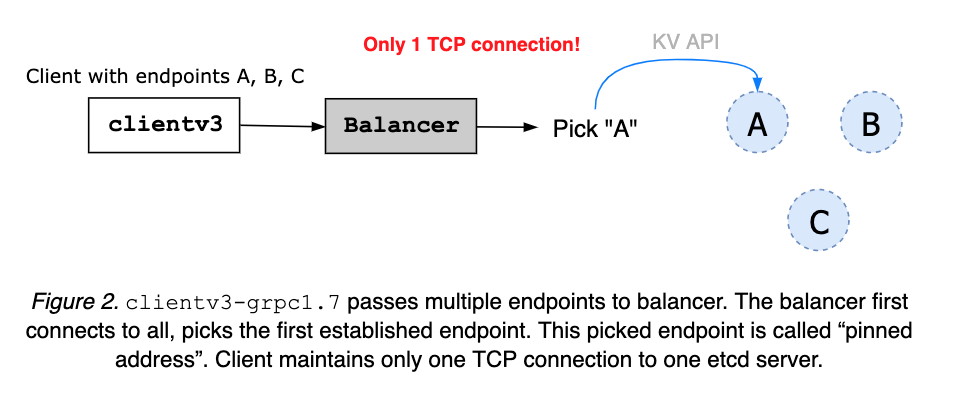
clientv3-grpc1.7 仅与选定的 etcd 服务器维持一个 TCP 连接。当提供多个集群端点时,客户端会尝试连接所有端点。一旦建立任一连接,负载均衡器即固定该地址,并关闭其他连接(参见 图 2)。该固定地址需保持至客户端对象关闭。若发生服务器错误或客户端网络故障,错误将被发送至客户端错误处理程序(参见 图 3)。
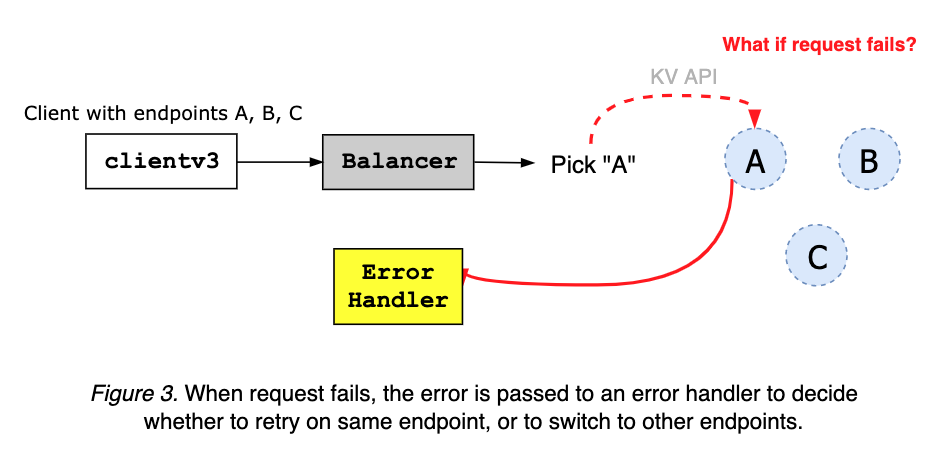
客户端错误处理程序接收来自 gRPC 服务器的错误,并根据错误码和错误信息决定是在同一端点重试,还是切换到其他地址(参见 图 4 和 图 5)。
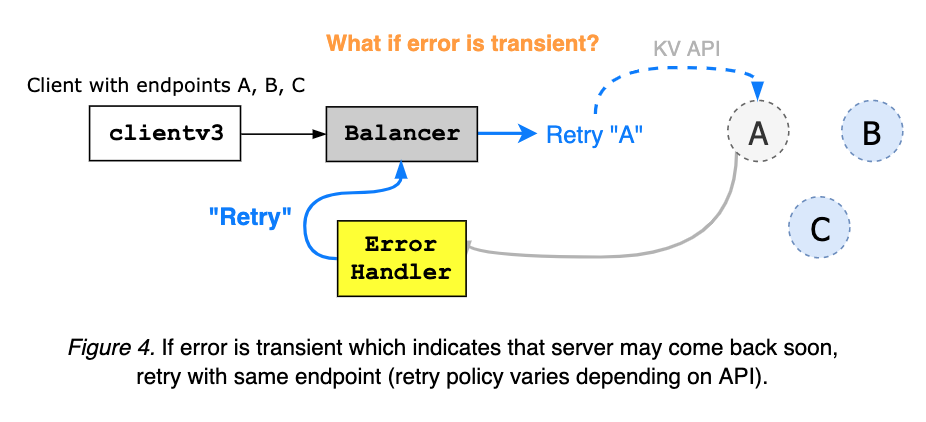
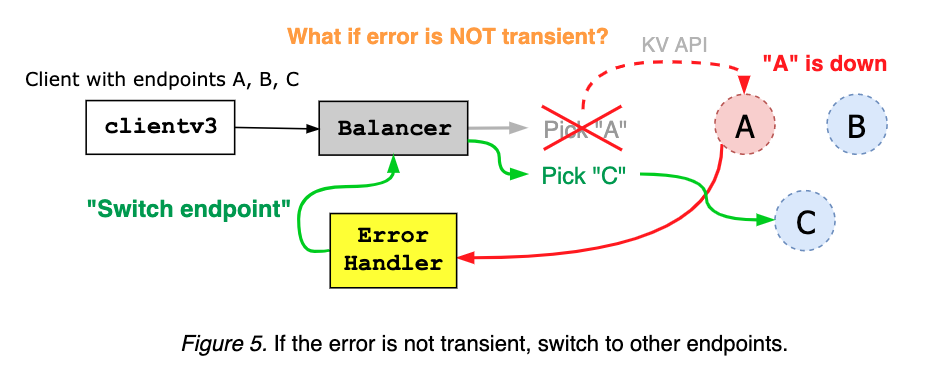
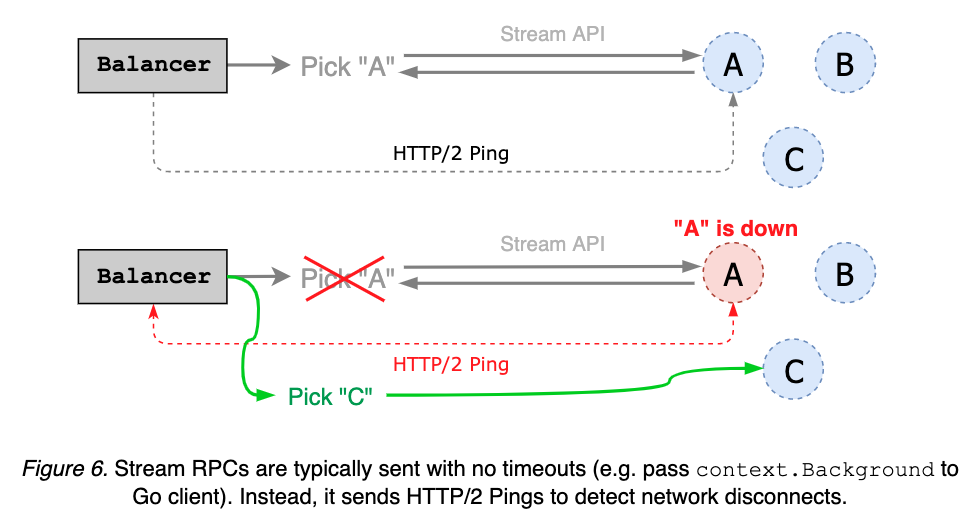
流式 RPC,例如监听(Watch)和保活(KeepAlive),通常在无超时的情况下发起请求。客户端可定期发送 HTTP/2 保活 ping 来检查已绑定端点的状态;若服务器未响应 ping,负载均衡器将切换至其他端点(参见 图 6)。
clientv3-grpc1.7:负载均衡器限制
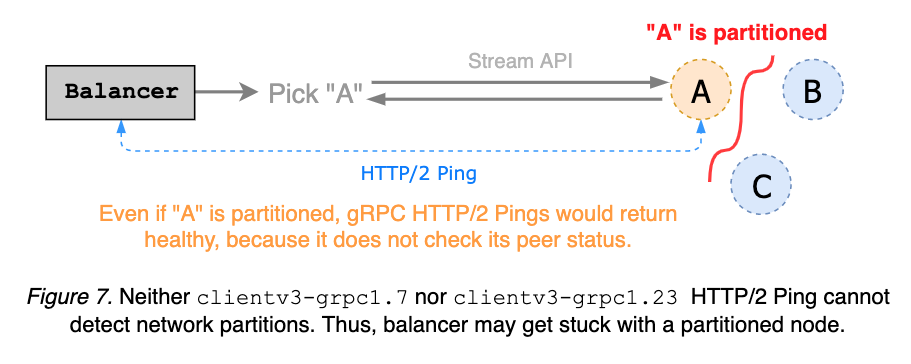
clientv3-grpc1.7 负载均衡器通过 HTTP/2 保活机制检测流式请求的断连。这是一种简单的 gRPC 服务器 ping 机制,不涉及集群成员关系的判断,因此无法检测网络分区。由于被分区的 gRPC 服务器仍可响应客户端 ping,负载均衡器可能陷入与分区节点的连接中。理想情况下,保活 ping 应在请求超时前检测到分区并触发端点切换(参见 etcd#8673
和 图 7)。
clientv3-grpc1.7 负载均衡器维护一个不健康端点列表。断开连接的地址会被加入“不健康”列表,并在等待时长过后才被视为可用,该等待时长硬编码为连接超时时间,默认值为 5 秒。负载均衡器可能对哪些端点不健康产生误判。例如,端点 A 可能在被标记为黑名单后立即恢复,但在接下来的 5 秒内仍不可用(参见 图 8)。
clientv3-grpc1.0 遇到了上述相同的问题。
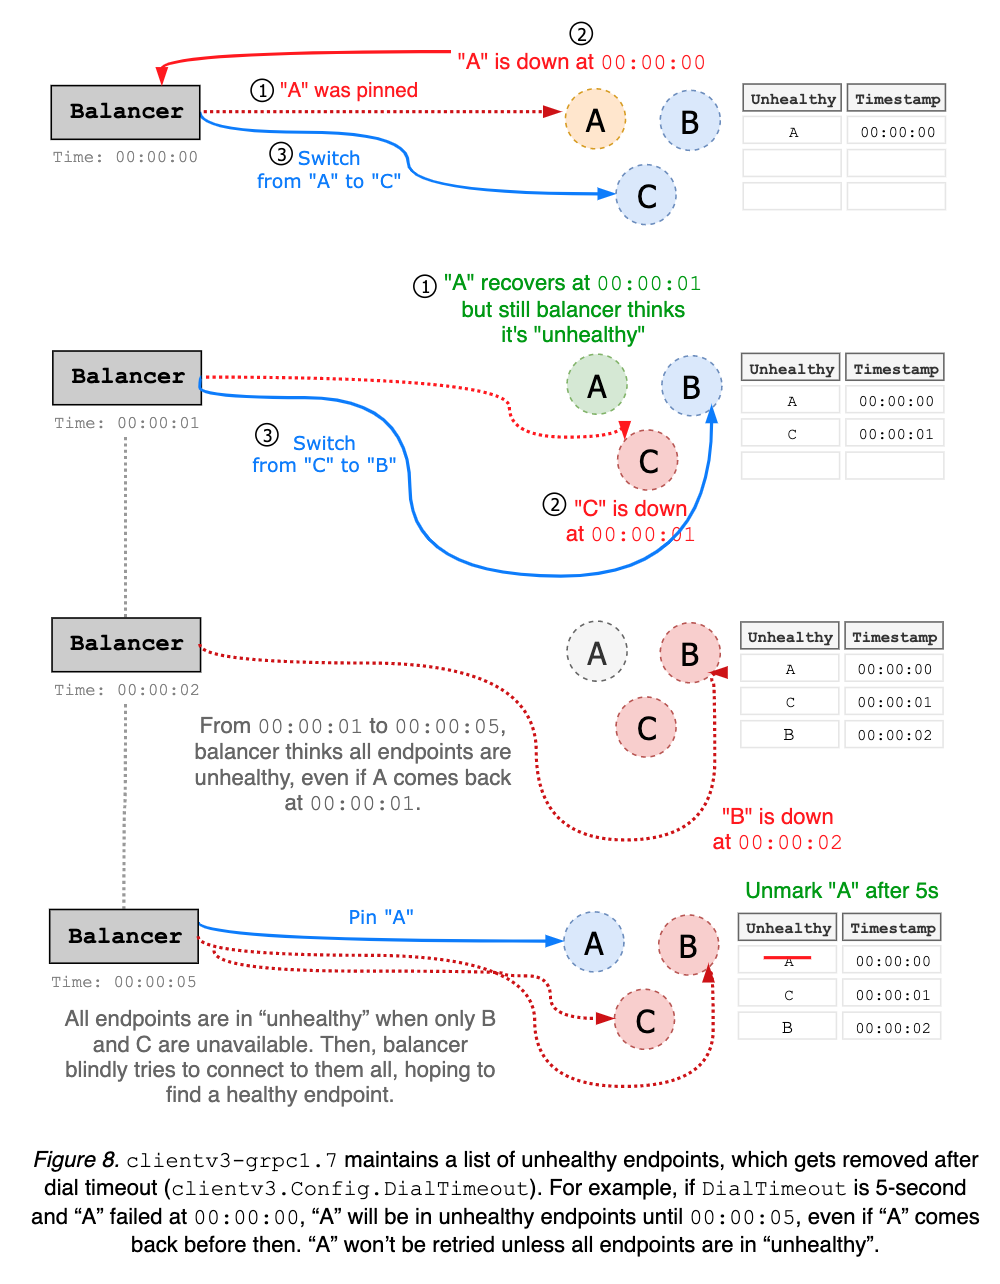
上游 gRPC Go 已经迁移到新的负载均衡接口。例如,clientv3-grpc1.7 的底层负载均衡实现使用了新的 gRPC 负载均衡机制,并努力与旧负载均衡行为保持一致。尽管兼容性已得到合理维护,etcd 客户端仍然 遭受了细微的破坏性变更
。此外,gRPC 维护者建议 不要依赖旧的负载均衡接口
。通常而言,为获得上游更好的支持,最好与最新的 gRPC 发布版本保持同步。此外,新功能(如重试策略)可能不会回溯到 gRPC 1.7 分支。因此,etcd 服务器和客户端都必须迁移到最新的 gRPC 版本。
clientv3-grpc1.23:负载均衡器概述
clientv3-grpc1.7 与旧版 gRPC 接口耦合过于紧密,导致每次 gRPC 依赖升级都会破坏客户端行为。大部分开发与调试工作都用于修复这些客户端行为变更。结果,其实现变得过于复杂,并基于对服务器连接性的错误假设。
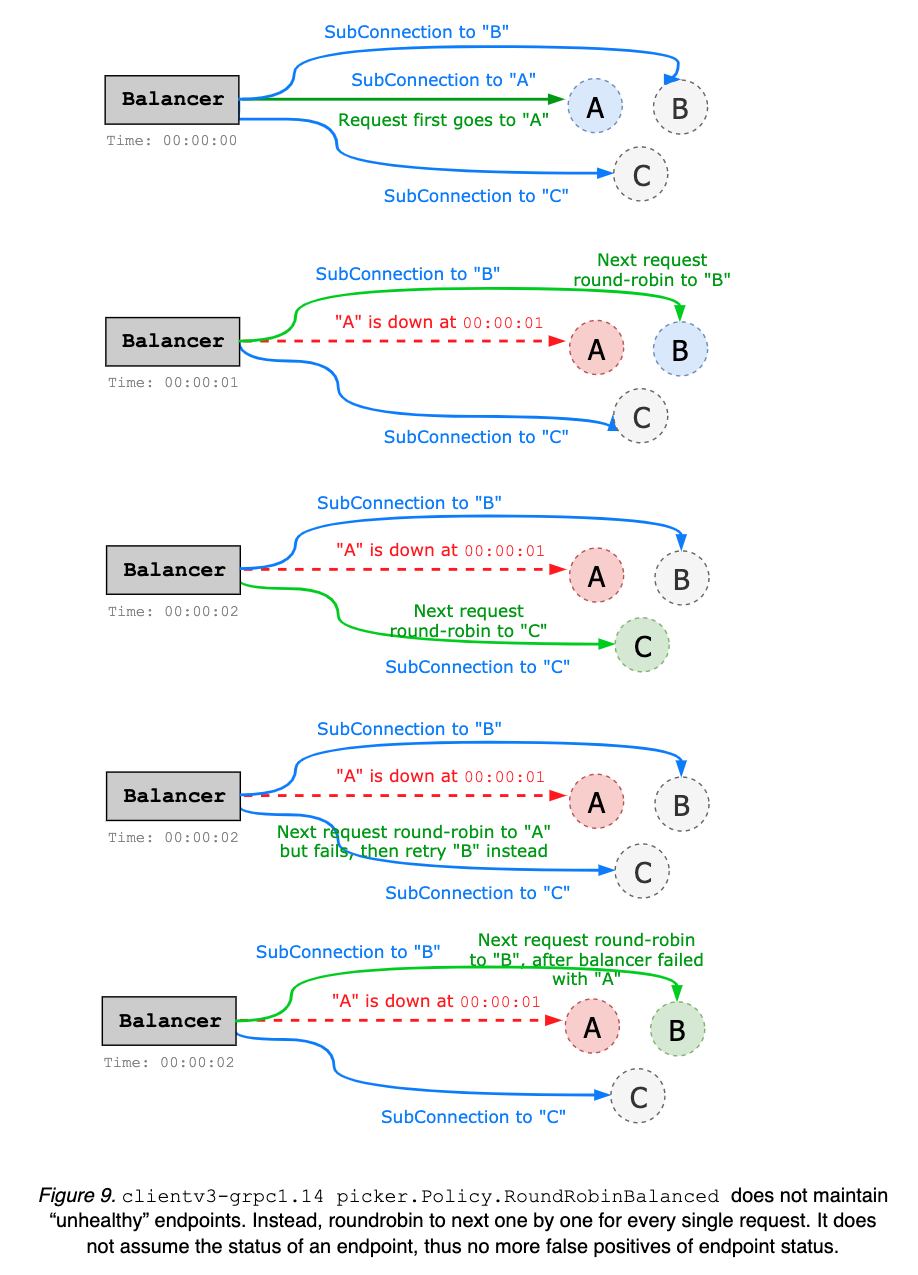
clientv3-grpc1.23 的主要目标是简化负载均衡器的故障转移逻辑:当客户端与当前端点断开连接时,不再维护一个可能已过时的不健康端点列表,而是直接轮询下一个端点。该机制不假设端点状态,因此无需再进行复杂的健康状态跟踪(参见 图 8 及以上内容)。升级至 clientv3-grpc1.23 不应存在问题;所有变更均为内部实现,同时保持了全部向后兼容性。
内部,当提供多个端点时,clientv3-grpc1.23 会创建多个子连接(每个端点对应一个子连接),而 clientv3-grpc1.7 仅连接到一个固定的端点(参见 图 9)。例如,在 5 节点集群中,clientv3-grpc1.23 负载均衡器需要 5 个 TCP 连接,而 clientv3-grpc1.7 仅需一个。通过保持 TCP 连接池,clientv3-grpc1.23 可能消耗更多资源,但能提供更具灵活性的负载均衡器,并具备更优的故障转移性能。默认的负载均衡策略为轮询,但可轻松扩展以支持其他类型的负载均衡器(例如,两倍选择、选择领导者等)。clientv3-grpc1.23 使用 gRPC 解析器组并实现负载均衡选择器策略,将复杂的负载均衡工作交由上游 gRPC 处理。另一方面,clientv3-grpc1.7 手动处理每个 gRPC 连接及负载均衡器故障转移,这增加了实现的复杂性。clientv3-grpc1.23 在 gRPC 拦截器链中实现重试机制,可自动处理 gRPC 内部错误,并支持更高级的重试策略(如指数退避),而 clientv3-grpc1.7 则需手动解析 gRPC 错误以实现重试。
clientv3-grpc1.23:负载均衡器限制
可通过缓存每个端点的状态来提升性能。例如,负载均衡器可预先 ping 每个服务器,以维护健康候选端点列表,并在轮询时使用该信息。或在断开连接时,负载均衡器可优先选择健康端点。这可能会增加负载均衡器实现的复杂性,因此可留待后续版本再行处理。
客户端保活 ping 仍不考虑网络分区情况。流式请求在与分区节点通信时可能陷入停滞。需实现高级健康检查服务以准确理解集群成员关系(详见 etcd#8673 )。
目前,重试逻辑需手动作为拦截器处理。可通过 官方 gRPC 重试 简化此过程。
3 - etcd 学习者成员设计
etcd 学习者成员
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
背景
成员变更配置一直是运维中最大的挑战之一。回顾常见问题。
1. 集群成员过载领导者
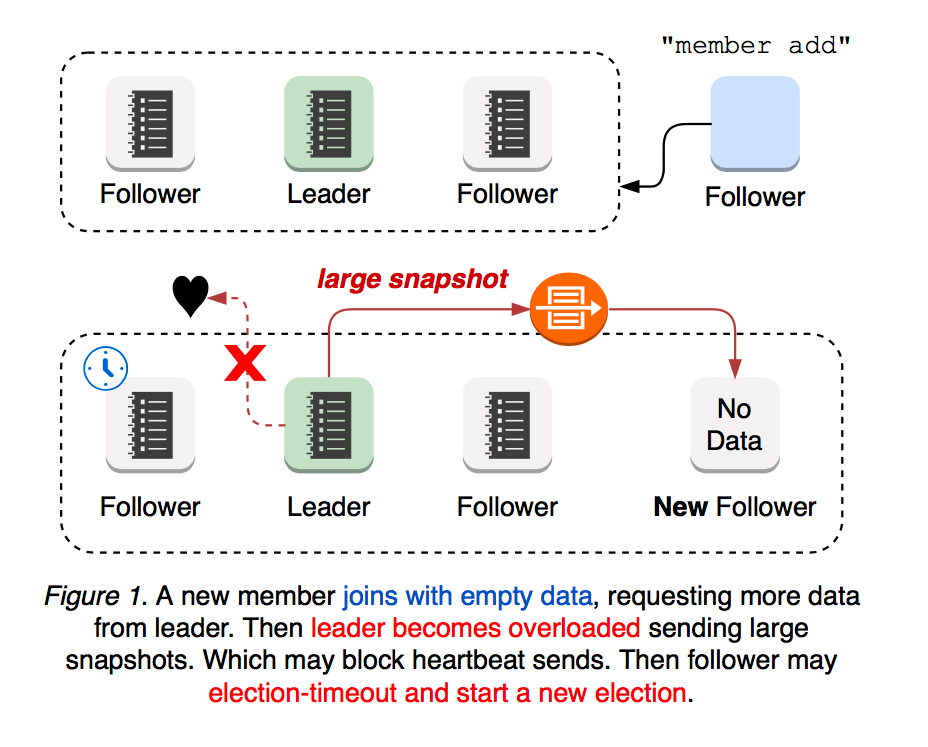
新加入的 etcd 成员初始时无任何数据,因此需要从领导者获取更多更新,直到其日志与领导者同步。此时,领导者网络更可能因负载过重而阻塞或丢弃发往跟随者的心跳。在这种情况下,跟随者可能因选举超时而发起新的领导者选举。也就是说,包含新成员的集群更容易发生领导者选举。领导者选举以及随后向新成员传播更新的过程均可能导致集群不可用的时段(参见 图 1)。
2. 网络分区场景
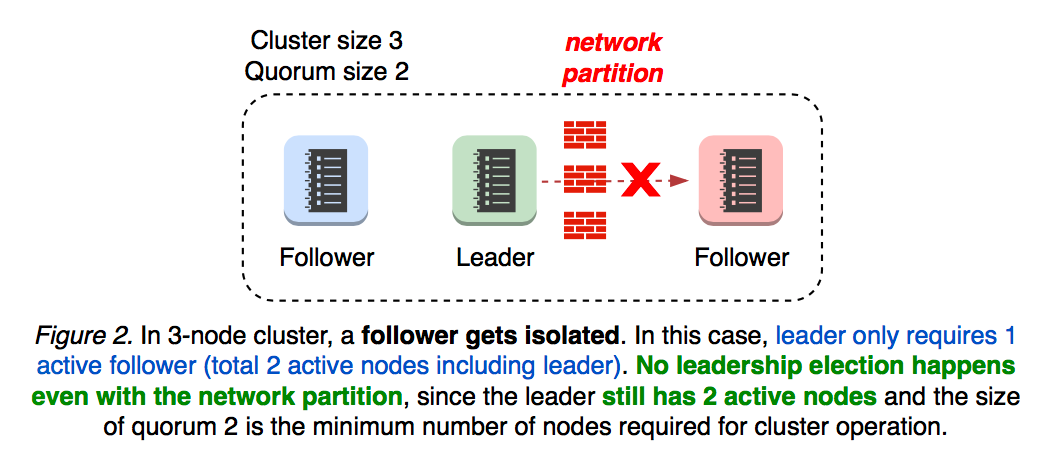
网络分区发生时会怎样?这取决于领导者是否仍能维持法定人数。如果领导者仍能保持活跃的法定人数,集群将继续运行(参见 图 2)。
2.1 领导者隔离
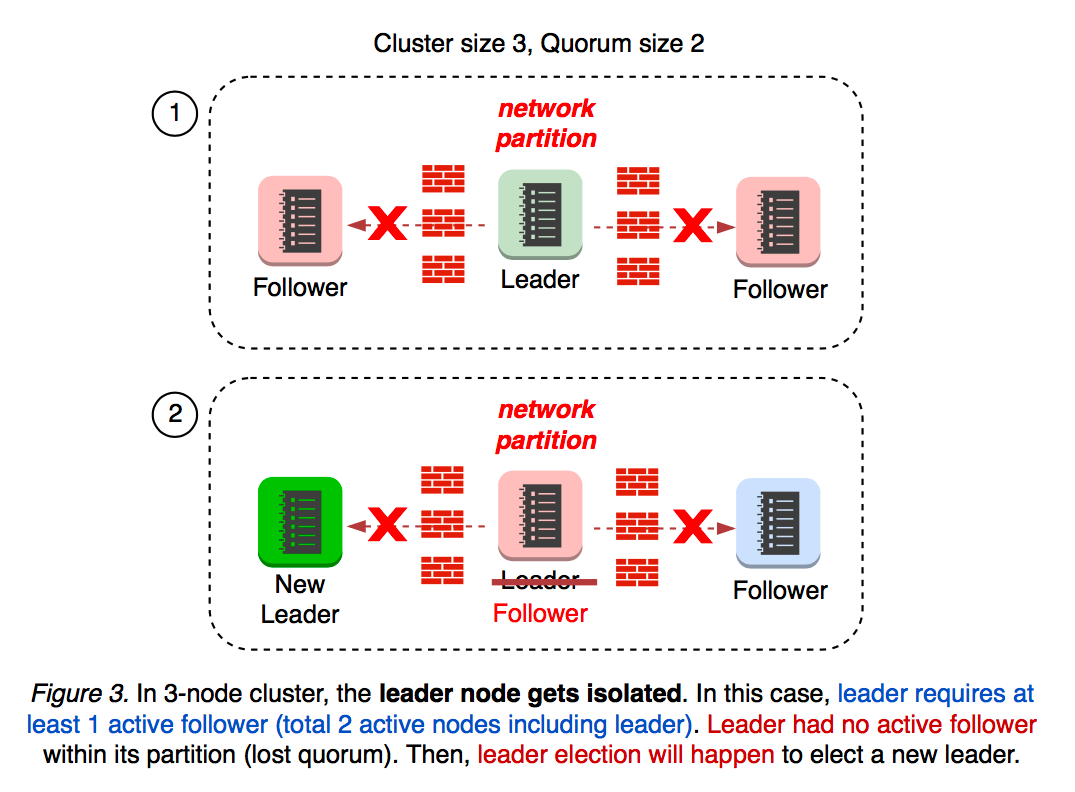
如果领导者与集群其余部分隔离,会发生什么?领导者会监控每个跟随者的进度。当领导者与法定人数失去连接时,它将回退为跟随者,这会影响集群的可用性(参见 图 3)。
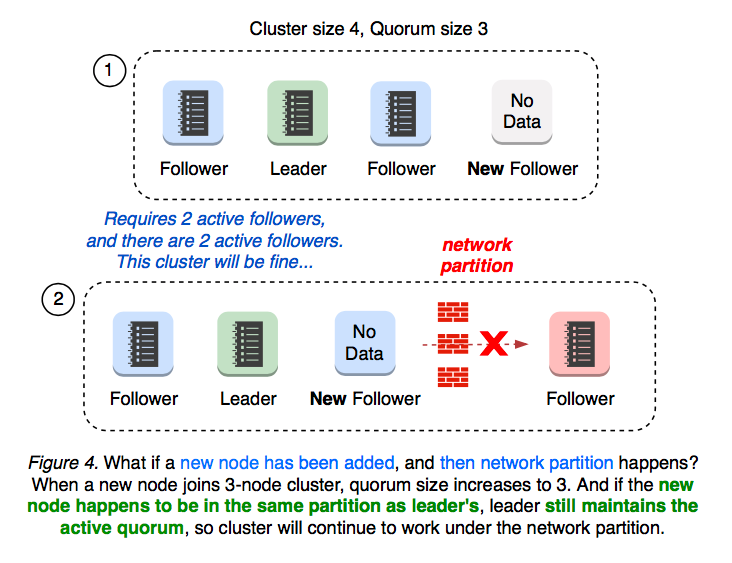
当向 3 个节点的集群添加新节点时,集群规模变为 4,法定人数规模变为 3。如果新节点加入集群后发生网络分区,结果取决于新成员在分区后位于哪个分区。
2.2 集群分裂 3+1
如果新节点恰好位于领导者所在的同一分区中,领导者仍能维持由 3 个节点组成的活跃法定人数。不会发生领导权选举,集群可用性也不会受到影响(参见 图 4)。
2.3 集群分裂 2+2
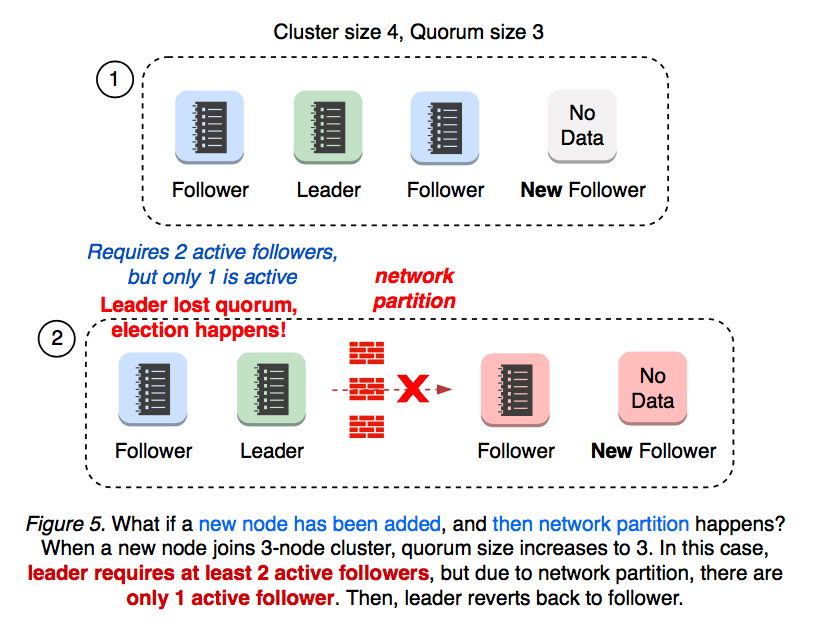
如果集群出现 2-2 分区,则任一分区均无法维持 3 个节点的法定人数。此时将触发领导权选举(参见 图 5)。
2.4 法定人数丢失
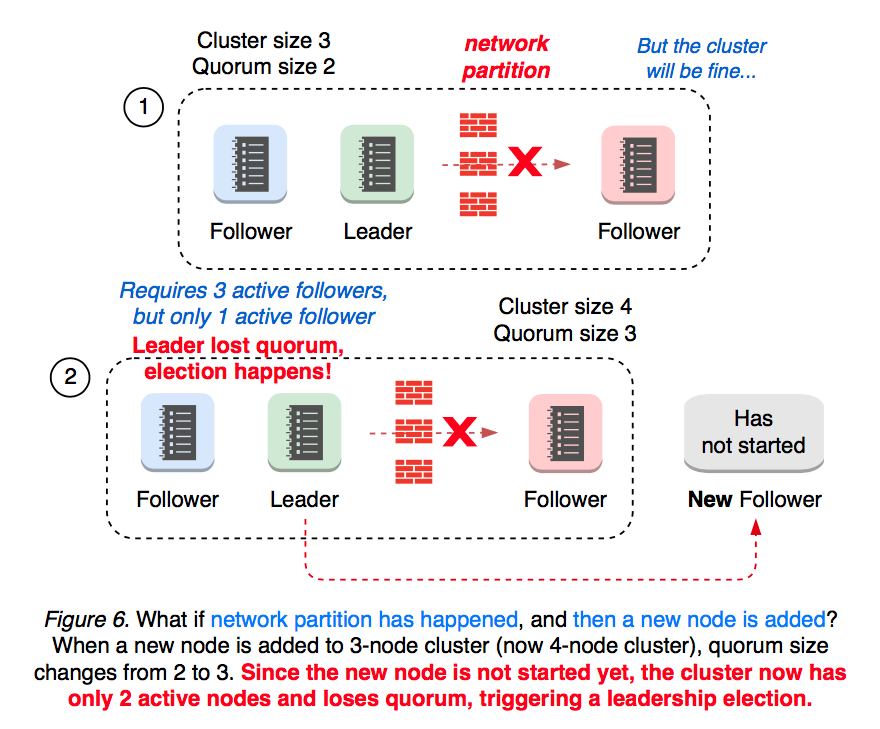
如果网络分区先发生,随后再添加新成员会怎样?一个已处于分区状态的 3 节点集群中,已有 1 个跟随者与集群断开连接。当添加新成员后,法定人数从 2 变为 3。此时,集群中仅有 4 个节点中的 2 个处于活跃状态,导致失去法定人数,并启动新的领导权选举(参见 图 6)。
由于成员添加操作可能改变法定人数规模,因此始终建议先执行“member remove”以替换不健康的节点。
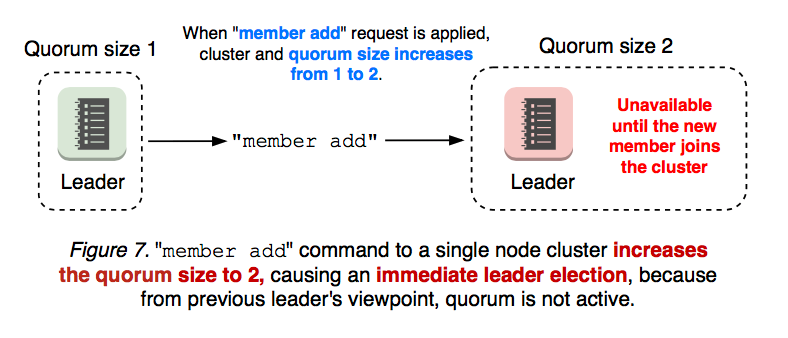
向单节点集群添加新成员会将法定人数大小更改为 2,当原领导者发现法定人数不再活跃时,会立即触发选举。这是因为“member add”操作是一个两步过程,用户需先执行“member add”命令,然后启动新节点进程(参见 图 7)。
3. 集群配置错误
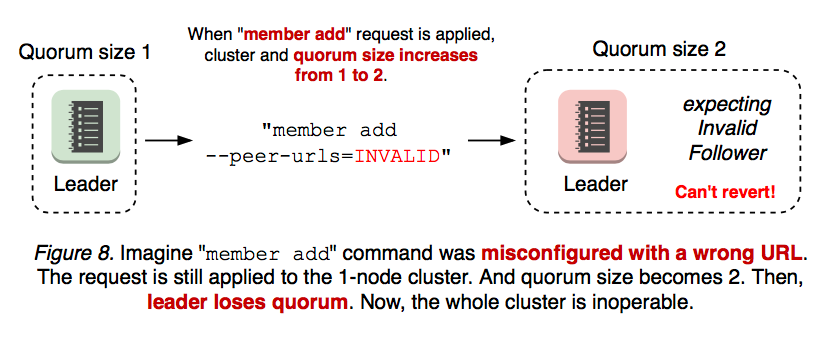
更严重的情况是,当新增成员配置错误时。成员变更是一项两步操作:首先执行“etcdctl member add”,然后使用指定的对等成员 URL 启动 etcd 服务器进程。也就是说,“member add” 命令的执行不依赖于 URL 的有效性,即使 URL 值无效也会被应用。若第一步使用了无效的 URL,第二步将无法启动新的 etcd 实例。一旦集群失去法定人数,就无法回滚成员变更(参见 图 8)。
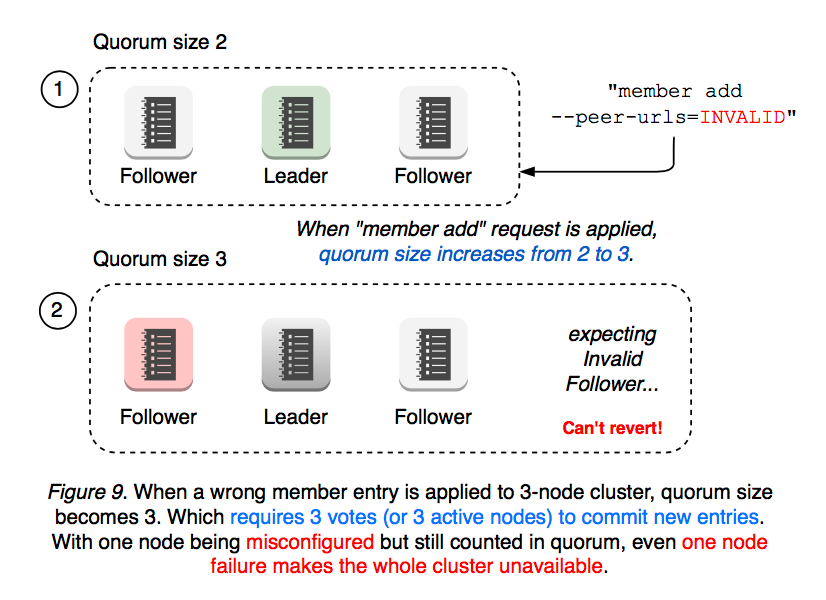
多节点集群情况亦同。例如,集群中有两个成员离线(一个已故障,另一个配置错误),两个成员在线,但此时更改集群成员关系至少需要 3 票(参见 图 9)。
如上所述,一个简单的配置错误可能导致整个集群进入无法运行的状态。在此情况下,操作员需手动使用 etcd --force-new-cluster 标志重建集群。随着 etcd 成为 Kubernetes 的关键任务服务,哪怕是最轻微的中断也可能对用户造成重大影响。我们能否进一步优化,使 etcd 的此类操作更加简便?在诸多方面中,领导者选举对集群可用性最为关键:能否通过不改变法定人数规模的方式,降低成员配置变更的干扰?新节点是否可以处于空闲状态,仅从领导者请求最小量的更新,直至完成同步?成员配置错误是否始终可逆,并以更安全的方式处理(错误执行成员添加命令不应导致集群失败)?用户在添加新成员时是否需要担心网络拓扑?成员添加 API 是否应与节点位置及正在进行的网络分区无关而正常工作?
Raft 学习者成员
为缓解上一节所述的可用性缺口,Raft §4.2.1 引入了一种新的节点状态“学习者成员”,该成员以非投票成员身份加入集群,直至其日志与领导者日志同步。
v3.4 版本特性
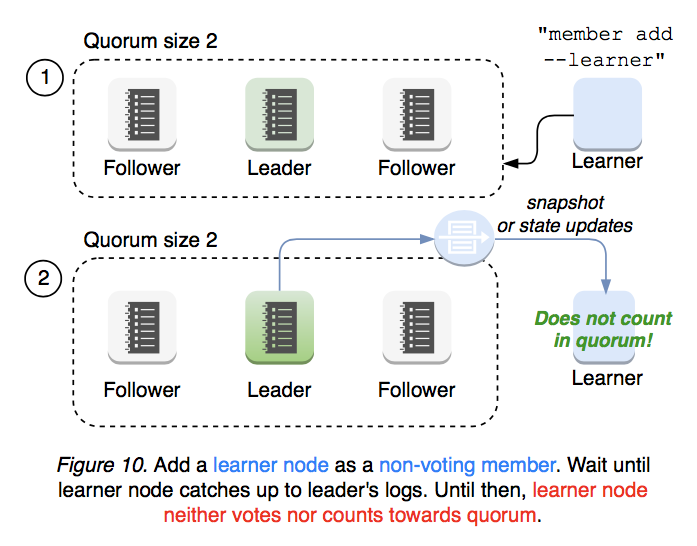
操作员应尽可能减少添加新学习者成员的工作量。使用 member add --learner 命令添加新的学习者成员,该成员以非投票成员身份加入集群,但仍接收来自领导者的全部数据(参见 图 10)。
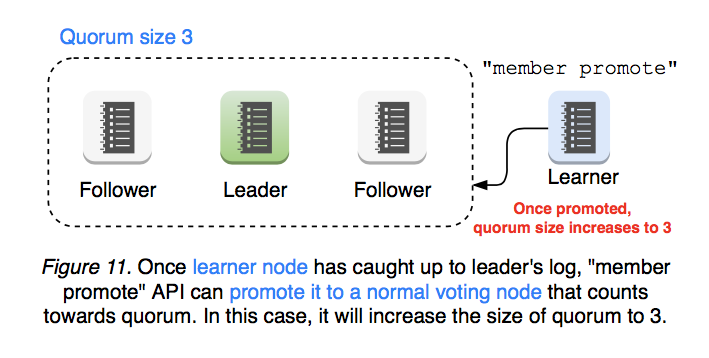
当学习者成员已追上领导者进度时,可使用 member promote API 将其晋升为投票成员,该成员将计入法定人数(参见 图 11)。
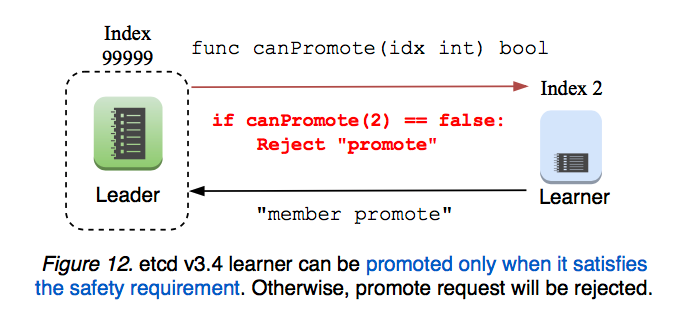
etcd 服务器会验证提升请求,以确保操作安全。只有当学习者成员的日志已追赶上领导者时,才能将其提升为投票成员(参见 图 12)。
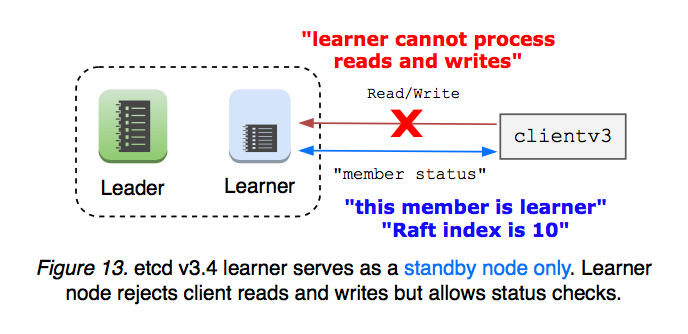
学习者成员仅作为备用节点,直到被提升:领导权无法转移至学习者成员。学习者成员拒绝客户端读写请求(客户端负载均衡器不应将请求路由至学习者成员)。这意味着学习者成员无需向领导者发起读索引请求。此限制简化了 v3.4 版本中学习者成员功能的初始实现(参见 图 13)。
此外,etcd 限制了集群可拥有的学习者成员总数,以避免领导者因日志复制而过载。学习者成员不会自行晋升。尽管 etcd 提供了学习者成员状态信息和安全检查,但集群操作员必须最终决定是否晋升学习者成员。
未来版本的待定功能
仅启用学习者成员状态并设为默认:将新成员状态默认设为学习者成员可显著提升成员配置变更的安全性,因为学习者成员不会影响法定人数的大小。配置错误始终可逆,且不会导致法定人数丢失。
实现学习者成员晋升的完全自动化:当学习者成员追赶上领导者的日志后,集群可自动将其晋升为投票成员。etcd 要求操作员定义特定阈值,一旦满足条件,学习者成员将自动晋升为投票成员。从操作员视角看,“member add” 命令的使用方式与当前一致,但通过学习者成员功能提供了更高的安全性。
将学习者成员设为备用故障转移节点:学习者成员以备用节点身份加入集群,当集群可用性受到影响时,将自动被提升为可用节点。
使学习者成员为只读:学习者成员可作为只读节点,且永远不会被提升为投票成员。在弱一致性模式下,学习者成员仅从领导者接收数据,且从不处理写入操作。通过本地提供读取服务而无需共识开销,可显著降低领导者的工作负载,但可能提供过时数据。在强一致性模式下,学习者成员会向领导者请求读索引以提供最新数据,但仍拒绝写入操作。
学习者成员与镜像制作器
etcd 使用监听 API 实现“镜像制作器”,以持续将键的创建和更新同步到另一个集群。镜像同步在完成初始同步后,通常具有较低的延迟开销。学习者成员与镜像同步存在重叠,二者均可用于复制现有数据以供只读访问。然而,镜像同步不保证线性一致性。在网络断开期间,先前的键值可能已被丢弃,客户端应验证监听响应以确保正确顺序。因此,镜像同步不提供顺序保证。在需要最低延迟(例如跨数据中心)的场景下,可使用镜像同步,但需承担一致性损失。如需保留所有历史数据及其顺序,应使用学习者成员。
附录:v3.4 中的学习者成员实现
将“Learner”节点类型暴露给“MemberAdd”API。
etcd 客户端在 “MemberAdd” API 中添加了一个用于学习者成员的标志。etcd 服务器处理程序会以 pb.ConfChangeAddLearnerNode 类型应用成员变更条目。命令应用完成后,服务器将以 etcd --initial-cluster-state=existing 标志加入集群。该学习者成员既不能投票,也不能计入法定人数。
etcd 服务器不得将领导权转移给学习者成员,因为学习者成员可能仍存在延迟,且不计入法定人数。etcd 服务器限制集群中学习者成员的数量为一个:学习者成员越多,领导者需传播的数据就越多。客户端可以与学习者成员通信,但学习者成员仅接受可串行化读取和成员状态 API 请求,拒绝所有其他请求。这是为了简化初始实现。未来,学习者成员可扩展为持续同步集群数据的只读服务器。客户端负载均衡器必须提供辅助函数以排除学习者成员的端点。否则,发送至学习者成员的请求可能失败。客户端同步成员调用应考虑学习者成员类型。客户端端点更新调用也应如此。
MemberList 和 MemberStatus 的响应应明确指出哪个节点是学习者成员。
添加 “MemberPromote” API。
在 Raft 内部,对学习者成员的第二次 MemberAdd 调用会将其提升为投票成员。领导者维护每个跟随者和学习者成员的进度。若学习者成员尚未完成其快照消息,则拒绝提升请求。仅当且仅当满足以下条件时,才接受提升请求:学习者成员处于健康状态;学习者成员与领导者同步,或偏差在阈值范围内(例如,需复制至学习者成员的条目数量少于快照数量的 1/10,这意味着即使在提升后,领导者也几乎无需再向学习者成员发送快照)。所有这些逻辑均硬编码在 etcdserver 包中,不可配置。
参考
- 原始 GitHub 问题:etcd#9161
- 使用场景:etcd#3715
- 使用场景:etcd#8888
- 使用场景:etcd#10114
4 - etcd v3 身份认证设计
为什么不重用 v2 认证系统?
v3 协议使用 gRPC 作为传输机制,而非 v2 所采用的 RESTful 接口。这一新协议为迭代和改进 v2 设计提供了机会。例如,v3 身份认证采用基于连接的身份认证,而非 v2 每请求身份认证的较慢方式。此外,v2 身份认证在实际应用中关于一致性推理的语义往往难以处理,这一点将在后续章节中详述。对于 v3,身份认证机制具有明确定义的描述和实现,解决了 v2 身份认证系统中的缺陷。
功能要求
- 按连接进行身份认证,而非按请求
- 为 gRPC API 实现基于用户 ID 和密码的身份认证
- 身份认证策略变更后必须重新刷新认证
- 功能应与 v2 版本一样简单且实用
- v3 提供扁平键空间,不同于 v2 的目录结构。权限检查将通过区间匹配实现。
- 其一致性保证应强于 v2 版本的身份认证
主要必要更改
- 客户端必须在发送已身份认证的请求前,仅通过专用连接完成身份认证
- 将权限信息(用户 ID 和授权的修订版本)添加到 Raft 命令中(
etcdserverpb.InternalRaftRequest) - 每个请求均在状态机层进行权限检查,而非 API 层
权限元数据一致性
认证相关的元数据也应像 etcd 中存储的其他数据一样,由 etcd 的 Raft 协议所控制的存储系统进行存储和管理。这是确保整个 etcd 集群可用性与一致性的必要条件。若读取或写入元数据(例如权限信息)需要所有节点达成一致(超过法定人数),则单个节点故障可能导致整个集群停止运行。要求所有节点同时达成一致,意味着只要任一集群成员离线,即使集群仍拥有可用的法定人数,普通读写请求也无法完成。这种全票通过机制最终会降低集群的可用性;而基于 Raft 的法定人数共识机制已足够,因为一致性排序自然带来共识。
etcd v2 协议中的身份认证机制存在一个复杂之处:元数据一致性应如上所述工作,但实际上并非如此。每个权限检查均由接收客户端请求的 etcd 成员(server/etcdserver/api/v2http/client.go)处理,包括跟随者成员。因此,检查结果可能基于过时的元数据。
此过时状态意味着,当操作员执行 etcdctl 时,认证配置无法立即反映。因此,无法知晓过时元数据的活跃时长。实际上,配置变更在命令执行后会立即生效。然而,在高负载情况下,不一致状态可能持续较长时间,从而导致用户和开发者遇到反直觉的情况。此时需采用如 this 的变通方案。
线性化请求存在不一致的权限是不安全的
对写操作而言,身份认证状态不一致是最严重的问题。即使管理员已禁用某个用户的写权限,如果写操作仅相对于键值存储有序,而未相对于身份认证系统有序,仍可能导致写操作成功完成。若身份认证存储与键值存储之间缺乏有序性,系统将容易受到过期权限攻击。
因此,权限检查逻辑应添加到 etcd 的状态机中。每个状态机应在应用阶段(apply phase)根据其权限信息检查请求(因此权限信息不得过期)。
设计与实现
身份认证
首先,客户端必须仅通过 gRPC 连接来完成身份认证,以验证其用户 ID 和密码。etcd 服务器将返回身份认证响应。认证成功时,响应中包含身份认证令牌;认证失败时,返回错误信息。客户端可在发起 API 请求时,使用该身份认证令牌向 etcd 提交其凭证。
用于请求身份认证令牌的客户端连接通常会被丢弃;该连接无法携带新令牌的凭据。这是因为 gRPC 不提供在连接创建后为每个 RPC 添加凭据的方式(调用 grpc.Dial())。因此,客户端无法将其通过连接获取的令牌分配给该连接。客户端需要建立新的连接以使用该令牌。
Authenticate() RPC 的实现说明
Authenticate() RPC 根据给定的用户名和密码生成身份认证令牌。etcd 使用 Go 的 bcrypt 包来保存和校验配置的密码与提供的密码。按照设计,bcrypt 的密码校验机制计算开销较大,在普通 x64 服务器上耗时接近 100 毫秒。因此,在状态机应用阶段执行此校验会导致性能问题:整个 etcd 集群每秒仅能处理约 10 Authenticate() 个请求。
为保证良好性能,v3 认证机制在 etcd 的 API 层检查密码,该层可在 Raft 之外并行处理。然而,这可能导致潜在的检查时间与使用时间(TOCTOU)权限漏洞:
- 客户端 A 发送请求
Authenticate() - API 层处理
Authenticate()的密码检查部分 - 另一个客户端 B 发送请求
ChangePassword(),服务器完成该请求 - 状态机层处理从
Authenticate()获取修订版本号的部分 - 服务器向 A 返回成功
- 此时 A 已使用过期的密码完成认证
为避免此类情况,API 层基于认证存储的修订版本执行 版本号验证。在检查密码时,API 层会保存认证存储的修订版本号。密码检查成功后,API 层将保存的修订版本号与最新的修订版本号进行比较。若两者不同,说明其他用户已更新认证元数据,因此会重试检查。通过该机制,可避免基于过时密码的密码检查成功。
解析 API 层中的令牌
在使用 Authenticate() 完成认证后,客户端可像未启用认证时一样建立 gRPC 连接。除原有的初始化流程外,客户端必须将令牌与新创建的连接关联。grpc.WithPerRPCCredentials() 提供了实现此目的的功能。
每个来自客户端的已认证请求均包含一个令牌。该令牌可通过服务器端的 grpc.metadata.FromIncomingContext() 获取。服务器可获取请求的发起者信息以及用户授权时间。相关信息将由 API 层填充至 Raft 日志条目(etcdserverpb.InternalRaftRequest)的头(etcdserverpb.RequestHeader.Username 和 etcdserverpb.RequestHeader.AuthRevision)。
检查状态机中的权限
在状态机的 apply 阶段检查 etcdserverpb.RequestHeader 中的认证信息。此步骤验证用户是否被授予对认证存储最新修订版本下所请求键的访问权限。
两种令牌类型:简单令牌和 JWT
有两种类型的令牌:简单令牌和 JWT 令牌。简单令牌不适用于生产环境。其令牌未经过加密签名,服务器必须有状态地维护令牌与用户之间的对应关系;该类型令牌仅用于开发测试。生产部署应使用 JWT 令牌,因其经过加密签名并可验证。从实现角度看,JWT 是无状态的。其令牌可包含元数据,例如用户名和修订版本,因此服务器无需记忆令牌与元数据之间的对应关系。
存在一个已知问题 #18437 ,与简单令牌相关。在 etcd 服务器中,令牌在 API 层进行解析,而简单令牌是带状态的。该过程未受到线性一致性检查的保护,这意味着某个 etcd 成员可能在完成前一次身份认证请求处理之前就接收到了下一次请求。在此情况下,成员可能会向客户端返回“无效的身份认证令牌”错误。该问题在网络状况良好的节点上通常很少发生,但如果存在显著延迟则可能发生。作为临时解决方案,应用程序应实现重试机制以处理此错误。
直接设置 JWT 令牌
除了标准的 Authenticate() RPC 流程外,etcd 还支持在客户端级别直接设置 JWT 令牌。这使得应用程序能够在 etcd 之外管理 JWT 令牌的完整生命周期,包括令牌生成、验证和轮换。
使用案例与工作流
此方法在以下情况中非常有用:
- 独立的令牌管理系统(位于 etcd 之外)负责 JWT 令牌的生成和生命周期管理
- 应用程序通过外部机制(例如,环境变量、配置服务)接收预先签名的 JWT 令牌
- 令牌生命周期必须完全由客户端应用程序管理,而非由 etcd 的自动令牌生成机制管理
典型的使用流程如下:
- 由外部权威机构(非 etcd)生成包含用户名及其他声明的已签名 JWT 令牌
- 应用程序接收预签名令牌,并使用该令牌配置 etcd 客户端
- 客户端将 JWT 令牌直接随请求发送(无需调用
Authenticate()) - etcd 服务器使用其配置的公钥验证令牌签名,并根据令牌中的用户名授予访问权限
- 在令牌到期前,应用程序从外部权威机构获取新的令牌
- 应用程序使用更新后的令牌创建新的客户端(令牌更新需要重新创建客户端)
与标准身份认证的区别
使用标准 Authenticate() 流程时:
- 客户端调用
Authenticate()并提供用户名和密码 - etcd 生成并返回一个令牌
- 客户端自动在后续请求中使用该令牌
- 令牌刷新需再次调用
Authenticate()
直接设置 JWT 令牌时:
- 客户端使用预签名的 JWT 令牌进行初始化
- 客户端 不 调用
Authenticate() - 令牌在所有请求中直接使用
- 客户端应用程序负责在令牌到期前获取新令牌,并管理客户端生命周期
认证状态无有效令牌
为支持自行管理 JWT 令牌的应用程序,AuthStatus RPC 旨在允许客户端判断身份认证是否启用,并获取当前的 authRevision。在令牌已过期的恢复场景中,客户端需要最新的修订版本,以便从外部令牌提供者获取新的有效令牌。
若缺少此功能,过期的令牌可能导致客户端无法获取当前 authRevision,从而引发死锁,致使无法生成新令牌。
关于 KVS 模型与文件系统模型的差异说明
etcd v3 是一个键值存储(KVS),而非文件系统。因此,权限可授予用户,形式为精确的键名称或键范围,例如 ["start key", "end key")。这意味着可以为不存在的键授予权限,因此应避免意外授权。在类似文件系统的系统(如 Chubby 或 ZooKeeper)中,类似 inode 的数据结构可包含权限信息,因此无法为不存在的键授予权限(粘滞位情况除外)。
etcd v3 模型需要多次查找元数据,这与类似文件系统的设计不同。最坏情况下的查找开销将等于用户所有已授予键和区间总数的总和。该开销无法避免,因为 v3 的扁平键空间与 Unix 文件系统模型(每个 inode 均包含权限元数据)存在本质差异。实际上,该开销通常不会成为严重问题,因为元数据足够小,可以充分受益于缓存。
5 - etcd API
本文旨在概述 v3 版 etcd API 的核心设计。 切勿将本指南与已弃用的 etcd v2 API 混淆,后者已于 etcd v3.5 中弃用。 本文并非全面涵盖所有内容,而是聚焦于理解 etcd 所需的基本概念,避免被较少使用的 API 调用分散注意力。 所有 etcd API 均定义在 [gRPC services][grpc-service] 中,这些服务对 etcd 服务器所理解的远程过程调用(RPC)进行了分类。 所有 etcd RPC 的完整列表已在 [gRPC API listing][grpc-api] 的 Markdown 文档中记录。
gRPC 服务
发送至 etcd 服务器的每个 API 请求均为 gRPC 远程过程调用。etcd 中的 RPC 按功能划分为不同的服务。
与 etcd 键空间相关的关键服务包括:
- KV - 创建、更新、获取和删除键值对。
- Watch - 监听键的变化。
- Lease - 客户端心跳消息的消费原语。 管理集群自身的服务包括:
- Auth - 基于角色的身份认证机制,用于用户身份认证。
- Cluster - 提供成员信息和配置管理功能。
- Maintenance - 执行恢复快照、整理碎片以及返回各成员状态信息。
请求与响应
etcd 中的所有 RPC 均遵循相同的格式。每个 RPC 都有一个函数 Name,它接收 NameRequest 作为参数,并返回 NameResponse 作为响应。例如,以下是 Range RPC 的描述:
响应头
etcd API 的所有响应均附带响应头,其中包含该响应对应的集群元数据:
- Cluster_ID - 生成响应的集群的 ID。
- Member_ID - 生成响应的成员的 ID。
- Revision - 生成响应时键值存储的修订版本。
- Raft_Term - 生成响应时成员的 Raft 任期。
应用程序可读取
Cluster_ID或Member_ID字段,以确保其与预期的集群(成员)进行通信。
应用程序可使用 Revision 字段了解键值存储的最新修订版本。当应用程序指定历史修订版本以执行 time travel query 操作,并希望获知请求时刻的最新修订版本时,此功能尤为有用。
应用程序可以使用 Raft_Term 检测集群完成新的领导者选举。
键值 API
键值对 API 用于操作存储在 etcd 中的键值对。发送至 etcd 的大多数请求通常为键值对请求。
系统原语
键值对
键值对是键值 API 可操作的最小单元。每个键值对包含若干字段,定义于 [protobuf 格式][kv-proto]:
- Key - 以字节表示的键。不允许使用空键。
- Value - 以字节表示的值。
- Version - 键的版本号。删除操作会将版本重置为零,对键的任何修改都会增加其版本号。
- Create_Revision - 键最后一次创建时的修订版本。
- Mod_Revision - 键最后一次修改时的修订版本。
- Lease - 附加到键的租约 ID。若租约为 0,则表示该键未附加任何租约。
除了键和值之外,etcd 还在键消息中附加了额外的修订版本元数据。该修订版本信息按创建和修改时间对键进行排序,有助于管理分布式同步中的并发。etcd 客户端的[分布式共享锁][locks] 使用创建修订版本来等待锁所有权。类似地,修改修订版本用于检测[软件事务内存][STM]读集冲突,并等待[选举][elections]更新。
修订版本
etcd 维护一个 64 位的集群范围计数器,即存储修订版本,每当键空间发生修改时,该计数器就会递增。修订版本充当全局逻辑时钟,对存储系统中的所有更新进行顺序排序。新修订版本所代表的变更具有增量特性;与某一修订版本关联的数据即为导致存储系统发生变化的数据。在内部,新修订版本意味着将变更写入后端数据库的 B+ 树,键为递增后的修订版本。
当结合 etcd 的 [多版本并发控制][mvcc] 后端时,修订版本的价值更加凸显。MVCC 模型意味着,由于历史键版本被保留,键值存储可从过去的修订版本中进行查看。此历史记录的保留策略可由集群管理员配置,以实现细粒度的存储管理;通常情况下,etcd 会通过定时机制丢弃旧的键修订版本。典型的 etcd 集群会保留被覆盖的键数据数小时。这同样能够可靠地处理长时间的客户端断开连接,而不仅仅是瞬时网络中断:监听器只需从最后一次观察到的历史修订版本处恢复即可。类似地,若需在特定时间点读取存储内容,读取请求可标记一个修订版本,以返回该修订版本提交时键空间的视图。
键范围
etcd 的数据模型将所有键索引于一个扁平的二进制键空间中。这与其它键值存储系统不同,后者采用层级结构将键组织为目录。etcd 不通过目录列出键,而是通过键区间列出键 [a, b)。
这些区间在 etcd 中通常被称为“范围”。对范围的操作比对目录的操作更强大。与分层存储类似,范围支持通过 [a, a+1) 进行单个键查找(例如,[‘a’, ‘a\x00’) 查找键 ‘a’),并可通过编码键的目录深度实现目录查找。除上述操作外,范围还可编码前缀;例如,范围 ['a', 'b') 用于查找所有以字符串 ‘a’ 为前缀的键。
按照惯例,请求的范围由字段 key 和 range_end 表示。key 字段为范围的起始键,必须非空。range_end 字段为范围最后一个键之后的键。若 range_end 未指定或为空,则范围仅包含键参数本身。若 range_end 为 key 加一(例如,“aa”+1 == “ab”,“a\xff”+1 == “b”),则范围表示所有以该键为前缀的键。若 key 和 range_end 均为 ‘\0’,则范围表示所有键。若 range_end 为 ‘\0’,则范围表示所有大于或等于键参数的键。
范围
通过 Range API 调用从键值存储中获取键,该调用接受一个 RangeRequest:
- Key, Range_End - 要获取的键范围。
- Limit - 请求返回的最大键数量。当 Limit 设置为 0 时,表示无限制。
- Revision - 用于范围查询的键值存储的时间点。若 Revision 小于或等于 0,则范围覆盖最新的键值存储。若指定的 Revision 已被压缩,返回 ErrCompacted 作为响应。
- Sort_Order - 已排序请求的排序顺序。
- Sort_Target - 用于排序的键值字段。
- Serializable - 将范围请求设置为使用可序列化成员本地读取。默认情况下,Range 为线性一致;其反映集群当前的共识状态。为获得更好的性能和可用性,可接受可能的陈旧读取,可序列化范围请求将本地服务,无需与其他节点达成共识。
- Keys_Only - 仅返回键,不返回值。
- Count_Only - 仅返回范围内键的数量。
- Min_Mod_Revision - 键修改修订版本的下限;过滤掉小于该值的修改修订版本。
- Max_Mod_Revision - 键修改修订版本的上限;过滤掉大于该值的修改修订版本。
- Min_Create_Revision - 键创建修订版本的下限;过滤掉小于该值的创建修订版本。
- Max_Create_Revision - 键创建修订版本的上限;过滤掉大于该值的创建修订版本。
客户端从
Range调用接收到RangeResponse消息:
- Kvs - 范围请求匹配的键值对列表。当
Count_Only设置时,Kvs为空。 - More - 当
limit设置时,表示请求范围内还有更多键待返回。 - Count - 满足范围请求的键的总数。 对于键范围较大且不希望缓冲完整响应的情况,请参见 RangeStream 。
范围流
RangeStream 返回的结果集与 Range 相同,但服务器会将响应拆分为一系列数据块,并流式传输至客户端。这可避免在任一端完全将大范围数据缓冲在内存中。RangeStream 接受与 RangeRequest 相同的 Range。
客户端从 RangeStream 调用接收 RangeStreamResponse 消息流:
跨块的字段填充:
- Kvs - 每个数据块携带结果的不相交片段。按接收顺序拼接每个数据块的
kvs,可得到与单次Range调用相同的结果键集合。 - Header, More, Count - 仅在最后一个数据块中填充,且仅在流无错误完成时。早期数据块中的这些字段保持零值。对每个数据块的
range_response应用proto.Merge,可得到与Range返回结果等价的RangeResponse。 如果流以错误结束,则没有任何数据块携带有效的header、more或count。
流中的每个数据块均基于相同的修订版本提供。若请求未设置 Revision,服务器将在流开始时捕获最新的已提交修订版本,并在流的剩余过程中重复使用该版本。
RangeStream 不支持自定义排序顺序或修订版本过滤(min_mod_revision、max_mod_revision、min_create_revision、max_create_revision)。使用任一功能的请求将返回 Unimplemented。RangeStream 也不被 etcd gRPC 代理支持。
有两种常用方法可用来使用 RangeStream:
- 独立处理每个数据块。 适用于高性能场景,客户端希望在键到达时立即解码并处理,而非先收集全部结果。客户端遍历各个数据块并处理其中的
kvs;流正常结束后,再从最后一个数据块读取header、more或count。 - 合并为单一响应。 适用于客户端希望获得与单次
Range调用等效结果的场景。客户端将每个数据块中的range_response合并为一个RangeResponse(例如使用proto.Merge)。合并后的结果包含完整的kvs,以及来自最后一个数据块的header、more和count。Go 客户端提供clientv3.GetStreamToGetResponse辅助函数来实现此模式。
设置
键通过发出 Put 调用保存到键值存储中,该调用接收一个 PutRequest:
- Key - 要写入键值存储的键名称。
- Value - 以字节为单位的值,与键值存储中的键关联。
- Lease - 与键值存储中键关联的租约 ID。租约值为 0 表示无租约。
- Prev_Kv - 设置后,响应中包含本次
Put请求更新前的键值对数据。 - Ignore_Value - 设置后,更新键而不更改其当前值。若键不存在,返回错误。
- Ignore_Lease - 设置后,更新键而不更改其当前租约。若键不存在,返回错误。
客户端从
Put调用接收到PutResponse消息:
- Prev_Kv - 若在
PutRequest中设置了Prev_Kv,则为Put覆盖的键值对。
删除范围
使用 DeleteRange 调用删除键的范围,该调用接受 DeleteRangeRequest:
- Key, Range_End - 要删除的键范围。
- Prev_Kv - 设置后,返回被删除的键值对内容。
客户端从
DeleteRange调用接收到DeleteRangeResponse消息:
- Deleted - 已删除的键的数量。
- Prev_Kv -
DeleteRange操作所删除的所有键值对的列表。
事务
事务是对键值存储的原子性 If/Then/Else 构造。它提供了一种将请求分组为原子块(即 Then/Else)的原语,其执行受键值存储内容的保护(即 If)。事务可用于防止键被意外的并发更新,构建比较并交换操作,并开发更高级别的并发控制。
事务可在单个请求中原子性地处理多个请求。对于键值存储的修改,这意味着事务的存储修订版本仅递增一次,且事务生成的所有事件将具有相同的修订版本。然而,在单个事务中多次修改同一键是被禁止的。
所有事务均通过一系列比较条件的合取进行保护,类似于一个 If 语句。每个比较条件检查存储系统中的单个键。它可以检查值是否存在或不存在,与指定值进行比较,或检查键的修订版本或版本号。两个不同的比较条件可作用于同一键或不同键。所有比较条件均以原子方式应用;若所有比较条件均为真,则认为事务成功,etcd 将执行事务的 then / success 请求块;否则认为事务失败,并执行 else / failure 请求块。
每个比较操作均以 Compare 消息编码:
- Result - 逻辑比较操作的类型(例如,相等、小于等)。
- Target - 要比较的键值字段。可以是键的版本、创建修订版本、修改修订版本或值。
- Key - 用于比较的键。
- Target_Union - 用户指定的用于比较的数据。
处理完比较块后,事务会应用一个请求块。块是一组
RequestOp消息:
- Request_Range - 一个
RangeRequest。 - Request_Put - 一个
PutRequest。键必须唯一。不得与任何其他 Put 或 Delete 操作共享键。 - Request_Delete_Range - 一个
DeleteRangeRequest。不得与任何 Put 或 Delete 请求共享键。 所有操作合并为一个事务,通过TxnAPI 调用发起,该调用接收一个TxnRequest:
- Compare - 用于保护事务的一组谓词,表示各项条件的合取。
- Success - 所有 Compare 测试结果均为真时要执行的一组请求。
- Failure - 任意一个 Compare 测试结果为假时要执行的一组请求。
客户端从
Txn调用接收到TxnResponse消息:
- Succeeded -
Compare评估结果为 true 或 false。 - Responses - 若 succeeded 为 true,则为应用
Success块所得结果的响应列表;若 succeeded 为 false,则为Failure的响应列表。Responses列表对应于应用RequestOp列表后的结果,每个响应均以ResponseOp编码:
每个内部响应中包含的 ResponseHeader 不应以任何方式解释。
若客户端需要获取最新的修订版本,则应始终检查 TxnResponse 中顶层的 ResponseHeader。
监听 API
本节中的 Watch API 提供基于事件的接口,用于异步监听键的变更。etcd 监听机制通过从指定的修订版本(当前或历史)持续监听键的变化,并将键的更新流式传输回客户端。
事件
每个键的每一次变更均以 Event 消息表示。Event 消息同时提供更新的数据和更新类型:
- Type - 事件类型。PUT 类型表示键已存储新数据。DELETE 类型表示键已被删除。
- KV - 与事件关联的 KeyValue。PUT 事件包含当前的键值对。PUT 事件中 kv.Version=1 表示键的创建。DELETE 事件包含被删除的键,其修改修订版本设置为删除操作的修订版本。
- Prev_KV - 事件发生前紧邻修订版本的键对应的键值对。为节省带宽,仅在监听操作显式启用时才填充。
监听流
监听是长期运行的请求,使用 gRPC 流来传输事件数据。监听流为双向通信;客户端通过向流写入来建立监听,通过读取来接收监听事件。通过为每个监听事件添加唯一的标识符,单个监听流可复用多个不同的监听。这种复用有助于降低核心 etcd 集群的内存占用和连接开销。
有关监听事件的保证说明,请参阅 [etcd api guarantees][watch-api-guarantees]。
客户端通过向 Watch 返回的流发送 WatchCreateRequest 来创建监听:
- Key, Range_End - 要监听的键范围。
- Start_Revision - 可选的修订版本,用于指定监听的起始位置(包含该修订版本)。若未指定,则从监听创建响应头中的修订版本之后的事件开始流式传输。可以从最后一次压缩修订版本开始,监听全部可用的事件历史。
- Progress_Notify - 若启用,当无新事件时,监听器将周期性地收到一个无事件的 WatchResponse。这在客户端希望从最近已知的修订版本恢复断开的监听器时非常有用。etcd 服务器根据当前负载决定通知的发送频率。
- Filters - 服务器端用于过滤的事件类型列表。
- Prev_Kv - 若启用,监听器将接收事件发生前的键值数据。这有助于了解哪些数据已被覆盖。
当收到
WatchCreateRequest或某个已建立的监听存在新事件时,客户端将收到WatchResponse:
- Watch_ID - 与响应对应的监听器 ID。
- Created - 若响应对应创建监听器请求,则设为 true。客户端应存储该 ID,并预期在流中接收该监听器的事件。发送至已创建监听器的所有事件均具有相同的 watch_id。
- Canceled - 若响应对应取消监听器请求,则设为 true。不再向已取消的监听器发送任何事件。
- Compact_Revision - 若监听器尝试在已压缩的修订版本上监听,则设为 etcd 可用的最小历史修订版本。此情况发生在以已压缩的修订版本创建监听器,或监听器无法跟上键值存储的进度时。监听器将被取消;使用相同 start_revision 创建新监听器将失败。
- Events - 与指定监听器 ID 对应的新事件序列列表。
如果客户端希望停止接收某个监听的事件,它会发出
WatchCancelRequest:
- Watch_ID - 用于取消监听的 ID,以停止后续事件的传输。
租约 API
租约是一种用于检测客户端活跃状态的机制。集群会授予带有生存时间(TTL)的租约。如果在指定的 TTL 期间内,etcd 集群未收到客户端的保活请求,该租约将到期。
为将租约与键值存储关联,每个键最多可绑定一个租约。当租约到期或被撤销时,所有绑定到该租约的键将被删除。每个过期的键都会在事件历史中生成一个删除事件。
获取租约
租约通过 LeaseGrant API 调用获取,该调用接收一个 LeaseGrantRequest:
- TTL - 建议的生存时间,单位为秒。
- ID - 租约请求的 ID。若 ID 设置为 0,etcd 将自动选择一个 ID。
客户端从
LeaseGrant调用接收到LeaseGrantResponse:
- ID - 已授予租约的租约 ID。
- TTL - 为服务器选定的生存时间(以秒为单位)的租约。
- ID - 要撤销的租约 ID。撤销租约后,所有关联的键将被删除。
保活
租约通过使用 LeaseKeepAlive API 调用创建的双向流进行刷新。当客户端希望刷新租约时,它会通过该流发送 LeaseKeepAliveRequest:
- ID - 要保活的租约的租约 ID。
保活流将响应
LeaseKeepAliveResponse:
- ID - 已通过新 TTL 刷新的租约。
- TTL - 租约剩余的有效时间,单位为秒。 [watch-api-guarantees]: /zh/docs/etcd/learning/api_guarantees/#watch-apis [elections]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/election.go [grpc-api]: /zh/docs/etcd/dev-guide/api_reference_v3/ [grpc-service]: https://github.com/etcd-io/etcd/blob/main/api/etcdserverpb/rpc.proto [kv-proto]: https://github.com/etcd-io/etcd/blob/main/api/mvccpb/kv.proto [locks]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/mutex.go [mvcc]: https://en.wikipedia.org/wiki/Multiversion_concurrency_control [stm]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/stm.go
6 - etcd 持久化存储文件
本文介绍了 etcd 持久化存储格式:命名规则、内容结构以及可供开发者用于检查存储内容的工具。后续应随着存储模型的变更持续扩展本文内容。本文面向 etcd 开发者,旨在帮助其满足数据恢复需求。
先决条件
以下文章为本文提供了有益的背景信息:
- etcd 数据模型概述
- Raft 概述 (特别是“5.3 日志复制”节)。
概述
长期存在的文件
| 文件名 | 主要用途 |
|---|---|
./member/snap/db | bbolt b+tree 用于存储所有已应用的数据、成员权限信息及元数据。它知晓最新的已应用 WAL 日志索引("consistent_index")。 |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | 定期生成的旧版 v2 存储系统快照,包含:
自 etcd v3 起,其内容与 /snap/db 文件的内容重复。 |
/member/snap/000000000007a178.snap.db | 如果副本严重滞后,则从 etcd 领导者下载完整的bbolt 快照。 其内容类型与 该文件用于以下两种场景:
恢复完成后,该文件不会被删除(其全部内容会填充到 ./member/snap/db 文件中)。这些文件会定期(30s)进行清理。
此处同样只保留 |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Raft 的预写日志,包含 Raft 接受的近期事务、定期快照或 CRC 记录。 保留最近的 如果快照生成频率过低,可能会出现超过 |
./member/wal/0.tmp (or .../1.tmp) | 为下一个预写日志文件预留的空间。 用于避免因 WAL 日志容量不足而导致 Raft 卡住,且无法触发告警的情况。 |
临时文件
在 etcd 内部处理过程中,可能会遇到多个生命周期较短的文件:
| 文件 | 主要用途 |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | 当快照文件无法加载时,会被重命名为“broken”。 etcd 启动时会尝试加载最新文件。 或在执行 etcdctl 的备份/迁移命令期间。 |
./member/snap/tmp071677638 (random suffix) | 该临时 bbolt 文件由副本创建,用于响应领导者的 msgSnap 请求,按要求从指定快照恢复存储。 完整内容成功获取后,文件将被重命名为 参见 etcd/issues/12837。已在 etcd 3.5 中修复。 |
/member/snap/db.tmp.071677638 (random suffix) | 在碎片整理过程中,该临时文件用于保存后端数据库内容(/member/snap/db)的副本。整理成功后,文件会重命名为 /member/snap/db,替换原后端数据库。 在 etcd 服务器启动时,这些文件会被清理。 |
bbolt B+ 树:member/snap/db
该文件包含已应用至 Raft 日志某个特定位置的 etcd 主要内容(参见 consistent_index )。
物理组织结构
Bolt 存储系统在物理上按 B+树 组织。B+树的物理页永远不会原地修改1。相反,内容会被复制到新页(从空闲页列表中回收)中,一旦没有正在运行的事务可能访问该旧页,该旧页即被加入空闲页列表。得益于这一机制,打开的只读(RO)事务可观察到存储系统一致的历史状态。读写(RW)事务具有排他性,会阻塞其他所有读写事务。 大值存储在多个连续页上。页回收过程与需分配不同大小的连续页区域的需求相结合,可能导致 bbolt 存储系统出现日益严重的碎片化。
bbolt 文件不会自行缩小。只有在执行碎片整理过程中,文件才能被重写为一个新的文件,该文件末尾保留了一定数量的空闲页,并且大小已被截断。
逻辑组织
bbolt 存储系统划分为多个桶。每个桶中以字典序存储键(byte[]→value byte[] 键值对)。下表列出了 etcd(截至版本 3.5)所使用的桶及其使用的键。
| 存储桶 | 键 | 示例值 | 描述 |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT} | nil | 表明其中一个成员已诊断出问题。 |
| auth | "authRevision" | ""(空)或 BigEndian.PutUint64 | 角色或用户任何变更都会在事务提交时递增此字段。 该值仅用于授权过程中的乐观锁。 |
| authRoles | [roleName] 为字符串 | authpb.Role 序列化 | |
| authUsers | [userName] 为字符串 | authpb.User 序列化 | |
| cluster | "clusterVersion" | "3.5.0"(字符串) | 次要 版本的共识达成的通用存储版本。 |
| "downgrade" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | 保存最近一次 自 v3.5 版本起 | |
| key | [revisionId] 使用 bytesToRev{main,sub} 编码 删除的键值对在序列化时会以 't' 结尾,表示“墓碑”(Tombstone) | mvccpb.KeyValue 序列化 proto(key, create_rev, mod_rev, version, value, lease id) | |
| lease | leasepb.Lease 序列化后的 proto(ID、TTL、RemainingTTL) | 注意:LeaseCheckpoint 仅扩展 RemainingTTL。TTL 仍来自原始 Grant。 注意 2:我们以秒为单位持久化 TTL(从未定义的“现在”开始计算)。崩溃循环的服务器不会释放租约! | |
| members | 以十六进制字符串形式表示的 [memberId]:"8e9e05c52164694d" | 以字符串形式序列化的 Member 结构:{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | 已达成一致的集群成员关系信息。 |
| members_removed | 以十六进制字符串形式表示的 [memberId]:"8e9e05c52164694d" | []byte("removed") | 所有已移除成员的 ID。用于验证已移除的成员不会以相同 ID 再次添加。 该字段目前(3.4 版本)从 V2 存储系统读取,从不从 V3 读取。详见 https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64 字节(大端序) | 表示最后应用的 WAL 条目在 Bolt DB 存储系统中的偏移量。 |
| scheduledCompactRev | bytesToRev{main,sub} 编码(共 16 字节)。 | 在执行压缩请求后发生崩溃时,用于重新初始化压缩。 | |
| finishedCompactRev | bytesToRev{main,sub} 编码(共 16 字节)。 | 存储系统最近成功完成压缩时的修订版本(https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | 自 etcd 3.5 版本起 | ||
| "term" | 自 etcd 3.5 版本起 | ||
| "storage-version" |
工具
bbolt
bbolt 提供了一个命令行工具,可用于检查文件内容。
使用示例:
列出给定 bbolt 文件中的所有桶:
读取特定键值对:
etcd-dump-db
etcd-dump-db 可用于列出 v3 etcd 后端数据库(bbolt)的内容。
更多示例请参见:https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL:预写日志
预写日志(Write Ahead Log)是 Raft 协议的持久化存储,用于存储提案。首先,领导者将提案写入其日志,然后(并发地)通过 Raft 协议将提案复制到跟随者。每个跟随者在向领导者确认复制之前,会先将其提案持久化到自身的 WAL 中。
etcd 中使用的 WAL 日志与标准 Raft 模型存在两方面的差异:
- 它不仅持久化索引条目,还持久化 Raft 快照(轻量级)和硬状态。因此,仅通过 WAL 日志即可恢复成员的完整 Raft 状态。
- WAL 只支持追加写入。条目不会原地覆盖;后续追加到文件中的同索引条目会取代先前的条目。
文件名
WAL 日志文件的命名遵循以下模式:
示例:./member/wal/0000000000000010-00000000000bf1e6.wal
因此,文件名包含十六进制编码:
- WAL 日志文件的顺序编号
- 文件中第一条条目或快照的索引。 特别地,第一个文件“0000000000000000-0000000000000000.wal”包含索引为 0 的初始快照记录。
物理内容
WAL 日志文件由一系列“帧 ”组成。每个帧包含:
- 使用 LittleEndian 2 编码的 uint64,表示序列化后 walpb.Record 的长度(3)。
- 填充:若干个 0 字节,使整个帧的大小按 8 字节对齐。
- 序列化后的 walpb.Record
数据:
- type - 以整数编码的枚举,用于决定如何解释下述 data 字段
- data - 由类型决定,通常是序列化后的 Protocol Buffers 数据
- crc - 自 WAL 日志创建以来,该副本上所有日志记录中所有“data”字段(不包含 type)的 RC-32 校验和。请注意,CRC 计算包含所有记录(即使它们未被 Raft 提交)。
当当前文件超过 64*10^6 字节时,会将其切分并开始写入新文件。
逻辑内容
预写日志文件在逻辑层包含:
Raftpb.Entry:由 Raft 领导者复制的最近提案。其中部分提案被视为“已提交”,其余提案可能被逻辑覆盖。Raftpb.HardState(term,commit,vote):关于日志条目索引的周期性(非常频繁)信息,该索引表示条目已“提交”(复制到多数服务器),因此保证不会被更改或覆盖,并可应用于后端(v2、v3)。该信息还包含“任期”(指示是否存在与选举相关的变更)以及投票信息——当前副本在当前任期中投给的成员。walpb.Snapshot(term, index):Raft 状态的周期性快照(不包含数据库内容,仅包含快照日志索引和 Raft 任期)- v2 存储内容存储在独立的 *.store 文件中。
- v3 存储内容保存在 bbolt 文件中,一旦条目被应用,该文件即成为隐式快照。
- crc32 校验和记录(位于每个文件开头),用于恢复对文件剩余部分的 CRC 检查。
etcdserverpb.Metadata(node_id, cluster_id)—— 用于标识日志所代表的集群与副本。
每个 WAL 日志文件按以下顺序构建:
CRC-32 帧(从之前所有文件延续的 CRC;第一个文件为 0)。
元数据帧(集群 ID 与副本 ID)。
仅初始 WAL 文件包含:
- 空快照帧(索引:0,任期:0)。 此帧用于维持一个不变量:所有条目之前均有一个快照。
对于非初始(第 2 个及后续)WAL 文件:
- HardState 帧。
条目、硬状态与快照记录的混合
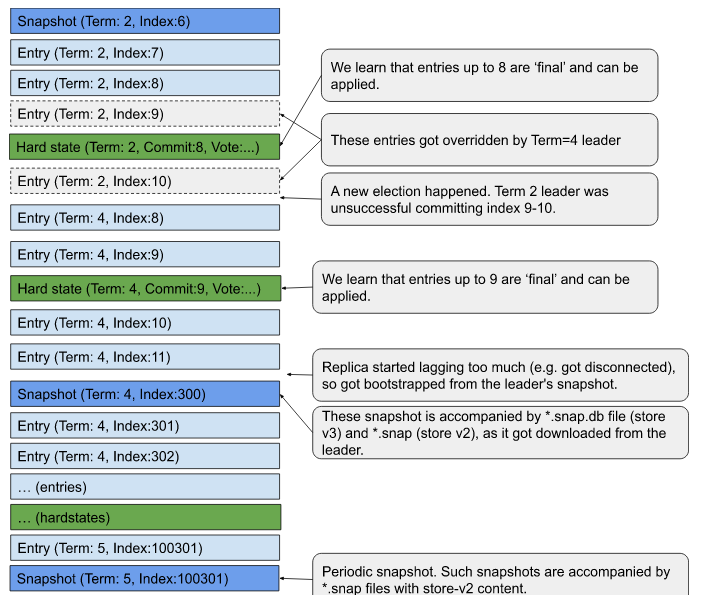
WAL 日志可能包含同一索引的多个条目。这种情况可能出现在 Raft 论文 图 7 所描述的场景中。etcd 的 WAL 日志仅支持追加写入,因此当新条目以相同索引写入时,原有条目会被覆盖。
特别是在读取 WAL 时,逻辑会用新条目覆盖旧条目 。因此,仅当条目索引 entry.index <= HardState.commit 时,才可视为最终版本。索引大于 HardState.commit 的条目可能发生变化。
WAL 日志中的“任期”应保持单调递增。
WAL 日志中的“索引”预期满足以下要求:
- 从某个快照开始
- 在该任期期间,索引应持续递增
- 若任期发生变化,索引可能减少,但必须大于最新的 HardState.commit 值
- 任意索引大于等于 HardState.commit 的新快照都可能发生,从而开启新的索引序列
工具
etcd-dump-logs
etcd 的 WAL 日志可使用 etcd-dump-logs 工具读取:
请注意:
- 该工具仅显示条目,而不显示 WAL 日志文件中的所有记录(如快照、HardState)。
- 该工具会自动应用“覆盖”规则。若某条目被同一索引下更新的条目覆盖,则工具仅输出最终值。
- 该工具还会输出未提交的条目(来自日志尾部),但不包含 HardState.commitIndex 信息,因此无法判断条目是否为最终值。
Store V2 快照:member/snap/{term}-{index}.snap
文件名:
member/snap/{term}-{index}.snap
文件名在 此处
("%016x-%016x.snap") 生成,采用 2 个十六进制编码的组合形式:
term-> 快照生成时的 Raft 任期(两次选举之间的时段)index-> 快照生成时最后一个已应用提案的索引
创建
*.snap 文件由 Snapshotter.SaveSnap 方法创建。
有两个触发器控制这些文件的创建:
- 每处理大约 –snapshotCount=(默认为 100'000)个已应用提案,就会创建一个新文件。这只是近似值:提案可能分批到达,而系统只会在一批处理结束时考虑生成快照,最终的快照过程还会异步调度。 标志名 –snapshotCount 容易产生误解:它控制最后一次快照索引与最后一次已应用提案索引之间的索引差 。
- Raft 请求副本从快照恢复。副本通过网络接收快照(msgSnap 消息)时,也会将其以轻量方式记录到 WAL 日志中。这可确保 WAL 日志尾部始终存在一个后接日志条目的有效快照,从而避免 WAL 日志中可能出现的不连续。
目前,这些文件大致3与 WAL 日志中的 Snapshot 条目一一对应。随着 v2 存储系统停用,预计将彻底停止写入这些文件(3.5.x 可选启用,3.6.x 强制执行)。
内容
该文件包含序列化后的 snapdb.snapshot proto
(uint32 crc, bytes data),
其中 data 字段包含 Raftpb.Snapshot
:
(字节数据,SnapshotMetadata{index, term, conf } 元数据),
最后,嵌套数据包含序列化为 JSON 格式的 存储 v2 内容 。
特别是存在:
- 任期
- 索引
- 成员数据:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- 存储版本:/0/version -> 3.5.0
工具
protoc
以下命令可在 etcd 根目录下执行,用于查看文件内容:
类似地,可以提取 data 字段,并将其解码为 Raftpb.Snapshot
。
etcd 3.4 *.snap 文件中示例 JSON 序列化存储 v2 内容:
变更记录
本节用于描述不同 etcd 版本之间引入的文件格式变更。
7 - etcd API 保证
etcd 是一个一致且持久的键值存储系统。 键值存储通过 gRPC Services 暴露。etcd 为分布式系统提供最强的一致性和持久性保证。 本文规范列出了 etcd 所提供的 API 保证。
值得考虑的 API
KV API 支持对键值存储进行直接读取和操作。 监听 API 支持订阅键值存储的变更。 租约 API 支持为键指定生存时间(TTL)。
KV 和 Watch API 均允许访问键的最新版本,同时也可在连续的历史窗口内访问之前的版本,该窗口受压缩操作的限制。
调用 KV API 会立即生效,而监听 API 可能会返回存在不可预测的延迟。
在正常运行的 etcd 集群中,通常应能在事件发生后 10 ms 内观察到监听事件。
然而,该延迟没有上限,不健康的集群中事件可能永远不会到达。
键值 API
etcd 保证所有 KV API 调用的持久性和严格可串行化。 这是分布式事务数据库系统所能提供的最强隔离保证。
持久性
任何已完成的操作都是持久的。所有可访问的数据也是持久数据。 读操作绝不会返回尚未持久化的数据。
严格的串行一致性
KV 服务操作具有原子性,并按全局顺序执行,该顺序与操作的实际时间顺序一致。全局顺序通过 revision 隐式确定。有关 strict serializability 的更多信息,请参阅相关文档。
对于不包含嵌套事务的事务,操作的执行顺序保证与其操作列表中的顺序一致,这意味着事务内部的 GET 操作响应具有稳定性。 对于包含嵌套事务的事务,执行顺序未作规定。
严格串行化意味着具备其他较弱的保证,这些保证可能更容易理解:
原子性
所有 API 请求均具有原子性;操作要么完全完成,要么完全不执行。对于监听请求,单次操作生成的所有事件将包含在同一个监听响应中。监听不会观察到单次操作的部分事件。
线性一致性
从客户端的角度来看,线性一致性提供了有用的性质,使推理变得简便。这是来自原始论文
的一段清晰描述:线性一致性提供了这样的假象:并发进程执行的每个操作,都在其调用与响应之间某个时刻瞬间生效。
例如,考虑一个客户端在时间点 1(t1)完成写入操作。在 t2(t2 > t1)时刻发起读取的客户端,应获取到至少与 t1 时刻完成的写入操作同等最新的值。然而,该读取操作可能实际仅在 t3 时刻才完成。线性一致性保证读取返回的是最新值。若无线性一致性保证,读取返回的值在读取开始时刻 t2 时是最新值,但在 t3 时刻可能已“过时”,因为 t2 与 t3 之间可能存在并发写入。
etcd 默认对所有其他操作保证线性一致性。
然而,线性一致性会带来开销,因为线性化请求必须经过 Raft 共识流程。为降低读请求的延迟并提高吞吐量,客户端可将请求的一致性模式配置为 serializable,该模式可能访问相对于法定人数过时的数据,但可消除线性化访问依赖实时共识所带来的性能开销。
监听 API
监听保证事件满足以下特性:
- 有序性 - 事件按修订版本排序。 若某个事件在时间上早于已发布的事件,则该事件不会出现在监听中。对于不含嵌套事务的事务,生成的事件顺序与操作列表中的顺序一致。对于包含嵌套事务的事务,生成事件的顺序未作规定。
- 唯一性 - 事件不会在监听中重复出现。
- 可靠性 - 事件序列不会丢失可用历史窗口内的任何子序列。若事件按时间顺序为 a < b < c,且监听收到了事件 a 和 c,则只要 b 仍在可用历史窗口内,就保证会收到事件 b。
- 原子性 - 事件列表保证涵盖完整的修订版本。同一修订版本中对多个键的更新不会被拆分到多个事件列表中。
- 可恢复性 - 若监听中断,可通过建立新的监听来恢复,新监听从中断前最后一个事件的修订版本之后开始,只要该修订版本仍在历史窗口内。
- 可标记性 - 进度通知事件保证所有至指定修订版本的事件均已送达。
etcd 不保证监听操作的线性一致性。应验证监听事件的修订版本,以确保其与其他操作的顺序正确。
租约 API
etcd 提供 租约机制 。租约的主要用途是实现分布式协调机制,例如分布式锁。租约机制本身较为简单:可通过 grant API 创建租约,通过 put API 将其绑定到键,通过 revoke API 撤销租约,并在生存时间(TTL)到期后由墙钟时间自动过期。然而,用户需注意 API 和使用方式的重要特性 ,以正确实现分布式协调机制。
etcd 特定定义
操作完成
etcd 操作在通过共识达成一致并由 etcd 存储引擎“执行”(即永久存储)后,被视为已完成。客户端在收到 etcd 服务器的响应时,即可确认操作已完成。请注意,若客户端超时,或客户端与 etcd 成员之间发生网络中断,客户端可能无法确定操作的状态。在发生领导者选举时,etcd 也可能中止操作。在此情况下,etcd 不会向客户端的未完成请求发送 abort 响应。
修订版本
对 etcd 键值存储执行修改操作时,将分配一个单一且递增的修订版本。事务操作可能多次修改键值存储,但仅分配一个修订版本。由该操作修改的键值对的修订版本属性,与操作的修订版本值相同。修订版本可作为键值存储的逻辑时钟。修订版本较大的键值对,其修改时间晚于修订版本较小的键值对。具有相同修订版本的两个键值对,是由一个操作“并发”修改的。
8 - etcd 与其它键值存储系统比较
etcd 这个名称源自两个理念:Unix 系统中的“/etc”目录和“d”istributed(分布式)系统。其中,“/etc”目录是用于存储单个系统配置数据的路径,而 etcd 则用于存储大规模分布式系统的配置信息。因此,“d”istributed “/etc”即为 etcd。
etcd 旨在作为大规模分布式系统的通用基础架构。这类系统无法容忍脑裂(split-brain)运行,且愿意牺牲可用性以达成此目标。etcd 以一致且容错的方式存储元数据。etcd 集群旨在提供具备顶级稳定性、可靠性、可扩展性和性能的键值存储。
分布式系统使用 etcd 作为一致性的键值存储,用于配置管理、服务发现以及协调分布式任务。许多 组织 使用 etcd 实现生产系统,例如容器调度器、服务发现服务和分布式数据存储。使用 etcd 的常见分布式模式包括 领导者选举 、分布式锁 ,以及监控机器存活状态。
使用场景
- Container Linux by CoreOS:在 Container Linux 上运行的应用程序可获得自动、零停机的 Linux 内核更新。Container Linux 使用 locksmith 协调更新过程。Locksmith 通过 etcd 实现分布式信号量,确保集群中任意时刻仅有一部分节点处于重启状态。
- Kubernetes 将配置数据存储于 etcd,以实现服务发现与集群管理;etcd 的一致性对服务的正确调度与运行至关重要。Kubernetes API 服务器将集群状态持久化至 etcd。它使用 etcd 的监听(watch)API 监控集群,并推送关键配置变更。
对比图表
也许 etcd 已经看起来非常合适,但如同所有技术决策一样,仍需谨慎行事。请注意,本文由 etcd 团队编写。尽管理想情况是客观比较技术与功能,但作者的专业知识和倾向显然偏向 etcd。请仅按说明使用。
下表为快速对比 etcd 与其最流行替代方案差异的便捷参考。各列的进一步说明与详细信息请参见表格后的章节。
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| 并发原语 | 锁 RPC , 选举 RPC , 命令行锁 , 命令行选举 , Go 中的通用模式 | 外部 Curator 模式 (Java) | 原生锁 API | 罕见 ,若有也极少 |
| 线性一致读取 | 是 | 否 | 是 | 有时 |
| 多版本并发控制 | 是 | 否 | 否 | 有时 |
| 事务 | 字段比较、读取、写入 | 版本检查、写入 | 字段比较、锁、读取、写入 | SQL 风格 |
| 变更通知 | 历史与当前键区间 | 当前键与目录 | 当前键与前缀 | 触发器(有时) |
| 用户权限 | 基于角色 | ACL | ACL | 不同(按表 GRANT ,按数据库 角色 ) |
| HTTP/JSON API | 是 | 否 | 是 | 很少 |
| 成员变更重配置 | 是 | 3.5.0 及以上 | 是 | 是 |
| 最大可靠数据库容量 | 数 GB | 数百 MB(有时可达数 GB) | 数百 MB | 数 TB 以上 |
| 最小读取线性化延迟 | 网络 RTT | 无读取线性化 | RTT + fsync | 时钟屏障(原子时钟、NTP) |
Apache ZooKeeper
ZooKeeper 解决的问题与 etcd 相同:分布式系统协调与元数据存储。然而,etcd 拥有从 ZooKeeper 设计与实现的工程和运维经验中汲取的后见之明。从 ZooKeeper 中汲取的教训确实影响了 etcd 的设计,使其能够支持 Kubernetes 等大规模系统。etcd 相较于 ZooKeeper 的改进包括:
- 动态集群成员关系配置
- 高负载下的稳定读写
- 多版本并发控制数据模型
- 可靠的键监控,永不静默丢失事件
- 租约原语将连接与会话解耦
- 用于安全分布式共享锁的 API
此外,etcd 原生支持多种语言和框架。与 Zookeeper 采用其专属的自定义 Jute RPC 协议不同,该协议完全专属于 Zookeeper 并限制了 支持的语言绑定
,etcd 的客户端协议基于 gRPC
,一个广受欢迎的 RPC 框架,提供 Go、C++、Java 等多种语言绑定。同样,gRPC 可通过 HTTP 序列化为 JSON,因此即使是一般的命令行工具如 curl 也能与其通信。由于系统可自由选择多种技术方案,它们通常基于 etcd 的原生工具链构建,而非围绕 etcd 采用单一固定的技栈。
在考虑功能、支持和稳定性时,计划使用 Zookeeper 作为一致键值存储的新应用程序应选择 etcd。
Consul
Consul 是一个端到端的服务发现框架。它提供内置的健康检查、故障检测和 DNS 服务。此外,Consul 还通过 RESTful HTTP API 暴露了一个键值存储系统。截至 Consul 1.0 版本 ,其存储系统在键值操作上的扩展性不如 etcd 或 Zookeeper 等系统;对于需要管理数百万个键的系统,将面临高延迟和内存压力。键值 API 缺少关键功能,尤其是多版本键、条件事务以及可靠的流式监听。
etcd 与 Consul 解决不同的问题。若需要分布式一致的键值存储,etcd 比 Consul 更为合适。若需要端到端的集群服务发现,etcd 功能不足;应选择 Kubernetes、Consul 或 SmartStack。
NewSQL (Cloud Spanner, CockroachDB, TiDB)
etcd 与 NewSQL 数据库(例如 Cockroach 、TiDB 、Google Spanner )均提供强数据一致性保证,并具备高可用性。然而,显著不同的系统设计参数导致其客户端 API 和性能特征存在显著差异。
NewSQL 数据库旨在跨数据中心水平扩展。这类系统通常将数据分区到多个一致的复制组(分片)中,这些分片可能分布于不同地理位置,存储的数据集规模可达数 TB 及以上。此类扩展方式导致其在分布式协调方面表现不佳,因为其依赖时钟等待,且更新操作的依赖图通常具有高度局部性。数据以表格形式组织,支持类似 SQL 的查询功能,语义比 etcd 更丰富,但相应地增加了查询处理、规划和优化的复杂性。
简而言之,选择 etcd 用于存储元数据或协调分布式应用。若需存储超过几 GB 的数据,或需要完整的 SQL 查询功能,则应选择 NewSQL 数据库。
使用 etcd 存储元数据
etcd 在单一一致的复制组内复制所有数据。对于存储几 GB 以内、需保持一致顺序的数据,这是最高效的方法。集群状态的每次修改(可能涉及多个键)都会被分配一个全局唯一标识,即 etcd 中的修订版本,该标识来自单调递增的计数器,用于推理操作顺序。由于仅存在一个复制组,修改请求只需通过 Raft 协议即可提交。通过将共识限制在单一复制组内,etcd 在采用简单协议的同时实现了分布式一致性,并达到了低延迟和高吞吐量。
etcd 的复制机制无法横向扩展,原因在于其缺乏数据分片。相比之下,NewSQL 数据库通常将数据分片存储于多个一致的复制组中,可存储规模达数 TB 及以上的数据集。然而,为确保每次修改都具有全局唯一且递增的 ID,每个请求必须在复制组之间通过额外的协调协议进行处理。这一额外的协调步骤可能导致全局 ID 冲突,迫使有序请求进行重试。最终结果是,该方案实现方式更为复杂,且在严格有序场景下的性能通常劣于 etcd。
如果应用程序主要关注元数据或元数据的顺序,例如用于协调进程,应选择 etcd。如果应用程序需要一个跨多个数据中心的大型数据存储系统,且对强全局顺序性要求不高,应选择 NewSQL 数据库。
使用 etcd 进行分布式协调
etcd 内置了分布式协调原语,包括事件监听、租约、选举以及分布式共享锁(请注意,使用分布式共享锁时,用户需了解其非显而易见的特性,详情见下文)。这些原语均由 etcd 开发者维护和支持;若将这些原语交由外部库实现,则等于推卸了开发基础分布式软件的责任,本质上使系统变得不完整。NewSQL 数据库通常期望这些分布式协调原语由第三方提供。类似地,ZooKeeper 以其独立的 协调算法库 著称。Consul 提供原生锁 API,甚至坦言其“并非牢靠的方法 ”。
理论上,可以在任何提供强一致性的存储系统之上构建这些原语。然而,相关算法往往十分微妙;很容易设计出看似可行的锁机制,却因惊群效应和时序偏差而突然失效。此外,etcd 支持的其他原语(如事务内存)依赖于 etcd 的 MVCC 数据模型;仅具备简单的强一致性是不够的。
在分布式协调场景中,选择 etcd 可以避免运维困扰并节省工程投入。
关于锁和租约的使用说明
etcd 提供 lock APIs ,其基于 租约机制 以及 etcd 中的实现 。租约机制的基本思想是:服务器向请求客户端授予一个令牌,称为租约。当服务器授予租约时,会为其关联一个 TTL。当服务器检测到时间流逝超过 TTL 时,将撤销该租约。只要客户端持有未被撤销的租约,即可声称其拥有与该租约关联的资源的访问权。在 etcd 中,该资源是 etcd 键空间中的一个键。etcd 通过此机制提供锁 API。然而,锁 API 本身不能作为互斥机制使用。API 被称为锁,是由于 历史原因 。不过,如以下所述,锁 API 可作为互斥机制的优化手段使用。
租约机制最重要的方面是,TTL 被定义为物理时间间隔。服务器和客户端均使用各自的时钟来衡量时间的流逝。这可能导致一种情况:服务器已撤销租约,但客户端仍声称自己拥有该租约。
租约机制如何保证锁机制的互斥性?实际上,租约机制本身并不能保证互斥性。拥有租约并不能保证租约持有者持有该资源的锁。
在使用 etcd 锁控制对 etcd 自身键的互斥访问时,互斥性基于版本号验证机制实现(在其他系统如 Consul 中有时称为比较并交换)。在 etcd 的 RPC 接口中,例如 Put 或 Txn,可指定操作所需的修订版本号和租约 ID 条件。若条件不满足,操作可能失败。借助此机制,etcd 为客户端提供分布式锁功能。这意味着,当客户端请求被 etcd 集群成功处理时,客户端可确认其已获取到某键的锁。
在分布式锁的文献中,类似的架构设计被描述如下:
- 在 Chubby 论文中,引入了 sequencer 的概念。我们理解该 sequencer 与 etcd 中的修订版本号和租约 ID 的组合几乎相同。
- 在 如何实现分布式锁 中,Martin Kleppmann 提出了 fencing token 的概念。作者认为,在 etcd 场景下,fencing token 即为修订版本号。
- 在 分布式系统中同步时钟的实际应用 中,可以找到描述:Thor 基于版本号验证和租约实现了一种分布式锁机制。
为何 etcd 及其他系统在基于版本号验证实现互斥的同时仍提供租约机制?这是因为租约可作为优化机制,有效减少被中止请求的数量。
请注意,etcd 键的锁定可高效实现,这是由于租约机制和版本号验证机制的共同作用。若用户需要保护与 etcd 无关的资源,则这些资源必须提供类似 etcd 键的版本号验证机制以及副本一致性保障。etcd 自身的锁功能无法用于保护外部资源。
9 - 术语表
本文定义了 etcd 文档、命令行和源代码中使用的各种术语。
告警
当集群需要操作员干预以保持可靠性时,etcd 服务器会触发告警。
身份认证
身份认证用于管理用户对 etcd 资源的访问权限。
客户端
客户端连接到 etcd 集群,以发出服务请求,例如获取键值对、写入数据或监听更新。
集群
集群由多个成员组成。
每个成员中的节点遵循 Raft 共识协议来复制日志。集群从成员接收提案,进行提交,并应用到本地存储。
压缩
压缩会丢弃指定修订版本之前的所有 etcd 事件历史记录和已被覆盖的键。该操作用于回收 etcd 后端数据库中的存储空间。
选举
etcd 集群通过 Raft 共识协议在成员之间进行选举,以选出领导者。
端点
指向 etcd 服务或资源的 URL。
键
用户定义的标识符,用于在 etcd 中存储和检索用户定义的值。
键范围
一组键,包含单个键、满足 a < x <= b 的字典序区间,或大于给定键的所有键。
键空间
etcd 集群中所有键的集合。
租约
一种短期有效的可续期合同,到期时会删除与其关联的键。
成员
一个参与提供 etcd 集群服务的逻辑 etcd 服务器。
修改修订版本
持有指定键最后一次写入操作的首个修订版本。
对等成员
对等成员是同一集群中的另一成员。
提案
提案是需要通过 Raft 协议处理的请求(例如写入请求、配置变更请求)。
法定人数
达成法定人数以修改集群状态所需的活跃成员数量。etcd 要求成员多数才能达成法定人数。
修订版本
一个从 1 开始、每次键空间被修改时递增的 64 位集群范围计数器。
角色
一组针对键范围的权限单元,可授予一组用户以实现访问控制。
快照
etcd 集群状态的某一时间点备份。
存储系统
支撑集群键空间的物理存储。
任期
任期是 Raft 算法中与每次领导者选举相关联的单调递增整数。 每个任期只能选举出一个领导者,且在领导者变更时,任期值将递增。
事务
一个原子执行的操作集合。事务中所有被修改的键共享相同的修改修订版本。
键版本
自键创建以来的写入次数,从 1 开始计数。不存在或已删除的键的版本号为 0。
监听器
客户端打开监听器以观察指定键范围的更新。