这是本节的多页打印视图。 .
etcd 3.7 中文文档
- 1: 任务
- 1.1: 运维任务
- 1.1.1: 如何搭建演示集群
- 1.1.2: 如何在 etcd 集群中进行领导者选举
- 1.1.3: 如何检查集群状态
- 1.1.4: 如何保存数据库
- 1.1.5: 如何添加和删除成员
- 1.2: 开发任务
- 1.2.1: 从 etcd 中读取
- 1.2.2: 向 etcd 写入
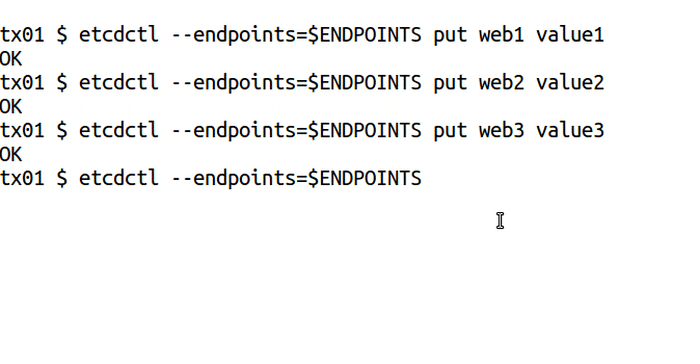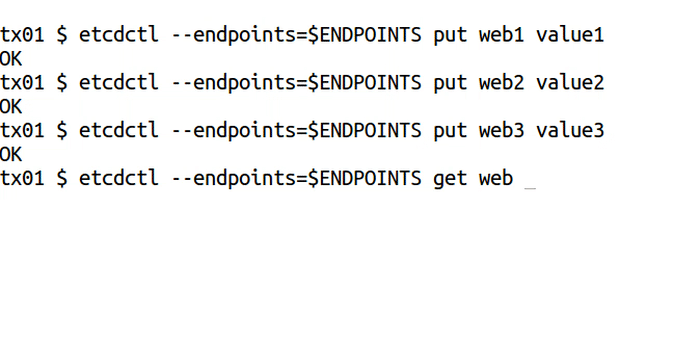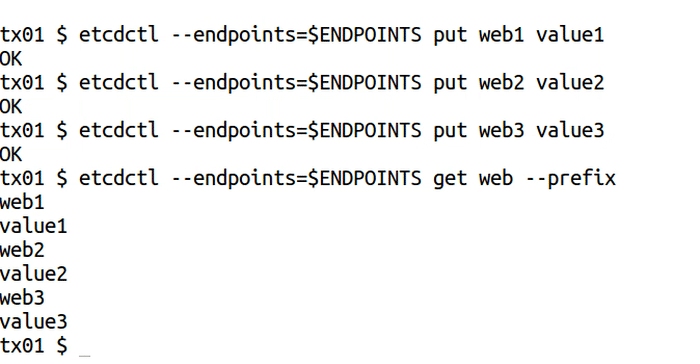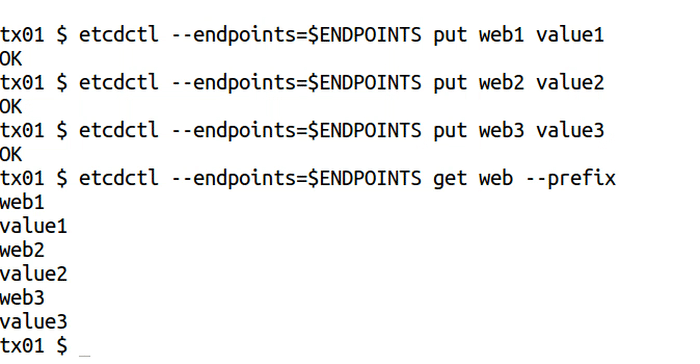
- 1.2.3: 如何根据前缀获取键
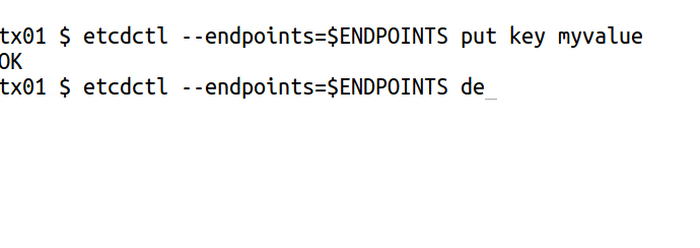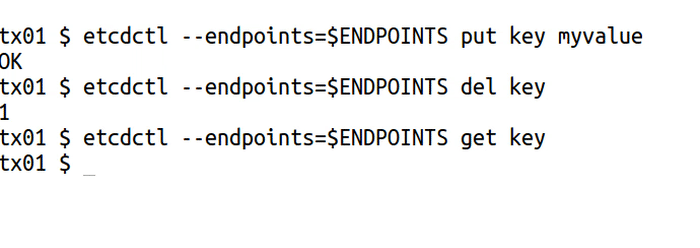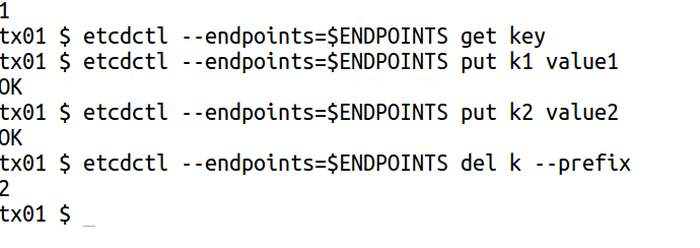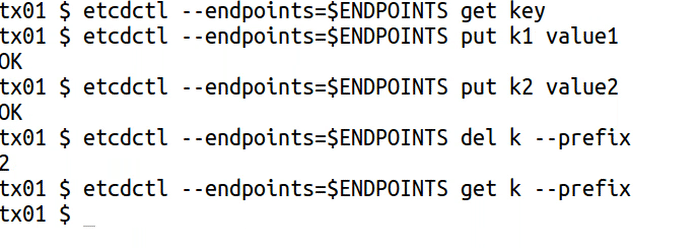
- 1.2.4: 如何删除键
- 1.2.5: 如何在事务中进行多次写操作
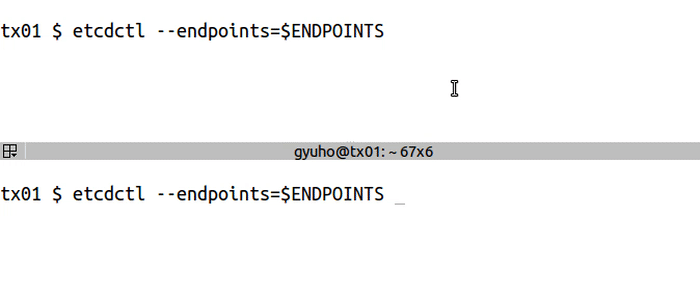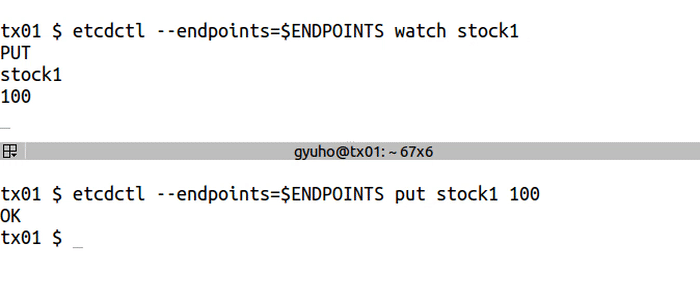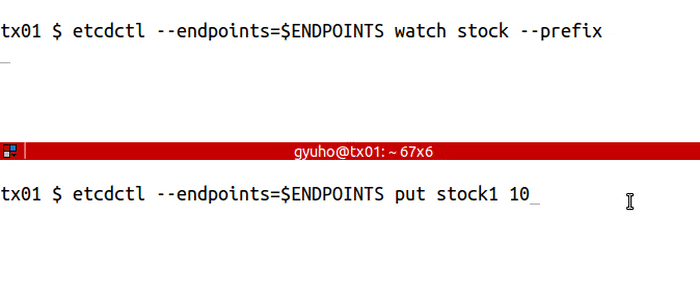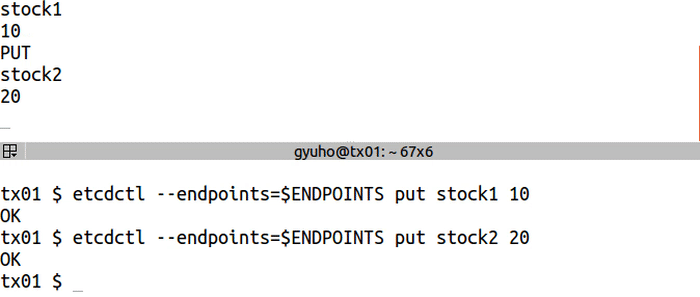
- 1.2.6: 如何监听键值变化
- 1.2.7: 如何创建租约
- 1.2.8: 如何创建锁
- 1.1: 运维任务
- 2: 快速入门
- 3: 示例
- 4: 安装
- 5: 功能门控
- 6: 常见问题
- 7: 库和工具
- 8: 指标
- 9: 报告缺陷
- 10: 调优
- 11: 内部架构
- 12: 学习
- 12.1: 数据模型
- 12.2: etcd 客户端设计
- 12.3: etcd 学习者成员设计
- 12.4: etcd v3 身份认证设计
- 12.5: etcd API
- 12.6: etcd 持久化存储文件
- 12.7: etcd API 保证
- 12.8: etcd 与其它键值存储系统比较
- 12.9: 术语表
- 13: 开发指南
- 13.1: 发现服务协议
- 13.2: 配置本地集群
- 13.3: 与 etcd 交互
- 13.4: 为什么使用 gRPC 网关
- 13.5: gRPC 命名与发现
- 13.6: 将 etcd 集成到 Go 应用中
- 13.7: 系统限制
- 13.8: etcd 功能
- 13.9: API 参考
- 13.10: API 参考:并发
- 14: 操作指南
- 15: 基准测试
- 15.1: 存储内存使用量基准测试
- 15.2: 监听内存使用量基准测试
- 15.3: etcd v3 基准测试
- 15.4: etcd v2.2.0-rc 内存基准测试
- 15.5: etcd v2.2.0-rc 基准测试
- 15.6: etcd v2.2.0 基准测试
- 15.7: etcd v2.1.0 基准测试
- 16: 降级
- 16.1: 降级 etcd 集群与应用程序
- 16.2: 将 etcd 从 v3.7 降级到 v3.6
- 16.3: 将 etcd 从 3.5 降级到 3.4
- 16.4: 将 etcd 从 v3.6 降级到 v3.5
- 17: 升级
- 17.1: 升级 etcd 集群与应用程序
- 17.2: 将 etcd 从 v3.5 升级到 v3.6
- 17.3: 将 etcd 从 3.4 升级到 3.5
- 17.4: 将 etcd 从 3.3 升级到 3.4
- 17.5: 将 etcd 从 v3.6 升级到 v3.7
- 17.6: 将 etcd 从 3.2 升级到 3.3
- 17.7: 将 etcd 从 3.1 升级到 3.2
- 17.8: 将 etcd 从 3.0 升级到 3.1
- 17.9: 将 etcd 从 2.3 升级到 3.0
- 18: 分类处置
- 18.1: Issue 分类处置指南
- 18.2: PR 管理
1 - 任务
1.1 - 运维任务
1.1.1 - 如何搭建演示集群
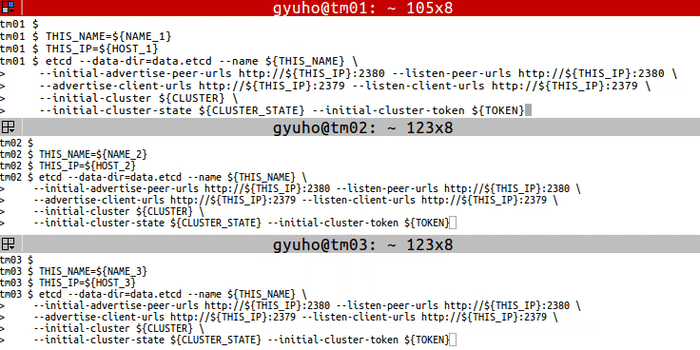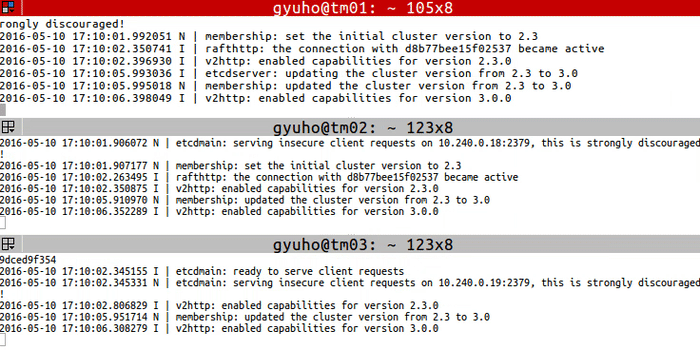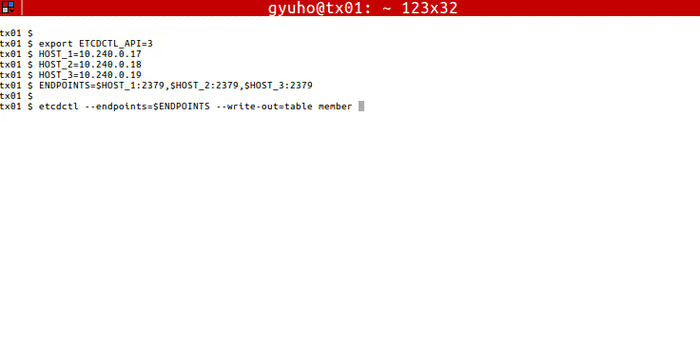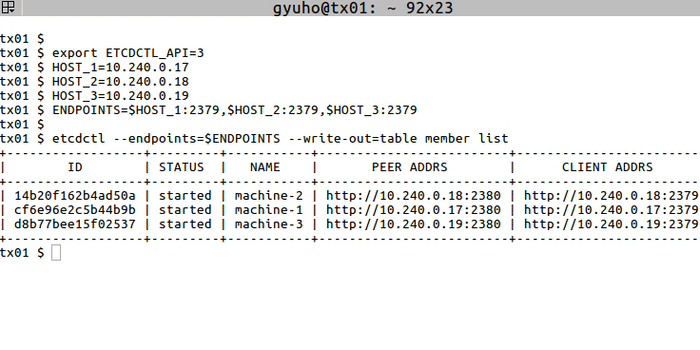
在每个 etcd 节点上,指定集群成员:
在每台机器上运行以下命令:
或使用我们的公开发现服务:
现在 etcd 已准备就绪!使用 etcdctl 连接 etcd:
1.1.2 - 如何在 etcd 集群中进行领导者选举
先决条件
进行领导者选举
etcdctl 命令用于在 etcd 集群中执行选举操作。该命令确保同一时间仅有一个客户端可成为领导者。
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
选项
--endpoints : $ENDPOINTS
每个 etcd 集群成员的地址。
election-name字符串
用于选举的字符串标识符。所有竞争领导权的参与者必须使用相同的选举名称。
leader-name字符串
新领导者的提案值。
示例
1.1.3 - 如何检查集群状态
先决条件
检查整体状态
使用 endpoint status 检查 --endpoints 标志中指定的每个端点的总体状态:
选项
检查健康状况
使用 endpoint health 检查 --endpoints 标志中指定的每个端点的健康状态:
选项
检查键值哈希
使用 endpoint hashkv 检查 --endpoints 标志中指定的每个端点的 KV 历史哈希值:
选项
继承自父命令的选项
示例
1.1.4 - 如何保存数据库
先决条件
快照数据库
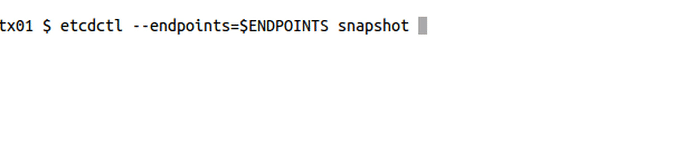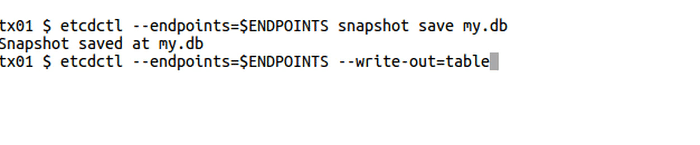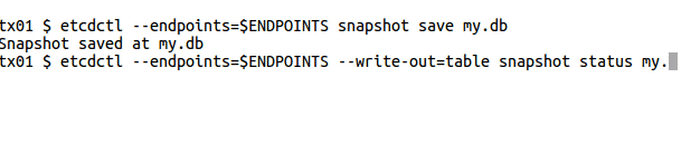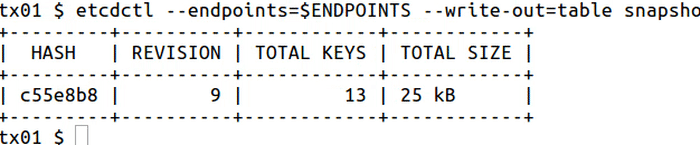
snapshot 用于保存 etcd 数据库的指定时间点快照:
全局选项
etcdctl
快照只能从一个 etcd 节点请求,因此 --endpoints 标志中应仅包含一个端点。
etcd 工具
示例
1.1.5 - 如何添加和删除成员
member 用于添加、删除或更新成员关系:
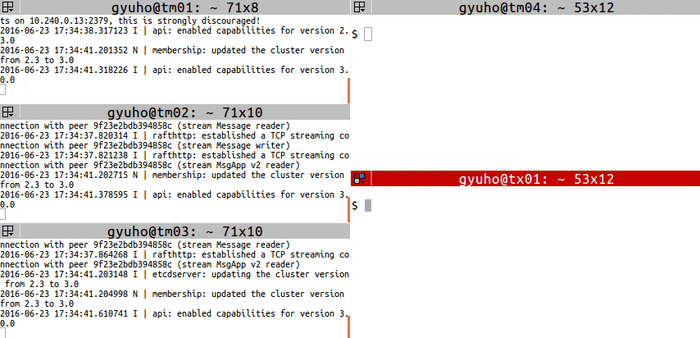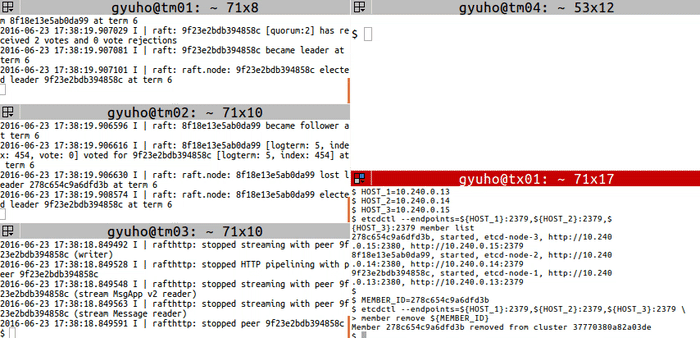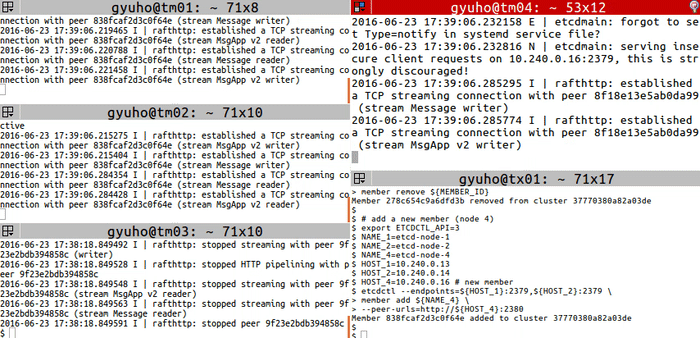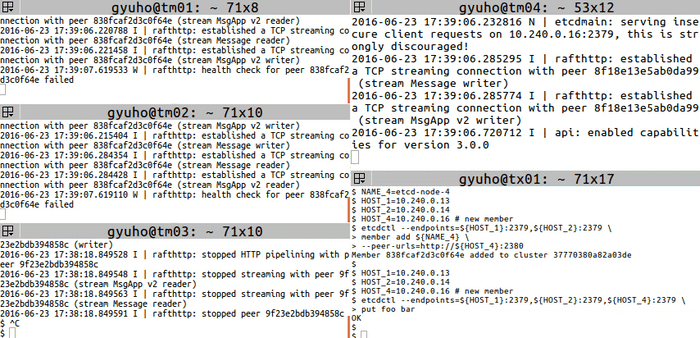
然后使用 member remove 和 member add 命令替换成员:
接下来,使用 --initial-cluster-state existing 标志启动新成员:
1.2 - 开发任务
1.2.1 - 从 etcd 中读取
先决条件
- 安装
etcdctl
步骤
使用 get 子命令从 etcd 读取:
其中:
foo为请求的键Hello World!为获取的值
或者,以格式化输出形式:
其中 write-out="json" 会导致值以 JSON 格式输出(注意:键不会被返回)。
1.2.2 - 向 etcd 写入
先决条件
- 安装
etcdctl
步骤
使用 put 子命令写入键值对:
其中:
foo为键名称"Hello World!"为用引号括起的值
1.2.5 - 如何在事务中进行多次写操作
先决条件
- 安装
etcd和etcdctl。 - 运行中的
etcd集群。
术语
以下是本文中使用的部分关键术语的定义,这些术语将在 Example 示例中出现。
| 术语 | 定义 |
|---|---|
| etcdctl | 用于与 etcd 服务器交互的命令行工具。 |
txn
命令 | txn 命令是“事务”的缩写。它从标准输入读取多个 etcd 请求,并将其作为单个原子事务执行。事务包含一组条件、一组在所有条件均为真时执行的请求,以及一组在任一条件为假时执行的请求。有关更多信息,请参阅 etcdctl 键值命令
。 |
compare | 事务(txn)中的 compare 子句用作条件检查,用于判断事务操作是否应继续执行。它确保仅当键值存储的当前状态符合预期条件时才应用变更,从而维护数据一致性,并在并发环境中防止冲突。要了解该命令的结构,请参阅下方 执行事务
章节。 |
事务
txn 以事务方式处理所有请求:
事务允许在 etcd 中原子性地执行多个操作,确保所有操作均被应用或全部不被应用。这在执行相关更新时对于维护数据一致性至关重要。有关事务的更多信息,请参见 API 文档 。
示例
考虑一种场景:需要在单个事务中更新用户的电子邮件和电话号码。这可确保两项更新同时生效。
0. 使用的变量和标志
| 变量 |
|---|
/users/{<user_id>/email : 表示用户电子邮件地址的 etcd 键。 |
/users/<user_id>/phone : 表示用户电话号码的 etcd 键。 |
| 标志 |
--interactive
: 用于允许手动输入事务数据的标志。 |
1. 初始化数据设置
首先,创建一个带有初始数据的用户。
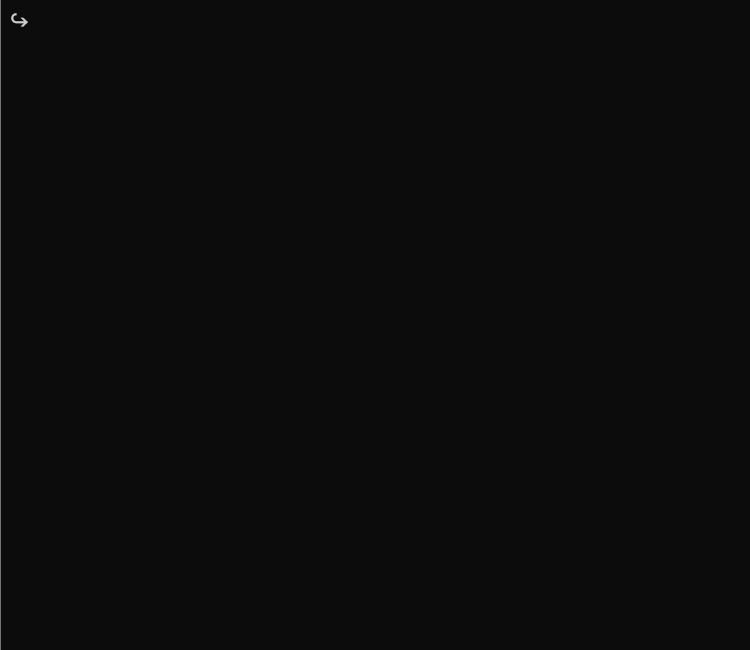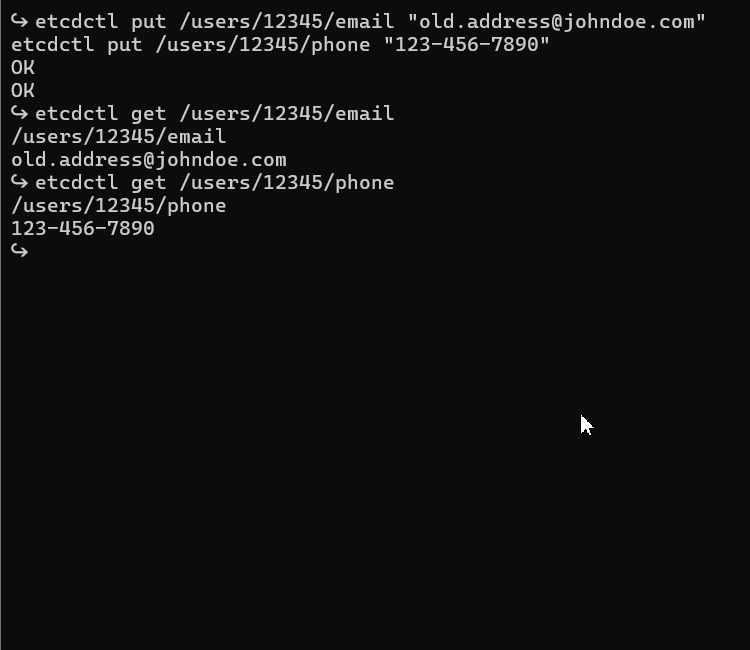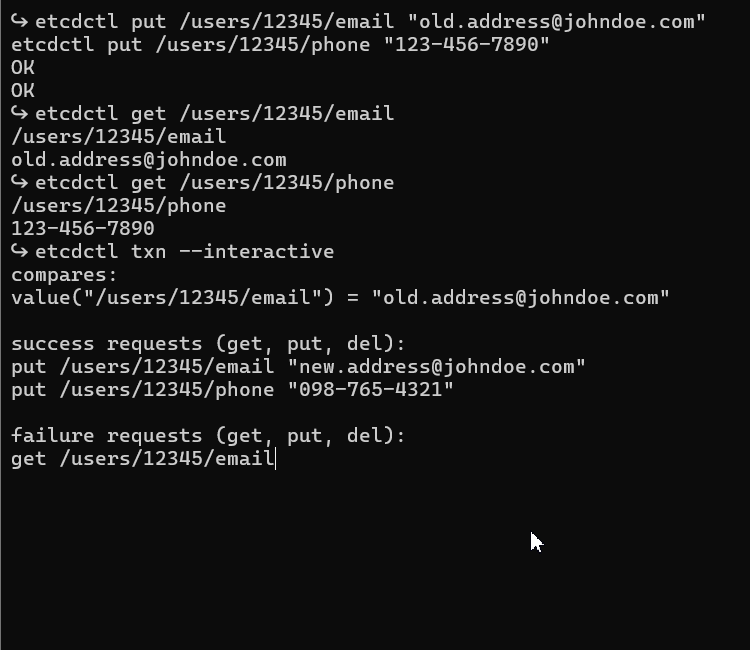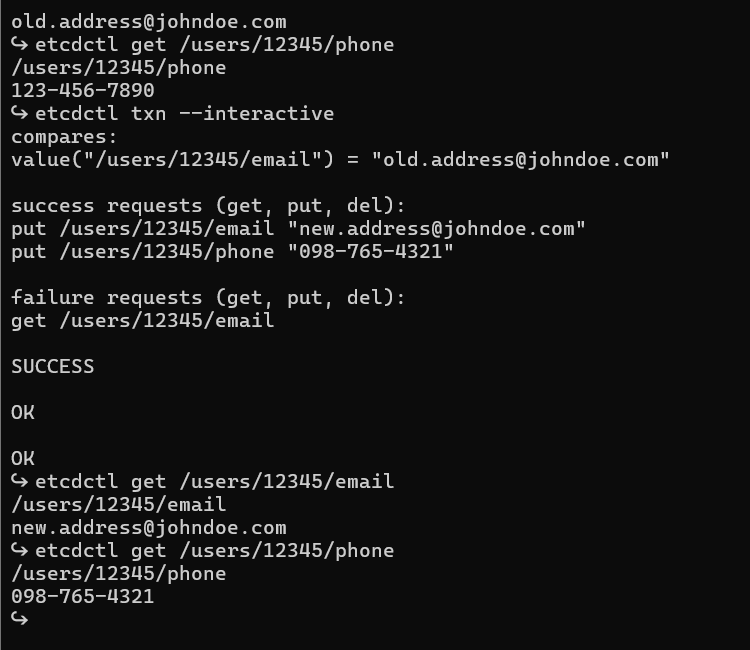
2. 执行事务
在单个事务中更新用户的电子邮件和电话号码。
- Compare:检查当前邮箱是否为 “old.address@johndoe.com "。这确保事务仅在数据符合预期时才继续执行。
- Success:如果比较结果为真,更新邮箱和电话号码。
- Failure:如果比较失败,获取当前邮箱以了解事务未执行的原因。
重要考虑事项
- 原子性:事务确保电子邮件和电话号码同时更新。如果初始条件(比较)不满足,则不会应用任何更新。
- 一致性:使用事务可维持数据一致性,尤其是在处理多个相关更新时。
- 避免在单个事务中对同一键多次写入:在单个事务中不要对同一键写入多个值,这可能导致意外结果。每个键在事务中应仅更新一次。
1.2.7 - 如何创建租约
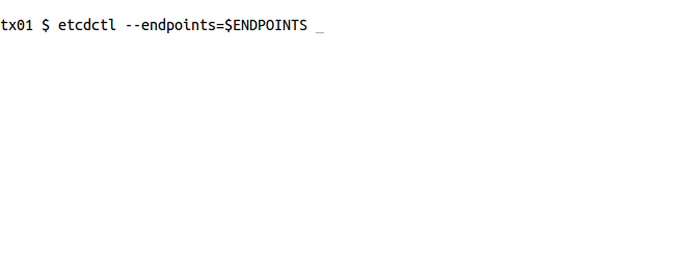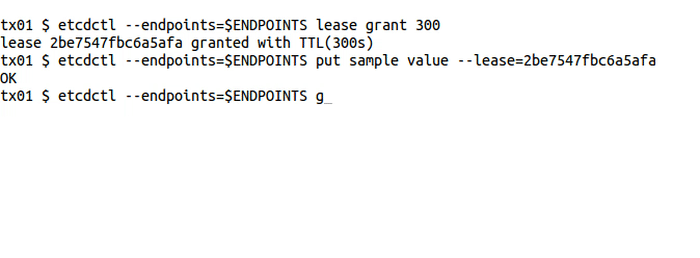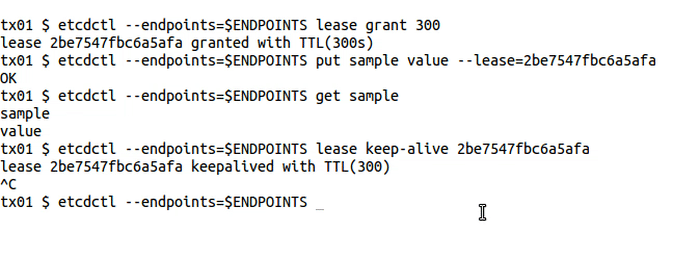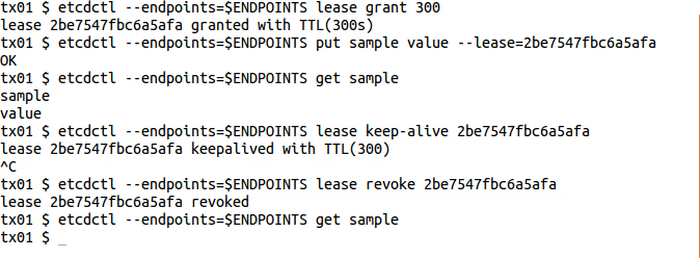
lease 以 TTL 写入:
1.2.8 - 如何创建锁
LOCK 使用指定名称获取一个分布式互斥锁。锁获取成功后,将一直持有,直至 etcdctl 终止。
先决条件
创建锁
lock 用于分布式锁:
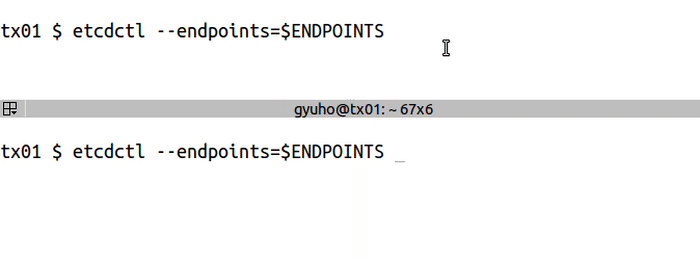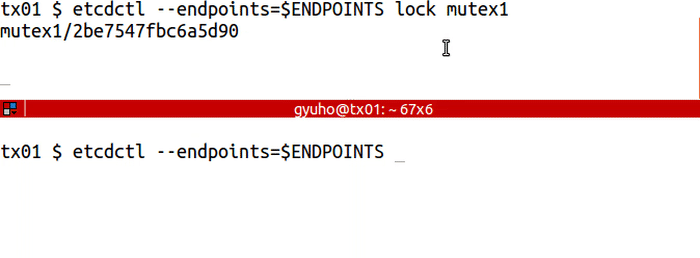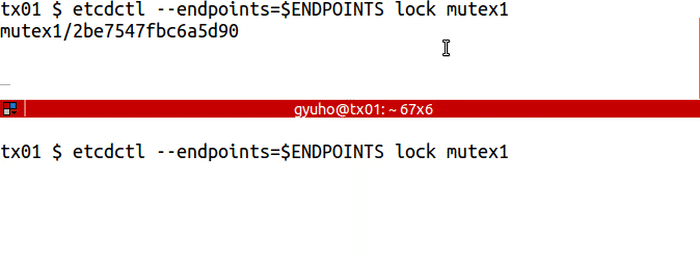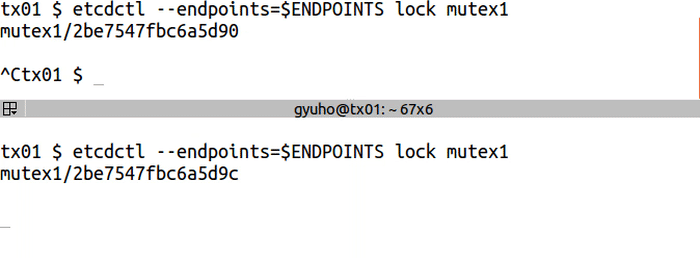
选项
- endpoints - 定义集群中机器地址的逗号分隔列表。
- ttl - 锁会话的超时时间,单位为秒。
2 - 快速入门
按照以下步骤本地安装、运行并测试单成员 etcd 集群:
从预构建的二进制文件或源码安装 etcd。详情请参见 [安装][]。
警告重要:务必完成安装说明的最后一步,确认可执行文件搜索路径中包含
etcd。启动
etcd:说明注意:
etcd生成的输出包含 日志 — 信息级别日志可忽略。在另一个终端中,使用
etcdctl设置键:在同一终端中,检索键:
下一步?
从以下页面了解配置和使用 etcd 的更多方式:
如果你是开发者:
如果是运维人员或管理员:
- 部署一个 多机集群 。
- 学习如何 [配置][] etcd。
- 使用 TLS 保护 etcd 集群 。
- 调优 etcd 。
3 - 示例
本系列示例展示了操作 etcd 集群的基本流程。
认证
auth、user、role 用于身份认证:
4 - 安装
先决条件
安装 etcd 之前,请参阅以下页面:
- [支持的平台][]
- [硬件建议][]
安装预构建二进制文件
安装 etcd 最简便的方式是使用预构建的二进制文件:
解压归档文件。解压后会生成一个包含二进制文件的目录。
将可执行二进制文件添加到 PATH。例如,可将二进制文件重命名或移动到 PATH 中的目录(如
/usr/local/bin),也可将上一步创建的目录添加到 PATH。在 shell 中验证
etcd是否位于 PATH 中:
从源码构建
如果已安装 Go 版本 1.21+ ,可按以下步骤从源码构建 etcd:
下载 etcd 仓库的 zip 文件 并解压,或使用以下命令克隆仓库。
如需从
main@HEAD构建,请省略-b v3.7.0标志。切换目录:
运行构建脚本:
二进制文件位于
bin目录下。将
bin目录的完整路径添加到 PATH 环境变量中,例如:验证
etcd是否位于 PATH 中:
通过操作系统包安装
请注意:通过操作系统包管理器安装的 etcd 可能会提供过时版本,因为这些版本不会被 etcd 项目自动维护或官方支持。因此,使用操作系统包时应格外谨慎。
在不同操作系统上安装 etcd 有多种方式,以下仅列举部分示例说明如何操作。
macOS (Homebrew)
- 更新 homebrew:
- 安装 etcd:
- 验证安装
Linux
尽管可通过多数主流 Linux 发行版的官方软件仓库和包管理器安装 etcd,但发布的版本可能严重过时。因此,强烈不建议采用此方式安装。
在 Linux 上安装 etcd 的推荐方式是通过 预构建二进制文件 ,或使用 Homebrew。
Linux 上的 Homebrew
Homebrew 可在 Linux 上运行,并可提供较新的软件版本。
先决条件
更新 Homebrew:
操作步骤
使用
brew安装:
结果
通过获取版本信息验证安装:
Docker
etcd 使用 gcr.io/etcd-development/etcd
作为主容器注册表,使用 quay.io/coreos/etcd
作为辅助注册表。
使用 Docker 运行 etcd:
Kubernetes 安装的一部分
- [以 Kubernetes StatefulSet 形式运行 etcd][]
安装检查
若需对安装进行稍复杂的完整性检查,请参阅[快速入门][]。
5 - 功能门控
本文概述了管理员可在 etcd 中指定的各种功能门控。
请参阅 feature stages 了解功能各阶段的说明。
概述
功能门控是一组描述 etcd 特性的 key=value 键值对。
可使用 etcd 的 --feature-gates 命令行标志来开启或关闭这些特性。
etcd 允许你启用或禁用一组功能门控。
使用 -h 标志查看全部功能门控列表。
要设置功能门控,请使用 --feature-gates 标志,并在命令行中指定功能对的列表:
或在 YAML 配置文件中指定 feature-gates:
变更 embed.EtcdServer 结构体
在 3.6 版本中,字段 ServerFeatureGate 被添加至 embed.Config,应取代以下实验性字段:
Alpha 或 Beta 功能的功能门控
下表总结了可在 etcd 上设置的功能门控。
| 特性 | 默认值 | 阶段 | 说明 |
|---|---|---|---|
| CompactHashCheck | false | Alpha | 在向任何客户端或对等成员提供服务前启用数据损坏检查。 |
| InitialCorruptCheck | false | Alpha | 启用领导者定期检查跟随者的压缩哈希值。 |
| LeaseCheckpoint | false | Alpha | 启用领导者向其他成员发送定期检查点,以防止领导者变更时剩余 TTL 被重置。 |
| LeaseCheckpointPersist | false | Alpha | 启用持久化剩余 TTL,以防止长期租约的无限自动续期。 |
| SetMemberLocalAddr | false | Alpha | 启用在与对等成员通信时,使用初始广告对等 URL 中指定的第一个非环回本地地址作为本地地址。 |
| StopGRPCServiceOnDefrag | false | Alpha | 启用在执行碎片整理时停止 etcd gRPC 服务对客户端请求的响应。 |
| TxnModeWriteWithSharedBuffer | true | Beta | 启用写入事务在其只读检查操作中使用共享缓冲区。 |
使用某个功能
特性阶段
特性可处于 Alpha、Beta、GA 或 Deprecated 阶段。 Alpha 特性表示:
- 默认禁用。
- 可能存在缺陷。启用该功能可能会暴露缺陷。
- 该功能的支持可能随时被取消,且不另行通知。
- 该 API 可能在后续软件版本中以不兼容的方式发生变更,且不另行通知。
- 由于存在更高的缺陷风险且缺乏长期支持,仅建议在短期测试集群中使用。
Beta 特性表示:
- 默认启用。
- 该功能经过充分测试,启用该功能被认为是安全的。
- 整体功能的支持不会被移除,尽管细节可能会变更。
- 仅建议用于非业务关键场景,因为更广泛采用可能导致发现新的难以察觉的缺陷。
请务必尝试使用 Beta 特性,并提供反馈! 进入正式发布阶段后,我们可能不再适合对这些特性进行进一步修改。
一个“正式发布”(General Availability,GA)特性也被称为“稳定”特性。其含义为:
- 该功能始终处于启用状态;无法将其禁用。
- 相应的功能门控已不再需要。
- 稳定版本的功能将在后续多个发布版本的软件中出现。
一个已弃用(Deprecated)的功能表示:
- 功能门控已不再使用。
- 该功能已进入正式发布阶段或已被移除。
6 - 常见问题
etcd,通用
etcd 是什么?
etcd 是一个一致性的分布式键值存储。主要用于分布式系统中的独立协调服务,专为存储可完全容纳在内存中的少量数据而设计。
如何发音 etcd?
etcd 读作 /ˈɛtsiːdiː/,意为“分布式 etc 目录”。
客户端是否需要向 etcd 领导者发送请求?
Raft 采用领导者机制;所有需要集群共识的客户端请求均由领导者处理。然而,客户端无需知晓哪个节点是领导者。任何发送至跟随者的需共识请求将自动转发至领导者。无需共识的请求(例如序列化读取)可由集群任意成员处理。
配置
客户端监听<client,peer>-urls、advertise-client-urls 或 initial-advertise-peer-urls 之间有什么区别?
listen-client-urls 和 listen-peer-urls 指定 etcd 服务器用于接受入站连接的本地地址。若需监听所有接口的端口,请将 0.0.0.0 作为监听 IP 地址。
advertise-client-urls 和 initial-advertise-peer-urls 指定 etcd 客户端或其他 etcd 成员应使用的地址,以联系 etcd 服务器。通告地址必须可从远程机器访问。生产环境不应通告 localhost 或 0.0.0.0 等地址,因为这些地址无法从远程机器访问。
为什么修改 --listen-peer-urls 或 --initial-advertise-peer-urls 不会更新 etcdctl member list 中的对等成员广告 URL?
成员的已通告对等成员 URL 来自 --initial-advertise-peer-urls,在集群初始启动时确定。在成员启动后更改监听对等成员 URL 或初始通告对等成员,不会影响已导出的通告对等成员 URL,因为此类变更必须通过法定人数达成一致,以避免成员配置出现脑裂。请使用 etcdctl member update 更新成员的对等成员 URL。
部署
系统要求
由于 etcd 将数据写入磁盘,其性能高度依赖磁盘性能。因此,强烈建议使用 SSD。为评估磁盘是否足够快以满足 etcd 需求,一种方法是使用磁盘基准测试工具,例如 fio 。有关具体操作示例,请参阅 here 。为防止性能下降或意外过度负载键值存储,etcd 默认强制执行 2GB 的可配置存储大小配额。为避免交换或内存不足,机器应至少具备与配额相当的 RAM。在常规环境中,建议最大大小为 8GB,若配置值超过此值,etcd 在启动时会发出警告。在 CoreOS,etcd 集群通常部署在专用的 CoreOS Container Linux 机器上,至少配备双核处理器、2GB 内存和 80GB SSD。请注意,性能本质上与工作负载相关;请在生产部署前进行测试。更多建议请参见 hardware 。
最稳定的生产环境为基于 amd64 架构的 Linux 操作系统;详见 支持的平台 。
为什么集群成员数要为奇数?
集群法定人数
etcd 集群需要多数节点达成一致,才能对集群状态进行更新,这一多数即为法定人数。对于包含 n 个成员的集群,法定人数为 (n/2)+1。对于任意奇数规模的集群,增加一个节点始终会提高达成法定人数所需的节点数量。尽管向奇数规模集群添加节点看似更优(因为机器数量更多),但其容错能力反而更差,因为即使仅相同数量的节点发生故障,仍可维持法定人数,但可故障的节点数量却增加了。当集群处于无法容忍更多故障的状态时,若在移除节点之前添加新节点,则存在风险:如果新节点无法成功注册到集群(例如地址配置错误),将永久性地失去法定人数。
集群最大规模是多少?
理论上,没有硬性限制。然而,etcd 集群的节点数量通常不应超过七个。Google Chubby 锁服务 ,与 etcd 类似,并在谷歌内部广泛部署多年,建议运行五个节点。五成员 etcd 集群可容忍两个成员故障,在大多数情况下已足够。尽管更大规模的集群能提供更好的容错能力,但写入性能会因数据需在更多机器间复制而下降。
什么是故障容忍度?
etcd 集群只要能够建立成员法定人数即可正常运行。若因临时网络故障(例如网络分区)导致法定人数丢失,etcd 在网络恢复并重新建立法定人数后会自动且安全地恢复;Raft 保证了集群的一致性。对于断电情况,etcd 会将 Raft 日志持久化到磁盘;etcd 会回放日志至故障点并恢复集群参与。对于永久性硬件故障,可通过 运行时重配置 将节点从集群中移除。
建议在集群中配置奇数个成员。奇数规模的集群在容忍故障数量上与偶数规模的集群相同,但所需节点更少。通过对比偶数规模与奇数规模集群,可以明显看出这一差异:
| 集群规模 | 多数成员数 | 故障容忍度 |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
| 8 | 5 | 3 |
| 9 | 5 | 4 |
将成员添加到集群以使集群规模变为偶数,并不会带来额外的容错能力。同样,在网络分区期间,奇数个成员可确保始终存在一个占多数的分区;分区结束后,该分区可继续运行,并成为权威数据源。
etcd 在跨区域或跨数据中心部署时是否可用?
跨区域部署 etcd 可提升 etcd 的容错能力,因为成员位于不同的故障域中。代价是跨数据中心边界带来的更高共识请求延迟。由于 etcd 依赖成员法定人数达成共识,因此跨数据中心的延迟会较为明显,因为至少需要集群中多数成员响应共识请求。此外,集群数据必须复制到所有对等成员,因此还会产生带宽开销。
在较长的延迟情况下,etcd 的默认配置可能导致频繁的选举或心跳超时。请参阅 tuning 以调整高延迟部署的超时设置。
操作
如何备份 etcd 集群?
etcdctl 提供了 snapshot 命令用于创建备份。详见 backup
以获取更多详情。
在移除不健康成员之前,我应该先添加一个成员吗?
替换 etcd 节点时,必须先移除成员,再添加其替代节点。
etcd 基于法定人数模型实现分布式共识;在集群中,必须有 (n/2)+1 个成员就某项提案达成一致,该提案才能被提交至集群。此类提案包括键值更新和成员变更。该模型完全避免了脑裂不一致的可能性。其缺点是,一旦永久性丢失法定人数,将造成灾难性后果。
对成员关系的影响如下:若一个 3 成员集群中有 1 个成员离线,集群仍可继续推进,因为法定人数为 2,仍有 2 个成员处于正常运行状态。然而,向 3 成员集群添加新成员后,法定人数将增至 3,因为 4 个成员中需要 3 票才能达成多数。由于法定人数增加,新增成员在容错能力方面并未带来任何提升;集群仍仅能承受一次节点故障,一旦再发生故障,将无法恢复。
此外,该新成员存在风险,因为它可能配置错误,或无法加入集群。在这种情况下,无法恢复法定人数,因为集群中有两个成员离线、两个成员在线,但要更改成员关系以撤销错误的成员添加操作,需要三个投票。etcd 默认会拒绝可能以这种方式导致集群瘫痪的成员添加尝试。
另一方面,如果先将故障成员从集群成员关系中移除,成员数量将变为 2,法定人数仍为 2。在移除该成员后,再添加新成员,法定人数仍可保持在 2。因此,即使新节点无法启动,仍可通过剩余的存活成员通过法定人数移除新成员。
为什么 etcd 不接受我的成员变更?
etcd 设置 strict-reconfig-check,以拒绝可能导致法定人数丢失的重新配置请求。放弃法定人数风险极高(尤其当集群已处于不健康状态时)。尽管在出现法定人数丢失时,可能倾向于禁用法定人数检查以添加新成员,但这可能导致集群完全不一致。对许多应用而言,这会使问题更加严重(“磁盘几何结构损坏”可能是最令人恐惧的案例)。
为什么 etcd 因磁盘延迟峰值而失去领导者?
这是有意为之的设计;磁盘延迟是领导者活跃性的一部分。假设集群领导者需要一分钟才能将 Raft 日志更新同步到磁盘,但 etcd 集群的选举超时时间为 1 秒。尽管领导者能在选举周期内处理网络消息(例如发送心跳),但由于无法提交任何新的提案而实际上处于不可用状态;它正在等待缓慢的磁盘。如果集群因磁盘延迟频繁失去领导者,请尝试 调优 磁盘设置或 etcd 时间参数。
etcd 警告“请求忽略(集群 ID 不匹配)”是什么意思?
每个新的 etcd 集群都会根据初始集群配置和用户提供的唯一 initial-cluster-token 值生成一个新的集群 ID。通过确保集群 ID 唯一,etcd 可防止跨集群交互,避免造成集群损坏。
通常,此警告出现在拆除旧集群后,又将部分对等成员地址用于新集群时。如果旧集群中的任何 etcd 进程仍在运行,它将尝试联系新集群。新集群会识别出集群 ID 不匹配,从而忽略该请求并发出此警告。通过确保不同集群之间的对等成员地址互不重叠,通常可清除此警告。
mvcc: 数据库空间超限"是什么意思,如何修复?
etcd 中的 多版本并发控制
数据模型会完整保留键空间的精确历史记录。若未定期执行压缩(例如,通过设置 --auto-compaction),etcd 最终将耗尽存储空间。当 etcd 存储空间不足时,会触发空间配额告警,以保护集群免受进一步写入操作的影响。只要告警处于激活状态,etcd 对写入请求的响应将返回错误 mvcc: database space exceeded。
从低空间配额告警中恢复:
etcd 警告“etcdserver/api/v3rpc: transport: http2Server.HandleStreams failed to read frame: read tcp 127.0.0.1:2379->127.0.0.1:43020: read: connection reset by peer”是什么意思?
这是 gRPC 侧警告,当服务器接收到客户端流提前关闭时的 TCP RST 标志。例如,客户端关闭连接时,gRPC 服务器尚未处理完 TCP 队列中的所有 HTTP/2 帧。服务器端可能丢失部分数据,但只要客户端连接已关闭,这种情况是可以接受的。
仅 旧版本的 gRPC
会记录此日志。etcd >=v3.2.13
默认以 DEBUG 级别记录此日志,因此仅在 --log-level=debug 标志启用时可见。
性能
如何对 etcd 进行基准测试?
尝试使用 benchmark 工具。当前的 benchmark 结果 可用于对比。
etcd 警告“应用条目花费时间过长”是什么意思?
在多数 etcd 成员就提交请求达成一致后,每个 etcd 服务器会将请求应用到其数据存储,并将结果持久化到磁盘。即使使用速度较慢的机械磁盘或虚拟化网络磁盘(如 Amazon 的 EBS 或 Google 的 PD),正常情况下应用请求的时间也应少于 50 毫秒。如果平均应用时间超过 100 毫秒,etcd 将发出警告,提示条目应用耗时过长。
通常此问题由磁盘速度过慢引起。磁盘可能正遭受 etcd 与其他应用程序之间的资源争用,或磁盘本身过于缓慢(例如,共享的虚拟化磁盘)。为排除磁盘过慢导致此警告的可能性,请监控 backend_commit_duration_seconds (p99 延迟应低于 25ms),以确认磁盘速度处于合理范围。若磁盘确实过慢,为 etcd 分配专用磁盘或使用更快速的磁盘通常可解决该问题。
第二个最常见的原因是 CPU 资源耗尽。若监控显示机器的 CPU 使用率过高,etcd 可能无法获得足够的计算资源。通常可通过将 etcd 迁移到专用机器、增加进程资源隔离(cgroups)或将 etcd 服务器进程的优先级提升来解决该问题。
访问过多键(例如获取整个键空间)的昂贵用户请求也可能导致较长的 Apply 延迟。然而,每个请求访问的键少于数百个时,性能应始终良好。
如果上述建议均未能消除警告,请提供详细的日志、监控数据、指标信息,以及可选的工作负载信息,打开一个问题 。
etcd 警告“未按时发送心跳”是什么意思?
etcd 使用基于领导者的共识协议,实现数据的一致性复制和日志执行。集群成员选举出一个单一的领导者,其余所有成员成为跟随者。被选举出的领导者必须定期向其跟随者发送心跳,以维持领导权。如果跟随者在选举间隔内未收到心跳,则推断领导者发生故障,并触发选举。若领导者虽仍在运行但未能及时发送心跳,将导致一次无效选举,通常由资源不足引起。为检测此类软故障,若领导者跳过两个心跳间隔,etcd 将发出警告,提示其未能按时发送心跳。
通常此问题由磁盘速度过慢引起。在领导者发送附带元数据的心跳前,可能需要将元数据持久化到磁盘。磁盘可能存在 etcd 与其他应用程序之间的争用,或磁盘本身过于缓慢(例如共享虚拟磁盘)。为排除磁盘过慢导致此警告的可能性,可监控 wal_fsync_duration_seconds (p99 延迟应低于 10ms),以确认磁盘速度是否合理。若磁盘过慢,为 etcd 分配专用磁盘或使用更快的磁盘通常可解决问题。为判断磁盘是否足够快以满足 etcd 需求,可使用 fio 等基准测试工具。请参阅 here 以获取示例。
第二个最常见的原因是 CPU 资源耗尽。如果监控显示机器的 CPU 使用率过高,etcd 可能无法获得足够的计算资源。通常可通过将 etcd 迁移到专用机器、使用 cgroups 增强进程资源隔离,或将 etcd 服务器进程的优先级提升来解决该问题。
慢速网络也可能导致此问题。如果 etcd 机器之间的网络指标显示延迟较长或丢包率较高,可能表明网络容量不足以支撑 etcd。将 etcd 成员迁移到负载较低的网络通常可解决该问题。然而,若 etcd 集群跨数据中心部署,成员间的高延迟属于正常现象。对于此类部署,应将 heartbeat-interval 配置调整为大致匹配机器间的往返时间,并将 election-timeout 配置设为至少 5 倍 heartbeat-interval。有关详细信息,请参阅 tuning documentation
。
如果上述建议均未能消除警告,请提供详细的日志、监控数据、指标信息,以及可选的工作负载信息,打开一个问题 。
etcd 警告“快照生成花费了超过 x 秒时间……”是什么意思?
etcd 会向缓慢的跟随者发送其完整键值存储的快照,以实现状态同步并用于 备份 。快照传输速度过慢会增加平均恢复时间(MTTR);若集群正在以高吞吐量接收数据,缓慢的跟随者可能因在完成接收前就需要新的快照而陷入活锁。为检测快照性能缓慢问题,当快照发送耗时超过三十秒且超出 1Gbps 连接的预期传输时间时,etcd 会发出警告。
7 - 库和工具
请注意,以下第三方库和工具未托管在 https://github.com/etcd-io 下,也未经 etcd 团队测试或维护。使用前应自行阅读相关资料并评估其可靠性。
工具
- etcdctl - etcd 的命令行客户端
- etcd-dump - 用于导出/恢复 etcd 的命令行工具
- etcd-fs - etcd 的 FUSE 文件系统
- etcddir - 实时同步 etcd 与本地目录的工具,支持 Windows 和 Linux
- etcd-browser - 基于 AngularJS 的 Web 端键值编辑器,用于 etcd
- etcd-lock - 基于 etcd 实现的领导者选举与分布式读写锁,支持 v2 版本
- etcd-console - 基于 PHP 的 Web 端键值编辑器,用于 etcd
- etcd-viewer - 使用 Java 编写的 etcd 键值存储编辑器/查看器
- etcdtool - 将 etcd 目录导出/导入/编辑为 JSON/YAML/TOML 格式,并使用 JSON Schema 验证目录
- etcdloadtest - 用于 etcd 3.0 及以上版本的命令行负载测试客户端
- etcd-tui - 用于与 etcd 数据库交互的现代终端用户界面(TUI),可在终端中导航键、查看值、过滤数据,并直接管理 etcd 集群
- etcdfinder - 一款快速、现代的 Web UI,支持 etcd v2 和 v3,具备即时搜索功能
- lucas - 用于 Kubernetes etcd 3.0+ 集群的 Web 端键值查看器
- etcd-manager - 一款现代、高效、跨平台且免费的 etcd 3.x 图形界面与客户端工具,支持 Windows、Linux 和 Mac
- etcd-backup-restore - 用于定期且增量备份与恢复 etcd 的工具
- etcd-druid - 用于部署 etcd 集群并管理日常运维操作的 Kubernetes Operator
- etcdadm - 用于操作 etcd 集群的命令行工具
- etcd-defrag - 更易用且智能的 etcd 碎片整理工具
- etcdhelper - 适用于 IntelliJ 平台的 etcd 插件
库
以下各节按语言列出了 etcd 客户端库。
Golang
- etcd/client/v3 - v3 版本的官方维护 Go 客户端
- go-etcd - 已弃用的官方客户端。对较旧版本(<2.0.0)的 etcd 可能仍有用处。
- encWrapper - encWrapper 是 etcd 客户端 Keys API/KV 的加密封装。
Java
- coreos/jetcd - 支持 v3
- justinsb/jetcd
- cdancy/etcd-rest - 使用 jclouds 提供 v2 API 的完整实现。
- IBM/etcd-java
Scala
- maciej/etcd-client - 支持 v2。基于 Akka HTTP 的完全异步客户端
- eiipii/etcdhttpclient - 支持 v2。基于 Netty 和 Scala Futures 的异步 HTTP 客户端
- mingchuno/etcd4s - 支持 v3,使用 gRPC,可选支持 Akka Stream
Perl
- hexfusion/perl-net-etcd - 支持 v3 gRPC 网关 HTTP API
- robn/p5-etcd - 支持 v2
Python
- kragniz/python-etcd3 - v3 版本客户端
- jplana/python-etcd - 支持 v2 版本
- russellhaering/txetcd - 基于 Twisted 的 Python 库
- cholcombe973/autodock - Docker 部署自动化工具
- lisael/aioetcd - (Python 3.4+) Asyncio 协程客户端(支持 v2)
- txaio-etcd - 面向 Twisted(当前)和 asyncio(未来)的异步 etcd v3 专用客户端库
- dims/etcd3-gateway - 使用 HTTP gRPC 网关的 etcd v3 API 库
- aioetcd3 - (Python 3.6+) asyncio 专用的 etcd v3 API
- Revolution1/etcd3-py - (Python 2.7 和 Python 3.5+) 使用 gRPC-JSON-Gateway 的 etcd v3 Python 客户端
节点
- mixer/etcd3 - 支持 v3
- stianeikeland/node-etcd - 支持 v2(使用 CoffeeScript)
- lavagetto/nodejs-etcd - 支持 v2
- deedubs/node-etcd-config - 支持 v2
Ruby
C
- apache/celix/etcdlib - 支持 v2
- jdarcy/etcd-api - 支持 v2
- shafreeck/cetcd - 支持 v2
C++
- edwardcapriolo/etcdcpp - 支持 v2
- suryanathan/etcdcpp - 支持 v2(带等待)
- nokia/etcd-cpp-api - 支持 v2
- etcd-cpp-apiv3/etcd-cpp-apiv3 - 支持 v3
Clojure
- aterreno/etcd-clojure
- dwwoelfel/cetcd - 支持 v2
- rthomas/clj-etcd - 支持 v2
Erlang
- marshall-lee/etcd.erl - 支持 v2
- zhongwencool/eetcd - 支持 v3+(仅 GRPC)
Elixir
- team-telnyx/etcdex - 支持 v3+(仅限 GRPC)
.NET
- wangjia184/etcdnet - 支持 v2
- drusellers/etcetera
- shubhamranjan/dotnet-etcd - 支持 v3+(仅 GRPC)
- SimplifyNet/etcd.Microsoft.Extensions.Configuration
PHP
- linkorb/etcd-php
- activecollab/etcd
- ouqiang/etcd-php - v3 gRPC 网关的客户端
Haskell
R
Nim
Tcl
- efrecon/etcd-tcl - 支持 v2,但不支持 wait。
Rust
- jimmycuadra/rust-etcd - 支持 v2
Gradle
- gradle-etcd-rest-plugin - 支持 v2
Lua
- api7/lua-resty-etcd - 支持 v2 和 v3(gRPC 网关 HTTP API)
部署工具
Chef 集成
Chef 转译包
BOSH 发行版
使用 etcd 的项目
- etcd Raft 用户 - 使用 etcd 的 Raft 库实现的项目。
- Apache APISIX - 将 etcd 用作配置存储的 API 网关。
- apache/celix - 适用于 C 和 C++ 的 OSGi 规范实现。
- binocarlos/yoda - etcd + ZeroMQ。
- blox/blox - 一组用于容器管理与编排的开源项目,支持 AWS ECS。
- calavera/active-proxy - 使用 etcd 配置的 HTTP 代理。
- chain/chain - 用于运行并连接高度可扩展的许可区块链网络的软件。
- derekchiang/etcdplus - 基于 etcd 构建的一组分布式同步原语。
- go-discover - Go 语言中的服务发现。
- gleicon/goreman - 支持 etcd 的 Go Foreman 克隆分支。
- garethr/hiera-etcd - 使用 etcd 作为后端的 Puppet hiera 后端。
- mattn/etcd-vim - 在 vim 内部进行键的 SET 和 GET 操作。
- mattn/etcdenv - 集成 etcd 的 “env” shebang。
- kelseyhightower/confd - 使用模板和来自 etcd 的数据管理本地应用配置文件。
- configdb - 基于任意数据库后端的 REST 关系型抽象,旨在存储配置和清单。
- kubernetes/kubernetes - 由 Google 推出的容器集群管理器。
- mailgun/vulcand - 使用 etcd 作为配置后端的 HTTP 代理。
- duedil-ltd/discodns - 使用 etcd 作为名称和记录数据库的简单 DNS 名称服务器。
- skynetservices/skydns - 符合 RFC 的 DNS 服务器。
- xordataexchange/crypt - 使用 GPG 加密在 etcd 中安全存储值。
- spf13/viper - Go 配置库,支持从 ENV、pflags、文件和 etcd 读取值,可选加密。
- lytics/metafora - Go 语言分布式任务库。
- ryandoyle/nss-etcd - 用于从 etcd 解析名称的 GNU libc NSS 模块。
- Gru - 使用 Go 实现的简易编排。
- Vitess - 用于 MySQL 水平扩展的数据库集群系统。
- lclarkmichalek/etcdhcp - 使用 etcd 实现持久化和协调的 DHCP 服务器。
- openstack/networking-vpp - 一个网络驱动程序,用于编程 FD.io VPP 数据平面 ,以提供 OpenStack 云虚拟网络。
- OpenStack - OpenStack 服务可依赖 etcd 作为基础服务。
- CoreDNS - CoreDNS 是一个可插件链式组合的 DNS 服务器,属于 CNCF 和 Kubernetes 项目。
- Uber M3 - M3:Uber 开源的大规模指标平台,兼容 Prometheus。
- Rook - Kubernetes 的存储编排。
- Patroni - 基于 ZooKeeper、etcd 或 Consul 的 PostgreSQL 高可用性模板。
- Trillian - Trillian 实现了一种默克尔树,其内容由数据存储层提供,以支持极大规模树的可扩展性。
- purpleidea/mgmt - 新一代分布式、事件驱动、并行配置管理工具。
- Portworx/kvdb - 用于存储 Portworx 集群配置的内部 kvdb。
- Apache Pulsar - Apache Pulsar 是一个面向云的开源分布式消息与流平台。
8 - 指标
etcd 使用 Prometheus 进行指标报告。指标可用于实时监控和调试。etcd 不会持久化其指标;若成员重启,指标将被重置。
查看可用指标最简单的方法是使用 cURL 访问指标端点 /metrics。其格式详见 Prometheus 文档
。
请按照 Prometheus 入门指南 启动 Prometheus 服务器,以收集 etcd 指标。
指标命名遵循建议的 Prometheus 最佳实践
。指标名称以 etcd 或 etcd_debugging 作为命名空间前缀,并可包含子系统前缀(例如 wal 和 etcdserver)。
etcd 命名空间指标
以 etcd 为前缀的指标用于监控和告警。这些是稳定且高层次的指标。若此类指标有任何变更,将包含在发布说明中。
与 etcd2 相关的指标在 v2 指标指南 中有详细说明。
服务器
这些指标描述了 etcd 服务器的运行状态。为检测故障或排查问题,应密切监控每个生产环境 etcd 集群的服务器指标。
所有这些指标均以 etcd_server_ 为前缀
| 名称 | 描述 | 类型 |
|---|---|---|
| has_leader | 是否存在领导者。1 表示存在,0 表示不存在。 | 仪表 |
| leader_changes_seen_total | 观察到的领导者变更次数。 | 计数器 |
| proposals_committed_total | 已提交的共识提案总数。 | 仪表 |
| proposals_applied_total | 已应用的共识提案总数。 | 仪表 |
| proposals_pending | 当前待处理的提案数量。 | 仪表 |
| proposals_failed_total | 观察到的失败提案总数。 | 计数器 |
has_leader 表示成员是否具有领导者。如果某个成员没有领导者,则该成员完全不可用。如果集群中的所有成员均无领导者,则整个集群完全不可用。
leader_changes_seen_total 统计该成员自启动以来所经历的领导者变更次数。频繁的领导权变更会显著影响 etcd 的性能,同时也表明领导者不稳定,可能是由于网络连接问题或 etcd 集群负载过高所致。
proposals_committed_total 记录已提交的共识提案总数。如果集群运行正常,该指标应随时间持续增长。etcd 集群中多个健康成员可能在某一时刻拥有不同的已提交提案总数。这种差异可能是由于启动后正在恢复对等成员、落后于领导者,或本身是领导者而拥有最多提交记录所致。必须在集群所有成员上监控此指标;若某个成员与领导者之间持续存在较大延迟,表明该成员运行缓慢或状态异常。
proposals_applied_total 记录已应用的共识提案总数。etcd 服务器异步应用每个已提交的提案。proposals_committed_total 与 proposals_applied_total 之间的差值通常应较小(即使在高负载下也应在数千以内)。如果两者之间的差值持续增大,表明 etcd 服务器已过载。这可能发生在应用高开销查询(如大量范围查询或大型事务操作)时。
proposals_pending 表示待提交的提案数量。待提交的提案数量上升,表明客户端负载较高,或成员无法提交提案。
proposals_failed_total 通常与两个问题相关:领导者选举期间的临时故障,或因集群失去法定人数而导致的长时间停机。
磁盘
这些指标描述了磁盘操作的状态。
所有这些指标均以 etcd_disk_ 为前缀。
| 名称 | 描述 | 类型 |
|---|---|---|
| wal_fsync_duration_seconds | WAL 调用 fsync 的延迟分布 | 直方图 |
| backend_commit_duration_seconds | 后端调用 commit 的延迟分布 | 直方图 |
在 etcd 将日志条目写入磁盘并应用之前,会调用 wal_fsync。
当 etcd 将其最近的增量快照写入磁盘时,会调用 backend_commit。
高磁盘操作延迟(wal_fsync_duration_seconds 或 backend_commit_duration_seconds)通常表明存在磁盘问题。可能导致请求延迟升高或使集群不稳定。
网络
这些指标描述了网络状态。
所有这些指标均以 etcd_network_ 为前缀
| 名称 | 描述 | 类型 |
|---|---|---|
| peer_sent_bytes_total | 发送到 ID 为 To 的对等成员的总字节数。 | 计数器(To) |
| peer_received_bytes_total | 从 ID 为 From 的对等成员接收的总字节数。 | 计数器(From) |
| peer_sent_failures_total | 发送到 ID 为 To 的对等成员时发生的失败总次数。 | 计数器(To) |
| peer_received_failures_total | 从 ID 为 From 的对等成员接收时发生的失败总次数。 | 计数器(From) |
| peer_round_trip_time_seconds | 对等成员之间的往返时间(RTT)直方图。 | 直方图(To) |
| client_grpc_sent_bytes_total | 发送到 gRPC 客户端的总字节数。 | 计数器 |
| client_grpc_received_bytes_total | 从 gRPC 客户端接收的总字节数。 | 计数器 |
peer_sent_bytes_total 统计发送至特定对等成员的总字节数。通常,领导者成员发送的数据量多于其他成员,因为它负责传输已复制的数据。
peer_received_bytes_total 统计从特定对等成员接收的总字节数。通常,跟随者成员仅从领导者成员接收数据。
gRPC 请求
这些指标通过 go-grpc-prometheus 暴露。
etcd 调试命名空间指标
以 etcd_debugging 为前缀的指标用于调试。这些指标高度依赖实现且不稳定,可能在新的 etcd 版本中未经通知即被修改或移除。当部分指标趋于稳定后,可能会被迁移至 etcd 前缀。
快照
| 名称 | 描述 | 类型 |
|---|---|---|
| snapshot_save_total_duration_seconds | 快照调用保存操作的总延迟分布 | 直方图 |
快照持续时间异常高(snapshot_save_total_duration_seconds)表明存在磁盘问题,可能导致集群不稳定。
Prometheus 供应的指标
Prometheus 客户端库在 go 和 process 命名空间下提供了一系列指标。其中有一些尤为值得关注。
| 名称 | 描述 | 类型 |
|---|---|---|
| process_open_fds | 打开的文件描述符数量。 | 仪表 |
| process_max_fds | 最大打开文件描述符数量。 | 仪表 |
当前版本不支持在 Darwin(macOS)系统上使用进程指标,例如 process_open_fds 和 process_max_fds。
高文件描述符(process_open_fds)使用率(即接近进程的文件描述符限制,process_max_fds)表明可能存在文件描述符耗尽问题。若文件描述符耗尽,etcd 可能因无法创建新的 WAL 文件而发生崩溃。
生成的指标列表
9 - 报告缺陷
如果 etcd 项目任何部分存在缺陷或文档错误,请通过 打开问题 告知我们。我们高度重视缺陷和错误,认为任何问题都不算太小。创建缺陷报告前,请确认尚未存在报告相同问题的议题。
为了使错误报告准确且易于理解,请尽量编写如下格式的错误报告:
具体。尽可能提供详细信息:包括版本号、运行环境、配置信息等。若该问题与运行 etcd 服务器相关,请附上 etcd 日志(包含 etcd 配置的启动日志尤为重要)。
可复现。请提供复现问题的完整步骤。我们理解某些问题可能难以复现,请尽可能提供可能导致问题的步骤。如有可能,请在缺陷报告中附上受影响的 etcd 数据目录和堆栈跟踪信息。
独立。请尽量在依赖最少的情况下复现问题。若报告中涉及过多依赖,将显著降低问题修复速度。排查依赖 etcd 的外部系统不在支持范围内,但我们可以提供正确的指导方向,或协助使用 etcd 本身。
唯一。请勿重复提交现有错误报告。
作用域明确。每个报告仅针对一个缺陷。请勿在单个报告中跟进其他缺陷。
在创建错误报告前,阅读 Elika Etemad 关于撰写优质错误报告的文章 可能会有所帮助。
我们可能需要进一步信息以定位问题。重复的错误报告将被关闭。
常见问题解答
如何获取堆栈跟踪
如何获取 etcd 版本
如何获取以 etcd2.service 运行的 systemd 服务的 etcd 配置和日志
由于上游 systemd 的一个缺陷,当 journald 的进程退出时,可能会丢失最后几行日志。如果 journalctl 显示 etcd 停止但未出现致命错误或 panic 消息,请尝试 sudo journalctl -f -t etcd2 以获取完整日志。
10 - 调优
默认情况下,etcd 的配置在平均网络延迟较低的本地网络环境中应能良好运行。然而,当在多个数据中心之间或高延迟网络上使用 etcd 时,可能需要调整心跳间隔和选举超时设置。
网络并非延迟的唯一来源。每个请求和响应都可能受到领导者和跟随者上慢速磁盘的影响。每个超时时间均表示从请求发出到从另一台机器成功返回响应的总时间。
时间参数
本文所依赖的分布式共识协议依赖两个独立的时间参数,以确保当某个节点停滞或离线时,其他节点能够完成领导权交接。第一个参数称为 心跳间隔(Heartbeat Interval)。该参数定义了领导者向跟随者通知自身仍为领导者的时间频率。
最佳实践建议,该参数应设置为成员间往返时间的近似值。默认情况下,etcd 使用 100ms 的心跳间隔。
第二个参数是 选举超时时间。该超时时间表示跟随者节点在未收到心跳消息的情况下,等待多久后将尝试自行成为领导者。默认情况下,etcd 使用 1000ms 选举超时时间。
调整这些值需要权衡。心跳间隔的值建议设置为成员间平均往返时间(RTT)的最大值,通常为往返时间的 0.5-1.5x。如果心跳间隔过低,etcd 会发送不必要的消息,增加 CPU 和网络资源的使用。另一方面,心跳间隔过高会导致选举超时时间变长,更高的选举超时会延长对领导者故障的检测时间。测量往返时间(RTT)最简便的方法是使用 PING utility 。
选举超时应根据心跳间隔以及成员之间的平均往返时间进行设置。选举超时必须至少为往返时间的 10 倍,以应对网络波动。例如,若成员之间的往返时间为 10ms,则选举超时应至少设置为 100ms。
选举超时的上限为 50000ms(50s),仅在部署全球分布式 etcd 集群时才应使用。美国大陆范围内的合理往返时间约为 130ms,而美国与日本之间的往返时间约为 350ms 至 400ms。若网络性能不均或存在常规的包延迟或丢包,则可能需要多次重试才能成功发送数据包。因此,5s 是全球往返时间的安全上限。由于选举超时应比广播时间大一个数量级,在全球分布式集群中约为 5s 的情况下,50 秒便成为合理的最大值。
集群中所有成员的心跳间隔和选举超时值应保持一致。为 etcd 成员设置不同的值可能会导致集群稳定性受损。
默认值可通过命令行进行覆盖:
值以毫秒为单位指定。
快照
etcd 将所有键的变更追加到日志文件中。该日志会无限增长,记录了键的所有变更的完整线性历史。完整的历史记录在轻度使用的集群中表现良好,但在高负载使用的集群中,日志会变得非常庞大。
为避免日志过大,etcd 会定期生成快照。这些快照使 etcd 能通过保存系统当前状态并删除旧日志来执行压缩。
快照调优
使用 V2 后端创建快照的开销较高,因此仅在 etcd 发生指定数量的变更后才会创建快照。默认情况下,每发生 10,000 次变更后将生成一次快照。若 etcd 的内存使用率和磁盘使用率过高,可尝试通过命令行设置降低快照阈值:
磁盘
etcd 集群对磁盘延迟非常敏感。由于 etcd 必须将提案持久化到日志中,其他进程的磁盘活动可能导致长时间的 fsync 延迟。结果是 etcd 可能错过心跳,导致请求超时和临时领导者丢失。当分配较高的磁盘优先级时,etcd 服务器有时可以与这些进程稳定共存。
在 Linux 上,etcd 的磁盘优先级可通过 ionice 配置:
网络
如果 etcd 领导者处理大量并发客户端请求,可能因网络拥塞而延迟处理跟随者对等成员的请求。这会在跟随者节点上表现为发送缓冲区错误消息:
这些错误可通过优先处理 etcd 的对等成员流量而非客户端流量来解决。在 Linux 上,可使用流量控制机制来优先处理对等成员流量:
要取消 tc,请执行:
CPU
由于 etcd 对延迟非常敏感,可在 Linux 系统上通过将 CPU 调度器设置为 performance 或 conservative 模式,进一步优化性能。
在 Linux 上,可将 CPU 调度器配置为性能模式:
11 - 内部架构
11.1 - 发现服务协议
发现服务协议有助于新 etcd 成员在集群引导阶段,通过共享的发现令牌和端点列表,发现集群中的所有其他成员。
发现服务协议仅在集群引导阶段使用,不可用于运行时重配置或集群监控。
该协议使用新的发现令牌来引导一个唯一的 etcd 集群。请注意,一个发现令牌只能代表一个 etcd 集群。只要该令牌的发现协议已启动,即使中途失败,也不得用于引导另一个 etcd 集群。
本文其余部分将通过示例介绍发现过程,这些示例对应自托管发现集群。
请注意,本文仅适用于 v3 发现机制。有关 v2 发现 的更多详情,请参阅前文文档。
协议工作流
发现协议的核心思想是利用一个内部 etcd 集群来协调新集群的引导过程。首先,所有新成员与发现服务交互,协助生成预期的成员列表。随后,每个新成员使用该列表引导其服务器,这一操作实现的功能与 -initial-cluster 标志相同。
在以下示例工作流程中,我们将使用 etcdctl 命令列出协议的每一步,以便于理解,并假设 http://example.com:2379 主机提供 etcd 集群作为发现服务。
按照惯例,etcd 发现协议使用键前缀 /_etcd/registry。
创建新的发现令牌
生成一个唯一令牌,用于标识新集群。该令牌将在后续步骤中作为发现键空间的唯一前缀使用。一种简便的方法是使用 uuidgen:
指定预期集群规模
发现令牌需要指定集群大小,该大小必须明确提供。发现服务使用此大小来判断是否已找到将初始组成集群的所有成员。
通常,集群大小为 3、5 或 7。请参阅 optimal cluster size 以获取更多详细信息。
启动 etcd 进程
将发现令牌 ${UUID} 设置为 --discovery-token 标志,并将支持发现服务的 etcd 集群端点设置为 --discovery-endpoints 标志。这将启用 v3 发现以引导 etcd 集群。
如果给定 --discovery-token 和 --discovery-endpoints 标志,每个 etcd 进程将内部遵循以下步骤。
如果发现服务启用了客户端证书身份认证,请配置以下标志。其使用方式与使用 etcdctl 与 etcd 集群通信完全相同。
如果发现服务启用了基于角色的身份认证,请配置以下标志。其使用方式与使用 etcdctl 与 etcd 集群通信完全相同。
默认的超时时间值也可通过以下标志进行修改,其使用方式与使用 etcdctl 与 etcd 集群通信时完全相同。
自我注册
每个 etcd 进程首先会将自身注册为指定新集群中的成员。这是通过在完整注册键中创建成员 ID 作为键来实现的。
检查状态
它检查预期的集群大小和注册状态,并决定下一步操作。
如果已注册的成员仍不足,系统将等待其他成员出现。
如果注册的成员数量大于预期的集群大小 N,则将前 N 个注册的成员视为集群的成员列表。如果该成员自身位于成员列表中,发现过程成功,并通过成员列表获取所有对等成员。如果不在成员列表中,发现过程将以集群已满的失败结果结束。
成员可在注册自身之前检查集群状态。因此,如果集群已满,成员可能迅速失败。
等待所有成员就位
等待过程将持续监听键前缀 /_etcd/registry/${UUID}/members,直至发现所有成员。
11.2 - 日志记录约定
etcd 使用 zap 库记录应用程序输出,输出按 级别 进行分类。日志消息的级别依据以下约定确定:
DebugLevel 日志通常非常庞大,通常在生产环境中禁用。
- 示例:
- 向远程对等成员发送一条普通消息
- 将日志条目写入磁盘
- 示例:
InfoLevel 为默认的日志优先级。
- 示例:
- 启动配置
- 开始创建快照
- 向集群中添加新节点
- 向认证子系统中添加新用户
- 示例:
警告级别日志比信息级别日志更为重要,但无需逐条人工审查。
- 示例:
- 无法向远程对等成员发送 Raft 消息
- 在配置的选举超时时间内未收到心跳消息
- 示例:
ErrorLevel 日志为高优先级。若应用程序运行正常,不应产生任何 ErrorLevel 日志。
- 示例:
- WAL 无法分配磁盘空间
- 示例:
PanicLevel 会记录一条消息,然后触发 panic。
- 示例:
- Raft 消息编码失败
- 示例:
FatalLevel 会记录一条消息,然后调用 os.Exit(1)。
- 示例:
- Raft 快照保存失败
- 示例:
11.3 - Go 模块
etcd 项目(自版本 3.5 起)采用多个 golang 模块 ,托管于 单个仓库 中。
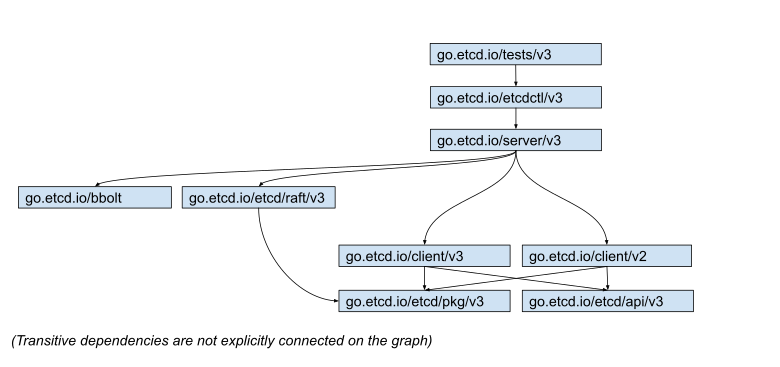
以下是各个模块:
go.etcd.io/etcd/api/v3 - 包含 API 定义 (如 protos 与 proto 生成的库),定义了 etcd 客户端与服务器之间的通信协议。
go.etcd.io/etcd/pkg/v3 - etcd 使用的通用工具包集合,不针对 etcd 本身。仅当某个包未来可能被移出至独立仓库时,才应归入此处。请避免在此处添加依赖关系复杂的代码,因为这些依赖会自动成为客户端库的依赖(我们希望客户端库保持轻量)。
go.etcd.io/etcd/client/v3 - 通过网络(gRPC)与 etcd 通信所使用的客户端库。建议所有新的 etcd 使用场景均采用此库。
go.etcd.io/etcd/client/v2 - 用于通过 HTTP 协议与 etcd 通信的旧版客户端库。已弃用。所有新用法应依赖 /v3 库。
go.etcd.io/etcd/raft/v3 - 分布式共识协议的实现。不应包含与 etcd 相关的特定代码。
go.etcd.io/etcd/server/v3 - etcd 实现。 该包中的代码为 etcd 内部实现,外部项目不应使用。包的结构和 API 可能在小版本内发生变更。
go.etcd.io/etcd/etcdctl/v3 - 用于访问和管理 etcd 的命令行工具。
go.etcd.io/etcd/tests/v3 - 包含 etcd 所有集成测试的模块。 请注意:所有单元测试(快速且不依赖跨模块依赖)应保留在被测试代码所在的本地模块中。
go.etcd.io/bbolt - 持久化 b 树的实现。 托管于独立的仓库中:https://github.com/etcd-io/bbolt.
运维
所有 etcd 模块应以相同版本发布,例如:
go.etcd.io/etcd/client/v3@v3.5.10必须依赖go.etcd.io/etcd/api/v3@v3.5.10。版本的持续更新可通过以下方式执行:
发布的模块应根据 https://golang.org/ref/mod#vcs-version 规则进行标记,即每个模块应拥有独立的标签。可通过以下方式执行标记:
所有 etcd 模块应依赖相同版本的底层依赖项。 可通过以下方式验证:
go.mod 文件中不得包含未使用的依赖项,且必须符合
go mod tidy格式要求。 验证方式如下:若要在所有模块中触发操作(例如自动格式化所有文件),请使用或扩展以下脚本:
未来
作为指引方向的北极星,我们希望基于以下模型评估 etcd 模块:
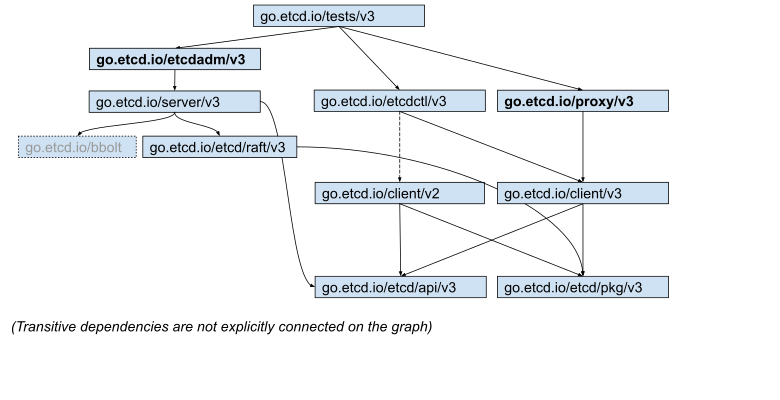
本文假设:
- 将 etcdmigrate/etcdadm 从 etcdctl 二进制文件中分离。 由此 etcdctl 将明确成为网络客户端 API 的命令行封装, 而 etcdmigrate/etcdadm 则支持对 etcd 存储文件的直接物理操作。
- 将 etcd-proxy 从 ./etcd 二进制文件中分离,因其包含更多实验性代码, 故带来额外风险与依赖。
- 废弃对 v2 协议的支持。
12 - 学习
12.1 - 数据模型
etcd 旨在可靠地存储更新频率较低的数据,并提供可靠的监听查询。etcd 通过暴露键值对的旧版本,支持低成本的快照和监听历史事件(“时间旅行查询”)。持久化、多版本、并发控制的数据模型非常适合这些应用场景。
etcd 将数据存储在多版本 持久化 键值存储中。当键值对的值被新数据覆盖时,持久化键值存储会保留该键值对的先前版本。键值存储本质上是不可变的;其操作不会就地更新结构,而是始终生成新的已更新结构。在修改后,所有历史版本的键仍可访问并可被监听。为防止数据存储随时间无限增长并避免长期保留旧版本,可对存储执行压缩以移除被覆盖数据的最旧版本。
逻辑视图
存储系统的逻辑视图是一个扁平的二进制键空间。键空间在字节字符串键上具有字典序排序的索引,因此范围查询的开销较低。
键空间维护多个修订版本。创建存储时,初始修订版本为 1。每次原子性修改操作(例如,事务操作可能包含多个操作)都会在键空间中创建一个新的修订版本。所有先前修订版本持有的数据保持不变。通过先前的修订版本仍可访问键的旧版本。同样,修订版本也进行了索引;通过监听器遍历修订版本的效率很高。若对存储执行压缩以节省空间,压缩修订版本之前的修订版本将被删除。在集群的生命周期内,修订版本单调递增。
键的生命周期跨越一个版本周期,从创建到删除。每个键可能拥有一个或多个版本周期。创建键会使其版本号递增,若该键在当前修订版本中不存在,则版本号从 1 开始。删除键会生成一个键墓碑,通过将版本号重置为 0 来结束该键的当前版本周期。对键的每次修改都会使其版本号递增;因此,在一个键的版本周期内,版本号单调递增。一旦执行压缩,所有在压缩修订版本之前结束的版本周期将被移除,且在压缩修订版本之前设置的值(除最新一个外)也将被移除。
物理视图
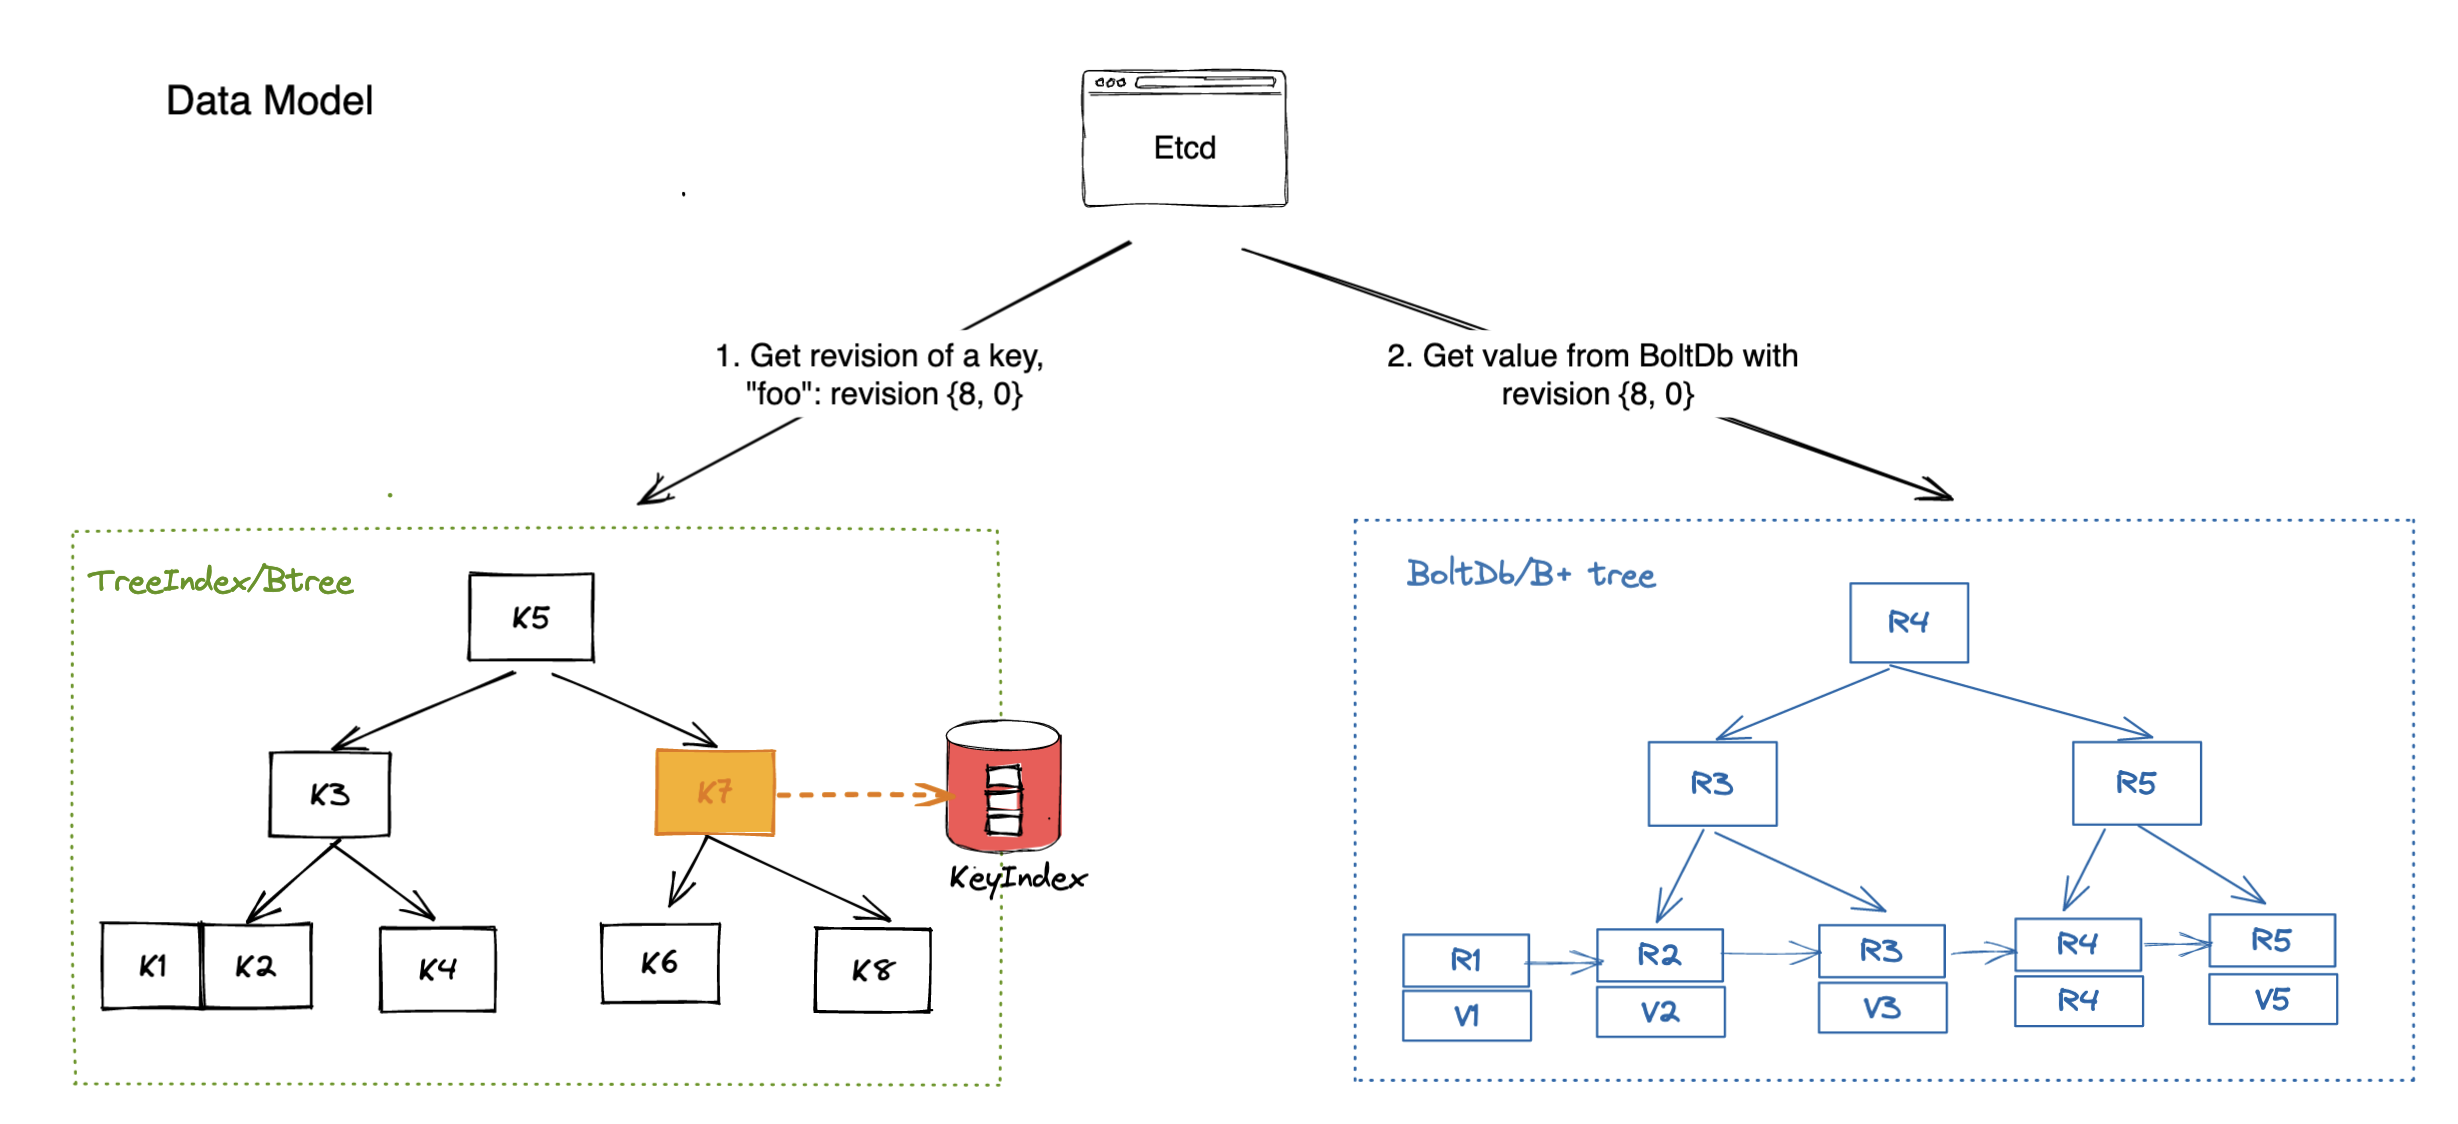
etcd 将物理数据以键值对的形式存储在持久化的 b+tree 中。存储系统状态的每个修订版本仅包含相对于前一修订版本的增量,以提高效率。单个修订版本可能对应树中的多个键。
键值对的键是一个三元组(主版本、子版本、类型)。主版本表示持有该键的存储修订版本。子版本用于区分同一修订版本内的不同键。类型是可选后缀,用于标识特殊值(例如,t 表示值中包含墓碑标记)。键值对的值包含相对于前一修订版本的修改内容,因此仅包含与前一修订版本的差异。B+ 树按键以字节序的字典序进行排序。对修订版本差异范围的查询操作快速;这使得能够快速定位从某一特定修订版本到另一修订版本的修改。压缩操作会移除过期的键值对。
etcd 还维护一个二级内存中的 btree 索引,以加速对键的范围查询。btree 索引中的键为存储系统向用户暴露的键。值为指向持久化 b+tree 修改记录的指针。执行压缩时会移除无效指针。
总体而言,etcd 从 btree 获取修订版本信息,然后使用该修订版本作为键,从 b+tree 中获取值(如下图所示)。
12.2 - etcd 客户端设计
etcd 客户端设计
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
简介
etcd 服务器通过多年的故障注入测试验证了其稳健性。大多数复杂的应用逻辑已由 etcd 服务器及其数据存储处理(例如,集群成员关系对客户端透明,提案通过 Raft 层转发至领导者)。尽管服务器组件本身正确,但其与客户端的组合需采用一组复杂的协议,以确保在故障条件下仍能保证正确性和高可用性。理想情况下,etcd 服务器为多台物理机器提供单一逻辑集群视图,客户端则实现副本间的自动故障转移。本文档描述客户端的架构决策及其具体实现细节。
术语表
clientv3:etcd v3 API 的官方 Go 客户端。
clientv3-grpc1.0:官方客户端实现,包含 grpc-go v1.0.x
,在最新版 etcd v3.1 中使用。
clientv3-grpc1.7:官方客户端实现,包含 grpc-go v1.7.x
,用于最新版 etcd v3.2 和 v3.3。
clientv3-grpc1.23:官方客户端实现,包含 grpc-go v1.23.x
,在最新版 etcd v3.4 中使用。
负载均衡器:etcd 客户端负载均衡器,实现重试和故障转移机制。etcd 客户端应能自动在多个端点之间均衡负载。
端点:客户端可连接的 etcd 服务器端点列表。通常为 etcd 集群的 3 个或 5 个客户端 URL。
固定端点:当配置多个端点时,v3.3 及更早版本的客户端负载均衡器仅选择一个端点建立 TCP 连接,以减少与 etcd 集群的总连接数。在 v3.4 版本中,负载均衡器对固定端点采用轮询策略,每个请求均轮询不同端点,从而实现更均衡的负载分布。
客户端连接:通过 gRPC Dial 建立的与 etcd 服务器的 TCP 连接。
子连接:gRPC SubConn 接口。每个子连接包含一个地址列表。负载均衡器根据解析后的地址列表创建子连接。gRPC 客户端连接可以映射到多个子连接(例如,example.com 解析为 10.10.10.1 和 10.10.10.2 两个子连接)。etcd v3.4 负载均衡器采用内部解析器,为每个端点建立一个子连接。
瞬时断开连接:当 gRPC 服务器返回状态错误 code Unavailable
时。
客户端要求
正确性。在服务器发生故障时,请求可能会失败。然而,这绝不会违反一致性保证:全局顺序性、永不写入损坏数据、可变操作的至多一次语义、监听不会观察到部分事件等。
存活性。服务器可能会短暂地发生故障或断开连接。客户端应能在这两种情况下均继续推进。客户端应 永不发生死锁 ,等待服务器从离线状态恢复,除非已配置为如此。理想情况下,客户端通过 HTTP/2 ping 检测不可用的服务器,并向其他节点进行故障转移,同时提供明确的错误信息。
有效性。客户端应以最少资源高效运行:在端点切换后,先前的 TCP 连接应 优雅关闭 。故障转移机制应能有效预测下一个要连接的副本,避免对已失败节点进行无谓重试。
可移植性。官方客户端应有清晰的文档说明,其实现应适用于其他语言绑定。不同语言绑定之间的错误处理应保持一致。由于 etcd 完全致力于 gRPC,实现应与 gRPC 长期设计目标紧密对齐(例如,可插拔重试策略应与 gRPC retry 兼容)。两个客户端版本之间的升级应为非中断式。
客户端概述
etcd 客户端实现了以下组件:
- 用于与 etcd 集群建立 gRPC 连接的负载均衡器,
- 用于向 etcd 服务器发送 RPC 的 API 客户端,以及
- 决定是否重试失败请求或切换端点的错误处理程序。
不同语言在建立初始连接(例如配置 TLS)、编码并发送 Protocol Buffer 消息至服务器、处理流式 RPC 等方面可能存在差异。然而,etcd 服务器返回的错误将保持一致。因此,错误处理和重试策略也应保持一致。
例如,etcd 服务器可能返回 "rpc error: code = Unavailable desc = etcdserver: request timed out",该错误为瞬态错误,应进行重试。或返回 rpc error: code = InvalidArgument desc = etcdserver: key is not provided,表示请求无效,不应重试。Go 客户端可使用 google.golang.org/grpc/status.FromError 解析错误,Java 客户端可使用 io.grpc.Status.fromThrowable。
clientv3-grpc1.0:负载均衡器概述
clientv3-grpc1.0 在配置多个 etcd 端点时,会维持多个 TCP 连接。随后选择一个地址,并使用该地址发送所有客户端请求。所固定的地址会一直保持,直至客户端对象关闭(参见 图 1)。当客户端收到错误时,会随机选择另一个地址并重试。
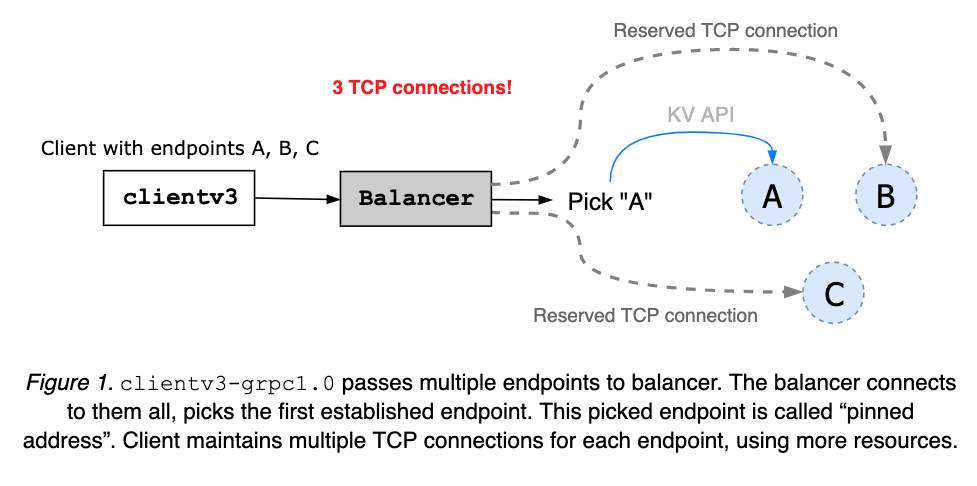
clientv3-grpc1.0:负载均衡器限制
clientv3-grpc1.0 同时打开多个 TCP 连接可提供更快的负载均衡器故障转移,但需要更多资源。负载均衡器不了解节点的健康状态或集群成员关系,因此可能出现负载均衡器卡在某个已失败或分区的节点上的情况。
clientv3-grpc1.7:负载均衡器概述
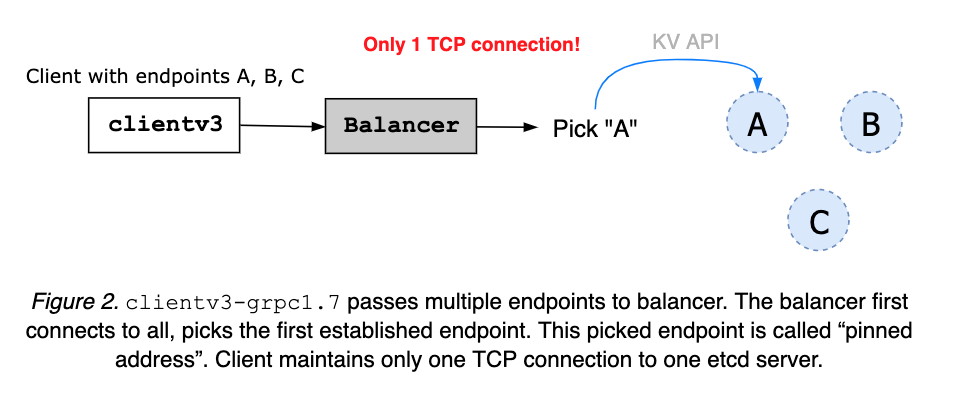
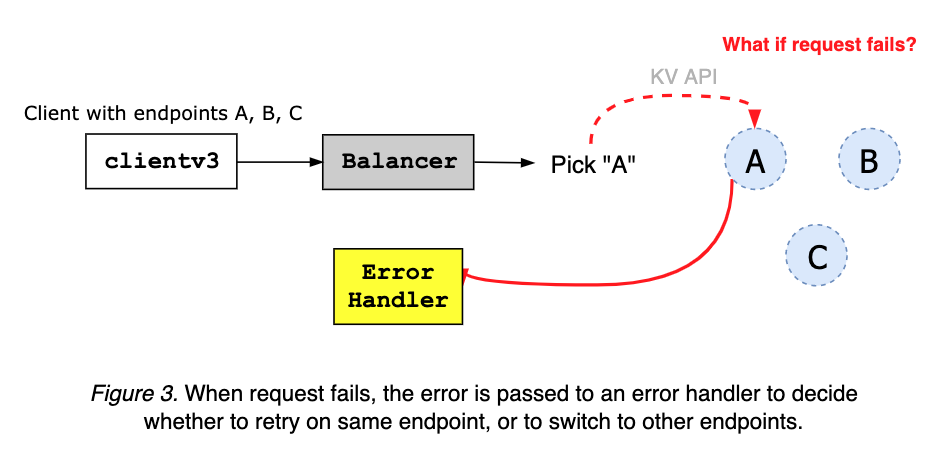
clientv3-grpc1.7 仅与选定的 etcd 服务器维持一个 TCP 连接。当提供多个集群端点时,客户端会尝试连接所有端点。一旦建立任一连接,负载均衡器即固定该地址,并关闭其他连接(参见 图 2)。该固定地址需保持至客户端对象关闭。若发生服务器错误或客户端网络故障,错误将被发送至客户端错误处理程序(参见 图 3)。
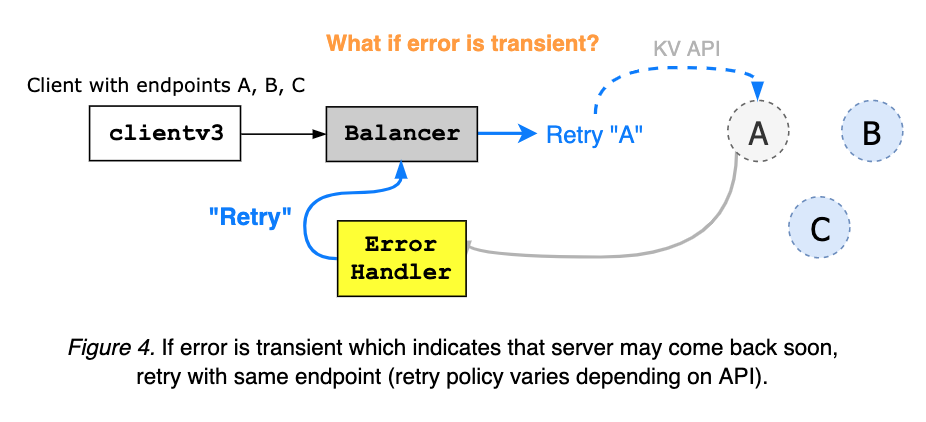
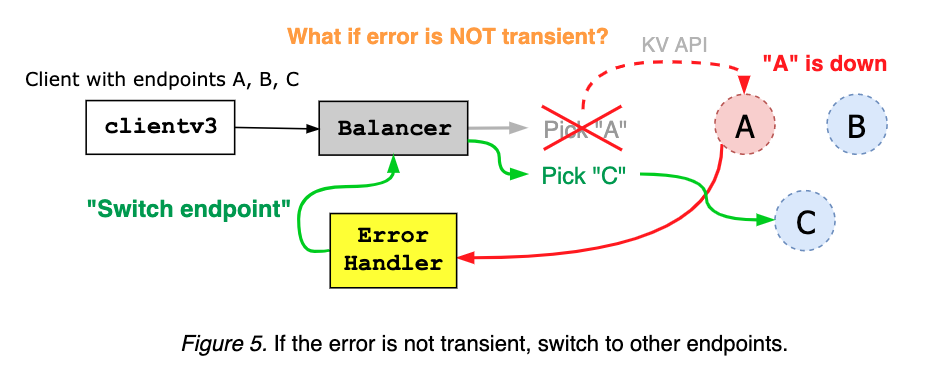
客户端错误处理程序接收来自 gRPC 服务器的错误,并根据错误码和错误信息决定是在同一端点重试,还是切换到其他地址(参见 图 4 和 图 5)。
流式 RPC,例如监听(Watch)和保活(KeepAlive),通常在无超时的情况下发起请求。客户端可定期发送 HTTP/2 保活 ping 来检查已绑定端点的状态;若服务器未响应 ping,负载均衡器将切换至其他端点(参见 图 6)。
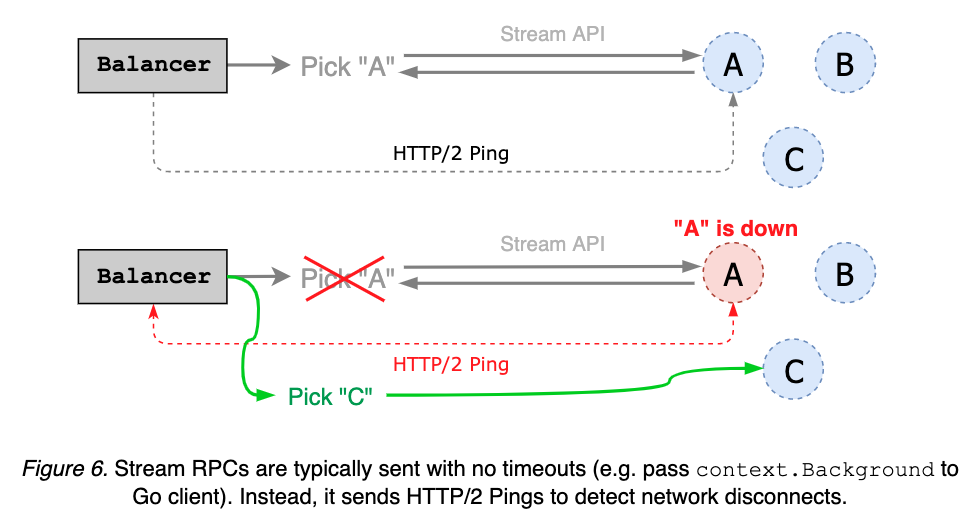
clientv3-grpc1.7:负载均衡器限制
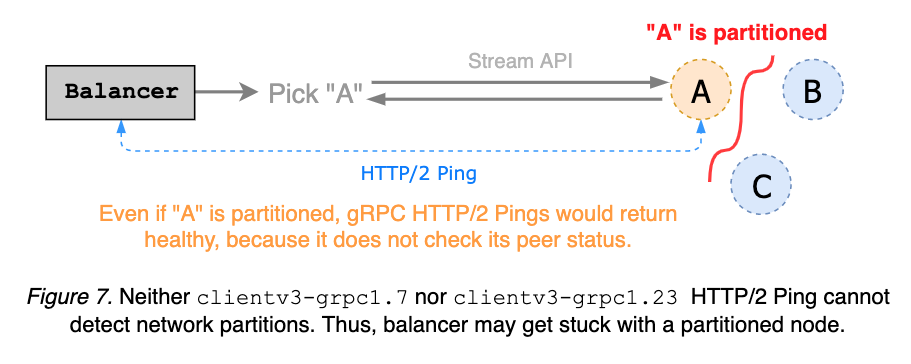
clientv3-grpc1.7 负载均衡器通过 HTTP/2 保活机制检测流式请求的断连。这是一种简单的 gRPC 服务器 ping 机制,不涉及集群成员关系的判断,因此无法检测网络分区。由于被分区的 gRPC 服务器仍可响应客户端 ping,负载均衡器可能陷入与分区节点的连接中。理想情况下,保活 ping 应在请求超时前检测到分区并触发端点切换(参见 etcd#8673
和 图 7)。
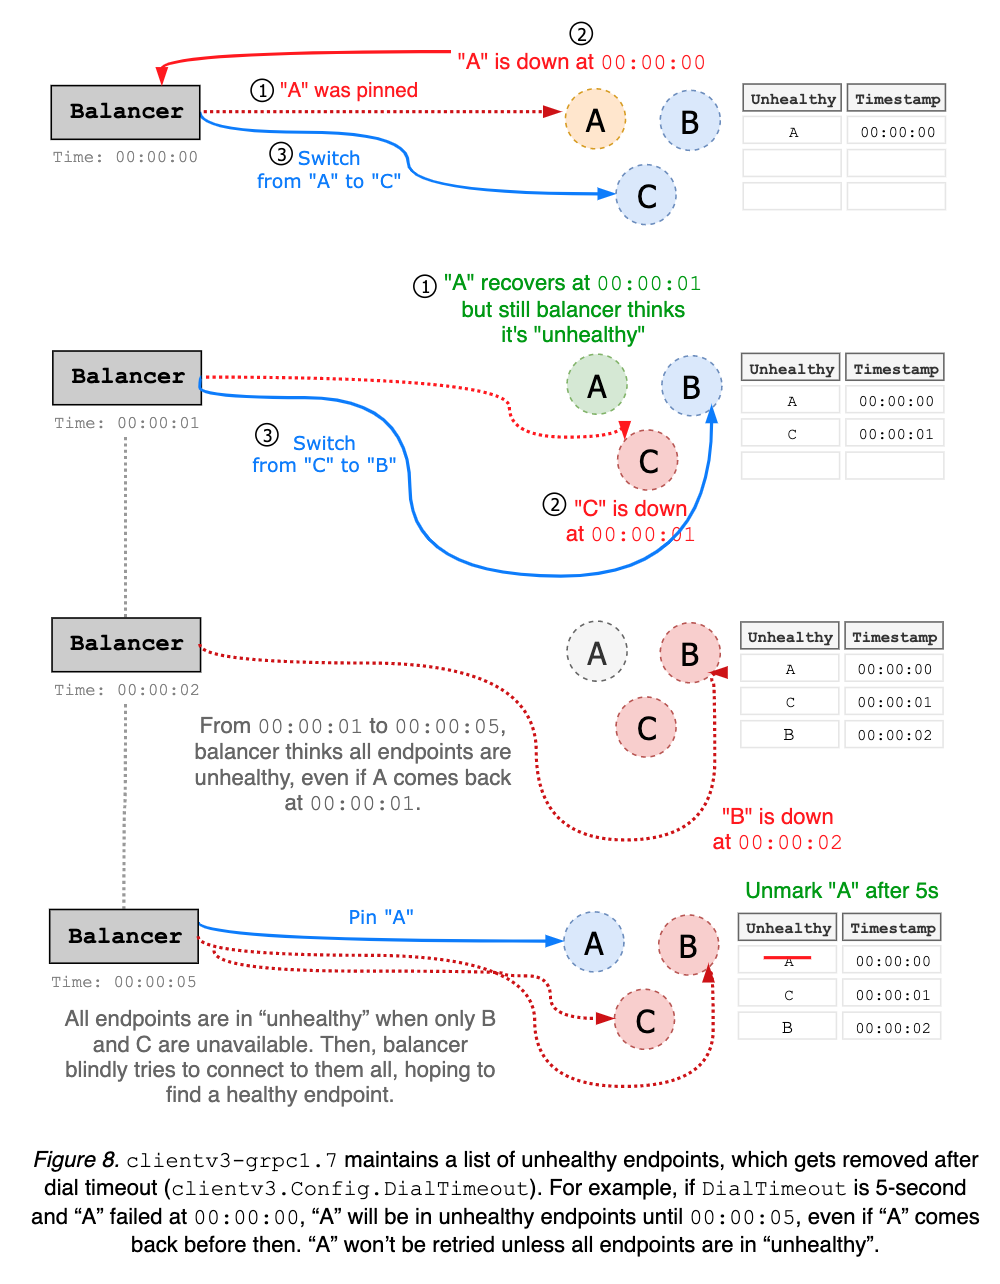
clientv3-grpc1.7 负载均衡器维护一个不健康端点列表。断开连接的地址会被加入“不健康”列表,并在等待时长过后才被视为可用,该等待时长硬编码为连接超时时间,默认值为 5 秒。负载均衡器可能对哪些端点不健康产生误判。例如,端点 A 可能在被标记为黑名单后立即恢复,但在接下来的 5 秒内仍不可用(参见 图 8)。
clientv3-grpc1.0 遇到了上述相同的问题。
上游 gRPC Go 已经迁移到新的负载均衡接口。例如,clientv3-grpc1.7 的底层负载均衡实现使用了新的 gRPC 负载均衡机制,并努力与旧负载均衡行为保持一致。尽管兼容性已得到合理维护,etcd 客户端仍然 遭受了细微的破坏性变更
。此外,gRPC 维护者建议 不要依赖旧的负载均衡接口
。通常而言,为获得上游更好的支持,最好与最新的 gRPC 发布版本保持同步。此外,新功能(如重试策略)可能不会回溯到 gRPC 1.7 分支。因此,etcd 服务器和客户端都必须迁移到最新的 gRPC 版本。
clientv3-grpc1.23:负载均衡器概述
clientv3-grpc1.7 与旧版 gRPC 接口耦合过于紧密,导致每次 gRPC 依赖升级都会破坏客户端行为。大部分开发与调试工作都用于修复这些客户端行为变更。结果,其实现变得过于复杂,并基于对服务器连接性的错误假设。
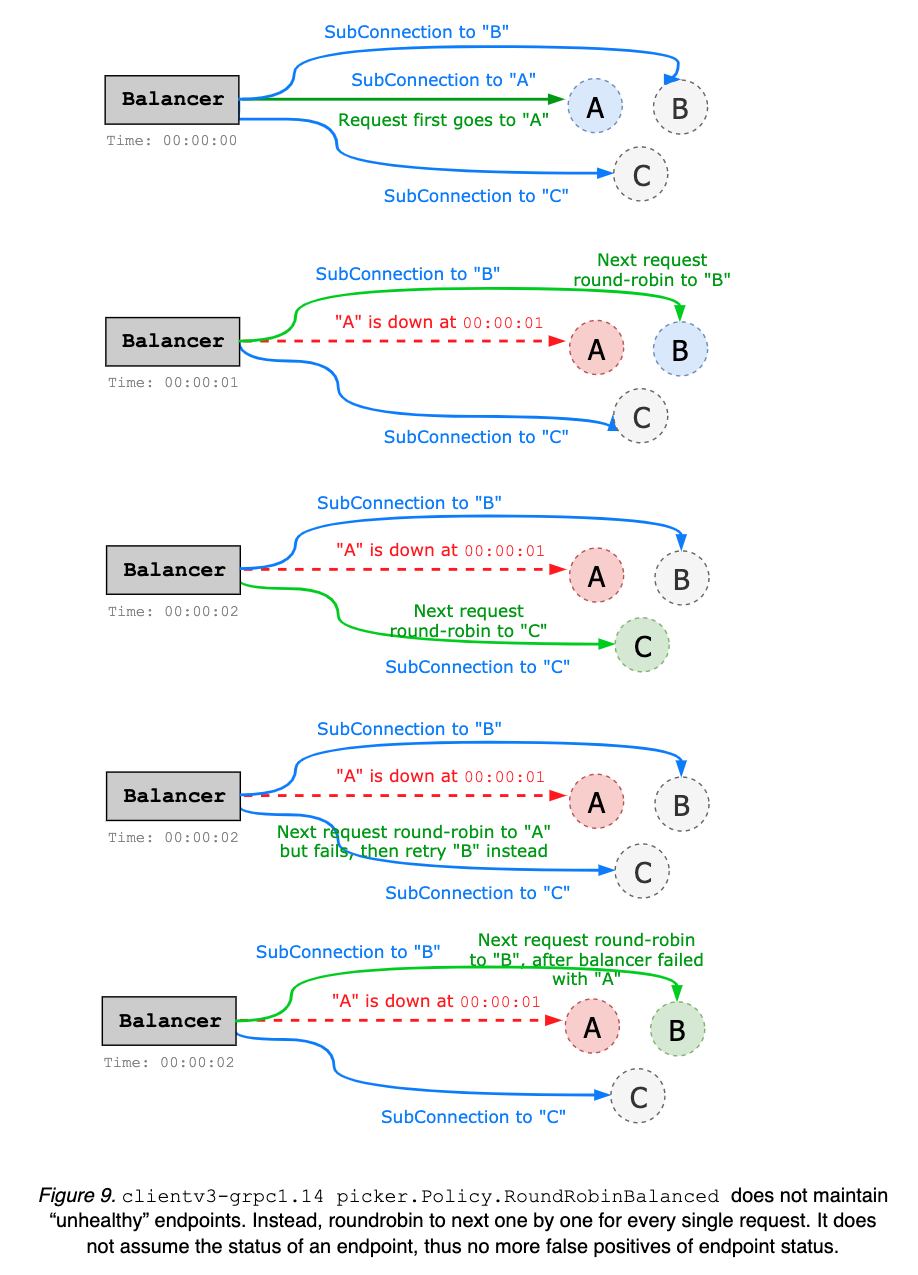
clientv3-grpc1.23 的主要目标是简化负载均衡器的故障转移逻辑:当客户端与当前端点断开连接时,不再维护一个可能已过时的不健康端点列表,而是直接轮询下一个端点。该机制不假设端点状态,因此无需再进行复杂的健康状态跟踪(参见 图 8 及以上内容)。升级至 clientv3-grpc1.23 不应存在问题;所有变更均为内部实现,同时保持了全部向后兼容性。
内部,当提供多个端点时,clientv3-grpc1.23 会创建多个子连接(每个端点对应一个子连接),而 clientv3-grpc1.7 仅连接到一个固定的端点(参见 图 9)。例如,在 5 节点集群中,clientv3-grpc1.23 负载均衡器需要 5 个 TCP 连接,而 clientv3-grpc1.7 仅需一个。通过保持 TCP 连接池,clientv3-grpc1.23 可能消耗更多资源,但能提供更具灵活性的负载均衡器,并具备更优的故障转移性能。默认的负载均衡策略为轮询,但可轻松扩展以支持其他类型的负载均衡器(例如,两倍选择、选择领导者等)。clientv3-grpc1.23 使用 gRPC 解析器组并实现负载均衡选择器策略,将复杂的负载均衡工作交由上游 gRPC 处理。另一方面,clientv3-grpc1.7 手动处理每个 gRPC 连接及负载均衡器故障转移,这增加了实现的复杂性。clientv3-grpc1.23 在 gRPC 拦截器链中实现重试机制,可自动处理 gRPC 内部错误,并支持更高级的重试策略(如指数退避),而 clientv3-grpc1.7 则需手动解析 gRPC 错误以实现重试。
clientv3-grpc1.23:负载均衡器限制
可通过缓存每个端点的状态来提升性能。例如,负载均衡器可预先 ping 每个服务器,以维护健康候选端点列表,并在轮询时使用该信息。或在断开连接时,负载均衡器可优先选择健康端点。这可能会增加负载均衡器实现的复杂性,因此可留待后续版本再行处理。
客户端保活 ping 仍不考虑网络分区情况。流式请求在与分区节点通信时可能陷入停滞。需实现高级健康检查服务以准确理解集群成员关系(详见 etcd#8673 )。
目前,重试逻辑需手动作为拦截器处理。可通过 官方 gRPC 重试 简化此过程。
12.3 - etcd 学习者成员设计
etcd 学习者成员
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
背景
成员变更配置一直是运维中最大的挑战之一。回顾常见问题。
1. 集群成员过载领导者
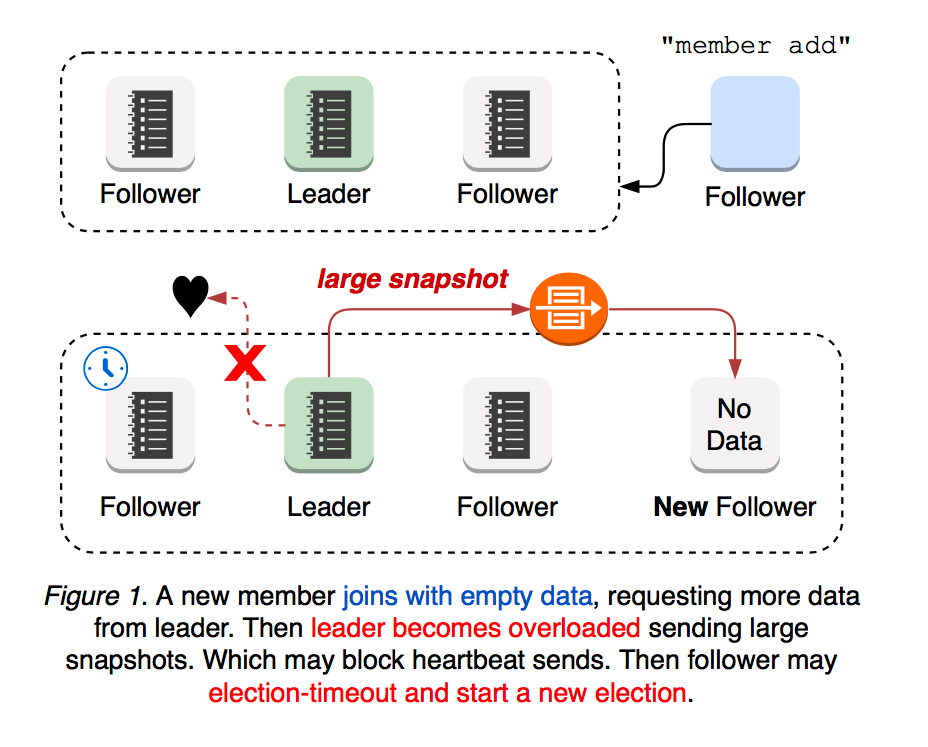
新加入的 etcd 成员初始时无任何数据,因此需要从领导者获取更多更新,直到其日志与领导者同步。此时,领导者网络更可能因负载过重而阻塞或丢弃发往跟随者的心跳。在这种情况下,跟随者可能因选举超时而发起新的领导者选举。也就是说,包含新成员的集群更容易发生领导者选举。领导者选举以及随后向新成员传播更新的过程均可能导致集群不可用的时段(参见 图 1)。
2. 网络分区场景
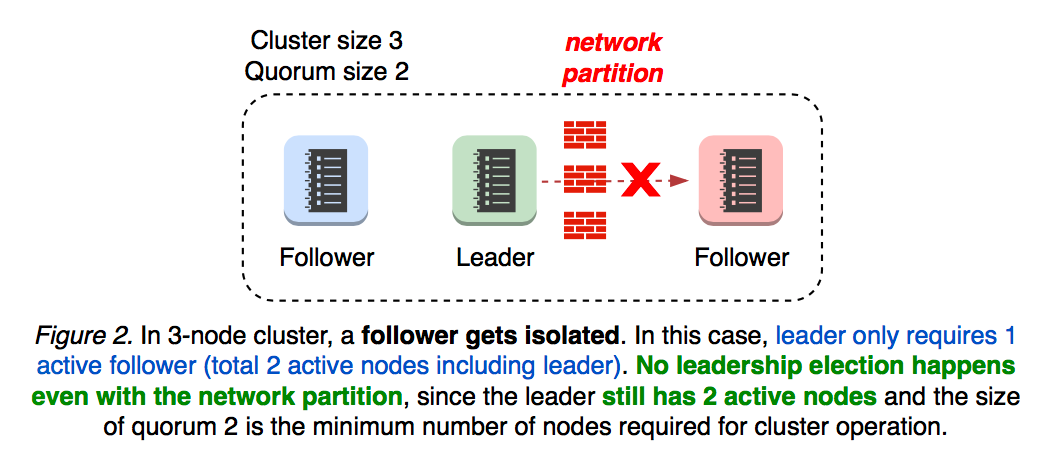
网络分区发生时会怎样?这取决于领导者是否仍能维持法定人数。如果领导者仍能保持活跃的法定人数,集群将继续运行(参见 图 2)。
2.1 领导者隔离
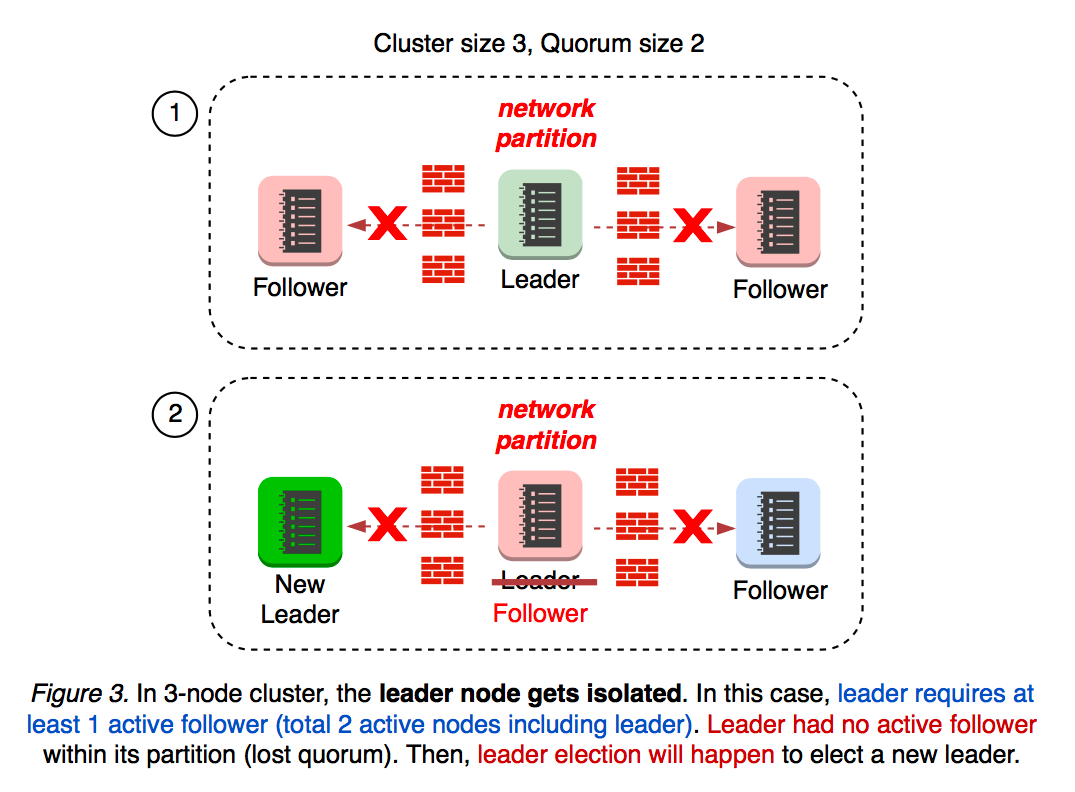
如果领导者与集群其余部分隔离,会发生什么?领导者会监控每个跟随者的进度。当领导者与法定人数失去连接时,它将回退为跟随者,这会影响集群的可用性(参见 图 3)。
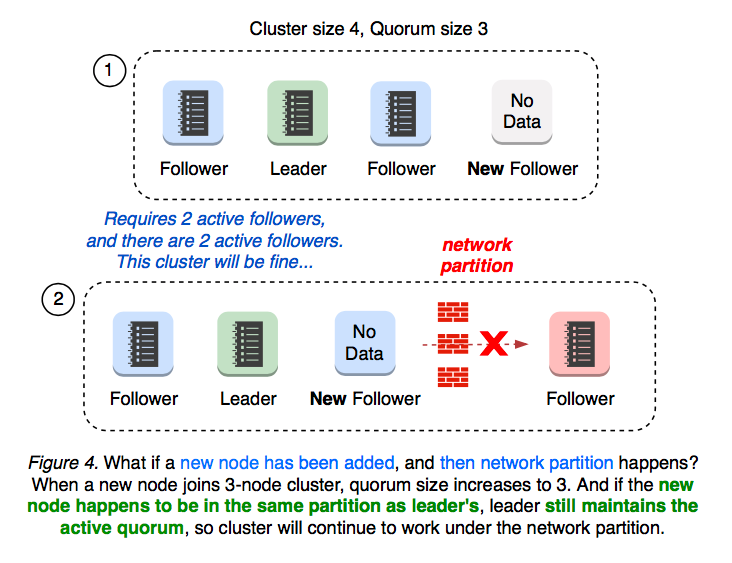
当向 3 个节点的集群添加新节点时,集群规模变为 4,法定人数规模变为 3。如果新节点加入集群后发生网络分区,结果取决于新成员在分区后位于哪个分区。
2.2 集群分裂 3+1
如果新节点恰好位于领导者所在的同一分区中,领导者仍能维持由 3 个节点组成的活跃法定人数。不会发生领导权选举,集群可用性也不会受到影响(参见 图 4)。
2.3 集群分裂 2+2
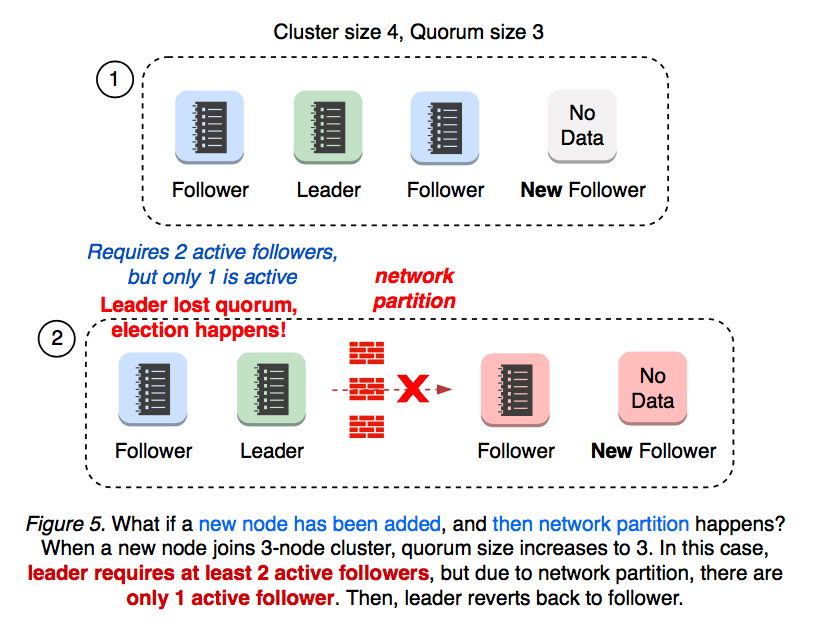
如果集群出现 2-2 分区,则任一分区均无法维持 3 个节点的法定人数。此时将触发领导权选举(参见 图 5)。
2.4 法定人数丢失
如果网络分区先发生,随后再添加新成员会怎样?一个已处于分区状态的 3 节点集群中,已有 1 个跟随者与集群断开连接。当添加新成员后,法定人数从 2 变为 3。此时,集群中仅有 4 个节点中的 2 个处于活跃状态,导致失去法定人数,并启动新的领导权选举(参见 图 6)。
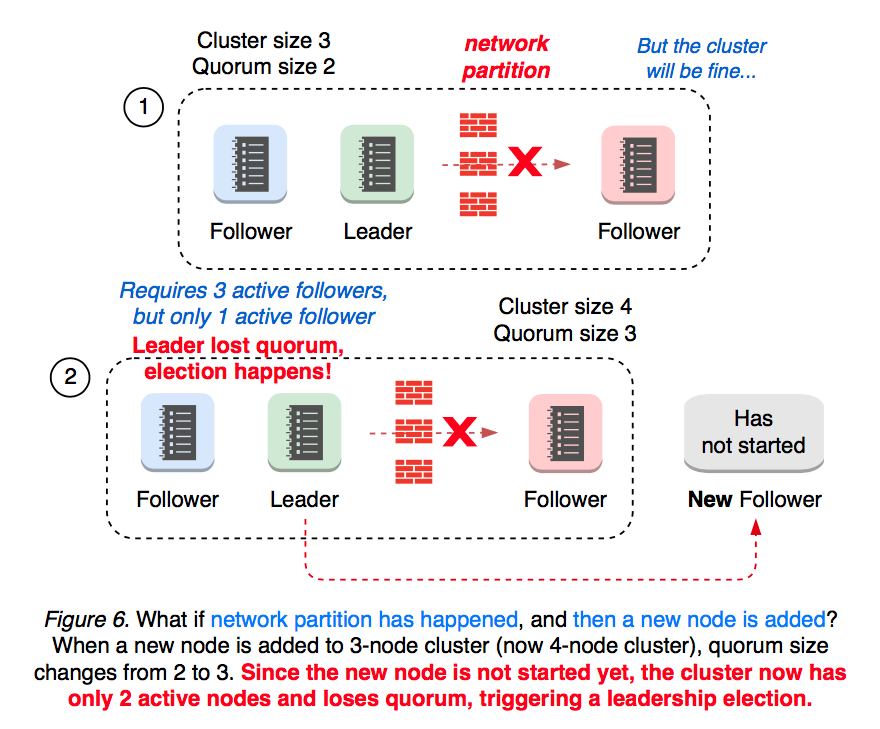
由于成员添加操作可能改变法定人数规模,因此始终建议先执行“member remove”以替换不健康的节点。
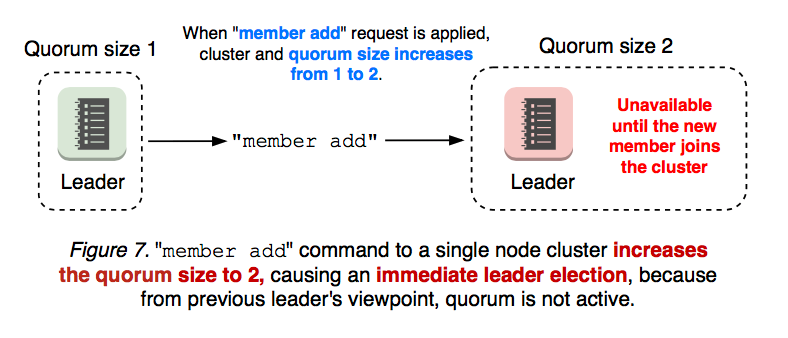
向单节点集群添加新成员会将法定人数大小更改为 2,当原领导者发现法定人数不再活跃时,会立即触发选举。这是因为“member add”操作是一个两步过程,用户需先执行“member add”命令,然后启动新节点进程(参见 图 7)。
3. 集群配置错误
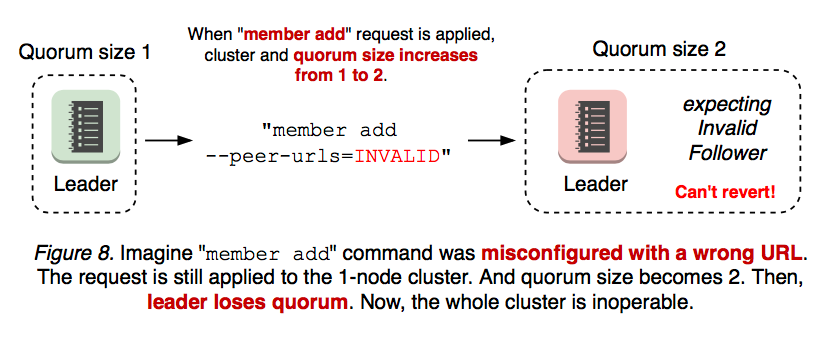
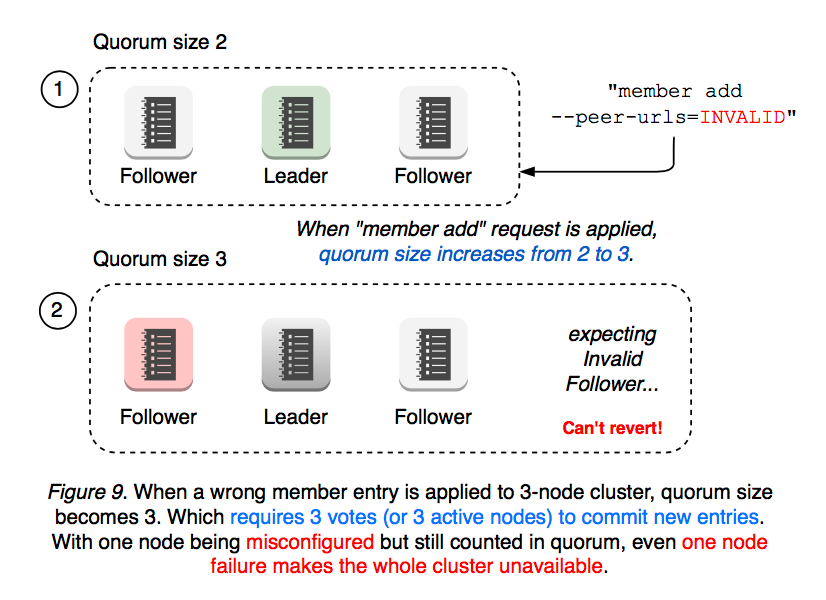
更严重的情况是,当新增成员配置错误时。成员变更是一项两步操作:首先执行“etcdctl member add”,然后使用指定的对等成员 URL 启动 etcd 服务器进程。也就是说,“member add” 命令的执行不依赖于 URL 的有效性,即使 URL 值无效也会被应用。若第一步使用了无效的 URL,第二步将无法启动新的 etcd 实例。一旦集群失去法定人数,就无法回滚成员变更(参见 图 8)。
多节点集群情况亦同。例如,集群中有两个成员离线(一个已故障,另一个配置错误),两个成员在线,但此时更改集群成员关系至少需要 3 票(参见 图 9)。
如上所述,一个简单的配置错误可能导致整个集群进入无法运行的状态。在此情况下,操作员需手动使用 etcd --force-new-cluster 标志重建集群。随着 etcd 成为 Kubernetes 的关键任务服务,哪怕是最轻微的中断也可能对用户造成重大影响。我们能否进一步优化,使 etcd 的此类操作更加简便?在诸多方面中,领导者选举对集群可用性最为关键:能否通过不改变法定人数规模的方式,降低成员配置变更的干扰?新节点是否可以处于空闲状态,仅从领导者请求最小量的更新,直至完成同步?成员配置错误是否始终可逆,并以更安全的方式处理(错误执行成员添加命令不应导致集群失败)?用户在添加新成员时是否需要担心网络拓扑?成员添加 API 是否应与节点位置及正在进行的网络分区无关而正常工作?
Raft 学习者成员
为缓解上一节所述的可用性缺口,Raft §4.2.1 引入了一种新的节点状态“学习者成员”,该成员以非投票成员身份加入集群,直至其日志与领导者日志同步。
v3.4 版本特性
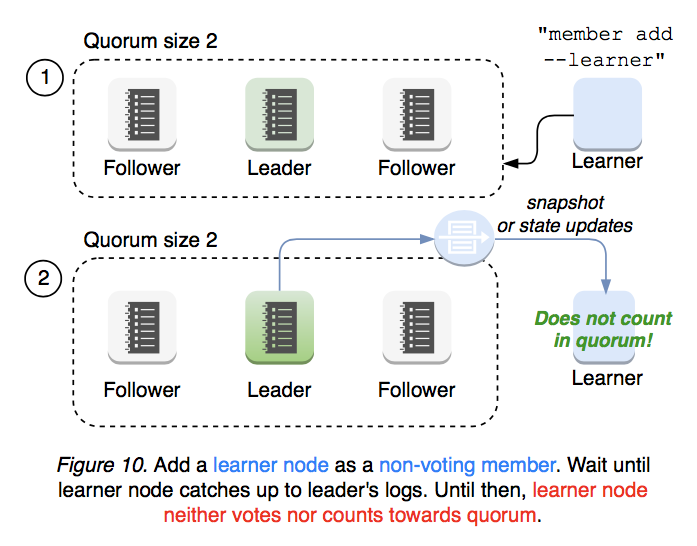
操作员应尽可能减少添加新学习者成员的工作量。使用 member add --learner 命令添加新的学习者成员,该成员以非投票成员身份加入集群,但仍接收来自领导者的全部数据(参见 图 10)。
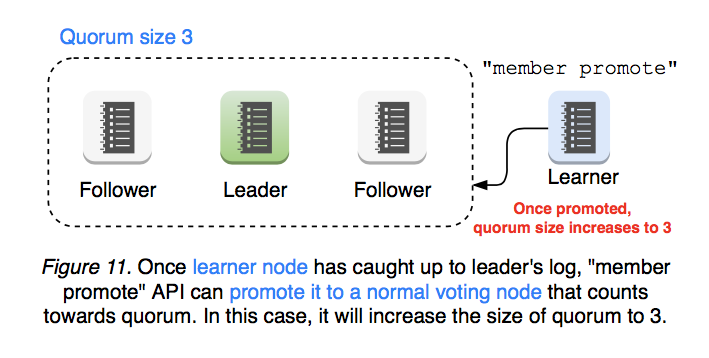
当学习者成员已追上领导者进度时,可使用 member promote API 将其晋升为投票成员,该成员将计入法定人数(参见 图 11)。
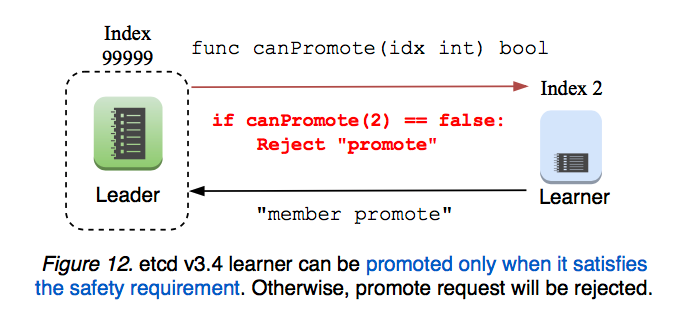
etcd 服务器会验证提升请求,以确保操作安全。只有当学习者成员的日志已追赶上领导者时,才能将其提升为投票成员(参见 图 12)。
学习者成员仅作为备用节点,直到被提升:领导权无法转移至学习者成员。学习者成员拒绝客户端读写请求(客户端负载均衡器不应将请求路由至学习者成员)。这意味着学习者成员无需向领导者发起读索引请求。此限制简化了 v3.4 版本中学习者成员功能的初始实现(参见 图 13)。
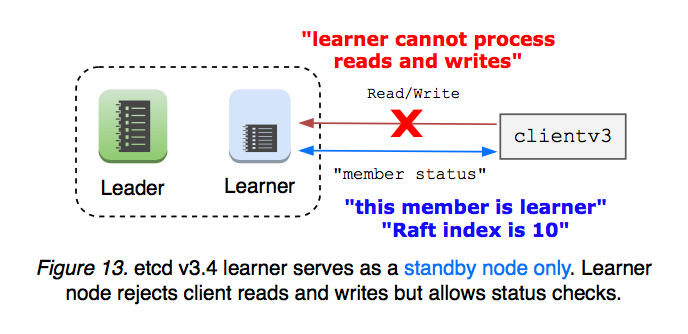
此外,etcd 限制了集群可拥有的学习者成员总数,以避免领导者因日志复制而过载。学习者成员不会自行晋升。尽管 etcd 提供了学习者成员状态信息和安全检查,但集群操作员必须最终决定是否晋升学习者成员。
未来版本的待定功能
仅启用学习者成员状态并设为默认:将新成员状态默认设为学习者成员可显著提升成员配置变更的安全性,因为学习者成员不会影响法定人数的大小。配置错误始终可逆,且不会导致法定人数丢失。
实现学习者成员晋升的完全自动化:当学习者成员追赶上领导者的日志后,集群可自动将其晋升为投票成员。etcd 要求操作员定义特定阈值,一旦满足条件,学习者成员将自动晋升为投票成员。从操作员视角看,“member add” 命令的使用方式与当前一致,但通过学习者成员功能提供了更高的安全性。
将学习者成员设为备用故障转移节点:学习者成员以备用节点身份加入集群,当集群可用性受到影响时,将自动被提升为可用节点。
使学习者成员为只读:学习者成员可作为只读节点,且永远不会被提升为投票成员。在弱一致性模式下,学习者成员仅从领导者接收数据,且从不处理写入操作。通过本地提供读取服务而无需共识开销,可显著降低领导者的工作负载,但可能提供过时数据。在强一致性模式下,学习者成员会向领导者请求读索引以提供最新数据,但仍拒绝写入操作。
学习者成员与镜像制作器
etcd 使用监听 API 实现“镜像制作器”,以持续将键的创建和更新同步到另一个集群。镜像同步在完成初始同步后,通常具有较低的延迟开销。学习者成员与镜像同步存在重叠,二者均可用于复制现有数据以供只读访问。然而,镜像同步不保证线性一致性。在网络断开期间,先前的键值可能已被丢弃,客户端应验证监听响应以确保正确顺序。因此,镜像同步不提供顺序保证。在需要最低延迟(例如跨数据中心)的场景下,可使用镜像同步,但需承担一致性损失。如需保留所有历史数据及其顺序,应使用学习者成员。
附录:v3.4 中的学习者成员实现
将“Learner”节点类型暴露给“MemberAdd”API。
etcd 客户端在 “MemberAdd” API 中添加了一个用于学习者成员的标志。etcd 服务器处理程序会以 pb.ConfChangeAddLearnerNode 类型应用成员变更条目。命令应用完成后,服务器将以 etcd --initial-cluster-state=existing 标志加入集群。该学习者成员既不能投票,也不能计入法定人数。
etcd 服务器不得将领导权转移给学习者成员,因为学习者成员可能仍存在延迟,且不计入法定人数。etcd 服务器限制集群中学习者成员的数量为一个:学习者成员越多,领导者需传播的数据就越多。客户端可以与学习者成员通信,但学习者成员仅接受可串行化读取和成员状态 API 请求,拒绝所有其他请求。这是为了简化初始实现。未来,学习者成员可扩展为持续同步集群数据的只读服务器。客户端负载均衡器必须提供辅助函数以排除学习者成员的端点。否则,发送至学习者成员的请求可能失败。客户端同步成员调用应考虑学习者成员类型。客户端端点更新调用也应如此。
MemberList 和 MemberStatus 的响应应明确指出哪个节点是学习者成员。
添加 “MemberPromote” API。
在 Raft 内部,对学习者成员的第二次 MemberAdd 调用会将其提升为投票成员。领导者维护每个跟随者和学习者成员的进度。若学习者成员尚未完成其快照消息,则拒绝提升请求。仅当且仅当满足以下条件时,才接受提升请求:学习者成员处于健康状态;学习者成员与领导者同步,或偏差在阈值范围内(例如,需复制至学习者成员的条目数量少于快照数量的 1/10,这意味着即使在提升后,领导者也几乎无需再向学习者成员发送快照)。所有这些逻辑均硬编码在 etcdserver 包中,不可配置。
参考
- 原始 GitHub 问题:etcd#9161
- 使用场景:etcd#3715
- 使用场景:etcd#8888
- 使用场景:etcd#10114
12.4 - etcd v3 身份认证设计
为什么不重用 v2 认证系统?
v3 协议使用 gRPC 作为传输机制,而非 v2 所采用的 RESTful 接口。这一新协议为迭代和改进 v2 设计提供了机会。例如,v3 身份认证采用基于连接的身份认证,而非 v2 每请求身份认证的较慢方式。此外,v2 身份认证在实际应用中关于一致性推理的语义往往难以处理,这一点将在后续章节中详述。对于 v3,身份认证机制具有明确定义的描述和实现,解决了 v2 身份认证系统中的缺陷。
功能要求
- 按连接进行身份认证,而非按请求
- 为 gRPC API 实现基于用户 ID 和密码的身份认证
- 身份认证策略变更后必须重新刷新认证
- 功能应与 v2 版本一样简单且实用
- v3 提供扁平键空间,不同于 v2 的目录结构。权限检查将通过区间匹配实现。
- 其一致性保证应强于 v2 版本的身份认证
主要必要更改
- 客户端必须在发送已身份认证的请求前,仅通过专用连接完成身份认证
- 将权限信息(用户 ID 和授权的修订版本)添加到 Raft 命令中(
etcdserverpb.InternalRaftRequest) - 每个请求均在状态机层进行权限检查,而非 API 层
权限元数据一致性
认证相关的元数据也应像 etcd 中存储的其他数据一样,由 etcd 的 Raft 协议所控制的存储系统进行存储和管理。这是确保整个 etcd 集群可用性与一致性的必要条件。若读取或写入元数据(例如权限信息)需要所有节点达成一致(超过法定人数),则单个节点故障可能导致整个集群停止运行。要求所有节点同时达成一致,意味着只要任一集群成员离线,即使集群仍拥有可用的法定人数,普通读写请求也无法完成。这种全票通过机制最终会降低集群的可用性;而基于 Raft 的法定人数共识机制已足够,因为一致性排序自然带来共识。
etcd v2 协议中的身份认证机制存在一个复杂之处:元数据一致性应如上所述工作,但实际上并非如此。每个权限检查均由接收客户端请求的 etcd 成员(server/etcdserver/api/v2http/client.go)处理,包括跟随者成员。因此,检查结果可能基于过时的元数据。
此过时状态意味着,当操作员执行 etcdctl 时,认证配置无法立即反映。因此,无法知晓过时元数据的活跃时长。实际上,配置变更在命令执行后会立即生效。然而,在高负载情况下,不一致状态可能持续较长时间,从而导致用户和开发者遇到反直觉的情况。此时需采用如 this 的变通方案。
线性化请求存在不一致的权限是不安全的
对写操作而言,身份认证状态不一致是最严重的问题。即使管理员已禁用某个用户的写权限,如果写操作仅相对于键值存储有序,而未相对于身份认证系统有序,仍可能导致写操作成功完成。若身份认证存储与键值存储之间缺乏有序性,系统将容易受到过期权限攻击。
因此,权限检查逻辑应添加到 etcd 的状态机中。每个状态机应在应用阶段(apply phase)根据其权限信息检查请求(因此权限信息不得过期)。
设计与实现
身份认证
首先,客户端必须仅通过 gRPC 连接来完成身份认证,以验证其用户 ID 和密码。etcd 服务器将返回身份认证响应。认证成功时,响应中包含身份认证令牌;认证失败时,返回错误信息。客户端可在发起 API 请求时,使用该身份认证令牌向 etcd 提交其凭证。
用于请求身份认证令牌的客户端连接通常会被丢弃;该连接无法携带新令牌的凭据。这是因为 gRPC 不提供在连接创建后为每个 RPC 添加凭据的方式(调用 grpc.Dial())。因此,客户端无法将其通过连接获取的令牌分配给该连接。客户端需要建立新的连接以使用该令牌。
Authenticate() RPC 的实现说明
Authenticate() RPC 根据给定的用户名和密码生成身份认证令牌。etcd 使用 Go 的 bcrypt 包来保存和校验配置的密码与提供的密码。按照设计,bcrypt 的密码校验机制计算开销较大,在普通 x64 服务器上耗时接近 100 毫秒。因此,在状态机应用阶段执行此校验会导致性能问题:整个 etcd 集群每秒仅能处理约 10 Authenticate() 个请求。
为保证良好性能,v3 认证机制在 etcd 的 API 层检查密码,该层可在 Raft 之外并行处理。然而,这可能导致潜在的检查时间与使用时间(TOCTOU)权限漏洞:
- 客户端 A 发送请求
Authenticate() - API 层处理
Authenticate()的密码检查部分 - 另一个客户端 B 发送请求
ChangePassword(),服务器完成该请求 - 状态机层处理从
Authenticate()获取修订版本号的部分 - 服务器向 A 返回成功
- 此时 A 已使用过期的密码完成认证
为避免此类情况,API 层基于认证存储的修订版本执行 版本号验证。在检查密码时,API 层会保存认证存储的修订版本号。密码检查成功后,API 层将保存的修订版本号与最新的修订版本号进行比较。若两者不同,说明其他用户已更新认证元数据,因此会重试检查。通过该机制,可避免基于过时密码的密码检查成功。
解析 API 层中的令牌
在使用 Authenticate() 完成认证后,客户端可像未启用认证时一样建立 gRPC 连接。除原有的初始化流程外,客户端必须将令牌与新创建的连接关联。grpc.WithPerRPCCredentials() 提供了实现此目的的功能。
每个来自客户端的已认证请求均包含一个令牌。该令牌可通过服务器端的 grpc.metadata.FromIncomingContext() 获取。服务器可获取请求的发起者信息以及用户授权时间。相关信息将由 API 层填充至 Raft 日志条目(etcdserverpb.InternalRaftRequest)的头(etcdserverpb.RequestHeader.Username 和 etcdserverpb.RequestHeader.AuthRevision)。
检查状态机中的权限
在状态机的 apply 阶段检查 etcdserverpb.RequestHeader 中的认证信息。此步骤验证用户是否被授予对认证存储最新修订版本下所请求键的访问权限。
两种令牌类型:简单令牌和 JWT
有两种类型的令牌:简单令牌和 JWT 令牌。简单令牌不适用于生产环境。其令牌未经过加密签名,服务器必须有状态地维护令牌与用户之间的对应关系;该类型令牌仅用于开发测试。生产部署应使用 JWT 令牌,因其经过加密签名并可验证。从实现角度看,JWT 是无状态的。其令牌可包含元数据,例如用户名和修订版本,因此服务器无需记忆令牌与元数据之间的对应关系。
存在一个已知问题 #18437 ,与简单令牌相关。在 etcd 服务器中,令牌在 API 层进行解析,而简单令牌是带状态的。该过程未受到线性一致性检查的保护,这意味着某个 etcd 成员可能在完成前一次身份认证请求处理之前就接收到了下一次请求。在此情况下,成员可能会向客户端返回“无效的身份认证令牌”错误。该问题在网络状况良好的节点上通常很少发生,但如果存在显著延迟则可能发生。作为临时解决方案,应用程序应实现重试机制以处理此错误。
直接设置 JWT 令牌
除了标准的 Authenticate() RPC 流程外,etcd 还支持在客户端级别直接设置 JWT 令牌。这使得应用程序能够在 etcd 之外管理 JWT 令牌的完整生命周期,包括令牌生成、验证和轮换。
使用案例与工作流
此方法在以下情况中非常有用:
- 独立的令牌管理系统(位于 etcd 之外)负责 JWT 令牌的生成和生命周期管理
- 应用程序通过外部机制(例如,环境变量、配置服务)接收预先签名的 JWT 令牌
- 令牌生命周期必须完全由客户端应用程序管理,而非由 etcd 的自动令牌生成机制管理
典型的使用流程如下:
- 由外部权威机构(非 etcd)生成包含用户名及其他声明的已签名 JWT 令牌
- 应用程序接收预签名令牌,并使用该令牌配置 etcd 客户端
- 客户端将 JWT 令牌直接随请求发送(无需调用
Authenticate()) - etcd 服务器使用其配置的公钥验证令牌签名,并根据令牌中的用户名授予访问权限
- 在令牌到期前,应用程序从外部权威机构获取新的令牌
- 应用程序使用更新后的令牌创建新的客户端(令牌更新需要重新创建客户端)
与标准身份认证的区别
使用标准 Authenticate() 流程时:
- 客户端调用
Authenticate()并提供用户名和密码 - etcd 生成并返回一个令牌
- 客户端自动在后续请求中使用该令牌
- 令牌刷新需再次调用
Authenticate()
直接设置 JWT 令牌时:
- 客户端使用预签名的 JWT 令牌进行初始化
- 客户端 不 调用
Authenticate() - 令牌在所有请求中直接使用
- 客户端应用程序负责在令牌到期前获取新令牌,并管理客户端生命周期
认证状态无有效令牌
为支持自行管理 JWT 令牌的应用程序,AuthStatus RPC 旨在允许客户端判断身份认证是否启用,并获取当前的 authRevision。在令牌已过期的恢复场景中,客户端需要最新的修订版本,以便从外部令牌提供者获取新的有效令牌。
若缺少此功能,过期的令牌可能导致客户端无法获取当前 authRevision,从而引发死锁,致使无法生成新令牌。
关于 KVS 模型与文件系统模型的差异说明
etcd v3 是一个键值存储(KVS),而非文件系统。因此,权限可授予用户,形式为精确的键名称或键范围,例如 ["start key", "end key")。这意味着可以为不存在的键授予权限,因此应避免意外授权。在类似文件系统的系统(如 Chubby 或 ZooKeeper)中,类似 inode 的数据结构可包含权限信息,因此无法为不存在的键授予权限(粘滞位情况除外)。
etcd v3 模型需要多次查找元数据,这与类似文件系统的设计不同。最坏情况下的查找开销将等于用户所有已授予键和区间总数的总和。该开销无法避免,因为 v3 的扁平键空间与 Unix 文件系统模型(每个 inode 均包含权限元数据)存在本质差异。实际上,该开销通常不会成为严重问题,因为元数据足够小,可以充分受益于缓存。
12.5 - etcd API
本文旨在概述 v3 版 etcd API 的核心设计。 切勿将本指南与已弃用的 etcd v2 API 混淆,后者已于 etcd v3.5 中弃用。 本文并非全面涵盖所有内容,而是聚焦于理解 etcd 所需的基本概念,避免被较少使用的 API 调用分散注意力。 所有 etcd API 均定义在 [gRPC services][grpc-service] 中,这些服务对 etcd 服务器所理解的远程过程调用(RPC)进行了分类。 所有 etcd RPC 的完整列表已在 [gRPC API listing][grpc-api] 的 Markdown 文档中记录。
gRPC 服务
发送至 etcd 服务器的每个 API 请求均为 gRPC 远程过程调用。etcd 中的 RPC 按功能划分为不同的服务。
与 etcd 键空间相关的关键服务包括:
- KV - 创建、更新、获取和删除键值对。
- Watch - 监听键的变化。
- Lease - 客户端心跳消息的消费原语。 管理集群自身的服务包括:
- Auth - 基于角色的身份认证机制,用于用户身份认证。
- Cluster - 提供成员信息和配置管理功能。
- Maintenance - 执行恢复快照、整理碎片以及返回各成员状态信息。
请求与响应
etcd 中的所有 RPC 均遵循相同的格式。每个 RPC 都有一个函数 Name,它接收 NameRequest 作为参数,并返回 NameResponse 作为响应。例如,以下是 Range RPC 的描述:
响应头
etcd API 的所有响应均附带响应头,其中包含该响应对应的集群元数据:
- Cluster_ID - 生成响应的集群的 ID。
- Member_ID - 生成响应的成员的 ID。
- Revision - 生成响应时键值存储的修订版本。
- Raft_Term - 生成响应时成员的 Raft 任期。
应用程序可读取
Cluster_ID或Member_ID字段,以确保其与预期的集群(成员)进行通信。
应用程序可使用 Revision 字段了解键值存储的最新修订版本。当应用程序指定历史修订版本以执行 time travel query 操作,并希望获知请求时刻的最新修订版本时,此功能尤为有用。
应用程序可以使用 Raft_Term 检测集群完成新的领导者选举。
键值 API
键值对 API 用于操作存储在 etcd 中的键值对。发送至 etcd 的大多数请求通常为键值对请求。
系统原语
键值对
键值对是键值 API 可操作的最小单元。每个键值对包含若干字段,定义于 [protobuf 格式][kv-proto]:
- Key - 以字节表示的键。不允许使用空键。
- Value - 以字节表示的值。
- Version - 键的版本号。删除操作会将版本重置为零,对键的任何修改都会增加其版本号。
- Create_Revision - 键最后一次创建时的修订版本。
- Mod_Revision - 键最后一次修改时的修订版本。
- Lease - 附加到键的租约 ID。若租约为 0,则表示该键未附加任何租约。
除了键和值之外,etcd 还在键消息中附加了额外的修订版本元数据。该修订版本信息按创建和修改时间对键进行排序,有助于管理分布式同步中的并发。etcd 客户端的[分布式共享锁][locks] 使用创建修订版本来等待锁所有权。类似地,修改修订版本用于检测[软件事务内存][STM]读集冲突,并等待[选举][elections]更新。
修订版本
etcd 维护一个 64 位的集群范围计数器,即存储修订版本,每当键空间发生修改时,该计数器就会递增。修订版本充当全局逻辑时钟,对存储系统中的所有更新进行顺序排序。新修订版本所代表的变更具有增量特性;与某一修订版本关联的数据即为导致存储系统发生变化的数据。在内部,新修订版本意味着将变更写入后端数据库的 B+ 树,键为递增后的修订版本。
当结合 etcd 的 [多版本并发控制][mvcc] 后端时,修订版本的价值更加凸显。MVCC 模型意味着,由于历史键版本被保留,键值存储可从过去的修订版本中进行查看。此历史记录的保留策略可由集群管理员配置,以实现细粒度的存储管理;通常情况下,etcd 会通过定时机制丢弃旧的键修订版本。典型的 etcd 集群会保留被覆盖的键数据数小时。这同样能够可靠地处理长时间的客户端断开连接,而不仅仅是瞬时网络中断:监听器只需从最后一次观察到的历史修订版本处恢复即可。类似地,若需在特定时间点读取存储内容,读取请求可标记一个修订版本,以返回该修订版本提交时键空间的视图。
键范围
etcd 的数据模型将所有键索引于一个扁平的二进制键空间中。这与其它键值存储系统不同,后者采用层级结构将键组织为目录。etcd 不通过目录列出键,而是通过键区间列出键 [a, b)。
这些区间在 etcd 中通常被称为“范围”。对范围的操作比对目录的操作更强大。与分层存储类似,范围支持通过 [a, a+1) 进行单个键查找(例如,[‘a’, ‘a\x00’) 查找键 ‘a’),并可通过编码键的目录深度实现目录查找。除上述操作外,范围还可编码前缀;例如,范围 ['a', 'b') 用于查找所有以字符串 ‘a’ 为前缀的键。
按照惯例,请求的范围由字段 key 和 range_end 表示。key 字段为范围的起始键,必须非空。range_end 字段为范围最后一个键之后的键。若 range_end 未指定或为空,则范围仅包含键参数本身。若 range_end 为 key 加一(例如,“aa”+1 == “ab”,“a\xff”+1 == “b”),则范围表示所有以该键为前缀的键。若 key 和 range_end 均为 ‘\0’,则范围表示所有键。若 range_end 为 ‘\0’,则范围表示所有大于或等于键参数的键。
范围
通过 Range API 调用从键值存储中获取键,该调用接受一个 RangeRequest:
- Key, Range_End - 要获取的键范围。
- Limit - 请求返回的最大键数量。当 Limit 设置为 0 时,表示无限制。
- Revision - 用于范围查询的键值存储的时间点。若 Revision 小于或等于 0,则范围覆盖最新的键值存储。若指定的 Revision 已被压缩,返回 ErrCompacted 作为响应。
- Sort_Order - 已排序请求的排序顺序。
- Sort_Target - 用于排序的键值字段。
- Serializable - 将范围请求设置为使用可序列化成员本地读取。默认情况下,Range 为线性一致;其反映集群当前的共识状态。为获得更好的性能和可用性,可接受可能的陈旧读取,可序列化范围请求将本地服务,无需与其他节点达成共识。
- Keys_Only - 仅返回键,不返回值。
- Count_Only - 仅返回范围内键的数量。
- Min_Mod_Revision - 键修改修订版本的下限;过滤掉小于该值的修改修订版本。
- Max_Mod_Revision - 键修改修订版本的上限;过滤掉大于该值的修改修订版本。
- Min_Create_Revision - 键创建修订版本的下限;过滤掉小于该值的创建修订版本。
- Max_Create_Revision - 键创建修订版本的上限;过滤掉大于该值的创建修订版本。
客户端从
Range调用接收到RangeResponse消息:
- Kvs - 范围请求匹配的键值对列表。当
Count_Only设置时,Kvs为空。 - More - 当
limit设置时,表示请求范围内还有更多键待返回。 - Count - 满足范围请求的键的总数。 对于键范围较大且不希望缓冲完整响应的情况,请参见 RangeStream 。
范围流
RangeStream 返回的结果集与 Range 相同,但服务器会将响应拆分为一系列数据块,并流式传输至客户端。这可避免在任一端完全将大范围数据缓冲在内存中。RangeStream 接受与 RangeRequest 相同的 Range。
客户端从 RangeStream 调用接收 RangeStreamResponse 消息流:
跨块的字段填充:
- Kvs - 每个数据块携带结果的不相交片段。按接收顺序拼接每个数据块的
kvs,可得到与单次Range调用相同的结果键集合。 - Header, More, Count - 仅在最后一个数据块中填充,且仅在流无错误完成时。早期数据块中的这些字段保持零值。对每个数据块的
range_response应用proto.Merge,可得到与Range返回结果等价的RangeResponse。 如果流以错误结束,则没有任何数据块携带有效的header、more或count。
流中的每个数据块均基于相同的修订版本提供。若请求未设置 Revision,服务器将在流开始时捕获最新的已提交修订版本,并在流的剩余过程中重复使用该版本。
RangeStream 不支持自定义排序顺序或修订版本过滤(min_mod_revision、max_mod_revision、min_create_revision、max_create_revision)。使用任一功能的请求将返回 Unimplemented。RangeStream 也不被 etcd gRPC 代理支持。
有两种常用方法可用来使用 RangeStream:
- 独立处理每个数据块。 适用于高性能场景,客户端希望在键到达时立即解码并处理,而非先收集全部结果。客户端遍历各个数据块并处理其中的
kvs;流正常结束后,再从最后一个数据块读取header、more或count。 - 合并为单一响应。 适用于客户端希望获得与单次
Range调用等效结果的场景。客户端将每个数据块中的range_response合并为一个RangeResponse(例如使用proto.Merge)。合并后的结果包含完整的kvs,以及来自最后一个数据块的header、more和count。Go 客户端提供clientv3.GetStreamToGetResponse辅助函数来实现此模式。
设置
键通过发出 Put 调用保存到键值存储中,该调用接收一个 PutRequest:
- Key - 要写入键值存储的键名称。
- Value - 以字节为单位的值,与键值存储中的键关联。
- Lease - 与键值存储中键关联的租约 ID。租约值为 0 表示无租约。
- Prev_Kv - 设置后,响应中包含本次
Put请求更新前的键值对数据。 - Ignore_Value - 设置后,更新键而不更改其当前值。若键不存在,返回错误。
- Ignore_Lease - 设置后,更新键而不更改其当前租约。若键不存在,返回错误。
客户端从
Put调用接收到PutResponse消息:
- Prev_Kv - 若在
PutRequest中设置了Prev_Kv,则为Put覆盖的键值对。
删除范围
使用 DeleteRange 调用删除键的范围,该调用接受 DeleteRangeRequest:
- Key, Range_End - 要删除的键范围。
- Prev_Kv - 设置后,返回被删除的键值对内容。
客户端从
DeleteRange调用接收到DeleteRangeResponse消息:
- Deleted - 已删除的键的数量。
- Prev_Kv -
DeleteRange操作所删除的所有键值对的列表。
事务
事务是对键值存储的原子性 If/Then/Else 构造。它提供了一种将请求分组为原子块(即 Then/Else)的原语,其执行受键值存储内容的保护(即 If)。事务可用于防止键被意外的并发更新,构建比较并交换操作,并开发更高级别的并发控制。
事务可在单个请求中原子性地处理多个请求。对于键值存储的修改,这意味着事务的存储修订版本仅递增一次,且事务生成的所有事件将具有相同的修订版本。然而,在单个事务中多次修改同一键是被禁止的。
所有事务均通过一系列比较条件的合取进行保护,类似于一个 If 语句。每个比较条件检查存储系统中的单个键。它可以检查值是否存在或不存在,与指定值进行比较,或检查键的修订版本或版本号。两个不同的比较条件可作用于同一键或不同键。所有比较条件均以原子方式应用;若所有比较条件均为真,则认为事务成功,etcd 将执行事务的 then / success 请求块;否则认为事务失败,并执行 else / failure 请求块。
每个比较操作均以 Compare 消息编码:
- Result - 逻辑比较操作的类型(例如,相等、小于等)。
- Target - 要比较的键值字段。可以是键的版本、创建修订版本、修改修订版本或值。
- Key - 用于比较的键。
- Target_Union - 用户指定的用于比较的数据。
处理完比较块后,事务会应用一个请求块。块是一组
RequestOp消息:
- Request_Range - 一个
RangeRequest。 - Request_Put - 一个
PutRequest。键必须唯一。不得与任何其他 Put 或 Delete 操作共享键。 - Request_Delete_Range - 一个
DeleteRangeRequest。不得与任何 Put 或 Delete 请求共享键。 所有操作合并为一个事务,通过TxnAPI 调用发起,该调用接收一个TxnRequest:
- Compare - 用于保护事务的一组谓词,表示各项条件的合取。
- Success - 所有 Compare 测试结果均为真时要执行的一组请求。
- Failure - 任意一个 Compare 测试结果为假时要执行的一组请求。
客户端从
Txn调用接收到TxnResponse消息:
- Succeeded -
Compare评估结果为 true 或 false。 - Responses - 若 succeeded 为 true,则为应用
Success块所得结果的响应列表;若 succeeded 为 false,则为Failure的响应列表。Responses列表对应于应用RequestOp列表后的结果,每个响应均以ResponseOp编码:
每个内部响应中包含的 ResponseHeader 不应以任何方式解释。
若客户端需要获取最新的修订版本,则应始终检查 TxnResponse 中顶层的 ResponseHeader。
监听 API
本节中的 Watch API 提供基于事件的接口,用于异步监听键的变更。etcd 监听机制通过从指定的修订版本(当前或历史)持续监听键的变化,并将键的更新流式传输回客户端。
事件
每个键的每一次变更均以 Event 消息表示。Event 消息同时提供更新的数据和更新类型:
- Type - 事件类型。PUT 类型表示键已存储新数据。DELETE 类型表示键已被删除。
- KV - 与事件关联的 KeyValue。PUT 事件包含当前的键值对。PUT 事件中 kv.Version=1 表示键的创建。DELETE 事件包含被删除的键,其修改修订版本设置为删除操作的修订版本。
- Prev_KV - 事件发生前紧邻修订版本的键对应的键值对。为节省带宽,仅在监听操作显式启用时才填充。
监听流
监听是长期运行的请求,使用 gRPC 流来传输事件数据。监听流为双向通信;客户端通过向流写入来建立监听,通过读取来接收监听事件。通过为每个监听事件添加唯一的标识符,单个监听流可复用多个不同的监听。这种复用有助于降低核心 etcd 集群的内存占用和连接开销。
有关监听事件的保证说明,请参阅 [etcd api guarantees][watch-api-guarantees]。
客户端通过向 Watch 返回的流发送 WatchCreateRequest 来创建监听:
- Key, Range_End - 要监听的键范围。
- Start_Revision - 可选的修订版本,用于指定监听的起始位置(包含该修订版本)。若未指定,则从监听创建响应头中的修订版本之后的事件开始流式传输。可以从最后一次压缩修订版本开始,监听全部可用的事件历史。
- Progress_Notify - 若启用,当无新事件时,监听器将周期性地收到一个无事件的 WatchResponse。这在客户端希望从最近已知的修订版本恢复断开的监听器时非常有用。etcd 服务器根据当前负载决定通知的发送频率。
- Filters - 服务器端用于过滤的事件类型列表。
- Prev_Kv - 若启用,监听器将接收事件发生前的键值数据。这有助于了解哪些数据已被覆盖。
当收到
WatchCreateRequest或某个已建立的监听存在新事件时,客户端将收到WatchResponse:
- Watch_ID - 与响应对应的监听器 ID。
- Created - 若响应对应创建监听器请求,则设为 true。客户端应存储该 ID,并预期在流中接收该监听器的事件。发送至已创建监听器的所有事件均具有相同的 watch_id。
- Canceled - 若响应对应取消监听器请求,则设为 true。不再向已取消的监听器发送任何事件。
- Compact_Revision - 若监听器尝试在已压缩的修订版本上监听,则设为 etcd 可用的最小历史修订版本。此情况发生在以已压缩的修订版本创建监听器,或监听器无法跟上键值存储的进度时。监听器将被取消;使用相同 start_revision 创建新监听器将失败。
- Events - 与指定监听器 ID 对应的新事件序列列表。
如果客户端希望停止接收某个监听的事件,它会发出
WatchCancelRequest:
- Watch_ID - 用于取消监听的 ID,以停止后续事件的传输。
租约 API
租约是一种用于检测客户端活跃状态的机制。集群会授予带有生存时间(TTL)的租约。如果在指定的 TTL 期间内,etcd 集群未收到客户端的保活请求,该租约将到期。
为将租约与键值存储关联,每个键最多可绑定一个租约。当租约到期或被撤销时,所有绑定到该租约的键将被删除。每个过期的键都会在事件历史中生成一个删除事件。
获取租约
租约通过 LeaseGrant API 调用获取,该调用接收一个 LeaseGrantRequest:
- TTL - 建议的生存时间,单位为秒。
- ID - 租约请求的 ID。若 ID 设置为 0,etcd 将自动选择一个 ID。
客户端从
LeaseGrant调用接收到LeaseGrantResponse:
- ID - 已授予租约的租约 ID。
- TTL - 为服务器选定的生存时间(以秒为单位)的租约。
- ID - 要撤销的租约 ID。撤销租约后,所有关联的键将被删除。
保活
租约通过使用 LeaseKeepAlive API 调用创建的双向流进行刷新。当客户端希望刷新租约时,它会通过该流发送 LeaseKeepAliveRequest:
- ID - 要保活的租约的租约 ID。
保活流将响应
LeaseKeepAliveResponse:
- ID - 已通过新 TTL 刷新的租约。
- TTL - 租约剩余的有效时间,单位为秒。 [watch-api-guarantees]: /zh/docs/etcd/learning/api_guarantees/#watch-apis [elections]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/election.go [grpc-api]: /zh/docs/etcd/dev-guide/api_reference_v3/ [grpc-service]: https://github.com/etcd-io/etcd/blob/main/api/etcdserverpb/rpc.proto [kv-proto]: https://github.com/etcd-io/etcd/blob/main/api/mvccpb/kv.proto [locks]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/mutex.go [mvcc]: https://en.wikipedia.org/wiki/Multiversion_concurrency_control [stm]: https://github.com/etcd-io/etcd/blob/main/client/v3/concurrency/stm.go
12.6 - etcd 持久化存储文件
本文介绍了 etcd 持久化存储格式:命名规则、内容结构以及可供开发者用于检查存储内容的工具。后续应随着存储模型的变更持续扩展本文内容。本文面向 etcd 开发者,旨在帮助其满足数据恢复需求。
先决条件
以下文章为本文提供了有益的背景信息:
- etcd 数据模型概述
- Raft 概述 (特别是“5.3 日志复制”节)。
概述
长期存在的文件
| 文件名 | 主要用途 |
|---|---|
./member/snap/db | bbolt b+tree 用于存储所有已应用的数据、成员权限信息及元数据。它知晓最新的已应用 WAL 日志索引("consistent_index")。 |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | 定期生成的旧版 v2 存储系统快照,包含:
自 etcd v3 起,其内容与 /snap/db 文件的内容重复。 |
/member/snap/000000000007a178.snap.db | 如果副本严重滞后,则从 etcd 领导者下载完整的bbolt 快照。 其内容类型与 该文件用于以下两种场景:
恢复完成后,该文件不会被删除(其全部内容会填充到 ./member/snap/db 文件中)。这些文件会定期(30s)进行清理。
此处同样只保留 |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Raft 的预写日志,包含 Raft 接受的近期事务、定期快照或 CRC 记录。 保留最近的 如果快照生成频率过低,可能会出现超过 |
./member/wal/0.tmp (or .../1.tmp) | 为下一个预写日志文件预留的空间。 用于避免因 WAL 日志容量不足而导致 Raft 卡住,且无法触发告警的情况。 |
临时文件
在 etcd 内部处理过程中,可能会遇到多个生命周期较短的文件:
| 文件 | 主要用途 |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | 当快照文件无法加载时,会被重命名为“broken”。 etcd 启动时会尝试加载最新文件。 或在执行 etcdctl 的备份/迁移命令期间。 |
./member/snap/tmp071677638 (random suffix) | 该临时 bbolt 文件由副本创建,用于响应领导者的 msgSnap 请求,按要求从指定快照恢复存储。 完整内容成功获取后,文件将被重命名为 参见 etcd/issues/12837。已在 etcd 3.5 中修复。 |
/member/snap/db.tmp.071677638 (random suffix) | 在碎片整理过程中,该临时文件用于保存后端数据库内容(/member/snap/db)的副本。整理成功后,文件会重命名为 /member/snap/db,替换原后端数据库。 在 etcd 服务器启动时,这些文件会被清理。 |
bbolt B+ 树:member/snap/db
该文件包含已应用至 Raft 日志某个特定位置的 etcd 主要内容(参见 consistent_index )。
物理组织结构
Bolt 存储系统在物理上按 B+树 组织。B+树的物理页永远不会原地修改1。相反,内容会被复制到新页(从空闲页列表中回收)中,一旦没有正在运行的事务可能访问该旧页,该旧页即被加入空闲页列表。得益于这一机制,打开的只读(RO)事务可观察到存储系统一致的历史状态。读写(RW)事务具有排他性,会阻塞其他所有读写事务。 大值存储在多个连续页上。页回收过程与需分配不同大小的连续页区域的需求相结合,可能导致 bbolt 存储系统出现日益严重的碎片化。
bbolt 文件不会自行缩小。只有在执行碎片整理过程中,文件才能被重写为一个新的文件,该文件末尾保留了一定数量的空闲页,并且大小已被截断。
逻辑组织
bbolt 存储系统划分为多个桶。每个桶中以字典序存储键(byte[]→value byte[] 键值对)。下表列出了 etcd(截至版本 3.5)所使用的桶及其使用的键。
| 存储桶 | 键 | 示例值 | 描述 |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT} | nil | 表明其中一个成员已诊断出问题。 |
| auth | "authRevision" | ""(空)或 BigEndian.PutUint64 | 角色或用户任何变更都会在事务提交时递增此字段。 该值仅用于授权过程中的乐观锁。 |
| authRoles | [roleName] 为字符串 | authpb.Role 序列化 | |
| authUsers | [userName] 为字符串 | authpb.User 序列化 | |
| cluster | "clusterVersion" | "3.5.0"(字符串) | 次要 版本的共识达成的通用存储版本。 |
| "downgrade" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | 保存最近一次 自 v3.5 版本起 | |
| key | [revisionId] 使用 bytesToRev{main,sub} 编码 删除的键值对在序列化时会以 't' 结尾,表示“墓碑”(Tombstone) | mvccpb.KeyValue 序列化 proto(key, create_rev, mod_rev, version, value, lease id) | |
| lease | leasepb.Lease 序列化后的 proto(ID、TTL、RemainingTTL) | 注意:LeaseCheckpoint 仅扩展 RemainingTTL。TTL 仍来自原始 Grant。 注意 2:我们以秒为单位持久化 TTL(从未定义的“现在”开始计算)。崩溃循环的服务器不会释放租约! | |
| members | 以十六进制字符串形式表示的 [memberId]:"8e9e05c52164694d" | 以字符串形式序列化的 Member 结构:{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | 已达成一致的集群成员关系信息。 |
| members_removed | 以十六进制字符串形式表示的 [memberId]:"8e9e05c52164694d" | []byte("removed") | 所有已移除成员的 ID。用于验证已移除的成员不会以相同 ID 再次添加。 该字段目前(3.4 版本)从 V2 存储系统读取,从不从 V3 读取。详见 https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64 字节(大端序) | 表示最后应用的 WAL 条目在 Bolt DB 存储系统中的偏移量。 |
| scheduledCompactRev | bytesToRev{main,sub} 编码(共 16 字节)。 | 在执行压缩请求后发生崩溃时,用于重新初始化压缩。 | |
| finishedCompactRev | bytesToRev{main,sub} 编码(共 16 字节)。 | 存储系统最近成功完成压缩时的修订版本(https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | 自 etcd 3.5 版本起 | ||
| "term" | 自 etcd 3.5 版本起 | ||
| "storage-version" |
工具
bbolt
bbolt 提供了一个命令行工具,可用于检查文件内容。
使用示例:
列出给定 bbolt 文件中的所有桶:
读取特定键值对:
etcd-dump-db
etcd-dump-db 可用于列出 v3 etcd 后端数据库(bbolt)的内容。
更多示例请参见:https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL:预写日志
预写日志(Write Ahead Log)是 Raft 协议的持久化存储,用于存储提案。首先,领导者将提案写入其日志,然后(并发地)通过 Raft 协议将提案复制到跟随者。每个跟随者在向领导者确认复制之前,会先将其提案持久化到自身的 WAL 中。
etcd 中使用的 WAL 日志与标准 Raft 模型存在两方面的差异:
- 它不仅持久化索引条目,还持久化 Raft 快照(轻量级)和硬状态。因此,仅通过 WAL 日志即可恢复成员的完整 Raft 状态。
- WAL 只支持追加写入。条目不会原地覆盖;后续追加到文件中的同索引条目会取代先前的条目。
文件名
WAL 日志文件的命名遵循以下模式:
示例:./member/wal/0000000000000010-00000000000bf1e6.wal
因此,文件名包含十六进制编码:
- WAL 日志文件的顺序编号
- 文件中第一条条目或快照的索引。 特别地,第一个文件“0000000000000000-0000000000000000.wal”包含索引为 0 的初始快照记录。
物理内容
WAL 日志文件由一系列“帧 ”组成。每个帧包含:
- 使用 LittleEndian 2 编码的 uint64,表示序列化后 walpb.Record 的长度(3)。
- 填充:若干个 0 字节,使整个帧的大小按 8 字节对齐。
- 序列化后的 walpb.Record
数据:
- type - 以整数编码的枚举,用于决定如何解释下述 data 字段
- data - 由类型决定,通常是序列化后的 Protocol Buffers 数据
- crc - 自 WAL 日志创建以来,该副本上所有日志记录中所有“data”字段(不包含 type)的 RC-32 校验和。请注意,CRC 计算包含所有记录(即使它们未被 Raft 提交)。
当当前文件超过 64*10^6 字节时,会将其切分并开始写入新文件。
逻辑内容
预写日志文件在逻辑层包含:
Raftpb.Entry:由 Raft 领导者复制的最近提案。其中部分提案被视为“已提交”,其余提案可能被逻辑覆盖。Raftpb.HardState(term,commit,vote):关于日志条目索引的周期性(非常频繁)信息,该索引表示条目已“提交”(复制到多数服务器),因此保证不会被更改或覆盖,并可应用于后端(v2、v3)。该信息还包含“任期”(指示是否存在与选举相关的变更)以及投票信息——当前副本在当前任期中投给的成员。walpb.Snapshot(term, index):Raft 状态的周期性快照(不包含数据库内容,仅包含快照日志索引和 Raft 任期)- v2 存储内容存储在独立的 *.store 文件中。
- v3 存储内容保存在 bbolt 文件中,一旦条目被应用,该文件即成为隐式快照。
- crc32 校验和记录(位于每个文件开头),用于恢复对文件剩余部分的 CRC 检查。
etcdserverpb.Metadata(node_id, cluster_id)—— 用于标识日志所代表的集群与副本。
每个 WAL 日志文件按以下顺序构建:
CRC-32 帧(从之前所有文件延续的 CRC;第一个文件为 0)。
元数据帧(集群 ID 与副本 ID)。
仅初始 WAL 文件包含:
- 空快照帧(索引:0,任期:0)。 此帧用于维持一个不变量:所有条目之前均有一个快照。
对于非初始(第 2 个及后续)WAL 文件:
- HardState 帧。
条目、硬状态与快照记录的混合
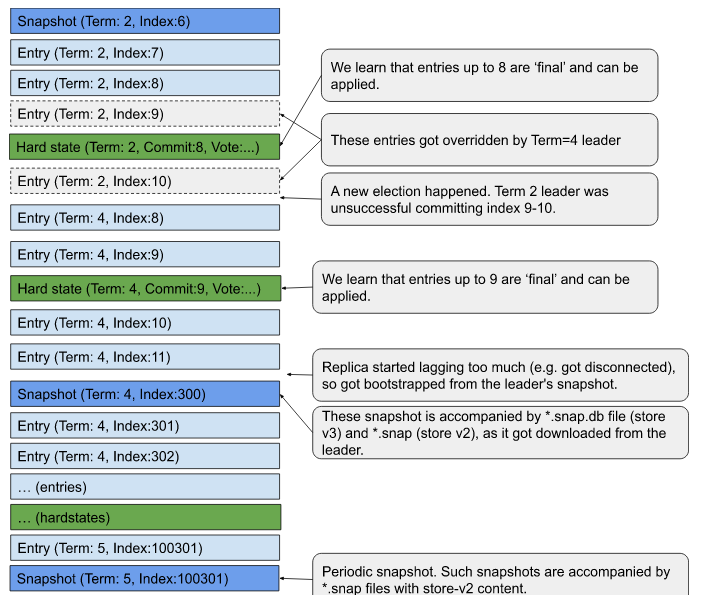
WAL 日志可能包含同一索引的多个条目。这种情况可能出现在 Raft 论文 图 7 所描述的场景中。etcd 的 WAL 日志仅支持追加写入,因此当新条目以相同索引写入时,原有条目会被覆盖。
特别是在读取 WAL 时,逻辑会用新条目覆盖旧条目 。因此,仅当条目索引 entry.index <= HardState.commit 时,才可视为最终版本。索引大于 HardState.commit 的条目可能发生变化。
WAL 日志中的“任期”应保持单调递增。
WAL 日志中的“索引”预期满足以下要求:
- 从某个快照开始
- 在该任期期间,索引应持续递增
- 若任期发生变化,索引可能减少,但必须大于最新的 HardState.commit 值
- 任意索引大于等于 HardState.commit 的新快照都可能发生,从而开启新的索引序列
工具
etcd-dump-logs
etcd 的 WAL 日志可使用 etcd-dump-logs 工具读取:
请注意:
- 该工具仅显示条目,而不显示 WAL 日志文件中的所有记录(如快照、HardState)。
- 该工具会自动应用“覆盖”规则。若某条目被同一索引下更新的条目覆盖,则工具仅输出最终值。
- 该工具还会输出未提交的条目(来自日志尾部),但不包含 HardState.commitIndex 信息,因此无法判断条目是否为最终值。
Store V2 快照:member/snap/{term}-{index}.snap
文件名:
member/snap/{term}-{index}.snap
文件名在 此处
("%016x-%016x.snap") 生成,采用 2 个十六进制编码的组合形式:
term-> 快照生成时的 Raft 任期(两次选举之间的时段)index-> 快照生成时最后一个已应用提案的索引
创建
*.snap 文件由 Snapshotter.SaveSnap 方法创建。
有两个触发器控制这些文件的创建:
- 每处理大约 –snapshotCount=(默认为 100'000)个已应用提案,就会创建一个新文件。这只是近似值:提案可能分批到达,而系统只会在一批处理结束时考虑生成快照,最终的快照过程还会异步调度。 标志名 –snapshotCount 容易产生误解:它控制最后一次快照索引与最后一次已应用提案索引之间的索引差 。
- Raft 请求副本从快照恢复。副本通过网络接收快照(msgSnap 消息)时,也会将其以轻量方式记录到 WAL 日志中。这可确保 WAL 日志尾部始终存在一个后接日志条目的有效快照,从而避免 WAL 日志中可能出现的不连续。
目前,这些文件大致3与 WAL 日志中的 Snapshot 条目一一对应。随着 v2 存储系统停用,预计将彻底停止写入这些文件(3.5.x 可选启用,3.6.x 强制执行)。
内容
该文件包含序列化后的 snapdb.snapshot proto
(uint32 crc, bytes data),
其中 data 字段包含 Raftpb.Snapshot
:
(字节数据,SnapshotMetadata{index, term, conf } 元数据),
最后,嵌套数据包含序列化为 JSON 格式的 存储 v2 内容 。
特别是存在:
- 任期
- 索引
- 成员数据:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- 存储版本:/0/version -> 3.5.0
工具
protoc
以下命令可在 etcd 根目录下执行,用于查看文件内容:
类似地,可以提取 data 字段,并将其解码为 Raftpb.Snapshot
。
etcd 3.4 *.snap 文件中示例 JSON 序列化存储 v2 内容:
变更记录
本节用于描述不同 etcd 版本之间引入的文件格式变更。
12.7 - etcd API 保证
etcd 是一个一致且持久的键值存储系统。 键值存储通过 gRPC Services 暴露。etcd 为分布式系统提供最强的一致性和持久性保证。 本文规范列出了 etcd 所提供的 API 保证。
值得考虑的 API
KV API 支持对键值存储进行直接读取和操作。 监听 API 支持订阅键值存储的变更。 租约 API 支持为键指定生存时间(TTL)。
KV 和 Watch API 均允许访问键的最新版本,同时也可在连续的历史窗口内访问之前的版本,该窗口受压缩操作的限制。
调用 KV API 会立即生效,而监听 API 可能会返回存在不可预测的延迟。
在正常运行的 etcd 集群中,通常应能在事件发生后 10 ms 内观察到监听事件。
然而,该延迟没有上限,不健康的集群中事件可能永远不会到达。
键值 API
etcd 保证所有 KV API 调用的持久性和严格可串行化。 这是分布式事务数据库系统所能提供的最强隔离保证。
持久性
任何已完成的操作都是持久的。所有可访问的数据也是持久数据。 读操作绝不会返回尚未持久化的数据。
严格的串行一致性
KV 服务操作具有原子性,并按全局顺序执行,该顺序与操作的实际时间顺序一致。全局顺序通过 revision 隐式确定。有关 strict serializability 的更多信息,请参阅相关文档。
对于不包含嵌套事务的事务,操作的执行顺序保证与其操作列表中的顺序一致,这意味着事务内部的 GET 操作响应具有稳定性。 对于包含嵌套事务的事务,执行顺序未作规定。
严格串行化意味着具备其他较弱的保证,这些保证可能更容易理解:
原子性
所有 API 请求均具有原子性;操作要么完全完成,要么完全不执行。对于监听请求,单次操作生成的所有事件将包含在同一个监听响应中。监听不会观察到单次操作的部分事件。
线性一致性
从客户端的角度来看,线性一致性提供了有用的性质,使推理变得简便。这是来自原始论文
的一段清晰描述:线性一致性提供了这样的假象:并发进程执行的每个操作,都在其调用与响应之间某个时刻瞬间生效。
例如,考虑一个客户端在时间点 1(t1)完成写入操作。在 t2(t2 > t1)时刻发起读取的客户端,应获取到至少与 t1 时刻完成的写入操作同等最新的值。然而,该读取操作可能实际仅在 t3 时刻才完成。线性一致性保证读取返回的是最新值。若无线性一致性保证,读取返回的值在读取开始时刻 t2 时是最新值,但在 t3 时刻可能已“过时”,因为 t2 与 t3 之间可能存在并发写入。
etcd 默认对所有其他操作保证线性一致性。
然而,线性一致性会带来开销,因为线性化请求必须经过 Raft 共识流程。为降低读请求的延迟并提高吞吐量,客户端可将请求的一致性模式配置为 serializable,该模式可能访问相对于法定人数过时的数据,但可消除线性化访问依赖实时共识所带来的性能开销。
监听 API
监听保证事件满足以下特性:
- 有序性 - 事件按修订版本排序。 若某个事件在时间上早于已发布的事件,则该事件不会出现在监听中。对于不含嵌套事务的事务,生成的事件顺序与操作列表中的顺序一致。对于包含嵌套事务的事务,生成事件的顺序未作规定。
- 唯一性 - 事件不会在监听中重复出现。
- 可靠性 - 事件序列不会丢失可用历史窗口内的任何子序列。若事件按时间顺序为 a < b < c,且监听收到了事件 a 和 c,则只要 b 仍在可用历史窗口内,就保证会收到事件 b。
- 原子性 - 事件列表保证涵盖完整的修订版本。同一修订版本中对多个键的更新不会被拆分到多个事件列表中。
- 可恢复性 - 若监听中断,可通过建立新的监听来恢复,新监听从中断前最后一个事件的修订版本之后开始,只要该修订版本仍在历史窗口内。
- 可标记性 - 进度通知事件保证所有至指定修订版本的事件均已送达。
etcd 不保证监听操作的线性一致性。应验证监听事件的修订版本,以确保其与其他操作的顺序正确。
租约 API
etcd 提供 租约机制 。租约的主要用途是实现分布式协调机制,例如分布式锁。租约机制本身较为简单:可通过 grant API 创建租约,通过 put API 将其绑定到键,通过 revoke API 撤销租约,并在生存时间(TTL)到期后由墙钟时间自动过期。然而,用户需注意 API 和使用方式的重要特性 ,以正确实现分布式协调机制。
etcd 特定定义
操作完成
etcd 操作在通过共识达成一致并由 etcd 存储引擎“执行”(即永久存储)后,被视为已完成。客户端在收到 etcd 服务器的响应时,即可确认操作已完成。请注意,若客户端超时,或客户端与 etcd 成员之间发生网络中断,客户端可能无法确定操作的状态。在发生领导者选举时,etcd 也可能中止操作。在此情况下,etcd 不会向客户端的未完成请求发送 abort 响应。
修订版本
对 etcd 键值存储执行修改操作时,将分配一个单一且递增的修订版本。事务操作可能多次修改键值存储,但仅分配一个修订版本。由该操作修改的键值对的修订版本属性,与操作的修订版本值相同。修订版本可作为键值存储的逻辑时钟。修订版本较大的键值对,其修改时间晚于修订版本较小的键值对。具有相同修订版本的两个键值对,是由一个操作“并发”修改的。
12.8 - etcd 与其它键值存储系统比较
etcd 这个名称源自两个理念:Unix 系统中的“/etc”目录和“d”istributed(分布式)系统。其中,“/etc”目录是用于存储单个系统配置数据的路径,而 etcd 则用于存储大规模分布式系统的配置信息。因此,“d”istributed “/etc”即为 etcd。
etcd 旨在作为大规模分布式系统的通用基础架构。这类系统无法容忍脑裂(split-brain)运行,且愿意牺牲可用性以达成此目标。etcd 以一致且容错的方式存储元数据。etcd 集群旨在提供具备顶级稳定性、可靠性、可扩展性和性能的键值存储。
分布式系统使用 etcd 作为一致性的键值存储,用于配置管理、服务发现以及协调分布式任务。许多 组织 使用 etcd 实现生产系统,例如容器调度器、服务发现服务和分布式数据存储。使用 etcd 的常见分布式模式包括 领导者选举 、分布式锁 ,以及监控机器存活状态。
使用场景
- Container Linux by CoreOS:在 Container Linux 上运行的应用程序可获得自动、零停机的 Linux 内核更新。Container Linux 使用 locksmith 协调更新过程。Locksmith 通过 etcd 实现分布式信号量,确保集群中任意时刻仅有一部分节点处于重启状态。
- Kubernetes 将配置数据存储于 etcd,以实现服务发现与集群管理;etcd 的一致性对服务的正确调度与运行至关重要。Kubernetes API 服务器将集群状态持久化至 etcd。它使用 etcd 的监听(watch)API 监控集群,并推送关键配置变更。
对比图表
也许 etcd 已经看起来非常合适,但如同所有技术决策一样,仍需谨慎行事。请注意,本文由 etcd 团队编写。尽管理想情况是客观比较技术与功能,但作者的专业知识和倾向显然偏向 etcd。请仅按说明使用。
下表为快速对比 etcd 与其最流行替代方案差异的便捷参考。各列的进一步说明与详细信息请参见表格后的章节。
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| 并发原语 | 锁 RPC , 选举 RPC , 命令行锁 , 命令行选举 , Go 中的通用模式 | 外部 Curator 模式 (Java) | 原生锁 API | 罕见 ,若有也极少 |
| 线性一致读取 | 是 | 否 | 是 | 有时 |
| 多版本并发控制 | 是 | 否 | 否 | 有时 |
| 事务 | 字段比较、读取、写入 | 版本检查、写入 | 字段比较、锁、读取、写入 | SQL 风格 |
| 变更通知 | 历史与当前键区间 | 当前键与目录 | 当前键与前缀 | 触发器(有时) |
| 用户权限 | 基于角色 | ACL | ACL | 不同(按表 GRANT ,按数据库 角色 ) |
| HTTP/JSON API | 是 | 否 | 是 | 很少 |
| 成员变更重配置 | 是 | 3.5.0 及以上 | 是 | 是 |
| 最大可靠数据库容量 | 数 GB | 数百 MB(有时可达数 GB) | 数百 MB | 数 TB 以上 |
| 最小读取线性化延迟 | 网络 RTT | 无读取线性化 | RTT + fsync | 时钟屏障(原子时钟、NTP) |
Apache ZooKeeper
ZooKeeper 解决的问题与 etcd 相同:分布式系统协调与元数据存储。然而,etcd 拥有从 ZooKeeper 设计与实现的工程和运维经验中汲取的后见之明。从 ZooKeeper 中汲取的教训确实影响了 etcd 的设计,使其能够支持 Kubernetes 等大规模系统。etcd 相较于 ZooKeeper 的改进包括:
- 动态集群成员关系配置
- 高负载下的稳定读写
- 多版本并发控制数据模型
- 可靠的键监控,永不静默丢失事件
- 租约原语将连接与会话解耦
- 用于安全分布式共享锁的 API
此外,etcd 原生支持多种语言和框架。与 Zookeeper 采用其专属的自定义 Jute RPC 协议不同,该协议完全专属于 Zookeeper 并限制了 支持的语言绑定
,etcd 的客户端协议基于 gRPC
,一个广受欢迎的 RPC 框架,提供 Go、C++、Java 等多种语言绑定。同样,gRPC 可通过 HTTP 序列化为 JSON,因此即使是一般的命令行工具如 curl 也能与其通信。由于系统可自由选择多种技术方案,它们通常基于 etcd 的原生工具链构建,而非围绕 etcd 采用单一固定的技栈。
在考虑功能、支持和稳定性时,计划使用 Zookeeper 作为一致键值存储的新应用程序应选择 etcd。
Consul
Consul 是一个端到端的服务发现框架。它提供内置的健康检查、故障检测和 DNS 服务。此外,Consul 还通过 RESTful HTTP API 暴露了一个键值存储系统。截至 Consul 1.0 版本 ,其存储系统在键值操作上的扩展性不如 etcd 或 Zookeeper 等系统;对于需要管理数百万个键的系统,将面临高延迟和内存压力。键值 API 缺少关键功能,尤其是多版本键、条件事务以及可靠的流式监听。
etcd 与 Consul 解决不同的问题。若需要分布式一致的键值存储,etcd 比 Consul 更为合适。若需要端到端的集群服务发现,etcd 功能不足;应选择 Kubernetes、Consul 或 SmartStack。
NewSQL (Cloud Spanner, CockroachDB, TiDB)
etcd 与 NewSQL 数据库(例如 Cockroach 、TiDB 、Google Spanner )均提供强数据一致性保证,并具备高可用性。然而,显著不同的系统设计参数导致其客户端 API 和性能特征存在显著差异。
NewSQL 数据库旨在跨数据中心水平扩展。这类系统通常将数据分区到多个一致的复制组(分片)中,这些分片可能分布于不同地理位置,存储的数据集规模可达数 TB 及以上。此类扩展方式导致其在分布式协调方面表现不佳,因为其依赖时钟等待,且更新操作的依赖图通常具有高度局部性。数据以表格形式组织,支持类似 SQL 的查询功能,语义比 etcd 更丰富,但相应地增加了查询处理、规划和优化的复杂性。
简而言之,选择 etcd 用于存储元数据或协调分布式应用。若需存储超过几 GB 的数据,或需要完整的 SQL 查询功能,则应选择 NewSQL 数据库。
使用 etcd 存储元数据
etcd 在单一一致的复制组内复制所有数据。对于存储几 GB 以内、需保持一致顺序的数据,这是最高效的方法。集群状态的每次修改(可能涉及多个键)都会被分配一个全局唯一标识,即 etcd 中的修订版本,该标识来自单调递增的计数器,用于推理操作顺序。由于仅存在一个复制组,修改请求只需通过 Raft 协议即可提交。通过将共识限制在单一复制组内,etcd 在采用简单协议的同时实现了分布式一致性,并达到了低延迟和高吞吐量。
etcd 的复制机制无法横向扩展,原因在于其缺乏数据分片。相比之下,NewSQL 数据库通常将数据分片存储于多个一致的复制组中,可存储规模达数 TB 及以上的数据集。然而,为确保每次修改都具有全局唯一且递增的 ID,每个请求必须在复制组之间通过额外的协调协议进行处理。这一额外的协调步骤可能导致全局 ID 冲突,迫使有序请求进行重试。最终结果是,该方案实现方式更为复杂,且在严格有序场景下的性能通常劣于 etcd。
如果应用程序主要关注元数据或元数据的顺序,例如用于协调进程,应选择 etcd。如果应用程序需要一个跨多个数据中心的大型数据存储系统,且对强全局顺序性要求不高,应选择 NewSQL 数据库。
使用 etcd 进行分布式协调
etcd 内置了分布式协调原语,包括事件监听、租约、选举以及分布式共享锁(请注意,使用分布式共享锁时,用户需了解其非显而易见的特性,详情见下文)。这些原语均由 etcd 开发者维护和支持;若将这些原语交由外部库实现,则等于推卸了开发基础分布式软件的责任,本质上使系统变得不完整。NewSQL 数据库通常期望这些分布式协调原语由第三方提供。类似地,ZooKeeper 以其独立的 协调算法库 著称。Consul 提供原生锁 API,甚至坦言其“并非牢靠的方法 ”。
理论上,可以在任何提供强一致性的存储系统之上构建这些原语。然而,相关算法往往十分微妙;很容易设计出看似可行的锁机制,却因惊群效应和时序偏差而突然失效。此外,etcd 支持的其他原语(如事务内存)依赖于 etcd 的 MVCC 数据模型;仅具备简单的强一致性是不够的。
在分布式协调场景中,选择 etcd 可以避免运维困扰并节省工程投入。
关于锁和租约的使用说明
etcd 提供 lock APIs ,其基于 租约机制 以及 etcd 中的实现 。租约机制的基本思想是:服务器向请求客户端授予一个令牌,称为租约。当服务器授予租约时,会为其关联一个 TTL。当服务器检测到时间流逝超过 TTL 时,将撤销该租约。只要客户端持有未被撤销的租约,即可声称其拥有与该租约关联的资源的访问权。在 etcd 中,该资源是 etcd 键空间中的一个键。etcd 通过此机制提供锁 API。然而,锁 API 本身不能作为互斥机制使用。API 被称为锁,是由于 历史原因 。不过,如以下所述,锁 API 可作为互斥机制的优化手段使用。
租约机制最重要的方面是,TTL 被定义为物理时间间隔。服务器和客户端均使用各自的时钟来衡量时间的流逝。这可能导致一种情况:服务器已撤销租约,但客户端仍声称自己拥有该租约。
租约机制如何保证锁机制的互斥性?实际上,租约机制本身并不能保证互斥性。拥有租约并不能保证租约持有者持有该资源的锁。
在使用 etcd 锁控制对 etcd 自身键的互斥访问时,互斥性基于版本号验证机制实现(在其他系统如 Consul 中有时称为比较并交换)。在 etcd 的 RPC 接口中,例如 Put 或 Txn,可指定操作所需的修订版本号和租约 ID 条件。若条件不满足,操作可能失败。借助此机制,etcd 为客户端提供分布式锁功能。这意味着,当客户端请求被 etcd 集群成功处理时,客户端可确认其已获取到某键的锁。
在分布式锁的文献中,类似的架构设计被描述如下:
- 在 Chubby 论文中,引入了 sequencer 的概念。我们理解该 sequencer 与 etcd 中的修订版本号和租约 ID 的组合几乎相同。
- 在 如何实现分布式锁 中,Martin Kleppmann 提出了 fencing token 的概念。作者认为,在 etcd 场景下,fencing token 即为修订版本号。
- 在 分布式系统中同步时钟的实际应用 中,可以找到描述:Thor 基于版本号验证和租约实现了一种分布式锁机制。
为何 etcd 及其他系统在基于版本号验证实现互斥的同时仍提供租约机制?这是因为租约可作为优化机制,有效减少被中止请求的数量。
请注意,etcd 键的锁定可高效实现,这是由于租约机制和版本号验证机制的共同作用。若用户需要保护与 etcd 无关的资源,则这些资源必须提供类似 etcd 键的版本号验证机制以及副本一致性保障。etcd 自身的锁功能无法用于保护外部资源。
12.9 - 术语表
本文定义了 etcd 文档、命令行和源代码中使用的各种术语。
告警
当集群需要操作员干预以保持可靠性时,etcd 服务器会触发告警。
身份认证
身份认证用于管理用户对 etcd 资源的访问权限。
客户端
客户端连接到 etcd 集群,以发出服务请求,例如获取键值对、写入数据或监听更新。
集群
集群由多个成员组成。
每个成员中的节点遵循 Raft 共识协议来复制日志。集群从成员接收提案,进行提交,并应用到本地存储。
压缩
压缩会丢弃指定修订版本之前的所有 etcd 事件历史记录和已被覆盖的键。该操作用于回收 etcd 后端数据库中的存储空间。
选举
etcd 集群通过 Raft 共识协议在成员之间进行选举,以选出领导者。
端点
指向 etcd 服务或资源的 URL。
键
用户定义的标识符,用于在 etcd 中存储和检索用户定义的值。
键范围
一组键,包含单个键、满足 a < x <= b 的字典序区间,或大于给定键的所有键。
键空间
etcd 集群中所有键的集合。
租约
一种短期有效的可续期合同,到期时会删除与其关联的键。
成员
一个参与提供 etcd 集群服务的逻辑 etcd 服务器。
修改修订版本
持有指定键最后一次写入操作的首个修订版本。
对等成员
对等成员是同一集群中的另一成员。
提案
提案是需要通过 Raft 协议处理的请求(例如写入请求、配置变更请求)。
法定人数
达成法定人数以修改集群状态所需的活跃成员数量。etcd 要求成员多数才能达成法定人数。
修订版本
一个从 1 开始、每次键空间被修改时递增的 64 位集群范围计数器。
角色
一组针对键范围的权限单元,可授予一组用户以实现访问控制。
快照
etcd 集群状态的某一时间点备份。
存储系统
支撑集群键空间的物理存储。
任期
任期是 Raft 算法中与每次领导者选举相关联的单调递增整数。 每个任期只能选举出一个领导者,且在领导者变更时,任期值将递增。
事务
一个原子执行的操作集合。事务中所有被修改的键共享相同的修改修订版本。
键版本
自键创建以来的写入次数,从 1 开始计数。不存在或已删除的键的版本号为 0。
监听器
客户端打开监听器以观察指定键范围的更新。
13 - 开发指南
13.1 - 发现服务协议
发现服务协议有助于新 etcd 成员在集群引导阶段通过共享的发现 URL 发现集群中的所有其他成员。
发现服务协议仅在集群引导阶段使用,不可用于运行时重配置或集群监控。
该协议使用新的发现令牌来引导一个唯一的 etcd 集群。请注意,一个发现令牌只能代表一个 etcd 集群。只要该令牌的发现协议已启动,即使中途失败,也不得用于引导另一个 etcd 集群。
本文其余部分将通过示例介绍发现过程,这些示例对应自托管发现集群。公共发现服务 discovery.etcd.io 的工作方式相同,但增加了一层优化,用于抽象掉难看的 URL,自动生成 UUID,并对过多请求提供一定防护。其核心仍使用 etcd 集群作为数据存储系统,如本文所述。
协议工作流
发现协议的核心思想是利用一个内部 etcd 集群来协调新集群的引导过程。首先,所有新成员与发现服务交互,协助生成预期的成员列表。随后,每个新成员使用该列表引导其服务器,这一操作实现的功能与 -initial-cluster 标志相同。
在以下示例工作流程中,我们将以 curl 格式列出协议的每一步,以便于理解。
按照惯例,etcd 发现协议使用键前缀 _etcd/registry。若 http://example.com 托管用于发现服务的 etcd 集群,则发现键空间的完整 URL 将为 http://example.com/v2/keys/_etcd/registry。本示例中将使用该 URL 前缀。
创建新的发现令牌
生成一个唯一令牌,用于标识新集群。该令牌将在后续步骤中作为发现键空间的唯一前缀使用。一种简便的方法是使用 uuidgen:
指定预期集群规模
发现令牌需要指定集群大小,该大小必须明确提供。发现服务使用此大小来判断是否已找到将初始组成集群的所有成员。
通常,集群大小为 3、5 或 7。请参阅 optimal cluster size 以获取更多详细信息。
启动 etcd 进程
给定发现 URL 后,将其作为 -discovery 标志使用,并启动 etcd 进程。每个 etcd 进程在接收到 -discovery 标志时,将自动执行以下内部步骤。
自我注册
etcd 进程的首要任务是将自身作为成员注册到发现 URL。这是通过在发现 URL 中以成员 ID 作为键来创建实现的。
检查状态
它检查发现 URL 中预期的集群大小和注册状态,并据此决定下一步操作。
如果已注册的成员仍不足,将等待缺失的成员出现。
如果注册的成员数量大于预期的集群大小 N,则将前 N 个注册的成员视为集群的成员列表。如果该成员自身在成员列表中,发现过程成功,并通过成员列表获取所有对等成员。如果不在成员列表中,发现过程将以集群已满的失败状态结束。
在 etcd 实现中,成员可能在注册自身之前就检查集群状态。因此,如果集群已满,该成员可能会快速失败。
等待所有成员就位
等待过程在 etcd API 文档 中有详细描述。
它将持续等待,直到找到所有成员。
公共发现服务
CoreOS Inc. 在 https://discovery.etcd.io/ 提供公开的发现服务,该服务具备多项便捷功能,便于使用。
隐藏键前缀
公共发现服务将 https://discovery.etcd.io/${UUID} 重定向至 /v2/keys/_etcd/registry 处的 etcd 集群。该服务可隐藏注册键前缀,使发现 URL 更短且更易读。
获取新令牌
服务中的生成过程遵循从 创建新的发现令牌 到 指定预期集群大小 的步骤。
检查发现状态
可通过请求 UUID 的值来检查此发现令牌的状态,包括已注册的机器。
开源代码库
仓库位于 https://github.com/coreos/discovery.etcd.io .,可用于构建自定义发现服务。
13.2 - 配置本地集群
对于测试和开发部署,最快捷简便的方式是配置本地集群。对于生产部署,请参考 clustering 章节。
本地独立集群
启动集群
运行以下命令以将 etcd 集群部署为独立集群:
如果 etcd 二进制文件不在当前工作目录中,它可能位于 $GOPATH/bin/etcd 或 /usr/local/bin/etcd。请相应地运行命令。
运行中的 etcd 成员在 localhost:2379 上监听客户端请求。
与集群交互
使用 etcdctl 与运行中的集群交互:
在集群中存储一个示例键值对:
如果输出 OK,表示键值对已成功存储。
获取
foo的值:如果返回
bar,表示可正常与 etcd 集群交互。
本地多成员集群
启动集群
在 etcd 代码仓库根目录下提供了一个 Procfile,用于便捷地配置本地多成员集群。要启动多成员集群,请进入 etcd 源码根目录并执行以下操作:
安装
goreman以控制基于 Procfile 的应用程序:使用
goreman和 etcd 的默认 Procfile 启动集群:各成员启动后,分别在
localhost:2379、localhost:22379和localhost:32379上监听客户端请求。
与集群交互
使用 etcdctl 与运行中的集群交互:
打印成员列表:
etcd 成员列表如下:
在集群中存储一个示例键值对:
如果输出 OK,表示键值对已成功存储。
测试容错能力
为验证 etcd 的容错能力,请终止一个成员,并尝试获取键。
确定待停止成员的进程名称。
Procfile列出了多成员集群的属性。以进程名为etcd2的成员为例。停止成员:
存储键:
检索上一步存储的键:
从已停止的成员中检索键:
该命令应显示由连接失败引起的错误:
重启已停止的成员:
从重启后的成员获取键:
重启成员后会重新建立连接,
etcdctl现在应能成功获取该键。如需详细了解如何与 etcd 交互,请参阅与 etcd 交互 。
13.3 - 与 etcd 交互
用户通常通过设置或获取键的值来与 etcd 交互。本节介绍如何使用 etcdctl(用于与 etcd 服务器交互的命令行工具)实现这一操作。此处描述的概念同样适用于 gRPC API 或客户端库 API。
etcdctl 与 etcd 通信时所使用的 API 版本可通过 ETCDCTL_API 环境变量设置为 2 或 3。默认情况下,主分支(3.4)上的 etcdctl 使用 v3 API,而较早版本(3.3 及更早)默认使用 v2 API。
请注意,使用 v2 API 创建的任何键均无法通过 v3 API 查询。对 v2 键执行 v3 API etcdctl get 操作时,将返回 0 且不包含键数据,这是预期行为。
查找版本
etcdctl 版本与服务器 API 版本可用于确定执行 etcd 各项操作时应使用的正确命令。
以下是查找版本号的命令:
写入键
应用程序通过向键写入数据将键存储到 etcd 集群中。每个存储的键都会通过 Raft 协议复制到集群中的所有成员,以实现一致性和可靠性。
以下是将键 foo 的值设置为 bar 的命令:
此外,可通过为键附加租约,将其设置为指定时间间隔。
以下是将键 foo1 的值设置为 bar1 并保留 10 秒的命令。
上述命令中的租约 ID 1234abcd 指创建 10 秒租约时返回的 ID。该 ID 后续可附加至键。
读取键
应用程序可从 etcd 集群读取键的值。查询可读取单个键,或键的范围。
假设 etcd 集群已存储以下键:
以下是读取键 foo 值的命令:
以下是读取键 foo 值的十六进制格式的命令:
以下是仅读取键 foo 值的命令:
以下是遍历从 foo 到 foo3 范围内键的命令:
foo3 被排除,因为范围位于半开区间 [foo, foo3) 内,不包含 foo3。
以下是遍历所有以 foo 为前缀的键的命令:
以下是遍历所有以 foo 为前缀的键、并将结果数量限制为 2 的命令:
以下是使用 RangeStream
RPC 遍历所有以 foo 为前缀的键的命令。结果与单次 Range 调用完全相同:
--stream 不支持 --order、--sort-by 或修订版本过滤。
读取键的过往版本
应用程序可能需要读取已被覆盖的键的旧版本。例如,应用程序可通过访问键的早期版本来回滚至旧配置。或者,应用程序可通过访问键的历史记录,在多次请求中获取多个键的一致视图。
由于对 etcd 集群键值存储的每次修改都会递增 etcd 集群的全局修订版本,因此应用程序可通过提供较早的 etcd 修订版本来读取已被覆盖的键。
假设一个 etcd 集群中已存在以下键:
以下是访问键的历史版本的示例:
读取大于等于指定键字节值的键
应用程序可能需要读取字节值大于或等于指定键的键。
假设一个 etcd 集群中已存在以下键:
以下是读取键值大于或等于键 b 字节值的命令:
删除键
应用程序可以从 etcd 集群中删除一个键或一组键。
假设一个 etcd 集群中已存在以下键:
以下是删除键 foo 的命令:
以下是删除键范围从 foo 到 foo9 的命令:
以下是删除键 zoo 的命令,删除后将返回被删除的键值对:
以下是用于删除前缀为 zoo 的键的命令:
以下是删除键值大于或等于键 b 字节值的命令:
监听键变化
应用程序可对键或键范围进行监听,以监控任何更新。
以下是监听键 foo 的命令:
以下是监听键 foo 的十六进制格式的命令:
以下是监听从 foo 到 foo9 范围键的命令:
以下是监听键前缀为 foo 的键的命令:
以下是监听多个键 foo 和 zoo 的命令:
监听键的历史变更
应用程序可能需要监听 etcd 中键的历史变更。例如,应用程序可能希望接收某个键的所有修改;如果应用程序保持与 etcd 的连接,则 watch 已足够。然而,如果应用程序或 etcd 发生故障,故障期间可能发生变更,应用程序将无法实时接收更新。为确保更新能够送达,应用程序必须能够监听键的历史变更。为此,应用程序可以在监听时指定一个历史修订版本,如同读取键的过去版本一样。
假设已完成以下操作序列:
以下是监听历史变更的示例:
以下是一个仅从最后一次历史变更开始监听的示例:
监听进度
应用程序可能需要检查监听的进度,以判断监听流的更新状态。例如,若监听用于更新缓存,则了解缓存相对于法定人数读取的修订版本是否过时会很有帮助。
可以使用交互式监听会话中的“progress”命令,向 etcd 服务器请求在监听流中发送进度通知更新:
进度通知响应中的修订版本号是监听流所连接的本地 etcd 服务器节点的修订版本。如果该节点处于网络分区状态且不属于法定人数,此进度通知的修订版本可能低于对非分区 etcd 服务器节点执行法定人数读取时返回的修订版本。
压缩的修订版本
如前所述,etcd 会保留修订版本,以便应用程序能够读取键的过往版本。然而,为了避免积累无限量的历史数据,必须对过去的修订版本执行压缩。执行压缩后,etcd 会移除历史修订版本,释放资源以供后续使用。所有修订版本早于已压缩修订版本的过时数据将不可用。
以下是执行压缩修订版本的命令:
可通过在任意键(存在或不存在)上使用 get 命令以 JSON 格式获取当前 etcd 服务器的修订版本。以下示例展示了对 etcd 服务器中不存在的 mykey 执行操作的情况:
授予租约
应用程序可从 etcd 集群授予键的租约。当键绑定到租约时,其生命周期与租约的生命周期绑定,而租约的生命周期由生存时间(TTL)决定。每个租约在授予时由应用程序指定最小生存时间(TTL)值。租约的实际 TTL 值至少为最小 TTL,且由 etcd 集群选定。一旦租约的 TTL 到期,租约即失效,所有绑定的键将被删除。
以下是授予租约的命令:
撤销租约
应用程序通过租约 ID 撤销租约。撤销租约将删除其所有关联的键。
假设已完成以下操作序列:
以下是撤销相同租约的命令:
保持租约有效
应用程序可通过刷新租约的 TTL 来维持租约有效,防止其过期。
假设已完成以下操作序列:
以下是保持相同租约持续有效的命令:
获取租约信息
应用程序可能需要了解租约信息,以便能够续期,或检查租约是否仍然有效或已过期。应用程序也可能需要知道某个特定租约所关联的键。
假设已完成以下操作序列:
获取租约信息的命令如下:
以下是获取租约信息及其关联键的命令:
13.4 - 为什么使用 gRPC 网关
etcd v3 使用 gRPC 作为其消息协议。etcd 项目包含一个基于 gRPC 的 Go 客户端 ,以及一个命令行工具 etcdctl ,用于通过 gRPC 与 etcd 集群通信。对于不支持 gRPC 的语言,etcd 提供一个 JSON gRPC 网关 。该网关提供一个 RESTful 代理,可将 HTTP/JSON 请求转换为 gRPC 消息。
使用 gRPC 网关
网关接受 etcd 的 协议缓冲
消息定义的 JSON 映射
。请注意,key 和 value 字段定义为字节数组,因此在 JSON 中必须进行 base64 编码。以下示例使用 curl,但任何 HTTP/JSON 客户端均可正常工作。
备注
自 etcd v3.3 起,gRPC 网关端点已更改:
- etcd v3.2 或更早版本仅使用
[CLIENT-URL]/v3alpha/*。 - etcd v3.3 使用
[CLIENT-URL]/v3beta/*,同时保留[CLIENT-URL]/v3alpha/*。 - etcd v3.4 使用
[CLIENT-URL]/v3/*,同时保留[CLIENT-URL]/v3beta/*。[CLIENT-URL]/v3alpha/*已弃用。
- etcd v3.5 或更高版本仅使用
[CLIENT-URL]/v3/*。[CLIENT-URL]/v3beta/*已弃用。
gRPC 网关不支持使用 TLS 通用名称进行身份认证。
设置和获取键
使用 /v3/kv/range 和 /v3/kv/put 服务读写键:
监听键
使用 /v3/watch 服务监听键:
事务
使用 /v3/kv/txn 发起一个事务:
身份认证
使用 /v3/auth 服务设置身份认证:
使用 /v3/auth/authenticate 对 etcd 进行身份认证以获取身份认证令牌:
将 Authorization 请求头设置为身份认证令牌,以使用身份认证凭据获取键:
错误响应
gRPC 网关将 gRPC 状态转换为 HTTP 状态码和 JSON 错误正文。从 etcd v3.6 开始,升级至 grpc-gateway v2 改变了错误处理方式(参见 v2 迁移指南中的 错误处理说明
),网关行为现在与 google.rpc.Status(代码、消息、详情)一致,如 Google API 错误模型
所述。历史上,较早版本的 grpc-gateway 也包含一个顶层 error 字段,但该字段在 etcd v3.6 及更高版本中不再受支持。
客户端应将 HTTP 状态码作为判断成功或失败的主要依据。若请求失败,客户端应以 message 字段作为错误信息的主要来源,并可使用其他附加信息获取进一步上下文。
Swagger 接口文档
生成的 Swagger API 定义可在 rpc.swagger.json 中找到。
13.5 - gRPC 命名与发现
etcd 提供了一个 gRPC 解析器,用于支持一种替代名称系统,该系统从 etcd 获取端点以发现 gRPC 服务。其底层机制基于监听以服务名称为前缀的键的更新。
请注意,此功能为实验性功能,因为它依赖于 google.golang.org/grpc/resolver 包,而该包在 grpc-go 中仍处于实验阶段。
使用 go-grpc 实现 etcd 发现
etcd 客户端为使用 etcd 后端解析 gRPC 端点提供了 gRPC 解析器。该解析器通过一个 etcd 客户端进行初始化:
管理服务端点
etcd 解析器将解析目标前缀下所有以 “/” 分隔的键(例如 “foo/bar/my-service/")视为潜在服务端点,这些键对应的值需为 JSON 编码格式(历史版本为 go-grpc naming.Update)。通过创建新键将端点添加至服务,通过删除键将端点从服务中移除。
添加端点
可通过 etcdctl 向服务添加新的端点:
etcd 客户端的 endpoints.Manager 方法还可注册新的端点,其键与 Addr 匹配:
当通过多个端点连接服务时,若要启用轮询负载均衡,可使用 gRPC 内置的轮询负载均衡器配置连接:
删除端点
可通过 etcdctl 从服务中删除主机:
etcd 客户端的 endpoints.Manager 方法还支持删除端点:
使用租约注册端点
使用租约注册端点可确保,若主机无法维持保活心跳(例如其所在机器发生故障),该端点将从服务中移除:
在 Go 语言中:
原子性更新端点
若需在单个事务中修改多个端点,可直接使用 endpoints.Manager:
13.6 - 将 etcd 集成到 Go 应用中
embed Go 包在应用程序中运行 etcd 服务器etcd embed go 包提供了一种简便方式,可将 etcd 服务器直接嵌入应用程序。
有关详细信息,请参见 embed 包文档 。
13.7 - 系统限制
请求大小限制
etcd 专为处理典型的元数据类小规模键值对而设计。虽然较大请求也能正常工作,但可能增加其他请求的延迟。默认情况下,任何请求的最大大小为 1.5 MiB。此限制可通过 etcd 服务器的 --max-request-bytes 标志进行配置。
存储容量限制
默认存储大小限制为 2 GiB,可通过 --quota-backend-bytes 标志进行配置。在常规环境中,建议最大大小为 8 GiB,若配置值超过此限制,etcd 在启动时会发出警告。
13.8 - etcd 功能
本文概述了 etcd 的各项功能,旨在帮助用户更好地理解这些功能及其相关弃用流程。若想了解 etcd 功能的开发方式,请参阅 开发指南 。
etcd 功能分为三个阶段:实验性、稳定和不安全。可通过运行 etcd --help 获取功能列表。
实验性
为获取早期反馈,任何新功能通常以实验性功能的形式添加。可通过标志名称识别实验性功能,其名称应以 --experimental 为前缀。使用实验性功能时,请注意以下事项:
- 由于缺乏用户测试,该功能可能存在缺陷。启用该功能可能无法按预期工作。
- 默认情况下处于禁用状态。
- 项目团队可能随时停止支持该功能,恕不另行通知。
- 若该功能未晋升为稳定功能,则可在下一个次要版本或主要版本中直接移除,无需遵循功能弃用 政策。
- 项目团队欢迎用户报告与实验性功能相关的问题。但此类问题的优先级可能低于与稳定功能相关的问题。
- 实验性功能晋升为稳定功能 时,其实验性功能标志将被弃用。应尽快改用稳定功能标志。
稳定
这是 etcd 中功能最常见的阶段。稳定功能具有以下特征:
- 作为 etcd 支持版本的一部分提供支持。
- 可以默认启用。
- 停止支持必须遵循功能弃用 政策。
不安全
不安全功能较为罕见,列于 etcd 使用文档的 Unsafe feature: 章节中。默认情况下,这些功能处于禁用状态。使用时应谨慎,并遵循文档说明。不安全功能可能在下一个次要版本或主要版本中被移除,且无需遵循功能弃用策略。
功能弃用
实验性
当实验性功能进入稳定阶段时,即被弃用。
- 实验性功能的文档将显示弃用提示,并建议使用相关的稳定功能标志。例如
DEPRECATED. Use <feature-name> instead. - 已弃用的功能将在后续版本中移除。
稳定
随着项目演进,某些稳定功能有时可能需要被弃用并移除。当发生这种情况时:
- 功能文档将在计划发布前显示警告消息。例如
To be deprecated in <release>.。若已有新功能计划替代To be deprecated功能,则文档还将提供相应说明。例如Use <feature-name> instead.。 - 该功能将在计划发布中被弃用。此时,功能文档将显示弃用消息,并建议使用相关稳定功能。例如
DEPRECATED. Use <feature-name> instead.。 - 已弃用的功能将在后续发布中移除。
13.9 - API 参考
本文 API 参考由命名的 .proto 文件自动生成。
服务 Auth (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| AuthEnable | AuthEnableRequest | AuthEnableResponse | AuthEnable 启用身份认证。 |
| AuthDisable | AuthDisableRequest | AuthDisableResponse | AuthDisable 禁用身份认证。 |
| AuthStatus | AuthStatusRequest | AuthStatusResponse | AuthStatus 显示身份认证状态。 |
| Authenticate | AuthenticateRequest | AuthenticateResponse | Authenticate 处理身份认证请求。 |
| UserAdd | AuthUserAddRequest | AuthUserAddResponse | UserAdd 添加新用户。用户名不能为空。 |
| UserGet | AuthUserGetRequest | AuthUserGetResponse | UserGet 获取用户详细信息。 |
| UserList | AuthUserListRequest | AuthUserListResponse | UserList 获取所有用户的列表。 |
| UserDelete | AuthUserDeleteRequest | AuthUserDeleteResponse | UserDelete 删除指定用户。 |
| UserChangePassword | AuthUserChangePasswordRequest | AuthUserChangePasswordResponse | UserChangePassword 更改指定用户的密码。 |
| UserGrantRole | AuthUserGrantRoleRequest | AuthUserGrantRoleResponse | UserGrant 为指定用户授予角色。 |
| UserRevokeRole | AuthUserRevokeRoleRequest | AuthUserRevokeRoleResponse | UserRevokeRole 撤销指定用户的指定角色。 |
| RoleAdd | AuthRoleAddRequest | AuthRoleAddResponse | RoleAdd 添加新角色。角色名不能为空。 |
| RoleGet | AuthRoleGetRequest | AuthRoleGetResponse | RoleGet 获取角色详细信息。 |
| RoleList | AuthRoleListRequest | AuthRoleListResponse | RoleList 获取所有角色的列表。 |
| RoleDelete | AuthRoleDeleteRequest | AuthRoleDeleteResponse | RoleDelete 删除指定角色。 |
| RoleGrantPermission | AuthRoleGrantPermissionRequest | AuthRoleGrantPermissionResponse | RoleGrantPermission 为指定角色授予指定键或范围的权限。 |
| RoleRevokePermission | AuthRoleRevokePermissionRequest | AuthRoleRevokePermissionResponse | RoleRevokePermission 撤销指定角色的指定键或范围的权限。 |
服务 Cluster (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| MemberAdd | MemberAddRequest | MemberAddResponse | MemberAdd 将成员添加至集群。 |
| MemberRemove | MemberRemoveRequest | MemberRemoveResponse | MemberRemove 从集群中移除现有成员。 |
| MemberUpdate | MemberUpdateRequest | MemberUpdateResponse | MemberUpdate 更新成员配置。 |
| MemberList | MemberListRequest | MemberListResponse | MemberList 列出集群中的所有成员。 |
| MemberPromote | MemberPromoteRequest | MemberPromoteResponse | MemberPromote 将学习者成员(非投票成员)提升为 Raft 投票成员。 |
服务 KV (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| Range | RangeRequest | RangeResponse | Range 从键值存储中获取指定范围内的键。 |
| Put | PutRequest | PutResponse | Put 将指定键写入键值存储。Put 请求会递增键值存储的修订版本,并在事件历史中生成一个事件。 |
| DeleteRange | DeleteRangeRequest | DeleteRangeResponse | DeleteRange 从键值存储中删除指定范围内的键。删除请求会递增键值存储的修订版本,并为每个被删除的键在事件历史中生成一个删除事件。 |
| Txn | TxnRequest | TxnResponse | Txn 在单个事务中处理多个请求。事务请求会递增键值存储的修订版本,并为每个完成的请求生成具有相同修订版本的事件。不允许在同一个事务中多次修改同一键。 |
| Compact | CompactionRequest | CompactionResponse | Compact 对 etcd 键值存储中的事件历史进行压缩。键值存储应定期执行压缩,否则事件历史将无限增长。 |
服务 Lease (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| LeaseGrant | LeaseGrantRequest | LeaseGrantResponse | LeaseGrant 创建一个租约,若服务器在指定的生存时间(TTL)内未收到保活请求,则该租约将过期。若租约过期,所有关联该租约的键将被过期并删除。每个过期的键都会在事件历史中生成一个删除事件。 |
| LeaseRevoke | LeaseRevokeRequest | LeaseRevokeResponse | LeaseRevoke 撤销一个租约。所有关联该租约的键将过期并被删除。 |
| LeaseKeepAlive | LeaseKeepAliveRequest | LeaseKeepAliveResponse | LeaseKeepAlive 通过客户端向服务器流式发送保活请求,并从服务器流式接收保活响应,以维持租约的活跃状态。 |
| LeaseTimeToLive | LeaseTimeToLiveRequest | LeaseTimeToLiveResponse | LeaseTimeToLive 获取租约信息。 |
| LeaseLeases | LeaseLeasesRequest | LeaseLeasesResponse | LeaseLeases 列出所有现有的租约。 |
服务 Maintenance (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| Alarm | AlarmRequest | AlarmResponse | 告警用于激活、停用和查询与集群健康状态相关的告警。 |
| Status | StatusRequest | StatusResponse | 状态用于获取成员的状态。 |
| Defragment | DefragmentRequest | DefragmentResponse | 碎片整理用于对成员的后端数据库进行碎片整理,以恢复存储空间。 |
| Hash | HashRequest | HashResponse | 哈希用于计算整个后端键空间的哈希值,包括存储中的键、租约及其他桶。此功能仅用于测试!请勿在存在持续事务的生产环境中依赖此操作,因为哈希操作不持有 MVCC 锁。如需对“键”桶进行一致性检查,请改用“HashKV” API。 |
| HashKV | HashKVRequest | HashKVResponse | 哈希键用于计算指定修订版本之前所有 MVCC 键的哈希值。它仅遍历后端存储中的“键”桶。 |
| Snapshot | SnapshotRequest | SnapshotResponse | 快照通过流将成员的整个后端数据发送给客户端。 |
| MoveLeader | MoveLeaderRequest | MoveLeaderResponse | 转移领导者用于请求当前领导者将其领导权转移给指定接收节点。 |
| Downgrade | DowngradeRequest | DowngradeResponse | 降级用于请求降级、验证可行性或取消集群版本的降级操作。自 etcd 3.5 起支持。 |
服务 Watch (api/etcdserverpb/rpc.proto)
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| Watch | WatchRequest | WatchResponse | Watch 用于监听发生的事件或已发生的事件。输入和输出均为流;输入流用于创建和取消监听器,输出流用于发送事件。一个 Watch RPC 可以同时监听多个键范围,一次性流式传输多个监听的事件。可以从最后一次压缩的修订版本开始,监听完整的事件历史。 |
消息 AlarmMember (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| memberID | memberID 是与触发告警相关的成员的 ID。 | uint64 |
| alarm | alarm 是已触发的告警类型。 | AlarmType |
消息 AlarmRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action 表示要发出的告警请求类型。action 可以是获取告警状态、激活告警,或停用已触发的告警。 | AlarmAction |
| memberID | memberID 表示与告警关联的成员 ID。如果 memberID 为 0,则该告警请求涵盖所有成员。 | uint64 |
| alarm | alarm 表示本次请求所考虑的告警类型。 | AlarmType |
消息 AlarmResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| alarms | alarms 是与告警请求相关联的告警列表。 | (slice of) AlarmMember |
消息 AuthDisableRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 AuthDisableResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthEnableRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 AuthEnableResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthRoleAddRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name 是要添加到身份认证系统中的角色名称。 | string |
消息 AuthRoleAddResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthRoleDeleteRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
消息 AuthRoleDeleteResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthRoleGetRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
消息 AuthRoleGetResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | ResponseHeader | |
| perm | (切片) authpb.Permission |
消息 AuthRoleGrantPermissionRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name 是将被授予权限的角色名称。 | string |
| perm | perm 是要授予角色的权限。 | authpb.Permission |
消息 AuthRoleGrantPermissionResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthRoleListRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 AuthRoleListResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
消息 AuthRoleRevokePermissionRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string | |
| key | bytes | |
| range_end | bytes |
消息 AuthRoleRevokePermissionResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthStatusRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 AuthStatusResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| enabled | bool | |
| authRevision | authRevision 是认证存储系统的当前修订版本 | uint64 |
消息 AuthUserAddRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string | |
| options | authpb.UserAddOptions | |
| hashedPassword | string |
消息 AuthUserAddResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthUserChangePasswordRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name 是要更改密码的用户的名称。 | string |
| password | password 是用户的新密码。请注意,该字段将在 API 层被移除。 | string |
| hashedPassword | hashedPassword 是用户的新的哈希密码。请注意,该字段将在 API 层被初始化。 | string |
消息 AuthUserChangePasswordResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthUserDeleteRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name 是要删除的用户名称。 | string |
消息 AuthUserDeleteResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthUserGetRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string |
消息 AuthUserGetResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
消息 AuthUserGrantRoleRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| user | user 是应被授予指定角色的用户名。 | string |
| role | role 是应授予用户的角色名称。 | string |
消息 AuthUserGrantRoleResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthUserListRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 AuthUserListResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| users | (slice of) string |
消息 AuthUserRevokeRoleRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| role | string |
消息 AuthUserRevokeRoleResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 AuthenticateRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string |
消息 AuthenticateResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| token | token 是可用于后续 RPC 的授权令牌 | string |
消息 CompactionRequest (api/etcdserverpb/rpc.proto)
CompactionRequest 对键值存储执行压缩,直至指定的修订版本。所有修订版本小于压缩修订版本的已覆盖键将被移除。
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revision 是执行压缩操作时键值存储的修订版本。 | int64 |
| physical | physical 设置为 true 时,RPC 将等待压缩操作在本地数据库中物理应用,确保已压缩的条目从后端数据库中完全移除。 | bool |
消息 CompactionResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 Compare (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| result | result 是本次比较操作的逻辑比较结果。 | CompareResult |
| target | target 是用于比较的键值字段。 | CompareTarget |
| key | key 是比较操作的主体键。 | bytes |
| target_union | oneof | |
| version | version 是指定键的版本。 | int64 |
| create_revision | create_revision 是指定键的创建修订版本。 | int64 |
| mod_revision | mod_revision 是指定键的最后一次修改修订版本。 | int64 |
| value | value 是指定键的值,以字节形式表示。 | bytes |
| lease | lease 是指定键的租约 ID。 | int64 |
| range_end | range_end 将指定目标与键范围 [key, range_end) 内的所有键进行比较。有关键范围的更多详情,请参见 RangeRequest。 | bytes |
消息 DefragmentRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 DefragmentResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 DeleteRangeRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | 键是范围中要删除的第一个键。 | bytes |
| range_end | range_end 是范围 [key, range_end) 中最后一个要删除的键的下一个键。若未指定 range_end,则范围仅包含 key 参数。若 range_end 比给定键大一位,则范围包含所有以该键为前缀的键。若 range_end 为 ‘\0’,则范围包含所有大于或等于 key 参数的键。 | bytes |
| prev_kv | 若设置 prev_kv,etcd 会在删除前获取对应的键值对。删除响应中将返回先前的键值对。 | bool |
消息 DeleteRangeResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| deleted | deleted 表示删除范围请求所删除的键的数量。 | int64 |
| prev_kvs | 若请求中设置了 prev_kv,则返回之前的键值对。 | (slice of) mvccpb.KeyValue |
消息 DowngradeInfo (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| enabled | enabled 表示集群是否启用降级。 | bool |
| targetVersion | targetVersion 是目标降级版本。 | string |
消息 DowngradeRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action 是要发出的降级请求类型。action 可以是 VALIDATE 目标版本、DOWNGRADE 集群版本,或 CANCEL 当前的降级任务。 | DowngradeAction |
| version | version 是要降级的目标版本。 | string |
消息 DowngradeResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version 是当前集群的版本。 | string |
消息 DowngradeVersionTestRequest (api/etcdserverpb/rpc.proto)
DowngradeVersionTestRequest 仅用于测试。请求中的版本将被读取为 WAL 记录版本。如果降级目标版本小于该版本,则降级(在线)或迁移(离线)不安全,因此不应允许。
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ver | string |
消息 HashKVRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | 修订版本是哈希操作对应的键值存储修订版本。 | int64 |
消息 HashKVResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash 是响应成员在指定修订版本前的 MVCC 键计算得出的哈希值。 | uint32 |
| compact_revision | compact_revision 是 hash 开始时键值存储的压缩修订版本。 | int64 |
| hash_revision | hash_revision 是哈希计算所覆盖的修订版本。 | int64 |
消息 HashRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 HashResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash 是响应成员的 KV 后端数据库计算得出的哈希值。 | uint32 |
消息 LeaseCheckpoint (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是要检查点的租约 ID。 | int64 |
| remaining_TTL | remaining_TTL 是租约到期前剩余的时间。 | int64 |
消息 LeaseCheckpointRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| checkpoints | (slice of) LeaseCheckpoint |
消息 LeaseCheckpointResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 LeaseGrantRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| TTL | TTL 是建议的存活时间(秒)。过期的租约将返回 -1. | int64 |
| ID | ID 是租约请求的 ID。若 ID 设置为 0,则由租约发放方选择 ID。 | int64 |
消息 LeaseGrantResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID 是授予租约的租约 ID。 | int64 |
| TTL | TTL 是服务器选定的租约存活时间(秒)。 | int64 |
| error | string |
消息 LeaseKeepAliveRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是要保持保活的租约的租约 ID。 | int64 |
消息 LeaseKeepAliveResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID 是保活请求中提供的租约 ID。 | int64 |
| TTL | TTL 是租约的新存活时间。 | int64 |
消息 LeaseLeasesRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 LeaseLeasesResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| leases | (slice of) LeaseStatus |
消息 LeaseRevokeRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是要撤销的租约 ID。撤销 ID 后,所有关联的键将被删除。 | int64 |
消息 LeaseRevokeResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 LeaseStatus (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | int64 |
消息 LeaseTimeToLiveRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是该租约的租约 ID。 | int64 |
| keys | keys 为 true 时表示查询与该租约关联的所有键。 | bool |
消息 LeaseTimeToLiveResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID 是保活请求中提供的租约 ID。 | int64 |
| TTL | TTL 是租约剩余的有效时间(秒);租约将在不超过 TTL+1 秒内过期。 | int64 |
| grantedTTL | GrantedTTL 是租约创建或续期时授予的初始有效时间(秒)。 | int64 |
| keys | Keys 是附加到该租约的键列表。 | (slice of) bytes |
消息 Member (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是此成员的成员 ID。 | uint64 |
| name | name 是成员的可读名称。如果成员未启动,name 将为空字符串。 | string |
| peerURLs | peerURLs 是成员向集群暴露的用于通信的 URL 列表。 | (slice of) string |
| clientURLs | clientURLs 是成员向客户端暴露的用于通信的 URL 列表。如果成员未启动,clientURLs 将为空。 | (slice of) string |
| isLearner | isLearner 表示该成员是否为 Raft 学习者成员。 | bool |
消息 MemberAddRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| peerURLs | peerURLs 是新增成员用于与集群通信的 URL 列表。 | (slice of) string |
| isLearner | isLearner 表示新增成员是否为 Raft 学习者成员。 | bool |
消息 MemberAddResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| member | member 是新增成员的成员信息。 | Member |
| members | members 是添加新成员后所有成员的列表。 | (slice of) Member |
消息 MemberListRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| linearizable | bool |
消息 MemberListResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members 是与集群关联的所有成员的列表。 | (slice of) Member |
消息 MemberPromoteRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是要提升的成员的成员 ID。 | uint64 |
消息 MemberPromoteResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members 是提升成员后所有成员的列表。 | (slice of) Member |
消息 MemberRemoveRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是要移除成员的成员 ID。 | uint64 |
消息 MemberRemoveResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members 是移除成员后所有成员的列表。 | (slice of) Member |
消息 MemberUpdateRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID 是待更新成员的成员 ID。 | uint64 |
| peerURLs | peerURLs 是成员与集群通信所使用的新的 URL 列表。 | (slice of) string |
消息 MemberUpdateResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members 是更新成员后所有成员的列表。 | (slice of) Member |
消息 MoveLeaderRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| targetID | targetID 是新领导者的节点 ID。 | uint64 |
消息 MoveLeaderResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
消息 PutRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key 是要存入键值对存储的键,以字节形式表示。 | bytes |
| value | value 是要与键关联的值,以字节形式表示。 | bytes |
| lease | lease 是要与键关联的租约 ID。租约值为 0 表示无租约。 | int64 |
| prev_kv | 若设置 prev_kv,etcd 在修改前获取该键的先前键值对。先前的键值对将在 put 响应中返回。 | bool |
| ignore_value | 若设置 ignore_value,etcd 使用键的当前值更新键。若键不存在,则返回错误。 | bool |
| ignore_lease | 若设置 ignore_lease,etcd 使用键的当前租约更新键。若键不存在,则返回错误。 | bool |
消息 PutResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| prev_kv | 若请求中设置了 prev_kv,则返回之前的键值对。 | mvccpb.KeyValue |
消息 RangeRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key 是范围的第一个键。若未指定 range_end,则请求仅查找该键。 | bytes |
| range_end | range_end 是请求范围 [key, range_end) 的上界。若 range_end 为 ‘\0’,则范围为所有大于等于 key 的键。若 range_end 为 key 加一(例如 “aa”+1 == “ab”,“a\xff”+1 == “b”),则范围请求获取所有以 key 为前缀的键。若 key 和 range_end 均为 ‘\0’,则范围请求返回所有键。 | bytes |
| limit | limit 是请求返回键数量的限制。当 limit 设置为 0 时,视为无限制。 | int64 |
| revision | revision 是用于范围请求的键值存储的时间点。若 revision 小于或等于零,则范围针对最新的键值存储。若该修订版本已被压缩,则返回 ErrCompacted 作为响应。 | int64 |
| sort_order | sort_order 是返回结果排序的顺序。 | SortOrder |
| sort_target | sort_target 是用于排序的键值字段。 | SortTarget |
| serializable | serializable 将范围请求设置为使用可序列化成员本地读取。范围请求默认为线性一致;线性一致请求的延迟较高、吞吐量较低,但反映集群当前的共识状态。为获得更好性能,可接受可能的陈旧读取,可序列化范围请求在本地服务,无需与其他节点达成共识。 | bool |
| keys_only | keys_only 为真时,仅返回键而不返回值。 | bool |
| count_only | count_only 为真时,仅返回范围内键的数量。 | bool |
| min_mod_revision | min_mod_revision 是返回键修改修订版本的下界;所有修改修订版本较小的键将被过滤掉。 | int64 |
| max_mod_revision | max_mod_revision 是返回键修改修订版本的上界;所有修改修订版本较大的键将被过滤掉。 | int64 |
| min_create_revision | min_create_revision 是返回键创建修订版本的下界;所有创建修订版本较小的键将被过滤掉。 | int64 |
| max_create_revision | max_create_revision 是返回键创建修订版本的上界;所有创建修订版本较大的键将被过滤掉。 | int64 |
消息 RangeResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| kvs | kvs 是范围请求匹配的键值对列表。当请求计数时,kvs 为空。 | (slice of) mvccpb.KeyValue |
| more | more 表示在请求的范围内是否还有更多键待返回。 | bool |
| count | 当请求计数时,count 设置为指定范围内实际的键数量。与 kvs 不同,它不受限制和过滤器(例如 Min/Max、Create/Modify、Revisions)影响,反映指定范围内完整的键数量。 | int64 |
消息 RequestOp (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request | request 是事务接受的请求类型的联合。 | oneof |
| request_range | RangeRequest | |
| request_put | PutRequest | |
| request_delete_range | DeleteRangeRequest | |
| request_txn | TxnRequest |
消息 ResponseHeader (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| cluster_id | cluster_id 是发送响应的集群的 ID。 | uint64 |
| member_id | member_id 是发送响应的成员的 ID。 | uint64 |
| revision | revision 是请求被应用时键值存储的修订版本,对于不与键值存储交互的调用,该字段未设置(即为 0)。对于监听进度响应,header.revision 表示进度。在此流中接收到的所有未来事件的修订版本号均保证高于 header.revision 号。 | int64 |
| raft_term | raft_term 是请求被应用时的 Raft 任期。 | uint64 |
消息 ResponseOp (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| response | response 是事务返回的响应类型集合。 | oneof |
| response_range | RangeResponse | |
| response_put | PutResponse | |
| response_delete_range | DeleteRangeResponse | |
| response_txn | TxnResponse |
消息 SnapshotRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 SnapshotResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | header 包含当前键值存储的信息。快照流中的第一个 header 指示快照的时间点。 | ResponseHeader |
| remaining_bytes | remaining_bytes 表示在本消息之后还需发送的 blob 字节数。 | uint64 |
| blob | blob 包含快照流中的下一个快照数据块。 | bytes |
| version | 创建快照的本地服务器版本。在运行不同版本二进制文件的集群中,各集群可能返回不同结果。用于告知恢复快照时应使用的 etcd 服务器版本。 | string |
消息 StatusRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 StatusResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version 是响应成员所使用的集群协议版本。 | string |
| dbSize | dbSize 是响应成员后端数据库实际分配的大小,单位为字节。 | int64 |
| leader | leader 是响应成员认为当前的领导者成员 ID。 | uint64 |
| raftIndex | raftIndex 是响应成员当前 Raft 已提交索引。 | uint64 |
| raftTerm | raftTerm 是响应成员当前的 Raft 任期。 | uint64 |
| raftAppliedIndex | raftAppliedIndex 是响应成员当前 Raft 已应用索引。 | uint64 |
| errors | errors 包含告警/健康信息和状态。 | (slice of) string |
| dbSizeInUse | dbSizeInUse 是响应成员后端数据库逻辑上正在使用的大小,单位为字节。 | int64 |
| isLearner | isLearner 表示该成员是否为 Raft 学习者成员。 | bool |
| storageVersion | storageVersion 是数据库文件的版本。该版本可能与目标集群版本存在延迟更新。 | string |
| dbSizeQuota | dbSizeQuota 是配置的 etcd 存储配额,单位为字节(由标志 –quota-backend-bytes 传递给 etcd 实例)。 | int64 |
| downgradeInfo | downgradeInfo 表示是否存在降级过程。 | DowngradeInfo |
消息 TxnRequest (api/etcdserverpb/rpc.proto)
MultiOp 原语
源自 Google PaxosDB 论文:我们的实现基于一种强大的原语,称为 MultiOp。除迭代外,所有数据库操作均通过一次 MultiOp 调用实现。MultiOp 以原子方式应用,包含三个组成部分:1. 一组称为 guard 的测试。guard 中的每个测试检查数据库中的单个条目。测试可检查值是否存在或不存在,或与给定值进行比较。guard 中的两个不同测试可作用于数据库中的同一或不同条目。所有测试均被应用,MultiOp 返回测试结果。若所有测试均为真,则执行 t op(参见下文第 2 项),否则执行 f op(参见下文第 3 项)。2. 一组称为 t op 的数据库操作。列表中的每个操作为插入、删除或查找操作,且作用于单个数据库条目。列表中的两个不同操作可作用于数据库中的同一或不同条目。当 guard 求值为真时执行这些操作。3. 一组称为 f op 的数据库操作。与 t op 类似,但在 guard 求值为假时执行。
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| compare | compare 是一组表示逻辑与关系的谓词。如果比较成功,则按顺序处理 success 请求,并在响应中按顺序返回各自的响应。如果比较失败,则按顺序处理 failure 请求,并在响应中按顺序返回各自的响应。 | (slice of) Compare |
| success | success 是一组在 compare 求值为 true 时执行的请求。 | (slice of) RequestOp |
| failure | failure 是一组在 compare 求值为 false 时执行的请求。 | (slice of) RequestOp |
消息 TxnResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| succeeded | 如果 compare 的评估结果为 true,则 succeeded 设置为 true;否则为 false。 | bool |
| responses | responses 是一个响应列表,对应于当 succeeded 为 true 时执行成功的结果,或当 succeeded 为 false 时执行失败的结果。 | (slice of) ResponseOp |
消息 WatchCancelRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| watch_id | watch_id 是要取消的监听器 ID,取消后将不再传输事件。 | int64 |
消息 WatchCreateRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key 是要监听的键。 | bytes |
| range_end | range_end 是要监听的范围 [key, range_end) 的结束位置。若未提供 range_end,则仅监听 key 参数指定的键。若 range_end 等于 ‘\0’,则监听所有大于或等于 key 参数的键。若 range_end 比给定键大一位,则监听所有具有该前缀(即给定键)的键。 | bytes |
| start_revision | start_revision 是可选的监听起始修订版本(包含)。未指定 start_revision 表示“现在”。 | int64 |
| progress_notify | progress_notify 设置后,若无新事件,etcd 服务器将定期向新监听器发送不包含事件的 WatchResponse。此功能在客户端希望从最近已知修订版本恢复断开的监听器时非常有用。etcd 服务器可根据当前负载决定通知发送的频率。 | bool |
| filters | filters 用于在服务器端过滤事件,再发送给监听器。 | (slice of) FilterType |
| prev_kv | 若设置 prev_kv,监听器将在事件发生前获取对应的前一个 KV。若前一个 KV 已被压缩,则不会返回任何内容。 | bool |
| watch_id | 若提供非零的 watch_id,该 ID 将被分配给此监听器。由于在 etcd 中创建监听器并非同步操作,因此可通过该 ID 确保在同一流上创建多个监听器时顺序正确。若在流上已存在相同 ID 的监听器,则创建操作将返回错误。 | int64 |
| fragment | fragment 启用将大修订版本拆分为多个监听响应。 | bool |
消息 WatchProgressRequest (api/etcdserverpb/rpc.proto)
请求在监听响应流中尽快发送监听流进度状态。
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
消息 WatchRequest (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request_union | request_union 是创建新监听器或取消现有监听器的请求。 | oneof |
| create_request | WatchCreateRequest | |
| cancel_request | WatchCancelRequest | |
| progress_request | WatchProgressRequest |
消息 WatchResponse (api/etcdserverpb/rpc.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| watch_id | watch_id 是与响应对应监听器的 ID。 | int64 |
| created | 如果响应对应创建监听请求,则 created 被设置为 true。客户端应记录 watch_id,并期望从同一流中接收该监听器的事件。发送给该监听器的所有事件都将附加相同的 watch_id。 | bool |
| canceled | 如果响应对应取消监听请求,或 start_revision 已被压缩,则 canceled 被设置为 true。不再向已取消的监听器发送任何事件。 | bool |
| compact_revision | 如果监听器尝试在已被压缩的索引处监听,则 compact_revision 被设置为最小索引。这种情况发生在以已被压缩的修订版本创建监听器,或监听器无法跟上键值存储进度时。客户端应将监听器视为已取消,并不应再尝试以相同 start_revision 创建监听器。 | int64 |
| cancel_reason | cancel_reason 表示取消监听器的原因。 | string |
| fragment | 如果大型监听响应被拆分到多个响应中,则 fragment 为 true。 | bool |
| events | (slice of) mvccpb.Event |
消息 Event (api/mvccpb/kv.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| type | type 表示事件类型。若 type 为 PUT,表示已将新数据存储至键。若 type 为 DELETE,表示该键已被删除。 | EventType |
| kv | kv 保存事件对应的 KeyValue。PUT 事件包含当前的键值对。PUT 事件中 kv.Version=1 表示键的创建。DELETE/EXPIRE 事件包含被删除的键,其修改修订版本设置为删除时的修订版本。 | KeyValue |
| prev_kv | prev_kv 保存事件发生前的键值对。 | KeyValue |
消息 KeyValue (api/mvccpb/kv.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| key | key 是以字节表示的键。不允许使用空键。 | bytes |
| create_revision | create_revision 是该键上次创建时的修订版本。 | int64 |
| mod_revision | mod_revision 是该键上次修改时的修订版本。 | int64 |
| version | version 是键的版本号。删除操作会将版本号重置为零,任何对键的修改都会增加其版本号。 | int64 |
| value | value 是键所持有的值,以字节表示。 | bytes |
| lease | lease 是附加到该键的租约 ID。当附加的租约到期时,该键将被删除。若 lease 为 0,则表示该键未附加任何租约。 | int64 |
消息 Lease (server/lease/leasepb/lease.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| ID | int64 | |
| TTL | int64 | |
| RemainingTTL | int64 |
消息 LeaseInternalRequest (server/lease/leasepb/lease.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| LeaseTimeToLiveRequest | etcdserverpb.LeaseTimeToLiveRequest |
消息 LeaseInternalResponse (server/lease/leasepb/lease.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| LeaseTimeToLiveResponse | etcdserverpb.LeaseTimeToLiveResponse |
消息 Permission (api/authpb/auth.proto)
权限是一个单一实体
| 字段 | 描述 | 类型 |
|---|---|---|
| permType | 类型 | |
| key | bytes | |
| range_end | bytes |
message Role (api/authpb/auth.proto)
角色是 authRoles 存储桶中的单个条目。
| 字段 | 描述 | 类型 |
|---|---|---|
| name | bytes | |
| keyPermission | (切片) Permission |
message User (api/authpb/auth.proto)
用户是存储桶 authUsers 中的单个条目
| 字段 | 描述 | 类型 |
|---|---|---|
| name | bytes | |
| password | bytes | |
| roles | (slice of) string | |
| options | UserAddOptions |
message UserAddOptions (api/authpb/auth.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| no_password | bool |
13.10 - API 参考:并发
本文 API 参考由命名的 .proto 文件自动生成。
服务 Lock (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
锁服务将客户端锁功能以 gRPC 接口的形式暴露。
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| Lock | LockRequest | LockResponse | Lock 在指定名称的锁上获取分布式共享锁。成功时,将返回一个唯一键,该键在调用方持有锁期间持续存在。该键可与事务配合使用,以确保对 etcd 的更新仅在持有锁所有权时发生。锁将持续持有,直至对键调用 Unlock,或与所有者关联的租约到期。 |
| Unlock | UnlockRequest | UnlockResponse | Unlock 接收 Lock 返回的键,并释放对锁的持有。等待获取锁的下一个 Lock 调用者将被唤醒,并获得锁的所有权。 |
消息 LockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| name | name 是要获取的分布式共享锁的标识符。 | bytes |
| lease | lease 是将附加到锁所有权的租约 ID。如果该租约到期或被撤销且当前持有锁,则锁会自动释放。使用相同租约调用 Lock 将被视为一次获取;使用相同租约两次锁定为无操作。 | int64 |
消息 LockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| key | 键是在锁持有者持有锁期间存在于 etcd 中的键。用户不应修改此键,否则锁可能表现出未定义行为。 | bytes |
消息 UnlockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| key | key 是由 Lock 分配的锁所有权键。 | bytes |
消息 UnlockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
服务 Election (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
选举服务通过 gRPC 接口向客户端暴露选举功能。
| 方法 | 请求类型 | 响应类型 | 描述 |
|---|---|---|---|
| Campaign | CampaignRequest | CampaignResponse | Campaign 等待在选举中获取领导权,若成功则返回代表领导权的 LeaderKey。该 LeaderKey 可用于在选举中发布新值、以事务方式保护依赖于当前领导权的 API 请求,以及退出选举。 |
| Proclaim | ProclaimRequest | ProclaimResponse | Proclaim 使用新值更新领导者的公布值。 |
| Leader | LeaderRequest | LeaderResponse | Leader 返回当前选举的公布值(如有)。 |
| Observe | LeaderRequest | LeaderResponse | Observe 以有序方式流式传输选举中当选领导者发布的公告。 |
| Resign | ResignRequest | ResignResponse | Resign 释放选举中的领导权,使其他竞选者可获取领导权。 |
消息 CampaignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| name | name 是竞选的标识符。 | bytes |
| lease | lease 是与选举领导权关联的租约 ID。如果在放弃领导权之前租约到期或被撤销,则领导权将转移给下一个竞选者(如果存在)。 | int64 |
| value | value 是竞选者赢得选举时设置的初始声明值。 | bytes |
消息 CampaignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| leader | leader 描述用于维持选举领导权的资源。 | LeaderKey |
消息 LeaderKey (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| name | name 是与领导权键对应的选举标识符。 | bytes |
| key | key 是表示选举所有权的不透明键。若该键被删除,则失去领导权。 | bytes |
| rev | rev 是该键的创建修订版本。在事务中可通过检查键的创建修订版本是否与 rev 匹配,来验证对选举的所有权。 | int64 |
| lease | lease 是选举领导者的租约 ID。 | int64 |
消息 LeaderRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| name | name 是领导权信息的选举标识符。 | bytes |
消息 LeaderResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| kv | kv 表示最新的领导者更新的键值对。 | mvccpb.KeyValue |
消息 ProclaimRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| leader | leader 表示对选举的领导权持有。 | LeaderKey |
| value | value 是用于覆盖领导者当前值的更新。 | bytes |
消息 ProclaimResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
消息 ResignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| leader | leader 是通过辞职放弃领导权的领导者。 | LeaderKey |
消息 ResignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
消息 Event (api/mvccpb/kv.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| type | type 表示事件类型。若 type 为 PUT,表示已将新数据存储至键。若 type 为 DELETE,表示该键已被删除。 | EventType |
| kv | kv 保存事件对应的 KeyValue。PUT 事件包含当前的键值对。PUT 事件中 kv.Version=1 表示键的创建。DELETE/EXPIRE 事件包含被删除的键,其修改修订版本设置为删除时的修订版本。 | KeyValue |
| prev_kv | prev_kv 保存事件发生前的键值对。 | KeyValue |
消息 KeyValue (api/mvccpb/kv.proto)
| 字段 | 描述 | 类型 |
|---|---|---|
| key | key 是以字节形式表示的键。不允许使用空键。 | 字节 |
| create_revision | create_revision 是该键上次创建时的修订版本。 | int64 |
| mod_revision | mod_revision 是该键上次修改时的修订版本。 | int64 |
| version | version 是键的版本号。删除操作会将版本号重置为零,任何对键的修改都会增加其版本号。 | int64 |
| value | value 是键所持有的值,以字节形式表示。 | 字节 |
| lease | lease 是附加到该键的租约 ID。当附加的租约到期时,该键将被删除。若 lease 为 0,则表示该键未附加任何租约。 | int64 |
14 - 操作指南
14.1 - 身份认证指南
14.1.1 - 身份认证
auth、user、role 用于身份认证:
注意:
本文仅为示例,需补充并更新关于身份认证的更多信息。上述文本仅为代码示例。
14.1.2 - 基于角色的访问控制
概述
身份认证功能自 etcd 2.1 版本起引入。etcd v3 API 对身份认证功能的 API 和用户界面进行了轻微调整,以更好地适配新的数据模型。本文旨在帮助用户在 etcd v3 中设置基本的身份认证和基于角色的访问控制。
特殊用户和角色
有一个特殊用户 root,以及一个特殊角色 root。
用户 root
root 用户在激活身份认证前必须先创建,该用户拥有对 etcd 的完全访问权限。root 用户的设计初衷是用于系统管理:管理角色和普通用户。root 用户必须拥有 root 角色,并被允许修改 etcd 内的任意内容。
角色 root
角色 root 可授予任意用户,包括根用户。拥有 root 角色的用户具备全局读写权限,并可更新集群的身份认证配置。此外,root 角色授予用户执行常规集群维护的权限,包括修改集群成员关系、整理碎片以及创建快照。
使用用户
user 子命令用于 etcdctl,负责处理与用户账户相关的所有事项。
用户列表可通过以下方式获取:
创建用户的方法如下:
创建新用户时将提示输入新密码。当提供选项 --interactive=false 时,可从标准输入提供密码。也可使用 --new-user-password 来提供密码。
创建无法通过密码认证的用户也是可行的,方法如下:
此类用户只能通过 TLS 通用名称 进行认证 。
etcd 不支持通过 --user username: 使用空密码进行身份认证。例如,使用空密码创建的用户,如 etcdctl user add anonymous:'',无法通过用户名/密码请求进行身份认证,类似 etcdctl --user anonymous: get foo 的请求将失败并返回 user name is empty。
用户的角色可使用以下方式授予或撤销:
用户设置可通过以下方式检查:
用户密码可通过以下方式更改:
更改密码后,将再次提示输入新密码。当提供选项 --interactive=false 时,密码可从标准输入提供。
使用以下命令删除账户:
使用角色
role 子命令用于 etcdctl,负责处理与特定角色访问控制相关的所有事项,这些权限已授予个别用户。
列出角色:
创建新角色,使用:
角色无密码;它仅用于定义一组新的访问权限。
角色被授予对单个键或键范围的访问权限。
范围可指定为区间 [起始键、结束键),其中起始键在字典序上应小于结束键。
访问权限可授予为读取、写入或两者兼有,例如以下示例所示:
要查看已授予的权限,可随时查看角色:
权限撤销以相同逻辑方式进行:
如移除角色本身:
启用身份认证
启用身份认证的最小步骤如下。系统管理员可根据偏好,在启用身份认证之前或之后设置用户和角色。
确保已创建 root 用户:
启用身份认证:
此后,etcd 已启用身份认证运行。如需出于任何原因禁用身份认证,请使用对应的反向命令:
身份认证的安全范围
当启用身份认证 etcdctl auth enable 时,可保护 V3 gRPC API 操作(get、put、delete、watch 等)。
/metrics 和 /health HTTP 端点使用独立的处理器,不受 V3 RBAC 身份认证保护。此设计允许 Prometheus 和负载均衡器在无需 gRPC 身份认证的情况下抓取指标,同时仍可保护键值数据。
为保障可观测性端点的安全:
- 使用
--cert-file、--key-file和--client-cert-auth启用 mTLS - 或通过
--listen-metrics-urls将指标绑定到私有接口 - 或使用网络策略/防火墙规则限制访问
使用 etcdctl 进行身份认证
etcdctl 支持与 curl 类似的身份认证标志。
密码可从提示中获取:
密码也可以从命令行标志 --password 获取:
否则,所有 etcdctl 命令保持不变。用户和角色仍可创建和修改,但需由具备根角色的用户进行身份认证。
使用 TLS 共用名称
从 v3.2 版本起,若 etcd 服务器以选项 --client-cert-auth=true 启动,则客户端 TLS 证书中的通用名称(CN)字段将用作 etcd 用户。在此情况下,通用名称用于身份认证,客户端无需提供密码。请注意,若同时满足以下两个条件:1. --client-cert-auth=true 被传递且客户端提供了通用名称,以及 2. 客户端提供了用户名和密码,则基于用户名和密码的身份认证将被优先使用。请注意,此功能无法与 gRPC-proxy 或 gRPC-gateway 一同使用。这是因为 gRPC-proxy 会终止来自其客户端的 TLS 连接,导致所有客户端共享代理的证书。gRPC-gateway 内部使用 TLS 连接将 HTTP 请求转换为 gRPC 请求,因此存在相同的限制。因此,客户端无法正确向服务器提供其通用名称。若给定证书的通用名称非空,gRPC-proxy 将报错并停止运行。gRPC-proxy 返回错误,提示客户端证书中包含非空的通用名称。
密码强度说明
etcdctl 和 etcd API 在用户创建或更新用户密码操作期间不强制要求特定密码长度。系统管理能力应负责实施此类要求。为避免与密码强度相关的安全风险,可使用 TLS Common Name 基于的身份认证
,或通过 --no-password 选项创建的用户。
14.2 - 配置选项
可以通过以下方式配置 etcd:
- 命令行标志
- 环境变量:每个标志都有一个对应的环境变量,其名称与标志相同,但前缀为
ETCD_,并以全大写和 [蛇形命名法][] 格式化。例如,--some-flag对应ETCD_SOME_FLAG。 - 配置文件
请注意:如果混合使用配置选项,则以下规则适用。
- 命令行标志优先于环境变量。
- 如果提供了 配置文件,则所有命令行标志和环境变量均被 忽略。
命令行标志
以下以 --flag-name DEFAULT_VALUE 格式展示命令行标志。
以下提供的标志列表可能因持续开发变更而未能保持最新。如需获取最新可用的标志,请运行 etcd --help 或查阅 etcd help
。
注意:有关 v3.7 版本新增、更新和已弃用标志的详细信息,请参阅 CHANGELOG-3.7.md 。
成员
集群管理
安全
认证
性能分析和监控
日志记录
注意:在 v3.7 中,多个 --experimental-* 标志已被提升或重命名。
请务必用下文列出的稳定对应标志替换已弃用的标志。
分布式跟踪
v2 代理
注意:标志位将在 v3.6 中被弃用。
功能
功能门控
不安全功能
警告:使用不安全功能可能会破坏共识协议所提供的保证!
配置文件
etcd 配置文件由一个 YAML 映射组成,其键为命令行标志名称,值为标志的取值。
为使用此文件,请将文件路径作为 --config-file 标志的值或 ETCD_CONFIG_FILE 环境变量的值指定。
有关示例,请参见 [etcd.conf.yml 样本][]。
诸如 --grpc-keepalive-min-time、--grpc-keepalive-interval、--grpc-keepalive-timeout、--backend-batch-interval、--corrupt-check-time、--compact-hash-check-time、--compaction-sleep-interval、--watch-progress-notify-interval、--warning-apply-duration、--warning-unary-request-duration 及 --downgrade-check-time 等持续时间字段在作为命令行标志传入时可接受人类可读的字符串(例如 10m、5s),但在配置文件中仅接受 以纳秒表示的整数值。这是 Go 标准库的一个已知限制
,其中 time.Duration 被反序列化为普通整数。
例如,在配置文件中设置 10 分钟的监听进度通知间隔:
14.3 - 传输安全模型
etcd 支持自动 TLS,以及通过客户端证书实现的客户端到服务器和对等成员(服务器到服务器 / 集群)通信的身份认证。请注意,etcd 默认不启用 基于 RBAC 的身份认证 或传输层的身份认证功能,以降低用户入门时的使用门槛。此外,更改此默认设置将对该项目造成破坏性变更,该项目自 2013 年确立以来一直保持该设定。未启用安全功能的 etcd 集群可能使数据暴露于任意客户端。
要快速上手,请先准备一个 CA 证书以及一个成员的已签名密钥对。建议为集群中的每个成员创建并签署新的密钥对。
为方便起见,cfssl 工具提供了便捷的证书生成接口,我们在此提供一个使用该工具的示例 here 。或者,可参考此 指南以生成自签名密钥对 。
以下提供的标志列表可能因持续开发变更而未能保持最新。如需获取最新可用的标志,请运行 etcd --help 或查阅 etcd help
。
基本配置
etcd 支持多个与证书相关的配置选项,可通过命令行标志或环境变量进行设置:
客户端到服务器通信:
--cert-file=<path>:用于与 etcd 建立 SSL/TLS 连接的证书。设置此选项后,advertise-client-urls 可使用 HTTPS 方案。
--key-file=<path>:证书的键。必须为未加密的。
--client-cert-auth:启用此选项后,etcd 将检查所有传入的 HTTPS 请求,确保其包含由受信任 CA 签发的客户端证书;未提供有效客户端证书的请求将失败。若 身份认证
已启用,证书中的通用名称(Common Name)字段将提供用户的用户名凭证。
--trusted-ca-file=<path>:受信任的证书颁发机构。
--auto-tls:对与客户端的 TLS 连接使用自动生成的自签名证书。
对等通信(服务器间/集群):
对等成员选项的工作方式与客户端到服务器选项相同:
--peer-cert-file=<path>:用于对等成员之间 SSL/TLS 连接的证书。该证书将同时用于在对等成员地址上监听以及向其他对等成员发送请求。
--peer-key-file=<path>:证书的键。必须为未加密的。
--peer-client-cert-auth:启用后,etcd 将检查来自集群的所有对等成员请求,确保其客户端证书由指定的 CA 签发。
--peer-trusted-ca-file=<path>:受信任的证书颁发机构。
--peer-auto-tls:对等成员之间的 TLS 连接使用自动生成的自签名证书。
若提供客户端到服务器证书或对等成员证书,则必须同时设置密钥。所有这些配置选项也可通过环境变量 ETCD_CA_FILE、ETCD_PEER_CA_FILE 等进行设置。
常用选项:
--cipher-suites:服务器/客户端与对等成员之间支持的 TLS 密码套件列表,以逗号分隔(空值将由 Go 自动填充)。
--tls-min-version=<version> 设置 etcd 支持的最低 TLS 版本。
--tls-max-version=<version> 设置 etcd 支持的最大 TLS 版本。若未设置,则使用 Go 支持的最大版本。
TLS 证书 keyUsage 和 extendedKeyUsage
在为 etcd 传输层安全生成 X.509 证书时,证书应根据其角色包含适当的 keyUsage 和 extendedKeyUsage 字段。etcd 依赖 Go 的 crypto/tls 和 crypto/x509 库进行证书验证,这些库会在 TLS 握手过程中强制执行这些用途。
下表总结了常见证书角色的推荐用法:
| 证书角色 | keyUsage | extendedKeyUsage |
|---|---|---|
| 服务器(客户端到服务器) | digitalSignature, keyEncipherment | serverAuth |
| 客户端 | digitalSignature, keyEncipherment | clientAuth |
| 对等成员(服务器到服务器) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
注意事项:
- 当启用
--peer-client-cert-auth时,对等成员之间使用证书进行双向 TLS,因此必须同时配置serverAuth和clientAuth。 - 与
--client-cert-auth一起使用的客户端证书应包含clientAuth。
示例 1: 使用 HTTPS 的客户端到服务器传输安全
为此,请准备好 CA 证书(ca.crt)以及已签名的密钥对(server.crt、server.key)。
请逐步配置 etcd 以提供简单的 HTTPS 传输安全:
这应能正常启动,可通过向 etcd 发送 HTTPS 请求来测试配置:
该命令应显示握手成功。由于我们使用自签名证书并采用自有的证书颁发机构,因此必须通过 --cacert 选项将 CA 传递给 curl。另一种方法是将 CA 证书添加至系统的受信任证书目录(通常位于 /etc/pki/tls/certs 或 /etc/ssl/certs)。
OSX 10.9+ 用户:OSX 10.9+ 上的 curl 7.30.0 不支持在命令行中传递证书。
请将 dummy ca.crt 直接导入钥匙串,或向 curl 添加 -k 标志以忽略错误。
若要不使用 -k 标志进行测试,请运行 open ./tests/fixtures/ca/ca.crt 并按照提示操作。
测试完成后请删除该证书!
如有可行的变通方法,请告知我们。
示例 2:使用 HTTPS 客户端证书进行客户端到服务器的身份认证
目前,etcd 客户端已具备验证服务器身份并提供传输安全的能力。然而,我们还可以使用客户端证书来防止未经授权的访问。
客户端将向服务器提供其证书,服务器将检查该证书是否由提供的 CA 签发,并据此决定是否响应请求。
与第一个示例中提到的文件相同,本例也需要一个由同一证书颁发机构签名的客户端密钥对(client.crt、client.key)。
现在以相同请求尝试此服务器:
请求应被服务器拒绝:
为使操作成功,需将由 CA 签署的客户端证书提供给服务器:
输出应包含:
同时,服务器的响应如下:
指定要阻止的加密套件 弱 TLS 加密套件 。
当客户端使用无效的加密套件请求 Client Hello 时,TLS 握手将失败。
例如:
然后,客户端请求必须指定服务器中指定的加密套件之一:
示例 3:集群中的传输安全与客户端证书
etcd 支持与上述相同的模型用于 对等成员通信,即集群中 etcd 成员之间的通信。
假设我们已拥有 ca.crt,以及两个分别使用该 CA 签署其密钥对的成员(member1.crt 与 member1.key,member2.crt 与 member2.key),则按如下方式启动 etcd:
etcd 成员将组成一个集群,集群内成员之间的所有通信均将使用客户端证书进行加密和身份认证。etcd 的输出将显示其连接的地址使用 HTTPS。
示例 4:自动生成的自签名传输安全
指定 ClientAutoTLS 和 PeerAutoTLS 时,etcd 自动生成的客户端证书和对等成员证书的有效期仅为 1 年。可以指定 –self-signed-cert-validity 标志来设置证书的有效期(以年为单位)。
当仅需通信加密而无需身份认证时,etcd 支持使用自动生成的自签名证书对消息进行加密。此举简化了部署流程,无需在 etcd 外部管理证书和密钥。
通过标志 --auto-tls 和 --peer-auto-tls 配置 etcd,使其对客户端和对等成员连接使用自签名证书:
自签名证书无法验证身份,因此 curl 会返回错误:
要禁用证书链检查,请使用 -k 标志调用 curl:
DNS SRV 服务记录说明
自 v3.1.0 版本起(v3.2.9 除外),发现 SRV 引导通过 ServerName 的根域名来认证 --discovery-srv 标志指定的域名。此举旨在防止中间人证书攻击,要求证书的 Subject Alternative Name(SAN)字段中必须包含与根域名匹配的条目。例如,etcd --discovery-srv=etcd.local 仅在提供的证书中包含根域名 etcd.local 作为 SAN 字段条目时,才会认证对等成员/客户端。
etcd 代理使用说明
etcd 代理在连接安全时终止来自客户端的 TLS,并使用在 --peer-key-file 和 --peer-cert-file 中指定的代理自身密钥/证书与 etcd 成员通信。
代理通过给定成员的 --advertise-client-urls 和 --advertise-peer-urls 与 etcd 成员通信。它将客户端请求转发至 etcd 成员的已通告客户端 URL,同时通过 etcd 成员的已通告对等成员 URL 同步初始集群配置。
当为 etcd 成员启用客户端身份认证时,系统管理员必须确保代理的 --peer-cert-file 选项中指定的对等成员证书适用于该身份认证。如果启用了对等成员身份认证,则代理的对等成员证书也必须适用于对等成员身份认证。
TLS 身份认证注意事项
自 v3.2.0 起,客户端每次连接时都会重新加载 TLS 证书 。此机制在无需停止 etcd 服务器的情况下替换过期证书时非常有用;可通过用新证书覆盖旧证书来实现。每次连接时刷新证书的开销不应过大,但未来可通过引入缓存层进一步优化。示例测试可参见 这里 。
自 v3.2.0
起,服务器拒绝包含错误 IP 地址的对等成员证书 SAN
。例如,若对等成员证书的 Subject Alternative Name (SAN) 字段中包含任何 IP 地址,服务器仅在远程 IP 地址与其中任一 IP 地址匹配时才认证该对等成员。此举旨在防止未经授权的端点加入集群。例如,对等成员 B 的 CSR(含 cfssl)为:
当对等成员 B 的实际 IP 地址为 10.138.0.2 时,而非 10.138.0.27。当对等成员 B 尝试加入集群时,对等成员 A 将以错误 x509: certificate is valid for 10.138.0.27, not 10.138.0.2 拒绝 B 的加入请求,因为 B 的远程 IP 地址与 Subject Alternative Name (SAN) 字段中的地址不匹配。
自 v3.2.0
起,服务器在检查 SAN
时会解析 TLS DNSNames。例如,若对等成员证书的 Subject Alternative Name(SAN)字段中仅包含 DNS 名称(无 IP 地址),则服务器仅在对这些 DNS 名称执行正向查找(dig b.com)并确认其解析出的 IP 地址与远程 IP 地址匹配时,才完成对等成员的身份认证。例如,对等成员 B 的 CSR(含 cfssl)为:
当对等成员 B 的远程 IP 地址为 10.138.0.2 时。当对等成员 B 尝试加入集群时,对等成员 A 会查找入站主机 b.com 以获取 IP 地址列表(例如 dig b.com)。如果该列表不包含 IP 10.138.0.2,则拒绝 B 的加入请求,并返回错误 tls: 10.138.0.2 does not match any of DNSNames ["b.com"]。
自 v3.2.2
起,服务器在 IP 地址匹配时接受连接,不再检查 DNS 条目
。例如,若对等成员证书中的 Subject Alternative Name (SAN) 字段包含 IP 地址和 DNS 名称,且远程 IP 地址与其中任一 IP 地址匹配,服务器将直接接受连接,不再进一步验证 DNS 名称。例如,对等成员 B 的 CSR(含 cfssl)为:
当对等成员 B 的远程 IP 地址为 10.138.0.2 且 invalid.domain 为无效主机时,对等成员 B 尝试加入集群,对等成员 A 可成功对 B 进行身份认证,因为主题备用名称(SAN)字段包含有效的匹配 IP 地址。详情请参见 issue#8206
。
自 v3.2.5
起,服务器支持对通配符 DNS 的反向查找 SAN
。例如,若对等成员证书中的 Subject Alternative Name(SAN)字段仅包含 DNS 名称(无 IP 地址),服务器首先对远程 IP 地址执行反向查找,以获取映射到该地址的一组名称(例如 nslookup IPADDR)。若这些名称中存在与对等成员证书中 DNS 名称匹配的名称(通过精确匹配或通配符匹配),则接受连接。若无匹配项,服务器将对证书中的每个 DNS 条目执行正向查找(例如,当条目为 *.example.default.svc 时,查找 example.default.svc),仅当主机解析出的地址中包含与对等成员远程 IP 地址匹配的 IP 地址时,才接受连接。例如,对等成员 B 的 CSR(含 cfssl)为:
当对等成员 B 的远程 IP 地址为 10.138.0.2 时。对等成员 B 尝试加入集群,对等成员 A 会反向查找 IP 10.138.0.2 以获取主机名列表,并将主机名与对等成员 B 证书中 Subject Alternative Name (SAN) 字段的 DNS 名称进行精确匹配或通配符匹配。若反向或正向查找均失败,将返回错误 "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"]。详情请参见 issue#8268
。
v3.3.0
引入 etcd --peer-cert-allowed-cn
标志,以支持对等成员间连接的 基于 CN(通用名称)的身份认证
。Kubernetes TLS 引导机制涉及为 etcd 成员及其他系统组件(例如 API 服务器、kubelet 等)生成动态证书。为每个组件维护不同的 CA 可提供对 etcd 集群更严格的访问控制,但通常较为繁琐。当指定 –peer-cert-allowed-cn 标志时,节点仅能以匹配的通用名称加入集群,即使使用共享 CA 亦然。匹配方式为与证书的通用名称(CN)字段进行精确字符串比较——不支持通配符或前缀匹配。对于基于主机名的过滤,使用 –peer-cert-allowed-hostname 或 –client-cert-allowed-hostname 时,匹配采用 Go 的 x509.Certificate.VerifyHostname() 函数,支持精确主机名及通配符条目(例如 *.example.com)。例如,三节点集群中每个成员使用 CSRs(通过 cfssl)配置如下:
若提供了 --peer-cert-allowed-cn etcd.local,则仅对等成员中 Common Name 匹配的才会被认证。若证书签名请求(CSR)中的 CN 不同,或 --peer-cert-allowed-cn 不同,则节点将被拒绝:
每个进程应以以下方式启动:
v3.2.19
和 v3.3.4
修复了当 证书 SAN 字段仅包含 IP 地址而无域名
时的 TLS 重载问题。例如,成员使用如下 CSRs(含 cfssl)进行配置:
在 Go 中,仅当服务器的 (*tls.Config).Certificates 字段非空,或客户端提供了有效 SNI 且 (*tls.ClientHelloInfo).ServerName 非空时,服务器才会调用 (*tls.Config).GetCertificate 以重新加载 TLS。此前,etcd 始终在初始客户端 TLS 握手时填充 (*tls.Config).Certificates(非空)。因此,客户端始终需提供匹配的 SNI,以通过 TLS 验证并触发 (*tls.Config).GetCertificate 重新加载 TLS 资产。
不过,如果证书的 SAN 字段 不包含任何域名而只有 IP 地址
,请求中的 *tls.ClientHelloInfo 会带有空的 ServerName 字段,导致初始 TLS 握手无法触发 TLS 重载;需要在线替换过期证书时,这就会成为问题。
现在,(*tls.Config).Certificates 在初始 TLS 客户端握手时被创建为空,首先用于触发 (*tls.Config).GetCertificate,然后在每次新的 TLS 连接时填充其余证书,即使客户端 SNI 为空(例如,证书仅包含 IP 地址)。
主机白名单说明
etcd --host-whitelist 标志指定可接受的 HTTP 客户端请求主机名。客户端来源策略可防范针对不安全 etcd 服务器的 “DNS 重绑定”
攻击。即,任何网站均可创建一个合法的 DNS 名称,并将 DNS 指向 "localhost"(或其他任意地址)。随后,监听在 "localhost" 上的 etcd 服务器所有 HTTP 端点均可能被访问,从而面临 DNS 重绑定攻击。详情请参见 CVE-2018-5702
。
客户端来源策略的工作方式如下:
- 若客户端通过 HTTPS 安全连接,则允许任意主机名。
- 若客户端连接不安全且
"HostWhitelist"非空,则仅允许 Host 字段在白名单中的 HTTP 请求。
请注意,无论是否启用身份认证,客户端来源策略均会被强制执行,以实现更严格的控制。
默认情况下,etcd --host-whitelist 和 embed.Config.HostWhitelist 被设置为 空,以允许所有主机名。请注意,指定主机名时,环回地址不会自动添加。如需允许环回接口,应手动将其添加至白名单(例如 "localhost"、"127.0.0.1" 等)。
常见问题解答
我在使用 TLS 客户端身份认证时遇到 SSLv3 握手失败错误?
crypto/tls 包中的 golang 在使用证书公钥前会检查其键用途。
要使用证书公钥进行客户端认证,创建证书公钥时需在 clientAuth 中添加 Extended Key Usage。
操作方法如下:
在 OpenSSL.cnf 中添加以下章节:
生成证书时,请确保在 -extensions 标志中引用该证书:
使用对等证书身份认证时,我收到“证书有效域名是 127.0.0.1,不是$MY_IP”
请确保使用成员的公网 IP 地址作为证书的主体名称(Subject Name)进行签名。例如,etcd-ca 工具为 new-cert 命令提供了 --ip= 选项。
证书需在成员的完全限定域名(FQDN)作为其主题名称(Subject Name)时进行签名,使用主题备用名称(IP SANs)添加 IP 地址。etcd-ca 工具为 new-cert 命令提供 --domain= 选项,OpenSSL 也可实现 it
。
etcd 是否对磁盘上存储的数据进行加密?
etcd 不会对存储在磁盘驱动器上的键值数据进行加密。若用户需要对存储在 etcd 中的数据进行加密,可选择以下方案:
- 由客户端应用程序负责对数据进行加密和解密
- 使用底层存储系统的加密功能,例如 dm-crypt
我看到一条日志警告,内容是“目录 X 存在但没有推荐的权限 -rwx——”
当 etcd 创建某些新目录时,会将文件权限设置为 700,以尽可能防止非特权访问。然而,如果用户已使用自定义偏好创建了目录,etcd 将使用现有目录,并在权限与 700 不同时记录警告消息。
14.4 - 集群指南
概述
静态启动 etcd 集群要求每个成员均知晓集群中的其他成员。在某些情况下,集群成员的 IP 地址可能无法提前确定。在这些情况下,可以借助发现服务来引导启动 etcd 集群。
一旦 etcd 集群启动并运行,添加或移除成员需通过 运行时重配置 完成。为更好地理解运行时重配置的设计原理,建议阅读 运行时配置设计文档 。
本文将介绍用于引导 etcd 集群的以下机制:
每个引导机制将用于创建一个由三台机器组成的 etcd 集群,具体细节如下:
| 名称 | 地址 | 主机名 |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
静态
如已知晓集群成员、其地址及集群规模,可在启动前通过设置 initial-cluster 标志使用离线引导配置。每台机器将获取以下任一环境变量或命令行参数:
请注意,initial-cluster 中指定的 URL 是 已通告的对等成员 URL,即它们应与相应节点上 initial-advertise-peer-urls 的值匹配。
若为测试目的而启动多个集群(或创建并销毁单个集群),强烈建议为每个集群分配一个唯一的 initial-cluster-token。通过此操作,即使各集群配置完全相同,etcd 仍可为各集群生成唯一的集群 ID 和成员 ID。此举可防止集群间相互干扰,避免造成集群数据损坏。
etcd 在 listen-client-urls
监听以接收客户端流量。etcd 成员会向其他成员、代理和客户端通告 advertise-client-urls
中指定的 URL。请注意,advertise-client-urls 必须对目标客户端可达。常见错误是将 advertise-client-urls 设置为 localhost,或在远程客户端需访问 etcd 时未更改默认值。
在每台机器上,使用以下标志启动 etcd:
以 --initial-cluster 开头的命令行参数在 etcd 的后续运行中将被忽略。引导过程完成后,可自由移除环境变量或命令行标志。如需后续修改配置(例如向集群中添加或移除成员),请参阅 runtime configuration
指南。
TLS
etcd 通过 TLS 协议支持加密通信。TLS 通道可用于对等成员之间的集群内部加密通信,也可用于客户端流量的加密。本节提供配置启用对等成员和客户端 TLS 的集群示例。有关 etcd TLS 支持的更多详细信息,请参阅 security guide 。
自签名证书
使用自签名证书的集群可同时实现流量加密和连接身份认证。要启动使用自签名证书的集群,每个集群成员应拥有唯一的密钥对(member.crt、member.key),并由共享的集群 CA 证书(ca.crt)分别对对等成员连接和客户端连接的证书进行签名。证书可通过参考 etcd TLS 设置
示例生成。
在每台机器上,etcd 将使用以下标志启动:
自动证书管理
如果集群需要加密通信但不需要身份认证连接,etcd 可配置为自动为其生成密钥。在初始化时,每个成员会根据其通告的 IP 地址和主机名自动生成一组密钥。
在每台机器上,etcd 将使用以下标志启动:
错误案例
在以下示例中,我们未将新主机包含在已枚举节点的列表中。如果这是一个新集群,该节点必须添加到初始集群成员列表中。
在此示例中,我们尝试将一个节点(infra0)映射到与其在集群列表中枚举的地址(10.0.1.10:2380)不同的地址(127.0.0.1:2380)。如果该节点需监听多个地址,则所有地址 必须 在 “initial-cluster” 配置指令中反映出来。
如果对等成员使用了不同的配置参数集并尝试加入此集群,etcd 将报告集群 ID 不匹配并退出。
发现
在多种情况下,集群对等成员的 IP 地址可能无法提前知晓。这在使用云服务提供商或网络采用 DHCP 时较为常见。在这种情况下,应避免指定静态配置,而是利用现有的 etcd 集群来引导新集群。此过程称为“发现”。
有两种可用于发现的方法:
- etcd 发现服务
- DNS SRV 记录
etcd 发现
为更好地理解发现服务协议的设计,建议阅读发现服务协议 documentation 。
发现 URL 的生命周期
发现 URL 用于标识一个唯一的 etcd 集群。每个 etcd 实例应共享一个新的发现 URL,以引导新集群,而非复用现有的发现 URL。
此外,发现 URL 仅可用于集群的初始引导。若需在集群运行后更改集群成员关系,请参阅 运行时重配置 指南。
自定义 etcd 发现服务
发现机制通过现有的集群来引导自身。若使用私有 etcd 集群,请按如下方式创建 URL:
通过将 size 键设置为 URL,可创建一个预期集群大小为 3 的发现 URL。
此情况下使用的 URL 为 https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83,etcd 成员在启动时将使用 https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 目录进行注册。
每个成员必须指定不同的名称标志。Hostname 或 machine-id 是不错的选择。否则,由于名称重复,发现将失败。
现在我们为每个成员启动 etcd,并设置相关标志:
这将导致每个成员向自定义的 etcd 发现服务注册自身,并在所有机器完成注册后启动集群。
公共 etcd 发现服务
如果无可用的现有集群,可使用托管在 discovery.etcd.io 的公共发现服务。若要使用“new”端点创建私有发现 URL,请使用以下命令:
这将创建一个初始大小为 3 个成员的集群。若未指定大小,则默认使用 3。
每个成员必须指定不同的名称标志,否则由于名称重复,发现将失败。Hostname 或 machine-id 是不错的选择。
现在我们为每个成员启动 etcd,并设置相关标志:
这将导致每个成员向发现服务注册自身,并在所有成员注册完成后启动集群。
使用环境变量 ETCD_DISCOVERY_PROXY 可使 etcd 通过 HTTP 代理连接发现服务。
错误和警告情况
发现服务器错误
警告
这是一个无害的警告,表示此机器将忽略发现 URL。
DNS 发现
DNS SRV 记录
可用作发现机制。--discovery-srv 标志可用于设置发现 SRV 记录所在的 DNS 域名。
设置 --discovery-srv example.com 会导致按列出的顺序查找 DNS SRV 记录:
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
如果发现 _etcd-server-ssl._tcp.example.com,etcd 将尝试通过 TLS 执行引导过程。
为帮助客户端发现 etcd 集群,将按以下顺序查找下列 DNS SRV 记录:
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
如果发现 _etcd-client-ssl._tcp.example.com,客户端将尝试通过 SSL/TLS 与 etcd 集群通信。
如果 etcd 使用 TLS,发现 SRV 记录(例如 example.com)必须包含在 SSL 证书的 DNS SAN 中,且需与主机名一同列出,否则集群化将失败,并出现如下日志消息:
如果 etcd 使用 TLS 但未使用自定义证书颁发机构,则发现域名(例如 example.com)必须与 SRV 记录域名(例如 infra1.example.com)匹配。此举旨在防范伪造 SRV 记录指向其他域名的攻击;若域名匹配,即使该域名在 PKI 下拥有有效证书,也不会被未知第三方控制。
-discovery-srv-name 标志还可配置在发现过程中查询的 SRV 名称后缀。
使用此标志可在同一域名下区分多个 etcd 集群。
例如,若 discovery-srv=example.com 和 -discovery-srv-name=foo 均已设置,则会执行以下 DNS SRV 查询:
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
创建 DNS SRV 记录
使用 DNS 引导 etcd 集群
etcd 集群成员可通告域名或 IP 地址,引导过程将解析 DNS A 记录。
自 3.2 版本起(3.1 版本会打印警告)--listen-peer-urls 和 --listen-client-urls 将拒绝为网络接口绑定使用域名。
--initial-advertise-peer-urls 中解析出的地址必须与 SRV 目标中的任一解析地址匹配。etcd 成员会读取解析地址,以判断其是否属于 SRV 记录中定义的集群。
集群也可使用 IP 地址而非域名进行引导:
自 v3.1.0 版本起(v3.2.9 除外),当 etcd --discovery-srv=example.com 配置了 TLS 时,服务器仅在提供的证书中包含根域名 example.com 作为主题备用名称(SAN)字段的条目时,才会对对等成员/客户端进行身份认证。参见 DNS SRV 说明
。
网关
etcd 网关是一个简单的 TCP 代理,用于将网络数据转发至 etcd 集群。请参阅 网关指南 以获取更多信息。
代理
当设置 --proxy 标志时,etcd 以 代理模式
运行。该代理模式仅支持 etcd v2 API;目前无计划支持 v3 API。对于 v3 API 支持,将在 etcd 3.0 发布后推出具备增强功能的新代理。
要使用 v2 API 代理搭建 etcd 集群,请阅读 etcd 2.3 版本发布中的 集群化文档 。
14.5 - 以 Kubernetes StatefulSet 运行 etcd 集群
以下演示如何作为 Kubernetes StatefulSet 执行 静态引导过程 。
示例 Manifest
本文档包含用于在 Kubernetes 中部署静态 etcd 集群的服务和有状态集(StatefulSet)配置。
如果将清单内容复制到名为 etcd.yaml 的文件中,可使用以下命令将其应用到集群。
应用后,请等待 Pod 进入就绪状态。
示例中使用的容器包含 etcdctl,可直接在 Pod 内调用。
使用自签名证书部署时,请参考以 ## TLS 开头的注释配置标题,查找可取消注释的配置项。使用 cert-manager 生成证书的额外说明包含在下方章节中。
生成证书
在本节中,使用 Helm 安装名为 cert-manager 的操作符。
在集群中安装 cert-manager 后,可在集群内生成自签名证书。生成的证书将存放在一个 Secret 对象中,该对象可作为文件挂载到容器中。
本文是用于安装 cert-manager 的 Helm 命令。
本文档提供了一个用于生成自签名证书的 ClusterIssuer 配置示例。
本清单为客户端和服务器证书创建 Certificate 对象,引用 ClusterIssuer “selfsigned”。dnsNames 应为 cert-manager 所创建证书的有效主机名的完整列表。
14.6 - 在容器中运行 etcd 集群
本文指南展示了如何使用 Docker 以 静态引导过程 运行 etcd。
Docker
为使 Docker 主机外部的客户端能够访问 etcd API,请使用容器的主机 IP 地址。有关获取 IP 地址的详细信息,请参见 docker inspect
。或者,可向 docker run 命令指定 --net=host 标志,以跳过将容器置于独立网络栈中的操作。
运行单节点 etcd
配置 etcd 时,请使用主机 IP 地址:
配置 Docker 卷以存储 etcd 数据:
运行最新版本的 etcd(v3.7.0,撰写本文时的版本):
列出集群成员:
运行一个 3 节点 etcd 集群
使用 API 版本 3 运行 etcdctl:
裸金属
要在裸金属上部署一个由 3 个节点组成的 etcd 集群,可参考 baremetal 仓库 中的示例。
挂载证书卷
etcd 发行版容器不包含默认的根证书。如需使用由根证书机构信任的证书(例如用于发现),请将证书目录挂载到 etcd 容器中:
14.7 - 故障模式
在大规模机器部署中,故障是常见现象。当硬件或软件发生故障时,机器会失效。若出现断电或网络问题,多台机器可能同时失效。多种类型的故障也可能同时发生;几乎无法穷举所有可能的故障场景。
本节列举各类故障,并讨论 etcd 的设计如何容忍这些故障。大多数用户(若非全部)均可将特定故障归入某一类故障。为应对罕见或 不可恢复的故障 ,务必 备份 etcd 集群。
次要跟随者故障
当少于一半的跟随者发生故障时,etcd 集群仍可接受请求并持续进展,不会出现重大中断。例如,五个成员的 etcd 集群中发生两个跟随者故障,不会影响集群的正常运行。然而,客户端将与故障成员失去连接。客户端库应通过自动重连至其他成员,隐藏读请求的中断对用户的影响。系统管理员应预期其他成员的系统负载因重连而增加。
领导者故障排查
当领导者发生故障时,etcd 集群会自动选举新的领导者。领导者故障后,选举不会立即发生。由于故障检测机制基于超时,因此需要大约一个选举超时时间才能完成新领导者的选举。
在选举领导者期间,集群无法处理任何写入操作。选举期间发送的写入请求将被暂存,直到新领导者被选出。
已发送至旧领导者但尚未提交的写入操作可能会丢失。新领导者有权重写前任领导者的所有未提交条目。从用户角度看,新领导者选举后,部分写入请求可能会超时。然而,已提交的写入操作绝不会丢失。
新领导者会自动延长所有租约的超时时间。此机制确保即使租约由旧领导者授予,其有效期也不会在授予的 TTL 到期前终止。
多数节点故障
当集群的多数成员发生故障时,etcd 集群将失效,无法接受更多写入操作。
etcd 集群仅在多数成员恢复可用后,方可完成恢复。若多数成员无法恢复上线,则操作员必须启动 灾难恢复 以恢复集群。
一旦多数成员正常工作,etcd 集群将自动选举出新的领导者,并恢复到健康状态。新的领导者会自动延长所有租约的超时时间。该机制确保因服务器端不可用而导致的租约过期问题不会发生。
网络分区
网络分区与少数跟随者故障或领导者故障类似。网络分区会将 etcd 集群划分为两部分:一部分拥有成员多数,另一部分拥有成员少数。多数侧成为可用集群,少数侧则不可用。etcd 中不存在“脑裂”现象,因为集群成员的增删均需显式操作,且每次变更必须获得当前多数成员的批准。
如果领导者位于多数方,那么从多数方的视角来看,此次故障属于少数跟随者故障。如果领导者位于少数方,则属于领导者故障。位于少数方的领导者将主动降级,多数方将选举出新的领导者。
网络分区解除后,少数方会自动识别多数方的领导者,并恢复其状态。
启动过程中失败
集群引导仅在所有必需成员均成功启动时才能成功。若引导过程中发生任何故障,请删除所有成员上的数据目录,并使用新的集群令牌或新的发现令牌重新引导集群。
当然,可以像恢复运行中的集群一样恢复已启动失败的集群。然而,恢复该集群通常需要比启动新集群更多的时间和资源,因为无需恢复任何数据。
14.8 - 灾难恢复
etcd 设计用于抵御机器故障。etcd 集群可自动从临时故障(例如机器重启)中恢复,并能容忍最多 (N−1)/2 个成员的永久性故障,适用于由 N 个成员组成的集群。当某个成员发生永久性故障(无论是硬件故障还是磁盘损坏)时,该成员将失去对集群的访问权限。若集群永久性丢失超过 (N−1)/2 个成员,则将发生灾难性故障,法定人数不可逆地丢失。一旦法定人数丢失,集群将无法达成共识,因而无法继续接受更新。
为从灾难性故障中恢复,etcd v3 提供了快照与恢复功能,可在不丢失 v3 键数据的情况下重建集群。如需恢复 v2 键,请参阅 v2 管理指南 。
键空间快照
恢复集群首先需要从 etcd 成员获取键空间的快照。快照可通过以下方式获取:使用 etcdctl snapshot save 命令从运行中的成员获取,或从 etcd 数据目录中复制 member/snap/db 文件。例如,以下命令将 $ENDPOINT 提供的键空间快照保存至文件 snapshot.db:
请注意,从 member/snap/db 文件获取快照可能会丢失尚未写入但已包含在 wal(预写日志)文件夹中的数据。
快照状态
要了解某个快照所包含的修订版本和哈希值,可以使用 etcdutl snapshot status 命令:
恢复集群
修订版本差异
在恢复集群时,现有客户端可能会感知到修订版本倒退数百甚至数千个。这是因为特定快照仅包含截至其创建时刻的数据版本历史,而当前状态可能已向前推进得更远。
当使用 etcd 运行 Kubernetes 时,此问题尤为突出,控制器和操作员可能使用所谓的 informers 作为本地缓存,并通过监听机制获取更新通知。恢复到较早的修订版本可能无法正确刷新缓存,导致控制器出现不可预测且不一致的行为。
在从快照恢复的场景下,例如已知的监听 API 消费者、etcd 数据的本地缓存副本,或在一般情况下使用 Kubernetes 时,强烈建议使用以下“修订版本提升”方式进行恢复。
从快照恢复
要恢复集群,仅需一个快照“db”文件即可。使用 etcdutl snapshot restore 执行集群恢复时,会创建新的 etcd 数据目录;所有成员应使用相同的快照进行恢复。恢复操作会覆盖部分快照元数据(特别是成员 ID 和集群 ID);成员将失去原有身份。此元数据覆盖可防止新成员意外加入现有集群。因此,要从快照启动集群,恢复操作必须启动一个新的逻辑集群。
简单的恢复操作可按如下方式执行:
完整性检查
快照完整性可在恢复时选择性地进行验证。若快照是使用 etcdctl snapshot save 创建的,则会包含完整性哈希,该哈希由 etcdutl snapshot restore 进行校验。若快照是从数据目录复制的,则不包含完整性哈希,只能通过 --skip-hash-check 恢复。
使用修订版本恢复
为确保恢复后修订版本永不递减,可提供 --bump-revision 选项。该选项接受一个 64 位整数,表示在快照当前修订版本基础上增加的修订版本数。由于每次向 etcd 写入都会使修订版本加一,因此只要 etcd 每秒写入次数少于 1500 次,即可通过增加 1'000'000'000 个修订版本来覆盖一周前的快照。
在 Kubernetes 控制器的上下文中,还应使用 --mark-compacted 标记所有修订版本,包括版本递增操作,以执行压缩。这可确保所有监听操作被终止,且 etcd 不再响应关于快照创建后发生的修订版本的请求——从而有效使 informer 缓存失效。
完整调用示例如下:
使用更新后的成员信息恢复
etcd 集群的成员信息存储在 etcd 自身中,并通过 Raft 共识算法进行维护。当完全失去法定人数时,应重新考虑新集群的组建位置和方式,例如在一组全新的成员上进行组建。
从快照恢复时,可直接将新的成员信息提供给数据存储,如下所示:
这确保了新构建的集群仅与具有指定令牌的其他已恢复成员连接,而不会连接到可能仍处于活跃状态的旧成员。
另一种做法是在启动 etcd 时提供 --force-new-cluster,在保留现有应用数据的同时覆盖集群成员关系。强烈不建议采用此方法;如果旧集群的其他成员仍在运行,etcd 将发生 panic。务必定期保存快照。
全流程示例
使用以下命令从运行中的集群获取快照:
接续上一示例,以下为三成员集群创建新的 etcd 数据目录(m1.etcd、m2.etcd、m3.etcd):
接下来,使用新的数据目录启动 etcd:
现在,已恢复的 etcd 集群应已可用,并开始提供快照中的键空间服务。
从 etcd v3.6 开始,用户只能使用 etcdctl 将数据保存为快照,而必须使用 etcdutl 从快照恢复数据。若未指定 --data-dir,则默认 --data-dir 值为 <name>.etcd(其中 <name> 为 --name 的值)。例如,若未提供 --data-dir,且成员名称为 m1、m2 和 m3,则 --data-dir 目录分别为 m1.etcd、m2.etcd 和 m3.etcd。
14.9 - etcd 网关
etcd 网关是什么
etcd 网关是一个简单的 TCP 代理,负责将网络数据转发至 etcd 集群。网关为无状态且透明的;它既不检查客户端请求,也不干扰集群响应。网关不会终止 TLS 连接,不会代表客户端执行 TLS 握手,也不会验证连接是否已加密。
网关支持多个 etcd 服务器端点,并采用简单的轮询策略。它仅将请求路由至可用端点,并向客户端隐藏故障。未来可能支持其他重试策略,例如加权轮询。
何时使用 etcd 网关
每个访问 etcd 的应用程序都必须首先知晓 etcd 集群客户端端点的地址。如果同一服务器上的多个应用程序访问同一个 etcd 集群,每个应用程序仍需知晓 etcd 集群的通告客户端端点。如果 etcd 集群重新配置为使用不同的端点,每个应用程序也可能需要更新其端点列表。这种大规模的重新配置既繁琐又容易出错。
etcd 网关通过作为稳定的本地端点来解决此问题。典型的 etcd 网关配置中,每台机器上运行一个监听本地地址的网关,每个 etcd 应用程序连接到其本地网关。结果是,只需更新网关的端点,而无需逐一更新每个应用程序。
综上所述,为自动传播集群端点变更,etcd 网关需在每台运行多个访问同一 etcd 集群的应用程序的机器上运行。
何时不应使用 etcd 网关
- 提升性能
网关并非用于提升 etcd 集群性能。它不提供缓存、监听合并或批处理功能。etcd 团队正在开发一种用于提升集群可扩展性的缓存代理。
- 在集群管理系统上运行
高级集群管理系统(如 Kubernetes)原生支持服务发现。应用程序可通过系统管理的 DNS 名称或虚拟 IP 地址访问 etcd 集群。例如,kube-proxy 相当于 etcd 网关。
启动 etcd 网关
考虑一个具有以下静态端点的 etcd 集群:
| 名称 | 地址 | 主机名 | 端口 |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
使用以下命令启动 etcd 网关,以通过静态端点进行访问:
或者,若使用 DNS 进行服务发现,请考虑使用 DNS SRV 记录:
使用以下命令启动 etcd 网关,从 DNS SRV 条目中获取端点:
配置标志
etcd 集群
–endpoints
- 用逗号分隔的 etcd 服务器端点列表,用于转发客户端连接。
- 默认值:
127.0.0.1:2379 - 必须包含端口。
- 无效示例:
https://127.0.0.1:2379(网关不终止 TLS)。请注意,网关不会验证 HTTP 协议模式或检查请求内容,仅将请求转发至指定端点。
–discovery-srv
- 用于通过 SRV 记录引导集群端点的 DNS 域名。
- 默认值:未设置
网络
–listen-addr
- 用于接收客户端请求的接口和端口。
- 默认值:
127.0.0.1:23790
–retry-delay
- 重试连接已失败端点前的延迟时长。
- 默认值:1m0s
- 无效示例:“123”(期望以时间单位格式提供)
安全
–insecure-discovery
- 接受不安全或易受中间人攻击的 SRV 记录。
- 默认值:
false
–trusted-ca-file
- 客户端 TLS CA 文件路径,用于 etcd 集群验证 SRV 发现返回的端点。请注意,该设置仅用于认证发现的端点,而非用于数据传输的连接建立。网关不会终止 TLS 连接,也不会代表客户端创建 TLS 连接。
- 默认值:未设置
14.10 - gRPC 代理
gRPC 代理是运行在 gRPC 层(L7)的无状态 etcd 反向代理。该代理旨在降低核心 etcd 集群的总体处理负载。为实现横向扩展,代理会合并监听和租约 API 请求。为防止恶意客户端对集群造成影响,代理会缓存键范围请求。
gRPC 代理支持多个 etcd 服务器端点。代理启动时,会随机选择一个 etcd 服务器端点使用。该端点将处理所有请求,直至代理检测到端点故障。若 gRPC 代理检测到端点故障,且存在其他可用端点,则会切换至其他端点,以向客户端隐藏故障。未来可能支持其他重试策略,例如加权轮询。
可扩展的监听 API
gRPC 代理将同一键或范围上的多个客户端监听器(c-watchers)合并为一个连接到 etcd 服务器的监听器(s-watcher)。代理将 s-watcher 的所有事件广播给其 c-watchers。
假设有 N 个客户端监听同一个键,一个 gRPC 代理可将 etcd 服务器的监听负载从 N 降低至 1。用户可部署多个 gRPC 代理以进一步分摊服务器负载。
在以下示例中,三个客户端监听键 A。gRPC 代理将这三个监听器合并为一个监听器,该监听器连接到 etcd 服务器。
限制
为有效将多个客户端监听器合并为单一监听器,gRPC 代理在可能的情况下会将新的 c-watchers 合并至现有的 s-watcher。由于网络延迟或缓冲未送达的事件,该合并后的 s-watcher 可能与 etcd 服务器不同步。当监听修订版本未指定时,gRPC 代理不能保证 c-watcher 会从最新的存储修订版本开始监听。例如,若客户端从修订版本为 1000 的 etcd 服务器进行监听,该监听器将从修订版本 1000 开始。若客户端从 gRPC 代理进行监听,可能从修订版本 990 开始监听。
取消操作也存在类似的限制。当监听器被取消时,etcd 服务器的修订版本可能大于取消响应的修订版本。
上述两项限制通常不会对大多数使用场景造成影响。未来可能会增加额外选项,以强制监听器绕过 gRPC 代理,从而获得更精确的修订版本响应。
可扩展的租约 API
为保持租约有效,客户端必须至少建立一个 gRPC 流至 etcd 服务器,以发送周期性心跳。若 etcd 工作负载涉及大量租约操作且分布于多个客户端,这些流可能导致 CPU 利用率过高。为减少核心集群上的总流数,代理支持租约流合并。
假设有 N 个客户端在更新租约,单个 gRPC 代理可将 etcd 服务器的流负载从 N 降低至 1。部署中可增加额外的 gRPC 代理,以进一步将流分布到多个代理上。
在以下示例中,三个客户端分别更新三个独立的租约(L1、L2 和 L3)。gRPC 代理将这三个客户端的租约流(c-streams)合并为一个附加到 etcd 服务器的租约保活流(s-stream)。代理将客户端侧租约心跳从 c-流转发至 s-流,随后将响应返回至对应的 c-流。
客户端滥用防护
gRPC 代理在不违反一致性要求的前提下,会缓存请求的响应。这可以防止在紧密循环中运行的恶意客户端对 etcd 服务器造成过载。
启动 etcd gRPC 代理
考虑一个具有以下静态端点的 etcd 集群:
| 名称 | 地址 | 主机名 |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
使用以下命令启动 etcd gRPC 代理,以通过这些静态端点进行访问:
etcd gRPC 代理启动并在端口 2379 上监听。它将客户端请求转发至上述三个端点中的一个。
通过代理发送请求:
客户端端点同步与名称解析
代理支持将端点注册至用户定义的发现端点,以供发现。此举具有两个目的。首先,它允许客户端将其端点与一组代理端点同步,以实现高可用性。其次,它是 etcd gRPC 命名 的端点提供者。
通过提供用户自定义前缀来注册代理:
代理将列出其所有成员的成员列表:
这使得客户端可通过 Sync 自动发现代理端点:
请注意,如果配置代理时未指定解析器前缀,
成员列表 API 通过 gRPC 代理返回其自身的 advertise-client-url:
命名空间
假设某个应用需要完全控制整个键空间,但 etcd 集群与其他应用共享。为使所有应用能够互不干扰地运行,代理可对 etcd 键空间进行分区,使客户端看似拥有对完整键空间的访问权限。当代理收到标志 --namespace 时,所有进入代理的客户端请求都会被转换,使键带上用户自定义的前缀。对 etcd 集群的访问将基于该前缀,而代理返回的响应会移除前缀;对客户端而言,似乎根本不存在前缀。
要为代理命名空间,请使用 --namespace 启动它:
对代理的访问现在已透明地在 etcd 集群上添加前缀:
TLS 终止
通过 gRPC 代理终止安全 etcd 集群的 TLS,通过提供一个未加密的本地端点。
尝试操作,请使用客户端 HTTPS 启动单成员 etcd 集群:
确认客户端端口正在提供 HTTPS 服务:
接下来,在 localhost:12379 上启动一个 gRPC 代理,通过客户端证书连接到 etcd 端点 https://localhost:2379:
最后,通过使用 HTTP 向代理写入键来测试 TLS 终止:
指标与健康状况
gRPC 代理为 --endpoints 定义的 etcd 成员暴露 /health 和 Prometheus /metrics 端点。可另定义一个额外的 URL,该 URL 将对 /metrics 和 /health 端点响应,并设置 --metrics-addr 标志。
已知问题
代理的主要接口同时支持 HTTP/2 和 HTTP/1.1。若如上例所示配置了 TLS,当使用 cURL 等客户端访问监听接口时,必须在请求中显式设置协议为 HTTP/1.1,才能返回 /metrics 或 /health。通过使用 --metrics-addr 标志,次要接口将不再具有此要求。
14.11 - 硬件推荐
etcd 在资源有限的开发或测试环境中通常运行良好;在笔记本电脑或廉价云主机上开发 etcd 是常见做法。然而,在生产环境中运行 etcd 集群时,遵循一些硬件建议有助于实现有效的系统管理。这些建议并非硬性规定,而是构建稳健生产部署的良好起点。和往常一样,部署前应使用模拟工作负载进行测试。
处理器核心
极少有 etcd 部署需要大量 CPU 资源。典型集群只需两到四个核心即可平稳运行。
高负载的 etcd 部署(例如每秒服务数千个客户端或数万个请求)通常受 CPU 限制,因为 etcd 可以从内存中提供请求服务。此类高负载部署通常需要八到十六个专用核心。
内存
etcd 的内存占用相对较小,但其性能仍依赖于充足的内存。etcd 服务器会积极缓存键值数据,并将大部分其他内存用于跟踪监听器。通常 8GB 内存已足够。对于拥有数千个监听器和数百万个键的高负载部署,应相应分配 16GB 至 64GB 内存。
磁盘
快速磁盘是影响 etcd 部署性能和稳定性的最关键因素。
慢速磁盘会增加 etcd 请求延迟,并可能影响集群稳定性。由于 etcd 的共识协议依赖于将元数据持久化存储到日志中,集群中多数成员必须将每个请求写入磁盘。此外,etcd 还会将状态增量式地进行快照并写入磁盘,以便截断该日志。若这些写入操作耗时过长,心跳可能超时并触发选举,从而破坏集群稳定性。通常,可通过基准测试工具如 fio 判断磁盘是否足够快以满足 etcd 需求。请参阅 here 了解示例。
etcd 对磁盘写入延迟非常敏感。通常需要 50 个顺序 IOPS(例如,7200 RPM 磁盘)。对于负载较高的集群,建议使用 500 个顺序 IOPS(例如,典型的本地 SSD 或高性能虚拟化块设备)。请注意,大多数云服务提供商公布的都是并发 IOPS 而非顺序 IOPS;公布的并发 IOPS 可能是顺序 IOPS 的 10 倍。为测量实际的顺序 IOPS,建议使用磁盘基准测试工具,例如 diskbench 或 fio 。
etcd 对磁盘带宽的要求较低,但更高的磁盘带宽可在成员故障后快速追上集群时显著缩短恢复时间。通常,10 MB/s 的带宽可在 15 秒内完成 100 MB 数据的恢复。对于大规模集群,建议使用 100 MB/s 或更高的带宽,以在 15 秒内完成 1 GB 数据的恢复。
在可能的情况下,使用 SSD 作为 etcd 存储的后端。SSD 通常比传统旋转磁盘提供更低的写入延迟,并且延迟波动更小,从而提升 etcd 的稳定性和可靠性。若使用旋转磁盘,应选择转速尽可能高的磁盘(例如 15,000 RPM)。使用 RAID 0 也是提升磁盘速度的有效方式,适用于旋转磁盘和 SSD。当集群中至少有三个成员时,RAID 的镜像或奇偶校验等冗余模式不再必要,因为 etcd 的一致性复制已提供高可用性。
网络
多成员 etcd 部署得益于快速且可靠的网络。为确保 etcd 在一致性和分区容错性方面表现良好,不可靠且存在分区故障的网络会导致可用性下降。低延迟可确保 etcd 成员之间通信迅速。高带宽可缩短故障成员恢复所需时间。对于常见的 etcd 部署,1GbE 网络已足够。对于大型 etcd 集群,采用 10GbE 网络可进一步降低平均恢复时间。
在可能的情况下,将 etcd 成员部署于单一数据中心,以避免延迟开销并降低分区事件的发生概率。若需在其他数据中心设置故障域,请选择与现有数据中心更近的数据中心。请同时阅读 tuning 文档,以获取关于跨数据中心部署的更多信息。
示例硬件配置
以下是 AWS 和 GCE 环境中的一些典型硬件配置示例。如前所述,尽管必须反复强调,系统管理员在将 etcd 部署投入生产环境前,应使用模拟工作负载进行测试。
请注意,这些配置假设这些机器完全专用于 etcd。在这些机器上同时运行其他应用程序可能导致资源争用,进而引发集群不稳定。
小型集群
小型集群支持的客户端数量少于 100 个,每秒请求数少于 200 次,存储数据量不超过 100MB。
示例应用工作负载:一个包含 50 个节点的 Kubernetes 集群
| 提供商 | 类型 | vCPU 数量 | 内存 (GB) | 最大并发 IOPS | 磁盘带宽 (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
中等规模集群
一个中等规模的集群支持的客户端少于 500 个,每秒请求数少于 1,000 次,存储数据量不超过 500MB。
示例应用负载:一个包含 250 个节点的 Kubernetes 集群
| 提供商 | 类型 | vCPU 数量 | 内存 (GB) | 最大并发 IOPS | 磁盘带宽 (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
大规模集群
大规模集群支持的客户端数量少于 1,500 个,每秒请求数少于 10,000 次,存储数据量不超过 1 GB。
示例应用负载:1,000 节点的 Kubernetes 集群
| 提供商 | 类型 | vCPU 数量 | 内存 (GB) | 最大并发 IOPS | 磁盘带宽 (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
大规模集群
一个 xLarge 集群可支持超过 1,500 个客户端,每秒处理超过 10,000 个请求,并存储超过 1 GB 的数据。
示例应用负载:一个包含 3,000 个节点的 Kubernetes 集群
| 提供商 | 类型 | vCPU 数量 | 内存 (GB) | 最大并发 IOPS | 磁盘带宽 (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
14.12 - 维护
概述
etcd 集群需要定期维护以保持可靠性。根据 etcd 应用的需求,此类维护通常可以自动化执行,且无需停机或显著降低性能。
本文所述的 etcd 维护操作均用于管理 etcd 键空间所占用的存储资源。若未能充分控制键空间大小,系统将通过存储空间配额进行防护;当 etcd 成员可用空间不足时,配额将触发集群范围的告警,使系统进入受限操作的维护模式。为避免键空间写入空间耗尽,必须对 etcd 键空间历史数据执行压缩。存储空间本身可通过整理碎片来回收。此外,定期对 etcd 成员状态进行快照备份,可实现对因操作失误导致的意外逻辑数据丢失或数据损坏的恢复。
Raft 日志保留
etcd --snapshot-count 配置在执行压缩前需在内存中保留的已应用 Raft 条目数量。当 --snapshot-count 达到时,服务器会先将快照数据持久化到磁盘,然后截断旧的条目。当慢速跟随者请求的日志索引早于已压缩的索引时,领导者会发送快照,强制跟随者覆盖其状态。
较高的 --snapshot-count 会在生成快照前将更多 Raft 条目保留在内存中,从而导致 内存使用量持续较高
。由于领导者会更长时间保留最新的 Raft 条目,缓慢的跟随者有更多时间在领导者生成快照前完成追赶。--snapshot-count 是较高内存使用与缓慢跟随者更高可用性之间的权衡。
自 v3.2 起,--snapshot-count 的默认值已 从 10,000 改为 100,000
。
从性能角度而言,--snapshot-count 超过 100,000 可能会影响写入吞吐量。内存中对象数量过多会减慢 Go GC 标记阶段 runtime.scanobject
,且内存回收不频繁会导致分配变慢。性能表现因工作负载和系统环境而异。然而,通常情况下,压缩过于频繁会影响集群可用性及写入吞吐量;压缩过于稀疏同样有害,会向 Go 垃圾回收器施加过大压力。更多研究结果请参见 Understanding Performance Aspects of etcd and Raft
。
历史压缩:v3 API 键值数据库
由于 etcd 会保留键空间的完整历史记录,因此应定期执行压缩以避免性能下降及最终存储空间耗尽。执行压缩操作会丢弃指定键空间修订版本之前所有被覆盖键的相关信息。这些键所占用的空间随后将可用于键空间的额外写入操作。
键空间可通过 etcd 的时间窗口历史保留策略自动执行压缩,或通过 etcdctl 手动执行压缩。etcdctl 方法可对压缩过程提供细粒度控制,而自动压缩适用于仅需保留一段时间键历史的应用场景。
etcdctl 执行压缩的过程如下:
执行压缩后的修订版本之前的所有修订版本将变得不可访问:
自动压缩
etcd 可通过设置 --auto-compaction-mode 和 --auto-compaction-retention 选项自动对键空间执行压缩。压缩模式有两种:periodic(默认)和 revision。
周期性压缩
周期性压缩保留基于时间的键空间历史窗口:
保留值指定要保留的历史记录量。一条记录在创建后约经过该时长才会被压缩。这确保了慢速监听器仍能在保留窗口内完成追赶。
当保留周期大于 1 小时时,etcd 每小时执行一次压缩,同时保持完整的保留窗口。当保留周期为 1 小时或更短时,etcd 按保留周期间隔执行压缩。
例如,使用 --auto-compaction-retention=10h 时,etcd 首次压缩前等待 10 小时,之后每隔一小时执行一次压缩:
推荐值取决于具体使用场景:
- 对同一键频繁更新:较短周期,例如
1h或30m - 更新频率较低:较长周期,例如
24h、48h或72h - 通用默认值:
10h
修订版本压缩
修订版本压缩保留固定数量的修订版本:
etcd 每 5 分钟检查一次,并对 "latest revision" - 1000 执行压缩。例如,当最新修订版本为 30000 时,它将对修订版本 29000 执行压缩。
碎片整理
执行键空间压缩后,后端数据库可能会出现内部碎片。内部碎片是指后端数据库中虽已空闲但仍在占用存储空间的区域。压缩旧版修订版本会通过在后端数据库中留下空隙,导致 etcd 出现内部碎片。这些碎片空间可供 etcd 使用,但对主机文件系统不可用。换句话说,删除应用数据不会释放磁盘空间。
碎片整理过程会将这部分存储空间释放回文件系统。碎片整理按成员分别执行,以避免引发集群范围内的延迟峰值。
要整理 etcd 成员的碎片,请使用 etcdctl defrag 命令:
请注意,对运行中的成员执行碎片整理会阻塞系统读写数据,直至其状态重建完成
请注意,碎片整理请求不会在集群中复制。也就是说,该请求仅应用于本地节点。请在 --endpoints 标志或 --cluster 标志中指定所有成员,以自动发现集群中的所有成员。
对与默认端点关联的集群中的所有端点执行碎片整理操作:
要直接对 etcd 数据目录进行碎片整理,且 etcd 未运行时,请使用以下命令:
空间配额
etcd 中的存储配额确保集群以可靠方式运行。若无存储配额,当键空间过度增长时,etcd 可能出现性能下降,或直接耗尽存储空间,导致集群行为不可预测。若任一成员的键空间后端数据库超过存储配额,etcd 将触发集群级告警,使集群进入仅接受键读取和删除操作的维护模式。只有在键空间中释放足够空间、完成后端数据库碎片整理,并清除存储配额告警后,集群方可恢复常规运行。
默认情况下,etcd 设置了一个适用于大多数应用的保守空间配额,但可通过命令行以字节为单位进行配置:
空间配额可由循环触发:
删除过多的键空间数据并整理后端数据库,可使集群恢复至配额限制范围内:
指标 etcd_mvcc_db_total_size_in_use_in_bytes 表示执行历史压缩后的实际数据库使用量,而 etcd_debugging_mvcc_db_total_size_in_bytes 显示包含待整理碎片的空闲空间在内的数据库大小。后者仅在前者接近其值时增加,这意味着当这两个指标均接近配额时,必须执行历史压缩以避免触发空间配额限制。
etcd_debugging_mvcc_db_total_size_in_bytes 从 v3.4 版本起重命名为 etcd_mvcc_db_total_size_in_bytes。
对于 Put/Txn/LeaseGrant 请求,可能会收到 ErrGRPCNoSpace 错误,但写入请求仍可能在后端数据库中成功,因为 etcd 在 API 层和内部 Apply 层均检查空间配额,而 Apply 层仅会触发 NOSPACE 告警,不会阻塞事务的继续执行。
快照备份
定期对 etcd 集群进行快照,可为 etcd 键空间提供持久化备份。通过定期对 etcd 成员的后端数据库进行快照,etcd 集群可恢复至某个时间点且状态已知良好的状态。
使用 etcdctl 执行快照操作:
14.13 - 监控 etcd
每个 etcd 服务器通过其客户端端口上的 HTTP 端点提供本地监控信息。监控数据对于系统健康检查和集群调试均具有实用价值。
调试端点
若设置 --log-level=debug,etcd 服务器将在其客户端端口的 /debug 路径下导出调试信息。设置 --log-level=debug 时需谨慎,因为会导致性能下降和日志输出过于 verbose。
/debug/pprof 端点是标准的 Go 运行时性能分析端点。该端点可用于分析 CPU、堆、互斥锁和协程的使用情况。例如,以下命令通过 go tool pprof 获取 etcd 花费时间最多的前 10 个函数:
端点 /debug/requests 通过网页浏览器提供 gRPC 跟踪信息和性能统计数据。例如,以下是一个针对键 abc 的 Range 请求:
指标端点
每个 etcd 服务器在其客户端端口上通过 /metrics 路径导出指标,并可选地通过 --listen-metrics-urls 指定的位置导出。
指标可通过 curl 获取:
健康检查
自 v3.3.0 起,除了响应 /metrics 端点外,任何由 --listen-metrics-urls 指定的位置也将响应 /health 端点。若标准端点配置了双向(客户端) TLS 身份认证,但负载均衡器或监控服务仍需访问健康检查时,此功能可提供便利。
从 v3.4 版本起,新增了两个端点 /livez 和 /readyz。
/livez端点反映进程是否正常运行,或是否需要重启。/readyz端点反映进程是否已就绪,可接收流量。
端点的设计细节在 KEP 中有详细记录。
每个端点包含多个独立的健康检查,可以使用 verbose 参数打印出检查详情及其状态,例如
将看到类似以下的响应:
HTTP API 还支持排除特定检查,例如
Prometheus
运行 Prometheus 监控服务是采集和记录 etcd 指标最简便的方式。
首先,安装 Prometheus:
将 Prometheus 的抓取器配置为指向 etcd 集群端点:
设置 Prometheus 处理程序:
现在 Prometheus 每 10 秒采集一次 etcd 指标。
告警
etcd v3 集群为 Prometheus 提供了一组 默认告警 。
请注意,job 标签可能需要根据特定需求进行调整。规则编写时仅适用于单个集群,因此建议选择仅属于特定集群的标签。
Grafana
Grafana 内置了 Prometheus 支持;只需添加一个 Prometheus 数据源:
然后导入默认的 etcd dashboard template
并进行自定义。例如,若 Prometheus 数据源名称为 my-etcd,则 JSON 中的 datasource 字段值也需相应设置为 my-etcd。
示例仪表板:
分布式跟踪
在 v3.5 版本中,etcd 已添加对使用 OpenTelemetry 的分布式追踪支持。
该功能仍处于实验阶段,可能随时更改。
要启用此实验性功能,请向 etcd 服务器传递 --experimental-enable-distributed-tracing=true,并配合 --experimental-distributed-tracing-sampling-rate=<number> 标志以选择每百万跨度收集的采样数量,默认采样率为 0。
通过以下可选标志启动 etcd 服务器,以配置分布式追踪:
--experimental-distributed-tracing-address- (可选) - “localhost:4317” - 跟踪收集器的地址。--experimental-distributed-tracing-service-name- (可选) - “etcd” - 分布式追踪服务名称,所有 etcd 实例之间必须保持一致。--experimental-distributed-tracing-instance-id- (可选) - 实例 ID,虽然可选,但强烈建议设置,每个 etcd 实例必须唯一。
启用分布式追踪前,请确保已配置 OpenTelemetry 端点。若该地址与默认值不同,请使用 --experimental-distributed-tracing-address 标志进行覆盖。由于 OpenTelemetry 存在多种运行方式,请参阅 collector 文档
以获取更多信息。
与任何可观测性信号一样,存在资源开销。根据我们的初步测量,该开销可能在 2% 至 4% 的 CPU 开销之间。
14.14 - 性能
理解性能
etcd 提供稳定、持续的高性能。性能由两个因素决定:延迟和吞吐量。延迟是指完成操作所需的时间。吞吐量是指在一定时间周期内完成的总操作数。通常情况下,当 etcd 接受并发客户端请求时,平均延迟会随着整体吞吐量的增加而上升。在常见的云环境(如 Google Compute Engine (GCE) 上的标准 n-4 实例,或 AWS 上相当的机器类型)中,三成员 etcd 集群在轻负载下请求完成时间小于 1 毫秒,重负载下每秒可完成超过 30,000 次请求。
etcd 使用 Raft 共识算法在成员之间复制请求并达成一致。共识性能,尤其是提交延迟,受限于两个物理因素:网络 I/O 延迟和磁盘 I/O 延迟。完成一次 etcd 请求所需的最短时间,是成员之间的网络往返时间(RTT),加上 fdatasync 将数据提交至持久存储所需的时间。数据中心内部的 RTT 可能长达数百微秒。美国境内的典型 RTT 约为 50ms,跨洲际的 RTT 可能慢至 400ms。传统旋转磁盘的典型 fdatasync 延迟约为 10ms。对于 SSD,延迟通常低于 1ms。为提升吞吐量,etcd 将多个请求批量处理并提交至 Raft。该批处理策略使 etcd 即便在高负载下也能实现高吞吐量。
其他子系统也会影响 etcd 的整体性能。每个序列化的 etcd 请求都必须经过基于 boltdb 的 MVCC 存储引擎处理,通常需要数十微秒完成。etcd 会周期性地对其最近应用的请求进行增量快照,并将其与之前的磁盘快照合并。此过程可能导致延迟突增。尽管在 SSD 上通常不是问题,但在 HDD 上可能导致观测到的延迟翻倍。同样,正在进行的压缩操作也可能影响 etcd 的性能。幸运的是,影响通常不显著,因为压缩操作是分阶段执行的,不会与常规请求争用资源。gRPC 作为 RPC 系统,为 etcd 提供了定义明确且可扩展的 API,但也引入了额外延迟,尤其在本地读取时更为明显。
基准测试
使用 etcd 自带的 benchmark 命令行工具可对 etcd 性能进行基准测试。
针对一些基准性能数据,我们以具有以下硬件配置的三成员 etcd 集群为例:
- Google Cloud Compute Engine
- 3 台 8 个 vCPU + 16GB 内存 + 50GB SSD 的机器
- 1 台客户端机器(16 个 vCPU + 30GB 内存 + 50GB SSD)
- Ubuntu 17.04
- etcd 3.2.0,go 1.8.3
使用此配置时,etcd 大约可写入:
| 键数量 | 键大小(字节) | 值大小(字节) | 连接数 | 客户端数 | 目标 etcd 服务器 | 平均写入 QPS | 平均每次请求延迟 | 平均服务器 RSS |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | 仅领导者 | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | 仅领导者 | 44,341 | 22ms | 124 MB |
| 100,000 | 8 | 256 | 100 | 1000 | 所有成员 | 50,104 | 20ms | 126 MB |
示例命令如下:
线性一致读取请求需通过集群成员的法定人数达成共识,以获取最新数据。可串行化读取比线性一致读取成本更低,因为其可由任意单个 etcd 成员提供服务,而非需经过成员法定人数,但可能提供过时数据作为代价。etcd 可执行以下读取操作:
| 请求次数 | 键大小(字节) | 值大小(字节) | 连接数 | 客户端数 | 线性一致性 | 平均读取 QPS | 每次请求的平均延迟 |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | 线性一致 | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | 可串行化 | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | 线性一致 | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | 可串行化 | 185,758 | 2.2ms |
示例命令如下:
建议在新环境中首次搭建 etcd 集群时运行基准测试,以确保集群达到足够的性能;集群延迟和吞吐量可能对环境的微小差异较为敏感。
14.15 - 运行时重配置设计
运行时重配置是分布式系统中最为复杂且最容易出错的功能之一,尤其是在基于共识的系统(如 etcd)中。
继续阅读以了解 etcd 运行时重配置命令的设计原理,以及我们如何解决这些问题。
两阶段配置变更确保集群安全
在 etcd 中,每次运行时重配置都必须出于安全考虑,经过 两个阶段 。例如,添加成员时,需先通知集群新配置,再启动新成员。
1 - 通知集群新配置
要将成员添加到 etcd 集群,需通过 API 调用请求将新成员加入集群。这是向现有集群添加新成员的唯一方式。API 调用将在集群就配置变更达成一致后返回。
2 阶段 - 启动新成员
要将新的 etcd 成员加入现有集群,需指定正确的 initial-cluster,并将 initial-cluster-state 设置为 existing。成员启动时,会首先联系现有集群,并验证当前集群配置是否与 initial-cluster 中指定的预期配置一致。当新成员成功启动后,集群即达到预期配置。
通过将流程分为两个独立阶段,用户必须明确指定集群成员关系的变更。这实际上为用户提供了更大的灵活性,也使问题更容易理解。例如,若尝试向 etcd 集群添加一个 ID 与现有成员相同的成员,该操作将在第一阶段立即失败,且不会影响正在运行的集群。类似保护机制可防止因误操作而添加新成员。若新的 etcd 成员在集群尚未接受配置变更前尝试加入集群,该成员将不会被集群接受。
若未明确指定集群成员关系的管理流程,etcd 将面临意外的集群成员关系变更风险。例如,若 etcd 在 systemd 等初始化系统下运行,当通过成员关系 API 移除某个成员后,etcd 会被重启,并在启动时尝试重新加入集群。若 systemd 配置为在失败后重启 etcd,每当通过 API 移除成员时,此循环便会重复发生,这是不符合预期的行为。
我们预计运行时重配置应为低频操作。为确保配置安全并始终在明确控制下平稳运行,我们决定将其保持为显式且由用户驱动。
永久失去法定人数需要新建集群
如果集群永久性地丢失了多数成员,需从旧的数据目录启动新集群,以恢复之前的状态。
完全有可能强制从现有集群中移除故障成员以实现恢复。然而,我们决定不支持此方法,因为它绕过了正常的共识提交阶段,存在安全隐患。如果要移除的成员实际上并未宕机,或在同一个集群中通过不同成员强制移除,etcd 将导致集群出现分叉,且集群 ID 相同。这种情况非常危险,后续难以排查或修复。
在正确部署的情况下,永久性多数节点失联的可能性极低。但该问题严重程度足以引起特别关注。强烈建议阅读 灾难恢复文档 ,并在将 etcd 投入生产环境前,做好应对永久性多数节点失联的准备。
不要使用公共发现服务进行运行时重配置
公共发现服务仅可用于引导集群启动。如需将成员加入现有集群,请使用运行时重配置 API。
发现服务专为在云环境中引导启动 etcd 集群而设计,适用于所有成员的 IP 地址事先未知的情况。成功引导启动集群后,所有成员的 IP 地址均已被知晓。从技术上讲,此时发现服务便不再需要。
使用公共发现服务进行运行时重配置似乎是一种便捷的方式,毕竟发现服务已掌握集群的全部配置信息。然而,依赖公共发现服务会带来诸多问题:
它为集群的整个生命周期引入了外部依赖,而不仅仅是引导阶段。如果集群与公共发现服务之间存在网络问题,集群将受到影响。
公共发现服务必须在其生命周期内准确反映集群的运行时配置。该服务需提供安全机制以防止恶意行为,实现难度较高。
公共发现服务必须维护数以万计的集群配置。我们的公共发现服务后端尚未准备好应对此类工作负载。
要实现支持运行时重配置的发现服务,最佳选择是自行构建私有服务。
14.16 - 运行时重配置
etcd 支持增量式运行时重配置,允许用户在运行时更新集群成员。
重新配置请求仅在集群多数成员正常运行时才能处理。生产环境中强烈建议始终将集群规模设置为大于二。从两成员集群中移除成员是不安全的。两成员集群的多数为两个。若在移除过程中发生故障,集群可能无法继续推进,需 从多数故障中重启 。
为更好地理解运行时重配置的设计原理,请阅读 运行时重配置文档 。
重新配置用例
本节将介绍集群重新配置的一些常见原因。大多数情况仅涉及添加或移除成员的组合操作,具体说明如下,详见 集群重新配置操作 。
批量升级多台机器
如果多个集群成员需因计划内维护(如硬件升级、网络中断等)而迁移,建议逐个修改成员。
安全移除领导者是可行的,但选举过程期间会有一段短暂的停机时间。如果集群中存储的 v2 数据超过 50MB,建议对 成员的数据目录 执行迁移。
修改集群规模
增加集群规模可提升 故障容忍度 ,并提供更优的读取性能。由于客户端可从任意成员读取,增加成员数量可提升整体序列化读取吞吐量。
减小集群规模可提升集群的写入性能,但会降低其容错能力。写入操作在被确认为已提交前,需复制到集群中多数成员。减小集群规模会降低所需的多数成员数,从而使每次写入更快地被提交。
替换故障节点
如果某台机器因硬件故障、数据目录损坏或其他严重情况而发生故障,应尽快予以替换。尚未移除的故障机器会负面影响法定人数,并降低系统对额外故障的容错能力。
要替换机器,请按照 从集群中移除成员 的操作说明执行,然后 添加新成员 以替代原成员。如果集群数据量超过 50MB,建议在原成员数据目录仍可访问的情况下 迁移该成员的数据目录 。
从多数节点故障重启集群
如果集群的多数节点丢失,或所有节点的 IP 地址均发生变更,则必须通过手动操作来安全恢复。恢复过程的基本步骤包括 使用旧数据创建新集群 、强制单个成员作为领导者,最后通过运行时配置逐个 添加新成员 至该新集群。
从少数派失败中恢复集群
若某个特定成员丢失,则相当于替换一台故障机器。具体步骤请参见 Replace a failed machine 。
集群重新配置操作
考虑到这些使用场景,每种相关操作均可予以描述。
在进行任何更改之前,必须有 etcd 成员的简单多数(法定人数)可用。这与向 etcd 执行任何写操作的基本要求相同。
对集群的所有更改必须按顺序执行:
- 若要更新单个成员的 peerURLs,请执行更新操作
- 若要替换健康的单个成员,请先移除旧成员,再添加新成员
- 若要从 3 个成员增加到 5 个成员,请执行两次添加操作
- 若要从 5 个成员减少到 3 个成员,请执行两次移除操作
所有示例均使用 etcd 自带的 etcdctl 命令行工具。如需在不使用 etcdctl 的情况下更改成员关系,请使用 v2 HTTP members API
或 v3 gRPC members API
。
更新成员
更新广告客户端 URL
要更新成员的通告客户端 URL,只需使用更新后的客户端 URL 标志(--advertise-client-urls)或环境变量(ETCD_ADVERTISE_CLIENT_URLS)重启该成员。重启后的成员将自动发布更新后的 URL。错误更新的客户端 URL 不会影响 etcd 集群的健康状态。
更新对等成员广告 URL
要更新成员的通告对等成员 URL,需先通过 member 命令显式更新,然后重启该成员。由于更新对等成员 URL 会更改集群范围的配置,可能影响 etcd 集群的健康状态,因此需要额外执行此操作。
要更新通告的对等成员 URL,首先需找到目标成员的 ID。列出所有成员的命令如下:etcdctl
本示例将 update a8266ecf031671f3 成员 ID,并将其 peerURLs 值更改为 http://10.0.1.10:2380:
移除成员
假设要移除的成员 ID 为 a8266ecf031671f3。使用 remove 命令执行移除操作:
目标成员将在此时自行停止,并在日志中输出移除信息:
安全移除领导者是可行的,但在此期间集群将处于不可用状态,直到新的领导者被选举出来。该持续时间通常为选举超时时间加上投票过程所需时间。
添加新成员
添加成员是一个两步过程:
- 通过 HTTP 成员 API
、gRPC 成员 API
或
etcdctl member add命令将新成员添加至集群。 - 使用包含更新后成员列表(现有成员 + 新成员)的新集群配置启动新成员。
etcdctl 通过指定成员的 名称
和 已通告的对等成员 URL
,将新成员添加到集群中:
etcdctl 已向集群通报了新成员,并打印出成功启动该成员所需的环境变量。现在请使用新成员的相关标志启动新的 etcd 进程:
新成员将作为集群的一部分运行,并立即开始追赶集群中其他成员的进度。
若添加多个成员,最佳实践是逐个配置成员,并在添加更多新成员前验证每个成员是否已正确启动。若向单成员集群添加新成员,在新成员启动前,集群无法推进,因为达成共识需要多数成员(即至少两个成员)达成一致。此行为仅发生在 etcdctl member add 通知集群新成员存在,且新成员成功与现有成员建立连接之间的时段。
添加一个学习者成员
从 v3.4 版本开始,etcd 支持以学习者成员 / 非投票成员身份添加新成员。 其设计动机与架构详情请参见 设计文档 。 为使添加新成员的过程更加安全,并在添加新成员时降低集群停机时间,建议将新成员以学习者成员身份加入集群,直至其完成数据同步。该过程可描述为三个步骤:
通过 gRPC members API 或
etcdctl member add --learner命令,将新成员添加为学习者成员。使用新的集群配置启动新成员,配置中包含更新后的成员列表(现有成员 + 新成员)。 此步骤与之前完全相同。
通过 gRPC members API 或
etcdctl member promote命令,将新添加的学习者成员提升为投票成员。etcd 服务器会验证提升请求,以确保操作安全。 只有当学习者成员的 Raft 日志已追赶上领导者时,才能将其提升为投票成员。 若学习者成员尚未追赶上领导者的 Raft 日志,成员提升请求将失败(详见[提升成员时的错误情况]一节获取更多细节)。 在此情况下,应等待片刻后重试。
在 v3.4 版本中,etcd 服务器将集群可拥有的学习者成员数量限制为一个。主要考虑是减少因将数据从领导者传播到学习者成员而给领导者带来的额外负载。
使用 etcdctl member add 并配合标志 --learner,可将新成员作为学习者成员添加至集群。
新添加的学习者成员启动新的 etcd 进程后,使用 etcdctl member promote 将该学习者成员提升为投票成员。
添加成员时的错误情况
在以下情况下,新主机未包含在已枚举节点的列表中。如果这是一个新集群,必须将该节点添加到初始集群成员列表中。
在这种情况下,请使用与加入集群时不同的地址(10.0.1.14:2380),而非用于加入集群的地址(10.0.1.13:2380):
如果 etcd 启动时使用了已移除成员的数据目录,且连接到集群中的任何活跃成员,则 etcd 会自动退出:
添加学习者成员时的错误情况
如果集群中已存在 1 个学习者成员,则无法再添加学习者成员(v3.4)。
晋升学习者成员时的错误情况
学习者成员只有在与领导者同步后,才能被提升为投票成员。
提升非学习者成员将失败。
提升集群中不存在的成员将失败。
严格重新配置检查模式 (-strict-reconfig-check)
如上所述,添加新成员的最佳实践是每次仅配置一个成员,并在添加更多新成员前验证其是否正确启动。逐步进行此操作至关重要,因为如果新添加的成员配置不正确(例如对等成员 URL 错误),集群可能失去法定人数。法定人数丢失的原因在于,即使新添加的成员无法与其他现有成员通信,该成员仍会被计入法定人数。此外,若存在连接问题或操作问题,也可能导致法定人数丢失。
为避免此问题,etcd 提供了选项 -strict-reconfig-check。若将此选项传递给 etcd,则当重新配置后已启动的成员数量将少于重新配置后集群的法定人数时,etcd 会拒绝该重新配置请求。
默认启用。
14.17 - 支持的平台
支持层级
etcd 可在不同平台上运行,但其提供的保证取决于平台的支持级别:
- Tier 1:由 [etcd 维护者][] 完全支持;etcd 保证通过所有测试,包括功能测试和健壮性测试。
- Tier 2:etcd 保证通过集成测试和端到端测试,但不保证通过功能测试或健壮性测试。
- Tier 3:etcd 保证可构建,可能仅进行轻度测试(或未测试),因此应视为 不稳定。
当前支持
下表列出了当前支持的平台及其对应的 etcd 支持级别:
| 架构 | 操作系统 | 支持层级 | 维护者 |
|---|---|---|---|
| AMD64 | Linux | 1 | etcd maintainers |
| ARM64 | Linux | 1 | etcd maintainers |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
未列出的平台不受支持。
支持新平台
希望作为新平台的“官方”维护者参与 etcd 贡献?除承诺支持该平台外,还必须设置 etcd 持续集成(CI),满足以下要求,具体取决于支持层级:
| etcd 持续集成 | Tier 1 | Tier 2 | Tier 3 |
|---|---|---|---|
| 构建通过 | ✓ | ✓ | ✓ |
| 单元测试通过 | ✓ | ✓ | |
| 集成与端到端测试通过 | ✓ | ✓ | |
| 健壮性测试通过 | ✓ |
有关为 ARM64 设置二级 CI 的示例,请参见 etcd PR #12928 。
不支持的平台
为避免意外在不支持的平台上运行 etcd 服务器,除非环境变量 ETCD_UNSUPPORTED_ARCH 被设置为目标架构,否则 etcd 会打印警告信息并立即退出。
32 位系统 由于 Go 运行时存在缺陷,etcd 在 32 位系统上存在已知问题。 详细信息请参见 Go 问题 #599 以及 atomic 包缺陷说明 。
14.18 - 版本管理
本文描述了 etcd 项目所支持的版本。
服务版本管理与支持版本
etcd 版本号采用 x.y.z 格式,其中 x 表示主版本号,y 表示次版本号,z 表示补丁版本号,遵循 语义化版本控制 规范。 新次版本号可能向 API 添加额外功能。
etcd 项目为当前版本及前一个版本维护发布分支。例如,当 v3.5 为当前版本时,v3.4 仍受支持。当 v3.6 发布后,v3.4 即停止支持。
根据严重性和可行性,适用于这两个发布分支的修复(包括安全修复)可能被回溯应用。 必要时,将从这些分支中发布补丁版本。
项目 Maintainers 拥有此决策权。
可以使用 etcdctl 检查正在运行的 etcd 集群版本:
API 版本管理
v3 API 的响应结果在 3.0.0 版本发布后不应发生变化,但后续将陆续增加新功能。
14.19 - 数据损坏
etcd 内置了自动数据损坏检测机制,以防止成员状态发生不一致。
启用数据损坏检测
数据损坏检测可通过以下方式执行:
- 初始检查,通过
--experimental-initial-corrupt-check标志启用。 - 定期检查包括:
- 已压缩的修订版本哈希,通过
--experimental-compact-hash-check-enabled标志启用。 - 最新修订版本哈希,通过
--experimental-corrupt-check-time标志启用。
- 已压缩的修订版本哈希,通过
引导过程中将执行初始检查。 成员将比较其持久化状态与其他成员的状态,若发现不匹配则退出。
两个周期性检查将在已运行的集群中由领导者执行。 领导者将比较其持久化状态与其他成员的状态,若发现不一致则触发 CORRUPT ALARM。 两项检查目的相同,但均建议启用,以在性能与检测时间之间取得平衡。
- 压缩修订版本哈希检查 - 需要定期执行压缩,性能开销极小,可处理缓慢的跟随者。
- 最新修订版本哈希检查 - 性能开销较高,无法处理缓慢的跟随者或频繁的压缩。
压缩修订版本哈希检查
启用 --experimental-compact-hash-check-enabled 标志后,每分钟执行一次检查。
可使用 --experimental-compact-hash-check-time 标志调整检查频率,格式为:1m - 每分钟,1h - 每小时。
该检查将压缩功能扩展为同时计算校验和,以便在集群成员之间进行比对。
不会引起额外的数据库扫描,因此开销极低,但要求集群定期执行压缩。
最新修订版本哈希校验
通过 --experimental-corrupt-check-time 标志启用,需以如下格式提供执行周期:1m —— 每分钟,1h —— 每小时。
由于性能开销较高,建议周期为数小时。
运行检查需在指定修订版本下扫描整个 etcd 内容以计算校验和。
恢复受损成员
恢复损坏成员有三种方法:
- 清除成员持久化状态
- 替换成员
- 恢复整个集群
成员恢复后,可移除 CORRUPT ALARM 告警。
清除成员持久化状态
可按以下步骤清除成员状态:
- 停止 etcd 实例。
- 备份 etcd 数据目录。
- 将 etcd 数据目录中的
snap子目录移出。 - 使用
--initial-cluster-state=existing启动etcd,并在--initial-cluster中列出集群成员。
预计 etcd 成员将从领导者下载最新的快照。
替换成员
可按以下步骤替换成员:
- 停止 etcd 实例。
- 备份 etcd 数据目录。
- 删除数据目录。
- 运行
etcdctl member remove从集群中移除该成员。 - 运行
etcdctl member add将其重新添加。 - 使用
--initial-cluster-state=existing启动etcd,并在--initial-cluster中列出集群成员。
恢复整个集群
可通过从当前领导者保存快照,并将快照恢复到所有成员来恢复集群。
对领导者执行 etcdctl snapshot save,并参照 恢复集群过程
。
15 - 基准测试
基准测试
etcd 性能基准测试结果将定期发布,并在以下各版本中持续追踪:
内存使用基准
它记录了在不同场景下的预期内存使用情况。
15.1 - 存储内存使用量基准测试
etcd 存储的两个组件会占用物理内存。etcd 进程分配了一个 内存索引,用于加速键的查找。进程的 页缓存 由操作系统管理,用于存储从磁盘读取的最近访问数据,以便快速重用。
内存索引将所有键以 B 树 数据结构的形式存储,并附带指向磁盘数据(即值)的指针。B 树中的每个键可能包含多个指针,指向其值的不同版本。因此,内存索引的理论内存消耗可近似表示为以下公式:
N * (c1 + avg_key_size) + N * (avg_versions_of_key) * (c2 + size_of_pointer)
其中 c1 为键元数据开销,c2 为版本元数据开销。
图表展示了内存中索引 B 树的详细结构。
页面缓存内存 由操作系统管理,本文档不对其进行详细说明。
测试环境
etcd 版本
GCE n1-standard-2 机器类型
- 7.5 GB 内存
- 2 个 CPU
内存中索引内存使用量
本测试仅针对内存索引的内存使用情况进行基准测试。目标是查找上述 c1 和 c2,并了解存储系统的内存消耗上限。
我们通过 Go 运行时的 ReadMemStats 计算内存使用量。通过对比创建索引前后的已分配字节数差异来估算内存使用情况。该方法无法完全反映内存中索引本身的内存使用量,但可展示大致的消耗趋势。
| N | 版本数 | 键大小 | 内存占用 |
|---|---|---|---|
| 100K | 1 | 64 字节 | 22 MB |
| 100K | 5 | 64 字节 | 39 MB |
| 1M | 1 | 64 字节 | 218 MB |
| 1M | 5 | 64 字节 | 432 MB |
| 100K | 1 | 256 字节 | 41 MB |
| 100K | 5 | 256 字节 | 65 MB |
| 1M | 1 | 256 字节 | 409 MB |
| 1M | 5 | 256 字节 | 506 MB |
根据结果,我们可以计算 c1=120bytes、c2=30bytes。仅需两组数据即可计算 c1 和 c2,因为它们是公式中唯一的未知变量。c1=120bytes 和 c2=30bytes 是我们计算出的 4 组 c1 和 c2 的平均值。对于小键值对,键元数据开销仍相对显著(50%)。然而,这相较于旧存储系统已实现显著改进,后者至少存在 1000% 的开销。
整体内存使用情况
整体内存使用量反映了 etcd 在存储系统上的 RSS 内存占用情况。值的大小对 etcd 的整体内存使用量影响极小,因为值数据存储在磁盘上,仅将热值保留在内存中,由操作系统的页面缓存进行管理。
| N | versions | 键大小 | 值大小 | 内存占用 |
|---|---|---|---|---|
| 100K | 1 | 64 字节 | 256 字节 | 40 MB |
| 100K | 5 | 64 字节 | 256 字节 | 89 MB |
| 1M | 1 | 64 字节 | 256 字节 | 470 MB |
| 1M | 5 | 64 字节 | 256 字节 | 880 MB |
| 100K | 1 | 64 字节 | 1 KB | 102 MB |
| 100K | 5 | 64 字节 | 1 KB | 164 MB |
| 1M | 1 | 64 字节 | 1 KB | 587 MB |
| 1M | 5 | 64 字节 | 1 KB | 836 MB |
根据结果可知,值的大小对内存消耗的影响并不显著。由于操作系统页缓存中存储了更多数据,存在轻微的内存增长。
15.2 - 监听内存使用量基准测试
监听功能正处于积极开发中,其内存使用量可能随开发进展而变化。我们预计其内存使用量不会显著超过以下所述数值。
etcd 的一个核心目标是支持大量客户端执行海量监听操作。etcd 旨在支持 O(10k) 个客户端、O(100K) 个监听流(每个客户端约 O(10) 个监听流)以及 O(10M) 个总监听操作(每个监听流约 O(100) 个监听)。每个单独监听操作所消耗的内存占 etcd 整体内存使用量的最大部分,因此成为当前及未来优化的重点。
etcd 监听功能的三个相关组件会占用物理内存:每个 grpc.Conn、每个监听流以及每次监听活动的实例。grpc.Conn 维护实际的 TCP 连接及其他 gRPC 连接状态。每个 grpc.Conn 消耗约 10 KB 内存,且可能关联多个监听流。
每个监听流都是一个独立的 HTTP2 连接,消耗额外约 10 kB 的内存。 多个监听操作可能共享一个监听流。
监听是实际用于跟踪键值存储变更的结构。每个监听操作的内存消耗应低于 < 1 KB。
监听的理论内存消耗可通过以下公式近似计算:memory = c1 * number_of_conn + c2 * avg_number_of_stream_per_conn + c3 * avg_number_of_watch_stream
测试环境
etcd 版本
GCE n1-standard-2 机器类型
- 7.5 GB 内存
- 2 个 CPU
整体内存使用情况
总体内存使用量反映了 etcd 在客户端监听器存在的情况下所消耗的 RSS 。尽管结果可能有高达 10% 的波动,但该数据仍具有意义,因为目标是了解内存使用的粗略情况及分配模式。
根据基准测试结果,我们可以粗略计算出 c1 = 17kb、c2 = 18kb 和 c3 = 350bytes。因此,每个额外的客户端连接消耗 17 KB 内存,每个额外的流消耗 18 KB 内存,而每个额外的监听仅消耗 350 字节。在正常情况下,单个 etcd 服务器可使用几 GB 内存维持数百万个监听。
| 客户端数量 | 每客户端流数量 | 每流监听数量 | 总监听数量 | 内存占用 |
|---|---|---|---|---|
| 1k | 1 | 1 | 1k | 50MB |
| 2k | 1 | 1 | 2k | 90MB |
| 5k | 1 | 1 | 5k | 200MB |
| 1k | 10 | 1 | 10k | 217MB |
| 2k | 10 | 1 | 20k | 417MB |
| 5k | 10 | 1 | 50k | 980MB |
| 1k | 50 | 1 | 50k | 1001MB |
| 2k | 50 | 1 | 100k | 1960MB |
| 5k | 50 | 1 | 250k | 4700MB |
| 1k | 50 | 10 | 500k | 1171MB |
| 2k | 50 | 10 | 1M | 2371MB |
| 5k | 50 | 10 | 2.5M | 5710MB |
| 1k | 50 | 100 | 5M | 2380MB |
| 2k | 50 | 100 | 10M | 4672MB |
| 5k | 50 | 100 | 25M | OOM |
15.3 - etcd v3 基准测试
物理机
GCE n1-highcpu-2 机器类型
- 1x 专用本地 SSD,挂载于 /var/lib/etcd
- 1x 专用慢速磁盘,用于操作系统
- 1.8 GB 内存
- 2x CPU
- etcd 版本 2.2.0
etcd 集群
1 以 v3 演示模式运行的 etcd 成员
测试
使用 etcd v3 基准测试工具 。
性能
读取单一键
| 键大小(字节) | 客户端数量 | 读取 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|
| 256 | 1 | 2716 | 0.4 |
| 256 | 64 | 16623 | 6.1 |
| 256 | 256 | 16622 | 21.7 |
性能几乎与空服务器处理器的情况相同。
读取单个键的操作
| 键大小(字节) | 客户端数量 | 读取 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|
| 256 | 1 | 2269 | 0.5 |
| 256 | 64 | 13582 | 8.6 |
| 256 | 256 | 13262 | 47.5 |
空服务器处理器的性能不受单次写入操作影响。因此,性能下降应由存储系统导致。
15.4 - etcd v2.2.0-rc 内存基准测试
物理机
GCE n1-standard-2 机器类型
- 1 个专用本地 SSD,挂载于 /var/lib/etcd
- 1 个专用慢速磁盘,用于操作系统
- 7.5 GB 内存
- 2 个 CPU
etcd
测试
启动一个由 3 个成员组成的 etcd 集群,每个成员使用 2 个核心。
键名的长度始终为 64 字节,这是一个平均键字节数的合理长度。
内存最大使用量
- 当一个跟随者失效而领导者持续发送快照时,etcd 可能会使用最大内存。
max RSS是在三次运行中记录的最大内存使用量。
| 键字节数 | 键数量 | 数据大小(MB) | 最大 RSS(MB) | 领导者最大 RSS/数据比 |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
数据大小阈值
- 当 etcd 达到数据大小阈值时,可能容易触发选举,并丢弃部分提案。
- 对于大多数情况,只要 etcd 集群未触及该阈值,即可正常运行。若因资源不足导致运行不佳,应减小其数据规模。
| 键大小(字节) | 键数量限制 | 建议数据大小阈值(MB) | 消耗的 RSS(MB) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
15.5 - etcd v2.2.0-rc 基准测试
物理机
GCE n1-highcpu-2 机器类型
- 1 个专用本地 SSD,挂载于 /var/lib/etcd
- 1 个专用慢速磁盘,用于操作系统
- 1.8 GB 内存
- 2 个 CPU
etcd 集群
3 etcd 2.2.0-rc 成员,每个成员运行在单台机器上。
详细版本:
此外,我们使用 3 个 etcd 2.1.0 alpha 阶段成员组成集群以获取基准性能。etcd 的提交头位于 c7146bd5 ,与 etcd 2.1 基准测试 中所用版本相同。
测试
引导另一台机器,并使用 hey HTTP 压力测试工具 向每个 etcd 成员发送请求。请参阅 基准测试黑客指南 以获取详细操作说明。
性能
读取单一键
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 读取 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 2804 (-5%) | 0.4 (+0%) |
| 64 | 64 | 仅领导者 | 17816 (+0%) | 5.7 (-6%) |
| 64 | 256 | 仅领导者 | 18667 (-6%) | 20.4 (+2%) |
| 256 | 1 | 仅领导者 | 2181 (-15%) | 0.5 (+25%) |
| 256 | 64 | 仅领导者 | 17435 (-7%) | 6.0 (+9%) |
| 256 | 256 | 仅领导者 | 18180 (-8%) | 21.3 (+3%) |
| 64 | 64 | 所有服务器 | 46965 (-4%) | 2.1 (+0%) |
| 64 | 256 | 所有服务器 | 55286 (-6%) | 7.4 (+6%) |
| 256 | 64 | 所有服务器 | 46603 (-6%) | 2.1 (+5%) |
| 256 | 256 | 所有服务器 | 55291 (-6%) | 7.3 (+4%) |
编写一个键
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 写入 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 76(+22%) | 19.4(-15%) |
| 64 | 64 | 仅领导者 | 2461(+45%) | 31.8(-32%) |
| 64 | 256 | 仅领导者 | 4275(+1%) | 69.6(-10%) |
| 256 | 1 | 仅领导者 | 64(+20%) | 16.7(-30%) |
| 256 | 64 | 仅领导者 | 2385(+30%) | 31.5(-19%) |
| 256 | 256 | 仅领导者 | 4353(-3%) | 74.0(+9%) |
| 64 | 64 | 所有服务器 | 2005(+81%) | 49.8(-55%) |
| 64 | 256 | 所有服务器 | 4868(+35%) | 81.5(-40%) |
| 256 | 64 | 所有服务器 | 1925(+72%) | 47.7(-59%) |
| 256 | 256 | 所有服务器 | 4975(+36%) | 70.3(-36%) |
性能变化说明
在大多数场景下,读取 QPS 下降了 5%~8%。原因是 etcd 会为每次存储操作记录存储指标。这些指标对监控和调试至关重要,因此该情况可接受。
写入 QPS 到领导者提升了 20%~30%。这是因为我们将 Raft 主循环与条目应用循环解耦,避免了两者相互阻塞。
所有服务器的写入 QPS 提升了 30% 至 80%,因为跟随者可更早接收到最新的提交索引,从而更快地提交提案。
15.6 - etcd v2.2.0 基准测试
物理机
GCE n1-highcpu-2 机器类型
- 1 块专用本地 SSD,挂载为 etcd 数据目录
- 1 块专用慢速磁盘,用于操作系统
- 1.8 GB 内存
- 2 个 CPU
etcd 集群
3 etcd 2.2.0 成员,每个成员运行在单台机器上。
详细版本:
测试
在 etcd 集群外部引导另一台机器,并运行 hey HTTP 基准测试工具
(含连接复用补丁),向每个 etcd 集群成员发送请求。请参阅 基准测试说明
获取补丁及复现我们操作步骤的详细信息。
性能通过 100 次基准测试结果计算得出。
性能
单键读取性能
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 平均读取 QPS | 读取 QPS 标准差 | 平均 90th 百分位延迟(毫秒) | 延迟标准差 |
|---|---|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 2303 | 200 | 0.49 | 0.06 |
| 64 | 64 | 仅领导者 | 15048 | 685 | 7.60 | 0.46 |
| 64 | 256 | 仅领导者 | 14508 | 434 | 29.76 | 1.05 |
| 256 | 1 | 仅领导者 | 2162 | 214 | 0.52 | 0.06 |
| 256 | 64 | 仅领导者 | 14789 | 792 | 7.69 | 0.48 |
| 256 | 256 | 仅领导者 | 14424 | 512 | 29.92 | 1.42 |
| 64 | 64 | 所有服务器 | 45752 | 2048 | 2.47 | 0.14 |
| 64 | 256 | 所有服务器 | 46592 | 1273 | 10.14 | 0.59 |
| 256 | 64 | 所有服务器 | 45332 | 1847 | 2.48 | 0.12 |
| 256 | 256 | 所有服务器 | 46485 | 1340 | 10.18 | 0.74 |
单键写入性能
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 平均写入 QPS | 写入 QPS 标准差 | 平均 90th 百分位延迟(毫秒) | 延迟标准差 |
|---|---|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 55 | 4 | 24.51 | 13.26 |
| 64 | 64 | 仅领导者 | 2139 | 125 | 35.23 | 3.40 |
| 64 | 256 | 仅领导者 | 4581 | 581 | 70.53 | 10.22 |
| 256 | 1 | 仅领导者 | 56 | 4 | 22.37 | 4.33 |
| 256 | 64 | 仅领导者 | 2052 | 151 | 36.83 | 4.20 |
| 256 | 256 | 仅领导者 | 4442 | 560 | 71.59 | 10.03 |
| 64 | 64 | 所有服务器 | 1625 | 85 | 58.51 | 5.14 |
| 64 | 256 | 所有服务器 | 4461 | 298 | 89.47 | 36.48 |
| 256 | 64 | 所有服务器 | 1599 | 94 | 60.11 | 6.43 |
| 256 | 256 | 所有服务器 | 4315 | 193 | 88.98 | 7.01 |
性能变化
由于 etcd 现在会记录每个 API 调用的指标,大多数场景下读取 QPS 性能似乎出现轻微下降。这种极小的性能影响被认为是对所返回监控与调试信息广度的合理投入。
写入 QPS 到集群领导者似乎略有增加。这是因为 etcd Raft 逻辑中主循环与条目应用循环已解耦,消除了两者之间的多个阻塞点。
写入 QPS 向所有成员显著增加,因为跟随者现在能更早接收到最新的提交索引,从而更快地提交提案。
15.7 - etcd v2.1.0 基准测试
物理机
GCE n1-highcpu-2 机器类型
- 1 块专用本地 SSD,挂载于 /var/lib/etcd
- 1 块专用慢速磁盘,用于操作系统
- 1.8 GB 内存
- 2 个 CPU
- etcd 版本 2.1.0 alpha
etcd 集群
3 个 etcd 成员,每个成员运行在单台机器上
测试
引导另一台机器,并使用 hey HTTP 压力测试工具 向每个 etcd 成员发送请求。请参阅 基准测试黑客指南 以获取详细操作说明。
性能
读取单一键
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 读取 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 1534 | 0.7 |
| 64 | 64 | 仅领导者 | 10125 | 9.1 |
| 64 | 256 | 仅领导者 | 13892 | 27.1 |
| 256 | 1 | 仅领导者 | 1530 | 0.8 |
| 256 | 64 | 仅领导者 | 10106 | 10.1 |
| 256 | 256 | 仅领导者 | 14667 | 27.0 |
| 64 | 64 | 所有服务器 | 24200 | 3.9 |
| 64 | 256 | 所有服务器 | 33300 | 11.8 |
| 256 | 64 | 所有服务器 | 24800 | 3.9 |
| 256 | 256 | 所有服务器 | 33000 | 11.5 |
编写一个键
| 键大小(字节) | 客户端数量 | 目标 etcd 服务器 | 写入 QPS | 第 90 百分位延迟(毫秒) |
|---|---|---|---|---|
| 64 | 1 | 仅领导者 | 60 | 21.4 |
| 64 | 64 | 仅领导者 | 1742 | 46.8 |
| 64 | 256 | 仅领导者 | 3982 | 90.5 |
| 256 | 1 | 仅领导者 | 58 | 20.3 |
| 256 | 64 | 仅领导者 | 1770 | 47.8 |
| 256 | 256 | 仅领导者 | 4157 | 105.3 |
| 64 | 64 | 所有服务器 | 1028 | 123.4 |
| 64 | 256 | 所有服务器 | 3260 | 123.8 |
| 256 | 64 | 所有服务器 | 1033 | 121.5 |
| 256 | 256 | 所有服务器 | 3061 | 119.3 |
16 - 降级
16.1 - 降级 etcd 集群与应用程序
本节包含与降级 etcd 集群及应用程序相关的文档。
降级 etcd v3.x 集群
16.2 - 将 etcd 从 v3.7 降级到 v3.6
在一般情况下,从 etcd v3.7 降级到 v3.6 可以实现零停机、滚动降级:
- 逐一停止 etcd v3.7 进程,并替换为 etcd v3.6 进程
- 启用降级后,集群将不再支持 v3.7 中的新特性
开始 降级 前,请阅读本指南其余内容并做好准备。
降级检查列表
v3.7 与 v3.6 之间的主要差异:
不同标志
v3.7 未引入任何新标志,因此 v3.6 进程可接受 v3.7 配置中的所有标志,降级时无需进行配置更改。
本次差异对比基于版本 v3.7.0-rc.0 与 v3.6.13。实际差异取决于所用补丁版本,请先查阅 diff <(etcd-3.7/bin/etcd -h | grep \\-\\-) <(etcd-3.6/bin/etcd -h | grep \\-\\-)。
在 v3.7 中已弃用的 --experimental-* 标志在 v3.6 中仍存在,但降级后不得重新添加;应使用其非实验性等效标志或 --feature-gates 条目,两者在两个版本中均有效。
Prometheus 指标差异
服务器降级检查清单
降级要求
为确保平滑的滚动降级,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在将 etcd 降级之前,务必在预发环境中测试依赖 etcd 的服务,确认无误后再将降级操作部署到生产环境。
在开始之前,下载快照备份 。若降级过程中出现异常,可使用此备份对 回滚 至现有 etcd 版本。
在开始之前,请下载 etcd v3.6 的最新版本。
混合版本
降级过程中,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。当通过 etcdctl downgrade enable 3.6 启用降级后,集群即被视为已降级。内部上,集群整体版本被设置为降级目标版本,该版本控制报告的版本号以及所支持的功能。
回滚
在降级 etcd 集群之前,请创建并 下载快照备份 。如需恢复集群至降级前的状态,可使用该快照。若用户在降级过程中遇到问题,应首先识别并解决根本原因。
如果降级操作在执行 etcdctl downgrade enable 之后开始,且集群仍处于混合版本状态(即至少有一个成员仍运行在 v3.7 版本),用户可以通过执行 etcdctl downgrade cancel 取消正在进行的降级过程,并使用原始的 v3.7 二进制文件重启所有已降级的成员。
当所有成员均降级至 v3.6 版本后,集群即被视为已完全降级。若用户在完成完全降级后希望恢复至原始版本,应遵循官方 升级指南 ,以确保一致性并避免数据损坏。
降级操作
本示例演示如何将运行在本地机器上的 3 个成员 v3.7 etcd 集群降级。以下输出来自在单个主机上使用三个环回端口,对 v3.7.0-rc.0 和 v3.6.13 版本的 etcd 执行的实际运行,该集群在不久之前从 v3.6.13 升级而来。
步骤 1: 检查降级要求
集群是否健康且运行 v3.7.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径:
第 3 步:验证降级目标版本
在启用降级前,验证降级目标版本:
- 我们仅支持逐次降级一个次版本。例如,不允许从 v3.7 降级到 v3.5。
- 请在验证成功前不要进行下一步操作。
第 4 步:启用降级模式
启用降级后,集群将开始使用 v3.6 协议运行,该版本即为降级目标版本。此外,etcd 会自动将模式迁移至降级目标版本,此过程通常非常迅速。在继续下一步之前,请通过检查端点状态确认所有服务器的存储版本均已迁移至 v3.6。
启用降级后,即使所有服务器仍在运行 v3.7 二进制文件,集群仍将继续使用 v3.6 协议运行,除非使用 etcdctl downgrade cancel 取消降级。
第 5 步:停止一个现有的 etcd 服务器
在停止服务器之前,请检查其是否为领导者。我们建议最后再停用领导者。如果要停止的服务器是领导者,可以在停止该服务器前通过 move-leader 将领导者角色转移至其他服务器,以减少停机时间。
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 6 步:使用相同配置重启 etcd 服务器
使用相同配置,但以 v3.6 版本的 etcd 二进制文件重启 etcd 服务器。
验证每个成员以及整个集群在使用 v3.6 etcd 二进制文件后是否恢复正常状态:
与 v3.5 不同,v3.6 的状态端点会报告降级信息,因此降级中的成员会持续显示 DOWNGRADE ENABLED 为 true 以及其存储版本,直至降级完成。
第 7 步:重复第 5 步和第 6 步,直至所有成员完成
当所有成员均完成降级后,降级操作将自动完成,DOWNGRADE ENABLED 被重置为 false。检查集群的健康状况和状态,确认所有成员的次要版本以及存储版本均为 v3.6:
在领导者的日志中,应能看到类似以下的消息:
16.3 - 将 etcd 从 3.5 降级到 3.4
在一般情况下,从 etcd 3.5 降级到 3.4 可以实现零停机、滚动降级:
- 逐一停止 etcd 3.5 进程,并替换为 etcd 3.4 进程
- 启动任意 3.4 进程后,集群将不再支持 3.5 中的新特性
开始 降级 前,请阅读本指南其余内容并做好准备。
降级检查列表
content/enhttps://etcd.io/docs/v3.5/op-guide/authentication/rbac.md
如果集群启用了身份认证,将无法回滚降级至 3.5 版本,因为 3.5 更改了与身份认证相关的 WAL 条目格式 。可以参考 身份认证操作指南 禁用身份认证,并先删除所有用户。
3.5 版本到 3.4 版本的突出变更:
不同标志
如果在 3.5 版本的配置中使用了以下任意标志,请在降级至 3.4 版本时确保移除、重命名或更改其默认值。
本文的差异对比基于版本 3.5.14 和 v.3.4.33。实际差异取决于所用补丁版本,请先与 diff <(etcd-3.5/bin/etcd -h | grep \\-\\-) <(etcd-3.4/bin/etcd -h | grep \\-\\-) 核对。
etcd --logger zap
3.4 默认值为 --logger=capnslog,而 3.5 默认值为 --logger=zap。
如果要继续使用 zap,必须显式指定。
Prometheus 指标差异
服务器降级检查清单
降级要求
为确保平滑的滚动降级,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
必须降级至的 3.4 版本应大于等于 3.4.32。
准备
在将 etcd 降级之前,务必在预发环境中测试依赖 etcd 的服务,确认无误后再将降级操作部署到生产环境。
在开始之前,下载快照备份
。若降级过程中出现异常,可使用此备份执行回滚
至当前 etcd 版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参见备份 v2 数据存储
。
开始之前,请下载 etcd 3.4 的最新版本,并确保其版本号 ≥ 3.4.32。
混合版本
在降级过程中,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。一旦集群中的任意成员降级至 3.4 版本,即认为集群已完成降级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本以及所支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新降级的成员可能需要长达两分钟才能追上现有集群。请检查最近快照的大小,以估算总数据量。换句话说,为确保安全,应在降级每个成员之间等待两分钟。
对于数据量更大的情况,总数据大小达到 100MB 或更多时,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在降级前自由联系 etcd 团队 ,我们将乐意提供相关操作建议。
回滚
如果任一成员降级至 3.4 版本,集群版本将降级至 3.4,操作将保持 “3.4” 兼容。如需回滚,请遵循 升级 etcd 从 3.4 到 3.5 的说明。
请 下载快照备份 ,以便在集群完全降级后仍可进行回滚。
降级操作
本示例演示如何将运行在本地机器上的 3 成员 3.5 版 etcd 集群降级。
步骤 1: 检查降级要求
集群是否健康且运行 3.5.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
第 3 步:停止一个现有的 etcd 服务器
在停止服务器之前,请检查其是否为领导者
如果要停止的服务器是领导者,可以在停止该服务器之前通过 move-leader 将领导者转移至其他服务器,以减少停机时间。
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 4 步:使用相同配置重启 etcd 服务器 + --next-cluster-version-compatible
使用相同配置重启 etcd 服务器,但使用新的 etcd 二进制文件和 --next-cluster-version-compatible。
新的 3.4 版 etcd 将向集群发布其信息。此时,集群将开始以 3.4 协议运行,该协议为最低公共版本。
验证每个成员以及整个集群在使用新的 3.4 etcd 二进制文件后是否恢复正常健康状态:
未降级的成员将记录如下信息:
第 5 步:重复第 3 步和第 4 步,对剩余的成员进行操作
当所有成员均降级后,请检查集群的健康状态和版本:
16.4 - 将 etcd 从 v3.6 降级到 v3.5
在一般情况下,从 etcd v3.6 降级到 v3.5 可以实现零停机、滚动降级:
- 逐一停止 etcd v3.6 进程,并替换为 etcd v3.5 进程
- 启用降级后,集群将不再支持 v3.6 中的新特性
开始 降级 前,请阅读本指南其余内容并做好准备。
降级检查列表
v3.6 版本到 v3.5 版本的突出变更:
不同标志
如果在 v3.6 配置中使用了以下任一标志,请在降级至 v3.5 时确保移除、重命名或更改其默认值。
本文的差异对比基于版本 v3.6.0 和 v3.5.18。实际差异取决于所用补丁版本,请先与 diff <(etcd-3.6/bin/etcd -h | grep \\-\\-) <(etcd-3.5/bin/etcd -h | grep \\-\\-) 核对。
Prometheus 指标差异
服务器降级检查清单
降级要求
为确保平滑的滚动降级,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在将 etcd 降级之前,务必在预发环境中测试依赖 etcd 的服务,确认无误后再将降级操作部署到生产环境。
在开始之前,下载快照备份 。若降级过程中出现异常,可使用此备份对 回滚 至现有 etcd 版本。
在开始之前,请下载 etcd v3.5 的最新版本。
混合版本
降级过程中,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。当通过 etcdctl downgrade enable 3.5 启用降级后,集群即被视为已降级。内部上,集群整体版本被设置为降级目标版本,该版本控制报告的版本号以及所支持的功能。
回滚
在降级 etcd 集群之前,请创建并 下载快照备份 。该快照可用于在需要时将集群恢复至升级前的状态。若用户在降级过程中遇到问题,应首先识别并解决根本原因。
如果降级操作在执行 etcdctl downgrade enabled 之后开始,且集群仍处于混合版本状态(即至少有一个成员仍运行在 v3.6 版本),用户可以通过执行 etcdctl downgrade cancel 取消正在进行的降级过程,并使用原始的 v3.6 二进制文件重启所有已降级的成员。
当所有成员均降级至 v3.5 版本后,集群即被视为已完全降级。若用户在完成完全降级后希望恢复至原始版本,应遵循官方 升级指南 ,以确保一致性并避免数据损坏。
降级操作
本示例演示如何将运行在本地机器上的 3 个成员 v3.6 etcd 集群降级。
步骤 1: 检查降级要求
集群是否健康且运行 v3.6.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
第 3 步:验证降级目标版本
在启用降级前,验证降级目标版本:
- 仅支持逐次降级一个次版本。例如,不允许从 v3.6 降级至 v3.4。
- 请在验证成功前不要进行下一步操作。
第 4 步:启用降级模式
启用降级后,集群将开始使用 v3.5 协议运行,该版本即为降级目标版本。此外,etcd 会自动将模式迁移至降级目标版本,此过程通常非常迅速。在继续下一步之前,请通过检查端点状态确认所有服务器的存储版本均已迁移至 v3.5。
启用降级后,即使所有服务器仍在运行 v3.6 二进制文件,集群仍将以 v3.5 协议持续运行,除非使用 etcdctl downgrade cancel 取消降级。
第 5 步:停止一个现有的 etcd 服务器
在停止服务器之前,请检查其是否为领导者。建议最后再降级领导者。
如果要停止的服务器是领导者,可以在停止该服务器之前通过 move-leader 将领导者转移至其他服务器,以减少停机时间。
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 6 步:使用相同配置重启 etcd 服务器(不包含 v3.5 中移除或替换的参数)
使用相同配置但采用新 etcd 二进制文件重启 etcd 服务器。
验证每个成员以及整个集群在使用新的 v3.5 etcd 二进制文件后是否恢复正常健康状态:
在 v3.5 版本的服务器中,将看到 DOWNGRADE ENABLED 为 false,因为 v3.5 的状态端点尚未实现降级信息,此时集群的降级功能仍处于启用状态。
第 7 步:重复第 5 步和第 6 步,直至所有成员完成
当所有成员均降级后,请检查集群的健康状况和状态,并确认所有成员的次要版本均为 v3.5,且存储版本为空:
在领导者的日志中,应能看到类似以下的消息:
17 - 升级
17.1 - 升级 etcd 集群与应用程序
本节包含与升级 etcd 集群及应用程序相关的特定文档。
升级策略
升级前请注意,etcd 仅支持以下两种升级场景:
- 补丁升级:在同一小版本内升级补丁版本(例如 3.7.0 至 3.7.1)。
- 小版本升级:每次仅升级一个次版本(例如 3.6 至 3.7)。不支持跳过次版本的升级,此类操作很可能失败。请在升级至下一个次版本前,先更新至最新补丁版本。
升级 etcd v3.x 集群
- 将 etcd 从 3.0 升级至 3.1
- 将 etcd 从 3.1 升级至 3.2
- 将 etcd 从 3.2 升级至 3.3
- 将 etcd 从 3.3 升级至 3.4
- 将 etcd 从 3.4 升级至 3.5
- 将 etcd 从 3.5 升级至 3.6
- 将 etcd 从 3.6 升级至 3.7
升级至 etcd v2.3
17.2 - 将 etcd 从 v3.5 升级到 v3.6
在一般情况下,从 etcd v3.5 升级到 v3.6 可以实现零停机时间的滚动升级:
- 逐一停止 etcd v3.5 进程,并替换为 etcd v3.6 进程
- 所有 v3.6 进程运行后,集群即可使用 v3.6 中的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
更新 3.5
升级至 3.6 之前,请确保 所有 3.5 版本的成员均已更新至 3.5.32 或更高版本
。补丁版本 3.5.24 至 3.5.26 修复了多个潜在的升级障碍;3.5.32
增加了 --v2-deprecation=write-only-skip-check 功能,并将 etcdutl check v2store 扩展至可检查 WAL 记录以及 v2 快照。
V2 存储系统
如果未配置 --enable-v2 标志或将其设置为 false,则无需采取进一步操作。
如果配置了 --enable-v2,请运行命令 etcdutl check v2store,以验证 v2store 中是否存在非成员关系(自定义)数据。若不存在自定义数据,可安全移除该标志。否则,请参阅 v2 迁移指南
获取更多详情。
新增标志
已移除标志
标志已弃用
etcd --experimental-bootstrap-defrag-threshold-megabytes 标志已被弃用.
etcd --experimental-compaction-batch-limit 标志已被弃用.
etcd --experimental-compact-hash-check-time 标志已被弃用.
etcd --experimental-compaction-sleep-interval 标志已被弃用.
etcd --experimental-corrupt-check-time 标志已被弃用.
etcd --experimental-enable-distributed-tracing 标志已弃用.
etcd --experimental-distributed-tracing-address 标志已被弃用.
etcd --experimental-distributed-tracing-instance-id 标志已弃用.
etcd --experimental-distributed-tracing-sampling-rate 标志已被弃用.
etcd --experimental-distributed-tracing-service-name 标志已弃用.
etcd --experimental-downgrade-check-time 标志已被弃用.
etcd --experimental-max-learners 标志已被弃用.
etcd --experimental-memory-mlock 标志已被弃用.
etcd --experimental-peer-skip-client-san-verification 标志已被弃用.
etcd --experimental-snapshot-catchup-entries 标志已被弃用.
etcd --experimental-warning-apply-duration 标志已弃用.
etcd --experimental-warning-unary-request-duration 标志已被弃用.
etcd --experimental-watch-progress-notify-interval 标志已被弃用.
v3.5 功能门控的等效标志
对应的功能门控标志 etcd --experimental-compact-hash-check-enabled=true
对应的功能门控标志 etcd --experimental-initial-corrupt-check=true
对应的功能门控标志 etcd --experimental-enable-lease-checkpoint=true
对应的功能门控标志 etcd --experimental-enable-lease-checkpoint-persist=true
对应的功能门控标志 etcd --experimental-stop-grpc-service-on-defrag=true
对应的功能门控标志 etcd --experimental-txn-mode-write-with-shared-buffer=false
带有新默认值的标志
原始默认标志 etcd --snapshot-count=100000
原始默认标志 etcd --v2-deprecation='not-yet'
原始默认标志 etcd --discovery-fallback='proxy'
Prometheus 指标差异
服务器升级检查清单
升级要求
要将现有的 etcd 部署升级至 v3.6,运行中的集群版本必须为 v3.5 或更高。若版本低于 v3.5,请先 升级至 v3.5 ,再升级至 v3.6。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
开始前,请先 下载快照备份
。如果升级出现问题,可以使用此备份 回滚
到现有 etcd 版本。请注意,snapshot 命令只备份 v3 数据。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 v3.6 版本后,才认为集群已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及支持的功能。
回滚
升级 etcd 集群前,请创建并 下载快照备份 。该快照可用于在需要时将集群恢复至升级前的状态。若用户在升级过程中遇到问题,应首先识别并解决根本原因。若集群仍处于混合版本状态——即至少有一个成员仍运行在 v3.5 版本——则可选择将二进制文件或镜像替换为旧版 v3.5,或直接使用快照恢复集群。在此混合状态下,集群仍以 v3.5 集群模式运行,支持回滚而无需执行正式的降级流程。
然而,一旦所有成员均升级至 v3.6 版本,集群即被视为已完全升级,此时使用二进制文件回滚将不再可行。在此情况下,唯一的恢复方式是恢复升级前创建的快照。若用户希望在完成完整升级后返回原始版本,应遵循官方降级指南,以确保一致性并避免数据损坏。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.5 etcd 集群。
步骤 1: 检查升级要求
集群是否健康且运行 v3.5.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
etcd 领导者保证拥有最新的应用数据,因此应从领导者获取快照:
第 3 步:停止一个现有的 etcd 服务器
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 4 步:使用相同配置重启 etcd 服务器
使用相同配置但采用新 etcd 二进制文件重启 etcd 服务器。
新的 v3.6 etcd 将向集群发布其信息。此时,集群仍以 v3.5 协议运行,该版本为最低公共版本。
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.889+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"bf9071f4639c75cc","from":"3.0","to":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.894+0530","caller":"etcdserver/server.go:1686","msg":"published local member to cluster through raft","local-member-id":"bf9071f4639c75cc","local-member-attributes":"{Name:node1 ClientURLs:[http://127.0.0.1:2379]}","cluster-id":"59a05384c9b79ee","publish-timeout":"7s"}
验证每个成员以及整个集群在使用新的 v3.6 etcd 二进制文件后是否恢复正常健康状态:
未升级的成员将持续记录如下警告,直至整个集群完成升级。
这是预期行为,当所有 etcd 集群成员都升级到 v3.6 后,该现象将停止。
第 5 步:重复第 3 步和第 4 步,对剩余的成员进行操作
所有成员升级完成后,集群将成功报告升级至 v3.6:
成员 1:
{"level":"info","ts":"2025-03-01T04:58:32.375+0530","caller":"etcdserver/server.go:2149","msg":"updating cluster version using v3 API","from":"3.5","to":"3.6"}{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"etcdserver/server.go:2164","msg":"cluster version is updated","cluster-version":"3.6"}
成员 2:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"91bc3c398fb3c146","from":"3.5","to":"3.6"}
成员 3:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"fd422379fda50e48","from":"3.5","to":"3.6"}
17.3 - 将 etcd 从 3.4 升级到 3.5
在一般情况下,从 etcd 3.4 升级到 3.5 可以实现零停机滚动升级:
- 逐一停止 etcd v3.4 进程,并替换为 etcd v3.5 进程
- 在所有 v3.5 进程运行后,集群即可使用 v3.5 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
如果集群启用了认证,将无法执行从 3.4 或更早版本的滚动升级,因为 3.5 更改了与认证相关的 WAL 条目格式 。
3.5 版本中的重点变更。
已弃用 etcd_debugging_mvcc_db_total_size_in_bytes Prometheus 指标
v3.5 将 etcd_debugging_mvcc_db_total_size_in_bytes 的 Prometheus 指标提升至 etcd_mvcc_db_total_size_in_bytes,以鼓励对 etcd 存储进行监控。v3.5 完全弃用了 etcd_debugging_mvcc_db_total_size_in_bytes。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
已弃用 etcd_debugging_mvcc_put_total Prometheus 指标
v3.5 将 etcd_debugging_mvcc_put_total 的 Prometheus 指标提升至 etcd_mvcc_put_total,以鼓励对 etcd 存储进行监控。v3.5 完全弃用了 etcd_debugging_mvcc_put_total。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
已弃用 etcd_debugging_mvcc_delete_total Prometheus 指标
v3.5 将 etcd_debugging_mvcc_delete_total 的 Prometheus 指标提升至 etcd_mvcc_delete_total,以鼓励对 etcd 存储进行监控。v3.5 完全弃用了 etcd_debugging_mvcc_delete_total。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
已弃用 etcd_debugging_mvcc_txn_total Prometheus 指标
v3.5 将 etcd_debugging_mvcc_txn_total 的 Prometheus 指标提升至 etcd_mvcc_txn_total,以鼓励对 etcd 存储进行监控。v3.5 完全弃用了 etcd_debugging_mvcc_txn_total。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
已弃用 etcd_debugging_mvcc_range_total Prometheus 指标
v3.5 将 etcd_debugging_mvcc_range_total Prometheus 指标提升至 etcd_mvcc_range_total 级别,以鼓励对 etcd 存储进行监控。v3.5 完全弃用了 etcd_debugging_mvcc_range_total。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
已弃用 etcd --logger capnslog
v3.4 默认使用 --logger=zap,以支持多日志输出和结构化日志。
etcd --logger=capnslog 在 v3.5 中已被弃用,现在 --logger=zap 为默认值。
v3.4 增加 etcd --logger=zap 对结构化日志和多日志输出的支持。主要动机是推动 etcd 的自动化监控,而非在服务出现异常时回溯服务器日志。未来开发将尽量减少 etcd 的日志输出,并通过指标和告警使 etcd 更易于监控。etcd --logger=capnslog 将在 v3.5 中弃用。
已弃用 etcd --log-output
v3.4 将 etcd --log-output 重命名为 --log-outputs
,以支持多日志输出。
etcd --log-output 已在 v3.5 中弃用.
已弃用 etcd --debug 标志(现已 --log-level=debug)
etcd --debug 标志已弃用.
已弃用 etcd --log-package-levels
etcd --log-package-levels 标志在 capnslog 中已弃用.
现在,etcd --logger=zap 为默认值。
已弃用 [CLIENT-URL]/config/local/log
/config/local/log 端点在 v3.5 中正在被弃用,同时 etcd --log-package-levels 标志也将被弃用.
变更 gRPC 网关 HTTP 端点(已弃用 /v3beta)
本文未提供内容。
之后
/v3beta 已在 3.5 版本中移除。
服务器升级检查清单
升级要求
要将现有 etcd 部署升级至 3.5 版本,运行中的集群版本必须为 3.4 或更高。若版本低于 3.4,请先 升级至 3.4 ,再升级至 3.5。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
在开始之前,下载快照备份
。若升级过程中出现异常,可使用此备份将 etcd 版本 回退
至当前版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参见备份 v2 数据存储
。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.5 版本后,才认为集群已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新升级的成员可能需要最多 2 分钟才能追上现有集群。请检查最近快照的大小以估算总数据量。换句话说,升级每个成员之间应至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.5,则集群将升级至 v3.5,从该完成状态回退不可行。然而,若任一成员仍为 v3.4,则集群及其操作仍保持 “v3.4”,在此混合集群状态下,可将所有成员恢复为使用 v3.4 etcd 二进制文件。
请 下载快照备份 ,以便在集群完成升级后仍可执行降级操作。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.4 etcd 集群。
步骤 1: 检查升级要求
集群是否健康且运行 v3.4.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
etcd 领导者保证拥有最新的应用数据,因此应从领导者获取快照:
第 3 步:停止一个现有的 etcd 服务器
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 4 步:使用相同配置重启 etcd 服务器
使用相同配置但采用新 etcd 二进制文件重启 etcd 服务器。
新的 v3.5 etcd 将向集群发布其信息。此时,集群仍以 v3.4 协议运行,该版本为最低公共版本。
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.4"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
验证每个成员以及整个集群在使用新的 v3.5 etcd 二进制文件后是否恢复正常健康状态:
未升级的成员将持续记录如下警告,直至整个集群完成升级。
这是预期行为,当所有 etcd 集群成员都升级到 v3.5 后,该现象将停止。
第 5 步:重复第 3 步和第 4 步,对剩余的成员进行操作
所有成员升级完成后,集群将成功报告升级至 3.5:
成员 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.5"}
成员 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
成员 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
17.4 - 将 etcd 从 3.3 升级到 3.4
在一般情况下,从 etcd 3.3 升级到 3.4 可以实现零停机滚动升级:
- 逐一停止 etcd v3.3 进程,并替换为 etcd v3.4 进程
- 在所有 v3.4 进程运行后,集群即可使用 v3.4 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
3.4 版本中的重点变更。
设置 ETCDCTL_API=3 etcdctl 为默认值
ETCDCTL_API=3 现为默认值。
设置 etcd --enable-v2=false 为默认值
etcd --enable-v2=false
现为默认值。
这意味着,除非指定了 etcd --enable-v2=true,否则 etcd v3.4 服务器将不会提供 v2 API 请求服务。
如果使用了 v2 API,请确保在 v3.4 版本中启用了 v2 API:
其他 HTTP API 仍可正常工作(例如 [CLIENT-URL]/metrics、[CLIENT-URL]/health、v3 gRPC 网关)。
已弃用 etcd --ca-file 和 etcd --peer-ca-file 标志
--ca-file 和 --peer-ca-file 标志已弃用;自 v2.1 版本起已弃用。
请注意,设置此参数将自动启用客户端证书身份认证,无论 --client-cert-auth 设置为何值。
废弃的grpc.ErrClientConnClosing错误
grpc.ErrClientConnClosing 在 gRPC ≥ 1.10 中已被 弃用
。
要求 grpc.WithBlock 进行客户端连接
新的客户端负载均衡器
使用异步解析器,将端点传递给 gRPC 连接函数。因此,v3.4 客户端必须使用 grpc.WithBlock 连接选项,以等待底层连接建立完成。
废弃 etcd_debugging_mvcc_db_total_size_in_bytes Prometheus 指标
v3.4 将 etcd_debugging_mvcc_db_total_size_in_bytes Prometheus 指标提升至 etcd_mvcc_db_total_size_in_bytes,以鼓励对 etcd 存储进行监控。
etcd_debugging_mvcc_db_total_size_in_bytes 在 v3.4 版本中仍为向后兼容而提供,将在 v3.5 版本中完全弃用。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
废弃 etcd_debugging_mvcc_put_total Prometheus 指标
v3.4 将 etcd_debugging_mvcc_put_total Prometheus 指标提升至 etcd_mvcc_put_total,以鼓励对 etcd 存储进行监控。
etcd_debugging_mvcc_put_total 在 v3.4 版本中仍为向后兼容而提供,将在 v3.5 版本中完全弃用。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
废弃 etcd_debugging_mvcc_delete_total Prometheus 指标
v3.4 将 etcd_debugging_mvcc_delete_total Prometheus 指标提升至 etcd_mvcc_delete_total,以鼓励对 etcd 存储进行监控。
etcd_debugging_mvcc_delete_total 在 v3.4 版本中仍为向后兼容而提供,将在 v3.5 版本中完全弃用。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
废弃 etcd_debugging_mvcc_txn_total Prometheus 指标
v3.4 将 etcd_debugging_mvcc_txn_total Prometheus 指标提升至 etcd_mvcc_txn_total,以鼓励对 etcd 存储进行监控。
etcd_debugging_mvcc_txn_total 在 v3.4 版本中仍为向后兼容而提供,将在 v3.5 版本中完全弃用。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
废弃 Prometheus 元度指标etcd_debugging_mvcc_range_total
v3.4 将 etcd_debugging_mvcc_range_total 的 Prometheus 指标提升至 etcd_mvcc_range_total,以鼓励对 etcd 存储进行监控。
etcd_debugging_mvcc_range_total 在 v3.4 版本中仍为向后兼容而提供,将在 v3.5 版本中完全弃用。
请注意,etcd_debugging_* 命名空间指标已被标记为实验性。随着监控指南的完善,我们可能会将更多指标升级为正式支持。
弃用 etcd --log-output 标志(现已 --log-outputs)
将 etcd --log-output 重命名为 --log-outputs
,以支持多日志输出。etcd --logger=capnslog 不支持多日志输出。
etcd --log-output 将在 v3.5 版本中弃用。etcd --logger=capnslog 将在 v3.5 版本中弃用。
v3.4 增加 etcd --logger=zap --log-outputs=stderr 对结构化日志和多日志输出的支持。主要动机是推动 etcd 的自动化监控,而非在服务出现异常时回溯服务器日志。未来开发将尽量减少 etcd 的日志输出,并通过指标和告警使 etcd 更易于监控。etcd --logger=capnslog 将在 v3.5 中弃用。
将 log-outputs 字段类型在 etcd --config-file 中更改为 []string
现在 log-outputs(旧字段名 log-output)支持多个写入者,因此 etcd 配置 YAML 文件 log-outputs 字段必须更改为如下所示的 []string 类型:
将embed.Config.LogOutput重命名为embed.Config.LogOutputs
将 embed.Config.LogOutput 重命名为 embed.Config.LogOutputs
,以支持多日志输出。并将 embed.Config.LogOutput 类型从 string 改为 []string
,以支持多日志输出。
v3.5 弃用capnslog
v3.5 将弃用 etcd --log-package-levels 标志的 capnslog 功能;etcd --logger=zap --log-outputs=stderr 将成为默认值。v3.5 将弃用 [CLIENT-URL]/config/local/log 端点。
弃用 etcd --debug 标志(现已 --log-level=debug)
v3.4 已弃用 etcd --debug
标志。应改用 etcd --log-level=debug 标志。
弃用的 pkg/transport.TLSInfo.CAFile 字段
已弃用 pkg/transport.TLSInfo.CAFile 字段。
将 embed.Config.SnapCount 更改为 embed.Config.SnapshotCount
为与标志名称 etcd --snapshot-count 保持一致,embed.Config.SnapCount 字段已重命名为 embed.Config.SnapshotCount:
将 etcdserver.ServerConfig.SnapCount 更改为 etcdserver.ServerConfig.SnapshotCount
为与标志名称 etcd --snapshot-count 保持一致,etcdserver.ServerConfig.SnapCount 字段已重命名为 etcdserver.ServerConfig.SnapshotCount:
修改了包 wal 的函数签名
修改 wal 函数签名以支持结构化日志记录。
更改了 IntervalTree 类型 在 pkg/adt 包中
pkg/adt.IntervalTree 现已定义为 interface。
已弃用 embed.Config.SetupLogging
embed.Config.SetupLogging 已被移除,以防止错误的日志配置,现在将自动设置。
Changed gRPC 网关 HTTP 端点(替换 /v3beta 为 /v3)
本文未提供内容。
之后
对 /v3beta 端点的请求将重定向至 /v3,/v3beta 将在 3.5 版本中移除。
已弃用的容器镜像标签
latest 及其小版本镜像标签已弃用:
服务器升级检查清单
升级要求
要将现有 etcd 部署升级至 3.4 版本,运行中的集群版本必须为 3.3 或更高。若版本低于 3.3,请先 升级至 3.3 ,再升级至 3.4。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
在开始之前,下载快照备份
。若升级过程中出现异常,可使用此备份将 etcd 版本 回退
至当前版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参见备份 v2 数据存储
。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.4 版本后,该集群才被视为已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新升级的成员可能需要最多 2 分钟才能追上现有集群。请检查最近快照的大小以估算总数据量。换句话说,升级每个成员之间应至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.4 版本,集群将升级至 v3.4 版本,从该完成状态回退不可行。然而,若任一成员仍为 v3.3 版本,则集群及其操作仍保持 “v3.3” 状态,此时可从该混合集群状态恢复至所有成员均使用 v3.3 etcd 二进制文件。
请 下载快照备份 ,以便在集群完成升级后仍可执行降级操作。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.3 etcd 集群。
步骤 1: 检查升级要求
集群是否健康且运行 v3.3.x 版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
etcd 领导者保证拥有最新的应用数据,因此应从领导者获取快照:
第 3 步:停止一个现有的 etcd 服务器
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
第 4 步:使用相同配置重启 etcd 服务器
使用相同配置但采用新 etcd 二进制文件重启 etcd 服务器。
新的 v3.4 etcd 将向集群发布其信息。此时,集群仍以 v3.3 协议运行,该版本为最低公共版本。
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.3"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.3"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
验证每个成员以及整个集群在使用新的 v3.4 etcd 二进制文件后是否恢复正常健康状态:
未升级的成员将持续记录如下警告,直至整个集群完成升级。
这是预期行为,当所有 etcd 集群成员都升级到 v3.4 后,该现象将停止。
第 5 步:重复第 3 步和第 4 步,对剩余的成员进行操作
所有成员升级完成后,集群将成功报告升级至 3.4:
成员 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.4"}
成员 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
成员 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
17.5 - 将 etcd 从 v3.6 升级到 v3.7
在一般情况下,从 etcd v3.6 升级到 v3.7 可以实现零停机滚动升级:
- 逐一停止 etcd v3.6 进程,并替换为 etcd v3.7 进程
- 在所有 v3.7 进程运行后,集群即可使用 v3.7 中的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
更新 3.6
在升级到 3.7 之前,请确保所有 3.6 成员均已更新至 3.6.11 或更高版本。较早的 3.6 补丁版本可能与 3.7 的滚动升级不兼容。
V2 存储系统
v3.7 版本中已完全移除 v2 存储。v2 HTTP API(--enable-v2)、v2-on-v3 模拟层(--experimental-enable-v2v3)、v2 发现服务、client/v2 包,以及 v2 快照文件的加载功能均已不可用。请参阅 CHANGELOG-3.7
中的破坏性变更说明。
如果从 3.6 版本集群升级,这些标志已不存在,无需采取任何操作。如果从包含自定义 v2 数据的旧版本升级,请在升级前遵循 v2 迁移指南 。
Go 重构
v3.7 包含重大的内部重构,对正常升级流程无影响,但在升级自定义集成时值得留意:
- 从
gogo/protobuf迁移到标准google.golang.org/protobuf(跟踪于 #14533 )。 - 已将已弃用的
go-grpc-middlewarev1 日志和标签库迁移至 v2 拦截器(#20420 )。 - OpenTelemetry gRPC 拦截器已更新至
otelgrpcv0.61.0,用NewServerHandler替代已弃用的UnaryServerInterceptor和StreamServerInterceptor(#20017 )。
如果将 etcd 作为库嵌入,或针对 clientv3 API 进行构建,或依赖内部包,请在升级前查阅 CHANGELOG
。
已移除标志
v3.7 版本已移除所有已弃用的 --experimental-* 标志(#19959
)。在 v3.6 版本中,这些标志均已被同名的非实验性标志或 --feature-gates 条目替代。如果仍存在这些标志的设置,请务必在升级至 v3.7 之前,将其替换为 v3.6 对应的等效设置,否则 v3.7 进程将无法启动。
请参阅 v3.5 到 v3.6 升级指南
,以获取每个已移除标志与其非实验性等效标志的映射关系,或查阅 --feature-gates 条目。
新增标志
None.
带有新默认值的标志
None.
服务器升级检查清单
升级要求
要将现有 etcd 部署升级至 v3.7,运行中的集群必须为 v3.6.11 或更高版本。若当前版本为较旧的小版本,请先 升级至 v3.6 ;etcd 仅支持一次升级一个次要版本。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
开始之前,下载快照备份 。若升级过程中出现异常,可使用此备份 回滚 至现有 etcd 版本。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低共同版本的协议运行。只有当集群中所有成员均升级至 v3.7 版本后,该集群才被视为已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及所支持的功能。
回滚
升级 etcd 集群前,请创建并 下载快照备份 。该快照可用于在需要时将集群恢复至升级前的状态。若用户在升级过程中遇到问题,应首先识别并解决根本原因。若集群仍处于混合版本状态(即至少有一个成员仍运行在 v3.6 版本),可选择将二进制文件或镜像替换为旧版 v3.6 版本,或直接使用快照恢复集群。在此混合状态下,集群仍以 v3.6 版本运行,支持回滚而无需执行正式的降级流程。
然而,一旦所有成员均升级至 v3.7 版本,集群即被视为已完全升级,此时使用二进制文件回滚将不再可行。在此情况下,唯一的恢复选项为从升级前的快照进行恢复,或在升级失败时遵循官方 降级指南 。
升级流程
本示例演示如何升级在本地主机上运行的 3 个成员的 v3.6 etcd 集群。以下输出来自在单个主机上使用三个环回端口对 etcd v3.6.12 和 etcd v3.7.0-rc.0 的实际运行结果。
步骤 1: 检查升级要求
集群是否健康且运行 v3.6.11 或更高版本?
Step 2: 从领导者下载快照备份
下载快照备份 ,以便在出现任何问题时提供回退路径。
etcd 领导者保证拥有最新的应用数据,因此应从领导者获取快照:
第 3 步:停止一个现有的 etcd 服务器
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误日志。这是正常的,因为集群成员之间的连接已(暂时)中断。领导者将在退出前转移领导权:
第 4 步:使用相同配置重启 etcd 服务器
使用相同配置但采用新 etcd 二进制文件重启 etcd 服务器。
新的 v3.7 etcd 将向集群发布其信息。此时,集群仍以 v3.6 协议运行,该版本为最低公共版本。
{"level":"info","ts":"2026-06-02T07:01:58.920780+0300","caller":"membership/cluster.go:296","msg":"set cluster version from store","cluster-version":"3.6"}
{"level":"info","ts":"2026-06-02T07:01:58.979186+0300","caller":"etcdserver/server.go:1828","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","cluster-id":"7dee9ba76d59ed53","publish-timeout":"7s"}
验证每个成员以及整个集群在使用新的 v3.7 etcd 二进制文件后是否恢复正常健康状态:
未升级的成员和已升级的成员将持续记录关于混合版本状态的日志,直到整个集群完成升级。这是预期行为,当所有 etcd 集群成员均升级至 v3.7 后,日志将停止。
第 5 步:重复第 3 步和第 4 步,对剩余的成员进行操作
所有成员升级完成后,集群将成功报告升级至 v3.7:
{"level":"info","ts":"2026-06-02T07:02:36.054783+0300","caller":"etcdserver/server.go:2311","msg":"updating cluster version using v3 API","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059345+0300","caller":"membership/cluster.go:593","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059409+0300","caller":"etcdserver/server.go:2326","msg":"cluster version is updated","cluster-version":"3.7"}
17.6 - 将 etcd 从 3.2 升级到 3.3
在一般情况下,从 etcd 3.2 升级到 3.3 可以实现零停机滚动升级:
- 逐一停止 etcd v3.2 进程,并替换为 etcd v3.3 进程
- 在所有 v3.3 进程运行后,集群即可使用 v3.3 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
3.3 版本中的重点变更。
将 etcd --auto-compaction-retention 标志的价值类型更改为 string
将 --auto-compaction-retention 标志改为 接受字符串值
,并支持 更细粒度
。由于 --auto-compaction-retention 现在接受字符串值,etcd 配置 YAML 文件 auto-compaction-retention 字段必须改为 string 类型。此前 --config-file etcd.config.yaml 可包含 auto-compaction-retention: 24 字段,现在必须为 auto-compaction-retention: "24" 或 auto-compaction-retention: "24h"。若配置为 --auto-compaction-mode periodic --auto-compaction-retention "24h",则 --auto-compaction-retention 标志的时间持续值必须对 Go 中的 time.ParseDuration
函数有效。
将 etcdserver.EtcdServer.ServerConfig 更改为 *etcdserver.EtcdServer.ServerConfig
etcdserver.EtcdServer 已将成员字段 *etcdserver.ServerConfig 的类型更改为 etcdserver.ServerConfig。现在 etcdserver.NewServer 接受 etcdserver.ServerConfig,而非 *etcdserver.ServerConfig。
之前和之后(例如 k8s.io/kubernetes/test/e2e_node/services/etcd.go )
添加了 embed.Config.LogOutput 结构体
请注意,此字段在 v3.4 版本中已重命名为 embed.Config.LogOutputs,适用于 []string 类型。详情请参阅 v3.4 升级指南
。
字段 LogOutput 已添加至 embed.Config:
在 gRPC 服务器警告被记录到 etcdserver 之前。
从 v3.3 版本开始,gRPC 服务器日志默认已禁用。
请注意,embed.Config.SetupLogging 方法已在 v3.4 版本中弃用。详情请参阅 v3.4 升级指南
。
将 embed.Config.Debug 字段设置为 true 以启用 gRPC 服务器日志。
Changed /health 端点响应
此前,[endpoint]:[client-port]/health 返回手动序列化的 JSON 值。3.3 版本现在定义了 etcdhttp.Health
结构体。
请注意,在 v3.3.0-rc.0、v3.3.0-rc.1 和 v3.3.0-rc.2 版本中,etcdhttp.Health 的 "health" 和 "errors" 字段为布尔类型。为保持向后兼容性,已将 "health" 字段恢复为 string 类型,并移除了 "errors" 字段。后续的健康信息将通过独立的 API 提供。
Changed gRPC 网关 HTTP 端点(替换 /v3alpha 为 /v3beta)
本文未提供内容。
之后
对 /v3alpha 端点的请求将重定向至 /v3beta,/v3alpha 将在 3.4 版本中移除。
调整了最大请求大小限制
3.3 现在允许为服务器端和客户端分别设置自定义请求大小限制。在之前版本(v3.2.10、v3.2.11)中,客户端响应大小限制仅为 4 MiB。
服务器端请求限制可通过 --max-request-bytes 标志进行配置:
或配置 embed.Config.MaxRequestBytes 字段:
如果未指定,服务器端限制默认为 1.5 MiB。
客户端请求限制必须根据服务器端限制进行配置。
如果未指定,客户端发送限制默认为 2 MiB(1.5 MiB + gRPC 开销字节),接收限制为 math.MaxInt32。请参阅 clientv3 godoc
获取更多详细信息。
更改了原始 gRPC 客户端包装函数的签名
3.3 修改了 clientv3 gRPC 客户端封装的函数签名。此变更旨在支持 自定义 grpc.CallOption 消息大小限制
。
之前和之后
Changed clientv3 Snapshot API 错误类型
此前,clientv3 Snapshot API 返回原始的 [grpc/*status.statusError] 类型错误。v3.3 现已将这些错误转换为对应的公开错误类型,以与其他 API 保持一致。
本文未提供内容。
之后
Changed etcdctl lease timetolive 命令输出
此前,对已过期租约执行 lease timetolive LEASE_ID 命令时会输出 -1s 表示剩余秒数。3.3 版本现在输出更清晰的提示信息。
本文未提供内容。
之后
变更 golang.org/x/net/context 导入
clientv3 已弃用 golang.org/x/net/context。若项目在其他代码中引入 golang.org/x/net/context(例如 etcd 生成的协议缓冲区代码)并导入 github.com/coreos/etcd/clientv3,则编译时需使用 Go 1.9 或更高版本。
本文未提供内容。
之后
更改了 gRPC 依赖
3.3 必须使用 grpc/grpc-go
v1.7.5。
已弃用 grpclog.Logger
grpclog.Logger 已被弃用,建议改用 grpclog.LoggerV2
。clientv3.Logger 现已改为 grpclog.LoggerV2。
本文未提供内容。
之后
已弃用 grpc.ErrClientConnTimeout
此前,在客户端连接超时时返回 grpc.ErrClientConnTimeout 错误。3.3 版本改为返回 context.DeadlineExceeded(参见 #8504
)。
本文未提供内容。
之后
变更官方容器注册表
etcd 现在使用 gcr.io/etcd-development/etcd
作为主容器注册表,使用 quay.io/coreos/etcd
作为备用。
本文未提供内容。
之后
升级至>=v3.3.14
v3.3.14 在尽量减少客户端负载均衡实现差异的前提下,引入了部分 3.4 版本的特性。此版本修复了 “当首个 etcd-server 不可用时,kube-apiserver 1.13.x 拒绝运行”(kubernetes#72102) 的问题。
grpc.ErrClientConnClosing 在 gRPC ≥ 1.10 中已被 弃用
。
新的客户端负载均衡器
使用异步解析器将端点传递给 gRPC dial 函数。因此,v3.3.14
或更高版本必须使用 grpc.WithBlock dial 选项,以等待底层连接建立完成。
请参阅 CHANGELOG 以获取完整变更列表。
服务器升级检查清单
升级要求
要将现有 etcd 部署升级至 3.3 版本,运行中的集群版本必须为 3.2 或更高。若版本低于 3.2,请先 升级至 3.2 ,再升级至 3.3。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
升级前,请对 etcd 数据执行 备份 etcd 数据
。若升级过程中出现异常,可使用此备份将系统 降级
至现有 etcd 版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参阅 备份 v2 数据存储
。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.3 版本后,该集群才被视为已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及所支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新升级的成员可能需要最多 2 分钟才能追上现有集群。请检查最近快照的大小以估算总数据量。换句话说,升级每个成员之间应至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.3 版本,集群将升级至 v3.3 版本,从该完成状态回退不可行。然而,若任一成员仍为 v3.2 版本,则集群及其操作仍保持 “v3.2” 状态,此时可从该混合集群状态恢复至所有成员均使用 v3.2 etcd 二进制文件。
请备份所有 etcd 成员的数据目录 backup the data directory ,以确保在集群完全升级后仍可执行降级操作。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.2 etcd 集群。
1. 检查升级要求
集群是否健康且运行 v3.2.x 版本?
2. 停止现有 etcd 进程
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
此时建议 备份 etcd 数据 ,以便在出现任何问题时可回退至之前版本:
3. 插入 etcd v3.3 二进制文件并启动新 etcd 进程
新的 v3.3 版 etcd 将向集群发布其信息:
验证每个成员以及整个集群在使用新的 v3.3 etcd 二进制文件后是否恢复正常健康状态:
升级后的成员将在整个集群完成升级前持续记录类似以下的警告日志。这是预期行为,当所有 etcd 集群成员均升级至 v3.3 后,警告将停止出现。
4. 重复第 2 步到第 3 步,对所有其他成员执行
5. 完成
所有成员升级完成后,集群将成功报告升级至 3.3:
17.7 - 将 etcd 从 3.1 升级到 3.2
在一般情况下,从 etcd 3.1 升级到 3.2 可以实现零停机滚动升级:
- 逐一停止 etcd v3.1 进程,并替换为 etcd v3.2 进程
- 在所有 v3.2 进程运行后,集群即可使用 v3.2 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
3.2 版本中的重点变更。
Changed default snapshot-count value
较高的 --snapshot-count 会在生成快照前将更多 Raft 条目保留在内存中,从而导致 内存使用量持续较高
。由于领导者会更长时间保留最新的 Raft 条目,缓慢的跟随者有更多时间在领导者生成快照前完成追赶。--snapshot-count 是较高内存使用与缓慢跟随者更高可用性之间的权衡。
自 v3.2 起,--snapshot-count 的默认值已 从 10,000 改为 100,000
。
更新了 gRPC 依赖 (>=3.2.10)
3.2.10 及更高版本现在要求 grpc/grpc-go
v1.7.5(3.2.9 及更早版本要求 v1.2.1)。
已弃用 grpclog.Logger
grpclog.Logger 已被弃用,建议改用 grpclog.LoggerV2
。clientv3.Logger 现已改为 grpclog.LoggerV2。
本文未提供内容。
之后
已弃用 grpc.ErrClientConnTimeout
此前,在客户端连接超时时返回 grpc.ErrClientConnTimeout 错误。3.2 版本改为返回 context.DeadlineExceeded(参见 #8504
)。
本文未提供内容。
之后
调整了最大请求大小限制(>=3.2.10)
3.2.10 和 3.2.11 版本允许在服务端自定义请求大小限制。从 3.2.12 版本开始,服务端和客户端均支持自定义请求大小限制。在之前的版本(v3.2.10、v3.2.11)中,客户端响应大小仅限于 4 MiB。
服务器端请求限制可通过 --max-request-bytes 标志进行配置:
或配置 embed.Config.MaxRequestBytes 字段:
如果未指定,服务器端限制默认为 1.5 MiB。
客户端请求限制必须根据服务器端限制进行配置。
如果未指定,客户端发送限制默认为 2 MiB(1.5 MiB + gRPC 开销字节),接收限制为 math.MaxInt32。请参阅 clientv3 godoc
获取更多详细信息。
更改了原始 gRPC 客户端包装器
3.2.12 及更高版本更改了 clientv3 gRPC 客户端封装的函数签名。此更改旨在支持 自定义 grpc.CallOption 消息大小限制
。
之前和之后
变更 clientv3.Lease.TimeToLive API
此前,clientv3.Lease.TimeToLive API 在不存在的租约 ID 上返回 lease.ErrLeaseNotFound。3.2 版本改为在响应中返回 TTL=-1 且不返回错误(参见 #7305
)。
本文未提供内容。
之后
将clientv3.NewFromConfigFile移动到clientv3.yaml.NewConfig
clientv3.NewFromConfigFile 已移至 yaml.NewConfig。
本文未提供内容。
之后
Change in --listen-peer-urls and --listen-client-urls
3.2 现在拒绝为 --listen-peer-urls 和 --listen-client-urls 使用域名(3.1 仅输出警告),因为域名对网络接口绑定无效。请确保这些 URL 已正确格式化为 scheme://IP:port。
有关更多上下文,请参见 issue #6336 。
服务器升级检查清单
升级要求
要将现有 etcd 部署升级至 3.2 版本,运行中的集群版本必须为 3.1 或更高。若版本低于 3.1,请先 升级至 3.1 ,再升级至 3.2。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
升级前,请对 etcd 数据执行 备份 etcd 数据
。若升级过程中出现异常,可使用此备份将系统 降级
至现有 etcd 版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参阅 备份 v2 数据存储
。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.2 版本后,才认为集群已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新升级的成员可能需要最多 2 分钟才能追上现有集群。请检查最近快照的大小以估算总数据量。换句话说,升级每个成员之间应至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.2 版本,集群将升级至 v3.2 版本,从该完成状态回退不可行。然而,若任一成员仍为 v3.1 版本,则集群及其操作仍保持 “v3.1” 状态,此时可从该混合集群状态恢复至所有成员均使用 v3.1 etcd 二进制文件。
请注意,务必对所有 etcd 成员的数据目录 backup the data directory 进行备份,以确保在集群完全升级后仍可执行降级操作。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.1 etcd 集群。
1. 检查升级要求
集群是否健康且运行 v3.1.x 版本?
2. 停止现有 etcd 进程
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
此时建议 备份 etcd 数据 ,以便在出现任何问题时提供回退路径:
3. 直接部署 etcd v3.2 二进制文件并启动新 etcd 进程
新的 v3.2 版 etcd 将向集群发布其信息:
验证每个成员,然后整个集群,使用新的 v3.2 etcd 二进制文件后是否健康:
升级后的成员将在整个集群完成升级前持续记录如下警告信息。这是正常现象,待所有 etcd 集群成员均升级至 v3.2 后,警告将停止出现。
4. 重复第 2 步到第 3 步,对所有其他成员执行
5. 完成
所有成员升级完成后,集群将成功报告升级至 3.2:
17.8 - 将 etcd 从 3.0 升级到 3.1
在一般情况下,从 etcd 3.0 升级到 3.1 可以实现零停机滚动升级:
- 逐一停止 etcd v3.0 进程,并替换为 etcd v3.1 进程
- 在所有 v3.1 进程运行后,集群即可使用 v3.1 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
监控
以下来自 v3.0.x 的指标已弃用,建议改用 go-grpc-prometheus :
etcd_grpc_requests_totaletcd_grpc_requests_failed_totaletcd_grpc_active_streamsetcd_grpc_unary_requests_duration_seconds
升级要求
要将现有 etcd 部署升级至 3.1 版本,运行中的集群版本必须为 3.0 或更高。若版本低于 3.0,请先 升级至 3.0 ,再升级至 3.1。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。在继续操作前,请使用 etcdctl endpoint health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
升级前,请对 etcd 数据执行 备份 etcd 数据
。若升级过程中出现异常,可使用此备份将系统 降级
至现有 etcd 版本。请注意,snapshot命令仅备份 v3 数据。如需备份 v2 数据,请参阅 备份 v2 数据存储
。
混合版本
升级过程中,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.1 版本后,才认为集群已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本号以及所支持的功能。
限制
请注意:如果集群仅包含 v3 数据且无 v2 数据,则不受此限制影响。
如果集群正在服务的数据集大小超过 50MB,每个新升级的成员可能需要最多 2 分钟才能追上现有集群。请检查最近快照的大小以估算总数据量。换句话说,升级每个成员之间应至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.1 版本,集群将升级至 v3.1 版本,从该完成状态回退不可行。然而,若任一成员仍为 v3.0 版本,则集群及其操作仍保持 “v3.0” 状态,此时可从该混合集群状态恢复至所有成员均使用 v3.0 etcd 二进制文件。
请注意,务必对所有 etcd 成员的数据目录 backup the data directory 进行备份,以确保在集群完全升级后仍可执行降级操作。
升级流程
本示例演示如何升级在本地计算机上运行的 3 个成员的 v3.0 etcd 集群。
1. 检查升级要求
集群是否健康且运行 v3.0.x 版本?
2. 停止现有 etcd 进程
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
此时建议 备份 etcd 数据 ,以便在出现任何问题时提供回退路径:
3. 直接替换 etcd v3.1 二进制文件并启动新 etcd 进程
新版 v3.1 etcd 将向集群发布其信息:
验证每个成员以及整个集群在使用新的 v3.1 etcd 二进制文件后是否恢复正常健康状态:
升级后的成员将在整个集群完成升级前持续记录如下警告信息。这是预期行为,待所有 etcd 集群成员升级至 v3.1 后,警告将停止出现。
4. 对所有其他成员重复步骤 2 至步骤 3
5. 完成
所有成员升级完成后,集群将成功报告升级至 3.1:
17.9 - 将 etcd 从 2.3 升级到 3.0
在一般情况下,从 etcd 2.3 升级到 3.0 可以实现零停机滚动升级:
- 逐一停止 etcd v2.3 进程,并替换为 etcd v3.0 进程
- 在所有 v3.0 进程运行后,集群即可使用 v3.0 的新特性
在 开始升级 之前,请通读本指南其余部分以做好准备。
升级检查列表
从 没有 v3 数据的 v2 迁移
时,如果 etcd 从现有快照恢复,但不存在 v3 ETCD_DATA_DIR/member/snap/db 文件,etcd v3.2+ 服务器会发生崩溃。这种情况出现在服务器由 v2 迁移且此前没有 v3 数据时。此限制也可防止意外丢失 v3 数据(例如 db 文件可能已被移动)。etcd 要求 v3 迁移后的操作必须有 v3 数据。v3.0 服务器包含 v3 数据之前,请勿升级到更新的 v3 版本。
升级要求
要将现有的 etcd 部署升级至 3.0,运行中的集群版本必须为 2.3 或更高。若版本低于 2.3,请先升级至 2.3 ,再升级至 3.0。
此外,为确保滚动升级顺利进行,运行中的集群必须处于健康状态。请在继续操作前,使用 etcdctl cluster-health 命令检查集群健康状况。
准备
在升级 etcd 之前,请务必在预发环境中测试依赖 etcd 的服务,再将升级部署到生产环境。
开始前,请先 备份 etcd 数据目录 。如果升级出现问题,可以使用此备份 降级 回现有 etcd 版本。
混合版本
升级期间,etcd 集群支持不同版本的 etcd 成员共存,并以最低公共版本的协议运行。只有当集群中所有成员均升级至 3.0 版本后,才认为集群已完成升级。内部机制上,etcd 成员之间会相互协商以确定集群的整体版本,该版本控制报告的版本及支持的功能。
限制
当集群总数据量超过 50MB 时,新升级的成员可能需要最多 2 分钟才能追上现有集群。可通过检查最近快照的大小来估算总数据量。换句话说,为确保安全,应在升级每个成员之间至少等待 2 分钟。
对于数据总量更大(例如 100MB 或更多)的情况,此一次性操作可能需要更长时间。对于规模达到此类程度的大型 etcd 集群,系统管理员可在升级前自由联系 etcd 团队 ,我们将乐意提供升级流程方面的建议。
降级
如果所有成员均已升级至 v3.0,则集群将升级至 v3.0,从该完成状态回退不可行。然而,若任一成员仍为 v2.3,则集群及其操作仍处于“v2.3”状态,此时可从该混合集群状态恢复至所有成员均使用 v2.3 etcd 二进制文件。
请备份所有 etcd 成员的数据目录 ,以便在集群完成升级后仍可执行降级操作 。
升级流程
本示例详细说明如何升级运行在本地机器上的三成员 v2.3 etcd 集群。
1. 检查升级要求。
集群是否健康且运行 v.2.3.x 版本?
2. 停止现有 etcd 进程
当每个 etcd 进程停止时,集群中的其他成员会记录预期的错误。这是正常的,因为集群成员之间的连接已(暂时)中断:
此时建议 备份 etcd 数据目录 ,以便在出现任何问题时能够回退。
3. 插入 etcd v3.0 二进制文件并启动新 etcd 进程
新版 v3.0 etcd 将向集群发布其信息:
验证每个成员以及整个集群在使用新的 v3.0 etcd 二进制文件后是否均恢复正常状态:
升级后的成员将在整个集群完成升级前持续记录如下警告信息。这是预期行为,当所有 etcd 集群成员均升级至 v3.0 后,警告将停止出现。
4. 对所有其他成员重复步骤 2 至步骤 3
5. 完成
所有成员升级完成后,集群将成功报告升级至 3.0:
进一步考虑事项
- etcdctl 环境变量已更新。如果
ETCDCTL_API=2 etcdctl cluster-health运行正常但ETCDCTL_API=3 etcdctl endpoints health返回Error: grpc: timed out when dialing,请务必使用 新的变量名 。
已知问题
- etcd < v3.1 在使用 Go > v1.7 构建时无法正常工作。详情请参见 Issue 6951 。
- 若 etcd 服务器日志中出现
transport: http2Client.notifyError got notified that the client transport was broken unexpected EOF.类似错误,请确保 etcd 为预构建版本,或使用以下组合构建:(etcd v3.1+ & go v1.7+) 或 (etcd <v3.1 & go v1.6.x)。 - 在升级过程中向 v2.3 集群添加 v3 成员不被支持,可能引发 panic。详情请参见 Issue 7249 。仅在 v3 迁移期间允许混合版本的 etcd 成员。完成升级前不得进行任何成员变更操作。
18 - 分类处置
18.1 - Issue 分类处置指南
目的
加快问题管理。
etcd 问题列于 https://github.com/etcd-io/etcd/issues
,并以标签标识。例如,被识别为缺陷的问题最终将被标记为 area/bug 。新创建的问题初始时无标签,但通常由 etcd 维护者和活跃贡献者根据其分析结果添加标签。标签的详细列表可参见 https://github.com/kubernetes/kubernetes/labels
以下是为方便起见预设的若干问题搜索:
适用范围
本文指南作为处理 etcd 中新提交问题的首要文档。欢迎所有人协助管理问题和拉取请求,但本文讨论的工作与职责主要面向 etcd 维护者及活跃贡献者。
验证是否为 bug 故障
请验证该问题是否确实为 bug。若否,请添加分析结论并关闭无关紧要的问题。对于非无关紧要的问题,等待问题报告者回复,确认是否存在异议。若问题报告者 30 天内未回复,关闭该问题。若问题无法复现或需要更多信息,请向问题报告者留言说明。
未解决问题
若问题报告者在 60 天内未提供足够信息,则应关闭该问题。
重复问题
如果问题为重复问题,请添加评论说明情况,并附上原始问题的引用链接,然后关闭该问题。
不属于 etcd 的问题
有时报告的问题实际上属于其他项目,例如 etcd 使用的问题。例如 grpc 或 golang 问题。此类问题应要求报告者在相应的其他项目中提交。除非维护者与问题报告者认为有必要保留该问题以用于追踪,否则应关闭问题。
验证重要标签已就位
请确保问题已添加所属领域标签,已正确分配负责人,并已确定里程碑。若缺少任一标签,请补充添加。若因权限受限无法分配标签,或无法确定正确标签,亦可接受,必要时请联系维护者。
如需,催促问题负责人
若某开发者负责的问题在 30 天内未提交任何 PR,应联系问题负责人,要求其提交 PR 或在必要时释放所有权。
18.2 - PR 管理
目的
加速 PR 管理。
etcd 的 PR 列表位于 https://github.com/etcd-io/etcd/pulls
PR 可能包含多种标签、里程碑、评审人等。标签的详细列表可参见 https://github.com/kubernetes/kubernetes/labels
以下是 PR 中便于参考的若干搜索示例:
适用范围
本文指南作为管理 etcd 中 PR 的主要文档。欢迎所有人协助管理 PR,但本文讨论的工作与职责是针对 etcd 维护者及活跃贡献者设计的。
处理无效的 PR 请求
若评审意见在 15 天内未得到回应,请联系 PR 提交者。若 PR 提交者在 90 天内未回复,且可能的话,请通过提交新提交更新 PR。若无法做到,则应在 180 天后关闭不活跃的 PR。
需时审核人审核时提醒
审阅者会及时响应,但考虑到大家工作繁忙,若未获得快速回复,请在请求审阅后稍等一段时间。若 10 天内未收到回复,可自由通过在 PR 中添加评论,或发送电子邮件,或在 Slack 上发送消息的方式联系他们。
验证重要标签已就位
请确保已添加适当的评审人员至 PR。同时,请确保已指定里程碑。若缺少上述任一或其它重要标签,请予以补充。若无法确定正确标签,请留言通知维护人员酌情处理。