HA-кластер с несколькими центрами обработки данных
Высокая доступность кластера PostgreSQL, развернутого в нескольких центрах обработки данных, основана на репликации, которая может быть синхронной или асинхронной (см. режимы репликации ).
В обоих случаях важно четко понимать следующие понятия:
- PostgreSQL может работать в качестве первичного сервера или резервного сервера-лидера только тогда, когда он владеет ключом лидера и может обновлять этот ключ.
- Рекомендуется запускать нечётное количество узлов etcd, ZooKeeper или Consul: 3 или 5!
Синхронная репликация
Для создания кластера с несколькими ЦО, способного автоматически переживать отказ зоны, требуется как минимум 3.
Схема архитектуры будет следующей:
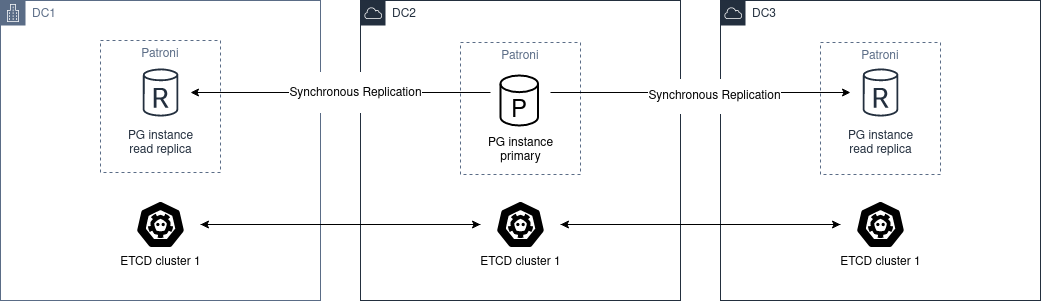
Необходимо развернуть кластер etcd, ZooKeeper или Consul через разные зоны доступности, с минимальным количеством 3 узлов, по одному в каждой зоне.
Что касается postgres, необходимо развернуть не менее 2 узлов в разных ЦОД. Затем следует задать synchronous_mode: true в глобальной динамической конфигурации
.
Это включает синхронную репликацию, при этом первичный сервер выберет один из узлов в качестве синхронного.
Асинхронная репликация
При наличии только двух центров обработки данных предпочтительнее иметь два независимых кластера etcd и запускать в втором центре обработки данных резервный сервер Patroni standby cluster . Если первый сайт выйдет из строя, вы можете MANUALLY вручную повысить привилегии standby_cluster .
Схема архитектуры будет следующей:
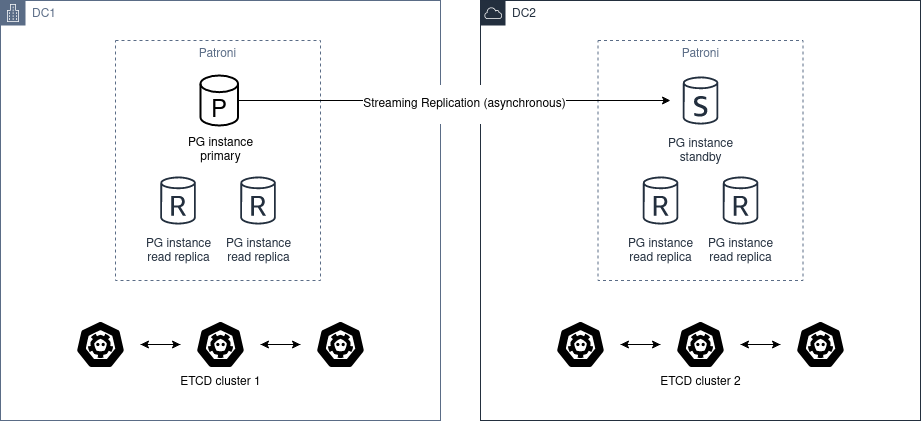
Автоматическое повышение невозможна, поскольку DC2 никогда не сможет определить состояние DC1.
В этом сценарии следует не использовать pg_ctl promote, необходимо вручную повысить приоритет работоспособного кластера, удалив раздел standby_cluster
из динамической конфигурации
.
Если исходный кластер по-прежнему работает, а вы повышаете резервный сервер до основного, возникает состояние split-brain.
В случае, если вы хотите вернуться в «исходное» состояние, существует только два способа его устранения:
- Добавьте секцию standby_cluster обратно — это вызовет
pg_rewind; однако для корректной работыpg_rewindкластер должен быть инициализирован с использованиемdata page checksums(опция--data-checksumsдляinitdb) и/или значениеwal_log_hintsдолжно быть установлено вon, но даже при этом возможны случаи сбояpg_rewindиз-за других факторов. - Перестройте резервный сервер с нуля.
Перед повышением резервного сервера в кластере необходимо вручную убедиться, что исходный кластер выключен (STONITH). Когда DC1 восстановится, кластер должен быть преобразован в резервный сервер.
Перед выполнением этого действия вы можете вручную проанализировать базу данных и извлечь все изменения, произошедшие между моментом, когда сеть между DC1 и DC2 перестала работать, и моментом, когда вы вручную остановили кластер в DC1.
После извлечения вы также можете вручную применить эти изменения к кластеру в DC2.