Конструкция обучающегося участника etcd
Обучающийся участник etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Предпосылки
Изменение состава кластера остаётся одной из крупнейших эксплуатационных сложностей. Рассмотрим типичные проблемы.
1. Новый участник кластера перегружает лидера
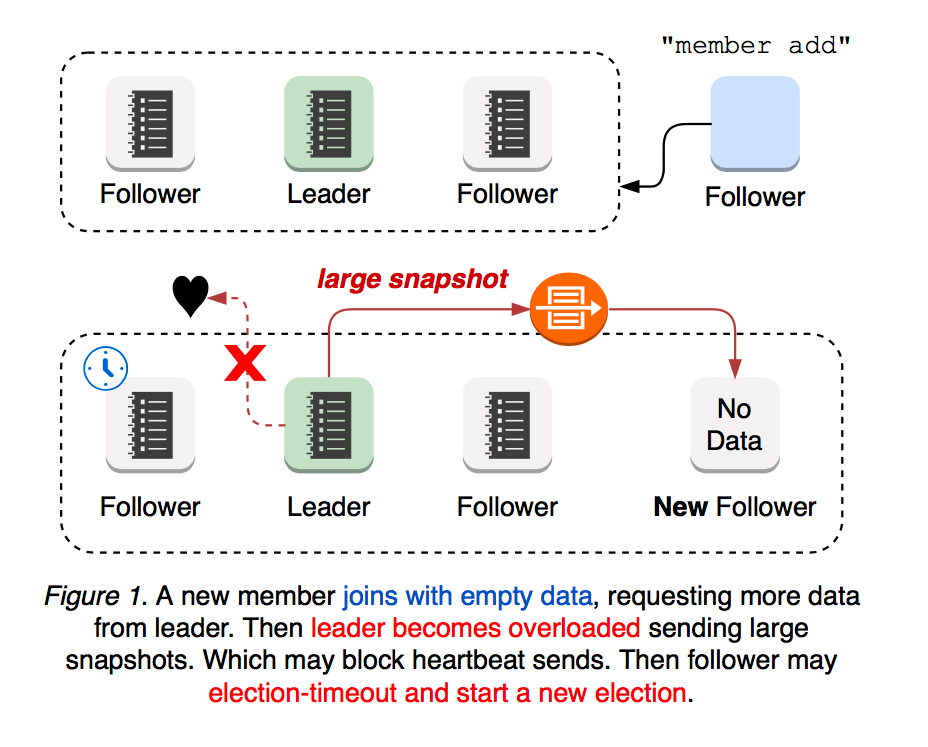
Только что присоединившийся участник etcd начинает без данных и потому требует больше обновлений от лидера, пока не догонит его журнал. Из-за этого сеть лидера с большей вероятностью окажется перегружена, а его сигналы активности последователям будут заблокированы или отброшены. Тогда у последователя может истечь тайм-аут выборов, и он начнёт новые выборы лидера. Таким образом, кластер с новым участником более подвержен выборам лидера. И сами выборы, и последующее распространение обновлений новому участнику могут вызывать периоды недоступности кластера (см. рисунок 1).
2. Сценарии разделения сети
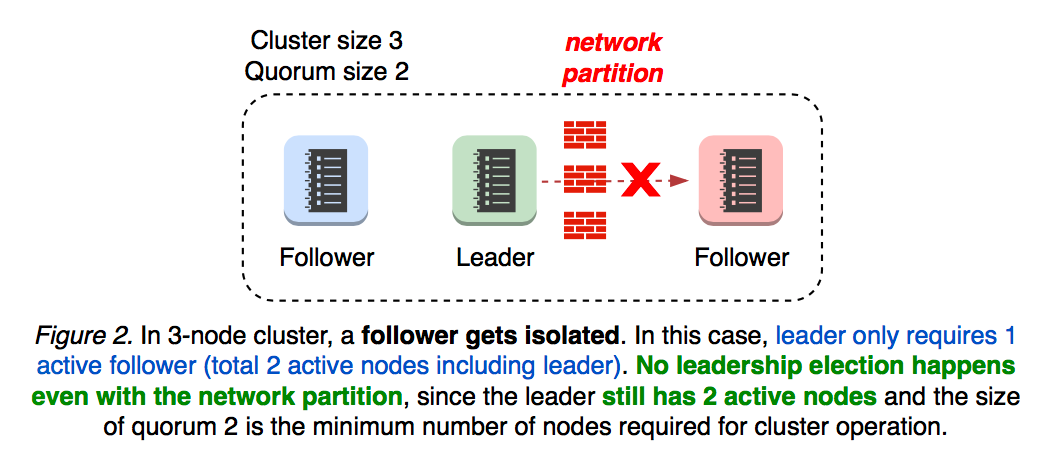
Что произойдёт при разделении сети? Это зависит от того, в какой части находится лидер. Если лидер по-прежнему поддерживает активный кворум, кластер продолжит работу (см. рисунок 2).
2.1 Изоляция лидера
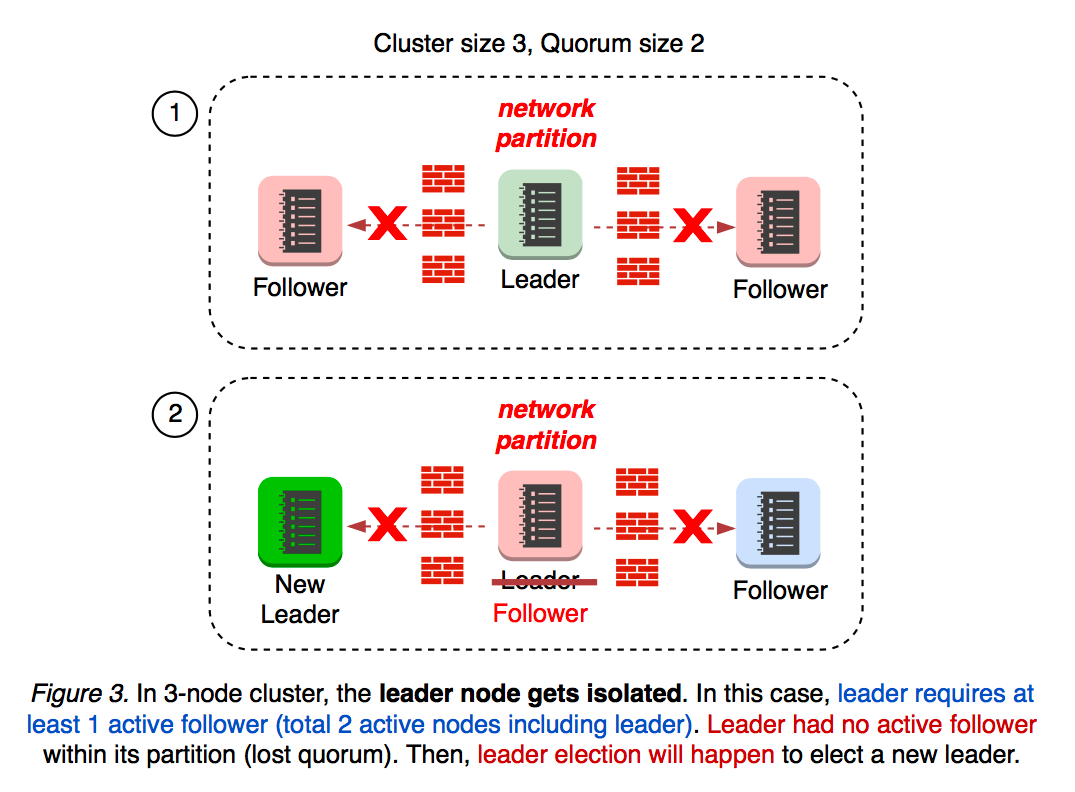
Что произойдёт, если лидер окажется изолирован от остального кластера? Лидер отслеживает прогресс каждого последователя. Потеряв связь с кворумом, он возвращается в состояние последователя, что влияет на доступность кластера (см. рисунок 3).
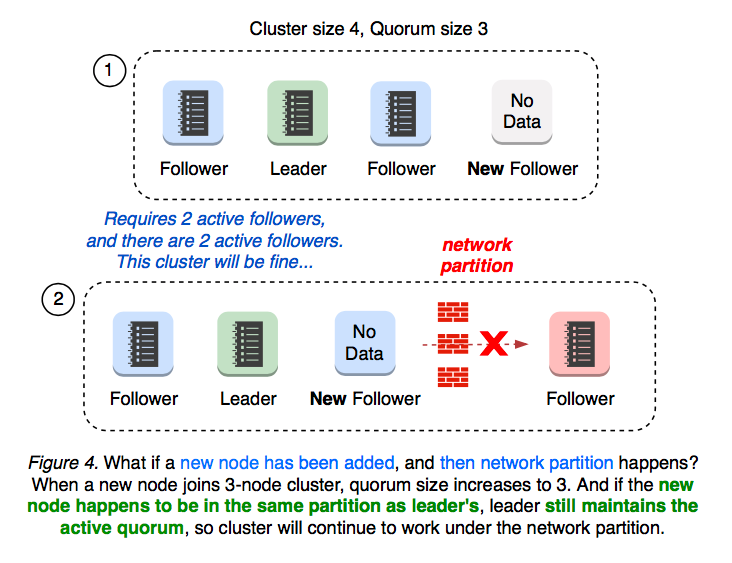
При добавлении нового узла в кластер из 3 узлов размер кластера становится равен 4, а размер кворума — 3. Что произойдёт, если новый узел присоединился к кластеру, после чего возникло разделение сети? Это зависит от того, в какой части после разделения окажется новый участник.
2.2 Разделение кластера 3+1
Если новый узел окажется в той же части, что и лидер, лидер сохранит активный кворум из 3 участников. Новых выборов лидера не будет, и доступность кластера не пострадает (см. рисунок 4).
2.3 Разделение кластера 2+2
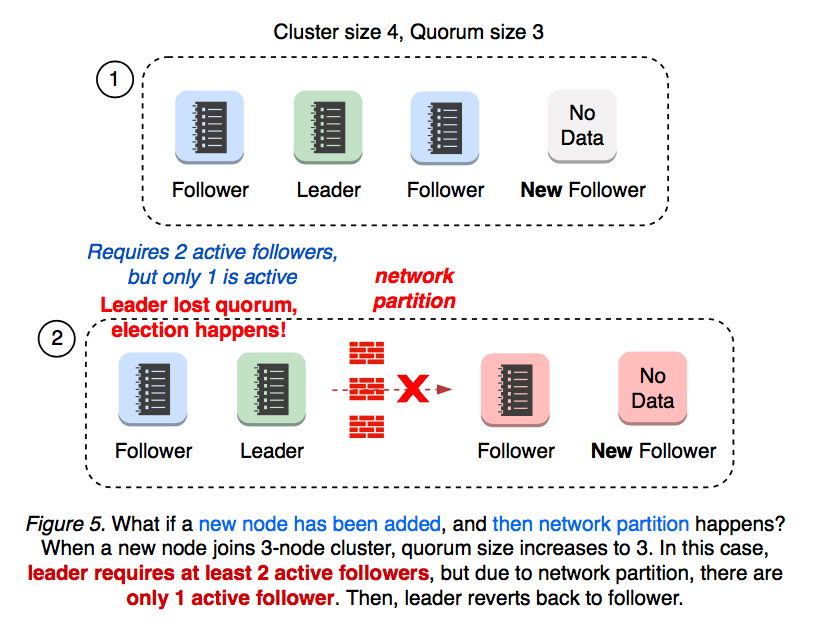
Если кластер разделён на части из 2 и 2 узлов, ни одна из них не сохраняет кворум из 3 участников. В этом случае начинаются выборы лидера (см. рисунок 5).
2.4 Потеря кворума
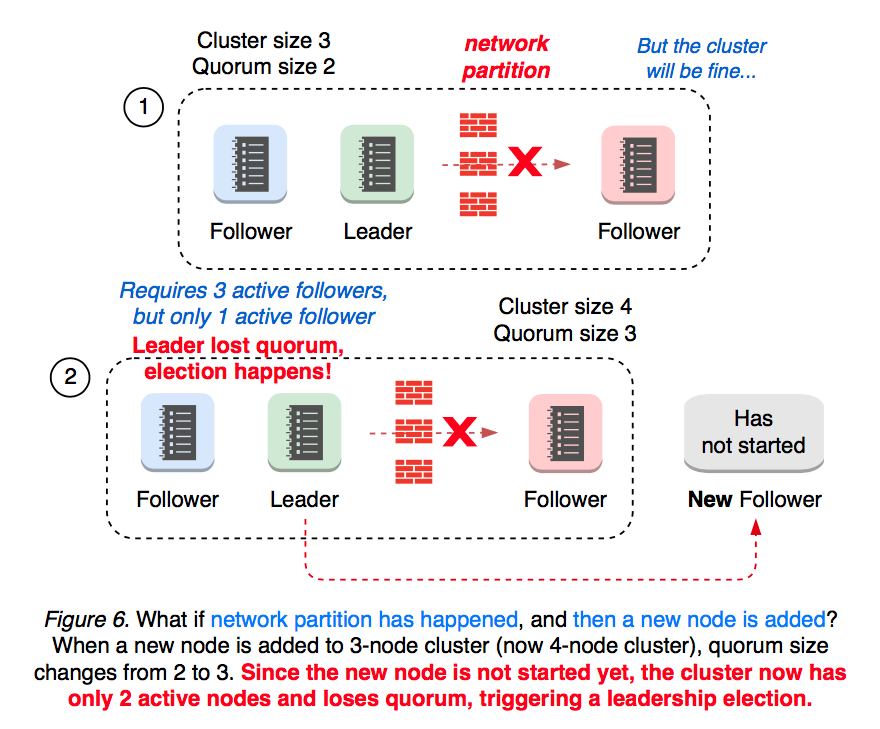
Что произойдёт, если сначала разделится сеть, а затем будет добавлен новый участник? В разделённом кластере из 3 узлов уже есть один отключённый последователь. После добавления участника кворум меняется с 2 на 3. Теперь в кластере активны только 2 узла из 4, поэтому он теряет кворум и начинает новые выборы лидера (см. рисунок 6).
Поскольку операция добавления участника может изменить размер кворума, при замене неисправного узла всегда рекомендуется сначала выполнить «member remove».
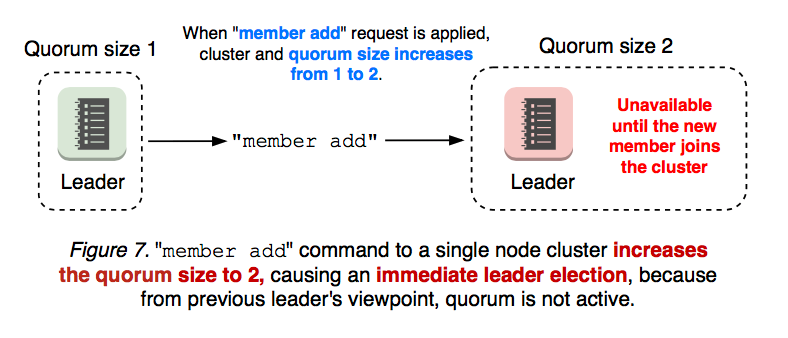
Добавление нового участника в кластер из 1 узла увеличивает размер кворума до 2 и немедленно вызывает выборы лидера, когда прежний лидер обнаруживает отсутствие активного кворума. Причина в том, что операция «member add» состоит из 2 этапов: пользователь сначала должен выполнить команду «member add», а затем запустить процесс нового узла (см. рисунок 7).
3. Ошибки конфигурации кластера
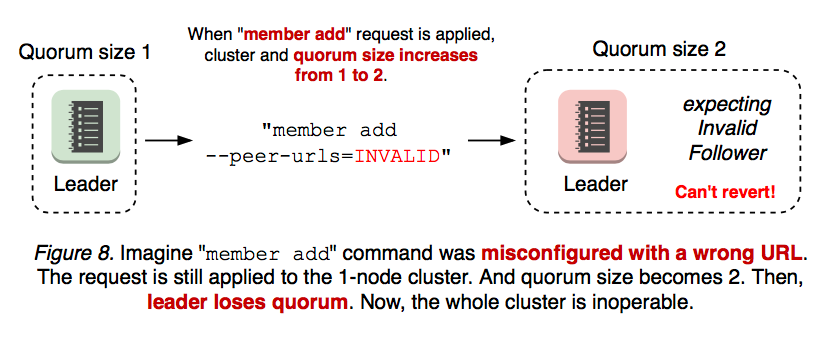
Ещё хуже, если добавленный участник настроен неверно. Изменение состава кластера состоит из двух этапов: «etcdctl member add» и запуск процесса сервера etcd с заданным URL однорангового узла. Иными словами, команда «member add» применяется независимо от URL, даже если его значение недопустимо. Если первый этап выполнен с недопустимыми URL, на втором этапе новый etcd даже не сможет запуститься. После потери кворума отменить изменение состава уже невозможно (см. рисунок 8).
То же относится к многоузловому кластеру. Например, два участника кластера не работают (один отказал, другой настроен неверно), а ещё два работают, но для изменения состава теперь требуется не менее 3 голосов (см. рисунок 9).
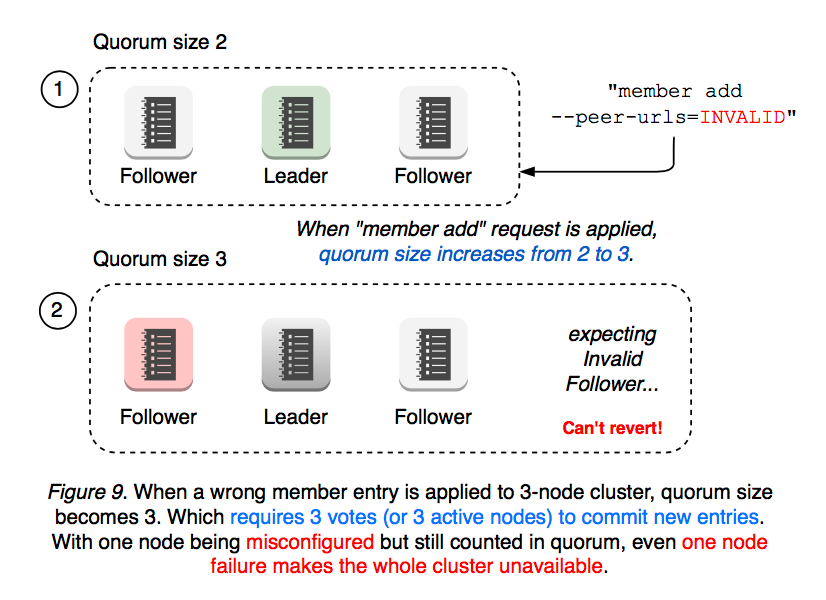
Как показано выше, простая ошибка конфигурации способна привести весь кластер в неработоспособное состояние. В таком случае оператору приходится вручную пересоздавать кластер с флагом etcd --force-new-cluster. Поскольку etcd стал критически важной службой для Kubernetes, даже малейший сбой может существенно повлиять на пользователей. Как упростить подобные операции с etcd? Среди прочего для доступности кластера наиболее важны выборы лидера. Можно ли сделать изменение состава менее разрушительным, не меняя размер кворума? Может ли новый узел бездействовать и запрашивать у лидера лишь минимум обновлений, пока не догонит его? Можно ли гарантировать обратимость ошибок конфигурации состава и обрабатывать их безопаснее (неверная команда добавления участника никогда не должна выводить кластер из строя)? Должен ли пользователь учитывать топологию сети при добавлении нового участника? Может ли API добавления участника работать независимо от расположения узлов и текущих разделений сети?
Обучающийся участник Raft
Чтобы устранить описанные выше провалы доступности, Raft §4.2.1 вводит новое состояние узла «Learner», в котором узел присоединяется к кластеру как участник без права голоса, пока не догонит журнал лидера.
Возможности v3.4
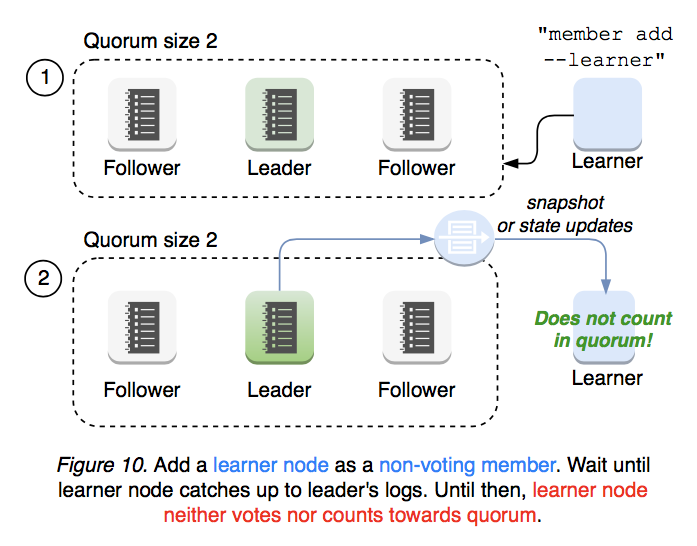
Для добавления нового обучающегося узла оператор должен выполнять как можно меньше действий. Команда member add --learner добавляет нового обучающегося участника, который присоединяется к кластеру без права голоса, но всё же получает все данные от лидера (см. рисунок 10).
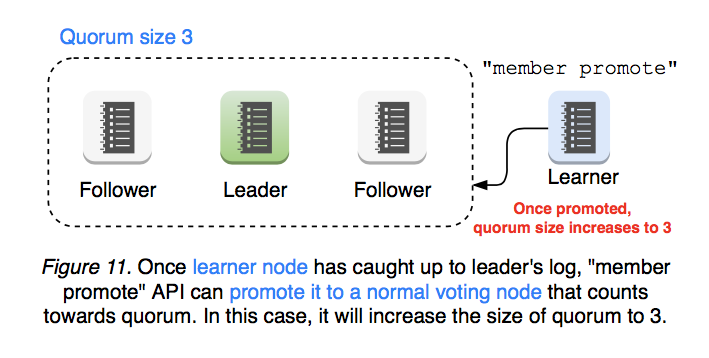
Когда обучающийся участник догоняет лидера, его можно повысить до участника с правом голоса с помощью API member promote; после этого он учитывается в кворуме (см. рисунок 11).
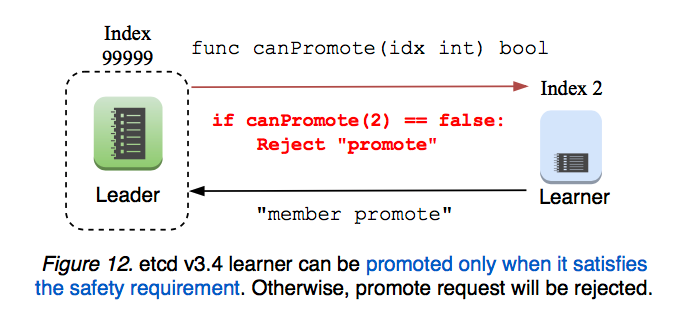
Сервер etcd проверяет запрос повышения, обеспечивая эксплуатационную безопасность. Обучающегося участника можно повысить до участника с правом голоса лишь после того, как его журнал догонит журнал лидера (см. рисунок 12).
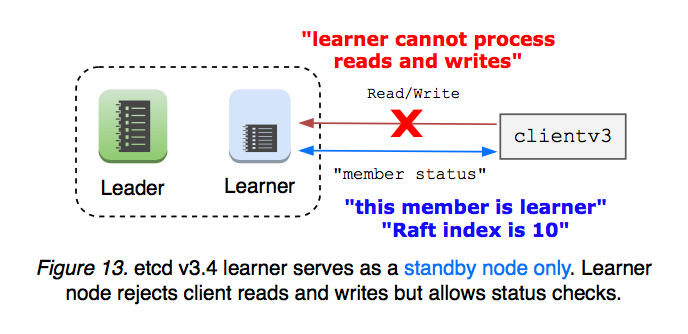
До повышения обучающийся участник служит только резервным узлом: передать ему лидерство нельзя. Он отклоняет клиентские операции чтения и записи (клиентский балансировщик не должен направлять к нему запросы). Следовательно, обучающемуся участнику не нужно отправлять лидеру запросы Read Index. Это ограничение упрощает первоначальную реализацию обучающегося участника в выпуске v3.4 (см. рисунок 13).
Кроме того, etcd ограничивает общее количество обучающихся участников в кластере, чтобы не перегружать лидера репликацией журнала. Обучающийся участник никогда не повышает себя самостоятельно. etcd предоставляет сведения о его состоянии и проверки безопасности, но окончательное решение о повышении должен принимать оператор кластера.
Предлагаемые возможности будущих выпусков
Сделать состояние обучающегося единственным и используемым по умолчанию: назначение новому участнику состояния обучающегося по умолчанию значительно повысит безопасность изменения состава, поскольку обучающийся участник не меняет размер кворума. Ошибку конфигурации всегда можно будет отменить без потери кворума.
Сделать повышение до участника с правом голоса полностью автоматическим: когда обучающийся участник догонит журнал лидера, кластер сможет автоматически его повысить. Пользователь должен будет задать определённые пороговые значения; после выполнения требований обучающийся участник самостоятельно повысится до участника с правом голоса. С точки зрения пользователя команда «member add» будет работать так же, как сегодня, но благодаря функции обучающегося участника станет безопаснее.
Сделать обучающегося участника резервным узлом переключения при отказе: обучающийся участник присоединяется как резервный узел и автоматически повышается, когда доступность кластера нарушается.
Сделать обучающегося участника доступным только для чтения: обучающийся участник может служить узлом только для чтения, который никогда не повышается. В режиме слабой согласованности он лишь получает данные от лидера и никогда не обрабатывает записи. Локальное обслуживание чтения без накладных расходов консенсуса существенно снизит нагрузку на лидера, но может возвращать устаревшие данные. В режиме строгой согласованности обучающийся участник запрашивает у лидера индекс чтения, чтобы обслуживать актуальные данные, но по-прежнему отклоняет записи.
Обучающийся участник и Mirror Maker
etcd реализует «mirror maker» с помощью API наблюдения, непрерывно передавая создания и обновления ключей в отдельный кластер. После первоначальной синхронизации зеркалирование обычно добавляет небольшую задержку. Обучающийся участник и зеркалирование частично пересекаются: оба подхода можно использовать для репликации существующих данных только для чтения. Однако зеркалирование не гарантирует линеаризуемость. Во время разрывов сети предыдущие пары «ключ — значение» могли быть отброшены, поэтому клиенты должны проверять правильность порядка в ответах наблюдения. Следовательно, зеркало не гарантирует порядок. Используйте зеркало для минимальной задержки (например, между центрами обработки данных) ценой согласованности. Используйте обучающегося участника, чтобы сохранить все исторические данные и их порядок.
Приложение: реализация обучающегося участника в v3.4
Предоставить тип узла “Learner” в API “MemberAdd”.
Клиент etcd добавляет в API «MemberAdd» флаг обучающегося узла. Обработчик сервера etcd применяет запись изменения состава с типом pb.ConfChangeAddLearnerNode. После применения команды сервер присоединяется к кластеру с флагом etcd --initial-cluster-state=existing. Этот обучающийся узел не может голосовать и не учитывается в кворуме.
Сервер etcd не должен передавать лидерство обучающемуся участнику: тот может всё ещё отставать и не учитывается в кворуме. Сервер etcd ограничивает количество обучающихся участников кластера одним: чем их больше, тем больше данных должен распространять лидер. Клиенты могут обращаться к обучающемуся узлу, но он отклоняет все запросы, кроме сериализуемого чтения и API состояния участника. Это сделано для простоты первоначальной реализации. В будущем обучающегося участника можно расширить до сервера только для чтения, непрерывно зеркалирующего данные кластера. Клиентский балансировщик должен предоставлять вспомогательную функцию для исключения конечной точки обучающегося узла. Иначе отправленный ему запрос может завершиться ошибкой. Клиентский вызов синхронизации участников должен учитывать тип обучающегося узла. То же относится к вызову обновления клиентских конечных точек.
Ответы MemberList и MemberStatus должны указывать, какой узел является обучающимся.
Добавить API “MemberPromote”.
На внутреннем уровне Raft второй вызов MemberAdd для обучающегося узла повышает его до участника с правом голоса. Лидер отслеживает прогресс каждого последователя и обучающегося участника. Если обучающийся участник не завершил обработку сообщения снимка, запрос повышения отклоняется. Запрос принимается тогда и только тогда, когда обучающийся узел исправен, а также синхронизирован с лидером либо разница не превышает порог (например, количество записей, которые нужно реплицировать обучающемуся участнику, меньше 1/10 количества снимка; тогда после повышения лидеру с меньшей вероятностью придётся отправлять ему снимок). Вся эта логика жёстко задана в пакете etcdserver и не настраивается.
Ссылки
- Исходная проблема GitHub: etcd#9161
- Сценарий использования: etcd#3715
- Сценарий использования: etcd#8888
- Сценарий использования: etcd#10114