Модель данных
etcd предназначен для надёжного хранения редко обновляемых данных и выполнения надёжных запросов наблюдения. etcd предоставляет предыдущие версии пар «ключ — значение», поддерживая недорогие снимки и историю событий наблюдения («запросы с перемещением во времени»). Для этих сценариев хорошо подходит постоянная многоверсионная модель данных с управлением параллелизмом.
etcd хранит данные в многоверсионном постоянном хранилище ключей и значений. Когда значение пары заменяется новыми данными, постоянное хранилище сохраняет её предыдущую версию. Фактически хранилище неизменяемо: операции не обновляют структуру на месте, а всегда создают новую обновлённую структуру. После изменения все прежние версии ключей остаются доступными для чтения и наблюдения. Чтобы хранилище не росло бесконечно и не сохраняло старые версии, его можно компактизировать, удалив самые старые версии замещённых данных.
Логическое представление
Логически хранилище представляет собой плоское пространство двоичных ключей. Пространство имеет лексически отсортированный индекс по ключам — строкам байтов, поэтому запросы диапазонов выполняются недорого.
Пространство ключей поддерживает несколько ревизий. При создании хранилища начальная ревизия равна 1. Каждая атомарная изменяющая операция — например, одна транзакция может содержать несколько операций — создаёт новую ревизию пространства ключей. Данные предыдущих ревизий остаются неизменными. Старые версии ключа доступны через прежние ревизии. Сами ревизии также индексируются, поэтому наблюдатели эффективно перебирают их диапазоны. При компактизации для экономии места ревизии до ревизии компактизации удаляются. На протяжении жизни кластера номер ревизии монотонно возрастает.
Жизнь ключа образует поколение от создания до удаления. У ключа может быть одно или несколько поколений. Создание ключа увеличивает его версию, начиная с 1, если ключ не существует в текущей ревизии. Удаление создаёт надгробную метку ключа, завершает текущее поколение и сбрасывает версию в 0. Каждое изменение ключа увеличивает версию, поэтому внутри поколения версии монотонно возрастают. После компактизации удаляются все поколения, завершившиеся до ревизии компактизации, а также все значения, заданные до неё, кроме самого нового.
Физическое представление
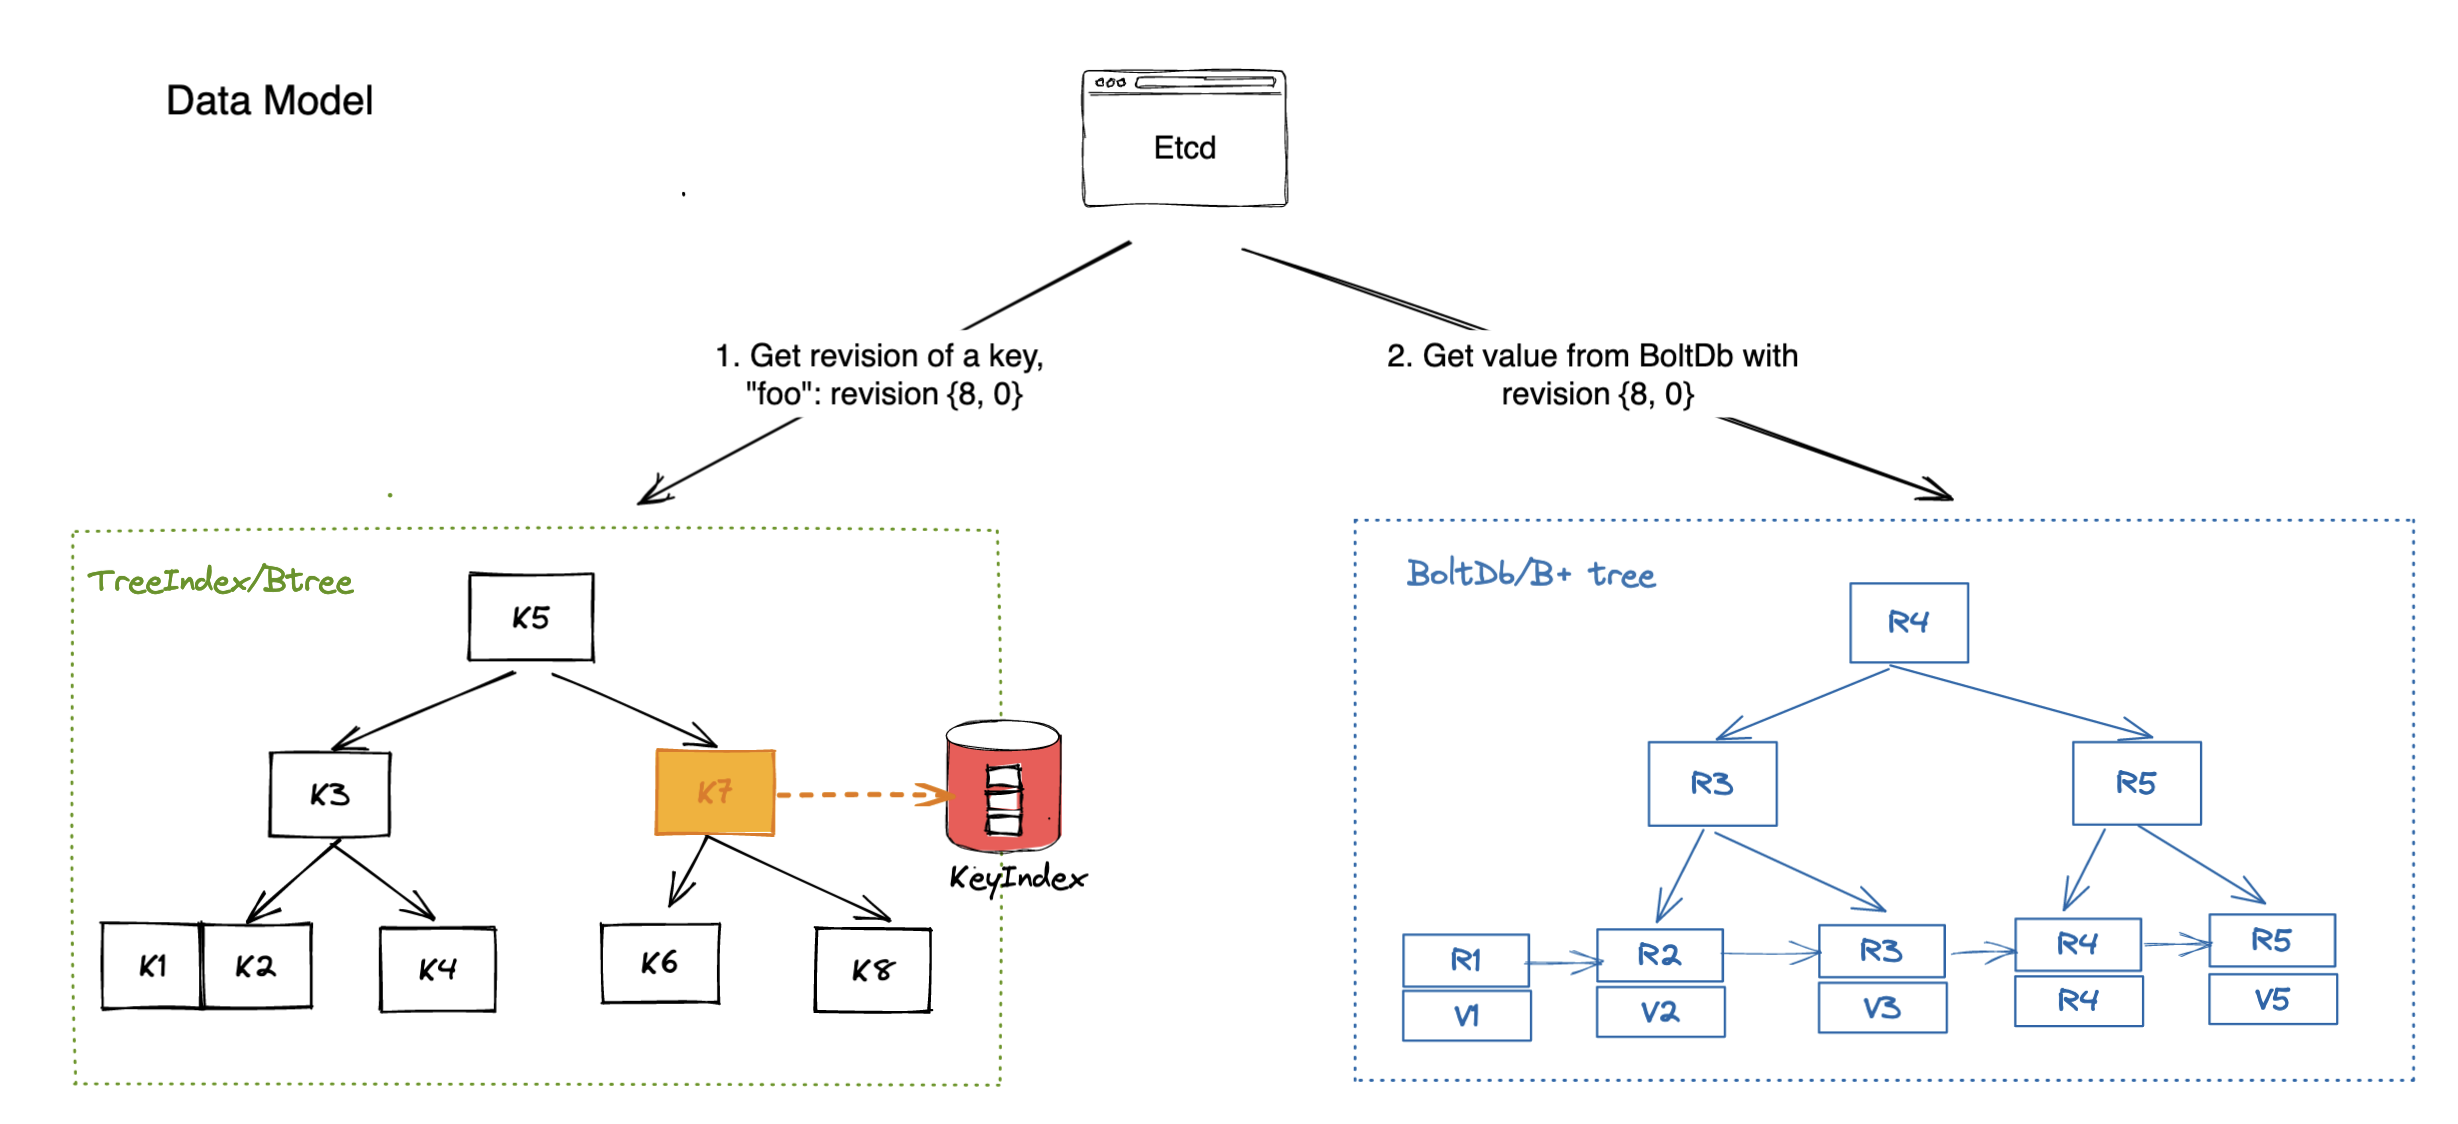
Физически etcd хранит данные как пары «ключ — значение» в постоянном b+tree . Для эффективности каждая ревизия состояния содержит только разницу относительно предыдущей. Одной ревизии может соответствовать несколько ключей дерева.
Ключ пары «ключ — значение» является 3-кортежем (major, sub, type). Major — ревизия хранилища, содержащая ключ. Sub различает ключи в одной ревизии. Type — необязательный суффикс для особого значения, например t, если значение содержит надгробную метку. Значение пары содержит изменение относительно предыдущей ревизии, то есть одну разницу. b+tree упорядочен по ключам в лексическом порядке байтов. Диапазонный поиск по разницам ревизий выполняется быстро, что позволяет быстро находить изменения между двумя заданными ревизиями. Компактизация удаляет устаревшие пары.
Для ускорения диапазонных запросов по ключам etcd также поддерживает вторичный индекс btree в памяти. Ключи этого индекса — ключи хранилища, предоставляемые пользователю. Значение является указателем на изменение в постоянном b+tree. Компактизация удаляет недействующие указатели.
В итоге etcd получает сведения о ревизии из btree, а затем использует ревизию как ключ для получения значения из b+tree, как показано ниже.