Это многостраничная версия текущего раздела для печати. .
Руководство по операциям
- 1: Аутентификационные руководства
- 2: Параметры конфигурации
- 3: Модель транспортной безопасности
- 4: Руководство по кластеризации
- 5: Запуск кластеров etcd в контейнерах
- 6: Запуск кластеров etcd как StatefulSet Kubernetes
- 7: Режимы отказа
- 8: Восстановление после аварии
- 9: Шлюз etcd
- 10: Прокси gRPC
- 11: Рекомендации по оборудованию
- 12: Обслуживание
- 13: Мониторинг etcd
- 14: Производительность
- 15: Устройство реконфигурации во время выполнения
- 16: Динамическое изменение конфигурации
- 17: Поддерживаемые платформы
- 18: Версионирование
- 19: Повреждение данных
1 - Аутентификационные руководства
1.1 - Аутентификация
auth,user,role для аутентификации:
Примечание:
Это всего лишь заглушка, которую необходимо заполнить и обновить, добавив больше информации об аутентификации. Текст выше — всего лишь пример кода.
1.2 - Управление доступом на основе ролей
Обзор
Аутентификация появилась в etcd 2.1. В API etcd v3 интерфейс API и пользовательский интерфейс аутентификации немного изменены для соответствия новой модели данных. Это руководство поможет настроить базовую аутентификацию и управление доступом на основе ролей в etcd v3.
Специальные пользователи и роли
Существует один специальный пользователь root и одна специальная роль root.
Пользователь root
Пользователя root с полным доступом к etcd необходимо создать до включения
аутентификации. Он предназначен для административных задач: управления ролями
и обычными пользователями. Пользователь root должен иметь роль root и может
изменять любые данные в etcd.
Роль root
Роль root можно назначить любому пользователю, не только пользователю root.
Пользователь с этой ролью имеет глобальный доступ на чтение и запись и право
изменять конфигурацию аутентификации кластера. Роль root также предоставляет
права для общего обслуживания кластера, включая изменение состава, дефрагментацию
хранилища и создание снимков.
Работа с пользователями
Подкоманда user утилиты etcdctl выполняет все операции с учётными записями пользователей.
Список пользователей выводится командой:
Пользователь создаётся командой:
При создании нового пользователя запрашивается пароль. Если указан параметр
--interactive=false, пароль можно передать через стандартный ввод. Его также
можно задать параметром --new-user-password.
Пользователя без возможности парольной аутентификации можно создать так:
Такой пользователь может аутентифицироваться только по Common Name сертификата TLS .
etcd не поддерживает аутентификацию с пустым паролем через --user username:. Например, пользователь с пустым паролем, созданный командой etcdctl user add anonymous:'', не может пройти аутентификацию по имени и паролю, а запросы вида etcdctl --user anonymous: get foo завершаются ошибкой user name is empty.
Роли назначаются и отзываются у пользователя командами:
Параметры пользователя можно просмотреть командой:
Пароль пользователя изменяется командой:
При изменении снова запрашивается новый пароль. С параметром --interactive=false
его можно передать через стандартный ввод.
Учётная запись удаляется командой:
Работа с ролями
Подкоманда role утилиты etcdctl управляет правами доступа отдельных ролей,
назначаемых пользователям.
Список ролей выводится командой:
Новая роль создаётся командой:
У роли нет пароля; она лишь определяет набор прав доступа.
Роли предоставляется доступ к одному ключу или диапазону ключей.
Диапазон задаётся интервалом [start-key, end-key), где start-key должен лексикографически предшествовать end-key.
Можно предоставить доступ на чтение, запись или оба вида, как в следующих примерах:
Выданные права можно в любой момент просмотреть у роли:
Права отзываются аналогичным образом:
Роль целиком удаляется командой:
Включение аутентификации
Ниже приведён минимальный порядок включения аутентификации. Администратор может настроить пользователей и роли до или после её включения.
Убедитесь, что пользователь root создан:
Включите аутентификацию:
После этого etcd работает с включённой аутентификацией. Для её отключения используйте обратную команду:
Область защиты аутентификации
Аутентификация, включённая командой etcdctl auth enable, защищает операции
V3 gRPC API (get, put, delete, watch и т. д.).
Конечные точки HTTP /metrics и /health обслуживаются отдельным обработчиком
и не защищены аутентификацией V3 RBAC. Поэтому Prometheus и балансировщики
нагрузки могут собирать метрики без аутентификации gRPC, тогда как данные
ключей и значений остаются защищёнными.
Чтобы защитить эти конечные точки наблюдаемости:
- включите mTLS с
--cert-file,--key-fileи--client-cert-auth; - либо привяжите метрики к частному интерфейсу через
--listen-metrics-urls; - либо ограничьте доступ сетевыми политиками или правилами межсетевого экрана.
Аутентификация с помощью etcdctl
Для аутентификации etcdctl поддерживает флаг, аналогичный curl.
Пароль можно ввести по запросу:
Пароль также можно передать флагом командной строки --password:
В остальном команды etcdctl не меняются. Пользователей и роли по-прежнему
можно создавать и изменять, но для этого требуется аутентификация пользователя
с ролью root.
Использование Common Name сертификата TLS
Начиная с v3.2, если сервер etcd запущен с --client-cert-auth=true, поле
Common Name (CN) клиентского сертификата TLS используется как пользователь etcd.
В этом случае CN аутентифицирует пользователя, и пароль клиенту не нужен. Если
одновременно 1. передан --client-cert-auth=true и клиент предоставляет CN и
2. клиент предоставляет имя пользователя и пароль, приоритет имеет аутентификация
по имени и паролю. Эту возможность нельзя использовать с gRPC-proxy и
gRPC-gateway. gRPC-proxy завершает TLS-соединение клиента, поэтому все клиенты
используют сертификат прокси. gRPC-gateway внутренне использует TLS-соединение
для преобразования запроса HTTP в запрос gRPC и имеет то же ограничение. Поэтому
клиенты не могут правильно передать серверу свой CN. Если предоставленный
сертификат содержит непустой CN, gRPC-proxy возвращает ошибку и останавливается.
Примечания о стойкости паролей
etcdctl и API etcd не требуют определённой длины пароля при создании пользователя
или обновлении его пароля. Соблюдение таких требований должен обеспечивать
администратор. Чтобы избежать рисков, связанных со стойкостью паролей, можно
использовать аутентификацию по Common Name сертификата TLS
и пользователей, созданных с параметром --no-password.
2 - Параметры конфигурации
etcd можно настроить следующими способами:
- Флаги командной строки
- Переменные окружения: каждому флагу соответствует переменная окружения
с тем же именем, префиксом
ETCD_, прописными буквами и форматом snake case . Например,--some-flagсоответствуетETCD_SOME_FLAG. - Файл конфигурации
Внимание: при сочетании разных способов конфигурации действуют следующие правила.
- Флаги командной строки имеют приоритет над переменными окружения.
- Если указан файл конфигурации, все флаги командной строки и переменные окружения игнорируются.
Флаги командной строки
Ниже флаги представлены в формате --flag-name DEFAULT_VALUE.
Из-за продолжающейся разработки приведённый ниже список флагов может быть неактуален. Последние доступные флаги можно получить командой etcd --help или в [справке etcd][].
Примечание: сведения о новых, обновлённых и устаревших флагах v3.7 приведены в CHANGELOG-3.7.md .
Участник
Кластеризация
Безопасность
Аутентификация
Профилирование и мониторинг
Ведение журнала
Примечание: в v3.7 несколько флагов --experimental-* стали стабильными или были переименованы.
Обязательно замените устаревшие флаги перечисленными ниже стабильными эквивалентами.
Распределённая трассировка
Прокси v2
Примечание: флаги будут объявлены устаревшими в v3.6.
Возможности
Флаги функций
Небезопасные возможности
Предупреждение: использование небезопасных возможностей может нарушить гарантии протокола консенсуса!
Файл конфигурации
Файл конфигурации etcd представляет собой отображение YAML, ключами которого
служат имена флагов командной строки, а значениями — значения флагов.
Чтобы использовать файл, укажите его путь как значение флага --config-file или переменной окружения ETCD_CONFIG_FILE.
Пример см. в [образце etcd.conf.yml][].
Поля длительности, такие как --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration и --downgrade-check-time, при передаче как флаги
командной строки принимают понятные человеку строки (например, 10m, 5s), однако
в файле конфигурации допускаются только целые значения, представляющие
наносекунды. Это известное ограничение стандартной библиотеки Go
,
где time.Duration десериализуется как обычное целое число.
Например, чтобы задать в файле конфигурации 10-минутный интервал уведомлений о ходе наблюдения:
3 - Модель транспортной безопасности
etcd поддерживает автоматический TLS и аутентификацию по клиентским сертификатам как для связи клиентов с сервером, так и для связи одноранговых узлов (серверов друг с другом внутри кластера). Обратите внимание: по умолчанию etcd не включает аутентификацию на основе RBAC и аутентификацию на транспортном уровне, чтобы упростить начало работы с базой данных. Кроме того, изменение этого значения по умолчанию нарушило бы совместимость проекта, установленную с 2013 года. Кластер etcd без включённых функций безопасности может открыть свои данные любым клиентам.
Для начала подготовьте сертификат CA и подписанную пару ключей для одного участника. Рекомендуется создавать и подписывать новую пару ключей для каждого участника кластера.
Для удобства инструмент cfssl предоставляет простой интерфейс создания сертификатов; пример его использования приведён здесь . В качестве альтернативы воспользуйтесь руководством по созданию самоподписанных пар ключей .
Из-за продолжающейся разработки приведённый ниже список флагов может быть неактуален. Последние доступные флаги можно получить командой etcd --help или в [справке etcd][].
Базовая настройка
etcd принимает несколько относящихся к сертификатам параметров конфигурации в виде флагов командной строки или переменных окружения:
Связь клиента с сервером:
--cert-file=<path>: сертификат, используемый для соединений SSL/TLS с etcd. При заданном параметре advertise-client-urls может использовать схему HTTPS.
--key-file=<path>: ключ сертификата. Должен быть незашифрованным.
--client-cert-auth: если задан, etcd проверяет во всех входящих запросах HTTPS наличие клиентского сертификата, подписанного доверенным CA; запросы без действительного клиентского сертификата завершаются ошибкой. Если включена аутентификация
, сертификат предоставляет учётные данные для имени пользователя из поля Common Name.
--trusted-ca-file=<path>: доверенный центр сертификации.
--auto-tls: использовать автоматически созданные самоподписанные сертификаты для соединений TLS с клиентами.
Связь одноранговых узлов (между серверами / в кластере):
Параметры одноранговых узлов работают так же, как параметры связи клиента с сервером:
--peer-cert-file=<path>: сертификат для соединений SSL/TLS между одноранговыми узлами. Используется как при прослушивании адреса однорангового узла, так и при отправке запросов другим узлам.
--peer-key-file=<path>: ключ сертификата. Должен быть незашифрованным.
--peer-client-cert-auth: если задан, etcd проверяет во всех входящих запросах одноранговых узлов кластера действительные клиентские сертификаты, подписанные указанным CA.
--peer-trusted-ca-file=<path>: доверенный центр сертификации.
--peer-auto-tls: использовать автоматически созданные самоподписанные сертификаты для соединений TLS между одноранговыми узлами.
Если указан сертификат связи клиента с сервером или одноранговых узлов, необходимо также задать ключ. Все эти параметры конфигурации доступны и через переменные окружения ETCD_CA_FILE, ETCD_PEER_CA_FILE и т. д.
Общие параметры:
--cipher-suites: разделённый запятыми список поддерживаемых наборов шифров TLS между сервером и клиентом, а также между одноранговыми узлами (пустой список автоматически заполняется Go).
--tls-min-version=<version> задаёт минимальную версию TLS, поддерживаемую etcd.
--tls-max-version=<version> задаёт максимальную версию TLS, поддерживаемую etcd. Если не задана, используется максимальная версия, поддерживаемая Go.
keyUsage и extendedKeyUsage сертификата TLS
При создании сертификатов X.509 для защиты транспорта etcd
сертификаты должны содержать подходящие поля keyUsage и
extendedKeyUsage в зависимости от своей роли. Для проверки сертификатов
etcd использует библиотеки Go crypto/tls и crypto/x509, которые
контролируют эти варианты использования во время рукопожатия TLS.
В таблице приведены рекомендуемые варианты использования для распространённых ролей сертификатов:
| Роль сертификата | keyUsage | extendedKeyUsage |
|---|---|---|
| Сервер (клиент — сервер) | digitalSignature, keyEncipherment | serverAuth |
| Клиент | digitalSignature, keyEncipherment | clientAuth |
| Одноранговый узел (сервер — сервер) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Примечания:
- При включённом
--peer-client-cert-authсертификаты одноранговых узлов используются для взаимного TLS между участниками etcd и поэтому требуют какserverAuth, так иclientAuth. - Клиентские сертификаты, используемые с
--client-cert-auth, должны содержатьclientAuth.
Пример 1: транспортная безопасность между клиентом и сервером с HTTPS
Подготовьте сертификат CA (ca.crt) и подписанную пару ключей (server.crt, server.key).
Настроим простую транспортную безопасность HTTPS в etcd по шагам:
etcd должен успешно запуститься; конфигурацию можно проверить, обратившись к etcd по HTTPS:
Команда должна показать успешное рукопожатие. Поскольку используются самоподписанные сертификаты и собственный центр сертификации, CA необходимо передать curl с параметром --cacert. Другой вариант — добавить сертификат CA в системный каталог доверенных сертификатов (обычно /etc/pki/tls/certs или /etc/ssl/certs).
Пользователям OSX 10.9+: curl 7.30.0 в OSX 10.9+ не распознаёт сертификаты, переданные в командной строке.
Вместо этого импортируйте тестовый ca.crt непосредственно в связку ключей либо добавьте curl флаг -k, чтобы игнорировать ошибки.
Для проверки без флага -k выполните open ./tests/fixtures/ca/ca.crt и следуйте указаниям.
После тестирования удалите этот сертификат!
Если известно обходное решение, сообщите о нём.
Пример 2: аутентификация клиента на сервере с клиентскими сертификатами HTTPS
К этому моменту клиент etcd умеет проверять подлинность сервера и обеспечивает транспортную безопасность. Клиентские сертификаты также позволяют предотвратить несанкционированный доступ к etcd.
Клиенты предъявляют серверу свои сертификаты, а сервер проверяет их подпись указанным CA и решает, обслуживать ли запрос.
Потребуются те же файлы, что и в первом примере, а также пара ключей клиента (client.crt, client.key), подписанная тем же центром сертификации.
Теперь отправьте серверу тот же запрос, что и выше:
Сервер должен отклонить запрос:
Для успешного выполнения нужно передать серверу подписанный CA клиентский сертификат:
Вывод должен содержать:
А также ответ сервера:
Укажите наборы шифров, чтобы заблокировать слабые наборы шифров TLS .
Рукопожатие TLS завершается ошибкой, если приветствие клиента запрошено с недопустимыми наборами шифров.
Например:
После этого клиентские запросы должны указывать один из заданных на сервере наборов шифров:
Пример 3: транспортная безопасность и клиентские сертификаты в кластере
etcd поддерживает ту же описанную выше модель для связи одноранговых узлов, то есть для обмена между участниками etcd в кластере.
Предположим, имеется ca.crt и два участника с собственными парами ключей (member1.crt и member1.key, member2.crt и member2.key), подписанными этим CA. Запустим etcd следующим образом:
Участники etcd образуют кластер, а весь обмен между ними шифруется и аутентифицируется клиентскими сертификатами. Вывод etcd покажет, что адреса подключений используют HTTPS.
Пример 4: автоматическая транспортная безопасность с самоподписанными сертификатами
При указании ClientAutoTLS и PeerAutoTLS срок действия автоматически созданных etcd клиентского сертификата и сертификата однорангового узла составляет только 1 год. Срок действия сертификата в годах можно задать флагом –self-signed-cert-validity.
Если требуется шифрование связи без аутентификации, etcd может шифровать сообщения автоматически созданными самоподписанными сертификатами. Это упрощает развёртывание, поскольку управлять сертификатами и ключами вне etcd не требуется.
Настройте etcd на использование самоподписанных сертификатов для клиентских и одноранговых соединений флагами --auto-tls и --peer-auto-tls:
Самоподписанные сертификаты не подтверждают подлинность, поэтому curl вернёт ошибку:
Чтобы отключить проверку цепочки сертификатов, вызовите curl с флагом -k:
Примечания по DNS SRV
Начиная с v3.1.0 (кроме v3.2.9), начальная инициализация через SRV аутентифицирует ServerName по корневому доменному имени из флага --discovery-srv. Для защиты от атак «человек посередине» с сертификатами требуется, чтобы сертификат содержал совпадающее корневое доменное имя в поле Subject Alternative Name (SAN). Например, etcd --discovery-srv=etcd.local аутентифицирует одноранговые узлы и клиентов, только если предоставленные сертификаты содержат корневой домен etcd.local в поле Subject Alternative Name (SAN)
Примечания для прокси etcd
Прокси etcd терминирует TLS своего клиента, если соединение защищено, а для связи с участниками etcd использует собственные ключ и сертификат прокси, заданные в --peer-key-file и --peer-cert-file.
Прокси связывается с участниками etcd как через --advertise-client-urls, так и через --advertise-peer-urls соответствующего участника. Он пересылает клиентские запросы на объявленные клиентские URL участников etcd и синхронизирует исходную конфигурацию кластера через объявленные URL их одноранговых узлов.
Когда для участника etcd включена аутентификация клиентов, администратор должен убедиться, что сертификат однорангового узла из параметра прокси --peer-cert-file действителен для этой аутентификации. При включённой аутентификации одноранговых узлов сертификат прокси также должен быть действителен для неё.
Примечания по аутентификации TLS
Начиная с v3.2.0 , сертификаты TLS перезагружаются при каждом клиентском соединении . Это позволяет заменять истекающие сертификаты без остановки серверов etcd, перезаписывая старые сертификаты новыми. Обновление сертификатов для каждого соединения не должно создавать значительных накладных расходов, однако в будущем его можно улучшить уровнем кэширования. Примеры тестов находятся здесь .
Начиная с v3.2.0
, сервер отклоняет входящие сертификаты одноранговых узлов с неверным IP в SAN
. Если сертификат однорангового узла содержит IP-адреса в поле Subject Alternative Name (SAN), сервер аутентифицирует узел только при совпадении удалённого IP-адреса с одним из них. Это предотвращает присоединение к кластеру неавторизованных конечных точек. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом фактический IP-адрес узла B равен 10.138.0.2, а не 10.138.0.27. Когда B пытается присоединиться к кластеру, узел A отклоняет его с ошибкой x509: certificate is valid for 10.138.0.27, not 10.138.0.2, поскольку удалённый IP-адрес B не совпадает с адресом в поле Subject Alternative Name (SAN).
Начиная с v3.2.0
, при проверке SAN сервер разрешает TLS DNSNames
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) только DNS-имена без IP-адресов, сервер аутентифицирует узел лишь тогда, когда прямое разрешение этих DNS-имён (dig b.com) даёт IP, совпадающий с удалённым адресом. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2. Когда B пытается присоединиться к кластеру, узел A разрешает входящее имя b.com, получая список IP-адресов (например, командой dig b.com). Если список не содержит IP 10.138.0.2, A отклоняет B с ошибкой tls: 10.138.0.2 does not match any of DNSNames ["b.com"].
Начиная с v3.2.2
, при совпадении IP сервер принимает соединение без проверки записей DNS
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) IP-адреса и DNS-имена, а удалённый IP совпадает с одним из адресов, сервер принимает соединение без дальнейшей проверки DNS-имён. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2, а invalid.domain — недопустимое имя узла. Когда B пытается присоединиться к кластеру, узел A успешно аутентифицирует его, поскольку поле Subject Alternative Name (SAN) содержит действительный совпадающий IP-адрес. Подробнее см. issue#8206
.
Начиная с v3.2.5
, сервер поддерживает обратное разрешение шаблонных DNS SAN
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) только DNS-имена без IP-адресов, сервер сначала выполняет обратное разрешение удалённого IP и получает список соответствующих ему имён (например, командой nslookup IPADDR). Затем соединение принимается, если одно из имён совпадает с DNS-именем сертификата точно или по шаблону. Если совпадений нет, сервер выполняет прямое разрешение каждой записи DNS сертификата (например, разрешает example.default.svc для записи *.example.default.svc) и принимает соединение, только когда среди разрешённых адресов узла есть IP, совпадающий с удалённым IP однорангового узла. Например, CSR узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2. Когда B пытается присоединиться к кластеру, узел A выполняет обратное разрешение IP 10.138.0.2 и получает список имён узлов. Затем он точно или по шаблону сопоставляет их с DNS-именами в поле Subject Alternative Name (SAN) сертификата B. Если ни обратное, ни прямое разрешение не дало совпадений, возвращается ошибка "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"]. Подробнее см. issue#8268
.
В v3.3.0
добавлен флаг etcd --peer-cert-allowed-cn
, поддерживающий аутентификацию соединений одноранговых узлов по CN (Common Name)
. Начальная инициализация TLS в Kubernetes включает создание динамических сертификатов для участников etcd и других системных компонентов (например, сервера API, kubelet и т. д.). Отдельные CA для каждого компонента обеспечивают более строгий контроль доступа к кластеру etcd, но часто неудобны. При заданном флаге –peer-cert-allowed-cn узел может присоединиться только с совпадающим общим именем, даже если CA общий. Сопоставление является точным сравнением строки с полем Common Name (CN) сертификата; шаблоны и префиксы не поддерживаются. При фильтрации по имени узла с –peer-cert-allowed-hostname или –client-cert-allowed-hostname используется x509.Certificate.VerifyHostname() из Go, поддерживающий как точные имена, так и шаблонные записи (например, *.example.com). Например, каждый участник кластера из 3 узлов настраивается со следующими CSR (созданными с cfssl):
При заданном --peer-cert-allowed-cn etcd.local аутентифицируются только одноранговые узлы с совпадающими общими именами. Узлы с другими CN в CSR или другим --peer-cert-allowed-cn отклоняются:
Каждый процесс следует запускать с параметром:
В v3.2.19
и v3.3.4
исправлена перезагрузка TLS, когда поле SAN сертификата содержит только IP-адреса без доменных имён
. Например, участник настраивается со следующим CSR (созданным с cfssl):
В Go сервер вызывает (*tls.Config).GetCertificate для перезагрузки TLS тогда и только тогда, когда поле сервера (*tls.Config).Certificates непусто либо (*tls.ClientHelloInfo).ServerName непусто и содержит действительный SNI клиента. Ранее etcd всегда заполнял (*tls.Config).Certificates при первом клиентском рукопожатии TLS, делая поле непустым. Поэтому клиент всегда должен был передавать совпадающий SNI, чтобы пройти проверку TLS и вызвать (*tls.Config).GetCertificate для перезагрузки ресурсов TLS.
Однако сертификат, поле SAN которого не содержит доменных имён, а только IP-адреса
, запрашивает *tls.ClientHelloInfo с пустым полем ServerName, поэтому при первом рукопожатии TLS перезагрузка не запускается. Это становится проблемой при замене истёкших сертификатов без остановки службы.
Теперь при первом клиентском рукопожатии TLS (*tls.Config).Certificates создаётся пустым, чтобы сначала вызвать (*tls.Config).GetCertificate, а затем заполнять остальные сертификаты при каждом новом соединении TLS, даже если SNI клиента пуст (например, сертификат содержит только IP-адреса).
Примечания по белому списку узлов
Флаг etcd --host-whitelist задаёт допустимые имена узлов из клиентских запросов HTTP. Политика происхождения клиента защищает незащищённые серверы etcd от атак “DNS Rebinding”
. Любой веб-сайт может создать разрешённое DNS-имя и направить DNS на "localhost" или любой другой адрес. Тогда все конечные точки HTTP сервера etcd, слушающего "localhost", становятся доступны и уязвимы для атак повторной привязки DNS. Подробнее см. CVE-2018-5702
.
Политика происхождения клиента работает следующим образом:
- Если клиентское соединение защищено HTTPS, разрешаются любые имена узлов.
- Если клиентское соединение не защищено и
"HostWhitelist"не пуст, разрешаются только запросы HTTP, поле Host которых указано в белом списке.
Для более строгого контроля политика происхождения клиента применяется независимо от того, включена ли аутентификация.
По умолчанию etcd --host-whitelist и embed.Config.HostWhitelist пусты, поэтому разрешены все имена узлов. Обратите внимание: при указании имён адреса обратной петли автоматически не добавляются. Чтобы разрешить интерфейсы обратной петли, внесите их в белый список вручную (например, "localhost", "127.0.0.1" и т. д.).
Часто задаваемые вопросы
При клиентской аутентификации TLS появляется ошибка рукопожатия SSLv3 alert handshake failure?
Пакет crypto/tls языка golang проверяет назначение открытого ключа сертификата перед его использованием.
Чтобы применять открытый ключ сертификата для аутентификации клиента, при его создании нужно добавить clientAuth в Extended Key Usage.
Это выполняется следующим образом:
Добавьте в openssl.cnf следующий раздел:
При создании сертификата обязательно укажите его во флаге -extensions:
При аутентификации сертификата однорангового узла появляется “certificate is valid for 127.0.0.1, not $MY_IP”
Убедитесь, что сертификаты подписаны с Subject Name, содержащим общедоступный IP-адрес участника. Например, инструмент etcd-ca предоставляет параметр --ip= для команды new-cert.
Сертификат должен быть подписан для FQDN участника в Subject Name; для добавления IP-адреса используйте Subject Alternative Names (кратко — IP SAN). Инструмент etcd-ca предоставляет параметр --domain= для команды new-cert, а openssl также умеет это
.
Шифрует ли etcd данные, хранящиеся на дисках?
Нет. etcd не шифрует данные ключей и значений, хранящиеся на дисках. Если данные etcd необходимо шифровать, доступны следующие варианты:
- выполнять шифрование и расшифрование в клиентских приложениях
- использовать функцию нижележащей системы хранения для шифрования сохранённых данных, например dm-crypt
В журнале появляется предупреждение “directory X exist without recommended permission -rwx——”
При создании некоторых новых каталогов etcd задаёт права доступа 700, чтобы по возможности предотвратить непривилегированный доступ. Однако если пользователь уже создал каталог с собственными правами, etcd использует существующий каталог и записывает предупреждение, если права отличаются от 700.
4 - Руководство по кластеризации
Обзор
При статическом запуске кластера etcd каждый участник должен знать других участников кластера. В некоторых случаях IP-адреса участников заранее неизвестны. Тогда кластер etcd можно инициализировать с помощью службы обнаружения.
После запуска кластера etcd участники добавляются и удаляются посредством динамического изменения конфигурации . Чтобы лучше понять конструкцию этого механизма, рекомендуется прочитать документ о конструкции динамической конфигурации .
В руководстве рассматриваются следующие механизмы начальной инициализации кластера etcd:
Каждый механизм будет использован для создания кластера etcd из трёх машин со следующими параметрами:
| Имя | Адрес | Имя узла |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Статическая инициализация
Поскольку участники, их адреса и размер кластера известны до запуска, можно применить автономную конфигурацию начальной инициализации, задав флаг initial-cluster. Каждая машина получает следующие переменные окружения либо параметры командной строки:
Обратите внимание: URL в initial-cluster — это объявленные URL одноранговых узлов, поэтому они должны совпадать со значением initial-advertise-peer-urls на соответствующих узлах.
При запуске нескольких кластеров (либо многократном создании и уничтожении одного кластера) с одинаковой конфигурацией для тестирования настоятельно рекомендуется задавать каждому кластеру уникальный initial-cluster-token. Тогда etcd создаёт уникальные идентификаторы кластера и участников, даже если остальные параметры полностью совпадают. Это защищает etcd от взаимодействия между кластерами, способного их повредить.
Для приёма клиентского трафика etcd слушает адреса listen-client-urls
. Участник etcd объявляет URL из advertise-client-urls
другим участникам, прокси и клиентам. Убедитесь, что advertise-client-urls доступны предполагаемым клиентам. Распространённая ошибка — указать в advertise-client-urls localhost или оставить значение по умолчанию, когда к etcd должны обращаться удалённые клиенты.
На каждой машине запустите etcd со следующими флагами:
При последующих запусках etcd параметры командной строки, начинающиеся с --initial-cluster, игнорируются. После исходной инициализации переменные окружения или флаги командной строки можно удалить. Если конфигурацию потребуется изменить позднее (например, добавить участника в кластер или удалить его), обратитесь к руководству по динамической конфигурации
.
TLS
etcd поддерживает шифрованную связь по протоколу TLS. Каналы TLS можно использовать как для шифрования внутреннего обмена между одноранговыми узлами кластера, так и для шифрования клиентского трафика. В этом разделе приведены примеры настройки кластера с TLS для одноранговых и клиентских соединений. Подробности о поддержке TLS в etcd см. в руководстве по безопасности .
Самоподписанные сертификаты
Кластер с самоподписанными сертификатами одновременно шифрует трафик и аутентифицирует соединения. Для запуска такого кластера каждый участник должен иметь уникальную пару ключей (member.crt, member.key), подписанную общим сертификатом CA кластера (ca.crt) для одноранговых и клиентских соединений. Сертификаты можно создать по примеру настройки TLS
в etcd.
На каждой машине etcd запускается со следующими флагами:
Автоматические сертификаты
Если кластеру требуется шифрованная связь, но не нужна аутентификация соединений, etcd можно настроить на автоматическое создание ключей. При инициализации каждый участник создаёт собственный набор ключей на основе объявленных IP-адресов и имён узлов.
На каждой машине etcd запускается со следующими флагами:
Случаи ошибок
В следующем примере новый узел не включён в перечень узлов. Для нового кластера узел обязательно должен быть добавлен в список исходных участников.
В этом примере узел (infra0) сопоставляется с адресом (127.0.0.1:2380), отличным от указанного для него в списке кластера (10.0.1.10:2380). Если узел должен слушать несколько адресов, все они обязательно должны быть отражены в директиве конфигурации “initial-cluster”.
Если одноранговый узел с другим набором параметров конфигурации попытается присоединиться к кластеру, etcd сообщит о несовпадении идентификатора кластера и завершит работу.
Обнаружение
В некоторых случаях IP-адреса одноранговых узлов кластера заранее неизвестны. Такое часто происходит при использовании облачных провайдеров или DHCP в сети. Тогда вместо статической конфигурации для начальной инициализации нового кластера используется существующий кластер etcd. Этот процесс называется «обнаружением».
Для обнаружения доступны два метода:
- служба обнаружения etcd
- записи DNS SRV
Обнаружение etcd
Чтобы лучше понять конструкцию протокола службы обнаружения, рекомендуется прочитать документацию протокола.
Срок жизни URL обнаружения
URL обнаружения идентифицирует уникальный кластер etcd. Вместо повторного использования существующего URL каждый экземпляр etcd получает новый общий URL обнаружения для начальной инициализации нового кластера.
Кроме того, URL обнаружения следует использовать ТОЛЬКО для исходной инициализации кластера. Для изменения состава уже работающего кластера обратитесь к руководству по динамическому изменению конфигурации .
Пользовательская служба обнаружения etcd
Для обнаружения и начальной инициализации используется существующий кластер. При использовании частного кластера etcd создайте URL следующим образом:
Задание ключа размера по этому URL создаёт URL обнаружения с ожидаемым размером кластера 3.
В этом случае используется URL https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83, а участники etcd при запуске регистрируются в каталоге https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83.
Для каждого участника должен быть задан уникальный флаг имени. Подходящим выбором может быть Hostname или machine-id. Иначе обнаружение завершится ошибкой из-за повторяющегося имени.
Теперь запустим etcd с соответствующими флагами для каждого участника:
Каждый участник зарегистрируется в пользовательской службе обнаружения etcd, а после регистрации всех машин кластер начнёт работу.
Общедоступная служба обнаружения etcd
Если существующего кластера нет, используйте общедоступную службу обнаружения на discovery.etcd.io. Чтобы создать частный URL обнаружения через конечную точку “new”, выполните команду:
Будет создан кластер с исходным размером 3 участника. Если размер не указан, по умолчанию также используется 3.
Для каждого участника должен быть задан уникальный флаг имени, иначе обнаружение завершится ошибкой из-за повторяющихся имён. Подходящим выбором может быть Hostname или machine-id.
Теперь запустим etcd с соответствующими флагами для каждого участника:
Каждый участник зарегистрируется в службе обнаружения, а после регистрации всех участников кластер начнёт работу.
Чтобы etcd подключался к службе обнаружения через HTTP-прокси, задайте переменную окружения ETCD_DISCOVERY_PROXY.
Случаи ошибок и предупреждений
Ошибки сервера обнаружения
Предупреждения
Это безвредное предупреждение означает, что URL обнаружения будет проигнорирован на этой машине.
Обнаружение DNS
В качестве механизма обнаружения можно использовать записи SRV
DNS.
Флаг --discovery-srv задаёт доменное имя DNS, в котором находятся записи SRV обнаружения.
При значении --discovery-srv example.com записи DNS SRV ищутся в следующем порядке:
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Если найдена _etcd-server-ssl._tcp.example.com, etcd попытается выполнить начальную инициализацию через TLS.
Чтобы клиенты могли обнаружить кластер etcd, следующие записи DNS SRV ищутся в указанном порядке:
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Если найдена _etcd-client-ssl._tcp.example.com, клиенты попытаются связаться с кластером etcd через SSL/TLS.
Если etcd использует TLS, запись SRV обнаружения (например, example.com) вместе с именем узла должна входить в DNS SAN сертификата SSL, иначе кластеризация завершится ошибкой с сообщениями журнала наподобие следующего:
Если etcd использует TLS без пользовательского центра сертификации, домен обнаружения (например, example.com) должен совпадать с доменом записи SRV (например, infra1.example.com). Это снижает риск атак с поддельными записями SRV, указывающими на другой домен: такой домен мог бы иметь действительный сертификат PKI, но контролироваться неизвестной третьей стороной.
Флаг -discovery-srv-name дополнительно задаёт суффикс имени SRV, запрашиваемого при обнаружении.
Используйте его, чтобы различать несколько кластеров etcd в одном домене.
Например, при значениях discovery-srv=example.com и -discovery-srv-name=foo выполняются следующие запросы DNS SRV:
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
Создание записей DNS SRV
Начальная инициализация кластера etcd через DNS
Участники кластера etcd могут объявлять доменные имена или IP-адреса; при начальной инициализации разрешаются записи DNS A.
Начиная с 3.2 (в 3.1 выводятся предупреждения), --listen-peer-urls и --listen-client-urls отклоняют доменное имя при привязке сетевого интерфейса.
Разрешённый адрес из --initial-advertise-peer-urls должен совпадать с одним из разрешённых адресов в целях SRV. Участник etcd считывает разрешённый адрес, чтобы определить, принадлежит ли он кластеру, заданному записями SRV.
Кластер также можно инициализировать по IP-адресам вместо доменных имён:
Начиная с v3.1.0 (кроме v3.2.9), когда etcd --discovery-srv=example.com настроен с TLS, сервер аутентифицирует одноранговые узлы и клиентов только в том случае, если предоставленные сертификаты содержат корневой домен example.com в поле Subject Alternative Name (SAN). См. примечания по DNS SRV
.
Шлюз
Шлюз etcd — простой TCP-прокси, пересылающий сетевые данные кластеру etcd. Подробнее см. в руководстве по шлюзу .
Прокси
При заданном флаге --proxy etcd работает в режиме прокси
. Этот режим поддерживает только API etcd v2; поддержка API v3 не планируется. Вместо этого после выпуска etcd 3.0 для API v3 появится новый прокси с расширенными возможностями.
Для настройки кластера etcd с прокси API v2 прочитайте документ о кластеризации в выпуске etcd 2.3 .
5 - Запуск кластеров etcd в контейнерах
В этом руководстве показано, как запустить etcd в Docker с помощью процесса статической начальной инициализации .
Docker
Чтобы предоставить клиентам вне узла Docker доступ к API etcd, используйте IP-адрес узла контейнера. Способ получения IP-адреса подробно описан в документации docker inspect
. Также можно передать команде docker run флаг --net=host, чтобы не помещать контейнер в отдельный сетевой стек.
Запуск одного узла etcd
При настройке etcd используйте IP-адрес узла:
Настройте том Docker для хранения данных etcd:
Запустите последнюю версию etcd (на момент написания — v3.7.0):
Выведите список участников кластера:
Запуск кластера etcd из 3 узлов
Чтобы использовать etcdctl с API версии 3:
Физические серверы
При развёртывании кластера etcd из 3 узлов на физических серверах могут быть полезны примеры из репозитория baremetal .
Подключение тома с сертификатами
Контейнер выпуска etcd не содержит корневых сертификатов по умолчанию. Чтобы использовать HTTPS с сертификатами, которым доверяет корневой центр, например для обнаружения, подключите каталог сертификатов к контейнеру etcd:
6 - Запуск кластеров etcd как StatefulSet Kubernetes
Ниже показано, как выполнить статическую начальную инициализацию в виде StatefulSet Kubernetes.
Пример манифеста
Этот манифест содержит службу и StatefulSet для развёртывания статического кластера etcd в Kubernetes.
Если скопировать содержимое манифеста в файл etcd.yaml, его можно применить к кластеру следующей командой.
После применения дождитесь готовности подов.
Используемый в примере контейнер содержит etcdctl, который можно вызывать непосредственно внутри подов.
Для развёртывания с самоподписанным сертификатом найдите в закомментированной конфигурации разделы, начинающиеся с ## TLS, и раскомментируйте нужные значения. Дополнительные инструкции по созданию сертификата с помощью cert-manager приведены ниже.
Создание сертификатов
В этом разделе Helm используется для установки оператора cert-manager .
После установки cert-manager в кластере можно создавать самоподписанные сертификаты. Созданные сертификаты помещаются в объект Secret, который можно подключить к контейнерам как файлы.
Команда Helm для установки cert-manager:
Пример конфигурации ClusterIssuer для создания самоподписанных сертификатов:
Этот манифест создаёт объекты Certificate для клиентских и серверных сертификатов, ссылаясь на ClusterIssuer “selfsigned”. Поле dnsNames должно содержать исчерпывающий список действительных имён узлов для сертификатов, создаваемых cert-manager.
7 - Режимы отказа
В крупных развёртываниях машин отказы неизбежны. Машина выходит из строя при неисправности оборудования или программного обеспечения. Несколько машин могут отказать одновременно из-за перебоя питания или проблем с сетью. Разные виды отказов также могут происходить одновременно; перечислить все возможные случаи практически невозможно.
В этом разделе описаны виды отказов и механизмы, позволяющие etcd сохранять работоспособность. Почти любой конкретный отказ можно отнести к одной из этих категорий. Чтобы подготовиться к редким или невосстановимым отказам , всегда создавайте резервные копии кластера etcd.
Отказ меньшинства последователей
Если отказало менее половины последователей, кластер etcd продолжает принимать запросы и работать без серьёзных нарушений. Например, отказ двух последователей не влияет на работу кластера etcd из пяти участников. Однако клиенты теряют соединение с отказавшими участниками. Клиентские библиотеки должны скрывать эти перебои при чтении, автоматически переподключаясь к другим участникам. Операторам следует ожидать роста нагрузки на оставшихся участников из-за переподключений.
Отказ лидера
При отказе лидера кластер etcd автоматически выбирает нового. Выборы начинаются не мгновенно: из-за модели обнаружения отказов по тайм-ауту для выбора нового лидера требуется примерно один тайм-аут выборов.
Во время выборов кластер не может обрабатывать записи. Запросы на запись, отправленные в этот период, ставятся в очередь до выбора нового лидера.
Записи, уже отправленные старому лидеру, но ещё не зафиксированные, могут быть потеряны. Новый лидер вправе перезаписать любые незафиксированные записи предыдущего лидера. С точки зрения пользователя некоторые запросы на запись после выборов могут завершиться по тайм-ауту. При этом зафиксированные записи никогда не теряются.
Новый лидер автоматически продлевает тайм-ауты всех аренд. Благодаря этому аренда не истекает раньше предоставленного TTL, даже если её выдал прежний лидер.
Отказ большинства
Если отказало большинство участников, кластер etcd прекращает работу и больше не может принимать записи.
Восстановление после отказа большинства возможно только тогда, когда большинство участников снова становится доступно. Если большинство нельзя вернуть в работу, оператор должен запустить аварийное восстановление кластера.
Как только большинство участников заработает, кластер etcd автоматически выбирает нового лидера и возвращается в исправное состояние. Новый лидер автоматически продлевает тайм-ауты всех аренд, поэтому аренды не истекают из-за недоступности серверов.
Разделение сети
Разделение сети похоже на отказ меньшинства последователей или лидера. Оно делит кластер etcd на две части: одну с большинством участников и другую с меньшинством. Сторона большинства становится доступным кластером, а сторона меньшинства остаётся недоступной. В etcd не возникает «расщепления сознания» (split-brain), поскольку участники явно добавляются и удаляются, а каждое такое изменение утверждается текущим большинством.
Если лидер находится на стороне большинства, с точки зрения этой стороны произошёл отказ меньшинства последователей. Если лидер оказался на стороне меньшинства, это отказ лидера: прежний лидер складывает полномочия, а большинство выбирает нового.
После восстановления сети сторона меньшинства автоматически распознаёт лидера большинства и восстанавливает своё состояние.
Отказ во время начальной инициализации
Начальная инициализация кластера успешна только в том случае, если запустились все обязательные участники. При любом отказе во время инициализации удалите каталоги данных на всех участниках и заново инициализируйте кластер с новым cluster-token или токеном обнаружения.
Разумеется, неудачно инициализированный кластер можно восстанавливать так же, как работающий. Однако почти всегда это требует больше времени и ресурсов, чем повторная инициализация, поскольку сохранять в таком кластере ещё нечего.
8 - Восстановление после аварии
etcd рассчитан на отказы машин. Кластер etcd автоматически восстанавливается после временных сбоев, например перезагрузки машины, и допускает до (N-1)/2 постоянных отказов в кластере из N участников. При постоянном отказе из-за неисправности оборудования или повреждения диска участник теряет доступ к кластеру. Если кластер навсегда теряет более (N-1)/2 участников, происходит катастрофический отказ с безвозвратной потерей кворума. Без кворума кластер не может достичь консенсуса и продолжать принимать обновления.
Для восстановления после катастрофического отказа etcd v3 предоставляет средства снимков и восстановления, позволяющие воссоздать кластер без потери данных ключей v3. Восстановление ключей v2 описано в руководстве администратора v2 .
Создание снимка пространства ключей
Для восстановления кластера сначала нужен снимок пространства ключей одного
участника etcd. Его можно создать с работающего участника командой
etcdctl snapshot save либо скопировать файл member/snap/db из каталога данных
etcd. Следующая команда сохраняет пространство ключей, обслуживаемое $ENDPOINT,
в файл snapshot.db:
Обратите внимание: снимок из файла member/snap/db может потерять ещё не
записанные данные, находящиеся в каталоге wal (журнале предзаписи).
Состояние снимка
Чтобы узнать ревизию и хеш снимка, используйте команду etcdutl snapshot status:
Восстановление кластера
Разница ревизий
При восстановлении кластера существующие клиенты могут увидеть откат ревизии на сотни или тысячи значений. Снимок содержит историю данных только до момента создания, тогда как текущее состояние могло уйти далеко вперёд.
Это особенно опасно для Kubernetes с etcd, где контроллеры и операторы могут
использовать так называемые informers как локальные кэши, получающие уведомления
об обновлениях через наблюдения. Восстановление старой ревизии может неправильно
обновить кэши и вызвать непредсказуемое, несогласованное поведение контроллеров.
При известных потребителях API наблюдения, локальных кэшированных копиях данных etcd или использовании Kubernetes настоятельно рекомендуется восстанавливать снимок с описанным ниже «увеличением ревизии».
Восстановление из снимка
Для восстановления кластера достаточно одного файла снимка “db”. Команда
etcdutl snapshot restore создаёт новые каталоги данных etcd; все участники
должны восстанавливаться из одного снимка. При восстановлении перезаписывается
часть метаданных снимка, в частности идентификаторы участника и кластера, поэтому
участник теряет прежнюю идентичность. Это не позволяет новому участнику случайно
присоединиться к существующему кластеру. Следовательно, восстановление из снимка
обязательно должно запускать новый логический кластер.
Простое восстановление выполняется так:
Проверка целостности
Целостность снимка можно проверить при восстановлении. Снимок, созданный
etcdctl snapshot save, содержит хеш целостности, который проверяет
etcdutl snapshot restore. У снимка, скопированного из каталога данных, хеша
нет, и восстановить его можно только с --skip-hash-check.
Восстановление с увеличением ревизии
Чтобы после восстановления ревизии никогда не уменьшались, укажите
--bump-revision. Параметр принимает 64 bit целое число ревизий, добавляемых к
текущей ревизии снимка. Каждая запись в etcd увеличивает ревизию на один, поэтому
для снимка недельной давности достаточно увеличения на 1'000'000'000, если etcd
обрабатывает менее 1500 записей в секунду.
Для контроллеров Kubernetes важно также пометить все ревизии, включая добавленные,
как компактизированные через --mark-compacted. Тогда все наблюдения завершаются,
а etcd не отвечает на запросы о ревизиях после создания снимка, фактически
инвалидируя кэши informer.
Полная команда выглядит так:
Восстановление с обновлённым составом
Участники кластера etcd хранятся в самом etcd и обслуживаются алгоритмом консенсуса Raft. После полной потери кворума можно изменить место и способ формирования нового кластера, например создать его из совершенно нового набора участников.
При восстановлении из снимка новый состав можно сразу записать в хранилище:
Так новый кластер будет подключаться только к другим восстановленным участникам с указанным токеном, а не к старым участникам, которые ещё могут работать и пытаться подключиться.
В качестве альтернативы при запуске etcd можно указать --force-new-cluster,
чтобы перезаписать состав кластера, сохранив данные приложения. Это настоятельно
не рекомендуется: если другие участники прежнего кластера ещё работают, произойдёт
аварийное завершение. Обязательно регулярно сохраняйте снимки.
Сквозной пример End-2-End
Получите снимок работающего кластера командой:
В продолжение примера следующие команды создают новые каталоги данных etcd
(m1.etcd, m2.etcd, m3.etcd) для кластера из трёх участников:
Затем запустите etcd с новыми каталогами данных:
Теперь восстановленный кластер etcd должен быть доступен и обслуживать пространство ключей из снимка.
Начиная с etcd v3.6, снимок данных создаётся только с помощью etcdctl, а
восстановление выполняется через etcdutl. Если --data-dir не указан, значение
--data-dir по умолчанию — <name>.etcd, где <name> берётся из --name. Например,
если --data-dir отсутствует, а участников зовут m1, m2 и m3, каталогами
--data-dir будут m1.etcd, m2.etcd и m3.etcd.
9 - Шлюз etcd
Что такое шлюз etcd
Шлюз etcd — простой TCP-прокси, пересылающий сетевые данные кластеру etcd. Шлюз не хранит состояния и работает прозрачно: он не анализирует клиентские запросы и не вмешивается в ответы кластера. Он не завершает TLS-соединения, не выполняет TLS-рукопожатия от имени клиентов и не проверяет защищённость соединения.
Шлюз поддерживает несколько конечных точек серверов etcd и использует простую циклическую политику. Он направляет трафик только доступным конечным точкам и скрывает от клиентов отказы. В будущем могут появиться другие политики повторных попыток, например взвешенная циклическая.
Когда следует использовать шлюз etcd
Каждому приложению для доступа к etcd сначала требуется адрес клиентской конечной точки кластера. Если несколько приложений на одном сервере обращаются к одному кластеру etcd, каждое из них всё равно должно знать объявленные клиентские конечные точки. При изменении конечных точек кластера списки, возможно, придётся обновить во всех приложениях. Такая массовая перенастройка трудоёмка и подвержена ошибкам.
Шлюз etcd решает эту проблему, предоставляя стабильную локальную конечную точку. В типичной конфигурации на каждой машине работает шлюз, слушающий локальный адрес, а все приложения etcd подключаются к нему. Поэтому при изменении кластера достаточно обновить конечные точки шлюза, а не каждого приложения.
Итак, для автоматического распространения изменений конечных точек кластера шлюз etcd запускается на каждой машине, где несколько приложений обращаются к одному кластеру etcd.
Когда не следует использовать шлюз etcd
- Повышение производительности
Шлюз не предназначен для повышения производительности кластера etcd. Он не кэширует данные, не объединяет наблюдения и не пакетирует запросы. Команда etcd разрабатывает кэширующий прокси для улучшения масштабируемости кластера.
- Работа в системе управления кластером
Развитые системы управления кластерами, такие как Kubernetes, изначально поддерживают обнаружение служб. Приложения могут обращаться к кластеру etcd по DNS-имени или виртуальному IP-адресу, управляемому системой. Например, kube-proxy выполняет ту же роль, что и шлюз etcd.
Запуск шлюза etcd
Рассмотрим кластер etcd со следующими статическими конечными точками:
| Имя | Адрес | Имя узла | Порт |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Запустите шлюз etcd с этими статическими конечными точками:
При обнаружении служб через DNS рассмотрим следующие записи DNS SRV:
Запустите шлюз etcd, чтобы получить конечные точки из записей DNS SRV:
Флаги конфигурации
Кластер etcd
–endpoints
- Разделённый запятыми список целевых серверов etcd, которым пересылаются клиентские соединения.
- По умолчанию:
127.0.0.1:2379 - Порт обязателен.
- Недопустимый пример:
https://127.0.0.1:2379(шлюз не завершает TLS). Шлюз не проверяет схему HTTP и не анализирует запросы, а только пересылает их заданным конечным точкам.
–discovery-srv
- Домен DNS для начальной загрузки конечных точек кластера через записи SRV.
- По умолчанию: не задано
Сеть
–listen-addr
- Интерфейс и порт для привязки и приёма клиентских запросов.
- По умолчанию:
127.0.0.1:23790
–retry-delay
- Задержка перед повторной попыткой подключения к недоступным конечным точкам.
- По умолчанию: 1m0s
- Недопустимый пример: “123” (ожидается единица времени)
Безопасность
–insecure-discovery
- Принимать небезопасные или уязвимые для атак посредника записи SRV.
- По умолчанию:
false
–trusted-ca-file
- Путь к клиентскому файлу центра сертификации TLS, с помощью которого кластер etcd проверяет конечные точки, полученные при обнаружении SRV. Он используется ТОЛЬКО для аутентификации обнаруженных конечных точек, а не для создания соединений передачи данных. Шлюз никогда не завершает TLS-соединения и не создаёт их от имени клиентов.
- По умолчанию: не задано
10 - Прокси gRPC
Прокси gRPC — это не сохраняющий состояние обратный прокси etcd, работающий на уровне gRPC (L7). Он предназначен для снижения общей вычислительной нагрузки на основной кластер etcd. Для горизонтального масштабирования прокси объединяет запросы API наблюдения и аренды. Для защиты кластера от злоупотребляющих клиентов он кэширует запросы диапазонов ключей.
Прокси gRPC поддерживает несколько конечных точек сервера etcd. При запуске прокси случайным образом выбирает одну конечную точку сервера etcd. Она обслуживает все запросы, пока прокси не обнаружит её отказ. Обнаружив отказ конечной точки, прокси gRPC переключается на другую доступную точку, скрывая сбой от клиентов. В будущем могут поддерживаться и другие политики повторных попыток, например взвешенный циклический выбор.
Масштабируемый API наблюдения
Прокси gRPC объединяет несколько клиентских наблюдателей (c-watchers) за одним ключом или диапазоном в единственного наблюдателя (s-watcher), подключённого к серверу etcd. Все события от s-watcher прокси рассылает своим c-watchers.
Если N клиентов наблюдают за одним ключом, один прокси gRPC может снизить нагрузку наблюдения на сервер etcd с N до 1. Для дальнейшего распределения серверной нагрузки можно развернуть несколько прокси gRPC.
В следующем примере три клиента наблюдают за ключом A. Прокси gRPC объединяет трёх наблюдателей, создавая одного наблюдателя, подключённого к серверу etcd.
Ограничения
Чтобы эффективно объединить несколько клиентских наблюдателей в одного, прокси gRPC по возможности присоединяет новые c-watchers к существующему s-watcher. Такой объединённый s-watcher может быть не синхронизирован с сервером etcd из-за сетевых задержек или буферизованных недоставленных событий. Если ревизия наблюдения не указана, прокси gRPC не гарантирует, что c-watcher начнёт наблюдение с самой последней ревизии хранилища. Например, наблюдатель клиента, подключённого к серверу etcd с ревизией 1000, начнёт с ревизии 1000. Наблюдатель клиента, подключённого через прокси gRPC, может начать с ревизии 990.
Аналогичные ограничения относятся к отмене. При отмене наблюдателя ревизия сервера etcd может превышать ревизию ответа на отмену.
В большинстве сценариев эти два ограничения не должны создавать проблем. В будущем могут появиться дополнительные параметры, принудительно направляющие наблюдателя в обход прокси gRPC для получения более точных ревизий в ответах.
Масштабируемый API аренды
Чтобы поддерживать аренды активными, клиент должен установить как минимум один поток gRPC к серверу etcd для отправки периодических сигналов активности. Если рабочая нагрузка etcd включает интенсивную работу с арендами, распределённую между множеством клиентов, эти потоки могут приводить к чрезмерной загрузке CPU. Чтобы сократить общее количество потоков в основном кластере, прокси поддерживает объединение потоков аренды.
Если N клиентов обновляют аренды, один прокси gRPC снижает потоковую нагрузку на сервер etcd с N до 1. В развёртывании можно использовать дополнительные прокси gRPC, чтобы распределить потоки между несколькими прокси.
В следующем примере три клиента обновляют три независимые аренды (L1, L2 и L3). Прокси gRPC объединяет три клиентских потока аренды (c-streams) в один поток поддержания аренды активной (s-stream), подключённый к серверу etcd. Прокси пересылает сигналы активности аренды с клиентской стороны из c-streams в s-stream, а затем возвращает ответы соответствующим c-streams.
Защита от злоупотребляющих клиентов
Прокси gRPC кэширует ответы на запросы, когда это не нарушает требований согласованности. Так сервер etcd можно защитить от злоупотребляющих клиентов с плотными циклами for.
Запуск прокси gRPC etcd
Рассмотрим кластер etcd со следующими статическими конечными точками:
| Имя | Адрес | Имя узла |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Запустите прокси gRPC etcd для использования этих статических конечных точек следующей командой:
Прокси gRPC etcd запускается и слушает порт 2379. Он пересылает клиентские запросы одной из трёх указанных выше конечных точек.
Отправка запросов через прокси:
Синхронизация клиентских конечных точек и разрешение имён
Прокси поддерживает регистрацию своих конечных точек для обнаружения путём записи в заданную пользователем конечную точку. Это решает две задачи. Во-первых, клиенты могут синхронизировать свои конечные точки с набором конечных точек прокси для высокой доступности. Во-вторых, прокси становится поставщиком конечных точек для разрешения имён gRPC в etcd.
Зарегистрируйте прокси, указав определённый пользователем префикс:
В списке участников прокси перечислит всех своих участников:
Это позволяет клиентам автоматически обнаруживать конечные точки прокси через Sync:
Обратите внимание: если прокси настроен без префикса разрешения,
API списка участников прокси grpc-proxy возвращает его собственный advertise-client-url:
Пространства имён
Предположим, приложению нужен полный контроль над всем пространством ключей, однако кластер etcd используется совместно с другими приложениями. Чтобы все приложения могли работать, не мешая друг другу, прокси может разделить пространство ключей etcd так, чтобы клиентам казалось, что они имеют доступ ко всему пространству. Если прокси передан флаг --namespace, все поступающие в него клиентские запросы преобразуются: к ключам добавляется заданный пользователем префикс. Обращения к кластеру etcd выполняются под этим префиксом, а прокси удаляет префикс из ответов; для клиента всё выглядит так, будто префикса нет.
Чтобы назначить прокси пространство имён, запустите его с --namespace:
Теперь обращения к прокси прозрачно снабжаются префиксом в кластере etcd:
Терминирование TLS
Терминируйте TLS защищённого кластера etcd с помощью прокси gRPC, обслуживающего незашифрованную локальную конечную точку.
Для проверки запустите одноузловой кластер etcd с клиентским https:
Убедитесь, что клиентский порт обслуживает https:
Затем запустите прокси gRPC на localhost:12379, подключив его к конечной точке etcd https://localhost:2379 с помощью клиентских сертификатов:
Наконец, проверьте терминирование TLS, записав ключ в прокси по http:
Метрики и состояние
Прокси gRPC предоставляет конечные точки /health и Prometheus /metrics для участников etcd, заданных через --endpoints. В качестве альтернативы флагом --metrics-addr можно определить дополнительный URL, отвечающий на запросы к конечным точкам /metrics и /health.
Известная проблема
Основной интерфейс прокси обслуживает как HTTP2, так и HTTP/1.1. Если прокси настроен с TLS, как в примере выше, при обращении к слушающему интерфейсу клиентом наподобие cURL для получения /metrics или /health потребуется явно указать в запросе протокол HTTP/1.1. При использовании флага --metrics-addr вторичный интерфейс этого не требует.
11 - Рекомендации по оборудованию
Для разработки и тестирования etcd обычно хорошо работает с ограниченными ресурсами; его часто запускают на ноутбуке или дешёвой облачной машине. Однако для правильной эксплуатации промышленных кластеров полезны рекомендации по оборудованию. Это не строгие правила, а хорошая отправная точка для надёжного развёртывания. Перед вводом в эксплуатацию всегда проверяйте систему с имитацией рабочей нагрузки.
CPU
Немногим развёртываниям etcd требуется большая вычислительная мощность. Типичному кластеру для стабильной работы достаточно от двух до четырёх ядер. Сильно нагруженные развёртывания, обслуживающие тысячи клиентов или десятки тысяч запросов в секунду, обычно ограничены CPU, поскольку etcd может отдавать запросы из памяти. Им, как правило, требуется от восьми до шестнадцати выделенных ядер.
Память
etcd потребляет относительно мало памяти, но производительность всё же зависит от её достаточного объёма. Сервер активно кэширует данные ключей и значений, а большую часть оставшейся памяти использует для отслеживания наблюдателей. Обычно достаточно 8GB. Для тяжёлых развёртываний с тысячами наблюдателей и миллионами ключей выделяйте от 16GB до 64GB в зависимости от нагрузки.
Диски
Быстрые диски — наиболее важный фактор производительности и стабильности etcd.
Медленный диск увеличивает задержку запросов и может нарушить стабильность кластера. Поскольку протокол консенсуса etcd требует постоянной записи метаданных в журнал, большинство участников должно записывать каждый запрос на диск. Кроме того, etcd инкрементно сохраняет контрольные точки состояния, чтобы усекать журнал. Если записи занимают слишком много времени, heartbeat может завершиться по тайм-ауту и вызвать выборы, подрывая стабильность. Проверить достаточную скорость диска можно инструментом вроде fio ; пример приведён здесь .
etcd очень чувствителен к задержке записи. Обычно требуется 50 последовательных IOPS, например от диска 7200 RPM. Для сильно нагруженных кластеров рекомендуется 500 последовательных IOPS, что обеспечивает типичный локальный SSD или высокопроизводительное виртуальное блочное устройство. Большинство облачных провайдеров публикуют параллельные, а не последовательные IOPS; опубликованное значение может быть в 10x раз выше последовательного. Фактические последовательные IOPS измеряйте с помощью diskbench или fio .
etcd требует умеренной пропускной способности диска, но более быстрый диск сокращает восстановление, когда отказавший участник догоняет кластер. Обычно 10MB/s позволяет восстановить 100MB данных за 15 секунд. Для крупных кластеров рекомендуется 100MB/s или больше, чтобы восстановить 1GB за 15 секунд.
По возможности используйте SSD для хранилища etcd. SSD обычно обеспечивает меньшую и более стабильную задержку записи, повышая стабильность и надёжность. Если используются вращающиеся диски, выбирайте самые быстрые, например 15,000 RPM. RAID 0 также эффективно увеличивает скорость как вращающихся дисков, так и SSD. При наличии как минимум трёх участников зеркалирование и варианты RAID с контролем чётности не нужны: согласованная репликация etcd уже обеспечивает высокую доступность.
Сеть
Кластеру etcd из нескольких участников нужна быстрая и надёжная сеть. Чтобы одновременно сохранять согласованность и устойчивость к разделению, в ненадёжной сети с разрывами разделов доступность будет низкой. Малая задержка ускоряет обмен между участниками, а высокая пропускная способность сокращает восстановление отказавшего участника. Для обычного развёртывания достаточно 1GbE; в крупном кластере сеть 10GbE уменьшает среднее время восстановления.
По возможности размещайте участников etcd в одном центре обработки данных, чтобы избежать дополнительной задержки и снизить вероятность разделения сети. Если требуется домен отказа в другом центре, выбирайте ближайший. Развёртывание между центрами также описано в документации по настройке .
Примеры аппаратных конфигураций
Ниже приведено несколько примеров для AWS и GCE. Несмотря на уже сказанное, необходимо ещё раз подчеркнуть: перед промышленной эксплуатацией администраторы должны проверить развёртывание etcd с имитацией нагрузки.
Предполагается, что машины полностью выделены для etcd. Другие приложения могут вызвать конкуренцию за ресурсы и нестабильность кластера.
Малый кластер
Малый кластер обслуживает менее 100 клиентов и 200 запросов в секунду и хранит не более 100MB данных.
Пример нагрузки: кластер Kubernetes из 50 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
Средний кластер
Средний кластер обслуживает менее 500 клиентов и 1,000 запросов в секунду и хранит не более 500MB данных.
Пример нагрузки: кластер Kubernetes из 250 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
Большой кластер
Большой кластер обслуживает менее 1,500 клиентов и 10,000 запросов в секунду и хранит не более 1GB данных.
Пример нагрузки: кластер Kubernetes из 1,000 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
Кластер xLarge
Кластер xLarge обслуживает более 1,500 клиентов и более 10,000 запросов в секунду и хранит более 1GB данных.
Пример нагрузки: кластер Kubernetes из 3,000 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
12 - Обслуживание
Обзор
Для сохранения надёжности кластер etcd нуждается в периодическом обслуживании. В зависимости от требований использующего etcd приложения такое обслуживание обычно можно автоматизировать и выполнять без простоя или существенного снижения производительности.
Все операции обслуживания etcd управляют ресурсами хранилища, занятыми пространством ключей etcd. Недостаточный контроль его размера предотвращается квотами дискового пространства: если у участника etcd заканчивается место, квота активирует аварийные сигналы для всего кластера и переводит систему в режим обслуживания с ограниченными операциями. Чтобы не исчерпать место для записи в пространство ключей, его историю необходимо компактизировать. Само дисковое пространство можно освободить дефрагментацией участников etcd. Наконец, регулярное резервное копирование состояния участника с помощью снимков позволяет восстановиться после непреднамеренной логической потери или повреждения данных, вызванных ошибкой эксплуатации.
Хранение журнала Raft
Параметр etcd --snapshot-count задаёт количество применённых записей Raft, которые хранятся в памяти до компактизации. Когда достигается значение --snapshot-count, сервер сначала сохраняет данные снимка на диск, а затем усекает старые записи. Если медленный последователь запрашивает журналы до уже компактизированного индекса, лидер отправляет снимок, вынуждая последователь перезаписать своё состояние.
Большее значение --snapshot-count удерживает больше записей Raft в памяти до создания снимка, тем самым вызывая повторяющееся повышенное потребление памяти
. Поскольку лидер дольше хранит последние записи Raft, у медленного последователя больше времени, чтобы догнать его до создания снимка лидером. Выбор --snapshot-count — компромисс между повышенным потреблением памяти и лучшей доступностью медленных последователей.
Начиная с v3.2 значение --snapshot-count по умолчанию изменено с 10,000 на 100,000
.
С точки зрения производительности значение --snapshot-count больше 100,000 может снизить пропускную способность записи. Большое количество объектов в памяти способно замедлить фазу маркировки Go GC runtime.scanobject
, а редкое освобождение памяти замедляет её выделение. Производительность зависит от рабочей нагрузки и системного окружения. Однако в целом слишком частая компактизация ухудшает доступность кластера и пропускную способность записи. Слишком редкая компактизация также вредна, поскольку создаёт чрезмерную нагрузку на сборщик мусора Go. Дополнительные результаты исследований приведены в материале Understanding Performance Aspects of etcd and Raft
.
Компактизация истории: база данных Key-Value API v3
Поскольку etcd хранит точную историю пространства ключей, её следует периодически компактизировать во избежание снижения производительности и окончательного исчерпания дискового пространства. Компактизация истории пространства ключей удаляет всю информацию о ключах, замещённых до заданной ревизии пространства ключей. Занимавшееся ими место становится доступным для последующих записей.
Пространство ключей можно компактизировать автоматически с помощью политики хранения истории etcd с временным окном либо вручную с помощью etcdctl. Метод etcdctl обеспечивает точное управление процессом компактизации, тогда как автоматическая компактизация подходит приложениям, которым история ключей нужна лишь в течение определённого времени.
Компактизация, инициированная etcdctl, выполняется следующим образом:
Ревизии, предшествующие ревизии компактизации, становятся недоступны:
Автоматическая компактизация
Для автоматической компактизации пространства ключей в etcd можно задать параметры --auto-compaction-mode и --auto-compaction-retention. Существует два режима компактизации: periodic (по умолчанию) и revision.
Периодическая компактизация
Периодическая компактизация сохраняет ограниченное временным окном количество истории пространства ключей:
Значение срока хранения определяет, какой объём истории сохранять. Запись не будет компактизирована примерно до истечения указанного времени с момента создания. Это позволяет медленным наблюдателям успеть наверстать отставание в пределах окна хранения.
Если срок хранения превышает 1 час, etcd выполняет компактизацию каждый час, сохраняя полное окно хранения. Если срок хранения не превышает 1 часа, etcd выполняет компактизацию с интервалом, равным сроку хранения.
Например, с --auto-compaction-retention=10h etcd ждёт 10 часов до первой компактизации, а затем выполняет её каждый час:
Рекомендуемые значения зависят от сценария использования:
- Частые обновления одних и тех же ключей: короткий период, например
1hили30m - Редкие обновления: более длительный период, например
24h,48hили72h - Значение общего назначения по умолчанию:
10h
Компактизация по ревизиям
Компактизация по ревизиям сохраняет фиксированное количество ревизий:
etcd выполняет проверку каждые 5 минут и компактизирует на ревизии "latest revision" - 1000. Например, если последняя ревизия равна 30000, компактизация выполняется на ревизии 29000.
Дефрагментация
После компактизации пространства ключей в базе данных бэкенда может возникнуть внутренняя фрагментация. Внутренне фрагментированное пространство доступно бэкенду, но по-прежнему занимает место в хранилище. Компактизация старых ревизий внутренне фрагментирует etcd, оставляя пустоты в базе данных бэкенда. Это место доступно для использования etcd, но недоступно файловой системе узла. Иными словами, удаление данных приложения не освобождает место на диске.
Дефрагментация возвращает это дисковое пространство файловой системе. Она запускается отдельно для каждого участника, что позволяет избежать всплесков задержки во всём кластере.
Для дефрагментации участника etcd используйте команду etcdctl defrag:
Учтите, что дефрагментация работающего участника блокирует чтение и запись данных в системе на время перестроения его состояния
Учтите, что запрос дефрагментации не реплицируется по кластеру, то есть применяется только к локальному узлу. Укажите всех участников во флаге --endpoints или используйте флаг --cluster, чтобы автоматически найти всех участников кластера.
Выполните дефрагментацию всех конечных точек кластера, связанных с конечной точкой по умолчанию:
Чтобы напрямую дефрагментировать каталог данных etcd при остановленном etcd, используйте команду:
Квота дискового пространства
Квота дискового пространства в etcd обеспечивает надёжную работу кластера. Без неё при чрезмерном росте пространства ключей производительность etcd может ухудшиться либо место в хранилище может полностью закончиться, что приведёт к непредсказуемому поведению кластера. Если база данных бэкенда пространства ключей любого участника превышает квоту, etcd активирует аварийный сигнал для всего кластера и переводит его в режим обслуживания, принимающий только операции чтения и удаления ключей. Возобновить нормальную работу кластер сможет лишь после освобождения достаточного места в пространстве ключей, дефрагментации базы данных бэкенда и сброса аварийного сигнала квоты.
По умолчанию etcd задаёт консервативную квоту дискового пространства, подходящую большинству приложений, однако в командной строке её можно указать в байтах:
Квоту дискового пространства можно активировать с помощью цикла:
Удаление избыточных данных пространства ключей и дефрагментация базы данных бэкенда вернут кластер в пределы квоты:
Метрика etcd_mvcc_db_total_size_in_use_in_bytes показывает фактическое использование базы данных после компактизации истории, а etcd_debugging_mvcc_db_total_size_in_bytes — размер базы данных с учётом свободного места, ожидающего дефрагментации. Вторая метрика увеличивается только тогда, когда первая приближается к ней; следовательно, когда обе метрики близки к квоте, необходимо компактизировать историю, чтобы избежать активации квоты дискового пространства.
Начиная с v3.4, etcd_debugging_mvcc_db_total_size_in_bytes переименована в etcd_mvcc_db_total_size_in_bytes.
Для запроса Put/Txn/LeaseGrant можно получить ошибку ErrGRPCNoSpace, хотя запись в бэкенде окажется успешной. Это возможно потому, что etcd проверяет квоту дискового пространства на уровне API и на внутреннем уровне Apply, причём уровень Apply только активирует аварийный сигнал NOSPACE, не блокируя выполнение транзакции.
Резервное копирование снимка
Регулярное создание снимков кластера etcd обеспечивает долговечную резервную копию пространства ключей etcd. Благодаря периодическим снимкам базы данных бэкенда участника кластер etcd можно восстановить до момента времени с заведомо исправным состоянием.
Снимок создаётся с помощью etcdctl:
13 - Мониторинг etcd
Каждый сервер etcd предоставляет локальные сведения мониторинга через конечные точки HTTP на клиентском порту. Эти данные полезны для проверки состояния системы и отладки кластера.
Конечная точка отладки
Если задан --log-level=debug, сервер etcd экспортирует отладочные сведения по
пути /debug на клиентском порту. Используйте --log-level=debug осторожно:
он снижает производительность и включает подробное ведение журнала.
/debug/pprof — стандартная конечная точка профилирования среды выполнения Go.
Она позволяет профилировать использование CPU, кучи, мьютексов и goroutine.
В примере go tool pprof получает 10 функций, на которые etcd тратит больше всего времени:
Конечная точка /debug/requests показывает трассировки gRPC и статистику
производительности в веб-браузере. Например, так выглядит запрос Range для ключа abc:
Конечная точка метрик
Каждый сервер etcd экспортирует метрики по пути /metrics на клиентском порту
и, необязательно, по адресам из --listen-metrics-urls.
Метрики можно получить с помощью curl:
Проверка состояния
Начиная с v3.3.0, все адреса из --listen-metrics-urls отвечают не только через
/metrics, но и через /health. Это полезно, когда стандартная конечная точка
защищена взаимной клиентской аутентификацией TLS, но балансировщику нагрузки или
службе мониторинга всё ещё нужен доступ к проверке состояния.
Начиная с v3.4 добавлены две конечные точки: /livez и /readyz.
/livezпоказывает, работает ли процесс или его необходимо перезапустить;/readyzпоказывает, готов ли процесс обслуживать трафик.
Архитектура конечных точек описана в KEP .
Каждая конечная точка включает несколько отдельных проверок. Параметр verbose
выводит подробности проверок и их состояние, например:
Ответ будет выглядеть примерно так:
API HTTP также позволяет исключать отдельные проверки, например:
Prometheus
Самый простой способ получать и сохранять метрики etcd — запустить службу мониторинга Prometheus .
Сначала установите Prometheus:
Настройте сборщик Prometheus на конечные точки кластера etcd:
Запустите обработчик Prometheus:
Теперь Prometheus будет собирать метрики etcd каждые 10 секунд.
Оповещения
Для кластеров etcd v3 доступен набор стандартных оповещений Prometheus.
Метки job может потребоваться адаптировать к конкретной задаче. Правила рассчитаны на один кластер, поэтому рекомендуется выбирать уникальные для кластера метки.
Grafana
Grafana имеет встроенную поддержку Prometheus; добавьте источник данных Prometheus:
Затем импортируйте стандартный шаблон панели etcd
и настройте его.
Например, если источник данных Prometheus называется my-etcd, поля datasource
в JSON также должны иметь значение my-etcd.
Пример панели:
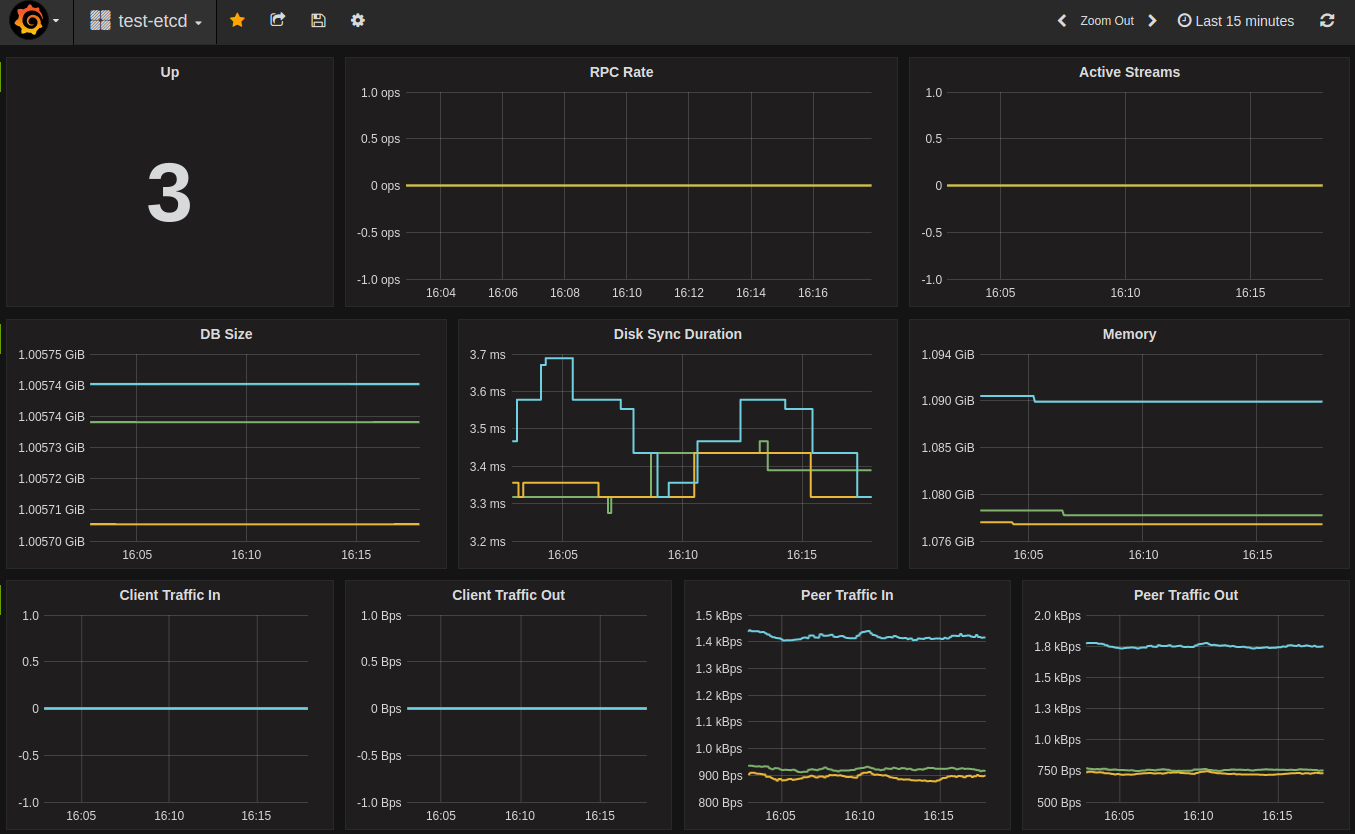
Распределённая трассировка
В v3.5 etcd добавлена распределённая трассировка с помощью OpenTelemetry .
Эта возможность остаётся экспериментальной и может измениться в любое время.
Чтобы включить экспериментальную возможность, передайте серверу etcd
--experimental-enable-distributed-tracing=true и флаг
--experimental-distributed-tracing-sampling-rate=<number>, задающий число
выборок на миллион спанов. Частота выборки по умолчанию — 0.
Настройте распределённую трассировку, запустив сервер etcd со следующими необязательными флагами:
--experimental-distributed-tracing-address- (необязательно) - “localhost:4317” - адрес сборщика трассировок.--experimental-distributed-tracing-service-name- (необязательно) - “etcd” - имя службы распределённой трассировки, одинаковое для всех экземпляров etcd.--experimental-distributed-tracing-instance-id- (необязательно) - идентификатор экземпляра; хотя параметр необязателен, его настоятельно рекомендуется задать уникальным для каждого экземпляра etcd.
Перед включением распределённой трассировки убедитесь, что конечная точка
OpenTelemetry доступна. Если её адрес отличается от стандартного, переопределите
его флагом --experimental-distributed-tracing-address. Варианты запуска
OpenTelemetry описаны в документации сборщика
.
Как и любой сигнал наблюдаемости, эта возможность расходует ресурсы. По первым измерениям дополнительные затраты CPU составляют от 2% - 4%.
14 - Производительность
Понимание производительности
etcd обеспечивает стабильную и устойчиво высокую производительность. Её определяют два фактора: задержка и пропускная способность. Задержка — время выполнения одной операции. Пропускная способность — общее число операций, завершённых за определённый период. Обычно средняя задержка растёт вместе с общей пропускной способностью, когда etcd принимает параллельные клиентские запросы. В типичной облачной среде, например на стандартной машине n-4 в Google Compute Engine (GCE) или сопоставимой машине AWS, кластер etcd из трёх участников при небольшой нагрузке завершает запрос менее чем за одну миллисекунду, а при высокой выполняет более 30,000 запросов в секунду.
Для репликации запросов между участниками и достижения соглашения etcd использует алгоритм консенсуса Raft. Производительность консенсуса, особенно задержку фиксации, ограничивают два физических фактора: задержка сетевого и дискового ввода-вывода. Минимальное время выполнения запроса etcd равно времени кругового обхода сети (RTT) между участниками плюс время, необходимое fdatasync для фиксации данных в постоянном хранилище. RTT внутри центра обработки данных может достигать нескольких сотен микросекунд. Типичный RTT в пределах США составляет около 50ms, а между континентами может доходить до 400ms. Типичная задержка fdatasync для вращающегося диска — около 10ms, а для SSD часто меньше 1ms. Чтобы увеличить пропускную способность, etcd объединяет несколько запросов в пакет и передаёт его Raft. Такая политика позволяет сохранять высокую пропускную способность под большой нагрузкой.
На общую производительность etcd влияют и другие подсистемы. Каждый сериализованный запрос etcd проходит через механизм хранения MVCC на основе boltdb, что обычно занимает десятки микросекунд. Периодически etcd создаёт инкрементный снимок недавно применённых запросов и объединяет его с предыдущим снимком на диске. Это может вызвать скачок задержки. На SSD проблема обычно незаметна, но на HDD наблюдаемая задержка может удвоиться. Выполняющаяся компактизация также влияет на производительность etcd. Обычно её влияние незначительно, поскольку компактизация распределена во времени и не конкурирует с обычными запросами за ресурсы. Система RPC gRPC предоставляет etcd чётко определённый расширяемый API, но добавляет задержку, особенно при локальном чтении.
Тесты производительности
Производительность etcd можно измерить инструментом командной строки benchmark , входящим в состав etcd.
В качестве базового примера рассмотрим кластер etcd из трёх участников со следующей аппаратной конфигурацией:
- Google Cloud Compute Engine
- 3 машины: 8 vCPU + 16GB памяти + 50GB SSD
- 1 клиентская машина: 16 vCPU + 30GB памяти + 50GB SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
С такой конфигурацией etcd показывает примерно следующую производительность записи:
| Число ключей | Размер ключа в байтах | Размер значения в байтах | Число соединений | Число клиентов | Целевой сервер etcd | Средний QPS записи | Средняя задержка запроса | Средний RSS сервера |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | только лидер | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | только лидер | 44,341 | 22ms | 124MB |
| 100,000 | 8 | 256 | 100 | 1000 | все участники | 50,104 | 20ms | 126MB |
Примеры команд:
Линеаризуемые запросы чтения проходят через кворум участников кластера, чтобы на основе консенсуса получить самые свежие данные. Сериализуемые запросы дешевле линеаризуемых, поскольку обслуживаются одним участником etcd, а не кворумом, но могут вернуть устаревшие данные. Производительность чтения etcd:
| Число запросов | Размер ключа в байтах | Размер значения в байтах | Число соединений | Число клиентов | Согласованность | Средний QPS чтения | Средняя задержка запроса |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | Линеаризуемая | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | Сериализуемая | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | Линеаризуемая | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | Сериализуемая | 185,758 | 2.2ms |
Примеры команд:
При первой настройке кластера etcd в новом окружении рекомендуется выполнить тест производительности и убедиться, что кластер достигает требуемых показателей: задержка и пропускная способность чувствительны даже к небольшим различиям среды.
15 - Устройство реконфигурации во время выполнения
Реконфигурация во время выполнения — одна из самых сложных и подверженных ошибкам возможностей распределённой системы, особенно основанной на консенсусе системы вроде etcd.
Ниже описано устройство команд реконфигурации etcd и способы решения связанных проблем.
Двухфазное изменение конфигурации сохраняет безопасность кластера
В etcd каждая реконфигурация во время выполнения в целях безопасности проходит две фазы . Например, чтобы добавить участника, сначала сообщите кластеру новую конфигурацию, а затем запустите участника.
Фаза 1 — сообщение кластеру новой конфигурации
Чтобы добавить участника в кластер etcd, вызовите API с запросом на его добавление. Это единственный способ добавить нового участника в существующий кластер. Вызов API возвращается после того, как кластер согласует изменение конфигурации.
Фаза 2 — запуск нового участника
Чтобы присоединить нового участника etcd к существующему кластеру, укажите правильный initial-cluster и задайте initial-cluster-state значение existing. При запуске участник сначала связывается с существующим кластером и проверяет, соответствует ли текущая конфигурация ожидаемой, заданной в initial-cluster. После успешного запуска нового участника кластер достигает ожидаемой конфигурации.
Разделение процесса на две отдельные фазы заставляет явно задавать изменения состава кластера. Это даёт больше гибкости и упрощает анализ. Например, попытка добавить в кластер etcd нового участника с тем же ID, что у существующего, немедленно завершится ошибкой на первой фазе и не повлияет на работающий кластер. Аналогичная защита предотвращает случайное добавление участников. Если новый участник etcd попытается присоединиться до принятия кластером изменения конфигурации, кластер его не примет.
Без явной процедуры управления составом etcd был бы уязвим для неожиданных изменений. Например, если etcd работает под управлением системы инициализации вроде systemd, после удаления через API состава systemd перезапустит etcd, и тот при запуске попытается снова войти в кластер. Если systemd настроен перезапускать etcd после сбоя, этот цикл будет повторяться при каждом удалении участника через API, что является неожиданным поведением.
Реконфигурация во время выполнения предполагается редкой операцией. Явная процедура под управлением пользователя обеспечивает безопасность конфигурации и позволяет кластеру стабильно работать под непосредственным контролем.
Безвозвратная потеря кворума требует нового кластера
Если кластер безвозвратно потерял большинство участников, для восстановления предыдущего состояния потребуется запустить новый кластер из старого каталога данных.
Технически можно принудительно удалить отказавших участников из существующего кластера и восстановить его. Однако etcd не поддерживает этот способ, поскольку он обходит обычную фазу фиксации консенсусом и небезопасен. Если удаляемый участник на самом деле не отказал или принудительное удаление выполняется через разных участников одного кластера, получится расходящийся кластер с одинаковым clusterID. Это крайне опасно и впоследствии трудно диагностируется и исправляется.
При правильном развёртывании вероятность безвозвратной потери большинства очень мала. Но последствия достаточно серьёзны и требуют специальной подготовки. Перед вводом etcd в эксплуатацию настоятельно рекомендуется прочитать документацию по аварийному восстановлению и подготовиться к безвозвратной потере большинства.
Не используйте общедоступную службу обнаружения для реконфигурации
Общедоступную службу обнаружения следует применять только для начальной инициализации кластера. Для присоединения участника к существующему кластеру используйте API реконфигурации во время выполнения.
Служба обнаружения предназначена для начальной инициализации кластера etcd в облачной среде, когда IP-адреса всех участников заранее неизвестны. После успешной инициализации они становятся известны, и служба обнаружения технически больше не нужна.
Использование общедоступной службы обнаружения для реконфигурации может показаться удобным, поскольку она уже содержит всю конфигурацию кластера. Однако зависимость от неё создаёт проблемы:
Внешняя зависимость сохраняется на протяжении всего жизненного цикла кластера, а не только во время инициализации. Проблемы сети между кластером и общедоступной службой будут влиять на кластер.
В течение всего жизненного цикла общедоступная служба должна отражать правильную текущую конфигурацию кластера. Ей потребуются механизмы безопасности против вредоносных действий, что сложно реализовать.
Общедоступной службе придётся хранить десятки тысяч конфигураций кластеров. Бэкенд нашей службы не готов к такой нагрузке.
Для поддержки реконфигурации лучше всего создать частную службу обнаружения.
16 - Динамическое изменение конфигурации
etcd поддерживает поэтапное изменение конфигурации во время работы, позволяя обновлять состав кластера без остановки.
Запросы изменения конфигурации обрабатываются только при работающем большинстве участников. В производственной среде настоятельно рекомендуется кластер размером более двух. Удалять участника из кластера из двух участников небезопасно: его большинство также равно двум, поэтому ошибка во время удаления может остановить кластер и потребовать перезапуска после потери большинства .
Архитектура описана в документе о динамическом изменении конфигурации .
Сценарии реконфигурации
В этом разделе рассмотрены распространённые причины изменения конфигурации. Обычно это сочетания добавления и удаления участников, описанные в разделе Операции изменения конфигурации кластера .
Поочерёдная замена или обновление машин
Если несколько участников кластера необходимо переместить из-за запланированного обслуживания (обновления аппаратного обеспечения, простоя сети и т. д.), рекомендуется изменять их по одному.
Лидера можно безопасно удалить, но во время выборов возникнет краткий простой. Если кластер содержит более 50MB данных v2, рекомендуется перенести каталог данных участника .
Изменение размера кластера
Увеличение размера кластера может повысить устойчивость к отказам участников и обеспечить лучшую производительность чтения. Поскольку клиенты могут читать из любого участника, увеличение числа участников увеличивает общую серийную пропускную способность чтения.
Уменьшение размера может ускорить запись ценой отказоустойчивости. До фиксации запись реплицируется большинству участников; меньшее большинство подтверждает её быстрее.
Заменить сбойную машину
Машину, отказавшую из-за оборудования, повреждения каталога данных или другой критической причины, следует заменить как можно скорее. Неудалённый отказавший участник ухудшает кворум и снижает устойчивость к следующему отказу.
Для замены удалите участника , затем добавьте нового . Если кластер содержит более 50MB и каталог отказавшего участника доступен, рекомендуется перенести его .
Перезапуск кластера после потери большинства
При потере большинства или изменении IP-адресов всех узлов требуется ручное восстановление: создать новый кластер из старых данных , принудительно назначить одного участника лидером, затем по одному добавить новых участников .
Восстановить кластер после миноритарной ошибки
Потеря отдельного участника эквивалентна замене отказавшей машины; см. Замена отказавшей машины .
Операции перенастройки кластера
Для этих сценариев используются следующие операции.
Перед внесением любых изменений должно быть доступно простое большинство (кворум) участников etcd. Это в сущности то же самое требование для любого вида записи в etcd.
Все изменения в кластере должны выполняться последовательно:
- Чтобы обновить peerURLs одного участника, выполните операцию обновления.
- Чтобы заменить одного исправного участника, удалите старого и добавьте нового.
- Для увеличения с 3 до 5 участников выполните две операции добавления.
- Для уменьшения с 5 до 3 выполните две операции удаления.
Во всех примерах используется поставляемая с etcd утилита etcdctl. Чтобы
изменить состав без etcdctl, используйте HTTP API участников v2
или
gRPC API участников v3
.
Обновление участника
Обновление адресов клиентов для обмена
Для обновления адресов advertise клиентских URL-ов участника достаточно перезапустить этот участник с флагом (--advertise-client-urls) или переменной окружения (ETCD_ADVERTISE_CLIENT_URLS) обновленными клиентскими URL-ами. Перезапущенный участник сам опубликует обновленные URL-ы. Неправильно обновленный клиент (URL) не повлияет на состояние здоровья кластера etcd.
Обновление анонсируемых адресов пеерконтроллеров
Для обновления адресов пеер-членов участника, сначала явно обновите его с помощью команды member, а затем перезапустите участника. Дополнительное действие необходимо, так как обновление адресов пеер-членов изменяет конфигурацию кластера и может повлиять на состояние etcd кластера.
Для обновления объявляемых URL сначала найдите ID участника. Список выводится командой etcdctl:
Пример выполняет update участника с ID a8266ecf031671f3 и задаёт peerURLs
http://10.0.1.10:2380:
Удалить участника
Предположим, что идентификатор участника для удаления — a8266ecf031671f3. Используйте команду remove для выполнения удаления:
Целевой участник остановит себя на этом этапе и выведет удаление в лог:
Было бы безопасно удалить лидера, однако кластер будет неактивен до тех пор, пока не будет выбран новый лидер. Этот период составляет обычно сумму тайм-аута выборов и процесса голосования.
Добавление нового участника
Добавление участника является двухэтапным процессом:
- Добавьте участника через HTTP API участников
, gRPC API участников
или
etcdctl member add. - Запустите его с новой конфигурацией кластера и обновлённым списком участников (существующие + новый).
etcdctl добавляет участника по его имени
и
объявляемым URL однорангового узла
:
etcdctl уведомил кластер о новом участнике и вывел переменные окружения, необходимые для успешного запуска. Теперь запустите новый процесс etcd с соответствующими флагами для нового участника:
Новый участник будет функционировать как часть кластера и немедленно начнет синхронизироваться с остальными участниками кластера.
При добавлении нескольких участников настраивайте их по одному и проверяйте
запуск. После добавления участника в кластер из 1 узла кластер не продвигается,
пока новый участник не запустится: для консенсуса теперь нужно большинство из
двух. Пауза длится от etcdctl member add до успешного соединения нового участника.
Добавление нового участника как обучающегося
Начиная с v3.4 etcd поддерживает добавление обучающегося участника без права голоса. Мотивация и дизайн можно найти в документе по дизайну . Чтобы сделать процесс добавления нового участника безопаснее, и снизить время простоя кластера при добавлении нового участника, рекомендуется добавлять новый участник в кластер как обучающийся до тех пор, пока он не синхронизируется. Это можно описать как трехступенчатый процесс:
Добавьте новый участник как обучающийся участника через gRPC members API или команду
etcdctl member add --learner.Запустите нового участника с новой конфигурацией и обновлённым списком участников (существующие + новый). Этот шаг не отличается от описанного выше.
Промотировать новый добавленный обучающийся до участника с правом голоса через gRPC members API или командой
etcdctl member promote. сервер etcd проверяет запрос на промотацию для обеспечения его оперативной безопасности. Только после того как лог raft обучающегося участника захватит лог лидера, он может быть промовирован до участника с правом голоса. Если обучающийся участник не захватил лог лидера, запрос на промотацию участника завершится неудачей (см. раздел об ошибках при промотации участника для получения дополнительной информации). В этом случае пользователь должен подождать и повторить попытку позже.
В v3.4 сервер etcd ограничивает количество обучающихся участников, которые может иметь кластер, одним. Основное соображение заключается в ограничении дополнительной нагрузки на лидера при распространении данных от лидера к обучающемуся участнику.
Используйте etcdctl member add с флагом --learner для добавления нового участника в кластер как обучающегося участника.
После запуска нового процесса etcd для нового добавленного обучающегося участника используйте etcdctl member promote для повышения обучающегося участника до голосующего участника.
Случаи ошибок при добавлении участников
В следующем случае новый хост не включается в список перечисленных узлов. Если это новый кластер, узел должен быть добавлен в список исходных участников кластера.
В этом случае используйте другую адресацию (10.0.1.14:2380), отличную от той, которая была использована для присоединения к кластеру (10.0.1.13:2380):
Если etcd начинает использовать данные из директории данных удаленного участника, etcd автоматически завершает работу, если он подключается к любому активному участнику в кластере:
Ошибки при добавлении обучающегося участника
Нельзя добавить обучающегося участника в кластер, если кластер уже имеет 1 обучающегося участника (v3.4).
Ошибки при повышении обучающегося участника до участника
Обучающегося можно повысить до голосующего участника только после синхронизации с лидером.
Повышение участника, который не является обучающимся, завершится ошибкой.
Повышение отсутствующего в кластере участника завершится ошибкой.
Тщательный режим проверки строгой реконфигурации (-strict-reconfig-check)
Как описано выше, лучшая практика добавления новых участников заключается в настройке одного участника за раз и проверке того, что он стартует корректно, прежде чем добавлять новые участники. Этот пошаговый подход очень важен, так как если новый участник не настроен правильно (например, URL-адреса коллегиальных узлов неверны), кластер может потерять кворум. Потеря кворума происходит, так как новый участник учитывается в кворуме даже если он недоступен из других существующих участников. Также потеря кворума может произойти при проблемах с связностью или при операционных проблемах.
Для предотвращения проблемы etcd предоставляет -strict-reconfig-check.
С этим параметром etcd отклоняет изменение конфигурации, если число запущенных
участников станет меньше кворума нового состава.
По умолчанию включено.
17 - Поддерживаемые платформы
Уровни поддержки
etcd работает на разных платформах, однако предоставляемые гарантии зависят от уровня поддержки платформы:
- Уровень 1: полностью поддерживается сопровождающими etcd ; гарантируется прохождение всех тестов, включая функциональные тесты и тесты надёжности.
- Уровень 2: гарантируется прохождение интеграционных и сквозных тестов, но не обязательно функциональных тестов или тестов надёжности.
- Уровень 3: гарантируется успешная сборка; тестирование может быть минимальным или отсутствовать, поэтому платформу следует считать нестабильной.
Текущая поддержка
В следующей таблице перечислены поддерживаемые платформы и соответствующие уровни поддержки etcd:
| Архитектура | Операционная система | Уровень поддержки | Сопровождающие |
|---|---|---|---|
| AMD64 | Linux | 1 | сопровождающие etcd |
| ARM64 | Linux | 1 | сопровождающие etcd |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Платформы, отсутствующие в таблице, не поддерживаются.
Поддержка новой платформы
Хотите участвовать в etcd как «официальный» сопровождающий новой платформы? Помимо обязательства поддерживать платформу, необходимо настроить непрерывную интеграцию (CI) etcd, удовлетворяющую требованиям соответствующего уровня:
| Непрерывная интеграция etcd | Уровень 1 | Уровень 2 | Уровень 3 |
|---|---|---|---|
| Сборка проходит | ✓ | ✓ | ✓ |
| Модульные тесты проходят | ✓ | ✓ | |
| Интеграционные и сквозные тесты проходят | ✓ | ✓ | |
| Тесты надёжности проходят | ✓ |
Пример настройки CI уровня 2 для ARM64 приведён в etcd PR #12928 .
Неподдерживаемые платформы
Чтобы сервер etcd не был случайно запущен на неподдерживаемой платформе, etcd
выводит предупреждение и немедленно завершает работу, если переменная окружения
ETCD_UNSUPPORTED_ARCH не содержит целевую архитектуру.
32-bit системы В etcd существуют известные проблемы на 32-bit системах из-за ошибки в среде выполнения Go. Дополнительные сведения приведены в issue Go #599 и примечании об ошибке пакета atomic .
18 - Версионирование
Данный документ описывает версии, поддерживаемые проектом etcd.
Версионирование сервиса и поддерживаемые версии
Версии etcd выражаются как x.y.z, где x — мажорная версия, y — минорная версия, а z — версия исправления, в соответствии с терминологией Semantic Versioning
.
Новые минорные версии могут добавлять дополнительные функции в API.
Проект etcd поддерживает ветки релизов для текущей версии и предыдущего выпуска. Например, когда v3.5 является текущей версией, поддерживается v3.4. Когда выпускается v3.6, v3.4 прекращает поддержку.
Исправления, включая исправления уязвимостей, могут быть перенесены в эти два ветвления выпусков в зависимости от серьезности и реализуемости. Патч-релизы выпускаются из этих ветвлений по мере необходимости.
Команда разработчиков Maintainers несёт ответственность за это решение.
Вы можете проверить версию работающего кластера etcd с помощью etcdctl:
API версионирование
Ответы v3 API не должны изменяться после выпуска 3.0.0, но со временем будут добавляться новые функции.
19 - Повреждение данных
В etcd встроено автоматическое обнаружение повреждения данных, предотвращающее расхождение состояния участников.
Включение обнаружения повреждения данных
Повреждение данных можно обнаруживать с помощью:
- Начальной проверки, включаемой флагом
--experimental-initial-corrupt-check. - Периодической проверки:
- Хеша сжатой ревизии, включаемой флагом
--experimental-compact-hash-check-enabled. - Хеша последней ревизии, включаемой флагом
--experimental-corrupt-check-time.
- Хеша сжатой ревизии, включаемой флагом
Начальная проверка выполняется при начальной инициализации участника etcd. Участник сравнивает своё постоянное состояние с другими участниками и завершает работу при несовпадении.
Обе периодические проверки выполняются лидером уже работающего кластера. Лидер сравнивает своё постоянное состояние с другими участниками и при несовпадении подаёт аварийный сигнал CORRUPT. Обе проверки решают одну задачу, однако для баланса между производительностью и временем обнаружения стоит включить обе.
- Проверка хеша сжатой ревизии — требует регулярной компактизации, имеет минимальную стоимость и работает с медленными последователями.
- Проверка хеша последней ревизии — имеет высокую стоимость и не работает с медленными последователями или частой компактизацией.
Проверка хеша сжатой ревизии
Если проверка включена флагом --experimental-compact-hash-check-enabled, она выполняется раз в минуту.
Период можно изменить флагом --experimental-compact-hash-check-time в формате: 1m — раз в минуту, 1h — раз в час.
Проверка расширяет компактизацию вычислением контрольной суммы, которую можно сравнить между участниками кластера.
Дополнительное сканирование базы данных не выполняется, поэтому стоимость проверки очень мала, но кластеру требуется регулярная компактизация.
Проверка хеша последней ревизии
Проверка включается флагом --experimental-corrupt-check-time; необходимо указать период выполнения в формате: 1m — раз в минуту, 1h — раз в час.
Из-за высокой стоимости рекомендуется период в несколько часов.
Для проверки вычисляется контрольная сумма путём сканирования всего содержимого etcd на заданной ревизии.
Восстановление повреждённого участника
Повреждённого участника можно восстановить тремя способами:
- Очистить постоянное состояние участника
- Заменить участника
- Восстановить весь кластер
После восстановления повреждённого участника аварийный сигнал CORRUPT можно удалить.
Очистка постоянного состояния участника
Состояние участника можно очистить следующим образом:
- Остановите экземпляр etcd.
- Создайте резервную копию каталога данных etcd.
- Переместите подкаталог
snapиз каталога данных etcd. - Запустите
etcdс--initial-cluster-state=existingи списком участников кластера в--initial-cluster.
После этого участник etcd должен загрузить актуальный снимок у лидера.
Замена участника
Участника можно заменить следующим образом:
- Остановите экземпляр etcd.
- Создайте резервную копию каталога данных etcd.
- Удалите каталог данных.
- Удалите участника из кластера командой
etcdctl member remove. - Добавьте его обратно командой
etcdctl member add. - Запустите
etcdс--initial-cluster-state=existingи списком участников кластера в--initial-cluster.
Восстановление всего кластера
Кластер можно восстановить, сохранив снимок текущего лидера и восстановив его на всех участниках.
Выполните etcdctl snapshot save для лидера и следуйте процедуре восстановления кластера
.