Это многостраничная версия текущего раздела для печати. .
Учеба
1 - Модель данных
etcd предназначен для надёжного хранения редко обновляемых данных и выполнения надёжных запросов наблюдения. etcd предоставляет предыдущие версии пар «ключ — значение», поддерживая недорогие снимки и историю событий наблюдения («запросы с перемещением во времени»). Для этих сценариев хорошо подходит постоянная многоверсионная модель данных с управлением параллелизмом.
etcd хранит данные в многоверсионном постоянном хранилище ключей и значений. Когда значение пары заменяется новыми данными, постоянное хранилище сохраняет её предыдущую версию. Фактически хранилище неизменяемо: операции не обновляют структуру на месте, а всегда создают новую обновлённую структуру. После изменения все прежние версии ключей остаются доступными для чтения и наблюдения. Чтобы хранилище не росло бесконечно и не сохраняло старые версии, его можно компактизировать, удалив самые старые версии замещённых данных.
Логическое представление
Логически хранилище представляет собой плоское пространство двоичных ключей. Пространство имеет лексически отсортированный индекс по ключам — строкам байтов, поэтому запросы диапазонов выполняются недорого.
Пространство ключей поддерживает несколько ревизий. При создании хранилища начальная ревизия равна 1. Каждая атомарная изменяющая операция — например, одна транзакция может содержать несколько операций — создаёт новую ревизию пространства ключей. Данные предыдущих ревизий остаются неизменными. Старые версии ключа доступны через прежние ревизии. Сами ревизии также индексируются, поэтому наблюдатели эффективно перебирают их диапазоны. При компактизации для экономии места ревизии до ревизии компактизации удаляются. На протяжении жизни кластера номер ревизии монотонно возрастает.
Жизнь ключа образует поколение от создания до удаления. У ключа может быть одно или несколько поколений. Создание ключа увеличивает его версию, начиная с 1, если ключ не существует в текущей ревизии. Удаление создаёт надгробную метку ключа, завершает текущее поколение и сбрасывает версию в 0. Каждое изменение ключа увеличивает версию, поэтому внутри поколения версии монотонно возрастают. После компактизации удаляются все поколения, завершившиеся до ревизии компактизации, а также все значения, заданные до неё, кроме самого нового.
Физическое представление
Физически etcd хранит данные как пары «ключ — значение» в постоянном b+tree . Для эффективности каждая ревизия состояния содержит только разницу относительно предыдущей. Одной ревизии может соответствовать несколько ключей дерева.
Ключ пары «ключ — значение» является 3-кортежем (major, sub, type). Major — ревизия хранилища, содержащая ключ. Sub различает ключи в одной ревизии. Type — необязательный суффикс для особого значения, например t, если значение содержит надгробную метку. Значение пары содержит изменение относительно предыдущей ревизии, то есть одну разницу. b+tree упорядочен по ключам в лексическом порядке байтов. Диапазонный поиск по разницам ревизий выполняется быстро, что позволяет быстро находить изменения между двумя заданными ревизиями. Компактизация удаляет устаревшие пары.
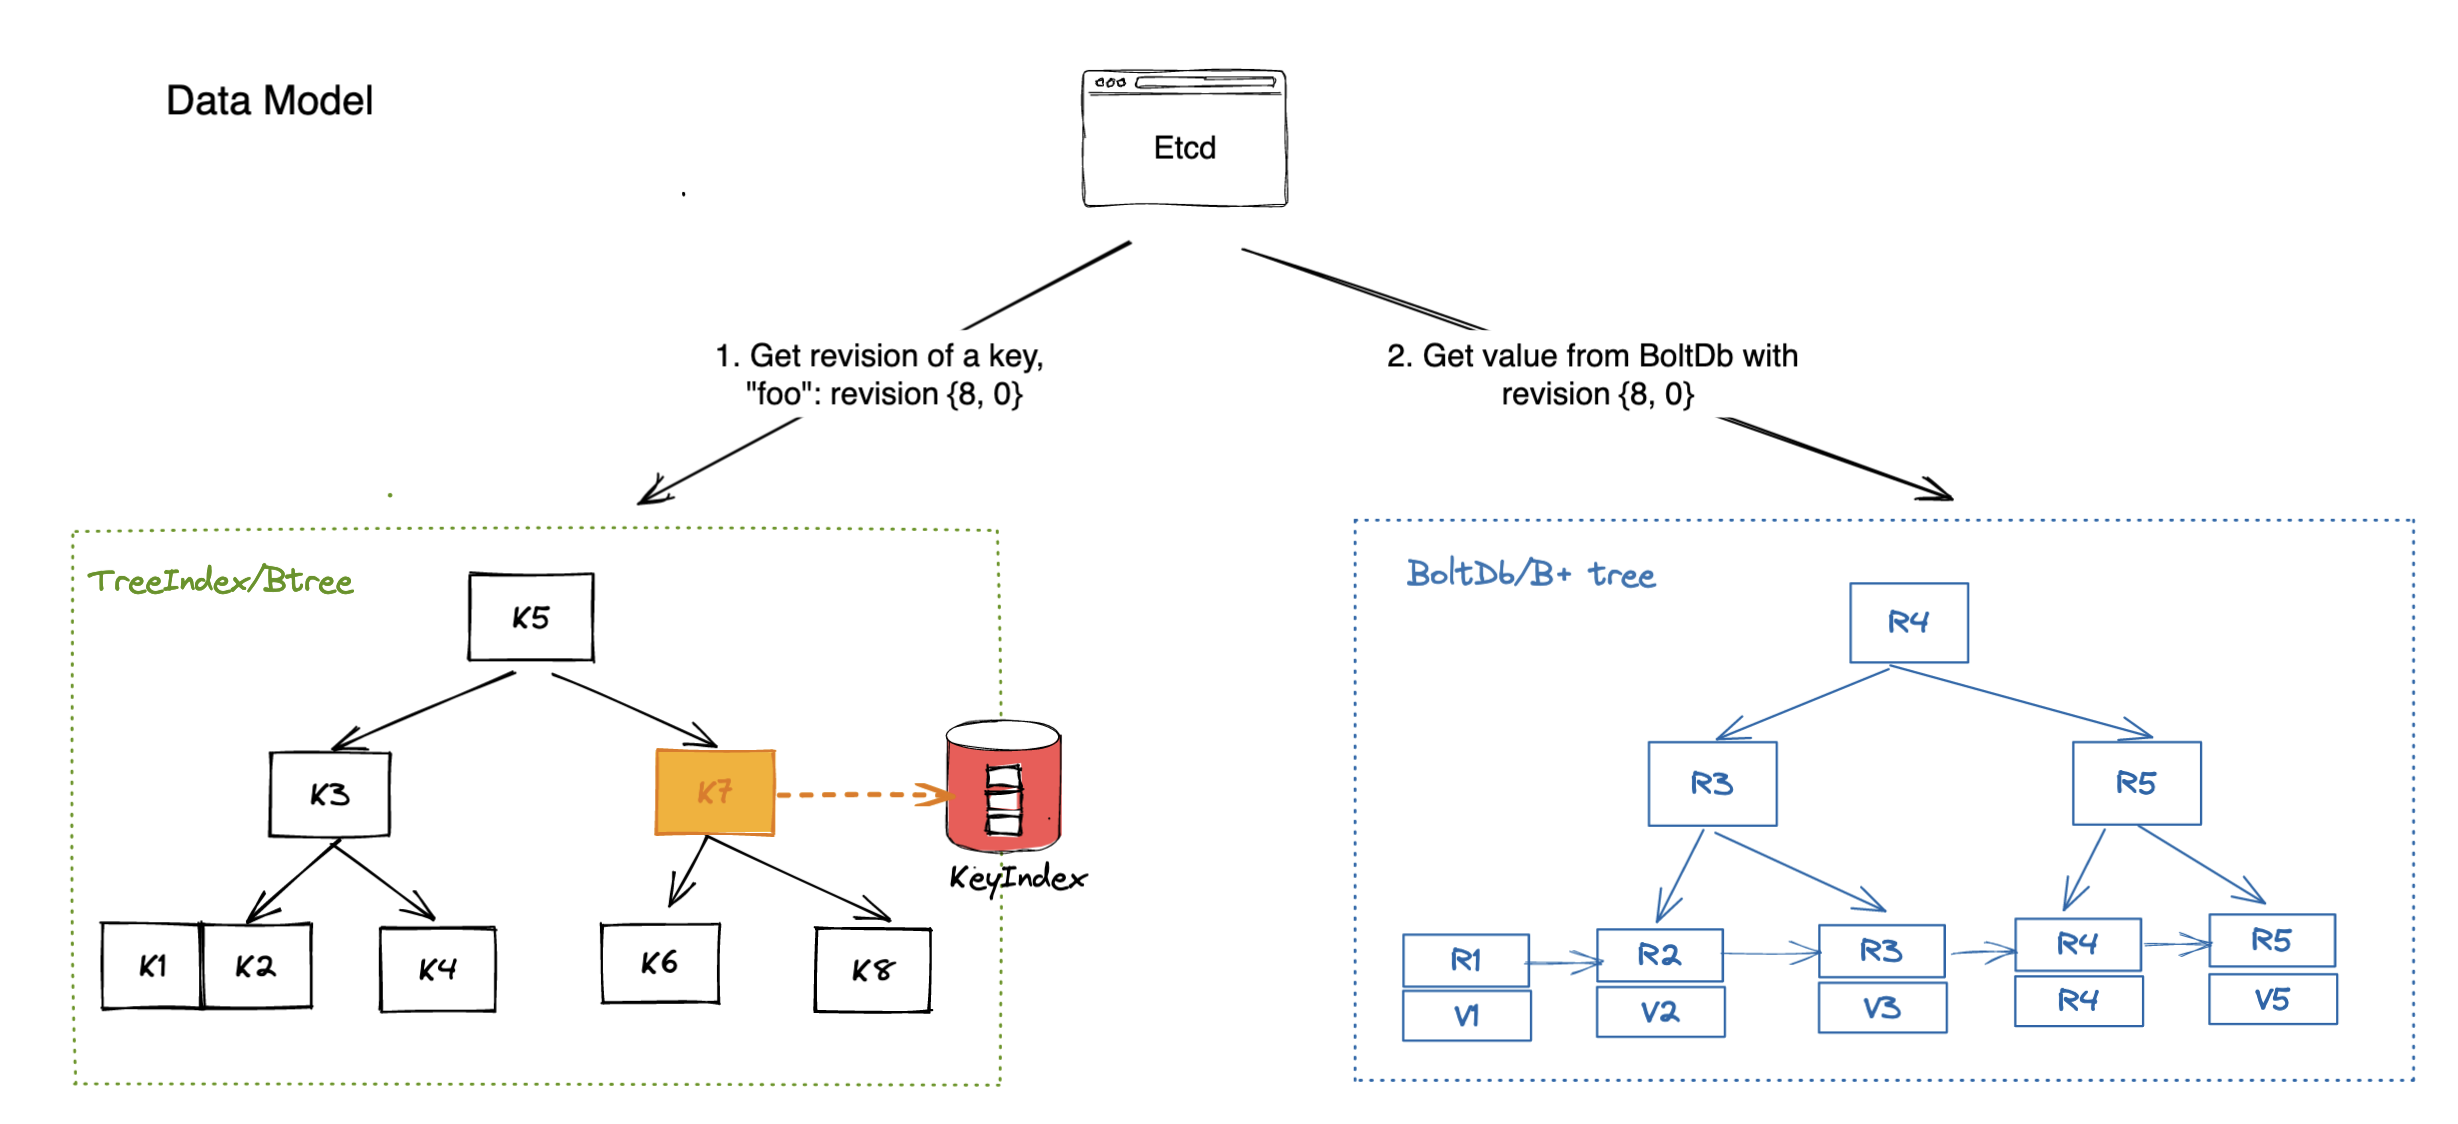
Для ускорения диапазонных запросов по ключам etcd также поддерживает вторичный индекс btree в памяти. Ключи этого индекса — ключи хранилища, предоставляемые пользователю. Значение является указателем на изменение в постоянном b+tree. Компактизация удаляет недействующие указатели.
В итоге etcd получает сведения о ревизии из btree, а затем использует ревизию как ключ для получения значения из b+tree, как показано ниже.
2 - Конструкция клиента etcd
Конструкция клиента etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Введение
Сервер etcd доказал свою надёжность многолетним тестированием с внедрением отказов. Большая часть сложной логики приложений уже обрабатывается сервером etcd и его хранилищами данных (например, состав кластера прозрачен для клиентов, а уровень Raft пересылает предложения лидеру). Хотя серверные компоненты корректны, их взаимодействие с клиентом требует иного набора сложных протоколов, обеспечивающих корректность и высокую доступность в условиях отказов. В идеале сервер etcd представляет множество физических машин как единый логический кластер, а клиент реализует автоматическое переключение между репликами при отказе. В этом документе описаны архитектурные решения клиента и подробности их реализации.
Глоссарий
clientv3: официальный клиент etcd на Go для API etcd v3.
clientv3-grpc1.0: официальная реализация клиента с grpc-go v1.0.x
, используемая в последней версии etcd v3.1.
clientv3-grpc1.7: официальная реализация клиента с grpc-go v1.7.x
, используемая в последних версиях etcd v3.2 и v3.3.
clientv3-grpc1.23: официальная реализация клиента с grpc-go v1.23.x
, используемая в последней версии etcd v3.4.
Балансировщик: балансировщик нагрузки клиента etcd, реализующий механизм повторных попыток и переключения при отказе. Клиент etcd должен автоматически распределять нагрузку между несколькими конечными точками.
Конечные точки: список конечных точек сервера etcd, к которым могут подключаться клиенты. Обычно это 3 или 5 клиентских URL кластера etcd.
Закреплённая конечная точка: при настройке нескольких конечных точек балансировщик клиента <= v3.3 выбирает только одну для установления TCP-соединения, чтобы сократить общее количество открытых соединений с кластером etcd. В v3.4 балансировщик циклически выбирает закреплённые конечные точки для каждого запроса, распределяя нагрузку равномернее.
Клиентское соединение: TCP-соединение с сервером etcd, установленное посредством gRPC Dial.
Подсоединение: интерфейс gRPC SubConn. Каждое подсоединение содержит список адресов. Балансировщик создаёт SubConn из списка разрешённых адресов. gRPC ClientConn может соответствовать нескольким SubConn (например, example.com разрешается в 10.10.10.1 и 10.10.10.2, относящиеся к двум подсоединениям). Балансировщик etcd v3.4 использует внутренний разрешитель, чтобы создать по одному подсоединению для каждой конечной точки.
Кратковременный разрыв соединения: сервер gRPC возвращает ошибку состояния code Unavailable
.
Требования к клиенту
Корректность. При отказах сервера запросы могут завершаться неудачно. Однако гарантии согласованности никогда не нарушаются: свойства глобального порядка, недопустимость записи повреждённых данных, семантика «не более одного раза» для изменяющих операций, наблюдение никогда не видит частичные события и так далее.
Живучесть. Серверы могут кратковременно отказывать или отключаться. Клиенты должны в любом случае продолжать работу. Если не настроено иное, клиенты никогда не должны попадать во взаимоблокировку , ожидая возвращения сервера в сеть. В идеале клиенты обнаруживают недоступные серверы с помощью ping HTTP/2, переключаются на другие узлы и выдают понятные сообщения об ошибках.
Эффективность. Клиенты должны эффективно работать с минимальными ресурсами: после переключения конечной точки прежние TCP-соединения следует плавно закрывать . Механизм переключения при отказе должен эффективно выбирать следующую реплику для подключения, не тратя ресурсы на повторные попытки к отказавшим узлам.
Переносимость. Официальный клиент должен иметь ясную документацию, а его реализация должна быть применима к привязкам других языков. Обработка ошибок в разных языковых привязках должна быть согласованной. Поскольку etcd полностью опирается на gRPC, реализацию следует тесно согласовать с долгосрочными целями конструкции gRPC (например, подключаемая политика повторов должна быть совместима с повторными попытками gRPC ). Обновление между двумя версиями клиента не должно прерывать работу.
Обзор клиента
Клиент etcd реализует следующие компоненты:
- балансировщик, устанавливающий соединения gRPC с кластером etcd;
- клиент API, отправляющий RPC серверу etcd; и
- обработчик ошибок, решающий, следует ли повторить неудачный запрос или переключить конечную точку.
Языки могут различаться способом установления исходного соединения (например, настройкой TLS), кодирования и отправки серверу сообщений Protocol Buffer, обработки потоковых RPC и так далее. Однако ошибки, возвращаемые сервером etcd, одинаковы. Такими же должны быть обработка ошибок и политика повторных попыток.
Например, сервер etcd может вернуть "rpc error: code = Unavailable desc = etcdserver: request timed out" — временную ошибку, предполагающую повторные попытки. Либо он может вернуть rpc error: code = InvalidArgument desc = etcdserver: key is not provided, что означает недопустимый запрос, который повторять не следует. Клиент Go может разбирать ошибки с помощью google.golang.org/grpc/status.FromError, а клиент Java — с помощью io.grpc.Status.fromThrowable.
clientv3-grpc1.0: обзор балансировщика
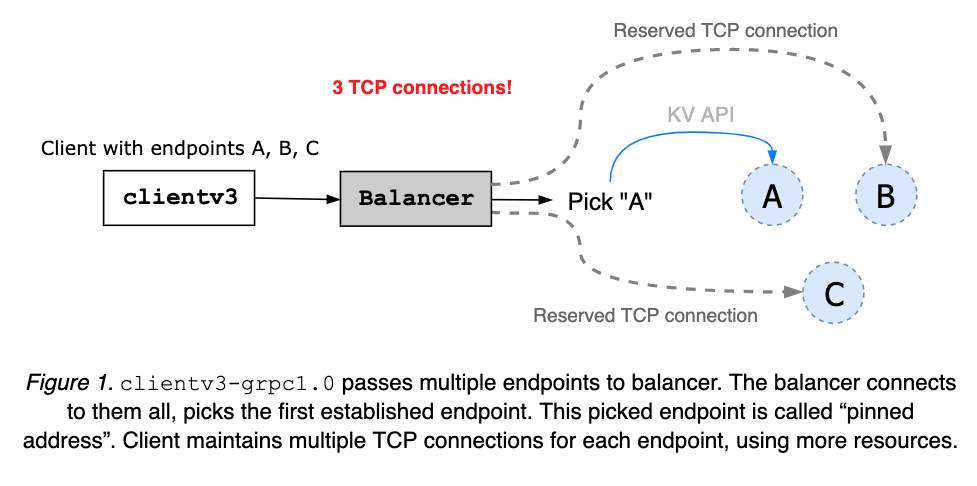
При настройке нескольких конечных точек etcd clientv3-grpc1.0 поддерживает несколько TCP-соединений. Затем он выбирает один адрес и использует его для всех клиентских запросов. Закреплённый адрес сохраняется до закрытия объекта клиента (см. рисунок 1). Получив ошибку, клиент случайным образом выбирает другой адрес и повторяет запрос.
clientv3-grpc1.0: ограничение балансировщика
Несколько TCP-соединений, открываемых clientv3-grpc1.0, могут ускорить переключение балансировщика при отказе, но требуют больше ресурсов. Балансировщик не знает ни состояние узлов, ни состав кластера. Поэтому он может застрять на одном отказавшем или изолированном узле.
clientv3-grpc1.7: обзор балансировщика
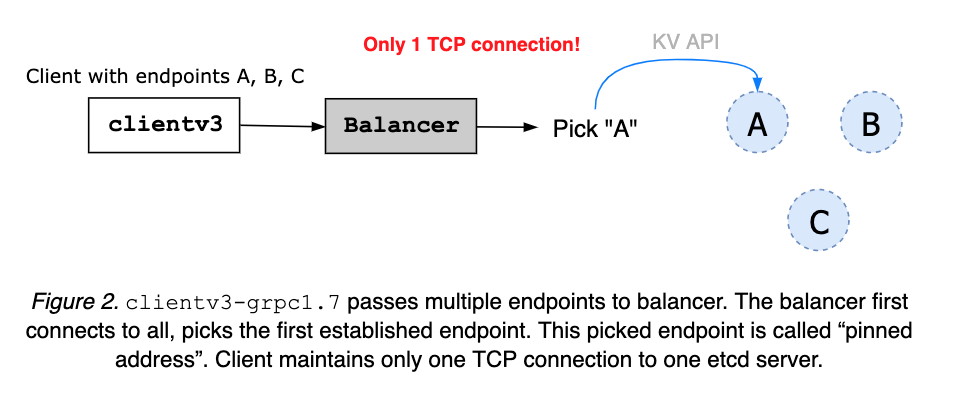
clientv3-grpc1.7 поддерживает только одно TCP-соединение с выбранным сервером etcd. Получив несколько конечных точек кластера, клиент сначала пытается подключиться ко всем. Как только одно соединение устанавливается, балансировщик закрепляет адрес и закрывает остальные (см. рисунок 2). Закреплённый адрес сохраняется до закрытия объекта клиента. Ошибка сервера или клиентской сети передаётся клиентскому обработчику ошибок (см. рисунок 3).
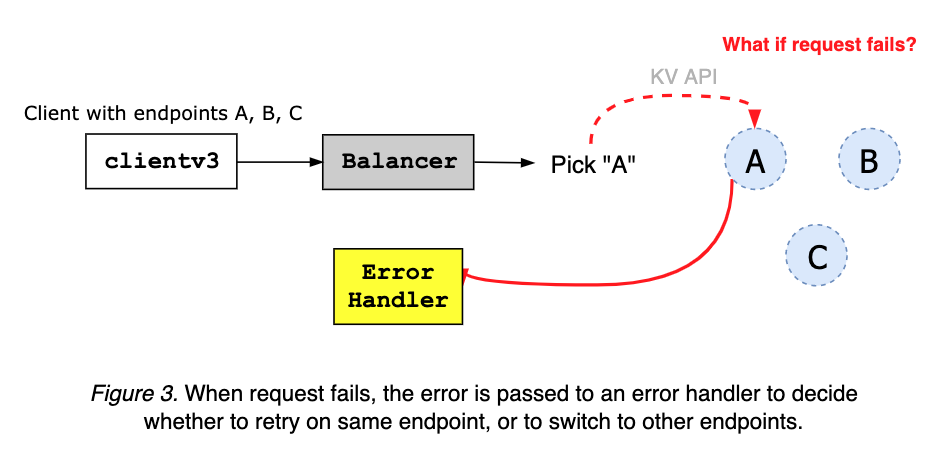
Клиентский обработчик получает ошибку от сервера gRPC и по её коду и сообщению решает, повторить ли запрос к той же конечной точке или переключиться на другие адреса (см. рисунок 4 и рисунок 5).
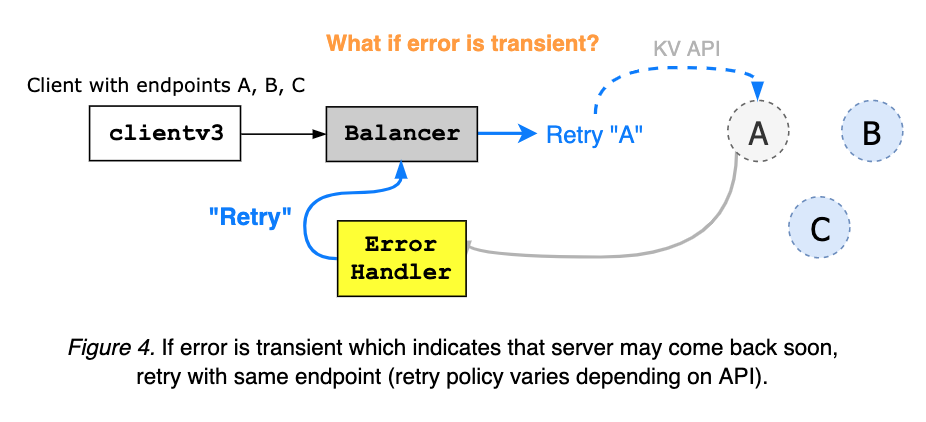
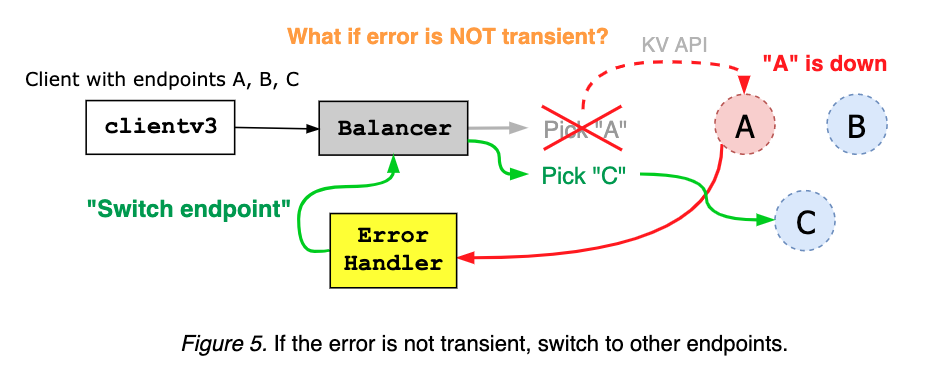
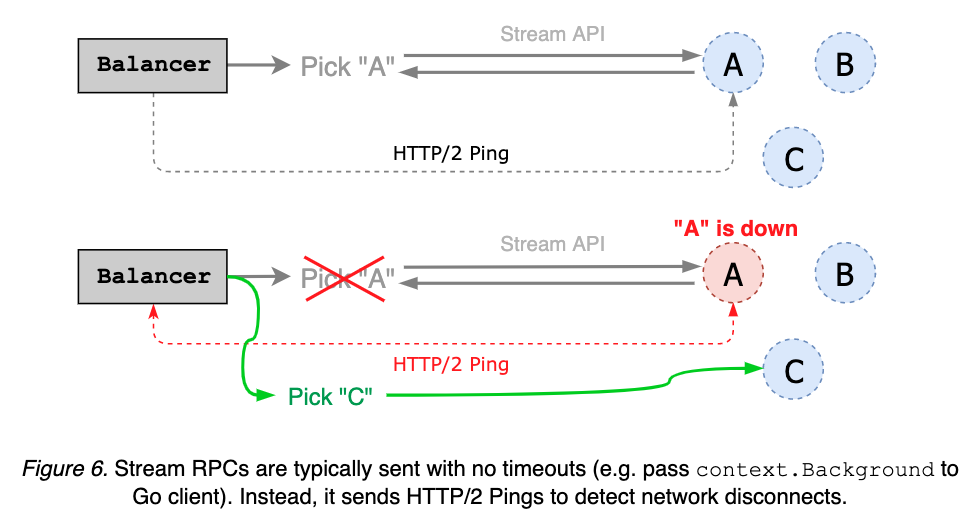
Потоковые RPC, такие как Watch и KeepAlive, часто запрашиваются без тайм-аутов. Вместо этого клиент может периодически отправлять ping HTTP/2 для проверки состояния закреплённой конечной точки; если сервер не отвечает, балансировщик переключается на другие конечные точки (см. рисунок 6).
clientv3-grpc1.7: ограничение балансировщика
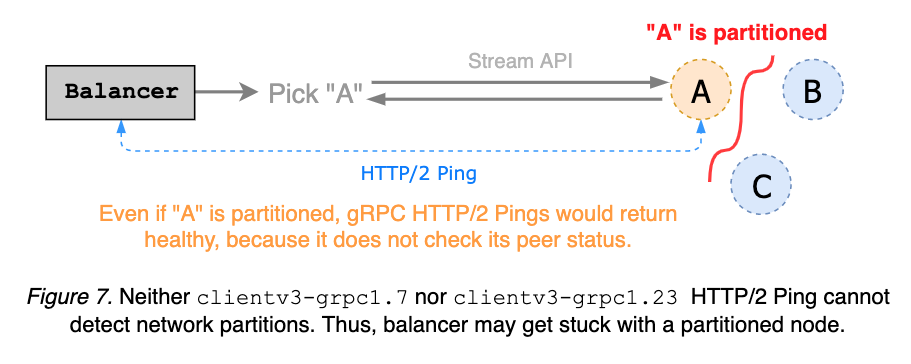
Балансировщик clientv3-grpc1.7 отправляет сигналы keepalive HTTP/2, чтобы обнаруживать разрывы потоковых запросов. Это простой механизм ping сервера gRPC, не учитывающий состав кластера и потому не способный обнаружить разделение сети. Поскольку изолированный сервер gRPC всё ещё может отвечать на клиентские ping, балансировщик способен застрять на нём. В идеале ping keepalive обнаруживает разделение и вызывает переключение конечной точки до истечения тайм-аута запроса (см. etcd#8673
и рисунок 7).
Балансировщик clientv3-grpc1.7 поддерживает список неисправных конечных точек. Отключённые адреса добавляются в список «неисправных» и считаются недоступными до окончания периода ожидания, жёстко заданного как тайм-аут набора номера со значением по умолчанию 5 секунд. Балансировщик может ошибочно считать конечные точки неисправными. Например, конечная точка A может вернуться сразу после внесения в чёрный список, но останется недоступной следующие 5 секунд (см. рисунок 8).
clientv3-grpc1.0 испытывал те же описанные выше проблемы.
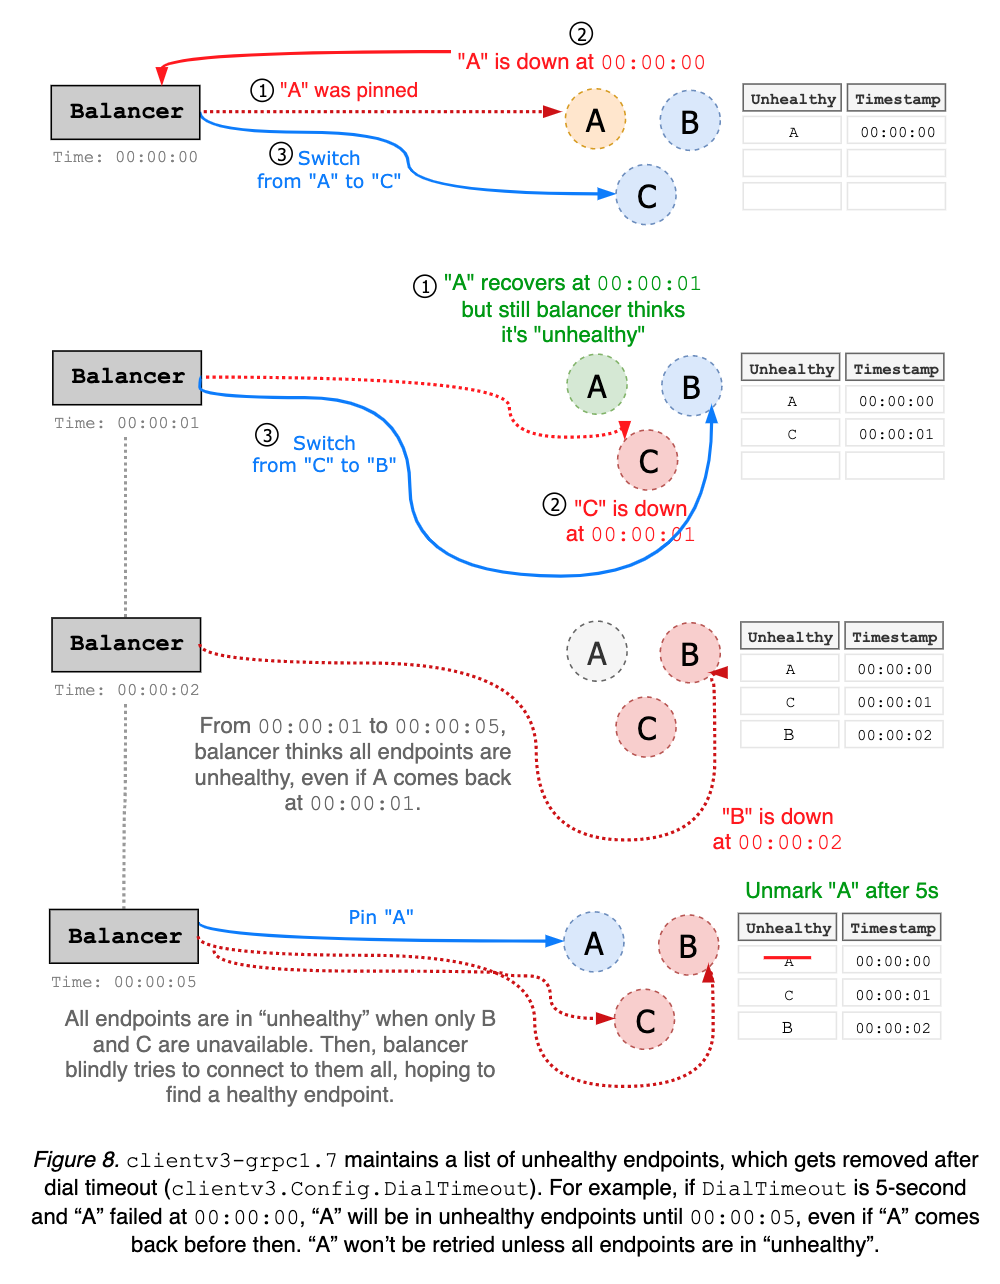
Вышестоящий gRPC Go уже перешёл на новый интерфейс балансировщика. Например, внутренняя реализация балансировщика clientv3-grpc1.7 использует новый балансировщик gRPC и пытается сохранять поведение старого. Хотя совместимость поддерживалась достаточно хорошо, клиент etcd всё же страдал от малозаметных нарушающих совместимость изменений
. Кроме того, сопровождающие gRPC рекомендуют не полагаться на старый интерфейс балансировщика
. В целом для более качественной поддержки со стороны вышестоящего проекта лучше синхронизироваться с последними выпусками gRPC. Новые функции, например политика повторных попыток, могут не переноситься в ветвь gRPC 1.7. Поэтому и сервер, и клиент etcd должны перейти на последние версии gRPC.
clientv3-grpc1.23: обзор балансировщика
clientv3-grpc1.7 настолько тесно связан со старым интерфейсом gRPC, что каждое обновление зависимости gRPC нарушало поведение клиента. Большая часть усилий по разработке и отладке уходила на исправление этих изменений. В результате реализация стала чрезмерно сложной и опиралась на неверные предположения о соединениях с серверами.
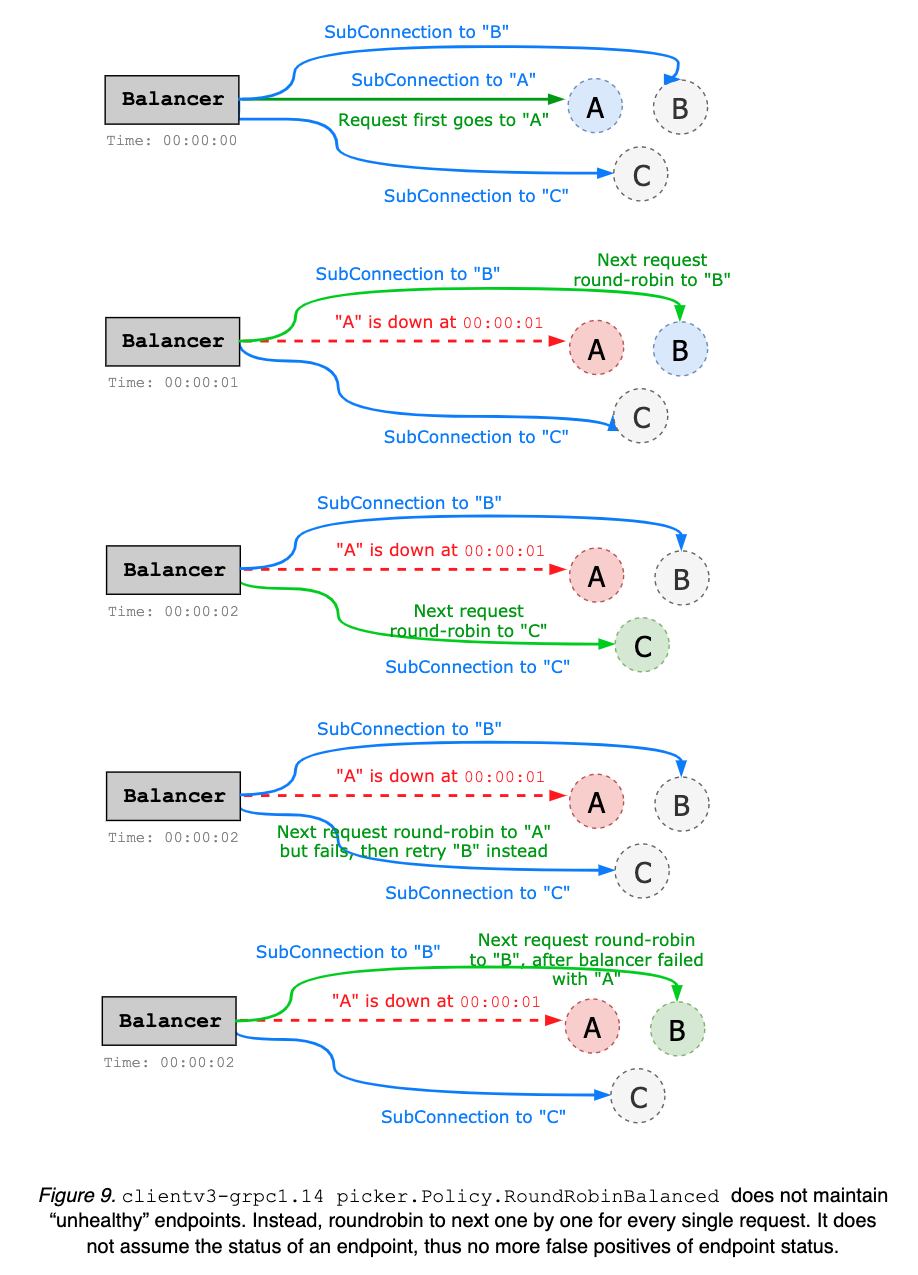
Основная цель clientv3-grpc1.23 — упростить логику переключения балансировщика при отказе. Вместо поддержки потенциально устаревшего списка неисправных конечных точек он просто циклически переходит к следующей точке при каждом отключении клиента от текущей. Состояние конечных точек не предполагается, поэтому сложное отслеживание состояния больше не нужно (см. рисунок 8 и текст выше). Переход на clientv3-grpc1.23 не должен создавать проблем: все изменения внутренние, а обратная совместимость полностью сохранена.
Получив несколько конечных точек, clientv3-grpc1.23 внутри создаёт несколько подсоединений (по одному на каждую точку), тогда как clientv3-grpc1.7 создаёт только одно соединение с закреплённой точкой (см. рисунок 9). Например, в кластере из 5 узлов балансировщику clientv3-grpc1.23 потребуется 5 TCP-соединений, а clientv3-grpc1.7 — только одно. Сохраняя пул TCP-соединений, clientv3-grpc1.23 может потреблять больше ресурсов, но предоставляет более гибкую балансировку нагрузки и лучшее переключение при отказе. По умолчанию используется циклическая политика балансировки, которую легко расширить другими типами балансировщиков (например, выбором из двух, выбором лидера и т. п.). clientv3-grpc1.23 использует группу разрешителей gRPC и реализует политику выбора балансировщика, чтобы передать сложную балансировку вышестоящему gRPC. Напротив, clientv3-grpc1.7 вручную управляет каждым соединением gRPC и переключением балансировщика, что усложняет реализацию. clientv3-grpc1.23 реализует повторные попытки в цепочке перехватчиков gRPC, которая автоматически обрабатывает внутренние ошибки gRPC и поддерживает более сложные политики повторов, например отложенные повторы; clientv3-grpc1.7 вручную интерпретирует ошибки gRPC для повторных попыток.
clientv3-grpc1.23: ограничение балансировщика
Работу можно улучшить, кэшируя состояние каждой конечной точки. Например, балансировщик может заранее проверять каждый сервер с помощью ping, поддерживая список исправных кандидатов, и использовать эти сведения при циклическом выборе. Либо при разрыве соединения отдавать приоритет исправным точкам. Это может усложнить реализацию балансировщика, поэтому улучшение можно оставить для последующих версий.
Клиентский ping keepalive всё ещё не учитывает разделения сети. Потоковый запрос может застрять на изолированном узле. Для понимания состава кластера необходимо реализовать расширенную службу проверки работоспособности (подробнее см. etcd#8673 ).
Сейчас логика повторных попыток обрабатывается вручную перехватчиком. Её можно упростить с помощью официального механизма повторных попыток gRPC .
3 - Конструкция обучающегося участника etcd
Обучающийся участник etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Предпосылки
Изменение состава кластера остаётся одной из крупнейших эксплуатационных сложностей. Рассмотрим типичные проблемы.
1. Новый участник кластера перегружает лидера
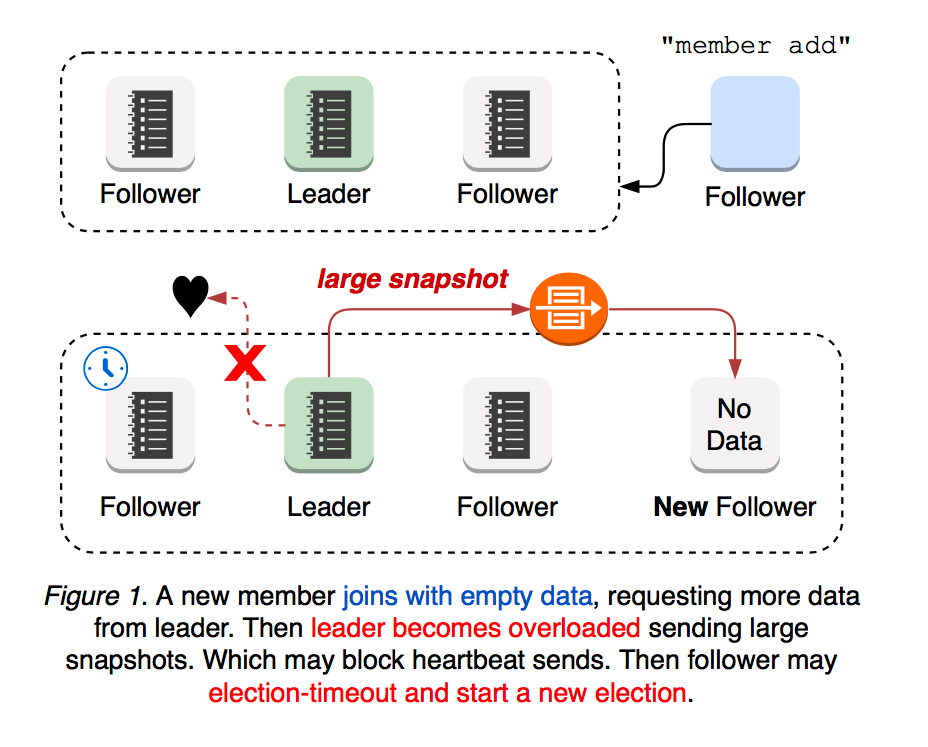
Только что присоединившийся участник etcd начинает без данных и потому требует больше обновлений от лидера, пока не догонит его журнал. Из-за этого сеть лидера с большей вероятностью окажется перегружена, а его сигналы активности последователям будут заблокированы или отброшены. Тогда у последователя может истечь тайм-аут выборов, и он начнёт новые выборы лидера. Таким образом, кластер с новым участником более подвержен выборам лидера. И сами выборы, и последующее распространение обновлений новому участнику могут вызывать периоды недоступности кластера (см. рисунок 1).
2. Сценарии разделения сети
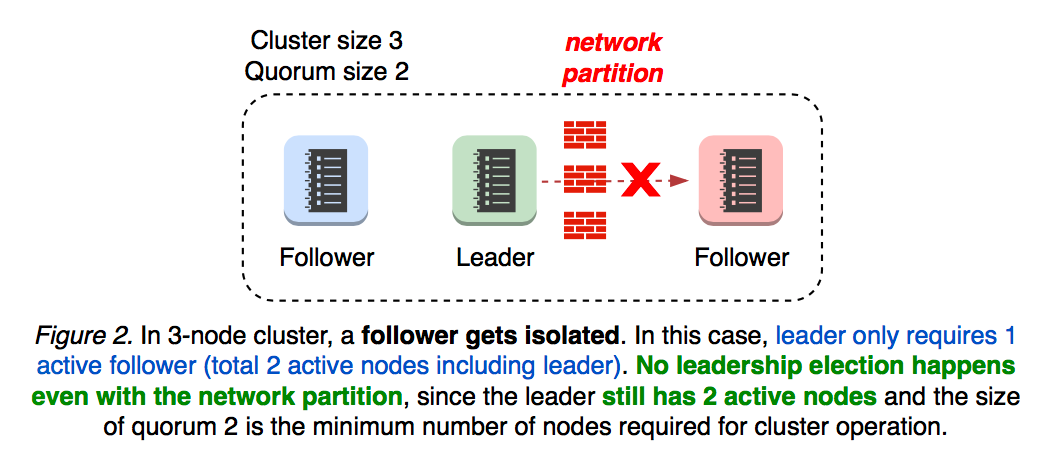
Что произойдёт при разделении сети? Это зависит от того, в какой части находится лидер. Если лидер по-прежнему поддерживает активный кворум, кластер продолжит работу (см. рисунок 2).
2.1 Изоляция лидера
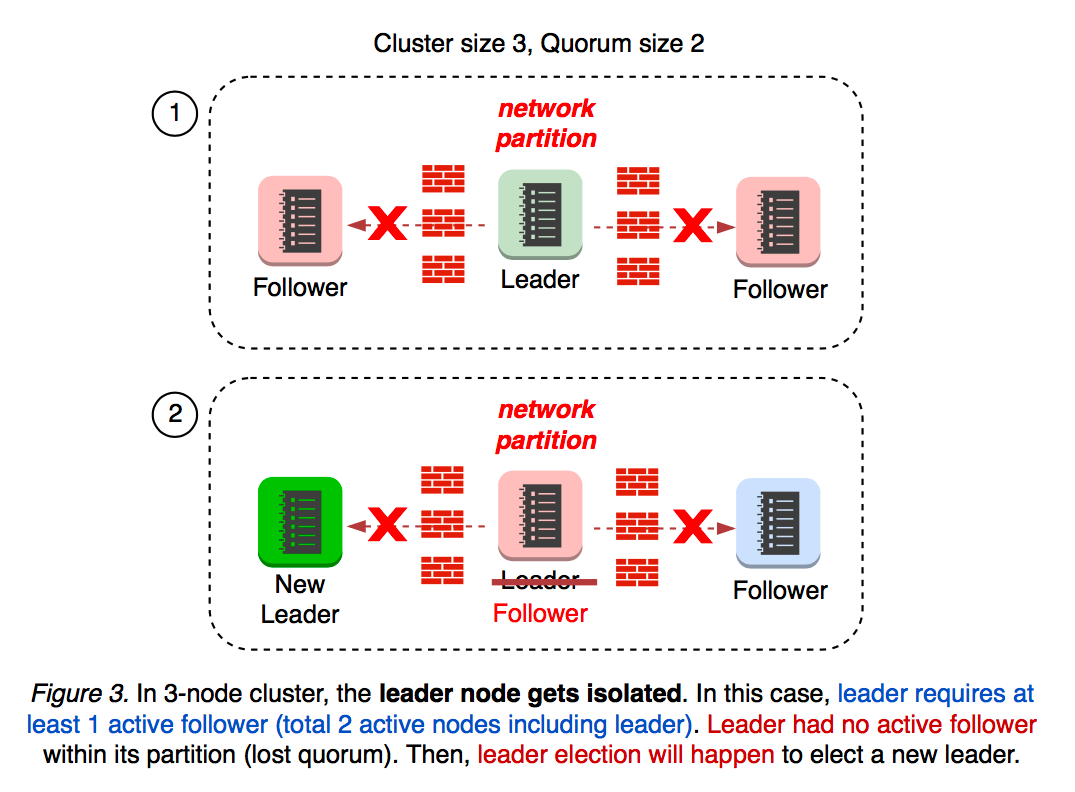
Что произойдёт, если лидер окажется изолирован от остального кластера? Лидер отслеживает прогресс каждого последователя. Потеряв связь с кворумом, он возвращается в состояние последователя, что влияет на доступность кластера (см. рисунок 3).
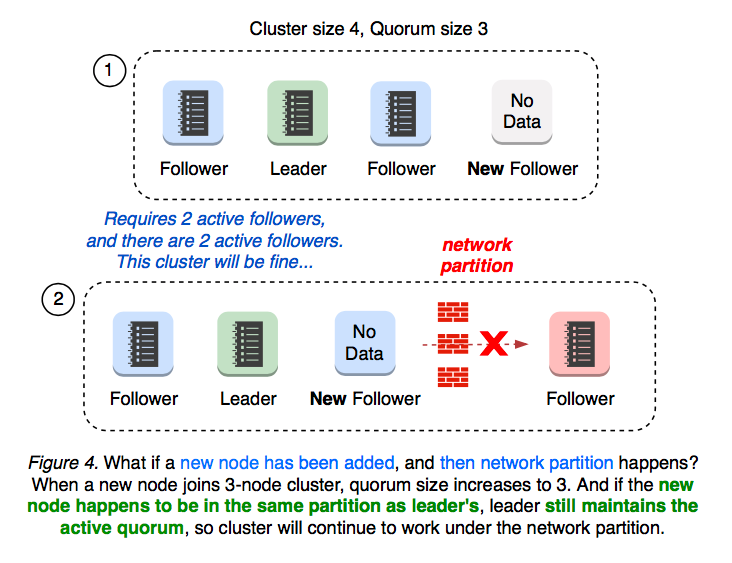
При добавлении нового узла в кластер из 3 узлов размер кластера становится равен 4, а размер кворума — 3. Что произойдёт, если новый узел присоединился к кластеру, после чего возникло разделение сети? Это зависит от того, в какой части после разделения окажется новый участник.
2.2 Разделение кластера 3+1
Если новый узел окажется в той же части, что и лидер, лидер сохранит активный кворум из 3 участников. Новых выборов лидера не будет, и доступность кластера не пострадает (см. рисунок 4).
2.3 Разделение кластера 2+2
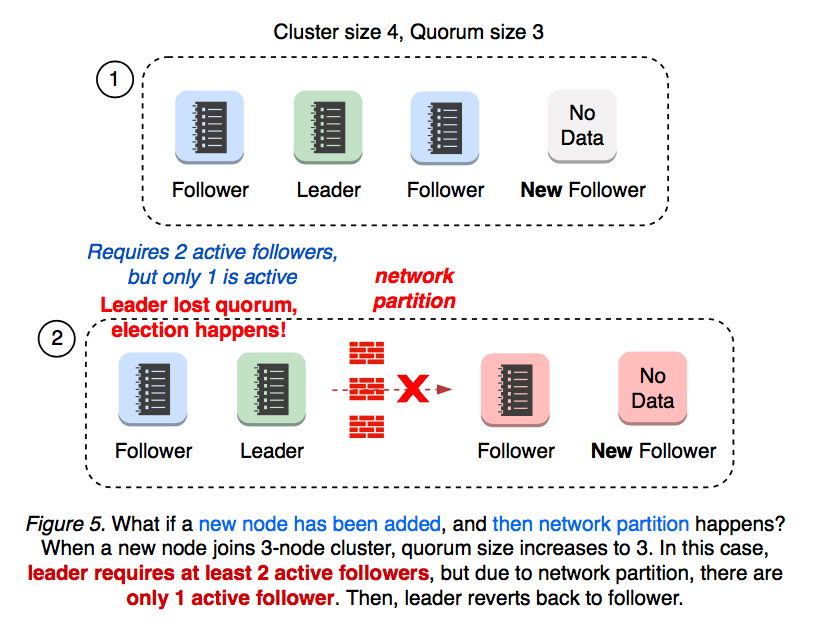
Если кластер разделён на части из 2 и 2 узлов, ни одна из них не сохраняет кворум из 3 участников. В этом случае начинаются выборы лидера (см. рисунок 5).
2.4 Потеря кворума
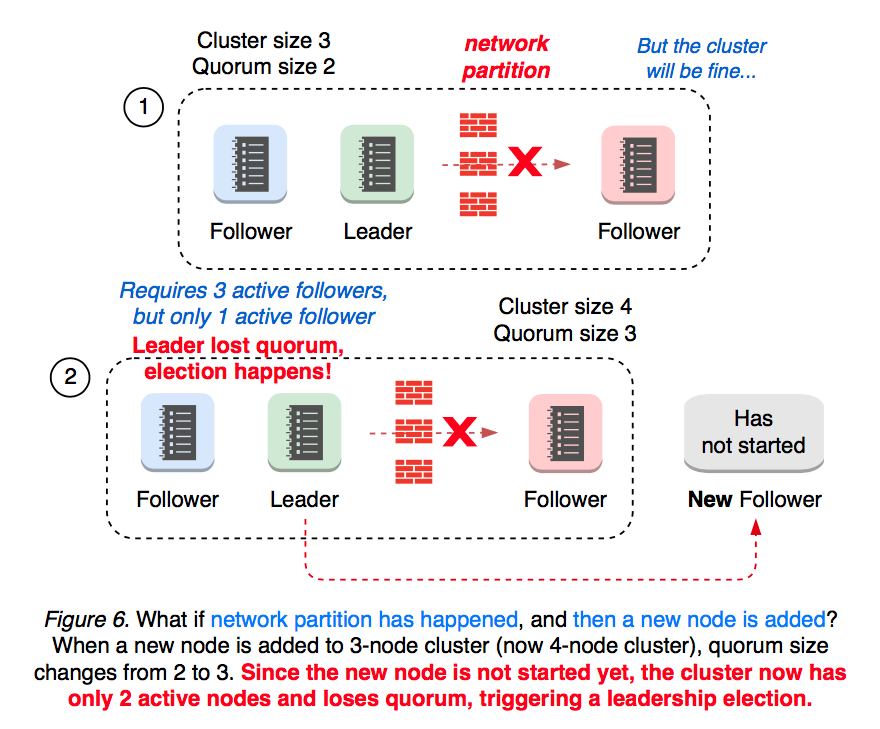
Что произойдёт, если сначала разделится сеть, а затем будет добавлен новый участник? В разделённом кластере из 3 узлов уже есть один отключённый последователь. После добавления участника кворум меняется с 2 на 3. Теперь в кластере активны только 2 узла из 4, поэтому он теряет кворум и начинает новые выборы лидера (см. рисунок 6).
Поскольку операция добавления участника может изменить размер кворума, при замене неисправного узла всегда рекомендуется сначала выполнить «member remove».
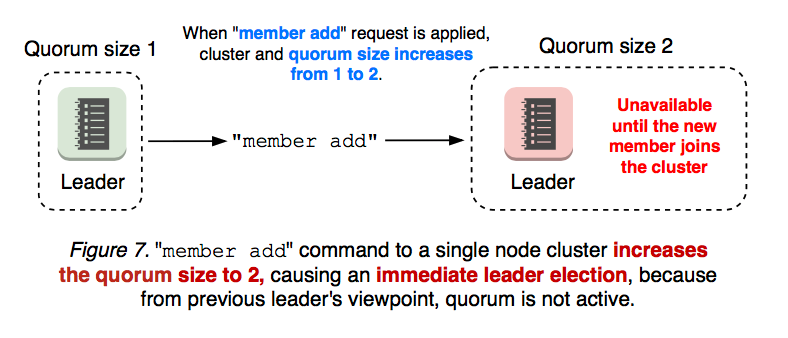
Добавление нового участника в кластер из 1 узла увеличивает размер кворума до 2 и немедленно вызывает выборы лидера, когда прежний лидер обнаруживает отсутствие активного кворума. Причина в том, что операция «member add» состоит из 2 этапов: пользователь сначала должен выполнить команду «member add», а затем запустить процесс нового узла (см. рисунок 7).
3. Ошибки конфигурации кластера
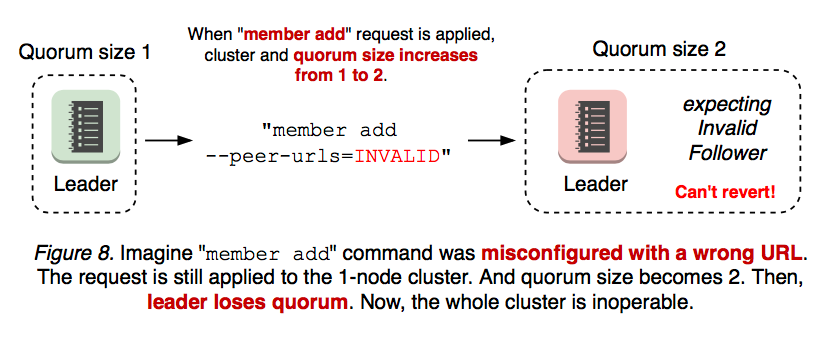
Ещё хуже, если добавленный участник настроен неверно. Изменение состава кластера состоит из двух этапов: «etcdctl member add» и запуск процесса сервера etcd с заданным URL однорангового узла. Иными словами, команда «member add» применяется независимо от URL, даже если его значение недопустимо. Если первый этап выполнен с недопустимыми URL, на втором этапе новый etcd даже не сможет запуститься. После потери кворума отменить изменение состава уже невозможно (см. рисунок 8).
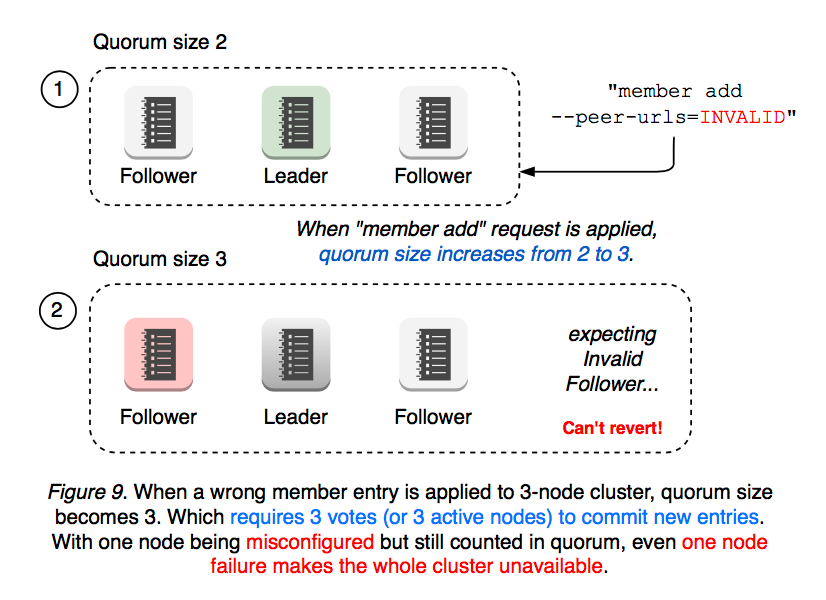
То же относится к многоузловому кластеру. Например, два участника кластера не работают (один отказал, другой настроен неверно), а ещё два работают, но для изменения состава теперь требуется не менее 3 голосов (см. рисунок 9).
Как показано выше, простая ошибка конфигурации способна привести весь кластер в неработоспособное состояние. В таком случае оператору приходится вручную пересоздавать кластер с флагом etcd --force-new-cluster. Поскольку etcd стал критически важной службой для Kubernetes, даже малейший сбой может существенно повлиять на пользователей. Как упростить подобные операции с etcd? Среди прочего для доступности кластера наиболее важны выборы лидера. Можно ли сделать изменение состава менее разрушительным, не меняя размер кворума? Может ли новый узел бездействовать и запрашивать у лидера лишь минимум обновлений, пока не догонит его? Можно ли гарантировать обратимость ошибок конфигурации состава и обрабатывать их безопаснее (неверная команда добавления участника никогда не должна выводить кластер из строя)? Должен ли пользователь учитывать топологию сети при добавлении нового участника? Может ли API добавления участника работать независимо от расположения узлов и текущих разделений сети?
Обучающийся участник Raft
Чтобы устранить описанные выше провалы доступности, Raft §4.2.1 вводит новое состояние узла «Learner», в котором узел присоединяется к кластеру как участник без права голоса, пока не догонит журнал лидера.
Возможности v3.4
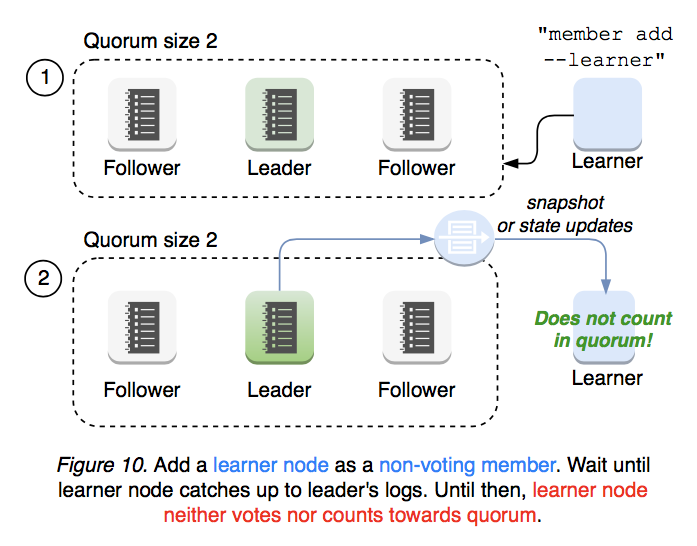
Для добавления нового обучающегося узла оператор должен выполнять как можно меньше действий. Команда member add --learner добавляет нового обучающегося участника, который присоединяется к кластеру без права голоса, но всё же получает все данные от лидера (см. рисунок 10).
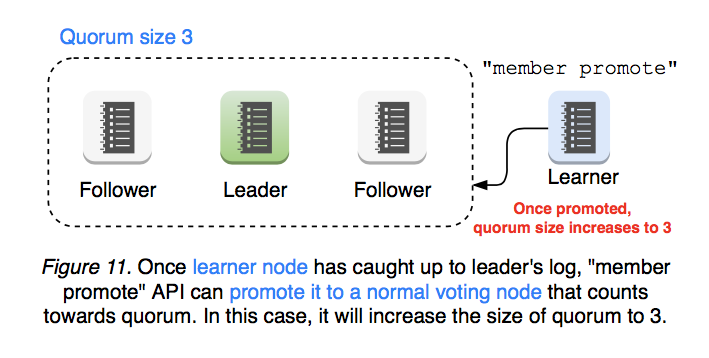
Когда обучающийся участник догоняет лидера, его можно повысить до участника с правом голоса с помощью API member promote; после этого он учитывается в кворуме (см. рисунок 11).
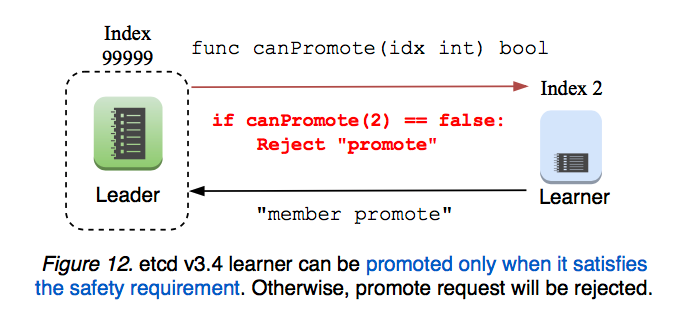
Сервер etcd проверяет запрос повышения, обеспечивая эксплуатационную безопасность. Обучающегося участника можно повысить до участника с правом голоса лишь после того, как его журнал догонит журнал лидера (см. рисунок 12).
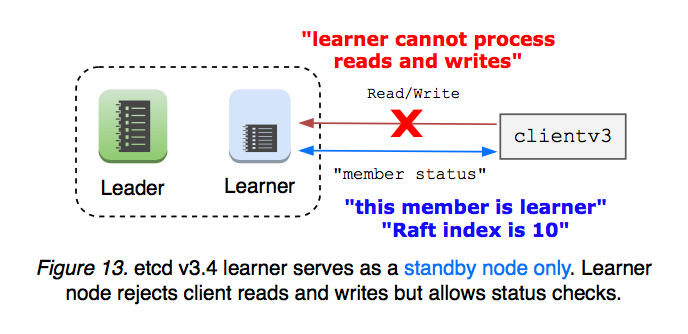
До повышения обучающийся участник служит только резервным узлом: передать ему лидерство нельзя. Он отклоняет клиентские операции чтения и записи (клиентский балансировщик не должен направлять к нему запросы). Следовательно, обучающемуся участнику не нужно отправлять лидеру запросы Read Index. Это ограничение упрощает первоначальную реализацию обучающегося участника в выпуске v3.4 (см. рисунок 13).
Кроме того, etcd ограничивает общее количество обучающихся участников в кластере, чтобы не перегружать лидера репликацией журнала. Обучающийся участник никогда не повышает себя самостоятельно. etcd предоставляет сведения о его состоянии и проверки безопасности, но окончательное решение о повышении должен принимать оператор кластера.
Предлагаемые возможности будущих выпусков
Сделать состояние обучающегося единственным и используемым по умолчанию: назначение новому участнику состояния обучающегося по умолчанию значительно повысит безопасность изменения состава, поскольку обучающийся участник не меняет размер кворума. Ошибку конфигурации всегда можно будет отменить без потери кворума.
Сделать повышение до участника с правом голоса полностью автоматическим: когда обучающийся участник догонит журнал лидера, кластер сможет автоматически его повысить. Пользователь должен будет задать определённые пороговые значения; после выполнения требований обучающийся участник самостоятельно повысится до участника с правом голоса. С точки зрения пользователя команда «member add» будет работать так же, как сегодня, но благодаря функции обучающегося участника станет безопаснее.
Сделать обучающегося участника резервным узлом переключения при отказе: обучающийся участник присоединяется как резервный узел и автоматически повышается, когда доступность кластера нарушается.
Сделать обучающегося участника доступным только для чтения: обучающийся участник может служить узлом только для чтения, который никогда не повышается. В режиме слабой согласованности он лишь получает данные от лидера и никогда не обрабатывает записи. Локальное обслуживание чтения без накладных расходов консенсуса существенно снизит нагрузку на лидера, но может возвращать устаревшие данные. В режиме строгой согласованности обучающийся участник запрашивает у лидера индекс чтения, чтобы обслуживать актуальные данные, но по-прежнему отклоняет записи.
Обучающийся участник и Mirror Maker
etcd реализует «mirror maker» с помощью API наблюдения, непрерывно передавая создания и обновления ключей в отдельный кластер. После первоначальной синхронизации зеркалирование обычно добавляет небольшую задержку. Обучающийся участник и зеркалирование частично пересекаются: оба подхода можно использовать для репликации существующих данных только для чтения. Однако зеркалирование не гарантирует линеаризуемость. Во время разрывов сети предыдущие пары «ключ — значение» могли быть отброшены, поэтому клиенты должны проверять правильность порядка в ответах наблюдения. Следовательно, зеркало не гарантирует порядок. Используйте зеркало для минимальной задержки (например, между центрами обработки данных) ценой согласованности. Используйте обучающегося участника, чтобы сохранить все исторические данные и их порядок.
Приложение: реализация обучающегося участника в v3.4
Предоставить тип узла “Learner” в API “MemberAdd”.
Клиент etcd добавляет в API «MemberAdd» флаг обучающегося узла. Обработчик сервера etcd применяет запись изменения состава с типом pb.ConfChangeAddLearnerNode. После применения команды сервер присоединяется к кластеру с флагом etcd --initial-cluster-state=existing. Этот обучающийся узел не может голосовать и не учитывается в кворуме.
Сервер etcd не должен передавать лидерство обучающемуся участнику: тот может всё ещё отставать и не учитывается в кворуме. Сервер etcd ограничивает количество обучающихся участников кластера одним: чем их больше, тем больше данных должен распространять лидер. Клиенты могут обращаться к обучающемуся узлу, но он отклоняет все запросы, кроме сериализуемого чтения и API состояния участника. Это сделано для простоты первоначальной реализации. В будущем обучающегося участника можно расширить до сервера только для чтения, непрерывно зеркалирующего данные кластера. Клиентский балансировщик должен предоставлять вспомогательную функцию для исключения конечной точки обучающегося узла. Иначе отправленный ему запрос может завершиться ошибкой. Клиентский вызов синхронизации участников должен учитывать тип обучающегося узла. То же относится к вызову обновления клиентских конечных точек.
Ответы MemberList и MemberStatus должны указывать, какой узел является обучающимся.
Добавить API “MemberPromote”.
На внутреннем уровне Raft второй вызов MemberAdd для обучающегося узла повышает его до участника с правом голоса. Лидер отслеживает прогресс каждого последователя и обучающегося участника. Если обучающийся участник не завершил обработку сообщения снимка, запрос повышения отклоняется. Запрос принимается тогда и только тогда, когда обучающийся узел исправен, а также синхронизирован с лидером либо разница не превышает порог (например, количество записей, которые нужно реплицировать обучающемуся участнику, меньше 1/10 количества снимка; тогда после повышения лидеру с меньшей вероятностью придётся отправлять ему снимок). Вся эта логика жёстко задана в пакете etcdserver и не настраивается.
Ссылки
- Исходная проблема GitHub: etcd#9161
- Сценарий использования: etcd#3715
- Сценарий использования: etcd#8888
- Сценарий использования: etcd#10114
4 - Конструкция аутентификации etcd v3
Почему не используется система аутентификации v2?
Вместо RESTful-интерфейса, как в v2, протокол v3 использует gRPC в качестве транспорта. Новый протокол даёт возможность развить и улучшить конструкцию v2. Например, аутентификация v3 выполняется для соединения, а не для каждого запроса, как более медленная аутентификация v2. Кроме того, на практике семантика аутентификации v2 неудобна для рассуждений о согласованности, что будет описано в следующих разделах. Для v3 существует чёткое описание и реализация механизма аутентификации, устраняющие недостатки системы v2.
Функциональные требования
- Аутентификация для соединения, а не для каждого запроса
- Для API gRPC реализована аутентификация по идентификатору пользователя и паролю
- После изменения политики аутентификацию необходимо обновлять
- Функциональность должна быть такой же простой и полезной, как в v2
- В отличие от структуры каталогов v2, v3 предоставляет плоское пространство ключей. Разрешения будут проверяться посредством сопоставления интервалов.
- Гарантии согласованности должны быть сильнее, чем у аутентификации v2
Основные необходимые изменения
- До отправки аутентифицированных запросов клиент должен создать отдельное соединение исключительно для аутентификации
- Добавить сведения о разрешениях (идентификатор пользователя и авторизованную ревизию) в команды Raft (
etcdserverpb.InternalRaftRequest) - Проверять разрешения каждого запроса на уровне конечного автомата, а не на уровне API
Согласованность метаданных разрешений
Метаданные аутентификации, как и другие данные etcd, также должны храниться и управляться в хранилище, контролируемом протоколом Raft etcd. Это необходимо, чтобы не жертвовать доступностью и согласованностью всего кластера etcd. Если для чтения или записи метаданных (например, сведений о разрешениях) требуется согласие каждого узла, а не только кворума, отказ одного узла может остановить весь кластер. Требование одновременного согласия всех узлов означает, что проверку обычных запросов чтения и записи невозможно завершить при недоступности любого участника, даже если кластер располагает кворумом. Такая единогласная схема в итоге снижает доступность кластера; консенсуса Raft на основе кворума должно быть достаточно, поскольку согласие следует из согласованного порядка.
В механизме аутентификации протокола etcd v2 есть сложность: согласованность метаданных должна работать описанным выше образом, но это не так. Каждая проверка разрешений обрабатывается участником etcd, получившим клиентский запрос (server/etcdserver/api/v2http/client.go), включая участников-последователей. Поэтому проверка может основываться на устаревших метаданных.
Эта устарелость означает, что конфигурация аутентификации не может отразиться сразу после выполнения операторами etcdctl. Поэтому невозможно определить, как долго остаются активны устаревшие метаданные. На практике изменение конфигурации отражается непосредственно после выполнения команды. Однако при высокой нагрузке несогласованное состояние иногда сохраняется дольше и может приводить к неочевидным для пользователей и разработчиков ситуациям. Требуется обходное решение наподобие этого .
Несогласованные разрешения небезопасны для линеаризованных запросов
Несогласованное состояние аутентификации особенно опасно для записи. Даже если оператор запретил пользователю запись, она может успешно завершиться, если упорядочена относительно хранилища ключей и значений, но не относительно системы аутентификации. Без упорядочивания как хранилища аутентификации, так и хранилища ключей и значений система будет уязвима для атак с устаревшими разрешениями.
Поэтому логику проверки разрешений следует добавить в конечный автомат etcd. Каждый конечный автомат должен проверять запросы по своим сведениям о разрешениях на фазе применения (следовательно, сведения об аутентификации не должны быть устаревшими).
Конструкция и реализация
Аутентификация
Сначала клиент должен создать соединение gRPC исключительно для аутентификации идентификатора пользователя и пароля. Сервер etcd отправляет ответ аутентификации: при успехе он содержит токен аутентификации, а при неудаче — ошибку. Клиент может предъявлять этот токен серверу etcd в качестве учётных данных при выполнении запросов API.
Клиентское соединение, использованное для запроса токена аутентификации, обычно закрывается: оно не может передавать учётные данные нового токена. Причина в том, что gRPC не позволяет добавить учётные данные отдельных RPC после создания соединения (вызова grpc.Dial()). Поэтому клиент не может назначить соединению токен, полученный через это же соединение. Для использования токена клиенту требуется новое соединение.
Примечания о реализации RPC Authenticate()
RPC Authenticate() создаёт токен аутентификации по заданному имени пользователя и паролю. etcd сохраняет настроенный пароль и проверяет переданный пароль с помощью пакета Go bcrypt. Механизм проверки пароля bcrypt намеренно требует значительных вычислительных ресурсов и занимает около 100ms на обычном сервере x64. Поэтому выполнение этой проверки в фазе применения конечного автомата создало бы проблемы с производительностью: весь кластер etcd мог бы обслуживать лишь около 10 запросов Authenticate() в секунду.
Для высокой производительности механизм аутентификации v3 проверяет пароли на уровне API etcd, где проверку можно распараллелить вне Raft. Однако это способно привести к потенциальным нарушениям разрешений типа «время проверки — время использования» (TOCTOU):
- клиент A отправляет запрос
Authenticate() - уровень API выполняет часть
Authenticate()с проверкой пароля - другой клиент B отправляет запрос
ChangePassword(), и сервер завершает его - уровень конечного автомата выполняет часть получения номера ревизии для
Authenticate()от A - сервер возвращает A успешный результат
- теперь A аутентифицирован по устаревшему паролю
Чтобы избежать такой ситуации, уровень API выполняет проверку номера версии на основе номера ревизии хранилища аутентификации. Во время проверки пароля уровень API сохраняет номер ревизии хранилища. После успешной проверки пароля он сравнивает сохранённый номер с последним номером ревизии. Если номера различаются, значит кто-то обновил метаданные аутентификации, и проверка выполняется повторно. Этот механизм предотвращает успешную проверку устаревшего пароля.
Разрешение токена на уровне API
После аутентификации с помощью Authenticate() клиент может создать соединение gRPC так же, как без аутентификации. Помимо обычной инициализации клиент должен связать токен с вновь созданным соединением. Для этого служит grpc.WithPerRPCCredentials().
Каждый аутентифицированный запрос клиента содержит токен. На стороне сервера его можно получить с помощью grpc.metadata.FromIncomingContext(). Сервер может определить, кто отправляет запрос и когда пользователь был авторизован. Уровень API заполняет эти сведения в заголовке (etcdserverpb.RequestHeader.Username и etcdserverpb.RequestHeader.AuthRevision) записи журнала Raft (etcdserverpb.InternalRaftRequest).
Проверка разрешения в конечном автомате
Сведения об аутентификации в etcdserverpb.RequestHeader проверяются на фазе применения конечного автомата. На этом шаге проверяется, предоставлено ли пользователю разрешение на запрошенные ключи в последней ревизии хранилища аутентификации.
Два типа токенов: simple и JWT
Существует два типа токенов: simple и JWT. Токен simple не предназначен для рабочих сценариев. Такие токены не подписаны криптографически, а серверы должны хранить состояние соответствия токенов пользователям; этот тип предназначен для тестирования при разработке. В рабочих развёртываниях следует использовать токены JWT, поскольку они подписываются и проверяются криптографически. С точки зрения реализации JWT не сохраняет состояние. Токен может содержать метаданные, включая имя пользователя и ревизию, поэтому серверам не нужно помнить соответствие между токенами и метаданными.
Для токенов simple известна проблема #18437 . В серверах etcd токены разрешаются на уровне API, а токены simple сохраняют состояние. Процесс не защищён линеаризуемой проверкой: участник etcd может не успеть завершить обработку предыдущего запроса аутентификации до получения следующего. В таких случаях участник может вернуть клиенту ошибку “invalid auth token”. На узле с хорошими сетевыми условиями проблема обычно возникает редко, но возможна при значительной задержке. В качестве обходного решения приложения могут реализовать повторные попытки обработки этой ошибки.
Непосредственная установка токенов JWT
Помимо стандартного потока RPC Authenticate(), etcd поддерживает непосредственную установку токенов JWT на уровне клиента. Это позволяет приложениям управлять полным жизненным циклом токенов JWT вне etcd, включая создание, проверку и ротацию токенов.
Сценарий использования и рабочий процесс
Этот подход полезен, когда:
- Отдельная система управления токенами (вне etcd) отвечает за создание и жизненный цикл токенов JWT
- Приложения получают заранее подписанные токены JWT через внешний механизм (например, переменные окружения или службу конфигурации)
- Жизненным циклом токена должно полностью управлять клиентское приложение, а не автоматическое создание токенов в etcd
Типичный рабочий процесс:
- Внешний доверенный центр (не etcd) создаёт подписанный токен JWT, содержащий имя пользователя и другие утверждения
- Приложение получает заранее подписанный токен и настраивает с ним клиент etcd
- Клиент отправляет токен JWT непосредственно с запросами (не вызывая
Authenticate()) - Сервер etcd проверяет подпись токена с помощью настроенного открытого ключа и предоставляет доступ на основе имени пользователя в токене
- До истечения срока токена приложение получает новый токен от внешнего доверенного центра
- Приложение создаёт новый клиент с обновлённым токеном (для обновления токена клиент необходимо пересоздать)
Отличия от стандартной аутентификации
При использовании стандартного потока Authenticate():
- Клиент вызывает
Authenticate()с именем пользователя и паролем - etcd создаёт и возвращает токен
- Клиент автоматически использует этот токен для последующих запросов
- Для обновления токена требуется снова вызвать
Authenticate()
При непосредственной установке токенов JWT:
- Клиент инициализируется с заранее подписанным токеном JWT
- Клиент не вызывает
Authenticate() - Токен используется непосредственно во всех запросах
- Клиентское приложение отвечает за получение новых токенов до истечения срока и управление жизненным циклом клиента
AuthStatus без действительного токена
Для поддержки приложений, самостоятельно управляющих токенами JWT, RPC AuthStatus позволяет клиентам определить, включена ли аутентификация, и получить текущую authRevision. Это важно для сценариев восстановления, когда срок токена истёк и клиенту требуется последняя ревизия, чтобы получить новый действительный токен от внешнего поставщика токенов.
Без этой возможности токен с истёкшим сроком мог бы помешать клиенту узнать текущую authRevision, создав взаимоблокировку, при которой невозможно создать новый токен.
Примечания о различиях между моделями KVS и файловой системы
etcd v3 — это KVS, а не файловая система. Поэтому разрешения пользователям можно предоставлять в форме точного имени ключа или диапазона ключей, например ["start key", "end key"). Это позволяет предоставить разрешение для несуществующего ключа. Пользователям следует учитывать возможность непреднамеренного предоставления разрешений. В системе, подобной файловой (например, Chubby или ZooKeeper), структура данных наподобие inode может содержать сведения о разрешениях. Поэтому предоставить разрешение для несуществующего ключа невозможно (за исключением случая sticky bits).
В отличие от систем, подобных файловой, модель etcd v3 требует нескольких поисков метаданных. В худшем случае стоимость поиска равна сумме всех ключей и интервалов, разрешённых пользователю. Избежать этих затрат нельзя, поскольку плоское пространство ключей v3 полностью отличается от модели файловой системы Unix (каждый inode содержит метаданные разрешений). На практике затраты не станут серьёзной проблемой, поскольку метаданные достаточно малы для эффективного кэширования.
5 - API etcd
Этот документ содержит обзор основной конструкции API etcd v3. Не следует путать его с API etcd v2, объявленным устаревшим в etcd v3.5. Документ не претендует на полноту, а сосредоточен на основных идеях, необходимых для понимания etcd, без отвлечения на менее распространённые вызовы API. Все API etcd определены в службах gRPC , которые группируют удалённые вызовы процедур (RPC), распознаваемые сервером etcd. Полный перечень RPC etcd приведён в формате Markdown в справочнике API gRPC .
Службы gRPC
Каждый запрос API, отправленный серверу etcd, является удалённым вызовом процедуры gRPC. RPC в etcd объединяются в службы по назначению.
К важным для работы с пространством ключей etcd службам относятся:
- KV — создаёт, обновляет, получает и удаляет пары «ключ — значение».
- Watch — отслеживает изменения ключей.
- Lease — предоставляет примитивы для обработки клиентских сообщений поддержания активности.
К службам управления самим кластером относятся:
- Auth — механизм аутентификации пользователей на основе ролей.
- Cluster — предоставляет сведения о составе кластера и средства конфигурации.
- Maintenance — создаёт снимки для восстановления, дефрагментирует хранилище и возвращает сведения о состоянии отдельных участников.
Запросы и ответы
Все RPC в etcd имеют одинаковый формат. Каждый RPC содержит функцию Name, которая принимает NameRequest как аргумент и возвращает NameResponse как ответ. Например, RPC Range описывается следующим образом:
Заголовок ответа
Все ответы API etcd содержат заголовок с метаданными кластера для данного ответа:
- Cluster_ID — идентификатор кластера, создавшего ответ.
- Member_ID — идентификатор участника, создавшего ответ.
- Revision — ревизия хранилища ключей и значений на момент создания ответа.
- Raft_Term — срок полномочий Raft участника на момент создания ответа.
Приложение может прочитать поле Cluster_ID или Member_ID, чтобы убедиться, что взаимодействует с предполагаемым кластером (участником).
По полю Revision приложения могут узнать последнюю ревизию хранилища ключей и значений. Это особенно полезно, когда приложение задаёт историческую ревизию для time travel query и хочет определить последнюю ревизию на момент запроса.
С помощью Raft_Term приложения могут определить момент завершения новых выборов лидера в кластере.
API ключей и значений
API ключей и значений управляет парами «ключ — значение», хранящимися в etcd. Обычно большинство запросов к etcd относится именно к ним.
Системные примитивы
Пара «ключ — значение»
Пара «ключ — значение» — минимальная единица, которой может управлять соответствующий API. Каждая пара содержит ряд полей, определённых в формате protobuf :
- Key — ключ в байтах. Пустой ключ недопустим.
- Value — значение в байтах.
- Version — версия ключа. Удаление сбрасывает её в ноль, а любое изменение ключа увеличивает версию.
- Create_Revision — ревизия последнего создания ключа.
- Mod_Revision — ревизия последнего изменения ключа.
- Lease — идентификатор аренды, присоединённой к ключу. Если lease равен 0, аренда к ключу не присоединена.
Помимо ключа и значения etcd добавляет в сообщение ключа метаданные ревизии. Они упорядочивают ключи по времени создания и изменения, что полезно для управления параллелизмом при распределённой синхронизации. Распределённые совместные блокировки клиента etcd используют ревизию создания при ожидании владения блокировкой. Аналогично, ревизия изменения применяется для обнаружения конфликтов набора чтения программной транзакционной памяти и ожидания обновлений выборов лидера .
Ревизии
etcd поддерживает общий для кластера 64-битный счётчик — ревизию хранилища, которая увеличивается при каждом изменении пространства ключей. Ревизия служит глобальными логическими часами, последовательно упорядочивающими все обновления хранилища. Изменение, представленное новой ревизией, является инкрементным: связанные с ревизией данные — это данные, изменившие хранилище. На внутреннем уровне новая ревизия означает запись изменений в B+tree бэкенда с увеличенной ревизией в качестве ключа.
Особую ценность ревизии приобретают в бэкенде etcd с многоверсионным управлением параллелизмом . Модель MVCC позволяет просматривать хранилище ключей и значений на прошлых ревизиях, поскольку исторические ревизии ключей сохраняются. Администраторы кластера могут настроить политику хранения этой истории для точного управления хранилищем; обычно etcd удаляет старые ревизии ключей по таймеру. Типичный кластер etcd хранит замещённые данные ключей несколько часов. Это также обеспечивает надёжную обработку длительных отключений клиентов, а не только временных сетевых сбоев: наблюдатели просто продолжают работу с последней замеченной исторической ревизии. Аналогично, для чтения хранилища в определённый момент запрос чтения можно пометить ревизией, чтобы вернуть ключи из представления пространства на момент фиксации этой ревизии.
Диапазоны ключей
Модель данных etcd индексирует все ключи в плоском двоичном пространстве. Этим она отличается от других хранилищ ключей и значений, использующих иерархическую организацию ключей в каталогах. Вместо перечисления по каталогам ключи перечисляются по интервалам [a, b).
В etcd эти интервалы часто называют «диапазонами». Операции над диапазонами мощнее операций над каталогами. Подобно иерархическому хранилищу, интервалы поддерживают поиск одного ключа через [a, a+1) (например, [‘a’, ‘a\x00’) ищет ‘a’) и поиск в каталоге посредством кодирования ключей по глубине каталога. Кроме того, интервалы могут кодировать префиксы: например, интервал ['a', 'b') ищет все ключи с префиксом ‘a’.
По соглашению диапазон запроса обозначается полями key и range_end. Поле key содержит первый ключ диапазона и не должно быть пустым. range_end — ключ, следующий за последним ключом диапазона. Если range_end не задан или пуст, диапазон содержит только аргумент key. Если range_end равен key плюс один (например, “aa”+1 == “ab”, “a\xff”+1 == “b”), диапазон представляет все ключи с префиксом key. Если и key, и range_end равны ‘\0’, диапазон представляет все ключи. Если ‘\0’ равен только range_end, диапазон содержит все ключи, большие либо равные аргументу key.
Range
Ключи извлекаются из хранилища ключей и значений вызовом API Range, принимающим RangeRequest:
- Key, Range_End — диапазон извлекаемых ключей.
- Limit — максимальное количество ключей в ответе. Значение limit, равное 0, означает отсутствие ограничения.
- Revision — момент состояния хранилища ключей и значений для диапазона. Если revision меньше или равна нулю, диапазон относится к последнему состоянию хранилища. Если ревизия компактизирована, возвращается ответ ErrCompacted.
- Sort_Order — порядок для отсортированных запросов.
- Sort_Target — поле пары «ключ — значение» для сортировки.
- Serializable — задаёт использование сериализуемого локального чтения с участника для диапазонного запроса. По умолчанию Range линеаризуем и отражает текущий консенсус кластера. Ради повышения производительности и доступности ценой возможного чтения устаревших данных сериализуемый запрос диапазона обслуживается локально без достижения консенсуса с другими узлами кластера.
- Keys_Only — возвращать только ключи без значений.
- Count_Only — возвращать только количество ключей в диапазоне.
- Min_Mod_Revision — нижняя граница ревизий изменения ключей; меньшие ревизии отфильтровываются.
- Max_Mod_Revision — верхняя граница ревизий изменения ключей; большие ревизии отфильтровываются.
- Min_Create_Revision — нижняя граница ревизий создания ключей; меньшие ревизии отфильтровываются.
- Max_Create_Revision — верхняя граница ревизий создания ключей; большие ревизии отфильтровываются.
В ответ на вызов Range клиент получает сообщение RangeResponse:
- Kvs — список пар «ключ — значение», соответствующих диапазонному запросу. При заданном
Count_OnlyполеKvsпусто. - More — при заданном
limitуказывает, остались ли в запрошенном диапазоне ключи для возврата. - Count — общее количество ключей, удовлетворяющих диапазонному запросу.
Для больших диапазонов ключей, когда буферизация полного ответа нежелательна, используйте RangeStream .
RangeStream
RangeStream возвращает тот же набор результатов, что и Range, однако сервер разбивает ответ на последовательность фрагментов и передаёт их клиенту потоком. Благодаря этому ни одной стороне не нужно целиком буферизовать большие диапазоны в памяти. RangeStream принимает тот же RangeRequest, что и Range.
В ответ на вызов RangeStream клиент получает поток сообщений RangeStreamResponse:
Заполнение полей во фрагментах:
- Kvs — каждый фрагмент содержит непересекающуюся часть результата. Объединение
kvsвсех фрагментов в порядке получения даёт тот же набор ключей, что и один вызовRange. - Header, More, Count — заполняются только в последнем фрагменте и лишь при завершении потока без ошибки. В предыдущих фрагментах эти поля имеют нулевые значения. Применение
proto.Mergeко всемrange_responseфрагментов даётRangeResponse, эквивалентный ответуRange.
Если поток завершается ошибкой, ни один фрагмент не содержит действительных header, more или count.
Все фрагменты потока обслуживаются относительно одной ревизии. Если запрос не задаёт Revision, при запуске потока сервер фиксирует последнюю зафиксированную ревизию и использует её до конца потока.
RangeStream не поддерживает пользовательские порядки сортировки и фильтры ревизий (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Использующие их запросы возвращают Unimplemented. Прокси gRPC etcd также не поддерживает RangeStream.
Существует два распространённых способа обработки RangeStream:
- Обрабатывать каждый фрагмент независимо. Подходит для высокопроизводительных сценариев, когда клиент хочет декодировать и обрабатывать ключи по мере поступления, а не сначала собирать весь результат. Клиент перебирает фрагменты и обрабатывает
kvsкаждого, а после успешного завершения потока читаетheader,moreилиcountиз последнего фрагмента. - Собрать единый ответ. Подходит, когда клиенту требуется результат, эквивалентный унарному
Range. Клиент объединяетrange_responseкаждого фрагмента в одинRangeResponse(например, черезproto.Merge). Объединённый результат содержит полныйkvs, а такжеheader,moreиcountиз последнего фрагмента. Для этого шаблона клиент Go предоставляет вспомогательную функциюclientv3.GetStreamToGetResponse.
Put
Ключи сохраняются в хранилище ключей и значений вызовом Put, принимающим PutRequest:
- Key — имя ключа, записываемого в хранилище ключей и значений.
- Value — значение в байтах, связываемое с ключом в хранилище.
- Lease — идентификатор аренды, связываемой с ключом. Значение аренды 0 означает отсутствие аренды.
- Prev_Kv — если задано, в ответе возвращаются данные пары «ключ — значение» до обновления запросом
Put. - Ignore_Value — если задано, ключ обновляется без изменения текущего значения. Если ключ не существует, возвращается ошибка.
- Ignore_Lease — если задано, ключ обновляется без изменения текущей аренды. Если ключ не существует, возвращается ошибка.
В ответ на вызов Put клиент получает сообщение PutResponse:
- Prev_Kv — пара «ключ — значение», перезаписанная операцией
Put, если вPutRequestбыло заданоPrev_Kv.
Удаление диапазона
Диапазоны ключей удаляются вызовом DeleteRange, принимающим DeleteRangeRequest:
- Key, Range_End — удаляемый диапазон ключей.
- Prev_Kv — если задано, возвращает содержимое удалённых пар «ключ — значение».
В ответ на вызов DeleteRange клиент получает сообщение DeleteRangeResponse:
- Deleted — количество удалённых ключей.
- Prev_Kv — список всех пар «ключ — значение», удалённых операцией
DeleteRange.
Транзакция
Транзакция — атомарная конструкция If/Then/Else над хранилищем ключей и значений. Она предоставляет примитив для объединения запросов в атомарные блоки (then/else), выполнение которых защищено условием (if), основанным на содержимом хранилища. Транзакции позволяют защищать ключи от непреднамеренных параллельных обновлений, строить операции сравнения с обменом и создавать механизмы управления параллелизмом более высокого уровня.
Транзакция может атомарно обработать несколько запросов в одном запросе. При изменении хранилища его ревизия увеличивается только один раз на транзакцию, а все созданные ею события имеют одинаковую ревизию. Однако многократное изменение одного ключа в рамках одной транзакции запрещено.
Все транзакции защищены конъюнкцией сравнений, подобной оператору If. Каждое сравнение проверяет один ключ в хранилище: отсутствие или наличие значения, равенство заданному значению либо ревизию или версию ключа. Два разных сравнения могут относиться к одному или разным ключам. Все сравнения применяются атомарно. Если они истинны, транзакция считается успешной и etcd применяет блок запросов then / success; иначе транзакция считается неудачной и применяется блок else / failure.
Каждое сравнение кодируется сообщением Compare:
- Result — тип логической операции сравнения (например, равно, меньше и т. д.).
- Target — сравниваемое поле пары «ключ — значение»: версия ключа, ревизия создания, ревизия изменения либо значение.
- Key — ключ для сравнения.
- Target_Union — заданные пользователем данные сравнения.
После обработки блока сравнений транзакция применяет блок запросов. Блок представляет собой список сообщений RequestOp:
- Request_Range —
RangeRequest. - Request_Put —
PutRequest. Ключи должны быть уникальны и не могут пересекаться с ключами других операций Put или Delete. - Request_Delete_Range —
DeleteRangeRequest. Ключи не могут пересекаться с ключами запросов Put или Delete.
В итоге транзакция выполняется вызовом API Txn, принимающим TxnRequest:
- Compare — список предикатов, представляющих конъюнкцию условий защиты транзакции.
- Success — список запросов, обрабатываемых, если все сравнения истинны.
- Failure — список запросов, обрабатываемых, если хотя бы одно сравнение ложно.
В ответ на вызов Txn клиент получает сообщение TxnResponse:
- Succeeded — результат вычисления
Compare: true или false. - Responses — список ответов, соответствующих результатам применения блока
Success, если succeeded равно true, либо блокаFailure, если succeeded равно false.
Список Responses соответствует результатам применённого списка RequestOp, причём каждый ответ кодируется как ResponseOp:
Включённый в каждый внутренний ответ ResponseHeader не следует интерпретировать каким-либо образом.
Если клиенту нужна последняя ревизия, он всегда должен проверять верхнеуровневый ResponseHeader в TxnResponse.
API наблюдения
API Watch предоставляет событийный интерфейс для асинхронного отслеживания изменений ключей. Наблюдение etcd ожидает изменения, непрерывно отслеживая ключи с заданной текущей или исторической ревизии, и потоком отправляет обновления клиенту.
События
Каждое изменение любого ключа представлено сообщением Event. Сообщение Event содержит данные и тип обновления:
- Type — тип события. PUT означает сохранение новых данных по ключу, DELETE — удаление ключа.
- KV — связанный с событием KeyValue. Событие PUT содержит текущую пару kv. PUT с kv.Version=1 означает создание ключа. DELETE содержит удалённый ключ, у которого ревизия изменения равна ревизии удаления.
- Prev_KV — пара «ключ — значение» из ревизии непосредственно перед событием. Для экономии пропускной способности заполняется, только если явно включена в наблюдении.
Потоки наблюдения
Наблюдения — длительные запросы, использующие потоки gRPC для передачи данных событий. Поток наблюдения двунаправлен: клиент записывает в него для создания наблюдений и читает для получения событий. Один поток может мультиплексировать множество отдельных наблюдений, помечая события их идентификаторами. Это снижает потребление памяти и накладные расходы соединений в основном кластере etcd.
Гарантии для событий наблюдения описаны в разделе гарантии API etcd .
Клиент создаёт наблюдение, отправляя WatchCreateRequest через поток, возвращённый Watch:
- Key, Range_End — наблюдаемый диапазон ключей.
- Start_Revision — необязательная ревизия, с которой включительно начинается наблюдение. Если не задана, поток передаёт события после ревизии из заголовка ответа о создании наблюдения. Всю доступную историю событий можно наблюдать с последней ревизии компактизации.
- Progress_Notify — если задано и недавних событий нет, наблюдение периодически получает WatchResponse без событий. Это полезно для восстановления отключённого наблюдателя с недавней известной ревизии. Сервер etcd выбирает частоту уведомлений по текущей нагрузке.
- Filters — список типов событий, отфильтровываемых на стороне сервера.
- Prev_Kv — если задано, наблюдение получает данные пары «ключ — значение» до события. Это позволяет узнать, какие данные были перезаписаны.
В ответ на WatchCreateRequest либо при появлении нового события для созданного наблюдения клиент получает WatchResponse:
- Watch_ID — идентификатор наблюдения, соответствующего ответу.
- Created — равно true, если это ответ на запрос создания наблюдения. Клиент должен сохранить идентификатор и ожидать события наблюдения в потоке. Все отправленные созданному наблюдателю события имеют одинаковый watch_id.
- Canceled — равно true, если это ответ на запрос отмены наблюдения. Отменённому наблюдателю больше не отправляются события.
- Compact_Revision — минимальная доступная etcd историческая ревизия, если наблюдатель пытается начать с компактизированной ревизии. Такое происходит при создании наблюдателя на компактизированной ревизии или когда наблюдатель не успевает за изменениями хранилища. Наблюдатель отменяется; создание новых наблюдений с тем же start_revision завершится ошибкой.
- Events — упорядоченный список новых событий, соответствующих данному идентификатору наблюдения.
Чтобы прекратить получение событий наблюдения, клиент отправляет WatchCancelRequest:
- Watch_ID — идентификатор отменяемого наблюдения, которому больше не будут передаваться события.
API аренды
Аренды служат механизмом определения активности клиента. Кластер выдаёт аренды со сроком жизни. Аренда истекает, если кластер etcd не получает keepAlive в течение заданного периода TTL.
Для связи аренд с хранилищем каждый ключ можно присоединить не более чем к одной аренде. При истечении или отзыве аренды все присоединённые ключи удаляются. Каждый истёкший ключ создаёт событие удаления в истории событий.
Получение аренд
Аренды получают вызовом API LeaseGrant, принимающим LeaseGrantRequest:
- TTL — рекомендуемый срок жизни в секундах.
- ID — запрошенный идентификатор аренды. Если ID равен 0, etcd выбирает идентификатор самостоятельно.
В ответ на вызов LeaseGrant клиент получает LeaseGrantResponse:
- ID — идентификатор выданной аренды.
- TTL — выбранный сервером срок жизни аренды в секундах.
- ID — идентификатор отзываемой аренды. При отзыве все присоединённые ключи удаляются.
Поддержание активности
Аренды обновляются через двунаправленный поток, созданный вызовом API LeaseKeepAlive. Чтобы обновить аренду, клиент отправляет через поток LeaseKeepAliveRequest:
- ID — идентификатор аренды, активность которой поддерживается.
Поток поддержания активности отвечает сообщением LeaseKeepAliveResponse:
- ID — аренда, обновлённая с новым TTL.
- TTL — новый оставшийся срок жизни аренды в секундах.
6 - Файлы постоянного хранилища etcd
В этом документе описан формат постоянного хранилища etcd: именование, содержимое и инструменты, позволяющие разработчикам исследовать файлы. В дальнейшем документ следует дополнять по мере изменений модели хранения. Он предназначен для разработчиков etcd и помогает при восстановлении данных.
Предварительные сведения
Для понимания документа полезны следующие вводные материалы:
- обзор модели данных etcd
- обзор Raft (особенно раздел “5.3 Log replication”).
Обзор
Долгоживущие файлы
| Имя файла | Высокоуровневое назначение |
|---|---|
./member/snap/db | b+tree bbolt, хранящее все применённые данные, сведения об авторизации состава кластера и метаданные. Оно знает последний применённый индекс журнала WAL ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | Периодические снимки устаревшего хранилища v2, содержащие:
Начиная с etcd v3 их содержимое дублирует содержимое файлов /snap/db. Периодически (каждые 30s) эти файлы удаляются, при этом сохраняются последние |
/member/snap/000000000007a178.snap.db | Полный загруженный снимок bbolt с лидера etcd, если реплика отставала слишком сильно. Содержит данные того же типа, что и файл ( Файл используется в 2 сценариях:
Файл не удаляется после завершения восстановления, когда всё его содержимое перенесено в ./member/snap/db. Периодически (каждые 30s) файлы удаляются.
Здесь также сохраняются последние |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Журналы предзаписи Raft, содержащие недавние транзакции, принятые Raft, периодические снимки или записи CRC. Сохраняются последние Если снимки создаются слишком редко, файлов может быть больше |
./member/wal/0.tmp (or .../1.tmp) | Предварительно выделенное пространство для следующего файла журнала предзаписи. Позволяет не допустить остановки Raft из-за нехватки места для журналов WAL без возможности активировать аварийный сигнал. |
Временные файлы
Во время внутренней обработки etcd могут встречаться несколько краткоживущих файлов:
| Файл | Высокоуровневое назначение |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | Файлы снимков переименовываются в ‘broken’, если их невозможно загрузить. Попытка загрузить самый новый файл выполняется при запуске etcd. Либо при выполнении команд backup/migrate в etcdctl. |
./member/snap/tmp071677638 (random suffix) | Временный файл bbolt, создаваемый на репликах в ответ на запрос лидера msgSnap, то есть на требование лидера восстановить хранилище из заданного снимка. После успешного полного получения содержимого файл переименовывается в См. etcd/issues/12837. Исправлено в etcd 3.5. |
/member/snap/db.tmp.071677638 (random suffix) | Временный файл, содержащий копию содержимого бэкенда (/member/snap/db) во время дефрагментации. После её успешного завершения файл переименовывается в /member/snap/db и заменяет исходный бэкенд. При запуске сервера etcd эти файлы удаляются. |
b+tree bbolt: member/snap/db
Этот файл содержит основное содержимое etcd, применённое до определённой точки журнала Raft (см. consistent_index ).
Физическая организация
Физически хранилище better bolt организовано как b+tree
. Физические страницы b-tree никогда не изменяются на месте1. Вместо этого содержимое копируется на новую страницу, полученную из списка свободных, а старая страница добавляется в список свободных, как только не остаётся открытых транзакций, способных к ней обратиться. Благодаря этому открытая транзакция RO видит согласованное историческое состояние хранилища. Транзакция RW является исключительной и блокирует все остальные транзакции RW.
Большие значения хранятся на нескольких непрерывных страницах. Освобождение страниц в сочетании с необходимостью выделять непрерывные области страниц разного размера может усиливать фрагментацию хранилища bbolt.
Файл bbolt сам по себе никогда не уменьшается. Только при дефрагментации его можно переписать в новый файл с некоторым запасом свободных страниц в конце и усечённым размером.
Логическая организация
Хранилище bbolt разделено на сегменты. В каждом сегменте ключи (пары byte[]->value byte[]) хранятся в лексикографическом порядке. Ниже перечислены сегменты, используемые etcd по состоянию на версию 3.5, и задействованные ключи.
| Сегмент | Ключ | Пример значения | Описание |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT} | nil | Указывает, что у одного из участников диагностированы проблемы. |
| auth | "authRevision" | "" (empty) or BigEndian.PutUint64 | Любое изменение ролей или пользователей увеличивает это поле при фиксации транзакции. Значение используется только для оптимистической блокировки во время авторизации. |
| authRoles | [roleName] в виде строки | сериализованный authpb.Role | |
| authUsers | [userName] в виде строки | сериализованный authpb.User | |
| cluster | "clusterVersion" | "3.5.0" (string) | Дополнительная версия общей версии хранилища, согласованной консенсусом. |
| "downgrade" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | Сохраняет намерение, заданное последним запросом Начиная с v3.5 | |
| key | [revisionId], закодированный с помощью bytesToRev{main,sub} Удаления пар «ключ — значение» сериализуются с 't' в конце (как "Tombstone") | сериализованный proto mvccpb.KeyValue (key, create_rev, mod_rev, version, value, lease id) | |
| lease | сериализованный proto leasepb.Lease (ID, TTL, RemainingTTL) | Примечание: LeaseCheckpoint продлевает только RemainingTTL. TTL берётся из исходного Grant. Примечание 2: TTL сохраняются в секундах (от неопределённого 'now'). Сервер в цикле аварийных перезапусков не освобождает аренды!!! | |
| members | [memberId] в шестнадцатеричном виде как строка: "8e9e05c52164694d" | Структура Member, сериализованная в JSON как строка:{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | Согласованные сведения о составе кластера. |
| members_removed | [memberId] в шестнадцатеричном виде как строка: "8e9e05c52164694d" | []byte("removed") | Идентификаторы всех удалённых участников. Используются для проверки, что удалённый участник никогда не добавляется снова с тем же идентификатором. Сейчас (3.4) поле читается из хранилища V2 и никогда из V3. См. https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | байты uint64 (BigEndian) | Представляет смещение последней записи WAL, применённой к хранилищу БД bolt. |
| "scheduledCompactRev" | закодированный bytesToRev{main,sub}. (16 байтов) | Используется для повторной инициализации компактизации, если после её запроса произошёл сбой. | |
| "finishedCompactRev" | закодированный bytesToRev{main,sub}. (16 байтов) | Ревизия, на которой недавно успешно компактизировано хранилище (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Начиная с etcd 3.5 | ||
| "term" | Начиная с etcd 3.5 | ||
| "storage-version" |
Инструменты
bbolt
bbolt предоставляет инструмент командной строки для исследования содержимого файла.
Примеры использования:
Перечисление всех сегментов заданного файла bbolt:
Чтение определённой пары «ключ — значение»:
etcd-dump-db
etcd-dump-db позволяет перечислить содержимое бэкенда etcd v3 (bbolt).
Дополнительные примеры: https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL: журнал предзаписи
Журнал предзаписи — постоянное хранилище Raft для предложений. Сначала лидер сохраняет предложение в своём журнале, а затем параллельно реплицирует его последователям по протоколу Raft. Каждый последователь сохраняет предложение в своём WAL, прежде чем подтвердить репликацию лидеру.
Используемый в etcd журнал WAL отличается от канонической модели Raft по 2 признакам:
- Он сохраняет не только индексированные записи, но также облегчённые снимки Raft и hard-state. Поэтому полное состояние Raft участника можно восстановить только из журнала WAL.
- Он доступен только для добавления. Записи не перезаписываются на месте: добавленная позднее в файл запись с тем же индексом замещает предыдущую.
Имена файлов
Файлы журнала WAL именуются по следующему шаблону:
Пример: ./member/wal/0000000000000010-00000000000bf1e6.wal
Таким образом, имя файла содержит в шестнадцатеричной кодировке:
- Порядковый номер файла журнала WAL
- Индекс первой записи или снимка в файле. В частности, первый файл “0000000000000000-0000000000000000.wal” содержит запись исходного снимка с index=0.
Физическое содержимое
Файл журнала WAL содержит последовательность «кадров ». Каждый кадр содержит:
- Закодированное в LittleEndian 2 значение uint64, содержащее длину сериализованной walpb.Record (3).
- Заполнение: некоторое количество байтов 0, обеспечивающее выравнивание размера всего кадра (mod 8)
- Сериализованные данные walpb.Record
:
- type — перечисление в кодировке int, определяющее интерпретацию поля data ниже
- data — в зависимости от типа, обычно сериализованный proto
- crc — контрольная сумма RC-32 совокупности всех полей “data” без type во всех записях журнала этой реплики с момента создания WAL. Обратите внимание: CRC учитывает ВСЕ записи, даже если Raft их не зафиксировал.
Файлы «обрезаются» (начинается новый файл), когда текущий превышает 64*10^6 байтов.
Логическое содержимое
На логическом уровне файлы журнала предзаписи содержат:
Raftpb.Entry:недавние предложения, реплицированные лидером Raft. Некоторые из них считаются зафиксированными, а остальные могут быть логически замещены.Raftpb.HardState(term,commit,vote):периодические и очень частые сведения об индексе зафиксированной записи журнала, то есть реплицированной на большинство серверов, гарантированно не подлежащей изменению или замещению и применимой к бэкендам (v2, v3). Также содержит “term”, указывающий на изменения, связанные с выборами, и vote — участника, за которого текущая реплика проголосовала в текущем сроке полномочий.walpb.Snapshot(term, index):периодические снимки состояния Raft без содержимого БД, только индекс журнала снимка и срок полномочий Raft- Содержимое хранилища V2 хранится в отдельных файлах *.store.
- Содержимое хранилища V3 находится в файле bbolt и становится неявным снимком сразу после применения записей.
- запись контрольной суммы crc32 в начале каждого файла, позволяющая продолжить проверку CRC для остальной части файла.
etcdserverpb.Metadata(node_id, cluster_id)— идентификаторы кластера и реплики, представленных журналом.
Каждый файл журнала WAL состоит из следующих элементов по порядку:
Кадр CRC-32 (накопленная crc всех предыдущих файлов, 0 для первого файла).
Кадр метаданных (идентификаторы кластера и реплики)
Только для исходного файла WAL:
- Пустой кадр Snapshot (Index:0, Term: 0). Он поддерживает инвариант, согласно которому всем записям «предшествует» снимок.
Для не исходного файла WAL (2nd+):
- Кадр HardState.
Смесь записей entry, hard-state и snapshot
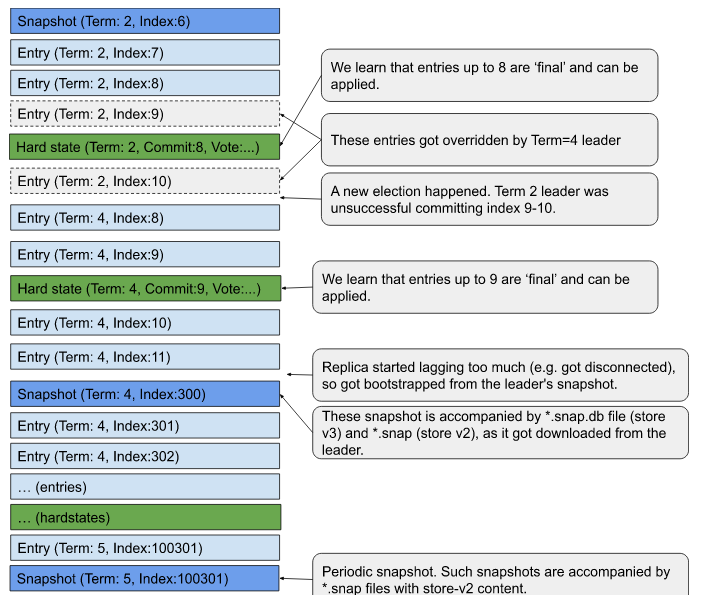
Журнал WAL может содержать несколько записей с одним индексом. Такая ситуация возможна в случаях, описанных на рисунке 7 статьи о Raft . Журнал WAL etcd доступен только для добавления, поэтому запись замещается добавлением новой записи с тем же индексом.
В частности, при чтении WAL логика замещает старые записи новыми . Поэтому окончательной можно считать только последнюю версию записей с entry.index <= HardState.commit. Записи с index > HardState.commit могут изменяться.
Значения “terms” в журнале WAL должны быть монотонными.
Значения “indexes” в журнале WAL должны:
- начинаться с некоторого снимка
- последовательно расти после снимка, пока остаются в том же ‘term’
- при изменении term индекс может уменьшиться, но только до нового значения, превышающего последний HardState.commit.
- новый снимок может появиться с любым index >= HardState.commit, открывая новую последовательность индексов.
Инструменты
etcd-dump-logs
Журналы WAL etcd можно читать инструментом etcd-dump-logs :
Учитывайте следующее:
- Инструмент показывает только Entries, а не все записи WAL (Snapshots, HardStates) из файлов журнала.
- Инструмент автоматически применяет «замещения» записей. Если запись замещена более новой с тем же индексом, выводится только окончательное значение.
- Инструмент также выводит незафиксированные записи из хвоста LOG без сведений о HardState.commitIndex, поэтому неизвестно, являются ли они окончательными.
Снимки (хранилища V2): member/snap/{term}-{index}.snap
Имена файлов:
member/snap/{term}-{index}.snap
Имена файлов создаются здесь
по шаблону ("%016x-%016x.snap") и содержат 2 компонента в шестнадцатеричной кодировке:
- term -> срок полномочий Raft (период между выборами) на момент создания снимка
- index -> индекс последнего применённого предложения на момент создания снимка
Создание
Файлы *.snap создаются методом Snapshotter.SaveSnap .
Создание этих файлов управляется 2 триггерами:
- Новый файл создаётся примерно каждые –snapshotCount=(по умолчанию 100'000) применённых предложений. Значение приблизительно, поскольку предложения могут поступать пакетами, создание снимка рассматривается только в конце пакета, а сам процесс планируется асинхронно. Имя флага (–snapshotCount) не вполне точно: он определяет разницу значений индекса между индексом последнего снимка и индексом последнего применённого предложения.
- Raft требует, чтобы реплика восстановилась из снимка. Получая снимок по сети в сообщении msgSnap, реплика также создаёт его облегчённую контрольную точку в журнале WAL. Это гарантирует, что в хвосте журналов WAL всегда находится действительный снимок с последующими записями, и предотвращает возможный разрыв непрерывности журналов.
Сейчас файлы приблизительно3 соответствуют записям Snapshot журналов WAL в отношении 1-1. После вывода хранилища v2 из эксплуатации запись этих файлов должна полностью прекратиться (необязательно в 3.5.x, обязательно в 3.6.x).
Содержимое
Файл содержит сериализованный proto snapdb.snapshot
(uint32 crc, bytes data),
в поле ‘data’ которого находится Raftpb.Snapshot :
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Наконец, вложенные данные содержат сериализованное в JSON содержимое хранилища v2 .
В частности, присутствуют:
- Term
- Index
- Данные о составе кластера:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Версия хранилища: /0/version-> 3.5.0
Инструменты
protoc
Следующая команда позволяет просмотреть содержимое файла при выполнении из корневого каталога etcd:
Аналогично можно извлечь поле ‘data’ и декодировать его как ‘Raftpb.Snapshot
'
Пример сериализованного в JSON содержимого хранилища v2 в файлах *.snap etcd 3.4:
Изменения
Этот раздел предназначен для описания изменений форматов файлов между различными версиями etcd.
7 - Гарантии API etcd
etcd — согласованное и долговечное хранилище ключей и значений. Доступ к нему предоставляют службы gRPC . etcd обеспечивает наиболее строгие гарантии согласованности и долговечности для распределённой системы. В этой спецификации перечислены гарантии API etcd.
Рассматриваемые API
- KV APIs
- API наблюдения
- API аренды
- Grant
- [Отзыв][Revoke]
- Keep alive
API KV позволяет напрямую читать и изменять хранилище ключей и значений. API наблюдения позволяет подписываться на изменения хранилища. API аренды позволяет назначать ключу время существования.
API KV и наблюдения предоставляют доступ не только к последним версиям ключей, но и к предыдущим версиям в непрерывном окне истории, ограниченном операцией компактизации.
Вызов API KV действует немедленно, тогда как API наблюдения возвращает события с неограниченной задержкой. В исправном кластере etcd события наблюдения обычно появляются через 10ms после возникновения. Однако верхней границы нет, и в неисправном кластере события могут не поступить вовсе.
API KV
etcd гарантирует долговечность и строгую сериализуемость всех вызовов API KV. Это самые строгие гарантии изоляции распределённых транзакционных баз данных.
Долговечность
Любая завершённая операция долговечна. Все доступные данные также долговечны. Чтение никогда не вернёт данные, которые не были сохранены долговечно.
Строгая сериализуемость
Операции службы KV атомарны и выполняются в полном порядке, согласованном с их порядком в реальном времени. Полный порядок задаётся ревизией . Подробнее см. строгая сериализуемость .
В транзакциях без вложенных TXN порядок выполнения операций гарантированно совпадает с порядком в списке, что обеспечивает стабильные ответы GET внутри транзакции. Для транзакций с вложенными TXN порядок выполнения не определён.
Строгая сериализуемость подразумевает другие, более слабые и понятные гарантии:
Атомарность
Все запросы API атомарны: операция либо завершается полностью, либо не выполняется совсем. Для запросов наблюдения все события одной операции входят в один ответ. Наблюдение никогда не видит частичные события отдельной операции.
Линеаризуемость
С точки зрения клиента линеаризуемость предоставляет полезные свойства,
упрощающие рассуждения. В оригинальной статье
дано ясное
описание: Linearizability provides the illusion that each operation applied by concurrent processes takes effect instantaneously at some point between its invocation and its response.
Например, клиент завершает запись в момент 1 (t1). Клиент, начавший чтение в t2 (где t2 > t1), должен получить значение не старее предыдущей записи, завершённой в t1. Однако само чтение может завершиться только в t3. Линеаризуемость гарантирует возврат самого актуального значения. Без неё значение, актуальное в t2 при начале чтения, может устареть к t3, поскольку между t2 и t3 могла произойти параллельная запись.
По умолчанию etcd обеспечивает линеаризуемость всех остальных операций. За это
приходится платить: линеаризуемые запросы должны проходить через консенсус Raft.
Чтобы снизить задержку и повысить пропускную способность чтения, клиент может
выбрать для запроса режим согласованности serializable. Он допускает чтение
устаревших относительно кворума данных, но устраняет затраты на живой консенсус,
необходимый линеаризуемому доступу.
API наблюдения
Наблюдения предоставляют следующие гарантии событий:
- Упорядоченность — события упорядочены по ревизии. В наблюдении не появится событие, которое по времени предшествует уже опубликованному. Для транзакций без вложенных TXN порядок создаваемых событий гарантированно совпадает с порядком операций в списке. Для транзакций с вложенными TXN порядок не определён.
- Уникальность — событие не появится в одном наблюдении дважды.
- Надёжность — последовательность не пропустит подпоследовательность событий в доступном окне истории. Если события упорядочены как a < b < c и наблюдение получает a и c, оно гарантированно получит b, пока b находится в доступном окне.
- Атомарность — список событий гарантированно охватывает полные ревизии. Обновления нескольких ключей в одной ревизии не разделяются между списками.
- Возобновляемость — прерванное наблюдение можно возобновить, создав новое после последней ревизии, полученной до разрыва, пока она находится в окне истории.
- Возможность закладки — события уведомления о ходе гарантируют, что все события до указанной ревизии уже доставлены.
etcd не гарантирует линеаризуемость операций наблюдения. Для правильного порядка относительно других операций пользователи должны проверять ревизию событий.
API аренды
etcd предоставляет механизм аренды . Основной сценарий — реализация распределённой координации, например распределённых блокировок. Механизм прост: аренда создаётся API grant, привязывается к ключу API put, отзывается API revoke и истекает по времени существования (TTL) настенных часов. Однако для правильной распределённой координации необходимо учитывать важные свойства API и их использования .
Определения, специфичные для etcd
Завершённая операция
Операция etcd считается завершённой, когда она зафиксирована через консенсус и,
следовательно, «выполнена» — навсегда сохранена — движком хранения etcd. Клиент
узнаёт о завершении, получив ответ сервера etcd. Если истёк тайм-аут или между
клиентом и участником etcd нарушилась сеть, статус операции может остаться
неопределённым для клиента. etcd также может прерывать операции во время выборов
лидера. В этом случае etcd не отправляет ответы abort на ожидающие запросы клиентов.
Ревизия
Операции etcd, изменяющей хранилище ключей и значений, назначается одна возрастающая ревизия. Транзакция может изменить хранилище несколько раз, но получает только одну ревизию. Атрибут ревизии изменённой пары «ключ — значение» равен ревизии операции. Ревизию можно использовать как логические часы хранилища. Пара с большей ревизией изменена после пары с меньшей. Две пары с одинаковой ревизией изменены одной операцией «одновременно».
8 - etcd в сравнении с другими хранилищами ключей и значений
Название «etcd» образовано из двух идей: каталога Unix «/etc» и распределённых («d»istributed) систем. В «/etc» хранятся данные конфигурации одной системы, тогда как etcd хранит конфигурацию крупных распределённых систем. Поэтому распределённый («d»istributed) «/etc» называется «etcd».
etcd задуман как универсальная основа крупных распределённых систем. Такие системы не допускают split-brain и готовы ради этого пожертвовать доступностью. etcd хранит метаданные согласованно и отказоустойчиво. Кластер etcd предоставляет хранилище ключей и значений с высокой стабильностью, надёжностью, масштабируемостью и производительностью.
Распределённые системы используют etcd как согласованное хранилище ключей и значений для управления конфигурацией, обнаружения служб и координации работы. Многие организации строят на etcd производственные системы: планировщики контейнеров, службы обнаружения и распределённые хранилища данных. Распространённые шаблоны включают выбор лидера , распределённые блокировки и контроль работоспособности машин.
Сценарии использования
- Container Linux от CoreOS: приложения в Container Linux автоматически получают обновления ядра Linux без простоя. Container Linux координирует обновления через locksmith , реализующий распределённый семафор на etcd, чтобы одновременно перезагружалась только часть кластера.
- Kubernetes хранит в etcd конфигурацию для обнаружения служб и управления кластером; согласованность etcd критична для правильного планирования и работы служб. Сервер API Kubernetes сохраняет состояние кластера в etcd и использует API наблюдения для мониторинга и применения важных изменений.
Сравнительная таблица
Возможно, etcd уже кажется подходящим, но любое технологическое решение требует осторожности. Документацию написала команда etcd. Хотя сравнение должно быть беспристрастным, опыт и предпочтения авторов неизбежно склоняются в пользу etcd.
Таблица позволяет быстро сравнить etcd с популярными альтернативами. Подробности по каждому столбцу приведены в следующих разделах.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Примитивы конкурентности | RPC блокировок , RPC выборов , блокировки командной строки , выборы командной строки , рецепты на Go | Внешние рецепты curator на Java | Встроенный API блокировок | Редко , если вообще есть |
| Линеаризуемое чтение | Да | Нет | Да | Иногда |
| Многоверсионное управление конкурентностью | Да | Нет | Нет | Иногда |
| Транзакции | Сравнение полей, чтение, запись | Проверка версии, запись | Сравнение поля, блокировка, чтение, запись | В стиле SQL |
| Уведомления об изменениях | Исторические и текущие интервалы ключей | Текущие ключи и каталоги | Текущие ключи и префиксы | Триггеры (иногда) |
| Права пользователей | На основе ролей | ACL | ACL | Различаются (табличный GRANT , роли базы данных ) |
| API HTTP/JSON | Да | Нет | Да | Редко |
| Изменение состава | Да | >3.5.0 | Да | Да |
| Максимальный надёжный размер базы | Несколько гигабайт | Сотни мегабайт (иногда несколько гигабайт) | Сотни MB | Терабайты+ |
| Минимальная задержка линеаризации чтения | Сетевой RTT | Без линеаризации чтения | RTT + fsync | Барьеры часов (атомарные, NTP) |
ZooKeeper
ZooKeeper решает ту же задачу, что и etcd: координацию распределённых систем и хранение метаданных. Но при создании etcd учитывался инженерный и эксплуатационный опыт проектирования ZooKeeper. Эти уроки помогли etcd поддерживать крупные системы, такие как Kubernetes. Улучшения относительно ZooKeeper включают:
- динамическое изменение состава кластера;
- стабильное чтение и запись под высокой нагрузкой;
- модель многоверсионного управления конкурентностью;
- надёжное наблюдение за ключами без скрытой потери событий;
- примитивы аренды, отделяющие соединения от сеансов;
- API безопасных распределённых совместных блокировок.
Кроме того, etcd изначально поддерживает множество языков и фреймворков.
ZooKeeper использует собственный уникальный протокол Jute RPC, ограничивающий
языковые привязки
, тогда как клиентский протокол etcd основан на
gRPC
с привязками для Go, C++, Java и других языков. gRPC можно
сериализовать в JSON поверх HTTP, поэтому с etcd работают даже утилиты вроде
curl. Системы строятся на etcd с естественными инструментами выбранного стека.
Новым приложениям, которым нужно согласованное хранилище ключей и значений, с учётом возможностей, поддержки и стабильности лучше выбрать etcd вместо ZooKeeper.
Consul
Consul — комплексная среда обнаружения служб со встроенными проверками состояния, обнаружением отказов и DNS. Она также предоставляет хранилище ключей и значений через RESTful API HTTP. В Consul 1.0 операции с ключами масштабировались хуже etcd и ZooKeeper: миллионы ключей приводили к высоким задержкам и давлению на память. В API отсутствуют многоверсионные ключи, условные транзакции и надёжные потоковые наблюдения.
etcd и Consul решают разные задачи. Для распределённого согласованного хранилища лучше etcd. Для комплексного обнаружения служб кластера возможностей etcd недостаточно; выберите Kubernetes, Consul или SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
И etcd, и базы NewSQL, например Cockroach , TiDB и Google Spanner , обеспечивают строгую согласованность при высокой доступности. Но различия архитектуры приводят к разным клиентским API и характеристикам.
Базы NewSQL горизонтально масштабируются между центрами обработки данных. Они разделяют терабайты данных между несколькими, иногда удалёнными, согласованными группами репликации (шардами). Из-за ожидания часов и локализованных графов зависимостей обновлений они плохо подходят для распределённой координации. Данные организованы в таблицы с более богатым SQL, чем у etcd, ценой сложности обработки, планирования и оптимизации запросов.
Итого: для метаданных и координации распределённых приложений выбирайте etcd. Для объёмов более нескольких GB или полноценных запросов SQL выбирайте NewSQL.
Использование etcd для метаданных
etcd реплицирует все данные в одной согласованной группе. Для нескольких GB с согласованным порядком это наиболее эффективно. Каждому изменению состояния кластера присваивается глобальный уникальный возрастающий идентификатор — ревизия. Поскольку группа репликации одна, для фиксации запрос проходит только протокол Raft. Один консенсус обеспечивает согласованность, низкую задержку и высокую пропускную способность при простом протоколе.
Репликация etcd не масштабируется горизонтально без шардирования. NewSQL обычно распределяет терабайты данных между несколькими согласованными группами. Чтобы назначить каждому изменению глобальный возрастающий ID, запрос проходит дополнительную координацию между группами. Возможные конфликты ID заставляют повторять упорядоченные запросы, усложняя систему и обычно снижая производительность строгого порядка относительно etcd.
Если приложение в основном работает с метаданными и их порядком для координации процессов, выбирайте etcd. Для крупного хранилища между несколькими ЦОД без сильной зависимости от глобального порядка выбирайте NewSQL.
Использование etcd для распределённой координации
etcd изначально предоставляет наблюдения, аренды, выборы и распределённые совместные блокировки. У блокировок есть неочевидные свойства, описанные ниже. Примитивы сопровождают разработчики etcd; перенос их во внешние библиотеки оставляет базовую распределённую систему неполной. В NewSQL их обычно реализуют третьи стороны, у ZooKeeper есть независимая библиотека рецептов, а Consul предупреждает, что его встроенный API блокировок — «не безупречный метод ».
Теоретически такие примитивы можно построить над любым строго согласованным хранилищем. Но алгоритмы тонки: кажущаяся рабочей блокировка внезапно ломается из-за эффекта лавины запросов и рассинхронизации времени. Другие примитивы, например транзакционная память, зависят от модели MVCC etcd; одной строгой согласованности недостаточно.
Для распределённой координации etcd снижает эксплуатационные риски и экономит инженерные усилия.
Примечания об использовании блокировок и аренд
etcd предоставляет API блокировок на основе механизма аренды и его реализации в etcd . Сервер выдаёт клиенту токен — аренду — с TTL и отзывает её после истечения времени. Пока клиент держит неотозванную аренду, он может заявлять владение связанным ресурсом; в etcd это ключ. Но сами API блокировок не обеспечивают взаимное исключение. Название lock сохранено по историческим причинам ; ниже показано, как API оптимизирует механизм взаимного исключения.
Главное свойство аренды: TTL — физический интервал времени, который сервер и клиент измеряют собственными часами. Поэтому сервер может отозвать аренду, пока клиент всё ещё считает себя владельцем.
Следовательно, сама аренда не гарантирует взаимное исключение, а владение арендой не гарантирует удержание блокировки ресурса.
Для ключей etcd взаимное исключение реализуется проверкой номера версии (в
других системах — compare-and-swap). В RPC Put и Txn задаются условия по
ревизии и идентификатору аренды. При невыполнении условий операция завершается
ошибкой. Клиент знает, что получил блокировку ключа, когда кластер etcd успешно
завершил его запрос.
Подобные схемы описаны в литературе:
- в статье о Chubby вводится sequencer, приблизительно соответствующий сочетанию ревизии и ID аренды etcd;
- в How to do distributed locking Martin Kleppmann вводит fencing token, которому в etcd соответствует ревизия;
- в Practical Uses of Synchronized Clocks in Distributed Systems описана распределённая блокировка Thor на проверке версии и аренде.
Аренды нужны даже при проверке версий, поскольку уменьшают число прерванных запросов.
Ключи etcd эффективно блокируются благодаря аренде и проверке версии. Внешние ресурсы должны сами предоставлять проверку версий и согласованность реплик, подобную ключам etcd. Блокировки etcd не могут непосредственно защищать внешние ресурсы.
9 - Глоссарий
Этот документ определяет различные термины, используемые в документации, командной строке и исходном коде etcd.
Аварийный сигнал
Сервер etcd подаёт аварийный сигнал, когда для сохранения надёжности кластера требуется вмешательство оператора.
Аутентификация
Аутентификация управляет правами доступа пользователей к ресурсам etcd.
Клиент
Клиент подключается к кластеру etcd и отправляет служебные запросы: получает пары «ключ — значение», записывает данные или наблюдает за обновлениями.
Кластер
Кластер состоит из нескольких участников.
Узел каждого участника следует протоколу консенсуса Raft для репликации журналов. Кластер получает предложения от участников, фиксирует их и применяет к локальному хранилищу.
Компактизация
Компактизация удаляет всю историю событий etcd и замещённые ключи до заданной ревизии. Она освобождает место в базе данных бэкенда etcd.
Выборы
В рамках протокола консенсуса Raft кластер etcd проводит выборы лидера среди своих участников.
Конечная точка
URL, указывающий на службу или ресурс etcd.
Ключ
Определяемый пользователем идентификатор для хранения и получения пользовательских значений в etcd.
Диапазон ключей
Набор ключей, содержащий отдельный ключ, лексический интервал всех x, для которых a < x <= b, либо все ключи больше заданного ключа.
Пространство ключей
Множество всех ключей в кластере etcd.
Аренда
Краткосрочный возобновляемый договор, который по истечении срока удаляет связанные с ним ключи.
Участник
Логический сервер etcd, участвующий в обслуживании кластера etcd.
Ревизия изменения
Первая ревизия, содержащая последнюю запись заданного ключа.
Одноранговый узел
Одноранговый узел — другой участник того же кластера.
Предложение
Предложение — это запрос, например на запись или изменение конфигурации, который должен пройти через протокол Raft.
Кворум
Количество активных участников, необходимое для достижения консенсуса при изменении состояния кластера. Для кворума etcd требуется большинство участников.
Ревизия
64-bit общий для кластера счётчик, который начинается с 1 и увеличивается при каждом изменении пространства ключей.
Роль
Набор прав для диапазонов ключей, который можно предоставить группе пользователей в целях контроля доступа.
Снимок
Резервная копия состояния кластера etcd на определённый момент времени.
Хранилище
Физическое хранилище, лежащее в основе пространства ключей кластера.
Срок
Срок — монотонно возрастающее целое число, связанное с каждыми выборами лидера в алгоритме Raft. В течение одного срока может быть выбран только один лидер; при смене лидера срок увеличивается.
Транзакция
Атомарно выполняемый набор операций. Все изменённые в транзакции ключи имеют одну и ту же ревизию изменения.
Версия ключа
Количество записей ключа с момента его создания, начиная с 1. Версия несуществующего или удалённого ключа равна 0.
Наблюдатель
Клиент открывает наблюдателя, чтобы отслеживать обновления в заданном диапазоне ключей.