Это многостраничная версия текущего раздела для печати. .
etcd 3.7 Документация
- 1: Задачи
- 1.1: Задачи оператора
- 1.2: Задачи разработчика
- 1.2.1: Чтение из etcd
- 1.2.2: Запись в etcd
- 1.2.3: Как получить ключи по префиксу
- 1.2.4: Как удалить ключи
- 1.2.5: Как выполнить несколько записей в транзакции
- 1.2.6: Как наблюдать за ключами
- 1.2.7: Как создать аренду
- 1.2.8: Как создавать блокировки
- 2: Быстрый старт
- 3: Демонстрация
- 4: Установка
- 5: Функциональные шлюзы
- 6: Часто задаваемые вопросы
- 7: Библиотеки и инструменты
- 8: Метрики
- 9: Сообщение об ошибках
- 10: Настройка производительности
- 11: Внутренности
- 11.1: Протокол службы обнаружения
- 11.2: Соглашения по ведению журнала
- 11.3: Модули Golang
- 12: Учеба
- 13: Руководство для разработчиков
- 13.1: Протокол службы обнаружения
- 13.2: Настройка локального кластера
- 13.3: Интеракция с etcd
- 13.4: Зачем нужен шлюз gRPC
- 13.5: Именование и обнаружение gRPC
- 13.6: Встраивание etcd в Go-приложение
- 13.7: Ограничения системы
- 13.8: Возможности etcd
- 13.9: Справочник API
- 13.10: Справочник API: конкурентность
- 14: Руководство по операциям
- 14.1: Аутентификационные руководства
- 14.1.1: Аутентификация
- 14.1.2: Управление доступом на основе ролей
- 14.2: Параметры конфигурации
- 14.3: Модель транспортной безопасности
- 14.4: Руководство по кластеризации
- 14.5: Запуск кластеров etcd в контейнерах
- 14.6: Запуск кластеров etcd как StatefulSet Kubernetes
- 14.7: Режимы отказа
- 14.8: Восстановление после аварии
- 14.9: Шлюз etcd
- 14.10: Прокси gRPC
- 14.11: Рекомендации по оборудованию
- 14.12: Обслуживание
- 14.13: Мониторинг etcd
- 14.14: Производительность
- 14.15: Устройство реконфигурации во время выполнения
- 14.16: Динамическое изменение конфигурации
- 14.17: Поддерживаемые платформы
- 14.18: Версионирование
- 14.19: Повреждение данных
- 14.1: Аутентификационные руководства
- 15: Тестирование производительности
- 15.1: Тестирование использования памяти хранилищем
- 15.2: Тестирование использования памяти наблюдателями
- 15.3: Тестирование производительности etcd v3
- 15.4: Тестирование памяти etcd v2.2.0-rc
- 15.5: Тестирование производительности etcd v2.2.0-rc
- 15.6: Тестирование производительности etcd v2.2.0
- 15.7: Тестирование производительности etcd v2.1.0
- 16: Обновление
- 16.1: Обновление кластеров etcd и приложений
- 16.2: Обновление etcd с v3.5 до v3.6
- 16.3: Обновление etcd с 3.4 до 3.5
- 16.4: Обновление etcd с 3.3 до 3.4
- 16.5: Обновление etcd с v3.6 до v3.7
- 16.6: Обновление etcd с 3.2 до 3.3
- 16.7: Обновление etcd от 3.1 до 3.2
- 16.8: Обновление etcd с 3.0 до 3.1
- 16.9: Обновление etcd с 2.3 до 3.0
- 17: Снижение версии
- 18: Триаж
- 18.1: Рекомендации по триажу issue
- 18.2: Управление PR
etcd — это строго согласованное распределённое хранилище ключей и значений. Эти руководства охватывают установку и эксплуатацию etcd, разработку приложений с использованием его API, понимание архитектуры, измерение производительности, а также обновление или понижение версии кластеров в линейке выпусков 3.7.
Начните с Краткого руководства для локального кластера из одного участника, Установка для поддерживаемых путей установки или Руководства по эксплуатации для промышленных развёртываний.
1 - Задачи
1.1 - Задачи оператора
1.1.1 - Как настроить демонстрационный кластер etcd
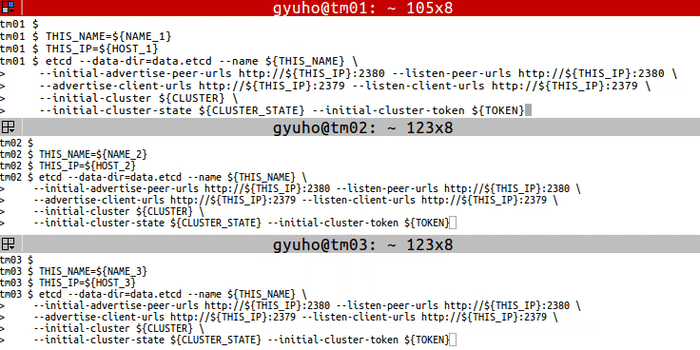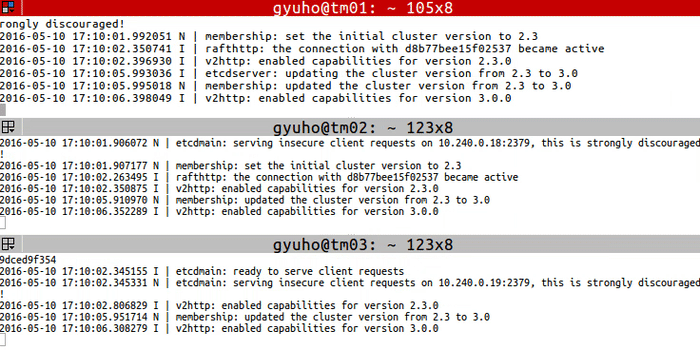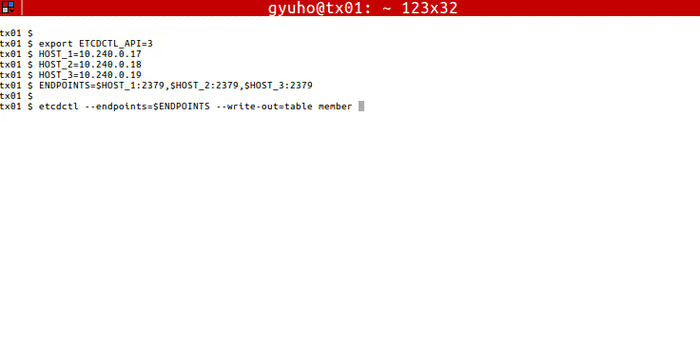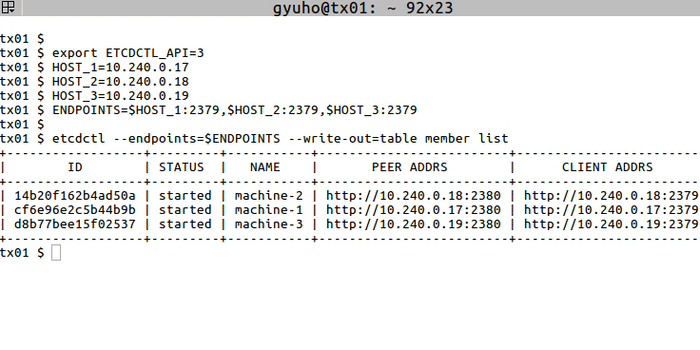
На каждом узле etcd укажите участников кластера:
Выполните следующее на каждой машине:
Или воспользуйтесь общедоступной службой обнаружения:
Теперь etcd готов к работе! Для подключения к etcd с помощью etcdctl выполните:
1.1.2 - Как проводить выборы лидера в кластере etcd
Предварительные требования
Проведение выборов лидера
Команда etcdctl используется для проведения выборов лидера в кластере etcd. Она гарантирует, что в один момент времени только один клиент может стать лидером.
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
Параметры
--endpoints : $ENDPOINTS
Адрес каждого участника кластера etcd.
election-nameстрока
Строка-идентификатор для выборов. Все участники, конкурирующие за лидерство, должны использовать одно и то же имя выборов.
leader-nameстрока
Значение предложения нового лидера.
Пример
1.1.3 - Как проверить состояние кластера
Предварительные условия
- Установите
etcdиetcdctl
Проверка общего состояния
Команда endpoint status проверяет общее состояние каждой конечной точки, указанной флагом --endpoints:
Параметры
Проверка работоспособности
Команда endpoint health проверяет работоспособность каждой конечной точки, указанной флагом --endpoints:
Параметры
Проверка хеша KV
Команда endpoint hashkv проверяет хеш истории KV каждой конечной точки, указанной флагом --endpoints:
Параметры
Параметры, унаследованные от родительских команд
Примеры
1.1.4 - Как сохранить базу данных
Предварительные требования
Сделать снимок базы данных
snapshot для создания снимка базы данных etcd в определённый момент времени:
Глобальные параметры
etcdctl
Снимок можно запрашивать только у одного узла etcd, поэтому флаг --endpoints должен содержать только одну конечную точку.
etcdutl
Пример
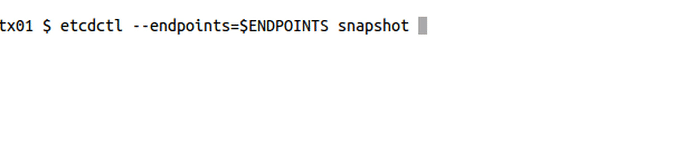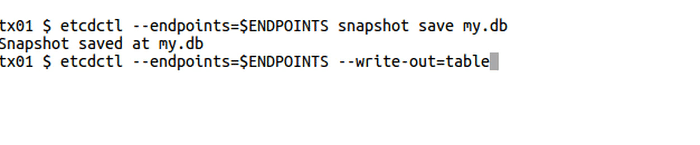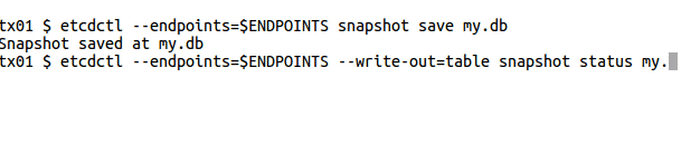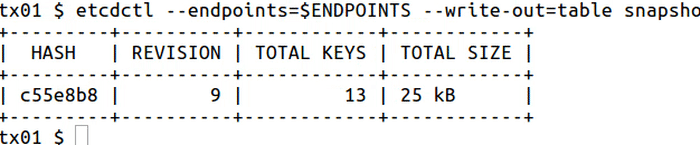
1.1.5 - Как добавлять и удалять участников
Команда member добавляет, удаляет и обновляет участников:
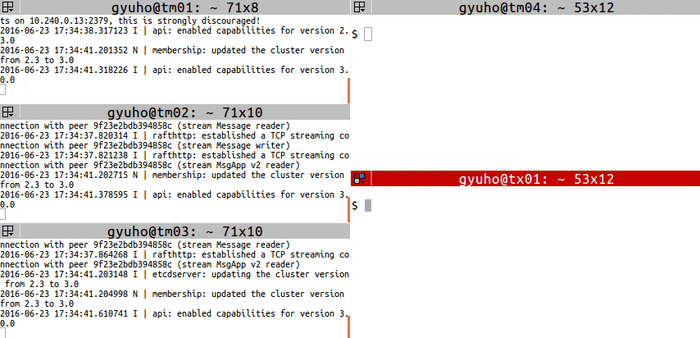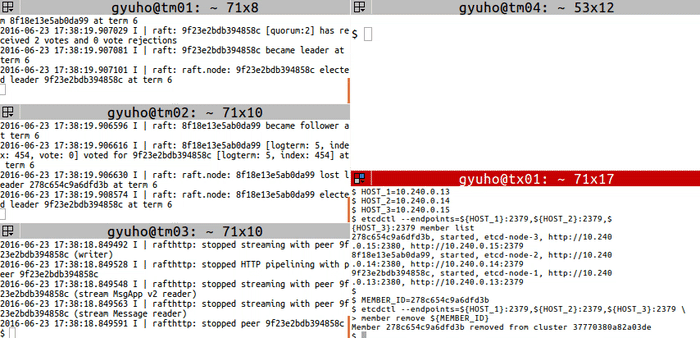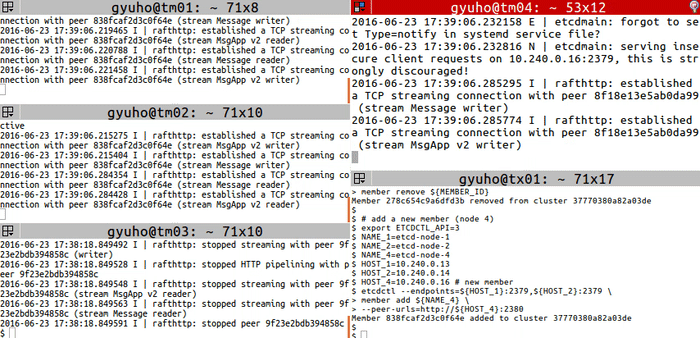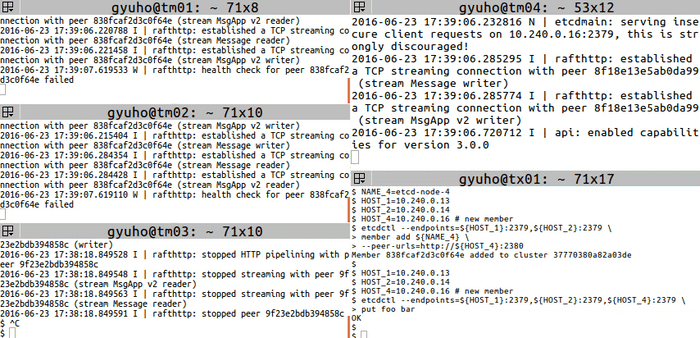
Затем замените участника командами member remove и member add:
После этого запустите нового участника с флагом --initial-cluster-state existing:
1.2 - Задачи разработчика
1.2.1 - Чтение из etcd
Предварительные требования
- Установите
etcdctl
Процедура
Используйте подкоманду get для чтения из etcd:
где:
foo— запрашиваемый ключHello World!— полученное значение
Или для форматированного вывода:
где write-out="json" заставляет выводить значение в формате JSON (обратите внимание, ключ не возвращается).
1.2.2 - Запись в etcd
Предварительные условия
- Установите
etcdctl
Процедура
Используйте подкоманду put для записи пары «ключ — значение»:
где:
foo— имя ключа"Hello World!"— значение, заключённое в кавычки
1.2.3 - Как получить ключи по префиксу
Предварительные требования
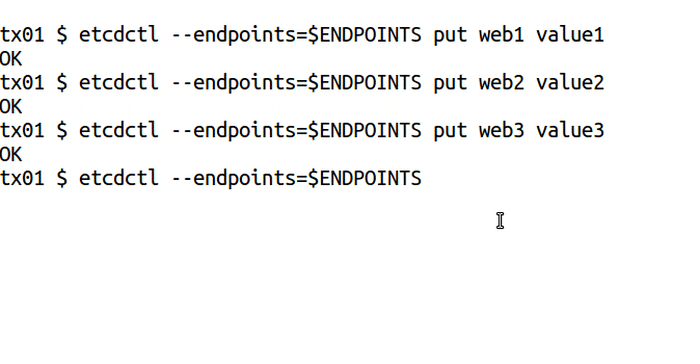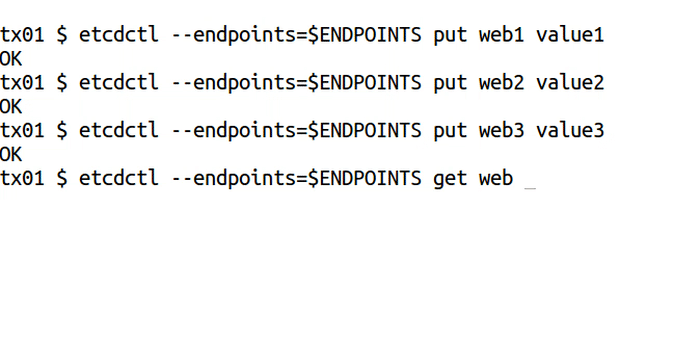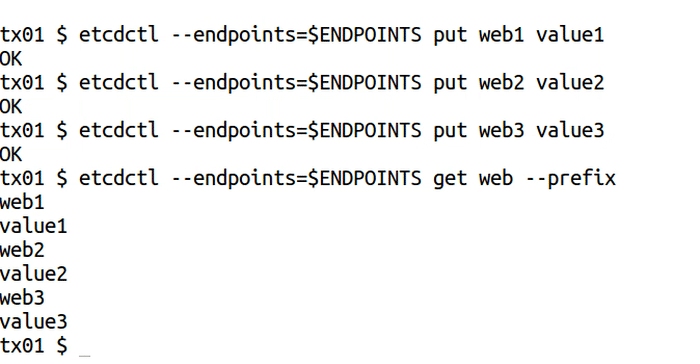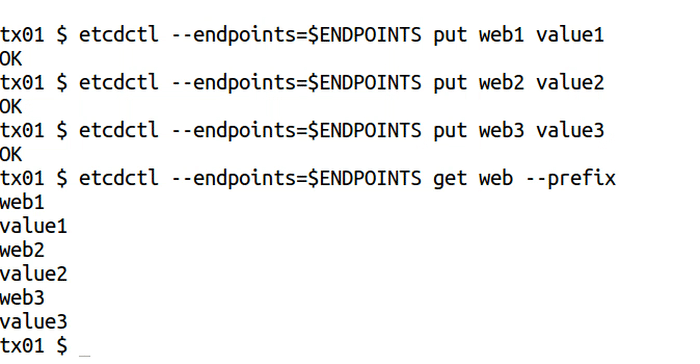
Получить ключи по префиксу
Глобальные параметры
Параметры
Пример
1.2.4 - Как удалить ключи
Предварительные требования
- Установите
etcdиetcdctl
Добавление или удаление ключей
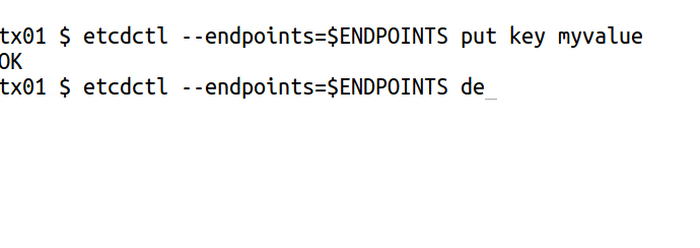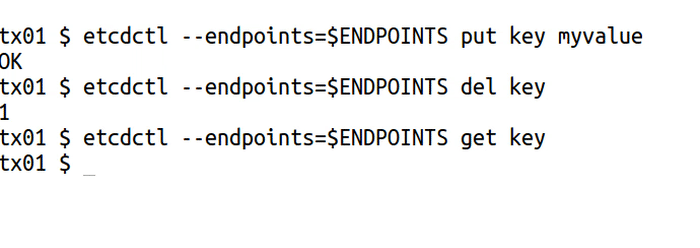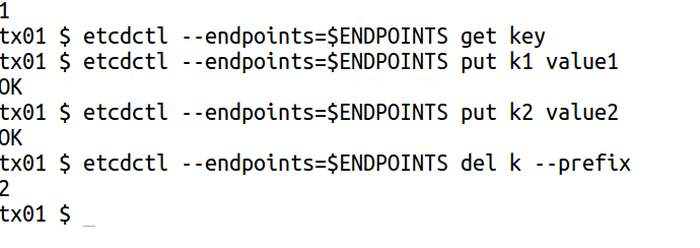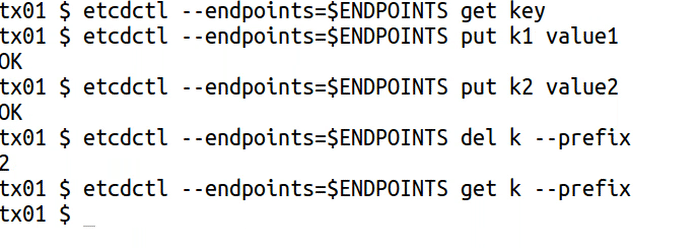
del для удаления указанного ключа или диапазона ключей:
Параметры
Параметры, унаследованные от родительских команд
Примеры
1.2.5 - Как выполнить несколько записей в транзакции
Предварительные условия
- Установите
etcdиetcdctl. - Работающий кластер
etcd.
Терминология
Ниже определены ключевые термины, используемые в примере .
| Термин | Определение |
|---|---|
| etcdctl | Инструмент командной строки для взаимодействия с сервером etcd. |
Команда txn | Название команды txn сокращает слово «transaction». Она читает несколько запросов etcd из стандартного ввода и применяет их как одну атомарную транзакцию. Транзакция состоит из списка условий, списка запросов, выполняемых при истинности всех условий, и списка запросов, выполняемых при ложности любого условия. Дополнительные сведения приведены в разделе команд etcdctl для ключей и значений
. |
compare | Секция compare в транзакции (txn) выполняет условную проверку и определяет, следует ли выполнять операции транзакции. Изменения применяются только тогда, когда текущее состояние хранилища ключей и значений соответствует ожидаемым условиям. Это сохраняет согласованность данных и предотвращает конфликты при параллельной работе. Структура команды показана ниже в разделе Выполнение транзакции
. |
Транзакции
Команда txn обрабатывает все запросы в одной транзакции:
Транзакции etcd позволяют атомарно выполнить несколько операций: либо применяются все операции, либо не применяется ни одна. Это необходимо для сохранения согласованности данных при связанных обновлениях. Подробнее см. в документации API .
Пример
Рассмотрим обновление адреса электронной почты и номера телефона пользователя в одной транзакции. Оба изменения будут применены совместно.
0. Используемые переменные и флаги
| Переменные |
|---|
/users/{<user_id>/email : ключ etcd, представляющий адрес электронной почты пользователя. |
/users/<user_id>/phone : ключ etcd, представляющий номер телефона пользователя. |
| Флаги |
--interactive
: флаг, разрешающий вводить данные транзакции вручную |
1. Создание исходных данных
Сначала создайте пользователя с исходными данными.
2. Выполнение транзакции
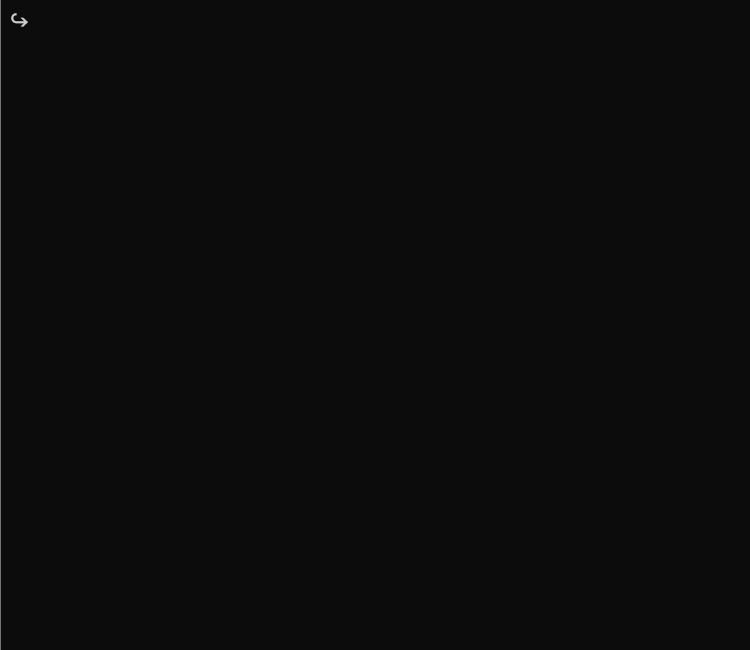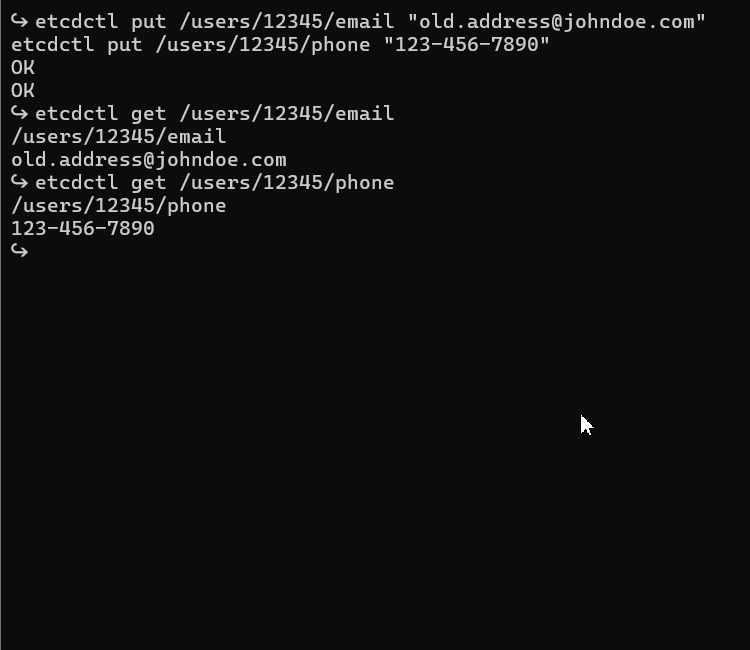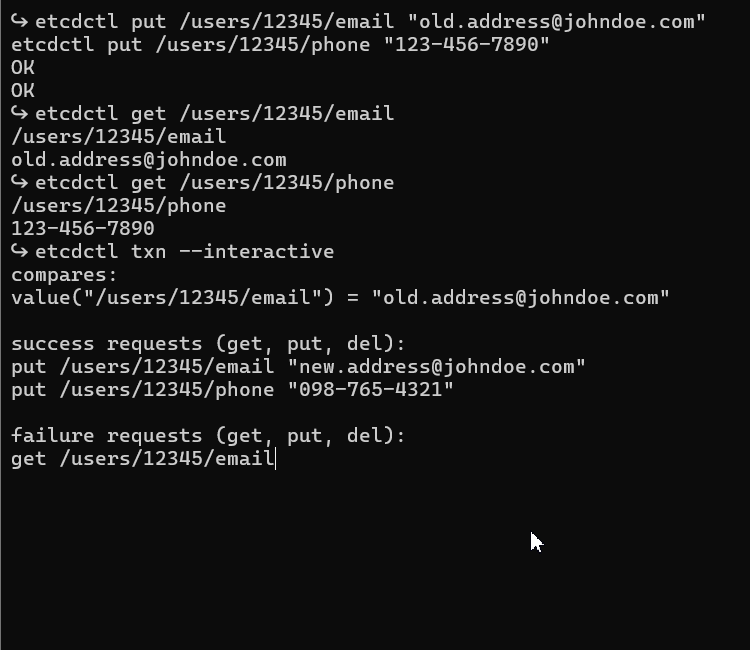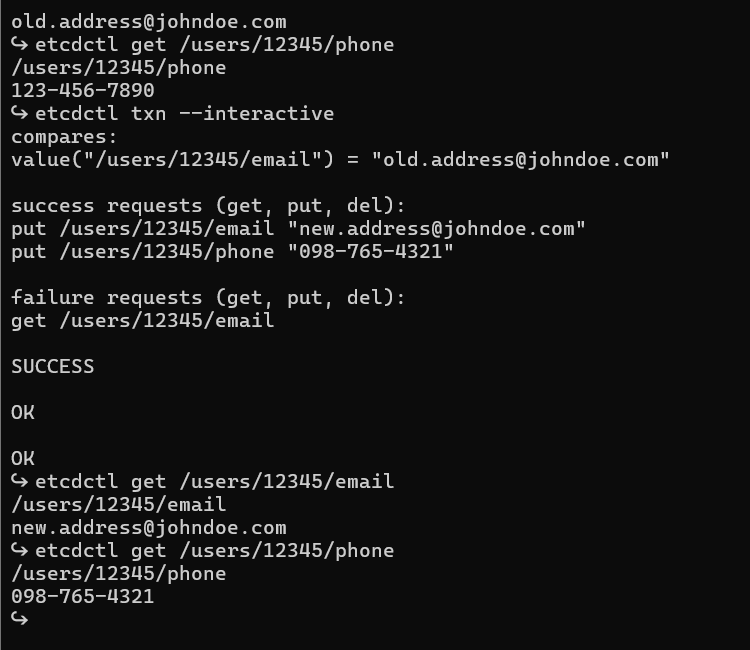
Обновите адрес электронной почты и номер телефона пользователя в одной транзакции.
- Сравнение: проверьте, что текущий адрес равен «old.address@johndoe.com ». Транзакция продолжится только при ожидаемом состоянии данных.
- Успех: если сравнение истинно, обновите и адрес электронной почты, и номер телефона.
- Неудача: если сравнение ложно, получите текущий адрес, чтобы выяснить, почему транзакция не была выполнена.
Важные соображения
- Атомарность: транзакция гарантирует совместное обновление адреса электронной почты и номера телефона. Если исходное условие сравнения не выполнено, ни одно обновление не применяется.
- Согласованность: транзакции сохраняют согласованность данных, особенно при нескольких связанных обновлениях.
- Не записывайте один ключ несколько раз: не присваивайте одному ключу несколько значений в одной транзакции, поскольку это может привести к неожиданным результатам. Каждый ключ следует обновлять только один раз за транзакцию.
1.2.6 - Как наблюдать за ключами
Предварительные требования
- Установите
etcdиetcdctl
Наблюдение за ключами
watch для получения уведомлений о будущих изменениях:
Параметры
Параметры, унаследованные от родительских команд
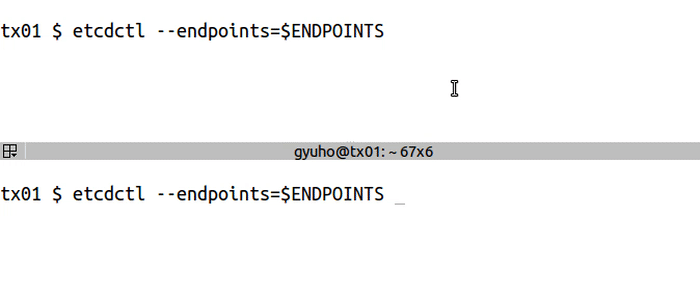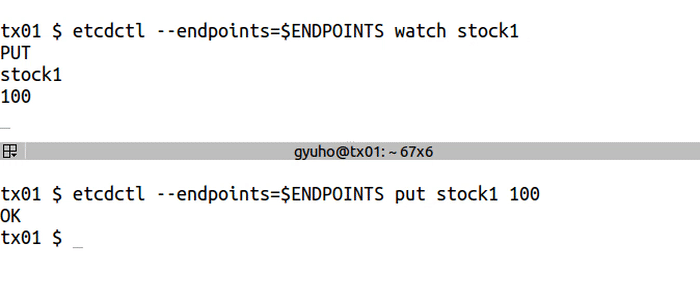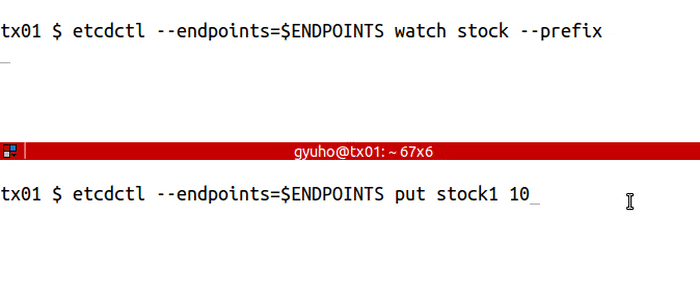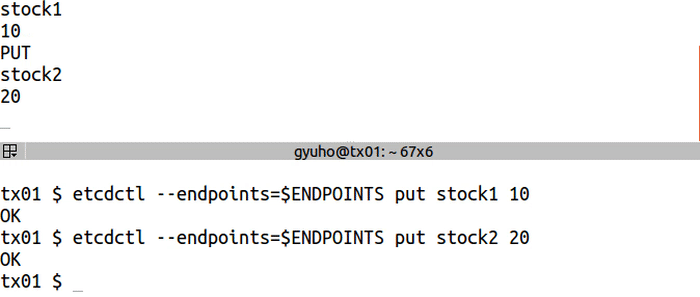
Примеры
1.2.7 - Как создать аренду
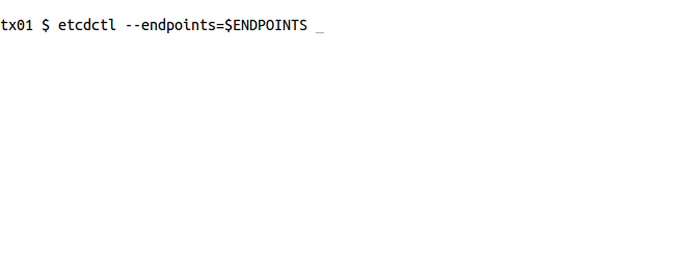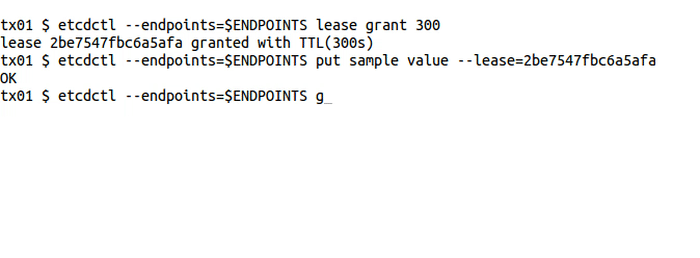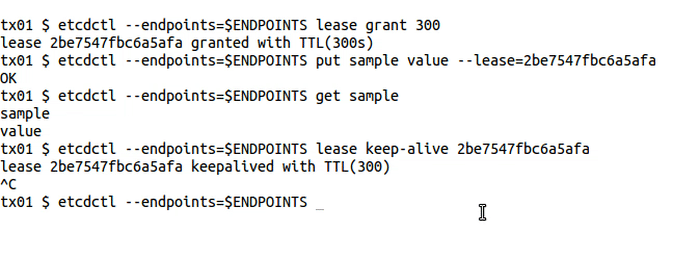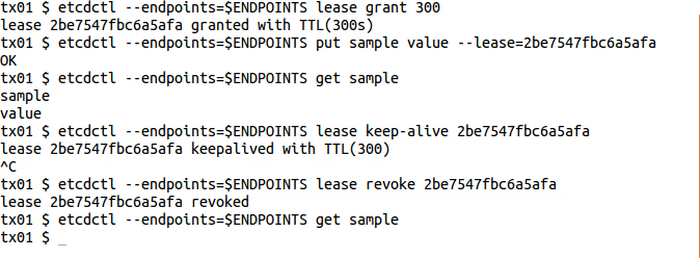
lease записывать с TTL:
1.2.8 - Как создавать блокировки
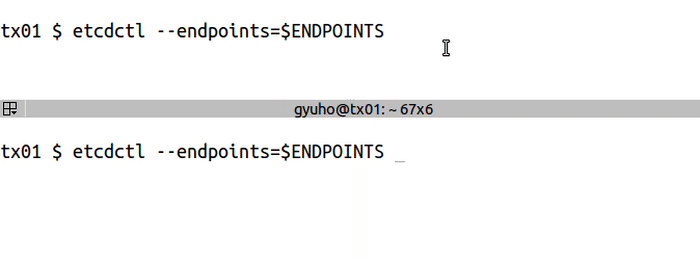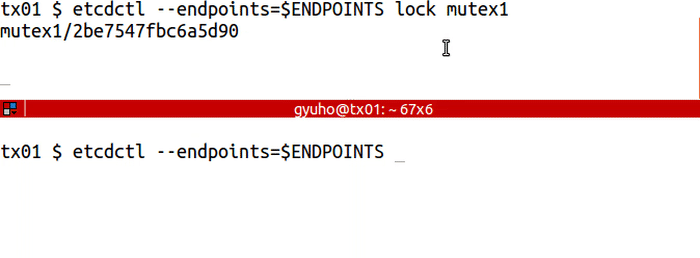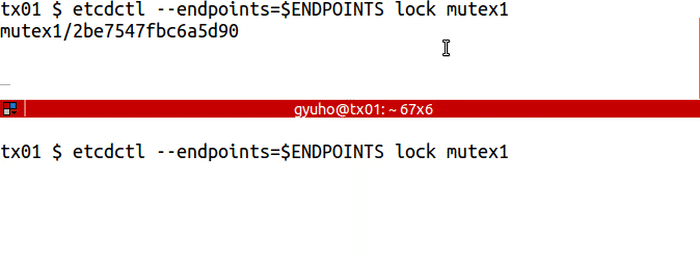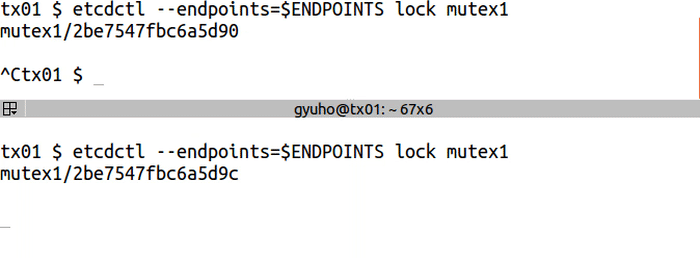
LOCK приобретает распределённый мьютекс с указанным именем. Как только блокировка будет получена, она будет удерживаться до завершения работы etcdctl.
Предварительные требования
- Установите
etcdиetcdctl
Создание блокировки
lock для распределённой блокировки:
Параметры
- endpoints — определяет список адресов машин в кластере, разделённых запятыми.
- ttl — время ожидания в секундах сессии блокировки.
2 - Быстрый старт
Следуйте этим инструкциям, чтобы локально установить, запустить и проверить кластер etcd из одного участника:
Установите etcd из готовых бинарных файлов или исходного кода. Подробности см. в разделе [Установка][].
ПредупреждениеВажно: обязательно выполните последний шаг инструкции по установке и убедитесь, что
etcdдоступен в пути поиска.Запустите
etcd:ПримечаниеПримечание: вывод
etcdпредставляет собой журналы — сообщения уровня info можно игнорировать.В другом терминале задайте ключ с помощью
etcdctl:В том же терминале получите значение ключа:
Что дальше?
Дополнительные способы настройки и использования etcd описаны на следующих страницах:
Для разработчиков:
- Изучите gRPC API .
- Найдите языковые библиотеки и инструменты .
Для операторов и администраторов:
- Настройте кластер из нескольких машин .
- Узнайте, как настроить etcd.
- Используйте TLS, чтобы защитить кластер etcd .
- Настройте производительность etcd .
3 - Демонстрация
В этом ряду примеров показаны базовые процедуры работы с кластером etcd.
Аутентификация
auth,user,role для аутентификации:
4 - Установка
Требования
Перед установкой etcd ознакомьтесь со следующими страницами:
Установка готовых бинарных файлов
Проще всего установить etcd из готовых бинарных файлов:
Загрузите с Releases сжатый архив для своей платформы, выбрав выпуск v3.7.0 или новее.
Распакуйте архив. В результате появится каталог с бинарными файлами.
Добавьте исполняемые файлы в путь поиска. Например, переименуйте и/или переместите их в каталог из пути поиска, такой как
/usr/local/bin, либо добавьте в путь каталог, созданный на предыдущем шаге.В оболочке проверьте, что
etcdдоступен в пути поиска:
Сборка из исходного кода
Если установлен Go версии 1.21+ , etcd можно собрать из исходного кода:
Загрузите репозиторий etcd в виде zip-файла и распакуйте его либо клонируйте репозиторий следующей командой.
Чтобы собрать
main@HEAD, не указывайте флаг-b v3.7.0.Перейдите в каталог:
Запустите скрипт сборки:
Бинарные файлы находятся в каталоге
bin.Добавьте полный путь к каталогу
binв путь поиска, например:Проверьте, что
etcdдоступен в пути поиска:
Установка из пакетов ОС
Отказ от ответственности: пакеты etcd из менеджеров пакетов ОС могут содержать устаревшие версии, поскольку они не обслуживаются автоматически и официально не поддерживаются проектом etcd. Используйте их с осторожностью.
Способы установки etcd зависят от операционной системы. Ниже приведено несколько примеров.
MacOS (Homebrew)
- Обновите Homebrew:
- Установите etcd:
- Проверьте установку:
Linux
etcd можно установить из официальных репозиториев и менеджеров пакетов многих крупных дистрибутивов Linux, однако опубликованные там версии могут значительно устареть. Поэтому этот способ настоятельно не рекомендуется.
Рекомендуется устанавливать etcd в Linux из готовых бинарных файлов или с помощью Homebrew.
Homebrew в Linux
Homebrew работает в Linux и предоставляет свежие версии программ.
Предварительные условия
Обновите Homebrew:
Процедура
Установите пакет с помощью
brew:
Результат
Проверьте установленную версию:
Docker
Основным реестром контейнеров etcd служит gcr.io/etcd-development/etcd
,
а вторичным — quay.io/coreos/etcd
.
Чтобы запустить etcd в Docker:
Установка в составе Kubernetes
Проверка установки
Более полная базовая проверка установки приведена в разделе Быстрый старт .
5 - Функциональные шлюзы
На этой странице представлен обзор функциональных шлюзов, которые администратор может задать для etcd.
Описание стадий возможностей приведено в разделе стадий возможностей .
Обзор
Функциональные шлюзы — набор пар key=value, описывающих возможности etcd.
Возможности включаются и отключаются флагом командной строки --feature-gates
процесса etcd.
etcd позволяет включить или отключить набор функциональных шлюзов.
Полный список можно увидеть с помощью флага -h.
Чтобы задать шлюзы, присвойте флагу --feature-gates список пар возможностей в командной строке:
Или укажите feature-gates в конфигурационном файле YAML:
Изменение структуры embed.EtcdServer
В 3.6 поле ServerFeatureGate добавлено в embed.Config и должно заменить перечисленные ниже экспериментальные поля:
Функциональные шлюзы возможностей Alpha и Beta
В следующей таблице перечислены функциональные шлюзы, которые можно настроить в etcd.
| Возможность | По умолчанию | Стадия | Описание |
|---|---|---|---|
| CompactHashCheck | false | Alpha | Включает проверку повреждения данных до обслуживания клиентского или однорангового трафика. |
| InitialCorruptCheck | false | Alpha | Позволяет лидеру периодически проверять хеши компактизации последователей. |
| LeaseCheckpoint | false | Alpha | Позволяет лидеру регулярно отправлять контрольные точки другим участникам, предотвращая сброс оставшегося TTL при смене лидера. |
| LeaseCheckpointPersist | false | Alpha | Включает сохранение remainingTTL, предотвращая бесконечное автоматическое продление долгоживущих аренд. |
| SetMemberLocalAddr | false | Alpha | Использует первый заданный локальный адрес без loopback из initial-advertise-peer-urls как локальный адрес для связи с одноранговым участником. |
| StopGRPCServiceOnDefrag | false | Alpha | Останавливает обслуживание клиентских запросов службой gRPC etcd на время дефрагментации. |
| TxnModeWriteWithSharedBuffer | true | Beta | Позволяет транзакции записи использовать общий буфер при проверочных операциях только для чтения. |
Использование возможности
Стадии возможностей
Возможность может находиться на стадии Alpha, Beta, GA или Deprecated. Стадия Alpha означает:
- По умолчанию возможность отключена.
- Возможны ошибки; включение может проявить их.
- Поддержка может быть прекращена в любой момент без уведомления.
- API может без уведомления несовместимо измениться в следующем выпуске.
- Из-за повышенного риска ошибок и отсутствия долгосрочной поддержки рекомендуется использовать только в краткоживущих тестовых кластерах.
Стадия Beta означает:
- По умолчанию возможность включена.
- Возможность хорошо протестирована и считается безопасной для включения.
- Поддержка возможности в целом не будет прекращена, хотя детали могут измениться.
- Рекомендуется только для некритичных сценариев: широкое применение может выявить новые труднообнаружимые ошибки.
Пожалуйста, испытывайте возможности Beta и сообщайте о результатах! После выхода из beta внесение дополнительных изменений может стать непрактичным.
Стадия General Availability (GA), также называемая стабильной, означает:
- Возможность всегда включена и не может быть отключена.
- Соответствующий функциональный шлюз больше не нужен.
- Стабильные версии возможности будут присутствовать во многих последующих выпусках программного обеспечения.
Стадия Deprecated означает:
- Функциональный шлюз больше не используется.
- Возможность перешла в GA или была удалена.
6 - Часто задаваемые вопросы
Общие вопросы об etcd
Что такое etcd?
etcd — согласованное распределённое хранилище ключей и значений. В основном оно используется как отдельная служба координации в распределённых системах и предназначено для небольших объёмов данных, целиком помещающихся в памяти.
Как произносится etcd?
etcd произносится как /ˈɛtsiːdiː/ и означает «распределённый каталог etc».
Должны ли клиенты отправлять запросы лидеру etcd?
Raft основан на лидере: лидер обрабатывает все клиентские запросы, требующие консенсуса кластера. Однако клиенту не нужно знать, какой узел является лидером. Любой требующий консенсуса запрос, отправленный последователю, автоматически пересылается лидеру. Запросы, не требующие консенсуса (например, сериализуемое чтение), может обработать любой участник кластера.
Конфигурация
Чем различаются listen-<client,peer>-urls, advertise-client-urls и initial-advertise-peer-urls?
listen-client-urls и listen-peer-urls задают локальные адреса, к которым сервер etcd привязывается для приёма входящих соединений. Чтобы слушать порт на всех интерфейсах, укажите 0.0.0.0 как IP-адрес прослушивания.
advertise-client-urls и initial-advertise-peer-urls задают адреса, по которым клиенты или другие участники etcd должны обращаться к серверу. Объявленные адреса должны быть доступны с удалённых машин. В рабочем окружении не объявляйте адреса наподобие localhost или 0.0.0.0, поскольку удалённые машины не могут к ним подключиться.
Почему изменение --listen-peer-urls или --initial-advertise-peer-urls не обновляет объявленные URL одноранговых узлов в etcdctl member list?
Объявленные URL одноранговых узлов участника берутся из --initial-advertise-peer-urls при первоначальном запуске кластера. Изменение URL прослушивания или исходных объявленных URL после запуска участника не влияет на опубликованные адреса: во избежание расщепления конфигурации состава такие изменения должны пройти через кворум. Для обновления URL одноранговых узлов участника используйте etcdctl member update.
Развёртывание
Системные требования
Поскольку etcd записывает данные на диск, производительность сильно зависит от диска. Поэтому настоятельно рекомендуется SSD. Оценить, достаточно ли быстр диск для etcd, можно инструментом тестирования наподобие fio ; пример приведён здесь . Чтобы предотвратить снижение производительности или непреднамеренную перегрузку хранилища ключей и значений, etcd устанавливает настраиваемую квоту хранилища, по умолчанию равную 2GB. Во избежание свопинга или исчерпания памяти машина должна иметь как минимум достаточно RAM для покрытия квоты. Для обычных окружений рекомендуемый максимальный размер — 8GB; при превышении настроенного значения etcd выдаёт предупреждение при запуске. В CoreOS кластер etcd обычно развёртывается на выделенных машинах CoreOS Container Linux как минимум с двухъядерными процессорами, 2GB RAM и SSD на 80GB. Обратите внимание: производительность по своей природе зависит от нагрузки; проведите тестирование до рабочего развёртывания. Дополнительные рекомендации см. в разделе оборудование .
Наиболее стабильное рабочее окружение — операционная система Linux с архитектурой amd64; подробнее см. поддерживаемые платформы .
Почему в кластере должно быть нечётное число участников?
Для согласования обновлений состояния кластеру etcd требуется большинство узлов — кворум. В кластере из n участников кворум равен (n/2)+1. Добавление одного узла в любой кластер нечётного размера всегда увеличивает количество узлов, необходимое для кворума. Хотя добавление узла кажется улучшением благодаря большему числу машин, отказоустойчивость ухудшается: без потери кворума может отказать ровно столько же узлов, но возможных точек отказа становится больше. Если кластер больше не допускает ни одного отказа, добавлять узел до удаления неисправного опасно: если новый узел не сможет зарегистрироваться, например из-за неверного адреса, кворум будет потерян навсегда.
Каков максимальный размер кластера?
Теоретически жёсткого ограничения нет. Однако кластер etcd, вероятно, не должен содержать более семи узлов. Служба блокировок Google Chubby , похожая на etcd и много лет широко используемая в Google, рекомендует пять узлов. Кластер etcd из 5 участников выдерживает отказ двух участников, чего достаточно в большинстве случаев. Более крупные кластеры лучше переносят отказы, но производительность записи снижается, поскольку данные нужно реплицировать на большее число машин.
Какова устойчивость к отказам?
Кластер etcd работает, пока можно сформировать кворум участников. Если кворум потерян из-за временных сетевых сбоев, например разделения сети, после её восстановления etcd автоматически и безопасно возобновляет работу и восстанавливает кворум; Raft обеспечивает согласованность кластера. На случай отключения питания etcd сохраняет журнал Raft на диск, воспроизводит его до точки сбоя и возобновляет участие в кластере. При постоянном отказе оборудования узел можно удалить посредством динамического изменения конфигурации .
Рекомендуется использовать в кластере нечётное число участников. Кластер нечётного размера выдерживает столько же отказов, сколько кластер чётного размера, но содержит меньше узлов. Различие показано в таблице:
| Размер кластера | Большинство | Допустимые отказы |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
| 8 | 5 | 3 |
| 9 | 5 | 4 |
Добавление участника, доводящее размер кластера до чётного числа, не повышает отказоустойчивость. Кроме того, при разделении сети нечётное число участников гарантирует существование части с большинством, которая продолжит работу и останется источником истины после устранения разделения.
Работает ли etcd в развёртываниях между регионами или центрами обработки данных?
Развёртывание etcd в нескольких регионах повышает отказоустойчивость, поскольку участники находятся в разных доменах отказа. Цена этого — повышенная задержка запросов консенсуса из-за пересечения границ центров обработки данных. Поскольку для консенсуса etcd опирается на кворум, задержка между центрами будет заметной: на запросы должно ответить как минимум большинство участников. Кроме того, данные кластера реплицируются на все одноранговые узлы, что требует дополнительной пропускной способности.
При больших задержках конфигурация etcd по умолчанию может вызывать частые выборы или истечение тайм-аутов сигналов активности. Настройка тайм-аутов для таких развёртываний описана в разделе оптимизация .
Эксплуатация
Как создать резервную копию кластера etcd?
Для создания резервных копий etcdctl предоставляет команду snapshot. Подробнее см. резервное копирование
.
Следует ли добавлять участника до удаления неисправного?
При замене узла etcd важно сначала удалить участника, а затем добавить замену.
etcd использует распределённый консенсус на основе кворума: прежде чем предложение будет зафиксировано в кластере, с ним должно согласиться большинство — (n/2)+1 участников. Предложения включают обновления ключей и значений и изменения состава кластера. Эта модель полностью предотвращает несогласованность из-за расщепления кластера, но постоянная потеря кворума катастрофична.
Применительно к составу это означает следующее. Если в кластере из 3 участников 1 участник не работает, кластер всё ещё может продвигаться: кворум равен 2, и 2 участника активны. Однако добавление нового участника в кластер из 3 участников увеличивает кворум до 3, поскольку для большинства из 4 участников нужны 3 голоса. Из-за увеличения кворума дополнительный участник не повышает отказоустойчивость: кластер по-прежнему отделяет от невосстановимого состояния отказ одного узла.
Кроме того, новый участник создаёт риск: он может оказаться неверно настроенным или неспособным присоединиться к кластеру. Тогда восстановить кворум невозможно: два участника не работают, два работают, но для изменения состава и отмены неудачного добавления нужны три голоса. По умолчанию etcd отклоняет попытки добавления участников, способные вывести кластер из строя таким образом.
Если же сначала удалить неработающего участника из состава кластера, число участников станет равно 2, а кворум останется равен 2. Последующее добавление нового участника также сохранит кворум 2. Поэтому даже при невозможности запустить новый узел его всё ещё можно удалить решением кворума оставшихся активных участников.
Почему etcd не принимает изменения состава кластера?
etcd задаёт strict-reconfig-check, чтобы отклонять запросы изменения конфигурации, приводящие к потере кворума. Отказ от кворума крайне опасен, особенно если кластер уже неисправен. При потере кворума может возникнуть желание отключить проверку ради добавления участника, однако это способно привести к полной несогласованности кластера. Для многих приложений проблема станет ещё хуже («повреждение геометрии диска» — один из наиболее пугающих вариантов).
Почему etcd теряет лидера при всплесках дисковой задержки?
Это сделано намеренно: дисковая задержка влияет на активность лидера. Предположим, лидеру кластера требуется минута для fsync обновления журнала raft на диск, а тайм-аут выборов кластера etcd равен одной секунде. Хотя лидер может обрабатывать сетевые сообщения в пределах интервала выборов, например отправлять сигналы активности, фактически он недоступен, поскольку не может зафиксировать новые предложения и ждёт медленный диск. Если кластер часто теряет лидера из-за дисковой задержки, попробуйте настроить параметры диска или времени etcd.
Что означает предупреждение etcd “request ignored (cluster ID mismatch)”?
Каждый новый кластер etcd создаёт новый идентификатор кластера на основе исходной конфигурации и заданного пользователем уникального значения initial-cluster-token. Уникальные идентификаторы защищают etcd от взаимодействия между кластерами, способного повредить кластер.
Обычно предупреждение возникает после уничтожения старого кластера и повторного использования части его адресов одноранговых узлов в новом. Если какой-либо процесс etcd старого кластера всё ещё работает, он попытается связаться с новым кластером. Новый кластер обнаружит несовпадение идентификаторов, проигнорирует запрос и выдаст предупреждение. Как правило, проблема устраняется, если адреса одноранговых узлов разных кластеров не пересекаются.
Что означает “mvcc: database space exceeded” и как это исправить?
Модель данных etcd с многоверсионным управлением параллелизмом
хранит точную историю пространства ключей. Без её периодической компактизации, например посредством --auto-compaction, etcd в итоге исчерпает место в хранилище. При нехватке места etcd активирует аварийный сигнал квоты, защищая кластер от дальнейших записей. Пока сигнал активен, etcd отвечает на запросы записи ошибкой mvcc: database space exceeded.
Чтобы восстановиться после аварийного сигнала нехватки места:
- Компактизируйте историю etcd.
- Дефрагментируйте каждую конечную точку etcd.
- Сбросьте аварийный сигнал.
Что означает предупреждение etcd “etcdserver/api/v3rpc: transport: http2Server.HandleStreams failed to read frame: read tcp 127.0.0.1:2379->127.0.0.1:43020: read: connection reset by peer”?
Это предупреждение gRPC появляется, когда сервер получает флаг TCP RST при преждевременном закрытии клиентских потоков. Например, клиент закрывает соединение, пока сервер gRPC ещё не обработал все кадры HTTP/2 в очереди TCP. Часть данных на стороне сервера могла быть потеряна, но это допустимо, если клиентское соединение уже закрыто.
Такое сообщение записывают только старые версии gRPC
. etcd >=v3.2.13 по умолчанию записывает его на уровне DEBUG
, поэтому оно видно лишь при включённом флаге --log-level=debug.
Производительность
Как тестировать производительность etcd?
Используйте инструмент benchmark . Для сравнения доступны текущие результаты тестов .
Что означает предупреждение etcd “apply entries took too long”?
После того как большинство участников etcd согласится зафиксировать запрос, каждый сервер etcd применяет его к своему хранилищу данных и сохраняет результат на диск. Даже с медленным механическим или виртуализированным сетевым диском наподобие Amazon EBS или Google PD применение запроса обычно должно занимать менее 50 миллисекунд. Если средняя длительность превышает 100 миллисекунд, etcd предупреждает, что применение записей занимает слишком много времени.
Обычно проблема вызвана медленным диском. Возможно, etcd конкурирует за диск с другими приложениями либо сам диск слишком медленный, например общий виртуализированный диск. Чтобы исключить эту причину, отслеживайте backend_commit_duration_seconds : длительность p99 должна быть меньше 25ms, что подтверждает достаточную скорость диска. Если диск слишком медленный, проблему обычно решает выделенный диск для etcd или более быстрый накопитель.
Вторая по распространённости причина — нехватка CPU. Если мониторинг показывает высокую загрузку CPU машины, вычислительной мощности для etcd может быть недостаточно. Обычно помогает перенос etcd на выделенную машину, усиление изоляции ресурсов процесса с помощью cgroups или повышение приоритета процесса сервера etcd через renice.
Дорогостоящие пользовательские запросы, обращающиеся к слишком большому числу ключей, например извлекающие всё пространство ключей, также могут вызывать длительную задержку применения. Однако запросы менее чем к нескольким сотням ключей всегда должны выполняться эффективно.
Если ни одна из рекомендаций не устраняет предупреждения, создайте проблему с подробными журналами, данными мониторинга, метриками и, по возможности, сведениями о нагрузке.
Что означает предупреждение etcd “failed to send out heartbeat on time”?
Для согласованной репликации данных и выполнения журнала etcd использует протокол консенсуса на основе лидера. Участники кластера выбирают одного лидера, а остальные становятся последователями. Для сохранения лидерства избранный лидер должен периодически отправлять последователям сигналы активности. Если сигнал не поступает в течение интервала выборов, последователи считают лидера отказавшим и запускают выборы. Если работающий лидер не отправляет сигналы вовремя, выборы ложны и, вероятно, вызваны нехваткой ресурсов. Для обнаружения таких мягких отказов etcd предупреждает о несвоевременной отправке сигнала, если лидер пропустил два интервала активности.
Обычно проблема вызвана медленным диском. Перед отправкой сигналов активности с метаданными лидеру может потребоваться сохранить метаданные на диск. Возможно, etcd конкурирует за диск с другими приложениями либо сам диск слишком медленный, например общий виртуализированный диск. Чтобы исключить эту причину, отслеживайте wal_fsync_duration_seconds : длительность p99 должна быть меньше 10ms. Если диск слишком медленный, обычно помогает выделенный диск для etcd или более быстрый накопитель. Проверить скорость диска можно инструментом наподобие fio ; пример приведён здесь .
Вторая по распространённости причина — нехватка CPU. Если мониторинг показывает высокую загрузку CPU машины, вычислительной мощности для etcd может быть недостаточно. Обычно помогает перенос etcd на выделенную машину, усиление изоляции ресурсов процесса с помощью cgroups или повышение приоритета процесса сервера etcd через renice.
Причиной также может быть медленная сеть. Если сетевые метрики между машинами etcd показывают высокую задержку или большую долю потерь, пропускной способности сети может быть недостаточно. Обычно помогает перенос участников etcd в менее загруженную сеть. Однако при развёртывании кластера между центрами обработки данных высокая задержка между участниками ожидаема. В таких развёртываниях настройте heartbeat-interval примерно равным времени прохождения туда и обратно между машинами, а election-timeout — не менее 5 * heartbeat-interval. Подробнее см. документацию по оптимизации
.
Если ни одна из рекомендаций не устраняет предупреждения, создайте проблему с подробными журналами, данными мониторинга, метриками и, по возможности, сведениями о нагрузке.
Что означает предупреждение etcd “snapshotting is taking more than x seconds to finish …”?
etcd отправляет снимок всего хранилища ключей и значений для обновления медленных последователей и резервного копирования . Медленная передача снимка увеличивает MTTR; если кластер принимает данные с высокой пропускной способностью, медленные последователи могут попасть в бесконечный цикл, нуждаясь в новом снимке ещё до окончания получения предыдущего. Для обнаружения низкой производительности etcd предупреждает, если отправка снимка занимает более тридцати секунд и превышает ожидаемое время передачи через соединение 1Gbps.
7 - Библиотеки и инструменты
Обратите внимание: перечисленные ниже сторонние библиотеки и инструменты (размещённые не на https://github.com/etcd-io ) не тестируются и не сопровождаются командой etcd. Перед использованием рекомендуется прочитать и изучить их документацию и исходный код.
Инструменты
- etcdctl — клиент командной строки для etcd
- etcd-dump — утилита командной строки для выгрузки и восстановления etcd.
- etcd-fs — файловая система FUSE для etcd
- etcddir — синхронизация etcd с локальным каталогом в реальном времени. Работает в Windows и Linux.
- etcd-browser — веб-редактор ключей и значений etcd на AngularJS
- etcd-lock — реализация выборов главного узла и распределённой блокировки чтения/записи на основе etcd; поддерживает v2
- etcd-console — веб-редактор ключей и значений etcd на PHP
- etcd-viewer — редактор и средство просмотра хранилища ключей и значений etcd, написанное на Java
- etcdtool — экспорт, импорт и редактирование каталога etcd в JSON/YAML/TOML, а также проверка каталога по схеме JSON
- etcdloadtest — клиент командной строки для нагрузочного тестирования etcd версии 3.0 и выше.
- etcd-tui — современный терминальный пользовательский интерфейс (TUI) для работы с базой данных etcd. Позволяет переходить по ключам, просматривать значения, фильтровать данные и управлять кластером etcd непосредственно из терминала.
- etcdfinder — сверхбыстрый современный веб-интерфейс etcd с мгновенным поиском. Поддерживает etcd v2 и v3.
- lucas — веб-средство просмотра ключей и значений для кластера kubernetes etcd3.0+.
- etcd-manager — современный, эффективный, многоплатформенный и бесплатный графический интерфейс и клиентский инструмент etcd 3.x. Доступен для Windows, Linux и Mac.
- etcd-backup-restore — утилита для периодического инкрементного резервного копирования и восстановления etcd.
- etcd-druid — оператор Kubernetes для развёртывания кластеров etcd и управления эксплуатационными операциями 2-го дня.
- etcdadm — инструмент командной строки для эксплуатации кластера etcd.
- etcd-defrag — более удобный и интеллектуальный инструмент дефрагментации etcd.
- etcdhelper — плагин платформы intellij для etcd.
Библиотеки
В следующих разделах клиентские библиотеки etcd перечислены по языкам.
Go
- etcd/client/v3 — официально сопровождаемый клиент Go для v3
- go-etcd — устаревший официальный клиент. Может пригодиться для старых версий etcd (<2.0.0).
- encWrapper — оболочка шифрования для API Keys/KV клиента etcd.
Java
- coreos/jetcd — поддерживает v3
- justinsb/jetcd
- cdancy/etcd-rest — использует jclouds для полной реализации API v2.
- IBM/etcd-java
Scala
- maciej/etcd-client — поддерживает v2. Полностью асинхронный клиент на основе Akka HTTP
- eiipii/etcdhttpclient — поддерживает v2. Асинхронный клиент HTTP на основе Netty и Scala Futures.
- mingchuno/etcd4s — поддерживает v3 через gRPC с необязательной поддержкой Akka Stream.
Perl
- hexfusion/perl-net-etcd — поддерживает HTTP API шлюза grpc v3
- robn/p5-etcd — поддерживает v2
Python
- kragniz/python-etcd3 — клиент для v3
- jplana/python-etcd — поддерживает v2
- russellhaering/txetcd — библиотека Twisted для Python
- cholcombe973/autodock — инструмент автоматизации развёртывания Docker
- lisael/aioetcd — клиент на корутинах Asyncio (Python 3.4+), поддерживает v2
- txaio-etcd — асинхронная клиентская библиотека только для etcd v3: для Twisted сейчас и asyncio в будущем
- dims/etcd3-gateway — библиотека API etcd v3, использующая HTTP-шлюз grpc
- aioetcd3 — API etcd v3 для asyncio (Python 3.6+)
- Revolution1/etcd3-py — клиент Python для etcd v3 (python2.7 и python3.5+), использующий gRPC-JSON-Gateway
Node
- mixer/etcd3 — поддерживает v3
- stianeikeland/node-etcd — поддерживает v2 (с Coffeescript)
- lavagetto/nodejs-etcd — поддерживает v2
- deedubs/node-etcd-config — поддерживает v2
Ruby
- iconara/etcd-rb
- jpfuentes2/etcd-ruby
- ranjib/etcd-ruby — поддерживает v2
- davissp14/etcdv3-ruby — поддерживает v3
C
- apache/celix/etcdlib — поддерживает v2
- jdarcy/etcd-api — поддерживает v2
- shafreeck/cetcd — поддерживает v2
C++
- edwardcapriolo/etcdcpp — поддерживает v2
- suryanathan/etcdcpp — поддерживает v2 (с ожиданиями)
- nokia/etcd-cpp-api — поддерживает v2
- etcd-cpp-apiv3/etcd-cpp-apiv3 — поддерживает v3
Clojure
- aterreno/etcd-clojure
- dwwoelfel/cetcd — поддерживает v2
- rthomas/clj-etcd — поддерживает v2
Erlang
- marshall-lee/etcd.erl — поддерживает v2
- zhongwencool/eetcd — поддерживает v3+ (только GRPC)
Elixir
- team-telnyx/etcdex — поддерживает v3+ (только GRPC)
.NET
- wangjia184/etcdnet — поддерживает v2
- drusellers/etcetera
- shubhamranjan/dotnet-etcd — поддерживает v3+ (только GRPC)
- SimplifyNet/Etcd.Microsoft.Extensions.Configuration
PHP
- linkorb/etcd-php
- activecollab/etcd
- ouqiang/etcd-php — клиент для шлюза gRPC v3
Haskell
R
Nim
Tcl
- efrecon/etcd-tcl — поддерживает v2, кроме ожидания.
Rust
- jimmycuadra/rust-etcd — поддерживает v2
Gradle
- gradle-etcd-rest-plugin — поддерживает v2
Lua
- api7/lua-resty-etcd — поддерживает v2 и v3 (HTTP API шлюза grpc)
Инструменты развёртывания
Интеграции Chef
Рецепты Chef
Выпуски BOSH
Проекты, использующие etcd
- Пользователи Raft etcd — проекты, использующие реализацию библиотеки raft от etcd.
- Apache APISIX — шлюз API, использующий etcd как хранилище конфигурации.
- apache/celix — адаптированная для C и C++ реализация спецификации OSGi
- binocarlos/yoda — etcd + ZeroMQ
- blox/blox — набор проектов с открытым исходным кодом для управления контейнерами и оркестрации с AWS ECS
- calavera/active-proxy — HTTP-прокси, настраиваемый с помощью etcd
- chain/chain — программное обеспечение для работы и соединения высокомасштабируемых блокчейн-сетей с контролем доступа
- derekchiang/etcdplus — набор примитивов распределённой синхронизации на основе etcd
- go-discover — обнаружение служб на Go
- gleicon/goreman — ветвь клона Foreman на Go с поддержкой etcd
- garethr/hiera-etcd — бэкенд Puppet hiera на основе etcd
- mattn/etcd-vim — операции SET и GET с ключами из vim
- mattn/etcdenv — шебанг “env” с интеграцией etcd
- kelseyhightower/confd — управление локальными файлами конфигурации приложений с помощью шаблонов и данных etcd
- configdb — реляционная абстракция REST над произвольными бэкендами баз данных для хранения конфигураций и инвентарных данных.
- kubernetes/kubernetes — диспетчер контейнерных кластеров, созданный Google.
- mailgun/vulcand — HTTP-прокси, использующий etcd как бэкенд конфигурации.
- duedil-ltd/discodns — простой DNS-сервер имён, использующий etcd как базу данных имён и записей.
- skynetservices/skydns — DNS-сервер, соответствующий RFC
- xordataexchange/crypt — безопасное хранение значений в etcd с шифрованием GPG
- spf13/viper — библиотека конфигурации Go, читающая значения из ENV, pflags, файлов и etcd с необязательным шифрованием
- lytics/metafora — библиотека распределённых задач на Go
- ryandoyle/nss-etcd — модуль GNU libc NSS для разрешения имён из etcd.
- Gru — упрощённая оркестрация на Go
- Vitess — система кластеризации баз данных для горизонтального масштабирования MySQL.
- lclarkmichalek/etcdhcp — сервер DHCP, использующий etcd для постоянного хранения и координации.
- openstack/networking-vpp — сетевой драйвер, программирующий плоскость данных FD.io VPP для создания облачной виртуальной сети OpenStack
- OpenStack — службы OpenStack могут использовать etcd как базовую службу.
- CoreDNS — DNS-сервер CoreDNS, объединяющий плагины в цепочку и входящий в CNCF и Kubernetes
- Uber M3 — M3: крупномасштабная платформа метрик Uber с открытым исходным кодом для Prometheus
- Rook — оркестрация хранилища для Kubernetes
- Patroni — шаблон высокой доступности PostgreSQL с ZooKeeper, etcd или Consul
- Trillian — реализация дерева Меркла, содержимое которого обслуживается из уровня хранения данных, что позволяет масштабироваться до чрезвычайно больших деревьев.
- purpleidea/mgmt — новое поколение распределённого, событийного и параллельного управления конфигурацией!
- Portworx/kvdb — внутреннее хранилище kvdb для конфигурации кластера Portworx.
- Apache Pulsar — распределённая платформа обмена сообщениями и потоковой обработки с открытым исходным кодом, созданная для облака.
8 - Метрики
Для публикации метрик etcd использует Prometheus . Метрики можно применять для мониторинга и отладки в реальном времени. etcd не сохраняет метрики: при перезапуске участника они сбрасываются.
Проще всего просмотреть доступные метрики, запросив конечную точку /metrics с помощью cURL. Формат описан в документации Prometheus
.
Чтобы запустить сервер Prometheus для сбора метрик etcd, следуйте руководству Prometheus по началу работы .
Имена метрик соответствуют рекомендуемым практикам Prometheus
. Имя метрики содержит префикс пространства имён etcd или etcd_debugging и префикс подсистемы (например, wal и etcdserver).
Метрики пространства имён etcd
Метрики с префиксом etcd предназначены для мониторинга и оповещений. Это стабильные высокоуровневые метрики. Любое их изменение указывается в примечаниях к выпуску.
Метрики, относящиеся к etcd2, описаны в руководстве по метрикам v2 .
Сервер
Эти метрики описывают состояние сервера etcd. Чтобы выявлять сбои и проблемы при устранении неполадок, следует внимательно отслеживать серверные метрики каждого рабочего кластера etcd.
Все эти метрики имеют префикс etcd_server_
| Имя | Описание | Тип |
|---|---|---|
| has_leader | Существует ли лидер. 1 — существует, 0 — отсутствует. | Gauge |
| leader_changes_seen_total | Количество обнаруженных смен лидера. | Counter |
| proposals_committed_total | Общее количество зафиксированных предложений консенсуса. | Gauge |
| proposals_applied_total | Общее количество применённых предложений консенсуса. | Gauge |
| proposals_pending | Текущее количество ожидающих предложений. | Gauge |
| proposals_failed_total | Общее количество обнаруженных неудачных предложений. | Counter |
has_leader показывает, есть ли у участника лидер. Если у участника нет лидера, он полностью недоступен. Если лидера нет ни у одного участника кластера, весь кластер полностью недоступен.
leader_changes_seen_total подсчитывает количество смен лидера, замеченных участником с момента запуска. Частая смена лидера существенно снижает производительность etcd. Она также указывает на нестабильность лидера, возможно из-за проблем с сетевым соединением или чрезмерной нагрузки на кластер etcd.
proposals_committed_total регистрирует общее количество зафиксированных предложений консенсуса. В исправном кластере этот индикатор должен со временем расти. Несколько исправных участников кластера etcd могут одновременно иметь разные общие количества зафиксированных предложений. Расхождение может быть связано с восстановлением по данным одноранговых узлов после запуска, отставанием от лидера или с тем, что участник сам является лидером и потому имеет больше всего фиксаций. Важно отслеживать эту метрику для всех участников кластера: устойчиво большое отставание одного участника от его лидера означает, что этот участник работает медленно или неисправен.
proposals_applied_total регистрирует общее количество применённых предложений консенсуса. Сервер etcd применяет каждое зафиксированное предложение асинхронно. Разница между proposals_committed_total и proposals_applied_total обычно должна быть небольшой (не более нескольких тысяч даже при высокой нагрузке). Если она продолжает расти, сервер etcd перегружен. Такое возможно при выполнении дорогостоящих запросов, например тяжёлых диапазонных запросов или крупных операций txn.
proposals_pending показывает количество предложений в очереди на фиксацию. Рост числа ожидающих предложений указывает на высокую клиентскую нагрузку либо на неспособность участника фиксировать предложения.
proposals_failed_total обычно связано с двумя проблемами: временными сбоями во время выборов лидера или более длительным простоем из-за потери кворума в кластере.
Диск
Эти метрики описывают состояние дисковых операций.
Все эти метрики имеют префикс etcd_disk_.
| Имя | Описание | Тип |
|---|---|---|
| wal_fsync_duration_seconds | Распределение задержки вызова fsync подсистемой wal | Histogram |
| backend_commit_duration_seconds | Распределение задержки вызова commit бэкендом. | Histogram |
wal_fsync вызывается, когда etcd сохраняет записи журнала на диск перед их применением.
backend_commit вызывается, когда etcd фиксирует на диске инкрементный снимок последних изменений.
Высокая задержка дисковых операций (wal_fsync_duration_seconds или backend_commit_duration_seconds) часто указывает на проблемы с диском. Она может привести к высокой задержке запросов или сделать кластер нестабильным.
Сеть
Эти метрики описывают состояние сети.
Все эти метрики имеют префикс etcd_network_
| Имя | Описание | Тип |
|---|---|---|
| peer_sent_bytes_total | Общее количество байтов, отправленных одноранговому узлу с ID To. | Counter(To) |
| peer_received_bytes_total | Общее количество байтов, полученных от однорангового узла с ID From. | Counter(From) |
| peer_sent_failures_total | Общее количество сбоев отправки одноранговому узлу с ID To. | Counter(To) |
| peer_received_failures_total | Общее количество сбоев получения от однорангового узла с ID From. | Counter(From) |
| peer_round_trip_time_seconds | Гистограмма времени прохождения туда и обратно между одноранговыми узлами. | Histogram(To) |
| client_grpc_sent_bytes_total | Общее количество байтов, отправленных клиентам grpc. | Counter |
| client_grpc_received_bytes_total | Общее количество байтов, полученных от клиентов grpc. | Counter |
peer_sent_bytes_total подсчитывает общее количество байтов, отправленных определённому одноранговому узлу. Обычно участник-лидер отправляет больше данных, чем остальные участники, поскольку отвечает за передачу реплицированных данных.
peer_received_bytes_total подсчитывает общее количество байтов, полученных от определённого однорангового узла. Обычно участники-последователи получают данные только от участника-лидера.
Запросы gRPC
Эти метрики предоставляются через go-grpc-prometheus .
Метрики пространства имён etcd_debugging
Метрики с префиксом etcd_debugging предназначены для отладки. Они сильно зависят от реализации и нестабильны. В новых выпусках etcd они могут изменяться или удаляться без предупреждения. По мере стабилизации некоторые метрики могут быть перенесены под префикс etcd.
Снимок
| Имя | Описание | Тип |
|---|---|---|
| snapshot_save_total_duration_seconds | Общее распределение задержки вызова сохранения снимком | Histogram |
Аномально большая длительность создания снимка (snapshot_save_total_duration_seconds) указывает на проблемы с диском и может сделать кластер нестабильным.
Метрики, предоставляемые Prometheus
Клиентская библиотека Prometheus предоставляет ряд метрик в пространствах имён go и process. Некоторые из них особенно полезны.
| Имя | Описание | Тип |
|---|---|---|
| process_open_fds | Количество открытых файловых дескрипторов. | Gauge |
| process_max_fds | Максимальное количество файловых дескрипторов. | Gauge |
Метрики процесса, такие как process_open_fds и process_max_fds, в настоящее время не поддерживаются в системах Darwin (macOS).
Интенсивное использование файловых дескрипторов (process_open_fds), то есть приближение к их лимиту для процесса (process_max_fds), указывает на возможное исчерпание файловых дескрипторов. При их исчерпании etcd может аварийно завершиться, поскольку не сможет создавать новые файлы WAL.
Сгенерированный список метрик
9 - Сообщение об ошибках
Если в какой-либо части проекта etcd обнаружена ошибка или неточность в документации, сообщите нам, создав issue . Мы очень серьёзно относимся к ошибкам и считаем, что незначительных проблем не бывает. Перед созданием отчёта убедитесь, что issue с описанием той же проблемы ещё не существует.
Чтобы отчёт был точным и понятным, постарайтесь соблюдать следующие требования:
Конкретность. Укажите как можно больше подробностей: версию, окружение, конфигурацию и другие существенные сведения. Если ошибка связана с работой сервера etcd, приложите журнал etcd; особенно важны начальные сообщения с конфигурацией etcd.
Воспроизводимость. Приведите шаги для воспроизведения проблемы. Некоторые проблемы трудно воспроизвести, но в таком случае укажите хотя бы действия, которые могут к ней привести. По возможности приложите затронутый каталог данных etcd и трассировку стека.
Изолированность. Постарайтесь изолировать и воспроизвести ошибку с минимальным числом зависимостей. Большое количество зависимостей в отчёте существенно замедляет исправление. Отладка внешних систем, зависящих от etcd, выходит за рамки проекта, но мы готовы подсказать правильное направление или помочь с использованием самого etcd.
Уникальность. Не дублируйте существующие отчёты об ошибках.
Ограниченная область. Один отчёт должен описывать одну ошибку. Не добавляйте в тот же отчёт другую проблему.
Перед созданием отчёта полезно прочитать статью Elika Etemad о качественных отчётах об ошибках .
Для локализации ошибки мы можем запросить дополнительные сведения. Дублирующий отчёт будет закрыт.
Часто задаваемые вопросы
Как получить трассировку стека
Как узнать версию etcd
Как получить конфигурацию и журнал etcd при запуске службой systemd «etcd2.service»
Из-за ошибки в systemd journald может потерять несколько последних строк журнала при завершении процессов. Если journalctl сообщает, что etcd остановлен, но в журнале нет сообщения fatal или panic, выполните sudo journalctl -f -t etcd2, чтобы получить полный журнал.
10 - Настройка производительности
Настройки etcd по умолчанию хорошо подходят для локальных сетей с небольшой средней задержкой. Однако при использовании etcd в нескольких центрах обработки данных или в сети с высокой задержкой может потребоваться настроить интервал heartbeat и тайм-аут выборов.
Сеть — не единственный источник задержки. На каждый запрос и ответ могут влиять медленные диски лидера и последователя. Каждый из этих тайм-аутов охватывает полное время от отправки запроса до успешного ответа другой машины.
Временные параметры
Базовый протокол распределённого консенсуса использует два независимых временных параметра, чтобы узлы могли передать лидерство при зависании или отключении лидера. Первый параметр — интервал heartbeat. Он определяет, как часто лидер сообщает последователям, что по-прежнему остаётся лидером.
Рекомендуется устанавливать его примерно равным времени кругового обхода между участниками. По умолчанию etcd использует интервал heartbeat 100ms.
Второй параметр — тайм-аут выборов. Он определяет, как долго последователь может не получать heartbeat, прежде чем сам попытается стать лидером. По умолчанию etcd использует тайм-аут выборов 1000ms.
Выбор этих значений является компромиссом. Интервал heartbeat рекомендуется задавать примерно равным максимальному среднему времени кругового обхода (RTT) между участниками, обычно 0.5-1.5x RTT. Слишком малый интервал заставляет etcd отправлять лишние сообщения и увеличивает потребление ресурсов CPU и сети. Слишком большой интервал приводит к большому тайм-ауту выборов, а значит замедляет обнаружение отказа лидера. Проще всего измерить RTT с помощью утилиты PING .
Тайм-аут выборов следует выбирать на основе интервала heartbeat и среднего RTT между участниками. Он должен как минимум в 10 раз превышать RTT, чтобы учитывать колебания сети. Например, если RTT между участниками равен 10ms, тайм-аут выборов должен составлять не менее 100ms.
Верхний предел тайм-аута выборов — 50000ms (50s); использовать его следует только в глобально распределённом кластере etcd. Разумный RTT в пределах континентальной части США составляет 130ms, а между США и Японией — около 350-400ms. При неравномерной работе сети или регулярных задержках и потерях пакетов для успешной передачи может потребоваться несколько попыток. Поэтому 5s — безопасная верхняя граница глобального RTT. Поскольку тайм-аут выборов должен быть на порядок больше времени распространения, при глобальном RTT около ~5s разумный максимум составляет 50 секунд.
Интервал heartbeat и тайм-аут выборов должны быть одинаковыми у всех участников одного кластера. Разные значения могут нарушить стабильность кластера.
Значения по умолчанию можно переопределить в командной строке:
Значения задаются в миллисекундах.
Снимки
etcd добавляет каждое изменение ключа в файл журнала. Этот журнал растёт неограниченно и содержит полную линейную историю всех изменений ключей. Для малонагруженных кластеров это удобно, но активно используемые кластеры вынуждены хранить большой журнал.
Чтобы журнал не становился огромным, etcd периодически создаёт снимки. Снимки позволяют компактизировать журнал: сохранить текущее состояние системы и удалить старые записи.
Настройка снимков
Создание снимков с бэкендом V2 может быть дорогой операцией, поэтому они создаются только после заданного числа изменений etcd. По умолчанию снимок создаётся после каждых 10,000 изменений. Если etcd использует слишком много памяти или дискового пространства, уменьшите порог снимка в командной строке:
Диск
Кластер etcd очень чувствителен к задержкам диска. Поскольку etcd должен сохранять предложения в журнале, дисковая активность других процессов может вызывать большие задержки fsync. В результате etcd может пропускать heartbeat, что приводит к тайм-аутам запросов и временной потере лидера. Иногда сервер etcd может стабильно работать рядом с такими процессами, если ему назначить высокий дисковый приоритет.
В Linux дисковый приоритет etcd настраивается с помощью ionice:
Сеть
Если лидер etcd обслуживает большое число параллельных клиентских запросов, из-за перегрузки сети может задерживаться обработка запросов от последователей. На узлах-последователях это проявляется сообщениями об ошибке буфера отправки:
Эти ошибки можно устранить, назначив трафику между участниками etcd более высокий приоритет, чем клиентскому трафику. В Linux приоритет настраивается механизмом управления трафиком:
Чтобы отменить настройку tc, выполните:
CPU
Поскольку etcd очень чувствителен к задержке, в Linux производительность можно дополнительно оптимизировать, переведя регулятор частоты CPU в режим performance или conservative.
В Linux режим performance настраивается командой:
11 - Внутренности
11.1 - Протокол службы обнаружения
Протокол службы обнаружения помогает новому участнику etcd найти остальных участников на этапе начальной инициализации кластера с помощью общего токена обнаружения и списка конечных точек.
Протокол используется только во время начальной инициализации и не подходит для реконфигурации во время выполнения или мониторинга кластера.
Один новый токен обнаружения предназначен для инициализации одного уникального кластера etcd. Один токен может представлять только один кластер. После запуска протокола для токена его нельзя использовать для инициализации другого кластера etcd, даже если первый процесс завершился с ошибкой на полпути.
Далее процесс обнаружения рассматривается на примере самостоятельно размещённого кластера обнаружения.
Этот документ относится только к обнаружению v3. Обнаружение v2 подробнее описано в предыдущем документе .
Рабочий процесс протокола
Протокол использует внутренний кластер etcd для координации начальной инициализации нового кластера. Сначала все новые участники взаимодействуют со службой обнаружения и совместно формируют ожидаемый список участников. Затем каждый участник запускает свой сервер с этим списком, что выполняет ту же функцию, что и флаг -initial-cluster.
В примере ниже каждый шаг показан с помощью команды etcdctl. Предполагается, что на http://example.com:2379 работает кластер etcd, обслуживающий службу обнаружения.
По соглашению протокол обнаружения etcd использует префикс ключей /_etcd/registry.
Создание нового токена обнаружения
Создайте уникальный токен, идентифицирующий новый кластер. На следующих шагах он будет уникальным префиксом в пространстве ключей обнаружения. Простой способ создать токен — использовать uuidgen:
Указание ожидаемого размера кластера
Для токена обнаружения необходимо указать размер кластера. Служба использует его, чтобы определить, когда найдены все участники, изначально формирующие кластер.
Обычно размер кластера равен 3, 5 или 7. Подробнее см. в разделе оптимального размера кластера .
Запуск процессов etcd
Передайте токен обнаружения ${UUID} флагу --discovery-token, а конечные точки кластера etcd, обслуживающего службу обнаружения, — флагу --discovery-endpoints. Это включает обнаружение v3 для начальной инициализации кластера etcd.
Если заданы флаги --discovery-token и --discovery-endpoints, каждый процесс etcd выполняет следующие шаги автоматически.
Если служба обнаружения использует аутентификацию по клиентским сертификатам, настройте следующие флаги. Они применяются так же, как при обращении etcdctl к кластеру etcd.
Если служба обнаружения использует ролевую аутентификацию, настройте следующие флаги. Они применяются так же, как при обращении etcdctl к кластеру etcd.
Значения времени и тайм-аутов по умолчанию можно изменить следующими флагами, которые применяются так же, как при обращении etcdctl к кластеру etcd.
Саморегистрация
Сначала каждый процесс etcd регистрирует себя как участника нового кластера. Для этого ID участника создаётся как ключ в полном ключе реестра.
Проверка состояния
Процесс проверяет ожидаемый размер кластера и состояние регистрации, а затем выбирает следующее действие.
Если зарегистрированных участников пока недостаточно, процесс ожидает появления остальных.
Если зарегистрированных участников больше ожидаемого размера N, первые N участников принимаются за список кластера. Если текущий участник входит в список, процедура обнаружения завершается успешно и получает из списка всех одноранговых участников. Если его в списке нет, процедура завершается ошибкой, сообщающей, что кластер заполнен.
Участник может проверить состояние кластера ещё до саморегистрации, поэтому при заполненном кластере отказ произойдёт быстро.
Ожидание всех участников
Процесс продолжает наблюдать за префиксом ключей /_etcd/registry/${UUID}/members, пока не найдёт всех участников.
11.2 - Соглашения по ведению журнала
etcd использует библиотеку zap для ведения журнала вывода приложения, категоризированного по уровням. Уровень сообщения в журнале определяется в соответствии со следующими соглашениями:
Логи DebugLevel обычно объёмные и обычно отключены в рабочей среде.
- Примеры:
- Отправка обычного сообщения удалённому узлу
- Запись записи журнала на диск
- Примеры:
Уровень InfoLevel является уровнем ведения журнала по умолчанию.
- Примеры:
- Конфигурация при запуске
- Начало создания снимка
- Добавление нового узла в кластер
- Добавление нового пользователя в подсистему аутентификации
- Примеры:
Журналы уровня Warn более важны, чем Info, но не требуют индивидуального человеческого контроля.
- Примеры:
- Неудача при отправке сообщения Raft удалённому узлу
- Неудача при получении сообщения heartbeat в течение заданного тайм-аута выборов
- Примеры:
Журналы уровня ошибок имеют высокий приоритет. Если приложение работает без сбоев, оно не должно генерировать журналы уровня ошибок.
- Примеры:
- Неудача выделения дискового пространства для WAL
- Примеры:
PanicLevel записывает сообщение, а затем вызывает панику.
- Примеры:
- Сбой при кодировании сообщений Raft
- Примеры:
FatalLevel записывает сообщение, а затем вызывает os.Exit(1).
- Примеры:
- Неудача при сохранении снимка Raft
- Примеры:
11.3 - Модули Golang
Начиная с версии 3.5 проект etcd организован как несколько модулей Golang , размещённых в одном репозитории .
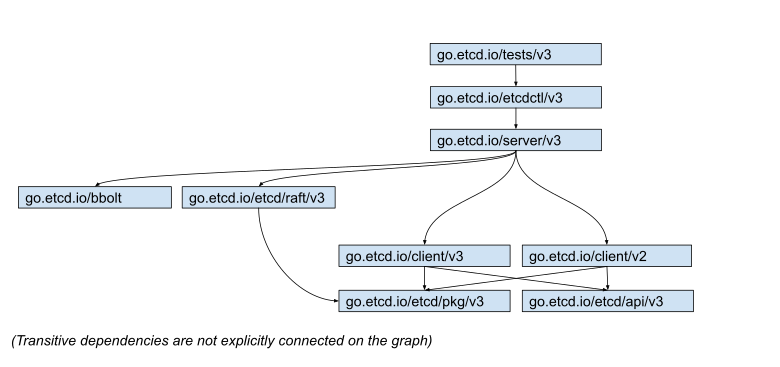
Проект включает следующие модули:
go.etcd.io/etcd/api/v3 — определения API, например protos и созданные из proto библиотеки, которые задают протокол взаимодействия между клиентами и сервером etcd.
go.etcd.io/etcd/pkg/v3 — набор вспомогательных пакетов, используемых etcd, но не зависящих от его специфики. Пакет следует размещать здесь только в том случае, если в будущем его можно будет вынести в отдельный репозиторий. Не добавляйте сюда код с большим числом собственных зависимостей: они автоматически станут зависимостями клиентской библиотеки, которую важно сохранять легковесной.
go.etcd.io/etcd/client/v3 — клиентская библиотека для сетевого обращения к etcd по grpc. Рекомендуется для всех новых применений etcd.
go.etcd.io/etcd/client/v2 — устаревшая клиентская библиотека для обращения к etcd по протоколу HTTP. Новые проекты должны зависеть от библиотеки /v3.
go.etcd.io/etcd/raft/v3 — реализация протокола распределённого консенсуса. Не должна содержать код, специфичный для etcd.
go.etcd.io/etcd/server/v3 — реализация etcd. Код этого пакета является внутренним и не предназначен для внешних проектов. Структура пакета и API могут меняться между минорными версиями.
go.etcd.io/etcd/etcdctl/v3 — инструмент командной строки для доступа к etcd и управления им.
go.etcd.io/etcd/tests/v3 — модуль со всеми интеграционными тестами etcd. Обратите внимание: все модульные тесты — быстрые и не требующие межмодульных зависимостей — должны храниться в локальном модуле рядом с тестируемым кодом.
go.etcd.io/bbolt — реализация постоянного b-tree. Размещается в отдельном репозитории: https://github.com/etcd-io/bbolt .
Операции
Все модули etcd должны выпускаться с одинаковыми версиями; например,
go.etcd.io/etcd/client/v3@v3.5.10должен зависеть отgo.etcd.io/etcd/api/v3@v3.5.10.Согласованно обновить версии можно командой:
Выпущенные модули должны получать теги по правилам https://golang.org/ref/mod#vcs-version , то есть каждому модулю требуется собственный тег. Создать теги можно командой:
Все модули etcd должны зависеть от одинаковых версий базовых зависимостей. Это проверяется командой:
Файлы go.mod не должны содержать неиспользуемых зависимостей и должны соответствовать формату
go mod tidy. Проверка выполняется командой:Для запуска действий во всех модулях, например автоматического форматирования всех файлов, используйте или расширьте следующий скрипт:
Будущее
В качестве целевой модели предлагается развивать модули etcd следующим образом:
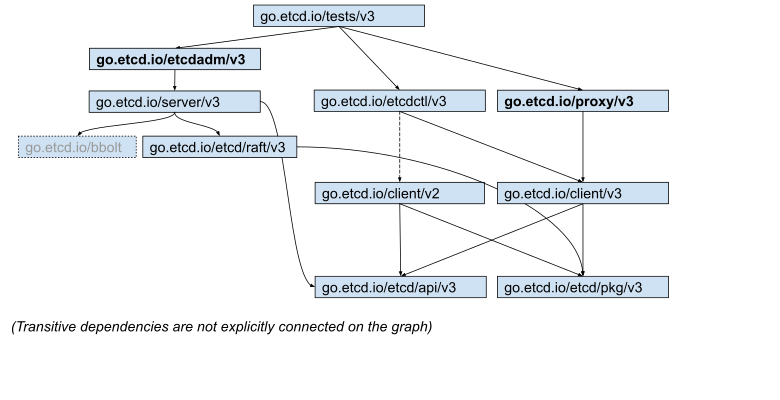
Предполагается:
- Вынести etcdmigrate/etcdadm из бинарного файла etcdctl. Тогда etcdctl станет однозначной оболочкой командной строки над сетевым клиентским API, а etcdmigrate/etcdadm будет выполнять прямые физические операции с файлами хранилища etcd.
- Вынести etcd-proxy из бинарного файла ./etcd: он содержит больше экспериментального кода, а значит несёт дополнительные риски и зависимости.
- Прекратить поддержку протокола v2.
12 - Учеба
12.1 - Модель данных
etcd предназначен для надёжного хранения редко обновляемых данных и выполнения надёжных запросов наблюдения. etcd предоставляет предыдущие версии пар «ключ — значение», поддерживая недорогие снимки и историю событий наблюдения («запросы с перемещением во времени»). Для этих сценариев хорошо подходит постоянная многоверсионная модель данных с управлением параллелизмом.
etcd хранит данные в многоверсионном постоянном хранилище ключей и значений. Когда значение пары заменяется новыми данными, постоянное хранилище сохраняет её предыдущую версию. Фактически хранилище неизменяемо: операции не обновляют структуру на месте, а всегда создают новую обновлённую структуру. После изменения все прежние версии ключей остаются доступными для чтения и наблюдения. Чтобы хранилище не росло бесконечно и не сохраняло старые версии, его можно компактизировать, удалив самые старые версии замещённых данных.
Логическое представление
Логически хранилище представляет собой плоское пространство двоичных ключей. Пространство имеет лексически отсортированный индекс по ключам — строкам байтов, поэтому запросы диапазонов выполняются недорого.
Пространство ключей поддерживает несколько ревизий. При создании хранилища начальная ревизия равна 1. Каждая атомарная изменяющая операция — например, одна транзакция может содержать несколько операций — создаёт новую ревизию пространства ключей. Данные предыдущих ревизий остаются неизменными. Старые версии ключа доступны через прежние ревизии. Сами ревизии также индексируются, поэтому наблюдатели эффективно перебирают их диапазоны. При компактизации для экономии места ревизии до ревизии компактизации удаляются. На протяжении жизни кластера номер ревизии монотонно возрастает.
Жизнь ключа образует поколение от создания до удаления. У ключа может быть одно или несколько поколений. Создание ключа увеличивает его версию, начиная с 1, если ключ не существует в текущей ревизии. Удаление создаёт надгробную метку ключа, завершает текущее поколение и сбрасывает версию в 0. Каждое изменение ключа увеличивает версию, поэтому внутри поколения версии монотонно возрастают. После компактизации удаляются все поколения, завершившиеся до ревизии компактизации, а также все значения, заданные до неё, кроме самого нового.
Физическое представление
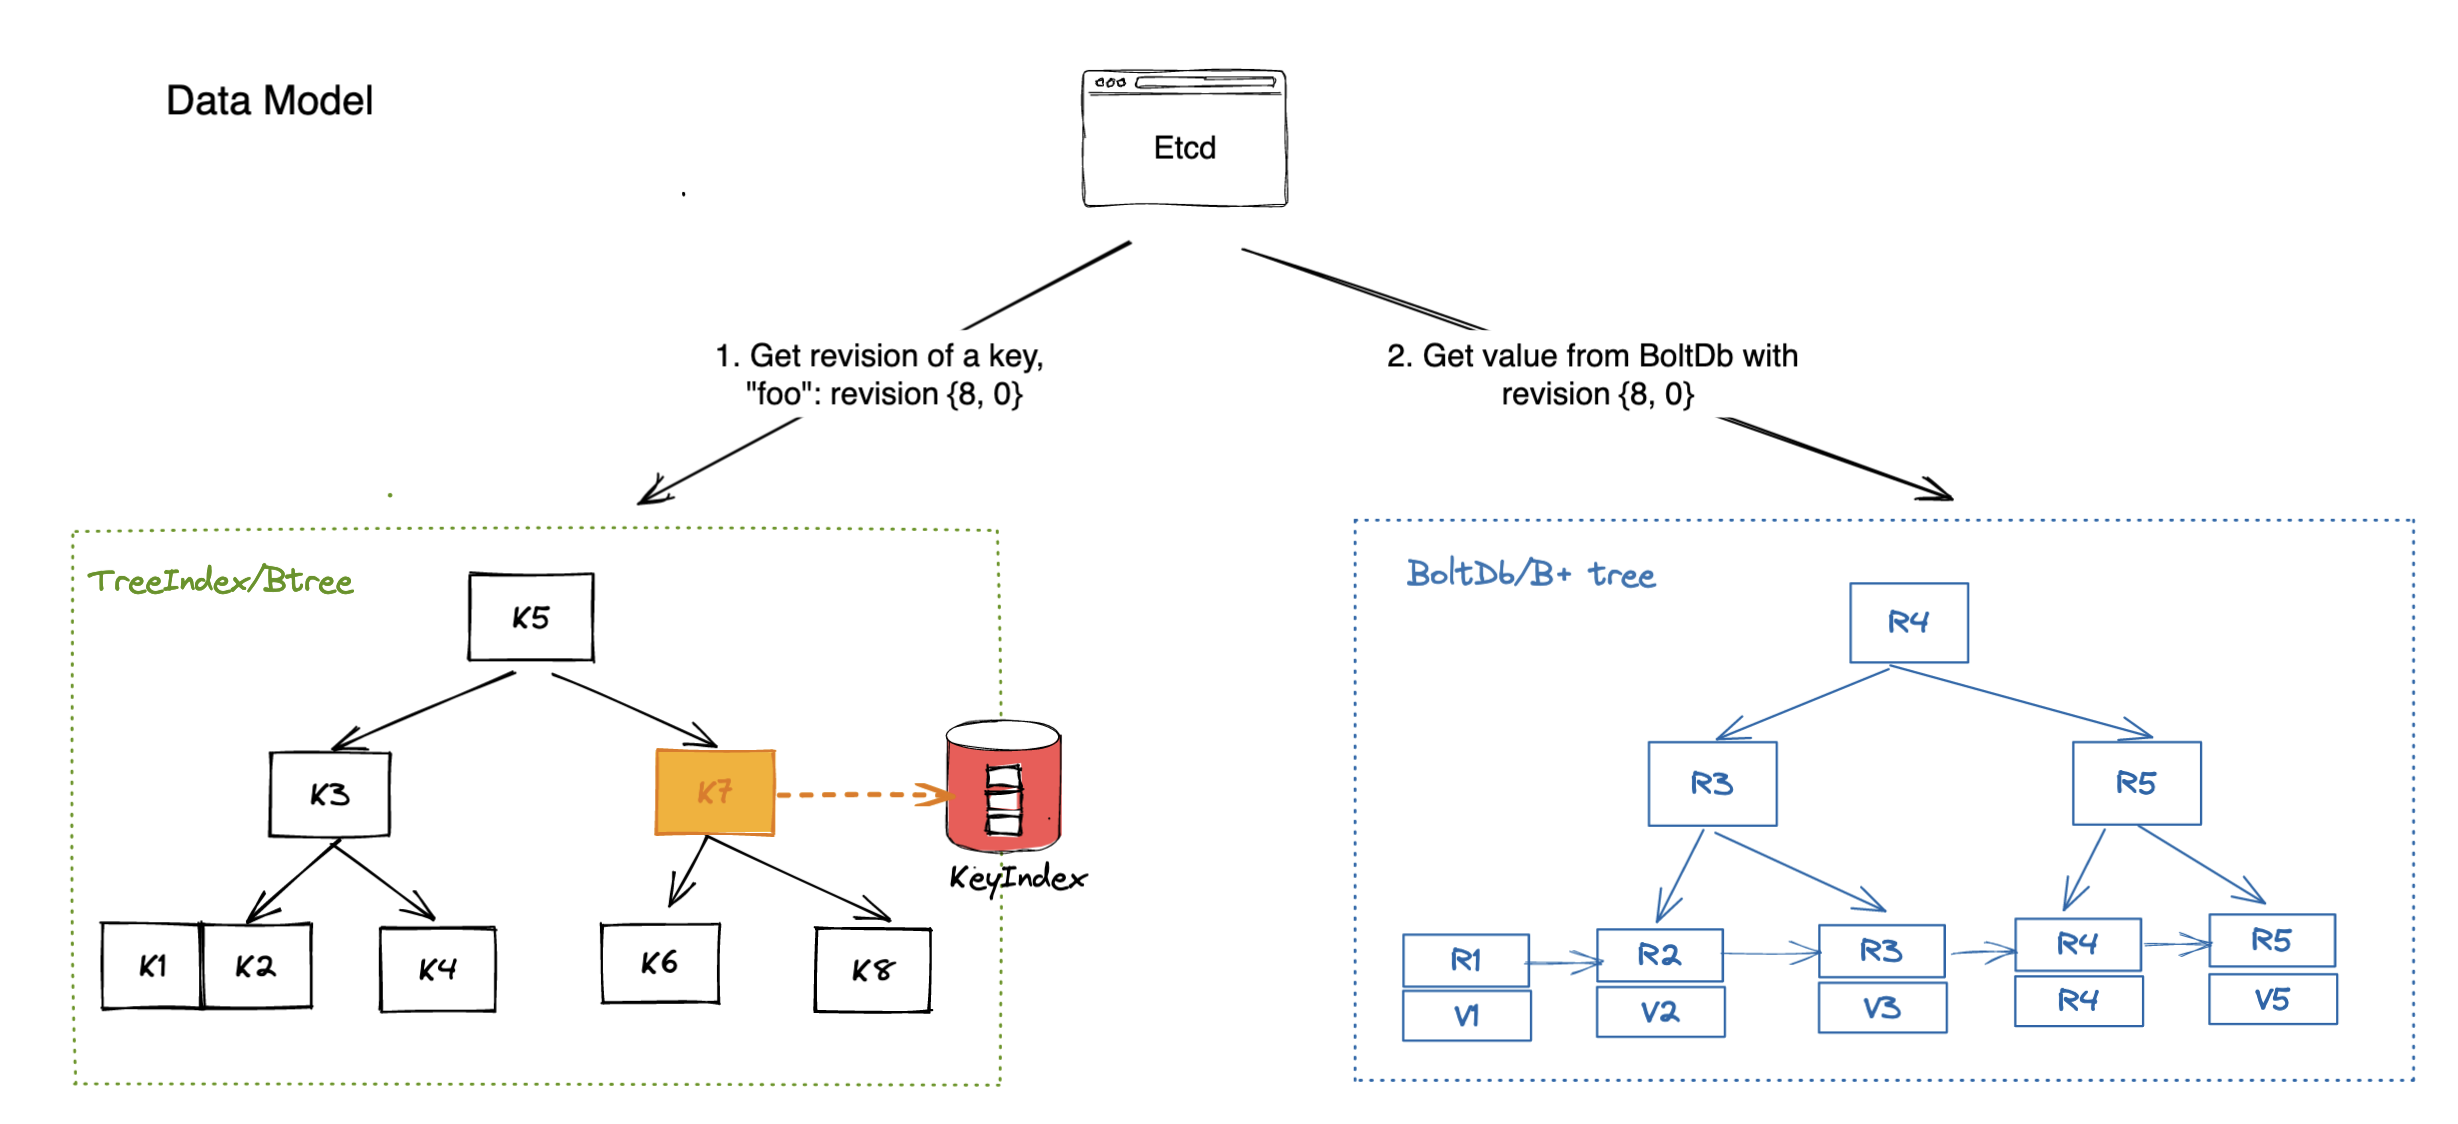
Физически etcd хранит данные как пары «ключ — значение» в постоянном b+tree . Для эффективности каждая ревизия состояния содержит только разницу относительно предыдущей. Одной ревизии может соответствовать несколько ключей дерева.
Ключ пары «ключ — значение» является 3-кортежем (major, sub, type). Major — ревизия хранилища, содержащая ключ. Sub различает ключи в одной ревизии. Type — необязательный суффикс для особого значения, например t, если значение содержит надгробную метку. Значение пары содержит изменение относительно предыдущей ревизии, то есть одну разницу. b+tree упорядочен по ключам в лексическом порядке байтов. Диапазонный поиск по разницам ревизий выполняется быстро, что позволяет быстро находить изменения между двумя заданными ревизиями. Компактизация удаляет устаревшие пары.
Для ускорения диапазонных запросов по ключам etcd также поддерживает вторичный индекс btree в памяти. Ключи этого индекса — ключи хранилища, предоставляемые пользователю. Значение является указателем на изменение в постоянном b+tree. Компактизация удаляет недействующие указатели.
В итоге etcd получает сведения о ревизии из btree, а затем использует ревизию как ключ для получения значения из b+tree, как показано ниже.
12.2 - Конструкция клиента etcd
Конструкция клиента etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Введение
Сервер etcd доказал свою надёжность многолетним тестированием с внедрением отказов. Большая часть сложной логики приложений уже обрабатывается сервером etcd и его хранилищами данных (например, состав кластера прозрачен для клиентов, а уровень Raft пересылает предложения лидеру). Хотя серверные компоненты корректны, их взаимодействие с клиентом требует иного набора сложных протоколов, обеспечивающих корректность и высокую доступность в условиях отказов. В идеале сервер etcd представляет множество физических машин как единый логический кластер, а клиент реализует автоматическое переключение между репликами при отказе. В этом документе описаны архитектурные решения клиента и подробности их реализации.
Глоссарий
clientv3: официальный клиент etcd на Go для API etcd v3.
clientv3-grpc1.0: официальная реализация клиента с grpc-go v1.0.x
, используемая в последней версии etcd v3.1.
clientv3-grpc1.7: официальная реализация клиента с grpc-go v1.7.x
, используемая в последних версиях etcd v3.2 и v3.3.
clientv3-grpc1.23: официальная реализация клиента с grpc-go v1.23.x
, используемая в последней версии etcd v3.4.
Балансировщик: балансировщик нагрузки клиента etcd, реализующий механизм повторных попыток и переключения при отказе. Клиент etcd должен автоматически распределять нагрузку между несколькими конечными точками.
Конечные точки: список конечных точек сервера etcd, к которым могут подключаться клиенты. Обычно это 3 или 5 клиентских URL кластера etcd.
Закреплённая конечная точка: при настройке нескольких конечных точек балансировщик клиента <= v3.3 выбирает только одну для установления TCP-соединения, чтобы сократить общее количество открытых соединений с кластером etcd. В v3.4 балансировщик циклически выбирает закреплённые конечные точки для каждого запроса, распределяя нагрузку равномернее.
Клиентское соединение: TCP-соединение с сервером etcd, установленное посредством gRPC Dial.
Подсоединение: интерфейс gRPC SubConn. Каждое подсоединение содержит список адресов. Балансировщик создаёт SubConn из списка разрешённых адресов. gRPC ClientConn может соответствовать нескольким SubConn (например, example.com разрешается в 10.10.10.1 и 10.10.10.2, относящиеся к двум подсоединениям). Балансировщик etcd v3.4 использует внутренний разрешитель, чтобы создать по одному подсоединению для каждой конечной точки.
Кратковременный разрыв соединения: сервер gRPC возвращает ошибку состояния code Unavailable
.
Требования к клиенту
Корректность. При отказах сервера запросы могут завершаться неудачно. Однако гарантии согласованности никогда не нарушаются: свойства глобального порядка, недопустимость записи повреждённых данных, семантика «не более одного раза» для изменяющих операций, наблюдение никогда не видит частичные события и так далее.
Живучесть. Серверы могут кратковременно отказывать или отключаться. Клиенты должны в любом случае продолжать работу. Если не настроено иное, клиенты никогда не должны попадать во взаимоблокировку , ожидая возвращения сервера в сеть. В идеале клиенты обнаруживают недоступные серверы с помощью ping HTTP/2, переключаются на другие узлы и выдают понятные сообщения об ошибках.
Эффективность. Клиенты должны эффективно работать с минимальными ресурсами: после переключения конечной точки прежние TCP-соединения следует плавно закрывать . Механизм переключения при отказе должен эффективно выбирать следующую реплику для подключения, не тратя ресурсы на повторные попытки к отказавшим узлам.
Переносимость. Официальный клиент должен иметь ясную документацию, а его реализация должна быть применима к привязкам других языков. Обработка ошибок в разных языковых привязках должна быть согласованной. Поскольку etcd полностью опирается на gRPC, реализацию следует тесно согласовать с долгосрочными целями конструкции gRPC (например, подключаемая политика повторов должна быть совместима с повторными попытками gRPC ). Обновление между двумя версиями клиента не должно прерывать работу.
Обзор клиента
Клиент etcd реализует следующие компоненты:
- балансировщик, устанавливающий соединения gRPC с кластером etcd;
- клиент API, отправляющий RPC серверу etcd; и
- обработчик ошибок, решающий, следует ли повторить неудачный запрос или переключить конечную точку.
Языки могут различаться способом установления исходного соединения (например, настройкой TLS), кодирования и отправки серверу сообщений Protocol Buffer, обработки потоковых RPC и так далее. Однако ошибки, возвращаемые сервером etcd, одинаковы. Такими же должны быть обработка ошибок и политика повторных попыток.
Например, сервер etcd может вернуть "rpc error: code = Unavailable desc = etcdserver: request timed out" — временную ошибку, предполагающую повторные попытки. Либо он может вернуть rpc error: code = InvalidArgument desc = etcdserver: key is not provided, что означает недопустимый запрос, который повторять не следует. Клиент Go может разбирать ошибки с помощью google.golang.org/grpc/status.FromError, а клиент Java — с помощью io.grpc.Status.fromThrowable.
clientv3-grpc1.0: обзор балансировщика
При настройке нескольких конечных точек etcd clientv3-grpc1.0 поддерживает несколько TCP-соединений. Затем он выбирает один адрес и использует его для всех клиентских запросов. Закреплённый адрес сохраняется до закрытия объекта клиента (см. рисунок 1). Получив ошибку, клиент случайным образом выбирает другой адрес и повторяет запрос.
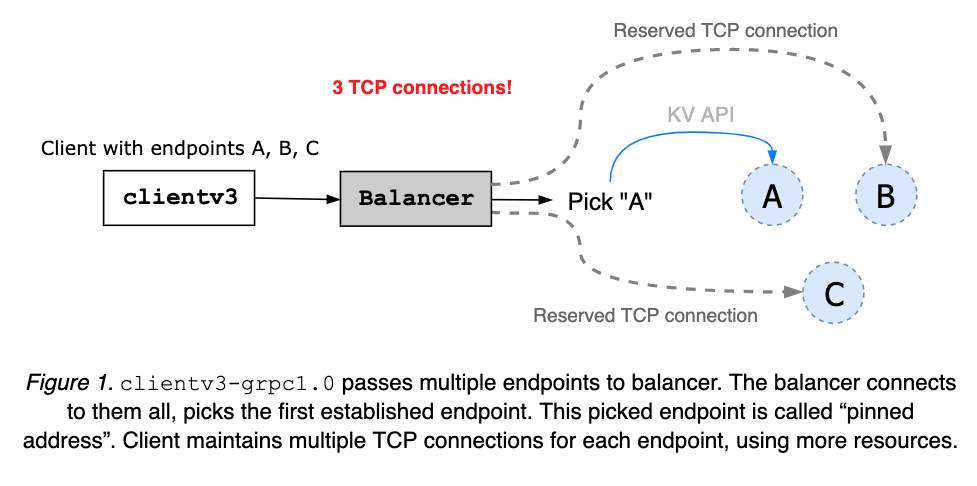
clientv3-grpc1.0: ограничение балансировщика
Несколько TCP-соединений, открываемых clientv3-grpc1.0, могут ускорить переключение балансировщика при отказе, но требуют больше ресурсов. Балансировщик не знает ни состояние узлов, ни состав кластера. Поэтому он может застрять на одном отказавшем или изолированном узле.
clientv3-grpc1.7: обзор балансировщика
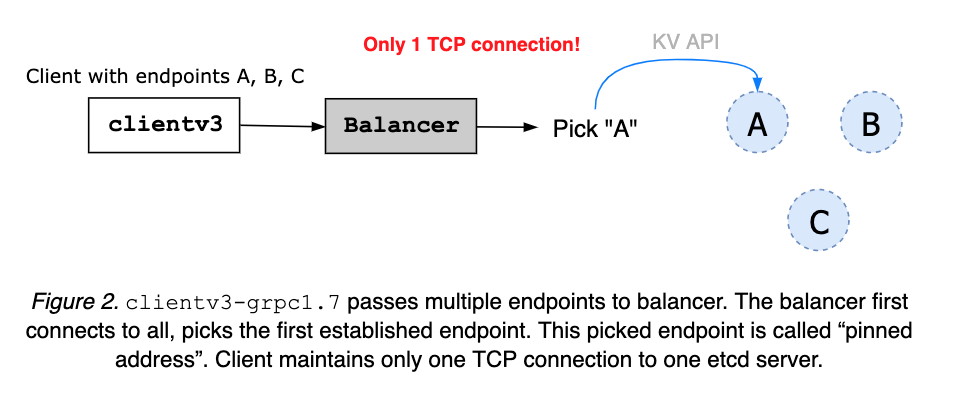
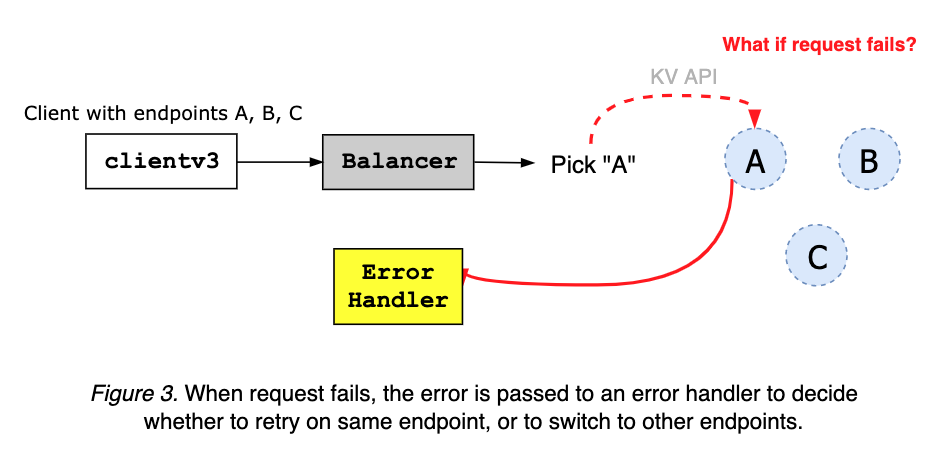
clientv3-grpc1.7 поддерживает только одно TCP-соединение с выбранным сервером etcd. Получив несколько конечных точек кластера, клиент сначала пытается подключиться ко всем. Как только одно соединение устанавливается, балансировщик закрепляет адрес и закрывает остальные (см. рисунок 2). Закреплённый адрес сохраняется до закрытия объекта клиента. Ошибка сервера или клиентской сети передаётся клиентскому обработчику ошибок (см. рисунок 3).
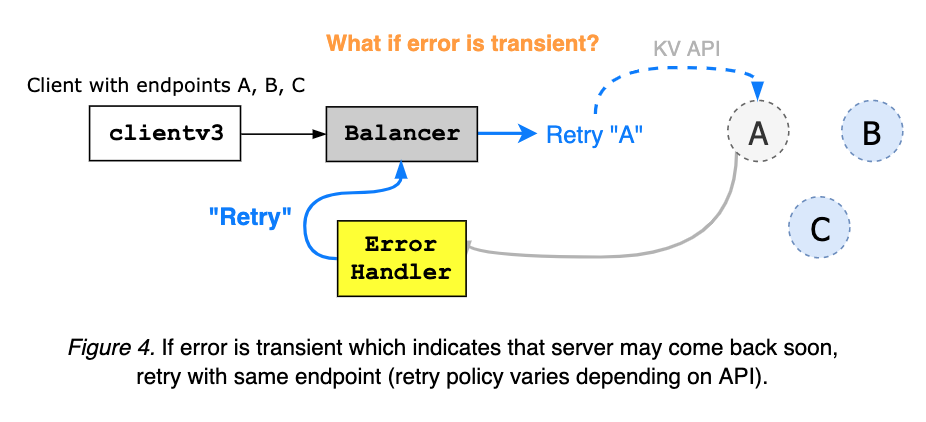
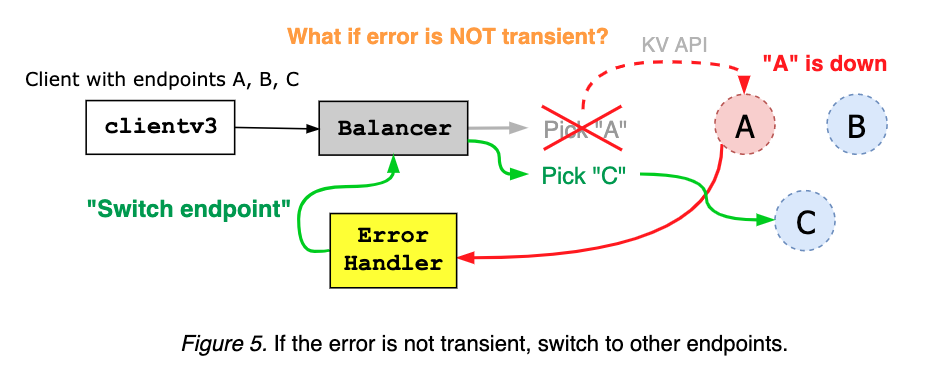
Клиентский обработчик получает ошибку от сервера gRPC и по её коду и сообщению решает, повторить ли запрос к той же конечной точке или переключиться на другие адреса (см. рисунок 4 и рисунок 5).
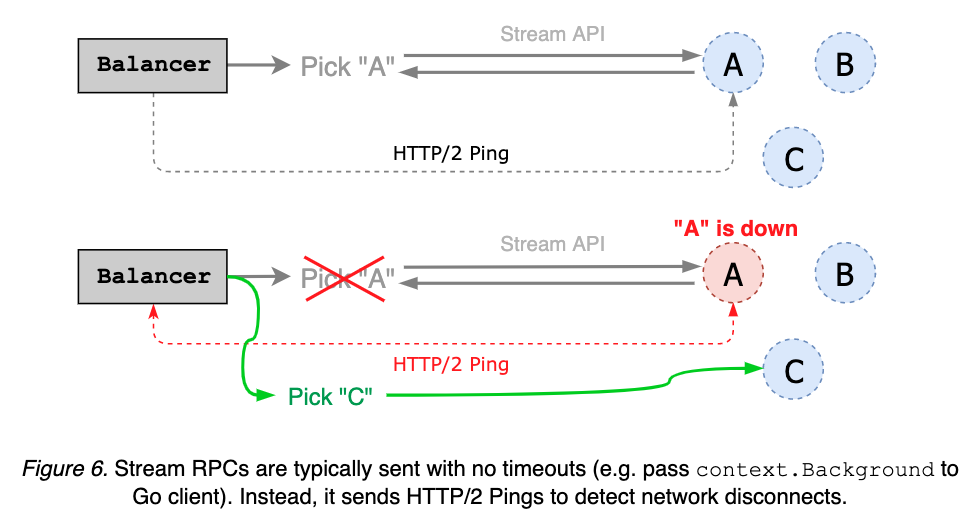
Потоковые RPC, такие как Watch и KeepAlive, часто запрашиваются без тайм-аутов. Вместо этого клиент может периодически отправлять ping HTTP/2 для проверки состояния закреплённой конечной точки; если сервер не отвечает, балансировщик переключается на другие конечные точки (см. рисунок 6).
clientv3-grpc1.7: ограничение балансировщика
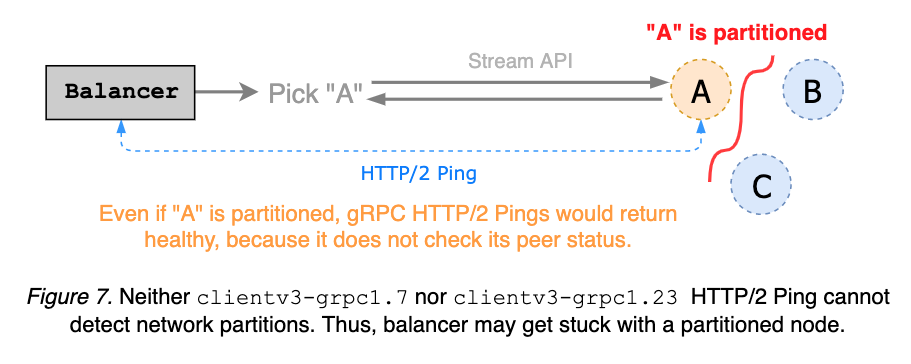
Балансировщик clientv3-grpc1.7 отправляет сигналы keepalive HTTP/2, чтобы обнаруживать разрывы потоковых запросов. Это простой механизм ping сервера gRPC, не учитывающий состав кластера и потому не способный обнаружить разделение сети. Поскольку изолированный сервер gRPC всё ещё может отвечать на клиентские ping, балансировщик способен застрять на нём. В идеале ping keepalive обнаруживает разделение и вызывает переключение конечной точки до истечения тайм-аута запроса (см. etcd#8673
и рисунок 7).
Балансировщик clientv3-grpc1.7 поддерживает список неисправных конечных точек. Отключённые адреса добавляются в список «неисправных» и считаются недоступными до окончания периода ожидания, жёстко заданного как тайм-аут набора номера со значением по умолчанию 5 секунд. Балансировщик может ошибочно считать конечные точки неисправными. Например, конечная точка A может вернуться сразу после внесения в чёрный список, но останется недоступной следующие 5 секунд (см. рисунок 8).
clientv3-grpc1.0 испытывал те же описанные выше проблемы.
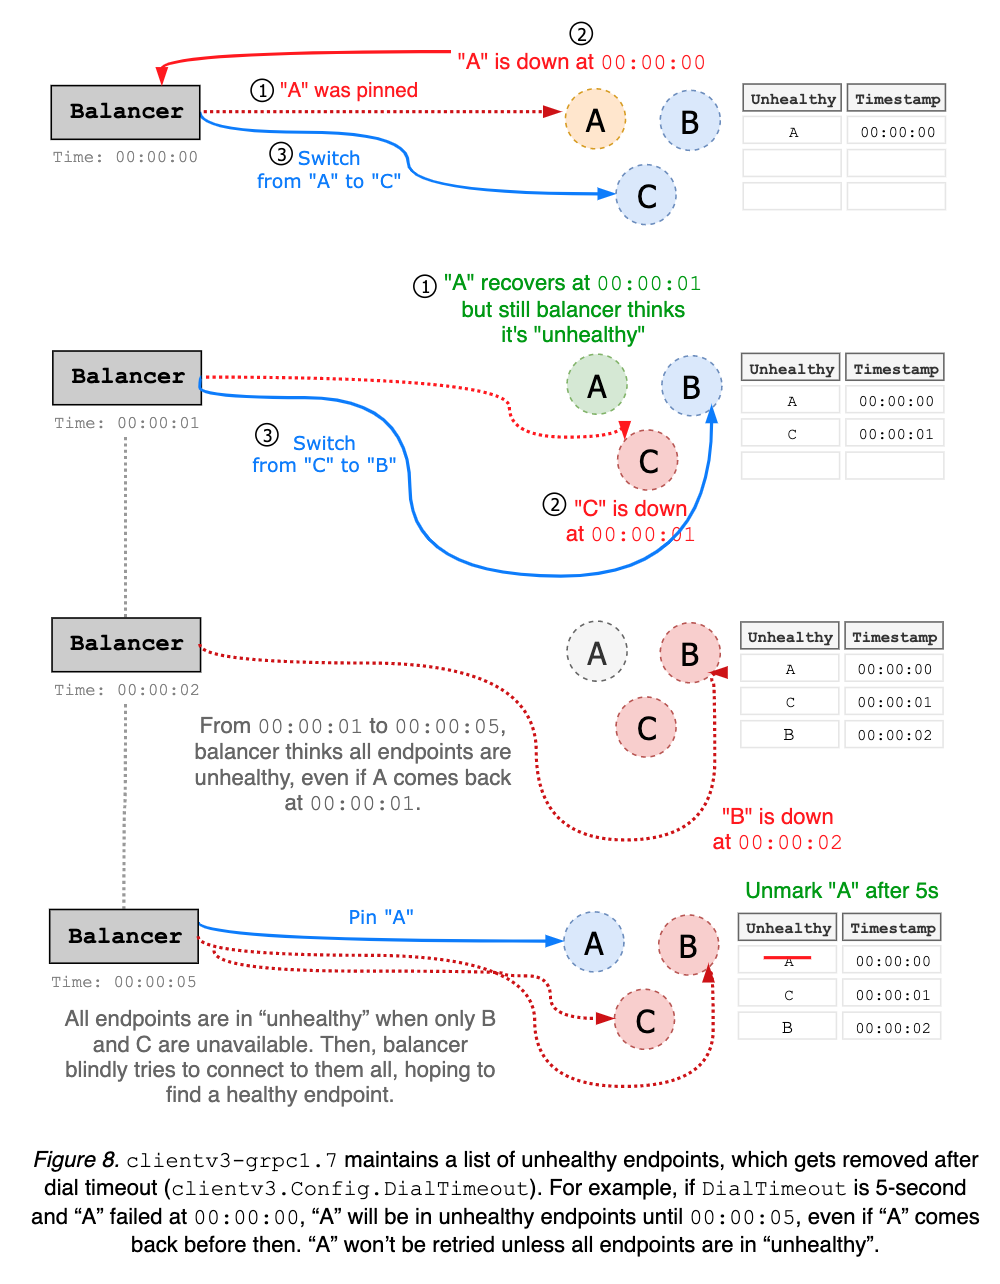
Вышестоящий gRPC Go уже перешёл на новый интерфейс балансировщика. Например, внутренняя реализация балансировщика clientv3-grpc1.7 использует новый балансировщик gRPC и пытается сохранять поведение старого. Хотя совместимость поддерживалась достаточно хорошо, клиент etcd всё же страдал от малозаметных нарушающих совместимость изменений
. Кроме того, сопровождающие gRPC рекомендуют не полагаться на старый интерфейс балансировщика
. В целом для более качественной поддержки со стороны вышестоящего проекта лучше синхронизироваться с последними выпусками gRPC. Новые функции, например политика повторных попыток, могут не переноситься в ветвь gRPC 1.7. Поэтому и сервер, и клиент etcd должны перейти на последние версии gRPC.
clientv3-grpc1.23: обзор балансировщика
clientv3-grpc1.7 настолько тесно связан со старым интерфейсом gRPC, что каждое обновление зависимости gRPC нарушало поведение клиента. Большая часть усилий по разработке и отладке уходила на исправление этих изменений. В результате реализация стала чрезмерно сложной и опиралась на неверные предположения о соединениях с серверами.
Основная цель clientv3-grpc1.23 — упростить логику переключения балансировщика при отказе. Вместо поддержки потенциально устаревшего списка неисправных конечных точек он просто циклически переходит к следующей точке при каждом отключении клиента от текущей. Состояние конечных точек не предполагается, поэтому сложное отслеживание состояния больше не нужно (см. рисунок 8 и текст выше). Переход на clientv3-grpc1.23 не должен создавать проблем: все изменения внутренние, а обратная совместимость полностью сохранена.
Получив несколько конечных точек, clientv3-grpc1.23 внутри создаёт несколько подсоединений (по одному на каждую точку), тогда как clientv3-grpc1.7 создаёт только одно соединение с закреплённой точкой (см. рисунок 9). Например, в кластере из 5 узлов балансировщику clientv3-grpc1.23 потребуется 5 TCP-соединений, а clientv3-grpc1.7 — только одно. Сохраняя пул TCP-соединений, clientv3-grpc1.23 может потреблять больше ресурсов, но предоставляет более гибкую балансировку нагрузки и лучшее переключение при отказе. По умолчанию используется циклическая политика балансировки, которую легко расширить другими типами балансировщиков (например, выбором из двух, выбором лидера и т. п.). clientv3-grpc1.23 использует группу разрешителей gRPC и реализует политику выбора балансировщика, чтобы передать сложную балансировку вышестоящему gRPC. Напротив, clientv3-grpc1.7 вручную управляет каждым соединением gRPC и переключением балансировщика, что усложняет реализацию. clientv3-grpc1.23 реализует повторные попытки в цепочке перехватчиков gRPC, которая автоматически обрабатывает внутренние ошибки gRPC и поддерживает более сложные политики повторов, например отложенные повторы; clientv3-grpc1.7 вручную интерпретирует ошибки gRPC для повторных попыток.
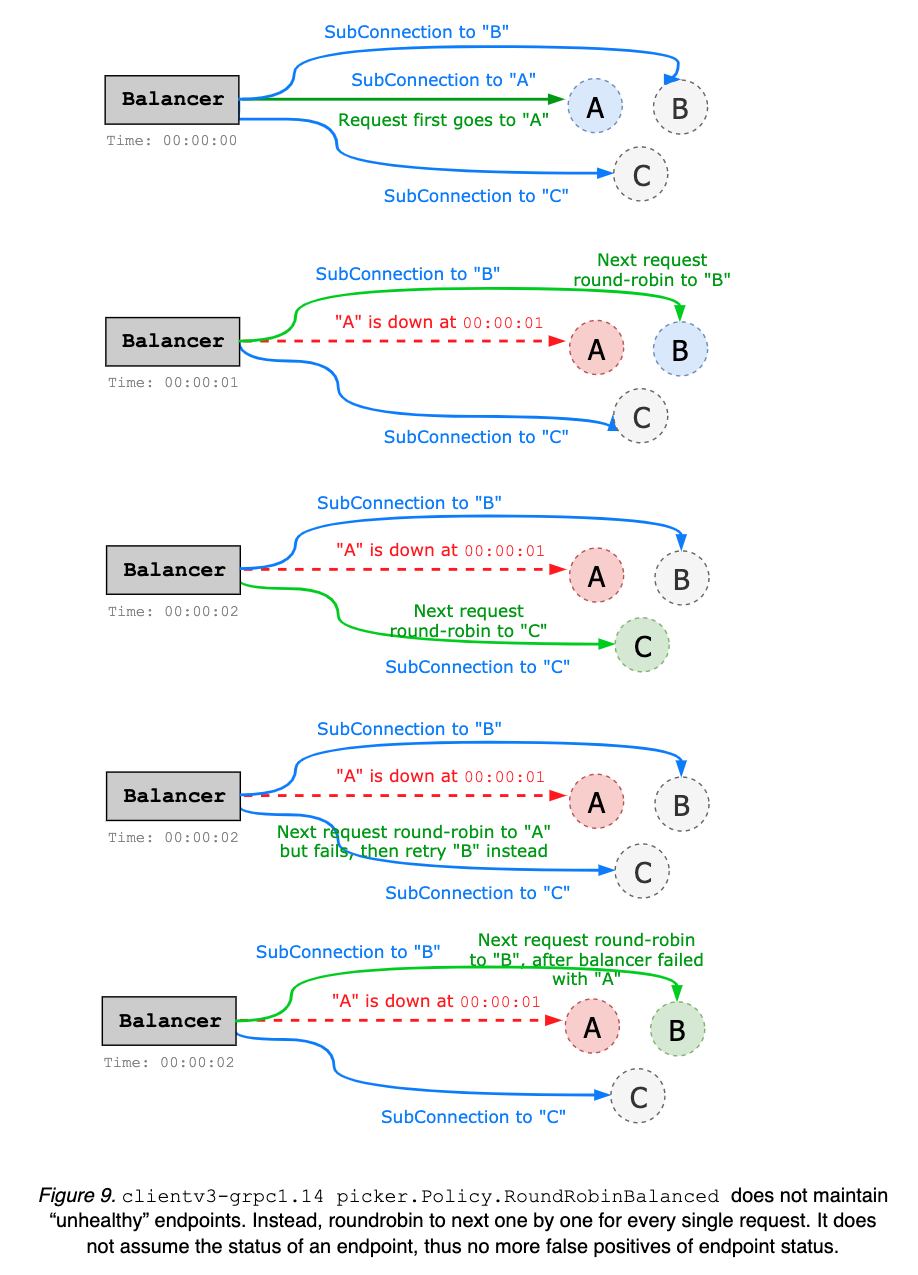
clientv3-grpc1.23: ограничение балансировщика
Работу можно улучшить, кэшируя состояние каждой конечной точки. Например, балансировщик может заранее проверять каждый сервер с помощью ping, поддерживая список исправных кандидатов, и использовать эти сведения при циклическом выборе. Либо при разрыве соединения отдавать приоритет исправным точкам. Это может усложнить реализацию балансировщика, поэтому улучшение можно оставить для последующих версий.
Клиентский ping keepalive всё ещё не учитывает разделения сети. Потоковый запрос может застрять на изолированном узле. Для понимания состава кластера необходимо реализовать расширенную службу проверки работоспособности (подробнее см. etcd#8673 ).
Сейчас логика повторных попыток обрабатывается вручную перехватчиком. Её можно упростить с помощью официального механизма повторных попыток gRPC .
12.3 - Конструкция обучающегося участника etcd
Обучающийся участник etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Предпосылки
Изменение состава кластера остаётся одной из крупнейших эксплуатационных сложностей. Рассмотрим типичные проблемы.
1. Новый участник кластера перегружает лидера
Только что присоединившийся участник etcd начинает без данных и потому требует больше обновлений от лидера, пока не догонит его журнал. Из-за этого сеть лидера с большей вероятностью окажется перегружена, а его сигналы активности последователям будут заблокированы или отброшены. Тогда у последователя может истечь тайм-аут выборов, и он начнёт новые выборы лидера. Таким образом, кластер с новым участником более подвержен выборам лидера. И сами выборы, и последующее распространение обновлений новому участнику могут вызывать периоды недоступности кластера (см. рисунок 1).
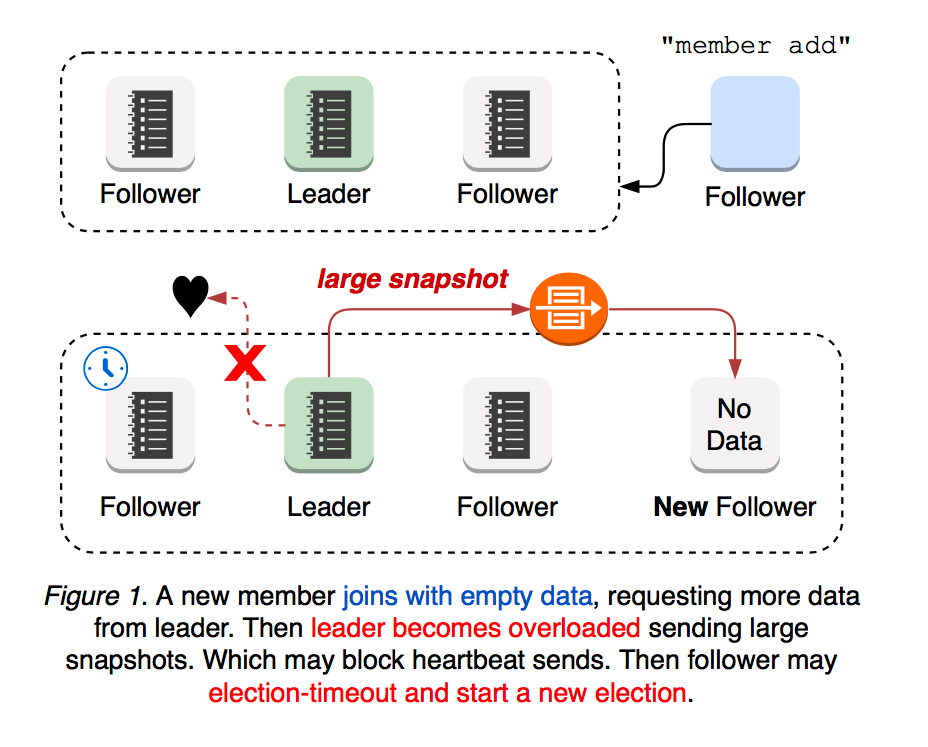
2. Сценарии разделения сети
Что произойдёт при разделении сети? Это зависит от того, в какой части находится лидер. Если лидер по-прежнему поддерживает активный кворум, кластер продолжит работу (см. рисунок 2).
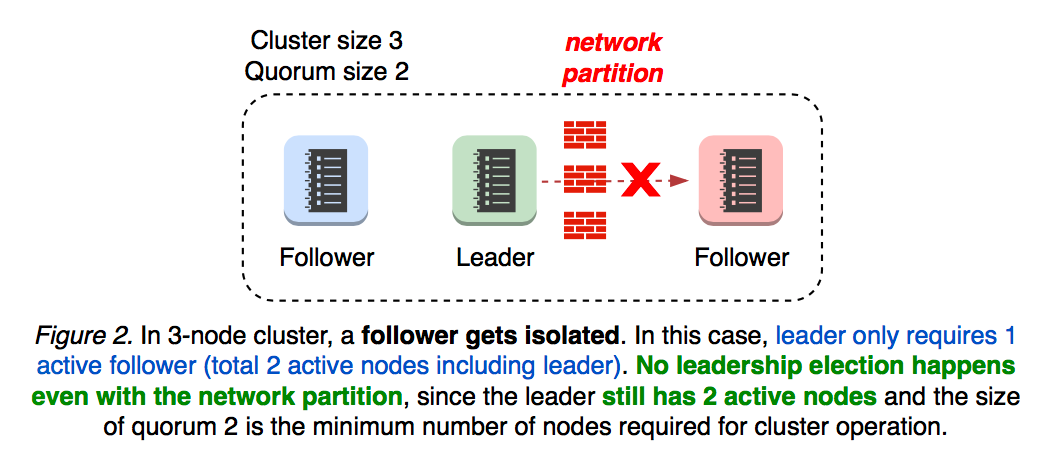
2.1 Изоляция лидера
Что произойдёт, если лидер окажется изолирован от остального кластера? Лидер отслеживает прогресс каждого последователя. Потеряв связь с кворумом, он возвращается в состояние последователя, что влияет на доступность кластера (см. рисунок 3).
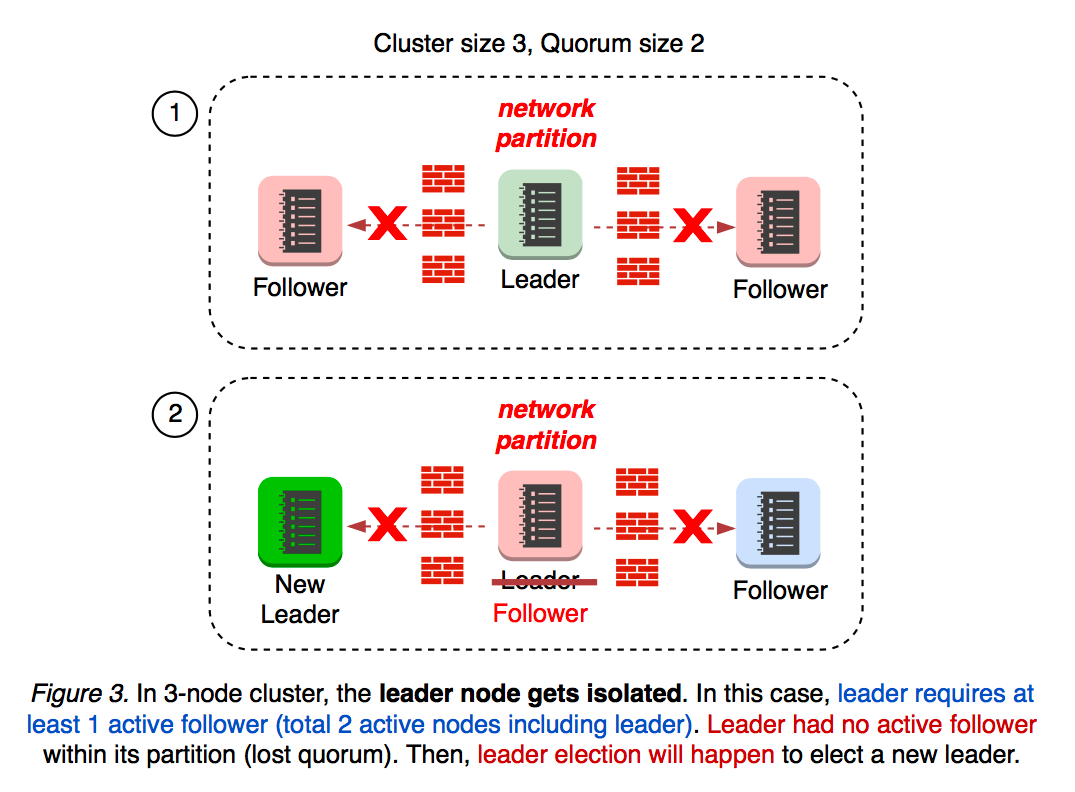
При добавлении нового узла в кластер из 3 узлов размер кластера становится равен 4, а размер кворума — 3. Что произойдёт, если новый узел присоединился к кластеру, после чего возникло разделение сети? Это зависит от того, в какой части после разделения окажется новый участник.
2.2 Разделение кластера 3+1
Если новый узел окажется в той же части, что и лидер, лидер сохранит активный кворум из 3 участников. Новых выборов лидера не будет, и доступность кластера не пострадает (см. рисунок 4).
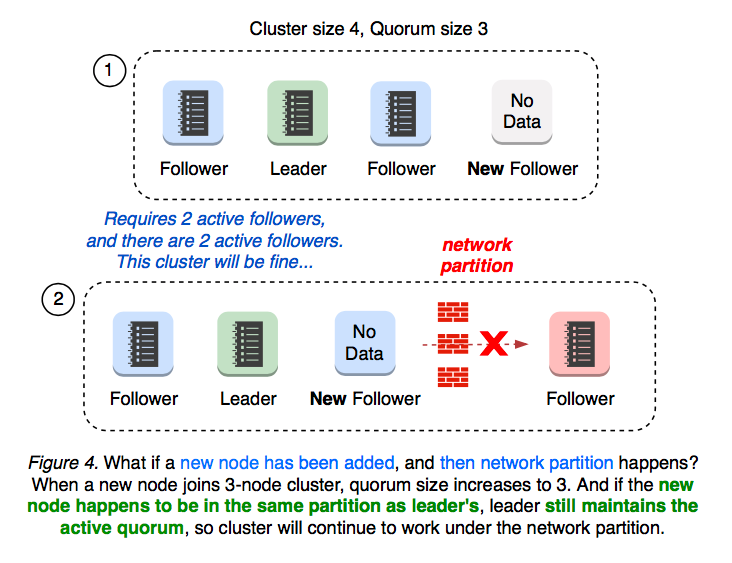
2.3 Разделение кластера 2+2
Если кластер разделён на части из 2 и 2 узлов, ни одна из них не сохраняет кворум из 3 участников. В этом случае начинаются выборы лидера (см. рисунок 5).
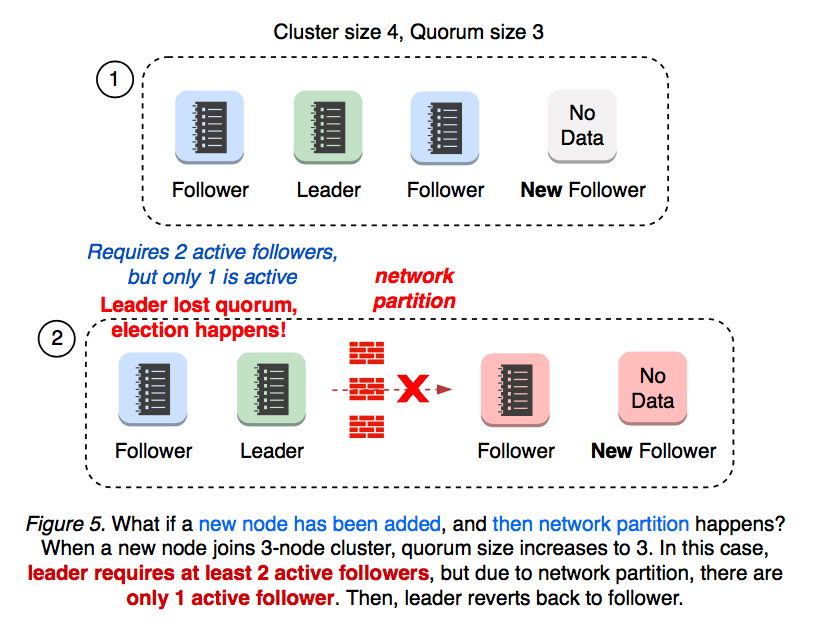
2.4 Потеря кворума
Что произойдёт, если сначала разделится сеть, а затем будет добавлен новый участник? В разделённом кластере из 3 узлов уже есть один отключённый последователь. После добавления участника кворум меняется с 2 на 3. Теперь в кластере активны только 2 узла из 4, поэтому он теряет кворум и начинает новые выборы лидера (см. рисунок 6).
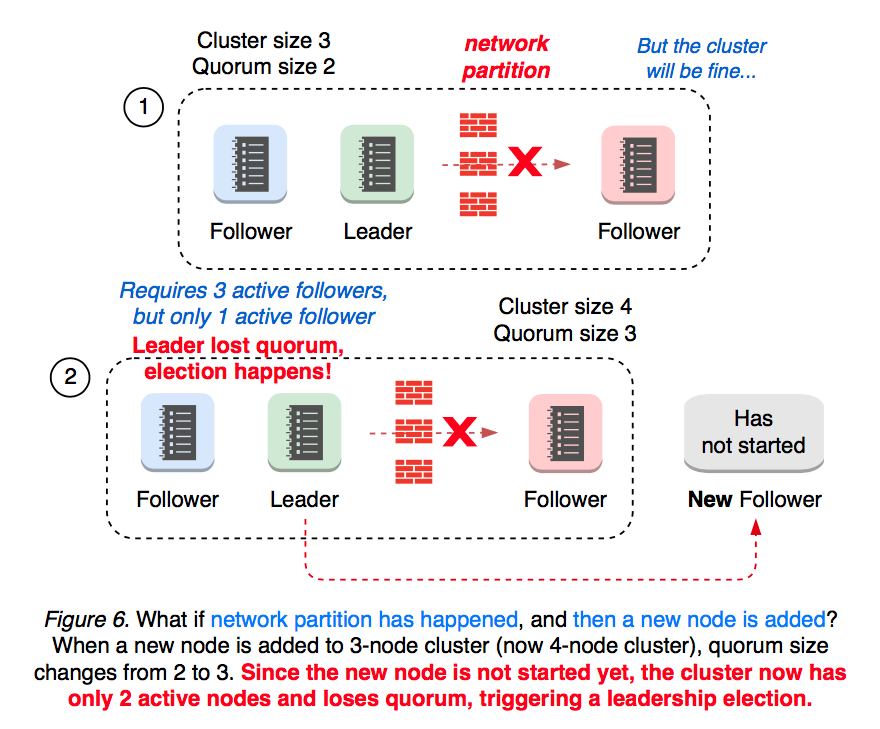
Поскольку операция добавления участника может изменить размер кворума, при замене неисправного узла всегда рекомендуется сначала выполнить «member remove».
Добавление нового участника в кластер из 1 узла увеличивает размер кворума до 2 и немедленно вызывает выборы лидера, когда прежний лидер обнаруживает отсутствие активного кворума. Причина в том, что операция «member add» состоит из 2 этапов: пользователь сначала должен выполнить команду «member add», а затем запустить процесс нового узла (см. рисунок 7).
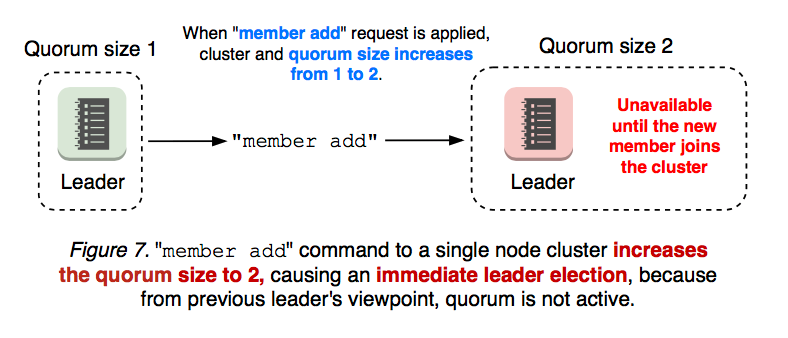
3. Ошибки конфигурации кластера
Ещё хуже, если добавленный участник настроен неверно. Изменение состава кластера состоит из двух этапов: «etcdctl member add» и запуск процесса сервера etcd с заданным URL однорангового узла. Иными словами, команда «member add» применяется независимо от URL, даже если его значение недопустимо. Если первый этап выполнен с недопустимыми URL, на втором этапе новый etcd даже не сможет запуститься. После потери кворума отменить изменение состава уже невозможно (см. рисунок 8).
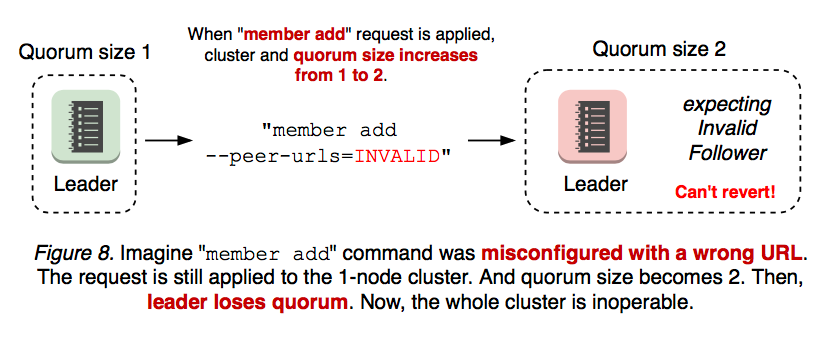
То же относится к многоузловому кластеру. Например, два участника кластера не работают (один отказал, другой настроен неверно), а ещё два работают, но для изменения состава теперь требуется не менее 3 голосов (см. рисунок 9).
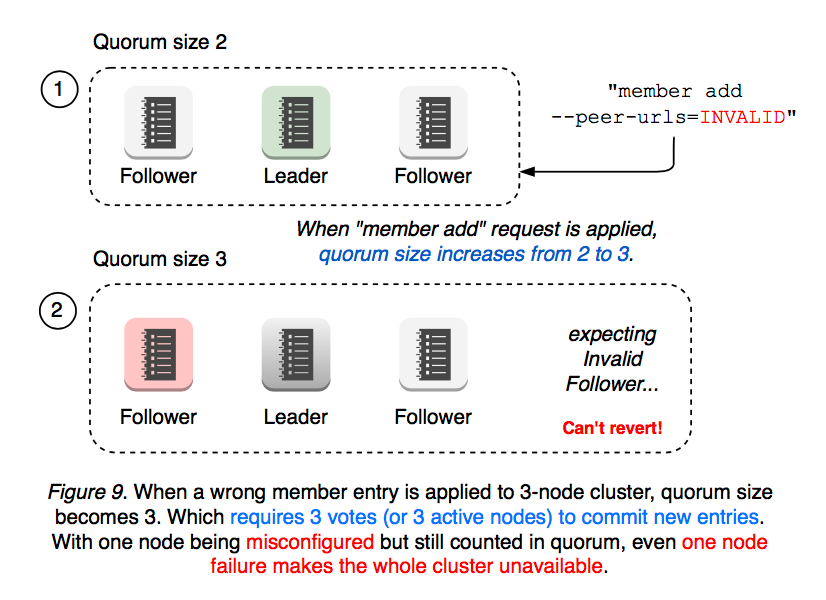
Как показано выше, простая ошибка конфигурации способна привести весь кластер в неработоспособное состояние. В таком случае оператору приходится вручную пересоздавать кластер с флагом etcd --force-new-cluster. Поскольку etcd стал критически важной службой для Kubernetes, даже малейший сбой может существенно повлиять на пользователей. Как упростить подобные операции с etcd? Среди прочего для доступности кластера наиболее важны выборы лидера. Можно ли сделать изменение состава менее разрушительным, не меняя размер кворума? Может ли новый узел бездействовать и запрашивать у лидера лишь минимум обновлений, пока не догонит его? Можно ли гарантировать обратимость ошибок конфигурации состава и обрабатывать их безопаснее (неверная команда добавления участника никогда не должна выводить кластер из строя)? Должен ли пользователь учитывать топологию сети при добавлении нового участника? Может ли API добавления участника работать независимо от расположения узлов и текущих разделений сети?
Обучающийся участник Raft
Чтобы устранить описанные выше провалы доступности, Raft §4.2.1 вводит новое состояние узла «Learner», в котором узел присоединяется к кластеру как участник без права голоса, пока не догонит журнал лидера.
Возможности v3.4
Для добавления нового обучающегося узла оператор должен выполнять как можно меньше действий. Команда member add --learner добавляет нового обучающегося участника, который присоединяется к кластеру без права голоса, но всё же получает все данные от лидера (см. рисунок 10).
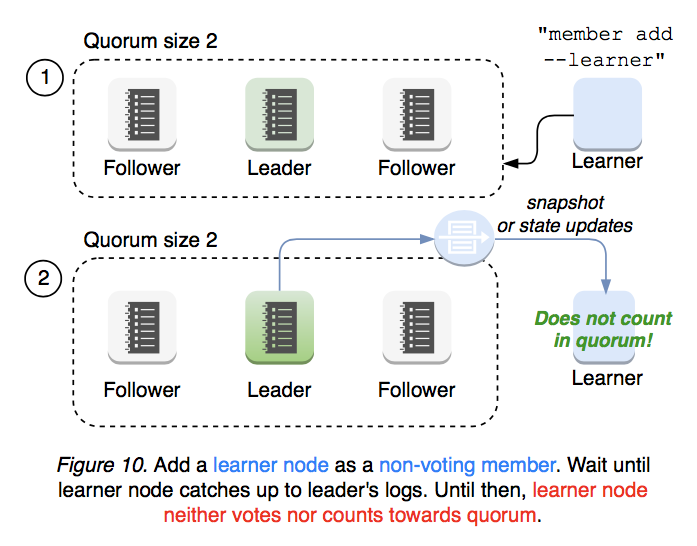
Когда обучающийся участник догоняет лидера, его можно повысить до участника с правом голоса с помощью API member promote; после этого он учитывается в кворуме (см. рисунок 11).
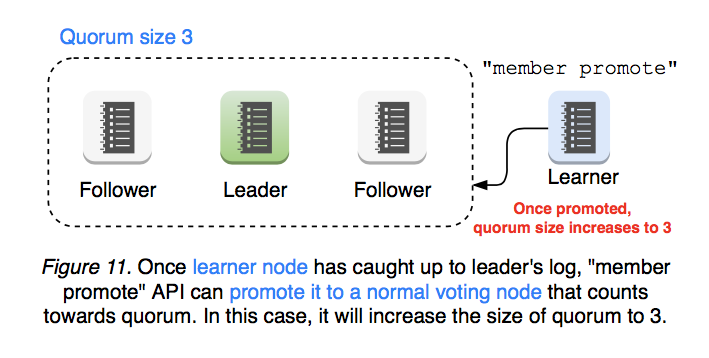
Сервер etcd проверяет запрос повышения, обеспечивая эксплуатационную безопасность. Обучающегося участника можно повысить до участника с правом голоса лишь после того, как его журнал догонит журнал лидера (см. рисунок 12).
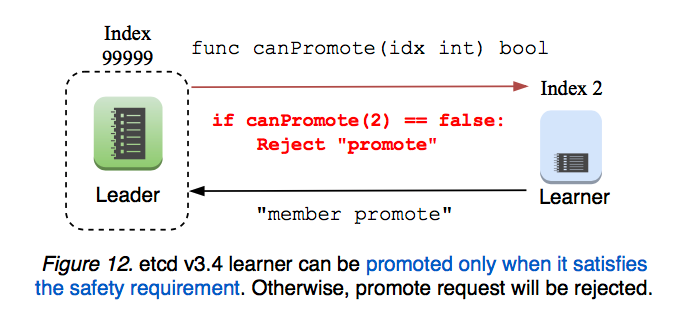
До повышения обучающийся участник служит только резервным узлом: передать ему лидерство нельзя. Он отклоняет клиентские операции чтения и записи (клиентский балансировщик не должен направлять к нему запросы). Следовательно, обучающемуся участнику не нужно отправлять лидеру запросы Read Index. Это ограничение упрощает первоначальную реализацию обучающегося участника в выпуске v3.4 (см. рисунок 13).
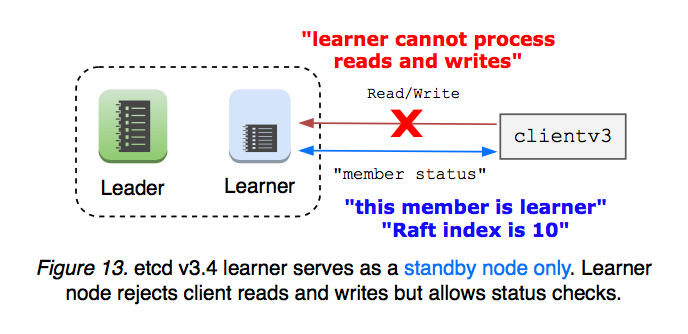
Кроме того, etcd ограничивает общее количество обучающихся участников в кластере, чтобы не перегружать лидера репликацией журнала. Обучающийся участник никогда не повышает себя самостоятельно. etcd предоставляет сведения о его состоянии и проверки безопасности, но окончательное решение о повышении должен принимать оператор кластера.
Предлагаемые возможности будущих выпусков
Сделать состояние обучающегося единственным и используемым по умолчанию: назначение новому участнику состояния обучающегося по умолчанию значительно повысит безопасность изменения состава, поскольку обучающийся участник не меняет размер кворума. Ошибку конфигурации всегда можно будет отменить без потери кворума.
Сделать повышение до участника с правом голоса полностью автоматическим: когда обучающийся участник догонит журнал лидера, кластер сможет автоматически его повысить. Пользователь должен будет задать определённые пороговые значения; после выполнения требований обучающийся участник самостоятельно повысится до участника с правом голоса. С точки зрения пользователя команда «member add» будет работать так же, как сегодня, но благодаря функции обучающегося участника станет безопаснее.
Сделать обучающегося участника резервным узлом переключения при отказе: обучающийся участник присоединяется как резервный узел и автоматически повышается, когда доступность кластера нарушается.
Сделать обучающегося участника доступным только для чтения: обучающийся участник может служить узлом только для чтения, который никогда не повышается. В режиме слабой согласованности он лишь получает данные от лидера и никогда не обрабатывает записи. Локальное обслуживание чтения без накладных расходов консенсуса существенно снизит нагрузку на лидера, но может возвращать устаревшие данные. В режиме строгой согласованности обучающийся участник запрашивает у лидера индекс чтения, чтобы обслуживать актуальные данные, но по-прежнему отклоняет записи.
Обучающийся участник и Mirror Maker
etcd реализует «mirror maker» с помощью API наблюдения, непрерывно передавая создания и обновления ключей в отдельный кластер. После первоначальной синхронизации зеркалирование обычно добавляет небольшую задержку. Обучающийся участник и зеркалирование частично пересекаются: оба подхода можно использовать для репликации существующих данных только для чтения. Однако зеркалирование не гарантирует линеаризуемость. Во время разрывов сети предыдущие пары «ключ — значение» могли быть отброшены, поэтому клиенты должны проверять правильность порядка в ответах наблюдения. Следовательно, зеркало не гарантирует порядок. Используйте зеркало для минимальной задержки (например, между центрами обработки данных) ценой согласованности. Используйте обучающегося участника, чтобы сохранить все исторические данные и их порядок.
Приложение: реализация обучающегося участника в v3.4
Предоставить тип узла “Learner” в API “MemberAdd”.
Клиент etcd добавляет в API «MemberAdd» флаг обучающегося узла. Обработчик сервера etcd применяет запись изменения состава с типом pb.ConfChangeAddLearnerNode. После применения команды сервер присоединяется к кластеру с флагом etcd --initial-cluster-state=existing. Этот обучающийся узел не может голосовать и не учитывается в кворуме.
Сервер etcd не должен передавать лидерство обучающемуся участнику: тот может всё ещё отставать и не учитывается в кворуме. Сервер etcd ограничивает количество обучающихся участников кластера одним: чем их больше, тем больше данных должен распространять лидер. Клиенты могут обращаться к обучающемуся узлу, но он отклоняет все запросы, кроме сериализуемого чтения и API состояния участника. Это сделано для простоты первоначальной реализации. В будущем обучающегося участника можно расширить до сервера только для чтения, непрерывно зеркалирующего данные кластера. Клиентский балансировщик должен предоставлять вспомогательную функцию для исключения конечной точки обучающегося узла. Иначе отправленный ему запрос может завершиться ошибкой. Клиентский вызов синхронизации участников должен учитывать тип обучающегося узла. То же относится к вызову обновления клиентских конечных точек.
Ответы MemberList и MemberStatus должны указывать, какой узел является обучающимся.
Добавить API “MemberPromote”.
На внутреннем уровне Raft второй вызов MemberAdd для обучающегося узла повышает его до участника с правом голоса. Лидер отслеживает прогресс каждого последователя и обучающегося участника. Если обучающийся участник не завершил обработку сообщения снимка, запрос повышения отклоняется. Запрос принимается тогда и только тогда, когда обучающийся узел исправен, а также синхронизирован с лидером либо разница не превышает порог (например, количество записей, которые нужно реплицировать обучающемуся участнику, меньше 1/10 количества снимка; тогда после повышения лидеру с меньшей вероятностью придётся отправлять ему снимок). Вся эта логика жёстко задана в пакете etcdserver и не настраивается.
Ссылки
- Исходная проблема GitHub: etcd#9161
- Сценарий использования: etcd#3715
- Сценарий использования: etcd#8888
- Сценарий использования: etcd#10114
12.4 - Конструкция аутентификации etcd v3
Почему не используется система аутентификации v2?
Вместо RESTful-интерфейса, как в v2, протокол v3 использует gRPC в качестве транспорта. Новый протокол даёт возможность развить и улучшить конструкцию v2. Например, аутентификация v3 выполняется для соединения, а не для каждого запроса, как более медленная аутентификация v2. Кроме того, на практике семантика аутентификации v2 неудобна для рассуждений о согласованности, что будет описано в следующих разделах. Для v3 существует чёткое описание и реализация механизма аутентификации, устраняющие недостатки системы v2.
Функциональные требования
- Аутентификация для соединения, а не для каждого запроса
- Для API gRPC реализована аутентификация по идентификатору пользователя и паролю
- После изменения политики аутентификацию необходимо обновлять
- Функциональность должна быть такой же простой и полезной, как в v2
- В отличие от структуры каталогов v2, v3 предоставляет плоское пространство ключей. Разрешения будут проверяться посредством сопоставления интервалов.
- Гарантии согласованности должны быть сильнее, чем у аутентификации v2
Основные необходимые изменения
- До отправки аутентифицированных запросов клиент должен создать отдельное соединение исключительно для аутентификации
- Добавить сведения о разрешениях (идентификатор пользователя и авторизованную ревизию) в команды Raft (
etcdserverpb.InternalRaftRequest) - Проверять разрешения каждого запроса на уровне конечного автомата, а не на уровне API
Согласованность метаданных разрешений
Метаданные аутентификации, как и другие данные etcd, также должны храниться и управляться в хранилище, контролируемом протоколом Raft etcd. Это необходимо, чтобы не жертвовать доступностью и согласованностью всего кластера etcd. Если для чтения или записи метаданных (например, сведений о разрешениях) требуется согласие каждого узла, а не только кворума, отказ одного узла может остановить весь кластер. Требование одновременного согласия всех узлов означает, что проверку обычных запросов чтения и записи невозможно завершить при недоступности любого участника, даже если кластер располагает кворумом. Такая единогласная схема в итоге снижает доступность кластера; консенсуса Raft на основе кворума должно быть достаточно, поскольку согласие следует из согласованного порядка.
В механизме аутентификации протокола etcd v2 есть сложность: согласованность метаданных должна работать описанным выше образом, но это не так. Каждая проверка разрешений обрабатывается участником etcd, получившим клиентский запрос (server/etcdserver/api/v2http/client.go), включая участников-последователей. Поэтому проверка может основываться на устаревших метаданных.
Эта устарелость означает, что конфигурация аутентификации не может отразиться сразу после выполнения операторами etcdctl. Поэтому невозможно определить, как долго остаются активны устаревшие метаданные. На практике изменение конфигурации отражается непосредственно после выполнения команды. Однако при высокой нагрузке несогласованное состояние иногда сохраняется дольше и может приводить к неочевидным для пользователей и разработчиков ситуациям. Требуется обходное решение наподобие этого .
Несогласованные разрешения небезопасны для линеаризованных запросов
Несогласованное состояние аутентификации особенно опасно для записи. Даже если оператор запретил пользователю запись, она может успешно завершиться, если упорядочена относительно хранилища ключей и значений, но не относительно системы аутентификации. Без упорядочивания как хранилища аутентификации, так и хранилища ключей и значений система будет уязвима для атак с устаревшими разрешениями.
Поэтому логику проверки разрешений следует добавить в конечный автомат etcd. Каждый конечный автомат должен проверять запросы по своим сведениям о разрешениях на фазе применения (следовательно, сведения об аутентификации не должны быть устаревшими).
Конструкция и реализация
Аутентификация
Сначала клиент должен создать соединение gRPC исключительно для аутентификации идентификатора пользователя и пароля. Сервер etcd отправляет ответ аутентификации: при успехе он содержит токен аутентификации, а при неудаче — ошибку. Клиент может предъявлять этот токен серверу etcd в качестве учётных данных при выполнении запросов API.
Клиентское соединение, использованное для запроса токена аутентификации, обычно закрывается: оно не может передавать учётные данные нового токена. Причина в том, что gRPC не позволяет добавить учётные данные отдельных RPC после создания соединения (вызова grpc.Dial()). Поэтому клиент не может назначить соединению токен, полученный через это же соединение. Для использования токена клиенту требуется новое соединение.
Примечания о реализации RPC Authenticate()
RPC Authenticate() создаёт токен аутентификации по заданному имени пользователя и паролю. etcd сохраняет настроенный пароль и проверяет переданный пароль с помощью пакета Go bcrypt. Механизм проверки пароля bcrypt намеренно требует значительных вычислительных ресурсов и занимает около 100ms на обычном сервере x64. Поэтому выполнение этой проверки в фазе применения конечного автомата создало бы проблемы с производительностью: весь кластер etcd мог бы обслуживать лишь около 10 запросов Authenticate() в секунду.
Для высокой производительности механизм аутентификации v3 проверяет пароли на уровне API etcd, где проверку можно распараллелить вне Raft. Однако это способно привести к потенциальным нарушениям разрешений типа «время проверки — время использования» (TOCTOU):
- клиент A отправляет запрос
Authenticate() - уровень API выполняет часть
Authenticate()с проверкой пароля - другой клиент B отправляет запрос
ChangePassword(), и сервер завершает его - уровень конечного автомата выполняет часть получения номера ревизии для
Authenticate()от A - сервер возвращает A успешный результат
- теперь A аутентифицирован по устаревшему паролю
Чтобы избежать такой ситуации, уровень API выполняет проверку номера версии на основе номера ревизии хранилища аутентификации. Во время проверки пароля уровень API сохраняет номер ревизии хранилища. После успешной проверки пароля он сравнивает сохранённый номер с последним номером ревизии. Если номера различаются, значит кто-то обновил метаданные аутентификации, и проверка выполняется повторно. Этот механизм предотвращает успешную проверку устаревшего пароля.
Разрешение токена на уровне API
После аутентификации с помощью Authenticate() клиент может создать соединение gRPC так же, как без аутентификации. Помимо обычной инициализации клиент должен связать токен с вновь созданным соединением. Для этого служит grpc.WithPerRPCCredentials().
Каждый аутентифицированный запрос клиента содержит токен. На стороне сервера его можно получить с помощью grpc.metadata.FromIncomingContext(). Сервер может определить, кто отправляет запрос и когда пользователь был авторизован. Уровень API заполняет эти сведения в заголовке (etcdserverpb.RequestHeader.Username и etcdserverpb.RequestHeader.AuthRevision) записи журнала Raft (etcdserverpb.InternalRaftRequest).
Проверка разрешения в конечном автомате
Сведения об аутентификации в etcdserverpb.RequestHeader проверяются на фазе применения конечного автомата. На этом шаге проверяется, предоставлено ли пользователю разрешение на запрошенные ключи в последней ревизии хранилища аутентификации.
Два типа токенов: simple и JWT
Существует два типа токенов: simple и JWT. Токен simple не предназначен для рабочих сценариев. Такие токены не подписаны криптографически, а серверы должны хранить состояние соответствия токенов пользователям; этот тип предназначен для тестирования при разработке. В рабочих развёртываниях следует использовать токены JWT, поскольку они подписываются и проверяются криптографически. С точки зрения реализации JWT не сохраняет состояние. Токен может содержать метаданные, включая имя пользователя и ревизию, поэтому серверам не нужно помнить соответствие между токенами и метаданными.
Для токенов simple известна проблема #18437 . В серверах etcd токены разрешаются на уровне API, а токены simple сохраняют состояние. Процесс не защищён линеаризуемой проверкой: участник etcd может не успеть завершить обработку предыдущего запроса аутентификации до получения следующего. В таких случаях участник может вернуть клиенту ошибку “invalid auth token”. На узле с хорошими сетевыми условиями проблема обычно возникает редко, но возможна при значительной задержке. В качестве обходного решения приложения могут реализовать повторные попытки обработки этой ошибки.
Непосредственная установка токенов JWT
Помимо стандартного потока RPC Authenticate(), etcd поддерживает непосредственную установку токенов JWT на уровне клиента. Это позволяет приложениям управлять полным жизненным циклом токенов JWT вне etcd, включая создание, проверку и ротацию токенов.
Сценарий использования и рабочий процесс
Этот подход полезен, когда:
- Отдельная система управления токенами (вне etcd) отвечает за создание и жизненный цикл токенов JWT
- Приложения получают заранее подписанные токены JWT через внешний механизм (например, переменные окружения или службу конфигурации)
- Жизненным циклом токена должно полностью управлять клиентское приложение, а не автоматическое создание токенов в etcd
Типичный рабочий процесс:
- Внешний доверенный центр (не etcd) создаёт подписанный токен JWT, содержащий имя пользователя и другие утверждения
- Приложение получает заранее подписанный токен и настраивает с ним клиент etcd
- Клиент отправляет токен JWT непосредственно с запросами (не вызывая
Authenticate()) - Сервер etcd проверяет подпись токена с помощью настроенного открытого ключа и предоставляет доступ на основе имени пользователя в токене
- До истечения срока токена приложение получает новый токен от внешнего доверенного центра
- Приложение создаёт новый клиент с обновлённым токеном (для обновления токена клиент необходимо пересоздать)
Отличия от стандартной аутентификации
При использовании стандартного потока Authenticate():
- Клиент вызывает
Authenticate()с именем пользователя и паролем - etcd создаёт и возвращает токен
- Клиент автоматически использует этот токен для последующих запросов
- Для обновления токена требуется снова вызвать
Authenticate()
При непосредственной установке токенов JWT:
- Клиент инициализируется с заранее подписанным токеном JWT
- Клиент не вызывает
Authenticate() - Токен используется непосредственно во всех запросах
- Клиентское приложение отвечает за получение новых токенов до истечения срока и управление жизненным циклом клиента
AuthStatus без действительного токена
Для поддержки приложений, самостоятельно управляющих токенами JWT, RPC AuthStatus позволяет клиентам определить, включена ли аутентификация, и получить текущую authRevision. Это важно для сценариев восстановления, когда срок токена истёк и клиенту требуется последняя ревизия, чтобы получить новый действительный токен от внешнего поставщика токенов.
Без этой возможности токен с истёкшим сроком мог бы помешать клиенту узнать текущую authRevision, создав взаимоблокировку, при которой невозможно создать новый токен.
Примечания о различиях между моделями KVS и файловой системы
etcd v3 — это KVS, а не файловая система. Поэтому разрешения пользователям можно предоставлять в форме точного имени ключа или диапазона ключей, например ["start key", "end key"). Это позволяет предоставить разрешение для несуществующего ключа. Пользователям следует учитывать возможность непреднамеренного предоставления разрешений. В системе, подобной файловой (например, Chubby или ZooKeeper), структура данных наподобие inode может содержать сведения о разрешениях. Поэтому предоставить разрешение для несуществующего ключа невозможно (за исключением случая sticky bits).
В отличие от систем, подобных файловой, модель etcd v3 требует нескольких поисков метаданных. В худшем случае стоимость поиска равна сумме всех ключей и интервалов, разрешённых пользователю. Избежать этих затрат нельзя, поскольку плоское пространство ключей v3 полностью отличается от модели файловой системы Unix (каждый inode содержит метаданные разрешений). На практике затраты не станут серьёзной проблемой, поскольку метаданные достаточно малы для эффективного кэширования.
12.5 - API etcd
Этот документ содержит обзор основной конструкции API etcd v3. Не следует путать его с API etcd v2, объявленным устаревшим в etcd v3.5. Документ не претендует на полноту, а сосредоточен на основных идеях, необходимых для понимания etcd, без отвлечения на менее распространённые вызовы API. Все API etcd определены в службах gRPC , которые группируют удалённые вызовы процедур (RPC), распознаваемые сервером etcd. Полный перечень RPC etcd приведён в формате Markdown в справочнике API gRPC .
Службы gRPC
Каждый запрос API, отправленный серверу etcd, является удалённым вызовом процедуры gRPC. RPC в etcd объединяются в службы по назначению.
К важным для работы с пространством ключей etcd службам относятся:
- KV — создаёт, обновляет, получает и удаляет пары «ключ — значение».
- Watch — отслеживает изменения ключей.
- Lease — предоставляет примитивы для обработки клиентских сообщений поддержания активности.
К службам управления самим кластером относятся:
- Auth — механизм аутентификации пользователей на основе ролей.
- Cluster — предоставляет сведения о составе кластера и средства конфигурации.
- Maintenance — создаёт снимки для восстановления, дефрагментирует хранилище и возвращает сведения о состоянии отдельных участников.
Запросы и ответы
Все RPC в etcd имеют одинаковый формат. Каждый RPC содержит функцию Name, которая принимает NameRequest как аргумент и возвращает NameResponse как ответ. Например, RPC Range описывается следующим образом:
Заголовок ответа
Все ответы API etcd содержат заголовок с метаданными кластера для данного ответа:
- Cluster_ID — идентификатор кластера, создавшего ответ.
- Member_ID — идентификатор участника, создавшего ответ.
- Revision — ревизия хранилища ключей и значений на момент создания ответа.
- Raft_Term — срок полномочий Raft участника на момент создания ответа.
Приложение может прочитать поле Cluster_ID или Member_ID, чтобы убедиться, что взаимодействует с предполагаемым кластером (участником).
По полю Revision приложения могут узнать последнюю ревизию хранилища ключей и значений. Это особенно полезно, когда приложение задаёт историческую ревизию для time travel query и хочет определить последнюю ревизию на момент запроса.
С помощью Raft_Term приложения могут определить момент завершения новых выборов лидера в кластере.
API ключей и значений
API ключей и значений управляет парами «ключ — значение», хранящимися в etcd. Обычно большинство запросов к etcd относится именно к ним.
Системные примитивы
Пара «ключ — значение»
Пара «ключ — значение» — минимальная единица, которой может управлять соответствующий API. Каждая пара содержит ряд полей, определённых в формате protobuf :
- Key — ключ в байтах. Пустой ключ недопустим.
- Value — значение в байтах.
- Version — версия ключа. Удаление сбрасывает её в ноль, а любое изменение ключа увеличивает версию.
- Create_Revision — ревизия последнего создания ключа.
- Mod_Revision — ревизия последнего изменения ключа.
- Lease — идентификатор аренды, присоединённой к ключу. Если lease равен 0, аренда к ключу не присоединена.
Помимо ключа и значения etcd добавляет в сообщение ключа метаданные ревизии. Они упорядочивают ключи по времени создания и изменения, что полезно для управления параллелизмом при распределённой синхронизации. Распределённые совместные блокировки клиента etcd используют ревизию создания при ожидании владения блокировкой. Аналогично, ревизия изменения применяется для обнаружения конфликтов набора чтения программной транзакционной памяти и ожидания обновлений выборов лидера .
Ревизии
etcd поддерживает общий для кластера 64-битный счётчик — ревизию хранилища, которая увеличивается при каждом изменении пространства ключей. Ревизия служит глобальными логическими часами, последовательно упорядочивающими все обновления хранилища. Изменение, представленное новой ревизией, является инкрементным: связанные с ревизией данные — это данные, изменившие хранилище. На внутреннем уровне новая ревизия означает запись изменений в B+tree бэкенда с увеличенной ревизией в качестве ключа.
Особую ценность ревизии приобретают в бэкенде etcd с многоверсионным управлением параллелизмом . Модель MVCC позволяет просматривать хранилище ключей и значений на прошлых ревизиях, поскольку исторические ревизии ключей сохраняются. Администраторы кластера могут настроить политику хранения этой истории для точного управления хранилищем; обычно etcd удаляет старые ревизии ключей по таймеру. Типичный кластер etcd хранит замещённые данные ключей несколько часов. Это также обеспечивает надёжную обработку длительных отключений клиентов, а не только временных сетевых сбоев: наблюдатели просто продолжают работу с последней замеченной исторической ревизии. Аналогично, для чтения хранилища в определённый момент запрос чтения можно пометить ревизией, чтобы вернуть ключи из представления пространства на момент фиксации этой ревизии.
Диапазоны ключей
Модель данных etcd индексирует все ключи в плоском двоичном пространстве. Этим она отличается от других хранилищ ключей и значений, использующих иерархическую организацию ключей в каталогах. Вместо перечисления по каталогам ключи перечисляются по интервалам [a, b).
В etcd эти интервалы часто называют «диапазонами». Операции над диапазонами мощнее операций над каталогами. Подобно иерархическому хранилищу, интервалы поддерживают поиск одного ключа через [a, a+1) (например, [‘a’, ‘a\x00’) ищет ‘a’) и поиск в каталоге посредством кодирования ключей по глубине каталога. Кроме того, интервалы могут кодировать префиксы: например, интервал ['a', 'b') ищет все ключи с префиксом ‘a’.
По соглашению диапазон запроса обозначается полями key и range_end. Поле key содержит первый ключ диапазона и не должно быть пустым. range_end — ключ, следующий за последним ключом диапазона. Если range_end не задан или пуст, диапазон содержит только аргумент key. Если range_end равен key плюс один (например, “aa”+1 == “ab”, “a\xff”+1 == “b”), диапазон представляет все ключи с префиксом key. Если и key, и range_end равны ‘\0’, диапазон представляет все ключи. Если ‘\0’ равен только range_end, диапазон содержит все ключи, большие либо равные аргументу key.
Range
Ключи извлекаются из хранилища ключей и значений вызовом API Range, принимающим RangeRequest:
- Key, Range_End — диапазон извлекаемых ключей.
- Limit — максимальное количество ключей в ответе. Значение limit, равное 0, означает отсутствие ограничения.
- Revision — момент состояния хранилища ключей и значений для диапазона. Если revision меньше или равна нулю, диапазон относится к последнему состоянию хранилища. Если ревизия компактизирована, возвращается ответ ErrCompacted.
- Sort_Order — порядок для отсортированных запросов.
- Sort_Target — поле пары «ключ — значение» для сортировки.
- Serializable — задаёт использование сериализуемого локального чтения с участника для диапазонного запроса. По умолчанию Range линеаризуем и отражает текущий консенсус кластера. Ради повышения производительности и доступности ценой возможного чтения устаревших данных сериализуемый запрос диапазона обслуживается локально без достижения консенсуса с другими узлами кластера.
- Keys_Only — возвращать только ключи без значений.
- Count_Only — возвращать только количество ключей в диапазоне.
- Min_Mod_Revision — нижняя граница ревизий изменения ключей; меньшие ревизии отфильтровываются.
- Max_Mod_Revision — верхняя граница ревизий изменения ключей; большие ревизии отфильтровываются.
- Min_Create_Revision — нижняя граница ревизий создания ключей; меньшие ревизии отфильтровываются.
- Max_Create_Revision — верхняя граница ревизий создания ключей; большие ревизии отфильтровываются.
В ответ на вызов Range клиент получает сообщение RangeResponse:
- Kvs — список пар «ключ — значение», соответствующих диапазонному запросу. При заданном
Count_OnlyполеKvsпусто. - More — при заданном
limitуказывает, остались ли в запрошенном диапазоне ключи для возврата. - Count — общее количество ключей, удовлетворяющих диапазонному запросу.
Для больших диапазонов ключей, когда буферизация полного ответа нежелательна, используйте RangeStream .
RangeStream
RangeStream возвращает тот же набор результатов, что и Range, однако сервер разбивает ответ на последовательность фрагментов и передаёт их клиенту потоком. Благодаря этому ни одной стороне не нужно целиком буферизовать большие диапазоны в памяти. RangeStream принимает тот же RangeRequest, что и Range.
В ответ на вызов RangeStream клиент получает поток сообщений RangeStreamResponse:
Заполнение полей во фрагментах:
- Kvs — каждый фрагмент содержит непересекающуюся часть результата. Объединение
kvsвсех фрагментов в порядке получения даёт тот же набор ключей, что и один вызовRange. - Header, More, Count — заполняются только в последнем фрагменте и лишь при завершении потока без ошибки. В предыдущих фрагментах эти поля имеют нулевые значения. Применение
proto.Mergeко всемrange_responseфрагментов даётRangeResponse, эквивалентный ответуRange.
Если поток завершается ошибкой, ни один фрагмент не содержит действительных header, more или count.
Все фрагменты потока обслуживаются относительно одной ревизии. Если запрос не задаёт Revision, при запуске потока сервер фиксирует последнюю зафиксированную ревизию и использует её до конца потока.
RangeStream не поддерживает пользовательские порядки сортировки и фильтры ревизий (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Использующие их запросы возвращают Unimplemented. Прокси gRPC etcd также не поддерживает RangeStream.
Существует два распространённых способа обработки RangeStream:
- Обрабатывать каждый фрагмент независимо. Подходит для высокопроизводительных сценариев, когда клиент хочет декодировать и обрабатывать ключи по мере поступления, а не сначала собирать весь результат. Клиент перебирает фрагменты и обрабатывает
kvsкаждого, а после успешного завершения потока читаетheader,moreилиcountиз последнего фрагмента. - Собрать единый ответ. Подходит, когда клиенту требуется результат, эквивалентный унарному
Range. Клиент объединяетrange_responseкаждого фрагмента в одинRangeResponse(например, черезproto.Merge). Объединённый результат содержит полныйkvs, а такжеheader,moreиcountиз последнего фрагмента. Для этого шаблона клиент Go предоставляет вспомогательную функциюclientv3.GetStreamToGetResponse.
Put
Ключи сохраняются в хранилище ключей и значений вызовом Put, принимающим PutRequest:
- Key — имя ключа, записываемого в хранилище ключей и значений.
- Value — значение в байтах, связываемое с ключом в хранилище.
- Lease — идентификатор аренды, связываемой с ключом. Значение аренды 0 означает отсутствие аренды.
- Prev_Kv — если задано, в ответе возвращаются данные пары «ключ — значение» до обновления запросом
Put. - Ignore_Value — если задано, ключ обновляется без изменения текущего значения. Если ключ не существует, возвращается ошибка.
- Ignore_Lease — если задано, ключ обновляется без изменения текущей аренды. Если ключ не существует, возвращается ошибка.
В ответ на вызов Put клиент получает сообщение PutResponse:
- Prev_Kv — пара «ключ — значение», перезаписанная операцией
Put, если вPutRequestбыло заданоPrev_Kv.
Удаление диапазона
Диапазоны ключей удаляются вызовом DeleteRange, принимающим DeleteRangeRequest:
- Key, Range_End — удаляемый диапазон ключей.
- Prev_Kv — если задано, возвращает содержимое удалённых пар «ключ — значение».
В ответ на вызов DeleteRange клиент получает сообщение DeleteRangeResponse:
- Deleted — количество удалённых ключей.
- Prev_Kv — список всех пар «ключ — значение», удалённых операцией
DeleteRange.
Транзакция
Транзакция — атомарная конструкция If/Then/Else над хранилищем ключей и значений. Она предоставляет примитив для объединения запросов в атомарные блоки (then/else), выполнение которых защищено условием (if), основанным на содержимом хранилища. Транзакции позволяют защищать ключи от непреднамеренных параллельных обновлений, строить операции сравнения с обменом и создавать механизмы управления параллелизмом более высокого уровня.
Транзакция может атомарно обработать несколько запросов в одном запросе. При изменении хранилища его ревизия увеличивается только один раз на транзакцию, а все созданные ею события имеют одинаковую ревизию. Однако многократное изменение одного ключа в рамках одной транзакции запрещено.
Все транзакции защищены конъюнкцией сравнений, подобной оператору If. Каждое сравнение проверяет один ключ в хранилище: отсутствие или наличие значения, равенство заданному значению либо ревизию или версию ключа. Два разных сравнения могут относиться к одному или разным ключам. Все сравнения применяются атомарно. Если они истинны, транзакция считается успешной и etcd применяет блок запросов then / success; иначе транзакция считается неудачной и применяется блок else / failure.
Каждое сравнение кодируется сообщением Compare:
- Result — тип логической операции сравнения (например, равно, меньше и т. д.).
- Target — сравниваемое поле пары «ключ — значение»: версия ключа, ревизия создания, ревизия изменения либо значение.
- Key — ключ для сравнения.
- Target_Union — заданные пользователем данные сравнения.
После обработки блока сравнений транзакция применяет блок запросов. Блок представляет собой список сообщений RequestOp:
- Request_Range —
RangeRequest. - Request_Put —
PutRequest. Ключи должны быть уникальны и не могут пересекаться с ключами других операций Put или Delete. - Request_Delete_Range —
DeleteRangeRequest. Ключи не могут пересекаться с ключами запросов Put или Delete.
В итоге транзакция выполняется вызовом API Txn, принимающим TxnRequest:
- Compare — список предикатов, представляющих конъюнкцию условий защиты транзакции.
- Success — список запросов, обрабатываемых, если все сравнения истинны.
- Failure — список запросов, обрабатываемых, если хотя бы одно сравнение ложно.
В ответ на вызов Txn клиент получает сообщение TxnResponse:
- Succeeded — результат вычисления
Compare: true или false. - Responses — список ответов, соответствующих результатам применения блока
Success, если succeeded равно true, либо блокаFailure, если succeeded равно false.
Список Responses соответствует результатам применённого списка RequestOp, причём каждый ответ кодируется как ResponseOp:
Включённый в каждый внутренний ответ ResponseHeader не следует интерпретировать каким-либо образом.
Если клиенту нужна последняя ревизия, он всегда должен проверять верхнеуровневый ResponseHeader в TxnResponse.
API наблюдения
API Watch предоставляет событийный интерфейс для асинхронного отслеживания изменений ключей. Наблюдение etcd ожидает изменения, непрерывно отслеживая ключи с заданной текущей или исторической ревизии, и потоком отправляет обновления клиенту.
События
Каждое изменение любого ключа представлено сообщением Event. Сообщение Event содержит данные и тип обновления:
- Type — тип события. PUT означает сохранение новых данных по ключу, DELETE — удаление ключа.
- KV — связанный с событием KeyValue. Событие PUT содержит текущую пару kv. PUT с kv.Version=1 означает создание ключа. DELETE содержит удалённый ключ, у которого ревизия изменения равна ревизии удаления.
- Prev_KV — пара «ключ — значение» из ревизии непосредственно перед событием. Для экономии пропускной способности заполняется, только если явно включена в наблюдении.
Потоки наблюдения
Наблюдения — длительные запросы, использующие потоки gRPC для передачи данных событий. Поток наблюдения двунаправлен: клиент записывает в него для создания наблюдений и читает для получения событий. Один поток может мультиплексировать множество отдельных наблюдений, помечая события их идентификаторами. Это снижает потребление памяти и накладные расходы соединений в основном кластере etcd.
Гарантии для событий наблюдения описаны в разделе гарантии API etcd .
Клиент создаёт наблюдение, отправляя WatchCreateRequest через поток, возвращённый Watch:
- Key, Range_End — наблюдаемый диапазон ключей.
- Start_Revision — необязательная ревизия, с которой включительно начинается наблюдение. Если не задана, поток передаёт события после ревизии из заголовка ответа о создании наблюдения. Всю доступную историю событий можно наблюдать с последней ревизии компактизации.
- Progress_Notify — если задано и недавних событий нет, наблюдение периодически получает WatchResponse без событий. Это полезно для восстановления отключённого наблюдателя с недавней известной ревизии. Сервер etcd выбирает частоту уведомлений по текущей нагрузке.
- Filters — список типов событий, отфильтровываемых на стороне сервера.
- Prev_Kv — если задано, наблюдение получает данные пары «ключ — значение» до события. Это позволяет узнать, какие данные были перезаписаны.
В ответ на WatchCreateRequest либо при появлении нового события для созданного наблюдения клиент получает WatchResponse:
- Watch_ID — идентификатор наблюдения, соответствующего ответу.
- Created — равно true, если это ответ на запрос создания наблюдения. Клиент должен сохранить идентификатор и ожидать события наблюдения в потоке. Все отправленные созданному наблюдателю события имеют одинаковый watch_id.
- Canceled — равно true, если это ответ на запрос отмены наблюдения. Отменённому наблюдателю больше не отправляются события.
- Compact_Revision — минимальная доступная etcd историческая ревизия, если наблюдатель пытается начать с компактизированной ревизии. Такое происходит при создании наблюдателя на компактизированной ревизии или когда наблюдатель не успевает за изменениями хранилища. Наблюдатель отменяется; создание новых наблюдений с тем же start_revision завершится ошибкой.
- Events — упорядоченный список новых событий, соответствующих данному идентификатору наблюдения.
Чтобы прекратить получение событий наблюдения, клиент отправляет WatchCancelRequest:
- Watch_ID — идентификатор отменяемого наблюдения, которому больше не будут передаваться события.
API аренды
Аренды служат механизмом определения активности клиента. Кластер выдаёт аренды со сроком жизни. Аренда истекает, если кластер etcd не получает keepAlive в течение заданного периода TTL.
Для связи аренд с хранилищем каждый ключ можно присоединить не более чем к одной аренде. При истечении или отзыве аренды все присоединённые ключи удаляются. Каждый истёкший ключ создаёт событие удаления в истории событий.
Получение аренд
Аренды получают вызовом API LeaseGrant, принимающим LeaseGrantRequest:
- TTL — рекомендуемый срок жизни в секундах.
- ID — запрошенный идентификатор аренды. Если ID равен 0, etcd выбирает идентификатор самостоятельно.
В ответ на вызов LeaseGrant клиент получает LeaseGrantResponse:
- ID — идентификатор выданной аренды.
- TTL — выбранный сервером срок жизни аренды в секундах.
- ID — идентификатор отзываемой аренды. При отзыве все присоединённые ключи удаляются.
Поддержание активности
Аренды обновляются через двунаправленный поток, созданный вызовом API LeaseKeepAlive. Чтобы обновить аренду, клиент отправляет через поток LeaseKeepAliveRequest:
- ID — идентификатор аренды, активность которой поддерживается.
Поток поддержания активности отвечает сообщением LeaseKeepAliveResponse:
- ID — аренда, обновлённая с новым TTL.
- TTL — новый оставшийся срок жизни аренды в секундах.
12.6 - Файлы постоянного хранилища etcd
В этом документе описан формат постоянного хранилища etcd: именование, содержимое и инструменты, позволяющие разработчикам исследовать файлы. В дальнейшем документ следует дополнять по мере изменений модели хранения. Он предназначен для разработчиков etcd и помогает при восстановлении данных.
Предварительные сведения
Для понимания документа полезны следующие вводные материалы:
- обзор модели данных etcd
- обзор Raft (особенно раздел “5.3 Log replication”).
Обзор
Долгоживущие файлы
| Имя файла | Высокоуровневое назначение |
|---|---|
./member/snap/db | b+tree bbolt, хранящее все применённые данные, сведения об авторизации состава кластера и метаданные. Оно знает последний применённый индекс журнала WAL ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | Периодические снимки устаревшего хранилища v2, содержащие:
Начиная с etcd v3 их содержимое дублирует содержимое файлов /snap/db. Периодически (каждые 30s) эти файлы удаляются, при этом сохраняются последние |
/member/snap/000000000007a178.snap.db | Полный загруженный снимок bbolt с лидера etcd, если реплика отставала слишком сильно. Содержит данные того же типа, что и файл ( Файл используется в 2 сценариях:
Файл не удаляется после завершения восстановления, когда всё его содержимое перенесено в ./member/snap/db. Периодически (каждые 30s) файлы удаляются.
Здесь также сохраняются последние |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Журналы предзаписи Raft, содержащие недавние транзакции, принятые Raft, периодические снимки или записи CRC. Сохраняются последние Если снимки создаются слишком редко, файлов может быть больше |
./member/wal/0.tmp (or .../1.tmp) | Предварительно выделенное пространство для следующего файла журнала предзаписи. Позволяет не допустить остановки Raft из-за нехватки места для журналов WAL без возможности активировать аварийный сигнал. |
Временные файлы
Во время внутренней обработки etcd могут встречаться несколько краткоживущих файлов:
| Файл | Высокоуровневое назначение |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | Файлы снимков переименовываются в ‘broken’, если их невозможно загрузить. Попытка загрузить самый новый файл выполняется при запуске etcd. Либо при выполнении команд backup/migrate в etcdctl. |
./member/snap/tmp071677638 (random suffix) | Временный файл bbolt, создаваемый на репликах в ответ на запрос лидера msgSnap, то есть на требование лидера восстановить хранилище из заданного снимка. После успешного полного получения содержимого файл переименовывается в См. etcd/issues/12837. Исправлено в etcd 3.5. |
/member/snap/db.tmp.071677638 (random suffix) | Временный файл, содержащий копию содержимого бэкенда (/member/snap/db) во время дефрагментации. После её успешного завершения файл переименовывается в /member/snap/db и заменяет исходный бэкенд. При запуске сервера etcd эти файлы удаляются. |
b+tree bbolt: member/snap/db
Этот файл содержит основное содержимое etcd, применённое до определённой точки журнала Raft (см. consistent_index ).
Физическая организация
Физически хранилище better bolt организовано как b+tree
. Физические страницы b-tree никогда не изменяются на месте1. Вместо этого содержимое копируется на новую страницу, полученную из списка свободных, а старая страница добавляется в список свободных, как только не остаётся открытых транзакций, способных к ней обратиться. Благодаря этому открытая транзакция RO видит согласованное историческое состояние хранилища. Транзакция RW является исключительной и блокирует все остальные транзакции RW.
Большие значения хранятся на нескольких непрерывных страницах. Освобождение страниц в сочетании с необходимостью выделять непрерывные области страниц разного размера может усиливать фрагментацию хранилища bbolt.
Файл bbolt сам по себе никогда не уменьшается. Только при дефрагментации его можно переписать в новый файл с некоторым запасом свободных страниц в конце и усечённым размером.
Логическая организация
Хранилище bbolt разделено на сегменты. В каждом сегменте ключи (пары byte[]->value byte[]) хранятся в лексикографическом порядке. Ниже перечислены сегменты, используемые etcd по состоянию на версию 3.5, и задействованные ключи.
| Сегмент | Ключ | Пример значения | Описание |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT} | nil | Указывает, что у одного из участников диагностированы проблемы. |
| auth | "authRevision" | "" (empty) or BigEndian.PutUint64 | Любое изменение ролей или пользователей увеличивает это поле при фиксации транзакции. Значение используется только для оптимистической блокировки во время авторизации. |
| authRoles | [roleName] в виде строки | сериализованный authpb.Role | |
| authUsers | [userName] в виде строки | сериализованный authpb.User | |
| cluster | "clusterVersion" | "3.5.0" (string) | Дополнительная версия общей версии хранилища, согласованной консенсусом. |
| "downgrade" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | Сохраняет намерение, заданное последним запросом Начиная с v3.5 | |
| key | [revisionId], закодированный с помощью bytesToRev{main,sub} Удаления пар «ключ — значение» сериализуются с 't' в конце (как "Tombstone") | сериализованный proto mvccpb.KeyValue (key, create_rev, mod_rev, version, value, lease id) | |
| lease | сериализованный proto leasepb.Lease (ID, TTL, RemainingTTL) | Примечание: LeaseCheckpoint продлевает только RemainingTTL. TTL берётся из исходного Grant. Примечание 2: TTL сохраняются в секундах (от неопределённого 'now'). Сервер в цикле аварийных перезапусков не освобождает аренды!!! | |
| members | [memberId] в шестнадцатеричном виде как строка: "8e9e05c52164694d" | Структура Member, сериализованная в JSON как строка:{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | Согласованные сведения о составе кластера. |
| members_removed | [memberId] в шестнадцатеричном виде как строка: "8e9e05c52164694d" | []byte("removed") | Идентификаторы всех удалённых участников. Используются для проверки, что удалённый участник никогда не добавляется снова с тем же идентификатором. Сейчас (3.4) поле читается из хранилища V2 и никогда из V3. См. https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | байты uint64 (BigEndian) | Представляет смещение последней записи WAL, применённой к хранилищу БД bolt. |
| "scheduledCompactRev" | закодированный bytesToRev{main,sub}. (16 байтов) | Используется для повторной инициализации компактизации, если после её запроса произошёл сбой. | |
| "finishedCompactRev" | закодированный bytesToRev{main,sub}. (16 байтов) | Ревизия, на которой недавно успешно компактизировано хранилище (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Начиная с etcd 3.5 | ||
| "term" | Начиная с etcd 3.5 | ||
| "storage-version" |
Инструменты
bbolt
bbolt предоставляет инструмент командной строки для исследования содержимого файла.
Примеры использования:
Перечисление всех сегментов заданного файла bbolt:
Чтение определённой пары «ключ — значение»:
etcd-dump-db
etcd-dump-db позволяет перечислить содержимое бэкенда etcd v3 (bbolt).
Дополнительные примеры: https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL: журнал предзаписи
Журнал предзаписи — постоянное хранилище Raft для предложений. Сначала лидер сохраняет предложение в своём журнале, а затем параллельно реплицирует его последователям по протоколу Raft. Каждый последователь сохраняет предложение в своём WAL, прежде чем подтвердить репликацию лидеру.
Используемый в etcd журнал WAL отличается от канонической модели Raft по 2 признакам:
- Он сохраняет не только индексированные записи, но также облегчённые снимки Raft и hard-state. Поэтому полное состояние Raft участника можно восстановить только из журнала WAL.
- Он доступен только для добавления. Записи не перезаписываются на месте: добавленная позднее в файл запись с тем же индексом замещает предыдущую.
Имена файлов
Файлы журнала WAL именуются по следующему шаблону:
Пример: ./member/wal/0000000000000010-00000000000bf1e6.wal
Таким образом, имя файла содержит в шестнадцатеричной кодировке:
- Порядковый номер файла журнала WAL
- Индекс первой записи или снимка в файле. В частности, первый файл “0000000000000000-0000000000000000.wal” содержит запись исходного снимка с index=0.
Физическое содержимое
Файл журнала WAL содержит последовательность «кадров ». Каждый кадр содержит:
- Закодированное в LittleEndian 2 значение uint64, содержащее длину сериализованной walpb.Record (3).
- Заполнение: некоторое количество байтов 0, обеспечивающее выравнивание размера всего кадра (mod 8)
- Сериализованные данные walpb.Record
:
- type — перечисление в кодировке int, определяющее интерпретацию поля data ниже
- data — в зависимости от типа, обычно сериализованный proto
- crc — контрольная сумма RC-32 совокупности всех полей “data” без type во всех записях журнала этой реплики с момента создания WAL. Обратите внимание: CRC учитывает ВСЕ записи, даже если Raft их не зафиксировал.
Файлы «обрезаются» (начинается новый файл), когда текущий превышает 64*10^6 байтов.
Логическое содержимое
На логическом уровне файлы журнала предзаписи содержат:
Raftpb.Entry:недавние предложения, реплицированные лидером Raft. Некоторые из них считаются зафиксированными, а остальные могут быть логически замещены.Raftpb.HardState(term,commit,vote):периодические и очень частые сведения об индексе зафиксированной записи журнала, то есть реплицированной на большинство серверов, гарантированно не подлежащей изменению или замещению и применимой к бэкендам (v2, v3). Также содержит “term”, указывающий на изменения, связанные с выборами, и vote — участника, за которого текущая реплика проголосовала в текущем сроке полномочий.walpb.Snapshot(term, index):периодические снимки состояния Raft без содержимого БД, только индекс журнала снимка и срок полномочий Raft- Содержимое хранилища V2 хранится в отдельных файлах *.store.
- Содержимое хранилища V3 находится в файле bbolt и становится неявным снимком сразу после применения записей.
- запись контрольной суммы crc32 в начале каждого файла, позволяющая продолжить проверку CRC для остальной части файла.
etcdserverpb.Metadata(node_id, cluster_id)— идентификаторы кластера и реплики, представленных журналом.
Каждый файл журнала WAL состоит из следующих элементов по порядку:
Кадр CRC-32 (накопленная crc всех предыдущих файлов, 0 для первого файла).
Кадр метаданных (идентификаторы кластера и реплики)
Только для исходного файла WAL:
- Пустой кадр Snapshot (Index:0, Term: 0). Он поддерживает инвариант, согласно которому всем записям «предшествует» снимок.
Для не исходного файла WAL (2nd+):
- Кадр HardState.
Смесь записей entry, hard-state и snapshot
Журнал WAL может содержать несколько записей с одним индексом. Такая ситуация возможна в случаях, описанных на рисунке 7 статьи о Raft . Журнал WAL etcd доступен только для добавления, поэтому запись замещается добавлением новой записи с тем же индексом.
В частности, при чтении WAL логика замещает старые записи новыми . Поэтому окончательной можно считать только последнюю версию записей с entry.index <= HardState.commit. Записи с index > HardState.commit могут изменяться.
Значения “terms” в журнале WAL должны быть монотонными.
Значения “indexes” в журнале WAL должны:
- начинаться с некоторого снимка
- последовательно расти после снимка, пока остаются в том же ‘term’
- при изменении term индекс может уменьшиться, но только до нового значения, превышающего последний HardState.commit.
- новый снимок может появиться с любым index >= HardState.commit, открывая новую последовательность индексов.
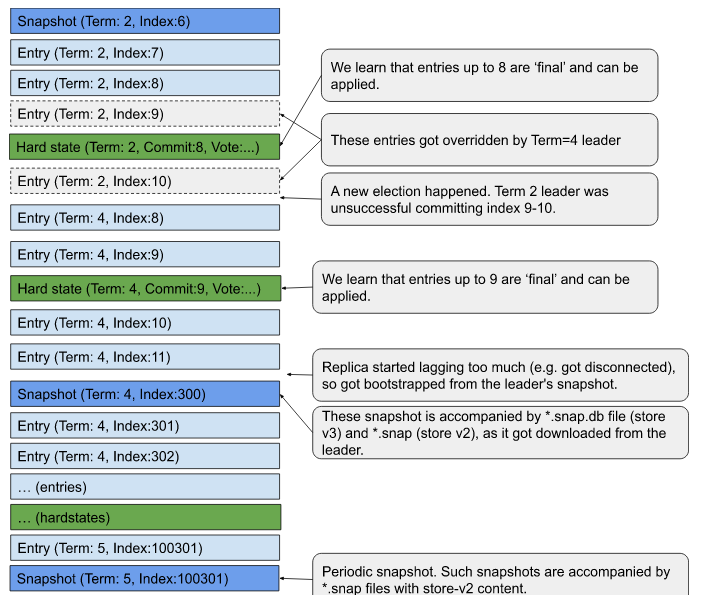
Инструменты
etcd-dump-logs
Журналы WAL etcd можно читать инструментом etcd-dump-logs :
Учитывайте следующее:
- Инструмент показывает только Entries, а не все записи WAL (Snapshots, HardStates) из файлов журнала.
- Инструмент автоматически применяет «замещения» записей. Если запись замещена более новой с тем же индексом, выводится только окончательное значение.
- Инструмент также выводит незафиксированные записи из хвоста LOG без сведений о HardState.commitIndex, поэтому неизвестно, являются ли они окончательными.
Снимки (хранилища V2): member/snap/{term}-{index}.snap
Имена файлов:
member/snap/{term}-{index}.snap
Имена файлов создаются здесь
по шаблону ("%016x-%016x.snap") и содержат 2 компонента в шестнадцатеричной кодировке:
- term -> срок полномочий Raft (период между выборами) на момент создания снимка
- index -> индекс последнего применённого предложения на момент создания снимка
Создание
Файлы *.snap создаются методом Snapshotter.SaveSnap .
Создание этих файлов управляется 2 триггерами:
- Новый файл создаётся примерно каждые –snapshotCount=(по умолчанию 100'000) применённых предложений. Значение приблизительно, поскольку предложения могут поступать пакетами, создание снимка рассматривается только в конце пакета, а сам процесс планируется асинхронно. Имя флага (–snapshotCount) не вполне точно: он определяет разницу значений индекса между индексом последнего снимка и индексом последнего применённого предложения.
- Raft требует, чтобы реплика восстановилась из снимка. Получая снимок по сети в сообщении msgSnap, реплика также создаёт его облегчённую контрольную точку в журнале WAL. Это гарантирует, что в хвосте журналов WAL всегда находится действительный снимок с последующими записями, и предотвращает возможный разрыв непрерывности журналов.
Сейчас файлы приблизительно3 соответствуют записям Snapshot журналов WAL в отношении 1-1. После вывода хранилища v2 из эксплуатации запись этих файлов должна полностью прекратиться (необязательно в 3.5.x, обязательно в 3.6.x).
Содержимое
Файл содержит сериализованный proto snapdb.snapshot
(uint32 crc, bytes data),
в поле ‘data’ которого находится Raftpb.Snapshot :
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Наконец, вложенные данные содержат сериализованное в JSON содержимое хранилища v2 .
В частности, присутствуют:
- Term
- Index
- Данные о составе кластера:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Версия хранилища: /0/version-> 3.5.0
Инструменты
protoc
Следующая команда позволяет просмотреть содержимое файла при выполнении из корневого каталога etcd:
Аналогично можно извлечь поле ‘data’ и декодировать его как ‘Raftpb.Snapshot
'
Пример сериализованного в JSON содержимого хранилища v2 в файлах *.snap etcd 3.4:
Изменения
Этот раздел предназначен для описания изменений форматов файлов между различными версиями etcd.
12.7 - Гарантии API etcd
etcd — согласованное и долговечное хранилище ключей и значений. Доступ к нему предоставляют службы gRPC . etcd обеспечивает наиболее строгие гарантии согласованности и долговечности для распределённой системы. В этой спецификации перечислены гарантии API etcd.
Рассматриваемые API
- KV APIs
- API наблюдения
- API аренды
- Grant
- [Отзыв][Revoke]
- Keep alive
API KV позволяет напрямую читать и изменять хранилище ключей и значений. API наблюдения позволяет подписываться на изменения хранилища. API аренды позволяет назначать ключу время существования.
API KV и наблюдения предоставляют доступ не только к последним версиям ключей, но и к предыдущим версиям в непрерывном окне истории, ограниченном операцией компактизации.
Вызов API KV действует немедленно, тогда как API наблюдения возвращает события с неограниченной задержкой. В исправном кластере etcd события наблюдения обычно появляются через 10ms после возникновения. Однако верхней границы нет, и в неисправном кластере события могут не поступить вовсе.
API KV
etcd гарантирует долговечность и строгую сериализуемость всех вызовов API KV. Это самые строгие гарантии изоляции распределённых транзакционных баз данных.
Долговечность
Любая завершённая операция долговечна. Все доступные данные также долговечны. Чтение никогда не вернёт данные, которые не были сохранены долговечно.
Строгая сериализуемость
Операции службы KV атомарны и выполняются в полном порядке, согласованном с их порядком в реальном времени. Полный порядок задаётся ревизией . Подробнее см. строгая сериализуемость .
В транзакциях без вложенных TXN порядок выполнения операций гарантированно совпадает с порядком в списке, что обеспечивает стабильные ответы GET внутри транзакции. Для транзакций с вложенными TXN порядок выполнения не определён.
Строгая сериализуемость подразумевает другие, более слабые и понятные гарантии:
Атомарность
Все запросы API атомарны: операция либо завершается полностью, либо не выполняется совсем. Для запросов наблюдения все события одной операции входят в один ответ. Наблюдение никогда не видит частичные события отдельной операции.
Линеаризуемость
С точки зрения клиента линеаризуемость предоставляет полезные свойства,
упрощающие рассуждения. В оригинальной статье
дано ясное
описание: Linearizability provides the illusion that each operation applied by concurrent processes takes effect instantaneously at some point between its invocation and its response.
Например, клиент завершает запись в момент 1 (t1). Клиент, начавший чтение в t2 (где t2 > t1), должен получить значение не старее предыдущей записи, завершённой в t1. Однако само чтение может завершиться только в t3. Линеаризуемость гарантирует возврат самого актуального значения. Без неё значение, актуальное в t2 при начале чтения, может устареть к t3, поскольку между t2 и t3 могла произойти параллельная запись.
По умолчанию etcd обеспечивает линеаризуемость всех остальных операций. За это
приходится платить: линеаризуемые запросы должны проходить через консенсус Raft.
Чтобы снизить задержку и повысить пропускную способность чтения, клиент может
выбрать для запроса режим согласованности serializable. Он допускает чтение
устаревших относительно кворума данных, но устраняет затраты на живой консенсус,
необходимый линеаризуемому доступу.
API наблюдения
Наблюдения предоставляют следующие гарантии событий:
- Упорядоченность — события упорядочены по ревизии. В наблюдении не появится событие, которое по времени предшествует уже опубликованному. Для транзакций без вложенных TXN порядок создаваемых событий гарантированно совпадает с порядком операций в списке. Для транзакций с вложенными TXN порядок не определён.
- Уникальность — событие не появится в одном наблюдении дважды.
- Надёжность — последовательность не пропустит подпоследовательность событий в доступном окне истории. Если события упорядочены как a < b < c и наблюдение получает a и c, оно гарантированно получит b, пока b находится в доступном окне.
- Атомарность — список событий гарантированно охватывает полные ревизии. Обновления нескольких ключей в одной ревизии не разделяются между списками.
- Возобновляемость — прерванное наблюдение можно возобновить, создав новое после последней ревизии, полученной до разрыва, пока она находится в окне истории.
- Возможность закладки — события уведомления о ходе гарантируют, что все события до указанной ревизии уже доставлены.
etcd не гарантирует линеаризуемость операций наблюдения. Для правильного порядка относительно других операций пользователи должны проверять ревизию событий.
API аренды
etcd предоставляет механизм аренды . Основной сценарий — реализация распределённой координации, например распределённых блокировок. Механизм прост: аренда создаётся API grant, привязывается к ключу API put, отзывается API revoke и истекает по времени существования (TTL) настенных часов. Однако для правильной распределённой координации необходимо учитывать важные свойства API и их использования .
Определения, специфичные для etcd
Завершённая операция
Операция etcd считается завершённой, когда она зафиксирована через консенсус и,
следовательно, «выполнена» — навсегда сохранена — движком хранения etcd. Клиент
узнаёт о завершении, получив ответ сервера etcd. Если истёк тайм-аут или между
клиентом и участником etcd нарушилась сеть, статус операции может остаться
неопределённым для клиента. etcd также может прерывать операции во время выборов
лидера. В этом случае etcd не отправляет ответы abort на ожидающие запросы клиентов.
Ревизия
Операции etcd, изменяющей хранилище ключей и значений, назначается одна возрастающая ревизия. Транзакция может изменить хранилище несколько раз, но получает только одну ревизию. Атрибут ревизии изменённой пары «ключ — значение» равен ревизии операции. Ревизию можно использовать как логические часы хранилища. Пара с большей ревизией изменена после пары с меньшей. Две пары с одинаковой ревизией изменены одной операцией «одновременно».
12.8 - etcd в сравнении с другими хранилищами ключей и значений
Название «etcd» образовано из двух идей: каталога Unix «/etc» и распределённых («d»istributed) систем. В «/etc» хранятся данные конфигурации одной системы, тогда как etcd хранит конфигурацию крупных распределённых систем. Поэтому распределённый («d»istributed) «/etc» называется «etcd».
etcd задуман как универсальная основа крупных распределённых систем. Такие системы не допускают split-brain и готовы ради этого пожертвовать доступностью. etcd хранит метаданные согласованно и отказоустойчиво. Кластер etcd предоставляет хранилище ключей и значений с высокой стабильностью, надёжностью, масштабируемостью и производительностью.
Распределённые системы используют etcd как согласованное хранилище ключей и значений для управления конфигурацией, обнаружения служб и координации работы. Многие организации строят на etcd производственные системы: планировщики контейнеров, службы обнаружения и распределённые хранилища данных. Распространённые шаблоны включают выбор лидера , распределённые блокировки и контроль работоспособности машин.
Сценарии использования
- Container Linux от CoreOS: приложения в Container Linux автоматически получают обновления ядра Linux без простоя. Container Linux координирует обновления через locksmith , реализующий распределённый семафор на etcd, чтобы одновременно перезагружалась только часть кластера.
- Kubernetes хранит в etcd конфигурацию для обнаружения служб и управления кластером; согласованность etcd критична для правильного планирования и работы служб. Сервер API Kubernetes сохраняет состояние кластера в etcd и использует API наблюдения для мониторинга и применения важных изменений.
Сравнительная таблица
Возможно, etcd уже кажется подходящим, но любое технологическое решение требует осторожности. Документацию написала команда etcd. Хотя сравнение должно быть беспристрастным, опыт и предпочтения авторов неизбежно склоняются в пользу etcd.
Таблица позволяет быстро сравнить etcd с популярными альтернативами. Подробности по каждому столбцу приведены в следующих разделах.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Примитивы конкурентности | RPC блокировок , RPC выборов , блокировки командной строки , выборы командной строки , рецепты на Go | Внешние рецепты curator на Java | Встроенный API блокировок | Редко , если вообще есть |
| Линеаризуемое чтение | Да | Нет | Да | Иногда |
| Многоверсионное управление конкурентностью | Да | Нет | Нет | Иногда |
| Транзакции | Сравнение полей, чтение, запись | Проверка версии, запись | Сравнение поля, блокировка, чтение, запись | В стиле SQL |
| Уведомления об изменениях | Исторические и текущие интервалы ключей | Текущие ключи и каталоги | Текущие ключи и префиксы | Триггеры (иногда) |
| Права пользователей | На основе ролей | ACL | ACL | Различаются (табличный GRANT , роли базы данных ) |
| API HTTP/JSON | Да | Нет | Да | Редко |
| Изменение состава | Да | >3.5.0 | Да | Да |
| Максимальный надёжный размер базы | Несколько гигабайт | Сотни мегабайт (иногда несколько гигабайт) | Сотни MB | Терабайты+ |
| Минимальная задержка линеаризации чтения | Сетевой RTT | Без линеаризации чтения | RTT + fsync | Барьеры часов (атомарные, NTP) |
ZooKeeper
ZooKeeper решает ту же задачу, что и etcd: координацию распределённых систем и хранение метаданных. Но при создании etcd учитывался инженерный и эксплуатационный опыт проектирования ZooKeeper. Эти уроки помогли etcd поддерживать крупные системы, такие как Kubernetes. Улучшения относительно ZooKeeper включают:
- динамическое изменение состава кластера;
- стабильное чтение и запись под высокой нагрузкой;
- модель многоверсионного управления конкурентностью;
- надёжное наблюдение за ключами без скрытой потери событий;
- примитивы аренды, отделяющие соединения от сеансов;
- API безопасных распределённых совместных блокировок.
Кроме того, etcd изначально поддерживает множество языков и фреймворков.
ZooKeeper использует собственный уникальный протокол Jute RPC, ограничивающий
языковые привязки
, тогда как клиентский протокол etcd основан на
gRPC
с привязками для Go, C++, Java и других языков. gRPC можно
сериализовать в JSON поверх HTTP, поэтому с etcd работают даже утилиты вроде
curl. Системы строятся на etcd с естественными инструментами выбранного стека.
Новым приложениям, которым нужно согласованное хранилище ключей и значений, с учётом возможностей, поддержки и стабильности лучше выбрать etcd вместо ZooKeeper.
Consul
Consul — комплексная среда обнаружения служб со встроенными проверками состояния, обнаружением отказов и DNS. Она также предоставляет хранилище ключей и значений через RESTful API HTTP. В Consul 1.0 операции с ключами масштабировались хуже etcd и ZooKeeper: миллионы ключей приводили к высоким задержкам и давлению на память. В API отсутствуют многоверсионные ключи, условные транзакции и надёжные потоковые наблюдения.
etcd и Consul решают разные задачи. Для распределённого согласованного хранилища лучше etcd. Для комплексного обнаружения служб кластера возможностей etcd недостаточно; выберите Kubernetes, Consul или SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
И etcd, и базы NewSQL, например Cockroach , TiDB и Google Spanner , обеспечивают строгую согласованность при высокой доступности. Но различия архитектуры приводят к разным клиентским API и характеристикам.
Базы NewSQL горизонтально масштабируются между центрами обработки данных. Они разделяют терабайты данных между несколькими, иногда удалёнными, согласованными группами репликации (шардами). Из-за ожидания часов и локализованных графов зависимостей обновлений они плохо подходят для распределённой координации. Данные организованы в таблицы с более богатым SQL, чем у etcd, ценой сложности обработки, планирования и оптимизации запросов.
Итого: для метаданных и координации распределённых приложений выбирайте etcd. Для объёмов более нескольких GB или полноценных запросов SQL выбирайте NewSQL.
Использование etcd для метаданных
etcd реплицирует все данные в одной согласованной группе. Для нескольких GB с согласованным порядком это наиболее эффективно. Каждому изменению состояния кластера присваивается глобальный уникальный возрастающий идентификатор — ревизия. Поскольку группа репликации одна, для фиксации запрос проходит только протокол Raft. Один консенсус обеспечивает согласованность, низкую задержку и высокую пропускную способность при простом протоколе.
Репликация etcd не масштабируется горизонтально без шардирования. NewSQL обычно распределяет терабайты данных между несколькими согласованными группами. Чтобы назначить каждому изменению глобальный возрастающий ID, запрос проходит дополнительную координацию между группами. Возможные конфликты ID заставляют повторять упорядоченные запросы, усложняя систему и обычно снижая производительность строгого порядка относительно etcd.
Если приложение в основном работает с метаданными и их порядком для координации процессов, выбирайте etcd. Для крупного хранилища между несколькими ЦОД без сильной зависимости от глобального порядка выбирайте NewSQL.
Использование etcd для распределённой координации
etcd изначально предоставляет наблюдения, аренды, выборы и распределённые совместные блокировки. У блокировок есть неочевидные свойства, описанные ниже. Примитивы сопровождают разработчики etcd; перенос их во внешние библиотеки оставляет базовую распределённую систему неполной. В NewSQL их обычно реализуют третьи стороны, у ZooKeeper есть независимая библиотека рецептов, а Consul предупреждает, что его встроенный API блокировок — «не безупречный метод ».
Теоретически такие примитивы можно построить над любым строго согласованным хранилищем. Но алгоритмы тонки: кажущаяся рабочей блокировка внезапно ломается из-за эффекта лавины запросов и рассинхронизации времени. Другие примитивы, например транзакционная память, зависят от модели MVCC etcd; одной строгой согласованности недостаточно.
Для распределённой координации etcd снижает эксплуатационные риски и экономит инженерные усилия.
Примечания об использовании блокировок и аренд
etcd предоставляет API блокировок на основе механизма аренды и его реализации в etcd . Сервер выдаёт клиенту токен — аренду — с TTL и отзывает её после истечения времени. Пока клиент держит неотозванную аренду, он может заявлять владение связанным ресурсом; в etcd это ключ. Но сами API блокировок не обеспечивают взаимное исключение. Название lock сохранено по историческим причинам ; ниже показано, как API оптимизирует механизм взаимного исключения.
Главное свойство аренды: TTL — физический интервал времени, который сервер и клиент измеряют собственными часами. Поэтому сервер может отозвать аренду, пока клиент всё ещё считает себя владельцем.
Следовательно, сама аренда не гарантирует взаимное исключение, а владение арендой не гарантирует удержание блокировки ресурса.
Для ключей etcd взаимное исключение реализуется проверкой номера версии (в
других системах — compare-and-swap). В RPC Put и Txn задаются условия по
ревизии и идентификатору аренды. При невыполнении условий операция завершается
ошибкой. Клиент знает, что получил блокировку ключа, когда кластер etcd успешно
завершил его запрос.
Подобные схемы описаны в литературе:
- в статье о Chubby вводится sequencer, приблизительно соответствующий сочетанию ревизии и ID аренды etcd;
- в How to do distributed locking Martin Kleppmann вводит fencing token, которому в etcd соответствует ревизия;
- в Practical Uses of Synchronized Clocks in Distributed Systems описана распределённая блокировка Thor на проверке версии и аренде.
Аренды нужны даже при проверке версий, поскольку уменьшают число прерванных запросов.
Ключи etcd эффективно блокируются благодаря аренде и проверке версии. Внешние ресурсы должны сами предоставлять проверку версий и согласованность реплик, подобную ключам etcd. Блокировки etcd не могут непосредственно защищать внешние ресурсы.
12.9 - Глоссарий
Этот документ определяет различные термины, используемые в документации, командной строке и исходном коде etcd.
Аварийный сигнал
Сервер etcd подаёт аварийный сигнал, когда для сохранения надёжности кластера требуется вмешательство оператора.
Аутентификация
Аутентификация управляет правами доступа пользователей к ресурсам etcd.
Клиент
Клиент подключается к кластеру etcd и отправляет служебные запросы: получает пары «ключ — значение», записывает данные или наблюдает за обновлениями.
Кластер
Кластер состоит из нескольких участников.
Узел каждого участника следует протоколу консенсуса Raft для репликации журналов. Кластер получает предложения от участников, фиксирует их и применяет к локальному хранилищу.
Компактизация
Компактизация удаляет всю историю событий etcd и замещённые ключи до заданной ревизии. Она освобождает место в базе данных бэкенда etcd.
Выборы
В рамках протокола консенсуса Raft кластер etcd проводит выборы лидера среди своих участников.
Конечная точка
URL, указывающий на службу или ресурс etcd.
Ключ
Определяемый пользователем идентификатор для хранения и получения пользовательских значений в etcd.
Диапазон ключей
Набор ключей, содержащий отдельный ключ, лексический интервал всех x, для которых a < x <= b, либо все ключи больше заданного ключа.
Пространство ключей
Множество всех ключей в кластере etcd.
Аренда
Краткосрочный возобновляемый договор, который по истечении срока удаляет связанные с ним ключи.
Участник
Логический сервер etcd, участвующий в обслуживании кластера etcd.
Ревизия изменения
Первая ревизия, содержащая последнюю запись заданного ключа.
Одноранговый узел
Одноранговый узел — другой участник того же кластера.
Предложение
Предложение — это запрос, например на запись или изменение конфигурации, который должен пройти через протокол Raft.
Кворум
Количество активных участников, необходимое для достижения консенсуса при изменении состояния кластера. Для кворума etcd требуется большинство участников.
Ревизия
64-bit общий для кластера счётчик, который начинается с 1 и увеличивается при каждом изменении пространства ключей.
Роль
Набор прав для диапазонов ключей, который можно предоставить группе пользователей в целях контроля доступа.
Снимок
Резервная копия состояния кластера etcd на определённый момент времени.
Хранилище
Физическое хранилище, лежащее в основе пространства ключей кластера.
Срок
Срок — монотонно возрастающее целое число, связанное с каждыми выборами лидера в алгоритме Raft. В течение одного срока может быть выбран только один лидер; при смене лидера срок увеличивается.
Транзакция
Атомарно выполняемый набор операций. Все изменённые в транзакции ключи имеют одну и ту же ревизию изменения.
Версия ключа
Количество записей ключа с момента его создания, начиная с 1. Версия несуществующего или удалённого ключа равна 0.
Наблюдатель
Клиент открывает наблюдателя, чтобы отслеживать обновления в заданном диапазоне ключей.
13 - Руководство для разработчиков
13.1 - Протокол службы обнаружения
Протокол службы обнаружения помогает новому участнику etcd найти остальных участников на этапе начальной инициализации кластера с помощью общего URL обнаружения.
Протокол используется только при начальной инициализации и не подходит для реконфигурации во время выполнения или мониторинга кластера.
Один новый токен обнаружения предназначен для инициализации одного уникального кластера etcd. Один токен может представлять только один кластер. После запуска протокола для токена его нельзя использовать для инициализации другого кластера, даже если первый процесс завершился с ошибкой на полпути.
Далее процесс обнаружения рассматривается на примере самостоятельно размещённого кластера. Общедоступная служба discovery.etcd.io работает так же, но скрывает неудобные URL, автоматически создаёт UUID и защищает от чрезмерного количества запросов. В основе общедоступной службы всё равно лежит кластер etcd, используемый как описанное здесь хранилище данных.
Рабочий процесс протокола
Протокол использует внутренний кластер etcd для координации начальной инициализации нового кластера. Сначала все новые участники взаимодействуют со службой и совместно формируют ожидаемый список. Затем каждый участник запускает сервер с этим списком, что выполняет ту же функцию, что и флаг -initial-cluster.
В примере ниже каждый шаг для наглядности показан в формате curl.
По соглашению протокол обнаружения etcd использует префикс ключей _etcd/registry. Если кластер службы расположен на http://example.com, полный URL пространства ключей будет http://example.com/v2/keys/_etcd/registry. Этот URL используется в примерах как префикс.
Создание нового токена обнаружения
Создайте уникальный токен, идентифицирующий новый кластер. На следующих шагах он будет уникальным префиксом пространства ключей обнаружения. Простой способ создать токен — использовать uuidgen:
Указание ожидаемого размера кластера
Для токена необходимо указать размер кластера. Служба использует его, чтобы определить, когда найдены все участники, изначально формирующие кластер.
Обычно размер кластера равен 3, 5 или 7. Подробнее см. в разделе оптимального размера кластера .
Запуск процессов etcd
Передайте URL обнаружения флагу -discovery и запустите процессы etcd. При наличии флага -discovery каждый процесс автоматически выполняет следующие шаги.
Саморегистрация
Сначала процесс etcd регистрирует себя как участника по URL обнаружения. Для этого ID участника создаётся как ключ URL.
Проверка состояния
Процесс проверяет ожидаемый размер кластера и состояние регистрации по URL, а затем выбирает следующее действие.
Если зарегистрированных участников недостаточно, процесс ожидает появления остальных.
Если участников больше ожидаемого размера N, первые N принимаются за список кластера. Если текущий участник входит в список, процедура завершается успешно и получает из списка всех одноранговых участников. В противном случае она завершается ошибкой, сообщающей, что кластер заполнен.
В реализации etcd участник может проверить состояние кластера ещё до саморегистрации, поэтому при заполненном кластере отказ произойдёт быстро.
Ожидание всех участников
Процесс ожидания подробно описан в документации API etcd .
Он продолжает ожидать, пока не найдёт всех участников.
Общедоступная служба обнаружения
CoreOS Inc. размещает общедоступную службу на https://discovery.etcd.io/ с дополнительными удобствами.
Скрытие префикса ключа
Служба перенаправляет https://discovery.etcd.io/${UUID} к стоящему за ней кластеру etcd для ключа /v2/keys/_etcd/registry. Это скрывает префикс реестра и делает URL короче и понятнее.
Получение нового токена
Процесс создания следует шагам от создания нового токена до указания ожидаемого размера кластера .
Проверка состояния обнаружения
Состояние токена, включая зарегистрированные машины, можно проверить, запросив значение UUID.
Репозиторий с открытым исходным кодом
Репозиторий расположен по адресу https://github.com/coreos/discovery.etcd.io . На его основе можно создать собственную службу обнаружения.
13.2 - Настройка локального кластера
Для тестирования и разработки быстрее и проще всего настроить локальный кластер. Промышленное развёртывание описано в разделе кластеризации .
Локальный автономный кластер
Запуск кластера
Чтобы развернуть автономный кластер etcd, выполните:
Если бинарный файл etcd отсутствует в текущем рабочем каталоге, он может находиться в $GOPATH/bin/etcd или /usr/local/bin/etcd. Укажите правильный путь при запуске.
Работающий участник etcd принимает клиентские запросы на localhost:2379.
Взаимодействие с кластером
Используйте etcdctl для взаимодействия с работающим кластером:
Сохраните в кластере пример пары «ключ — значение»:
Вывод OK означает, что пара успешно сохранена.
Получите значение ключа
foo:Если возвращено
bar, взаимодействие с кластером etcd работает ожидаемым образом.
Локальный кластер из нескольких участников
Запуск кластера
В корне git-репозитория etcd находится Procfile, упрощающий настройку локального кластера из нескольких участников. Перейдите в корень дерева исходного кода etcd и выполните следующие действия:
Установите
goremanдля управления приложениями на основе Procfile:Запустите кластер через
goreman, используя штатный Procfile etcd:Участники запускаются и принимают клиентские запросы соответственно на
localhost:2379,localhost:22379иlocalhost:32379.
Взаимодействие с кластером
Используйте etcdctl для взаимодействия с работающим кластером:
Выведите список участников:
Список участников etcd выглядит следующим образом:
Сохраните в кластере пример пары «ключ — значение»:
Вывод OK означает, что пара успешно сохранена.
Проверка отказоустойчивости
Чтобы проверить отказоустойчивость etcd, остановите одного участника и попытайтесь получить ключ.
Определите имя процесса участника, которого нужно остановить.
Свойства кластера из нескольких участников перечислены в
Procfile. Для примера возьмём участника с именем процессаetcd2.Остановите участника:
Сохраните ключ:
Получите ключ, сохранённый на предыдущем шаге:
Получите ключ у остановленного участника:
Команда должна вывести ошибку из-за отсутствия соединения:
Перезапустите остановленного участника:
Получите ключ у перезапущенного участника:
После перезапуска участника соединение восстанавливается, и
etcdctlснова может успешно получить ключ. Дополнительные сведения приведены в разделе взаимодействия с etcd .
13.3 - Интеракция с etcd
Пользователи чаще всего взаимодействуют с etcd, устанавливая или получая значение ключа. В этом разделе описано, как это сделать с помощью etcdctl — командной строки для взаимодействия с сервером etcd. Концепции, описанные здесь, должны применимы к gRPC–API или API клиентской библиотеки.
Версию API 2 или 3, которую etcdctl использует для связи с etcd, задаёт
переменная окружения ETCDCTL_API. По умолчанию etcdctl из master (3.4)
использует API v3, а версии 3.3 и старше — API v2.
Примечание: любой ключ, созданный с использованием v2 API, не сможет быть запрослен через v3 API. Запрос v3 API etcdctl get ключа v2 завершится с кодом 0 и без данных ключа, это ожидаемое поведение.
Найти версии
etcdctl версия и версия сервера API могут быть полезны при определении подходящих команд для выполнения различных операций с etcd.
Здесь команда для поиска версий:
Запишите ключ
Приложения хранят ключи в кластере etcd, записывая их в ключи. Каждый сохраненный ключ реплицируется всем участникам кластера etcd через протокол Raft для достижения согласованности и надежности.
Команда задаёт ключу foo значение bar:
Также ключ можно установить на определенный период времени, привязав к нему аренду.
Здесь команда для установки значения ключа foo1 равным bar1 для 10s.
В команде выше идентификатор арены 1234abcd относится к идентификатору, возвращенному при создании арены длительности 10s. Этот идентификатор можно затем прикрепить к ключу.
Прочитать ключи
Приложения могут читать из кластера etcd один ключ или диапазон ключей.
Предположим, что кластер etcd содержит следующие ключи:
Команда читает значение ключа foo:
Команда читает значение ключа foo в шестнадцатеричном формате:
Команда выводит только значение ключа foo:
Команда читает диапазон ключей от foo до foo3:
foo3 исключается, так как диапазон является полуоткрытым интервалом [foo, foo3), исключающим foo3.
Команда читает все ключи с префиксом foo:
Здесь команда для обхода всех ключей, предшествующих foo, с ограничением количества результатов до 2:
Здесь команда для обхода всех ключей, предшествующих foo, с использованием RangeStream
RPC. Результат идентичен однократному Range:
--stream не поддерживает --order, --sort-by и фильтры ревизий.
Прочитать версию ключа в прошлом состоянии
Приложения могут захотеть прочитать устаревшие версии ключа. Например, приложение может захотеть откатиться к старой конфигурации, обратившись к более ранней версии ключа. Альтернативно, приложение может получить согласованное представление над несколькими ключами через несколько запросов, обратившись к истории ключа. Поскольку каждое изменение в кластере etcd ключ-значение увеличивает глобальную ревизию кластера etcd, приложение может прочитать устаревшие ключи, предоставив более старую ревизию etcd.
Предположим, что кластер etcd уже содержит следующие ключи:
Здесь пример, как получить доступ к прошлым версиям ключей:
Читать ключи, которые не меньше указанного ключа по байтовому значению
Приложения могут хотеть прочитать ключи, которые больше или равны байтовому значению указанного ключа.
Предположим, что кластер etcd уже содержит следующие ключи:
Команда читает ключи, байтовое значение которых не меньше ключа b:
Удалить ключи
Приложения могут удалить ключ или диапазон ключей из кластера etcd.
Предположим, что кластер etcd уже содержит следующие ключи:
Здесь команда для удаления ключа foo:
Здесь команда для удаления ключей от foo до foo9:
Команда удаляет zoo и возвращает удалённую пару «ключ — значение»:
Команда удаляет ключи с префиксом zoo:
Команда удаляет ключи, байтовое значение которых не меньше ключа b:
Наблюдение за изменениями ключа
Приложения могут наблюдать за ключом или диапазоном ключей для мониторинга любых обновлений.
Здесь команда для наблюдения за ключом foo:
Команда наблюдает за ключом foo в шестнадцатеричном формате:
Здесь команда для наблюдения за диапазоном ключей от foo до foo9:
Здесь команда для наблюдения за ключами с префиксом foo:
Команда наблюдает за несколькими ключами foo и zoo:
Наблюдение за историческими изменениями ключей
Программы могут хотеть наблюдать за историческими изменениями ключей в etcd. Например, программа может желать получать все модификации ключа; если программа останется подключена к etcd, то watch будет достаточно. Однако, если программа или etcd сбоит, изменение может произойти во время сбоя, и программа не получит обновление в реальном времени. Чтобы гарантировать доставку обновления, программа должна быть способна наблюдать за историческими изменениями ключей. Для этого программа может указать историческую ревизию при наблюдении, как при чтении прошлых версий ключей.
Предположим, что мы завершили следующую последовательность операций:
Здесь пример наблюдения за историческими изменениями:
Здесь пример наблюдения только с последней исторической измененной точки:
Наблюдение за прогрессом
Приложение может проверять ход наблюдения, чтобы определить актуальность потока. Например, при обновлении кэша полезно знать, не устарел ли он относительно ревизии, полученной чтением по кворуму.
Запросы прогресса можно отправлять с помощью команды “progress” в интерактивном сеансе наблюдения, чтобы попросить сервер etcd отправлять уведомление о прогрессе в потоке наблюдения:
Номер ревизии в ответе на уведомление о прогрессе — это номер ревизии локального узла сервера etcd, к которому подключено наблюдение. Если этот узел отсечен и не является частью кворума, то этот номер ревизии уведомления о прогрессе может быть ниже номера ревизии, возвращаемого чтением кворума на непрерывном узле сервера etcd.
Компактированные ревизии
Как мы уже упоминали, etcd хранит ревизии, чтобы приложения могли читать прошлые версии ключей. Однако для того чтобы избежать накопления неограниченного количества истории, важно проводить компактацию прошлых ревизий. После компактации etcd удаляет исторические ревизии, освобождая ресурсы для будущего использования. Все превышенные данные с ревизиями, предшествующими компактированной ревизии, станут недоступны.
Здесь команда для компактного хранения ревизий:
Текущая ревизия сервера etcd можно найти с помощью команды get для любого ключа (существующего или несуществующего) в формате json. Пример показан ниже для ключа mykey, который не существует на сервере etcd:
Выдать аренду
Приложения могут выдавать аренды для ключей из кластера etcd. Когда ключ прикреплен к аренде, его срок жизни связан с сроком жизни аренды, который в свою очередь регулируется временем жизни (TTL). Каждая аренда имеет минимальное значение времени жизни (TTL), указанное приложением при выдаче. Фактическое значение TTL арены составляет не менее минимального TTL и выбирается кластером etcd. После истечения срока жизни TTL арены она истекает и все прикрепленные ключи удаляются.
Команда выдаёт аренду:
Отменить аренду
Приложения отменяют аренды по идентификатору арены. Отмена арены удаляет все связанные с ней ключи.
Предположим, что мы завершили следующую последовательность операций:
Команда отзывает ту же аренду:
Сохраняйте аренду активной
Приложения могут поддерживать аренду активной обновлением её TTL, чтобы она не истекла.
Предположим, что мы завершили следующую последовательность операций:
Команда поддерживает ту же аренду активной:
Получить информацию об аренде
Приложения могут заинтересоваться информацией об арендах, чтобы их можно было продлить или проверить, существует ли аренда и не истек ли срок её действия. Приложения также могут заинтересоваться ключами, к которым прикреплена определённая аренда.
Предположим, что мы завершили следующую последовательность операций:
Команда получает сведения об аренде:
Команда получает сведения об аренде вместе с привязанными ключами:
13.4 - Зачем нужен шлюз gRPC
etcd v3 использует gRPC как протокол обмена сообщениями. Проект etcd включает основанный на gRPC клиент Go и утилиту командной строки etcdctl для взаимодействия с кластером etcd через gRPC. Для языков без поддержки gRPC etcd предоставляет JSON-шлюз gRPC . Он служит RESTful-прокси, преобразующим запросы HTTP/JSON в сообщения gRPC.
Использование шлюза gRPC
Шлюз принимает JSON-сопоставление
определений сообщений
protocol buffer
etcd. Поля key и value определены как массивы
байтов, поэтому в JSON их обязательно кодировать в base64. В следующих примерах
используется curl, но подойдёт любой клиент HTTP/JSON.
Примечания
Конечная точка шлюза gRPC менялась начиная с etcd v3.3:
- etcd v3.2 и более ранние версии используют только
[CLIENT-URL]/v3alpha/*. - etcd v3.3 использует
[CLIENT-URL]/v3beta/*, сохраняя[CLIENT-URL]/v3alpha/*. - etcd v3.4 использует
[CLIENT-URL]/v3/*, сохраняя[CLIENT-URL]/v3beta/*.[CLIENT-URL]/v3alpha/*устарел.
- etcd v3.5 и более поздние версии используют только
[CLIENT-URL]/v3/*.[CLIENT-URL]/v3beta/*устарел.
gRPC-gateway не поддерживает аутентификацию по Common Name сертификата TLS.
Запись и получение ключей
Для чтения и записи ключей используйте службы /v3/kv/range и /v3/kv/put:
Наблюдение за ключами
Для наблюдения за ключами используйте службу /v3/watch:
Транзакции
Выполните транзакцию через /v3/kv/txn:
Аутентификация
Настройте аутентификацию с помощью службы /v3/auth:
Получите токен аутентификации etcd через /v3/auth/authenticate:
Чтобы получить ключ с учётными данными аутентификации, задайте токен в заголовке Authorization:
Ответы об ошибках
Шлюз gRPC преобразует статус gRPC в код состояния HTTP и тело ошибки JSON.
Начиная с etcd v3.6, обновление до grpc-gateway v2 изменило обработку ошибок
(см. примечание об обработке ошибок
в руководстве по
миграции на v2), и теперь поведение шлюза соответствует google.rpc.Status
(code, message, details), как описано в модели ошибок API Google
.
В старых версиях grpc-gateway также присутствовало поле верхнего уровня error,
но etcd v3.6 и более новые версии его не поддерживают.
Клиентам следует считать код состояния HTTP главным признаком успеха или ошибки.
При ошибке запроса основным источником сведений должно быть поле message, а
дополнительные данные следует использовать как контекст.
Swagger
Сгенерированные определения API Swagger находятся в rpc.swagger.json .
13.5 - Именование и обнаружение gRPC
etcd предоставляет резолвер gRPC для альтернативной системы имён, которая получает конечные точки из etcd при обнаружении служб gRPC. Механизм основан на наблюдении за обновлениями ключей с префиксом имени службы.
Эта возможность является экспериментальной, поскольку зависит от пакета google.golang.org/grpc/resolver , который всё ещё считается экспериментальным в grpc-go.
Использование обнаружения etcd с go-grpc
Клиент etcd предоставляет резолвер gRPC для разрешения конечных точек gRPC с бэкендом etcd. Резолвер инициализируется клиентом etcd:
Управление конечными точками службы
Резолвер etcd рассматривает как потенциальные конечные точки службы все ключи под префиксом целевого имени с завершающим “/” (например, “foo/bar/my-service/”), значения которых закодированы в JSON (исторически — go-grpc naming.Update).
Конечные точки добавляются созданием новых ключей и удаляются удалением ключей.
Добавление конечной точки
Новые конечные точки можно добавить в службу с помощью etcdctl:
Метод endpoints.Manager клиента etcd также может зарегистрировать новую конечную точку с ключом, соответствующим Addr:
Чтобы включить циклическую балансировку нагрузки при подключении к службе с несколькими конечными точками, настройте соединение с внутренним циклическим балансировщиком gRPC:
Удаление конечной точки
Узлы можно удалить из службы с помощью etcdctl:
Метод endpoints.Manager клиента etcd также поддерживает удаление конечных точек:
Регистрация конечной точки с арендой
Регистрация конечной точки с арендой гарантирует её удаление из службы, если узел не сможет поддерживать heartbeat keepalive, например из-за отказа машины:
В Golang:
Атомарное обновление конечных точек
Чтобы изменить несколько конечных точек в одной транзакции, можно напрямую использовать endpoints.Manager:
13.6 - Встраивание etcd в Go-приложение
embed go для запуска сервера etcd внутри вашей приложенияПакет go etcd embed предоставляет простой способ встраивания сервера etcd непосредственно в ваше приложение.
Дополнительные сведения см. в документации пакета embed .
13.7 - Ограничения системы
Ограничение размера запроса
etcd разработан для обработки небольших пар ключ-значение, характерных для метаданных. Более крупные запросы будут работать, но могут увеличить задержку других запросов. По умолчанию максимальный размер любого запроса составляет 1.5 MiB. Этот лимит можно настроить с помощью флага --max-request-bytes для сервера etcd.
Ограничение размера хранилища
По умолчанию ограничение размера хранилища составляет 2 GiB, настраивается с помощью флага --quota-backend-bytes. 8 GiB — рекомендуемый максимальный размер для обычных сред, etcd выдает предупреждение при запуске, если сконфигурированное значение превышает его.
13.8 - Возможности etcd
В этом документе представлен обзор возможностей etcd, помогающий понять их назначение и связанный с ними процесс устаревания. Порядок разработки возможностей etcd описан в рекомендациях для разработчиков .
Возможности etcd проходят три стадии: экспериментальную, стабильную и небезопасную. Получить их список можно командой etcd --help.
Экспериментальные
Чтобы получить обратную связь на раннем этапе, новые возможности обычно добавляются как экспериментальные. Их можно определить по имени флага с префиксом --experimental. При использовании экспериментальной возможности учитывайте следующее:
- Из-за недостаточного пользовательского тестирования она может содержать ошибки и работать не так, как ожидается.
- По умолчанию она отключена.
- Её поддержка может быть прекращена в любой момент без уведомления.
- Возможность может быть удалена в следующем минорном или мажорном выпуске без соблюдения политики устаревания возможностей , если она не перейдёт в стабильную стадию.
- Команда проекта приветствует сообщения о проблемах с экспериментальными возможностями, однако такие проблемы могут иметь более низкий приоритет, чем проблемы стабильных возможностей.
- Экспериментальный флаг возможности устаревает при переходе в стабильную стадию. Следует как можно раньше перейти на стабильный флаг.
Стабильные
Это наиболее распространённая стадия возможностей etcd. Стабильная возможность обладает следующими свойствами:
- Поддерживается в составе поддерживаемых выпусков etcd.
- Может быть включена по умолчанию.
- Прекращение поддержки должно соответствовать политике устаревания возможностей .
Небезопасные
Небезопасные возможности встречаются редко и перечисляются в разделе Unsafe feature: документации по использованию etcd. По умолчанию они отключены. Используйте их с осторожностью и в соответствии с документацией. Небезопасная возможность может быть удалена в следующем минорном или мажорном выпуске без соблюдения политики устаревания.
Устаревание возможностей
Экспериментальные
Экспериментальная возможность устаревает при переходе в стабильную стадию.
- В документации экспериментальной возможности появляется сообщение об устаревании с рекомендацией использовать соответствующий стабильный флаг, например
DEPRECATED. Use <feature-name> instead. - Устаревшая возможность удаляется в следующем выпуске.
Стабильные
По мере развития проекта стабильную возможность иногда приходится объявлять устаревшей и удалять. В таком случае:
- До запланированного выпуска с объявлением об устаревании в документации появляется предупреждение, например
To be deprecated in <release>.. Если уже запланирована замена возможности, помеченнойTo be deprecated, документация также указывает её, напримерUse <feature-name> instead.. - В запланированном выпуске возможность объявляется устаревшей. В документации появляется соответствующее сообщение с рекомендацией использовать связанную стабильную возможность, например
DEPRECATED. Use <feature-name> instead. - Устаревшая возможность удаляется в следующем выпуске.
13.9 - Справочник API
Этот справочник API автоматически создан из указанных файлов .proto.
Служба Auth (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| AuthEnable | AuthEnableRequest | AuthEnableResponse | AuthEnable включает аутентификацию. |
| AuthDisable | AuthDisableRequest | AuthDisableResponse | AuthDisable отключает аутентификацию. |
| AuthStatus | AuthStatusRequest | AuthStatusResponse | AuthStatus отображает состояние аутентификации. |
| Authenticate | AuthenticateRequest | AuthenticateResponse | Authenticate обрабатывает запрос аутентификации. |
| UserAdd | AuthUserAddRequest | AuthUserAddResponse | UserAdd добавляет нового пользователя. Имя пользователя не может быть пустым. |
| UserGet | AuthUserGetRequest | AuthUserGetResponse | UserGet получает подробные сведения о пользователе. |
| UserList | AuthUserListRequest | AuthUserListResponse | UserList получает список всех пользователей. |
| UserDelete | AuthUserDeleteRequest | AuthUserDeleteResponse | UserDelete удаляет указанного пользователя. |
| UserChangePassword | AuthUserChangePasswordRequest | AuthUserChangePasswordResponse | UserChangePassword изменяет пароль указанного пользователя. |
| UserGrantRole | AuthUserGrantRoleRequest | AuthUserGrantRoleResponse | UserGrant предоставляет указанному пользователю роль. |
| UserRevokeRole | AuthUserRevokeRoleRequest | AuthUserRevokeRoleResponse | UserRevokeRole отзывает роль указанного пользователя. |
| RoleAdd | AuthRoleAddRequest | AuthRoleAddResponse | RoleAdd добавляет новую роль. Имя роли не может быть пустым. |
| RoleGet | AuthRoleGetRequest | AuthRoleGetResponse | RoleGet получает подробные сведения о роли. |
| RoleList | AuthRoleListRequest | AuthRoleListResponse | RoleList получает список всех ролей. |
| RoleDelete | AuthRoleDeleteRequest | AuthRoleDeleteResponse | RoleDelete удаляет указанную роль. |
| RoleGrantPermission | AuthRoleGrantPermissionRequest | AuthRoleGrantPermissionResponse | RoleGrantPermission предоставляет указанной роли разрешение на заданный ключ или диапазон. |
| RoleRevokePermission | AuthRoleRevokePermissionRequest | AuthRoleRevokePermissionResponse | RoleRevokePermission отзывает у указанной роли разрешение на ключ или диапазон. |
Служба Cluster (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| MemberAdd | MemberAddRequest | MemberAddResponse | MemberAdd добавляет участника в кластер. |
| MemberRemove | MemberRemoveRequest | MemberRemoveResponse | MemberRemove удаляет существующего участника из кластера. |
| MemberUpdate | MemberUpdateRequest | MemberUpdateResponse | MemberUpdate обновляет конфигурацию участника. |
| MemberList | MemberListRequest | MemberListResponse | MemberList перечисляет всех участников кластера. |
| MemberPromote | MemberPromoteRequest | MemberPromoteResponse | MemberPromote повышает обучающегося участника raft без права голоса до участника raft с правом голоса. |
Служба KV (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| Range | RangeRequest | RangeResponse | Range получает ключи диапазона из хранилища ключей и значений. |
| Put | PutRequest | PutResponse | Put помещает заданный ключ в хранилище ключей и значений. Запрос put увеличивает ревизию хранилища и создаёт одно событие в истории событий. |
| DeleteRange | DeleteRangeRequest | DeleteRangeResponse | DeleteRange удаляет заданный диапазон из хранилища ключей и значений. Запрос удаления увеличивает ревизию хранилища и создаёт событие удаления в истории для каждого удалённого ключа. |
| Txn | TxnRequest | TxnResponse | Txn обрабатывает несколько запросов в одной транзакции. Запрос txn увеличивает ревизию хранилища ключей и значений и создаёт события с одной ревизией для каждого выполненного запроса. Многократное изменение одного ключа в одной txn недопустимо. |
| Compact | CompactionRequest | CompactionResponse | Compact компактизирует историю событий в хранилище ключей и значений etcd. Хранилище следует периодически компактизировать, иначе история событий будет расти бесконечно. |
Служба Lease (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| LeaseGrant | LeaseGrantRequest | LeaseGrantResponse | LeaseGrant создаёт аренду, которая истекает, если сервер не получает keepAlive в течение заданного срока жизни. При истечении аренды все присоединённые к ней ключи истекают и удаляются. Каждый истёкший ключ создаёт событие удаления в истории событий. |
| LeaseRevoke | LeaseRevokeRequest | LeaseRevokeResponse | LeaseRevoke отзывает аренду. Все присоединённые к ней ключи истекают и удаляются. |
| LeaseKeepAlive | LeaseKeepAliveRequest | LeaseKeepAliveResponse | LeaseKeepAlive поддерживает аренду активной, передавая потоком запросы поддержания активности от клиента серверу и ответы от сервера клиенту. |
| LeaseTimeToLive | LeaseTimeToLiveRequest | LeaseTimeToLiveResponse | LeaseTimeToLive получает сведения об аренде. |
| LeaseLeases | LeaseLeasesRequest | LeaseLeasesResponse | LeaseLeases перечисляет все существующие аренды. |
Служба Maintenance (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| Alarm | AlarmRequest | AlarmResponse | Alarm активирует, деактивирует и запрашивает аварийные сигналы о состоянии кластера. |
| Status | StatusRequest | StatusResponse | Status получает состояние участника. |
| Defragment | DefragmentRequest | DefragmentResponse | Defragment дефрагментирует базу данных бэкенда участника для освобождения места. |
| Hash | HashRequest | HashResponse | Hash вычисляет хеш всего пространства ключей бэкенда, включая сегменты key, lease и другие сегменты хранилища. Предназначено ТОЛЬКО для тестирования! Не полагайтесь на операцию в рабочей среде с текущими транзакциями, поскольку Hash не удерживает блокировки MVCC. Для проверки согласованности сегмента “key” используйте API “HashKV”. |
| HashKV | HashKVRequest | HashKVResponse | HashKV вычисляет хеш всех ключей MVCC до заданной ревизии. Перебирает только сегмент “key” в хранилище бэкенда. |
| Snapshot | SnapshotRequest | SnapshotResponse | Snapshot передаёт снимок всего бэкенда от участника клиенту потоком. |
| MoveLeader | MoveLeaderRequest | MoveLeaderResponse | MoveLeader запрашивает у текущего узла-лидера передачу лидерства назначенному узлу. |
| Downgrade | DowngradeRequest | DowngradeResponse | Downgrade запрашивает понижение версии, проверяет его допустимость или отменяет его для версии кластера. Поддерживается начиная с etcd 3.5. |
Служба Watch (api/etcdserverpb/rpc.proto)
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| Watch | WatchRequest | WatchResponse | Watch наблюдает за происходящими или уже произошедшими событиями. Ввод и вывод являются потоками: входной поток создаёт и отменяет наблюдателей, выходной отправляет события. Один RPC watch может наблюдать несколько диапазонов ключей и одновременно передавать события нескольких наблюдений. Всю историю событий можно наблюдать с последней ревизии компактизации. |
Сообщение AlarmMember (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| memberID | memberID — идентификатор участника, связанного с активированным аварийным сигналом. | uint64 |
| alarm | alarm — тип активированного аварийного сигнала. | AlarmType |
Сообщение AlarmRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action — тип отправляемого запроса аварийного сигнала. Действие может GET состояния сигналов, ACTIVATE сигнал или DEACTIVATE активированный сигнал. | AlarmAction |
| memberID | memberID — идентификатор участника, связанного с сигналом. Если memberID равен 0, запрос относится ко всем участникам. | uint64 |
| alarm | alarm — тип аварийного сигнала, рассматриваемого запросом. | AlarmType |
Сообщение AlarmResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| alarms | alarms — список аварийных сигналов, связанных с запросом. | (slice of) AlarmMember |
Сообщение AuthDisableRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение AuthDisableResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthEnableRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение AuthEnableResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthRoleAddRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name — имя роли, добавляемой в систему аутентификации. | string |
Сообщение AuthRoleAddResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthRoleDeleteRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
Сообщение AuthRoleDeleteResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthRoleGetRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
Сообщение AuthRoleGetResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | ResponseHeader | |
| perm | (slice of) authpb.Permission |
Сообщение AuthRoleGrantPermissionRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name — имя роли, которой будет предоставлено разрешение. | string |
| perm | perm — разрешение, предоставляемое роли. | authpb.Permission |
Сообщение AuthRoleGrantPermissionResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthRoleListRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение AuthRoleListResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
Сообщение AuthRoleRevokePermissionRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string | |
| key | bytes | |
| range_end | bytes |
Сообщение AuthRoleRevokePermissionResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthStatusRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение AuthStatusResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| enabled | bool | |
| authRevision | authRevision — текущая ревизия хранилища аутентификации | uint64 |
Сообщение AuthUserAddRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string | |
| options | authpb.UserAddOptions | |
| hashedPassword | string |
Сообщение AuthUserAddResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthUserChangePasswordRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name — имя пользователя, пароль которого изменяется. | string |
| password | password — новый пароль пользователя. Обратите внимание: это поле будет удалено на уровне API. | string |
| hashedPassword | hashedPassword — новый пароль пользователя. Обратите внимание: это поле будет инициализировано на уровне API. | string |
Сообщение AuthUserChangePasswordResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthUserDeleteRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name — имя удаляемого пользователя. | string |
Сообщение AuthUserDeleteResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthUserGetRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string |
Сообщение AuthUserGetResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
Сообщение AuthUserGrantRoleRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| user | user — имя пользователя, которому следует предоставить указанную роль. | string |
| role | role — имя роли, предоставляемой пользователю. | string |
Сообщение AuthUserGrantRoleResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthUserListRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение AuthUserListResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| users | (slice of) string |
Сообщение AuthUserRevokeRoleRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| role | string |
Сообщение AuthUserRevokeRoleResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение AuthenticateRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string |
Сообщение AuthenticateResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| token | token — авторизованный токен, который можно использовать в последующих RPC | string |
Сообщение CompactionRequest (api/etcdserverpb/rpc.proto)
CompactionRequest компактизирует хранилище ключей и значений до заданной ревизии. Все замещённые ключи с ревизией меньше ревизии компактизации удаляются.
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revision — ревизия хранилища ключей и значений для операции компактизации. | int64 |
| physical | physical задаётся, чтобы RPC дождался физического применения компактизации к локальной базе данных и полного удаления компактизированных записей из базы данных бэкенда. | bool |
Сообщение CompactionResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение Compare (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| result | result — логическая операция данного сравнения. | CompareResult |
| target | target — поле пары «ключ — значение», проверяемое при сравнении. | CompareTarget |
| key | key — целевой ключ операции сравнения. | bytes |
| target_union | oneof | |
| version | version — версия заданного ключа | int64 |
| create_revision | create_revision — ревизия создания заданного ключа | int64 |
| mod_revision | mod_revision — ревизия последнего изменения заданного ключа. | int64 |
| value | value — значение заданного ключа в байтах. | bytes |
| lease | lease — идентификатор аренды заданного ключа. | int64 |
| range_end | range_end сравнивает заданную цель со всеми ключами диапазона [key, range_end). Подробнее о диапазонах ключей см. RangeRequest. | bytes |
Сообщение DefragmentRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение DefragmentResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение DeleteRangeRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key — первый удаляемый ключ диапазона. | bytes |
| range_end | range_end — ключ, следующий за последним удаляемым ключом диапазона [key, range_end). Если range_end не задан, диапазон содержит только аргумент key. Если range_end на один бит больше заданного ключа, диапазон содержит все ключи с префиксом заданного ключа. Если range_end равен ‘\0’, диапазон содержит все ключи, большие либо равные аргументу key. | bytes |
| prev_kv | Если prev_kv задан, etcd получает предыдущие пары «ключ — значение» перед удалением. Они возвращаются в ответе удаления. | bool |
Сообщение DeleteRangeResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| deleted | deleted — количество ключей, удалённых запросом удаления диапазона. | int64 |
| prev_kvs | если в запросе задан prev_kv, возвращаются предыдущие пары «ключ — значение». | (slice of) mvccpb.KeyValue |
Сообщение DowngradeInfo (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| enabled | enabled указывает, включено ли понижение версии кластера. | bool |
| targetVersion | targetVersion — целевая версия понижения. | string |
Сообщение DowngradeRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action — тип отправляемого запроса понижения версии. Действие может VALIDATE целевую версию, DOWNGRADE версию кластера или CANCEL текущую задачу понижения. | DowngradeAction |
| version | version — целевая версия понижения. | string |
Сообщение DowngradeResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version — текущая версия кластера. | string |
Сообщение DowngradeVersionTestRequest (api/etcdserverpb/rpc.proto)
DowngradeVersionTestRequest используется только для тестирования. Версия в запросе читается как версия записи WAL. Если целевая версия понижения меньше этой версии, понижение (online) или миграция (offline) небезопасны и не должны разрешаться.
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ver | string |
Сообщение HashKVRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revision — ревизия хранилища ключей и значений для операции хеширования. | int64 |
Сообщение HashKVResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash — значение хеша, вычисленное по ключам MVCC отвечающего участника до заданной ревизии. | uint32 |
| compact_revision | compact_revision — компактизированная ревизия хранилища ключей и значений в момент начала хеширования. | int64 |
| hash_revision | hash_revision — ревизия, до которой вычислен хеш. | int64 |
Сообщение HashRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение HashResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash — значение хеша, вычисленное по бэкенду KV отвечающего участника. | uint32 |
Сообщение LeaseCheckpoint (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор аренды для контрольной точки. | int64 |
| remaining_TTL | Remaining_TTL — время, оставшееся до истечения аренды. | int64 |
Сообщение LeaseCheckpointRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| checkpoints | (slice of) LeaseCheckpoint |
Сообщение LeaseCheckpointResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение LeaseGrantRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| TTL | TTL — рекомендуемый срок жизни в секундах. Истёкшая аренда возвращает -1. | int64 |
| ID | ID — запрошенный идентификатор аренды. Если ID равен 0, арендодатель выбирает идентификатор. | int64 |
Сообщение LeaseGrantResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID — идентификатор выданной аренды. | int64 |
| TTL | TTL — выбранный сервером срок жизни аренды в секундах. | int64 |
| error | string |
Сообщение LeaseKeepAliveRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор аренды, активность которой поддерживается. | int64 |
Сообщение LeaseKeepAliveResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID — идентификатор аренды из запроса поддержания активности. | int64 |
| TTL | TTL — новый срок жизни аренды. | int64 |
Сообщение LeaseLeasesRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение LeaseLeasesResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| leases | (slice of) LeaseStatus |
Сообщение LeaseRevokeRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор отзываемой аренды. При отзыве ID все связанные ключи удаляются. | int64 |
Сообщение LeaseRevokeResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение LeaseStatus (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | int64 |
Сообщение LeaseTimeToLiveRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор аренды. | int64 |
| keys | keys равно true для запроса всех ключей, присоединённых к этой аренде. | bool |
Сообщение LeaseTimeToLiveResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID — идентификатор аренды из запроса поддержания активности. | int64 |
| TTL | TTL — оставшийся срок жизни аренды в секундах; аренда истечёт менее чем через TTL+1 секунд. | int64 |
| grantedTTL | GrantedTTL — исходный выданный срок в секундах при создании или обновлении аренды. | int64 |
| keys | Keys — список ключей, присоединённых к аренде. | (slice of) bytes |
Сообщение Member (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор этого участника. | uint64 |
| name | name — понятное человеку имя участника. Если участник не запущен, имя является пустой строкой. | string |
| peerURLs | peerURLs — список URL, которые участник предоставляет кластеру для связи. | (slice of) string |
| clientURLs | clientURLs — список URL, которые участник предоставляет клиентам для связи. Если участник не запущен, clientURLs пуст. | (slice of) string |
| isLearner | isLearner указывает, является ли участник обучающимся участником raft. | bool |
Сообщение MemberAddRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| peerURLs | peerURLs — список URL, которые добавленный участник использует для связи с кластером. | (slice of) string |
| isLearner | isLearner указывает, является ли добавленный участник обучающимся участником raft. | bool |
Сообщение MemberAddResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| member | member — сведения о добавленном участнике. | Member |
| members | members — список всех участников после добавления нового. | (slice of) Member |
Сообщение MemberListRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| linearizable | bool |
Сообщение MemberListResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members — список всех участников, связанных с кластером. | (slice of) Member |
Сообщение MemberPromoteRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор повышаемого участника. | uint64 |
Сообщение MemberPromoteResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members — список всех участников после повышения участника. | (slice of) Member |
Сообщение MemberRemoveRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор удаляемого участника. | uint64 |
Сообщение MemberRemoveResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members — список всех участников после удаления участника. | (slice of) Member |
Сообщение MemberUpdateRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID — идентификатор обновляемого участника. | uint64 |
| peerURLs | peerURLs — новый список URL, которые участник использует для связи с кластером. | (slice of) string |
Сообщение MemberUpdateResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members — список всех участников после обновления участника. | (slice of) Member |
Сообщение MoveLeaderRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| targetID | targetID — идентификатор узла нового лидера. | uint64 |
Сообщение MoveLeaderResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Сообщение PutRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key — ключ в байтах, помещаемый в хранилище ключей и значений. | bytes |
| value | value — значение в байтах, связываемое с ключом в хранилище. | bytes |
| lease | lease — идентификатор аренды, связываемой с ключом. Значение аренды 0 означает отсутствие аренды. | int64 |
| prev_kv | Если prev_kv задан, etcd получает предыдущую пару «ключ — значение» перед её изменением. Она возвращается в ответе put. | bool |
| ignore_value | Если ignore_value задан, etcd обновляет ключ с его текущим значением. Если ключ не существует, возвращается ошибка. | bool |
| ignore_lease | Если ignore_lease задан, etcd обновляет ключ с его текущей арендой. Если ключ не существует, возвращается ошибка. | bool |
Сообщение PutResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| prev_kv | если в запросе задан prev_kv, возвращается предыдущая пара «ключ — значение». | mvccpb.KeyValue |
Сообщение RangeRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key — первый ключ диапазона. Если range_end не задан, запрос ищет только key. | bytes |
| range_end | range_end — верхняя граница запрошенного диапазона [key, range_end). Если range_end равен ‘\0’, диапазон содержит все ключи >= key. Если range_end равен key плюс один (например, “aa”+1 == “ab”, “a\xff”+1 == “b”), запрос получает все ключи с префиксом key. Если и key, и range_end равны ‘\0’, запрос возвращает все ключи. | bytes |
| limit | limit — ограничение количества ключей, возвращаемых запросом. Значение limit 0 означает отсутствие ограничения. | int64 |
| revision | revision — момент состояния хранилища ключей и значений для диапазона. Если revision меньше или равна нулю, диапазон относится к новейшему состоянию хранилища. Если ревизия компактизирована, возвращается ErrCompacted. | int64 |
| sort_order | sort_order — порядок возвращаемых отсортированных результатов. | SortOrder |
| sort_target | sort_target — поле пары «ключ — значение» для сортировки. | SortTarget |
| serializable | serializable задаёт использование сериализуемого локального чтения с участника для диапазонного запроса. По умолчанию запросы Range линеаризуемы; их задержка выше, а пропускная способность ниже, чем у сериализуемых запросов, зато они отражают текущий консенсус кластера. Ради повышения производительности ценой возможного чтения устаревших данных сериализуемый запрос обслуживается локально без достижения консенсуса с другими узлами. | bool |
| keys_only | если keys_only задан, возвращаются только ключи без значений. | bool |
| count_only | если count_only задан, возвращается только количество ключей в диапазоне. | bool |
| min_mod_revision | min_mod_revision — нижняя граница возвращаемых ревизий изменения ключей; ключи с меньшими ревизиями отфильтровываются. | int64 |
| max_mod_revision | max_mod_revision — верхняя граница возвращаемых ревизий изменения ключей; ключи с большими ревизиями отфильтровываются. | int64 |
| min_create_revision | min_create_revision — нижняя граница возвращаемых ревизий создания ключей; ключи с меньшими ревизиями отфильтровываются. | int64 |
| max_create_revision | max_create_revision — верхняя граница возвращаемых ревизий создания ключей; ключи с большими ревизиями отфильтровываются. | int64 |
Сообщение RangeResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| kvs | kvs — список пар «ключ — значение», соответствующих диапазонному запросу. При запросе count поле kvs пусто. | (slice of) mvccpb.KeyValue |
| more | more указывает, остались ли в запрошенном диапазоне ключи для возврата. | bool |
| count | при запросе count содержит фактическое количество ключей в диапазоне. В отличие от Kvs, оно не зависит от ограничений и фильтров (например, Min/Max, Create/Modify, Revisions) и отражает полное количество в указанном диапазоне. | int64 |
Сообщение RequestOp (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request | request — объединение типов запросов, принимаемых транзакцией. | oneof |
| request_range | RangeRequest | |
| request_put | PutRequest | |
| request_delete_range | DeleteRangeRequest | |
| request_txn | TxnRequest |
Сообщение ResponseHeader (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| cluster_id | cluster_id — идентификатор кластера, отправившего ответ. | uint64 |
| member_id | member_id — идентификатор участника, отправившего ответ. | uint64 |
| revision | revision — ревизия хранилища ключей и значений при применении запроса; для вызовов, не взаимодействующих с хранилищем, она не задана (то есть равна 0). В ответах о ходе наблюдения header.revision обозначает прогресс. Все последующие события в этом потоке гарантированно имеют номер ревизии выше номера header.revision. | int64 |
| raft_term | raft_term — срок полномочий raft при применении запроса. | uint64 |
Сообщение ResponseOp (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| response | response — объединение типов ответов, возвращаемых транзакцией. | oneof |
| response_range | RangeResponse | |
| response_put | PutResponse | |
| response_delete_range | DeleteRangeResponse | |
| response_txn | TxnResponse |
Сообщение SnapshotRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение SnapshotResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | header содержит текущие сведения о хранилище ключей и значений. Первый заголовок в потоке снимка указывает момент времени снимка. | ResponseHeader |
| remaining_bytes | remaining_bytes — количество байтов blob, отправляемых после этого сообщения | uint64 |
| blob | blob содержит следующий фрагмент снимка в потоке снимка. | bytes |
| version | локальная версия сервера, создавшего снимок. В кластере с двоичными файлами разных версий каждый участник может возвращать иной результат. Указывает, какую версию сервера etcd следует использовать при восстановлении снимка. | string |
Сообщение StatusRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение StatusResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version — версия протокола кластера, используемая отвечающим участником. | string |
| dbSize | dbSize — физически выделенный размер базы данных бэкенда отвечающего участника в байтах. | int64 |
| leader | leader — идентификатор участника, которого отвечающий участник считает текущим лидером. | uint64 |
| raftIndex | raftIndex — текущий зафиксированный индекс raft отвечающего участника. | uint64 |
| raftTerm | raftTerm — текущий срок полномочий raft отвечающего участника. | uint64 |
| raftAppliedIndex | raftAppliedIndex — текущий применённый индекс raft отвечающего участника. | uint64 |
| errors | errors содержит сведения об аварийных сигналах, работоспособности и состоянии. | (slice of) string |
| dbSizeInUse | dbSizeInUse — логически используемый размер базы данных бэкенда отвечающего участника в байтах. | int64 |
| isLearner | isLearner указывает, является ли участник обучающимся участником raft. | bool |
| storageVersion | storageVersion — версия файла БД. Она может обновляться с задержкой относительно целевой версии кластера. | string |
| dbSizeQuota | dbSizeQuota — настроенная квота хранилища etcd в байтах (значение, переданное экземпляру etcd флагом –quota-backend-bytes) | int64 |
| downgradeInfo | downgradeInfo указывает на наличие процесса понижения версии. | DowngradeInfo |
Сообщение TxnRequest (api/etcdserverpb/rpc.proto)
Из статьи Google о paxosdb: наша реализация строится вокруг мощного примитива MultiOp. Все остальные операции с базой данных, кроме итерации, реализованы как один вызов MultiOp. MultiOp применяется атомарно и состоит из трёх компонентов: 1. Список проверок guard. Каждая проверка guard проверяет одну запись базы данных: отсутствие или наличие значения либо равенство заданному значению. Две проверки guard могут относиться к одной или разным записям. Все проверки guard применяются, и MultiOp возвращает результаты. Если все проверки истинны, MultiOp выполняет t op (см. пункт 2 ниже), иначе — f op (см. пункт 3 ниже). 2. Список операций базы данных t op. Каждая операция списка является вставкой, удалением или поиском и применяется к одной записи. Две операции могут относиться к одной или разным записям. Они выполняются, если guard истинно. 3. Список операций базы данных f op. Аналогичен t op, но выполняется, если guard ложно.
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| compare | compare — список предикатов, представляющих конъюнкцию условий. Если сравнения успешны, запросы success обрабатываются по порядку, а ответ содержит их соответствующие ответы в том же порядке. Если сравнения неудачны, по порядку обрабатываются запросы failure, и ответ содержит соответствующие ответы по порядку. | (slice of) Compare |
| success | success — список запросов, применяемых, когда compare истинно. | (slice of) RequestOp |
| failure | failure — список запросов, применяемых, когда compare ложно. | (slice of) RequestOp |
Сообщение TxnResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| succeeded | succeeded равно true, если compare истинно, и false в противном случае. | bool |
| responses | responses — список ответов, соответствующих результатам применения success, если succeeded равно true, либо failure, если succeeded равно false. | (slice of) ResponseOp |
Сообщение WatchCancelRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| watch_id | watch_id — идентификатор отменяемого наблюдателя, которому больше не будут передаваться события. | int64 |
Сообщение WatchCreateRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key — ключ, регистрируемый для наблюдения. | bytes |
| range_end | range_end — конец наблюдаемого диапазона [key, range_end). Если range_end не задан, наблюдается только аргумент key. Если range_end равен ‘\0’, наблюдаются все ключи, большие либо равные аргументу key. Если range_end на один бит больше заданного ключа, наблюдаются все ключи с префиксом заданного ключа. | bytes |
| start_revision | start_revision — необязательная ревизия, с которой включительно начинается наблюдение. Отсутствие start_revision означает “now”. | int64 |
| progress_notify | progress_notify задаётся, чтобы сервер etcd периодически отправлял новому наблюдателю WatchResponse без событий, если недавних событий нет. Это полезно для восстановления отключённого наблюдателя с недавней известной ревизии. Сервер etcd может выбирать частоту уведомлений по текущей нагрузке. | bool |
| filters | filters фильтруют события на стороне сервера до их отправки наблюдателю. | (slice of) FilterType |
| prev_kv | Если prev_kv задан, созданный наблюдатель получает предыдущий KV до события. Если предыдущий KV уже компактизирован, ничего не возвращается. | bool |
| watch_id | Если предоставлен ненулевой watch_id, он назначается этому наблюдателю. Поскольку создание наблюдателя в etcd не является синхронной операцией, это помогает обеспечить правильный порядок при создании нескольких наблюдателей в одном потоке. Создание наблюдателя с уже используемым в потоке ID возвращает ошибку. | int64 |
| fragment | fragment позволяет разбивать большие ревизии на несколько ответов наблюдения. | bool |
Сообщение WatchProgressRequest (api/etcdserverpb/rpc.proto)
Запрашивает как можно скорее отправить состояние прогресса потока наблюдения в потоке ответов наблюдения.
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Сообщение WatchRequest (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request_union | request_union — запрос создания нового либо отмены существующего наблюдателя. | oneof |
| create_request | WatchCreateRequest | |
| cancel_request | WatchCancelRequest | |
| progress_request | WatchProgressRequest |
Сообщение WatchResponse (api/etcdserverpb/rpc.proto)
| Поле | Описание | Тип |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| watch_id | watch_id — идентификатор наблюдателя, соответствующего ответу. | int64 |
| created | created равно true, если это ответ на запрос создания наблюдения. Клиент должен сохранить watch_id и ожидать события созданного наблюдателя из того же потока. Все отправленные созданному наблюдателю события имеют одинаковый watch_id. | bool |
| canceled | canceled равно true, если это ответ на запрос отмены наблюдения или start_revision уже компактизирована. Отменённому наблюдателю больше не отправляются события. | bool |
| compact_revision | compact_revision содержит минимальный индекс, если наблюдатель пытается наблюдать с компактизированного индекса. Это происходит при создании наблюдателя на компактизированной ревизии или когда наблюдатель не успевает за изменениями хранилища ключей и значений. Клиент должен считать наблюдателя отменённым и больше не пытаться создавать наблюдателя с тем же start_revision. | int64 |
| cancel_reason | cancel_reason указывает причину отмены наблюдателя. | string |
| fragment | framgment равно true, если большой ответ наблюдения разбит на несколько ответов. | bool |
| events | (slice of) mvccpb.Event |
Сообщение Event (api/mvccpb/kv.proto)
| Поле | Описание | Тип |
|---|---|---|
| type | type — тип события. PUT означает сохранение новых данных по ключу, DELETE — удаление ключа. | EventType |
| kv | kv содержит KeyValue события. Событие PUT содержит текущую пару kv. PUT с kv.Version=1 означает создание ключа. DELETE/EXPIRE содержит удалённый ключ, ревизия изменения которого равна ревизии удаления. | KeyValue |
| prev_kv | prev_kv содержит пару «ключ — значение» до события. | KeyValue |
Сообщение KeyValue (api/mvccpb/kv.proto)
| Поле | Описание | Тип |
|---|---|---|
| key | key — ключ в байтах. Пустой ключ недопустим. | bytes |
| create_revision | create_revision — ревизия последнего создания этого ключа. | int64 |
| mod_revision | mod_revision — ревизия последнего изменения этого ключа. | int64 |
| version | version — версия ключа. Удаление сбрасывает её в ноль, а любое изменение ключа увеличивает версию. | int64 |
| value | value — значение ключа в байтах. | bytes |
| lease | lease — идентификатор аренды, присоединённой к ключу. При истечении аренды ключ удаляется. Если lease равен 0, аренда к ключу не присоединена. | int64 |
Сообщение Lease (server/lease/leasepb/lease.proto)
| Поле | Описание | Тип |
|---|---|---|
| ID | int64 | |
| TTL | int64 | |
| RemainingTTL | int64 |
Сообщение LeaseInternalRequest (server/lease/leasepb/lease.proto)
| Поле | Описание | Тип |
|---|---|---|
| LeaseTimeToLiveRequest | etcdserverpb.LeaseTimeToLiveRequest |
Сообщение LeaseInternalResponse (server/lease/leasepb/lease.proto)
| Поле | Описание | Тип |
|---|---|---|
| LeaseTimeToLiveResponse | etcdserverpb.LeaseTimeToLiveResponse |
Сообщение Permission (api/authpb/auth.proto)
Permission — отдельная сущность
| Поле | Описание | Тип |
|---|---|---|
| permType | Type | |
| key | bytes | |
| range_end | bytes |
Сообщение Role (api/authpb/auth.proto)
Role — отдельная запись в сегменте authRoles
| Поле | Описание | Тип |
|---|---|---|
| name | bytes | |
| keyPermission | (slice of) Permission |
Сообщение User (api/authpb/auth.proto)
User — отдельная запись в сегменте authUsers
| Поле | Описание | Тип |
|---|---|---|
| name | bytes | |
| password | bytes | |
| roles | (slice of) string | |
| options | UserAddOptions |
Сообщение UserAddOptions (api/authpb/auth.proto)
| Поле | Описание | Тип |
|---|---|---|
| no_password | bool |
13.10 - Справочник API: конкурентность
Этот справочник API автоматически создан из указанных файлов .proto.
служба Lock (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
Служба блокировок предоставляет клиентские средства блокировки через интерфейс gRPC.
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| Lock | LockRequest | LockResponse | Lock получает распределённую совместную блокировку с указанным именем. При успехе возвращается уникальный ключ, существующий, пока вызывающая сторона удерживает блокировку. Вместе с транзакциями ключ позволяет безопасно гарантировать, что etcd обновляется только при владении блокировкой. Блокировка удерживается до вызова Unlock для ключа или истечения аренды владельца. |
| Unlock | UnlockRequest | UnlockResponse | Unlock принимает ключ, возвращённый Lock, и освобождает блокировку. Следующий ожидающий вызов Lock пробуждается и получает владение блокировкой. |
сообщение LockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Поле | Описание | Тип |
|---|---|---|
| name | name — идентификатор получаемой распределённой совместной блокировки. | bytes |
| lease | lease — идентификатор аренды, привязанной к владению блокировкой. Если удерживающая блокировку аренда истекает или отзывается, блокировка освобождается автоматически. Вызовы Lock с одной арендой считаются одним получением; повторная блокировка с той же арендой ничего не делает. | int64 |
сообщение LockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| key | key — ключ, существующий в etcd, пока вызывающая Lock сторона владеет блокировкой. Пользователи не должны изменять ключ, иначе поведение блокировки не определено. | bytes |
сообщение UnlockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Поле | Описание | Тип |
|---|---|---|
| key | key — ключ владения блокировкой, выданный Lock. | bytes |
сообщение UnlockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
служба Election (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
Служба выборов предоставляет клиентские средства выборов через интерфейс gRPC.
| Метод | Тип запроса | Тип ответа | Описание |
|---|---|---|---|
| Campaign | CampaignRequest | CampaignResponse | Campaign ожидает получения лидерства на выборах и при успехе возвращает представляющий его LeaderKey. Затем LeaderKey можно использовать для публикации новых значений выборов, транзакционной защиты запросов API условием сохранения лидерства и отказа от участия. |
| Proclaim | ProclaimRequest | ProclaimResponse | Proclaim заменяет опубликованное лидером значение новым. |
| Leader | LeaderRequest | LeaderResponse | Leader возвращает текущее объявление выборов, если оно существует. |
| Observe | LeaderRequest | LeaderResponse | Observe потоково передаёт объявления выборов в порядке их публикации избранными лидерами. |
| Resign | ResignRequest | ResignResponse | Resign освобождает лидерство, чтобы его мог получить другой кандидат. |
сообщение CampaignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| name | name — идентификатор выборов для кампании. | bytes |
| lease | lease — идентификатор аренды, привязанной к лидерству на выборах. Если аренда истекает или отзывается до отказа от лидерства, оно передаётся следующему кандидату, если он есть. | int64 |
| value | value — начальное объявленное значение, задаваемое после победы кандидата. | bytes |
сообщение CampaignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| leader | leader описывает ресурсы, используемые для удержания лидерства на выборах. | LeaderKey |
сообщение LeaderKey (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| name | name — идентификатор выборов, соответствующий ключу лидерства. | bytes |
| key | key — непрозрачный ключ, представляющий владение выборами. При удалении ключа лидерство теряется. | bytes |
| rev | rev — ревизия создания ключа. В транзакциях она позволяет проверить владение выборами, сравнив ревизию создания ключа с rev. | int64 |
| lease | lease — идентификатор аренды лидера выборов. | int64 |
сообщение LeaderRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| name | name — идентификатор выборов для сведений о лидерстве. | bytes |
сообщение LeaderResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| kv | kv — пара «ключ — значение», представляющая последнее обновление лидера. | mvccpb.KeyValue |
сообщение ProclaimRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| leader | leader — удерживаемое лидерство на выборах. | LeaderKey |
| value | value — обновление, заменяющее текущее значение лидера. | bytes |
сообщение ProclaimResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
сообщение ResignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| leader | leader — лидерство, освобождаемое при отказе. | LeaderKey |
сообщение ResignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Поле | Описание | Тип |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
сообщение Event (api/mvccpb/kv.proto)
| Поле | Описание | Тип |
|---|---|---|
| type | type — вид события. PUT означает запись новых данных в ключ, DELETE — удаление ключа. | EventType |
| kv | kv содержит KeyValue события. Событие PUT содержит текущую пару kv. PUT с kv.Version=1 означает создание ключа. DELETE/EXPIRE содержит удалённый ключ, ревизия изменения которого равна ревизии удаления. | KeyValue |
| prev_kv | prev_kv содержит пару «ключ — значение» до события. | KeyValue |
сообщение KeyValue (api/mvccpb/kv.proto)
| Поле | Описание | Тип |
|---|---|---|
| key | key — ключ в байтах. Пустой ключ запрещён. | bytes |
| create_revision | create_revision — ревизия последнего создания этого ключа. | int64 |
| mod_revision | mod_revision — ревизия последнего изменения этого ключа. | int64 |
| version | version — версия ключа. Удаление сбрасывает версию в ноль, а любое изменение увеличивает её. | int64 |
| value | value — значение ключа в байтах. | bytes |
| lease | lease — идентификатор аренды, привязанной к ключу. После истечения аренды ключ удаляется. Если lease равно 0, аренда к ключу не привязана. | int64 |
14 - Руководство по операциям
14.1 - Аутентификационные руководства
14.1.1 - Аутентификация
auth,user,role для аутентификации:
Примечание:
Это всего лишь заглушка, которую необходимо заполнить и обновить, добавив больше информации об аутентификации. Текст выше — всего лишь пример кода.
14.1.2 - Управление доступом на основе ролей
Обзор
Аутентификация появилась в etcd 2.1. В API etcd v3 интерфейс API и пользовательский интерфейс аутентификации немного изменены для соответствия новой модели данных. Это руководство поможет настроить базовую аутентификацию и управление доступом на основе ролей в etcd v3.
Специальные пользователи и роли
Существует один специальный пользователь root и одна специальная роль root.
Пользователь root
Пользователя root с полным доступом к etcd необходимо создать до включения
аутентификации. Он предназначен для административных задач: управления ролями
и обычными пользователями. Пользователь root должен иметь роль root и может
изменять любые данные в etcd.
Роль root
Роль root можно назначить любому пользователю, не только пользователю root.
Пользователь с этой ролью имеет глобальный доступ на чтение и запись и право
изменять конфигурацию аутентификации кластера. Роль root также предоставляет
права для общего обслуживания кластера, включая изменение состава, дефрагментацию
хранилища и создание снимков.
Работа с пользователями
Подкоманда user утилиты etcdctl выполняет все операции с учётными записями пользователей.
Список пользователей выводится командой:
Пользователь создаётся командой:
При создании нового пользователя запрашивается пароль. Если указан параметр
--interactive=false, пароль можно передать через стандартный ввод. Его также
можно задать параметром --new-user-password.
Пользователя без возможности парольной аутентификации можно создать так:
Такой пользователь может аутентифицироваться только по Common Name сертификата TLS .
etcd не поддерживает аутентификацию с пустым паролем через --user username:. Например, пользователь с пустым паролем, созданный командой etcdctl user add anonymous:'', не может пройти аутентификацию по имени и паролю, а запросы вида etcdctl --user anonymous: get foo завершаются ошибкой user name is empty.
Роли назначаются и отзываются у пользователя командами:
Параметры пользователя можно просмотреть командой:
Пароль пользователя изменяется командой:
При изменении снова запрашивается новый пароль. С параметром --interactive=false
его можно передать через стандартный ввод.
Учётная запись удаляется командой:
Работа с ролями
Подкоманда role утилиты etcdctl управляет правами доступа отдельных ролей,
назначаемых пользователям.
Список ролей выводится командой:
Новая роль создаётся командой:
У роли нет пароля; она лишь определяет набор прав доступа.
Роли предоставляется доступ к одному ключу или диапазону ключей.
Диапазон задаётся интервалом [start-key, end-key), где start-key должен лексикографически предшествовать end-key.
Можно предоставить доступ на чтение, запись или оба вида, как в следующих примерах:
Выданные права можно в любой момент просмотреть у роли:
Права отзываются аналогичным образом:
Роль целиком удаляется командой:
Включение аутентификации
Ниже приведён минимальный порядок включения аутентификации. Администратор может настроить пользователей и роли до или после её включения.
Убедитесь, что пользователь root создан:
Включите аутентификацию:
После этого etcd работает с включённой аутентификацией. Для её отключения используйте обратную команду:
Область защиты аутентификации
Аутентификация, включённая командой etcdctl auth enable, защищает операции
V3 gRPC API (get, put, delete, watch и т. д.).
Конечные точки HTTP /metrics и /health обслуживаются отдельным обработчиком
и не защищены аутентификацией V3 RBAC. Поэтому Prometheus и балансировщики
нагрузки могут собирать метрики без аутентификации gRPC, тогда как данные
ключей и значений остаются защищёнными.
Чтобы защитить эти конечные точки наблюдаемости:
- включите mTLS с
--cert-file,--key-fileи--client-cert-auth; - либо привяжите метрики к частному интерфейсу через
--listen-metrics-urls; - либо ограничьте доступ сетевыми политиками или правилами межсетевого экрана.
Аутентификация с помощью etcdctl
Для аутентификации etcdctl поддерживает флаг, аналогичный curl.
Пароль можно ввести по запросу:
Пароль также можно передать флагом командной строки --password:
В остальном команды etcdctl не меняются. Пользователей и роли по-прежнему
можно создавать и изменять, но для этого требуется аутентификация пользователя
с ролью root.
Использование Common Name сертификата TLS
Начиная с v3.2, если сервер etcd запущен с --client-cert-auth=true, поле
Common Name (CN) клиентского сертификата TLS используется как пользователь etcd.
В этом случае CN аутентифицирует пользователя, и пароль клиенту не нужен. Если
одновременно 1. передан --client-cert-auth=true и клиент предоставляет CN и
2. клиент предоставляет имя пользователя и пароль, приоритет имеет аутентификация
по имени и паролю. Эту возможность нельзя использовать с gRPC-proxy и
gRPC-gateway. gRPC-proxy завершает TLS-соединение клиента, поэтому все клиенты
используют сертификат прокси. gRPC-gateway внутренне использует TLS-соединение
для преобразования запроса HTTP в запрос gRPC и имеет то же ограничение. Поэтому
клиенты не могут правильно передать серверу свой CN. Если предоставленный
сертификат содержит непустой CN, gRPC-proxy возвращает ошибку и останавливается.
Примечания о стойкости паролей
etcdctl и API etcd не требуют определённой длины пароля при создании пользователя
или обновлении его пароля. Соблюдение таких требований должен обеспечивать
администратор. Чтобы избежать рисков, связанных со стойкостью паролей, можно
использовать аутентификацию по Common Name сертификата TLS
и пользователей, созданных с параметром --no-password.
14.2 - Параметры конфигурации
etcd можно настроить следующими способами:
- Флаги командной строки
- Переменные окружения: каждому флагу соответствует переменная окружения
с тем же именем, префиксом
ETCD_, прописными буквами и форматом snake case . Например,--some-flagсоответствуетETCD_SOME_FLAG. - Файл конфигурации
Внимание: при сочетании разных способов конфигурации действуют следующие правила.
- Флаги командной строки имеют приоритет над переменными окружения.
- Если указан файл конфигурации, все флаги командной строки и переменные окружения игнорируются.
Флаги командной строки
Ниже флаги представлены в формате --flag-name DEFAULT_VALUE.
Из-за продолжающейся разработки приведённый ниже список флагов может быть неактуален. Последние доступные флаги можно получить командой etcd --help или в [справке etcd][].
Примечание: сведения о новых, обновлённых и устаревших флагах v3.7 приведены в CHANGELOG-3.7.md .
Участник
Кластеризация
Безопасность
Аутентификация
Профилирование и мониторинг
Ведение журнала
Примечание: в v3.7 несколько флагов --experimental-* стали стабильными или были переименованы.
Обязательно замените устаревшие флаги перечисленными ниже стабильными эквивалентами.
Распределённая трассировка
Прокси v2
Примечание: флаги будут объявлены устаревшими в v3.6.
Возможности
Флаги функций
Небезопасные возможности
Предупреждение: использование небезопасных возможностей может нарушить гарантии протокола консенсуса!
Файл конфигурации
Файл конфигурации etcd представляет собой отображение YAML, ключами которого
служат имена флагов командной строки, а значениями — значения флагов.
Чтобы использовать файл, укажите его путь как значение флага --config-file или переменной окружения ETCD_CONFIG_FILE.
Пример см. в [образце etcd.conf.yml][].
Поля длительности, такие как --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration и --downgrade-check-time, при передаче как флаги
командной строки принимают понятные человеку строки (например, 10m, 5s), однако
в файле конфигурации допускаются только целые значения, представляющие
наносекунды. Это известное ограничение стандартной библиотеки Go
,
где time.Duration десериализуется как обычное целое число.
Например, чтобы задать в файле конфигурации 10-минутный интервал уведомлений о ходе наблюдения:
14.3 - Модель транспортной безопасности
etcd поддерживает автоматический TLS и аутентификацию по клиентским сертификатам как для связи клиентов с сервером, так и для связи одноранговых узлов (серверов друг с другом внутри кластера). Обратите внимание: по умолчанию etcd не включает аутентификацию на основе RBAC и аутентификацию на транспортном уровне, чтобы упростить начало работы с базой данных. Кроме того, изменение этого значения по умолчанию нарушило бы совместимость проекта, установленную с 2013 года. Кластер etcd без включённых функций безопасности может открыть свои данные любым клиентам.
Для начала подготовьте сертификат CA и подписанную пару ключей для одного участника. Рекомендуется создавать и подписывать новую пару ключей для каждого участника кластера.
Для удобства инструмент cfssl предоставляет простой интерфейс создания сертификатов; пример его использования приведён здесь . В качестве альтернативы воспользуйтесь руководством по созданию самоподписанных пар ключей .
Из-за продолжающейся разработки приведённый ниже список флагов может быть неактуален. Последние доступные флаги можно получить командой etcd --help или в [справке etcd][].
Базовая настройка
etcd принимает несколько относящихся к сертификатам параметров конфигурации в виде флагов командной строки или переменных окружения:
Связь клиента с сервером:
--cert-file=<path>: сертификат, используемый для соединений SSL/TLS с etcd. При заданном параметре advertise-client-urls может использовать схему HTTPS.
--key-file=<path>: ключ сертификата. Должен быть незашифрованным.
--client-cert-auth: если задан, etcd проверяет во всех входящих запросах HTTPS наличие клиентского сертификата, подписанного доверенным CA; запросы без действительного клиентского сертификата завершаются ошибкой. Если включена аутентификация
, сертификат предоставляет учётные данные для имени пользователя из поля Common Name.
--trusted-ca-file=<path>: доверенный центр сертификации.
--auto-tls: использовать автоматически созданные самоподписанные сертификаты для соединений TLS с клиентами.
Связь одноранговых узлов (между серверами / в кластере):
Параметры одноранговых узлов работают так же, как параметры связи клиента с сервером:
--peer-cert-file=<path>: сертификат для соединений SSL/TLS между одноранговыми узлами. Используется как при прослушивании адреса однорангового узла, так и при отправке запросов другим узлам.
--peer-key-file=<path>: ключ сертификата. Должен быть незашифрованным.
--peer-client-cert-auth: если задан, etcd проверяет во всех входящих запросах одноранговых узлов кластера действительные клиентские сертификаты, подписанные указанным CA.
--peer-trusted-ca-file=<path>: доверенный центр сертификации.
--peer-auto-tls: использовать автоматически созданные самоподписанные сертификаты для соединений TLS между одноранговыми узлами.
Если указан сертификат связи клиента с сервером или одноранговых узлов, необходимо также задать ключ. Все эти параметры конфигурации доступны и через переменные окружения ETCD_CA_FILE, ETCD_PEER_CA_FILE и т. д.
Общие параметры:
--cipher-suites: разделённый запятыми список поддерживаемых наборов шифров TLS между сервером и клиентом, а также между одноранговыми узлами (пустой список автоматически заполняется Go).
--tls-min-version=<version> задаёт минимальную версию TLS, поддерживаемую etcd.
--tls-max-version=<version> задаёт максимальную версию TLS, поддерживаемую etcd. Если не задана, используется максимальная версия, поддерживаемая Go.
keyUsage и extendedKeyUsage сертификата TLS
При создании сертификатов X.509 для защиты транспорта etcd
сертификаты должны содержать подходящие поля keyUsage и
extendedKeyUsage в зависимости от своей роли. Для проверки сертификатов
etcd использует библиотеки Go crypto/tls и crypto/x509, которые
контролируют эти варианты использования во время рукопожатия TLS.
В таблице приведены рекомендуемые варианты использования для распространённых ролей сертификатов:
| Роль сертификата | keyUsage | extendedKeyUsage |
|---|---|---|
| Сервер (клиент — сервер) | digitalSignature, keyEncipherment | serverAuth |
| Клиент | digitalSignature, keyEncipherment | clientAuth |
| Одноранговый узел (сервер — сервер) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Примечания:
- При включённом
--peer-client-cert-authсертификаты одноранговых узлов используются для взаимного TLS между участниками etcd и поэтому требуют какserverAuth, так иclientAuth. - Клиентские сертификаты, используемые с
--client-cert-auth, должны содержатьclientAuth.
Пример 1: транспортная безопасность между клиентом и сервером с HTTPS
Подготовьте сертификат CA (ca.crt) и подписанную пару ключей (server.crt, server.key).
Настроим простую транспортную безопасность HTTPS в etcd по шагам:
etcd должен успешно запуститься; конфигурацию можно проверить, обратившись к etcd по HTTPS:
Команда должна показать успешное рукопожатие. Поскольку используются самоподписанные сертификаты и собственный центр сертификации, CA необходимо передать curl с параметром --cacert. Другой вариант — добавить сертификат CA в системный каталог доверенных сертификатов (обычно /etc/pki/tls/certs или /etc/ssl/certs).
Пользователям OSX 10.9+: curl 7.30.0 в OSX 10.9+ не распознаёт сертификаты, переданные в командной строке.
Вместо этого импортируйте тестовый ca.crt непосредственно в связку ключей либо добавьте curl флаг -k, чтобы игнорировать ошибки.
Для проверки без флага -k выполните open ./tests/fixtures/ca/ca.crt и следуйте указаниям.
После тестирования удалите этот сертификат!
Если известно обходное решение, сообщите о нём.
Пример 2: аутентификация клиента на сервере с клиентскими сертификатами HTTPS
К этому моменту клиент etcd умеет проверять подлинность сервера и обеспечивает транспортную безопасность. Клиентские сертификаты также позволяют предотвратить несанкционированный доступ к etcd.
Клиенты предъявляют серверу свои сертификаты, а сервер проверяет их подпись указанным CA и решает, обслуживать ли запрос.
Потребуются те же файлы, что и в первом примере, а также пара ключей клиента (client.crt, client.key), подписанная тем же центром сертификации.
Теперь отправьте серверу тот же запрос, что и выше:
Сервер должен отклонить запрос:
Для успешного выполнения нужно передать серверу подписанный CA клиентский сертификат:
Вывод должен содержать:
А также ответ сервера:
Укажите наборы шифров, чтобы заблокировать слабые наборы шифров TLS .
Рукопожатие TLS завершается ошибкой, если приветствие клиента запрошено с недопустимыми наборами шифров.
Например:
После этого клиентские запросы должны указывать один из заданных на сервере наборов шифров:
Пример 3: транспортная безопасность и клиентские сертификаты в кластере
etcd поддерживает ту же описанную выше модель для связи одноранговых узлов, то есть для обмена между участниками etcd в кластере.
Предположим, имеется ca.crt и два участника с собственными парами ключей (member1.crt и member1.key, member2.crt и member2.key), подписанными этим CA. Запустим etcd следующим образом:
Участники etcd образуют кластер, а весь обмен между ними шифруется и аутентифицируется клиентскими сертификатами. Вывод etcd покажет, что адреса подключений используют HTTPS.
Пример 4: автоматическая транспортная безопасность с самоподписанными сертификатами
При указании ClientAutoTLS и PeerAutoTLS срок действия автоматически созданных etcd клиентского сертификата и сертификата однорангового узла составляет только 1 год. Срок действия сертификата в годах можно задать флагом –self-signed-cert-validity.
Если требуется шифрование связи без аутентификации, etcd может шифровать сообщения автоматически созданными самоподписанными сертификатами. Это упрощает развёртывание, поскольку управлять сертификатами и ключами вне etcd не требуется.
Настройте etcd на использование самоподписанных сертификатов для клиентских и одноранговых соединений флагами --auto-tls и --peer-auto-tls:
Самоподписанные сертификаты не подтверждают подлинность, поэтому curl вернёт ошибку:
Чтобы отключить проверку цепочки сертификатов, вызовите curl с флагом -k:
Примечания по DNS SRV
Начиная с v3.1.0 (кроме v3.2.9), начальная инициализация через SRV аутентифицирует ServerName по корневому доменному имени из флага --discovery-srv. Для защиты от атак «человек посередине» с сертификатами требуется, чтобы сертификат содержал совпадающее корневое доменное имя в поле Subject Alternative Name (SAN). Например, etcd --discovery-srv=etcd.local аутентифицирует одноранговые узлы и клиентов, только если предоставленные сертификаты содержат корневой домен etcd.local в поле Subject Alternative Name (SAN)
Примечания для прокси etcd
Прокси etcd терминирует TLS своего клиента, если соединение защищено, а для связи с участниками etcd использует собственные ключ и сертификат прокси, заданные в --peer-key-file и --peer-cert-file.
Прокси связывается с участниками etcd как через --advertise-client-urls, так и через --advertise-peer-urls соответствующего участника. Он пересылает клиентские запросы на объявленные клиентские URL участников etcd и синхронизирует исходную конфигурацию кластера через объявленные URL их одноранговых узлов.
Когда для участника etcd включена аутентификация клиентов, администратор должен убедиться, что сертификат однорангового узла из параметра прокси --peer-cert-file действителен для этой аутентификации. При включённой аутентификации одноранговых узлов сертификат прокси также должен быть действителен для неё.
Примечания по аутентификации TLS
Начиная с v3.2.0 , сертификаты TLS перезагружаются при каждом клиентском соединении . Это позволяет заменять истекающие сертификаты без остановки серверов etcd, перезаписывая старые сертификаты новыми. Обновление сертификатов для каждого соединения не должно создавать значительных накладных расходов, однако в будущем его можно улучшить уровнем кэширования. Примеры тестов находятся здесь .
Начиная с v3.2.0
, сервер отклоняет входящие сертификаты одноранговых узлов с неверным IP в SAN
. Если сертификат однорангового узла содержит IP-адреса в поле Subject Alternative Name (SAN), сервер аутентифицирует узел только при совпадении удалённого IP-адреса с одним из них. Это предотвращает присоединение к кластеру неавторизованных конечных точек. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом фактический IP-адрес узла B равен 10.138.0.2, а не 10.138.0.27. Когда B пытается присоединиться к кластеру, узел A отклоняет его с ошибкой x509: certificate is valid for 10.138.0.27, not 10.138.0.2, поскольку удалённый IP-адрес B не совпадает с адресом в поле Subject Alternative Name (SAN).
Начиная с v3.2.0
, при проверке SAN сервер разрешает TLS DNSNames
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) только DNS-имена без IP-адресов, сервер аутентифицирует узел лишь тогда, когда прямое разрешение этих DNS-имён (dig b.com) даёт IP, совпадающий с удалённым адресом. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2. Когда B пытается присоединиться к кластеру, узел A разрешает входящее имя b.com, получая список IP-адресов (например, командой dig b.com). Если список не содержит IP 10.138.0.2, A отклоняет B с ошибкой tls: 10.138.0.2 does not match any of DNSNames ["b.com"].
Начиная с v3.2.2
, при совпадении IP сервер принимает соединение без проверки записей DNS
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) IP-адреса и DNS-имена, а удалённый IP совпадает с одним из адресов, сервер принимает соединение без дальнейшей проверки DNS-имён. Например, CSR однорангового узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2, а invalid.domain — недопустимое имя узла. Когда B пытается присоединиться к кластеру, узел A успешно аутентифицирует его, поскольку поле Subject Alternative Name (SAN) содержит действительный совпадающий IP-адрес. Подробнее см. issue#8206
.
Начиная с v3.2.5
, сервер поддерживает обратное разрешение шаблонных DNS SAN
. Если сертификат однорангового узла содержит в поле Subject Alternative Name (SAN) только DNS-имена без IP-адресов, сервер сначала выполняет обратное разрешение удалённого IP и получает список соответствующих ему имён (например, командой nslookup IPADDR). Затем соединение принимается, если одно из имён совпадает с DNS-именем сертификата точно или по шаблону. Если совпадений нет, сервер выполняет прямое разрешение каждой записи DNS сертификата (например, разрешает example.default.svc для записи *.example.default.svc) и принимает соединение, только когда среди разрешённых адресов узла есть IP, совпадающий с удалённым IP однорангового узла. Например, CSR узла B (созданный с cfssl) имеет вид:
при этом удалённый IP-адрес узла B равен 10.138.0.2. Когда B пытается присоединиться к кластеру, узел A выполняет обратное разрешение IP 10.138.0.2 и получает список имён узлов. Затем он точно или по шаблону сопоставляет их с DNS-именами в поле Subject Alternative Name (SAN) сертификата B. Если ни обратное, ни прямое разрешение не дало совпадений, возвращается ошибка "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"]. Подробнее см. issue#8268
.
В v3.3.0
добавлен флаг etcd --peer-cert-allowed-cn
, поддерживающий аутентификацию соединений одноранговых узлов по CN (Common Name)
. Начальная инициализация TLS в Kubernetes включает создание динамических сертификатов для участников etcd и других системных компонентов (например, сервера API, kubelet и т. д.). Отдельные CA для каждого компонента обеспечивают более строгий контроль доступа к кластеру etcd, но часто неудобны. При заданном флаге –peer-cert-allowed-cn узел может присоединиться только с совпадающим общим именем, даже если CA общий. Сопоставление является точным сравнением строки с полем Common Name (CN) сертификата; шаблоны и префиксы не поддерживаются. При фильтрации по имени узла с –peer-cert-allowed-hostname или –client-cert-allowed-hostname используется x509.Certificate.VerifyHostname() из Go, поддерживающий как точные имена, так и шаблонные записи (например, *.example.com). Например, каждый участник кластера из 3 узлов настраивается со следующими CSR (созданными с cfssl):
При заданном --peer-cert-allowed-cn etcd.local аутентифицируются только одноранговые узлы с совпадающими общими именами. Узлы с другими CN в CSR или другим --peer-cert-allowed-cn отклоняются:
Каждый процесс следует запускать с параметром:
В v3.2.19
и v3.3.4
исправлена перезагрузка TLS, когда поле SAN сертификата содержит только IP-адреса без доменных имён
. Например, участник настраивается со следующим CSR (созданным с cfssl):
В Go сервер вызывает (*tls.Config).GetCertificate для перезагрузки TLS тогда и только тогда, когда поле сервера (*tls.Config).Certificates непусто либо (*tls.ClientHelloInfo).ServerName непусто и содержит действительный SNI клиента. Ранее etcd всегда заполнял (*tls.Config).Certificates при первом клиентском рукопожатии TLS, делая поле непустым. Поэтому клиент всегда должен был передавать совпадающий SNI, чтобы пройти проверку TLS и вызвать (*tls.Config).GetCertificate для перезагрузки ресурсов TLS.
Однако сертификат, поле SAN которого не содержит доменных имён, а только IP-адреса
, запрашивает *tls.ClientHelloInfo с пустым полем ServerName, поэтому при первом рукопожатии TLS перезагрузка не запускается. Это становится проблемой при замене истёкших сертификатов без остановки службы.
Теперь при первом клиентском рукопожатии TLS (*tls.Config).Certificates создаётся пустым, чтобы сначала вызвать (*tls.Config).GetCertificate, а затем заполнять остальные сертификаты при каждом новом соединении TLS, даже если SNI клиента пуст (например, сертификат содержит только IP-адреса).
Примечания по белому списку узлов
Флаг etcd --host-whitelist задаёт допустимые имена узлов из клиентских запросов HTTP. Политика происхождения клиента защищает незащищённые серверы etcd от атак “DNS Rebinding”
. Любой веб-сайт может создать разрешённое DNS-имя и направить DNS на "localhost" или любой другой адрес. Тогда все конечные точки HTTP сервера etcd, слушающего "localhost", становятся доступны и уязвимы для атак повторной привязки DNS. Подробнее см. CVE-2018-5702
.
Политика происхождения клиента работает следующим образом:
- Если клиентское соединение защищено HTTPS, разрешаются любые имена узлов.
- Если клиентское соединение не защищено и
"HostWhitelist"не пуст, разрешаются только запросы HTTP, поле Host которых указано в белом списке.
Для более строгого контроля политика происхождения клиента применяется независимо от того, включена ли аутентификация.
По умолчанию etcd --host-whitelist и embed.Config.HostWhitelist пусты, поэтому разрешены все имена узлов. Обратите внимание: при указании имён адреса обратной петли автоматически не добавляются. Чтобы разрешить интерфейсы обратной петли, внесите их в белый список вручную (например, "localhost", "127.0.0.1" и т. д.).
Часто задаваемые вопросы
При клиентской аутентификации TLS появляется ошибка рукопожатия SSLv3 alert handshake failure?
Пакет crypto/tls языка golang проверяет назначение открытого ключа сертификата перед его использованием.
Чтобы применять открытый ключ сертификата для аутентификации клиента, при его создании нужно добавить clientAuth в Extended Key Usage.
Это выполняется следующим образом:
Добавьте в openssl.cnf следующий раздел:
При создании сертификата обязательно укажите его во флаге -extensions:
При аутентификации сертификата однорангового узла появляется “certificate is valid for 127.0.0.1, not $MY_IP”
Убедитесь, что сертификаты подписаны с Subject Name, содержащим общедоступный IP-адрес участника. Например, инструмент etcd-ca предоставляет параметр --ip= для команды new-cert.
Сертификат должен быть подписан для FQDN участника в Subject Name; для добавления IP-адреса используйте Subject Alternative Names (кратко — IP SAN). Инструмент etcd-ca предоставляет параметр --domain= для команды new-cert, а openssl также умеет это
.
Шифрует ли etcd данные, хранящиеся на дисках?
Нет. etcd не шифрует данные ключей и значений, хранящиеся на дисках. Если данные etcd необходимо шифровать, доступны следующие варианты:
- выполнять шифрование и расшифрование в клиентских приложениях
- использовать функцию нижележащей системы хранения для шифрования сохранённых данных, например dm-crypt
В журнале появляется предупреждение “directory X exist without recommended permission -rwx——”
При создании некоторых новых каталогов etcd задаёт права доступа 700, чтобы по возможности предотвратить непривилегированный доступ. Однако если пользователь уже создал каталог с собственными правами, etcd использует существующий каталог и записывает предупреждение, если права отличаются от 700.
14.4 - Руководство по кластеризации
Обзор
При статическом запуске кластера etcd каждый участник должен знать других участников кластера. В некоторых случаях IP-адреса участников заранее неизвестны. Тогда кластер etcd можно инициализировать с помощью службы обнаружения.
После запуска кластера etcd участники добавляются и удаляются посредством динамического изменения конфигурации . Чтобы лучше понять конструкцию этого механизма, рекомендуется прочитать документ о конструкции динамической конфигурации .
В руководстве рассматриваются следующие механизмы начальной инициализации кластера etcd:
Каждый механизм будет использован для создания кластера etcd из трёх машин со следующими параметрами:
| Имя | Адрес | Имя узла |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Статическая инициализация
Поскольку участники, их адреса и размер кластера известны до запуска, можно применить автономную конфигурацию начальной инициализации, задав флаг initial-cluster. Каждая машина получает следующие переменные окружения либо параметры командной строки:
Обратите внимание: URL в initial-cluster — это объявленные URL одноранговых узлов, поэтому они должны совпадать со значением initial-advertise-peer-urls на соответствующих узлах.
При запуске нескольких кластеров (либо многократном создании и уничтожении одного кластера) с одинаковой конфигурацией для тестирования настоятельно рекомендуется задавать каждому кластеру уникальный initial-cluster-token. Тогда etcd создаёт уникальные идентификаторы кластера и участников, даже если остальные параметры полностью совпадают. Это защищает etcd от взаимодействия между кластерами, способного их повредить.
Для приёма клиентского трафика etcd слушает адреса listen-client-urls
. Участник etcd объявляет URL из advertise-client-urls
другим участникам, прокси и клиентам. Убедитесь, что advertise-client-urls доступны предполагаемым клиентам. Распространённая ошибка — указать в advertise-client-urls localhost или оставить значение по умолчанию, когда к etcd должны обращаться удалённые клиенты.
На каждой машине запустите etcd со следующими флагами:
При последующих запусках etcd параметры командной строки, начинающиеся с --initial-cluster, игнорируются. После исходной инициализации переменные окружения или флаги командной строки можно удалить. Если конфигурацию потребуется изменить позднее (например, добавить участника в кластер или удалить его), обратитесь к руководству по динамической конфигурации
.
TLS
etcd поддерживает шифрованную связь по протоколу TLS. Каналы TLS можно использовать как для шифрования внутреннего обмена между одноранговыми узлами кластера, так и для шифрования клиентского трафика. В этом разделе приведены примеры настройки кластера с TLS для одноранговых и клиентских соединений. Подробности о поддержке TLS в etcd см. в руководстве по безопасности .
Самоподписанные сертификаты
Кластер с самоподписанными сертификатами одновременно шифрует трафик и аутентифицирует соединения. Для запуска такого кластера каждый участник должен иметь уникальную пару ключей (member.crt, member.key), подписанную общим сертификатом CA кластера (ca.crt) для одноранговых и клиентских соединений. Сертификаты можно создать по примеру настройки TLS
в etcd.
На каждой машине etcd запускается со следующими флагами:
Автоматические сертификаты
Если кластеру требуется шифрованная связь, но не нужна аутентификация соединений, etcd можно настроить на автоматическое создание ключей. При инициализации каждый участник создаёт собственный набор ключей на основе объявленных IP-адресов и имён узлов.
На каждой машине etcd запускается со следующими флагами:
Случаи ошибок
В следующем примере новый узел не включён в перечень узлов. Для нового кластера узел обязательно должен быть добавлен в список исходных участников.
В этом примере узел (infra0) сопоставляется с адресом (127.0.0.1:2380), отличным от указанного для него в списке кластера (10.0.1.10:2380). Если узел должен слушать несколько адресов, все они обязательно должны быть отражены в директиве конфигурации “initial-cluster”.
Если одноранговый узел с другим набором параметров конфигурации попытается присоединиться к кластеру, etcd сообщит о несовпадении идентификатора кластера и завершит работу.
Обнаружение
В некоторых случаях IP-адреса одноранговых узлов кластера заранее неизвестны. Такое часто происходит при использовании облачных провайдеров или DHCP в сети. Тогда вместо статической конфигурации для начальной инициализации нового кластера используется существующий кластер etcd. Этот процесс называется «обнаружением».
Для обнаружения доступны два метода:
- служба обнаружения etcd
- записи DNS SRV
Обнаружение etcd
Чтобы лучше понять конструкцию протокола службы обнаружения, рекомендуется прочитать документацию протокола.
Срок жизни URL обнаружения
URL обнаружения идентифицирует уникальный кластер etcd. Вместо повторного использования существующего URL каждый экземпляр etcd получает новый общий URL обнаружения для начальной инициализации нового кластера.
Кроме того, URL обнаружения следует использовать ТОЛЬКО для исходной инициализации кластера. Для изменения состава уже работающего кластера обратитесь к руководству по динамическому изменению конфигурации .
Пользовательская служба обнаружения etcd
Для обнаружения и начальной инициализации используется существующий кластер. При использовании частного кластера etcd создайте URL следующим образом:
Задание ключа размера по этому URL создаёт URL обнаружения с ожидаемым размером кластера 3.
В этом случае используется URL https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83, а участники etcd при запуске регистрируются в каталоге https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83.
Для каждого участника должен быть задан уникальный флаг имени. Подходящим выбором может быть Hostname или machine-id. Иначе обнаружение завершится ошибкой из-за повторяющегося имени.
Теперь запустим etcd с соответствующими флагами для каждого участника:
Каждый участник зарегистрируется в пользовательской службе обнаружения etcd, а после регистрации всех машин кластер начнёт работу.
Общедоступная служба обнаружения etcd
Если существующего кластера нет, используйте общедоступную службу обнаружения на discovery.etcd.io. Чтобы создать частный URL обнаружения через конечную точку “new”, выполните команду:
Будет создан кластер с исходным размером 3 участника. Если размер не указан, по умолчанию также используется 3.
Для каждого участника должен быть задан уникальный флаг имени, иначе обнаружение завершится ошибкой из-за повторяющихся имён. Подходящим выбором может быть Hostname или machine-id.
Теперь запустим etcd с соответствующими флагами для каждого участника:
Каждый участник зарегистрируется в службе обнаружения, а после регистрации всех участников кластер начнёт работу.
Чтобы etcd подключался к службе обнаружения через HTTP-прокси, задайте переменную окружения ETCD_DISCOVERY_PROXY.
Случаи ошибок и предупреждений
Ошибки сервера обнаружения
Предупреждения
Это безвредное предупреждение означает, что URL обнаружения будет проигнорирован на этой машине.
Обнаружение DNS
В качестве механизма обнаружения можно использовать записи SRV
DNS.
Флаг --discovery-srv задаёт доменное имя DNS, в котором находятся записи SRV обнаружения.
При значении --discovery-srv example.com записи DNS SRV ищутся в следующем порядке:
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Если найдена _etcd-server-ssl._tcp.example.com, etcd попытается выполнить начальную инициализацию через TLS.
Чтобы клиенты могли обнаружить кластер etcd, следующие записи DNS SRV ищутся в указанном порядке:
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Если найдена _etcd-client-ssl._tcp.example.com, клиенты попытаются связаться с кластером etcd через SSL/TLS.
Если etcd использует TLS, запись SRV обнаружения (например, example.com) вместе с именем узла должна входить в DNS SAN сертификата SSL, иначе кластеризация завершится ошибкой с сообщениями журнала наподобие следующего:
Если etcd использует TLS без пользовательского центра сертификации, домен обнаружения (например, example.com) должен совпадать с доменом записи SRV (например, infra1.example.com). Это снижает риск атак с поддельными записями SRV, указывающими на другой домен: такой домен мог бы иметь действительный сертификат PKI, но контролироваться неизвестной третьей стороной.
Флаг -discovery-srv-name дополнительно задаёт суффикс имени SRV, запрашиваемого при обнаружении.
Используйте его, чтобы различать несколько кластеров etcd в одном домене.
Например, при значениях discovery-srv=example.com и -discovery-srv-name=foo выполняются следующие запросы DNS SRV:
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
Создание записей DNS SRV
Начальная инициализация кластера etcd через DNS
Участники кластера etcd могут объявлять доменные имена или IP-адреса; при начальной инициализации разрешаются записи DNS A.
Начиная с 3.2 (в 3.1 выводятся предупреждения), --listen-peer-urls и --listen-client-urls отклоняют доменное имя при привязке сетевого интерфейса.
Разрешённый адрес из --initial-advertise-peer-urls должен совпадать с одним из разрешённых адресов в целях SRV. Участник etcd считывает разрешённый адрес, чтобы определить, принадлежит ли он кластеру, заданному записями SRV.
Кластер также можно инициализировать по IP-адресам вместо доменных имён:
Начиная с v3.1.0 (кроме v3.2.9), когда etcd --discovery-srv=example.com настроен с TLS, сервер аутентифицирует одноранговые узлы и клиентов только в том случае, если предоставленные сертификаты содержат корневой домен example.com в поле Subject Alternative Name (SAN). См. примечания по DNS SRV
.
Шлюз
Шлюз etcd — простой TCP-прокси, пересылающий сетевые данные кластеру etcd. Подробнее см. в руководстве по шлюзу .
Прокси
При заданном флаге --proxy etcd работает в режиме прокси
. Этот режим поддерживает только API etcd v2; поддержка API v3 не планируется. Вместо этого после выпуска etcd 3.0 для API v3 появится новый прокси с расширенными возможностями.
Для настройки кластера etcd с прокси API v2 прочитайте документ о кластеризации в выпуске etcd 2.3 .
14.5 - Запуск кластеров etcd в контейнерах
В этом руководстве показано, как запустить etcd в Docker с помощью процесса статической начальной инициализации .
Docker
Чтобы предоставить клиентам вне узла Docker доступ к API etcd, используйте IP-адрес узла контейнера. Способ получения IP-адреса подробно описан в документации docker inspect
. Также можно передать команде docker run флаг --net=host, чтобы не помещать контейнер в отдельный сетевой стек.
Запуск одного узла etcd
При настройке etcd используйте IP-адрес узла:
Настройте том Docker для хранения данных etcd:
Запустите последнюю версию etcd (на момент написания — v3.7.0):
Выведите список участников кластера:
Запуск кластера etcd из 3 узлов
Чтобы использовать etcdctl с API версии 3:
Физические серверы
При развёртывании кластера etcd из 3 узлов на физических серверах могут быть полезны примеры из репозитория baremetal .
Подключение тома с сертификатами
Контейнер выпуска etcd не содержит корневых сертификатов по умолчанию. Чтобы использовать HTTPS с сертификатами, которым доверяет корневой центр, например для обнаружения, подключите каталог сертификатов к контейнеру etcd:
14.6 - Запуск кластеров etcd как StatefulSet Kubernetes
Ниже показано, как выполнить статическую начальную инициализацию в виде StatefulSet Kubernetes.
Пример манифеста
Этот манифест содержит службу и StatefulSet для развёртывания статического кластера etcd в Kubernetes.
Если скопировать содержимое манифеста в файл etcd.yaml, его можно применить к кластеру следующей командой.
После применения дождитесь готовности подов.
Используемый в примере контейнер содержит etcdctl, который можно вызывать непосредственно внутри подов.
Для развёртывания с самоподписанным сертификатом найдите в закомментированной конфигурации разделы, начинающиеся с ## TLS, и раскомментируйте нужные значения. Дополнительные инструкции по созданию сертификата с помощью cert-manager приведены ниже.
Создание сертификатов
В этом разделе Helm используется для установки оператора cert-manager .
После установки cert-manager в кластере можно создавать самоподписанные сертификаты. Созданные сертификаты помещаются в объект Secret, который можно подключить к контейнерам как файлы.
Команда Helm для установки cert-manager:
Пример конфигурации ClusterIssuer для создания самоподписанных сертификатов:
Этот манифест создаёт объекты Certificate для клиентских и серверных сертификатов, ссылаясь на ClusterIssuer “selfsigned”. Поле dnsNames должно содержать исчерпывающий список действительных имён узлов для сертификатов, создаваемых cert-manager.
14.7 - Режимы отказа
В крупных развёртываниях машин отказы неизбежны. Машина выходит из строя при неисправности оборудования или программного обеспечения. Несколько машин могут отказать одновременно из-за перебоя питания или проблем с сетью. Разные виды отказов также могут происходить одновременно; перечислить все возможные случаи практически невозможно.
В этом разделе описаны виды отказов и механизмы, позволяющие etcd сохранять работоспособность. Почти любой конкретный отказ можно отнести к одной из этих категорий. Чтобы подготовиться к редким или невосстановимым отказам , всегда создавайте резервные копии кластера etcd.
Отказ меньшинства последователей
Если отказало менее половины последователей, кластер etcd продолжает принимать запросы и работать без серьёзных нарушений. Например, отказ двух последователей не влияет на работу кластера etcd из пяти участников. Однако клиенты теряют соединение с отказавшими участниками. Клиентские библиотеки должны скрывать эти перебои при чтении, автоматически переподключаясь к другим участникам. Операторам следует ожидать роста нагрузки на оставшихся участников из-за переподключений.
Отказ лидера
При отказе лидера кластер etcd автоматически выбирает нового. Выборы начинаются не мгновенно: из-за модели обнаружения отказов по тайм-ауту для выбора нового лидера требуется примерно один тайм-аут выборов.
Во время выборов кластер не может обрабатывать записи. Запросы на запись, отправленные в этот период, ставятся в очередь до выбора нового лидера.
Записи, уже отправленные старому лидеру, но ещё не зафиксированные, могут быть потеряны. Новый лидер вправе перезаписать любые незафиксированные записи предыдущего лидера. С точки зрения пользователя некоторые запросы на запись после выборов могут завершиться по тайм-ауту. При этом зафиксированные записи никогда не теряются.
Новый лидер автоматически продлевает тайм-ауты всех аренд. Благодаря этому аренда не истекает раньше предоставленного TTL, даже если её выдал прежний лидер.
Отказ большинства
Если отказало большинство участников, кластер etcd прекращает работу и больше не может принимать записи.
Восстановление после отказа большинства возможно только тогда, когда большинство участников снова становится доступно. Если большинство нельзя вернуть в работу, оператор должен запустить аварийное восстановление кластера.
Как только большинство участников заработает, кластер etcd автоматически выбирает нового лидера и возвращается в исправное состояние. Новый лидер автоматически продлевает тайм-ауты всех аренд, поэтому аренды не истекают из-за недоступности серверов.
Разделение сети
Разделение сети похоже на отказ меньшинства последователей или лидера. Оно делит кластер etcd на две части: одну с большинством участников и другую с меньшинством. Сторона большинства становится доступным кластером, а сторона меньшинства остаётся недоступной. В etcd не возникает «расщепления сознания» (split-brain), поскольку участники явно добавляются и удаляются, а каждое такое изменение утверждается текущим большинством.
Если лидер находится на стороне большинства, с точки зрения этой стороны произошёл отказ меньшинства последователей. Если лидер оказался на стороне меньшинства, это отказ лидера: прежний лидер складывает полномочия, а большинство выбирает нового.
После восстановления сети сторона меньшинства автоматически распознаёт лидера большинства и восстанавливает своё состояние.
Отказ во время начальной инициализации
Начальная инициализация кластера успешна только в том случае, если запустились все обязательные участники. При любом отказе во время инициализации удалите каталоги данных на всех участниках и заново инициализируйте кластер с новым cluster-token или токеном обнаружения.
Разумеется, неудачно инициализированный кластер можно восстанавливать так же, как работающий. Однако почти всегда это требует больше времени и ресурсов, чем повторная инициализация, поскольку сохранять в таком кластере ещё нечего.
14.8 - Восстановление после аварии
etcd рассчитан на отказы машин. Кластер etcd автоматически восстанавливается после временных сбоев, например перезагрузки машины, и допускает до (N-1)/2 постоянных отказов в кластере из N участников. При постоянном отказе из-за неисправности оборудования или повреждения диска участник теряет доступ к кластеру. Если кластер навсегда теряет более (N-1)/2 участников, происходит катастрофический отказ с безвозвратной потерей кворума. Без кворума кластер не может достичь консенсуса и продолжать принимать обновления.
Для восстановления после катастрофического отказа etcd v3 предоставляет средства снимков и восстановления, позволяющие воссоздать кластер без потери данных ключей v3. Восстановление ключей v2 описано в руководстве администратора v2 .
Создание снимка пространства ключей
Для восстановления кластера сначала нужен снимок пространства ключей одного
участника etcd. Его можно создать с работающего участника командой
etcdctl snapshot save либо скопировать файл member/snap/db из каталога данных
etcd. Следующая команда сохраняет пространство ключей, обслуживаемое $ENDPOINT,
в файл snapshot.db:
Обратите внимание: снимок из файла member/snap/db может потерять ещё не
записанные данные, находящиеся в каталоге wal (журнале предзаписи).
Состояние снимка
Чтобы узнать ревизию и хеш снимка, используйте команду etcdutl snapshot status:
Восстановление кластера
Разница ревизий
При восстановлении кластера существующие клиенты могут увидеть откат ревизии на сотни или тысячи значений. Снимок содержит историю данных только до момента создания, тогда как текущее состояние могло уйти далеко вперёд.
Это особенно опасно для Kubernetes с etcd, где контроллеры и операторы могут
использовать так называемые informers как локальные кэши, получающие уведомления
об обновлениях через наблюдения. Восстановление старой ревизии может неправильно
обновить кэши и вызвать непредсказуемое, несогласованное поведение контроллеров.
При известных потребителях API наблюдения, локальных кэшированных копиях данных etcd или использовании Kubernetes настоятельно рекомендуется восстанавливать снимок с описанным ниже «увеличением ревизии».
Восстановление из снимка
Для восстановления кластера достаточно одного файла снимка “db”. Команда
etcdutl snapshot restore создаёт новые каталоги данных etcd; все участники
должны восстанавливаться из одного снимка. При восстановлении перезаписывается
часть метаданных снимка, в частности идентификаторы участника и кластера, поэтому
участник теряет прежнюю идентичность. Это не позволяет новому участнику случайно
присоединиться к существующему кластеру. Следовательно, восстановление из снимка
обязательно должно запускать новый логический кластер.
Простое восстановление выполняется так:
Проверка целостности
Целостность снимка можно проверить при восстановлении. Снимок, созданный
etcdctl snapshot save, содержит хеш целостности, который проверяет
etcdutl snapshot restore. У снимка, скопированного из каталога данных, хеша
нет, и восстановить его можно только с --skip-hash-check.
Восстановление с увеличением ревизии
Чтобы после восстановления ревизии никогда не уменьшались, укажите
--bump-revision. Параметр принимает 64 bit целое число ревизий, добавляемых к
текущей ревизии снимка. Каждая запись в etcd увеличивает ревизию на один, поэтому
для снимка недельной давности достаточно увеличения на 1'000'000'000, если etcd
обрабатывает менее 1500 записей в секунду.
Для контроллеров Kubernetes важно также пометить все ревизии, включая добавленные,
как компактизированные через --mark-compacted. Тогда все наблюдения завершаются,
а etcd не отвечает на запросы о ревизиях после создания снимка, фактически
инвалидируя кэши informer.
Полная команда выглядит так:
Восстановление с обновлённым составом
Участники кластера etcd хранятся в самом etcd и обслуживаются алгоритмом консенсуса Raft. После полной потери кворума можно изменить место и способ формирования нового кластера, например создать его из совершенно нового набора участников.
При восстановлении из снимка новый состав можно сразу записать в хранилище:
Так новый кластер будет подключаться только к другим восстановленным участникам с указанным токеном, а не к старым участникам, которые ещё могут работать и пытаться подключиться.
В качестве альтернативы при запуске etcd можно указать --force-new-cluster,
чтобы перезаписать состав кластера, сохранив данные приложения. Это настоятельно
не рекомендуется: если другие участники прежнего кластера ещё работают, произойдёт
аварийное завершение. Обязательно регулярно сохраняйте снимки.
Сквозной пример End-2-End
Получите снимок работающего кластера командой:
В продолжение примера следующие команды создают новые каталоги данных etcd
(m1.etcd, m2.etcd, m3.etcd) для кластера из трёх участников:
Затем запустите etcd с новыми каталогами данных:
Теперь восстановленный кластер etcd должен быть доступен и обслуживать пространство ключей из снимка.
Начиная с etcd v3.6, снимок данных создаётся только с помощью etcdctl, а
восстановление выполняется через etcdutl. Если --data-dir не указан, значение
--data-dir по умолчанию — <name>.etcd, где <name> берётся из --name. Например,
если --data-dir отсутствует, а участников зовут m1, m2 и m3, каталогами
--data-dir будут m1.etcd, m2.etcd и m3.etcd.
14.9 - Шлюз etcd
Что такое шлюз etcd
Шлюз etcd — простой TCP-прокси, пересылающий сетевые данные кластеру etcd. Шлюз не хранит состояния и работает прозрачно: он не анализирует клиентские запросы и не вмешивается в ответы кластера. Он не завершает TLS-соединения, не выполняет TLS-рукопожатия от имени клиентов и не проверяет защищённость соединения.
Шлюз поддерживает несколько конечных точек серверов etcd и использует простую циклическую политику. Он направляет трафик только доступным конечным точкам и скрывает от клиентов отказы. В будущем могут появиться другие политики повторных попыток, например взвешенная циклическая.
Когда следует использовать шлюз etcd
Каждому приложению для доступа к etcd сначала требуется адрес клиентской конечной точки кластера. Если несколько приложений на одном сервере обращаются к одному кластеру etcd, каждое из них всё равно должно знать объявленные клиентские конечные точки. При изменении конечных точек кластера списки, возможно, придётся обновить во всех приложениях. Такая массовая перенастройка трудоёмка и подвержена ошибкам.
Шлюз etcd решает эту проблему, предоставляя стабильную локальную конечную точку. В типичной конфигурации на каждой машине работает шлюз, слушающий локальный адрес, а все приложения etcd подключаются к нему. Поэтому при изменении кластера достаточно обновить конечные точки шлюза, а не каждого приложения.
Итак, для автоматического распространения изменений конечных точек кластера шлюз etcd запускается на каждой машине, где несколько приложений обращаются к одному кластеру etcd.
Когда не следует использовать шлюз etcd
- Повышение производительности
Шлюз не предназначен для повышения производительности кластера etcd. Он не кэширует данные, не объединяет наблюдения и не пакетирует запросы. Команда etcd разрабатывает кэширующий прокси для улучшения масштабируемости кластера.
- Работа в системе управления кластером
Развитые системы управления кластерами, такие как Kubernetes, изначально поддерживают обнаружение служб. Приложения могут обращаться к кластеру etcd по DNS-имени или виртуальному IP-адресу, управляемому системой. Например, kube-proxy выполняет ту же роль, что и шлюз etcd.
Запуск шлюза etcd
Рассмотрим кластер etcd со следующими статическими конечными точками:
| Имя | Адрес | Имя узла | Порт |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Запустите шлюз etcd с этими статическими конечными точками:
При обнаружении служб через DNS рассмотрим следующие записи DNS SRV:
Запустите шлюз etcd, чтобы получить конечные точки из записей DNS SRV:
Флаги конфигурации
Кластер etcd
–endpoints
- Разделённый запятыми список целевых серверов etcd, которым пересылаются клиентские соединения.
- По умолчанию:
127.0.0.1:2379 - Порт обязателен.
- Недопустимый пример:
https://127.0.0.1:2379(шлюз не завершает TLS). Шлюз не проверяет схему HTTP и не анализирует запросы, а только пересылает их заданным конечным точкам.
–discovery-srv
- Домен DNS для начальной загрузки конечных точек кластера через записи SRV.
- По умолчанию: не задано
Сеть
–listen-addr
- Интерфейс и порт для привязки и приёма клиентских запросов.
- По умолчанию:
127.0.0.1:23790
–retry-delay
- Задержка перед повторной попыткой подключения к недоступным конечным точкам.
- По умолчанию: 1m0s
- Недопустимый пример: “123” (ожидается единица времени)
Безопасность
–insecure-discovery
- Принимать небезопасные или уязвимые для атак посредника записи SRV.
- По умолчанию:
false
–trusted-ca-file
- Путь к клиентскому файлу центра сертификации TLS, с помощью которого кластер etcd проверяет конечные точки, полученные при обнаружении SRV. Он используется ТОЛЬКО для аутентификации обнаруженных конечных точек, а не для создания соединений передачи данных. Шлюз никогда не завершает TLS-соединения и не создаёт их от имени клиентов.
- По умолчанию: не задано
14.10 - Прокси gRPC
Прокси gRPC — это не сохраняющий состояние обратный прокси etcd, работающий на уровне gRPC (L7). Он предназначен для снижения общей вычислительной нагрузки на основной кластер etcd. Для горизонтального масштабирования прокси объединяет запросы API наблюдения и аренды. Для защиты кластера от злоупотребляющих клиентов он кэширует запросы диапазонов ключей.
Прокси gRPC поддерживает несколько конечных точек сервера etcd. При запуске прокси случайным образом выбирает одну конечную точку сервера etcd. Она обслуживает все запросы, пока прокси не обнаружит её отказ. Обнаружив отказ конечной точки, прокси gRPC переключается на другую доступную точку, скрывая сбой от клиентов. В будущем могут поддерживаться и другие политики повторных попыток, например взвешенный циклический выбор.
Масштабируемый API наблюдения
Прокси gRPC объединяет несколько клиентских наблюдателей (c-watchers) за одним ключом или диапазоном в единственного наблюдателя (s-watcher), подключённого к серверу etcd. Все события от s-watcher прокси рассылает своим c-watchers.
Если N клиентов наблюдают за одним ключом, один прокси gRPC может снизить нагрузку наблюдения на сервер etcd с N до 1. Для дальнейшего распределения серверной нагрузки можно развернуть несколько прокси gRPC.
В следующем примере три клиента наблюдают за ключом A. Прокси gRPC объединяет трёх наблюдателей, создавая одного наблюдателя, подключённого к серверу etcd.
Ограничения
Чтобы эффективно объединить несколько клиентских наблюдателей в одного, прокси gRPC по возможности присоединяет новые c-watchers к существующему s-watcher. Такой объединённый s-watcher может быть не синхронизирован с сервером etcd из-за сетевых задержек или буферизованных недоставленных событий. Если ревизия наблюдения не указана, прокси gRPC не гарантирует, что c-watcher начнёт наблюдение с самой последней ревизии хранилища. Например, наблюдатель клиента, подключённого к серверу etcd с ревизией 1000, начнёт с ревизии 1000. Наблюдатель клиента, подключённого через прокси gRPC, может начать с ревизии 990.
Аналогичные ограничения относятся к отмене. При отмене наблюдателя ревизия сервера etcd может превышать ревизию ответа на отмену.
В большинстве сценариев эти два ограничения не должны создавать проблем. В будущем могут появиться дополнительные параметры, принудительно направляющие наблюдателя в обход прокси gRPC для получения более точных ревизий в ответах.
Масштабируемый API аренды
Чтобы поддерживать аренды активными, клиент должен установить как минимум один поток gRPC к серверу etcd для отправки периодических сигналов активности. Если рабочая нагрузка etcd включает интенсивную работу с арендами, распределённую между множеством клиентов, эти потоки могут приводить к чрезмерной загрузке CPU. Чтобы сократить общее количество потоков в основном кластере, прокси поддерживает объединение потоков аренды.
Если N клиентов обновляют аренды, один прокси gRPC снижает потоковую нагрузку на сервер etcd с N до 1. В развёртывании можно использовать дополнительные прокси gRPC, чтобы распределить потоки между несколькими прокси.
В следующем примере три клиента обновляют три независимые аренды (L1, L2 и L3). Прокси gRPC объединяет три клиентских потока аренды (c-streams) в один поток поддержания аренды активной (s-stream), подключённый к серверу etcd. Прокси пересылает сигналы активности аренды с клиентской стороны из c-streams в s-stream, а затем возвращает ответы соответствующим c-streams.
Защита от злоупотребляющих клиентов
Прокси gRPC кэширует ответы на запросы, когда это не нарушает требований согласованности. Так сервер etcd можно защитить от злоупотребляющих клиентов с плотными циклами for.
Запуск прокси gRPC etcd
Рассмотрим кластер etcd со следующими статическими конечными точками:
| Имя | Адрес | Имя узла |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Запустите прокси gRPC etcd для использования этих статических конечных точек следующей командой:
Прокси gRPC etcd запускается и слушает порт 2379. Он пересылает клиентские запросы одной из трёх указанных выше конечных точек.
Отправка запросов через прокси:
Синхронизация клиентских конечных точек и разрешение имён
Прокси поддерживает регистрацию своих конечных точек для обнаружения путём записи в заданную пользователем конечную точку. Это решает две задачи. Во-первых, клиенты могут синхронизировать свои конечные точки с набором конечных точек прокси для высокой доступности. Во-вторых, прокси становится поставщиком конечных точек для разрешения имён gRPC в etcd.
Зарегистрируйте прокси, указав определённый пользователем префикс:
В списке участников прокси перечислит всех своих участников:
Это позволяет клиентам автоматически обнаруживать конечные точки прокси через Sync:
Обратите внимание: если прокси настроен без префикса разрешения,
API списка участников прокси grpc-proxy возвращает его собственный advertise-client-url:
Пространства имён
Предположим, приложению нужен полный контроль над всем пространством ключей, однако кластер etcd используется совместно с другими приложениями. Чтобы все приложения могли работать, не мешая друг другу, прокси может разделить пространство ключей etcd так, чтобы клиентам казалось, что они имеют доступ ко всему пространству. Если прокси передан флаг --namespace, все поступающие в него клиентские запросы преобразуются: к ключам добавляется заданный пользователем префикс. Обращения к кластеру etcd выполняются под этим префиксом, а прокси удаляет префикс из ответов; для клиента всё выглядит так, будто префикса нет.
Чтобы назначить прокси пространство имён, запустите его с --namespace:
Теперь обращения к прокси прозрачно снабжаются префиксом в кластере etcd:
Терминирование TLS
Терминируйте TLS защищённого кластера etcd с помощью прокси gRPC, обслуживающего незашифрованную локальную конечную точку.
Для проверки запустите одноузловой кластер etcd с клиентским https:
Убедитесь, что клиентский порт обслуживает https:
Затем запустите прокси gRPC на localhost:12379, подключив его к конечной точке etcd https://localhost:2379 с помощью клиентских сертификатов:
Наконец, проверьте терминирование TLS, записав ключ в прокси по http:
Метрики и состояние
Прокси gRPC предоставляет конечные точки /health и Prometheus /metrics для участников etcd, заданных через --endpoints. В качестве альтернативы флагом --metrics-addr можно определить дополнительный URL, отвечающий на запросы к конечным точкам /metrics и /health.
Известная проблема
Основной интерфейс прокси обслуживает как HTTP2, так и HTTP/1.1. Если прокси настроен с TLS, как в примере выше, при обращении к слушающему интерфейсу клиентом наподобие cURL для получения /metrics или /health потребуется явно указать в запросе протокол HTTP/1.1. При использовании флага --metrics-addr вторичный интерфейс этого не требует.
14.11 - Рекомендации по оборудованию
Для разработки и тестирования etcd обычно хорошо работает с ограниченными ресурсами; его часто запускают на ноутбуке или дешёвой облачной машине. Однако для правильной эксплуатации промышленных кластеров полезны рекомендации по оборудованию. Это не строгие правила, а хорошая отправная точка для надёжного развёртывания. Перед вводом в эксплуатацию всегда проверяйте систему с имитацией рабочей нагрузки.
CPU
Немногим развёртываниям etcd требуется большая вычислительная мощность. Типичному кластеру для стабильной работы достаточно от двух до четырёх ядер. Сильно нагруженные развёртывания, обслуживающие тысячи клиентов или десятки тысяч запросов в секунду, обычно ограничены CPU, поскольку etcd может отдавать запросы из памяти. Им, как правило, требуется от восьми до шестнадцати выделенных ядер.
Память
etcd потребляет относительно мало памяти, но производительность всё же зависит от её достаточного объёма. Сервер активно кэширует данные ключей и значений, а большую часть оставшейся памяти использует для отслеживания наблюдателей. Обычно достаточно 8GB. Для тяжёлых развёртываний с тысячами наблюдателей и миллионами ключей выделяйте от 16GB до 64GB в зависимости от нагрузки.
Диски
Быстрые диски — наиболее важный фактор производительности и стабильности etcd.
Медленный диск увеличивает задержку запросов и может нарушить стабильность кластера. Поскольку протокол консенсуса etcd требует постоянной записи метаданных в журнал, большинство участников должно записывать каждый запрос на диск. Кроме того, etcd инкрементно сохраняет контрольные точки состояния, чтобы усекать журнал. Если записи занимают слишком много времени, heartbeat может завершиться по тайм-ауту и вызвать выборы, подрывая стабильность. Проверить достаточную скорость диска можно инструментом вроде fio ; пример приведён здесь .
etcd очень чувствителен к задержке записи. Обычно требуется 50 последовательных IOPS, например от диска 7200 RPM. Для сильно нагруженных кластеров рекомендуется 500 последовательных IOPS, что обеспечивает типичный локальный SSD или высокопроизводительное виртуальное блочное устройство. Большинство облачных провайдеров публикуют параллельные, а не последовательные IOPS; опубликованное значение может быть в 10x раз выше последовательного. Фактические последовательные IOPS измеряйте с помощью diskbench или fio .
etcd требует умеренной пропускной способности диска, но более быстрый диск сокращает восстановление, когда отказавший участник догоняет кластер. Обычно 10MB/s позволяет восстановить 100MB данных за 15 секунд. Для крупных кластеров рекомендуется 100MB/s или больше, чтобы восстановить 1GB за 15 секунд.
По возможности используйте SSD для хранилища etcd. SSD обычно обеспечивает меньшую и более стабильную задержку записи, повышая стабильность и надёжность. Если используются вращающиеся диски, выбирайте самые быстрые, например 15,000 RPM. RAID 0 также эффективно увеличивает скорость как вращающихся дисков, так и SSD. При наличии как минимум трёх участников зеркалирование и варианты RAID с контролем чётности не нужны: согласованная репликация etcd уже обеспечивает высокую доступность.
Сеть
Кластеру etcd из нескольких участников нужна быстрая и надёжная сеть. Чтобы одновременно сохранять согласованность и устойчивость к разделению, в ненадёжной сети с разрывами разделов доступность будет низкой. Малая задержка ускоряет обмен между участниками, а высокая пропускная способность сокращает восстановление отказавшего участника. Для обычного развёртывания достаточно 1GbE; в крупном кластере сеть 10GbE уменьшает среднее время восстановления.
По возможности размещайте участников etcd в одном центре обработки данных, чтобы избежать дополнительной задержки и снизить вероятность разделения сети. Если требуется домен отказа в другом центре, выбирайте ближайший. Развёртывание между центрами также описано в документации по настройке .
Примеры аппаратных конфигураций
Ниже приведено несколько примеров для AWS и GCE. Несмотря на уже сказанное, необходимо ещё раз подчеркнуть: перед промышленной эксплуатацией администраторы должны проверить развёртывание etcd с имитацией нагрузки.
Предполагается, что машины полностью выделены для etcd. Другие приложения могут вызвать конкуренцию за ресурсы и нестабильность кластера.
Малый кластер
Малый кластер обслуживает менее 100 клиентов и 200 запросов в секунду и хранит не более 100MB данных.
Пример нагрузки: кластер Kubernetes из 50 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
Средний кластер
Средний кластер обслуживает менее 500 клиентов и 1,000 запросов в секунду и хранит не более 500MB данных.
Пример нагрузки: кластер Kubernetes из 250 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
Большой кластер
Большой кластер обслуживает менее 1,500 клиентов и 10,000 запросов в секунду и хранит не более 1GB данных.
Пример нагрузки: кластер Kubernetes из 1,000 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
Кластер xLarge
Кластер xLarge обслуживает более 1,500 клиентов и более 10,000 запросов в секунду и хранит более 1GB данных.
Пример нагрузки: кластер Kubernetes из 3,000 узлов
| Провайдер | Тип | vCPU | Память (GB) | Максимальные параллельные IOPS | Пропускная способность диска (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
14.12 - Обслуживание
Обзор
Для сохранения надёжности кластер etcd нуждается в периодическом обслуживании. В зависимости от требований использующего etcd приложения такое обслуживание обычно можно автоматизировать и выполнять без простоя или существенного снижения производительности.
Все операции обслуживания etcd управляют ресурсами хранилища, занятыми пространством ключей etcd. Недостаточный контроль его размера предотвращается квотами дискового пространства: если у участника etcd заканчивается место, квота активирует аварийные сигналы для всего кластера и переводит систему в режим обслуживания с ограниченными операциями. Чтобы не исчерпать место для записи в пространство ключей, его историю необходимо компактизировать. Само дисковое пространство можно освободить дефрагментацией участников etcd. Наконец, регулярное резервное копирование состояния участника с помощью снимков позволяет восстановиться после непреднамеренной логической потери или повреждения данных, вызванных ошибкой эксплуатации.
Хранение журнала Raft
Параметр etcd --snapshot-count задаёт количество применённых записей Raft, которые хранятся в памяти до компактизации. Когда достигается значение --snapshot-count, сервер сначала сохраняет данные снимка на диск, а затем усекает старые записи. Если медленный последователь запрашивает журналы до уже компактизированного индекса, лидер отправляет снимок, вынуждая последователь перезаписать своё состояние.
Большее значение --snapshot-count удерживает больше записей Raft в памяти до создания снимка, тем самым вызывая повторяющееся повышенное потребление памяти
. Поскольку лидер дольше хранит последние записи Raft, у медленного последователя больше времени, чтобы догнать его до создания снимка лидером. Выбор --snapshot-count — компромисс между повышенным потреблением памяти и лучшей доступностью медленных последователей.
Начиная с v3.2 значение --snapshot-count по умолчанию изменено с 10,000 на 100,000
.
С точки зрения производительности значение --snapshot-count больше 100,000 может снизить пропускную способность записи. Большое количество объектов в памяти способно замедлить фазу маркировки Go GC runtime.scanobject
, а редкое освобождение памяти замедляет её выделение. Производительность зависит от рабочей нагрузки и системного окружения. Однако в целом слишком частая компактизация ухудшает доступность кластера и пропускную способность записи. Слишком редкая компактизация также вредна, поскольку создаёт чрезмерную нагрузку на сборщик мусора Go. Дополнительные результаты исследований приведены в материале Understanding Performance Aspects of etcd and Raft
.
Компактизация истории: база данных Key-Value API v3
Поскольку etcd хранит точную историю пространства ключей, её следует периодически компактизировать во избежание снижения производительности и окончательного исчерпания дискового пространства. Компактизация истории пространства ключей удаляет всю информацию о ключах, замещённых до заданной ревизии пространства ключей. Занимавшееся ими место становится доступным для последующих записей.
Пространство ключей можно компактизировать автоматически с помощью политики хранения истории etcd с временным окном либо вручную с помощью etcdctl. Метод etcdctl обеспечивает точное управление процессом компактизации, тогда как автоматическая компактизация подходит приложениям, которым история ключей нужна лишь в течение определённого времени.
Компактизация, инициированная etcdctl, выполняется следующим образом:
Ревизии, предшествующие ревизии компактизации, становятся недоступны:
Автоматическая компактизация
Для автоматической компактизации пространства ключей в etcd можно задать параметры --auto-compaction-mode и --auto-compaction-retention. Существует два режима компактизации: periodic (по умолчанию) и revision.
Периодическая компактизация
Периодическая компактизация сохраняет ограниченное временным окном количество истории пространства ключей:
Значение срока хранения определяет, какой объём истории сохранять. Запись не будет компактизирована примерно до истечения указанного времени с момента создания. Это позволяет медленным наблюдателям успеть наверстать отставание в пределах окна хранения.
Если срок хранения превышает 1 час, etcd выполняет компактизацию каждый час, сохраняя полное окно хранения. Если срок хранения не превышает 1 часа, etcd выполняет компактизацию с интервалом, равным сроку хранения.
Например, с --auto-compaction-retention=10h etcd ждёт 10 часов до первой компактизации, а затем выполняет её каждый час:
Рекомендуемые значения зависят от сценария использования:
- Частые обновления одних и тех же ключей: короткий период, например
1hили30m - Редкие обновления: более длительный период, например
24h,48hили72h - Значение общего назначения по умолчанию:
10h
Компактизация по ревизиям
Компактизация по ревизиям сохраняет фиксированное количество ревизий:
etcd выполняет проверку каждые 5 минут и компактизирует на ревизии "latest revision" - 1000. Например, если последняя ревизия равна 30000, компактизация выполняется на ревизии 29000.
Дефрагментация
После компактизации пространства ключей в базе данных бэкенда может возникнуть внутренняя фрагментация. Внутренне фрагментированное пространство доступно бэкенду, но по-прежнему занимает место в хранилище. Компактизация старых ревизий внутренне фрагментирует etcd, оставляя пустоты в базе данных бэкенда. Это место доступно для использования etcd, но недоступно файловой системе узла. Иными словами, удаление данных приложения не освобождает место на диске.
Дефрагментация возвращает это дисковое пространство файловой системе. Она запускается отдельно для каждого участника, что позволяет избежать всплесков задержки во всём кластере.
Для дефрагментации участника etcd используйте команду etcdctl defrag:
Учтите, что дефрагментация работающего участника блокирует чтение и запись данных в системе на время перестроения его состояния
Учтите, что запрос дефрагментации не реплицируется по кластеру, то есть применяется только к локальному узлу. Укажите всех участников во флаге --endpoints или используйте флаг --cluster, чтобы автоматически найти всех участников кластера.
Выполните дефрагментацию всех конечных точек кластера, связанных с конечной точкой по умолчанию:
Чтобы напрямую дефрагментировать каталог данных etcd при остановленном etcd, используйте команду:
Квота дискового пространства
Квота дискового пространства в etcd обеспечивает надёжную работу кластера. Без неё при чрезмерном росте пространства ключей производительность etcd может ухудшиться либо место в хранилище может полностью закончиться, что приведёт к непредсказуемому поведению кластера. Если база данных бэкенда пространства ключей любого участника превышает квоту, etcd активирует аварийный сигнал для всего кластера и переводит его в режим обслуживания, принимающий только операции чтения и удаления ключей. Возобновить нормальную работу кластер сможет лишь после освобождения достаточного места в пространстве ключей, дефрагментации базы данных бэкенда и сброса аварийного сигнала квоты.
По умолчанию etcd задаёт консервативную квоту дискового пространства, подходящую большинству приложений, однако в командной строке её можно указать в байтах:
Квоту дискового пространства можно активировать с помощью цикла:
Удаление избыточных данных пространства ключей и дефрагментация базы данных бэкенда вернут кластер в пределы квоты:
Метрика etcd_mvcc_db_total_size_in_use_in_bytes показывает фактическое использование базы данных после компактизации истории, а etcd_debugging_mvcc_db_total_size_in_bytes — размер базы данных с учётом свободного места, ожидающего дефрагментации. Вторая метрика увеличивается только тогда, когда первая приближается к ней; следовательно, когда обе метрики близки к квоте, необходимо компактизировать историю, чтобы избежать активации квоты дискового пространства.
Начиная с v3.4, etcd_debugging_mvcc_db_total_size_in_bytes переименована в etcd_mvcc_db_total_size_in_bytes.
Для запроса Put/Txn/LeaseGrant можно получить ошибку ErrGRPCNoSpace, хотя запись в бэкенде окажется успешной. Это возможно потому, что etcd проверяет квоту дискового пространства на уровне API и на внутреннем уровне Apply, причём уровень Apply только активирует аварийный сигнал NOSPACE, не блокируя выполнение транзакции.
Резервное копирование снимка
Регулярное создание снимков кластера etcd обеспечивает долговечную резервную копию пространства ключей etcd. Благодаря периодическим снимкам базы данных бэкенда участника кластер etcd можно восстановить до момента времени с заведомо исправным состоянием.
Снимок создаётся с помощью etcdctl:
14.13 - Мониторинг etcd
Каждый сервер etcd предоставляет локальные сведения мониторинга через конечные точки HTTP на клиентском порту. Эти данные полезны для проверки состояния системы и отладки кластера.
Конечная точка отладки
Если задан --log-level=debug, сервер etcd экспортирует отладочные сведения по
пути /debug на клиентском порту. Используйте --log-level=debug осторожно:
он снижает производительность и включает подробное ведение журнала.
/debug/pprof — стандартная конечная точка профилирования среды выполнения Go.
Она позволяет профилировать использование CPU, кучи, мьютексов и goroutine.
В примере go tool pprof получает 10 функций, на которые etcd тратит больше всего времени:
Конечная точка /debug/requests показывает трассировки gRPC и статистику
производительности в веб-браузере. Например, так выглядит запрос Range для ключа abc:
Конечная точка метрик
Каждый сервер etcd экспортирует метрики по пути /metrics на клиентском порту
и, необязательно, по адресам из --listen-metrics-urls.
Метрики можно получить с помощью curl:
Проверка состояния
Начиная с v3.3.0, все адреса из --listen-metrics-urls отвечают не только через
/metrics, но и через /health. Это полезно, когда стандартная конечная точка
защищена взаимной клиентской аутентификацией TLS, но балансировщику нагрузки или
службе мониторинга всё ещё нужен доступ к проверке состояния.
Начиная с v3.4 добавлены две конечные точки: /livez и /readyz.
/livezпоказывает, работает ли процесс или его необходимо перезапустить;/readyzпоказывает, готов ли процесс обслуживать трафик.
Архитектура конечных точек описана в KEP .
Каждая конечная точка включает несколько отдельных проверок. Параметр verbose
выводит подробности проверок и их состояние, например:
Ответ будет выглядеть примерно так:
API HTTP также позволяет исключать отдельные проверки, например:
Prometheus
Самый простой способ получать и сохранять метрики etcd — запустить службу мониторинга Prometheus .
Сначала установите Prometheus:
Настройте сборщик Prometheus на конечные точки кластера etcd:
Запустите обработчик Prometheus:
Теперь Prometheus будет собирать метрики etcd каждые 10 секунд.
Оповещения
Для кластеров etcd v3 доступен набор стандартных оповещений Prometheus.
Метки job может потребоваться адаптировать к конкретной задаче. Правила рассчитаны на один кластер, поэтому рекомендуется выбирать уникальные для кластера метки.
Grafana
Grafana имеет встроенную поддержку Prometheus; добавьте источник данных Prometheus:
Затем импортируйте стандартный шаблон панели etcd
и настройте его.
Например, если источник данных Prometheus называется my-etcd, поля datasource
в JSON также должны иметь значение my-etcd.
Пример панели:
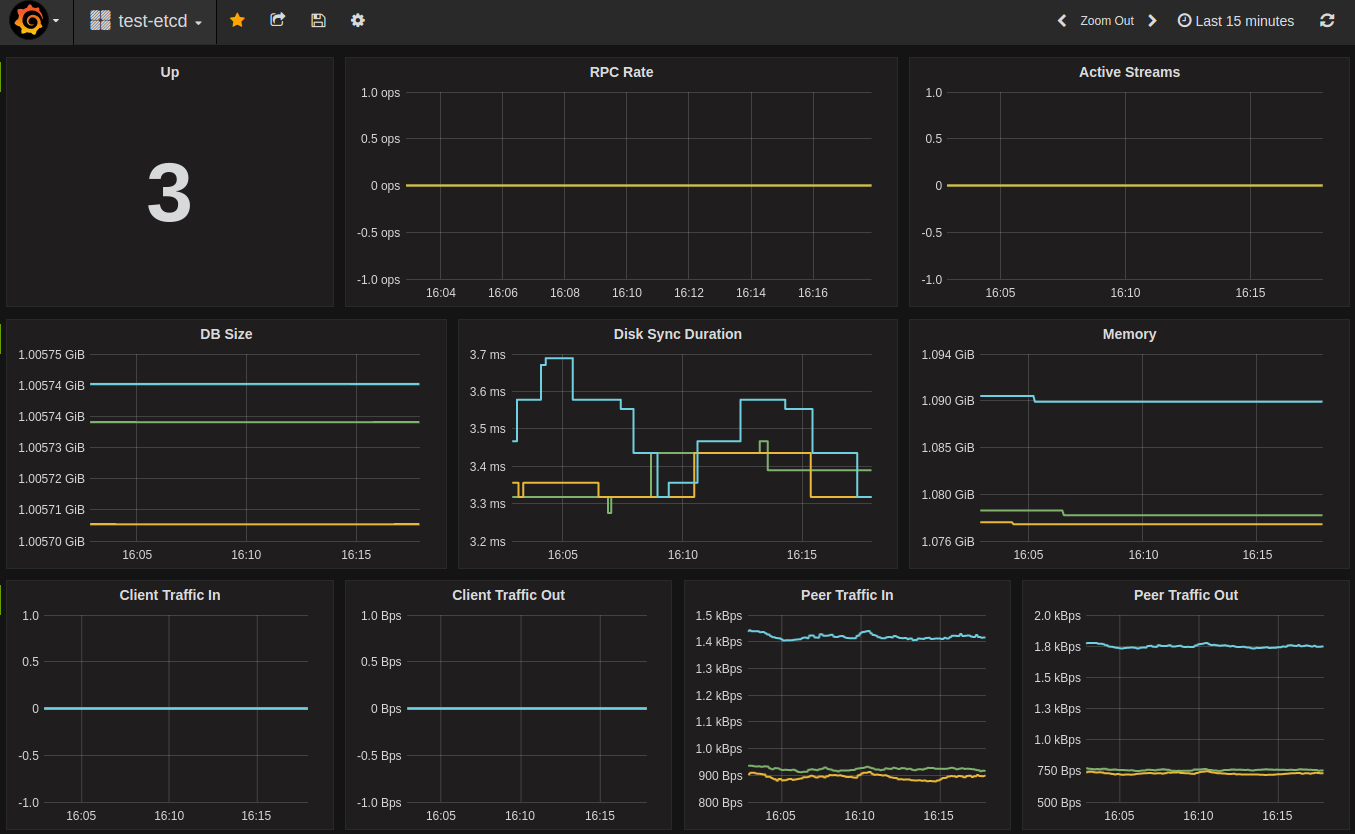
Распределённая трассировка
В v3.5 etcd добавлена распределённая трассировка с помощью OpenTelemetry .
Эта возможность остаётся экспериментальной и может измениться в любое время.
Чтобы включить экспериментальную возможность, передайте серверу etcd
--experimental-enable-distributed-tracing=true и флаг
--experimental-distributed-tracing-sampling-rate=<number>, задающий число
выборок на миллион спанов. Частота выборки по умолчанию — 0.
Настройте распределённую трассировку, запустив сервер etcd со следующими необязательными флагами:
--experimental-distributed-tracing-address- (необязательно) - “localhost:4317” - адрес сборщика трассировок.--experimental-distributed-tracing-service-name- (необязательно) - “etcd” - имя службы распределённой трассировки, одинаковое для всех экземпляров etcd.--experimental-distributed-tracing-instance-id- (необязательно) - идентификатор экземпляра; хотя параметр необязателен, его настоятельно рекомендуется задать уникальным для каждого экземпляра etcd.
Перед включением распределённой трассировки убедитесь, что конечная точка
OpenTelemetry доступна. Если её адрес отличается от стандартного, переопределите
его флагом --experimental-distributed-tracing-address. Варианты запуска
OpenTelemetry описаны в документации сборщика
.
Как и любой сигнал наблюдаемости, эта возможность расходует ресурсы. По первым измерениям дополнительные затраты CPU составляют от 2% - 4%.
14.14 - Производительность
Понимание производительности
etcd обеспечивает стабильную и устойчиво высокую производительность. Её определяют два фактора: задержка и пропускная способность. Задержка — время выполнения одной операции. Пропускная способность — общее число операций, завершённых за определённый период. Обычно средняя задержка растёт вместе с общей пропускной способностью, когда etcd принимает параллельные клиентские запросы. В типичной облачной среде, например на стандартной машине n-4 в Google Compute Engine (GCE) или сопоставимой машине AWS, кластер etcd из трёх участников при небольшой нагрузке завершает запрос менее чем за одну миллисекунду, а при высокой выполняет более 30,000 запросов в секунду.
Для репликации запросов между участниками и достижения соглашения etcd использует алгоритм консенсуса Raft. Производительность консенсуса, особенно задержку фиксации, ограничивают два физических фактора: задержка сетевого и дискового ввода-вывода. Минимальное время выполнения запроса etcd равно времени кругового обхода сети (RTT) между участниками плюс время, необходимое fdatasync для фиксации данных в постоянном хранилище. RTT внутри центра обработки данных может достигать нескольких сотен микросекунд. Типичный RTT в пределах США составляет около 50ms, а между континентами может доходить до 400ms. Типичная задержка fdatasync для вращающегося диска — около 10ms, а для SSD часто меньше 1ms. Чтобы увеличить пропускную способность, etcd объединяет несколько запросов в пакет и передаёт его Raft. Такая политика позволяет сохранять высокую пропускную способность под большой нагрузкой.
На общую производительность etcd влияют и другие подсистемы. Каждый сериализованный запрос etcd проходит через механизм хранения MVCC на основе boltdb, что обычно занимает десятки микросекунд. Периодически etcd создаёт инкрементный снимок недавно применённых запросов и объединяет его с предыдущим снимком на диске. Это может вызвать скачок задержки. На SSD проблема обычно незаметна, но на HDD наблюдаемая задержка может удвоиться. Выполняющаяся компактизация также влияет на производительность etcd. Обычно её влияние незначительно, поскольку компактизация распределена во времени и не конкурирует с обычными запросами за ресурсы. Система RPC gRPC предоставляет etcd чётко определённый расширяемый API, но добавляет задержку, особенно при локальном чтении.
Тесты производительности
Производительность etcd можно измерить инструментом командной строки benchmark , входящим в состав etcd.
В качестве базового примера рассмотрим кластер etcd из трёх участников со следующей аппаратной конфигурацией:
- Google Cloud Compute Engine
- 3 машины: 8 vCPU + 16GB памяти + 50GB SSD
- 1 клиентская машина: 16 vCPU + 30GB памяти + 50GB SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
С такой конфигурацией etcd показывает примерно следующую производительность записи:
| Число ключей | Размер ключа в байтах | Размер значения в байтах | Число соединений | Число клиентов | Целевой сервер etcd | Средний QPS записи | Средняя задержка запроса | Средний RSS сервера |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | только лидер | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | только лидер | 44,341 | 22ms | 124MB |
| 100,000 | 8 | 256 | 100 | 1000 | все участники | 50,104 | 20ms | 126MB |
Примеры команд:
Линеаризуемые запросы чтения проходят через кворум участников кластера, чтобы на основе консенсуса получить самые свежие данные. Сериализуемые запросы дешевле линеаризуемых, поскольку обслуживаются одним участником etcd, а не кворумом, но могут вернуть устаревшие данные. Производительность чтения etcd:
| Число запросов | Размер ключа в байтах | Размер значения в байтах | Число соединений | Число клиентов | Согласованность | Средний QPS чтения | Средняя задержка запроса |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | Линеаризуемая | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | Сериализуемая | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | Линеаризуемая | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | Сериализуемая | 185,758 | 2.2ms |
Примеры команд:
При первой настройке кластера etcd в новом окружении рекомендуется выполнить тест производительности и убедиться, что кластер достигает требуемых показателей: задержка и пропускная способность чувствительны даже к небольшим различиям среды.
14.15 - Устройство реконфигурации во время выполнения
Реконфигурация во время выполнения — одна из самых сложных и подверженных ошибкам возможностей распределённой системы, особенно основанной на консенсусе системы вроде etcd.
Ниже описано устройство команд реконфигурации etcd и способы решения связанных проблем.
Двухфазное изменение конфигурации сохраняет безопасность кластера
В etcd каждая реконфигурация во время выполнения в целях безопасности проходит две фазы . Например, чтобы добавить участника, сначала сообщите кластеру новую конфигурацию, а затем запустите участника.
Фаза 1 — сообщение кластеру новой конфигурации
Чтобы добавить участника в кластер etcd, вызовите API с запросом на его добавление. Это единственный способ добавить нового участника в существующий кластер. Вызов API возвращается после того, как кластер согласует изменение конфигурации.
Фаза 2 — запуск нового участника
Чтобы присоединить нового участника etcd к существующему кластеру, укажите правильный initial-cluster и задайте initial-cluster-state значение existing. При запуске участник сначала связывается с существующим кластером и проверяет, соответствует ли текущая конфигурация ожидаемой, заданной в initial-cluster. После успешного запуска нового участника кластер достигает ожидаемой конфигурации.
Разделение процесса на две отдельные фазы заставляет явно задавать изменения состава кластера. Это даёт больше гибкости и упрощает анализ. Например, попытка добавить в кластер etcd нового участника с тем же ID, что у существующего, немедленно завершится ошибкой на первой фазе и не повлияет на работающий кластер. Аналогичная защита предотвращает случайное добавление участников. Если новый участник etcd попытается присоединиться до принятия кластером изменения конфигурации, кластер его не примет.
Без явной процедуры управления составом etcd был бы уязвим для неожиданных изменений. Например, если etcd работает под управлением системы инициализации вроде systemd, после удаления через API состава systemd перезапустит etcd, и тот при запуске попытается снова войти в кластер. Если systemd настроен перезапускать etcd после сбоя, этот цикл будет повторяться при каждом удалении участника через API, что является неожиданным поведением.
Реконфигурация во время выполнения предполагается редкой операцией. Явная процедура под управлением пользователя обеспечивает безопасность конфигурации и позволяет кластеру стабильно работать под непосредственным контролем.
Безвозвратная потеря кворума требует нового кластера
Если кластер безвозвратно потерял большинство участников, для восстановления предыдущего состояния потребуется запустить новый кластер из старого каталога данных.
Технически можно принудительно удалить отказавших участников из существующего кластера и восстановить его. Однако etcd не поддерживает этот способ, поскольку он обходит обычную фазу фиксации консенсусом и небезопасен. Если удаляемый участник на самом деле не отказал или принудительное удаление выполняется через разных участников одного кластера, получится расходящийся кластер с одинаковым clusterID. Это крайне опасно и впоследствии трудно диагностируется и исправляется.
При правильном развёртывании вероятность безвозвратной потери большинства очень мала. Но последствия достаточно серьёзны и требуют специальной подготовки. Перед вводом etcd в эксплуатацию настоятельно рекомендуется прочитать документацию по аварийному восстановлению и подготовиться к безвозвратной потере большинства.
Не используйте общедоступную службу обнаружения для реконфигурации
Общедоступную службу обнаружения следует применять только для начальной инициализации кластера. Для присоединения участника к существующему кластеру используйте API реконфигурации во время выполнения.
Служба обнаружения предназначена для начальной инициализации кластера etcd в облачной среде, когда IP-адреса всех участников заранее неизвестны. После успешной инициализации они становятся известны, и служба обнаружения технически больше не нужна.
Использование общедоступной службы обнаружения для реконфигурации может показаться удобным, поскольку она уже содержит всю конфигурацию кластера. Однако зависимость от неё создаёт проблемы:
Внешняя зависимость сохраняется на протяжении всего жизненного цикла кластера, а не только во время инициализации. Проблемы сети между кластером и общедоступной службой будут влиять на кластер.
В течение всего жизненного цикла общедоступная служба должна отражать правильную текущую конфигурацию кластера. Ей потребуются механизмы безопасности против вредоносных действий, что сложно реализовать.
Общедоступной службе придётся хранить десятки тысяч конфигураций кластеров. Бэкенд нашей службы не готов к такой нагрузке.
Для поддержки реконфигурации лучше всего создать частную службу обнаружения.
14.16 - Динамическое изменение конфигурации
etcd поддерживает поэтапное изменение конфигурации во время работы, позволяя обновлять состав кластера без остановки.
Запросы изменения конфигурации обрабатываются только при работающем большинстве участников. В производственной среде настоятельно рекомендуется кластер размером более двух. Удалять участника из кластера из двух участников небезопасно: его большинство также равно двум, поэтому ошибка во время удаления может остановить кластер и потребовать перезапуска после потери большинства .
Архитектура описана в документе о динамическом изменении конфигурации .
Сценарии реконфигурации
В этом разделе рассмотрены распространённые причины изменения конфигурации. Обычно это сочетания добавления и удаления участников, описанные в разделе Операции изменения конфигурации кластера .
Поочерёдная замена или обновление машин
Если несколько участников кластера необходимо переместить из-за запланированного обслуживания (обновления аппаратного обеспечения, простоя сети и т. д.), рекомендуется изменять их по одному.
Лидера можно безопасно удалить, но во время выборов возникнет краткий простой. Если кластер содержит более 50MB данных v2, рекомендуется перенести каталог данных участника .
Изменение размера кластера
Увеличение размера кластера может повысить устойчивость к отказам участников и обеспечить лучшую производительность чтения. Поскольку клиенты могут читать из любого участника, увеличение числа участников увеличивает общую серийную пропускную способность чтения.
Уменьшение размера может ускорить запись ценой отказоустойчивости. До фиксации запись реплицируется большинству участников; меньшее большинство подтверждает её быстрее.
Заменить сбойную машину
Машину, отказавшую из-за оборудования, повреждения каталога данных или другой критической причины, следует заменить как можно скорее. Неудалённый отказавший участник ухудшает кворум и снижает устойчивость к следующему отказу.
Для замены удалите участника , затем добавьте нового . Если кластер содержит более 50MB и каталог отказавшего участника доступен, рекомендуется перенести его .
Перезапуск кластера после потери большинства
При потере большинства или изменении IP-адресов всех узлов требуется ручное восстановление: создать новый кластер из старых данных , принудительно назначить одного участника лидером, затем по одному добавить новых участников .
Восстановить кластер после миноритарной ошибки
Потеря отдельного участника эквивалентна замене отказавшей машины; см. Замена отказавшей машины .
Операции перенастройки кластера
Для этих сценариев используются следующие операции.
Перед внесением любых изменений должно быть доступно простое большинство (кворум) участников etcd. Это в сущности то же самое требование для любого вида записи в etcd.
Все изменения в кластере должны выполняться последовательно:
- Чтобы обновить peerURLs одного участника, выполните операцию обновления.
- Чтобы заменить одного исправного участника, удалите старого и добавьте нового.
- Для увеличения с 3 до 5 участников выполните две операции добавления.
- Для уменьшения с 5 до 3 выполните две операции удаления.
Во всех примерах используется поставляемая с etcd утилита etcdctl. Чтобы
изменить состав без etcdctl, используйте HTTP API участников v2
или
gRPC API участников v3
.
Обновление участника
Обновление адресов клиентов для обмена
Для обновления адресов advertise клиентских URL-ов участника достаточно перезапустить этот участник с флагом (--advertise-client-urls) или переменной окружения (ETCD_ADVERTISE_CLIENT_URLS) обновленными клиентскими URL-ами. Перезапущенный участник сам опубликует обновленные URL-ы. Неправильно обновленный клиент (URL) не повлияет на состояние здоровья кластера etcd.
Обновление анонсируемых адресов пеерконтроллеров
Для обновления адресов пеер-членов участника, сначала явно обновите его с помощью команды member, а затем перезапустите участника. Дополнительное действие необходимо, так как обновление адресов пеер-членов изменяет конфигурацию кластера и может повлиять на состояние etcd кластера.
Для обновления объявляемых URL сначала найдите ID участника. Список выводится командой etcdctl:
Пример выполняет update участника с ID a8266ecf031671f3 и задаёт peerURLs
http://10.0.1.10:2380:
Удалить участника
Предположим, что идентификатор участника для удаления — a8266ecf031671f3. Используйте команду remove для выполнения удаления:
Целевой участник остановит себя на этом этапе и выведет удаление в лог:
Было бы безопасно удалить лидера, однако кластер будет неактивен до тех пор, пока не будет выбран новый лидер. Этот период составляет обычно сумму тайм-аута выборов и процесса голосования.
Добавление нового участника
Добавление участника является двухэтапным процессом:
- Добавьте участника через HTTP API участников
, gRPC API участников
или
etcdctl member add. - Запустите его с новой конфигурацией кластера и обновлённым списком участников (существующие + новый).
etcdctl добавляет участника по его имени
и
объявляемым URL однорангового узла
:
etcdctl уведомил кластер о новом участнике и вывел переменные окружения, необходимые для успешного запуска. Теперь запустите новый процесс etcd с соответствующими флагами для нового участника:
Новый участник будет функционировать как часть кластера и немедленно начнет синхронизироваться с остальными участниками кластера.
При добавлении нескольких участников настраивайте их по одному и проверяйте
запуск. После добавления участника в кластер из 1 узла кластер не продвигается,
пока новый участник не запустится: для консенсуса теперь нужно большинство из
двух. Пауза длится от etcdctl member add до успешного соединения нового участника.
Добавление нового участника как обучающегося
Начиная с v3.4 etcd поддерживает добавление обучающегося участника без права голоса. Мотивация и дизайн можно найти в документе по дизайну . Чтобы сделать процесс добавления нового участника безопаснее, и снизить время простоя кластера при добавлении нового участника, рекомендуется добавлять новый участник в кластер как обучающийся до тех пор, пока он не синхронизируется. Это можно описать как трехступенчатый процесс:
Добавьте новый участник как обучающийся участника через gRPC members API или команду
etcdctl member add --learner.Запустите нового участника с новой конфигурацией и обновлённым списком участников (существующие + новый). Этот шаг не отличается от описанного выше.
Промотировать новый добавленный обучающийся до участника с правом голоса через gRPC members API или командой
etcdctl member promote. сервер etcd проверяет запрос на промотацию для обеспечения его оперативной безопасности. Только после того как лог raft обучающегося участника захватит лог лидера, он может быть промовирован до участника с правом голоса. Если обучающийся участник не захватил лог лидера, запрос на промотацию участника завершится неудачей (см. раздел об ошибках при промотации участника для получения дополнительной информации). В этом случае пользователь должен подождать и повторить попытку позже.
В v3.4 сервер etcd ограничивает количество обучающихся участников, которые может иметь кластер, одним. Основное соображение заключается в ограничении дополнительной нагрузки на лидера при распространении данных от лидера к обучающемуся участнику.
Используйте etcdctl member add с флагом --learner для добавления нового участника в кластер как обучающегося участника.
После запуска нового процесса etcd для нового добавленного обучающегося участника используйте etcdctl member promote для повышения обучающегося участника до голосующего участника.
Случаи ошибок при добавлении участников
В следующем случае новый хост не включается в список перечисленных узлов. Если это новый кластер, узел должен быть добавлен в список исходных участников кластера.
В этом случае используйте другую адресацию (10.0.1.14:2380), отличную от той, которая была использована для присоединения к кластеру (10.0.1.13:2380):
Если etcd начинает использовать данные из директории данных удаленного участника, etcd автоматически завершает работу, если он подключается к любому активному участнику в кластере:
Ошибки при добавлении обучающегося участника
Нельзя добавить обучающегося участника в кластер, если кластер уже имеет 1 обучающегося участника (v3.4).
Ошибки при повышении обучающегося участника до участника
Обучающегося можно повысить до голосующего участника только после синхронизации с лидером.
Повышение участника, который не является обучающимся, завершится ошибкой.
Повышение отсутствующего в кластере участника завершится ошибкой.
Тщательный режим проверки строгой реконфигурации (-strict-reconfig-check)
Как описано выше, лучшая практика добавления новых участников заключается в настройке одного участника за раз и проверке того, что он стартует корректно, прежде чем добавлять новые участники. Этот пошаговый подход очень важен, так как если новый участник не настроен правильно (например, URL-адреса коллегиальных узлов неверны), кластер может потерять кворум. Потеря кворума происходит, так как новый участник учитывается в кворуме даже если он недоступен из других существующих участников. Также потеря кворума может произойти при проблемах с связностью или при операционных проблемах.
Для предотвращения проблемы etcd предоставляет -strict-reconfig-check.
С этим параметром etcd отклоняет изменение конфигурации, если число запущенных
участников станет меньше кворума нового состава.
По умолчанию включено.
14.17 - Поддерживаемые платформы
Уровни поддержки
etcd работает на разных платформах, однако предоставляемые гарантии зависят от уровня поддержки платформы:
- Уровень 1: полностью поддерживается сопровождающими etcd ; гарантируется прохождение всех тестов, включая функциональные тесты и тесты надёжности.
- Уровень 2: гарантируется прохождение интеграционных и сквозных тестов, но не обязательно функциональных тестов или тестов надёжности.
- Уровень 3: гарантируется успешная сборка; тестирование может быть минимальным или отсутствовать, поэтому платформу следует считать нестабильной.
Текущая поддержка
В следующей таблице перечислены поддерживаемые платформы и соответствующие уровни поддержки etcd:
| Архитектура | Операционная система | Уровень поддержки | Сопровождающие |
|---|---|---|---|
| AMD64 | Linux | 1 | сопровождающие etcd |
| ARM64 | Linux | 1 | сопровождающие etcd |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Платформы, отсутствующие в таблице, не поддерживаются.
Поддержка новой платформы
Хотите участвовать в etcd как «официальный» сопровождающий новой платформы? Помимо обязательства поддерживать платформу, необходимо настроить непрерывную интеграцию (CI) etcd, удовлетворяющую требованиям соответствующего уровня:
| Непрерывная интеграция etcd | Уровень 1 | Уровень 2 | Уровень 3 |
|---|---|---|---|
| Сборка проходит | ✓ | ✓ | ✓ |
| Модульные тесты проходят | ✓ | ✓ | |
| Интеграционные и сквозные тесты проходят | ✓ | ✓ | |
| Тесты надёжности проходят | ✓ |
Пример настройки CI уровня 2 для ARM64 приведён в etcd PR #12928 .
Неподдерживаемые платформы
Чтобы сервер etcd не был случайно запущен на неподдерживаемой платформе, etcd
выводит предупреждение и немедленно завершает работу, если переменная окружения
ETCD_UNSUPPORTED_ARCH не содержит целевую архитектуру.
32-bit системы В etcd существуют известные проблемы на 32-bit системах из-за ошибки в среде выполнения Go. Дополнительные сведения приведены в issue Go #599 и примечании об ошибке пакета atomic .
14.18 - Версионирование
Данный документ описывает версии, поддерживаемые проектом etcd.
Версионирование сервиса и поддерживаемые версии
Версии etcd выражаются как x.y.z, где x — мажорная версия, y — минорная версия, а z — версия исправления, в соответствии с терминологией Semantic Versioning
.
Новые минорные версии могут добавлять дополнительные функции в API.
Проект etcd поддерживает ветки релизов для текущей версии и предыдущего выпуска. Например, когда v3.5 является текущей версией, поддерживается v3.4. Когда выпускается v3.6, v3.4 прекращает поддержку.
Исправления, включая исправления уязвимостей, могут быть перенесены в эти два ветвления выпусков в зависимости от серьезности и реализуемости. Патч-релизы выпускаются из этих ветвлений по мере необходимости.
Команда разработчиков Maintainers несёт ответственность за это решение.
Вы можете проверить версию работающего кластера etcd с помощью etcdctl:
API версионирование
Ответы v3 API не должны изменяться после выпуска 3.0.0, но со временем будут добавляться новые функции.
14.19 - Повреждение данных
В etcd встроено автоматическое обнаружение повреждения данных, предотвращающее расхождение состояния участников.
Включение обнаружения повреждения данных
Повреждение данных можно обнаруживать с помощью:
- Начальной проверки, включаемой флагом
--experimental-initial-corrupt-check. - Периодической проверки:
- Хеша сжатой ревизии, включаемой флагом
--experimental-compact-hash-check-enabled. - Хеша последней ревизии, включаемой флагом
--experimental-corrupt-check-time.
- Хеша сжатой ревизии, включаемой флагом
Начальная проверка выполняется при начальной инициализации участника etcd. Участник сравнивает своё постоянное состояние с другими участниками и завершает работу при несовпадении.
Обе периодические проверки выполняются лидером уже работающего кластера. Лидер сравнивает своё постоянное состояние с другими участниками и при несовпадении подаёт аварийный сигнал CORRUPT. Обе проверки решают одну задачу, однако для баланса между производительностью и временем обнаружения стоит включить обе.
- Проверка хеша сжатой ревизии — требует регулярной компактизации, имеет минимальную стоимость и работает с медленными последователями.
- Проверка хеша последней ревизии — имеет высокую стоимость и не работает с медленными последователями или частой компактизацией.
Проверка хеша сжатой ревизии
Если проверка включена флагом --experimental-compact-hash-check-enabled, она выполняется раз в минуту.
Период можно изменить флагом --experimental-compact-hash-check-time в формате: 1m — раз в минуту, 1h — раз в час.
Проверка расширяет компактизацию вычислением контрольной суммы, которую можно сравнить между участниками кластера.
Дополнительное сканирование базы данных не выполняется, поэтому стоимость проверки очень мала, но кластеру требуется регулярная компактизация.
Проверка хеша последней ревизии
Проверка включается флагом --experimental-corrupt-check-time; необходимо указать период выполнения в формате: 1m — раз в минуту, 1h — раз в час.
Из-за высокой стоимости рекомендуется период в несколько часов.
Для проверки вычисляется контрольная сумма путём сканирования всего содержимого etcd на заданной ревизии.
Восстановление повреждённого участника
Повреждённого участника можно восстановить тремя способами:
- Очистить постоянное состояние участника
- Заменить участника
- Восстановить весь кластер
После восстановления повреждённого участника аварийный сигнал CORRUPT можно удалить.
Очистка постоянного состояния участника
Состояние участника можно очистить следующим образом:
- Остановите экземпляр etcd.
- Создайте резервную копию каталога данных etcd.
- Переместите подкаталог
snapиз каталога данных etcd. - Запустите
etcdс--initial-cluster-state=existingи списком участников кластера в--initial-cluster.
После этого участник etcd должен загрузить актуальный снимок у лидера.
Замена участника
Участника можно заменить следующим образом:
- Остановите экземпляр etcd.
- Создайте резервную копию каталога данных etcd.
- Удалите каталог данных.
- Удалите участника из кластера командой
etcdctl member remove. - Добавьте его обратно командой
etcdctl member add. - Запустите
etcdс--initial-cluster-state=existingи списком участников кластера в--initial-cluster.
Восстановление всего кластера
Кластер можно восстановить, сохранив снимок текущего лидера и восстановив его на всех участниках.
Выполните etcdctl snapshot save для лидера и следуйте процедуре восстановления кластера
.
15 - Тестирование производительности
Тестирование производительности
Бенчмарки etcd будут регулярно публиковаться и отслеживаться для каждого выпуска ниже:
Тесты производительности использования памяти
Он фиксирует ожидаемое использование памяти в различных сценариях.
15.1 - Тестирование использования памяти хранилищем
Физическую память потребляют два компонента хранилища etcd. Для ускорения поиска ключей процесс etcd выделяет индекс в памяти. Управляемый операционной системой страничный кеш процесса хранит недавно прочитанные с диска данные для быстрого повторного использования.
Индекс в памяти хранит все ключи в структуре данных B-tree вместе с указателями на данные на диске — значения. Каждый ключ в B-tree может содержать несколько указателей на разные версии значения. Поэтому теоретическое потребление памяти индексом можно приблизительно оценить формулой:
N * (c1 + avg_key_size) + N * (avg_versions_of_key) * (c2 + size_of_pointer)
где c1 — накладные расходы метаданных ключа, а c2 — накладные расходы метаданных версии.
На схеме показана подробная структура B-tree индекса в памяти.
Память страничного кеша управляется операционной системой и подробно в этом документе не рассматривается.
Среда тестирования
Версия etcd
Тип машины GCE n1-standard-2
- 7.5 GB памяти
- 2x CPU
Использование памяти индексом в памяти
В этом тесте измеряется только потребление памяти индексом. Цель — найти упомянутые выше c1 и c2 и понять жёсткий предел потребления памяти хранилищем.
Потребление вычисляется с помощью Go runtime.ReadMemStats как разница общего числа выделенных байтов до и после создания индекса. Это не идеально отражает память самого индекса, но показывает приблизительный характер потребления.
| N | версии | размер ключа | использование памяти |
|---|---|---|---|
| 100K | 1 | 64bytes | 22MB |
| 100K | 5 | 64bytes | 39MB |
| 1M | 1 | 64bytes | 218MB |
| 1M | 5 | 64bytes | 432MB |
| 100K | 1 | 256bytes | 41MB |
| 100K | 5 | 256bytes | 65MB |
| 1M | 1 | 256bytes | 409MB |
| 1M | 5 | 256bytes | 506MB |
По результатам можно вычислить c1=120bytes и c2=30bytes. Для этого достаточно двух наборов данных, поскольку c1 и c2 — единственные неизвестные переменные в формуле. Значения c1=120bytes и c2=30bytes являются средними по 4 вычисленным наборам c1 и c2. Для небольших пар «ключ — значение» накладные расходы метаданных ключа всё ещё заметны (50%). Тем не менее это значительно лучше старого хранилища, где накладные расходы составляли не менее 1000%.
Общее использование памяти
Общее использование памяти показывает, сколько RSS потребляет etcd вместе с хранилищем. Размер значения почти не должен влиять на общее потребление памяти etcd, поскольку значения хранятся на диске, а в памяти остаются только горячие значения под управлением страничного кеша ОС.
| N | версии | размер ключа | размер значения | использование памяти |
|---|---|---|---|---|
| 100K | 1 | 64bytes | 256bytes | 40MB |
| 100K | 5 | 64bytes | 256bytes | 89MB |
| 1M | 1 | 64bytes | 256bytes | 470MB |
| 1M | 5 | 64bytes | 256bytes | 880MB |
| 100K | 1 | 64bytes | 1KB | 102MB |
| 100K | 5 | 64bytes | 1KB | 164MB |
| 1M | 1 | 64bytes | 1KB | 587MB |
| 1M | 5 | 64bytes | 1KB | 836MB |
Результаты показывают, что размер значения не оказывает существенного влияния на потребление памяти. Небольшой рост связан с увеличением объёма данных в страничном кеше ОС.
15.2 - Тестирование использования памяти наблюдателями
Возможности наблюдения активно развиваются, поэтому потребление памяти может меняться. Мы не ожидаем, что оно значительно превысит приведённые ниже значения.
Одна из основных целей etcd — поддерживать очень большое число наблюдателей, выполняющих огромное количество наблюдений. etcd стремится поддерживать O(10k) клиентов, O(100K) потоков наблюдения (O(10) потоков на клиента) и O(10M) наблюдений в сумме (O(100) наблюдений на поток). На каждое отдельное наблюдение приходится наибольшая часть общего потребления памяти etcd, поэтому именно оно находится в центре текущей и будущей оптимизации.
Физическую память потребляют три связанных компонента наблюдения etcd: каждый grpc.Conn, каждый поток наблюдения и каждый экземпляр операции наблюдения. grpc.Conn поддерживает фактическое TCP-соединение и другое состояние соединения gRPC. Каждый grpc.Conn потребляет O(10kb) памяти и может обслуживать несколько потоков наблюдения.
Каждый поток наблюдения является независимым HTTP2-соединением и потребляет ещё O(10kb) памяти. Несколько наблюдений могут совместно использовать один поток.
Наблюдение — это фактическая структура, отслеживающая изменения в хранилище ключей и значений. Каждое наблюдение должно потреблять менее O(1kb).
Теоретическое потребление памяти наблюдением можно оценить по формуле:
memory = c1 * number_of_conn + c2 * avg_number_of_stream_per_conn + c3 * avg_number_of_watch_stream
Среда тестирования
Версия etcd
Тип машины GCE n1-standard-2
- 7.5 GB памяти
- 2x CPU
Общее использование памяти
Общее использование памяти показывает, сколько RSS потребляет etcd с клиентскими наблюдателями. Результат может различаться на 10%, но всё равно полезен, поскольку цель — определить приблизительное потребление памяти и характер выделений.
По результатам тестирования можно приблизительно вычислить: c1 = 17kb, c2 = 18kb и c3 = 350bytes. Таким образом, каждое дополнительное клиентское соединение потребляет 17kb памяти, каждый дополнительный поток — 18kb, а каждое дополнительное наблюдение — лишь 350bytes. В обычных условиях один сервер etcd способен поддерживать миллионы наблюдений, располагая несколькими GB памяти.
| клиенты | потоков на клиента | наблюдений на поток | всего наблюдений | использование памяти |
|---|---|---|---|---|
| 1k | 1 | 1 | 1k | 50MB |
| 2k | 1 | 1 | 2k | 90MB |
| 5k | 1 | 1 | 5k | 200MB |
| 1k | 10 | 1 | 10k | 217MB |
| 2k | 10 | 1 | 20k | 417MB |
| 5k | 10 | 1 | 50k | 980MB |
| 1k | 50 | 1 | 50k | 1001MB |
| 2k | 50 | 1 | 100k | 1960MB |
| 5k | 50 | 1 | 250k | 4700MB |
| 1k | 50 | 10 | 500k | 1171MB |
| 2k | 50 | 10 | 1M | 2371MB |
| 5k | 50 | 10 | 2.5M | 5710MB |
| 1k | 50 | 100 | 5M | 2380MB |
| 2k | 50 | 100 | 10M | 4672MB |
| 5k | 50 | 100 | 25M | OOM |
15.3 - Тестирование производительности etcd v3
Физические машины
GCE тип машинного оборудования n1-highcpu-2
- 1x выделенный локальный диск SSD, подключённый под /var/lib/etcd
- 1x выделенный медленный диск для ОС
- 1.8 GB памяти
- 2x процессора
- версия etcd 2.2.0
etcd Кластер
1 участник etcd, работающий в режиме демонстрации v3
Тестирование
Используйте инструмент тестирования производительности etcd v3 .
Производительность
чтение одного ключа
| размер ключа в байтах | количество клиентов | чтение QPS | 90-й процентиль задержки (мс) |
|---|---|---|---|
| 256 | 1 | 2716 | 0.4 |
| 256 | 64 | 16623 | 6.1 |
| 256 | 256 | 16622 | 21.7 |
Производительность почти такая же, как и у сервера с пустым обработчиком.
чтение одного ключа после записи
| размер ключа в байтах | количество клиентов | чтение QPS | 90-й процентиль задержки (мс) |
|---|---|---|---|
| 256 | 1 | 2269 | 0.5 |
| 256 | 64 | 13582 | 8.6 |
| 256 | 256 | 13262 | 47.5 |
Производительность при пустом обработчике сервера не страдает от одного оператора put. Следовательно, понижение производительности должно быть вызвано пакетом хранения.
15.4 - Тестирование памяти etcd v2.2.0-rc
Физическая машина
Тип машины GCE n1-standard-2
- 1x выделенный локальный SSD, подключённый в /var/lib/etcd
- 1x выделенный медленный диск для ОС
- 7.5 GB памяти
- 2x CPU
etcd
Тестирование
Запускается кластер etcd из 3 участников, каждый из которых использует 2 ядра.
Длина имени ключа всегда составляет 64 bytes — это разумная средняя длина ключа.
Максимальное использование памяти
- etcd может использовать максимальный объём памяти, если один из последователей недоступен, а лидер продолжает отправлять снимки.
max RSS— максимальный объём используемой памяти, зафиксированный в 3 запусках.
| байт в значении | количество ключей | объём данных (MB) | max RSS (MB) | отношение max RSS к данным на лидере |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
Порог объёма данных
- Когда etcd достигает порогового объёма данных, это может легко вызвать выборы лидера и потерю части предложений.
- В большинстве случаев кластер etcd должен работать стабильно, пока не достигнут порог. Если из-за нехватки ресурсов работа нарушается, уменьшите объём данных.
| байт в значении | ограничение количества ключей | рекомендуемый порог объёма данных (MB) | потребление RSS (MB) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
15.5 - Тестирование производительности etcd v2.2.0-rc
Физическая машина
Тип машины GCE n1-highcpu-2
- 1x выделенный локальный SSD, подключённый в /var/lib/etcd
- 1x выделенный медленный диск для ОС
- 1.8 GB памяти
- 2x CPU
Кластер etcd
3 участника etcd 2.2.0-rc, каждый работает на отдельной машине.
Точные версии:
Кроме того, базовая производительность измеряется на кластере из 3 участников etcd 2.1.0 стадии alpha. Текущий коммит etcd — c7146bd5 , тот же, что использован в тестировании etcd 2.1 .
Тестирование
Запустите ещё одну машину и с помощью инструмента HTTP-тестирования hey отправляйте запросы каждому участнику etcd. Подробные инструкции приведены в руководстве по разработке тестов производительности .
Производительность
чтение одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | QPS чтения | задержка 90-го процентиля (ms) |
|---|---|---|---|---|
| 64 | 1 | только лидер | 2804 (-5%) | 0.4 (+0%) |
| 64 | 64 | только лидер | 17816 (+0%) | 5.7 (-6%) |
| 64 | 256 | только лидер | 18667 (-6%) | 20.4 (+2%) |
| 256 | 1 | только лидер | 2181 (-15%) | 0.5 (+25%) |
| 256 | 64 | только лидер | 17435 (-7%) | 6.0 (+9%) |
| 256 | 256 | только лидер | 18180 (-8%) | 21.3 (+3%) |
| 64 | 64 | все серверы | 46965 (-4%) | 2.1 (+0%) |
| 64 | 256 | все серверы | 55286 (-6%) | 7.4 (+6%) |
| 256 | 64 | все серверы | 46603 (-6%) | 2.1 (+5%) |
| 256 | 256 | все серверы | 55291 (-6%) | 7.3 (+4%) |
запись одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | QPS записи | задержка 90-го процентиля (ms) |
|---|---|---|---|---|
| 64 | 1 | только лидер | 76 (+22%) | 19.4 (-15%) |
| 64 | 64 | только лидер | 2461 (+45%) | 31.8 (-32%) |
| 64 | 256 | только лидер | 4275 (+1%) | 69.6 (-10%) |
| 256 | 1 | только лидер | 64 (+20%) | 16.7 (-30%) |
| 256 | 64 | только лидер | 2385 (+30%) | 31.5 (-19%) |
| 256 | 256 | только лидер | 4353 (-3%) | 74.0 (+9%) |
| 64 | 64 | все серверы | 2005 (+81%) | 49.8 (-55%) |
| 64 | 256 | все серверы | 4868 (+35%) | 81.5 (-40%) |
| 256 | 64 | все серверы | 1925 (+72%) | 47.7 (-59%) |
| 256 | 256 | все серверы | 4975 (+36%) | 70.3 (-36%) |
объяснение изменений производительности
QPS чтения в большинстве сценариев снизился на 5~8%. Причина в том, что etcd записывает метрики хранилища для каждой операции. Эти метрики важны для мониторинга и отладки, поэтому такое снижение приемлемо.
QPS записи на лидер увеличился на 20~30%. Основной цикл Raft и цикл применения записей были разделены, что устранило взаимные блокировки.
QPS записи на все серверы увеличился на 30~80%, поскольку последователи раньше получают последний зафиксированный индекс и быстрее фиксируют предложения.
15.6 - Тестирование производительности etcd v2.2.0
Физические машины
Тип машины GCE n1-highcpu-2
- 1x выделенный локальный SSD, используемый как каталог данных etcd
- 1x выделенный медленный диск для ОС
- 1.8 GB памяти
- 2x CPU
Кластер etcd
3 участника etcd 2.2.0, каждый работает на отдельной машине.
Точные версии:
Тестирование
Запустите ещё одну машину вне кластера etcd и примените инструмент HTTP-тестирования hey
с патчем повторного использования соединений для отправки запросов каждому участнику кластера etcd. Патч и шаги для воспроизведения процедуры приведены в инструкции по тестированию
.
Производительность вычислена по результатам 100 раундов тестирования.
Производительность
Производительность чтения одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | средний QPS чтения | стандартное отклонение QPS чтения | средняя задержка 90-го процентиля (ms) | стандартное отклонение задержки |
|---|---|---|---|---|---|---|
| 64 | 1 | только лидер | 2303 | 200 | 0.49 | 0.06 |
| 64 | 64 | только лидер | 15048 | 685 | 7.60 | 0.46 |
| 64 | 256 | только лидер | 14508 | 434 | 29.76 | 1.05 |
| 256 | 1 | только лидер | 2162 | 214 | 0.52 | 0.06 |
| 256 | 64 | только лидер | 14789 | 792 | 7.69 | 0.48 |
| 256 | 256 | только лидер | 14424 | 512 | 29.92 | 1.42 |
| 64 | 64 | все серверы | 45752 | 2048 | 2.47 | 0.14 |
| 64 | 256 | все серверы | 46592 | 1273 | 10.14 | 0.59 |
| 256 | 64 | все серверы | 45332 | 1847 | 2.48 | 0.12 |
| 256 | 256 | все серверы | 46485 | 1340 | 10.18 | 0.74 |
Производительность записи одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | средний QPS записи | стандартное отклонение QPS записи | средняя задержка 90-го процентиля (ms) | стандартное отклонение задержки |
|---|---|---|---|---|---|---|
| 64 | 1 | только лидер | 55 | 4 | 24.51 | 13.26 |
| 64 | 64 | только лидер | 2139 | 125 | 35.23 | 3.40 |
| 64 | 256 | только лидер | 4581 | 581 | 70.53 | 10.22 |
| 256 | 1 | только лидер | 56 | 4 | 22.37 | 4.33 |
| 256 | 64 | только лидер | 2052 | 151 | 36.83 | 4.20 |
| 256 | 256 | только лидер | 4442 | 560 | 71.59 | 10.03 |
| 64 | 64 | все серверы | 1625 | 85 | 58.51 | 5.14 |
| 64 | 256 | все серверы | 4461 | 298 | 89.47 | 36.48 |
| 256 | 64 | все серверы | 1599 | 94 | 60.11 | 6.43 |
| 256 | 256 | все серверы | 4315 | 193 | 88.98 | 7.01 |
Изменения производительности
Поскольку etcd теперь записывает метрики для каждого вызова API, в большинстве сценариев QPS чтения немного снизился. Это минимальное влияние на производительность признано разумной платой за широкий набор данных для мониторинга и отладки.
QPS записи на лидерах кластера немного увеличился. Основной цикл и циклы применения записей были разделены в логике Raft etcd, что устранило несколько блокировок между ними.
QPS записи на всех участниках значительно увеличился, поскольку последователи теперь раньше получают последний зафиксированный индекс и быстрее фиксируют предложения.
15.7 - Тестирование производительности etcd v2.1.0
Физические машины
Тип машины GCE n1-highcpu-2
- 1x выделенный локальный SSD, подключённый в /var/lib/etcd
- 1x выделенный медленный диск для ОС
- 1.8 GB памяти
- 2x CPU
- etcd версии 2.1.0 alpha
Кластер etcd
3 участника etcd, каждый работает на отдельной машине
Тестирование
Запустите ещё одну машину и с помощью инструмента HTTP-тестирования hey отправляйте запросы каждому участнику etcd. Подробные инструкции приведены в руководстве по разработке тестов производительности .
Производительность
чтение одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | QPS чтения | задержка 90-го процентиля (ms) |
|---|---|---|---|---|
| 64 | 1 | только лидер | 1534 | 0.7 |
| 64 | 64 | только лидер | 10125 | 9.1 |
| 64 | 256 | только лидер | 13892 | 27.1 |
| 256 | 1 | только лидер | 1530 | 0.8 |
| 256 | 64 | только лидер | 10106 | 10.1 |
| 256 | 256 | только лидер | 14667 | 27.0 |
| 64 | 64 | все серверы | 24200 | 3.9 |
| 64 | 256 | все серверы | 33300 | 11.8 |
| 256 | 64 | все серверы | 24800 | 3.9 |
| 256 | 256 | все серверы | 33000 | 11.5 |
запись одного ключа
| размер ключа в байтах | количество клиентов | целевой сервер etcd | QPS записи | задержка 90-го процентиля (ms) |
|---|---|---|---|---|
| 64 | 1 | только лидер | 60 | 21.4 |
| 64 | 64 | только лидер | 1742 | 46.8 |
| 64 | 256 | только лидер | 3982 | 90.5 |
| 256 | 1 | только лидер | 58 | 20.3 |
| 256 | 64 | только лидер | 1770 | 47.8 |
| 256 | 256 | только лидер | 4157 | 105.3 |
| 64 | 64 | все серверы | 1028 | 123.4 |
| 64 | 256 | все серверы | 3260 | 123.8 |
| 256 | 64 | все серверы | 1033 | 121.5 |
| 256 | 256 | все серверы | 3061 | 119.3 |
16 - Обновление
16.1 - Обновление кластеров etcd и приложений
В этом разделе содержатся документы, специфичные для обновления кластеров etcd и приложений.
Политика обновления
Перед обновлением обратите внимание, что etcd поддерживает только следующие два случая обновления:
- Обновление патча: обновление между выпусками патча в рамках одной минорной версии (e.g. 3.7.0 - 3.7.1).
- Минорное обновление: обновление по одной минорной версии за раз (e.g. 3.6 - 3.7). Обновления, пропускающие минорную версию, не поддерживаются и, скорее всего, завершатся неудачно. Обновитесь до последней версии патча перед обновлением до следующей минорной версии.
Обновление кластера etcd v3.x
- Обновление etcd с 3.0 до 3.1
- Обновление etcd с 3.1 до 3.2
- Обновление etcd с 3.2 до 3.3
- Обновление etcd с 3.3 до 3.4
- Обновление etcd с 3.4 до 3.5
- Обновление etcd с 3.5 до 3.6
- Обновление etcd с 3.6 до 3.7
Обновление с etcd v2.3
16.2 - Обновление etcd с v3.5 до v3.6
В общем случае переход с etcd v3.5 на v3.6 можно выполнить как скользящее обновление без простоя:
- поочерёдно останавливать процессы etcd v3.5 и заменять их процессами etcd v3.6
- после запуска всех процессов v3.6 кластеру становятся доступны новые возможности v3.6
До начала обновления прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки обновления
Обновление 3.5
Перед обновлением до 3.6 убедитесь, что все участники 3.5 обновлены до 3.5.32 или более поздней версии
. Корректирующие выпуски с 3.5.24 по 3.5.26 устраняют несколько потенциальных препятствий обновлению; в 3.5.32
добавлен --v2-deprecation=write-only-skip-check, а etcdutl check v2store расширен для проверки не только снимка v2, но и записей WAL.
Хранилище V2
Если флаг --enable-v2 не настроен или равен false, дальнейшие действия не требуются.
Если --enable-v2 настроен, выполните etcdutl check v2store, чтобы проверить наличие в v2store пользовательских данных, не относящихся к составу кластера. Если таких данных нет, флаг можно безопасно удалить. В противном случае обратитесь к руководству по миграции v2
.
Добавленные флаги
Удалённые флаги
Устаревшие флаги
Флаг etcd --experimental-bootstrap-defrag-threshold-megabytes объявлен устаревшим.
Флаг etcd --experimental-compaction-batch-limit объявлен устаревшим.
Флаг etcd --experimental-compact-hash-check-time объявлен устаревшим.
Флаг etcd --experimental-compaction-sleep-interval объявлен устаревшим.
Флаг etcd --experimental-corrupt-check-time объявлен устаревшим.
Флаг etcd --experimental-enable-distributed-tracing объявлен устаревшим.
Флаг etcd --experimental-distributed-tracing-address объявлен устаревшим.
Флаг etcd --experimental-distributed-tracing-instance-id объявлен устаревшим.
Флаг etcd --experimental-distributed-tracing-sampling-rate объявлен устаревшим.
Флаг etcd --experimental-distributed-tracing-service-name объявлен устаревшим.
Флаг etcd --experimental-downgrade-check-time объявлен устаревшим.
Флаг etcd --experimental-max-learners объявлен устаревшим.
Флаг etcd --experimental-memory-mlock объявлен устаревшим.
Флаг etcd --experimental-peer-skip-client-san-verification объявлен устаревшим.
Флаг etcd --experimental-snapshot-catchup-entries объявлен устаревшим.
Флаг etcd --experimental-warning-apply-duration объявлен устаревшим.
Флаг etcd --experimental-warning-unary-request-duration объявлен устаревшим.
Флаг etcd --experimental-watch-progress-notify-interval объявлен устаревшим.
Эквивалентные флаги функций v3.5
эквивалентный флаг функции для etcd --experimental-compact-hash-check-enabled=true
эквивалентный флаг функции для etcd --experimental-initial-corrupt-check=true
эквивалентный флаг функции для etcd --experimental-enable-lease-checkpoint=true
эквивалентный флаг функции для etcd --experimental-enable-lease-checkpoint-persist=true
эквивалентный флаг функции для etcd --experimental-stop-grpc-service-on-defrag=true
эквивалентный флаг функции для etcd --experimental-txn-mode-write-with-shared-buffer=false
Флаги с новыми значениями по умолчанию
Исходное значение флага по умолчанию etcd --snapshot-count=100000
Исходное значение флага по умолчанию etcd --v2-deprecation='not-yet'
Исходное значение флага по умолчанию etcd --discovery-fallback='proxy'
Различия в метриках Prometheus
Контрольные списки обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до v3.6 работающий кластер должен иметь версию v3.5 или более позднюю. Если версия старше v3.5, перед переходом на v3.6 обновитесь до v3.5 .
Кроме того, для плавного скользящего обновления работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать обновление в рабочем окружении.
До начала загрузите резервную копию снимка
. Если при обновлении возникнет проблема, эту копию можно использовать для отката
к существующей версии etcd. Обратите внимание: команда snapshot сохраняет только данные v3.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до v3.6. Участники etcd согласуют между собой общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Откат
Перед обновлением кластера etcd создайте и загрузите его резервную копию снимка . При необходимости снимок позволяет восстановить состояние кластера до обновления. Если во время обновления возникнут проблемы, сначала следует определить и устранить их первопричину. Пока кластер находится в состоянии смешанных версий и хотя бы один участник остаётся на v3.5, можно либо заменить двоичный файл или образ старой версией v3.5, либо непосредственно восстановить кластер из снимка. В таком смешанном состоянии кластер продолжает работать как кластер v3.5, что позволяет откатиться без формальной процедуры понижения версии.
Однако после обновления всех участников до v3.6 кластер считается полностью обновлённым, и откат заменой двоичных файлов больше невозможен. В этом случае восстановиться можно только из снимка, сделанного перед обновлением. Чтобы вернуться к исходной версии после полного обновления, необходимо следовать официальному руководству по понижению версии, обеспечивая согласованность и предотвращая повреждение данных.
Процедура обновления
В этом примере показано обновление работающего на локальной машине кластера etcd v3.5 из 3 участников.
Шаг 1: проверка требований к обновлению
Кластер исправен и использует v3.5.x?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии при возникновении проблем.
Лидер etcd гарантированно содержит последние данные приложения, поэтому снимок следует получать с лидера:
Шаг 3: остановка одного существующего сервера etcd
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
Шаг 4: перезапуск сервера etcd с той же конфигурацией
Перезапустите сервер etcd с прежней конфигурацией, но с новым двоичным файлом etcd.
Новый etcd v3.6 опубликует свои сведения в кластере. На этом этапе кластер всё ещё работает по протоколу v3.5 — наименьшей общей версии.
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.889+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"bf9071f4639c75cc","from":"3.0","to":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.894+0530","caller":"etcdserver/server.go:1686","msg":"published local member to cluster through raft","local-member-id":"bf9071f4639c75cc","local-member-attributes":"{Name:node1 ClientURLs:[http://127.0.0.1:2379]}","cluster-id":"59a05384c9b79ee","publish-timeout":"7s"}
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.6:
До обновления всего кластера необновлённые участники будут записывать в журнал подобные предупреждения.
Это ожидаемо и прекратится после обновления всех участников кластера etcd до v3.6:
Шаг 5: повторение шага 3 и шага 4 для остальных участников
После обновления всех участников кластер сообщит об успешном переходе на v3.6:
Участник 1:
{"level":"info","ts":"2025-03-01T04:58:32.375+0530","caller":"etcdserver/server.go:2149","msg":"updating cluster version using v3 API","from":"3.5","to":"3.6"}{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"etcdserver/server.go:2164","msg":"cluster version is updated","cluster-version":"3.6"}
Участник 2:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"91bc3c398fb3c146","from":"3.5","to":"3.6"}
Участник 3:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"fd422379fda50e48","from":"3.5","to":"3.6"}
16.3 - Обновление etcd с 3.4 до 3.5
В общем случае переход с etcd 3.4 на 3.5 можно выполнить как скользящее обновление без простоя:
- поочерёдно останавливать процессы etcd v3.4 и заменять их процессами etcd v3.5
- после запуска всех процессов v3.5 кластеру становятся доступны новые возможности v3.5
До начала обновления прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки обновления
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается, если etcd восстанавливается из существующих снимков, но файл v3 ETCD_DATA_DIR/member/snap/db отсутствует. Это происходит, когда сервер был перенесён с v2 и ранее не содержал данных v3. Такое поведение также предотвращает случайную потерю данных v3 (например, если файл db перемещён). etcd требует, чтобы после миграции на v3 работа продолжалась только при наличии данных v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данные v3.
Если в кластере включена аутентификация, скользящее обновление с 3.4 или более ранней версии не поддерживается, поскольку 3.5 изменяет формат относящихся к аутентификации записей WAL .
Основные нарушающие совместимость изменения в 3.5.
Устаревшая метрика Prometheus etcd_debugging_mvcc_db_total_size_in_bytes
Чтобы стимулировать мониторинг хранилища etcd, в v3.5 метрика Prometheus etcd_debugging_mvcc_db_total_size_in_bytes переведена в etcd_mvcc_db_total_size_in_bytes. В v3.5 метрика etcd_debugging_mvcc_db_total_size_in_bytes полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Устаревшая метрика Prometheus etcd_debugging_mvcc_put_total
Чтобы стимулировать мониторинг хранилища etcd, в v3.5 метрика Prometheus etcd_debugging_mvcc_put_total переведена в etcd_mvcc_put_total. В v3.5 метрика etcd_debugging_mvcc_put_total полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Устаревшая метрика Prometheus etcd_debugging_mvcc_delete_total
Чтобы стимулировать мониторинг хранилища etcd, в v3.5 метрика Prometheus etcd_debugging_mvcc_delete_total переведена в etcd_mvcc_delete_total. В v3.5 метрика etcd_debugging_mvcc_delete_total полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Устаревшая метрика Prometheus etcd_debugging_mvcc_txn_total
Чтобы стимулировать мониторинг хранилища etcd, в v3.5 метрика Prometheus etcd_debugging_mvcc_txn_total переведена в etcd_mvcc_txn_total. В v3.5 метрика etcd_debugging_mvcc_txn_total полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Устаревшая метрика Prometheus etcd_debugging_mvcc_range_total
Чтобы стимулировать мониторинг хранилища etcd, в v3.5 метрика Prometheus etcd_debugging_mvcc_range_total переведена в etcd_mvcc_range_total. В v3.5 метрика etcd_debugging_mvcc_range_total полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Устаревший etcd --logger capnslog
Для поддержки нескольких направлений вывода и структурированного ведения журнала v3.4 по умолчанию использует --logger=zap.
etcd --logger=capnslog объявлен устаревшим в v3.5, а теперь по умолчанию используется --logger=zap.
В v3.4 добавлена поддержка etcd --logger=zap для структурированного ведения журнала и нескольких направлений вывода. Основная цель — содействовать автоматизированному мониторингу etcd вместо просмотра серверных журналов уже после начала сбоя. В дальнейшем etcd будет записывать как можно меньше сообщений, а его мониторинг с помощью метрик и оповещений станет проще. etcd --logger=capnslog будет объявлен устаревшим в v3.5.
Устаревший etcd --log-output
Для поддержки нескольких направлений вывода журнала в v3.4 etcd --log-output переименован в --log-outputs
.
etcd --log-output объявлен устаревшим в v3.5.
Устаревший флаг etcd --debug (теперь --log-level=debug)
Флаг etcd --debug объявлен устаревшим.
Устаревший etcd --log-package-levels
Флаг etcd --log-package-levels для capnslog объявлен устаревшим.
Теперь по умолчанию используется etcd --logger=zap.
Устаревшая конечная точка [CLIENT-URL]/config/local/log
Конечная точка /config/local/log, как и флаг etcd --log-package-levels, объявляется устаревшей в v3.5.
Изменённые конечные точки HTTP шлюза gRPC (устаревшая /v3beta)
До
После
/v3beta удалена в выпуске 3.5.
Контрольные списки обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.5 работающий кластер должен иметь версию 3.4 или более позднюю. Если версия старше 3.4, перед переходом на 3.5 обновитесь до 3.4 .
Кроме того, для плавного скользящего обновления работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать обновление в рабочем окружении.
До начала загрузите резервную копию снимка
. Если при обновлении возникнет проблема, эту копию можно использовать для понижения версии
до существующей версии etcd. Обратите внимание: команда snapshot сохраняет только данные v3. О данных v2 см. раздел резервное копирование хранилища v2
.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до 3.5. Участники etcd согласуют между собой общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Ограничения
Примечание: это ограничение не относится к кластеру, содержащему только данные v3 и не содержащему данные v2.
Если кластер обслуживает набор данных v2 объёмом более 50MB, каждому только что обновлённому участнику может потребоваться до двух минут, чтобы догнать существующий кластер. Для оценки общего объёма данных проверьте размер недавнего снимка. Иными словами, безопаснее всего ждать 2 минуты между обновлениями участников.
При значительно большем общем объёме данных, 100MB или более, этот однократный процесс может занять ещё больше времени. Администраторы столь крупных кластеров etcd могут перед обновлением обратиться к команде etcd за рекомендациями по процедуре.
Понижение версии
После обновления всех участников до v3.5 кластер также переходит на v3.5, и понижение версии из этого завершённого состояния невозможно. Однако пока хотя бы один участник остаётся на v3.4, кластер и его операции имеют версию “v3.4”, а из смешанного состояния можно вернуться к использованию двоичного файла etcd v3.4 на всех участниках.
Загрузите резервную копию снимка , чтобы сохранить возможность понижения версии кластера даже после полного обновления.
Процедура обновления
В этом примере показано обновление работающего на локальной машине кластера etcd v3.4 из 3 участников.
Шаг 1: проверка требований к обновлению
Кластер исправен и использует v3.4.x?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии при возникновении проблем.
Лидер etcd гарантированно содержит последние данные приложения, поэтому снимок следует получать с лидера:
Шаг 3: остановка одного существующего сервера etcd
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
Шаг 4: перезапуск сервера etcd с той же конфигурацией
Перезапустите сервер etcd с прежней конфигурацией, но с новым двоичным файлом etcd.
Новый etcd v3.5 опубликует свои сведения в кластере. На этом этапе кластер всё ещё работает по протоколу v3.4 — наименьшей общей версии.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.4"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.5:
До обновления всего кластера необновлённые участники будут записывать в журнал подобные предупреждения.
Это ожидаемо и прекратится после обновления всех участников кластера etcd до v3.5:
Шаг 5: повторение шага 3 и шага 4 для остальных участников
После обновления всех участников кластер сообщит об успешном переходе на 3.5:
Участник 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.5"}
Участник 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
Участник 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
16.4 - Обновление etcd с 3.3 до 3.4
В общем случае переход с etcd 3.3 на 3.4 можно выполнить как скользящее обновление без простоя:
- поочерёдно останавливать процессы etcd v3.3 и заменять их процессами etcd v3.4
- после запуска всех процессов v3.4 кластеру становятся доступны новые возможности v3.4
До начала обновления прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки обновления
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается, если etcd восстанавливается из существующих снимков, но файл v3 ETCD_DATA_DIR/member/snap/db отсутствует. Это происходит, когда сервер был перенесён с v2 и ранее не содержал данных v3. Такое поведение также предотвращает случайную потерю данных v3 (например, если файл db перемещён). etcd требует, чтобы после миграции на v3 работа продолжалась только при наличии данных v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данные v3.
Основные нарушающие совместимость изменения в 3.4.
Использование ETCDCTL_API=3 etcdctl по умолчанию
Теперь ETCDCTL_API=3 используется по умолчанию.
Использование etcd --enable-v2=false по умолчанию
Теперь etcd --enable-v2=false
используется по умолчанию.
Это означает, что без явного etcd --enable-v2=true сервер etcd v3.4 не обслуживает запросы API v2.
Если использовался API v2, обязательно включите API v2 в v3.4:
Остальные API HTTP продолжат работать (например, [CLIENT-URL]/metrics, [CLIENT-URL]/health и шлюз gRPC v3).
Устаревшие флаги etcd --ca-file и etcd --peer-ca-file
Флаги --ca-file и --peer-ca-file устарели; они объявлены устаревшими начиная с v2.1.
Обратите внимание: задание этого параметра автоматически включает аутентификацию по клиентскому сертификату независимо от значения --client-cert-auth.
Устаревшая ошибка grpc.ErrClientConnClosing
grpc.ErrClientConnClosing объявлена устаревшей в gRPC >= 1.10
.
Требование grpc.WithBlock для клиентского подключения
Новый клиентский балансировщик
использует асинхронный разрешитель для передачи конечных точек функции подключения gRPC. Поэтому клиенту v3.4 требуется параметр подключения grpc.WithBlock, чтобы дождаться установления нижележащего соединения.
Объявление метрики Prometheus etcd_debugging_mvcc_db_total_size_in_bytes устаревшей
Чтобы стимулировать мониторинг хранилища etcd, в v3.4 метрика Prometheus etcd_debugging_mvcc_db_total_size_in_bytes переведена в etcd_mvcc_db_total_size_in_bytes.
Для обратной совместимости etcd_debugging_mvcc_db_total_size_in_bytes всё ещё предоставляется в v3.4. В v3.5 она будет полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Объявление метрики Prometheus etcd_debugging_mvcc_put_total устаревшей
Чтобы стимулировать мониторинг хранилища etcd, в v3.4 метрика Prometheus etcd_debugging_mvcc_put_total переведена в etcd_mvcc_put_total.
Для обратной совместимости etcd_debugging_mvcc_put_total всё ещё предоставляется в v3.4. В v3.5 она будет полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Объявление метрики Prometheus etcd_debugging_mvcc_delete_total устаревшей
Чтобы стимулировать мониторинг хранилища etcd, в v3.4 метрика Prometheus etcd_debugging_mvcc_delete_total переведена в etcd_mvcc_delete_total.
Для обратной совместимости etcd_debugging_mvcc_delete_total всё ещё предоставляется в v3.4. В v3.5 она будет полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Объявление метрики Prometheus etcd_debugging_mvcc_txn_total устаревшей
Чтобы стимулировать мониторинг хранилища etcd, в v3.4 метрика Prometheus etcd_debugging_mvcc_txn_total переведена в etcd_mvcc_txn_total.
Для обратной совместимости etcd_debugging_mvcc_txn_total всё ещё предоставляется в v3.4. В v3.5 она будет полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Объявление метрики Prometheus etcd_debugging_mvcc_range_total устаревшей
Чтобы стимулировать мониторинг хранилища etcd, в v3.4 метрика Prometheus etcd_debugging_mvcc_range_total переведена в etcd_mvcc_range_total.
Для обратной совместимости etcd_debugging_mvcc_range_total всё ещё предоставляется в v3.4. В v3.5 она будет полностью объявлена устаревшей.
Обратите внимание: метрики пространства имён etcd_debugging_* помечены как экспериментальные. По мере улучшения руководства по мониторингу дополнительные метрики могут становиться стабильными.
Объявление флага etcd --log-output устаревшим (теперь --log-outputs)
Для поддержки нескольких направлений вывода журнала etcd --log-output переименован в --log-outputs
. etcd --logger=capnslog не поддерживает несколько направлений вывода.
etcd --log-output будет объявлен устаревшим в v3.5. etcd --logger=capnslog будет объявлен устаревшим в v3.5.
В v3.4 добавлена поддержка etcd --logger=zap --log-outputs=stderr для структурированного ведения журнала и нескольких направлений вывода. Основная цель — содействовать автоматизированному мониторингу etcd вместо просмотра серверных журналов уже после начала сбоя. В дальнейшем etcd будет записывать как можно меньше сообщений, а его мониторинг с помощью метрик и оповещений станет проще. etcd --logger=capnslog будет объявлен устаревшим в v3.5.
Изменение типа поля log-outputs в etcd --config-file на []string
Поскольку log-outputs (прежнее имя поля — log-output) теперь принимает несколько получателей, тип поля log-outputs в файле конфигурации YAML etcd необходимо изменить на []string, как показано ниже:
Переименование embed.Config.LogOutput в embed.Config.LogOutputs
Для поддержки нескольких направлений вывода embed.Config.LogOutput переименован в embed.Config.LogOutputs
, а тип embed.Config.LogOutput изменён с string на []string
.
В v3.5 capnslog объявляется устаревшим
В v3.5 флаг etcd --log-package-levels для capnslog будет объявлен устаревшим; по умолчанию будет использоваться etcd --logger=zap --log-outputs=stderr. В v3.5 конечная точка [CLIENT-URL]/config/local/log будет объявлена устаревшей.
Объявление флага etcd --debug устаревшим (теперь --log-level=debug)
В v3.4 флаг etcd --debug
объявлен устаревшим. Вместо него используйте etcd --log-level=debug.
Устаревшее поле pkg/transport.TLSInfo.CAFile
Поле pkg/transport.TLSInfo.CAFile объявлено устаревшим.
Изменение embed.Config.SnapCount на embed.Config.SnapshotCount
Для согласованности с именем флага etcd --snapshot-count поле embed.Config.SnapCount переименовано в embed.Config.SnapshotCount:
Изменение etcdserver.ServerConfig.SnapCount на etcdserver.ServerConfig.SnapshotCount
Для согласованности с именем флага etcd --snapshot-count поле etcdserver.ServerConfig.SnapCount переименовано в etcdserver.ServerConfig.SnapshotCount:
Изменение сигнатур функций в пакете wal
Сигнатуры функций wal изменены для поддержки структурированного средства ведения журнала.
Изменение типа IntervalTree в пакете pkg/adt
Теперь pkg/adt.IntervalTree определён как interface.
Устаревший embed.Config.SetupLogging
embed.Config.SetupLogging удалён для предотвращения неверной конфигурации журналирования; теперь она настраивается автоматически.
Изменённые конечные точки HTTP шлюза gRPC (/v3beta заменена на /v3)
До
После
Запросы к конечным точкам /v3beta перенаправляются на /v3, а /v3beta будет удалена в выпуске 3.5.
Устаревшие теги образов контейнеров
Теги образов latest и дополнительной версии объявлены устаревшими:
Контрольные списки обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.4 работающий кластер должен иметь версию 3.3 или более позднюю. Если версия старше 3.3, перед переходом на 3.4 обновитесь до 3.3 .
Кроме того, для плавного скользящего обновления работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать обновление в рабочем окружении.
До начала загрузите резервную копию снимка
. Если при обновлении возникнет проблема, эту копию можно использовать для понижения версии
до существующей версии etcd. Обратите внимание: команда snapshot сохраняет только данные v3. О данных v2 см. раздел резервное копирование хранилища v2
.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до 3.4. Участники etcd согласуют между собой общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Ограничения
Примечание: это ограничение не относится к кластеру, содержащему только данные v3 и не содержащему данные v2.
Если кластер обслуживает набор данных v2 объёмом более 50MB, каждому только что обновлённому участнику может потребоваться до двух минут, чтобы догнать существующий кластер. Для оценки общего объёма данных проверьте размер недавнего снимка. Иными словами, безопаснее всего ждать 2 минуты между обновлениями участников.
При значительно большем общем объёме данных, 100MB или более, этот однократный процесс может занять ещё больше времени. Администраторы столь крупных кластеров etcd могут перед обновлением обратиться к команде etcd за рекомендациями по процедуре.
Понижение версии
После обновления всех участников до v3.4 кластер также переходит на v3.4, и понижение версии из этого завершённого состояния невозможно. Однако пока хотя бы один участник остаётся на v3.3, кластер и его операции имеют версию “v3.3”, а из смешанного состояния можно вернуться к использованию двоичного файла etcd v3.3 на всех участниках.
Загрузите резервную копию снимка , чтобы сохранить возможность понижения версии кластера даже после полного обновления.
Процедура обновления
В этом примере показано обновление работающего на локальной машине кластера etcd v3.3 из 3 участников.
Шаг 1: проверка требований к обновлению
Кластер исправен и использует v3.3.x?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии при возникновении проблем.
Лидер etcd гарантированно содержит последние данные приложения, поэтому снимок следует получать с лидера:
Шаг 3: остановка одного существующего сервера etcd
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
Шаг 4: перезапуск сервера etcd с той же конфигурацией
Перезапустите сервер etcd с прежней конфигурацией, но с новым двоичным файлом etcd.
Новый etcd v3.4 опубликует свои сведения в кластере. На этом этапе кластер всё ещё работает по протоколу v3.3 — наименьшей общей версии.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.3"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.3"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.4:
До обновления всего кластера необновлённые участники будут записывать в журнал подобные предупреждения.
Это ожидаемо и прекратится после обновления всех участников кластера etcd до v3.4:
Шаг 5: повторение шага 3 и шага 4 для остальных участников
После обновления всех участников кластер сообщит об успешном переходе на 3.4:
Участник 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.4"}
Участник 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
Участник 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
16.5 - Обновление etcd с v3.6 до v3.7
В общем случае переход с etcd v3.6 на v3.7 можно выполнить как скользящее обновление без простоя:
- поочерёдно останавливать процессы etcd v3.6 и заменять их процессами etcd v3.7
- после запуска всех процессов v3.7 кластеру становятся доступны новые возможности v3.7
До начала обновления прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки обновления
Обновление 3.6
Перед обновлением до 3.7 убедитесь, что все участники 3.6 обновлены до 3.6.11 или более поздней версии. Предыдущие корректирующие выпуски 3.6 могут быть несовместимы со скользящим обновлением до 3.7.
Хранилище V2
Хранилище v2 полностью удалено в v3.7. HTTP API v2 (--enable-v2), эмуляция v2 поверх v3 (--experimental-enable-v2v3), служба обнаружения v2, пакет client/v2 и загрузка файлов снимков v2 больше не существуют. Ссылки на нарушающие совместимость изменения приведены в CHANGELOG-3.7
.
При обновлении кластера 3.6 эти флаги уже отсутствуют, и никаких действий не требуется. Если переход выполняется со старого выпуска с пользовательскими данными v2, до обновления следуйте руководству по миграции v2 .
Рефакторинг Go
v3.7 содержит значительный внутренний рефакторинг, который не влияет на обычное обновление, но его следует учитывать при обновлении пользовательских интеграций:
- Переход с
gogo/protobufна стандартныйgoogle.golang.org/protobuf(отслеживается в #14533 ). - Переход с устаревших библиотек журналирования и тегов
go-grpc-middlewarev1 на перехватчики v2 (#20420 ). - Перехватчики gRPC OpenTelemetry обновлены до
otelgrpcv0.61.0: устаревшиеUnaryServerInterceptorиStreamServerInterceptorзаменены наNewServerHandler(#20017 ).
Если etcd встраивается как библиотека, приложение собирается с API clientv3 или зависит от внутренних пакетов, перед обновлением изучите CHANGELOG
.
Удалённые флаги
В v3.7 удалены все устаревшие флаги --experimental-* (#19959
). В v3.6 каждый из них был заменён либо одноимённым неэкспериментальным флагом, либо записью --feature-gates. Если какие-либо из этих флагов всё ещё заданы, замените их эквивалентами v3.6 до скользящего обновления до v3.7, иначе процесс v3.7 не запустится.
Соответствие каждого удалённого флага его неэкспериментальному эквиваленту или записи --feature-gates приведено в руководстве по обновлению с v3.5 до v3.6
.
Добавленные флаги
Нет.
Флаги с новыми значениями по умолчанию
Нет.
Контрольные списки обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до v3.7 работающий кластер должен иметь версию v3.6.11 или более позднюю. Если он использует более старую дополнительную версию, сначала обновитесь до v3.6 ; etcd поддерживает обновление только на одну дополнительную версию за раз.
Кроме того, для плавного скользящего обновления работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте службы, зависящие от etcd, в промежуточном окружении, прежде чем развёртывать обновление в рабочем окружении.
До начала загрузите резервную копию снимка . Если при обновлении возникнет проблема, эту копию можно использовать для отката к существующей версии etcd.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до v3.7. Участники etcd согласуют между собой общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Откат
Перед обновлением кластера etcd создайте и загрузите резервную копию снимка . При необходимости этот снимок можно использовать для восстановления состояния кластера до обновления. Если во время обновления возникнут проблемы, пользователям следует сначала определить и устранить их первопричину. Пока кластер остаётся в состоянии смешанных версий и хотя бы один участник работает на v3.6, можно либо заменить двоичный файл или образ старой версией v3.6, либо непосредственно восстановить кластер из снимка. В таком смешанном состоянии кластер продолжает работать как кластер v3.6, что позволяет откатиться без формальной процедуры понижения версии.
Однако после обновления всех участников до v3.7 кластер считается полностью обновлённым, и откат заменой двоичных файлов больше невозможен. В этом случае остаётся только восстановиться из снимка, сделанного перед обновлением, либо при неудачном обновлении следовать официальному руководству по понижению версии .
Процедура обновления
В этом примере показано обновление работающего на локальной машине кластера etcd v3.6 из 3 участников. Приведённый ниже вывод получен при реальном запуске etcd v3.6.12 и etcd v3.7.0-rc.0 на одном узле с тремя портами обратной петли.
Шаг 1: проверка требований к обновлению
Кластер исправен и использует v3.6.11 или более позднюю версию?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии в случае возникновения проблем.
Лидер etcd гарантированно содержит последние данные приложения, поэтому снимок следует получать с лидера:
Шаг 3: остановка одного существующего сервера etcd
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано. Перед завершением лидер передаст лидерство:
Шаг 4: перезапуск сервера etcd с той же конфигурацией
Перезапустите сервер etcd с прежней конфигурацией, но с новым двоичным файлом etcd.
Новый etcd v3.7 опубликует свои сведения в кластере. На этом этапе кластер всё ещё работает по протоколу v3.6 — наименьшей общей версии.
{"level":"info","ts":"2026-06-02T07:01:58.920780+0300","caller":"membership/cluster.go:296","msg":"set cluster version from store","cluster-version":"3.6"}
{"level":"info","ts":"2026-06-02T07:01:58.979186+0300","caller":"etcdserver/server.go:1828","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","cluster-id":"7dee9ba76d59ed53","publish-timeout":"7s"}
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.7:
До обновления всего кластера необновлённые и уже обновлённый участники будут записывать сообщения о состоянии смешанных версий. Это ожидаемо и прекратится после обновления всех участников кластера etcd до v3.7.
Шаг 5: повторение шага 3 и шага 4 для остальных участников
После обновления всех участников кластер сообщит об успешном переходе на v3.7:
{"level":"info","ts":"2026-06-02T07:02:36.054783+0300","caller":"etcdserver/server.go:2311","msg":"updating cluster version using v3 API","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059345+0300","caller":"membership/cluster.go:593","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059409+0300","caller":"etcdserver/server.go:2326","msg":"cluster version is updated","cluster-version":"3.7"}
16.6 - Обновление etcd с 3.2 до 3.3
В общем случае переход с etcd 3.2 на 3.3 можно выполнить как скользящее обновление без простоя:
- поочерёдно останавливать процессы etcd v3.2 и заменять их процессами etcd v3.3
- после запуска всех процессов v3.3 кластеру становятся доступны новые возможности v3.3
До начала обновления прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки обновления
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается, если etcd восстанавливается из существующих снимков, но файл v3 ETCD_DATA_DIR/member/snap/db отсутствует. Это происходит, когда сервер был перенесён с v2 и ранее не содержал данных v3. Такое поведение также предотвращает случайную потерю данных v3, например если файл db перемещён. etcd требует, чтобы после миграции на v3 работа продолжалась только при наличии данных v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данные v3.
Если включена аутентификация и используются аренды с малым ttl, высока вероятность столкнуться с проблемой
, приводящей к несогласованности данных. Настоятельно рекомендуется сначала обновиться до 3.2.31+ для её устранения, а затем до 3.3. Кроме того, если во время обновления пользователь без разрешения отправит запрос LeaseRevoke узлу 3.3, данные всё ещё могут быть повреждены. Перед обновлением лучше убедиться, что в окружении нет таких аномальных вызовов; подробнее см. #11691
.
Основные нарушающие совместимость изменения в 3.3.
Изменение типа значения флага etcd --auto-compaction-retention на string
Флаг --auto-compaction-retention изменён так, чтобы принимать строковые значения
с более высокой точностью
. Поскольку теперь --auto-compaction-retention принимает строки, тип поля auto-compaction-retention в файле конфигурации YAML etcd необходимо изменить на string. Ранее --config-file etcd.config.yaml мог содержать auto-compaction-retention: 24, теперь требуется auto-compaction-retention: "24" или auto-compaction-retention: "24h". При конфигурации --auto-compaction-mode periodic --auto-compaction-retention "24h" значение длительности флага --auto-compaction-retention должно быть допустимо для функции Go time.ParseDuration
.
Изменение etcdserver.EtcdServer.ServerConfig на *etcdserver.EtcdServer.ServerConfig
В etcdserver.EtcdServer тип поля участника изменён с *etcdserver.ServerConfig на etcdserver.ServerConfig. Кроме того, etcdserver.NewServer теперь принимает etcdserver.ServerConfig вместо *etcdserver.ServerConfig.
До и после (например, k8s.io/kubernetes/test/e2e_node/services/etcd.go )
Добавление структуры embed.Config.LogOutput
Обратите внимание: в v3.4 поле переименовано в embed.Config.LogOutputs с типом []string. Подробнее см. руководство по обновлению до v3.4
.
В embed.Config добавлено поле LogOutput:
Ранее предупреждения сервера gRPC записывались в журнал etcdserver.
Начиная с v3.3 журналы сервера gRPC по умолчанию отключены.
Обратите внимание: метод embed.Config.SetupLogging объявлен устаревшим в v3.4. Подробнее см. руководство по обновлению до v3.4
.
Чтобы включить журналы сервера gRPC, задайте полю embed.Config.Debug значение true.
Изменение ответа конечной точки /health
Ранее [endpoint]:[client-port]/health возвращала вручную сериализованное значение JSON. В 3.3 определена структура etcdhttp.Health
.
Обратите внимание: в v3.3.0-rc.0, v3.3.0-rc.1 и v3.3.0-rc.2 структура etcdhttp.Health содержит поля "health" и "errors" логического типа. Для обратной совместимости тип поля "health" возвращён к string, а поле "errors" удалено. Дополнительные сведения о работоспособности будут предоставляться отдельными API.
Изменение конечных точек HTTP шлюза gRPC (/v3alpha заменена на /v3beta)
До
После
Запросы к конечным точкам /v3alpha перенаправляются на /v3beta, а /v3alpha будет удалена в выпуске 3.4.
Изменение ограничений максимального размера запроса
В 3.3 можно настраивать ограничения размера запросов как на стороне сервера, так и на стороне клиента. В предыдущих версиях (v3.2.10, v3.2.11) размер клиентского ответа был ограничен 4 MiB.
Серверное ограничение запросов настраивается флагом --max-request-bytes:
Либо полем embed.Config.MaxRequestBytes:
Если значение не указано, серверное ограничение по умолчанию равно 1.5 MiB.
Клиентские ограничения запросов необходимо настраивать с учётом серверных.
Если значения не указаны, клиентское ограничение отправки по умолчанию равно 2 MiB (1.5 MiB плюс служебные байты gRPC), а ограничение получения — math.MaxInt32. Подробнее см. документацию clientv3
.
Изменение сигнатур функций низкоуровневой оболочки клиента gRPC
В 3.3 изменены сигнатуры функций оболочки клиента gRPC clientv3. Изменение необходимо для поддержки пользовательского grpc.CallOption для ограничений размера сообщений
.
До и после
Изменение типа ошибки API Snapshot в clientv3
Ранее API Snapshot clientv3 возвращал необработанную ошибку типа [grpc/*status.statusError]. В v3.3 такие ошибки преобразуются в соответствующие общедоступные типы для согласованности с другими API.
До
После
Изменение вывода команды etcdctl lease timetolive
Ранее команда lease timetolive LEASE_ID для истёкшей аренды выводила -1s как оставшееся время. В 3.3 сообщения стали понятнее.
До
После
Изменение импортов golang.org/x/net/context
В clientv3 пакет golang.org/x/net/context объявлен устаревшим. Если проект включает golang.org/x/net/context в другой код, например сгенерированный код Protocol Buffer etcd, и импортирует github.com/coreos/etcd/clientv3, для компиляции требуется Go 1.9+.
До
После
Изменение зависимости gRPC
Теперь 3.3 требует grpc/grpc-go
v1.7.5.
Устаревший grpclog.Logger
grpclog.Logger объявлен устаревшим в пользу grpclog.LoggerV2
. Теперь clientv3.Logger — это grpclog.LoggerV2.
До
После
Устаревший grpc.ErrClientConnTimeout
Ранее при истечении тайм-аута клиентского подключения возвращалась ошибка grpc.ErrClientConnTimeout. Вместо неё 3.3 возвращает context.DeadlineExceeded (см. #8504
).
До
После
Изменение официального реестра контейнеров
Теперь etcd использует gcr.io/etcd-development/etcd
как основной реестр контейнеров, а quay.io/coreos/etcd
— как дополнительный.
До
После
Обновления до >= v3.3.14
В v3.3.14 пришлось включить некоторые возможности 3.4, стараясь свести к минимуму различия реализаций клиентского балансировщика. Выпуск исправляет проблему “kube-apiserver 1.13.x refuses to work when first etcd-server is not available” (kubernetes#72102) .
grpc.ErrClientConnClosing объявлена устаревшей в gRPC >= 1.10
.
Новый клиентский балансировщик
использует асинхронный разрешитель для передачи конечных точек функции подключения gRPC. Поэтому v3.3.14
или более поздней версии требуется параметр подключения grpc.WithBlock, чтобы дождаться установления нижележащего соединения.
Полный список изменений приведён в CHANGELOG .
Контрольные списки обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.3 работающий кластер должен иметь версию 3.2 или более позднюю. Если версия старше 3.2, перед переходом на 3.3 обновитесь до 3.2 .
Кроме того, для плавного скользящего обновления работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать обновление в рабочем окружении.
До начала создайте резервную копию данных etcd
. Если при обновлении возникнет проблема, эту копию можно использовать для понижения версии
до существующей версии etcd. Обратите внимание: команда snapshot сохраняет только данные v3. О данных v2 см. раздел резервное копирование хранилища v2
.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до 3.3. Участники etcd согласуют между собой общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Ограничения
Примечание: это ограничение не относится к кластеру, содержащему только данные v3 и не содержащему данные v2.
Если кластер обслуживает набор данных v2 объёмом более 50MB, каждому только что обновлённому участнику может потребоваться до двух минут, чтобы догнать существующий кластер. Для оценки общего объёма данных проверьте размер недавнего снимка. Иными словами, безопаснее всего ждать 2 минуты между обновлениями участников.
При значительно большем общем объёме данных, 100MB или более, этот однократный процесс может занять ещё больше времени. Администраторы столь крупных кластеров etcd могут перед обновлением обратиться к команде etcd за рекомендациями по процедуре.
Понижение версии
После обновления всех участников до v3.3 кластер также переходит на v3.3, и понижение версии из этого завершённого состояния невозможно. Однако пока хотя бы один участник остаётся на v3.2, кластер и его операции имеют версию “v3.2”, а из смешанного состояния можно вернуться к использованию двоичного файла etcd v3.2 на всех участниках.
Создайте резервную копию каталога данных всех участников etcd, чтобы сохранить возможность понижения версии кластера даже после полного обновления.
Процедура обновления
В этом примере показано обновление работающего на локальной машине кластера etcd v3.2 из 3 участников.
1. Проверка требований к обновлению
Кластер исправен и использует v3.2.x?
2. Остановка существующего процесса etcd
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
На этом этапе рекомендуется создать резервную копию данных etcd , чтобы обеспечить путь понижения версии при возникновении проблем:
3. Установка двоичного файла etcd v3.3 и запуск нового процесса etcd
Новый etcd v3.3 опубликует свои сведения в кластере:
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.3:
До обновления всего кластера обновлённые участники будут записывать в журнал подобные предупреждения. Это ожидаемо и прекратится после обновления всех участников кластера etcd до v3.3:
4. Повторение шагов 2–3 для остальных участников
5. Завершение
После обновления всех участников кластер сообщит об успешном переходе на 3.3:
16.7 - Обновление etcd от 3.1 до 3.2
В общем случае, обновление от etcd 3.1 до 3.2 может быть обновлением с нулевым временем простоя:
- по одному, останавливайте процессы etcd v3.1 и заменяйте их процессами etcd v3.2
- после запуска всех процессов v3.2, новые функции в v3.2 становятся доступны для кластера
Перед обновлением внимательно прочитайте оставшуюся часть этого руководства для подготовки.
Обновление списков проверки
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается при восстановлении из снимка без файла v3 ETCD_DATA_DIR/member/snap/db. Это происходит после миграции с v2 без прежних данных v3 и предотвращает случайную потерю v3, например при перемещении db. После миграции на v3 etcd требует данные v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данные v3.
Изменения, требующие пересборки, в 3.2.
Изменено стандартное значение snapshot-count
Большее значение --snapshot-count удерживает до снимка больше записей Raft
в памяти, вызывая периодически повышенное потребление памяти
.
Лидер дольше хранит последние записи, и медленный последователь получает больше
времени догнать его до снимка. --snapshot-count — компромисс между памятью и
доступностью медленных последователей.
Начиная с v3.2 значение --snapshot-count по умолчанию изменено с 10,000 на 100,000
.
Изменена зависимость gRPC (>=3.2.10)
Выпуск 3.2.10 или более поздний теперь требует grpc/grpc-go
v1.7.5 (<=3.2.9 требует v1.2.1).
Устаревшая grpclog.Logger
grpclog.Logger был устаревшим в пользу grpclog.LoggerV2
. clientv3.Logger теперь grpclog.LoggerV2.
Перед
После
Устаревшая grpc.ErrClientConnTimeout
Ранее, grpc.ErrClientConnTimeout ошибка возвращалась при таймаутах на подключении клиента. 3.2 теперь возвращает context.DeadlineExceeded (см. #8504
).
Перед
После
Изменены максимальные ограничения размера запроса (>=3.2.10)
Версии 3.2.10 и 3.2.11 позволяют настраивать ограничение размера запроса на сервере. >=3.2.12 позволяет задавать его и на сервере, и на клиенте. В предыдущих версиях (v3.2.10, v3.2.11) ответ клиенту был ограничен 4 MiB.
Серверные ограничения на запросы можно настроить с помощью флага --max-request-bytes:
Или настройте поле embed.Config.MaxRequestBytes:
Если значение не задано, серверное ограничение по умолчанию равно 1.5 MiB.
Клиентские ограничения на запросы должны быть настроены в соответствии с серверными ограничениями.
Если значения не заданы, клиентское ограничение отправки по умолчанию равно
2 MiB (1.5 MiB + накладные байты gRPC), а получения — math.MaxInt32.
Подробнее см. godoc clientv3
.
Изменены.raw оболочки клиентов gRPC
3.2.12 или более поздняя версия изменяет сигнатуры функций оболочки gRPC клиентского clientv3. Этот изменения были необходимы для поддержки пользовательских ограничений размера сообщений grpc.CallOption.
До и после
Изменена clientv3.Lease.TimeToLive API
Прежде, clientv3.Lease.TimeToLive API возвращал lease.ErrLeaseNotFound при несуществующем идентификаторе арены. 3.2 вместо этого возвращает TTL=-1 в ответе и не выдает ошибку (см. #7305
).
Перед
После
Перемещен clientv3.NewFromConfigFile в clientv3.yaml.NewConfig
clientv3.NewFromConfigFile перенесен в yaml.NewConfig.
Перед
После
Изменение в --listen-peer-urls и --listen-client-urls
3.2 теперь отвергает доменные имена для --listen-peer-urls и --listen-client-urls (3.1 только выводит предупреждения), так как доменное имя недопустимо для привязки к сетевому интерфейсу. Убедитесь, что эти URL правильно форматированы как scheme://IP:port.
См. issue #6336 для более подробной информации.
Проверки для обновления сервера
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.2 кластер должен быть версии 3.1 или выше. Если это раньше 3.1, рекомендуется обновить до 3.1 перед обновлением до 3.2.
Также, для обеспечения плавного обновления кластер должен быть здоровым. Проверьте состояние кластера с помощью команды etcdctl endpoint health перед продолжением.
Подготовка
Перед обновлением etcd всегда протестируйте сервисы, зависящие от etcd, в стендовой среде перед развертыванием обновления в производственную среду.
Перед началом сделайте резервную копию данных etcd
. Если что-то пойдет не так с обновлением, можно использовать эту резервную копию для понижения версии
обратно к существующей версии etcd. Пожалуйста, примечание: команда snapshot выполняет только резервное копирование v3 данных. Для v2 данных см. резервное копирование v2 хранилища данных
.
Смешанные версии
При обновлении кластер etcd поддерживает смешанные версии участников etcd и работает с протоколом самой низкой общей версии. Кластер считается обновленным только после того, как все его участники будут обновлены до версии 3.2. Внутри кластерные участники переговариваются между собой, чтобы определить общую версию кластера, которая контролирует отчетываемую версию и поддерживаемые функции.
Ограничения
Примечание: если кластер содержит только данные версии 3 и нет данных версии 2, то он не подлежит этому ограничению.
Если кластер обслуживает набор данных версии v2 размером более 50MB, каждый новый обновленный участник может потребовать до двух минут для того, чтобы синхронизироваться с существующим кластером. Проверьте размер последнего снимка, чтобы оценить общий размер данных. Иными словами, наиболее безопасно ждать 2 минут между обновлением каждого участника.
Для гораздо большего объема данных, превышающего 100MB, этот одноразовый процесс может занять еще больше времени. Администраторы очень больших кластеров etcd такого масштаба могут обратиться к команде etcd перед обновлением, и мы с удовольствием предоставим рекомендации по процедуре.
Понижение версии
Если все участники были обновлены до v3.2, кластер будет обновлен до v3.2, и понижение версии из этого завершенного состояния невозможно. Если хотя бы один участник остается v3.1, кластер и его операции остаются “v3.1”, и из этого смешанного состояния кластера возможно вернуться к использованию etcd-бинарного файла версии v3.1 на всех участниках.
Создайте резервную копию каталога данных всех участников, чтобы понижение версии оставалось возможным после полного обновления.
Процедура обновления
Этот пример показывает, как обновить кластер etcd, работающий локально, состоящий из участника 3-члена v3.1.
1. Проверьте требования к обновлению
Я здоров и работает ли кластер v3.1.x?
2. Остановите существующий процесс etcd
Когда процесс etcd останавливается, ожидаемые ошибки будут записаны другими участниками кластера. Это нормально, так как соединение участника было (временно) прервано:
Это хорошая идея на данном этапе создать резервную копию данных etcd , чтобы обеспечить возможность понижения версии в случае возникновения любых проблем:
3. Замените встраиваемую версию etcd v3.2 и запустите новый процесс etcd
The новое v3.2 etcd будет публиковать свои данные в кластер:
Убедитесь, что с новым двоичным файлом etcd v3.2 каждый участник, а затем весь кластер становятся исправными:
Обновленные участники будут регистрировать предупреждения вида следующий до тех пор, пока весь кластер не будет обновлен. Это ожидаемо и прекратится после того, как все участники кластера etcd будут обновлены до v3.2:
4. Повторите шаг 2 до шага 3 для всех других участников
5. Завершить
Когда все участники будут обновлены, кластер будет сообщать о успешном переходе к 3.2:
16.8 - Обновление etcd с 3.0 до 3.1
В общем случае обновление etcd с 3.0 до 3.1 можно выполнить поэтапно без простоя:
- по очереди останавливать процессы etcd v3.0 и заменять их процессами etcd v3.1;
- после запуска всех процессов v3.1 кластеру станут доступны новые возможности v3.1.
Перед началом обновления прочитайте остальную часть руководства и подготовьтесь.
Контрольные списки обновления
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается при восстановлении из существующих снимков, если отсутствует файл v3 ETCD_DATA_DIR/member/snap/db. Это происходит, когда сервер мигрировал с v2 и ранее не содержал данных v3. Такое поведение также предотвращает случайную потерю данных v3, например при перемещении файла db. После миграции на v3 etcd может работать только с данными v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данных v3.
Мониторинг
Следующие метрики v3.0.x устарели в пользу go-grpc-prometheus :
etcd_grpc_requests_totaletcd_grpc_requests_failed_totaletcd_grpc_active_streamsetcd_grpc_unary_requests_duration_seconds
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.1 работающий кластер должен иметь версию 3.0 или новее. Версию ниже 3.0 сначала обновите до 3.0 , а затем до 3.1.
Для плавного поэтапного обновления работающий кластер также должен быть исправен.
Перед продолжением проверьте его командой etcdctl endpoint health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточной среде до развёртывания обновления в производственной.
До начала создайте резервную копию данных etcd
.
Если обновление завершится неудачно, копия позволит вернуться к предыдущей
версии
. Обратите внимание: команда snapshot копирует только
данные v3. Для данных v2 см. резервное копирование хранилища v2
.
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до 3.1. Участники etcd согласуют общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Ограничения
Примечание: ограничение не относится к кластеру, содержащему только данные v3 без данных v2.
Если кластер обслуживает набор данных v2 больше 50MB, новому обновлённому участнику может потребоваться до двух минут, чтобы догнать кластер. Оцените объём по размеру последнего снимка. Безопаснее всего ждать 2 минуты между обновлениями участников.
При значительно большем объёме, 100MB или более, этот однократный процесс может занять ещё больше времени. Администраторы настолько крупных кластеров etcd могут до обновления обратиться к команде etcd за рекомендациями.
Понижение версии
После обновления всех участников до v3.1 кластер становится кластером v3.1, и понизить версию из этого завершённого состояния невозможно. Пока хотя бы один участник остаётся на v3.0, кластер и его операции сохраняют версию “v3.0”, и из такого смешанного состояния можно вернуть двоичный файл etcd v3.0 на всех участниках.
Создайте резервную копию каталога данных всех участников etcd, чтобы понижение версии оставалось возможным даже после полного обновления кластера.
Процедура обновления
В примере показано обновление локального кластера etcd v3.0 из 3 участников.
1. Проверьте требования к обновлению
Кластер исправен и работает под управлением v3.0.x?
2. Остановите существующий процесс etcd
При остановке каждого процесса etcd другие участники записывают ожидаемые ошибки. Это нормально, поскольку соединение с участником временно разорвано:
На этом этапе рекомендуется создать резервную копию данных etcd , чтобы при проблемах сохранить путь понижения версии:
3. Установите двоичный файл etcd v3.1 и запустите новый процесс etcd
Новый etcd v3.1 опубликует свои сведения в кластере:
Убедитесь, что с новым двоичным файлом etcd v3.1 каждый участник, а затем весь кластер становятся исправными:
До обновления всего кластера обновлённые участники будут записывать следующие предупреждения. Это ожидаемо и прекратится после обновления всех участников до v3.1:
4. Повторите шаги 2–3 для остальных участников
5. Завершите обновление
После обновления всех участников кластер сообщит об успешном переходе на 3.1:
16.9 - Обновление etcd с 2.3 до 3.0
В общем случае обновление etcd с 2.3 до 3.0 можно выполнить поэтапно без простоя:
- по очереди останавливать процессы etcd v2.3 и заменять их процессами etcd v3.0;
- после запуска всех процессов v3.0 кластеру станут доступны новые возможности v3.0.
Перед началом обновления прочитайте остальную часть руководства и подготовьтесь.
Контрольные списки обновления
При миграции с v2 без данных v3
сервер etcd v3.2+ аварийно завершается при восстановлении из существующих снимков, если отсутствует файл v3 ETCD_DATA_DIR/member/snap/db. Это происходит, когда сервер мигрировал с v2 и ранее не содержал данных v3. Такое поведение также предотвращает случайную потерю данных v3, например при перемещении файла db. После миграции на v3 etcd может работать только с данными v3. Не обновляйтесь до более новых версий v3, пока сервер v3.0 не содержит данных v3.
Требования к обновлению
Для обновления существующего развёртывания etcd до 3.0 работающий кластер должен иметь версию 2.3 или новее. Версию ниже 2.3 сначала обновите до 2.3 , а затем до 3.0.
Для плавного поэтапного обновления работающий кластер также должен быть исправен.
Перед продолжением проверьте его командой etcdctl cluster-health.
Подготовка
Перед обновлением etcd обязательно протестируйте зависящие от него службы в промежуточной среде до развёртывания обновления в производственной.
До начала создайте резервную копию каталога данных etcd . Если обновление завершится неудачно, копия позволит вернуться к предыдущей версии .
Смешанные версии
Во время обновления кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается обновлённым только после обновления всех участников до 3.0. Участники etcd согласуют общую версию кластера, которая определяет сообщаемую версию и поддерживаемые возможности.
Ограничения
Если общий объём данных превышает 50MB, новому обновлённому участнику может потребоваться до 2 минут, чтобы догнать кластер. Оцените объём по размеру последнего снимка. Безопаснее всего ждать 2 минуты между обновлениями участников.
При значительно большем объёме, 100MB или более, этот однократный процесс может занять ещё больше времени. Администраторы настолько крупных кластеров etcd могут до обновления обратиться к команде etcd за рекомендациями.
Понижение версии
После обновления всех участников до v3.0 кластер становится кластером v3.0, и понизить версию из этого завершённого состояния невозможно. Пока хотя бы один участник остаётся на v2.3, кластер и его операции сохраняют версию «v2.3», и из такого смешанного состояния можно вернуть двоичный файл etcd v2.3 на всех участниках.
Создайте резервную копию каталога данных всех участников etcd, чтобы понижение версии оставалось возможным даже после полного обновления кластера.
Процедура обновления
В примере подробно показано обновление локального кластера etcd v2.3 из трёх участников.
1. Проверьте требования к обновлению
Кластер исправен и работает под управлением v.2.3.x?
2. Остановите существующий процесс etcd
При остановке каждого процесса etcd другие участники записывают ожидаемые ошибки. Это нормально, поскольку соединение с участником временно разорвано:
На этом этапе рекомендуется создать резервную копию каталога данных etcd , чтобы при проблемах сохранить путь понижения версии:
3. Установите двоичный файл etcd v3.0 и запустите новый процесс etcd
Новый etcd v3.0 опубликует свои сведения в кластере:
Убедитесь, что с новым двоичным файлом etcd v3.0 каждый участник, а затем весь кластер становятся исправными:
До обновления всего кластера обновлённые участники будут записывать следующие предупреждения. Это ожидаемо и прекратится после обновления всех участников до v3.0:
4. Повторите шаги 2–3 для остальных участников
5. Завершите обновление
После обновления всех участников кластер сообщит об успешном переходе на 3.0:
Дополнительные соображения
- Переменные окружения etcdctl были обновлены. Если
ETCDCTL_API=2 etcdctl cluster-healthработает, ноETCDCTL_API=3 etcdctl endpoints healthотвечаетError: grpc: timed out when dialing, убедитесь, что используются новые имена переменных .
Известные проблемы
- etcd < v3.1 работает неправильно при сборке с Go > v1.7. Дополнительные сведения см. в задаче 6951 .
- Если в журнале сервера etcd появляется ошибка
transport: http2Client.notifyError got notified that the client transport was broken unexpected EOF., убедитесь, что используется готовый выпуск etcd либо сборка с (etcd v3.1+ & go v1.7+) или (etcd <v3.1 & go v1.6.x). - Добавление узла v3 в кластер v2.3 во время обновления не поддерживается и может вызвать аварийное завершение. Дополнительные сведения см. в задаче 7249 . Смешанные версии участников разрешены только во время миграции на v3. Завершите обновление до любых изменений состава кластера.
17 - Снижение версии
17.1 - Снижение версии кластеров etcd и приложений
В этом разделе содержатся документы, специфичные для понижения версии кластеров etcd и приложений.
Снижение версии кластера etcd v3.x
17.2 - Понижение версии etcd с v3.7 до v3.6
В общем случае переход с etcd v3.7 на v3.6 можно выполнить как скользящее понижение версии без простоя:
- поочерёдно останавливать процессы etcd v3.7 и заменять их процессами etcd v3.6
- после включения понижения версии новые возможности v3.7 становятся недоступны кластеру
До начала понижения версии прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки понижения версии
Основные различия между v3.7 и v3.6:
Различия во флагах
v3.7 не добавляет новых флагов, поэтому процесс v3.6 принимает все флаги конфигурации v3.7 и при понижении версии изменять конфигурацию не требуется.
Различия приведены для версий v3.7.0-rc.0 и v3.6.13. Фактический результат зависит от корректирующей версии; сначала проверьте его командой diff <(etcd-3.7/bin/etcd -h | grep \\-\\-) <(etcd-3.6/bin/etcd -h | grep \\-\\-).
Удалённые в v3.7 устаревшие флаги --experimental-* всё ещё существуют в v3.6, но не добавляйте их обратно после понижения. Используйте неэкспериментальные эквиваленты или записи --feature-gates, работающие в обеих версиях.
Различия в метриках Prometheus
Контрольные списки понижения версии сервера
Требования к понижению версии
Для плавного скользящего понижения версии работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед понижением версии etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать изменение в рабочем окружении.
До начала загрузите резервную копию снимка . Если при понижении версии возникнет проблема, эту копию можно использовать для отката к существующей версии etcd.
До начала загрузите последний выпуск etcd v3.6.
Смешанные версии
Во время понижения версии кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается переведённым на более старую версию после включения операции командой etcdctl downgrade enable 3.6. На внутреннем уровне общая версия кластера устанавливается равной целевой версии понижения и определяет сообщаемую версию и поддерживаемые возможности.
Откат
Перед понижением версии кластера etcd создайте и загрузите его резервную копию снимка . При необходимости снимок позволяет восстановить состояние кластера до понижения. Если во время операции возникнут проблемы, сначала следует определить и устранить их первопричину.
Если понижение началось после выполнения etcdctl downgrade enable, но кластер всё ещё находится в состоянии смешанных версий и хотя бы один участник остаётся на v3.7, текущую операцию можно отменить командой etcdctl downgrade cancel, а всех уже переведённых участников перезапустить с исходными двоичными файлами v3.7.
После перевода всех участников на v3.6 понижение версии кластера считается завершённым. Чтобы вернуться к исходной версии после полного понижения, необходимо следовать официальному руководству по обновлению , обеспечивая согласованность и предотвращая повреждение данных.
Процедура понижения версии
В этом примере показано понижение версии работающего на локальной машине кластера etcd v3.7 из 3 участников. Приведённый вывод получен при реальном запуске etcd v3.7.0-rc.0 и etcd v3.6.13 на одном узле с тремя портами обратной петли в кластере, незадолго до этого обновлённом с v3.6.13.
Шаг 1: проверка требований к понижению версии
Кластер исправен и использует v3.7.x?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии при возникновении проблем:
Шаг 3: проверка целевой версии понижения
Перед включением понижения проверьте целевую версию:
- Поддерживается понижение только на одну дополнительную версию за раз. Например, переход с v3.7 на v3.5 недопустим.
- Не переходите к следующему шагу до успешного завершения проверки.
Шаг 4: включение понижения версии
После включения понижения кластер начнёт работать по протоколу v3.6 — целевой версии операции. Кроме того, etcd автоматически перенесёт схему на целевую версию, что обычно происходит очень быстро. Прежде чем переходить к следующему шагу, проверьте состояние конечных точек и убедитесь, что версия хранилища всех серверов изменена на v3.6.
После включения понижения кластер продолжает работать по протоколу v3.6, даже если все серверы всё ещё используют двоичный файл v3.7, пока операция не отменена командой etcdctl downgrade cancel
Шаг 5: остановка одного существующего сервера etcd
Перед остановкой сервера проверьте, является ли он лидером. Рекомендуется понижать версию лидера последним. Если останавливаемый сервер является лидером, часть простоя можно предотвратить, выполнив move-leader на другой сервер до остановки текущего.
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
Шаг 6: перезапуск сервера etcd с той же конфигурацией
Перезапустите сервер etcd с прежней конфигурацией, но с двоичным файлом etcd v3.6.
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с двоичным файлом etcd v3.6:
В отличие от v3.5 конечная точка состояния v3.6 сообщает сведения о понижении, поэтому до завершения операции переведённые участники продолжают показывать DOWNGRADE ENABLED как true и свою версию хранилища.
Шаг 7: повторение шага 5 и шага 6 для остальных участников
После понижения версии всех участников операция автоматически завершается, а DOWNGRADE ENABLED сбрасывается в false. Проверьте работоспособность и состояние кластера, убедившись, что дополнительная версия всех участников и версия хранилища равны v3.6:
В журнале лидера должно появиться сообщение, подобное следующему:
17.3 - Понижение версии etcd от 3.5 до 3.4
В общем случае, понижение версии от etcd 3.5 к 3.4 может быть безостановочным и ролевым:
- по одному останавливайте процессы etcd 3.5 и заменяйте их на процессы etcd 3.4
- после запуска любых процессов 3.4 новые функции в 3.5 больше не доступны для кластера
Перед началом понижения версии прочитайте остальную часть руководства и подготовьтесь.
Проверочные списки для понижения версии
содержимое/enhttps://etcd.io/docs/v3.5/op-guide/authentication/rbac.md
Если в кластере включена аутентификация, поэтапное понижение с 3.5 не поддерживается: 3.5 изменяет формат связанных с аутентификацией записей WAL . Сначала следуйте инструкциям по аутентификации , чтобы отключить её и удалить всех пользователей.
Изменения, требующие пересборки, от 3.5 до 3.4:
Разница в флагах
Если вы используете какие-либо из следующих флагов в своей конфигурации 3.5, обязательно убедитесь, что при устаревании до 3.4 вы либо удалили, либо переименовали эти флаги, либо изменили их значение по умолчанию.
Разница основана на версии 3.5.14 и v.3.4.33. Фактическая разница будет зависеть от вашей версии патча, свяжитесь с diff <(etcd-3.5/bin/etcd -h | grep \\-\\-) <(etcd-3.4/bin/etcd -h | grep \\-\\-) первым.
etcd --logger zap
3.4 по умолчанию равно --logger=capnslog, а 3.5 по умолчанию равно --logger=zap.
Если вы хотите продолжить использование zap, его нужно явно указать.
Разница в метриках Prometheus
Проверки при понижении версии сервера
Требования для понижения версии
Для обеспечения плавного понижения версии кластер должен быть здоровым. Перед продолжением проверьте состояние кластера с помощью команды etcdctl endpoint health.
Понижение версии к 3.4 должно быть >= 3.4.32.
Подготовка
Перед понижением версии etcd всегда тестируйте сервисы, зависящие от etcd, в стендовой среде перед развертыванием понижения в производственную среду.
Перед началом, скачайте резервную копию снимка
. Если что-то пойдет не так с понижением версии, возможно использование этой резервной копии для восстановления
обратно к существующей версии etcd. Пожалуйста, примечание: snapshot команда выполняет только резервное копирование v3 данных. Для v2 данных см. восстановление v2 хранилища данных
.
Перед началом скачайте последний выпуск etcd 3.4, и убедитесь, что его версия >= 3.4.32.
Смешанные версии
При децентрализации кластер etcd поддерживает смешанные версии участников etcd и работает с протоколом наименьшей общей версии. Кластер считается децентрализованным, если любой из его участников был децентрализован до версии 3.4. Внутри кластера участники переговариваются между собой для определения общей версии кластера, которая контролирует отчетываемую версию и поддерживаемые функции.
Ограничения
Примечание: если кластер содержит только данные версии 3 и нет данных версии 2, то он не подлежит этому ограничению.
Если кластер обслуживает набор данных версии v2 размером более 50MB, каждый новый участник, который был уменьшен в версии, может потребовать до двух минут для того, чтобы подтянуться до состояния существующего кластера. Проверьте размер последнего снимка, чтобы оценить общую величину данных. В противном случае, наиболее безопасно ждать 2 минут между уменьшением каждого участника.
Для значительно большего объема данных, превышающего 100MB или более , этот одноразовый процесс может занять еще больше времени. Администраторы очень больших кластеров etcd такого масштаба могут обратиться к команде etcd перед устареванием, и мы с удовольствием предоставим рекомендации по процедуре.
Откат
Если какой-либо участник был уменьшен до 3.4, версия кластера будет уменьшена до 3.4, и операции будут “3.4” совместимы. Вам потребуется следовать инструкциям Обновление etcd от 3.4 до 3.5 для отката.
Пожалуйста, скачайте резервную копию снимка для того, чтобы возможность деинсталляции кластера была сохранена даже после его полной деинсталляции .
Приемник понижения версии
Этот пример показывает, как понизить версию кластера etcd, работающего локально, состоящего из участника 3-члена 3.5.
Шаг 1: проверьте требования к понижению версии
Я здоров и работает ли кластер 3.5.x?
Шаг 2: скачать резервную копию снимка с лидера
Загрузите резервную копию снимка, для обеспечения пути понижения версии в случае возникновения любых проблем.
Шаг 3: остановите один из существующих серверов etcd
Перед остановкой сервера проверьте, является ли он лидером
Если сервер, который нужно остановить, является лидером, можно избежать некоторого времени простоя, перед остановкой этого сервера move-leader на другой сервер.
Когда процесс etcd останавливается, ожидаемые ошибки будут записаны другими участниками кластера. Это нормально, так как соединение участника было (временно) прервано:
Шаг 4: перезапустите сервер etcd с той же конфигурацией + --next-cluster-version-compatible
Перезапустите сервер etcd с той же конфигурацией, но с новой версией бинарного файла etcd и --next-cluster-version-compatible.
The новое 3.4 etcd будет публиковать информацию в кластер. В этот момент кластер начнет функционировать по протоколу 3.4, который является наименьшей общей версией.
Убедитесь, что с новым двоичным файлом etcd 3.4 каждый участник, а затем весь кластер становятся исправными:
Необновленные участники будут логировать информацию подобную следующей
Шаг 5: повторите шаг 3 и шаг 4 для остальных участников
При сбое всех участников проверьте состояние здоровья и версию кластера:
17.4 - Понижение версии etcd с v3.6 до v3.5
В общем случае переход с etcd v3.6 на v3.5 можно выполнить как скользящее понижение версии без простоя:
- поочерёдно останавливать процессы etcd v3.6 и заменять их процессами etcd v3.5
- после включения понижения версии новые возможности v3.6 становятся недоступны кластеру
До начала понижения версии прочитайте оставшуюся часть руководства и подготовьтесь.
Контрольные списки понижения версии
Основные нарушающие совместимость изменения между v3.6 и v3.5:
Различия во флагах
Если в конфигурации v3.6 используются какие-либо из следующих флагов, при переходе на v3.5 обязательно удалите или переименуйте их либо измените значение по умолчанию.
Различия приведены для версий v3.6.0 и v.3.5.18. Фактический результат зависит от корректирующей версии; сначала проверьте его командой diff <(etcd-3.6/bin/etcd -h | grep \\-\\-) <(etcd-3.5/bin/etcd -h | grep \\-\\-).
Различия в метриках Prometheus
Контрольные списки понижения версии сервера
Требования к понижению версии
Для плавного скользящего понижения версии работающий кластер должен быть исправен. Перед продолжением проверьте его работоспособность командой etcdctl endpoint health.
Подготовка
Перед понижением версии etcd обязательно протестируйте зависящие от него службы в промежуточном окружении, прежде чем развёртывать изменение в рабочем окружении.
До начала загрузите резервную копию снимка . Если при понижении версии возникнет проблема, эту копию можно использовать для отката к существующей версии etcd.
До начала загрузите последний выпуск etcd v3.5.
Смешанные версии
Во время понижения версии кластер etcd поддерживает участников разных версий и работает по протоколу наименьшей общей версии. Кластер считается переведённым на более старую версию после включения операции командой etcdctl downgrade enable 3.5. На внутреннем уровне общая версия кластера устанавливается равной целевой версии понижения и определяет сообщаемую версию и поддерживаемые возможности.
Откат
Перед понижением версии кластера etcd создайте и загрузите его резервную копию снимка . При необходимости снимок позволяет восстановить состояние кластера до обновления. Если во время понижения версии возникнут проблемы, сначала следует определить и устранить их первопричину.
Если понижение версии началось после выполнения etcdctl downgrade enabled, но кластер всё ещё находится в состоянии смешанных версий и хотя бы один участник остаётся на v3.6, текущую операцию можно отменить командой etcdctl downgrade cancel, а всех уже переведённых участников перезапустить с исходными двоичными файлами v3.6.
После перевода всех участников на v3.5 понижение версии кластера считается завершённым. Чтобы вернуться к исходной версии после полного понижения, необходимо следовать официальному руководству по обновлению , обеспечивая согласованность и предотвращая повреждение данных.
Процедура понижения версии
В этом примере показано понижение версии работающего на локальной машине кластера etcd v3.6 из 3 участников.
Шаг 1: проверка требований к понижению версии
Кластер исправен и использует v3.6.x?
Шаг 2: загрузка резервной копии снимка с лидера
Загрузите резервную копию снимка , чтобы обеспечить путь понижения версии при возникновении проблем.
Шаг 3: проверка целевой версии понижения
Перед включением понижения проверьте целевую версию:
- Поддерживается понижение только на одну дополнительную версию за раз. Например, переход с v3.6 на v3.4 недопустим.
- Не переходите к следующему шагу до успешного завершения проверки.
Шаг 4: включение понижения версии
После включения понижения кластер начнёт работать по протоколу v3.5 — целевой версии операции. Кроме того, etcd автоматически перенесёт схему на целевую версию, что обычно происходит очень быстро. Прежде чем переходить к следующему шагу, проверьте состояние конечных точек и убедитесь, что версия хранилища всех серверов изменена на v3.5.
После включения понижения кластер продолжает работать по протоколу v3.5, даже если все серверы всё ещё используют двоичный файл v3.6, пока операция не отменена командой etcdctl downgrade cancel
Шаг 5: остановка одного существующего сервера etcd
Перед остановкой сервера проверьте, является ли он лидером. Рекомендуется понижать версию лидера последним.
Если останавливаемый сервер является лидером, часть простоя можно предотвратить, выполнив move-leader на другой сервер до остановки текущего.
При остановке каждого процесса etcd другие участники кластера записывают в журнал ожидаемые ошибки. Это нормально, поскольку соединение с участником кластера (временно) разорвано:
Шаг 6: перезапуск сервера etcd с той же конфигурацией (за исключением удалённых или заменённых в v3.5 флагов)
Перезапустите сервер etcd с прежней конфигурацией, но с новым двоичным файлом etcd.
Убедитесь, что сначала каждый участник, а затем весь кластер становятся исправными с новым двоичным файлом etcd v3.5:
Для сервера v3.5 значение DOWNGRADE ENABLED равно false, поскольку сведения о понижении версии не реализованы в конечной точке состояния v3.5. На этом этапе понижение версии для кластера всё ещё включено.
Шаг 7: повторение шага 5 и шага 6 для остальных участников
После понижения версии всех участников проверьте работоспособность и состояние кластера, убедившись, что дополнительная версия всех участников равна v3.5, а версия хранилища пуста:
В журнале лидера должно появиться сообщение, подобное следующему:
18 - Триаж
18.1 - Рекомендации по триажу issue
Назначение
Ускорить управление issue.
Issue проекта etcd перечислены на странице https://github.com/etcd-io/etcd/issues
и классифицируются с помощью меток. Например, issue, признанный ошибкой,
в итоге получает метку area/bug . Новые issue сначала не имеют меток, но обычно
сопровождающие и активные участники etcd добавляют их по результатам анализа.
Подробный список меток находится на странице
https://github.com/kubernetes/kubernetes/labels
Для удобства ниже приведено несколько готовых поисковых запросов:
Область применения
Эти рекомендации служат основным документом по триажу поступающих issue в etcd. Помогать с issue и PR могут все желающие, однако описанные здесь работа и обязанности рассчитаны прежде всего на сопровождающих и активных участников etcd.
Проверка, является ли issue ошибкой
Убедитесь, что issue действительно описывает ошибку. Если это не так, добавьте комментарий с результатами анализа и закройте очевидный issue. Для нетривиального случая дождитесь ответа автора и возможных возражений. Если автор не отвечает 30 дней, закройте issue. Если проблему не удаётся воспроизвести или требуются дополнительные сведения, оставьте автору комментарий.
Неактивные issue
Issue с недостаточным объёмом сведений следует закрыть, если автор не предоставляет запрошенную информацию в течение 60 дней.
Дублирующие issue
Если issue дублирует существующий, добавьте комментарий со ссылкой на исходный issue и закройте дубликат.
Issue, не относящиеся к etcd
Иногда сообщают о проблемах, которые на самом деле относятся к другим проектам, используемым etcd, например к grpc или golang. Попросите автора открыть issue в соответствующем проекте. Закройте исходный issue, если сопровождающий и автор не считают необходимым оставить его открытым для отслеживания.
Проверка важных меток
Убедитесь, что issue помечен метками соответствующих областей, назначены подходящие исполнители и указан этап. Добавьте отсутствующие метки. Если прав для этого недостаточно или правильную метку выбрать не удаётся, при необходимости обратитесь к сопровождающим.
При необходимости напомните владельцу issue
Если разработчик владеет issue, но за 30 дней не создал PR, свяжитесь с ним и попросите подготовить PR либо освободить issue для другого исполнителя.
18.2 - Управление PR
Назначение
Ускорить управление PR.
PR проекта etcd перечислены на странице https://github.com/etcd-io/etcd/pulls
У PR могут быть различные метки, этап, рецензент и другие атрибуты. Подробный список меток находится на странице
https://github.com/kubernetes/kubernetes/labels
Для удобства ниже приведено несколько примеров поиска PR:
Область применения
Эти рекомендации служат основным документом по управлению PR в etcd. Помогать с PR могут все желающие, однако описанные здесь работа и обязанности рассчитаны прежде всего на сопровождающих и активных участников etcd.
Обработка неактивных PR
Напомните владельцу PR, если комментарии рецензента остаются без ответа 15 дней. Если владелец PR не отвечает 90 дней, по возможности обновите PR новым коммитом. В противном случае неактивный PR следует закрыть через 180 дней.
При необходимости напомните рецензенту
Рецензенты обычно отвечают своевременно, но у всех много работы, поэтому после запроса на проверку дайте им некоторое время. Если ответа нет 10 дней, свяжитесь с рецензентом: добавьте комментарий в PR либо отправьте письмо или сообщение в Slack.
Проверка важных меток
Убедитесь, что к PR добавлены подходящие рецензенты и указан этап. Если эти или другие важные метки отсутствуют, добавьте их. Если выбрать правильную метку не удаётся, оставьте комментарий, чтобы сопровождающие назначили её при необходимости.