複数のデータセンターにまたがるHA
複数のデータセンターにデプロイしたPostgreSQLクラスターの高可用性は、レプリケーションに基づきます。レプリケーションには同期と非同期があります(レプリケーションモード を参照)。
どちらの場合も、次の概念を明確に理解することが重要です。
- Postgresがプライマリーまたはスタンバイリーダーとして動作できるのは、リーダーキーを所有し、それを更新できる場合だけです。
- etcd、ZooKeeper、Consulのノードは、3または5という奇数台で実行することを推奨します。
同期レプリケーション
ゾーンの停止に自動的に耐えられる複数DCのクラスターにするには、少なくとも3つのゾーンが必要です。
アーキテクチャーの図は次のとおりです。
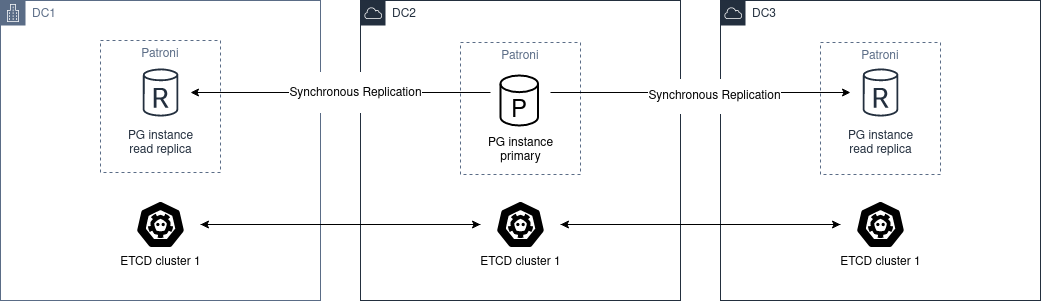
etcd、ZooKeeper、Consulのいずれかのクラスターを、複数のDCにまたがって、各ゾーンに一つずつ、少なくとも3ノードでデプロイしなければなりません。
Postgresについては、異なるDCに少なくとも2ノードをデプロイしなければなりません。そのうえで、グローバルな動的構成
にsynchronous_mode: trueを設定する必要があります。
これにより同期レプリケーションが有効になり、プライマリーノードはいずれかのノードを同期ノードとして選択します。
非同期レプリケーション
データセンターが二つだけの場合は、独立したetcdクラスターを二つ用意し、二つ目のデータセンターでPatroniのスタンバイクラスター を実行する方が適切です。最初のサイトが停止した場合は、standby_cluster を手動で昇格させられます。
アーキテクチャーの図は次のとおりです。
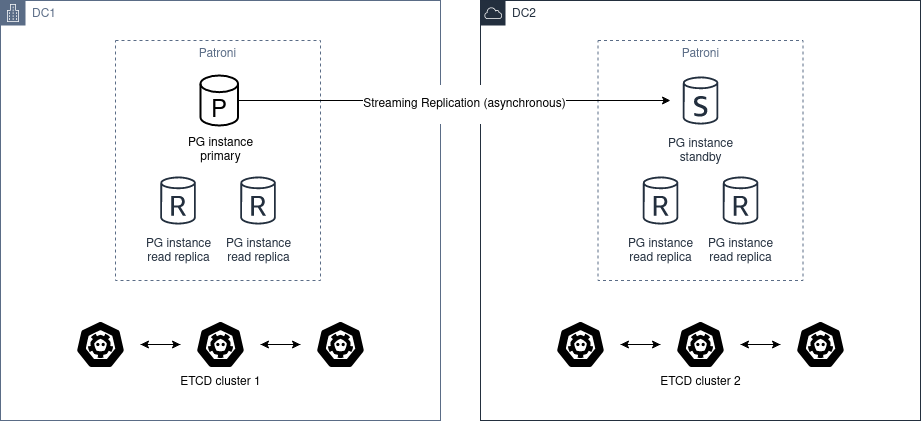
DC2はDC1の状態を判断できないため、自動昇格はできません。
この状況ではpg_ctl promoteを使用すべきではありません。動的構成
からstandby_cluster
セクションを削除して、正常なクラスターを「手動で昇格」させる必要があります。
ソースクラスターがまだ稼働している状態でスタンバイクラスターを昇格させると、スプリットブレインが発生します。
「初期」の状態に戻したい場合、解決する方法は次の二つだけです。
- standby_clusterセクションを再び追加すると、
pg_rewindが実行されます。ただし、pg_rewindを正しく動作させるには、data page checksums(initdbの--data-checksumsオプション)を有効にしてクラスターを初期化するか、wal_log_hintsをonに設定する、あるいはその両方を行わなければなりません。それでも、他の要因でpg_rewindが失敗する可能性は残ります。 - スタンバイクラスターを最初から再構築します。
スタンバイクラスターを昇格させる前に、ソースクラスターが停止していることを手動で確認しなければなりません(STONITH)。DC1が復旧したら、そのクラスターをスタンバイクラスターに変換する必要があります。
その前に、データベースを手動で調べて、DC1とDC2の間のネットワークが機能しなくなった時点から、DC1のクラスターを手動で停止した時点までに発生したすべての変更を抽出できます。
抽出した変更は、DC2のクラスターに手動で適用することもできます。