これはセクションの複数ページ印刷用ビューです。 .
etcd 3.7 ドキュメント
- 1: タスク
- 1.1: 運用担当者向けタスク
- 1.1.1: etcdクラスターでリーダー選出を行う方法
- 1.1.2: データベースの保存方法
- 1.2: 開発者向けタスク
- 1.2.1: etcdからの読み取り
- 1.2.2: etcdへの書き込み
- 1.2.3: プレフィックスでキーを取得する方法
- 1.2.4: キーの削除方法
- 1.2.5: キーの監視方法
- 1.2.6: リースの作成方法
- 1.2.7: ロックの作成方法
- 1.1: 運用担当者向けタスク
- 2: クイックスタート
- 3: デモ
- 4: バグの報告
- 5: 内部実装
- 5.1: ログの規約
- 6: 学習
- 7: 開発者ガイド
- 7.1: Goアプリケーションへのetcdの組み込み
- 7.2: システムの制限
- 8: 運用ガイド
- 9: ベンチマーク
- 10: アップグレード
- 11: ダウングレード
- 12: トリアージ
- 12.1: PRの管理
1 - タスク
1.1 - 運用担当者向けタスク
1.1.1 - etcdクラスターでリーダー選出を行う方法
前提条件
リーダー選出を行う
etcdctlコマンドは、etcdクラスターでリーダー選出を行うために使用します。一度にリーダーになれるクライアントが1つだけであることを保証します。
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
オプション
--endpoints : $ENDPOINTS
各etcdクラスターメンバーのアドレス。
election-name文字列
選出を識別する文字列です。リーダーの地位を競うすべての参加者は、同じ選出名を使用する必要があります。
leader-name文字列
新しいリーダーの提案値。
例
1.1.2 - データベースの保存方法
前提条件
- etcdctlとetcdutlをインストール します。
- ローカルクラスターをセットアップ します。
データベースのスナップショットを取得する
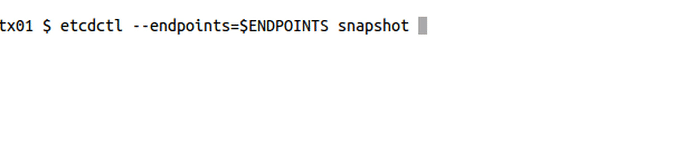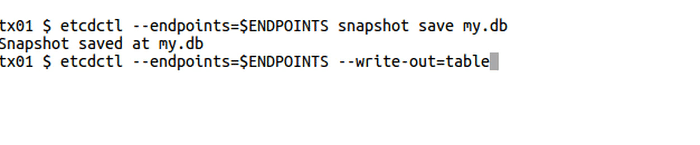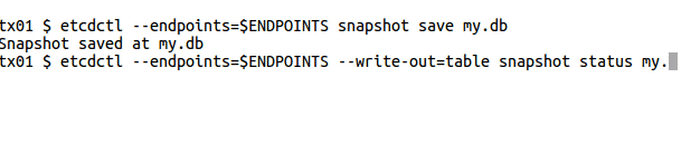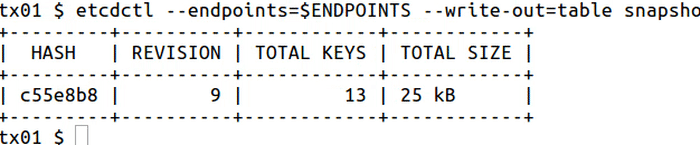
etcdデータベースのある時点のスナップショットを保存するsnapshot:
グローバルオプション
etcdctl
スナップショットを要求できるetcdノードは1つだけなので、--endpointsフラグにはエンドポイントを1つだけ指定する必要があります。
etcdutl
例
1.2 - 開発者向けタスク
1.2.1 - etcdからの読み取り
前提条件
etcdctlをインストールします。
手順
getサブコマンドを使用して、etcdから読み取ります。
各要素の意味は次のとおりです。
fooは要求したキーです。Hello World!は取得した値です。
出力形式を指定する場合は、次のように実行します。
ここで、write-out="json"を指定すると、値はJSON形式で出力されます(キーは返されない点に注意してください)。
1.2.2 - etcdへの書き込み
前提条件
etcdctlをインストールします。
手順
putサブコマンドを使用して、キー・バリューペアを書き込みます。
各要素の意味は次のとおりです。
fooはキーの名前です。"Hello World!"は引用符で囲んだ値です。
1.2.3 - プレフィックスでキーを取得する方法
前提条件
- etcdctlをインストール します。
- ローカルクラスターをセットアップ します。
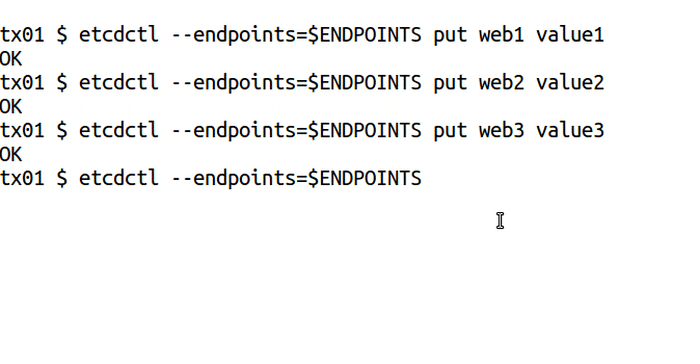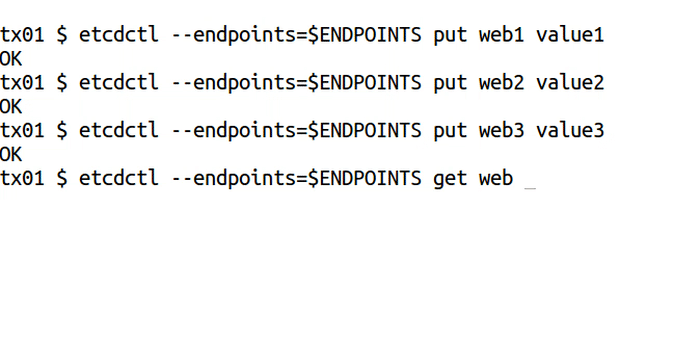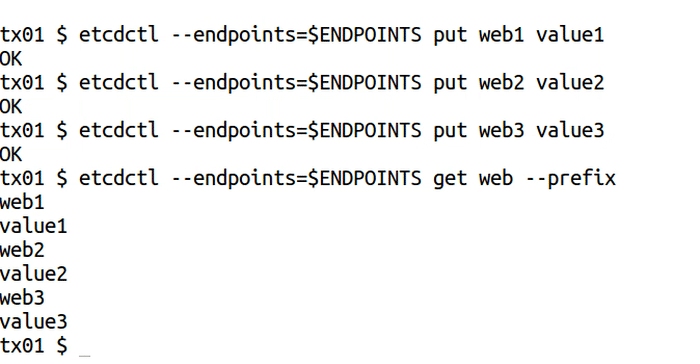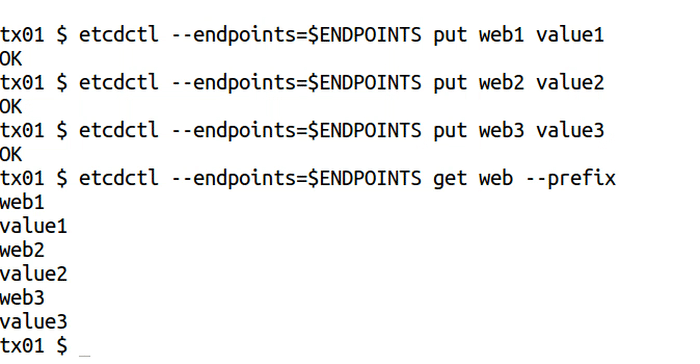
プレフィックスでキーを取得する
グローバルオプション
オプション
例
1.2.4 - キーの削除方法
前提条件
etcdとetcdctlをインストールします。
キーの追加と削除
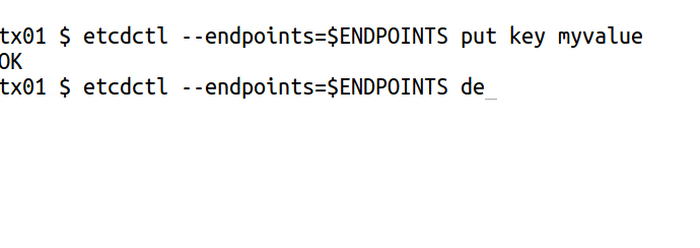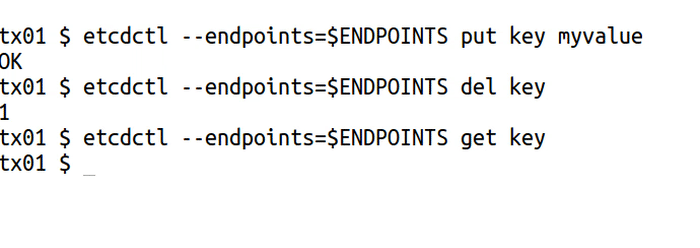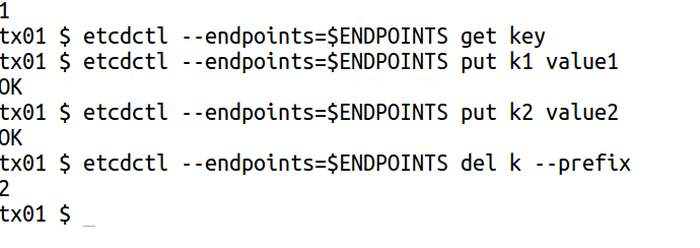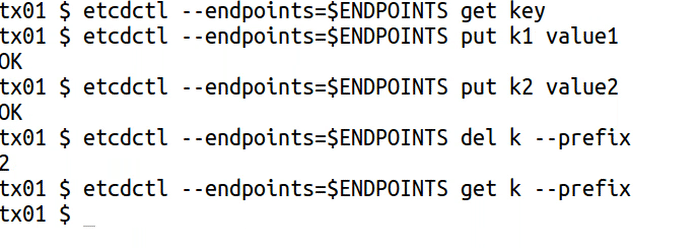
指定したキーまたはキー範囲を削除するdel:
オプション
親コマンドから継承されるオプション
例
1.2.5 - キーの監視方法
前提条件
etcdとetcdctlをインストールします。
キーの監視
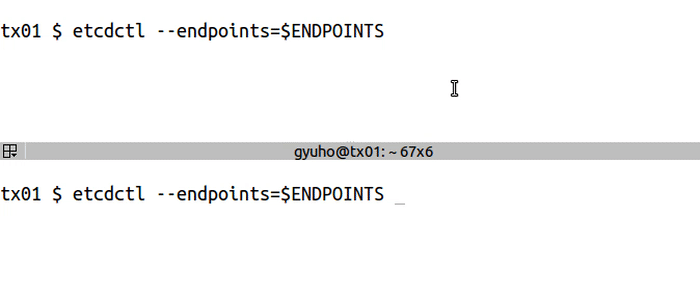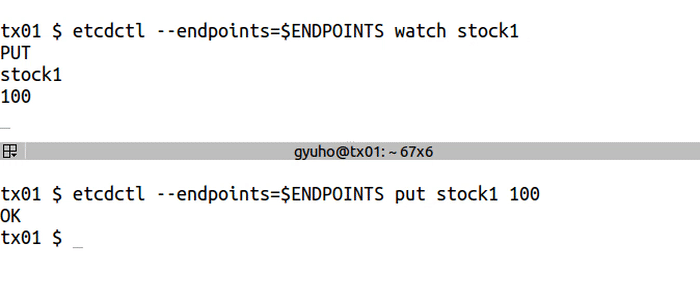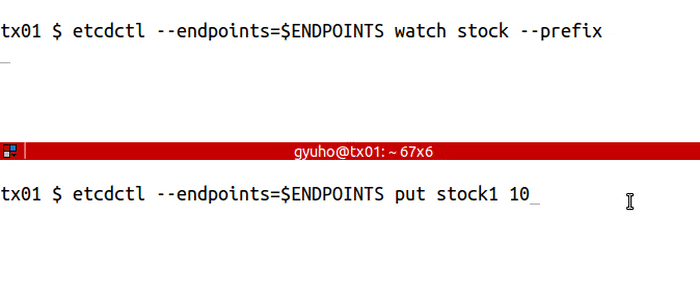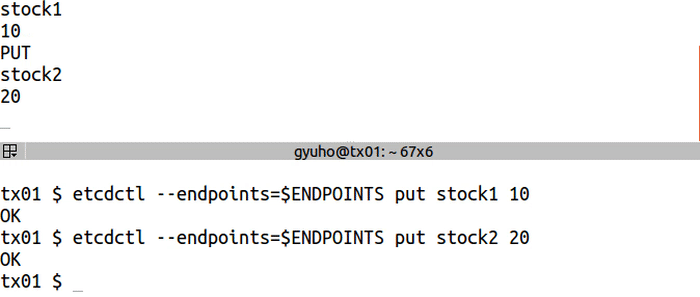
今後の変更の通知を受け取るwatch:
オプション
親コマンドから継承されるオプション
例
1.2.6 - リースの作成方法
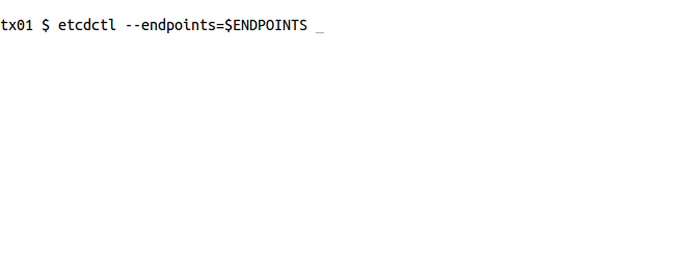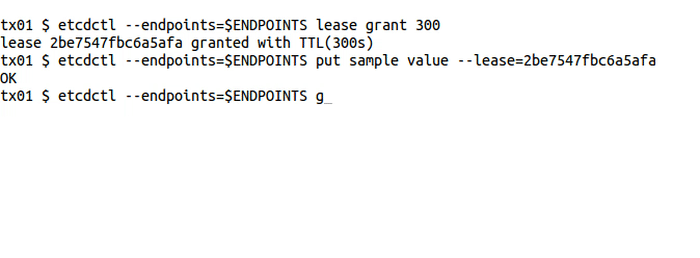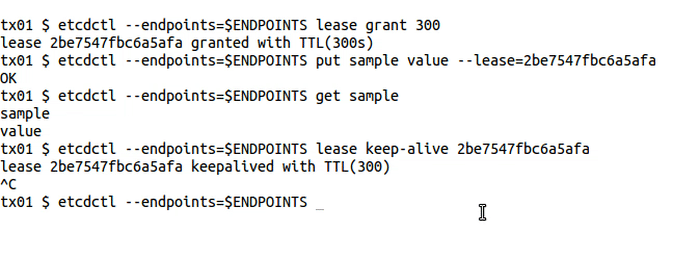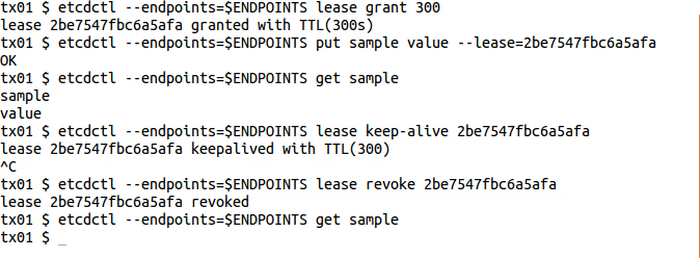
TTLを指定した書き込みに使用するlease:
1.2.7 - ロックの作成方法
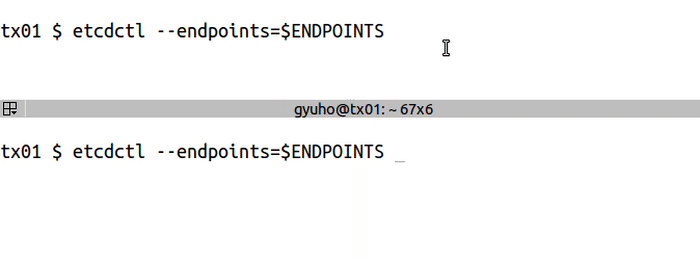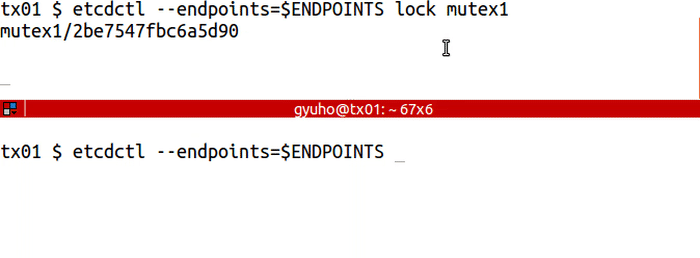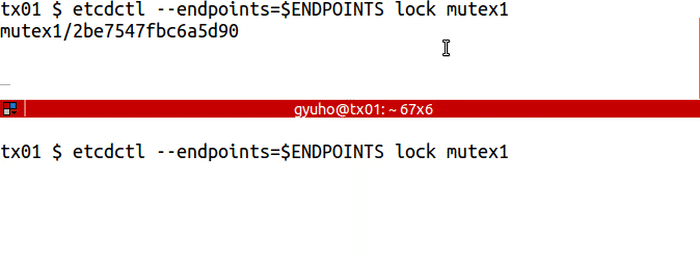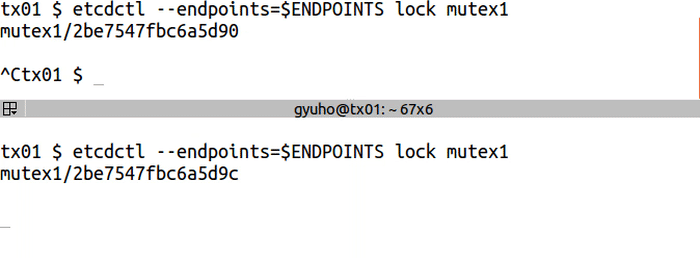
LOCKは、指定された名前の分散ミューテックスを取得します。取得したロックは、etcdctlが終了するまで保持されます。
前提条件
etcdとetcdctlをインストールします。
ロックの作成
分散ロックに使用するlock:
オプション
- endpoints - クラスター内のマシンのアドレスを、コンマ区切りのリストで指定します。
- ttl - ロックセッションのタイムアウトを秒単位で指定します。
2 - クイックスタート
次の手順に従って、単一メンバーのetcdクラスターをローカルにインストールし、実行してテストします。
ビルド済みのバイナリーまたはソースからetcdをインストールします。詳細はインストール を参照してください。
警告重要:インストール手順の最後のステップを必ず実行し、
etcdが検索パスに含まれていることを確認してください。etcdを起動します。注記注意:
etcdの出力はログ です。— infoレベルのログは無視できます。別のターミナルから、
etcdctlを使用してキーを設定します。同じターミナルからキーを取得します。
次のステップ
etcdの構成方法と使用方法について、詳しくは次のページを参照してください。
開発者向け:
- gRPC API を確認します。
- 言語バインディングとツール を探します。
運用担当者または管理者向け:
- 複数マシンのクラスター をセットアップします。
- etcdの構成方法 を学びます。
- TLSを使用してetcdクラスターを保護 します。
- etcdをチューニング します。
3 - デモ
この一連の例では、etcdクラスターを操作するための基本的な手順を示します。
認証
認証に使用するauth、user、role:
4 - バグの報告
etcdプロジェクトのいずれかの部分にバグやドキュメントの誤りを見つけた場合は、Issueを作成 してお知らせください。私たちはバグや誤りを真剣に受け止めており、小さすぎて報告する必要のない問題はないと考えています。バグを報告する前に、同じ問題を報告するIssueがすでに存在していないか確認してください。
バグ報告を正確で理解しやすいものにするため、次の点を満たすようにしてください。
具体的であること。バージョン、環境、構成など、できるだけ多くの詳細を含めてください。etcdサーバーの実行に関するバグの場合は、etcdのログを添付してください(etcdの構成が記録された起動時のログは特に重要です)。
再現可能であること。問題を再現する手順を含めてください。再現が難しい問題もあることは承知していますので、問題につながる可能性のある手順を記載してください。可能であれば、影響を受けたetcdのデータディレクトリとスタックトレースをバグ報告に添付してください。
問題が切り分けられていること。できる限り依存関係を最小限にして、バグを切り分け、再現してください。バグ報告に多すぎる依存関係が含まれていると、修正に大幅に時間がかかります。etcdに依存する外部システムのデバッグは対象外ですが、適切な方向性についての助言やetcd自体の使用方法については、喜んで支援します。
重複していないこと。既存のバグ報告と重複する報告はしないでください。
範囲が限定されていること。1つの報告につきバグは1つとしてください。同じ報告の中で、別のバグについて追記しないでください。
バグを報告する前に、適切なバグ報告の書き方に関するElika Etemadの記事 を読むと役立つかもしれません。
バグの原因を特定するため、追加の情報をお願いする場合があります。重複したバグ報告はクローズします。
よくある質問
スタックトレースの取得方法
etcdのバージョンの確認方法
systemdサービス「etcd2.service」として実行されるetcdの構成とログを取得する方法
アップストリームのsystemdのバグにより、プロセスの終了時にjournaldがログの最後の数行を記録しない場合があります。journalctlでetcdが停止したと表示されるのにfatalまたはpanicメッセージがない場合は、sudo journalctl -f -t etcd2を試して完全なログを取得してください。
5 - 内部実装
5.1 - ログの規約
etcdはzap ライブラリーを使用し、アプリケーションの出力をレベル別に分類してログに記録します。ログメッセージのレベルは、次の規約に従って決まります。
DebugLevelのログは通常、大量に出力されるため、本番環境では一般に無効にします。
- 例:
- リモートピアへの通常のメッセージの送信
- ディスクへのログエントリーの書き込み
- 例:
InfoLevelは、デフォルトのログ優先度です。
- 例:
- 起動時の構成
- スナップショット作成の開始
- クラスターへの新しいノードの追加
- 認証サブシステムへの新しいユーザーの追加
- 例:
WarnLevelのログはInfoより重要ですが、人が個別に確認する必要はありません。
- 例:
- リモートピアへのRaftメッセージの送信失敗
- 設定された選出タイムアウト内でのハートビートメッセージの受信失敗
- 例:
ErrorLevelのログは優先度が高いログです。アプリケーションが正常に動作している場合、エラーレベルのログは出力されないはずです。
- 例:
- WAL用のディスク領域の割り当て失敗
- 例:
PanicLevelはメッセージをログに記録した後、パニックを発生させます。
- 例:
- Raftメッセージのエンコード失敗
- 例:
FatalLevelはメッセージをログに記録した後、os.Exit(1)を呼び出します。
- 例:
- Raftスナップショットの保存失敗
- 例:
6 - 学習
7 - 開発者ガイド
7.1 - Goアプリケーションへのetcdの組み込み
embedを使用して、アプリケーション内でetcdサーバーを実行するetcdのGoパッケージembedを使用すると、etcdサーバーをアプリケーションに直接、簡単に組み込めます。
詳細はembedパッケージのドキュメント を参照してください。
7.2 - システムの制限
リクエストサイズの上限
etcdは、メタデータで一般的な小さなキー・バリューペアを処理するように設計されています。大きなリクエストも処理できますが、他のリクエストのレイテンシーが増加する可能性があります。デフォルトでは、各リクエストの最大サイズは1.5 MiBです。この上限は、etcdサーバーの--max-request-bytesフラグで設定できます。
ストレージサイズの上限
ストレージサイズのデフォルトの上限は2 GiBで、--quota-backend-bytesフラグで設定できます。通常の環境で推奨される最大サイズは8 GiBです。設定値がこのサイズを超えると、etcdは起動時に警告を出します。
8 - 運用ガイド
8.1 - 認証ガイド
8.1.1 - 認証
認証に使用するauth、user、role:
注意:
これは、認証に関する情報を追加して更新する必要がある未完成のページです。上記のテキストはコード例にすぎません。
8.2 - バージョン管理
このドキュメントでは、etcdプロジェクトでサポートされるバージョンについて説明します。
サービスのバージョン管理とサポート対象バージョン
etcdのバージョンは、セマンティックバージョニング の用語に従い、x.y.zと表記します。xはメジャーバージョン、yはマイナーバージョン、zはパッチバージョンです。新しいマイナーバージョンでは、APIに機能が追加される場合があります。
etcdプロジェクトでは、現行バージョンとその前のリリースのリリースブランチを保守します。たとえば、v3.5が現行バージョンの場合、v3.4もサポートされます。v3.6がリリースされると、v3.4のサポートは終了します。
セキュリティー修正を含む適用可能な修正は、重大度と実現可能性に応じて、これら2つのリリースブランチにバックポートされる場合があります。必要に応じて、これらのブランチからパッチリリースを作成します。
この判断は、プロジェクトのメンテナー が行います。
稼働中のetcdクラスターのバージョンは、etcdctlで確認できます。
APIのバージョン管理
v3 APIのレスポンスは、3.0.0リリース以降は変更されない想定ですが、新機能は今後も追加されます。
9 - ベンチマーク
ベンチマーク
etcdのベンチマークは定期的に公開され、以下の各リリースについて追跡されます。
メモリー使用量のベンチマーク
さまざまなシナリオで想定されるメモリー使用量を記録します。
9.1 - etcd v3のベンチマーク
物理マシン
GCE n1-highcpu-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD × 1
- OS用の専用低速ディスク × 1
- メモリー1.8 GB
- CPU × 2
- etcdバージョン2.2.0
etcd クラスター
v3デモモードで稼働するetcdメンバー1つ
テスト
etcd v3ベンチマークツール を使用します。
性能
単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 読み取りQPS | 90パーセンタイルのレイテンシー(ms) |
|---|---|---|---|
| 256 | 1 | 2716 | 0.4 |
| 256 | 64 | 16623 | 6.1 |
| 256 | 256 | 16622 | 21.7 |
空のサーバーハンドラーを使用した場合と、ほぼ同じ性能です。
書き込み後の単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 読み取りQPS | 90パーセンタイルのレイテンシー(ms) |
|---|---|---|---|
| 256 | 1 | 2269 | 0.5 |
| 256 | 64 | 13582 | 8.6 |
| 256 | 256 | 13262 | 47.5 |
空のサーバーハンドラーを使用した場合、1回のputによって性能は変わりません。したがって、性能低下の原因はストレージパッケージにあると考えられます。
9.2 - etcd v2.2.0-rc-memoryのベンチマーク
物理マシン
GCE n1-standard-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD × 1
- OS用の専用低速ディスク × 1
- メモリー7.5 GB
- CPU × 2
etcd
テスト
各メンバーが2コアを使用する3メンバーのetcdクラスターを起動します。
キー名の長さは常に64バイトとします。これは、キーの平均的なバイト長として妥当な長さです。
最大メモリー使用量
- フォロワーの1つが停止し、リーダーがスナップショットを送信し続けると、etcdのメモリー使用量が最大になる場合があります。
max RSSは、3回の実行で記録された最大メモリー使用量です。
| 値のバイト数 | キー数 | データサイズ(MB) | 最大RSS(MB) | リーダーの最大RSSとデータサイズの比率 |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
データサイズのしきい値
- etcdのデータサイズがしきい値に達すると、リーダー選出が起こりやすくなり、提案の一部が破棄される場合があります。
- ほとんどの場合、しきい値に達していなければetcdクラスターは問題なく動作するはずです。リソース不足によって正常に動作しない場合は、データサイズを減らしてください。
| 値のバイト数 | キー数の上限 | 推奨データサイズしきい値(MB) | 使用RSS(MB) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
10 - アップグレード
10.1 - etcdクラスターとアプリケーションのアップグレード
このセクションには、etcdクラスターとアプリケーションのアップグレードに関するドキュメントをまとめています。
アップグレード方針
アップグレードを始める前に、etcdでサポートされるアップグレードは次の2つの場合だけであることに注意してください。
- パッチアップグレード: 同じマイナーバージョン内でのパッチリリース間のアップグレードです(例:3.7.0 - 3.7.1)。
- マイナーアップグレード: マイナーバージョンを1つずつ上げるアップグレードです(例:3.6 - 3.7)。マイナーバージョンを飛ばすアップグレードはサポートされず、失敗する可能性が高くなります。次のマイナーバージョンにアップグレードする前に、最新のパッチバージョンに更新してください。
etcd v3.xクラスターのアップグレード
- etcdを3.0から3.1にアップグレード
- etcdを3.1から3.2にアップグレード
- etcdを3.2から3.3にアップグレード
- etcdを3.3から3.4にアップグレード
- etcdを3.4から3.5にアップグレード
- etcdを3.5から3.6にアップグレード
- etcdを3.6から3.7にアップグレード
etcd v2.3からのアップグレード
11 - ダウングレード
11.1 - etcdクラスターとアプリケーションのダウングレード
このセクションには、etcdクラスターとアプリケーションのダウングレードに関するドキュメントをまとめています。
etcd v3.xクラスターのダウングレード
12 - トリアージ
12.1 - PRの管理
目的
PRの管理を迅速にすること。
etcdのPRはhttps://github.com/etcd-io/etcd/pullsに一覧表示されています。
PRにはさまざまなラベル、マイルストーン、レビュアーなどを設定できます。ラベルの詳細な一覧は、次のページを参照してください。
https://github.com/kubernetes/kubernetes/labels
便利なPR検索の例を以下に示します。
対象範囲
このガイドラインは、etcdでPRを管理する際の基本となるドキュメントです。PRの管理への協力はどなたでも歓迎しますが、このドキュメントで扱う作業と責任は、etcdのメンテナーと積極的に活動するコントリビューターを想定しています。
動きのないPRへの対応
レビューコメントに15日間対応がない場合は、PRの作成者に確認を促してください。PRの作成者から90日間返信がない場合は、可能であれば新しいコミットでPRを更新してください。それができなければ、動きのないPRは180日後にクローズするべきです。
必要に応じてレビュアーに確認を促す
レビュアーは適時に応答していますが、全員が忙しいことを考慮し、レビューを依頼してすぐに応答がなくても、しばらく待ってください。10日間応答がなければ、PRへのコメントの追加、メールの送信、Slackでのメッセージ送信によって連絡して構いません。
重要なラベルが付いていることを確認する
PRに適切なレビュアーが追加されていることを確認してください。また、マイルストーンが指定されていることも確認してください。これらの項目やその他の重要なラベルが不足していれば追加してください。適切なラベルを判断できない場合は、必要に応じてメンテナーに対応を依頼するコメントを残してください。