Haute disponibilité multi-centre de données
La haute disponibilité d’un cluster PostgreSQL déployé dans plusieurs centres de données repose sur la réplication, qui peut être synchrone ou asynchrone (voir modes de réplication ).
Dans les deux cas, il est important de bien comprendre les concepts suivants :
- PostgreSQL peut fonctionner en tant que leader primaire ou en mode standby uniquement lorsqu’il détient la clé de leadership et peut mettre à jour cette clé.
- Vous devez exécuter un nombre impair de nœuds etcd, ZooKeeper ou Consul : 3 ou 5 !
Réplication synchrone
Pour disposer d’un cluster multi-DC pouvant tolérer automatiquement la perte d’une zone, un minimum de 3 est requis.
Le diagramme d’architecture serait le suivant :
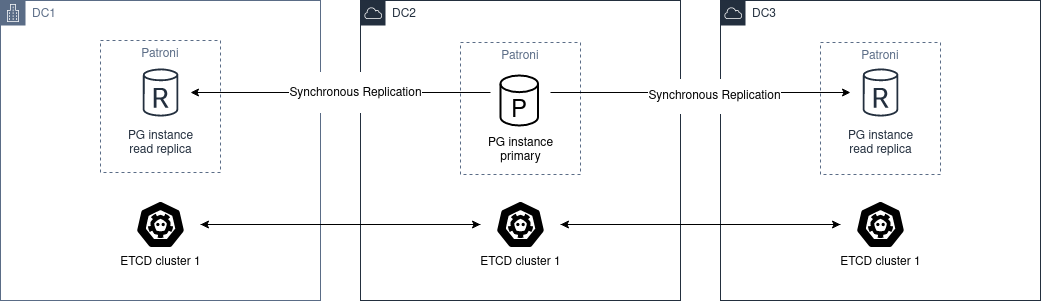
Nous devons déployer un cluster d’etcd, de ZooKeeper ou de Consul à travers les différents DC, avec un minimum de 3 nœuds, un dans chaque zone.
En ce qui concerne PostgreSQL, vous devez déployer au moins 2 nœuds, situés dans des centres de données différents. Ensuite, vous devez définir synchronous_mode: true dans la configuration dynamique globale .
Cela active la réplication synchrone et le nœud primaire choisira l’un des nœuds comme synchrone.
Réplication asynchrone
Avec seulement deux centres de données, il est préférable de disposer de deux clusters etcd indépendants et d’exécuter un cluster de secours Patroni standby cluster dans le second centre de données. Si le premier site tombe en panne, vous pouvez PROMOUVOIR MANUELLEMENT le cluster de secours .
Le diagramme d’architecture serait le suivant :
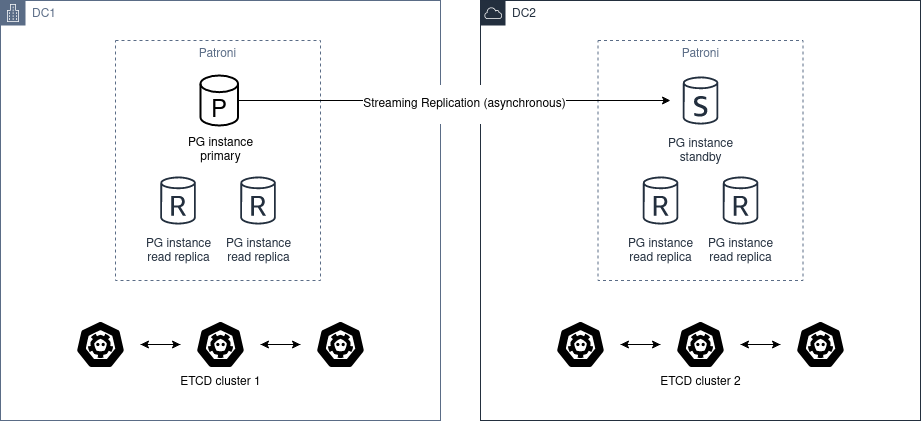
La promotion automatique n’est pas possible, car DC2 ne pourra jamais déterminer l’état de DC1.
Vous devez éviter d’utiliser pg_ctl promote dans ce scénario ; vous devez promouvoir manuellement le cluster sain en supprimant la section standby_cluster
du configuration dynamique
.
[!AVERTISSEMENT]
Si le cluster source est toujours en cours d’exécution et que vous promouvez le cluster de secours, vous créez une situation de split-brain.
En cas de souhait de revenir à l’état « initial », il n’existe que deux moyens de le résoudre :
- Rétablissez la section standby_cluster ; cela déclenchera
pg_rewind. Pour quepg_rewindfonctionne correctement, le cluster doit avoir été initialisé avecdata page checksums(option--data-checksumsdeinitdb) et/ouwal_log_hintsdoit être défini suron. D’autres facteurs peuvent toutefois encore faire échouerpg_rewind. - Reconstruisez entièrement le cluster standby.
Avant de promouvoir le cluster de secours, il faut manuellement s’assurer que le cluster source est arrêté (STONITH). Lorsque DC1 reprend, le cluster doit être converti en cluster de secours.
Avant de procéder, vous pouvez examiner manuellement la base de données et extraire toutes les modifications survenues entre l’instant où la communication réseau entre DC1 et DC2 a cessé de fonctionner et l’instant où vous avez arrêté manuellement le cluster sur DC1.
Une fois extrait, vous pouvez également appliquer manuellement ces modifications au cluster dans DC2.