Surveillance d’etcd
Chaque serveur etcd fournit des informations de surveillance locales sur son port client via des points de terminaison HTTP. Les données de surveillance sont utiles à la fois pour le contrôle de santé du système et le débogage du cluster.
Point d’entrée de débogage
Si --log-level=debug est défini, le serveur etcd exporte des informations de débogage sur son port client sous le chemin /debug. Prenez garde à la définition de --log-level=debug, car cela entraînera une dégradation des performances et une journalisation verbose.
Le point de terminaison /debug/pprof est le point de terminaison standard de profilage du runtime Go. Il peut être utilisé pour profiler l’utilisation du processeur, de la mémoire, des verrous et des goroutines. Par exemple, voici comment obtenir les 10 fonctions où etcd consacre le plus de temps :
go tool pprof
Le point de terminaison /debug/requests permet d’obtenir des traces gRPC et des statistiques de performance via un navigateur web. Par exemple, voici une requête Range pour la clé abc :
Point d’extrémité des métriques
Chaque serveur etcd exporte des métriques sous le chemin /metrics sur son port client, et éventuellement sur les emplacements indiqués par --listen-metrics-urls.
Les métriques peuvent être récupérées avec curl :
Vérification de santé
Depuis la version 3.3.0, outre la réponse à l’endpoint /metrics, toutes les localisations spécifiées par --listen-metrics-urls répondent également à l’endpoint /health. Cela peut être utile si l’endpoint standard est configuré avec une authentification TLS mutuelle (client), mais qu’un équilibreur de charge ou un service de surveillance doit tout de même accéder à la vérification de santé.
Depuis la version 3.4, deux nouveaux points d’entrée /livez et /readyz ont été ajoutés.
- le point de terminaison
/livezindique si le processus est actif ou s’il nécessite un redémarrage. - le point de terminaison
/readyzindique si le processus est prêt à servir le trafic.
Les détails de conception des points de terminaison sont documentés dans le KEP .
Chaque point de terminaison inclut plusieurs vérifications de santé individuelles, et vous pouvez utiliser le paramètre verbose pour afficher les détails des vérifications et leur état, par exemple
et vous verriez une réponse similaire à
L’API HTTP prend également en charge l’exclusion de vérifications spécifiques, par exemple
Prometheus
Exécuter un service de surveillance Prometheus est la méthode la plus simple pour ingérer et enregistrer les métriques d’etcd.
Tout d’abord, installez Prometheus :
Configurez l’extracteur Prometheus pour cibler les points d’accès du cluster etcd :
Configurez le gestionnaire Prometheus :
Prometheus récupérera désormais les métriques etcd toutes les 10 secondes.
Alerting
Il existe un ensemble d’alertes par défaut pour les clusters etcd v3 destinées à Prometheus .
Notez que les étiquettes job peuvent nécessiter un ajustement pour répondre à un besoin particulier. Les règles ont été rédigées pour s’appliquer à un seul cluster, il est donc recommandé de choisir des étiquettes uniques par cluster.
Grafana
Grafana dispose d’un support intégré pour Prometheus ; ajoutez simplement une source de données Prometheus :
Ensuite, importez le modèle de tableau de bord par défaut etcd dashboard template
et personnalisez-le. Par exemple, si le nom de la source de données Prometheus est my-etcd, les valeurs du champ datasource dans le JSON doivent également être my-etcd.
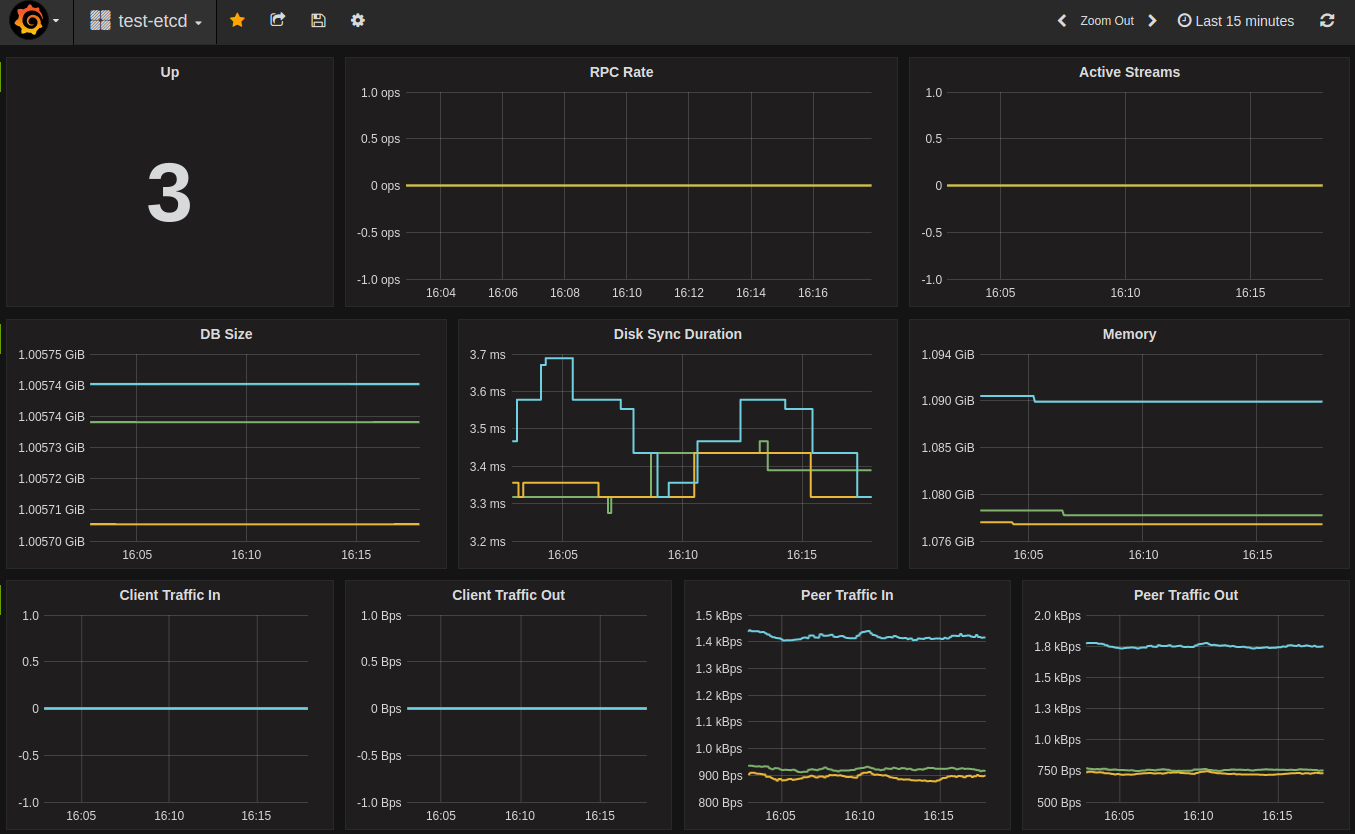
Tableau de bord d’exemple :
Traçage distribué
À partir de la version 3.5, etcd prend en charge le traçage distribué à l’aide de OpenTelemetry .
Cette fonctionnalité est encore expérimentale et peut être modifiée à tout moment.
Pour activer cette fonctionnalité expérimentale, passez le paramètre --experimental-enable-distributed-tracing=true au serveur etcd, ainsi que le drapeau --experimental-distributed-tracing-sampling-rate=<number> pour choisir le nombre d’échantillons à collecter par million de spans ; le taux d’échantillonnage par défaut est 0.
Configurez le traçage distribué en lançant le serveur etcd avec les indicateurs facultatifs suivants :
--experimental-distributed-tracing-address- (Facultatif) - « localhost:4317 » - Adresse du collecteur de traçage.--experimental-distributed-tracing-service-name- (Facultatif) - « etcd » - Nom du service de traçage distribué, doit être identique sur toutes les instances etcd.--experimental-distributed-tracing-instance-id- (Facultatif) - Identifiant d’instance ; bien qu’optionnel, il est fortement recommandé de le définir, et doit être unique par instance etcd.
Avant d’activer le traçage distribué, assurez-vous d’avoir un point de terminaison OpenTelemetry. Si cette adresse diffère de la valeur par défaut, remplacez-la à l’aide du drapeau --experimental-distributed-tracing-address. En raison des différentes manières de faire fonctionner OpenTelemetry, consultez la documentation du collector
pour en savoir plus.
Un surcroît de charge ressource existe, comme pour tout signal d’observabilité ; selon nos mesures initiales, cette surcharge pourrait s’élever entre 2 % et 4 % de la charge CPU.