Modèle de données
etcd est conçu pour stocker de manière fiable des données peu fréquemment mises à jour et fournir des requêtes de surveillance fiables. etcd expose les versions antérieures des paires clé-valeur afin de prendre en charge des instantanés à faible coût et les événements de historique de surveillance (« requêtes de voyage dans le temps »). Un modèle de données persistant, à plusieurs versions et contrôlant la concurrence s’adapte parfaitement à ces cas d’utilisation.
etcd stocke les données dans un magasin clé-valeur multiversion persistent . Le magasin clé-valeur préserve la version précédente d’une paire clé-valeur lorsque sa valeur est remplacée par de nouvelles données. Le magasin clé-valeur est effectivement immuable ; ses opérations ne mettent pas à jour la structure in situ, mais génèrent toujours une nouvelle structure mise à jour. Toutes les versions antérieures des clés restent accessibles et surveillables après modification. Pour empêcher que le magasin de données ne croisse indéfiniment au fil du temps et ne conserve des anciennes versions, le magasin peut être compacté afin de supprimer les versions les plus anciennes des données remplacées.
Vue logique
La vue logique du magasin est un espace binaire plat de clés. L’espace de clés dispose d’un index trié par ordre lexical sur les chaînes d’octets, ce qui rend les requêtes de plage peu coûteuses.
L’espace clé maintient plusieurs révisions. Lors de la création du magasin, la révision initiale est 1. Chaque opération mutative atomique (par exemple, une opération de transaction peut contenir plusieurs opérations) crée une nouvelle révision dans l’espace clé. Toutes les données détenues par les révisions précédentes restent inchangées. Les anciennes versions des clés peuvent toujours être consultées via les révisions antérieures. De même, les révisions sont indexées ; parcourir les révisions via des observateurs est efficace. Si le magasin est compacté pour économiser de l’espace, les révisions antérieures à la révision de compactage seront supprimées. Les révisions augmentent de manière monotone au cours de la durée de vie d’un cluster.
La durée de vie d’une clé s’étend sur une génération, depuis sa création jusqu’à sa suppression. Chaque clé peut avoir une ou plusieurs générations. La création d’une clé incrémente la version de cette clé, qui commence à 1 si la clé n’existe pas à la révision courante. La suppression d’une clé génère un jeton de suppression (tombstone), mettant fin à la génération courante de la clé en réinitialisant sa version à 0. Chaque modification d’une clé incrémente sa version ; ainsi, les versions augmentent de manière monotone au sein d’une génération de clé. Une fois un compactage effectué, toute génération terminée avant la révision de compactage est supprimée, ainsi que toutes les valeurs définies avant la révision de compactage, à l’exception de la dernière.
Vue physique
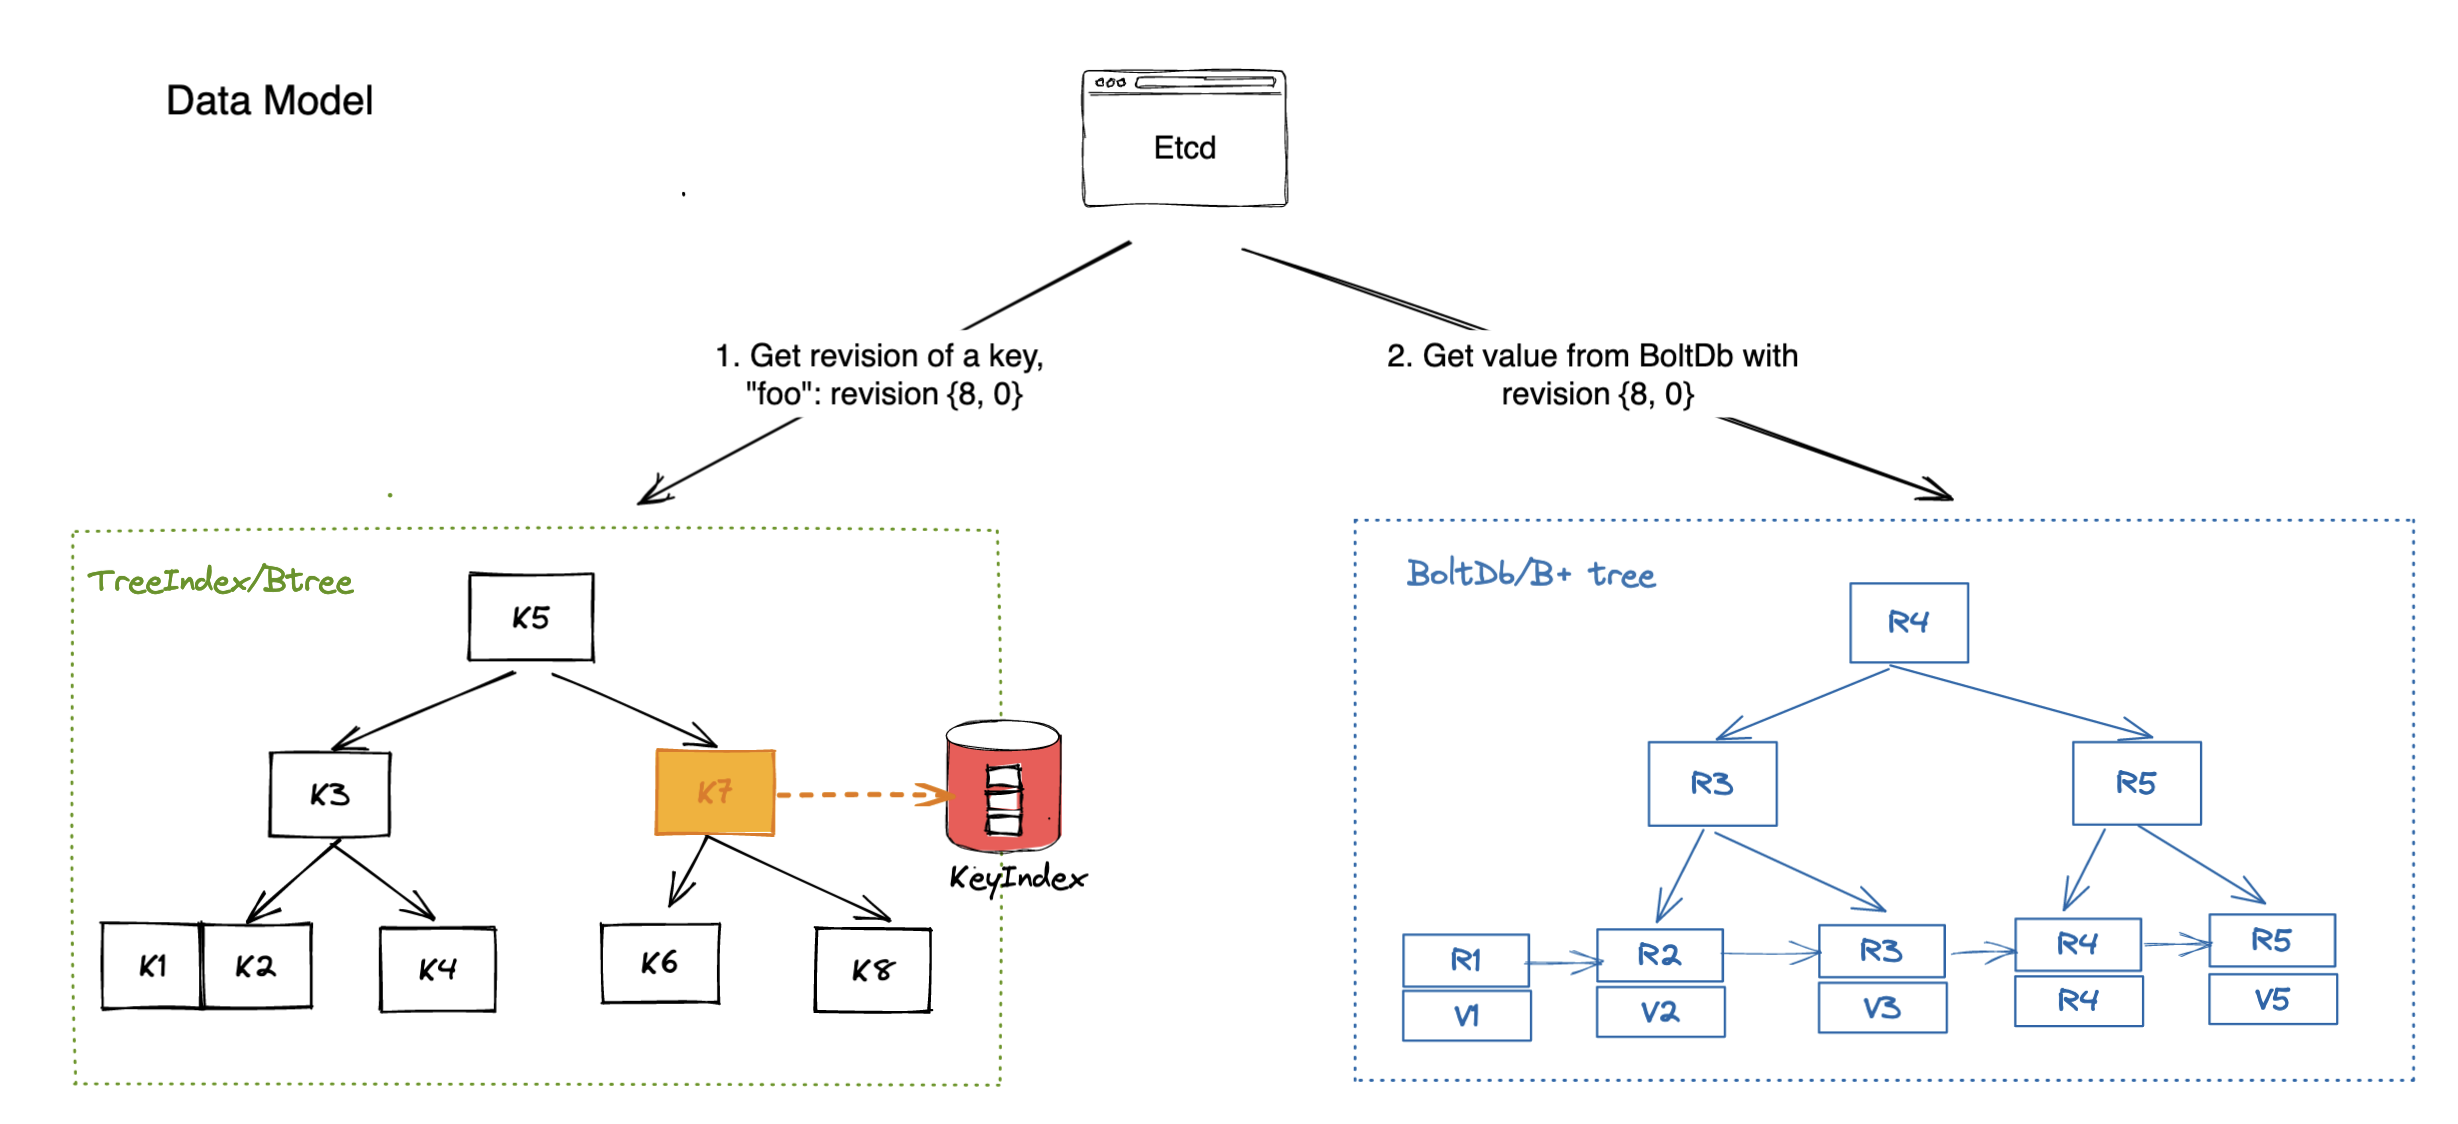
etcd stocke les données physiques sous forme de paires clé-valeur dans un arbre b+ persistant b+tree . Chaque révision de l’état du magasin ne contient que les différences par rapport à sa révision précédente, afin d’optimiser l’efficacité. Une seule révision peut correspondre à plusieurs clés dans l’arbre.
La clé d’une paire clé-valeur est un triplet (major, sub, type). Le champ major est la révision du magasin contenant la clé. Le champ sub permet de distinguer les clés au sein de la même révision. Le champ type est un suffixe facultatif pour des valeurs spéciales (par exemple, t si la valeur contient une suppression logique). La valeur de la paire clé-valeur contient la modification par rapport à la révision précédente, donc une différence par rapport à la révision précédente. L’arbre B+ est trié par clé selon l’ordre lexical par octets. Les recherches par plage sur les deltas de révision sont rapides ; cela permet de trouver rapidement les modifications entre deux révisions spécifiques. Le compactage supprime les paires clé-valeur obsolètes.
etcd maintient également un index secondaire en mémoire btree afin d’accélérer les requêtes portant sur une plage de clés. Les clés de l’index btree correspondent aux clés du magasin exposées à l’utilisateur. La valeur est un pointeur vers la modification du b+tree persistant. Le compactage supprime les pointeurs inutilisés.
Ensemble, etcd obtient les informations de révision à partir de l’arbre b, puis utilise la révision comme clé pour récupérer la valeur à partir de l’arbre b+ (comme illustré ci-dessous).