Vue imprimable multi-pages de cette section. .
Documentation Patroni 4.1.5
- 1: Introduction
- 2: Installation
- 3: Configuration Patroni
- 4: API REST Patroni
- 5: patronictl
- 6: Imagerie de réplique et amorçage
- 7: Modes de réplication
- 8: cluster de secours
- 9: Prise en charge du watchdog
- 10: Mode Pause/Reprise pour le cluster
- 11: Mode de secours DCS
- 12: Utilisation de Patroni avec Kubernetes
- 13: Prise en charge Citus
- 14: Convertir un nœud autonome en cluster Patroni
- 15: Intégration avec d'autres outils
- 16: Considérations de sécurité
- 17: Haute disponibilité multi-centre de données
- 18: FAQ
- 19: Notes de version
- 20: Guidelines pour les contributions
[!AVERTISSEMENT]
Exécution de Patroni sur des systèmes à mémoire limitée avec Python 3.11+
Si vous exécutez Patroni sur un système avec des limites de mémoire strictes, par exemple avec vm.overcommit_memory=2 (recommandé pour PostgreSQL), et utilisez Python 3.11 ou une version ultérieure, vous pouvez observer un comportement inattendu :
- Patroni est en état sain
- PostgreSQL continue de s’exécuter
- L’API REST de Patroni devient inopérante
- Le système d’exploitation indique que Patroni écoute sur le port de l’API REST
- Les journaux de Patroni semblent normaux ; cependant, les messages suivants peuvent apparaître une fois :
Exception ignored in thread started by: <object repr() failed>,MemoryError - Les journaux du noyau peuvent contenir des messages tels que
not enough memory for the allocation
Ce comportement est dû à un bug dans Python 3.11+ . Sous des conditions de mémoire strictes, le démarrage d’un nouveau thread peut bloquer indéfiniment en l’absence de mémoire libre.
Solution recommandée
Les versions récentes de Patroni (4.1.1+, 4.0.8+) réduisent l’impact de ce problème en lançant tous les threads requis dès le démarrage, avant que le système ne soit soumis à une pression mémoire.
Recommandations supplémentaires (Linux, glibc)
Lors de l’exécution avec vm.overcommit_memory=2 (recommandé pour PostgreSQL), nous recommandons également de lancer Patroni avec les variables d’environnement suivantes configurées :
MALLOC_ARENA_MAX=1- réduit la quantité de mémoire virtuelle allouée par glibc aux applications multithreadéesPG_MALLOC_ARENA_MAX=- réinitialise la valeur deMALLOC_ARENA_MAXpour les processus PostgreSQL lancés par Patroni.
En outre, vous pouvez ajuster les paramètres de configuration suivants de Patroni :
thread_stack_size- taille de la pile utilisée par les threads lancés par Patroni. Réduire cette valeur diminue l’utilisation mémoire du processus Patroni. La valeur par défaut définie par Patroni est512kB. Augmentezthread_stack_sizesi Patroni subit des plantages liés à la pile ; sinon, la valeur par défaut est suffisante.thread_pool_size- taille du pool de threads utilisé par Patroni pour les tâches asynchrones et la communication API REST avec les autres membres lors des courses au leader ou des vérifications en mode d’urgence. La valeur par défaut est5, qui est suffisante pour les clusters à trois nœuds.restapi.thread_pool_size- taille du pool de threads utilisé pour traiter les requêtes API REST. La valeur par défaut est5, permettant jusqu’à cinq requêtes API REST en parallèle. Notez que les requêtes impliquant des requêtes SQL sont effectivement sérialisées, car une seule connexion à la base de données est utilisée, aussi l’augmentation de cette valeur ne procure généralement aucun avantage.
Patroni est un modèle de solutions PostgreSQL à haute disponibilité (HA) basé sur Python. Pour une accessibilité maximale, Patroni prend en charge une variété de magasins de configuration distribués, tels que ZooKeeper , etcd , Consul ou Kubernetes . Les ingénieurs base de données, les DBA, les ingénieurs DevOps et les SRE qui souhaitent déployer rapidement une solution PostgreSQL à haute disponibilité dans des datacenters — ou ailleurs — devraient y trouver un intérêt.
Nous appelons Patroni un « modèle » car il est loin d’être un système de réplication universel ou immédiatement utilisable. Il présente ses propres contraintes. À utiliser avec prudence. Il existe de nombreuses façons de mettre en œuvre une haute disponibilité avec PostgreSQL ; pour en consulter la liste, reportez-vous à la Documentation PostgreSQL .
Versions de PostgreSQL actuellement prises en charge : 9.3 à 18.
Remarque aux utilisateurs de Citus : À compter de la version 3.0, Patroni intègre harmonieusement l’extension de base de données Citus pour PostgreSQL. Veuillez consulter la page Prise en charge de Citus dans la documentation de Patroni pour plus d’informations sur l’utilisation de la haute disponibilité Patroni avec un cluster distribué Citus.
Remarque aux utilisateurs Kubernetes : Patroni peut s’exécuter nativement sur Kubernetes. Consultez le chapitre Kubernetes de la documentation Patroni.
1 - Introduction
Patroni est un modèle de solutions PostgreSQL à haute disponibilité (HA) basé sur Python. Patroni a été initialement développé à partir d’une branche de Governor , le projet de Compose. Il intègre de nombreuses fonctionnalités nouvelles.
Pour plus d’informations de contexte, voir :
- Haute disponibilité PostgreSQL avec Kubernetes et Patroni , conférence de Josh Berkus à KubeCon 2016 (vidéo)
- Article du blog technique Zalando, février 2016
Statut de développement
Patroni est en développement actif et accepte les contributions. Consultez notre section Contributing ci-dessous pour plus de détails.
Nous signalons les informations sur les nouvelles versions ici .
Exigences techniques/Installation
Aller à here pour obtenir des instructions sur l’installation et la mise à jour de Patroni sur diverses plates-formes.
Planification du nombre de nœuds PostgreSQL
Les nœuds Patroni/PostgreSQL sont déconnectés des nœuds DCS (sauf lorsque Patroni implémente lui-même RAFT) et il n’existe donc aucune exigence concernant le nombre minimal de nœuds. Exécuter un cluster composé d’un nœud primaire et d’un nœud en veille est tout à fait acceptable. Vous pouvez ajouter davantage de nœuds en veille ultérieurement.
Clusters à 2 nœuds (primaire + secondaire) sont courants et offrent un basculement automatique avec une haute disponibilité. Notez qu’en cas de basculement, vous aurez temporairement une absence de redondance jusqu’à ce que le nœud défaillant se reconnecte.
Exigences du DCS : Votre DCS (etcd, ZooKeeper, Consul) doit fonctionner avec 3 ou 5 nœuds pour assurer un consensus correct et une tolérance aux pannes. Un seul cluster DCS peut stocker des informations pour des centaines ou des milliers de clusters Patroni en utilisant différentes combinaisons d’espace de noms (namespace) ou de portée (scope).
Exécution et configuration
La section suivante suppose que le dépôt Patroni a été cloné à partir de https://github.com/patroni/patroni
. Vous aurez besoin des fichiers de configuration exemple postgres0.yml et postgres1.yml. Si vous avez installé Patroni avec pip, vous pouvez obtenir ces fichiers à partir du dépôt git et remplacer ./patroni.py ci-dessous par la commande patroni.
Pour commencer, effectuez les opérations suivantes depuis des terminaux distincts :
> etcd --data-dir=data/etcd --enable-v2=true
> ./patroni.py postgres0.yml
> ./patroni.py postgres1.yml
Vous verrez alors un cluster à haute disponibilité démarrer. Testez différents paramètres dans les fichiers YAML pour observer les changements de comportement du cluster. Mettez hors service certains composants pour observer le comportement du système.
Ajoutez davantage de fichiers postgres*.yml pour créer un cluster encore plus grand.
Patroni fournit une configuration HAProxy , qui permet à votre application de se connecter au leader du cluster via un seul point d’accès. Pour la configurer, exécutez :
> haproxy -f haproxy.cfg

> psql --host 127.0.0.1 --port 5000 postgres
Configuration YAML
Aller à here pour obtenir des informations complètes sur les paramètres d’etcd, consul et ZooKeeper. Pour un exemple, voir postgres0.yml .
Configuration de l’environnement
Accédez à ici pour obtenir des informations complètes sur la configuration (remplacement) des paramètres via des variables d’environnement.
Options de réplication
Patroni utilise la réplication en streaming de Postgres, qui est asynchrone par défaut. La configuration de réplication asynchrone de Patroni permet de définir les paramètres maximum_lag_on_failover. Ce paramètre garantit qu’un basculement ne se produira pas si un suiveur est retardé de plus d’un certain nombre d’octets par rapport au leader. Ce paramètre doit être ajusté en fonction des besoins métiers. Il est également possible d’utiliser la réplication synchrone pour des garanties de durabilité renforcées. Voir la documentation sur les modes de réplication pour plus de détails
.
Les applications ne doivent pas utiliser de superutilisateurs
Lors de la connexion depuis une application, utilisez toujours un utilisateur non superutilisateur. Patroni nécessite un accès à la base de données pour fonctionner correctement. En utilisant un superutilisateur depuis une application, vous risquez d’utiliser l’intégralité du pool de connexions, y compris les connexions réservées aux superutilisateurs, avec le paramètre superuser_reserved_connections. Si Patroni ne parvient pas à accéder au primaire car le pool de connexions est plein, le comportement sera indésirable.
Test de votre solution haute disponibilité
Tester une solution haute disponibilité est une opération longue, soumise à de nombreux facteurs. Cela est particulièrement vrai lorsqu’il s’agit d’une application multiplateforme. Un administrateur système expérimenté ou un consultant est nécessaire pour mener à bien cette tâche. Ce point ne peut pas être traité en profondeur dans la documentation.
En revanche, voici quelques composants de votre infrastructure que vous devez impérativement tester :
- Réseau (le réseau devant votre système ainsi que les cartes réseau elles-mêmes)
- E/S disque
- Limites de fichiers (nofile sous Linux)
- Mémoire RAM. Même si l’oomkiller est désactivé, l’indisponibilité de la mémoire RAM peut entraîner des problèmes.
- Processeur
- Contestation de virtualisation (surallocation du système hôte)
- Toute limitation cgroup (probablement liée à ce qui précède)
kill -9de tout processus postgres (à l’exception du postmaster !). Ceci constitue une simulation raisonnable d’un plantage.
Une chose que vous ne devez pas faire est d’exécuter kill -9 sur un processus postmaster. Cela s’explique par le fait que cela ne reproduit aucun scénario réel. Si vous craignez que votre infrastructure soit compromise et qu’un attaquant puisse exécuter kill -9, aucune configuration de haute disponibilité ne pourra résoudre ce problème. L’attaquant supprimera simplement le processus à nouveau, ou provoquera d’autres perturbations.
2 - Installation
Prérequis pour Mac OS
Pour installer les prérequis sur un Mac, exécutez la commande suivante :
Psycopg
À compter de psycopg2-2.8
, la version binaire de psycopg2 ne sera plus installée par défaut. Son installation à partir du code source nécessite un compilateur C ainsi que les paquets de développement postgres+python. Étant donné qu’environnement Python ne permet pas de spécifier la dépendance comme psycopg2 OR psycopg2-binary, vous devrez déterminer vous-même la méthode d’installation.
Plusieurs options sont disponibles :
- Utilisez le gestionnaire de paquets de votre distribution
- Indiquez
psycopg,psycopg2oupsycopg2-binarydans la liste des dépendances lors de l’installation de Patroni avec pip.
Installation générale de pip
Patroni peut être installé avec pip :
où dependencies peut être vide ou composé d’un ou plusieurs des éléments suivants :
etcd ou etcd3
module python-etcd afin d’utiliser etcd comme magasin de configuration distribué (DCS)
consul
module py-consul afin d’utiliser Consul comme DCS
zookeeper
module kazoo afin d’utiliser Zookeeper comme DCS
exhibitor
module kazoo afin d’utiliser Exhibitor comme DCS (mêmes dépendances que pour Zookeeper)
kubernetes kubernetes module afin d’utiliser Kubernetes comme DCS dans Patroni
raft
module pysyncobj afin d’utiliser l’implémentation Python de Raft comme DCS
aws
boto3 afin d’utiliser les rappels AWS
jsonlogger
module python-json-logger afin d’activer la journalisation logging
au format JSON
systemd
systemd-python afin d’utiliser l’intégration sd_notify
tous tous les précédents (à l’exception de la famille psycopg)
psycopg3
module psycopg\[binary\]\>=3.0.0
psycopg2
module psycopg2\>=2.5.4
psycopg2-binary
module psycopg2-binary
Par exemple, la commande permettant d’installer Patroni avec psycopg3, les dépendances pour etcd en tant que DCS, et les rappels AWS est :
Notez que les outils externes appelés lors de la création d’une réplique ou dans des scripts d’amorçage personnalisés (par exemple WAL-E) doivent être installés indépendamment de Patroni.
Installation du paquet sous Linux
Les paquets Patroni peuvent être disponibles pour votre système d’exploitation, produits par la communauté Postgres pour :
- RHEL, Rocky Linux, AlmaLinux ;
- Debian et Ubuntu ;
- SUSE Enterprise Linux.
Vous pouvez également trouver des paquets pour les dépendances directes de Patroni, telles que des modules Python qui pourraient ne pas être disponibles dans les dépôts officiels du système d’exploitation.
Pour plus d’informations, consultez la documentation du dépôt PGDG .
Si vous utilisez un système d’exploitation dérivé de RedHat Enterprise Linux, vous devrez peut-être également installer des paquets provenant du dépôt EPEL repository .
Une fois que vous avez installé le dépôt PGDG pour votre système d’exploitation, vous pouvez installer Patroni.
Les paquets Patroni ne sont pas maintenus par les développeurs Patroni, mais par la communauté Postgres. Si vous avez besoin d’assistance, essayez d’abord de vous connecter sur Postgres slack .
Installation sur les dérivés de Debian
Avec le dépôt PGDG installé, consultez ci-dessus , puis installez Patroni via apt en exécutant :
Installation sur les dérivés RedHat
Avec le dépôt PGDG installé, voir ci-dessus , installez Patroni avec un DCS etcd via dnf sur RHEL 9 (et dérivés) en exécutant :
Vous pouvez installer etcd à partir de PGDG si votre distribution dérivée de RedHat ne fournit pas de paquets. Sur les nœuds qui hébergeront le DCS, exécutez :
Vous pouvez remplacer la version de RHEL par 8 dans le dépôt afin de créer pgdg-rhel8-extras si nécessaire. Le nom du dépôt reste pgdg-rhelN-extras sur RockyLinux, AlmaLinux, Oracle Linux, etc…
Installation sur SUSE Enterprise Linux
Vous devrez peut-être activer les référentiels SUSE PackageHub pour certaines dépendances. Voir la documentation de SUSE PackageHub .
Pour SLES 15 avec le dépôt PGDG installé, consultez ci-dessus pour installer Patroni avec :
Avec le dépôt PackageHub SUSE activé, vous pouvez également installer etcd :
Mise à jour
La mise à jour de Patroni est un processus très simple : mettez à jour l’installation logicielle, puis redémarrez le démon Patroni sur chaque nœud du cluster.
Toutefois, redémarrer le démon Patroni entraîne un redémarrage de la base de données PostgreSQL. Dans certaines situations, cela peut provoquer un basculement du nœud primaire de votre cluster ; il est donc recommandé de mettre le cluster en mode maintenance jusqu’à la fin du redémarrage du démon Patroni.
Pour placer le cluster en mode maintenance, exécutez la commande suivante sur l’un des nœuds Patroni :
Ensuite, sur chaque nœud du cluster, effectuez la mise à jour du paquet nécessaire pour votre système d’exploitation :
Redémarrez le processus daemon Patroni sur chaque nœud :
Enfin, reprenez la surveillance de Postgres avec Patroni afin de sortir le serveur du mode maintenance :
Le cluster sera désormais entièrement opérationnel avec la nouvelle version de Patroni.
3 - Configuration Patroni
Il existe 3 types de configuration Patroni :
Configuration dynamique globale pending_restart . Ces options sont stockées dans le magasin de configuration distribué (DCS) et appliquées sur tous les nœuds du cluster. La configuration dynamique peut être définie à tout moment à l’aide de l’outil patronictl_edit_config ou de l’API REST de Patroni REST API . Si les options modifiées ne font pas partie de la configuration au démarrage, elles sont appliquées de manière asynchrone (lors du prochain cycle de réveil) sur chaque nœud, qui est ensuite rechargé. Si le nœud nécessite un redémarrage pour appliquer la configuration (pour les paramètres PostgreSQL avec contexte postmaster, lorsque leurs valeurs ont changé), un indicateur spécial
pending_restartindiquant cela est défini dans le fichier JSON members.data. En outre, l’état du nœud indique cela en affichant"restart_pending": true.Fichier de configuration local patroni.yml (patroni.yml). Ces options sont définies dans le fichier de configuration et ont priorité sur la configuration dynamique.
patroni.ymlpeut être modifié et rechargé en cours d’exécution (sans redémarrage de Patroni) en envoyant le signal SIGHUP au processus Patroni, en effectuant une requêtePOST /reloadREST-API ou en exécutant patronictl_reload . La configuration locale peut être un fichier YAML unique ou un répertoire. Lorsqu’il s’agit d’un répertoire, tous les fichiers YAML qu’il contient sont chargés un par un dans l’ordre trié. En cas de définition d’une clé dans plusieurs fichiers, l’occurrence dans le dernier fichier a priorité.Configuration de l’environnement . Il est possible de définir/écraser certains paramètres de configuration « Local » à l’aide de variables d’environnement. La configuration par environnement est particulièrement utile lorsque vous exécutez l’application dans un environnement dynamique et que vous ne connaissez pas certains paramètres à l’avance (par exemple, il n’est pas possible de connaître votre adresse IP externe lorsque vous êtes exécuté à l’intérieur de
docker).
Règles importantes
Paramètres PostgreSQL contrôlés par Patroni
Certains paramètres PostgreSQL doivent avoir les mêmes valeurs sur le primaire et les répliques. Pour ces paramètres, les valeurs définies dans les fichiers de configuration localisés de Patroni ou via les variables d’environnement n’ont aucun effet. Pour modifier ou définir leurs valeurs, il faut modifier la configuration partagée dans le DCS. Voici la liste réelle de ces paramètres, accompagnée de leurs valeurs par défaut et minimales :
- max_connections : valeur par défaut 100, valeur minimale 25
- max_locks_per_transaction : valeur par défaut 64, valeur minimale 32
- max_worker_processes : valeur par défaut 8, valeur minimale 2
- max_prepared_transactions : valeur par défaut 0, valeur minimale 0
- wal_level : valeur par défaut hot_standby, valeurs acceptées : hot_standby, replica, logical
- track_commit_timestamp : valeur par défaut off
Pour les paramètres ci-dessous, PostgreSQL n’exige pas que les valeurs soient identiques entre le primaire et toutes les répliques. Toutefois, étant donné la possibilité qu’une réplique devienne le primaire à tout moment, il n’a guère de sens de les configurer différemment ; par conséquent, Patroni limite leur définition à la configuration dynamique .
- max_wal_senders : valeur par défaut 10, valeur minimale 3
- max_replication_slots : valeur par défaut 10, valeur minimale 4
- wal_keep_segments : valeur par défaut 8, valeur minimale 1
- wal_keep_size : valeur par défaut 128 Mo, valeur minimale 16 Mo
- wal_log_hints : activé
Ces paramètres sont vérifiés afin de s’assurer qu’ils sont valides ou qu’ils atteignent une valeur minimale.
Certains autres paramètres Postgres sont contrôlés par Patroni :
- listen_addresses - est défini soit à partir de la variable d’environnement
postgresql.listen, soit à partir de la variable d’environnementPATRONI_POSTGRESQL_LISTEN - port - est défini soit à partir de la variable d’environnement
postgresql.listen, soit à partir de la variable d’environnementPATRONI_POSTGRESQL_LISTEN - cluster_name - est défini soit à partir de la variable d’environnement
scope, soit à partir de la variable d’environnementPATRONI_SCOPE - hot_standby: on
Pour plus de sécurité, les paramètres provenant des listes ci-dessus sont écrits dans postgresql.conf, puis passés sous forme de liste d’arguments à postgres, qui leur accorde la plus haute priorité (sauf wal_keep_segments et wal_keep_size), même au-dessus de ALTER SYSTEM
Il existe également des paramètres tels que PostgreSQL.listen, PostgreSQL.data_dir qui peuvent être définis uniquement localement, c’est-à-dire dans le fichier de configuration Patroni config ou via la variable d’environnement configuration . Dans la plupart des cas, la configuration locale remplace la configuration dynamique.
Lors de l’application des options de configuration locales ou dynamiques, les actions suivantes sont effectuées :
- Le nœud vérifie d’abord s’il existe un fichier
postgresql.base.confou si le paramètrecustom_confest défini. - Si le paramètre
custom_confest défini, le fichier qu’il spécifie est utilisé comme configuration de base, en ignorantpostgresql.base.confetpostgresql.conf. - Si le paramètre
custom_confn’est pas défini et quepostgresql.base.confexiste, il contient la configuration « originale » renommée et est utilisé comme configuration de base. - Si aucun fichier
custom_confnipostgresql.base.confn’existe, le fichierpostgresql.confd’origine est renommé enpostgresql.base.confet utilisé comme configuration de base. - Les options dynamiques (à l’exception de celles mentionnées ci-dessus) sont exportées dans
postgresql.conf, et une directive d’inclusion est ajoutée danspostgresql.confvers la configuration de base (soitpostgresql.base.conf, soit le fichier situé àcustom_conf). Ainsi, il est possible d’appliquer de nouvelles options sans devoir relire le fichier de configuration pour vérifier la présence de l’inclusion. - Certains paramètres essentiels à la gestion du cluster par Patroni sont remplacés par la ligne de commande.
- Si une option nécessitant un redémarrage est modifiée (il faut examiner le contexte dans pg_settings et les valeurs réelles de ces options), un indicateur pending_restart est défini sur ce nœud. Cet indicateur est réinitialisé à chaque redémarrage.
Les paramètres seront appliqués dans l’ordre suivant (les paramètres en temps d’exécution ont la priorité la plus élevée) :
- charger les paramètres à partir du fichier
postgresql.base.conf(ou à partir d’un fichiercustom_conf, le cas échéant) - charger les paramètres à partir du fichier
postgresql.conf - charger les paramètres à partir du fichier
postgresql.auto.conf - paramètre en temps d’exécution utilisant
-o --name=value
Cela permet la configuration de tous les nœuds (2), la configuration d’un nœud spécifique à l’aide de ALTER SYSTEM (3) et garantit que les paramètres essentiels au fonctionnement de Patroni sont appliqués (4), tout en laissant de la place aux outils de configuration qui gèrent postgresql.conf directement sans impliquer Patroni (1).
Paramètres PostgreSQL affectant la mémoire partagée
PostgreSQL dispose de certains paramètres qui déterminent la taille de la mémoire partagée qu’ils utilisent :
- max_connections
- max_prepared_transactions
- max_locks_per_transaction
- max_wal_senders
- max_worker_processes
La modification de ces paramètres nécessite un redémarrage de PostgreSQL pour prendre effet, et leurs structures de mémoire partagée ne peuvent pas être plus petites sur les nœuds secondaires que sur le nœud primaire.
Comme expliqué précédemment, Patroni limite la modification de leurs valeurs à la configuration dynamique , qui comprend généralement :
- Application des modifications via patronictl_edit_config
(ou via l’API REST
/configpoint d’accès) - Redémarrage des nœuds via patronictl_restart
(ou via l’API REST
/restartpoint d’accès)
Note : veillez à redémarrer les nœuds PostgreSQL à l’aide de la commande patronictl_restart
, ou via l’endpoint REST /restart. Une tentative de redémarrage de PostgreSQL en redémarrant le démon Patroni, par exemple en exécutant systemctl restart patroni, peut provoquer un basculement dans le cluster, si vous redémarrez le nœud primaire.
Toutefois, comme ces paramètres gèrent la mémoire partagée, une attention particulière doit être portée lors du redémarrage des nœuds :
Si vous souhaitez augmenter la valeur de l’un de ces paramètres :
- Redémarrez tous les serveurs secondaires en premier
- Redémarrez le serveur primaire ensuite
Si vous souhaitez réduire la valeur de l’un de ces paramètres :
- Redémarrez le serveur primaire en premier
- Redémarrez ensuite tous les serveurs secondaires
Remarque : si vous tentez de redémarrer tous les nœuds en même temps après avoir diminué la valeur de l’un de ces paramètres, Patroni ignorera le changement et redémarrera le secondaire avec la valeur d’origine, ce qui nécessitera de redémarrer à nouveau les secondaires ultérieurement. Patroni agit ainsi pour empêcher le secondaire de tomber dans une boucle de redémarrages infinie, car PostgreSQL quitte avec un message FATAL si vous tentez de définir l’un de ces paramètres à une valeur inférieure à celle visible dans pg_controldata sur le nœud secondaire. Autrement dit, nous ne pouvons diminuer le paramètre sur le secondaire qu’une fois que son pg_controldata est à jour avec le primaire concernant ces modifications apportées au primaire.
Plus d’informations à ce sujet sont disponibles dans Aperçu administrateur PostgreSQL .
Paramètres de configuration Patroni
En outre, les options de configuration suivantes de Patroni peuvent être modifiées uniquement de manière dynamique :
- ttl : 30
- loop_wait : 10
- retry_timeout : 10
- maximum_lag_on_failover : 1048576
- max_timelines_history : 0
- check_timeline : false
- PostgreSQL.use_slots : true
Lorsque ces options sont modifiées, Patroni lit la section correspondante de la configuration stockée dans le DCS et met à jour ses valeurs en cours d’exécution.
Les nœuds Patroni enregistrent l’état des options du DCS sur le disque à chaque modification de configuration, dans le fichier patroni.dynamic.json situé dans le répertoire de données de Postgres. Seul le leader est autorisé à restaurer ces options à partir de la sauvegarde sur disque si elles sont totalement absentes du DCS ou si elles sont invalides.
Génération et validation de la configuration
Patroni fournit des interfaces en ligne de commande pour générer et valider une configuration locale
. Avec l’exécutable patroni, vous pouvez :
- Créez une configuration Patroni d’exemple locale ;
- Créez un fichier de configuration Patroni pour l’instance PostgreSQL en cours d’exécution localement (par exemple, comme étape de préparation pour l’intégration Patroni ) ;
- Validez un fichier de configuration Patroni donné.
Configuration exemple de Patroni
Description
Générez un fichier de configuration Patroni d’exemple au format yaml. Les valeurs des paramètres sont définies à l’aide de la configuration Environnement
, sinon, si non définies, les valeurs par défaut utilisées par Patroni ou la chaîne #FIXME sont utilisées pour les valeurs qui devront être définies ultérieurement par l’utilisateur.
Certains valeurs par défaut sont définies en fonction de la configuration locale :
- PostgreSQL.listen : l’adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard5432.- PostgreSQL.connect_address : l’adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard5432.- PostgreSQL.authentication.rewind : n’est défini que si la version de PostgreSQL peut être déterminée à partir du binaire et que la version est 11 ou ultérieure.
- restapi.listen : adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard8008.- restapi.connect_address : adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard8008.
Paramètres
configfile - chemin complet du fichier de configuration utilisé pour stocker le résultat. Si non fourni, le résultat est envoyé à stdout.
Configuration Patroni pour une instance en cours d’exécution
Description
Générez une configuration Patroni au format yaml pour l’instance PostgreSQL exécutée localement. Le DSN fourni, qui est prioritaire, ou les variables d’environnement
de PostgreSQL serviront à la connexion. Si aucun mot de passe n’est fourni, vous devrez le saisir à l’invite.
Toutes les options GUC non internes définies dans l’instance Postgres source, qu’elles aient été configurées via un fichier de configuration, via la ligne de commande du postmaster ou via des variables d’environnement, serviront de source pour les paramètres de configuration Patroni suivants :
- scope : valeur GUC
cluster_name;- PostgreSQL.listen : valeurs GUC
listen_addressesetport;- PostgreSQL.datadir : valeur GUC
data_directory;- PostgreSQL.parameters : valeurs GUC
archive_command,restore_command,archive_cleanup_command,recovery_end_command,ssl_passphrase_command,hba_file,ident_file,config_file;- bootstrap.dcs : toutes les autres valeurs GUC PostgreSQL collectées.
Si scope, postgresql.listen ou postgresql.datadir n’est pas défini à partir des paramètres GUC de Postgres, la valeur respective de la configuration Environment
est utilisée.
Autres règles applicables à la définition des valeurs :
- name : valeur de la variable d’environnement
PATRONI_NAMEsi définie, sinon le nom d’hôte de la machine actuelle.- PostgreSQL.bin_dir : chemin vers les binaires Postgres extraits de l’instance en cours d’exécution.
- PostgreSQL.connect_address : adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port utilisé pour la connexion à l’instance, ou la valeur du paramètre GUCport.- PostgreSQL.authentication.superuser : configuration utilisée pour la connexion à l’instance ;
- PostgreSQL.pg_hba : lignes extraites depuis le fichier
hba_filede l’instance source.- PostgreSQL.pg_ident : lignes extraites depuis le fichier
ident_filede l’instance source.- restapi.listen : adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard8008.- restapi.connect_address : adresse IP renvoyée par l’appel à
gethostnamepour le nom d’hôte de la machine actuelle et le port standard8008.
Les autres paramètres définis à l’aide de la configuration Environnement sont également inclus dans la configuration.
Paramètres
configfile
Chemin complet du fichier de configuration utilisé pour stocker le résultat. Si ce chemin n’est pas fourni, le résultat est envoyé à stdout.
dsn
Chaîne DSN facultative pour l’instance PostgreSQL locale afin d’obtenir les valeurs GUC.
Valider la configuration Patroni
Description
Validez la configuration Patroni fournie et affichez les informations relatives aux vérifications échouées.
Paramètres
configfile
Chemin complet du fichier de configuration à vérifier. Si non fourni ou si le fichier n’existe pas, tentera de lire à partir de la variable d’environnement PATRONI_CONFIG_VARIABLE, ou, si elle n’est pas définie, à partir des variables d’environnement Patroni Patroni
.
--ignore-listen-port | -i
Indicateur facultatif pour ignorer les échecs de liaison des ports listen déjà en cours d’utilisation lors de la validation de configfile.
--print | -p
Indicateur facultatif pour afficher la configuration locale (y compris les substitutions de configuration d’environnement) après sa validation réussie.
3.1 - Paramètres de configuration dynamique
La configuration dynamique est stockée dans le magasin de configuration distribué (DCS) et appliquée sur tous les nœuds du cluster.
Pour modifier la configuration dynamique, vous pouvez utiliser soit l’outil patronictl_edit_config , soit l’API REST de Patroni REST API .
- loop_wait : nombre de secondes pendant lesquelles la boucle s’endort. Valeur par défaut : 10, valeur minimale possible : 1
- ttl : durée de vie du verrou de leader (en secondes). Pensez-y comme la durée avant le déclenchement du processus de basculement automatique. Valeur par défaut : 30, valeur minimale possible : 20
- retry_timeout : délai d’attente pour les nouvelles tentatives des opérations DCS et PostgreSQL (en secondes). Les problèmes DCS ou réseau de durée inférieure à cette valeur ne provoqueront pas la désactivation du leader par Patroni. Valeur par défaut : 10, valeur minimale possible : 3
[!AVERTISSEMENT]
Lorsque vous modifiez les valeurs de loop_wait, retry_timeout ou ttl, vous devez respecter la règle suivante :
- maximum_lag_on_failover : le nombre maximum d’octets dont un suiveur peut être en retard pour pouvoir participer à l’élection du leader.
- primary_race_backoff : reporte l’élection du leader sur les répliques secondaires de
primary_race_backoffsecondes si la réplication WAL depuis le primaire progresse encore. Cela permet de réduire les basculements inutiles causés par une réponse temporairement bloquée de Patroni. Valeur par défaut : 0 (désactivé). - maximum_lag_on_syncnode : le nombre maximum d’octets dont un suiveur synchrone peut être en retard avant d’être considéré comme un candidat défaillant et remplacé par un suiveur asynchrone sain. Patroni utilise le LSN du réplique maximum s’il y a plusieurs suiveurs, sinon il utilise le LSN actuel du leader. Valeur par défaut : -1. Patroni ne prendra aucune mesure pour remplacer un suiveur synchrone défaillant lorsque cette valeur est réglée à 0 ou inférieure. Veuillez définir une valeur suffisamment élevée pour éviter que Patroni ne remplace fréquemment un suiveur synchrone pendant des pics de charge transactionnelle.
- max_timelines_history : nombre maximum d’éléments d’historique de timeline conservés dans le DCS. Valeur par défaut : 0. Lorsqu’elle est réglée sur 0, l’historique complet est conservé dans le DCS.
- primary_start_timeout : durée autorisée à un serveur primaire pour se rétablir après une panne avant que le basculement ne soit déclenché (en secondes). Valeur par défaut : 300 secondes. Si cette valeur est réglée sur 0, le basculement est effectué immédiatement après détection d’une panne, si possible. En cas de réplication asynchrone, un basculement peut entraîner la perte de transactions. Le temps de basculement maximal en cas de panne du primaire est : loop_wait + primary_start_timeout + loop_wait, sauf si primary_start_timeout est égal à zéro, auquel cas il est simplement égal à loop_wait. Ajustez cette valeur en fonction de votre compromis entre durabilité et disponibilité.
- primary_stop_timeout : nombre de secondes pendant lesquelles Patroni est autorisé à attendre lors de l’arrêt de Postgres, et qui n’est effectif que lorsque synchronous_mode est activé. Si la valeur est supérieure à 0 et que synchronous_mode est activé, Patroni envoie un signal SIGKILL au postmaster si l’opération d’arrêt dure plus longtemps que la valeur définie par primary_stop_timeout. Définissez cette valeur en fonction de votre compromis entre durabilité et disponibilité. Si ce paramètre n’est pas défini ou est défini à une valeur inférieure ou égale à 0, primary_stop_timeout n’est pas pris en compte.
- synchronous_mode : active le mode de réplication synchrone. Valeurs possibles :
off,on,quorum. Dans ce mode, le leader gère la gestion desynchronous_standby_names, et seul le dernier leader connu, ou l’une des répliques synchrones, est autorisée à participer à la course au leader. Le mode synchrone garantit que les transactions validées ne seront pas perdues lors d’un basculement, au prix de la perte de disponibilité pour les écritures lorsque Patroni ne peut pas garantir la durabilité des transactions. Voir la documentation sur les modes de réplication pour plus de détails. - synchronous_mode_strict : empêche la désactivation de la réplication synchrone si aucune réplique synchrone n’est disponible, bloquant toutes les écritures clients sur le primaire. Lorsque cette option est définie et qu’aucune réplique admissible n’est en cours de diffusion, Patroni maintient
synchronous_standby_namespointant vers les derniers nœuds synchrones connus à partir de la clé/syncdu DCS, ou utilise le placeholder interne__patroni_strict_sync_replica_placeholder__lorsque aucun état synchrone antérieur n’existe. Le nœudnamedanspatroni.yamlne doit pas être défini sur__patroni_strict_sync_replica_placeholder__. Consultez la documentation des modes de réplication pour plus de détails. - synchronous_node_count : si le mode synchronous_mode
est activé, ce paramètre est utilisé par Patroni pour gérer le nombre précis d’instances de standby synchrones et ajuste l’état dans le DCS ainsi que le paramètre
synchronous_standby_namesdans PostgreSQL au fur et à mesure que les membres rejoignent ou quittent le cluster. Si la valeur est définie à un nombre supérieur au nombre de nœuds éligibles, elle sera automatiquement ajustée. Valeur par défaut :1. - failsafe_mode : active le mode DCS Failsafe Mode
. Valeur par défaut :
false. - PostgreSQL :
- use_pg_rewind : indique si pg_rewind doit être utilisé. Valeur par défaut :
false. Notez que le cluster doit avoir été initialisé avecdata page checksums(--data-checksumsoption pourinitdb) et/ouwal_log_hintsdoit être défini àon, sinonpg_rewindne fonctionnera pas. - use_slots : indique si les slots de réplication doivent être utilisés. Valeur par défaut :
truesur PostgreSQL 9.4+. - recovery_conf : paramètres de configuration supplémentaires écrits dans recovery.conf lors de la configuration du suiveur. Il n’existe plus de recovery.conf dans PostgreSQL 12, mais vous pouvez continuer à utiliser cette section, car Patroni la gère de manière transparente.
- parameters : paramètres de configuration (GUC) pour Postgres au format
{max_connections: 100, wal_level: "replica", max_wal_senders: 10, wal_log_hints: "on"}. La plupart de ces paramètres sont requis pour que la réplication fonctionne. - parameters_primary : (facultatif) substitutions de paramètres spécifiques au rôle pour le leader. Ces valeurs sont fusionnées avec et remplacent celles du paramètre parameters.
- parameters_replica : (facultatif) substitutions de paramètres spécifiques au rôle pour la réplique. Ces valeurs sont fusionnées avec et remplacent celles du paramètre parameters.
- parameters_standby_leader : (facultatif) substitutions de paramètres spécifiques au rôle pour le standby_leader. Ces valeurs sont fusionnées avec et remplacent celles du paramètre parameters.
- pg_hba : liste de lignes que Patroni utilisera pour générer
pg_hba.conf. Patroni ignore ce paramètre si le paramètre PostgreSQLhba_fileest défini avec une valeur différente de celle par défaut.- - host all all 0.0.0.0/0 md5
- - host replication replicator 127.0.0.1/32 md5 : une ligne de ce type est obligatoire pour la réplication.
- pg_hba_primary : (facultatif) entrées pg_hba spécifiques au rôle primaire. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
- pg_hba_replica : (facultatif) entrées pg_hba spécifiques au rôle réplique. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
- pg_hba_standby_leader : (facultatif) entrées pg_hba spécifiques au rôle standby_leader. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
- pg_ident : liste de lignes que Patroni utilisera pour générer
pg_ident.conf. Patroni ignore ce paramètre si le paramètreident_filePostgreSQL est défini avec une valeur autre que celle par défaut.- - mapname1 systemname1 pguser1
- - mapname1 systemname2 pguser2
- pg_ident_primary : (facultatif) entrées pg_ident spécifiques au rôle primaire. Elles remplacent entièrement pg_ident (pas de fusion). Si non définies, pg_ident est utilisée.
- pg_ident_replica : (facultatif) entrées pg_ident spécifiques au rôle réplique. Elles remplacent entièrement pg_ident (pas de fusion). Si non définies, pg_ident est utilisée.
- pg_ident_standby_leader : (facultatif) entrées pg_ident spécifiques au rôle cluster de secours leader. Elles remplacent entièrement pg_ident (pas de fusion). Si non définies, pg_ident est utilisée.
- use_pg_rewind : indique si pg_rewind doit être utilisé. Valeur par défaut :
- standby_cluster : si cette section est définie, un amorçage d’un cluster de secours est requis.
- host : adresse du nœud distant
- port : port du nœud distant
- primary_slot_name : nom de la slot à utiliser sur le nœud distant pour la réplication. Ce paramètre est facultatif ; sa valeur par défaut est dérivée du nom de l’instance (voir la fonction
slot_name_from_member_name). - create_replica_methods : liste ordonnée des méthodes pouvant être utilisées pour amorcer un leader de secours à partir du primaire distant, peut différer de la liste définie dans postgresql_settings
- restore_command : commande permettant de restaurer les enregistrements WAL depuis le primaire distant vers les nœuds d’un cluster de secours, peut différer de la liste définie dans postgresql_settings
- archive_cleanup_command : commande de nettoyage pour le leader de secours
- recovery_min_apply_delay : durée d’attente avant d’appliquer réellement les enregistrements WAL sur un leader de secours
- member_slots_ttl : durée de rétention des slots de réplication physique pour les répliques lorsqu’elles sont arrêtées. Valeur par défaut :
30min. Définissez-la sur0si vous souhaitez conserver le comportement ancien (lorsque la clé du membre expire dans le DCS, le slot est supprimé immédiatement). Cette fonctionnalité n’est disponible qu’à partir de PostgreSQL 11. - slots : définir des slots de réplication permanents. Ces slots seront préservés lors d’un basculement planifié ou d’un basculement. Les slots permanents qui n’existent pas seront créés par Patroni. À partir de PostgreSQL 11, les slots physiques permanents sont créés sur tous les nœuds et leur position est avancée toutes les loop_wait secondes. Pour les versions de PostgreSQL antérieures à 11, les slots de réplication physiques permanents ne sont maintenus que sur le primaire actuel. Les slots logiques sont copiés depuis le primaire vers une réplique lors d’un redémarrage, puis leur position est avancée toutes les loop_wait secondes (le cas échéant). La copie des fichiers de slots logiques s’effectue via la connexion
libpqet à l’aide des identifiants de rewind ou des identifiants de superutilisateur (voir la section PostgreSQL.authentication). Il existe toujours un risque que la position du slot logique sur la réplique soit légèrement en retard par rapport au précédent primaire, l’application doit donc être préparée à recevoir certains messages une seconde fois après un basculement. La méthode la plus simple consiste à suivreconfirmed_flush_lsn. L’activation des slots de réplication permanents nécessite que PostgreSQL.use_slots soit défini àtrue. Si des slots de réplication logiques permanents sont définis, Patroni les activera automatiquementhot_standby_feedback. Étant donné que le basculement des slots de réplication logiques est dangereux sous PostgreSQL 9.6 et versions antérieures, et que PostgreSQL 10 manque certaines fonctions essentielles, cette fonctionnalité n’est disponible qu’avec PostgreSQL 11+.- my_slot_name : le nom de la slot de réplication permanente. Si le nom de la slot permanente correspond à celui du nœud actuel, celle-ci ne sera pas créée sur ce nœud. Si vous ajoutez une slot de réplication physique permanente dont le nom correspond à celui d’un membre Patroni, Patroni veillera à ce que la slot créée ne soit pas supprimée, même si le membre correspondant devient inactif, situation qui entraînerait normalement la suppression de la slot par Patroni. Bien que cela puisse être utile dans certaines situations, par exemple lorsque vous souhaitez que les slots de réplication utilisés par les membres persistent pendant des défaillances temporaires ou lors de l’importation de membres existants dans un nouveau cluster Patroni (voir Convert a Standalone to a Patroni Cluster
pour plus de détails), l’opérateur doit exercer une prudence particulière afin que ces conflits de noms ne soient pas persistés dans le DCS, lorsque la slot n’est plus nécessaire, en raison de leur impact sur le fonctionnement normal de Patroni.
- type : type de slot. Peut être
physicaloulogical. Si le slot est logique, vous devez également définirdatabaseetplugin. Si le slot est physique, vous pouvez éventuellement définircluster_type. - database : nom de la base de données où les slots logiques doivent être créés.
- plugin : nom du plugin pour le slot logique.
- cluster_type : type de cluster (
primaryoustandby) sur lequel le slot doit être créé, sinon il ne sera pas créé ou un slot existant sera supprimé.
- type : type de slot. Peut être
- my_slot_name : le nom de la slot de réplication permanente. Si le nom de la slot permanente correspond à celui du nœud actuel, celle-ci ne sera pas créée sur ce nœud. Si vous ajoutez une slot de réplication physique permanente dont le nom correspond à celui d’un membre Patroni, Patroni veillera à ce que la slot créée ne soit pas supprimée, même si le membre correspondant devient inactif, situation qui entraînerait normalement la suppression de la slot par Patroni. Bien que cela puisse être utile dans certaines situations, par exemple lorsque vous souhaitez que les slots de réplication utilisés par les membres persistent pendant des défaillances temporaires ou lors de l’importation de membres existants dans un nouveau cluster Patroni (voir Convert a Standalone to a Patroni Cluster
pour plus de détails), l’opérateur doit exercer une prudence particulière afin que ces conflits de noms ne soient pas persistés dans le DCS, lorsque la slot n’est plus nécessaire, en raison de leur impact sur le fonctionnement normal de Patroni.
- ignore_slots : liste de jeux de propriétés de slot de réplication que Patroni doit ignorer. Cette configuration/ce fonctionnalité est utile lorsque certains slots de réplication sont gérés en dehors de Patroni. Toute sous-ensemble de propriétés correspondantes entraînera l’ignorance d’un slot.
- name : nom du slot de réplication.
- type : type de slot. Peut être
physicaloulogical. Si le slot est logique, vous pouvez éventuellement définirdatabaseet/ouplugin. - database : le nom de la base de données (lorsqu’il correspond à une borne
logical). - plugin : le plugin de décodage logique (lorsqu’il correspond à une borne
logical).
Note : slots est une carte associatives tandis que ignore_slots est un tableau. Par exemple :
Note : Lorsque PostgreSQL v11 ou une version ultérieure est utilisé, Patroni maintient des slots de réplication physique sur tous les nœuds pouvant devenir un leader, afin que les nœuds répliques conservent les segments WAL réservés s’ils sont potentiellement requis par d’autres nœuds. Si un nœud est absent et que sa clé membre dans le DCS expire, le slot de réplication correspondant est supprimé après member_slots_ttl (valeur par défaut : 30min). Vous pouvez ajuster cette durée en fonction de vos besoins. En alternative, si la topologie du cluster est statique (nombre fixe de nœuds dont les noms ne changent jamais), vous pouvez configurer des slots de réplication physique permanents nommés selon les noms des nœuds afin d’éviter la suppression des slots et le recyclage des fichiers WAL pendant une indisponibilité temporaire de la réplique :
[!AVERTISSEMENT]
Les slots de réplication permanents ne sont synchronisés qu’à partir du
primary/standby_leadervers les nœuds répliques. Cela signifie que les applications doivent les utiliser uniquement depuis le nœud leader. Leur utilisation sur les nœuds répliques entraîne une croissance indéfinie depg_walsur tous les autres nœuds du cluster. Une exception à cette règle concerne les slots physiques correspondant aux noms des membres Patroni (créés et gérés par Patroni). Ces slots sont synchronisés entre tous les nœuds, car ils sont utilisés pour la réplication entre eux.
[!AVERTISSEMENT]
Définir l’étiquette
nostreamsur un nœud de secours désactive la copie et la synchronisation des emplacements de réplication logique permanents sur ce nœud lui-même et sur toutes ses répliques en cascade, le cas échéant.
3.2 - Paramètres de configuration YAML
Global/Universel
- thread_pool_size : taille du pool de threads utilisé par Patroni pour exécuter les tâches asynchrones et communiquer via l’API REST avec les autres membres lors d’une course au leader ou lors de vérifications en mode d’urgence. Valeur minimale :
5, valeur par défaut :5. - thread_stack_size : spécifie la taille de la pile à utiliser pour les threads lancés par Patroni. La valeur doit être alignée sur
64kB. Valeur minimale :64kB, valeur par défaut (définie par Patroni) :512kB. - name : le nom de l’hôte. Doit être unique dans le cluster. La valeur
__patroni_strict_sync_replica_placeholder__est réservée à une utilisation interne par Patroni et ne peut pas être utilisée comme nom de nœud. - namespace : chemin dans le magasin de configuration où Patroni stockera les informations sur le cluster. Valeur par défaut : “/service”
- scope : nom du cluster
Journalisation
- type : définit le format des journaux. Peut être soit plain soit json. Pour utiliser le format json, vous devez avoir installé jsonlogger . La valeur par défaut est plain.
- level : définit le niveau général de journalisation. La valeur par défaut est INFO (voir la documentation sur le module logging de Python )
- traceback_level : définit le niveau à partir duquel les traces d’erreur sont visibles. La valeur par défaut est ERROR. Définissez-la sur DEBUG si vous souhaitez voir les traces d’erreur uniquement lorsque log.level=DEBUG est activé.
- format : définit la chaîne de formatage des journaux. Si le type de journal est plain, le format de journal doit être une chaîne. Reportez-vous à les attributs LogRecord pour obtenir la liste des attributs disponibles. Si le type de journal est json, le format de journal peut être une liste en plus d’une chaîne. Chaque élément de la liste doit correspondre à un attribut LogRecord. Prenez garde à ce que seul le nom du champ soit requis, et que les %( et ) doivent être omis. Si vous souhaitez afficher un champ de journal avec un nom de clé différent, utilisez un dictionnaire où la clé du dictionnaire est le champ de journal, et la valeur est le nom du champ que vous souhaitez afficher dans le journal. Valeur par défaut : %(asctime)s %(levelname)s : %(message)s
- dateformat : définit la chaîne de formatage de la date et de l’heure. (voir la documentation de formatTime() )
- static_fields : ajoute des champs supplémentaires au journal. Cette option n’est disponible que lorsque le type de journal est défini sur json.
- max_queue_size : Patroni utilise une journalisation en deux étapes. Les enregistrements de journal sont écrits dans une file mémoire et un thread distinct les extrait de la file pour les écrire sur stderr ou dans un fichier. La taille maximale de la file interne est limitée par défaut à 1000 enregistrements, ce qui suffit à conserver les journaux des dernières 1h20.
- dir : Répertoire dans lequel écrire les journaux d’application. Le répertoire doit exister et être accessible en écriture par l’utilisateur exécutant Patroni. Si cette valeur est définie, l’application conserve par défaut 4 fichiers de journaux de 25 Mo chacun. Vous pouvez ajuster ces valeurs de rétention à l’aide de
file_numetfile_size(voir ci-dessous). - mode : Permissions des fichiers de journal (par exemple,
0644). Si non spécifié, les permissions sont déterminées selon la valeur courante de umask. - file_num : Nombre de fichiers de journaux d’application à conserver.
- file_size : Taille du fichier patroni.log (en octets) qui déclenche un roulement des journaux.
- loggers : Cette section permet de redéfinir le niveau de journalisation par module Python.
- Patroni.postmaster : AVERTISSEMENT
- urllib3 : DEBUG
- deduplicate_heartbeat_logs : Si défini à
true, les journaux de battement de cœur identiques successifs ne seront pas affichés. La valeur par défaut estfalse.
[!AVERTISSEMENT]
Le moment auquel la boucle HA s’exécute peut constituer une information très utile pour diagnostiquer les basculements dus à une épuisement des ressources et à des problèmes similaires. Lorsque
deduplicate_heartbeat_logsest défini surtrue, aucun journal n’est généré pour l’exécution de la boucle HA (sauf en cas de changement de leader), ce qui fait que cette information potentiellement utile ne sera pas disponible dans les journaux.
Voici un exemple de configuration de Patroni pour activer la journalisation au format JSON.
Configuration d’amorçage
Une fois que Patroni a initialisé le cluster pour la première fois et que les paramètres ont été stockés dans le DCS, toutes les modifications ultérieures apportées à la section bootstrap.dcs du fichier de configuration YAML n’auront aucun effet ! Pour les modifier, utilisez soit la commande patronictl_edit_config
, soit l’API REST de Patroni REST API
.
- amorçage :
dcs : Cette section sera écrite dans /<namespace>/<scope>/config du magasin de configuration donné après l’amorçage du nouveau cluster. La configuration dynamique globale du cluster. Vous pouvez y placer n’importe quel paramètre décrit dans les Paramètres de configuration dynamique sous
bootstrap.dcs; une fois Patroni initialisé (amorcé) le nouveau cluster, il écrira cette section dans /<namespace>/<scope>/config du magasin de configuration.method : script personnalisé à utiliser pour amorcer ce cluster.
Consultez la documentation des méthodes d’amorçage personnalisées pour plus de détails. Lorsque
initdbest spécifié, la commande par défautinitdbest utilisée.initdbest également déclenché lorsque le paramètremethodest absent du fichier de configuration.initdb : (facultatif) liste des options à passer à initdb.
- - data-checksums : doit être activé lorsque pg_rewind est nécessaire sur la version 9.3.
- - encoding : UTF8 : encodage par défaut pour les nouvelles bases de données.
- - locale : UTF8 : paramètre régional par défaut pour les nouvelles bases de données.
post_bootstrap ou post_init : un script supplémentaire exécuté après l’initialisation du cluster. Le script reçoit une chaîne de connexion au format URL (avec l’utilisateur superutilisateur du cluster). La variable PGPASSFILE est définie sur le chemin d’accès au fichier pgpass.
Citus
Active l’intégration de Patroni avec Citus . Si configuré, Patroni s’occupe de l’enregistrement des nœuds workers Citus sur le coordinateur. Vous trouverez plus d’informations sur le support Citus ici .
- groupe : l’identifiant du groupe Citus, entier. Utilisez
0pour le coordinateur et1,2, etc. pour les workers - base_de_données : la base de données où l’extension citus doit être créée. Doit être identique sur le coordinateur et tous les workers. Actuellement, une seule base de données est prise en charge.
Consul
La plupart des paramètres sont facultatifs, mais vous devez renseigner host ou url.
- host : l’hôte:port de l’agent local Consul.
- url : URL de l’agent local Consul, au format : http(s)://host:port.
- port : (facultatif) port de Consul.
- scheme : (facultatif) http ou https, par défaut http.
- token : (facultatif) jeton ACL.
- verify : (facultatif) indique si le certificat SSL doit être vérifié pour les requêtes HTTPS.
- cacert : (facultatif) certificat CA. Si présent, active la validation.
- cert : (facultatif) fichier contenant le certificat client.
- key : (facultatif) fichier contenant la clé client. Peut être vide si la clé est incluse dans cert.
- dc : (facultatif) Centre de données avec lequel établir la communication. Par défaut, la centrale de l’hôte est utilisée.
- consistency : (facultatif) Sélectionne le mode de cohérence de consul. Les valeurs possibles sont
default,consistentoustale(plus de détails dans référence API consul ) - checks : (facultatif) liste des vérifications de santé Consul utilisées pour la session. Par défaut, une liste vide est utilisée.
- register_service : (facultatif) indique s’il faut enregistrer un service avec le nom défini par le paramètre scope et l’étiquette master, primary, replica ou standby-leader selon le rôle du nœud. La valeur par défaut est false.
- service_tags : (facultatif) étiquettes statiques supplémentaires à ajouter au service Consul, en plus du rôle (
primary/replica/standby-leader). Par défaut, une liste vide est utilisée. - service_check_interval : (facultatif) fréquence à laquelle effectuer la vérification de santé contre l’URL enregistrée. Valeur par défaut : « 5s ».
- service_check_tls_server_name : (facultatif) remplacer le nom d’hôte SNI lors de la connexion via TLS, voir également référence de l’API de vérification du nœud Consul .
Le token doit disposer des autorisations ACL suivantes :
service_prefix "${scope}" {
    policy = "write"
}
key_prefix "${namespace}/${scope}" {
    policy = "write"
}
session_prefix "" {
    policy = "write"
}
etcd
La plupart des paramètres sont facultatifs, mais vous devez spécifier l’un des éléments suivants : host, hosts, url, proxy ou srv
- host : l’hôte:port de l’endpoint etcd.
- hosts : liste des endpoints etcd au format hôte1:port1,hôte2:port2,etc. Peut être une chaîne séparée par des virgules ou une liste YAML réelle.
- use_proxies : si ce paramètre est défini à true, Patroni considère hosts comme une liste de proxys et ne procède pas à la découverte de la topologie du cluster etcd.
- url : URL de l’endpoint etcd.
- proxy : URL du proxy pour etcd. Si vous vous connectez à etcd via un proxy, utilisez ce paramètre au lieu de url.
- srv : Domaine dans lequel rechercher les enregistrements SRV pour la découverte automatique du cluster. Patroni tentera de consulter ces noms de service SRV pour le domaine spécifié (dans cet ordre, jusqu’à la première réussite) :
_etcd-client-ssl,_etcd-client,_etcd-ssl,_etcd,_etcd-server-ssl,_etcd-server. Si des enregistrements SRV pour_etcd-server-sslou_etcd-serversont récupérés, le protocole pair ETCD sera utilisé pour interroger ETCD afin d’obtenir la liste des membres disponibles. Sinon, les hôtes provenant des enregistrements SRV seront utilisés. - srv_suffix : Configure un suffixe pour le nom SRV interrogé lors de la découverte. Utilisez cette option pour distinguer plusieurs clusters etcd sous le même domaine. Fonctionne uniquement en conjonction avec srv. Par exemple, si
srv_suffix: fooetsrv: example.orgsont définis, la requête DNS SRV suivante est effectuée :_etcd-client-ssl-foo._tcp.example.com(et ainsi de suite pour chaque nom de service SRV etcd possible). - protocol : (facultatif) http ou https, si non spécifié, http est utilisé. Si url ou proxy est spécifié, le protocole est déduit de ces valeurs.
- username : (facultatif) nom d’utilisateur pour l’authentification etcd.
- password : (facultatif) mot de passe pour l’authentification etcd.
- cacert : (facultatif) certificat CA. Si présent, active la validation.
- cert : (facultatif) fichier contenant le certificat client.
- key : (facultatif) fichier contenant la clé client. Peut être vide si la clé est incluse dans cert.
Etcdv3
Si vous souhaitez que Patroni fonctionne avec un cluster etcd via la version 3 du protocole, vous devez utiliser la section etcd3 dans le fichier de configuration de Patroni. Tous les paramètres de configuration sont identiques à ceux de etcd.
[!AVERTISSEMENT]
Les clés créées avec la version 2 du protocole ne sont pas visibles avec la version 3 du protocole, et inversement ; il n’est donc pas possible de passer de
etcdàetcd3en mettant simplement à jour le fichier de configuration Patroni. En outre, Patroni utilise la passerelle gRPC d’etcd (proxy) pour communiquer avec l’API V3, ce qui rend l’authentification par nom commun TLS impossible.
ZooKeeper
- hosts : Liste des membres du cluster ZooKeeper au format : .
- use_ssl : (facultatif) Indique si le protocole SSL est utilisé. Valeur par défaut :
false. Si défini àfalse, tous les paramètres spécifiques à SSL sont ignorés. - cacert : (facultatif) Certificat de l’autorité de certification. Présence de ce champ active la validation.
- cert : (facultatif) Fichier contenant le certificat client.
- key : (facultatif) Fichier contenant la clé client.
- key_password : (facultatif) Mot de passe de la clé client.
- verify : (facultatif) Indique si la vérification du certificat doit être effectuée ou non. La valeur par défaut est
true. - set_acls : (facultatif) Si défini, configure Kazoo pour appliquer une ACL par défaut à chaque ZNode qu’il crée. Les ACL peuvent utiliser le schéma
x509(par défaut) ou d’autres schémas ZooKeeper pris en charge, tels quedigest. Elles doivent être spécifiées sous forme de dictionnaire, où la clé est le principal complet (éventuellement préfixé par le schéma) et la valeur une liste de permissions. Les permissions peuvent être une ou plusieurs des valeurs suivantes :CREATE,READ,WRITE,DELETE,ADMIN, ouALL. Par exemple,set_acls: {CN=principal1: [CREATE, READ], digest:principal2:+pjROuBuuwNNSujKyH8dGcEnFPQ=: [ALL]}. - auth_data : (facultatif) Informations d’authentification à utiliser pour la connexion. Doit être un dictionnaire au format où
schemeest la clé etcredentialla valeur. Valeur par défaut : dictionnaire vide.
Il est obligatoire d’installer kazoo>=2.6.0 pour prendre en charge le SSL.
Exposant
- hosts : liste initiale des nœuds Exhibitor (ZooKeeper) au format : « host1,host2,etc… ». Cette liste est mise à jour automatiquement chaque fois que la topologie du cluster Exhibitor (ZooKeeper) change.
- poll_interval : fréquence à laquelle la liste des nœuds ZooKeeper et Exhibitor doit être actualisée depuis Exhibitor.
- port : port Exhibitor.
Kubernetes
- bypass_api_service : (facultatif) Lors de la communication avec l’API Kubernetes, Patroni utilise généralement le service kubernetes
, dont l’adresse est exposée dans les pods via la variable d’environnement
KUBERNETES_SERVICE_HOST. Sibypass_api_serviceest défini surtrue, Patroni résout la liste des nœuds API derrière le service et établit une connexion directe avec eux. - namespace : (facultatif) espace de noms Kubernetes dans lequel s’exécute le pod Patroni. Valeur par défaut :
default. - labels : Étiquettes au format
{label1: value1, label2: value2}. Ces étiquettes seront utilisées pour localiser les objets existants (Pods et soit des Endpoints, soit des ConfigMaps) associés au cluster actuel. Patroni les définira également sur chaque objet (Endpoint ou ConfigMap) qu’il crée. - scope_label : (facultatif) nom de l’étiquette contenant le nom du cluster. Valeur par défaut :
cluster-name. - bootstrap_labels : (facultatif) Étiquettes au format
{label1: value1, label2: value2}. Ces étiquettes seront attribuées au pod Patroni lorsque son état estinitializing new cluster,running custom bootstrap script,starting after custom bootstrapoucreating replica. - role_label : (facultatif) nom de l’étiquette contenant le rôle (
primary,replicaou autre valeur personnalisée). Patroni définira cette étiquette sur le pod dans lequel il s’exécute. Valeur par défaut :role. - leader_label_value : (facultatif) valeur de l’étiquette du pod lorsque le rôle de Postgres est
primary. Valeur par défaut :primary. - follower_label_value : (facultatif) valeur de l’étiquette du pod lorsque le rôle de Postgres est
replica. Valeur par défaut :replica. - standby_leader_label_value : (facultatif) valeur de l’étiquette du pod lorsque le rôle de Postgres est
standby_leader. Valeur par défaut :primary. - tmp_role_label : (facultatif) nom de l’étiquette temporaire contenant le rôle (
primaryoureplica). La valeur de cette étiquette utilisera toujours la valeur par défaut correspondante au rôle. À définir uniquement si nécessaire. - use_endpoints : (facultatif) si défini à true, Patroni utilisera des Endpoints au lieu de ConfigMaps pour effectuer les élections du leader et maintenir l’état du cluster.
- pod_ip : (facultatif) adresse IP du pod dans lequel s’exécute Patroni. Cette valeur est requise lorsque
use_endpointsest activé et est utilisée pour remplir les sous-ensembles du point de terminaison leader lorsque le PostgreSQL du pod est promu. - ports : (facultatif) si l’objet Service possède un nom de port, ce même nom doit apparaître dans l’objet Endpoint, sinon le service ne fonctionnera pas. Par exemple, si votre service est défini comme
{Kind: Service, spec: {ports: [{name: postgresql, port: 5432, targetPort: 5432}]}}, vous devez définirkubernetes.ports: [{"name": "postgresql", "port": 5432}]et Patroni l’utilisera pour mettre à jour les sous-ensembles de l’Endpoint leader. Ce paramètre n’est utilisé que sikubernetes.use_endpointsest défini. - cacert : (facultatif) indique le fichier CA_BUNDLE contenant les certificats des autorités de certification approuvées pour vérifier les certificats SSL de l’API Kubernetes. En l’absence de valeur, Patroni utilise celle du secret ServiceAccount.
- retriable_http_codes : (facultatif) liste des codes d’état HTTP de l’API K8s pour lesquels une nouvelle tentative doit être effectuée. Par défaut, Patroni réessaie pour
500,503et504, ou lorsque la réponse de l’API K8s contient l’en-tête HTTPretry-after.
Raft (obsolète)
self_addr : adresse
ip:portd’écoute des connexions Raft.self_addrdoit être accessible depuis les autres nœuds du cluster. Sans cette valeur, le nœud ne participe pas au consensus.bind_addr : (facultatif)
ip:portsur lequel écouter pour les connexions Raft. Si non spécifié,self_addrsera utilisé.partner_addrs : liste des autres nœuds Patroni du cluster au format :
data_dir : répertoire dans lequel stocker le journal Raft et les instantanés. Si non spécifié, le répertoire de travail actuel est utilisé.
password : (facultatif) Chiffrer le trafic Raft avec un mot de passe spécifié, nécessite le module
cryptography.min_timeout : (facultatif) délai minimum d’élection en secondes pour l’implémentation Raft sous-jacente pysyncobj. Doit être supérieur à 3 ×
append_entries_period. Valeur par défaut :0.4.max_timeout : (facultatif) délai maximum d’élection en secondes pour l’implémentation Raft sous-jacente pysyncobj. Doit être supérieur à
min_timeout. Valeur par défaut :1.4.connection_timeout : (facultatif) durée en secondes après laquelle une connexion sans réception de données est considérée comme inactive. Doit être supérieur ou égal à
max_timeout. Valeur par défaut :3.5.append_entries_period : (facultatif) intervalle en secondes pour l’envoi des commandes de battement de cœur (append_entries). Doit être inférieur à un tiers de
min_timeout. Valeur par défaut :0.1.connection_retry_time : (facultatif) intervalle en secondes entre les tentatives de reconnexion aux nœuds hors ligne. Valeur par défaut :
5.0.leader_fallback_timeout : (facultatif) durée en secondes après laquelle un leader ne recevant aucune réponse de la majorité redevient un suiveur. Doit être supérieur à
append_entries_period. Valeur par défaut :30.0.
Ces paramètres de temporisation sont utiles dans les réseaux à forte latence où les temporisations par défaut de pysyncobj sont trop strictes. Les contraintes suivantes doivent être respectées : min_timeout > 3 * append_entries_period, max_timeout > min_timeout, connection_timeout >= max_timeout et leader_fallback_timeout > append_entries_period. Patroni vérifie ces conditions au démarrage et refuse de s’exécuter si elles sont violées. Ces valeurs ne peuvent pas être modifiées en cours d’exécution et nécessitent un redémarrage.
[!AVERTISSEMENT]
Ces paramètres ne font que relâcher les temporisations d’élection et de connexion de pysyncobj ; ils n’étendent pas le délai maximal par commande que Patroni applique aux opérations Raft. Chaque commande Raft (rafraîchissement du verrou du leader, écriture de l’état du cluster) doit toujours s’achever dans un délai de retry_timeout (valeur par défaut 10). Sur des liens à très forte latence — environ au-dessus de quelques secondes de temps de trajet aller-retour — une seule commande peut dépasser retry_timeout même si connection_timeout est porté bien au-dessus du RTT, ce qui fait que le DCS semble inaccessible et le primaire peut être rétrogradé. Sur de tels liens, il faut également augmenter retry_timeout et ttl en conséquence, tout en maintenant loop_wait + 2 * retry_timeout <= ttl.
FAQ rapide sur l’implémentation Raft
Q : Comment lister tous les nœuds fournissant le consensus ?
A :
syncobj_admin -conn host:port -statusoù l’adresse hôte:port correspond à l’adresse d’un nœud du clusterQ : Nœud qui faisait partie du consensus et qui a disparu ; je ne peux pas réutiliser la même IP pour un autre nœud. Comment supprimer ce nœud du consensus ?
A :
syncobj_admin -conn host:port -remove host2:port2oùhost2:port2correspond à l’adresse du nœud que vous souhaitez supprimer de la consensus.Q : Où obtenir l’utilitaire
syncobj_admin?A : Il est installé conjointement avec le module
pysyncobj(implémentation Python du protocole RAFT), qui est une dépendance de Patroni.Q : Est-il possible d’exécuter un nœud Patroni sans l’ajouter au consensus ?
A : Oui, il suffit de commenter ou de supprimer
raft.self_addrdans la configuration de Patroni.Q : Est-il possible d’exécuter Patroni et PostgreSQL uniquement sur deux nœuds ?
A : Oui, sur le troisième nœud, vous pouvez exécuter
patroni_raft_controller(sans Patroni ni PostgreSQL). Dans un tel déploiement, il est possible de perdre temporairement un nœud sans affecter le primaire.
PostgreSQL
- PostgreSQL :
authentification :
- superutilisateur :
- utilisateur : nom de l’utilisateur superutilisateur, défini lors de l’initialisation (initdb) et utilisé ultérieurement par Patroni pour se connecter à PostgreSQL.
- mot_de_passe : mot de passe de l’utilisateur superutilisateur, défini lors de l’initialisation (initdb).
- sslmode : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - sslkey : (facultatif) correspond au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- sslpassword : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
sslkey. - sslcert : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- sslrootcert : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- sslcrl : (facultatif) correspond au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera la connexion à tout serveur dont le certificat figure dans cette liste.
- sslcrldir : (facultatif) correspond au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- sslnegotiation : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- gssencmode : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- channel_binding : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du binding de canal par le client.
- replication :
- username : nom d’utilisateur de réplication ; l’utilisateur sera créé lors de l’initialisation. Les répliques utiliseront cet utilisateur pour accéder à la source de réplication via la réplication en flux
- password : mot de passe de réplication ; l’utilisateur sera créé lors de l’initialisation.
- sslmode : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - sslkey : (facultatif) correspond au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- sslpassword : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
sslkey. - sslcert : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- sslrootcert : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- sslcrl : (facultatif) correspond au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera la connexion à tout serveur dont le certificat figure dans cette liste.
- sslcrldir : (facultatif) correspond au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- sslnegotiation : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- gssencmode : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- channel_binding : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du binding de canal par le client.
- rewind :
- username : (facultatif) nom de l’utilisateur pour
pg_rewind; l’utilisateur sera créé lors de l’initialisation de PostgreSQL 11+ et toutes les permissions nécessaires lui seront accordées. - password : (facultatif) mot de passe de l’utilisateur pour
pg_rewind; l’utilisateur sera créé lors de l’initialisation. - sslmode : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - sslkey : (facultatif) correspond au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- sslpassword : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
sslkey. - sslcert : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- sslrootcert : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- sslcrl : (facultatif) correspond au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera la connexion à tout serveur dont le certificat figure dans cette liste.
- sslcrldir : (facultatif) correspond au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- sslnegotiation : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- gssencmode : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- channel_binding : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du binding de canal par le client.
- username : (facultatif) nom de l’utilisateur pour
- superutilisateur :
callbacks : scripts d’appel de retour à exécuter lors de certaines actions. Patroni transmettra l’action, le rôle et le nom du cluster. (Voir le fichier scripts/aws.py pour un exemple de mise en œuvre.)
- on_reload : exécuter ce script lorsqu’une relecture de la configuration est déclenchée.
- on_restart : exécuter ce script lorsqu’un redémarrage de PostgreSQL est effectué (sans changement de rôle).
- on_role_change : exécuter ce script lorsqu’un changement de rôle de PostgreSQL est en cours (promotion ou démotion).
- on_start : exécuter ce script lors du démarrage de PostgreSQL.
- on_stop : exécuter ce script lors de l’arrêt de PostgreSQL.
connect_address : adresse IP + port par lequel PostgreSQL est accessible depuis d’autres nœuds et applications.
proxy_address : adresse IP + port par lequel un pool de connexions (par exemple pgbouncer) en cours d’exécution à côté de Postgres est accessible. La valeur est écrite dans la clé member du DCS sous la forme
proxy_urlet peut être utilisée utile pour la découverte de services.create_replica_methods : une liste ordonnée des méthodes de création pour transformer un nœud Patroni en nouvelle réplique. La méthode par défaut est « basebackup » ; les autres méthodes sont supposées faire référence à des scripts, chacun configuré comme un élément de configuration distinct. Voir la documentation méthodes personnalisées de création de réplique pour plus d’explications.
data_dir : Emplacement du répertoire de données PostgreSQL, soit existant soit à initialiser par Patroni.
config_dir : Emplacement du répertoire de configuration de Postgres, par défaut le répertoire de données. Doit être accessible en écriture par Patroni.
bin_dir : (facultatif) Chemin vers les binaires PostgreSQL (pg_ctl, initdb, pg_controldata, pg_basebackup, postgres, pg_isready, pg_rewind). Si ce paramètre n’est pas fourni ou est une chaîne vide, la variable d’environnement PATH sera utilisée pour localiser les exécutables.
bin_name : (facultatif) Permet de remplacer les noms des binaires Postgres, si vous utilisez une distribution Postgres personnalisée :
- pg_ctl : (facultatif) Nom personnalisé pour le binaire
pg_ctl. - initdb : (facultatif) Nom personnalisé pour le binaire
initdb. - pgcontroldata : (facultatif) Nom personnalisé pour le binaire
pg_controldata. - pg_basebackup : (facultatif) Nom personnalisé pour le binaire
pg_basebackup. - postgres : (facultatif) Nom personnalisé pour le binaire
postgres. - pg_isready : (facultatif) Nom personnalisé pour le binaire
pg_isready. - pg_rewind : (facultatif) Nom personnalisé pour le binaire
pg_rewind.
- pg_ctl : (facultatif) Nom personnalisé pour le binaire
listen : adresse IP + port auxquels Postgres écoute ; doit être accessible depuis les autres nœuds du cluster, si vous utilisez la réplication en flux. Plusieurs adresses séparées par des virgules sont autorisées, à condition que le composant port soit ajouté après la dernière adresse, séparé par deux-points, par exemple
listen: 127.0.0.1,127.0.0.2:5432. Patroni utilisera la première adresse de cette liste pour établir des connexions locales vers le nœud PostgreSQL.use_unix_socket : indique que Patroni doit privilégier l’utilisation de sockets Unix pour se connecter au cluster. La valeur par défaut est
false. Siunix_socket_directoriesest définie, Patroni utilisera la première valeur adaptée parmi celle-ci pour se connecter au cluster, puis passera à TCP en cas d’indisponibilité. Siunix_socket_directoriesn’est pas spécifié danspostgresql.parameters, Patroni supposera que la valeur par défaut doit être utilisée et omettrahostdes paramètres de connexion.use_unix_socket_repl : spécifie que Patroni doit privilégier l’utilisation de sockets Unix pour la connexion utilisateur de réplication au cluster. La valeur par défaut est
false. Siunix_socket_directoriesest définie, Patroni utilisera la première valeur adaptée parmi celle-ci pour se connecter au cluster, puis passera à TCP en cas d’absence de valeur adaptée. Siunix_socket_directoriesn’est pas spécifié danspostgresql.parameters, Patroni supposera que la valeur par défaut doit être utilisée et omettrahostdes paramètres de connexion.pgpass : chemin vers le fichier de mots de passe .pgpass . Patroni crée ce fichier avant d’exécuter pg_basebackup, le script post_init et dans certaines autres circonstances. Le chemin doit être accessible en écriture par Patroni.
recovery_conf : paramètres de configuration supplémentaires écrits dans recovery.conf lors de la configuration du suiveur.
custom_conf : chemin vers un fichier
postgresql.confpersonnalisé facultatif, qui sera utilisé à la place depostgresql.base.conf. Le fichier doit exister sur tous les nœuds du cluster, être lisible par PostgreSQL et sera inclus à partir de son emplacement réel surpostgresql.conf. Notez que Patroni ne surveillera pas ce fichier pour les modifications, ni ne le sauvegardera. Toutefois, ses paramètres peuvent toujours être remplacés par les mécanismes de configuration dynamique de Patroni — voir configuration dynamique pour plus de détails.parameters : paramètres de configuration (GUC) pour Postgres au format
{ssl: "on", ssl_cert_file: "cert_file"}.parameters_primary : (facultatif) substitutions de paramètres spécifiques au rôle pour le primaire. Ces valeurs sont fusionnées avec et remplacent celles du parameters de base.
parameters_replica : (facultatif) substitutions de paramètres spécifiques au rôle pour la réplique. Ces valeurs sont fusionnées avec et remplacent celles du parameters de base.
parameters_standby_leader : (facultatif) substitutions de paramètres spécifiques au rôle pour standby_leader. Ces valeurs sont fusionnées avec et remplacent celles du paramètre parameters.
pg_hba : liste des lignes que Patroni utilisera pour générer
pg_hba.conf. Patroni ignore ce paramètre si le paramètre PostgreSQLhba_filepossède une valeur différente de celle par défaut. Associé à la configuration dynamique , ce paramètre simplifie la gestion depg_hba.conf.- - host all all 0.0.0.0/0 md5
- - host replication replicator 127.0.0.1/32 md5 : Une ligne de ce type est obligatoire pour la réplication.
pg_hba_primary : (facultatif) entrées pg_hba spécifiques au rôle pour le serveur primaire. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
pg_hba_replica : (facultatif) entrées pg_hba spécifiques au rôle pour la réplique. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
pg_hba_standby_leader : (facultatif) entrées pg_hba spécifiques au rôle pour standby_leader. Elles remplacent entièrement pg_hba (pas de fusion). Si non définies, pg_hba est utilisée.
pg_ident : liste de lignes que Patroni utilisera pour générer
pg_ident.conf. Patroni ignore ce paramètre si le paramètreident_filePostgreSQL est défini avec une valeur différente de celle par défaut. Ensemble avec configuration dynamique , ce paramètre simplifie la gestion depg_ident.conf.- - mapname1 systemname1 pguser1
- - mapname1 systemname2 pguser2
pg_ident_primaire : (facultatif) entrées pg_ident spécifiques aux rôles pour le serveur primaire. Elles remplacent entièrement pg_ident (pas de fusion). Si non définies, pg_ident est utilisée.
pg_ident_réplique : (facultatif) entrées pg_ident spécifiques aux rôles pour la réplique. Elles remplacent entièrement pg_ident (pas de fusion). Si non définies, pg_ident est utilisée.
pg_ident_standby_leader : (facultatif) entrées pg_ident spécifiques au rôle pour standby_leader. Elles remplacent entièrement pg_ident (aucune fusion n’est effectuée). Si non définies, pg_ident est utilisée.
pg_ctl_timeout : Durée d’attente de pg_ctl lors des opérations
start,stopourestart. Valeur par défaut : 60 secondes.use_pg_rewind : tenter d’utiliser pg_rewind sur l’ancien leader lorsqu’il rejoint le cluster en tant que réplique. Le cluster doit être initialisé avec
data page checksums(--data-checksumspourinitdb) et/ouwal_log_hintsdoit être défini suron, sinonpg_rewindne fonctionnera pas.rewind : (facultatif) options personnalisées à passer à la commande
pg_rewind. Peut être spécifié sous forme de liste de chaînes de caractères et/ou de dictionnaires clé-valeur simples. Les options non autorisées sont :target-pgdata,source-pgdata,source-server,write-recovery-conf,dry-run,restore-target-wal,config-file,no-ensure-shutdown,version, ethelp. Exemple d’utilisation :remove_data_directory_on_rewind_failure : Si cette option est activée, Patroni supprime le répertoire de données PostgreSQL et recrée la réplique. Sinon, il tente de suivre le nouveau leader. La valeur par défaut est false.
remove_data_directory_on_diverged_timelines : Patroni supprimera le répertoire de données PostgreSQL et recréera la réplique si elle détecte une divergence des lignes temporelles et que l’ancien nœud primaire ne peut pas démarrer le streaming depuis le nouveau nœud primaire. Cette option est utile lorsque
pg_rewindne peut pas être utilisée. Lors de la vérification de la divergence des lignes temporelles sur PostgreSQL v10 et les versions antérieures, Patroni tentera de se connecter avec les identifiants de réplication à la base de données « postgres ». Par conséquent, un tel accès doit être autorisé dans pg_hba.conf. La valeur par défaut est false.replica_method : pour chaque méthode de création de réplique autre que basebackup, vous devez ajouter une section de configuration du même nom. Cette section doit au minimum inclure “command” avec le chemin complet vers le script réel à exécuter. D’autres paramètres de configuration seront transmis au script sous la forme “paramètre=valeur”.
pre_promote : un script de fencing qui s’exécute lors d’un basculement, après l’acquisition du verrou leader mais avant la promotion de la réplique. Si le script se termine avec un code différent de zéro, Patroni ne promeut pas la réplique et supprime la clé leader du DCS.
before_stop : un script qui s’exécute immédiatement avant l’arrêt de postgres. Contrairement à un rappel, ce script s’exécute de manière synchrone, bloquant l’arrêt jusqu’à son achèvement. Le code de retour de ce script n’a pas d’incidence sur la poursuite de l’arrêt.
REST API
- restapi :
- thread_pool_size : taille du pool de threads utilisé par Patroni pour traiter les requêtes de l’API REST. La valeur minimale est
5, la valeur par défaut est5. - connect_address : adresse IP (ou nom d’hôte) et port permettant d’accéder à l’API REST de Patroni REST API . Tous les membres du cluster doivent pouvoir se connecter à cette adresse, donc sauf si la configuration Patroni est destinée à une démonstration locale, cette adresse ne doit pas être une adresse « localhost » ou de boucle locale (par exemple, « localhost » ou “127.0.0.1”). Elle peut servir d’endpoint pour les vérifications de santé HTTP (voir ci-dessous la configuration du paramètre REST « listen »), ainsi que pour les requêtes utilisateur (directement ou via l’API REST), et pour les vérifications de santé effectuées par les membres du cluster lors des élections du leader (par exemple, pour déterminer si le leader est toujours en cours d’exécution, ou si un nœud possède une position WAL supérieure à celle de l’entité effectuant la requête, etc.). L’adresse connect_address est inscrite dans la clé du membre dans le DCS, ce qui permet de traduire le nom du membre en adresse pour se connecter à son API REST.
- listen : adresse IP (ou nom d’hôte) et port auxquels Patroni écoute pour l’API REST – afin de fournir également les contrôles de santé et la messagerie entre les nœuds participants, comme décrit ci-dessus. Permet de fournir des informations de contrôle de santé à HAProxy (ou tout autre équilibreur de charge capable d’effectuer des vérifications HTTP « OPTION » ou « GET »).
- authentication : (facultatif)
- username : nom d’utilisateur pour l’authentification basique protégeant les points d’accès de l’API REST non sécurisés.
- password : mot de passe d’authentification basique pour protéger les points d’entrée de l’API REST non sécurisés.
- certfile : (facultatif) : spécifie le fichier contenant le certificat au format PEM. Si le fichier de certificat n’est pas spécifié ou est vide, le serveur API fonctionnera sans SSL.
- keyfile : (facultatif) : spécifie le fichier contenant la clé secrète au format PEM.
- keyfile_password : (facultatif) : spécifie le mot de passe permettant de déchiffrer le fichier de clé.
- cafile : (facultatif) : Spécifie le fichier contenant le CA_BUNDLE avec les certificats des autorités de certification (CA) de confiance à utiliser lors de la vérification des certificats clients.
- ciphers : (facultatif) : Spécifie les suites de chiffrement autorisées (par exemple « ECDHE-RSA-AES256-GCM-SHA384:DHE-RSA-AES256-GCM-SHA384:ECDHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES128-GCM-SHA256:!SSLv1:!SSLv2:!SSLv3:!TLSv1:!TLSv1.1 »)
- verify_client: (facultatif) :
none(par défaut),optionalourequired. Lorsquenoneest utilisé, l’API REST ne vérifiera pas les certificats clients. Lorsquerequiredest utilisé, les certificats clients sont requis pour toutes les appels à l’API REST. Lorsqueoptionalest utilisé, les certificats clients sont requis pour toutes les finales REST non sécurisées. Lorsquerequiredest utilisé, l’authentification du client réussit si la vérification de la signature du certificat réussit. Pouroptional, le certificat client n’est vérifié que pour les requêtesPUT,POST,PATCHetDELETE. - allowlist : (facultatif) : spécifie l’ensemble des hôtes autorisés à appeler les points de terminaison d’API REST non sécurisés. Chaque élément peut être un nom d’hôte, une adresse IP ou une adresse réseau au format CIDR. Par défaut,
allow allest utilisé. Siallowlistouallowlist_include_memberssont définis, tout ce qui n’est pas inclus est rejeté. - allowlist_include_members : (facultatif) : si défini à
true, autorise l’accès à des points de terminaison d’API REST non sécurisés depuis d’autres membres du cluster inscrits dans le DCS (l’adresse IP ou le nom d’hôte est extrait des membresapi_url). Prenez garde, il se peut que le système d’exploitation utilise une adresse IP différente pour les connexions sortantes. - http_extra_headers : (facultatif) : les en-têtes HTTP permettent au serveur d’API REST de transmettre des informations supplémentaires dans une réponse HTTP.
- https_extra_headers : (facultatif) : Les en-têtes HTTPS permettent au serveur de l’API REST de transmettre des informations supplémentaires dans une réponse HTTP lorsque TLS est activé. Cela transmet également les informations supplémentaires définies dans
http_extra_headers. - request_queue_size : (facultatif) : Définit la taille de la file d’attente des requêtes pour la socket TCP utilisée par l’API REST de Patroni. Une fois la file pleine, les requêtes supplémentaires reçoivent une erreur « Connexion refusée ». La valeur par défaut est 5.
- server_tokens: (facultatif) : Configure la valeur de l’en-tête
ServerHTTP.Minimal: L’en-tête ne contiendra que la version de Patroni, par exemplePatroni/4.0.0.ProductOnly: L’en-tête ne contiendra que le nom du produit, par exemplePatroni.Original(par défaut) : L’en-tête affichera le comportement d’origine et indiquera les versions de BaseHTTP et de Python, par exempleBaseHTTP/0.6 Python/3.12.3.
- thread_pool_size : taille du pool de threads utilisé par Patroni pour traiter les requêtes de l’API REST. La valeur minimale est
Voici un exemple des paramètres http_extra_headers et https_extra_headers :
Avertissement
- Le
restapi.connect_addressdoit être accessible depuis tous les nœuds d’un cluster Patroni donné. Internement, Patroni l’utilise pendant la course au leader pour identifier les nœuds présentant un retard de réplication minimal. - Si vous avez activé la validation des certificats clients (
restapi.verify_clientest défini surrequired), vous devez également fournir des certificats clients valides dans lesctl.certfile,ctl.keyfile,ctl.keyfile_password. En l’absence de ces certificats, Patroni ne fonctionnera pas correctement.
CTL
- ctl : (facultatif)
- authentication :
- username : Nom d’utilisateur pour l’authentification basique afin d’accéder aux points de terminaison API REST protégés. Si non fourni, patronictl utilisera la valeur fournie pour le paramètre “username” de l’API REST.
- password : Mot de passe pour l’authentification basique afin d’accéder aux points de terminaison API REST protégés. Si non fourni, patronictl utilisera la valeur fournie pour le paramètre “password” de l’API REST.
- insecure : autorise les connexions à l’API REST sans vérification des certificats SSL.
- cacert : spécifie le fichier contenant le CA_BUNDLE ou le répertoire contenant les certificats des autorités de certification de confiance à utiliser lors de la vérification des certificats SSL de l’API REST. Si ce paramètre n’est pas fourni, patronictl utilisera la valeur fournie pour le paramètre “cafile” de l’API REST.
- certfile : spécifie le fichier contenant le certificat client au format PEM.
- keyfile : Spécifie le fichier contenant la clé secrète client au format PEM.
- keyfile_password : Spécifie un mot de passe pour déchiffrer le fichier de clé client.
- authentication :
watchdog
- mode :
off,automaticourequired. Avecoff, le watchdog est désactivé. Avecautomatic, il est utilisé s’il est disponible et ignoré sinon. Avecrequired, le nœud ne devient leader que si le watchdog peut être activé. - device : chemin du périphérique watchdog. Valeur par défaut :
/dev/watchdog. - safety_margin : marge de sécurité, en secondes, entre le déclenchement du watchdog et l’expiration de la clé de leader.
Balises
- clonefrom :
trueoufalse. Si cette option est définie àtrue, d’autres nœuds pourraient privilégier ce nœud pour l’amorçage (prendrepg_basebackupà partir de). Si plusieurs nœuds ont l’étiquetteclonefromdéfinie àtrue, le nœud à partir duquel amorcer sera choisi aléatoirement. La valeur par défaut estfalse. - noloadbalance :
trueoufalse. Si cette option est définie àtrue, le nœud renvoie le code d’état HTTP 503 pour la vérification de santé de l’API RESTGET /replicaet est donc exclu de la répartition de charge. Valeur par défaut :false. - replicatefrom : Le nom d’une autre réplique à partir de laquelle effectuer la réplication. Utilisé pour prendre en charge la réplication en cascade.
- nosync :
trueoufalse. Si cette option est définie àtrue, le nœud ne sera jamais sélectionné comme réplique synchrone. - sync_priority : entier, détermine la priorité que ce nœud doit avoir lors de la sélection de la réplique synchrone lorsque synchronous_mode
est défini sur
on. Les nœuds ayant une priorité plus élevée sont privilégiés par rapport à ceux ayant une priorité plus faible. Si la valeur desync_priorityest 0 ou négative, ce nœud ne peut pas être écrit danssynchronous_standby_namesPostgreSQL (similaire ànosync: true). Notez que ce paramètre a une signification opposée à la valeur indiquée danssync_priorityvue danspg_stat_replication. - nofailover :
trueoufalse, contrôle si ce nœud est autorisé à participer à la course au rôle de leader et à devenir leader. La valeur par défaut estfalse, ce qui signifie que ce nœud peut_ participer aux courses au rôle de leader. - failover_priority : entier, contrôle la priorité que ce nœud doit avoir lors d’un basculement. Les nœuds ayant une priorité plus élevée sont préférés aux nœuds à priorité plus faible si ceux-ci ont reçu/rejoué la même quantité de WAL. Toutefois, les nœuds ayant une valeur LSN de réception/rejouissance plus élevée sont préférés, quelle que soit leur priorité. Si
failover_priorityest égal à 0 ou négatif, ce nœud n’est pas autorisé à participer à la course au rôle de leader ni à devenir leader (similaire ànofailover: true). Limitation connue :failover_priorityne fonctionne actuellement pas avec réplication synchrone basée sur le quorum . - nostream :
trueoufalse. Si cette option est définie àtrue, le nœud n’utilisera pas le protocole de réplication pour diffuser les WAL. Il s’appuiera alors sur la récupération depuis les archives (sirestore_commandest configuré) ainsi que sur les sondagespg_wal/pg_xlog. Cette configuration désactive également la copie et la synchronisation des slots de réplication logique permanents sur le nœud lui-même et sur toutes ses répliques en cascade. Définir cette option sur un nœud primaire n’a aucun effet.
Renseignez uniquement nofailover ou failover_priority. nofailover: true équivaut à failover_priority: 0, tandis que nofailover: false attribue au nœud la priorité 1.
En plus de ces balises prédéfinies, vous pouvez également ajouter les vôtres :
- key1 :
true - key2 :
false - key3 :
1.4 - key4 :
"RandomString"
Les balises sont visibles dans l’API REST et dans la commande patronictl_list . Vous pouvez également vérifier l’état d’intégrité d’une instance à l’aide de ces balises. Si la balise n’est pas définie pour une instance, ou si sa valeur respective ne correspond pas à la valeur demandée, le code de statut HTTP renvoyé sera 503.
3.3 - Paramètres de configuration de l'environnement
Il est possible de remplacer certains paramètres de configuration définis dans le fichier de configuration Patroni à l’aide des variables d’environnement système. Ce document liste toutes les variables d’environnement prises en charge par Patroni. Les valeurs définies via ces variables ont toujours priorité sur celles définies dans le fichier de configuration Patroni.
Global/Universel
- PATRONI_CONFIGURATION : il est possible de définir toute la configuration de Patroni via la variable d’environnement PATRONI_CONFIGURATION . Dans ce cas, aucune autre variable d’environnement ne sera prise en compte !
- PATRONI_THREAD_POOL_SIZE : taille du pool de threads utilisé par Patroni pour exécuter les tâches asynchrones et communiquer via l’API REST avec les autres membres lors d’une course au leader ou lors de vérifications en mode d’urgence. La valeur minimale est
5, la valeur par défaut est5. - PATRONI_THREAD_STACK_SIZE : spécifie la taille de pile à utiliser pour les threads lancés par Patroni. La valeur doit être alignée sur
64kB. La valeur minimale est64kB, la valeur par défaut (définie par Patroni) est512kB. - PATRONI_NAME : nom du nœud sur lequel l’instance actuelle de Patroni est en cours d’exécution. Doit être unique dans le cluster. La valeur
__patroni_strict_sync_replica_placeholder__est réservée à une utilisation interne par Patroni et ne peut pas être utilisée comme nom de nœud. - PATRONI_NAMESPACE : chemin dans le magasin de configuration où Patroni conservera les informations sur le cluster. Valeur par défaut : “/service”
- PATRONI_SCOPE : nom du cluster
- PG_MALLOC_ARENA_MAX : valeur personnalisée pour la variable d’environnement
MALLOC_ARENA_MAXdu processuspostmaster. Si non définie,postmasterhéritera de la valeur deMALLOC_ARENA_MAX.
Journalisation
- PATRONI_LOG_TYPE : définit le format des journaux. Peut être soit plain soit json. Pour utiliser le format json, vous devez avoir installé jsonlogger . La valeur par défaut est plain.
- PATRONI_LOG_LEVEL : définit le niveau général de journalisation. La valeur par défaut est INFO (voir la documentation sur le module logging de Python )
- PATRONI_LOG_TRACEBACK_LEVEL : définit le niveau auquel les traces d’erreur seront visibles. La valeur par défaut est ERROR. Définissez-la sur DEBUG si vous souhaitez voir les traces d’erreur uniquement lorsque PATRONI_LOG_LEVEL=DEBUG est activé.
- PATRONI_LOG_FORMAT : définit la chaîne de formatage des journaux. Si le type de journal est plain, le format doit être une chaîne. Reportez-vous à les attributs LogRecord pour obtenir la liste des attributs disponibles. Si le type de journal est json, le format peut être une liste en plus d’une chaîne. Chaque élément de la liste doit correspondre à un attribut LogRecord. Prenez garde à ce que seul le nom du champ est requis, et que les %( et ) doivent être omis. Si vous souhaitez afficher un champ de journal avec un nom de clé différent, utilisez un dictionnaire où la clé du dictionnaire est le champ de journal, et la valeur est le nom du champ que vous souhaitez afficher dans le journal. Valeur par défaut : %(asctime)s %(levelname)s: %(message)s
- PATRONI_LOG_DATEFORMAT : définit la chaîne de formatage de la date et de l’heure. (voir la documentation de formatTime() )
- PATRONI_LOG_STATIC_FIELDS : ajoute des champs supplémentaires au journal. Cette option n’est disponible que lorsque le type de journal est défini sur json. Exemple
PATRONI_LOG_STATIC_FIELDS="{app: patroni}" - PATRONI_LOG_MAX_QUEUE_SIZE : Patroni utilise une journalisation en deux étapes. Les enregistrements de journal sont écrits dans une file mémoire et un thread distinct extrait ces enregistrements de la file pour les écrire sur stderr ou dans un fichier. La taille maximale de la file interne est limitée par défaut à 1000 enregistrements, ce qui suffit à conserver les journaux des dernières 1h20.
- PATRONI_LOG_DIR : Répertoire dans lequel écrire les journaux d’application. Le répertoire doit exister et être accessible en écriture par l’utilisateur exécutant Patroni. Si vous définissez cette variable d’environnement, l’application conservera par défaut 4 fichiers de journaux de 25 Mo chacun. Vous pouvez ajuster ces valeurs de rétention à l’aide de
PATRONI_LOG_FILE_NUMetPATRONI_LOG_FILE_SIZE(voir ci-dessous). - PATRONI_LOG_MODE : Permissions des fichiers de journal (par exemple,
0644). Si non spécifié, les permissions seront déterminées en fonction de la valeur actuelle de umask. - PATRONI_LOG_FILE_NUM : Nombre de journaux d’application à conserver.
- PATRONI_LOG_FILE_SIZE : Taille du fichier patroni.log (en octets) qui déclenche un roulement du journal.
- PATRONI_LOG_LOGGERS : Redéfinir le niveau de journalisation par module Python. Exemple
PATRONI_LOG_LOGGERS="{patroni.postmaster: WARNING, urllib3: DEBUG}". - PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGS : Si défini à
true, les journaux de battement de cœur identiques successifs ne seront pas affichés. La valeur par défaut estfalse.
[!AVERTISSEMENT]
Le moment auquel la boucle HA s’exécute peut constituer une information très utile pour diagnostiquer les basculements dus à une épuisement des ressources et à des problèmes similaires. Lorsque
PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGSest défini surtrue, aucun journal n’est généré pour l’exécution de la boucle HA (sauf en cas de changement de leader), ce qui fait que cette information potentiellement utile ne sera pas disponible dans les journaux.
Citus
Active l’intégration de Patroni avec Citus . Si configuré, Patroni s’occupe de l’enregistrement des nœuds workers Citus sur le coordinateur. Vous trouverez plus d’informations sur le support Citus ici .
- PATRONI_CITUS_GROUP : l’identifiant du groupe Citus, entier. Utilisez
0pour le coordinateur et1,2, etc. pour les workers - PATRONI_CITUS_DATABASE : la base de données où l’extension citus doit être créée. Doit être identique sur le coordinateur et tous les workers. Actuellement, une seule base de données est prise en charge.
Consul
- PATRONI_CONSUL_HOST : l’hôte:port de l’agent local Consul.
- PATRONI_CONSUL_URL : URL de l’agent local Consul, au format : http(s)://host:port
- PATRONI_CONSUL_PORT : (facultatif) port Consul
- PATRONI_CONSUL_SCHEME : (facultatif) http ou https, par défaut http
- PATRONI_CONSUL_TOKEN : (facultatif) jeton ACL
- PATRONI_CONSUL_VERIFY : (facultatif) indique si la vérification du certificat SSL est activée pour les requêtes HTTPS
- PATRONI_CONSUL_CACERT : (facultatif) Certificat CA. S’il est présent, l’authentification est activée.
- PATRONI_CONSUL_CERT : (facultatif) Fichier contenant le certificat client
- PATRONI_CONSUL_KEY : (facultatif) Fichier contenant la clé client. Peut être vide si la clé est incluse dans le certificat.
- PATRONI_CONSUL_DC : (facultatif) Centre de données avec lequel établir la communication. Par défaut, le centre de données de l’hôte est utilisé.
- PATRONI_CONSUL_CONSISTENCY : (facultatif) Sélectionne le mode de cohérence Consul. Les valeurs possibles sont
default,consistent, oustale(plus de détails dans la référence API Consul consul API reference ) - PATRONI_CONSUL_CHECKS : (facultatif) liste des vérifications de santé Consul utilisées pour la session. Par défaut, une liste vide est utilisée.
- PATRONI_CONSUL_REGISTER_SERVICE : (facultatif) indique si un service doit être enregistré avec le nom défini par le paramètre scope et l’étiquette master, primary, replica ou standby-leader selon le rôle du nœud. Valeur par défaut : false
- PATRONI_CONSUL_SERVICE_TAGS : (facultatif) étiquettes statiques supplémentaires à ajouter au service Consul, en plus du rôle (
primary/replica/standby-leader). Par défaut, une liste vide est utilisée. - PATRONI_CONSUL_SERVICE_CHECK_INTERVAL : (facultatif) fréquence à laquelle effectuer la vérification de santé contre l’URL enregistrée
- PATRONI_CONSUL_SERVICE_CHECK_TLS_SERVER_NAME : (facultatif) remplacer l’hôte SNI lors de la connexion via TLS, voir également référence de l’API de vérification de l’agent consul .
etcd
- PATRONI_ETCD_PROXY : URL du proxy pour etcd. Si vous vous connectez à etcd via un proxy, utilisez ce paramètre à la place de **PATRONI_ETCD_URL
- PATRONI_ETCD_URL : URL d’accès à etcd, au format : http(s)://(utilisateur:mot_de_passe@)hôte:port
- PATRONI_ETCD_HOSTS : liste des points d’accès etcd au format ‘hôte1:port1’,‘hôte2:port2’, etc…
- PATRONI_ETCD_USE_PROXIES : Si ce paramètre est défini sur true, Patroni considérera hosts comme une liste de proxys et n’effectuera pas de découverte de topologie du cluster etcd, mais restera fidèle à la liste fixe de hosts.
- PATRONI_ETCD_PROTOCOL : http ou https, si non spécifié, http est utilisé. Si url ou proxy est spécifié, le protocole sera déduit de ces valeurs.
- PATRONI_ETCD_HOST : l’hôte:port pour l’endpoint etcd.
- PATRONI_ETCD_SRV : Domaine dans lequel rechercher les enregistrements SRV pour la découverte automatique du cluster. Patroni tentera de consulter ces noms de service SRV pour le domaine spécifié (dans cet ordre, jusqu’à la première réussite) :
_etcd-client-ssl,_etcd-client,_etcd-ssl,_etcd,_etcd-server-ssl,_etcd-server. Si des enregistrements SRV pour_etcd-server-sslou_etcd-serversont récupérés, le protocole pair ETCD sera utilisé pour interroger ETCD afin d’obtenir la liste des membres disponibles. Sinon, les hôtes provenant des enregistrements SRV seront utilisés. - PATRONI_ETCD_SRV_SUFFIX : Configure un suffixe au nom SRV interrogé lors de la découverte. Utilisez cette option pour distinguer plusieurs clusters etcd sous le même domaine. Fonctionne uniquement en conjonction avec PATRONI_ETCD_SRV. Par exemple, si
PATRONI_ETCD_SRV_SUFFIX=fooetPATRONI_ETCD_SRV=example.orgsont définis, la requête DNS SRV suivante est effectuée :_etcd-client-ssl-foo._tcp.example.com(et ainsi de suite pour chaque nom de service SRV etcd possible). - PATRONI_ETCD_USERNAME : nom d’utilisateur pour l’authentification etcd.
- PATRONI_ETCD_PASSWORD : mot de passe pour l’authentification etcd.
- PATRONI_ETCD_CACERT : certificat CA. S’il est présent, il active la validation.
- PATRONI_ETCD_CERT : fichier contenant le certificat client.
- PATRONI_ETCD_KEY : fichier contenant la clé client. Peut être vide si la clé est incluse dans le certificat.
Etcdv3
Les noms d’environnement pour Etcdv3 sont similaires à ceux d’etcd ; il suffit de remplacer ETCD par ETCD3 dans le nom de la variable. Exemple : PATRONI_ETCD3_HOST, PATRONI_ETCD3_CACERT, et ainsi de suite.
[!AVERTISSEMENT]
Les clés créées avec la version 2 du protocole ne sont pas visibles avec la version 3 du protocole, et inversement ; il n’est donc pas possible de passer d’etcd à Etcdv3 en ne mettant à jour que la configuration de Patroni. En outre, Patroni utilise la passerelle gRPC (proxy) d’Etcd pour communiquer avec l’API V3, ce qui empêche l’authentification par nom commun TLS.
ZooKeeper
- PATRONI_ZOOKEEPER_HOSTS : Liste séparée par des virgules des membres du cluster ZooKeeper : “‘host1:port1’,‘host2:port2’,’etc…’”. Il est important de citer chaque entité !
- PATRONI_ZOOKEEPER_USE_SSL : (facultatif) Indique si le protocole SSL est utilisé. Valeur par défaut :
false. Si défini àfalse, tous les paramètres spécifiques au SSL sont ignorés. - PATRONI_ZOOKEEPER_CACERT : (facultatif) Certificat CA. Si présent, active la validation.
- PATRONI_ZOOKEEPER_CERT : (facultatif) Fichier contenant le certificat client.
- PATRONI_ZOOKEEPER_KEY : (facultatif) Fichier contenant la clé client.
- PATRONI_ZOOKEEPER_KEY_PASSWORD : (facultatif) Mot de passe de la clé client.
- PATRONI_ZOOKEEPER_VERIFY : (facultatif) Indique si la vérification du certificat doit être effectuée ou non. Valeur par défaut :
true. - PATRONI_ZOOKEEPER_SET_ACLS : (facultatif) Si défini, configure Kazoo pour appliquer une ACL par défaut à chaque ZNode qu’il crée. Les ACL peuvent utiliser le schéma
x509(par défaut) ou d’autres schémas pris en charge par ZooKeeper, tels quedigest. Elles doivent être spécifiées sous forme de dictionnaire, où la clé est le principal complet (éventuellement préfixé par le schéma) et la valeur une liste de permissions. Les permissions peuvent être une ou plusieurs des valeurs suivantes :CREATE,READ,WRITE,DELETE,ADMIN, ouALL. Par exemple,set_acls: {CN=principal1: [CREATE, READ], digest:principal2:+pjROuBuuwNNSujKyH8dGcEnFPQ=: [ALL]}. - PATRONI_ZOOKEEPER_AUTH_DATA : (facultatif) Informations d’authentification à utiliser pour la connexion. Doit être un dictionnaire dont
schemeest la clé etcredentialla valeur. Valeur par défaut : dictionnaire vide.
Il est obligatoire d’installer kazoo>=2.6.0 pour prendre en charge le SSL.
Exposant
- PATRONI_EXHIBITOR_HOSTS : liste initiale des nœuds Exhibitor (ZooKeeper) au format : ‘hôte1,hôte2,etc…’. Cette liste est mise à jour automatiquement chaque fois que la topologie du cluster Exhibitor (ZooKeeper) change.
- PATRONI_EXHIBITOR_PORT : port Exhibitor.
Kubernetes
- PATRONI_KUBERNETES_BYPASS_API_SERVICE : (facultatif) Lors de la communication avec l’API Kubernetes, Patroni utilise généralement le service kubernetes
, dont l’adresse est exposée dans les pods via la variable d’environnement
KUBERNETES_SERVICE_HOST. SiPATRONI_KUBERNETES_BYPASS_API_SERVICEest défini surtrue, Patroni résout la liste des nœuds API derrière le service et se connecte directement à ceux-ci. - PATRONI_KUBERNETES_NAMESPACE : (facultatif) Espace de noms Kubernetes dans lequel s’exécute le pod Patroni. Valeur par défaut :
default. - PATRONI_KUBERNETES_LABELS : Étiquettes au format
{label1: value1, label2: value2}. Ces étiquettes seront utilisées pour localiser les objets existants (Pods et soit des Endpoints, soit des ConfigMaps) associés au cluster actuel. Patroni les définira également sur chaque objet (Endpoint ou ConfigMap) qu’il crée. - PATRONI_KUBERNETES_SCOPE_LABEL : (facultatif) nom de l’étiquette contenant le nom du cluster. La valeur par défaut est
cluster-name. - PATRONI_KUBERNETES_BOOTSTRAP_LABELS : (facultatif) Étiquettes au format
{label1: value1, label2: value2}. Ces étiquettes seront attribuées au pod Patroni lorsque son état est l’un des suivants :initializing new cluster,running custom bootstrap script,starting after custom bootstrapoucreating replica. - PATRONI_KUBERNETES_ROLE_LABEL : (facultatif) nom de l’étiquette contenant le rôle (
primary,replicaou autre valeur personnalisée). Patroni définira cette étiquette sur le pod dans lequel il s’exécute. Valeur par défaut :role. - PATRONI_KUBERNETES_LEADER_LABEL_VALUE : (facultatif) valeur de l’étiquette du pod lorsque le rôle PostgreSQL est
primary. Valeur par défaut :primary. - PATRONI_KUBERNETES_FOLLOWER_LABEL_VALUE : (facultatif) valeur de l’étiquette du pod lorsque le rôle PostgreSQL est
replica. Valeur par défaut :replica. - PATRONI_KUBERNETES_STANDBY_LEADER_LABEL_VALUE : (facultatif) valeur de l’étiquette du pod lorsque le rôle Postgres est
standby_leader. Valeur par défaut :primary. - PATRONI_KUBERNETES_TMP_ROLE_LABEL : (facultatif) nom de l’étiquette temporaire contenant le rôle (
primaryoureplica). La valeur de cette étiquette utilisera toujours la valeur par défaut correspondante au rôle. À définir uniquement si nécessaire. - PATRONI_KUBERNETES_USE_ENDPOINTS : (facultatif) si défini à true, Patroni utilisera des Endpoints au lieu de ConfigMaps pour effectuer les élections du leader et maintenir l’état du cluster.
- PATRONI_KUBERNETES_POD_IP : (facultatif) adresse IP du pod dans lequel Patroni s’exécute. Cette valeur est requise lorsque
PATRONI_KUBERNETES_USE_ENDPOINTSest activé et est utilisée pour remplir les sous-ensembles de l’endpoint leader lorsque le pod PostgreSQL est promu. - PATRONI_KUBERNETES_PORTS : (facultatif) si l’objet Service possède un nom pour le port, ce même nom doit apparaître dans l’objet Endpoint, sinon le service ne fonctionnera pas. Par exemple, si votre service est défini comme
{Kind: Service, spec: {ports: [{name: postgresql, port: 5432, targetPort: 5432}]}}, vous devez définirPATRONI_KUBERNETES_PORTS='[{"name": "postgresql", "port": 5432}]'et Patroni l’utilisera pour mettre à jour les sous-ensembles de l’Endpoint leader. Ce paramètre n’est utilisé que siPATRONI_KUBERNETES_USE_ENDPOINTSest défini. - PATRONI_KUBERNETES_CACERT : (facultatif) indique le fichier CA_BUNDLE contenant les certificats des autorités de certification approuvées pour vérifier les certificats SSL de l’API Kubernetes. En l’absence de valeur, Patroni utilise celle du secret ServiceAccount.
- PATRONI_RETRIABLE_HTTP_CODES : (facultatif) liste des codes d’état HTTP de l’API K8s pour lesquels une nouvelle tentative doit être effectuée. Par défaut, Patroni réessaie pour
500,503et504, ou lorsque la réponse de l’API K8s contient l’en-tête HTTPretry-after.
Raft (obsolète)
- PATRONI_RAFT_SELF_ADDR:
ip:portsur lequel écouter pour les connexions Raft. L’self_addrdoit être accessible depuis les autres nœuds du cluster. Si non définie, le nœud ne participera pas au consensus. - PATRONI_RAFT_BIND_ADDR: (facultatif)
ip:portsur lequel écouter pour les connexions Raft. Si non spécifié, l’self_addrsera utilisé. - PATRONI_RAFT_PARTNER_ADDRS: liste des autres nœuds Patroni du cluster au format
"'ip1:port1','ip2:port2'". Il est important de citer chaque entité entre guillemets ! - PATRONI_RAFT_DATA_DIR : répertoire dans lequel stocker les journaux Raft et les instantanés. Si non spécifié, le répertoire de travail actuel est utilisé.
- PATRONI_RAFT_PASSWORD : (facultatif) Chiffrer le trafic Raft avec un mot de passe spécifié, nécessite le module
cryptographyPython. - PATRONI_RAFT_MIN_TIMEOUT : (facultatif) délai minimum d’élection en secondes pour l’implémentation Raft pysyncobj sous-jacente. Doit être supérieur à 3 ×
PATRONI_RAFT_APPEND_ENTRIES_PERIOD. Valeur par défaut :0.4. - PATRONI_RAFT_MAX_TIMEOUT : (facultatif) délai maximal d’élection en secondes pour l’implémentation Raft underlying pysyncobj. Doit être supérieur à
PATRONI_RAFT_MIN_TIMEOUT. Valeur par défaut :1.4. - PATRONI_RAFT_CONNECTION_TIMEOUT : (facultatif) délai en secondes après lequel une connexion sans données reçues est considérée comme inactive. Doit être supérieur ou égal à
PATRONI_RAFT_MAX_TIMEOUT. Valeur par défaut :3.5. - PATRONI_RAFT_APPEND_ENTRIES_PERIOD : (facultatif) intervalle en secondes pour l’envoi des commandes de battement de cœur. Doit être inférieur à un tiers de
PATRONI_RAFT_MIN_TIMEOUT. Valeur par défaut :0.1. - PATRONI_RAFT_CONNECTION_RETRY_TIME : (facultatif) intervalle en secondes entre les tentatives de reconnexion aux nœuds hors ligne. Valeur par défaut :
5.0. - PATRONI_RAFT_LEADER_FALLBACK_TIMEOUT : (facultatif) durée en secondes après laquelle un leader ne recevant aucune réponse de la majorité redevient un suiveur. Doit être supérieur à
PATRONI_RAFT_APPEND_ENTRIES_PERIOD. Valeur par défaut :30.0.
Patroni vérifie ces contraintes au démarrage et refusera de démarrer si elles sont violées. Ces valeurs ne peuvent pas être modifiées en cours d’exécution et nécessitent une redémarrage. Pour plus de détails, y compris la limitation liée aux latences élevées, consultez Paramètres Raft .
PostgreSQL
- PATRONI_POSTGRESQL_LISTEN : adresse IP + port auxquels Postgres écoute. Plusieurs adresses séparées par des virgules sont autorisées, à condition que le composant port soit ajouté après la dernière adresse, séparé par deux-points, c’est-à-dire
listen: 127.0.0.1,127.0.0.2:5432. Patroni utilisera la première adresse de cette liste pour établir des connexions locales vers le nœud PostgreSQL. - PATRONI_POSTGRESQL_CONNECT_ADDRESS : adresse IP + port par lequel Postgres est accessible depuis d’autres nœuds et applications.
- PATRONI_POSTGRESQL_PROXY_ADDRESS : adresse IP + port par lequel un pool de connexions (par exemple pgbouncer) en cours d’exécution à côté de Postgres est accessible. La valeur est écrite dans la clé member du DCS sous la forme
proxy_urlet peut être utilisée/utilisée pour la découverte de services. - PATRONI_POSTGRESQL_DATA_DIR : emplacement du répertoire de données Postgres, existant ou à initialiser par Patroni.
- PATRONI_POSTGRESQL_CONFIG_DIR : Emplacement du répertoire de configuration de Postgres, par défaut le répertoire de données. Doit être accessible en écriture par Patroni.
- PATRONI_POSTGRESQL_BIN_DIR : Chemin vers les binaires de PostgreSQL (pg_ctl, initdb, pg_controldata, pg_basebackup, postgres, pg_isready, pg_rewind). La valeur par défaut est une chaîne vide, ce qui signifie que les exécutables seront recherchés dans la variable d’environnement PATH.
- PATRONI_POSTGRESQL_BIN_PG_CTL : (facultatif) Nom personnalisé pour le binaire
pg_ctl. - PATRONI_POSTGRESQL_BIN_INITDB : (facultatif) Nom personnalisé pour le binaire
initdb. - PATRONI_POSTGRESQL_BIN_PG_CONTROLDATA : (facultatif) Nom personnalisé pour le binaire
pg_controldata. - PATRONI_POSTGRESQL_BIN_PG_BASEBACKUP : (facultatif) Nom personnalisé pour le binaire
pg_basebackup. - PATRONI_POSTGRESQL_BIN_POSTGRES : (facultatif) Nom personnalisé pour le binaire
postgres. - PATRONI_POSTGRESQL_BIN_IS_READY : (facultatif) Nom personnalisé pour le binaire
pg_isready. - PATRONI_POSTGRESQL_BIN_PG_REWIND : (facultatif) Nom personnalisé pour le binaire
pg_rewind. - PATRONI_POSTGRESQL_PGPASS : chemin vers le fichier de mot de passe .pgpass . Patroni crée ce fichier avant d’exécuter pg_basebackup et dans certaines autres circonstances. Le répertoire doit être accessible en écriture par Patroni.
- PATRONI_REPLICATION_USERNAME : nom d’utilisateur de réplication ; l’utilisateur sera créé lors de l’initialisation. Les répliques utiliseront cet utilisateur pour accéder à la source de réplication via la réplication en flux
- PATRONI_REPLICATION_PASSWORD : mot de passe de réplication ; l’utilisateur sera créé lors de l’initialisation.
- PATRONI_REPLICATION_SSLMODE : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - PATRONI_REPLICATION_SSLKEY : (facultatif) mappe au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- PATRONI_REPLICATION_SSLPASSWORD : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
PATRONI_REPLICATION_SSLKEY. - PATRONI_REPLICATION_SSLCERT : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- PATRONI_REPLICATION_SSLROOTCERT : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- PATRONI_REPLICATION_SSLCRL : (facultatif) correspond au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera la connexion à tout serveur dont le certificat figure dans cette liste.
- PATRONI_REPLICATION_SSLCRLDIR : (facultatif) correspond au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- PATRONI_REPLICATION_SSLNEGOTIATION : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- PATRONI_REPLICATION_GSSENCMODE : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- PATRONI_REPLICATION_CHANNEL_BINDING : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du binding de canal par le client.
- PATRONI_SUPERUSER_USERNAME : nom de l’utilisateur superutilisateur, défini lors de l’initialisation (initdb) et utilisé ultérieurement par Patroni pour se connecter à PostgreSQL. Cet utilisateur est également utilisé par pg_rewind.
- PATRONI_SUPERUSER_PASSWORD : mot de passe pour l’utilisateur superutilisateur, défini lors de l’initialisation (initdb).
- PATRONI_SUPERUSER_SSLMODE : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - PATRONI_SUPERUSER_SSLKEY : (facultatif) mappe au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- PATRONI_SUPERUSER_SSLPASSWORD : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
PATRONI_SUPERUSER_SSLKEY. - PATRONI_SUPERUSER_SSLCERT : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- PATRONI_SUPERUSER_SSLROOTCERT : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- PATRONI_SUPERUSER_SSLCRL : (facultatif) correspond au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera la connexion à tout serveur dont le certificat figure dans cette liste.
- PATRONI_SUPERUSER_SSLCRLDIR : (facultatif) mappe au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- PATRONI_SUPERUSER_SSLNEGOTIATION : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- PATRONI_SUPERUSER_GSSENCMODE : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- PATRONI_SUPERUSER_CHANNEL_BINDING : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du lien de canal par le client.
- PATRONI_REWIND_USERNAME : (facultatif) nom de l’utilisateur pour
pg_rewind; l’utilisateur sera créé lors de l’initialisation de PostgreSQL 11+ et toutes les autorisations nécessaires lui seront accordées. - PATRONI_REWIND_PASSWORD : (facultatif) mot de passe de l’utilisateur pour
pg_rewind; l’utilisateur sera créé lors de l’initialisation. - PATRONI_REWIND_SSLMODE : (facultatif) correspond au paramètre de connexion sslmode
, qui permet à un client de spécifier le mode de négociation TLS avec le serveur. Pour plus d’informations sur le fonctionnement de chaque mode, veuillez consulter la documentation PostgreSQL
. Le mode par défaut est
prefer. - PATRONI_REWIND_SSLKEY : (facultatif) correspond au paramètre de connexion sslkey , qui précise l’emplacement de la clé secrète utilisée avec le certificat client.
- PATRONI_REWIND_SSLPASSWORD : (facultatif) correspond au paramètre de connexion sslpassword
, qui précise le mot de passe de la clé secrète spécifiée dans
PATRONI_REWIND_SSLKEY. - PATRONI_REWIND_SSLCERT : (facultatif) correspond au paramètre de connexion sslcert , qui précise l’emplacement du certificat client.
- PATRONI_REWIND_SSLROOTCERT : (facultatif) correspond au paramètre de connexion sslrootcert , qui précise l’emplacement d’un fichier contenant un ou plusieurs certificats d’autorités de certification (CA) utilisés par le client pour vérifier le certificat d’un serveur.
- PATRONI_REWIND_SSLCRL : (facultatif) mappe au paramètre de connexion sslcrl , qui précise l’emplacement d’un fichier contenant une liste de révocation de certificats. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- PATRONI_REWIND_SSLCRLDIR : (facultatif) correspond au paramètre de connexion sslcrldir , qui précise l’emplacement d’un répertoire contenant des fichiers listant les certificats révoqués. Un client refusera de se connecter à tout serveur dont le certificat figure dans cette liste.
- PATRONI_REWIND_SSLNEGOTIATION : (facultatif) correspond au paramètre de connexion sslnegotiation , qui contrôle la négociation du chiffrement SSL avec le serveur, le cas échéant.
- PATRONI_REWIND_GSSENCMODE : (facultatif) correspond au paramètre de connexion gssencmode , qui détermine si une connexion TCP/IP sécurisée GSS sera négociée avec le serveur, et avec quelle priorité
- PATRONI_REWIND_CHANNEL_BINDING : (facultatif) correspond au paramètre de connexion channel_binding , qui contrôle l’utilisation du lien de canal par le client.
REST API
- PATRONI_RESTAPI_THREAD_POOL_SIZE : taille du pool de threads utilisé par Patroni pour traiter les requêtes de l’API REST. La valeur minimale est
5, la valeur par défaut est5. - PATRONI_RESTAPI_CONNECT_ADDRESS : adresse IP et port d’accès à l’API REST.
- PATRONI_RESTAPI_LISTEN : adresse IP et port auxquels Patroni écoute, afin de fournir des informations de santé-check pour HAProxy.
- PATRONI_RESTAPI_USERNAME : nom d’utilisateur pour l’authentification basique protégeant les points d’accès de l’API REST non sécurisés.
- PATRONI_RESTAPI_PASSWORD : Mot de passe d’authentification basique pour protéger les points de terminaison API REST non sécurisés.
- PATRONI_RESTAPI_CERTFILE : Spécifie le fichier contenant le certificat au format PEM. Si le fichier de certificat n’est pas précisé ou est vide, le serveur API fonctionnera sans SSL.
- PATRONI_RESTAPI_KEYFILE : Spécifie le fichier contenant la clé secrète au format PEM.
- PATRONI_RESTAPI_KEYFILE_PASSWORD : Spécifie le mot de passe pour déchiffrer le fichier de clé.
- PATRONI_RESTAPI_CAFILE : indique le fichier CA_BUNDLE contenant les certificats des autorités de certification approuvées pour vérifier les certificats clients.
- PATRONI_RESTAPI_CIPHERS : (facultatif) indique les suites de chiffrement autorisées, par exemple “ECDHE-RSA-AES256-GCM-SHA384:DHE-RSA-AES256-GCM-SHA384:ECDHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES128-GCM-SHA256:!SSLv1:!SSLv2:!SSLv3:!TLSv1:!TLSv1.1”.
- PATRONI_RESTAPI_VERIFY_CLIENT :
none(par défaut),optionalourequired. Lorsquenoneest utilisé, l’API REST ne vérifiera pas les certificats clients. Lorsquerequiredest utilisé, les certificats clients sont requis pour toutes les appels à l’API REST. Lorsqueoptionalest utilisé, les certificats clients sont requis pour toutes les finitions REST non sécurisées. Lorsquerequiredest utilisé, l’authentification du client réussit si la vérification de la signature du certificat réussit. Pouroptional, le certificat client n’est vérifié que pour les requêtesPUT,POST,PATCHetDELETE. - PATRONI_RESTAPI_ALLOWLIST : (facultatif) : Spécifie l’ensemble des hôtes autorisés à appeler les points de terminaison d’API REST non sécurisés. Chaque élément peut être un nom d’hôte, une adresse IP ou une adresse réseau au format CIDR. Par défaut,
allow allest utilisé. Siallowlistouallowlist_include_memberssont définis, tout ce qui n’est pas inclus est rejeté. - PATRONI_RESTAPI_ALLOWLIST_INCLUDE_MEMBERS : (facultatif) Si défini à
true, permet d’accéder à des points de terminaison d’API REST non sécurisés depuis d’autres membres du cluster inscrits dans le DCS (l’adresse IP ou le nom d’hôte est extrait des membresapi_url). Prenez garde, il se peut que le système d’exploitation utilise une adresse IP différente pour les connexions sortantes. - PATRONI_RESTAPI_HTTP_EXTRA_HEADERS : (facultatif) Les en-têtes HTTP permettent au serveur d’API REST de transmettre des informations supplémentaires dans une réponse HTTP.
- PATRONI_RESTAPI_HTTPS_EXTRA_HEADERS : (facultatif) Les en-têtes HTTPS permettent au serveur d’API REST de transmettre des informations supplémentaires dans une réponse HTTP lorsque TLS est activé. Cela transmet également les informations supplémentaires définies dans
http_extra_headers. - PATRONI_RESTAPI_REQUEST_QUEUE_SIZE : (facultatif) Définit la taille de la file d’attente des requêtes pour la socket TCP utilisée par l’API REST de Patroni. Dès que la file est pleine, les requêtes supplémentaires reçoivent une erreur « Connexion refusée ». La valeur par défaut est 5.
- PATRONI_RESTAPI_SERVER_TOKENS : (facultatif) Configure la valeur de l’en-tête HTTP
Server.Original(par défaut) conserve le comportement original et affiche les versions de BaseHTTP et de Python, par exempleBaseHTTP/0.6 Python/3.12.3.Minimal: l’en-tête ne contiendra que la version de Patroni, par exemplePatroni/4.0.0.ProductOnly: l’en-tête ne contiendra que le nom du produit, par exemplePatroni.
Avertissement
- Le
PATRONI_RESTAPI_CONNECT_ADDRESSdoit être accessible depuis tous les nœuds d’un cluster Patroni donné. Internement, Patroni l’utilise lors de la course au leader pour identifier les nœuds présentant un retard de réplication minimal. - Si vous avez activé la validation des certificats client (
PATRONI_RESTAPI_VERIFY_CLIENTest défini surrequired), vous devez également fournir des certificats clients valides dans lesPATRONI_CTL_CERTFILE,PATRONI_CTL_KEYFILE,PATRONI_CTL_KEYFILE_PASSWORD. En l’absence de ces certificats, Patroni ne fonctionnera pas correctement.
CTL
- PATRONICTL_CONFIG_FILE : (facultatif) emplacement du fichier de configuration.
- PATRONI_CTL_USERNAME : (facultatif) nom d’utilisateur pour l’authentification basique afin d’accéder aux points de terminaison protégés de l’API REST. Si non fourni, patronictl utilisera la valeur fournie pour le paramètre « username » de l’API REST.
- PATRONI_CTL_PASSWORD : (facultatif) Mot de passe d’authentification basique pour accéder aux points de terminaison protégés de l’API REST. Si non fourni, patronictl utilisera la valeur fournie pour le paramètre « password » de l’API REST.
- PATRONI_CTL_INSECURE : (facultatif) Autoriser les connexions à l’API REST sans vérification des certificats SSL.
- PATRONI_CTL_CACERT : (facultatif) indique le fichier CA_BUNDLE ou le répertoire contenant les certificats des autorités de certification approuvées pour vérifier les certificats SSL de l’API REST. En l’absence de valeur, patronictl utilise le paramètre “cafile” de l’API REST.
- PATRONI_CTL_CERTFILE : (facultatif) indique le fichier du certificat client au format PEM.
- PATRONI_CTL_KEYFILE : (facultatif) indique le fichier de la clé secrète du client au format PEM.
- PATRONI_CTL_KEYFILE_PASSWORD : (facultatif) Spécifie un mot de passe pour décrypter le fichier de clé client.
4 - API REST Patroni
Patroni dispose d’une API REST riche, utilisée par Patroni lui-même lors de la course au leader, par l’outil patronictl afin d’effectuer des basculements, des basculements planifiés, des réinitialisations, des redémarrages ou des rechargements, par HAProxy ou tout autre équilibreur de charge pour effectuer des vérifications de santé HTTP, et bien entendu également utilisée pour la surveillance. Ci-dessous figure la liste des points d’accès de l’API REST de Patroni.
Points de terminaison de vérification de santé
Pour toutes les requêtes de vérification de santé GET, Patroni renvoie un document JSON indiquant l’état du nœud, accompagné du code d’état HTTP. Si vous ne souhaitez pas ou n’avez pas besoin du document JSON, vous pouvez envisager d’utiliser la méthode HEAD ou OPTIONS au lieu de GET.
Les requêtes suivantes vers l’API REST de Patroni renvoient le code d’état HTTP 200 uniquement lorsque le nœud Patroni fonctionne en tant que primaire avec verrou de leader :
GET /GET /primaryGET /read-write
GET /standby-leader: renvoie le code d’état HTTP 200 uniquement lorsque le nœud Patroni est en cours d’exécution en tant que leader dans un cluster de secours .GET /leader: renvoie le code d’état HTTP 200 lorsque le nœud Patroni détient le verrou leader. La différence principale avec les deux précédents points d’accès est qu’elle ne tient pas compte de l’état d’exécution de PostgreSQL en tant queprimaryoustandby_leader.GET /replica: point de terminaison de vérification de santé de la réplique. Il renvoie le code d’état HTTP 200 uniquement lorsque le nœud Patroni est dans l’étatrunning, que son rôle estreplicaet que l’étiquettenoloadbalancen’est pas définie.GET /replica?replication_state=<required state>: point de contrôle de réplique. En plus des vérifications effectuées parreplica, il vérifie également que l’état de réplication correspond à celui requis. Principalement utile avecreplication_state=streaming, afin d’exclure les répliques encore en cours de synchronisation pendant une récupération archivée.GET /replica?lag=<max-lag>: point de contrôle de réplique. En plus des vérifications effectuées parreplica, il vérifie également le délai de réplication et renvoie le code d’état 200 uniquement lorsque ce délai est inférieur à la valeur spécifiée. La clé cluster.last_leader_operation provenant du DCS est utilisée pour la position WAL du leader et le calcul du délai sur la réplique, pour des raisons de performance. max-lag peut être spécifié en octets (entier) ou sous forme lisible par l’humain, par exemple 16kB, 64MB, 1GB.GET /replica?lag=1048576GET /replica?lag=1024kBGET /replica?lag=10MBGET /replica?lag=1GB
GET /replica?tag_key1=value1&tag_key2=value2: point de contrôle de réplique. En outre, il vérifie également les balises définies par l’utilisateurkey1etkey2ainsi que leurs valeurs respectives dans la section tags de la configuration YAML. Si une balise n’est pas définie pour une instance, ou si la valeur dans la configuration YAML ne correspond pas à la valeur demandée, le service renvoie le code d’état HTTP 503.
Dans les requêtes suivantes, comme nous vérifions l’état de leader ou de standby-leader, Patroni ne prend pas en compte les étiquettes définies par l’utilisateur, qui seront ignorées.
GET /?tag_key1=value1&tag_key2=value2GET /leader?tag_key1=value1&tag_key2=value2GET /primary?tag_key1=value1&tag_key2=value2GET /read-write?tag_key1=value1&tag_key2=value2GET /standby_leader?tag_key1=value1&tag_key2=value2GET /standby-leader?tag_key1=value1&tag_key2=value2GET /read-only: comme le point d’accès précédent, mais inclut également le primaire.GET /synchronousouGET /sync: renvoie le code d’état HTTP 200 uniquement lorsque le nœud Patroni fonctionne en réplica synchrone.GET /read-only-sync: comme le point d’accès précédent, mais inclut également le primaire.GET /quorum: renvoie le code d’état HTTP 200 uniquement lorsque ce nœud Patroni est répertorié comme nœud de quorum danssynchronous_standby_namessur le primaire.GET /read-only-quorum: comme le point d’accès précédent, mais inclut également le primaire.GET /asynchronousouGET /async: renvoie le code d’état HTTP 200 uniquement lorsque le nœud Patroni fonctionne en réplica asynchrone.GET /asynchronous?lag=<max-lag>ouGET /async?lag=<max-lag>: point de contrôle de basculement asynchrone. En plus des vérifications provenant deasynchronousouasync, il vérifie également le délai de réplication et renvoie le code d’état 200 uniquement lorsque ce délai est inférieur à la valeur spécifiée. La clé cluster.last_leader_operation provenant du DCS est utilisée pour la position WAL du leader et le calcul du délai sur la réplique, pour des raisons de performance. max-lag peut être spécifié en octets (entier) ou sous forme lisible par l’humain, par exemple 16kB, 64MB, 1GB.GET /async?lag=1048576GET /async?lag=1024kBGET /async?lag=10MBGET /async?lag=1GB
GET /health: renvoie le code d’état HTTP 200 uniquement lorsque PostgreSQL est en cours d’exécution.GET /liveness: renvoie le code d’état HTTP 200 si la boucle de battement de cœur Patroni fonctionne correctement, et 503 si la dernière exécution remonte à plus dettlsecondes sur le serveur primaire ou à plus de2*ttlsecondes sur la réplique. Peut être utilisé pourlivenessProbe.GET /readiness?lag=<max-lag>&mode=apply|write: renvoie le code d’état HTTP 200 lorsque le nœud Patroni fonctionne en tant que leader ou lorsque PostgreSQL est actif, en réplication et pas trop en retard par rapport au leader. Le paramètre lag définit la marge maximale de retard autorisée pour une instance de secours, avec une valeur par défaut demaximum_lag_on_failover. Le retard peut être spécifié en octets ou en valeurs lisibles par l’humain, par exemple 16kB, 64MB ou 1GB. Le paramètre mode indique si le WAL doit être appliqué (rejoué) ou simplement reçu (écrit). La valeur par défaut est apply.
Lorsqu’il est utilisé comme Kubernetes readinessProbe, il garantit que les nouveaux pods démarrés ne deviennent prêts qu’après avoir rattrapé le leader. Cela, combiné à un PodDisruptionBudget, protège contre une terminaison prématurée du leader lors d’un redémarrage progressif des nœuds. Il garantit également que les répliques incapables de suivre la réplication ne traitent pas le trafic en lecture seule. Ce point d’accès peut être utilisé pour readinessProbe lorsque l’utilisation des endpoints Kubernetes pour les élections de leader n’est pas possible (OpenShift).
Le point d’entrée liveness est très léger et n’exécute aucune requête SQL. Les sondes doivent être configurées de manière à commencer à échouer environ au moment où la clé leader expire. Avec la valeur par défaut de ttl, qui est 30s, les sondes devraient ressembler à l’exemple suivant :
Point de terminaison de surveillance
Le GET /patroni est utilisé par Patroni lors de la course au leader. Il peut également être utilisé par votre système de surveillance. Le document JSON produit par cette extension a la même structure que le JSON produit par les points d’entrée de vérification de santé.
Exemple : un cluster sain
Exemple : un cluster déverrouillé
Exemple : Un cluster déverrouillé avec le mode de sécurité du DCS activé
Exemple : Un cluster avec le mode pause activé
Récupérez les métriques Patroni au format Prometheus via l’endpoint GET /metrics.
Valeurs d’état PostgreSQL
La métrique patroni_postgres_state fournit une représentation numérique de l’état actuel de l’instance PostgreSQL. Cela est utile pour les systèmes de surveillance et d’alerte qui doivent suivre les changements d’état au fil du temps. Les valeurs numériques sont générées à l’aide de la méthode statique PostgresqlState.get_metrics_description().
| Valeur | Nom d’état | Description |
|---|---|---|
| 0 | initdb | Initialisation du nouveau cluster |
| 1 | initdb_failed | Échec de l’initialisation du nouveau cluster |
| 2 | custom_bootstrap | Exécution du script d’amorçage personnalisé |
| 3 | custom_bootstrap_failed | Échec du script d’amorçage personnalisé |
| 4 | creating_replica | Création d’une réplique à partir du primaire |
| 5 | running | PostgreSQL fonctionne normalement |
| 6 | starting | PostgreSQL démarre |
| 7 | bootstrap_starting | Démarrage après l’amorçage personnalisé |
| 8 | start_failed | Échec du démarrage de PostgreSQL |
| 9 | restarting | PostgreSQL redémarre |
| 10 | restart_failed | Échec du redémarrage de PostgreSQL |
| 11 | stopping | PostgreSQL s’arrête |
| 12 | stopped | PostgreSQL est arrêté |
| 13 | stop_failed | Échec de l’arrêt de PostgreSQL |
| 14 | crashed | PostgreSQL a planté |
Valeurs d’état de PostgreSQL
Ces valeurs numériques sont fixes et ne changeront jamais afin de préserver la compatibilité ascendante avec les systèmes de surveillance existants. Si de nouveaux états sont ajoutés à l’avenir, ils seront affectés à de nouvelles valeurs numériques sans modifier les valeurs existantes.
Points de terminaison d’état du cluster
- L’endpoint
GET /clustergénère un document JSON décrivant la topologie et l’état actuels du cluster :
- Le point d’accès
GET /historyfournit une vue sur l’historique des basculements ou des basculements planifiés du cluster. Le format est très similaire au contenu des fichiers d’historique dans le répertoirepg_wal. La seule différence réside dans le champ horodatage, qui indique quand la nouvelle ligne temporelle a été créée.
Point d’entrée de configuration
GET /config : Obtenir la version actuelle de la configuration dynamique :
PATCH /config : Modifiez la configuration existante.
L’appel d’API REST ci-dessus met à jour la configuration existante et renvoie la configuration mise à jour.
Vérifions que le nœud a bien appliqué cette configuration. Tout d’abord, il doit commencer à imprimer des lignes de journalisation toutes les 5 secondes (loop_wait=5). Le changement de “max_connections” nécessite un redémarrage, donc le drapeau “pending_restart” doit être exposé :
Suppression des paramètres :
Si vous souhaitez supprimer (réinitialiser) un paramètre, appliquez une mise à jour avec null :
L’appel ci-dessus retire postgresql.parameters.max_connections de la configuration dynamique.
PUT /config : Il est également possible d’effectuer la réécriture complète d’une configuration dynamique existante sans condition :
Points de terminaison de basculement planifié et de basculement
basculement planifié
Le point de terminaison /switchover ne fonctionne que lorsque le cluster est sain (un leader est présent). Il permet également de planifier un basculement planifié à une heure donnée.
Lors de l’appel de l’endpoint /switchover, un candidat peut être spécifié mais n’est pas obligatoire, contrairement à l’endpoint /failover. Si aucun candidat n’est fourni, tous les nœuds du cluster éligibles participeront à la course au leader après le départ du leader.
Dans le corps JSON de la requête POST, vous devez spécifier le champ leader. Les champs candidate et scheduled_at sont facultatifs et peuvent être utilisés pour planifier un basculement à une heure précise.
Selon la situation, les requêtes peuvent renvoyer des codes d’état HTTP et des corps différents. Le code d’état 200 est retourné lorsque le basculement planifié ou le basculement s’est terminé avec succès. Si le basculement planifié a été correctement planifié, Patroni renvoie le code d’état HTTP 202. En cas d’erreur, un code d’état d’erreur (l’un des codes 400, 412 ou 503) est retourné, accompagné de détails dans le corps de la réponse.
DELETE /switchover peut être utilisé pour supprimer le basculement planifié actuellement prévu.
Exemple : effectuer un basculement planifié vers une station de secours saine
Exemple : effectuer un basculement planifié vers un nœud spécifique
Exemple : planifier un basculement planifié du leader vers un autre nœud de secours sain du cluster à une heure précise.
basculement
Le point de terminaison /failover peut être utilisé pour effectuer un basculement manuel lorsque aucun nœud sain n’est disponible (par exemple, vers un réplica asynchrone si tous les réplicas synchrones ne sont pas suffisamment sains pour être promus). Toutefois, il n’existe aucune obligation pour un cluster de ne pas avoir de leader : le basculement peut également être exécuté sur un cluster sain.
Dans le corps JSON de la requête POST, vous devez spécifier le champ candidate. Si le champ leader est spécifié, un basculement planifié est déclenché à la place.
Exemple :
[!AVERTISSEMENT]
Faites preuve de prudence lors de l’utilisation de cette API, car cela peut entraîner une perte de données dans certaines situations. Dans la plupart des cas, l’endpoint de basculement planifié répond aux besoins de l’administrateur.
Les points de terminaison POST /switchover et POST /failover sont utilisés par patronictl_switchover
et patronictl_failover
respectivement.
DELETE /switchover est utilisé par patronictl flush cluster-name basculement planifié
.
| Basculer | Basculer planifié | |
|---|---|---|
| Nécessite un leader spécifié | non | oui |
| Nécessite un candidat spécifié | oui | non |
| Peut être exécuté en pause | oui | oui (uniquement vers un candidat spécifique) |
| Peut être planifié | non | oui (si non en pause) |
Comparaison entre basculement et basculement planifié
Standby sain
Plusieurs vérifications doivent être effectuées par un membre d’un cluster afin de pouvoir participer à la course au rôle de leader lors d’un basculement planifié ou de devenir leader en tant que candidat au basculement ou au basculement planifié :
- être accessible via l’API Patroni ;
- ne pas avoir l’étiquette
nofailoverdéfinie surtrue;
- ne pas avoir l’étiquette
- avoir le watchdog entièrement fonctionnel (si requis par la configuration) ;
- en cas de basculement planifié dans un cluster sain ou de basculement automatique, ne pas dépasser le décalage maximal de réplication (
maximum_lag_on_failoverparamètre de configuration ) ;
- en cas de basculement planifié dans un cluster sain ou de basculement automatique, ne pas dépasser le décalage maximal de réplication (
- en cas de basculement planifié dans un cluster sain ou de basculement automatique, ne pas avoir un numéro de timeline inférieur à celui du cluster si
check_timelineparamètre de configuration est défini surtrue;
- en cas de basculement planifié dans un cluster sain ou de basculement automatique, ne pas avoir un numéro de timeline inférieur à celui du cluster si
- en mode synchrone :
- En cas de basculement planifié (avec ou sans candidat) : être inclus dans la liste des membres
/sync;
- En cas de basculement planifié (avec ou sans candidat) : être inclus dans la liste des membres
- En cas de basculement dans des clusters sains ou défaillants, cette vérification est omise.
[!AVERTISSEMENT]
En cas de basculement manuel dans un cluster sans leader, un candidat peut être promu même si : - il n’est pas membre du
/synclorsque le mode synchrone est activé ; - son retard dépasse le retard maximal de réplication autorisé ; - son numéro de timeline est inférieur au dernier numéro de timeline connu du cluster.
Point d’arrêt de redémarrage
POST /restart: Vous pouvez redémarrer Postgres sur le nœud spécifique en effectuant l’appelPOST /restart. Dans le corps JSON de la requêtePOST, il est possible de spécifier de manière optionnelle certaines conditions de redémarrage :- restart_pending : booléen, si défini à
true, Patroni redémarrera PostgreSQL uniquement lorsque le redémarrage est en attente afin d’appliquer certaines modifications de configuration de PostgreSQL. - role : effectuer le redémarrage uniquement si le rôle actuel du nœud correspond au rôle fourni dans la requête POST.
- postgres_version : effectuer le redémarrage uniquement si la version actuelle de PostgreSQL est inférieure à celle spécifiée dans la requête POST.
- timeout : durée d’attente avant que PostgreSQL ne commence à accepter les connexions. Remplace
primary_start_timeout. - schedule : horodatage avec fuseau horaire, planifier le redémarrage à une date future.
- restart_pending : booléen, si défini à
DELETE /restart: supprimer le redémarrage planifié
Les points de terminaison POST /restart et DELETE /restart sont utilisés par patronictl_restart
et patronictl flush cluster-name restart
respectivement.
Point de terminaison de rechargement
L’appel POST /reload ordonne à Patroni de relire et d’appliquer le fichier de configuration. Cela équivaut à envoyer le signal SIGHUP au processus Patroni. Si vous avez modifié certains paramètres de Postgres nécessitant un redémarrage (comme shared_buffers), vous devez toujours effectuer explicitement le redémarrage de Postgres en appelant l’endpoint POST /restart ou à l’aide de patronictl restart
.
Le point de terminaison reload est utilisé par patronictl_reload .
Réinitialiser le point de terminaison
POST /reinitialize : réinitialiser le répertoire de données PostgreSQL sur le nœud spécifié. Cette opération ne peut être exécutée qu’aux répliques. Une fois appelée, elle supprime le répertoire de données et déclenche pg_basebackup ou une autre méthode alternative de création de réplique replica creation method
.
L’appel peut échouer si Patroni est en boucle de récupération (redémarrage) d’une instance Postgres défaillante. Pour contourner ce problème, il est possible de spécifier {"force":true} dans le corps de la requête.
Vous pouvez spécifier {“from-leader”:true} dans le corps de la requête pour obtenir directement un basebackup depuis le nœud leader. Cela est utile lors de l’exécution d’un reinit lorsque tous les nœuds répliques échouent.
Le point de terminaison de réinitialisation est utilisé par patronictl_reinit .
5 - patronictl
Patroni dispose d’une interface en ligne de commande nommée patronictl , utilisée principalement pour interagir avec l’API REST de Patroni et avec le DCS. Elle vise à simplifier l’exécution d’opérations au sein du cluster et peut être facilement utilisée par des humains ou des scripts.
Configuration
patronictl utilise trois sections de la configuration :
- ctl : comment s’authentifier contre l’API REST de Patroni, et comment valider l’identité du serveur. Consulter paramètres ctl pour plus de détails ;
- restapi : comment s’authentifier contre l’API REST de Patroni, et comment valider l’identité du serveur. N’est utilisé que si la configuration
ctlest insuffisante. patronictl s’intéresse principalement à la sectionrestapi.authentication(en cas de non-présence dectl.authentication) et au paramètrerestapi.cafile(en cas de non-présence dectl.cacert). Consulter paramètres de l’API REST pour plus de détails ; - DCS (par exemple etcd) : comment contacter et s’authentifier contre le DCS utilisé par Patroni.
Ces options de configuration peuvent provenir soit de variables d’environnement, soit d’un fichier de configuration. Consultez les sections ci-dessus dans Paramètres de configuration par environnement ou Paramètres de configuration YAML pour comprendre comment définir ces options via des variables d’environnement ou un fichier de configuration.
Si vous choisissez d’utiliser des variables d’environnement, il s’agit d’une approche directe. Patronictl lira les variables d’environnement et utilisera leurs valeurs.
Si vous choisissez d’utiliser un fichier de configuration, vous disposez de différentes méthodes pour indiquer à patronictl
le fichier à utiliser. Par défaut, patronictl
tentera de charger un fichier de configuration nommé patronictl.yaml, qui doit se trouver dans l’un des chemins suivants, selon votre système :
- macOS :
~/Library/Application Support/patroni - macOS (POSIX) :
~/.patroni - Unix :
~/.config/patroni - Unix (POSIX) :
~/.patroni - Windows (enregistrement local) :
C:\Users\<user>\AppData\Roaming\patroni - Windows (sans enregistrement local) :
C:\Users\<user>\AppData\Local\patroni
Vous pouvez remplacer ce comportement soit en :
- Définition de la variable d’environnement
PATRONICTL_CONFIG_FILEavec le chemin vers un fichier de configuration personnalisé ; - Utilisation de l’argument en ligne de commande
-c/--config-filede patronictl avec le chemin vers un fichier de configuration personnalisé.
Si vous exécutez patronictl
sur le même hôte que le patronidaemon__, vous pouvez utiliser le même fichier de configuration, à condition qu’il contienne toutes les sections de configuration requises par patronictl
.
Utilisation
patronictl met à disposition plusieurs opérations pratiques. Cette section a pour but de décrire chacune d’entre elles.
Avant d’aborder chacune des sous-commandes de patronictl , sachez que patronictl dispose elle-même des arguments suivants en ligne de commande :
-c / --config-file
Comme expliqué précédemment, utilisé pour spécifier le chemin vers un fichier de configuration pour patronictl
.
-d / --dcs-url / --dcs
Fournir une chaîne de connexion vers le DCS utilisé par Patroni.
Cet argument peut être utilisé soit pour remplacer les paramètres DCS et namespace provenant de la configuration patronictl
, soit pour les définir s’ils sont absents de la configuration.
La valeur doit être au format DCS://HOST:PORT/NAMESPACE, par exemple etcd3://localhost:2379/service pour se connecter à etcd v3 en cours d’exécution sur localhost avec le cluster Patroni stocké dans l’espace de noms service. Toute partie manquante dans la valeur de l’argument sera remplacée par la valeur présente dans la configuration ou par sa valeur par défaut.
-k / --insecure
Indicateur permettant de contourner la validation du certificat SSL du serveur API REST.
Voici le synopsis de l’exécution d’une commande depuis le patronictl :
Voici la syntaxe pour le synopsis :
- Les options entre crochets sont facultatives ;
- Les options entre accolades représentent une opération « choisir un parmi un ensemble » ;
- Les options avec
[, ... ]peuvent être spécifiées plusieurs fois ; - Les éléments écrits en majuscules représentent une valeur littérale qui doit être fournie.
Nous utiliserons cette même syntaxe pour décrire les sous-commandes de patronictl
dans les sous-sections suivantes. De plus, lors de la description des sous-commandes dans les sous-sections suivantes, la synthaxe des commandes doit être considérée comme une substitution du SUBCOMMAND dans le synopsis ci-dessus.
Dans les sous-sections suivantes, vous trouverez la description de chaque commande implémentée par patronictl
. Pour illustrer, nous utiliserons les fichiers de configuration présents dans le dépôt GitHub de Patroni (fichiers postgres0.yml, postgres1.yml et postgres2.yml).
patronictl demote-cluster
Synopsis
Description
patronictl demote-cluster convertit un cluster Patroni régulier en cluster de secours standby cluster
.
La commande applique une mise à jour de la configuration dynamique avec une section standby_cluster construite à partir des options de connexion fournies pour le primaire distant, puis attend que le leader soit en cours d’exécution en tant que leader de basculement. Elle affiche la topologie actuelle du cluster avant de modifier la configuration et demande une confirmation, sauf si --force est utilisé.
Au moins un des éléments --host, --port ou --restore-command doit être spécifié.
Paramètres
CLUSTER_NAME : Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--host : Adresse du nœud distant.
--port : Port du nœud distant.
--restore-command : Commande permettant de restaurer les enregistrements WAL depuis le serveur primaire distant.
--primary-slot-name : Nom de l’ensemble de réplication sur le nœud distant à utiliser pour la réplication.
--force : Indicateur permettant de passer outre les invites de confirmation lors de la désactivation du cluster.
Utile pour les scripts.
Exemples
Baissez le cluster en cluster de secours qui suit un point de terminaison primaire distant :
patronictl dsn
Synopsis
Description
patronictl dsn obtient la chaîne de connexion d’un membre du cluster Patroni.
Si plusieurs membres correspondent aux paramètres de cette commande, l’un d’entre eux sera sélectionné, en priorisant le nœud primaire.
Paramètres
CLUSTER_NAME : Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
-r / --role
Choisissez un membre ayant le rôle indiqué.
Le rôle peut être l’un des suivants :
leader: le leader d’un cluster Patroni régulier ou d’un cluster Patroni en veille ; ouprimary: le leader d’un cluster Patroni régulier ; oustandby-leader: le leader d’un cluster Patroni en veille ; oureplica: une réplique d’un cluster Patroni ; oustandby: identique àreplica; ouany: tout rôle. Identique à la suppression de ce paramètre ; ou
-m / --member
Sélectionnez un membre du cluster portant le nom indiqué.
MEMBER_NAME est le nom du membre.
--group
Sélectionnez un membre faisant partie du groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
Exemples
Obtenir le DSN du nœud primaire :
Obtenir la chaîne de connexion (DSN) du nœud nommé postgresql1 :
patronictl edit-config
Synopsis
Description
patronictl edit-config modifie la configuration dynamique du cluster et met à jour le DCS avec ces modifications.
Lorsqu’il est appelé via un TTY, la commande tente d’afficher une différence de la configuration dynamique à l’aide d’un visualiseur de pages. Par défaut, elle tente d’utiliser soit less soit more. Si vous souhaitez utiliser un autre visualiseur, définissez la variable d’environnement PAGER avec celui souhaité.
Paramètres
CLUSTER_NAME : Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Modifie la configuration dynamique du groupe Citus indiqué.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration citus.group, si elle existe.
CITUS_GROUP est l’identifiant du groupe Citus.
-q / --quiet
Indicateur permettant de passer outre l’affichage de la différence de configuration.
-s / --set
Définir une option de configuration dynamique donnée avec une valeur donnée.
CONFIG est le nom du chemin de configuration dynamique dans l’arborescence YAML, dont les niveaux sont séparés par ..
VALUE est la valeur de CONFIG. Si elle est égale à null, alors CONFIG sera supprimé de la configuration dynamique.
-p / --pg
Définir une option de configuration dynamique Postgres donnée avec la valeur indiquée.
Il s’agit essentiellement d’un raccourci pour --s / --set avec CONFIG préfixé par postgresql.parameters..
PG_CONFIG est le nom de la configuration Postgres à définir.
PG_VALUE est la valeur de PG_CONFIG. Si elle est égale à null, alors PG_CONFIG sera supprimé de la configuration dynamique.
--apply
Appliquer la configuration dynamique à partir du fichier spécifié.
Il est similaire à la spécification de plusieurs options -s / --set, une pour chaque configuration de CONFIG_FILE.
CONFIG_FILE est le chemin vers un fichier contenant la configuration dynamique à appliquer, au format YAML. Utilisez - si vous souhaitez lire à partir de stdin.
--replace
Remplacez la configuration dynamique dans le DCS par la configuration dynamique spécifiée dans le fichier fourni.
CONFIG_FILE est le chemin vers un fichier contenant la nouvelle configuration dynamique à appliquer, au format YAML. Utilisez - si vous souhaitez lire depuis stdin.
--force
Indicateur permettant de passer outre les invites de confirmation lors du changement de la configuration dynamique.
Utile pour les scripts.
Exemples
Modifiez le paramètre GUC Postgres max_connections :
Modifiez les paramètres loop_wait et ttl :
Supprimez le paramètre maximum_lag_on_failover de la configuration dynamique :
patronictl basculement
Synopsis
Description
patronictl failover effectue un basculement manuel dans le cluster.
Il est conçu pour être utilisé lorsque le cluster n’est pas sain, par exemple :
- Il n’y a pas de leader ; ou
- Aucun standby synchrone n’est disponible dans un cluster synchrone.
Il permet également de basculer vers un nœud asynchrone si le mode synchrone est activé.
Rien n’empêche d’exécuter patronictl failover dans un cluster sain. Toutefois, nous recommandons d’utiliser patronictl switchover dans ces cas.
[!AVERTISSEMENT]
Le déclenchement d’un basculement peut entraîner une perte de données, selon l’état de mise à jour de la réplique promue par rapport au primaire.
Paramètres
CLUSTER_NAME : Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Effectuez un basculement dans le groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
--candidate
Nœud à promouvoir lors d’un basculement.
CANDIDATE_NAME est le nom du nœud à promouvoir.
--force
Indicateur permettant de passer outre les invites de confirmation lors d’un basculement.
Utile pour les scripts.
Exemples
Basculer vers le nœud postgresql2 :
patronictl flush
Synopsis
Description
patronictl flush rejette les événements planifiés, le cas échéant.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
MEMBER_NAME
Ignorer les événements planifiés pour le ou les membres Patroni indiqués.
Plusieurs membres peuvent être spécifiés. Si aucun membre n’est spécifié, tous les membres sont pris en compte.
Utilisé uniquement si les événements de redémarrage planifié sont ignorés.
restart
Ignorer les événements de redémarrage planifiés.
switchover
Annuler l’événement de basculement planifié.
--group
Ignore les événements planifiés du groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
-r / --role
Ignorer les événements planifiés pour les membres ayant le rôle spécifié.
Le rôle peut être l’un des suivants :
leader: le leader d’un cluster Patroni régulier ou d’un cluster Patroni en veille ; ouprimary: le leader d’un cluster Patroni régulier ; oustandby-leader: le leader d’un cluster Patroni en veille ; oureplica: une réplique d’un cluster Patroni ; oustandby: identique àreplica; ouany: tout rôle. Identique à omettre ce paramètre.
Utilisé uniquement si les événements de redémarrage planifié sont ignorés.
--force
Indicateur permettant de passer outre les invites de confirmation lors de l’exécution de l’opération d’effacement.
Utile pour les scripts.
Exemples
Annuler un événement de basculement planifié :
Annuler le redémarrage planifié de tous les nœuds de secours :
Annuler le redémarrage planifié des nœuds postgresql0 et postgresql1 :
patronictl history
Synopsis
Description
patronictl history affiche l’historique des événements de basculement et de basculement planifié du cluster, le cas échéant.
Les informations suivantes sont incluses dans la sortie :
TL
Timeline Postgres au moment de l’événement.
LSN
LSN de Postgres au moment de l’événement.
Reason
Raison extraite du fichier Postgres .history.
Timestamp
Heure à laquelle l’événement s’est produit.
New Leader
Membre Patroni ayant été promu pendant l’événement.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Affiche l’historique des événements du groupe Citus spécifié.
CITUS_GROUP est l’identifiant du groupe Citus.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration citus.group, si elle existe.
-f / --format
Comment formater la liste des événements dans la sortie.
Le format peut être l’un des suivants :
pretty: affiche l’historique sous forme de tableau élégant ; outsv: affiche l’historique sous forme d’information tabulaire, les colonnes étant séparées par\t; oujson: affiche l’historique au format JSON ; ouyaml: affiche l’historique au format YAML.
La valeur par défaut est pretty.
--force
Indicateur permettant de passer outre les invites de confirmation lors de l’exécution de l’opération d’effacement.
Utile pour les scripts.
Exemples
Affichez l’historique des événements :
Affichez l’historique des événements au format YAML :
patronictl list
Synopsis
Description
patronictl list affiche des informations sur le cluster Patroni et ses membres.
Les informations suivantes sont incluses dans la sortie :
Cluster
Nom du cluster Patroni.
Member
Nom du membre Patroni.
Host
Hôte sur lequel le membre est situé.
Role
Rôle actuel du membre.
Peut être l’un des suivants :
Leader: le leader actuel d’un cluster Patroni régulier ; ouStandby Leader: le leader actuel d’un cluster de secours Patroni ; ouSync Standby: une réplique de secours synchrone d’un cluster Patroni avec le mode synchrone activé ; ouReplica: une réplique de secours régulière d’un cluster Patroni.
State
État actuel de PostgreSQL dans le membre Patroni.
Quelques exemples parmi les états possibles :
running: si PostgreSQL est actuellement en cours d’exécution ;streaming: si une réplique et PostgreSQL reçoit actuellement des journaux WAL depuis le nœud primaire ;in archive recovery: si une réplique et PostgreSQL récupère actuellement les journaux WAL depuis l’archive ;stopped: si PostgreSQL a été arrêté ;crashed: si PostgreSQL a planté.
TL
Timeline actuelle de PostgreSQL dans le membre Patroni.
Receive LSN
Dernière position du journal d’avance écrite reçue et synchronisée sur le disque par la réplication en streaming du membre (pg_catalog.pg_last_(xlog|wal)_receive_(location|lsn)()).
Receive Lag
Délai de réplication entre la position Receive LSN du membre et son amont, en mégaoctets.
Replay LSN
Emplacement du dernier journal d’écriture avancée rejeu durant la récupération du membre (pg_catalog.pg_last_(xlog|wal)_replay_(location|lsn)()).
Replay Lag
Délai de réplication entre la position Replay LSN du membre et son amont, en mégaoctets.
En outre, les informations suivantes peuvent être incluses dans la sortie :
System identifier
Identifiant système Postgres.
Affiché dans l’en-tête du tableau.
Affiché uniquement si le format de sortie est pretty.
Group
ID du groupe Citus.
Affiché dans l’en-tête du tableau.
Affiché uniquement si un cluster Citus est utilisé.
Pending restart
* indique que le nœud nécessite un redémarrage pour que certaines configurations Postgres prennent effet. Une valeur vide indique que le nœud n’a pas besoin de redémarrage.
Affiché en tant qu’attribut membre.
Affiché si :
- Impression au format
prettyoutsvavec la sortie étendue activée ; ou - Si le nœud nécessite un redémarrage.
Scheduled restart
Horodatage à partir duquel une redémarrage a été planifié pour l’instance Postgres gérée par le membre Patroni. Une valeur vide indique qu’aucun redémarrage n’est planifié pour le membre.
Affiché en tant qu’attribut membre.
Affiché si :
- Impression au format
prettyoutsvavec la sortie étendue activée ; ou - Si le nœud a un redémarrage planifié.
Tags
Contient les balises définies pour le membre Patroni. Une valeur vide indique qu’aucune balise n’a été configurée, ou qu’elles ont été configurées avec des valeurs par défaut.
Affiché en tant qu’attribut membre.
Affiché si :
- Impression au format
prettyoutsvavec la sortie étendue activée ; ou - Si le nœud possède des balises personnalisées, ou des balises par défaut avec des valeurs non par défaut.
Scheduled switchover
Horodatage auquel un basculement planifié a été prévu pour le cluster Patroni, le cas échéant.
Affiché dans le pied de tableau.
Affiché uniquement s’il existe un basculement planifié, et que le format de sortie est pretty.
Maintenance mode
Si la surveillance du cluster est actuellement mise en pause.
NoteAffiché dans le pied de tableau.
Affiché uniquement si le cluster est en pause, et que le format de sortie est
pretty.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Affiche les informations relatives aux membres du groupe Citus spécifié.
CITUS_GROUP est l’identifiant du groupe Citus.
-e / --extended
Affiche des informations étendues.
Forcer l’affichage des attributs Pending restart, Scheduled restart et Tags, même si leur valeur est vide.
S’applique uniquement aux formats de sortie pretty et tsv.
-t / --timestamp
Affiche une horodatage avant d’afficher les informations sur le cluster et ses membres.
-f / --format
Comment formater la liste des événements dans la sortie.
Le format peut être l’un des suivants :
pretty: affiche l’historique sous forme de tableau élégant ; outsv: affiche l’historique sous forme d’information tabulaire, les colonnes étant séparées par\t; oujson: affiche l’historique au format JSON ; ouyaml: affiche l’historique au format YAML.
La valeur par défaut est pretty.
-W
Actualisez automatiquement les informations toutes les 2 secondes.
-w / --watch
Actualiser automatiquement les informations à l’intervalle spécifié.
TIME est l’intervalle entre les actualisations, en secondes.
Exemples
Affichez les informations sur le cluster au format lisible :
Affichez les informations sur le cluster au format lisible avec des colonnes étendues :
Affichez les informations sur le cluster au format YAML, avec l’horodatage de l’exécution :
patronictl pause
Synopsis
Description
patronictl pause met temporairement le cluster Patroni en mode maintenance et désactive le basculement automatique.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Met en pause le groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration citus.group, si elle existe.
--wait
Attendez que tous les membres Patroni soient mis en pause avant de restituer le contrôle à l’appelant.
Exemples
Mettez le cluster en mode maintenance, puis attendez que tous les nœuds aient été mis en pause :
patronictl promouvoir-cluster
Synopsis
Description
patronictl promote-cluster convertit un cluster de secours en cluster Patroni régulier.
La commande supprime la section standby_cluster de la configuration dynamique et attend que le leader fonctionne en tant que primaire. Elle affiche la topologie actuelle du cluster avant de modifier la configuration et demande une confirmation, sauf si --force est utilisé.
Paramètres
CLUSTER_NAME : Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--force : Indicateur permettant de passer outre les invites de confirmation lors de la promotion du cluster.
Utile pour les scripts.
Exemples
Promouvoir le cluster de secours pour qu’il fonctionne en tant que cluster Patroni régulier :
patronictl query
Synopsis
Description
patronictl query exécute une commande ou un script SQL sur un membre du cluster Patroni.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Interrogez le groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
-r / --role
Choisissez un membre ayant le rôle indiqué.
Le rôle peut être l’un des suivants :
leader: le leader d’un cluster Patroni régulier ou d’un cluster Patroni en veille ; ouprimary: le leader d’un cluster Patroni régulier ; oustandby-leader: le leader d’un cluster Patroni en veille ; oureplica: une réplique d’un cluster Patroni ; oustandby: identique àreplica; ouany: tout rôle. Identique à omettre ce paramètre.
-m / --member
Choisissez un membre ayant le nom indiqué.
MEMBER_NAME est le nom du membre à sélectionner.
-d / --dbname
Base de données à laquelle se connecter pour exécuter la requête.
DBNAME est le nom de la base de données. S’il n’est pas fourni, la valeur par défaut est USERNAME.
-U / --username
Utilisateur pour se connecter à la base de données.
USERNAME nom de l’utilisateur. S’il n’est pas fourni, la valeur par défaut est l’utilisateur du système d’exploitation exécutant patronictl query.
--password
Invite le mot de passe de l’utilisateur connecté.
Comme Patroni utilise libpq, vous pouvez également créer un fichier ~/.pgpass ou définir la variable d’environnement PGPASSWORD.
--format
Comment formater la sortie de la requête.
Le format peut être l’un des suivants :
pretty: affiche les résultats de la requête sous forme de tableau mis en forme ; outsv: affiche les résultats de la requête sous forme d’information tabulaire, les colonnes étant séparées par\t; oujson: affiche les résultats de la requête au format JSON ; ouyaml: affiche les résultats de la requête au format YAML.
La valeur par défaut est tsv.
-f / --file
Utilisez un fichier comme source de commandes pour exécuter des requêtes.
FILE_NAME est le chemin d’accès au fichier source.
-c / --command
Exécutez la commande SQL fournie dans la requête.
SQL_COMMAND est la commande SQL à exécuter.
--delimiter
Le délimiteur utilisé lors de l’affichage des informations au format tsv, ou \t si omis.
-W
Exécuter automatiquement la requête toutes les 2 secondes.
-w / --watch
Réexécuter automatiquement la requête à l’intervalle spécifié.
TIME indique, en secondes, l’intervalle séparant les réexécutions.
Exemples
Exécutez une commande SQL en tant qu’utilisateur postgres, puis indiquez son mot de passe :
Exécutez une commande SQL en tant qu’utilisateur postgres, en prenant le mot de passe depuis la variable d’environnement libpq :
Exécutez une commande SQL et affichez au format pretty toutes les 2 secondes :
Exécutez une commande SQL sur la base de données test et affichez la sortie au format YAML :
Exécutez une commande SQL sur le membre postgresql2 :
Exécutez une commande SQL sur l’un des serveurs de secours :
patronictl reinit
Synopsis
Description
patronictl reinit reconstruit une instance Postgres en mode standby gérée par une réplique membre du cluster Patroni.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
MEMBER_NAME
Nom du membre réplique pour lequel l’instance Postgres sera reconstruite.
Plusieurs répliques peuvent être spécifiées. Si aucune réplique n’est spécifiée, la commande ne fait rien.
--group
Reconstruit un membre réplica du groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
--wait
Attendez que la réinitialisation du(nœud) de secours Postgres soit terminée.
--force
Indicateur permettant de passer outre les invites de confirmation lors de la reconstruction des instances secondaires Postgres.
--from-leader
Indicateur permettant d’obtenir un basebackup directement depuis le leader.
Utile pour les scripts.
Exemples
Demandez une reconstruction de toutes les répliques du cluster Patroni et renvoyez immédiatement le contrôle à l’appelant :
Demandez une reconstruction de postgresql2 et attendez sa finalisation :
Demandez une reconstruction de postgresql2 et obtenez le basebackup directement depuis le leader :
patronictl reload
Synopsis
Description
patronictl reload demande un rechargement de la configuration locale pour un ou plusieurs membres Patroni.
Il déclenche également pg_ctl reload sur l’instance Postgres gérée, même si rien n’a changé.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
MEMBER_NAME
Demander un rechargement de la configuration locale pour le ou les membres Patroni indiqués.
Plusieurs membres peuvent être spécifiés. Si aucun membre n’est spécifié, tous les membres sont pris en compte.
--group
Demandez un rechargement des membres du groupe Citus donné.
CITUS_GROUP est l’identifiant du groupe Citus.
-r / --role
Sélectionne les membres ayant le rôle indiqué.
Le rôle peut être l’un des suivants :
leader: le leader d’un cluster Patroni régulier ou d’un cluster Patroni en veille ; ouprimary: le leader d’un cluster Patroni régulier ; oustandby-leader: le leader d’un cluster Patroni en veille ; oureplica: une réplique d’un cluster Patroni ; oustandby: identique àreplica; ouany: tout rôle. Identique à omettre ce paramètre.
--force
Indicateur permettant de passer outre les invites de confirmation lors de la demande de rechargement de la configuration locale.
Utile pour les scripts.
Exemples
Demandez un rechargement de la configuration locale de tous les membres du cluster Patroni :
patronictl supprimer
Synopsis
Description
patronictl remove supprime les informations du cluster du DCS.
Il s’agit d’une action interactive.
[!AVERTISSEMENT]
Cette opération supprimera les informations du cluster Patroni dans le DCS.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
--group
Supprimez les informations relatives au cluster Patroni associées au groupe Citus donné.
CITUS_GROUP est l’identifiant du groupe Citus.
-f / --format
Comment formater la liste des membres dans la sortie lors de la demande de confirmation.
Le format peut être l’un des suivants :
pretty: affiche les membres sous forme de tableau mis en forme ; outsv: affiche les membres sous forme de tableaux, les colonnes étant séparées par\t; oujson: affiche les membres au format JSON ; ouyaml: affiche les membres au format YAML.
La valeur par défaut est pretty.
Exemples
Supprimer les informations relatives au cluster Patroni batman du DCS :
patronictl restart
Synopsis
Description
patronictl restart demande un redémarrage de l’instance Postgres gérée par un membre du cluster Patroni.
La redémarrage peut être effectué immédiatement ou planifié pour une date ultérieure.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
--group
Redémarrez le cluster Patroni associé au groupe Citus donné.
CITUS_GROUP est l’identifiant du groupe Citus.
-r / --role
Sélectionnez les membres ayant le rôle indiqué.
Le rôle peut être l’un des suivants :
leader: le leader d’un cluster Patroni régulier ou d’un cluster Patroni en veille ; ouprimary: le leader d’un cluster Patroni régulier ; oustandby-leader: le leader d’un cluster Patroni en veille ; oureplica: une réplique d’un cluster Patroni ; oustandby: identique àreplica; ouany: tout rôle. Identique à omettre ce paramètre.
--any
Redémarre un nœud aléatoire parmi ceux qui correspondent aux filtres donnés.
--pg-version
Sélectionnez uniquement les membres dont la version de l’instance Postgres gérée est antérieure à la version indiquée.
PG_VERSION est la version de Postgres à comparer.
--pending
Sélectionnez uniquement les membres marqués comme Pending restart.
--timeout : Interrompre le redémarrage s’il dure plus que le délai spécifié, et basculer vers une réplique si le problème se situe sur le primaire.
TIMEOUT est le nombre de secondes à attendre avant d’abandonner le redémarrage.
--scheduled
Planifiez une redémarrage à effectuer à l’instant indiqué.
TIMESTAMP est l’horodatage auquel la redémarrage doit avoir lieu. Spécifiez-le au format non ambigu, idéalement avec fuseau horaire. Vous pouvez également utiliser la valeur littérale now pour exécuter le redémarrage immédiatement.
--force
Indicateur permettant de passer outre les invites de confirmation lors de la demande de redémarrage.
Utile pour les scripts.
Exemples
Redémarrez immédiatement tous les membres du cluster :
Redémarrez immédiatement un membre aléatoire du cluster :
Planifiez une redémarrage à se produire à 2023-09-13T18:00-03:00 :
patronictl reprendre
Synopsis
Description
patronictl resume sort le cluster Patroni du mode maintenance et réactive le basculement automatique.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Reprendre le groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration citus.group, si elle existe.
--wait
Attendez que tous les membres Patroni soient repassés en mode actif avant de restituer le contrôle à l’appelant.
Exemples
Mettez le cluster hors du mode maintenance :
patronictl show-config
Synopsis
Description
patronictl show-config affiche la configuration dynamique du cluster stockée dans le DCS.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Affiche la configuration dynamique du groupe Citus donné.
CITUS_GROUP est l’identifiant du groupe Citus.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration citus.group, si elle existe.
Exemples
Affiche la configuration dynamique du cluster batman :
patronictl basculement planifié
Synopsis
Description
patronictl switchover effectue un basculement planifié dans le cluster.
Il est conçu pour être utilisé lorsque le cluster est sain, par exemple :
- Il y a un leader ;
- Il existe des répliques synchrones disponibles dans un cluster synchrone.
Si votre cluster est défaillant, vous pourriez être intéressé par patronictl failover à la place.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Effectuez un basculement planifié dans le groupe Citus indiqué.
CITUS_GROUP est l’identifiant du groupe Citus.
--leader / --primary
Indiquez le leader à rétrograder au moment du basculement planifié.
LEADER_NAME doit correspondre au nom du leader actuel dans le cluster.
--candidate
Nœud à promouvoir lors d’un basculement planifié, et qui prendra le rôle primaire.
CANDIDATE_NAME est le nom du nœud à promouvoir.
--scheduled
Planifiez un basculement planifié à s’effectuer à l’instant indiqué.
TIMESTAMP est l’horodatage auquel le basculement planifié doit avoir lieu. Indiquez-le au format non ambigu, idéalement avec fuseau horaire. Vous pouvez également utiliser le littéral now pour exécuter le basculement planifié immédiatement.
--force
Indicateur permettant de passer outre les invites de confirmation lors d’un basculement planifié.
Utile pour les scripts.
Exemples
Basculer sur le nœud postgresql2 :
Planifiez un basculement planifié entre postgresql0 et postgresql2 afin qu’il ait lieu à 2023-09-13T18:00:00-03:00 :
patronictl topology
Synopsis
Description
patronictl topology affiche les informations concernant le cluster Patroni et ses membres selon une approche en arbre.
Les informations suivantes sont incluses dans la sortie :
Cluster
Nom du cluster Patroni.
Affiché dans l’en-tête du tableau.
System identifier
Identifiant système Postgres.
Affiché dans l’en-tête du tableau.
Member
Nom du membre Patroni.
Les informations de cette colonne s’affichent sous forme d’arborescence des membres en fonction des connexions de réplication.
Host
Hôte sur lequel le membre est situé.
Role
Rôle actuel du membre.
Peut être l’un des suivants :
Leader: le leader actuel d’un cluster Patroni régulier ; ouStandby Leader: le leader actuel d’un cluster de secours Patroni ; ouSync Standby: une réplique de secours synchrone d’un cluster Patroni avec le mode synchrone activé ; ouReplica: une réplique de secours régulière d’un cluster Patroni.
State
État actuel de PostgreSQL dans le membre Patroni.
Quelques exemples parmi les états possibles :
running: si PostgreSQL est actuellement en cours d’exécution ;streaming: si une réplique et PostgreSQL reçoit actuellement des journaux WAL depuis le nœud primaire ;in archive recovery: si une réplique et PostgreSQL récupère actuellement les journaux WAL depuis l’archive ;stopped: si PostgreSQL a été arrêté ;crashed: si PostgreSQL a planté.
TL
Timeline actuelle de PostgreSQL dans le membre Patroni.
Receive LSN
Dernière position du journal d’avance écrite reçue et synchronisée sur le disque par la réplication en streaming du membre (pg_catalog.pg_last_(xlog|wal)_receive_(location|lsn)()).
Receive Lag
Délai de réplication entre la position Receive LSN du membre et son amont, en mégaoctets.
Replay LSN
Emplacement du dernier journal d’écriture avancée rejeu durant la récupération du membre (pg_catalog.pg_last_(xlog|wal)_replay_(location|lsn)()).
Replay Lag
Délai de réplication entre la position Replay LSN du membre et son amont, en mégaoctets.
En outre, les informations suivantes peuvent être incluses dans la sortie :
Group
ID du groupe Citus.
Affiché dans l’en-tête du tableau.
Affiché uniquement si un cluster Citus est utilisé.
Pending restart
* indique que le nœud nécessite un redémarrage pour que certaines configurations Postgres prennent effet. Une valeur vide indique que le nœud n’a pas besoin de redémarrage.
Affiché en tant qu’attribut membre.
Affiché si le nœud nécessite un redémarrage.
Scheduled restart
Horodatage à partir duquel une redémarrage a été planifié pour l’instance Postgres gérée par le membre Patroni. Une valeur vide indique qu’aucun redémarrage n’est planifié pour le membre.
Affiché en tant qu’attribut membre.
Affiché si le nœud a un redémarrage planifié.
Tags
Contient les balises définies pour le membre Patroni. Une valeur vide indique qu’aucune balise n’a été configurée, ou qu’elles ont été configurées avec des valeurs par défaut.
Affiché en tant qu’attribut membre.
Affiché si le nœud possède des balises personnalisées, ou des balises par défaut avec des valeurs non par défaut.
Scheduled switchover
Horodatage auquel un basculement planifié a été prévu pour le cluster Patroni, le cas échéant.
Affiché dans le pied de tableau.
Affiché uniquement si un basculement planifié est prévu.
Maintenance mode
Si la surveillance du cluster est actuellement mise en pause.
NoteAffiché dans le pied de tableau.
Affiché uniquement si le cluster est mis en pause.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
Si elle n’est pas fournie, patronictl
tentera de la récupérer à partir de la configuration scope, si elle existe.
--group
Affiche les informations relatives aux membres du groupe Citus spécifié.
CITUS_GROUP est l’identifiant du groupe Citus.
-W
Actualisez automatiquement les informations toutes les 2 secondes.
-w / --watch
Actualiser automatiquement les informations à l’intervalle spécifié.
TIME est l’intervalle entre les actualisations, en secondes.
Exemples
Affiche la topologie du cluster batman – postgresql1 et postgresql2 sont en réplication depuis postgresql0 :
patronictl version
Synopsis
Description
patronictl version obtient la version de l’application patronictl
. En outre, elle peut également inclure des informations sur la version des clusters Patroni et de leurs membres.
Paramètres
CLUSTER_NAME
Nom du cluster Patroni.
MEMBER_NAME
Nom du membre du cluster Patroni.
--group
Considérez un cluster Patroni avec le groupe Citus donné.
CITUS_GROUP est l’identifiant du groupe Citus.
Exemples
Obtenir la version de patronictl uniquement :
Obtenir la version de patronictl
et de tous les membres du cluster batman :
Obtenir la version de patronictl
et des membres postgresql1 et postgresql2 du cluster batman :
6 - Imagerie de réplique et amorçage
Patroni permet de personnaliser la création d’une nouvelle réplique. Il prend également en charge la définition des actions à effectuer lors de l’amorçage d’un nouveau cluster vide. La distinction entre les deux est clairement établie : Patroni crée des répliques uniquement si la clé initialize est présente dans le DCS pour le cluster. Si la clé initialize est absente, Patroni lance l’amorçage exclusivement sur le premier nœud qui obtient le verrou de la clé initialize.
amorçage
PostgreSQL fournit la commande initdb pour initialiser un nouveau cluster, et Patroni l’appelle par défaut. Dans certains cas, notamment lors de la création d’un nouveau cluster à partir d’une copie d’un cluster existant, il est nécessaire de remplacer la méthode intégrée par des actions personnalisées. Patroni prend en charge l’exécution de scripts définis par l’utilisateur pour amorcer de nouveaux clusters, en leur fournissant certains arguments requis, tels que le nom du cluster et le chemin du répertoire de données. Cette configuration est définie dans la section bootstrap de la configuration de Patroni. Par exemple :
Chaque méthode d’amorçage doit définir au moins un name et un command. Une méthode spéciale initdb est disponible pour déclencher le comportement par défaut, auquel cas le paramètre method peut être omis entièrement. Le command peut être spécifié soit par un chemin absolu, soit par un chemin relatif par rapport à l’emplacement de la commande patroni. En complément des paramètres fixes définis dans les fichiers de configuration, Patroni fournit deux paramètres spécifiques au cluster :
--scope
Nom du cluster à initialiser
--datadir
Chemin vers le répertoire de données de l’instance de cluster à initialiser
La transmission de ces deux drapeaux supplémentaires peut être désactivée en définissant un paramètre spécial no_params à True.
Si le script d’amorçage retourne 0, Patroni tente de configurer et de démarrer l’instance PostgreSQL qu’il a produite. Si l’une des étapes intermédiaires échoue, ou si le script retourne une valeur différente de zéro, Patroni considère que l’amorçage a échoué, nettoie après lui-même et libère le verrou d’initialisation afin de permettre à un autre nœud de tenter l’amorçage.
Si un bloc recovery_conf est défini dans la même section que la méthode d’amorçage personnalisée, Patroni générera un recovery.conf avant de démarrer l’instance nouvellement amorcée (ou définira les paramètres de récupération dans la configuration de PostgreSQL si PostgreSQL est en version >= 12). En général, cette configuration de récupération doit contenir au moins l’un des paramètres recovery_target_*, accompagné du paramètre recovery_target_action défini sur promote.
Si keep_existing_recovery_conf est défini et défini à True, Patroni ne supprimera pas le fichier recovery.conf existant s’il existe (PostgreSQL <= 11). De même, dans ce cas, Patroni ne supprimera pas le fichier recovery.signal ou standby.signal existant s’il existe, ni ne remplacera les paramètres de récupération configurés (PostgreSQL >= 12). Cela est utile lors du démarrage à partir d’une sauvegarde avec des outils comme pgBackRest, qui génèrent automatiquement la configuration de récupération appropriée.
En outre, toutes les paires clé/valeur supplémentaires indiquées dans la configuration de la méthode d’amorçage personnalisée seront passées en tant qu’arguments à command au format --name=value. Par exemple :
Fait appeler le command configuré en plus avec les arguments en ligne de commande --arg1=value1 --arg2=value2.
NoteLes méthodes d’amorçage ne sont ni chaînées, ni remplacées par celle par défaut en cas d’échec de la méthode primaire
Par exemple, vous pouvez amorcer un cluster Patroni vierge à partir d’une sauvegarde Barman avec une configuration de ce type :
patroni_barman recover nécessite que Barman et pg-backup-api soient configurés sur l’hôte Barman, afin de pouvoir exécuter un barman recover distant via l’API de sauvegarde. L’exemple ci-dessus utilise un sous-ensemble des paramètres disponibles. Vous pouvez obtenir davantage d’informations en exécutant patroni_barman recover --help.
Construction de répliques
Patroni utilise pg_basebackup éprouvé et éprouvé afin de créer de nouvelles répliques. Un inconvénient de cette solution est qu’elle nécessite un nœud leader en cours d’exécution. Un autre est l’absence de compression « en temps réel » des données de sauvegarde et l’absence de nettoyage automatique des fichiers de sauvegarde obsolètes. Certains utilisateurs préfèrent d’autres solutions de sauvegarde, telles que WAL-E, pgBackRest, Barman et d’autres, ou simplement concevoir leurs propres scripts. Afin de prendre en charge tous ces cas d’utilisation, Patroni prend en charge l’exécution de scripts personnalisés pour cloner une nouvelle réplique. Ceux-ci sont configurés dans le bloc de configuration postgresql :
exemple : wal_e
exemple : pgBackRest
exemple : Barman
patroni_barman recover nécessite que Barman et pg-backup-api soient configurés sur l’hôte Barman, afin de pouvoir exécuter un barman recover distant via l’API de sauvegarde. L’exemple ci-dessus utilise un sous-ensemble des paramètres disponibles. Vous pouvez obtenir davantage d’informations en exécutant patroni_barman recover --help.
Le create_replica_methods définit les méthodes disponibles pour créer une réplique ainsi que l’ordre d’exécution. Patroni s’arrête à la première méthode qui retourne 0. Chaque méthode doit définir une section distincte dans le fichier de configuration, en précisant la commande à exécuter et les paramètres personnalisés à passer à cette commande. Tous les paramètres seront transmis au format --name=value. Outre les paramètres définis par l’utilisateur, Patroni fournit plusieurs paramètres spécifiques au cluster :
--scope
Cluster auquel cette réplique appartient
--datadir
Chemin vers le répertoire de données de la réplique
--role
Toujours « réplique »
--connstring
Chaîne de connexion pour se connecter au membre du cluster à cloner (primaire ou autre réplique). L’utilisateur figurant dans la chaîne de connexion peut exécuter des commandes SQL et des commandes du protocole de réplication.
Un paramètre spécial no_leader, s’il est défini, permet à Patroni d’appeler la méthode de création de réplique même en l’absence de leader en cours d’exécution ou de répliques. Dans ce cas, une chaîne de connexion vide sera passée. Cela est utile pour restaurer un cluster précédemment en cours d’exécution à partir d’une sauvegarde binaire.
Un paramètre spécial keep_data, s’il est défini, indique à Patroni de ne pas nettoyer le dossier PGDATA avant d’appeler la restauration.
Un paramètre spécial no_params, si défini, limite le passage de paramètres à la commande personnalisée.
Une méthode basebackup est un cas particulier : elle sera utilisée si create_replica_methods est vide, même si elle peut être explicitement listée parmi les méthodes create_replica_methods. Cette méthode initialise une nouvelle réplique avec pg_basebackup ; la sauvegarde de base est extraite depuis le leader, sauf s’il existe des répliques étiquetées clonefrom, auquel cas l’une de ces répliques sera utilisée comme origine pour pg_basebackup. Elle fonctionne sans configuration ; toutefois, il est possible de spécifier une section de configuration basebackup. Les mêmes règles que pour la configuration des autres méthodes s’appliquent, à savoir que seules les options longues (avec –) doivent être indiquées. Tous les paramètres n’ont pas de sens ; si vous remplacez une chaîne de connexion ou fournissez une option pour créer des sauvegardes de base compressées ou archivées au format tar, Patroni ne pourra pas en faire une réplique. Aucune validation n’est effectuée sur les noms ou les valeurs des paramètres transmis à la section basebackup. Notez également que, dans le cas où des liens symboliques sont utilisés pour le dossier WAL, il incombe à l’utilisateur de spécifier le chemin correct --waldir en tant qu’option, afin que le lien symbolique soit conservé après la construction ou la réinitialisation de la réplique. Cette option n’est prise en charge qu’à partir de la version v10.
Vous pouvez spécifier les paramètres de basebackup soit sous forme de carte (paires clé-valeur), soit sous forme de liste d’éléments, chacun pouvant être une paire clé-valeur ou une clé unique (pour les options qui ne prennent aucune valeur, par exemple, --verbose). Considérez ces deux exemples :
et
Si toutes les méthodes de création de réplique échouent, Patroni tentera à nouveau toutes les méthodes dans l’ordre lors du cycle suivant de la boucle d’événements.
7 - Modes de réplication
Patroni utilise la réplication en streaming de PostgreSQL. Pour en savoir plus sur la réplication en streaming, consultez la documentation Postgres . Par défaut, Patroni configure PostgreSQL pour une réplication asynchrone. Le choix de votre schéma de réplication dépend de vos considérations métier. Étudiez à la fois la réplication asynchrone et synchrone, ainsi que d’autres solutions de haute disponibilité, afin de déterminer la solution la mieux adaptée à votre situation.
Durabilité en mode asynchrone
En mode asynchrone, le cluster peut perdre certaines transactions validées afin d’assurer la disponibilité. En cas de défaillance du serveur primaire ou de sa mise hors ligne pour toute autre raison, Patroni promeut automatiquement un serveur secondaire suffisamment sain en serveur primaire. Toutes les transactions non répliquées vers ce serveur secondaire restent sur une « timeline dérivée » sur le serveur primaire, et sont effectivement irrécupérables1.
Le nombre de transactions pouvant être perdues est contrôlé par le paramètre maximum_lag_on_failover. Étant donné que la position du journal de transactions du serveur primaire n’est pas échantillonnée en temps réel, en pratique, la quantité de données perdue en cas de basculement est bornée au pire cas par maximum_lag_on_failover octets de journal de transactions, plus la quantité écrite durant les dernières ttl secondes (loop_wait/2 secondes en cas moyen). Toutefois, le retard typique de réplication en régime stable est bien inférieur à une seconde.
Par défaut, lors de l’élection du leader, Patroni ne tient pas compte de la timeline actuelle des répliques, ce qui peut entraîner un comportement indésirable dans certains cas. Vous pouvez empêcher qu’un nœud dont la timeline diffère de celle d’un ancien primaire ne devienne le nouveau leader en modifiant la valeur du paramètre check_timeline en true.
Réplication synchrone PostgreSQL
Vous pouvez utiliser la réplication synchrone de Postgres synchronous replication avec Patroni. La réplication synchrone garantit la cohérence au sein d’un cluster en confirmant que les écritures sont écrites sur une instance secondaire avant de renvoyer une réponse de succès au client connecté. Le coût de la réplication synchrone : une latence accrue et un débit réduit en écriture. Ce débit dépend entièrement de la performance du réseau.
Dans les environnements de datacenter hébergés (comme AWS, Rackspace ou tout réseau que vous ne contrôlez pas), la réplication synchrone augmente sensiblement la variabilité des performances d’écriture. Si les followers deviennent inaccessibles depuis le leader, ce dernier devient effectivement en lecture seule.
Pour activer un test de réplication synchrone simple, ajoutez les lignes suivantes à la section parameters de vos fichiers de configuration YAML :
Lors de l’utilisation de la réplication synchrone PostgreSQL, utilisez au moins trois nœuds de données Postgres afin de garantir la disponibilité des écritures en cas de défaillance d’un hôte.
L’utilisation de la réplication synchrone PostgreSQL ne garantit pas l’absence totale de transactions perdues en toutes circonstances. Si le primaire et le secondaire servant actuellement de réplica synchrone tombent en panne simultanément, un troisième nœud ne contenant peut-être pas toutes les transactions sera promu.
mode synchrone
Pour les cas d’utilisation où la perte de transactions validées n’est pas acceptable, vous pouvez activer le mode synchrone de Patroni via synchronous_mode . Lorsque synchronous_mode est activé, Patroni ne promeut pas un serveur de secours à moins d’être certain que ce dernier contient toutes les transactions qui ont pu retourner un statut de validation réussie au client2. Cela signifie que le système peut être indisponible en écriture même si certains serveurs sont disponibles. Les administrateurs système peuvent toutefois utiliser des commandes de basculement manuel pour promouvoir un serveur de secours, même si cela entraîne une perte de transactions.
Activer le mode synchrone synchronous_mode ne garantit pas la durabilité des commits sur plusieurs nœuds dans toutes les circonstances. Lorsqu’aucun réplica approprié n’est disponible, le serveur primaire accepte toutefois les écritures, sans garantir leur réplication. Si le serveur primaire tombe en panne en ce mode, aucun réplica ne sera promu. Lorsque l’hôte qui était auparavant le primaire revient, il sera automatiquement promu, sauf si un basculement manuel a été effectué par l’administrateur système. Ce comportement rend le mode synchrone utilisable avec des clusters à deux nœuds.
Lorsque synchronous_mode
est activé et qu’un réplica tombe en panne, les validations bloquent jusqu’à l’itération suivante de Patroni, qui bascule le principal en mode autonome (retard maximal pour les écritures ttl secondes, cas moyen loop_wait/2 secondes). Une fermeture manuelle ou une redémarrage d’un réplica ne provoque pas d’interruption du service de validation. Le réplica signale au principal de se libérer de ses fonctions de réplica synchrone avant le démarrage de l’arrêt de PostgreSQL.
Lorsqu’il est absolument nécessaire de garantir que chaque écriture est stockée de manière durable sur au moins deux nœuds, activez synchronous_mode_strict en plus du mode synchronous_mode
. Ce paramètre empêche Patroni de désactiver la réplication synchrone sur le nœud primaire lorsque aucun candidat de réplique synchrone n’est disponible, à moins que la transaction PostgreSQL ne désactive explicitement synchronous_commit, bloquant ainsi toutes les demandes d’écriture clients jusqu’à ce qu’au moins une réplique synchrone soit disponible.
Lorsque synchronous_mode_strict est activé et qu’aucune connexion de réplication active ne satisfait le facteur de réplication minimal, Patroni détermine la valeur de synchronous_standby_names comme suit :
Les derniers nœuds synchrones connus sont disponibles dans la clé
/syncdu DCS : Patroni définit ou conservesynchronous_standby_namesavec les nœuds qui y sont enregistrés. Par exemple, si/synccontientleader=node1, sync_standby=node2,node3et que les deux réplicas cessent leur réplication, Patroni continuera d’utiliser :Ces nœuds sont les derniers connus pour avoir reçu le dernier commit. Les commits seront bloqués jusqu’à ce qu’au moins l’un d’entre eux se reconnecte.
Basculement manuel vers un nœud asynchrone : lorsqu’un nœud qui n’était pas dans la clé
/syncest promu, par exemple viapatronictl failover --force, il définitsynchronous_standby_namessur l’ancien nœud primaire, car l’ancien nœud primaire est le seul nœud garanti pour avoir les données validées les plus récentes.La clé
/syncest vide : par exemple, le mode strict vient d’être activé ou le cluster vient d’être initialisé sans réplique encore présente. Patroni définit :Il s’agit d’une valeur sentinelle intégrée qui ne correspond à aucun nom de nœud réel, ce qui fait bloquer toutes les écritures jusqu’à ce qu’une réplique admissible commence à diffuser depuis le primaire. Ce placeholder remplace l’ancienne option générique
*, qui pouvait inadvertamment permettre à un nœud non qualifié de satisfaire le critère de synchronisation.
[!AVERTISSEMENT]
La valeur
__patroni_strict_sync_replica_placeholder__est réservée par Patroni et ne doit pas être utilisée commenamed’un nœud Patroni danspatroni.yaml. Patroni refusera de démarrer si ce nom est configuré.
Lorsque le mode strict est activé, Patroni émet un avertissement dans les journaux : "No active replication connections and synchronous_mode_strict is requested. Commits will be delayed.". Cet avertissement est émis une seule fois par événement d’activation, et non à chaque itération de la boucle HA.
Vous pouvez garantir qu’un serveur de repli ne devienne jamais un serveur de repli synchrone en définissant l’option nosync sur true. Il est recommandé de le définir ainsi pour les serveurs de repli situés derrière des connexions réseau lentes, qui entraîneraient une dégradation des performances s’ils devenaient des serveurs de repli synchrone. Définir l’option nostream sur true aura également le même effet.
Le mode synchrone peut être activé ou désactivé à l’aide de la commande patronictl edit-config ou via l’interface REST de Patroni. Voir configuration dynamique
pour les instructions.
Note : En raison de la manière dont la réplication synchrone est implémentée dans PostgreSQL, il est encore possible de perdre des transactions même en utilisant synchronous_mode_strict. Si le backend PostgreSQL est annulé pendant l’attente de l’acquittement de la réplication (en raison d’une annulation de paquet due à un délai d’attente client ou à une panne du backend), les modifications de transaction deviennent visibles pour les autres backends. Ces modifications ne sont pas encore répliquées et peuvent être perdues en cas de promotion du standby.
Facteur de réplication synchrone
Le paramètre synchronous_node_count est utilisé par Patroni pour gérer le nombre de bases de données en mode synchrone. Il est défini par défaut à 1. Il n’a aucun effet lorsque synchronous_mode
est défini à off. Lorsqu’il est activé, Patroni gère précisément le nombre de bases de données en mode synchrone en fonction du paramètre synchronous_node_count et ajuste l’état dans le DCS et synchronous_standby_names dans PostgreSQL au moment où les membres rejoignent ou quittent le cluster. Si ce paramètre est défini à une valeur supérieure au nombre de nœuds éligibles, Patroni le réduit automatiquement.
Lag maximal sur nœud synchrone
Par défaut, Patroni reste sur les nœuds déclarés comme synchronous, selon la vue pg_stat_replication, même lorsque d’autres nœuds sont en avance. Cela permet de minimiser le nombre de changements de synchronous_standby_names. Pour modifier ce comportement, on peut utiliser le paramètre maximum_lag_on_syncnode. Il détermine jusqu’à quel retard une réplique peut être considérée comme « synchrone ».
Patroni utilise le LSN maximal de la réplique si plusieurs relais sont présents, sinon il utilise le LSN actuel du WAL du leader. La valeur par défaut est -1, et Patroni ne prendra aucune mesure pour échanger une réplique synchrone défaillante lorsque cette valeur est définie à 0 ou inférieure. Veuillez définir cette valeur suffisamment élevée afin que Patroni n’échange pas fréquemment les répliques synchrones pendant des pics de volume de transactions.
Implémentation du mode synchrone
Lorsque le mode synchrone est activé, Patroni maintient l’état de synchronisation dans le DCS (/sync key), qui contient la base primaire la plus récente et les bases de données en veille synchrone actuelles. Cet état est mis à jour selon des contraintes d’ordre strict afin d’assurer les invariants suivants :
- Un nœud doit être marqué comme leader le plus récent chaque fois qu’il peut accepter des transactions d’écriture. Un plantage de Patroni ou une fermeture incorrecte de PostgreSQL peut entraîner une violation de cet invariant.
- Un nœud doit être configuré comme réplica synchrone dans PostgreSQL aussi longtemps qu’il est publié comme réplica synchrone dans la clé
/syncdu DCS. - Un nœud qui n’est ni leader ni réplica synchrone actuel n’est pas autorisé à se promouvoir automatiquement.
Patroni n’attribuera qu’un ou plusieurs nœuds de secours synchrone en fonction du paramètre synchronous_node_count à synchronous_standby_names.
À chaque itération de la boucle HA, Patroni réévalue le choix des nœuds de secours synchrones. Si la liste actuelle de nœuds de secours synchrones est connectée et n’a pas demandé à être retirée de son statut synchrone, elle reste sélectionnée. Sinon, les membres du cluster disponibles pour la synchronisation les plus avancés dans la réplication sont sélectionnés.
Exemple :
Clé /config dans DCS
Clé /sync dans le DCS
postgresql.conf
Dans les exemples ci-dessus, seuls les nœuds node1 et node2 sont connus comme synchrones et autorisés à être promus automatiquement en cas de défaillance du primaire (node0).
Mode de validation Quorum
À partir de PostgreSQL v10, Patroni prend en charge la réplication synchrone basée sur le quorum.
En ce mode, Patroni maintient l’état de synchronisation dans le DCS, qui contient le dernier primary connu, le nombre de nœuds requis pour atteindre la majorité, et les nœuds actuellement éligibles à voter pour la majorité. En état stable, les nœuds votant pour la majorité sont le leader et tous les réplicas synchrones. Cet état est mis à jour selon des contraintes d’ordre strict, concernant la promotion des nœuds et synchronous_standby_names, afin de garantir qu’à tout moment, tout sous-ensemble de votants pouvant atteindre la majorité inclut au moins un nœud ayant effectué le dernier commit réussi.
À chaque itération de la boucle HA, Patroni réévalue les choix de réplicas synchrones et le quorum, en fonction de la disponibilité des nœuds et de la configuration demandée du cluster. Dans les versions de PostgreSQL supérieures à 9.6, tous les nœuds éligibles sont ajoutés en tant que réplicas synchrones dès que leur réplication rattrape le leader.
La validation en quorum permet de réduire les latences dans le cas le plus défavorable, même en fonctionnement normal, car une latence plus élevée de réplication vers un serveur de secours peut être compensée par les autres serveurs de secours.
Le mode synchrone basé sur le quorum peut être activé en définissant synchronous_mode
sur quorum à l’aide de la commande patronictl edit-config ou via l’interface REST de Patroni. Voir configuration dynamique
pour les instructions.
D’autres paramètres, tels que synchronous_node_count, maximum_lag_on_syncnode et synchronous_mode_strict, fonctionnent de la même manière qu’avec synchronous_mode=on.
En mode validation par quorum avec synchronous_mode_strict, lorsque aucune réplique active n’est disponible, Patroni définit synchronous_standby_names à ANY N (<last known voters>), en conservant les derniers électeurs du quorum connus à partir de /sync, ou à ANY 1 (__patroni_strict_sync_replica_placeholder__) lorsque aucun électeur n’est stocké dans la clé /sync.
Exemple :
Clé /config dans DCS
Clé /sync dans le DCS
postgresql.conf
Si le nœud primaire (node0) échoue, dans l’exemple ci-dessus, deux des nœuds node1, node2, node3 auront reçu la dernière transaction, mais nous ne savons pas lesquels. Pour déterminer si le nœud node1 a reçu la dernière transaction, il faut comparer son LSN avec celui d’au moins un nœud (quorum=1 dans la clé /sync) parmi node2 et node3. Si node1 n’est pas en retard par rapport à au moins l’un d’entre eux, on peut garantir qu’il n’y aura pas de perte de données visible pour l’utilisateur si node1 est promu.
Les données sont toujours présentes, mais leur récupération nécessite une intervention manuelle de la part d’un spécialiste de la récupération de données. Lorsque Patroni est autorisé à effectuer un rewind avec
use_pg_rewind, la timeline forkée est automatiquement supprimée afin de rejoindre le primaire défaillant dans le cluster. Toutefois, pour queuse_pg_rewindfonctionne correctement, soit le cluster doit être initialisé avecdata page checksums(--data-checksumsoption pourinitdb), soitwal_log_hintsdoit être défini suron. ↩︎Les clients peuvent modifier le comportement au niveau de chaque transaction à l’aide du paramètre
synchronous_commitde PostgreSQL. Les transactions dont la valeur desynchronous_commitestoffoulocalpeuvent être perdues en cas de basculement, mais ne seront pas bloquées par les retards de réplication. ↩︎
8 - cluster de secours
Patroni prend également en charge l’exécution d’une réplication en cascade vers un centre de données distant (région) à l’aide d’une fonctionnalité appelée « stand-by cluster ». Ce type de cluster présente les caractéristiques suivantes :
- « leader en veille », qui se comporte presque comme un leader de cluster régulier, à ceci près qu’il effectue la réplication à partir d’un nœud distant.
- répliques en cascade, qui effectuent la réplication à partir d’un leader en veille.
Le leader de secours détient et met à jour un verrou de leader dans le DCS. Si le verrou de leader expire, les répliques en cascade effectueront une élection afin de choisir un autre leader parmi les serveurs de secours.
Il n’existe aucune relation supplémentaire entre le cluster de secours et le cluster primaire dont il effectue la réplication, en particulier, ils ne doivent pas partager la même portée DCS s’ils utilisent le même DCS. Ils ne se connaissent mutuellement que par les informations de réplication. En outre, le cluster de secours n’est pas affiché dans la sortie de patronictl_list ou de patronictl_topology sur le cluster primaire.
Pour des raisons de flexibilité, vous pouvez spécifier les méthodes de création d’une réplique et de récupération des enregistrements WAL lorsque le cluster est en mode « standby » en indiquant la clé create_replica_methods
dans la section standby_cluster
. Cette configuration diffère de la création de répliques lorsque le cluster est détaché et fonctionne comme un cluster normal, qui est contrôlée par create_replica_methods dans la section postgresql. Les deux clés « standby » et « normal » font référence à la section create_replica_methods dans postgresql.
Pour configurer un tel cluster, vous devez spécifier la section standby_cluster dans la configuration Patroni :
Notez que ces options ne seront appliquées qu’une seule fois lors de l’amorçage du cluster, et que la seule manière de les modifier par la suite passe par le DCS.
Patroni s’attend à trouver postgresql.conf ou postgresql.conf.backup dans PGDATA du serveur primaire distant et ne démarrera pas si ces fichiers ne sont pas présents après une basebackup. Si le serveur primaire distant conserve postgresql.conf ailleurs, il vous incombe de le copier dans PGDATA.
Si vous utilisez des slots de réplication sur le cluster de secours, vous devez également créer le slot de réplication correspondant sur le cluster primaire. Ce dernier ne sera pas créé automatiquement par l’implémentation du cluster de secours. Vous pouvez utiliser la fonctionnalité des slots de réplication permanents de Patroni sur le cluster primaire afin de maintenir un slot de réplication portant le même nom que primary_slot_name, ou sa valeur par défaut si primary_slot_name n’est pas fourni.
En cas où le site distant ne fournit pas un seul point d’accès connecté au primaire, il est possible de lister tous les hôtes du cluster source dans la section standby_cluster.host. Lorsque standby_cluster.host contient plusieurs hôtes séparés par des virgules, Patroni effectuera :
- ajoutez
target_session_attrs=read-writeauprimary_conninfosur le nœud leader de secours. - utilisez
target_session_attrs=read-writepour déterminer si vous devez exécuterpg_rewindou lors de l’exécution depg_rewindsur tous les nœuds du cluster de secours. - Il est important de noter que pour que
pg_rewindfonctionne correctement, soit le cluster doit être initialisé avecdata page checksums(--data-checksumsoption pourinitdb) et/ouwal_log_hintsdoit être défini suron. Sinon,pg_rewindne fonctionnera pas correctement.
Il est également possible de répliquer un cluster de secours à partir d’un autre cluster de secours ou d’un membre de secours du cluster primaire : pour cela, vous devez définir un seul hôte dans la section standby_cluster.host. Toutefois, vous devez prendre garde au fait que pg_rewind échouera à s’exécuter sur le cluster de secours dans ce cas.
[!AVERTISSEMENT]
Les noms de membre (le champ
namedans la configuration Patroni de chaque nœud) doivent être uniques dans l’ensemble du cluster primaire et de tous les clusters de secours connectés à celui-ci.Patroni définit
synchronous_standby_namessur le cluster primaire à l’aide des noms de membre, qui deviennent également lesapplication_namede chaque connexion de réplication danspg_stat_replication. Si un nœud d’un cluster de secours partage le même nom qu’un membre du cluster primaire, PostgreSQL détecte deux connexions ayant des valeursapplication_nameidentiques. Cette ambiguïté peut amener PostgreSQL à satisfaire la condition de réplication synchrone en utilisant la connexion du cluster de secours au lieu du membre du cluster primaire prévu, ce qui fait que PostgreSQL reconnaît prématurément les transactions comme étant validées de manière synchrone, alors qu’elles ne sont pas durables sur le bon nœud de secours.Il s’agit d’une défaillance silencieuse : la réplication continue sans aucune erreur signalée, mais le cluster fonctionne effectivement sans nœud de secours synchrone valide, ce qui constitue un risque potentiel de perte de données en cas de défaillance du cluster primaire.
9 - Prise en charge du watchdog
L’exécution de plusieurs serveurs PostgreSQL en tant que primaires peut entraîner la perte de transactions en raison de lignes temporelles divergentes. Ce cas est également appelé problème de split-brain. Pour éviter le split-brain, Patroni doit s’assurer que PostgreSQL n’accepte aucune validation de transaction après l’expiration de la clé leader dans le DCS. Dans des conditions normales, Patroni tente d’atteindre cet objectif en arrêtant PostgreSQL lorsque la mise à jour du verrou leader échoue pour quelque raison que ce soit. Toutefois, cette action peut échouer pour diverses raisons :
- Patroni a planté à cause d’un bug, d’une condition de mémoire insuffisante ou par une suppression accidentelle par un administrateur système.
- L’arrêt de PostgreSQL est trop lent.
- Patroni ne parvient pas à s’exécuter en raison d’une charge élevée sur le système, de la mise en pause de la machine virtuelle par l’hyperviseur ou d’autres problèmes d’infrastructure.
Pour garantir un comportement correct dans ces conditions, Patroni prend en charge les périphériques watchdog. Les périphériques watchdog sont des mécanismes logiciels ou matériels qui redémarreront l’ensemble du système en cas de non réception d’un signal de cœur (keepalive) dans un délai spécifié. Cela ajoute une couche supplémentaire de sécurité en cas d’échec des mécanismes habituels de protection contre les scénarios de split-brain de Patroni.
Patroni tentera d’activer le watchdog avant de promouvoir PostgreSQL en rôle primaire. Si l’activation du watchdog échoue et que le mode watchdog est required, le nœud refusera de devenir leader. Lorsqu’il décidera de participer à l’élection du leader, Patroni vérifiera également que la configuration du watchdog lui permettra de devenir leader. Après avoir rétrogradé PostgreSQL (par exemple en cas de basculement manuel), Patroni désactivera à nouveau le watchdog. Le watchdog sera également désactivé pendant que Patroni est en état de pause.
Par défaut, Patroni configure le watchdog pour expirer 5 secondes avant l’expiration du TTL. Avec la configuration par défaut de loop_wait=10 et ttl=30, cela laisse au moins 15 secondes (ttl - safety_margin - loop_wait) au cycle de haute disponibilité pour se terminer correctement avant que le système ne soit réinitialisé de force. Par défaut, l’accès au DCS est configuré pour expirer après 10 secondes. Cela signifie qu’en cas d’indisponibilité du DCS, par exemple en raison de problèmes réseau, Patroni et PostgreSQL disposent d’au moins 5 secondes (ttl - safety_margin - loop_wait - retry_timeout) pour atteindre un état où toutes les connexions clients sont terminées.
Marge de sécurité est la durée de temps que Patroni réserve entre la mise à jour de la clé leader et la transmission du keepalive du watchdog. Patroni tente d’envoyer un keepalive immédiatement après la confirmation de la mise à jour de la clé leader. Si le processus Patroni est suspendu pendant une durée prolongée exactement au moment opportun, le keepalive peut être retardé de plus de la marge de sécurité sans déclencher le watchdog. Cela crée une fenêtre de temps durant laquelle le watchdog ne se déclenchera pas avant l’expiration de la clé leader, invalidant ainsi la garantie. Pour s’assurer absolument que le watchdog se déclenchera dans toutes les circonstances, configurez le watchdog pour qu’il expire après la moitié de la durée TTL en définissant safety_margin à -1 afin de fixer le délai d’expiration du watchdog à ttl // 2. Si vous avez besoin de cette garantie, vous devriez probablement augmenter ttl et/ou réduire loop_wait et retry_timeout.
Les watchdogs ne sont actuellement pris en charge que via l’interface du périphérique watchdog Linux.
Configuration du watchdog logiciel sous Linux
La configuration par défaut de Patroni tentera d’utiliser /dev/watchdog sous Linux si celui-ci est accessible à Patroni. Pour la plupart des cas d’utilisation, l’utilisation du watchdog logiciel intégré au noyau Linux est suffisamment sécurisée.
Pour activer le watchdog logiciel, exécutez les commandes suivantes en tant qu’utilisateur root avant de démarrer Patroni :
Pour le test, il peut être utile de désactiver le redémarrage en ajoutant soft_noboot=1 à la ligne de commande de modprobe. Dans ce cas, le watchdog enregistrera simplement une ligne dans le tampon d’anneau du noyau, visible via dmesg.
Patroni enregistrera les informations relatives au watchdog lorsqu’il sera activé avec succès.
10 - Mode Pause/Reprise pour le cluster
Objectif
Dans certains cas, Patroni doit pouvoir se retirer temporairement de la gestion du cluster tout en conservant l’état du cluster dans le DCS. Les cas d’utilisation possibles concernent des activités inhabituelles sur le cluster, telles que les mises à jour majeures de version ou la récupération après corruption. Pendant ces opérations, les nœuds sont souvent démarrés et arrêtés pour des raisons inconnues de Patroni, certains nœuds pouvant même être temporairement promus, ce qui contrevient à l’hypothèse d’un seul nœud primaire en cours d’exécution. Par conséquent, Patroni doit pouvoir se « déconnecter » du cluster en cours, en implémentant une fonctionnalité équivalente au mode maintenance de Pacemaker.
Implémentation
Lorsque Patroni s’exécute en mode mis en pause, il ne modifie pas l’état de PostgreSQL, à l’exception des cas suivants :
Pour chaque nœud, la clé membre dans le DCS est mise à jour avec les informations actuelles concernant le cluster. Cela fait que Patroni exécute des requêtes en lecture seule sur un nœud membre si ce dernier est en cours d’exécution.
Pour le nœud Postgres primaire possédant le verrou de leader, Patroni met à jour le verrou. Si le nœud détenteur du verrou de leader cesse d’être le primaire (par exemple, s’il est démote manuellement), Patroni libère le verrou au lieu de promouvoir à nouveau le nœud.
Les redémarrages manuels non planifiés, les basculements ou basculements planifiés manuels non planifiés et les réinitialisations sont autorisés. Aucune action planifiée n’est autorisée. Le basculement planifié manuel n’est autorisé que si le nœud vers lequel effectuer le basculement est spécifié.
Si Patroni détecte des primaires en parallèle, il émet un avertissement, mais ne démote pas le primaire sans verrou de leader.
S’il n’y a pas de verrou de leader dans le cluster, le primaire en cours d’exécution acquiert le verrou. S’il existe plus d’un nœud primaire, le premier primaire à acquérir le verrou l’emporte. S’il n’y a aucun primaire du tout, Patroni ne tente pas de promouvoir une réplique. Une exception à cette règle existe : si le verrou de leader est absent parce que l’ancien primaire s’est lui-même démoté suite à une promotion manuelle, alors seul le nœud candidat mentionné dans la requête de promotion peut acquérir le verrou de leader. Lorsque le nouveau verrou de leader est accordé (c’est-à-dire après avoir promu manuellement une réplique), Patroni s’assure que les répliques qui étaient en streaming depuis l’ancien leader basculent vers le nouveau.
Lorsque Postgres est arrêté, Patroni ne tente pas de le redémarrer. Lorsque Patroni est arrêté, il ne tente pas d’arrêter l’instance Postgres qu’il gère.
Patroni n’essaiera pas de supprimer les slots de réplication qui ne représentent pas un autre membre du cluster ou qui ne sont pas listés dans la configuration des slots permanents.
Guide utilisateur
patronictl prend en charge les commandes pause et resume .
On peut également émettre une requête PATCH vers la clé {namespace}/{cluster}/config avec {"pause": true/false/null}
11 - Mode de secours DCS
Le problème
Patroni s’appuie fortement sur le magasin de configuration distribué (DCS) pour résoudre les élections de leader et détecter les partitions réseau. Un nœud ne peut exécuter PostgreSQL en tant que primaire que s’il parvient à mettre à jour le verrou de leader dans le DCS. En cas d’échec de mise à jour du verrou de leader, PostgreSQL est immédiatement rétrogradé et lancé en lecture seule. Selon le DCS utilisé, les chances de rencontrer ce problème varient. Par exemple, avec etcd, utilisé exclusivement par Patroni, les chances sont quasi nulles, tandis qu’avec l’API Kubernetes (appuyée sur etcd), ce problème peut être observé plus fréquemment.
Motifs de l’implémentation actuelle
L’échec de mise à jour du verrou leader peut être dû à deux causes principales :
- Partitionnement réseau
- Le DCS est hors service
En général, il est impossible de distinguer ces deux cas à partir d’un seul nœud, et Patroni suppose donc le pire des cas – une partition du réseau. En cas de partition réseau, d’autres nœuds du cluster Patroni peuvent réussir à acquérir le verrou de leader et promouvoir PostgreSQL en primaire. Afin d’éviter une situation de split-brain, l’ancien primaire est rétrogradé avant l’expiration du verrou de leader.
Mode de secours DCS
Nous introduisons une option spéciale, failsafe_mode. Elle ne peut être activée que par la configuration dynamique
globale stockée dans la clé DCS /config. Si le mode de secours est activé et que la mise à jour du verrou de leader dans le DCS échoue pour une raison autre qu’une discordance de version, de valeur ou d’index, PostgreSQL peut continuer à fonctionner comme primaire s’il peut joindre tous les membres connus du cluster via l’API REST de Patroni.
Détails d’implémentation au niveau bas
- Nous introduisons une nouvelle clé permanente dans le DCS, nommée
/failsafe. - La clé
/failsafecontient tous les membres connus du cluster Patroni donné à un instant donné. - Le leader actuel maintient la clé
/failsafe. - Un membre n’est autorisé à participer à la course au leader et à devenir le nouveau leader que s’il est présent dans la clé
/failsafe. - Si le cluster se compose d’un seul nœud, la clé
/failsafecontiendra un seul membre. - En cas de « panne » du DCS, le primaire existant se connecte à tous les membres présentés dans la clé
/failsafevia l’API RESTPOST /failsafeet peut continuer à fonctionner en tant que primaire si toutes les répliques l’ont reconnu. - Si l’un des membres ne répond pas, le primaire est rétrogradé.
- Les répliques utilisent les requêtes entrantes de l’API REST
POST /failsafecomme indicateur que le primaire est toujours actif. Cette information est mise en cache pendantttlsecondes.
F.A.Q.
- Pourquoi le nœud primaire actuel doit-il voir TOUS les autres membres ? Ne pouvons-nous pas compter sur le quorum à cet effet ?
C’est une excellente question ! Le problème réside dans le fait que la vue sur le quorum peut différer selon le point de vue du DCS et de Patroni. Alors que les nœuds DCS doivent être répartis de manière égale entre les zones de disponibilité, aucune règle similaire n’existe pour Patroni, et surtout, aucun mécanisme n’existe pour introduire et imposer une telle règle. Si la majorité des nœuds Patroni se retrouve dans la partie perdante du réseau partitionné (y compris le primaire), alors le primaire doit être rétrogradé. Seule la vérification de TOUS les autres membres permet de détecter une telle situation.
- Que se passe-t-il si un nœud/pod est terminé pendant que le DCS est hors ligne ?
Si le DCS n’est pas accessible, la vérification « tous les autres membres du cluster sont-ils accessibles ? » est exécutée à chaque cycle de la boucle de battement (toutes les loop_wait secondes). Si le pod/nœud est arrêté, la vérification échoue et PostgreSQL sera démote en mode lecture seule, sans pouvoir se rétablir tant que le DCS n’est pas rétabli.
- Que se passe-t-il si tous les membres du cluster Patroni sont perdus pendant que le DCS est hors ligne ?
Patroni peut être configuré pour créer une nouvelle réplique à partir d’une sauvegarde même lorsque le cluster ne dispose pas de leader. Toutefois, si le nouvel membre n’est pas présent dans la clé /failsafe, il ne pourra pas acquérir le verrou de leader ni se promouvoir.
- Que se passe-t-il si le nœud primaire perd l’accès au DCS tandis que les répliques n’en sont pas affectées ?
Le primaire exécutera le code de secours et contactera toutes les répliques connues. Ces répliques utiliseront ces informations comme indicateur que le primaire est actif et ne démarreront pas la course au leader, même si le verrou de leader dans le DCS a expiré.
Comment activer le mode de secours ?
Avant d’activer
failsafe_mode, assurez-vous que tous les membres utilisent une version à jour de Patroni. Vous pouvez ensuite employer soit l’API RESTPATCH /config, soit patronictl edit-config -s failsafe_mode=true .
12 - Utilisation de Patroni avec Kubernetes
Patroni peut utiliser des objets Kubernetes afin de stocker l’état du cluster et gérer la clé du leader. Cela lui permet de fonctionner avec PostgreSQL dans un environnement Kubernetes sans nécessiter de magasin de cohérence, c’est-à-dire qu’il n’est pas nécessaire de déployer un Étcd supplémentaire. Patroni peut utiliser deux types d’objets Kubernetes pour stocker la clé du leader et les clés de configuration, configurés via les variables d’environnement kubernetes.use_endpoints ou PATRONI_KUBERNETES_USE_ENDPOINTS.
Utiliser les points de terminaison
Bien que ce soit le mode recommandé, il est désactivé par défaut pour des raisons de compatibilité. Lorsqu’il est activé, Patroni stocke la configuration du cluster et la clé du leader dans les champs metadata: annotations du Endpoints correspondant qu’il crée. Le changement de leader est plus sûr qu’avec ConfigMaps, car les annotations contenant les informations sur le leader ainsi que les adresses réelles pointant vers le pod leader en cours d’exécution sont mises à jour simultanément en une seule opération.
Utiliser les ConfigMaps
En ce mode, Patroni crée des ConfigMaps au lieu des Endpoints et stocke les clés dans les métadonnées de ces ConfigMaps. Le changement de leader nécessite au moins deux mises à jour : une pour le ConfigMap du leader, et une autre pour l’Endpoint correspondant.
Pour rediriger le trafic vers le leader PostgreSQL, vous devez configurer le service Kubernetes PostgreSQL afin d’utiliser un sélecteur d’étiquettes avec role_label (configuré dans la configuration Patroni).
Notez qu’il existe, dans certains cas — par exemple lors de l’exécution sur OpenShift — aucune alternative à l’utilisation des ConfigMaps.
Configuration
Les paramètres Patroni Kubernetes settings et les variables d’environnement environment variables sont décrits dans les chapitres généraux de la documentation.
Personnaliser l’étiquette de rôle
Par défaut, Patroni affecte des étiquettes correspondantes au pod dans lequel il s’exécute, en fonction du rôle du nœud, telles que role=primary. La clé et la valeur de l’étiquette peuvent être personnalisées à l’aide de kubernetes.role_label, kubernetes.leader_label_value, kubernetes.follower_label_value et kubernetes.standby_leader_label_value.
Remarque : si vous migrez des étiquettes de rôle par défaut vers des étiquettes personnalisées, vous pouvez réduire la durée d’indisponibilité en suivant les étapes de migration :
- Ajoutez une étiquette temporaire en utilisant la valeur d’origine du rôle pour le pod avec
kubernetes.tmp_role_label(commetmp_role). Une fois les pods redémarrés, les étiquettes suivantes seront définies par Patroni :
- Une fois tous les pods mis à jour, modifiez le sélecteur de service pour qu’il sélectionne l’étiquette temporaire.
- Ajoutez votre étiquette de rôle personnalisée (par exemple, définissez
kubernetes.leader_label_value=primary). Une fois les pods redémarrés, ils recevront les nouvelles étiquettes suivantes définies par Patroni :
- Une fois que tous les pods ont été mis à jour, modifiez le sélecteur de service pour utiliser la nouvelle valeur de rôle.
- Enfin, supprimez l’étiquette temporaire de votre configuration et mettez à jour tous les pods.
Exemples
- Le dossier kubernetes du dépôt Patroni contient des exemples d’image Docker et du manifeste Kubernetes permettant de tester la configuration Patroni sous Kubernetes. Notez qu’en l’état actuel, il ne sera pas possible d’utiliser des PersistentVolumes en raison de problèmes de permissions.
- Vous trouverez l’image Docker complète, capable d’utiliser des PersistentVolumes, dans le projet Spilo .
- Il existe également un Helm chart permettant de déployer l’image Spilo configurée avec Patroni en exécution sous Kubernetes.
- Pour exécuter vos clusters de bases de données à grande échelle avec Patroni et Spilo, consultez le projet postgres-operator . Il implémente le modèle d’opérateur pour gérer les clusters Spilo.
13 - Prise en charge Citus
Patroni permet de déployer très facilement des clusters Multi-Node Citus .
TL;DR
Il n’existe que quelques règles simples à suivre :
- Extension Citus pour PostgreSQL doit être disponible sur tous les nœuds. La version minimale prise en charge est 10.0, mais pour bénéficier pleinement des basculements planifiés transparents et des redémarrages des workers, nous recommandons d’utiliser au moins la version Citus 11.2.
- Le nom du cluster (
scope) doit être identique sur tous les nœuds Citus ! - Les identifiants de superutilisateur doivent être identiques sur le nœud coordinateur et sur tous les nœuds workers, et
pg_hba.confdoit autoriser l’accès en tant que superutilisateur entre tous les nœuds. - API REST doit être accessible depuis les nœuds workers vers le coordinateur. Par exemple, les identifiants doivent être identiques, et si configurés, les certificats clients émis par les nœuds workers doivent être acceptés par le coordinateur.
- Ajoutez la section suivante au
patroni.yaml:
Ensuite, il vous suffit de démarrer Patroni, qui s’occupera du reste :
- Patroni définira
bootstrap.dcs.synchronous_modesur quorum s’il n’est pas explicitement défini sur une autre valeur. - citus
sera automatiquement ajouté à
shared_preload_libraries. - Si
max_prepared_transactionsn’est pas explicitement défini dans la configuration globale dynamic , Patroni le définira automatiquement sur2*max_connections. - La valeur du GUC
citus.local_hostnamesera ajustée delocalhostà la valeur utilisée par Patroni pour se connecter à l’instance locale PostgreSQL. Cette valeur peut parfois différer delocalhostcar PostgreSQL pourrait ne pas écouter sur ce port. - Le
citus.databasesera automatiquement créé, suivi deCREATE EXTENSION citus. - Les identifiants
actuels du superutilisateur seront ajoutés à la table
pg_dist_authinfopour permettre la communication entre les nœuds. N’oubliez pas de les mettre à jour si vous modifiez ensuite le nom d’utilisateur, le mot de passe, le certificat SSL ou la clé SSL du superutilisateur ! - Le nœud primaire du coordinateur découvrira automatiquement les nœuds primaires workers et les ajoutera à la table
pg_dist_nodeau moyen de la fonctioncitus_add_node(). - Patroni maintiendra également
pg_dist_nodelors des basculements automatiques ou planifiés des clusters coordinateur ou workers.
patronictl
Les clusters coordinateur et workers sont des clusters PostgreSQL physiquement distincts, regroupés logiquement à l’aide de l’extension de base de données Citus pour PostgreSQL. Par conséquent, dans la plupart des cas, il n’est pas possible de les gérer comme une entité unique.
Cela entraîne deux différences majeures dans le comportement de patronictl
lorsque patroni.yaml contient la section citus
par rapport à l’usage habituel :
- Le
listet letopologyaffichent par défaut tous les membres de la formation Citus (coordonnateurs et workers). La nouvelle colonneGroupindique à quel groupe Citus ils appartiennent. - Pour toutes les commandes patronictl
, une nouvelle option est introduite, nommée
--group. Pour certaines commandes, la valeur par défaut du groupe peut être extraite dupatroni.yaml. Par exemple, patronictl_pause activera le mode maintenance par défaut pour legroupdéfini dans la section citus , mais par exemple pour patronictl_basculement_planifié ou patronictl_remove le groupe doit être spécifié explicitement.
Exemple de sortie de patronictl list pour le cluster Citus :
postgres@coord1:~$ patronictl list demo + Cluster Citus : demo ———-+—————-+———+—-+————-+—–+————+—–+ | Groupe | Membre | Hôte | Rôle | État | TL | Réception LSN | Décalage | Relecture LSN | Décalage | +——–+———+————-+—————-+———+—-+—————+———-+—————+———-+ | 0 | coord1 | 172.27.0.10 | Réplique | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord2 | 172.27.0.6 | Standby Quorum | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord3 | 172.27.0.4 | Leader | en cours | 1 | | | | | | 1 | work1-1 | 172.27.0.8 | Standby Quorum | en cours | 1 | 0/31D3198 | 0 | 0/31D3198 | 0 | | 1 | work1-2 | 172.27.0.2 | Leader | en cours | 1 | | | | | | 2 | work2-1 | 172.27.0.5 | Standby Quorum | en cours | 1 | 0/31CDFC0 | 0 | 0/31CDFC0 | 0 | | 2 | work2-2 | 172.27.0.7 | Leader | en cours | 1 | | | | | +——–+———+————-+—————-+———+—-+—————+———-+—————+———-+
Si nous ajoutons l’option --group, la sortie sera modifiée comme suit :
postgres@coord1:~$ patronictl list demo –group 0 + Cluster Citus : demo (groupe : 0, 7179854923829112860) -+————-+—–+————+—–+ | Membre | Hôte | Rôle | État | TL | LSN de réception | Retard | LSN de lecture | Retard | +——–+————-+—————-+———+—-+——————+——–+—————-+——–+ | coord1 | 172.27.0.10 | Réplique | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | coord2 | 172.27.0.6 | Standby quorum | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | coord3 | 172.27.0.4 | Leader | en cours | 1 | | | | | +——–+————-+—————-+———+—-+——————+——–+—————-+——–+
postgres@coord1:~$ patronictl list demo –group 1 + Cluster Citus : demo (groupe : 1, 7179854923881963547) -+————-+—–+————+—–+ | Membre | Hôte | Rôle | État | TL | Réception LSN | Décalage | Relecture LSN | Décalage | +———+————+—————-+———+—-+————-+—–+————+—–+ | work1-1 | 172.27.0.8 | Standby Quorum | running | 1 | 0/31D3198 | 0 | 0/31D3198 | 0 | | work1-2 | 172.27.0.2 | Leader | running | 1 | | | | | +———+————+—————-+———+—-+————-+—–+————+—–+
Basculement planifié worker Citus
Lorsqu’un basculement planifié est orchestré pour un nœud worker Citus, Citus permet de rendre ce basculement quasi transparent pour une application. Étant donné qu’une application se connecte au coordinateur, qui à son tour se connecte aux nœuds workers, il est possible avec Citus de mettre en pause le trafic SQL sur le coordinateur pour les shards hébergés sur un nœud worker. Le basculement s’effectue alors tout en maintenant le trafic sur le coordinateur, puis reprend dès qu’un nouveau nœud worker primaire est prêt à accepter les requêtes en lecture-écriture.
Exemple de patronictl_switchover sur le cluster worker :
postgres@coord1:~$ patronictl switchover demo + Cluster Citus : demo ———-+—————-+———+—-+————-+—–+————+—–+ | Groupe | Membre | Hôte | Rôle | État | TL | LSN de réception | Retard | LSN de relecture | Retard | +——–+———+————-+—————-+———+—-+——————+——-+——————+——-+ | 0 | coord1 | 172.27.0.10 | Réplique | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord2 | 172.27.0.6 | Standby quorum | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord3 | 172.27.0.4 | Primaire | en cours | 1 | | | | | | 1 | work1-1 | 172.27.0.8 | Primaire | en cours | 1 | | | | | | 1 | work1-2 | 172.27.0.2 | Standby quorum | en cours | 1 | 0/31D3198 | 0 | 0/31D3198 | 0 | | 2 | work2-1 | 172.27.0.5 | Standby quorum | en cours | 1 | 0/31CDFC0 | 0 | 0/31CDFC0 | 0 | | 2 | work2-2 | 172.27.0.7 | Primaire | en cours | 1 | | | | | +——–+———+————-+—————-+———+—-+——————+——-+——————+——-+ Groupe Citus : 2 Primaire [work2-2] : Candidat [‘work2-1’] [] : À quelle heure le basculement planifié doit-il avoir lieu (par exemple 2024-08-26T08:02) [maintenant] : Topologie actuelle du cluster + Cluster Citus : demo (groupe : 2, 7179854924063375386) -+————-+—–+————+—–+ | Membre | Hôte | Rôle | État | TL | Réception LSN | Délai | Relecture LSN | Délai | +———+————+—————-+———+—-+————-+—–+————+—–+ | work2-1 | 172.27.0.5 | Standby Quorum | running | 1 | 0/31CDFC0 | 0 | 0/31CDFC0 | 0 | | work2-2 | 172.27.0.7 | Primaire | running | 1 | | | | | +———+————+—————-+———+—-+————-+—–+————+—–+ Êtes-vous sûr de vouloir effectuer un basculement planifié du cluster demo, en rétrogradant le primaire actuel work2-2 ? [o/N] : o 2024-08-26 07:02:40.33003 Basculé avec succès vers “work2-1” + Cluster Citus : demo (groupe : 2, 7179854924063375386) ——–+———+————+———+ | Membre | Hôte | Rôle | État | TL | Réception LSN | Délai | Relecture LSN | Délai | +———+————+———+———+—-+————-+———+————+———+ | work2-1 | 172.27.0.5 | Leader | running | 1 | | | | | | work2-2 | 172.27.0.7 | Réplique | arrêté | | inconnu | inconnu | inconnu | inconnu | +———+————+———+———+—-+————-+———+————+———+
postgres@coord1:~$ patronictl list demo + Cluster Citus : demo ———-+—————-+———+—-+————-+—–+————+—–+ | Groupe | Membre | Hôte | Rôle | État | TL | Réception LSN | Décalage | Relecture LSN | Décalage | +——–+———+————-+—————-+———+—-+—————+———-+—————+———-+ | 0 | coord1 | 172.27.0.10 | Réplique | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord2 | 172.27.0.6 | Standby Quorum | en cours | 1 | 0/41C0368 | 0 | 0/41C0368 | 0 | | 0 | coord3 | 172.27.0.4 | Leader | en cours | 1 | | | | | | 1 | work1-1 | 172.27.0.8 | Leader | en cours | 1 | | | | | | 1 | work1-2 | 172.27.0.2 | Standby Quorum | en cours | 1 | 0/31D3198 | 0 | 0/31D3198 | 0 | | 2 | work2-1 | 172.27.0.5 | Leader | en cours | 2 | | | | | | 2 | work2-2 | 172.27.0.7 | Standby Quorum | en cours | 2 | 0/31CDFC0 | 0 | 0/31CDFC0 | 0 | +——–+———+————-+—————-+———+—-+—————+———-+—————+———-+
Et voici à quoi cela ressemble du côté du coordinateur :
# The worker primary notifies the coordinator that it is going to execute "pg_ctl stop".
2024-08-26 07:02:38,636 DEBUG: query(BEGIN, ())
2024-08-26 07:02:38,636 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (3, '172.19.0.7-demoted', 5432, 10000))
# From this moment all application traffic on the coordinator to the worker group 2 is paused.

# The old worker primary is assigned as a secondary.
2024-08-26 07:02:40,084 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (7, '172.19.0.7', 5432, 10000))

# The future worker primary notifies the coordinator that it acquired the leader lock in DCS and about to run "pg_ctl promote".
2024-08-26 07:02:40,085 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (3, '172.19.0.5', 5432, 10000))

# The new worker primary just finished promote and notifies coordinator that it is ready to accept read-write traffic.
2024-08-26 07:02:41,485 DEBUG: query(COMMIT, ())
# From this moment the application traffic on the coordinator to the worker group 2 is unblocked.
Nœuds secondaires
À compter de Patroni v4.0.0, les nœuds secondaires Citus sans balise noloadbalance tag
sont également inscrits dans pg_dist_node. Toutefois, pour utiliser les nœuds secondaires aux requêtes en lecture seule, les applications doivent modifier la variable GUC citus.use_secondary_nodes
.
Découverte du DCS
Le cluster Citus (coordinateur et workers) est stocké dans le DCS sous la forme d’une flotte de clusters Patroni logiquement regroupés :
/service/batman/              # scope=batman
/service/batman/0/            # citus.group=0, coordinator
/service/batman/0/initialize
/service/batman/0/leader
/service/batman/0/members/
/service/batman/0/members/m1
/service/batman/0/members/m2
/service/batman/1/            # citus.group=1, worker
/service/batman/1/initialize
/service/batman/1/leader
/service/batman/1/members/
/service/batman/1/members/m3
/service/batman/1/members/m4
...
Une telle approche a été retenue car, pour la plupart des SDC, il devient possible de récupérer l’intégralité du cluster Citus en une seule requête de lecture récursive. Seuls les nœuds coordinateurs Citus lisent l’arborescence entière, car ils doivent découvrir les nœuds workers. Les nœuds workers lisent uniquement le sous-arbre correspondant à leur propre groupe, et dans certains cas, celui du groupe coordinateur.
Citus sur Kubernetes
Étant donné que Kubernetes ne prend pas en charge les structures hiérarchiques, nous avons dû inclure le groupe citus à tous les objets K8s créés par Patroni :
batman-0-leader  # la carte de configuration du leader pour le coordinateur
batman-0-config  # la carte de configuration contenant les clés initialize, config et history
...
batman-1-leader  # la carte de configuration du leader pour le groupe de workers 1
batman-1-config
...
Autrement dit, le modèle de nommage est : ${scope}-${citus.group}-${type}.
Tous les objets Kubernetes sont découverts par Patroni à l’aide du sélecteur d’étiquettes label selector , les Pods exécutant Patroni&Citus ainsi que les Endpoints/ConfigMaps doivent donc posséder des étiquettes similaires, et Patroni doit être configuré pour les utiliser à l’aide des paramètres Kubernetes settings ou des variables d’environnement <kubernetes_environment>.
Quelques exemples de configuration Patroni utilisant les variables d’environnement des Pods :
- pour le cluster coordinateur
- pour le cluster worker du groupe 2
Comme vous l’avez peut-être remarqué, les deux exemples définissent le libellé citus-group. Celui-ci permet à Patroni d’identifier l’appartenance d’un objet à un groupe Citus donné. La variable d’environnement PATRONI_CITUS_GROUP porte la même valeur que ce libellé. Lorsque Patroni crée de nouveaux objets Kubernetes, ConfigMaps ou Endpoints, il leur ajoute automatiquement le libellé citus-group: ${env.PATRONI_CITUS_GROUP} :
Vous trouverez un exemple complet de déploiement Patroni sur Kubernetes avec prise en charge de Citus dans le dossier kubernetes du dépôt Patroni.
Il existe deux fichiers importants pour vous :
- Dockerfile.citus
- citus_k8s.yaml
Mises à jour Citus et mises à jour majeures PostgreSQL
Tout d’abord, veuillez consulter la procédure de mise à jour de la version Citus dans la documentation
. Une modification mineure est à noter dans le processus. Lors de l’exécution de la mise à jour, vous devez utiliser patronictl_restart
au lieu de systemctl restart pour redémarrer PostgreSQL.
La mise à niveau majeure de PostgreSQL avec Citus est un peu plus complexe. Vous devrez combiner les techniques décrites dans la documentation Citus concernant les mises à niveau majeures et la documentation Patroni concernant PostgreSQL major upgrade<major_upgrade>. Veillez à garder à l’esprit qu’un cluster Citus est composé de nombreux clusters Patroni (coordinateurs et workers), qui doivent tous être mis à niveau de manière indépendante.
14 - Convertir un nœud autonome en cluster Patroni
Cette section décrit le processus de conversion d’une instance PostgreSQL autonome en cluster Patroni.
Pour déployer un cluster Patroni sans utiliser d’instance PostgreSQL préexistante, consultez plutôt Exécution et configuration .
Procédure
Vous trouverez ci-dessous un aperçu des étapes permettant de convertir un cluster Postgres existant en cluster géré par Patroni. Dans ces étapes, nous supposons que tous les nœuds faisant partie du cluster existant sont actuellement en fonctionnement, et que vous ne prévoyez pas de modifier la configuration de Postgres pendant la migration. Les étapes :
Créez les utilisateurs Postgres comme indiqué dans la section authentification de la configuration Patroni. Vous trouverez des exemples de commandes SQL pour créer les utilisateurs dans le bloc de code ci-dessous, dans lequel vous devez remplacer les noms d’utilisateur et les mots de passe selon votre environnement. Si vous avez déjà les utilisateurs correspondants, vous pouvez ignorer cette étape.
Effectuez les étapes suivantes sur tous les nœuds Postgres. Effectuez toutes les étapes sur un nœud avant de passer au nœud suivant. Commencez par le nœud primaire, puis passez à chaque nœud de secours :
- Si vous exécutez Postgres via systemd, désactivez l’unité systemd de Postgres. Patroni gère le démarrage et l’arrêt du démon Postgres, il est donc nécessaire de désactiver cette unité.
- Créez un fichier de configuration YAML pour Patroni. Vous pouvez utiliser l’outil de génération et de validation de la configuration Patroni
à cette fin.
- Note (spécifique au nœud primaire) : Si vous utilisez des fentes de réplication pour la réplication entre les membres du cluster, il est recommandé d’activer
use_slotset de configurer les fentes de réplication existantes comme permanentes via l’élément de configurationslots. Prenez garde au fait que Patroni crée automatiquement des fentes de réplication pour la réplication entre les membres, et supprime les fentes qu’il ne reconnaît pas, lorsqueuse_slotsest activé. L’idée d’utiliser des fentes permanentes consiste à permettre à vos fentes existantes de persister pendant la migration vers Patroni. Consultez Paramètres de configuration dynamique pour plus de détails.
- Note (spécifique au nœud primaire) : Si vous utilisez des fentes de réplication pour la réplication entre les membres du cluster, il est recommandé d’activer
- Démarrez Patroni à l’aide de l’unité de service systemd
patroni. Elle détecte automatiquement que Postgres est déjà en cours d’exécution et commence à surveiller l’instance.
Transférez la procédure de démarrage de Postgres à Patroni. Pour cela, vous devez redémarrer les membres du cluster à l’aide de la commande patronictl restart cluster-name member-name . Pour une interruption minimale, vous pouvez souhaiter diviser cette étape en :
- Redémarrage immédiat des nœuds de secours.
- Redémarrage planifié du nœud primaire au sein d’une fenêtre de maintenance.
Si vous avez configuré des slots permanents à l’étape
1.2., vous devez les supprimer de la configurationslotsà l’aide de la commande patronictl edit-config cluster-name une fois que lerestart_lsndes slots créés par Patroni est en mesure de rattraper lerestart_lsndes slots originaux pour les membres correspondants. En supprimant les slots de la configurationslots, vous permettez à Patroni de supprimer les slots originaux de votre cluster une fois qu’ils ne sont plus nécessaires. Vous trouverez ci-dessous une requête d’exemple pour vérifier lerestart_lsnde quelques slots, afin de les comparer :
Mise à jour majeure de la version PostgreSQL
La seule méthode possible pour effectuer une mise à niveau majeure actuellement est :
- Arrêtez Patroni
- Mettez à jour les binaires PostgreSQL et exécutez pg_upgrade sur le nœud primaire
- Mettez à jour patroni.yml
- Supprimez la clé d’initialisation du DCS ou effacez l’état complet du cluster depuis le DCS. La deuxième option peut être réalisée en exécutant patronictl remove cluster-name . Cela est nécessaire car pg_upgrade exécute initdb, qui crée effectivement une nouvelle base de données avec un nouvel identifiant système PostgreSQL.
- Si vous avez effacé l’état du cluster à l’étape précédente, vous pouvez souhaiter copier patroni.dynamic.json depuis le répertoire de données ancien vers le nouveau. Cela vous aidera à conserver certains paramètres PostgreSQL que vous aviez définis auparavant.
- Démarrez Patroni sur le nœud primaire.
- Mettez à jour les binaires PostgreSQL, mettez à jour patroni.yml et effacez le répertoire de données sur les nœuds secondaires.
- Démarrez Patroni sur les nœuds secondaires et attendez la fin de la réplication.
L’exécution de pg_upgrade sur des nœuds en veille n’est pas prise en charge par PostgreSQL. Si vous savez ce que vous faites, vous pouvez essayer la procédure rsync décrite dans https://www.postgresql.org/docs/current/pgupgrade.html au lieu de supprimer le répertoire data_dir sur les nœuds en veille. La méthode la plus sûre reste toutefois de laisser Patroni effectuer la réplication des données pour vous.
FAQ
- Lors du démarrage de Patroni, Patroni signale qu’il ne peut pas se lier au port PostgreSQL.
Vous devez vérifier listen_addresses et port dans postgresql.conf et postgresql.listen dans patroni.yml. N’oubliez pas que pg_hba.conf doit autoriser un tel accès.
- Après avoir demandé à Patroni de redémarrer le nœud, PostgreSQL affiche le message d’erreur
could not open configuration file "/etc/postgresql/10/main/pg_hba.conf": No such file or directory
Cela peut signifier différentes choses selon la manière dont vous gérez la configuration de PostgreSQL. Si vous avez spécifié postgresql.config_dir, Patroni génère le pg_hba.conf à partir des paramètres de la section amorçage
uniquement lorsqu’il amorce un nouveau cluster. Dans ce scénario, le PGDATA n’était pas vide, par conséquent, aucun amorçage n’a eu lieu. Ce fichier doit exister au préalable.
15 - Intégration avec d'autres outils
Patroni est capable d’intégrer d’autres outils de votre infrastructure. Dans cette section, vous trouverez une liste d’exemples, qui, bien qu’elle ne soit pas exhaustive, peut vous inspirer sur les façons dont Patroni peut s’intégrer à d’autres outils.
Barman
Patroni fournit une application nommée patroni_barman qui intègre la logique de communication avec pg-backup-api, vous permettant ainsi d’effectuer des opérations Barman à distance.
Cette application possède actuellement plusieurs sous-commandes : recover et config-switch.
patroni_barman recover
Le sous-commande recover peut être utilisé comme méthode personnalisée d’amorçage ou de création de réplique. Vous trouverez plus d’informations à ce sujet dans replica_imaging_and_bootstrap
.
configuration du basculement de Patroni Barman
Le sous-commande config-switch est conçu pour être utilisé comme un rappel on_role_change dans Patroni. Par exemple, supposez que vous diffusez les WAL depuis votre serveur primaire actuel vers votre hôte Barman. En cas de basculement dans le cluster, vous souhaiterez peut-être commencer à diffuser les WAL depuis le nouveau serveur primaire. Vous pouvez réaliser cela en utilisant patroni_barman config-switch comme rappel on_role_change.
Ce sous-commande dépend de la commande barman config-switch, qui est chargée de remplacer la configuration d’un serveur Barman en appliquant un modèle prédéfini au-dessus de celle existante. Cette commande est disponible depuis Barman 3.10. Veuillez consulter la documentation Barman pour plus de détails.
Ceci est un exemple de la manière dont vous pouvez configurer Patroni pour appliquer un modèle de configuration si ce nœud Patroni est promu en primaire :
patroni_barman config-switch nécessite que Barman et pg-backup-api soient configurés sur l’hôte Barman, afin de pouvoir exécuter un barman config-switch distant via l’API de sauvegarde. Il requiert également que des modèles Barman préconfigurés soient appliqués. L’exemple ci-dessus utilise un sous-ensemble des paramètres disponibles. Vous pouvez obtenir davantage d’informations en exécutant patroni_barman config-switch --help et en consultant la documentation de Barman.
16 - Considérations de sécurité
Un cluster Patroni dispose de deux interfaces à protéger contre l’accès non autorisé : le stockage de configuration distribué (DCS) et l’API REST Patroni.
Protection du SCD
Patroni et patronictl stockent et récupèrent des données auprès du DCS.
Bien que le DCS ne contienne aucune information sensible, il permet de modifier certaines configurations de Patroni/PostgreSQL. Par conséquent, la première mesure à prendre est de protéger le DCS lui-même.
Les détails de protection dépendent du type de DCS utilisé. Les paramètres d’authentification et de chiffrement (jouets/authentification basique/certificats clients) pris en charge pour les types de DCS sont décrits dans settings .
La recommandation générale consiste à activer TLS pour toutes les communications DCS.
Protection de l’API REST
Protéger l’API REST est une tâche plus complexe.
L’API REST de Patroni est utilisée par Patroni lui-même lors de la course au leader, par l’outil patronictl afin d’effectuer des basculements, des basculements planifiés, des réinitialisations, des redémarrages ou des rechargements, par HAProxy ou tout autre équilibreur de charge pour effectuer des vérifications de santé HTTP, et bien sûr également pour la surveillance.
Du point de vue de la sécurité, l’API REST contient des points d’accès sécurisés (GET, uniquement des requêtes de récupération d’informations) et des points d’accès non sécurisés (PUT, POST, PATCH et DELETE, qui modifient l’état des nœuds).
Les points d’accès non sécurisés peuvent être protégés par une authentification HTTP basique en définissant les paramètres restapi.authentication.username et restapi.authentication.password. Il n’existe aucun moyen de protéger les points d’accès sécurisés sans activer le TLS.
Lorsque le TLS pour l’API REST est activé et qu’une PKI est configurée, l’authentification mutuelle entre le serveur API et le client API est possible pour tous les points d’accès.
Les paramètres de la section restapi permettent l’authentification client TLS auprès du serveur. Selon la valeur du paramètre verify_client, le serveur API exige une vérification réussie du certificat client pour les appels d’API sécurisés et non sécurisés (verify_client: required), uniquement pour les appels d’API non sécurisés (verify_client: optional), ou pour aucun appel d’API (verify_client: none).
Les paramètres de la section ctl permettent l’authentification TLS du serveur auprès du client (l’outil patronictl
, qui utilise la même configuration que Patroni). Définissez insecure: true pour désactiver la vérification du certificat serveur par le client. Consultez settings
pour une description détaillée des paramètres TLS client.
Protéger la base de données PostgreSQL contre l’accès non autorisé est hors du champ de ce document et est traité dans https://www.postgresql.org/docs/current/client-authentication.html
17 - Haute disponibilité multi-centre de données
La haute disponibilité d’un cluster PostgreSQL déployé dans plusieurs centres de données repose sur la réplication, qui peut être synchrone ou asynchrone (voir modes de réplication ).
Dans les deux cas, il est important de bien comprendre les concepts suivants :
- PostgreSQL peut fonctionner en tant que leader primaire ou en mode standby uniquement lorsqu’il détient la clé de leadership et peut mettre à jour cette clé.
- Vous devez exécuter un nombre impair de nœuds etcd, ZooKeeper ou Consul : 3 ou 5 !
Réplication synchrone
Pour disposer d’un cluster multi-DC pouvant tolérer automatiquement la perte d’une zone, un minimum de 3 est requis.
Le diagramme d’architecture serait le suivant :
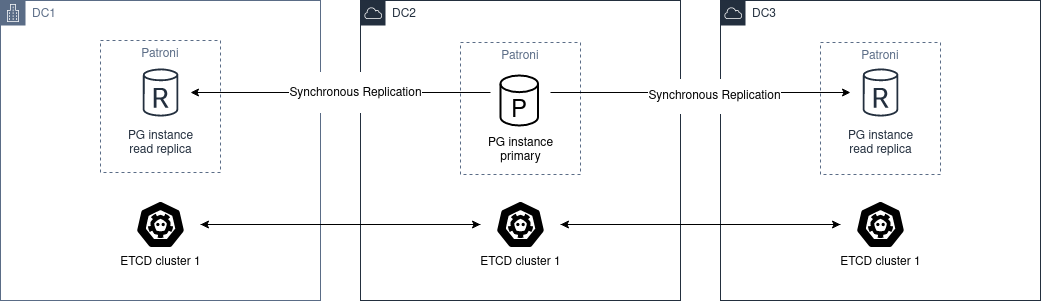
Nous devons déployer un cluster d’etcd, de ZooKeeper ou de Consul à travers les différents DC, avec un minimum de 3 nœuds, un dans chaque zone.
En ce qui concerne PostgreSQL, vous devez déployer au moins 2 nœuds, situés dans des centres de données différents. Ensuite, vous devez définir synchronous_mode: true dans la configuration dynamique globale .
Cela active la réplication synchrone et le nœud primaire choisira l’un des nœuds comme synchrone.
Réplication asynchrone
Avec seulement deux centres de données, il est préférable de disposer de deux clusters etcd indépendants et d’exécuter un cluster de secours Patroni standby cluster dans le second centre de données. Si le premier site tombe en panne, vous pouvez PROMOUVOIR MANUELLEMENT le cluster de secours .
Le diagramme d’architecture serait le suivant :
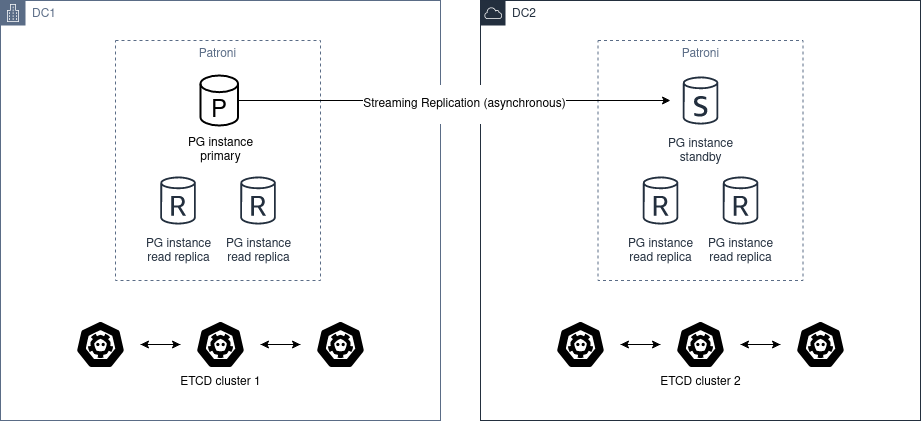
La promotion automatique n’est pas possible, car DC2 ne pourra jamais déterminer l’état de DC1.
Vous devez éviter d’utiliser pg_ctl promote dans ce scénario ; vous devez promouvoir manuellement le cluster sain en supprimant la section standby_cluster
du configuration dynamique
.
[!AVERTISSEMENT]
Si le cluster source est toujours en cours d’exécution et que vous promouvez le cluster de secours, vous créez une situation de split-brain.
En cas de souhait de revenir à l’état « initial », il n’existe que deux moyens de le résoudre :
- Rétablissez la section standby_cluster ; cela déclenchera
pg_rewind. Pour quepg_rewindfonctionne correctement, le cluster doit avoir été initialisé avecdata page checksums(option--data-checksumsdeinitdb) et/ouwal_log_hintsdoit être défini suron. D’autres facteurs peuvent toutefois encore faire échouerpg_rewind. - Reconstruisez entièrement le cluster standby.
Avant de promouvoir le cluster de secours, il faut manuellement s’assurer que le cluster source est arrêté (STONITH). Lorsque DC1 reprend, le cluster doit être converti en cluster de secours.
Avant de procéder, vous pouvez examiner manuellement la base de données et extraire toutes les modifications survenues entre l’instant où la communication réseau entre DC1 et DC2 a cessé de fonctionner et l’instant où vous avez arrêté manuellement le cluster sur DC1.
Une fois extrait, vous pouvez également appliquer manuellement ces modifications au cluster dans DC2.
18 - FAQ
Dans cette section, vous trouverez les réponses aux questions les plus fréquemment posées concernant Patroni. Chaque sous-section s’efforce de se concentrer sur des types de questions différents.
Nous espérons que cela vous aidera à clarifier la majeure partie de vos questions. Si vous avez encore des interrogations ou rencontrez un problème imprévu, veuillez vous référer à chatting et reporting_bugs pour obtenir des instructions sur la manière de demander de l’aide ou de signaler des anomalies.
Comparaison avec d’autres solutions de haute disponibilité
Pourquoi Patroni nécessite-t-il un cluster séparé de nœuds DCS alors que d’autres solutions comme repmgr n’en ont pas besoin ?
Il existe différentes manières de mettre en œuvre des solutions de haute disponibilité, chacune présentant ses avantages et inconvénients.
Logiciels tels que repmgr effectuent la communication entre les nœuds afin de déterminer le moment où des actions doivent être entreprises.
Patroni, en revanche, dépend de l’état stocké dans le DCS. Le DCS agit comme source de vérité pour Patroni afin de déterminer ses actions.
Bien qu’un cluster DCS séparé puisse alourdir votre architecture, cette approche réduit également les risques de survenance de scénarios de split-brain dans votre cluster Postgres.
Quelle est la différence entre Patroni et d’autres solutions de haute disponibilité en ce qui concerne la gestion de Postgres ? Patroni ne gère pas seulement la haute disponibilité du cluster Postgres, mais gère également Postgres lui-même.
Si les nœuds Postgres n’existent pas encore, Patroni s’occupe du démarrage du nœud primaire et du nœud de secours, ainsi que de la gestion de la configuration Postgres des nœuds. Si les nœuds Postgres existent déjà, Patroni reprendra la gestion du cluster.
En complément de ce qui précède, Patroni possède également des capacités d’autoréparation. Autrement dit, si un nœud primaire échoue, Patroni ne se contente pas de basculer vers une réplique, mais tente également de se reconnecter au nœud primaire précédent en tant que réplique du nouveau nœud primaire. De même, si une réplique échoue, Patroni tente de se reconnecter à cette réplique.
C’est pourquoi nous appelons Patroni un « modèle pour les solutions de haute disponibilité ». Il va au-delà de la simple gestion de la réplication physique : il gère PostgreSQL dans son ensemble.
DCS
Puis-je utiliser le même cluster etcd pour stocker les données de deux ou plusieurs clusters Patroni ?
Oui, vous le pouvez !
Les informations relatives à un cluster Patroni sont stockées dans le DCS sous un chemin préfixé par les paramètres Patroni namespace et scope.
Tant que vous n’avez pas de conflit d’espace de noms et de portée entre différents clusters Patroni, vous pouvez utiliser le même cluster DCS pour stocker les informations de plusieurs clusters Patroni.
Que se passe-t-il si j’essaie d’utiliser la même combinaison de namespace et scope pour différents clusters Patroni qui pointent vers le même cluster DCS ?
Le second cluster Patroni qui tente d’utiliser la même combinaison de namespace et scope ne pourra pas gérer PostgreSQL, car il trouvera des informations relatives à cette même combinaison dans le DCS, mais avec un identifiant système PostgreSQL incompatible. Ce désaccord sur l’identifiant système fait que Patroni interrompt la gestion du second cluster, car il suppose qu’il s’agit d’un autre cluster et que l’utilisateur a mal configuré Patroni.
Veillez à utiliser des valeurs différentes pour namespace / scope lorsque vous gérez plusieurs clusters Patroni partageant le même cluster DCS.
Que se passe-t-il si je perds mon cluster DCS ? Le DCS est utilisé pour stocker essentiellement l’état et la configuration dynamique du cluster Patroni.
Le premier effet est que tous les clusters Patroni qui dépendent de ce DCS passeront en mode lecture seule — sauf si dcs_failsafe_mode est activé.
Que dois-je faire si je perds mon cluster DCS ? Il existe trois résultats possibles en cas de perte de votre cluster DCS :
- Le cluster DCS est entièrement récupéré : aucune action n’est requise côté Patroni. Une fois le cluster DCS récupéré, Patroni devrait pouvoir se rétablir également ;
- Le cluster DCS est recréé sur place, et les points d’accès restent identiques. Aucun changement n’est nécessaire côté Patroni ;
- Un nouveau cluster DCS est créé avec des points d’accès différents. Vous devrez mettre à jour les points d’accès DCS dans la configuration Patroni de chaque nœud Patroni.
Si vous rencontrez le scénario 2. ou 3., Patroni s’occupera de recréer les informations d’état en fonction de l’état actuel du cluster, puis de régénérer la configuration dynamique sur le DCS à partir d’un fichier de sauvegarde nommé patroni.dynamic.json stocké dans le répertoire de données PostgreSQL de chaque membre du cluster Patroni.
Que se passe-t-il si je perds la majorité dans mon cluster DCS ? Le DCS deviendra inactif, ce qui entraînera la désactivation du nœud Postgres actuellement en lecture/écriture par Patroni.
Attention : Patroni s’appuie sur l’état du DCS pour effectuer des actions sur le cluster.
Vous pouvez utiliser le paramètre dcs_failsafe_mode pour atténuer cette situation.
patronictl
Dois-je exécuter patronictl sur l’hôte Patroni ? Non, il n’est pas nécessaire de le faire.
Exécuter patronictl
sur l’hôte Patroni est pratique si vous avez accès à l’hôte Patroni, car vous pouvez utiliser le même fichier de configuration provenant de l’patroniagent pour l’application patronictl
.
Toutefois, patronictl est essentiellement un client et peut être exécuté depuis des machines distantes. Il suffit de lui fournir une configuration suffisante pour qu’il puisse accéder au DCS et à l’API REST des membres Patroni.
Pourquoi l’information provenant d’un de mes membres Patroni a-t-elle disparu de la sortie de la commande patronictl_list ? Les informations affichées par la commande patronictl_list sont basées sur le contenu du DCS.
Si des informations relatives à un membre disparaissent du DCS, il est très probable que l’agent Patroni sur ce nœud ne s’exécute plus, ou qu’il ne parvient pas à communiquer avec le DCS.
Comme le membre n’est pas en mesure de mettre à jour les informations, celles-ci expirent finalement dans le DCS, et le membre n’est plus affiché dans la sortie de patronictl_list .
Pourquoi l’information relative à l’un de mes membres Patroni n’est-elle pas à jour dans la sortie de la commande patronictl_list ? Les informations affichées par la commande patronictl_list sont basées sur le contenu du DCS.
Par défaut, ces informations sont mises à jour par Patroni environ toutes loop_wait secondes. Autrement dit, même si tout fonctionne normalement, vous pouvez encore observer un « délai » allant jusqu’à loop_wait secondes dans les informations stockées dans le DCS.
Attention, cela n’est pas une règle. Certaines opérations effectuées par Patroni entraînent une mise à jour immédiate des informations dans le DCS.
Configuration
Quelle est la différence entre la configuration dynamique et la configuration locale ? La configuration dynamique (ou configuration globale) est la configuration stockée dans le DCS, et qui est appliquée à tous les membres du cluster Patroni. C’est principalement là que vous devez stocker votre configuration.
Les paramètres spécifiques à un nœud, ou les paramètres que vous souhaitez remplacer par rapport à la configuration globale, doivent être définis uniquement sur le membre Patroni souhaité en tant que configuration locale. Cette configuration locale peut être spécifiée soit via le fichier de configuration, soit via des variables d’environnement.
Voir plus dans config .
Quels sont les types de configuration dans Patroni, et quel est leur ordre de priorité ? Les types sont :
- Configuration dynamique : appliquée à tous les membres ;
- Configuration locale : appliquée au membre local, remplace la configuration dynamique ;
- Configuration d’environnement : appliquée au membre local, remplace à la fois la configuration dynamique et la configuration locale.
Remarque : certains paramètres GUC de Postgres ne peuvent être définis que globalement, c’est-à-dire via une configuration dynamique. En outre, certains GUC sont imposés par Patroni avec une valeur codée en dur.
Voir plus dans config .
Existe-t-il une fonctionnalité pour m’aider à créer mon fichier de configuration Patroni ? Oui, il y en a une.
Vous pouvez utiliser les commandes patroni --generate-sample-config ou patroni --generate-config pour générer une configuration Patroni d’exemple ou une configuration Patroni basée sur une instance Postgres existante, respectivement.
Veuillez vous référer à generate_sample_config et generate_config pour plus de détails.
J’ai modifié mes paramètres dans la configuration bootstrap.dcs, mais Patroni n’applique pas les changements aux membres du cluster. Quel est le problème ?
Les valeurs configurées sous bootstrap.dcs ne sont utilisées que lors de l’amorçage d’un cluster frais. Ces valeurs sont écrites dans le DCS pendant l’amorçage.
Une fois la phase d’amorçage terminée, vous ne pourrez modifier la configuration dynamique que via le DCS.
Reportez-vous à la question suivante pour plus de détails.
Comment puis-je modifier ma configuration dynamique ? Vous devez modifier la configuration dans le DCS. Cela s’effectue soit en utilisant :
- patronictl_edit_config ; ou
- Une requête
PATCHvers config_endpoint .
Comment puis-je modifier ma configuration locale ?
Vous devez modifier le fichier de configuration du membre Patroni concerné, puis envoyer SIHGUP à l’agent Patroni. Vous pouvez utiliser l’une des deux méthodes suivantes :
Envoyez une requête
POSTà l’API REST reload_endpoint ; ouExécutez patronictl_reload ; ou
Signalez localement le processus Patroni avec
SIGHUP:- Si vous avez lancé Patroni via systemd, vous pouvez utiliser la commande
systemctl reload PATRONI_UNIT.service,PATRONI_UNITétant le nom du service Patroni ; ou - Si vous avez lancé Patroni par d’autres moyens, vous devrez identifier le processus
patroniet exécuterkill -s HUP PID,PIDétant l’identifiant du processuspatroni.
- Si vous avez lancé Patroni via systemd, vous pouvez utiliser la commande
Remarque : il existe des cas où un rechargement via la commande patronictl_reload peut échouer :
- Certificats API REST expirés : vous pouvez y remédier en utilisant l’option
-kde la commande patronictl ; - Identifiants incorrects : par exemple, lorsqu’on modifie les identifiants
restapiouctldans le fichier de configuration, puis qu’on utilise ce même fichier de configuration pour Patroni et patronictl .
Comment puis-je modifier ma configuration d’environnement ? La configuration d’environnement n’est lue par Patroni qu’au démarrage.
En gardant cela à l’esprit, si vous modifiez la configuration de l’environnement, vous devrez redémarrer l’agent Patroni correspondant.
Prenez garde à ne pas provoquer de basculement dans le cluster ! Vous pourriez être intéressé par la vérification de patronictl_pause .
Comment puis-je réduire les lignes de journalisation répétitives relatives au battement cardiaque pendant un fonctionnement normal ?
Si vos journaux sont trop bruyants en raison de lignes répétées telles que Lock owner: ... et no action. I am ..., configurez log.deduplicate_heartbeat_logs: true.
Vous pouvez le définir soit dans le fichier YAML de Patroni (log settings
), soit avec PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGS=true.
Gardez à l’esprit que cela réduit le volume de journalisation en supprimant les messages de battement de cœur répétés, mais vous perdez également la visibilité du battement de cœur par boucle, qui peut être utile lors du diagnostic du basculement.
Que se passe-t-il si je modifie une directive GUC de Postgres nécessitant un redémarrage ? Lorsque vous modifiez la configuration dynamique ou locale, comme expliqué dans les questions précédentes, Patroni s’occupe automatiquement du rechargement de la configuration de Postgres pour vous.
Que se passe-t-il si je modifie une directive GUC de Postgres nécessitant un redémarrage ?
Patroni marquera les membres concernés avec un indicateur pending restart.
Il vous appartient de déterminer quand et comment redémarrer les membres. Cela peut être réalisé soit par :
- patronictl_restart ; ou
- Une
POSTrequête à restart_endpoint .
Remarque : certains paramètres GUC de Postgres nécessitent une gestion particulière en ce qui concerne l’ordre de redémarrage des nœuds Postgres. Reportez-vous à shared_memory_gucs pour plus de détails.
Quelle est la différence entre etcd et etcd3 dans la configuration de Patroni ?
etcd utilise la version 2 de l’API de etcd, tandis que etcd3 utilise la version 3 de l’API de etcd.
Attention : les informations stockées par la version 2 de l’API ne sont pas gérables par la version 3, et inversement.
Nous vous recommandons de configurer etcd3 plutôt que etcd car :
- La version 2 de l’API est désactivée par défaut à partir de etcd v3.4 ;
- La version 2 de l’API sera entièrement supprimée à partir de etcd v3.6.
J’ai use_slots activé dans ma configuration Patroni, mais lorsque membre du cluster devient hors ligne pendant une certaine durée, le slot de réplication utilisé par ce membre est supprimé sur le nœud amont. Que puis-je faire pour éviter ce problème ?
Il existe deux options :
- Vous pouvez ajuster
member_slots_ttl(valeur par défaut30min, disponible depuis Patroni4.0.0et PostgreSQL 11) ; les slots de réplication pour les membres absents ne seront pas supprimés lorsque la durée d’indisponibilité du membre est inférieure au seuil configuré. - Vous pouvez configurer des slots de réplication physique permanents pour les membres.
Depuis Patroni 3.2.0, il est désormais possible de disposer de slots membres en tant que slots permanents gérés par Patroni.
Patroni créera les emplacements physiques permanents sur tous les nœuds et veillera à ne pas supprimer ces emplacements, tout en faisant avancer les LSN de ces emplacements sur tous les nœuds selon le LSN consommé par le membre.
Plus tard, si vous décidez de supprimer le membre correspondant, il vous incombe de modifier la configuration des emplacements permanents ; sinon, Patroni conservera ces emplacements indéfiniment.
Remarque : pour les versions de Patroni antérieures à 3.2.0, il était encore possible de configurer des slots membres en tant que slots physiques permanents, mais ceux-ci n’étaient gérés qu’en tant que leader actuel. En cas de basculement ou de basculement planifié, ces slots étaient recréés sur le nouveau leader, mais cela ne garantissait pas que celui-ci disposait de tous les segments WAL du nœud absent.
Remarque : même avec Patroni 3.2.0, une petite condition de course peut survenir. Au tout début, lorsque le slot est créé sur la réplique, celui-ci peut être en avance par rapport au même slot sur le leader, et si personne ne consomme ce slot, il reste une possibilité que certains fichiers manquent après un basculement. En tenant compte de cela, il est recommandé de configurer l’archivage continu, ce qui permet de restaurer les WAL nécessaires ou d’effectuer une récupération à un point précis dans le temps.
Quelle est la différence entre loop_wait, retry_timeout et ttl ?
Patroni effectue périodiquement ce que l’on appelle un cycle HA. À chaque cycle HA, il effectue une série de vérifications sur le cluster afin d’évaluer son état de santé, et en fonction de cet état, il peut entreprendre des actions, comme basculer vers un serveur secondaire.
loop_wait détermine pendant combien de secondes Patroni doit s’endormir avant d’exécuter un nouveau cycle de vérifications de haute disponibilité.
retry_timeout définit le délai d’attente des opérations de réessai sur le DCS et sur Postgres. Par exemple : si le DCS est inactif depuis plus de retry_timeout secondes, Patroni peut démoter le nœud primaire en tant qu’action de sécurité.
ttl définit la durée de validité du verrou leader dans le DCS. Si le leader actuel du cluster n’est pas en mesure de renouveler la durée de validité pendant ses cycles de haute disponibilité pendant plus de ttl, alors la durée de validité expirera, ce qui déclenchera une leader race dans le cluster.
Note : lors de la modification de ces paramètres, veuillez garder à l’esprit que Patroni impose la règle et les valeurs minimales décrites dans la section dynamic du document.
Gestion de Postgres
Puis-je modifier directement les paramètres GUC de Postgres dans la configuration de Postgres ? Vous le pouvez, mais vous devriez éviter de le faire.
La configuration de Postgres est gérée par Patroni, et toute tentative de modifier les fichiers de configuration peut être frustrée par Patroni, qui peut éventuellement les écraser.
Plusieurs options sont disponibles pour contourner la gestion effectuée par Patroni :
- Modifiez les paramètres GUC de Postgres via
$PGDATA/postgresql.base.conf; ou - Définissez un
postgresql.custom_confqui sera utilisé à la place depostgresql.base.confafin de le gérer de manière externe ; ou - Modifiez les paramètres GUC à l’aide de
ALTER SYSTEM/ALTER DATABASE/ALTER USER.
Vous trouverez davantage d’informations à ce sujet dans la section important_configuration_rules .
Dans tous les cas, nous vous recommandons de gérer toute la configuration de Postgres via Patroni. Cela centralise la gestion et facilite le débogage de Patroni lorsque cela est nécessaire.
Puis-je redémarrer directement les nœuds Postgres ? Non, vous ne devez pas tenter de gérer Postgres directement !
Toute tentative de redémarrer le serveur Postgres sans Patroni peut entraîner des basculements dans votre cluster.
Si vous devez gérer le serveur Postgres, procédez par les moyens exposés par Patroni.
Patroni peut-il reprendre la gestion d’un cluster PostgreSQL déjà existant ? Oui, il le peut !
Veuillez vous référer à existing_data pour obtenir des instructions détaillées.
Comment Patroni gère-t-il Postgres ?
Patroni s’occupe de démarrer et d’arrêter Postgres en exécutant les binaires Postgres, tels que pg_ctl et postgres.
En gardant cela à l’esprit, vous devez désactiver toute autre source pouvant gérer les clusters Postgres, comme les unités systemd, par exemple postgresql.service. Seul Patroni doit être en mesure de démarrer, d’arrêter et de promouvoir les instances Postgres dans le cluster. Ne pas le faire peut entraîner des scénarios de split-brain. Par exemple : si le nœud en cours d’exécution en tant que primaire échoue et que l’unité postgresql.service est activée, Postgres pourrait être redémarré et provoquer un split-brain.
Concepts et exigences
Quelles sont les applications qui font partie de Patroni ? Patroni comprend essentiellement quelques applications :
patroni: C’est l’agent Patroni, chargé de gérer un nœud Postgres ;- patronictl : Il s’agit d’un utilitaire en ligne de commande utilisé pour interagir avec un cluster Patroni (effectuer des basculements planifiés, redémarrages, modifications de configuration, etc.). Pour plus d’informations, consultez patronictl .
Qu’est-ce qu’un standby cluster dans Patroni ?
Il s’agit d’un cluster ne comportant aucun nœud Postgres primaire en cours d’exécution, c’est-à-dire qu’aucun membre en lecture-écriture n’est présent dans le cluster.
Ces types de clusters existent pour répliquer des données depuis un autre cluster et sont généralement utiles lorsque vous souhaitez répliquer des données entre des centres de données.
Il y aura un leader dans le cluster, qui sera un standby chargé de répliquer les modifications depuis un nœud Postgres distant. Ensuite, il y aura un ensemble de standbys configurés avec une réplication en cascade à partir de ce membre leader.
Remarque : le cluster de secours ne connaît rien sur le cluster source dont il effectue la réplication — il peut même utiliser restore_command au lieu du streaming WAL, et peut utiliser un cluster DCS absolument indépendant.
Pour plus de détails, consultez standby_cluster .
Qu’est-ce qu’un leader dans Patroni ?
Un leader dans Patroni est comme un coordinateur du cluster.
Dans un cluster Patroni classique, leader sera le nœud en lecture/écriture.
Dans un cluster de secours Patroni, le leader (appelé aussi standby leader) sera chargé de la réplication depuis un nœud Postgres distant, et de la propagation de ces modifications aux autres membres du cluster de secours.
Le cluster Patroni nécessite-t-il un nombre minimum de nœuds Postgres ? Non, vous pouvez exécuter Patroni avec un nombre quelconque de nœuds Postgres.
Attention : Patroni est déconnecté du DCS.
Que signifie pause dans Patroni ? Pause est une opération exposée par Patroni permettant à l’utilisateur de demander à Patroni de suspendre la gestion de Postgres.
Cela est principalement utile lorsque vous souhaitez effectuer une maintenance sur le cluster et souhaitez éviter que Patroni ne prenne de décisions liées à la haute disponibilité, comme basculer vers un serveur secondaire lorsque vous arrêtez le serveur primaire.
Vous trouverez davantage d’informations à ce sujet dans pause .
Basculement automatique
Comment fonctionne le mécanisme de basculement automatique de Patroni ?
Le basculement automatique de Patroni repose sur ce que nous appelons leader race.
Patroni stocke l’état du cluster dans le DCS, notamment un verrou leader qui contient le nom du membre Patroni qui est actuellement le leader du cluster.
Ce verrou leader est associé à une durée de vie. Si le nœud leader ne parvient pas à mettre à jour le bail du verrou leader à temps, la clé expirera finalement dans le DCS.
Lorsque le verrou leader expire, il déclenche ce que Patroni appelle un leader race : tous les nœuds commencent à effectuer des vérifications pour déterminer s’ils sont les meilleurs candidats à la prise en charge du rôle leader. Certaines de ces vérifications incluent des appels à l’API REST de tous les autres membres Patroni.
Tous les membres Patroni qui se trouvent être le meilleur candidat pour acquérir le verrou leader tenteront de le faire. Le premier membre Patroni qui parvient à acquérir le verrou leader se promeut en nœud en lecture/écriture (ou standby leader), et les autres sont configurés pour le suivre.
Puis-je désactiver temporairement le basculement automatique dans le cluster Patroni ? Oui, vous le pouvez !
Vous pouvez y parvenir en mettant temporairement le cluster en pause. Cela est généralement utile pour effectuer des opérations de maintenance.
Lorsque vous souhaitez reprendre le basculement automatique du cluster, il suffit de le désactiver.
Vous trouverez davantage d’informations à ce sujet dans pause .
Initialisation et création des serveurs de secours
Comment Patroni crée-t-il un nœud Postgres primaire ? Et un nœud en veille ?
Par défaut, Patroni utilise initdb pour amorcer un cluster frais, et pg_basebackup pour créer des nœuds en veille à partir d’une copie du membre leader.
Vous pouvez personnaliser ce comportement en écrivant vos propres méthodes d’amorçage et vos propres méthodes de création de réplique.
Les méthodes personnalisées sont généralement utiles lorsque vous souhaitez restaurer des sauvegardes créées par des outils de sauvegarde tels que pgBackRest ou Barman, par exemple.
Pour obtenir des informations détaillées, veuillez vous référer à custom_bootstrap et custom_replica_creation .
Surveillance
Comment puis-je surveiller mon cluster Patroni ? Patroni expose quelques points de terminaison pratiques dans son rest_api :
/metrics: expose les métriques de surveillance au format pouvant être consommé par Prometheus ;/patroni: expose l’état du cluster au format JSON. Les informations affichées ici sont très similaires à celles affichées par l’endpoint/metrics.
Vous pouvez utiliser ces points d’accès pour implémenter des vérifications de surveillance.
19 - Notes de version
Version 4.1.5
Libéré le 2026-08-12
Améliorations de compatibilité
- Compatibilité avec PostgreSQL 14.24, 15.19, 16.15, 17.11, 18.6 (Alexander Kukushkin)
Ajoutez le nouveau paramètre GUC output_plugin_libraries, qui restreint les plugins de décodage logique.
Améliorations
- Réinitialisations de connexion de l’API REST à
DEBUGau lieu deWARNING(Kyle McLaren)
Assurez-vous que les variantes courantes de « client est parti au milieu de l’écriture » sont désactivées sans affecter le traitement des erreurs réelles (non liées à la connexion).
Correctifs de bogues
- Correction de l’alignement de la validation (
thread_stack_size) (Sundong Kim)
Corrigez la valeur aligned de 65535 à 65536 dans l’entrée du schéma thread_stack_size. Précédemment, patroni --validate-config rejetait presque toutes les valeurs réalistes, y compris la valeur par défaut 524288 appliquée par le démon lui-même.
- Autoriser la validation de
synchronous_modepour accepter'quorum'et des chaînes booléennes (Eray Araz)
patroni --validate-config a précédemment rejeté les valeurs synchronous_mode telles que quorum et les chaînes booléennes au format PostgreSQL acceptées en temps d’exécution.
Version 4.1.4
Sorti le 2026-07-07
Correctifs de bogues
- Vérifiez la variable d’environnement
NOTIFY_SOCKETavant d’utiliser le paquetsystemd(Polina Bungina)
Tentez d’importer et d’utiliser le package uniquement lorsque la variable d’environnement NOTIFY_SOCKET est définie, afin d’éviter l’exception FileNotFoundError: [Errno 2] No such file or directory.
- Unifier la requête
pg_replication_slots(Polina Bungina)
Une gestion incorrecte des valeurs failover et synced entraînait des exceptions KeyError lors de la suppression des slots de réplication logique incorrects.
- Prendre en compte les paramètres d’authentification spécifiques à la version lors de la génération de la configuration (Polina Bungina)
Dans la commande patroni --generate-config, supprimez tous les paramètres d’authentification inapplicables qui ont été accidentellement récupérés à partir de l’environnement, en fonction de la version obtenue via une connexion PostgreSQL.
- Gérer
pg_rewindpendant le démarrage d’une instance PostgreSQL en réplica (Alexander Kukushkin)
Passez à l’information pg_controldata en cas de non-connexion à une instance PostgreSQL en cours d’exécution mais qui n’accepte pas encore les connexions.
- Corriger le type de métrique Prometheus pour
patroni_postgres_timeline(Huseyin Demir)
Déclarez la métrique patroni_postgres_timeline comme gauge au lieu de counter, car elle n’est pas toujours strictement croissante (par exemple, elle peut être réinitialisée à 0 si une instance PostgreSQL n’est pas en cours d’exécution).
- Ne pas arrêter le watchdog tant que les clients backend ne sont pas entièrement arrêtés (Alexander Kukushkin)
Précédemment, si primary_stop_timeout était plus court que le délai minimum du watchdog, et que le délai d’arrêt expirait effectivement, Patroni désactivait le watchdog avant que tous les backends clients n’aient terminé.
- Gérer l’erreur de délai d’attente de requête pour la requête de surveillance (Alexander Kukushkin)
En cas d’erreur de délai d’attente de requête, utilisez le rôle mis en cache comme sauvegarde afin d’éviter de rétrograder le primaire. En outre, définissez explicitement pg_stat_statements.track sur none pour la requête de surveillance, afin d’éviter des appels coûteux à la collecte des déchets pg_stat_statements.
- Supprimer les slots de réplication gérés par Patroni avec
wal_status=lost(Alexander Kukushkin)
Les slots de réplication avec wal_status=lost ne sont plus utilisables. Patroni supprimera désormais ces slots et les recréera si nécessaire.
- Corriger la représentation du rôle dans l’erreur de validation du membre patronictl (Polina Bungina)
Assure que la représentation chaîne correcte soit utilisée dans le message d’exception, empêchant les erreurs d’être formatées comme Error: No CtlPostgresqlRole.REPLICA among provided members.
Version 4.1.3
Sorti le 2026-05-05
Améliorations de stabilité
- Gérer correctement l’erreur etcd mal étiquetée (Ants Aasma)
Les versions actuelles d’etcd génèrent une erreur Unknown lorsque le leader etcd est perdu pendant la mise à jour de la durée de location. Patroni va désormais remplacer le code d’erreur signalé par Unavailable.
Correctifs de bogues
- Utilisez la version binaire lorsque le fichier
PG_VERSIONn’existe pas (Polina Bungina)
Dans certains cas, par exemple lors de l’utilisation d’un amorçage personnalisé, le fichier PG_VERSION peut ne pas être présent dans le répertoire de données. Dans ce cas, Patroni traitait la version comme 0.0, ce qui provoquait des problèmes avec certaines logiques spécifiques à la version. Avec cette correction, Patroni tentera d’obtenir la version à partir de la binaire dans de tels cas.
- Réorganisation de l’initialisation du logger pour éviter la perte des messages d’audit précoces (Alexander Kukushkin)
Créez PatroniLogger avant de charger Config afin de capturer les messages de journalisation précoces.
- Inclure
MONOTONIC_USECdans la notification systemdRELOADING=1(Alexander Kukushkin)
systemd 257+ exige MONOTONIC_USEC en conjonction avec RELOADING=1 pour les services Type=notify-reload. Sans cela, systemctl reload bloque indéfiniment.
Améliorations
- Passer la récupération après panne en mode utilisateur unique lorsque
backup_labelexiste (Vadim Ponomarev)
Passer outre la récupération après panne en mode utilisateur unique et laisser PostgreSQL gérer la récupération pendant le démarrage normal lors du lancement d’une réplique restaurée à partir d’une sauvegarde externe (non via une méthode d’amorçage personnalisée).
- Avertir lors de l’exécution sous
systemdsans le paquetpython-systemd(Alexander Kukushkin)
Au lieu d’enregistrer « systemd integration is not supported » au démarrage, vérifiez la présence de NOTIFY_SOCKET et n’émettez un avertissement que lorsque vous êtes effectivement en cours d’exécution sous systemd sans que le paquet python-systemd soit installé.
Version 4.1.2
Libéré le 2026-04-21
Améliorations du support systemd
- Ajouter la prise en charge du type d’unité systemd
notify-reload(Ronan Dunklau)
Permet à systemctl reload d’attendre que Patroni ait effectivement traité le rechargement de la configuration en envoyant les notifications RELOADING=1 et READY=1 à systemd.
- Envoyer une notification
STOPPING=1à systemd lors de l’arrêt (Alexander Kukushkin)
Patroni notifie désormais correctement systemd qu’il s’arrête, conformément au protocole de notification systemd.
- Ne pas permettre à PostgreSQL d’envoyer des notifications à systemd (Alexander Kukushkin)
Supprime NotifyAccess=all du fichier unit systemd d’exemple. Filtre NOTIFY_SOCKET dans l’environnement au démarrage de PostgreSQL afin qu’il n’envoie pas READY=1 ni STOPPING=1 à systemd. Lorsque vous prenez en charge un PostgreSQL déjà démarré avant Patroni et qui possède déjà NOTIFY_SOCKET, réappliquez READY=1 lors de l’arrêt de PostgreSQL pour contrer son STOPPING=1.
Version 4.1.1
Sorti le 2026-04-08
Améliorations de stabilité
- Compatibilité avec les modifications liées au thread dans Python 3.11+ (Alexander Kukushkin)
Évitez de démarrer ou d’arrêter des threads en cours d’exécution. Introduisez des pools de threads pour l’API REST et pour l’exécution des tâches asynchrones. Permettez la configuration globale de thread_pool_size et de restapi.thread_pool_size.
- Compatibilité avec Python 3.14 (Alexander Kukushkin)
Exécuter les tests contre Python 3.14 et corriger les problèmes de compatibilité.
- Compatibilité avec les correctifs de sécurité etcd dans les versions 3.6.9, 3.5.28 et 3.4.42 (Alexander Kukushkin)
Ces versions d’etcd ont corrigé des CVEs et modifié le comportement : les lectures de topologie du cluster et les keepalives de bail ne sont désormais plus autorisés sans authentification. Patroni gère désormais cette contrainte en s’authentifiant dans les chemins d’identification des membres et de maintien du bail, en se réauthentifiant en cas d’échec d’authentification, et en renvoyant les requêtes en conséquence.
- Améliorations de la gestion des erreurs Etcd3 (Alexander Kukushkin)
Gérer les réponses JSON corrompues, être souple dans l’analyse des erreurs JSON, et améliorer le rapport des erreurs internes d’etcd.
Correctifs de bogues
- Réessayer la mise à jour du leader en cas d’erreur temporaire Kubernetes
403(Sophia Ruan, Alexander Kukushkin)
Lorsque l’API Kubernetes retourne temporairement 403 Permission Denied (par exemple lors de problèmes RBAC transitoires), Patroni vérifie désormais si le nœud actuel conserve toujours le statut de leader et retente la mise à jour du leader dans un délai de retry_timeout au lieu de se désigner immédiatement comme non leader.
- Corriger le problème de renommage du nœud leader en mode synchronisation et en pause (Alexander Kukushkin)
La clé /sync n’a pas été mise à jour après le renommage du nœud leader avec une redémarrage de Patroni en pause (sans redémarrage de Postgres). Cela a empêché Patroni de promouvoir après le prochain redémarrage sans pause.
- Déclencheur
pg_rewindvérification lorsque la même timeline primaire est augmentée (Alexander Kukushkin)
Une augmentation de timeline peut survenir suite à une récupération après panne en mode utilisateur unique, suivie d’une promotion après avoir obtenu la clé leader, tandis que les autres nœuds répliques sont isolés du DCS. Dans ce cas, les nœuds répliques n’ont pas déclenché la machine à états pg_rewind car le leader, et par conséquent primary_conninfo, n’a pas changé.
- Seuls écrire le mot de passe superutilisateur pendant l’
initdbamorçage si celui-ci n’est pas vide (Michael Banck)
Écrire un mot de passe vide pendant l’amorçage initdb causait des problèmes.
- Corriger le bogue lié à
failover_priorityavecsynchronous_mode=on(Alexander Kukushkin)
Les valeurs de tag.failover_priority ont été ignorées lorsque synchronous_node_count > 1 était actif.
- Corriger le bug de comparaison du mot de passe
primary_conninfo(Alexander Kukushkin)
À compter de PostgreSQL 10, Patroni utilise le fichier passfile situé dans primary_conninfo et échoue à mettre à jour ce fichier après la mise à jour du mot de passe de réplication dans la configuration YAML lors d’un rechargement.
- Ne redémarrez pas la réplique avec l’étiquette
nofailoveren mode pause (Alexander Kukushkin)
Patroni permet de démarrer une réplique PostgreSQL arrêtée manuellement en mode pause lorsque le tag nofailover est défini sur true.
- Corriger
check_recovery_conf()lorsque PostgreSQL est dans l’état de démarrage (Alexander Kukushkin)
Pour PostgreSQL v12 et les versions ultérieures, pg_settings ne peut pas être interrogé tant que le serveur n’est pas entièrement démarré et n’accepte pas encore de connexions. Les paramètres de récupération manquants sont désormais ajoutés à l’état interne lors de l’écriture de postgresql.conf. En outre, restaurez le contrôle Postgresql.is_starting() dans Ha.is_healthiest_node().
- Valider les options utilisateur au format dictionnaire pour
initdb/basebackup(m4rrypro)
Lorsque les options initdb ou basebackup ont été fournies sous forme de dictionnaire (au lieu d’une liste), la validation option_is_allowed() était ignorée, autorisant l’utilisation d’options bloquées.
- Autoriser la compression côté serveur pour l’option
basebackup(m4rrypro)
L’option compress était entièrement bloquée pour basebackup, mais depuis PostgreSQL 15, la compression côté serveur est utile et fonctionne de manière transparente avec le format brut. La compression côté client est toujours rejetée.
- Ne pas recharger la configuration PostgreSQL pendant l’exécution d’un amorçage personnalisé (Alexander Kukushkin)
Un amorçage personnalisé peut être complexe et impliquer plusieurs démarrages et arrêts de PostgreSQL. Les rechargements de la configuration de PostgreSQL pendant ce processus pourraient entraîner un comportement imprévu.
- Vérifier que
postgresql.parametersest un dictionnaire (Alexander Kukushkin)
Rejeter la nouvelle configuration si postgresql.parameters n’est pas un dictionnaire.
Version 4.1.0
Sortie le 2025-09-23
Nouvelles fonctionnalités
- Ajouter la prise en charge du type d’unité systemd « notify » (Ronan Dunklau)
Sans type d’unité de notification, il est possible de lancer Patroni puis de lui envoyer immédiatement un signal SIGHUP via systemd, ce qui l’arrête effectivement avant qu’il n’ait eu le temps de configurer ses gestionnaires de signaux.
- Fournir les informations sur le LSN/le décalage de réception et de relecture via l’API et ctl (Polina Bungina)
L’endpoint de l’API REST Patroni /cluster et la commande patronictl list fournissent désormais des informations sur le LSN de réception, le LSN de relecture, le délai de réception et le délai de relecture pour chaque membre répliqué.
- Assurez une désactivation propre vers le cluster de secours (Polina Bungina)
Veillez à ce que l’introduction de la section standby_cluster dans la configuration dynamique entraîne une désactivation propre du cluster.
- Implémenter les commandes
patronictl demote-clusteretpromote-cluster(Polina Bungina)
Nouvelles commandes pour la désactivation et l’activation du cluster gèrent à la fois l’édition dynamique de la configuration et la vérification de l’état du résultat.
- Implémenter le tag
sync_priority(Polina Bungina)
Ce paramètre contrôle la priorité qu’un membre doit avoir lors de la sélection d’une réplique synchrone lorsque synchronous_mode
est défini sur on.
- Implémenter l’option
--printpour--validate-config(Polina Bungina)
Affiche la configuration locale (y compris les substitutions de configuration d’environnement) après sa validation réussie.
- Implémenter
kubernetes.bootstrap_labels(Polina Bungina)
Cette fonctionnalité permet de définir des étiquettes qui seront attribuées à un pod membre lorsqu’il se trouve dans l’état initializing new cluster, running custom bootstrap script, starting after custom bootstrap ou creating replica.
- Ajouter une option de configuration pour supprimer les journaux de battement de cœur en doublon (Michael Morris)
Si elle est définie sur true, les journaux de battement de cœur identiques successifs ne doivent pas être affichés.
- Ajouter un attribut facultatif
cluster_typeaux slots de réplication permanents (Michael Banck)
Cela vous permet de définir si une slot de réplication permanente particulière doit toujours être créée, ou uniquement sur un cluster primaire ou un cluster de secours.
- Rendre le header du serveur HTTP configurable (David Grierson)
Introduisez le paramètre de configuration restapi.server_tokens qui permet de restreindre les informations divulguées dans l’en-tête HTTP du serveur.
- Implémenter des vérifications de disponibilité API pour la réplication sur les membres répliques (Ants Aasma)
L’implémentation précédente considérait les répliques comme prêtes dès que PostgreSQL était démarré. Avec ce changement, un pod réplique n’est considéré comme prêt que lorsque PostgreSQL est en cours de réplication et ne suit pas trop le leader.
Améliorations
- Réduire le niveau de journalisation des échecs de configuration du watchdog (Ants Aasma)
Affichez la ligne de journal Could not activate Linux watchdog device au niveau de journalisation débogage, sauf si le watchdog est configuré en mode required. Elle était précédemment affichée au niveau info.
- Profitez de
written_lsnetlatest_end_lsnprovenant depg_stat_wal_receiver(Alexander Kukushkin)
written_lsn, le LSN d’écriture réel, est désormais préféré à celui retourné par pg_last_wal_receive_lsn(), qui correspond en réalité au LSN de vidage. latest_end_lsn pointe vers le vidage du WAL sur l’hôte source. En cas de rôle primaire, cela permet un calcul plus précis du décalage de lecture, car les valeurs stockées dans le DCS ne sont mises à jour qu’ toutes les loop_wait secondes.
- Éviter les interactions avec les slots créés avec l’option
failover=true(Alexander Kukushkin)
Ce changement est nécessaire pour rendre la fonctionnalité des slots de basculement logique entièrement fonctionnelle.
- Ajouter l’état PostgreSQL à l’endpoint d’API REST
/metrics(Ivan Filianin)
Informations sur l’état de l’instance PostgreSQL sont désormais disponibles dans la sortie au format Prometheus de l’endpoint d’API REST /metrics.
Version 4.0.7
Sortie le 2025-09-22
Nouvelles fonctionnalités
- Ajouter le support de PostgreSQL 18 RC1 (Alexander Kukushkin)
Les règles de validation des paramètres GUC ont été étendues. Patroni gère désormais correctement le nouveau worker d’E/S en arrière-plan.
Correctifs de bogues
- Corriger un éventuel problème lié à la résolution de localhost en IPv6 sous Windows (András Váczi)
Lors de la configuration de listen_addresses dans PostgreSQL, l’utilisation de 0.0.0.0 ou 127.0.0.1 limite l’écoute à IPv4 uniquement, excluant IPv6. Sur les systèmes Windows typiques, localhost résout souvent par défaut vers l’adresse IPv6 ::1. Pour assurer la compatibilité, Patroni configure désormais PostgreSQL pour écouter sur 127.0.0.1, plutôt que sur localhost, sur les systèmes Windows.
- Retourner la configuration globale uniquement lorsque la clé
/configexiste dans le DCS (Alexander Kukushkin)
L’API REST de Patroni renvoyait une configuration vide au lieu de lever une erreur lorsque la clé /config était absente dans le DCS.
- Corriger le problème de mode de secours non déclenché en cas d’indisponibilité d’etcd (Alexander Kukushkin)
Patroni ne gérait pas toujours correctement les exceptions etcd3, ce qui empêchait le déclenchement du mode de secours.
- Correction d’un blocage en réentrance du gestionnaire de signal (Waynerv)
Patroni s’exécutant dans un conteneur Docker avec PID=1 présentait des blocages dans certains cas particuliers après avoir reçu SIGCHLD.
- Recréer (permanent) la slot physique lorsqu’elle ne réserve pas de WAL (Israel Barth Rubio)
Les slots de réplication physique permanents créés en dehors de l’orbite de Patroni sans réservation de WAL provoquaient une erreur replication slot cannot be advanced. Pour y remédier, Patroni recrée désormais ces slots.
- Gérer correctement les messages d’annulation de surveillance dans
etcd3(Alexander Kukushkin)
Lorsque etcd3 envoie un message d’annulation au canal d’observation, il ne ferme pas la connexion. Cela entraîne l’utilisation par Patroni de données obsolètes. Patroni résout désormais ce problème en interrompant la boucle de lecture des réponses fractionnées et en fermant la connexion côté Patroni.
- Gérer le cas où le
HTTPConnectionsocket est encapsulé parpyopenssl(Alexander Kukushkin)
Patroni n’utilisait pas correctement les interfaces pyopenssl, imposées dans python-etcd.
Améliorations de la documentation
- Améliorer les instructions pour les clusters à deux nœuds (Nikolay Samokhvalov)
Préciser le comportement pendant un basculement et les exigences relatives au DCS.
Version 4.0.6
Sortie le 2025-06-06
Correctifs de bogues
- Corriger un bug lors du basculement depuis un leader ayant une priorité plus élevée (Alexander Kukushkin)
Assurez-vous que Patroni ignore l’ancien leader ayant une priorité plus élevée lorsqu’il signale le même LSN que le nœud actuel.
- Corrigez les permissions du fichier
postgresql.confcréé en dehors dePGDATA(Michael Banck)
Respectez la valeur umask système lors de la création du fichier postgresql.conf en dehors du répertoire PGDATA.
- Corriger le bug lié au basculement planifié dans
synchronous_mode=quorum(Alexander Kukushkin)
Ne pas vérifier les exigences de quorum lorsqu’un candidat est spécifié.
- Ignorer les nœuds etcd obsolètes en comparant le terme du cluster (Alexander Kukushkin)
Mémorisez le dernier “raft_term” connu du cluster etcd, et lors de l’exécution des requêtes clientes, comparez-le avec le “raft_term” rapporté par un nœud etcd.
- Mettre à jour les fichiers de configuration PostgreSQL sur
SIGHUP(Alexander Kukushkin)
Précédemment, Patroni ne remplaçait les fichiers de configuration PostgreSQL que si un changement dans la configuration globale ou locale était détecté.
- Gérer correctement l’exception
Unavailablelevée paretcd3(Alexander Kukushkin)
Patroni tentait auparavant de renouveler ces requêtes sur le même nœud etcd3, mais passer à un autre nœud constitue une stratégie préférable.
- Améliorer la gestion des baux (
etcd3) (Alexander Kukushkin)
Assurez-vous que Patroni renouvelle la licence etcd3 au moins une fois par boucle HA.
- Revérifier les annotations en cas de code d’état 409 lors de l’acquisition du verrou leader (Alexander Kukushkin)
Implémenter le même comportement que celui appliqué à l’objet leader lors de la version 4.0.3 de Patroni.
- Prenez en compte
replay_lsnlors de l’avancement des slots (Polina Bungina)
N’essayez pas de faire avancer les slots sur les répliques au-delà de replay_lsn. En outre, faites avancer le slot à la position replay_lsn s’il est déjà passé au-delà de confirmed_flush_lsn de ce slot sur la réplique, mais que la réplique n’a pas encore rejoué l’LSN effective à laquelle ce slot se trouve sur le primaire.
- Assurez-vous que
CHECKPOINTest exécuté après la promotion (Alexander Kukushkin)
Il était possible que la tâche de point de contrôle n’ait pas été réinitialisée lors de la désactivation, car CHECKPOINT n’était pas encore terminé. Cela a entraîné l’utilisation d’un result périmé lors de la prochaine activation.
- Éviter d’exécuter en parallèle une désactivation en mode hors ligne (Alexander Kukushkin)
En cas d’arrêt lent, il se peut que la prochaine boucle de battement de cœur déclenche à nouveau la méthode de gestion des erreurs du DCS, entraînant un avertissement AsyncExecutor is busy, demoting from the main thread et le démarrage à nouveau de la dégradation hors ligne.
- Normaliser la valeur
data_diravant de renommer le répertoire de données en cas d’échec de l’initialisation (Waynerv)
Empêchez une barre oblique finale dans la valeur du paramètre data_dir de perturber le processus de renommage après une erreur d’initialisation.
- Vérifiez que
synchronous_standby_namescontient la valeur attendue (Alexander Kukushkin)
- Vérifiez que
Précédemment, le mécanisme implémentant la machine à états pour la réplication synchrone sans quorum ne vérifiait pas la valeur réelle de synchronous_standby_names, ce qui entraînait l’utilisation d’une valeur obsolète de synchronous_standby_names lorsque pg_stat_replication est un sous-ensemble de synchronous_standby_names.
Version 4.0.5
Sorti le 2025-02-20
Améliorations de stabilité
- Compatibilité avec
python-json-logger>=3.1(Alexander Kukushkin)
Supprimez les avertissements générés par l’utilisation de l’API ancienne.
- Compatibilité avec Python 3.13 (Alexander Kukushkin)
Exécuter les tests contre Python 3.13.
- Compatibilité avec
pyinstaller>=4.4(Joe Jensen)
Passez au iter_modules par défaut si l’attribut pyinstaller toc n’est pas présent.
Corriger les problèmes liés à la prise en charge de PostgreSQL 9.5 (Alexander Kukushkin)
- Gérer correctement le format de sortie
pg_rewind. - Tenir compte du fait que le format
synchronous_standby_namesne prend pas en charge la spécification « num ».
- Gérer correctement le format de sortie
Compatibilité avec les derniers changements apportés à
urlparse(Alexander Kukushkin)
urlparse n’accepte plus plusieurs hôtes contenant le caractère [] dans l’URL. Pour pallier ce problème, passez aux wrappers natifs de PQconninfoParse() à partir de libpq, lorsque cela est possible, et utilisez uniquement notre implémentation pour les versions anciennes de psycopg2 liées à une version obsolète de libpq.
Correctifs de bogues
- Afficher uniquement les membres à redémarrer lors de la confirmation du redémarrage (András Váczi)
Précédemment, lors de l’exécution de patronictl restart <clustername> --pending, la confirmation listait tous les membres, qu’ils aient ou non une redémarrage en attente.
- Annuler les tâches longues en cours lors de l’arrêt de Patroni et supprimer le répertoire de données en cas d’échec de l’amorçage d’une réplique (Alexander Kukushkin)
Précédemment, Patroni pouvait effectuer l’amorçage d’une réplique, tandis que pg_basebackup / wal-g / pgBackRest / barman ou des entités similaires continuaient de fonctionner.
- Gérer correctement les noms de cluster contenant une barre oblique dans
patronictl edit-config(Antoni Mur)
Remplacez une barre oblique dans cluster_name par un trait de soulignement.
- Éviter de supprimer les slots physiques trop tôt (Alexander Kukushkin)
Reporter la suppression des slots de réplication physique contenant xmin après un basculement : sur le nouveau primaire — jusqu’à ce que ce membre soit promu, sur les répliques — jusqu’à ce qu’un leader soit présent dans le cluster.
- Gérer toutes les exceptions levées par le sous-processus dans
controldata()(Alexander Kukushkin)
Patroni ne gérait pas correctement toutes les exceptions pouvant être levées lors de l’appel de l’utilitaire pg_controldata.
- Corriger le bug lié à une borne d’un ancien leader non conservée lors d’un basculement (Alexander Kukushkin)
Évitez de vous fier à tort à la présence des membres dans le DCS pendant un basculement, car la clé /member du leader précédent expire précisément au même moment.
Corriger quelques bogues dans la machine à états du quorum (Alexander Kukushkin)
- Lorsqu’il s’agit d’évaluer la présence de nœuds sains pour une course au rôle de leader, il est nécessaire de prendre en compte les exigences de quorum avant de procéder à la désactivation. En l’absence de cette prise en compte, l’ancien leader pourrait se retrouver en récupération entouré de nœuds asynchrones.
QuorumStateResolverne gérant pas correctement le cas où un nœud réplique se connecte puis se déconnecte rapidement.
Améliorations
- Améliorer le message d’erreur en cas de fichier de configuration vide ou non au format dictionnaire (Julian)
Lancer une exception plus explicite lors de la validation de la présence d’un objet Mapping valide dans le fichier de configuration Patroni.
Version 4.0.4
Sorti le 2024-11-22
Améliorations de stabilité
- Ajouter la compatibilité avec le module
py-consul(Alexander Kukushkin)
Le module python-consul n’est plus maintenu depuis longtemps, tandis que py-consul en est le remplacement officiel. La compatibilité descendante avec python-consul est conservée.
- Ajouter la compatibilité avec le module
prettytable>=3.12.0(Alexander Kukushkin)
Avertissements de dépréciation de l’adresse.
- Compatibilité avec le module
ydiff==1.4.2(Alexander Kukushkin)
Corrigez les problèmes de compatibilité pour la dernière version, restreignez la version dans requirements.txt, et introduisez un test de compatibilité pour la dernière version.
Correctifs de bogues
- Exécuter le rappel
on_role_changeaprès un échec de récupération du primaire (Polina Bungina, Alexander Kukushkin)
Exécutez également le rappel on_role_change pour une instance primaire qui n’a pas pu démarrer après un incident, afin d’augmenter les chances que le rappel soit exécuté, même si le démarrage ultérieur en tant que réplique échoue.
- Corriger une fuite de thread dans
patronictl list -W(Alexander Kukushkin)
Mettre en cache l’objet d’instance DCS pour éviter les fuites de threads.
- Veillez à n’écrire que les paramètres pris en charge dans la chaîne de connexion (Alexander Kukushkin)
Patroni utilisait de passer des paramètres introduits dans les versions plus récentes dans la chaîne de connexion, ce qui entraînait des erreurs de connexion.
Version 4.0.3
Sorti le 2024-10-18
Correctifs de bogues
- Désactiver
pgauditlors de la création d’utilisateurs afin de ne pas exposer le mot de passe (kviset)
Patroni enregistrait les mots de passe superuser, replication et rewind lors de leur création lorsque l’extension pgaudit était activée.
- Corriger le problème lié aux configurations mixtes : réplique primaire sur Patroni v4 ou antérieur et répliques sur v4+ (Alexander Kukushkin)
Utilisez xlog_location extrait de la clé /members au lieu de tenter d’obtenir la position de la tranche d’un membre à partir de la clé /status si la version de Patroni en cours d’exécution sur le leader est antérieure à 4.0.0. Ne pas procéder ainsi entraîne une accumulation des WAL sur les répliques.
- Ne pas ignorer les paramètres GUC PostgreSQL valides qui n’ont pas de validateur Patroni (Polina Bungina)
Vérifier toujours contre postgres --describe-config si une directive GUC ne dispose pas de validateur Patroni mais est en réalité une directive GUC valide.
Améliorations
- Vérifier les annotations en cas de code d’état 409 lors de la lecture de l’objet leader dans K8s (Alexander Kukushkin)
Évitez une mise à jour supplémentaire si la requête PATCH a été annulée par Patroni, même si la requête a réussi à mettre à jour la cible.
- Ajouter la prise en charge de l’option de connexion côté client
sslnegotiation(Alexander Kukushkin)
sslnegotiation a été ajouté à la version finale de PostgreSQL 17.
Version 4.0.2
Sorti le 2024-09-17
Correctifs de bogues
- Gérer les exceptions lors de la découverte des fichiers de validation de configuration (Alexander Kukushkin)
Ignorer les répertoires pour lesquels Patroni ne dispose pas des autorisations suffisantes pour effectuer des opérations de liste.
- Assurez-vous que les slots de réplication physique inactifs ne retiennent pas
xmin(Alexander Kukushkin, Polina Bungina)
Depuis la version 3.2.0, Patroni crée des slots de réplication physique pour tous les membres sur les répliques et les met à jour périodiquement à l’aide de la fonction pg_replication_slot_advance(). Toutefois, si hot_standby_feedback est activé pour une raison quelconque et que le primaire est démote en réplique, les slots désormais inactifs transmettent la valeur NOT NULL xmin au nouveau primaire. Cela empêche le seuil xmin d’être avancé et empêche le vacuum de nettoyer les tuples morts. Avec cette correction, Patroni recrée les slots de réplication physique qui devraient être inactifs mais dont la valeur NOT NULL xmin est présente.
- Corriger un traitement d’erreur non géré
DCSErrorpendant la phase de démarrage (Waynerv)
Assurez-vous de la connectivité DCS avant de vérifier l’unicité du nom du nœud.
- Inclure explicitement les paramètres GUC
CMDLINE_OPTIONSlors de la requête surpg_settings(Alexander Kukushkin)
Veillez à ce que toutes les options GUC transmises au postmaster sous forme de paramètres de ligne de commande soient restaurées lorsque Patroni rejoint un standby en cours d’exécution. Il s’agit d’une correction complémentaire liée au correctif appliqué dans Patroni 3.2.2.
- Corriger la logique d’encadrement des chaînes dans
synchronous_standby_names(Alexander Kukushkin)
Selon la documentation PostgreSQL, les mots-clés ANY et FIRST doivent être entre guillemets doubles, ce que Patroni n’avait pas fait auparavant.
- Corriger le problème de connexion keepalive hors plage (hadizamani021)
Assurez-vous que la valeur calculée de l’option keepalive, basée sur l’ensemble ttl, ne dépasse pas la valeur maximale autorisée pour la plateforme actuelle.
Version 4.0.1
Sortie le 2024-08-30
Correction de bogue
- Patroni créait des slots de réplication inutiles pour lui-même (Alexander Kukushkin)
Cela se produisait si name contenait des majuscules ou des caractères spéciaux.
Version 4.0.0
Sortie le 2024-08-29
- Cette version achève le travail de suppression du terme « master », en faveur de « primary ». Cela implique quelques modifications rétrocompatibles, veuillez lire attentivement les notes de version. La mise à jour vers Patroni 4+ fonctionnera de manière fiable uniquement si vous exécutez Patroni 3.1.0 ou une version ultérieure. La mise à jour depuis une version antérieure directement vers 4+ est possible, mais peut entraîner un comportement imprévu si le nœud primaire tombe pendant que les autres nœuds fonctionnent avec d’autres versions de Patroni.
Modifications importantes
- Les modifications suivantes ont été introduites lors de la suppression du terme non inclusif « master » dans le code de Patroni :
- Sur Kubernetes, Patroni définit par défaut l’étiquette
rolesurprimary. Si vous souhaitez conserver le comportement ancien et éviter toute interruption ou migrations complexes et longues, vous pouvez configurer les paramètreskubernetes.leader_label_valueetkubernetes.standby_leader_label_valueàmaster. En savoir plus ici . - Le rôle Patroni est écrit dans le DCS sous le nom
primaryau lieu demaster. - Le rôle Patroni retourné par l’API REST de Patroni a été modifié de
masteràprimary. - L’API REST de Patroni n’accepte plus
role=masterdans les requêtes aux points de terminaison/switchover,/failover,/restart. /metricsLe point de terminaison de l’API REST ne rapportera plus la métriquepatroni_master.- patronictl
n’accepte plus l’option
--masterpour aucune commande. Les options--leaderou--primarydoivent être utilisées à la place. no_masterdans la configuration déclarative des méthodes de création de réplique personnalisées n’est plus traité comme une option spéciale ; utilisezno_leaderà la place.patroni_wale_restorene prend plus en charge l’option--no_master.patroni_barmanne prend plus en charge l’option--role=master.- Tous les scripts de rappel sont exécutés avec l’option
role=primarypassée au lieu derole=master.
- Sur Kubernetes, Patroni définit par défaut l’étiquette
patronictl failoverne prend plus en charge l’option--leaderqui était obsolète depuis Patroni 3.2.0.- La fonctionnalité de création d’utilisateurs (
bootstrap.userssection de configuration) obsolète depuis Patroni 3.2.0 a été supprimée.
Nouvelles fonctionnalités
- Basculement basé sur le quorum (Ants Aasma, Alexander Kukushkin)
La fonctionnalité implémente une réplication synchrone basée sur le quorum (disponible à partir de PostgreSQL v10), qui permet de réduire les latences dans le pire des cas, même en opération normale, car une latence plus élevée de réplication vers un serveur secondaire peut être compensée par les autres serveurs secondaires. Patroni met en place des mesures supplémentaires pour empêcher toute perte de données visible par l’utilisateur en choisissant comme candidat au basculement le serveur ayant reçu la transaction la plus récente.
- Inscrire les secondaires Citus dans
pg_dist_node(Alexander Kukushkin)
Patroni maintient désormais la liste des nœuds avec role==replica, state==running et sans noloadbalance tag
dans pg_dist_node.
- Durée de rétention configurable des fentes de réplication des membres (Alexander Kukushkin)
Implémente le support du paramètre de configuration global member_slots_ttl, qui détermine pendant combien de temps les fentes de réplication des membres doivent être conservées lorsque la clé du membre est absente.
- Rendre les permissions des fichiers de journalisation créés par Patroni configurables (Alexander Kukushkin)
Permet de définir des permissions spécifiques pour les fichiers de journal créés par Patroni. Si non spécifié, les permissions sont définies en fonction de la valeur actuelle de umask.
- Compatibilité avec PostgreSQL 17 beta3 (Alexander Kukushkin)
Les règles de validation des paramètres GUC ont été étendues. Patroni gère tous les nouveaux backends auxiliaires lors de l’arrêt et définit dbname dans primary_conninfo, comme requis pour la synchronisation des slots de réplication logique.
- Implémenter l’option
--ignore-listen-portpour la validation de la configuration Patroni (Sahil Naphade)
Permettre d’ignorer les ports déjà bindés lors de l’exécution de patroni --validate-config.
Améliorations
- Rendre
wal_log_hintsconfigurables (Paul_Kim)
Permet d’éviter la surcharge liée à la configuration wal_log_hints lorsque use_pg_rewind est défini sur off.
- Journal
pg_basebackupen modeDEBUG(Waynerv)
Facilite le débogage des initialisations échouées.
Correctifs de bogues
- Avancer les slots permanents pour les nœuds en cascade pendant le mode de secours (Alexander Kukushkin)
Assurez-vous que les slots des répliques en cascade sont correctement avancés sur le serveur primaire lorsque le mode de sécurité est activé. Cela est réalisé en étendant la réponse des répliques à la requête de l’API REST POST /failsafe avec leur xlog_location.
- Ne pas permettre au nœud actuel d’être sélectionné comme synchrone (Alexander Kukushkin)
Il se peut qu’un « quelque chose » soit en cours de diffusion depuis le nœud primaire actuel avec application_name, correspondant au nom du nœud primaire actuel. Patroni ne gérait pas correctement cette situation, ce qui pouvait entraîner la déclaration du nœud primaire comme nœud synchrone, bloquant ainsi les basculements planifiés.
Ignorer
restapi.allowlist_include_memberspour les requêtes POST /failsafe (Alexander Kukushkin)Améliorer la validation des paramètres GUC (Polina Bungina)
En raison de la validation supplémentaire effectuée via l’exécution de la commande postgres --describe-config, il était auparavant impossible de définir des GUCs non listés dans ce cadre par le biais de la configuration Patroni. Cette limitation est désormais levée.
- Ajouter une ligne avec
localhostau fichier.pgpasslorsque des sockets Unix sont détectés (Alexander Kukushkin)
Patroni ajoutera une ligne supplémentaire au fichier .pgpass si le paramètre host spécifié commence par le caractère /. Cela permet de traiter un cas particulier où host correspond au chemin par défaut du répertoire de socket.
- Corriger les problèmes de journalisation (Waynerv)
URL de requête correctement définie dans les journaux de gestion des erreurs en mode de secours et ordre des horodatages corrigé dans les journaux de vérification du postmaster.
Version 3.3.2
Libéré le 2024-07-11
Correctifs de bogues
- Corriger le mode de réplication synchrone PostgreSQL en mode simple (Israel Barth Rubio)
Depuis l’introduction de synchronous_mode
dans Patroni, la réplication synchrone brute de Postgres ne fonctionnait plus. Avec cette correction, Patroni définit la valeur de synchronous_standby_names selon la configuration de l’utilisateur, le cas échéant, lorsque synchronous_mode
est désactivé.
- Gérer l’invalidation des slots logiques sur une station de secours (Polina Bungina)
Depuis PG16, les slots de réplication logique sur une instance de secours peuvent être invalidés en raison de l’horizon : à partir de maintenant, Patroni impose la copie (c’est-à-dire la recréation) des slots invalidés.
- Corriger la condition de course entre l’avancement de la fente logique et la copie (Alexander Kukushkin)
En raison de ce bogue, il était possible qu’une slot de réplication logique invalidée soit copiée lors d’un redémarrage de PostgreSQL à plusieurs reprises.
Version 3.3.1
Sorti le 2024-06-17
Améliorations de stabilité
- Compatibilité avec Python 3.12 (Alexander Kukushkin)
Gérer un nouvel attribut ajouté à logging.LogRecord.
Correctifs de bogues
- Corriger la récursion infinie dans la gestion des balises
replicatefrom(Alexander Kukushkin)
Dans le cadre de cette correction, améliorer également le contrôle is_physical_slot() et mettre à jour la documentation.
- Corriger le rapport de rôle incorrect dans les clusters de secours (Alexander Kukushkin)
synchronous_standby_names et la réplication synchrone ne fonctionnent qu’avec un nœud primaire réel, et dans le cas de la réplication en cascade, ils sont simplement ignorés par Postgres. Avant cette correction, patronictl list et GET /cluster signalait à tort certains nœuds comme synchrones.
- Assurer la disponibilité du paramètre GUC
allow_in_place_tablespaces(Polina Bungina)
allow_in_place_tablespaces a été ajouté non seulement à PostgreSQL 15, mais également intégré en retour (backpatched) dans les versions 10 à 14.
Version 3.3.0
Sorti le 2024-04-04
Toutes les versions anciennes de Patroni sont incompatibles avec ydiff>=1.3.
Les options suivantes sont disponibles pour “résoudre” le problème :
- mettre à jour Patroni vers la dernière version
- installer
ydiff<1.3après l’installation de Patroni - installer le module
cdiff
Nouvelles fonctionnalités
- Ajouter la possibilité de passer
auth_dataau client Zookeeper (Aras Mumcuyan)
Il permet de spécifier les identifiants d’authentification à utiliser pour la connexion.
- Ajouter un script contrib pour l’intégration avec
Barman(Israel Barth Rubio)
Fournissez une application patroni_barman permettant d’effectuer des opérations Barman à distance et pouvant être utilisée comme méthode d’amorçage personnalisée ou de réplique personnalisée, ou comme rappel on_role_change. Veuillez consulter ici
pour plus d’informations.
- Prise en charge du format de journal
JSON(alisalemmi)
Outre plain (par défaut), Patroni prend désormais en charge le format de journalisation json. Nécessite que la bibliothèque python-json-logger>=2.0.2 soit installée.
Afficher les informations
pending_restart_reason(Polina Bungina)Fournit des informations détaillées sur les paramètres PostgreSQL ayant déclenché l’indicateur
pending_restart. Aussi bienpatronictl listque le point de terminaison REST/patroniaffichent désormais les noms des paramètres et leur « diff » danspending_restart_reason.Implémenter le tag
nostream(Grigory Smolkin)
Si l’étiquette nostream est définie sur true, le nœud n’utilisera pas le protocole de réplication pour diffuser les WAL, mais s’appuiera à la place sur la récupération depuis les archives (si restore_command est configuré). Cela désactive également la copie et la synchronisation des slots de réplication logique permanents sur le nœud lui-même et sur toutes ses répliques en cascade.
Améliorations
- Effectuer la validation de la section
log(Alexander Kukushkin)
Jusqu’à présent, le validateur ne vérifiait pas la correction de la configuration de journalisation fournie.
- Améliorer la journalisation des modifications des paramètres PostgreSQL (Polina Bungina)
Convertir les anciennes valeurs au format lisible par un humain et journaliser les informations concernant le désaccord entre la configuration pg_controldata et la configuration globale de Patroni.
Correctifs de bogues
- Filtrer correctement les options non autorisées
pg_basebackup(Israel Barth Rubio)
En raison d’un bogue, Patroni ne filtrait pas correctement les options non autorisées configurées pour la méthode d’amorçage de la réplique basebackup, lorsqu’elles étaient fournies au format - setting: value.
- Correction de la gestion des erreurs d’authentification
etcd3(Alexander Kukushkin)
Toujours réessayer une fois en cas d’erreur d’authentification etcd3 si l’authentification n’a pas été effectuée juste avant l’exécution de la requête. En outre, ne pas redémarrer les observateurs lors de la réauthentification.
- Améliorer la logique de découverte des fichiers validateurs (Waynerv)
Utilisez la bibliothèque importlib pour découvrir les fichiers contenant des paramètres de configuration disponibles, lorsque cela est possible (pour Python 3.9+). Cette implémentation est plus stable et ne perturbe pas les distributions Patroni basées sur les archives zip.
- Utilisez
target_session_attrsuniquement lorsque plusieurs hôtes sont spécifiés dans la section standby_cluster (Alexander Kukushkin)
target_session_attrs=read-write est désormais ajouté à primary_conninfo sur le nœud de secours en tant que leader, uniquement lorsque la section standby_cluster.host contient plusieurs hôtes séparés par des virgules.
- Ajouter du code de compatibilité pour la bibliothèque
ydiffversion 1.3+ (Alexander Kukushkin)
Patroni s’appuie sur certaines API de ydiff qui ne sont pas publiques, car elles sont censées ne servir qu’à un outil terminal et non à un module Python. Malheureusement, les modifications apportées à l’API dans la version 1.3 ont rompu la compatibilité avec les anciennes versions de Patroni.
Version 3.2.2
Sorti le 2024-01-17
Correctifs de bogues
- Ne pas permettre à la réplique de restaurer la clé lorsqu’le DCS a été effacé (Alexander Kukushkin)
Cela se produisait dans la méthode où Patroni devait reprendre un cluster PG autonome.
- Utiliser une lecture cohérente lors de la récupération de la clé de synchronisation mise à jour depuis Consul (Alexander Kukushkin)
Consul ne propose aucune interface permettant d’obtenir immédiatement ModifyIndex pour la clé que nous venons de mettre à jour, il faut donc effectuer une opération de lecture explicite. Étant donné que les lectures en retard sont autorisées par défaut, nous pouvions parfois obtenir une version obsolète de la clé.
- Recharger la configuration de Postgres si un paramètre nécessitant un redémarrage a été rétabli à sa valeur d’origine (Polina Bungina)
Précédemment, Patroni ne mettait pas à jour la configuration, mais réinitialisait uniquement le pending_restart.
- Corriger la logique inversée du message de confirmation lors d’un basculement vers un candidat asynchrone en mode synchrone (Polina Bungina)
Le problème n’existe que dans patronictl .
- Exclure le leader des candidats au basculement dans patronictl (Polina Bungina)
Si le cluster est sain, basculer vers un leader existant est une opération sans effet.
- Créer la base de données Citus et l’extension de manière idempotente (Alexander Kukushkin, Zhao Junwang)
Il permettra de les créer dans le script post_bootstrap au cas où il serait nécessaire d’ajouter d’autres dépendances à la base de données Citus.
- Ne filtrez pas notre balise
nofailovercontradictoire (Polina Bungina)
La configuration {nofailover: false, failover_priority: 0} définie sur un nœud ne lui a pas permis de participer à la course, ce qui devrait être le cas, car le tag nofailover doit avoir la priorité.
- Corrigé le problème lié au gel avec PyInstaller (Sophia Ruan)
Le freeze_support() a été appelé après argparse, ce qui a empêché Patroni de démarrer PostgreSQL.
- Correctif d’un bogue dans le générateur de configuration pour la configuration patronictl et Citus (Israel Barth Rubio)
Il empêchait les paramètres de configuration patronictl et Citus définis via des variables d’environnement de être écrits dans la configuration générée.
- Restaurer les paramètres GUC de récupération et certains paramètres gérés par Patroni lors de la connexion à un standby en cours d’exécution (Alexander Kukushkin)
Patroni échouait à redémarrer Postgres à partir de la version 12 avec une erreur indiquant la présence manquante de port dans l’une des structures internes.
- Correctifs liés au drapeau
pending_restart(Polina Bungina)
N’exposez pas pending_restart lorsqu’un amorçage personnalisé est utilisé avec recovery_target_action = promote ou lorsque hot_standby ou wal_log_hints ont été modifiés, par exemple à l’aide de ALTER SYSTEM.
Version 3.2.1
Sorti le 2023-11-30
Correctifs de bogues
- Limite les valeurs acceptées pour l’argument
--formatdans patronictl (Alexander Kukushkin)
Il acceptait auparavant n’importe quelle chaîne arbitraire et ne produisait aucune sortie si la valeur n’était pas reconnue.
- Vérifiez que les nœuds répliques ont reçu le LSN de point de contrôle lors de l’arrêt avant de libérer la clé leader (Alexander Kukushkin)
Précédemment, dans certains cas, nous utilisions le LSN de l’enregistrement SWITCH qui suit un CHECKPOINT (si le mode d’archivage est activé). En conséquence, le primaire précédent devait parfois effectuer pg_rewind, mais cela n’entraînait aucune perte de données.
- Effectuer une requête HTTP réelle lors de la vérification de l’unicité du nom de nœud (Alexander Kukushkin)
Lors de l’exécution de Patroni dans des conteneurs, il se peut que le trafic soit acheminé via docker-proxy, qui écoute sur le port et accepte les connexions entrantes. Cela provoquait des faux positifs.
- Corrigé le support de Citus avec etcd v2 (Alexander Kukushkin)
Patroni échouait à déployer un nouveau cluster Citus avec etcd v2.
- Corrigé le comportement de
pg_rewindavec PostgreSQL v16+ (Alexander Kukushkin)
Le format du message d’erreur de pg_waldump a été modifié en version 16, ce qui a entraîné l’appel de pg_rewind par Patroni même lorsque cela n’était pas nécessaire.
- Correctif d’un bug lié à l’amorçage personnalisé (Alexander Kukushkin)
Patroni appliquait incorrectement l’argument --command, qui est en lui-même une commande d’amorçage.
- Corrigé le problème lié aux points de terminaison de vérification de santé de l’API REST (Sophia Ruan)
Il existait des risques que, après le redémarrage de Postgres, l’état unknown soit retourné pour Postgres en raison de connexions non correctement fermées.
- Mettre en mémoire tampon les résultats de sortie (
postgres --describe-config) (Waynerv)
Ils sont utilisés pour déterminer quels paramètres GUC sont disponibles afin de valider la configuration de PostgreSQL, et nous ne prévoyons pas que cette liste change pendant l’exécution de Patroni.
Version 3.2.0
Sorti le 2023-10-25
Avis de dépréciation
- Le support
bootstrap.userssera supprimé à partir de la version 4.0.0. Si vous devez créer des utilisateurs après le déploiement d’un nouveau cluster, utilisez l’hookbootstrap.post_bootstrapà cette fin.
Modifications importantes
- Appliquer la règle
loop_wait + 2*retry_timeout <= ttlet fixer en dur les valeurs minimales possibles (Alexander Kukushkin)
Valeurs minimales : loop_wait=2, retry_timeout=3, ttl=20. Si les valeurs sont inférieures ou violent cette règle, elles sont ajustées et un avertissement est inscrit dans les journaux de Patroni.
Nouvelles fonctionnalités
- Priorité de basculement (Mark Pekala)
Avec l’aide de tags.failover_priority, il est désormais possible de rendre un nœud plus favorisé lors de la course au leader. Plus de détails dans la documentation (référence aux balises).
- Implémenté
patroni --generate-config [--dsn DSN]etpatroni --generate-sample-config(Polina Bungina)
Il permet de générer un fichier de configuration pour le cluster PostgreSQL en cours d’exécution ou un fichier de configuration exemple pour un nouveau cluster Patroni.
- Utilisez une connexion dédiée à Postgres pour l’API REST de Patroni (Alexander Kukushkin)
Cela permet d’éviter de bloquer la boucle principale de battement si le système est sous tension.
- Enrichir certains points d’accès avec le
namedu nœud (sskserk)
Pour le point de terminaison de surveillance, name est ajouté à côté de scope, et pour le point de terminaison des métriques, name est ajouté aux étiquettes.
- Veiller à la distinction stricte entre basculement et basculement planifié (Polina Bungina)
Améliorer la précision des messages de journalisation et autoriser le basculement vers un nœud asynchrone dans un cluster synchrone sain.
- Rendre les slots de réplication physique permanents compatibles avec le comportement des slots logiques permanents (Alexander Kukushkin)
Créez des slots de réplication physique permanents sur tous les nœuds pouvant devenir le leader et utilisez la fonction pg_replication_slot_advance() pour avancer restart_lsn sur les slots des nœuds de secours.
- Ajouter la capacité de spécifier un espace de noms via l’argument
--dcsdans patronictl (Israel Barth Rubio)
Il pourrait être pratique d’utiliser patronictl sans fichier de configuration.
- Ajouter la prise en charge de paramètres supplémentaires dans la configuration d’amorçage personnalisée (Israel Barth Rubio)
Précédemment, il n’était possible d’ajouter que des arguments personnalisés à command, mais on peut désormais les spécifier sous forme de mappage.
Améliorations
- Définissez la variable GUC
citus.local_hostnamesur la même valeur utilisée par Patroni pour se connecter à Postgres (Alexander Kukushkin)
Il existe des cas où Citus doit établir une connexion avec le serveur Postgres local. Par défaut, il utilise localhost, qui n’est pas toujours disponible.
Correctifs de bogues
- Ignorez le paramètre synchronous_mode dans un cluster de secours (Polina Bungina)
PostgreSQL ne prend pas en charge la réplication synchrone en cascade, et ignorer synchronous_mode entraînait une défaillance du basculement planifié dans un cluster de secours.
- Gérer SIGCHLD pour le rappel
on_reload(Alexander Kukushkin)
Ne pas le faire entraîne un processus zombie, qui n’est ramassé qu’au moment de l’exécution suivante de on_reload.
- Gérer l’erreur
AuthOldRevisionlors de l’utilisation d’etcd v3 (Alexander Kukushkin, Kenny Do)
L’erreur est levée si etcd est configuré pour utiliser JWT et que la base de données utilisateur dans etcd est mise à jour.
Version 3.1.2
Libéré le 2023-09-26
Correctifs de bogues
- Correctif d’un bogue lié aux vérifications
wal_keep_size(Alexander Kukushkin)
Le wal_keep_size est une variable GUC qui possède normalement une unité, et Patroni échouait à convertir sa valeur en int. En conséquence, la valeur de bootstrap.dcs n’a pas été écrite dans la clé /config par la suite.
- Détecter et résoudre les incohérences entre la clé
/syncetsynchronous_standby_names(Alexander Kukushkin)
Par défaut, Patroni met à jour /sync et synchronous_standby_names dans un ordre très précis, mais en cas de bug ou lorsque quelqu’un redémarre manuellement synchronous_standby_names, Patroni pouvait entrer dans un état inconsistante. En conséquence, il était possible que le basculement se produise sur un nœud asynchrone.
- Lire les valeurs des paramètres GUC lors de la connexion à une instance Postgres en cours d’exécution (Alexander Kukushkin)
Lorsqu’il est redémarré en pause
, Patroni supprimait le paramètre GUC synchronous_standby_names provenant de postgresql.conf. Pour résoudre ce problème et éviter des situations similaires, Patroni lira la valeur du GUC s’il rejoint un serveur Postgres déjà en cours d’exécution.
- Supprimé les avertissements ennuyeux lors de la vérification de l’unicité du nœud (Alexander Kukushkin)
Les messages WARNING sont générés par urllib3 si Patroni est redémarré rapidement.
Version 3.1.1
Sorti le 2023-09-20
Correctifs de bogues
- Réinitialiser l’état de sécurité sur la promotion (ChenChangAo)
Si un basculement planifié ou un basculement s’est produit peu de temps après l’activation du mode de secours, le nouveau nœud primaire s’est désélevé après la désactivation du mode de secours.
- Supprimez les avertissements inutiles dans patronictl (Alexander Kukushkin)
Si patronictl
utilise le même patroni.yaml fichier que Patroni et peut accéder au répertoire PGDATA, il se peut qu’il affiche des avertissements gênants concernant des valeurs incorrectes dans la configuration globale.
- Activer explicitement le mode synchrone dans un cas particulier (Alexander Kukushkin)
Le mode synchrone n’a effectivement jamais été activé s’il n’y a aucune réplique en cours de diffusion depuis le primaire.
- Correctif d’un bogue lié à la validation des valeurs entières
0(Israel Barth Rubio)
Dans la plupart des cas, cela n’a causé aucun problème, seulement des avertissements.
- Ne pas renvoyer les slots logiques pour le cluster de secours (Alexander Kukushkin)
Patroni ne peut pas créer de slots de réplication logique dans le cluster de secours, ces derniers doivent donc être ignorés s’ils sont définis dans la configuration globale.
- Éviter d’afficher la documentation dans la sortie de
patronictl --help(Israel Barth Rubio)
Le module click doit recevoir un indice spécial à cet effet.
- Correctif d’un bogue lié à
kubernetes.standby_leader_label_value(Alexander Kukushkin)
Cette fonctionnalité n’a jamais fonctionné de manière fiable.
- Identifiant système du cluster retourné en sortie
patronictl list(Polina Bungina)
Le problème a été introduit lors de la mise en œuvre du support de Citus, où il fallait masquer l’identifiant car il diffère entre le coordinateur et tous les workers.
- Remplacer la méthode
write_leader_optimedans l’implémentation Kubernetes (Alexander Kukushkin)
La méthode doit écrire le LSN d’arrêt sur le Endpoint/ConfigMap du leader lorsque aucune réplique saine n’est disponible pour devenir le nouveau primaire.
- Ne pas démarrer PostgreSQL arrêté en mode pause (Alexander Kukushkin)
En raison d’une condition de course, Patroni supposait à tort que le standby devait être redémarré car certains paramètres de récupération (primary_conninfo ou similaires) avaient été modifiés.
- Correctif d’un bogue dans la commande
patronictl query(Israel Barth Rubio)
Ça n’a pas fonctionné lorsque seul l’argument -m a été fourni ou lorsque ni -r ni -m n’ont été fournis.
- Traiter correctement les paramètres entiers utilisés dans la ligne de commande pour démarrer postgres (Polina Bungina)
Si les valeurs sont fournies sous forme de chaînes de caractères et non converties en entier, cela entraînait un calcul incorrect de max_prepared_transactions basé sur max_connections pour les clusters Citus.
- Ne comptez pas sur
pg_stat_wal_receiverpour déterminerpg_rewind(Alexander Kukushkin)
Il se peut que le timeline rapporté par received_tli depuis pg_stat_wal_receiver soit en avance par rapport au timeline réellement rejoué, tandis que le timeline rapporté par DENTIFY_SYSTEM via la connexion de réplication est toujours correct.
Version 3.1.0
Sorti le 2023-08-03
Modifications importantes
- Modifié le sens sémantique de
restapi.keyfileetrestapi.certfile(Alexander Kukushkin)
Précédemment, Patroni utilisait restapi.keyfile et restapi.certfile comme certificats clients en tant que mécanisme de secours si aucun paramètre de configuration respective n’était présent dans la section ctl.
Si vous avez activé la validation des certificats clients (restapi.verify_client est défini sur required), vous devez également fournir des certificats clients valides dans ctl.certfile, ctl.keyfile, ctl.keyfile_password. En l’absence de ces certificats, Patroni ne fonctionnera pas correctement.
Nouvelles fonctionnalités
- Rendre le libellé du rôle du Pod configurables (Waynerv)
Les valeurs peuvent être personnalisées à l’aide des paramètres kubernetes.leader_label_value, kubernetes.follower_label_value et kubernetes.standby_leader_label_value. Cette fonctionnalité sera particulièrement utile lorsque nous modifierons le rôle master en primary. Vous trouverez davantage d’informations sur cette fonctionnalité et les étapes de migration ici
.
Améliorations
- Diverses améliorations apportées à
patroni --validate-config(Alexander Kukushkin)
Validation améliorée des paramètres pour différents DCS, bootstrap.dcs , ctl, restapi, et watchdog
sections.
- Démarrer PostgreSQL hors mode récupération s’il s’est arrêté pendant la récupération alors que Patroni est en cours d’exécution (Alexander Kukushkin)
Il peut réduire le temps de récupération et aidera à éviter des incréments inutiles de la timeline.
- Éviter les mises à jour inutiles de la clé
/status(Alexander Kukushkin)
Lorsqu’aucune slot logique permanente n’est présente, Patroni mettait à jour /status à chaque boucle de battement de cœur, même lorsque le LSN sur le primaire ne progressait pas.
- Interdire à un primaire obsolète de remporter la course au leader (Alexander Kukushkin)
Si Patroni était en suspens pendant une durée importante en raison d’un manque de ressources, il vérifiera en outre qu’aucun autre nœud n’a promu PostgreSQL avant d’acquérir le verrou de leader.
- Affichage de la visibilité de la validation de certains paramètres PostgreSQL (Alexander Kukushkin, Feike Steenbergen)
Si la validation de max_connections, max_wal_senders, max_prepared_transactions, max_locks_per_transaction, max_replication_slots ou max_worker_processes a échoué, Patroni utilisait auparavant une valeur par défaut raisonnable. À présent, en plus de cela, un avertissement sera également affiché.
- Définir les autorisations pour les fichiers et répertoires créés dans
PGDATA(Alexander Kukushkin)
Tous les fichiers créés par Patroni avaient uniquement des permissions de lecture/écriture pour le propriétaire. Ce comportement empêchait les outils de sauvegarde s’exécutant sous un utilisateur différent et s’appuyant sur les permissions de lecture par groupe. Patroni respecte désormais les permissions sur PGDATA et définit correctement les permissions sur tous les répertoires et fichiers qu’il crée à l’intérieur de PGDATA.
Correctifs de bogues
- Exécuter
archive_commandvia le shell (Waynerv)
Patroni peut archiver certains segments WAL avant d’effectuer une récupération d’incident en mode utilisateur unique ou avant pg_rewind. Si la commande d’archivage contient des opérateurs de shell, comme &&, elle ne fonctionne pas avec Patroni.
- Corrigé les vérifications d’arrêt « en cas de basculement planifié » (Polina Bungina)
Il se peut que le candidat spécifié soit toujours en cours de diffusion et n’ait pas reçu le contrôle d’arrêt, mais que la clé du leader ait été supprimée car d’autres nœuds étaient sains.
- Corrigé la vérification « est primaire » (Alexander Kukushkin)
Pendant la course au leader, les répliques n’ont pas pu détecter que PostgreSQL sur l’ancien leader était toujours en cours d’exécution en tant que primaire.
- Corrigé
patronictl list(Alexander Kukushkin)
Le champ Nom du cluster était absent dans les formats de sortie tsv, json et yaml.
- Comportement corrigé de
pg_rewindaprès pause (Alexander Kukushkin)
Dans certains cas, Patroni n’a pas pu réintégrer le primaire faux au cluster avec pg_rewind après la sortie du mode maintenance.
- Corrigé un bogue dans l’implémentation etcd v3 (Alexander Kukushkin)
Invalider le cache KV interne si une mise à jour de clé est effectuée à l’aide des champs create_revision/mod_revision en raison d’un désaccord de révision.
- Comportement corrigé des répliques dans un cluster de secours en pause (Alexander Kukushkin)
Lorsque la clé du leader expire, les répliques du cluster de secours ne suivront plus le nœud distant, mais conserveront primary_conninfo tel quel.
Version 3.0.4
Libéré le 2023-07-13
Nouvelles fonctionnalités
- Rendre le statut de réplication des nœuds secondaires visible (Alexander Kukushkin)
Pour PostgreSQL 9.6+, Patroni signalera l’état de réplication comme streaming lorsque le nœud secondaire diffuse depuis l’autre nœud, ou comme in archive recovery lorsqu’aucune connexion de réplication n’est établie et que restore_command est défini. Cet état est visible dans les clés member du DCS, dans l’API REST et dans la sortie de patronictl list.
Améliorations
- Messages d’erreur améliorés avec etcd v3 (Alexander Kukushkin)
Lorsque le cluster etcd v3 n’est pas accessible, Patroni signale qu’il ne parvient pas à accéder aux points d’entrée /v2.
- Utilisez la lecture en quorum dans patronictl si cela est possible (Alexander Kukushkin)
Les clusters etcd ou Consul pourraient être dégradés en lecture seule, mais du point de vue de patronictl tout semblait fonctionner correctement. Ce comportement va maintenant entraîner une erreur.
- Empêcher les scénarios de split-brain dus à des noms en double dans la configuration (Mark Pekala)
Lors du démarrage, Patroni vérifie si un nœud portant le même nom est enregistré dans le DCS, puis tente de consulter son API REST. Si l’API REST est accessible, Patroni s’arrête avec une erreur. Cela permet de prévenir les erreurs humaines.
- Démarrer PostgreSQL hors mode récupération s’il s’est arrêté brutalement pendant que Patroni était en cours d’exécution (Alexander Kukushkin)
Il peut réduire le temps de récupération et éviter des incréments inutiles de la timeline.
Correctifs de bogues
- Le certificat SSL de l’API REST n’a pas été rechargé lors de la réception d’un SIGHUP (Israel Barth Rubio)
La régression a été introduite dans la version 3.0.3.
- Validation des paramètres GUC entiers fixes pour des paramètres tels que
max_connections(Feike Steenbergen)
Patroni n’acceptait pas les valeurs numériques entre guillemets. Une régression a été introduite à partir de la version 3.0.3.
- Corriger le problème lié à synchronous_mode (Alexander Kukushkin)
Exécutez txid_current() avec synchronous_commit=off afin qu’il ne patiente pas accidentellement pour des répliques synchrones absentes lorsque synchronous_mode_strict est activé.
Version 3.0.3
Libéré le 2023-06-22
Nouvelles fonctionnalités
- Compatibilité avec PostgreSQL 16 beta1 (Alexander Kukushkin)
Règles étendues de validation des paramètres GUC.
- Rendre le validateur des paramètres GUC de PostgreSQL extensible (Israel Barth Rubio)
Les règles de validation sont chargées à partir de fichiers YAML situés dans le répertoire patroni/postgresql/available_parameters/. Les fichiers sont ordonnés par ordre alphabétique et appliqués les uns après les autres. Cela permet d’associer des validateurs personnalisés aux distributions non standards de Postgres.
- Ajout de l’option
restapi.request_queue_size(Andrey Zhidenkov, Aleksei Sukhov)
Définit la taille de la file d’attente des requêtes pour la socket TCP utilisée par l’API REST de Patroni. Dès que la file est pleine, les requêtes supplémentaires reçoivent une erreur « Connection denied ». La valeur par défaut est 5.
- Appeler
initdbdirectement lors de l’initialisation d’un nouveau cluster (Matt Baker)
Précédemment, il était appelé via pg_ctl, ce qui nécessitait une mise entre guillemets particulière des paramètres passés à initdb.
- Ajouté avant le hook d’arrêt (Le Duane)
Le hook peut être configuré via postgresql.before_stop et s’exécute juste avant pg_ctl stop. Le code de sortie n’a pas d’impact sur le processus d’arrêt.
- Ajout de la prise en charge des noms personnalisés pour les binaires Postgres (Israel Barth Rubio, Polina Bungina)
Lorsqu’un déploiement Postgres personnalisé est utilisé, il se peut que les binaires Postgres soient compilés avec des noms différents de ceux utilisés par la distribution communautaire. Les noms binaires personnalisés peuvent être configurés à l’aide des variables d’environnement postgresql.bin_name.* et PATRONI_POSTGRESQL_BIN_*.
Améliorations
Plusieurs améliorations apportées à
patroni --validate-config(Polina Bungina)- Rendre
bootstrap.initdbfacultatif. Il n’est requis que pour les nouveaux clusters, maispatroni --validate-configsignalait une erreur si ce paramètre manquait dans la configuration. - Ne pas générer d’erreur lorsque
postgresql.bin_direst vide ou non défini. Essayer d’abord de localiser les binaires Postgres dans le PATH par défaut. - Rendre la section
postgresql.authentication.rewindfacultative. Si elle est absente, Patroni utilise le superutilisateur.
- Rendre
Rapport d’erreurs amélioré dans patronictl (Israel Barth Rubio)
Le symbole \n a été affiché tel quel, au lieu du symbole de saut de ligne réel.
Correctifs de bogues
- Correctif apporté à la prise en charge de Citus (Alexander Kukushkin)
Si l’appel à l’API REST effectué par le worker promu vers le coordinateur échoue pendant un basculement planifié, le groupe Citus donné reste bloqué pendant une durée indéfinie.
- Autoriser l’URL
etcd3dans l’option--dcs-urlde patronictl (Israel Barth Rubio)
Si les utilisateurs tentaient de passer une URL etcd3 via l’option --dcs-url de patronictl
, ils rencontreraient une exception.
Version 3.0.2
Libéré le 2023-03-24
La version 3.0.2 a cessé de prendre en charge les versions de Python antérieures à 3.6.
Nouvelles fonctionnalités
- Ajout de l’état de réplique synchronisée à l’endpoint
/metrics(Thomas von Dein, Alexander Kukushkin)
Avant, seul le rapport primary/standby_leader/replica était effectué.
- Gestion conviviale de
PAGERdans patronictl (Israel Barth Rubio)
Il rend le pageur configurable via la variable d’environnement PAGER, qui remplace less et more par défaut.
- Rendre le code d’état HTTP réessayable configurable dans K8s (Alexander Kukushkin)
Sur certaines plates-formes gérées, il est possible d’obtenir le code d’état 401 Unauthorized, qui est parfois résolu après quelques tentatives supplémentaires.
Améliorations
- Définir
hot_standbysuroffuniquement pendant l’amorçage personnalisé sirecovery_target_actionest défini surpromote(Alexander Kukushkin)
Il était nécessaire de faire fonctionner recovery_target_action=pause correctement.
- Interdire au rappel
on_reloadde tuer d’autres rappels (Alexander Kukushkin)
on_start/on_stop/on_role_change sont généralement utilisés pour ajouter/supprimer une adresse IP virtuelle, et on_reload ne doit pas y interférer.
- Passé à
IMDSFetcherdans l’exemple de script de rappel AWS (Polina Bungina)
Le IMDSv2 nécessite un jeton pour fonctionner, et le IMDSFetcher le gère de manière transparente.
Correctifs de bogues
- Correctif apporté à
patronictl switchoversur un cluster Citus exécutant sur Kubernetes (Lukáš Lalinský)
Ça n’a pas fonctionné pour les espaces de noms différents de default.
- N’écrivez pas dans
PGDATAsi la version majeure n’est pas connue (Alexander Kukushkin)
Si immédiatement après le démarrage, PGDATA était vide (peut-être pas encore monté), Patroni effectuait une supposition erronée sur la version de PostgreSQL et créait de façon erronée le fichier recovery.conf, même si la version majeure réelle est v10+.
- Correction d’un bug lié aux métadonnées Citus après un basculement du coordinateur (Alexander Kukushkin)
L’appel citus_set_coordinator_host() ne provoque pas de synchronisation des métadonnées et le changement est resté invisible sur les nœuds worker. Ce problème est résolu en passant à citus_update_node().
- Utilisez les hôtes etcd répertoriés dans le fichier de configuration comme sauvegarde lorsque tous les nœuds etcd sont “défaillants” (Alexander Kukushkin)
Le cluster etcd peut modifier sa topologie au fil du temps, et Patroni tente de la suivre. Si, à un moment donné, tous les nœuds deviennent inaccessibles, Patroni utilisera une combinaison de nœuds provenant de la configuration, ainsi que de la dernière topologie connue, lorsqu’il tentera de se reconnecter.
Version 3.0.1
Libéré le 2023-02-16
Correctifs de bogues
- Passez le nom de rôle approprié à un script de rappel
on_role_change. (Alexander Kukushkin, Polina Bungina)
Patroni avait précédemment transmis incorrectement le rôle promoted à un script de rappel on_role_change lors d’une promotion. Le nom du rôle transmis a été rétabli à master. Cette régression a été introduite dans la version 3.0.0.
Version 3.0.0
Sorti le 2023-01-30
Cette version ajoute une intégration avec Citus et permet de résister aux interruptions temporaires du DCS sans dégrader le rôle de primaire.
La version 3.0.0 est la dernière version à supporter Python 2.7. La prochaine version supprimera le support des versions de Python antérieures à 3.7.
Le support RAFT est obsolète. Nous ferons notre possible pour le maintenir, mais nous ne garantissons ni ne prenons de responsabilité quant aux éventuels problèmes.
Cette version marque la première étape vers l’élimination du terme « master » au profit de « primary ». La mise à niveau vers la prochaine version majeure fonctionnera de manière fiable uniquement si vous exécutez au moins la version 3.0.0.
Nouvelles fonctionnalités
- Mode de secours DCS (Alexander Kukushkin, Polina Bungina)
Si la fonctionnalité est activée, elle permet au cluster Patroni de résister aux interruptions temporaires du DCS. Vous trouverez plus de détails dans la documentation .
- Prise en charge Citus (Alexander Kukushkin, Polina Bungina, Jelte Fennema)
Patroni permet un déploiement et une gestion simplifiés des clusters Citus hautement disponibles. Veuillez consulter la page here pour plus d’informations.
Améliorations
- Supprimer les erreurs récurrentes lors de la suppression de slots de réplication inconnus mais actifs (Michael Banck)
Patroni continuera d’écrire ces journaux, mais uniquement en mode DEBUG.
- Exécuter une seule requête de surveillance par boucle HA (Alexander Kukushkin)
Ce n’était pas le cas si la réplication synchrone est activée.
- Conserver uniquement le répertoire de données échoué le plus récent (William Albertus Dembo)
Si l’amorçage a échoué, Patroni renommait précédemment le dossier $PGDATA en y ajoutant un suffixe horodaté. Désormais, ce suffixe sera .failed et, si un tel dossier existe, il sera supprimé avant le renommage.
- Amélioration de la vérification des connexions de réplication synchrone (Alexander Kukushkin)
Lorsque le nouvel hôte est ajouté à synchronous_standby_names, il sera configuré en mode synchrone dans le DCS uniquement lorsqu’il aura rattrapé le primaire, en plus de pg_stat_replication.sync_state = 'sync'.
Fonctionnalité supprimée
- Supprimer
patronictl scaffold(Alexander Kukushkin)
La seule raison de sa présence était une méthode expéditive pour exécuter des clusters de secours.
Version 2.1.7
Sorti le 2023-01-04
Correctifs de bogues
- Corrigé de petites incompatibilités avec les modules Python hérités (Alexander Kukushkin)
Ils empêchaient la compilation ou l’exécution de Patroni sur Debian buster/Ubuntu bionic.
Version 2.1.6
Sorti le 2022-12-30
Améliorations
- Corriger les exceptions gênantes lors de la fermeture du socket SSL (Alexander Kukushkin)
HAProxy ferme les connexions dès qu’il reçoit le code d’état HTTP, ne laissant aucune chance à Patroni de fermer correctement la connexion SSL.
- Ajuster l’exemple de Dockerfile pour arm64 (Polina Bungina)
Supprimez explicitement amd64 et x86_64, ne supprimez pas libnss_files.so.*.
Améliorations de sécurité
- Forcer
search_path=pg_catalogpour les connexions non répliquées (Alexander Kukushkin)
Étant donné que Patroni dépend fortement des connexions en tant qu’utilisateur superutilisateur, nous souhaitons le protéger contre les attaques potentielles menées à l’aide de fonctions définies par l’utilisateur et/ou d’opérateurs dans le schéma public ayant le même nom et la même signature que les objets correspondants dans pg_catalog. Pour cela, search_path=pg_catalog est imposé pour toutes les connexions établies par Patroni (sauf les connexions de réplication).
- Empêcher la sauvegarde des mots de passe dans
pg_stat_statements(Feike Steenbergen)
Cela est réalisé en définissant pg_stat_statements.track_utility=off lors de la création des utilisateurs.
Correctifs de bogues
- Déclarer
proxy_addresscomme facultatif (Denis Laxalde)
Comme il s’agit en réalité d’une option non obligatoire.
- Améliorer le comportement de l’option non sécurisée (Alexander Kukushkin)
L’option insecure de Ctl ne fonctionnait pas correctement lorsque des certificats clients étaient utilisés pour les requêtes de l’API REST.
- Prendre la configuration du watchdog depuis
bootstrap.dcslors de l’amorçage du nouveau cluster (Matt Baker)
Patroni configurait initialement le watchdog avec les valeurs par défaut lors de l’amorçage d’un nouveau cluster, plutôt que d’utiliser la configuration utilisée pour amorcer le DCS.
- Corriger le traitement des extensions de fichier lors de la recherche d’exécutables dans WIN32 (Martín Marqués)
Ajoutez .exe au nom de fichier uniquement s’il ne possède pas d’extension.
- Correction de la configuration du TTL de Consul (Alexander Kukushkin)
Nous avons utilisé ttl/2.0 lors de la définition de la valeur sur HTTPClient, mais oublié de multiplier la valeur actuelle par 2 dans la propriété de la classe. Cela entraînait un décalage du TTL Consul de deux fois.
Fonctionnalité supprimée
- Supprimer
patronictl configure(Polina Bungina)
Il n’est plus nécessaire de créer séparément une configuration patronictl .
Version 2.1.5
Libéré le 2022-11-28
Cette version améliore la compatibilité avec PostgreSQL 15 et déclare la prise en charge d’etcd v3 comme prête pour la production. Patroni sur Raft reste en version Bêta.
Nouvelles fonctionnalités
- Améliorer
patroni --validate-config(Denis Laxalde)
Quitter avec le code 1 si la configuration est invalide et afficher les erreurs sur stderr.
- Ne supprimez pas les slots de réplication en mode pause (Alexander Kukushkin)
Patroni crée automatiquement ou supprime des slots de réplication physique lorsque les membres rejoignent ou quittent le cluster. En mode pause, les slots ne seront plus supprimés.
- Prise en charge de la méthode de requête
HEADpour les points de terminaison de surveillance (Robert Cutajar)
Si utilisé à la place de GET, Patroni ne renverra que le code d’état HTTP.
- Prise en charge des tests comportementaux sur Windows () (Alexander Kukushkin)
Émuler l’arrêt gracieux de Patroni (SIGTERM) sous Windows en introduisant le nouvel endpoint d’API REST POST /sigterm.
- Présentation de
postgresql.proxy_address(Alexander Kukushkin)
Il sera écrit dans la clé du membre du DCS sous la forme de proxy_url et pourra être utilisé utilement pour la découverte de service.
Améliorations de stabilité
- Appeler
pg_replication_slot_advance()depuis un thread (Alexander Kukushkin)
Sur les clusters chargés disposant de nombreux slots de réplication logique, l’appel pg_replication_slot_advance() affectait la boucle principale de haute disponibilité et pouvait entraîner l’expiration de la clé du membre.
- Archivage pouvant manquer des WALs avant d’appeler
pg_rewindsur le primaire ancien (Polina Bungina)
Si le primaire a cessé de fonctionner et est resté hors ligne pendant une durée importante, certains fichiers WAL pourraient manquer à l’archive ainsi qu’au nouveau primaire. Il existe un risque que pg_rewind supprime ces fichiers WAL depuis l’ancien primaire, rendant impossible son démarrage en tant que réplica. En archivant les fichiers WAL ready, nous atténuons non seulement ce problème, mais améliorons également l’expérience d’archivage continu en général.
- Ignorer les erreurs
403lors de la création du service Kubernetes (Nick Hudson, Polina Bungina)
Patroni envoyait en continu des messages de journalisation à cause d’essais infructueux de création du service, qui pouvait déjà exister.
- Améliorer l’enquête de disponibilité (Alexander Kukushkin)
Le problème de vivacité commencera à échouer si la boucle de battement de cœur s’exécute plus longtemps que ttl sur le serveur primaire ou 2\*ttl sur la réplique. Cela nous permettra de l’utiliser comme alternative au watchdog
sur Kubernetes.
- Assurez-vous qu’uniquement le nœud synchronisé tente d’acquérir le verrou lors d’un basculement planifié (Alexander Kukushkin, Polina Bungina)
Précédemment, il existait une faible probabilité qu’un membre asynchrone à jour devienne leader si un basculement planifié était effectué sans spécifier de cible.
- Éviter la duplication pendant l’amorçage (Ants Aasma)
N’autorisez pas de méthode de création de réplique qui ne nécessite pas de leader lors de l’amorçage du cluster.
- Compatibilité avec kazoo-2.9.0 (Alexander Kukushkin)
Selon la version de Python, la méthode SequentialThreadingHandler.select() peut lever les exceptions TypeError et IOError si select() est appelée sur une socket fermée.
- Arrêter explicitement la connexion SSL avant la fermeture du socket (Alexander Kukushkin)
Ne pas le faire a entraîné des erreurs unexpected eof while reading avec OpenSSL 3.0.
- Compatibilité avec
prettytable\>=2.2.0(Alexander Kukushkin)
En raison de modifications de l’API interne, l’en-tête du nom du cluster était affiché sur la mauvaise ligne.
Correctifs de bogues
- Gérer le jeton expiré pour l’acquisition de bail etcd (monsterxx03)
En cas d’erreur, obtenez un nouveau jeton et réessayez la requête.
- Corriger un bogue dans le point d’accès
GET /read-only-sync(Alexander Kukushkin)
Il a été introduit dans la version précédente et n’a jamais fonctionné correctement.
- Gérer le cas où le stockage du répertoire de données a disparu (Alexander Kukushkin)
Patroni vérifie périodiquement la présence et la non-vacuité du répertoire PGDATA, mais en cas de problème de stockage, os.listdir() lève l’exception OSError, interrompant ainsi la boucle de cœur.
- Appliquer
master_stop_timeouten attendant que les clients utilisateurs se ferment (Alexander Kukushkin)
Quelque chose qui ressemble à un backend utilisateur pourrait en réalité être un worker en arrière-plan (par exemple, le démon de maintenance Citus) qui échoue à s’arrêter.
- Accepter
*:<port>pourpostgresql.listen(Denis Laxalde)
Le patroni --validate-config se plaignait de son invalidité.
- Délais d’attente fixes dans Raft (Alexander Kukushkin)
Lorsque Patroni ou patronictl démarrent, ils tentent d’obtenir la topologie du cluster Raft à partir des membres connus. Ces appels étaient effectués sans délais d’attente appropriés.
- Mettre à jour de force le service Consul si le jeton a été modifié (John A. Lotoski)
Ne pas le faire entraîne des erreurs « rpc error making call: rpc error making call: ACL not found ».
Version 2.1.4
Sorti le 2022-06-01
Nouvelles fonctionnalités
- Améliorer le comportement de
pg_rewindsur les systèmes Debian/Ubuntu classiques (Gunnar “Nick” Bluth)
Dans les installations PostgreSQL qui situent postgresql.conf en dehors du répertoire de données (par exemple, les paquets Ubuntu/Debian), pg_rewind --restore-target-wal échoue à déterminer la valeur du champ restore_command.
- Autoriser la définition de
TLSServerNamedans les vérifications de service Consul (Michael Gmelin)
Utile lorsque les vérifications sont effectuées par adresse IP et que le Consul node_name n’est pas un nom complet.
- Ajout de la prise en charge de
ppc64ledans le watchdog (Jean-Michel Scheiwiler)
Et correction de la prise en charge du watchdog sur certaines plates-formes non-x86.
- Passé le rappel aws.py de
botoàboto3(Alexander Kukushkin)
boto2.x est abandonné depuis 2018 et échoue avec Python 3.9.
- Actualiser périodiquement le jeton du compte de service sur K8s (Haitao Li)
Depuis la version Kubernetes v1.21, les jetons de compte de service expirent au bout de 1 heure.
- Ajout du point de terminaison de surveillance
/read-only-sync(Dennis4b)
Il est similaire à /read-only mais inclut uniquement les répliques synchrones.
Améliorations de stabilité
- Ne copiez pas l’espace de réplication logique vers une réplique si une incompatibilité de configuration est détectée dans la configuration de décodage logique avec le serveur primaire (Alexander Kukushkin)
Une réplique ne copiera plus une borne de réplication logique depuis le serveur primaire si cette borne ne correspond pas aux options de configuration plugin ou database. Auparavant, la vérification de correspondance avec ces options de configuration n’était pas effectuée avant que la réplique n’ait copié la borne et ne l’ait commencée, ce qui entraînait des redémarrages inutiles et répétés.
- Traitement particulier des paramètres de configuration de récupération pour PostgreSQL v12+ (Alexander Kukushkin)
Lors du démarrage en tant que réplique, Patroni doit pouvoir mettre à jour postgresql.conf et redémarrer/recharger si l’adresse du leader a changé, en conservant les valeurs actuelles des paramètres au lieu de les interroger auprès de pg_settings.
- Meilleure gestion des adresses IPv6 dans les paramètres
postgresql.listen(Alexander Kukushkin)
Étant donné que le paramètre listen comporte un port, les utilisateurs tentent de placer des adresses IPv6 entre crochets, ce qui n’est pas correctement supprimé lorsque la liste contient plus d’une adresse.
- Utilisez les identifiants
replicationuniquement lors de la vérification de divergence sur PostgreSQL v10 et les versions antérieures (Alexander Kukushkin)
Si rewind est activé, Patroni utilisera à nouveau les identifiants superuser ou rewind sur les versions récentes de Postgres.
Correctifs de bogues
- Corrigé l’importation manquante de
dateutil.parser(Wesley Mendes)
Les tests ne plantaient pas uniquement parce qu’ils étaient également importés depuis d’autres modules.
- Vérifiez que l’annotation
optimeest une chaîne de caractères (Sebastian Hasler)
Dans certains cas, Patroni tentait de le passer comme une valeur numérique.
- Meilleure gestion de l’échec de tentative
pg_rewind(Alexander Kukushkin)
Si le primaire devient indisponible pendant pg_rewind, $PGDATA sera laissé dans un état corrompu. À ce stade, Patroni supprimera le répertoire de données, même si cette action n’est pas autorisée par la configuration.
- Ne supprimez pas les annotations
slotsdu leaderConfigMap/Endpointlorsque PostgreSQL n’est pas prêt (Alexander Kukushkin)
Si la valeur slots n’est pas fournie, l’annotation conserve la valeur actuelle.
- Gérer le problème de concurrence avec les observateurs API Kubernetes (Alexander Kukushkin)
Dans certains cas (inconnus), les observateurs pourraient devenir obsolètes ; en conséquence, la méthode attempt_to_acquire_leader() pourrait échouer en raison du code d’état HTTP 409. Dans ce cas, nous réinitialisons les connexions des observateurs et recommençons depuis le début.
Version 2.1.3
Sorti le 2022-02-18
Nouvelles fonctionnalités
- Ajout du support des clés TLS chiffrées pour patronictl (Alexander Kukushkin)
Il peut être configuré via la variable d’environnement ctl.keyfile_password ou la variable d’environnement PATRONI_CTL_KEYFILE_PASSWORD.
- Ajout de métriques supplémentaires à l’endpoint /metrics (Alexandre Pereira)
Spécifiquement, patroni_pending_restart et patroni_is_paused.
- Permettre de spécifier plusieurs hôtes dans la configuration du cluster de secours (Michael Banck)
Si le cluster de secours est en réplication depuis le cluster Patroni, il peut être utile de s’appuyer sur le basculement côté client, disponible dans libpq depuis PostgreSQL v10. Cela consiste à utiliser primary_conninfo sur le leader du cluster de secours et le paramètre pg_rewind dans la chaîne de connexion avec target_session_attrs=read-write. Le fichier pgpass sera généré avec plusieurs lignes (une ligne par hôte), et au lieu d’appeler CHECKPOINT sur les nœuds du cluster primaire, le cluster de secours attendra que pg_control soit mis à jour.
Améliorations de stabilité
- Compatibilité avec les versions anciennes de
psycopg2(Alexander Kukushkin)
Par exemple, le psycopg2 installé à partir des paquets Ubuntu 18.04 ne possède pas encore l’exception UndefinedFile.
- Redémarrez le surveillant
etcd3si aucun nœud etcd ne répond (Alexander Kukushkin)
Si le watcher est actif, la méthode get_cluster() continue de renvoyer des informations périmées, même si tous les nœuds etcd échouent.
- Ne supprimez pas le verrou du leader dans le cluster de secours pendant la mise en pause (Alexander Kukushkin)
Précédemment, le verrou était maintenu uniquement par le nœud en cours d’exécution en tant que leader primaire et non en tant que leader de secours.
Correctifs de bogues
- Correctif d’un bogue dans l’amorçage du leader de secours (Alexander Kukushkin)
Patroni considérait l’amorçage comme échoué si PostgreSQL ne recevait pas de connexions après 60 secondes. Ce bug a été introduit dans la version 2.1.2.
- Correctif d’un bug lié au basculement vers un serveur secondaire en cascade (Alexander Kukushkin)
Lors de la détermination des emplacements à créer sur une instance de basculement en cascade, nous avons oublié de tenir compte du fait que le leader pourrait être absent.
- Corrigé de petits problèmes dans le validateur de configuration de Postgres (Alexander Kukushkin)
Les paramètres entiers introduits dans PostgreSQL v14 échouaient à être validés car les valeurs min et max étaient entre guillemets dans le validator.py
- Utiliser les identifiants de réplication lors de la vérification de l’état de leader (Alexander Kukushkin)
Il se peut que remove_data_directory_on_diverged_timelines soit défini, mais que rewind_credentials ne soit pas défini et que l’accès en superutilisateur entre les nœuds ne soit pas autorisé.
- Corrigé l’erreur « port en cours d’utilisation » lors du remplacement du certificat de l’API REST (Ants Aasma)
Lors du changement de certificats, une condition de course existait avec une requête API concurrente. Si une requête est active pendant la période de remplacement, la substitution échoue avec une erreur « port en cours d’utilisation » et Patroni se retrouve bloqué dans un état sans serveur API actif.
- Corrigé un bug lors de l’amorçage du cluster si les mots de passe contiennent des caractères
%(Bastien Wirtz)
La méthode d’amorçage exécute le bloc DO, avec tous les paramètres correctement cités, mais la méthode cursor.execute() n’apprécie pas une liste vide lorsque des paramètres sont passés.
- Corrigé l’exception « AttributeError : aucun attribut ’leader’ » (Hrvoje Milković)
Cela peut survenir si le mode synchrone est activé et que le contenu DCS a été effacé.
- Corriger le bogue dans la vérification du timeline de divergence (Alexander Kukushkin)
Patroni supposait à tort que les timelines avaient divergé. Cela n’avait pas d’impact pour pg_rewind, mais si pg_rewind n’est pas autorisé et que remove_data_directory_on_diverged_timelines est défini, cela a entraîné une réinitialisation du précédent leader.
Version 2.1.2
Sorti le 2021-12-03
Nouvelles fonctionnalités
- Compatibilité avec
psycopg>=3.0(Alexander Kukushkin)
Par défaut, psycopg2 est privilégié. psycopg\>=3.0 est utilisé uniquement si psycopg2 n’est pas disponible ou si sa version est trop ancienne.
- Ajouter le champ
dcs_last_seenà l’API REST (Michael Banck)
Ce champ indique la dernière heure (en époque Unix) à laquelle un membre du cluster a communiqué avec succès avec le DCS. Cela permet d’identifier et/ou d’analyser les partitions réseau.
- Libérer le verrou de leader lorsque
pg_controldatasignale « shut down » (Alexander Kukushkin)
Pour résoudre le problème de basculement planifié ou d’arrêt lent lorsque archive_command est lent ou défaillant, Patroni supprimera immédiatement la clé leader après que pg_controldata aura signalé que PGDATA est shut down de manière propre et qu’il aura vérifié qu’au moins une réplique a reçu toutes les modifications. Si aucune réplique ne remplit cette condition, la clé leader n’est pas supprimée et le comportement précédent est conservé, c’est-à-dire que Patroni continuera à mettre à jour le verrou.
- Ajouter la prise en charge du paramètre de connexion
sslcrldir(Kostiantyn Nemchenko)
Le paramètre de connexion nouvellement introduit est disponible à partir de PostgreSQL v14.
- Autoriser la définition de listes de contrôle d’accès (ACL) pour les ZNodes dans Zookeeper (Alwyn Davis)
Introduisez une nouvelle option de configuration zookeeper.set_acls afin que Kazoo applique une liste de contrôle d’accès par défaut à chaque ZNode qu’il crée.
Améliorations de stabilité
- Reporte l’essai suivant de récupération jusqu’à la prochaine boucle HA (Alexander Kukushkin)
Si PostgreSQL s’est arrêté de manière inattendue en raison d’un espace disque insuffisant (par exemple), et qu’il ne parvient pas à démarrer, Patroni tente de le récupérer de manière trop impétueuse, ce qui provoque une surcharge des journaux.
- Ajouter un journal avant la dépromotion, qui peut prendre un certain temps (Michael Banck)
La mise à jour de niveau peut prendre un certain temps, et il n’est pas toujours évident, en consultant les journaux, ce qui se passe réellement.
- Améliorer les messages d’état « Je suis » (Michael Banck)
no action. I am a secondary ({0}) vs no action. I am ({0}), a secondary
Conversion en entier
wal_keep_segmentslors de la conversion enwal_keep_size(Jorge Solórzano)Il est possible de définir
wal_keep_segmentssous forme de chaîne dans la configuration dynamique globale. Python étant un langage à typage dynamique, la chaîne était simplement multipliée. Par exemple,wal_keep_segments: "100"était converti en100100100100100100100100100100100100100100100100MB.Autoriser le basculement planifié uniquement vers des nœuds synchrones lorsque la réplication synchrone est activée (Alexander Kukushkin)
En outre, le leader ne doit concourir qu’avec des nœuds synchrones connus.
- Utiliser le rôle mis en mémoire tampon comme solution de secours lorsque Postgres est lent (Alexander Kukushkin)
Dans certains cas extrêmes, PostgreSQL pourrait être tellement lent que la requête normale de surveillance ne s’achève pas en quelques secondes. Une gestion incorrecte de l’exception statement_timeout pourrait entraîner une situation où PostgreSQL n’est pas désélu en temps voulu lorsque la clé leader expire ou en cas d’échec de mise à jour. En cas d’une telle exception, Patroni utilisera le cache role pour déterminer si PostgreSQL est en cours d’exécution en tant que primaire.
- Éviter les mises à jour inutiles du ZNode membre (Alexander Kukushkin)
Si aucune valeur n’a changé dans les données des membres, la mise à jour ne doit pas avoir lieu.
- Optimiser le point de contrôle après promotion (Alexander Kukushkin)
Évitez d’exécuter CHECKPOINT si la dernière timeline est déjà stockée dans pg_control. Cela permet d’éviter des CHECKPOINT inutiles juste après l’initialisation du nouveau cluster avec initdb.
- Privilégier les membres sans
nofailoverlors du choix des nœuds de synchronisation (Alexander Kukushkin)
Précédemment, les nœuds synchrones étaient sélectionnés uniquement en fonction du retard de réplication, ce qui signifiait que le nœud portant l’étiquette nofailover avait les mêmes chances de devenir synchrone qu’un autre nœud. Ce comportement était à la fois ambigu et dangereux, car en cas de défaillance du primaire, le basculement ne pouvait pas avoir lieu automatiquement.
- Supprimer les hôtes en double du cache machine etcd (Michael Banck)
Les URL clientes annoncées dans le cluster etcd pourraient être mal configurées. Supprimer les doublons dans Patroni dans ce cas constitue une amélioration facile à mettre en œuvre.
Correctifs de bogues
- Ignorer les slots de réplication temporaires lors de la gestion des slots (Alexander Kukushkin)
À compter de la version 10, pg_basebackup crée une slot de réplication temporaire pour le streaming WAL, et Patroni tentait de la supprimer car le nom de la slot semblait inconnu. Pour résoudre ce problème, nous ignorons toutes les slots temporaires lors de la requête de la vue pg_stat_replication_slots.
- Assurez-vous que
pg_replication_slot_advance()n’expire pas (Alexander Kukushkin)
Patroni utilisait le statement_timeout par défaut dans ce cas, et une fois l’appel échoué, les chances de récupération sont très faibles, ce qui entraîne une augmentation de la taille de la bloat de pg_wal et pg_catalog.
- Le
/statusn’a pas été mis à jour lors de la désactivation (Alexander Kukushkin)
Après la désactivation du leader PostgreSQL, l’ancien leader met à jour le dernier LSN dans le DCS. À compter de 2.1.0, la nouvelle clé /status a été introduite, mais l’optime a continué à être écrit dans /optime/leader.
- Gérer les exceptions DCS lors de la désactivation (Alexander Kukushkin)
Lors de la désactivation du maître en raison d’une impossibilité à mettre à jour le verrou leader, il se peut que le DCS tombe complètement et que l’appel à get_cluster() lève une exception. En l’absence d’un traitement approprié, cela entraîne l’arrêt prolongé de Postgres jusqu’à la récupération du DCS.
- Le
use_unix_socket_replne fonctionne pas dans certains cas (Alexander Kukushkin)
Spécifiquement, si postgresql.unix_socket_directories n’est pas défini. Dans ce cas, Patroni doit utiliser la valeur par défaut de libpq.
- Corriger quelques problèmes liés à l’API REST de Patroni (Alexander Kukushkin)
Le champ clusters_unlocked peut parfois ne pas être défini, ce qui entraîne des exceptions dans le point de terminaison GET /metrics. En outre, la méthode de gestion des erreurs supposait que le tuple connect_address possédait toujours deux éléments, alors qu’il peut en contenir davantage en cas d’adresse IPv6.
- Attendez que le nœud nouvellement promu ait terminé la récupération avant de décider de l’annuler (Alexander Kukushkin)
La promotion effective peut prendre un certain temps, ainsi que la création de la nouvelle timeline. En l’absence d’attente, les répliques pourraient en venir à la conclusion qu’un retour en arrière n’est pas nécessaire.
- Gérer les timelines manquantes dans un fichier d’historique lors de la décision de retourner en arrière (Alexander Kukushkin)
Si la ligne temporelle de la réplique actuelle est absente du fichier d’historique sur le serveur primaire, la réplique supposait à tort qu’un rewind n’était pas nécessaire.
Version 2.1.1
Sorti le 2021-08-19
Nouvelles fonctionnalités
- Prise en charge du suffixe de nom SRV etcd (David Pavlicek)
etcd permet de distinguer plusieurs clusters etcd situés sous le même domaine, et Patroni le prend désormais en charge.
- Enrichir l’historique avec le nouveau leader (huiyalin525)
Il ajoute la nouvelle colonne à la sortie patronictl history.
- Rendre le bundle CA configurables pour la configuration Kubernetes intra-cluster (Aron Parsons)
Par défaut, Patroni utilise /var/run/secrets/kubernetes.io/serviceaccount/ca.crt et cette nouvelle fonctionnalité permet de spécifier un kubernetes.cacert personnalisé.
- Prise en charge de l’inscription/désinscription dynamique en tant que service Consul et du changement d’étiquettes (Tommy Li)
Un redémarrage de Patroni était auparavant nécessaire.
Correctifs de bogues
- Éviter un rechargement inutile de l’API REST (Alexander Kukushkin)
La version précédente a ajouté la fonctionnalité de recharger les certificats de l’API REST en cas de modification sur le disque. Malheureusement, le rechargement s’effectuait de manière inconditionnelle juste après le démarrage.
- Ne pas résoudre les membres du cluster lorsque
etcd.use_proxiesest défini (Alexander Kukushkin)
Lors du démarrage, Patroni vérifie l’état du cluster etcd en interrogeant la liste des membres. En outre, il tente également de résoudre les noms d’hôte, ce qui n’est pas nécessaire lors de l’utilisation d’etcd via un proxy et provoquait des avertissements inutiles.
- Ignorer les lignes comportant des valeurs NULL dans
pg_stat_replication(Alexander Kukushkin)
Il semble que la vue pg_stat_replication puisse contenir des valeurs NULL dans les champs replay_lsn, flush_lsn ou write_lsn même lorsque state = 'streaming' est défini.
Version 2.1.0
Publié le 2021-07-06
Cette version ajoute la compatibilité avec PostgreSQL v14, permet aux slots de réplication logique de persister lors d’un basculement ou d’un basculement planifié, implémente le support de la liste autorisée pour l’API REST, et réduit le nombre de journaux à une seule ligne par battement de cœur.
Nouvelles fonctionnalités
- Compatibilité avec PostgreSQL v14 (Alexander Kukushkin)
Reprendre la lecture du WAL si Patroni n’est pas en mode « pause » lui-même. Il pourrait être en « pause » en raison d’un changement de certains paramètres, par exemple max_connections sur le primaire.
- Basculement des slots logiques (Alexander Kukushkin)
Activer la persistance des slots de réplication logique lors d’un basculement ou d’un basculement planifié sur PostgreSQL v11+. Le slot de réplication est copié depuis le serveur primaire vers la réplique, puis la fonction pg_replication_slot_advance() est utilisée pour le faire avancer après redémarrage. En conséquence, le slot existe déjà avant le basculement, ce qui empêche la perte d’événements, mais il existe une possibilité que certains événements soient livrés plus d’une fois.
- Liste blanche implémentée pour l’API REST de Patroni (Alexander Kukushkin)
Si configuré, seules les adresses IP correspondant aux règles seront autorisées à appeler les points de terminaison non sécurisés. En outre, il est possible d’inclure automatiquement les adresses IP des membres du cluster dans la liste.
- Ajout du support des connexions de réplication via socket Unix (Mohamad El-Rifai)
Précédemment, Patroni utilisait toujours TCP pour la connexion de réplication, ce qui pouvait entraîner certains problèmes avec la vérification SSL. L’utilisation de sockets Unix permet d’exempter l’utilisateur de réplication de la vérification SSL.
- Vérification de santé sur les balises définies par l’utilisateur (Arman Jafari Tehrani)
En plus des balises prédéfinies : , il est possible de spécifier un nombre quelconque de balises personnalisées, visibles dans la sortie patronictl list et dans l’API REST. À partir de maintenant, il est possible d’utiliser des balises personnalisées dans les vérifications de santé.
- Ajouté le point de terminaison Prometheus
/metrics(Mark Mercado, Michael Banck)
Le point de terminaison exposant les mêmes métriques que /patroni.
- Réduction de la quantité de messages dans les journaux de Patroni (Alexander Kukushkin)
Lorsque tout fonctionne normalement, une seule ligne est écrite à chaque exécution de la boucle HA.
Modifications importantes
- La fonctionnalité
permanent logical replication slotsancienne ne fonctionnera plus avec PostgreSQL v10 et les versions antérieures (Alexander Kukushkin)
La stratégie de création des slots logiques après une promotion ne garantit pas qu’aucun événement logique ne soit perdu et est donc désactivée.
- Le point de terminaison
/leaderrenvoie toujours 200 si le nœud détient le verrou (Alexander Kukushkin)
Promouvoir le cluster de secours nécessite de mettre à jour les contrôles de santé du chargeur de trafic, ce qui n’est pas très pratique et facile à oublier. Pour y remédier, nous modifions le comportement de l’endpoint de contrôle de santé /leader. Il renverra désormais 200, indépendamment de l’état normal du cluster ou de la présence du standby_cluster
.
Améliorations apportées au support Raft
- Prise en charge fiable du chiffrement du trafic Raft (Alexander Kukushkin)
En raison des différents problèmes liés à PySyncObj, le support du chiffrement était très instable
- Gérer les problèmes de DNS dans l’implémentation Raft (Alexander Kukushkin)
Si self_addr et/ou partner_addrs sont configurés à l’aide du nom DNS au lieu des adresses IP, PySyncObj effectuait uniquement une résolution au moment de la création de l’objet. Cela provoquait des problèmes lorsque le même nœud revenait en ligne avec une adresse IP différente.
Améliorations de stabilité
- Compatibilité avec
psycopg2-2.9+(Alexander Kukushkin)
Dans psycopg2, le autocommit = True est ignoré dans le bloc with connection, ce qui interrompt les connexions du protocole de réplication.
- Corriger les boucles HA excessives avec Zookeeper (Alexander Kukushkin)
La mise à jour des ZNodes des membres provoquait une réaction en chaîne, entraînant l’exécution multiple consécutive des boucles HA.
- Recharger si le certificat de l’API REST est modifié sur le disque (Michael Todorovic)
Si le fichier de certificat de l’API REST a été mis à jour in situ, Patroni n’a pas effectué de rechargement.
- Ne pas créer le répertoire pgpass si l’authentification Kerberos est utilisée (Kostiantyn Nemchenko)
L’authentification Kerberos et l’authentification par mot de passe sont mutuellement exclusives.
- Corrigé de petits problèmes liés à l’amorçage personnalisé (Alexander Kukushkin)
Démarrez PostgreSQL avec hot_standby=off uniquement lors d’une restauration point-in-time (PITR), puis redémarrez-le après la fin de la restauration.
Correctifs de bogues
- Compatibilité avec
kazoo-2.7+(Alexander Kukushkin)
Étant donné que Patroni gère lui-même les nouvelles tentatives, il dépend du comportement ancien de kazoo selon lequel les requêtes adressées à un cluster Zookeeper sont immédiatement rejetées lorsque aucune connexion n’est disponible.
- Demander explicitement la version du cluster etcd v3 lorsque l’on sait qu’on se connecte via un proxy (Alexander Kukushkin)
Patroni fonctionne avec un cluster etcd v3 via un passerelle gPRC, et la version du cluster détermine l’endpoint à utiliser (/v3, /v3beta ou /v3alpha). La version a été déterminée uniquement en conjonction avec la topologie du cluster, mais cette dernière n’a jamais été établie lors de la connexion via un proxy.
Version 2.0.2
Publié le 2021-02-22
Nouvelles fonctionnalités
- Capacité à ignorer les slots de réplication gérés externement (James Coleman)
Patroni tente de supprimer toute slot de réplication inconnue de son point de vue, mais il existe certainement des cas où les slots de réplication doivent être gérés de manière externe. À partir de maintenant, il est possible de configurer des slots qui ne doivent pas être supprimés.
- Ajout du support de la limitation des suites de chiffrement pour l’API REST (Gunnar “Nick” Bluth)
Il peut être configuré via la variable d’environnement restapi.ciphers ou la variable d’environnement PATRONI_RESTAPI_CIPHERS.
- Ajout du support des clés TLS chiffrées pour l’API REST (Jonathan S. Katz)
Il peut être configuré via la variable d’environnement restapi.keyfile_password ou la variable d’environnement PATRONI_RESTAPI_KEYFILE_PASSWORD.
- Comparaison en temps constant des identifiants d’authentification de l’API REST (Alex Brasetvik)
Utilisez hmac.compare_digest() à la place de ==, qui est vulnérable aux attaques par timing.
- Sélectionnez les nœuds synchrones en fonction du délai de réplication (Krishna Sarabu)
Si le délai de réplication sur le nœud synchrone commence à dépasser le seuil configuré, il peut être rétrogradé en mode asynchrone et/ou remplacé par l’autre nœud. Le comportement est contrôlé par maximum_lag_on_syncnode.
Améliorations de stabilité
- Démarrer postgres avec
hot_standby = offlors d’un amorçage personnalisé (Igor Yanchenko)
Pendant l’amorçage personnalisé, Patroni restaure le basebackup, démarre PostgreSQL et attend la fin de la récupération. Certains paramètres PostgreSQL sur le serveur de secours ne peuvent pas être inférieurs à ceux du serveur primaire, et si la nouvelle valeur (restaurée à partir du WAL) est supérieure à la valeur configurée, PostgreSQL panique et s’arrête. Pour éviter ce comportement, nous effectuerons l’amorçage personnalisé sans le mode hot_standby.
- Avertir l’utilisateur si le watchdog requis n’est pas en état sain (Nicolas Thauvin)
Lorsque l’appareil watchdog n’est pas accessible en écriture ou est absent en mode requis, le membre ne peut pas être promu. Un avertissement a été ajouté pour indiquer à l’utilisateur l’emplacement de cette mauvaise configuration.
- Meilleure verbosité en mode récupération pour un seul utilisateur (Alexander Kukushkin)
Si Patroni détecte qu’PostgreSQL n’a pas été arrêté correctement, dans certains cas, la récupération après panne est exécutée en lançant PostgreSQL en mode utilisateur unique. Il se peut que la récupération échoue (par exemple en raison d’un manque d’espace disque), mais que les erreurs soient ignorées.
- Ajout de la compatibilité avec le module
python-consul2(Alexander Kukushkin, Wilfried Roset)
Le bon vieux python-consul n’est plus maintenu depuis plusieurs années, aussi quelqu’un a-t-il créé une version dérivée avec de nouvelles fonctionnalités et des correctifs de bogues.
- N’utilisez pas
bypass_api_servicelors de l’exécution de patronictl (Alexander Kukushkin)
Lorsqu’un pod K8s s’exécute dans un namespace différent de default, il ne dispose pas nécessairement de suffisamment de permissions pour interroger l’endpoint kubernetes
. Dans ce cas, Patroni affiche un avertissement et ignore le paramètre bypass_api_service. En cas d’utilisation de patronictl
, cet avertissement était un peu ennuyeux.
- Créez
raft.data_dirs’il n’existe pas ou assurez-vous qu’il est accessible en écriture (Mark Mercado)
Améliore l’ergonomie et la facilité d’utilisation.
Correctifs de bogues
- Ne pas interrompre le redémarrage ou la promotion si la verrouillage du leader est perdu en pause (Alexander Kukushkin)
En mode pause, il est autorisé à exécuter PostgreSQL en tant que primaire sans verrou.
- Correctif apporté à
shutdown_request()dans l’API REST (Nicolas Limage)
Afin d’améliorer la gestion des connexions SSL et de différer la négociation jusqu’à la mise en route du thread, Patroni substitue plusieurs méthodes dans le HTTPServer. La méthode shutdown_request() a été oubliée.
Corrigé le problème de temps de sommeil lors de l’utilisation de Zookeeper (Alexander Kukushkin)
Patroni pouvait dormir jusqu’à deux fois plus longtemps entre les exécutions du code HA.
Corrigé les appels invalides à
os.symlink()lors du déplacement du répertoire de données après un amorçage échoué (Andrew L’Ecuyer)
Si l’amorçage a échoué, Patroni renomme le répertoire de données, pg_wal et tous les tableaux d’objets. Ensuite, il met à jour les liens symboliques afin de maintenir la cohérence du système de fichiers. La création des liens symboliques échouait en raison de l’inversion des arguments src et dst.
- Corrigé un bogue dans la méthode post_bootstrap() (Alexander Kukushkin)
Si le mot de passe de superutilisateur n’a pas été configuré, Patroni échouait à appeler le script post_init, ce qui faisait échouer tout l’amorçage.
- Corrigé un problème avec pg_rewind dans le cluster de secours (Alexander Kukushkin)
Si le nom de l’utilisateur superutilisateur est différent de Postgres, la variable pg_rewind dans le cluster de secours échouait car la chaîne de connexion ne contenait pas le nom de la base de données.
- Quitter uniquement si l’authentification avec etcd v3 a échoué explicitement (Alexander Kukushkin)
Lors du démarrage, Patroni effectue la découverte de la topologie du cluster etcd et s’authentifie si nécessaire. Il se peut qu’un des serveurs etcd soit injoignable : Patroni tente alors de s’authentifier sur ce serveur, puis échoue au lieu de réessayer avec le nœud suivant.
- Gérer le cas où cmdline() de psutil retourne une liste vide (Alexander Kukushkin)
Les processus zombies sont encore des enfants du postmaster, mais ils n’ont pas de cmdline()
- Traiter la variable d’environnement
PATRONI_KUBERNETES_USE_ENDPOINTScomme une valeur booléenne (Alexander Kukushkin)
Ne pas le faire rendait impossible la désactivation de kubernetes.use_endpoints via l’environnement.
- Améliorer la gestion des erreurs de mise à jour concurrente des points de terminaison (Alexander Kukushkin)
Patroni interroge explicitement l’objet endpoint actuel, vérifie que le pod actuel détient toujours le verrou leader, puis répète la mise à jour.
Version 2.0.1
Sorti le 2020-10-01
Nouvelles fonctionnalités
Utilisez
morecomme visualiseur de pagination danspatronictl edit-configsilessn’est pas disponible (Pavel Golub)Sous Windows, il s’agit de
more.com. En outre,cdiffa été remplacé parydiffdansrequirements.txt, mais patronictl continue de prendre en charge chacun d’eux à des fins de compatibilité.Ajout du support de
raftbind_addretpassword(Alexander Kukushkin)
raft.bind_addr peut être utile lors de l’exécution derrière un NAT. raft.password active le chiffrement du trafic (nécessite le module cryptography).
- Prise en charge du paramètre de connexion
sslpasswordajoutée (Kostiantyn Nemchenko)
Le paramètre de connexion a été introduit dans PostgreSQL 13.
Améliorations de stabilité
Modifié le comportement en pause (Alexander Kukushkin)
- Patroni n’appellera pas la méthode
bootstrapsi le répertoirePGDATAest manquant ou vide. - Patroni ne quittera pas en cas de différence d’identifiant de système (sysid) en mode pause, il ne fera que générer un avertissement.
- Le nœud n’essaiera pas de s’attribuer la clé leader en mode pause si PostgreSQL est en cours d’exécution hors récupération (acceptant les écritures) mais que l’identifiant de système (sysid) ne correspond pas à celui de la clé d’initialisation.
- Patroni n’appellera pas la méthode
Appliquer
master_start_timeoutlors de l’exécution de la récupération après incident (Alexander Kukushkin)
Si PostgreSQL a planté sur le nœud leader, Patroni effectue une récupération après panne en lançant PostgreSQL en mode utilisateur unique. Pendant la récupération après panne, le verrou leader est mis à jour. Si la récupération après panne n’est pas terminée dans master_start_timeout secondes, Patroni l’interrompt de force et libère le verrou leader.
- Supprimé l’élément
securesupplémentaire des exigencesurllib3(Alexander Kukushkin)
La seule raison d’y ajouter cela était la dépendance ipaddress pour Python 2.7.
Correctifs de bogues
- Corrigé un bogue dans
Kubernetes.update_leader()(Alexander Kukushkin)
Une exception non gérée empêchait la promotion du primaire lorsque la mise à jour de l’objet leader avait échoué.
- Corrigé le blocage de patronictl lors de l’utilisation du protocole RAFT (Alexander Kukushkin)
Lors de l’utilisation de patronictl
avec la configuration Patroni, self_addr doit être ajouté au partner_addrs.
- Correctif d’un bogue dans
get_guc_value()(Alexander Kukushkin)
Patroni échouait à obtenir la valeur de restore_command sur PostgreSQL 12, ce qui empêchait la récupération des WAL manquants pour pg_rewind.
Version 2.0.0
Sorti le 2020-09-02
Cette version améliore la compatibilité avec PostgreSQL 13, ajoute le support de plusieurs répliques synchrones, apporte des améliorations importantes dans la gestion de pg_rewind, ajoute le support d’Etcd v3 et de Patroni en mode RAFT pur (sans Etcd, Consul ni Zookeeper), et permet d’appeler de manière optionnelle le script pre_promote (fencing).
Prise en charge de PostgreSQL 13
- Ne pas déclencher
on_reloadlors de la promotion versstandby_leadersur PostgreSQL 13+ (Alexander Kukushkin)
Lors de la promotion vers standby_leader, nous modifions primary_conninfo, mettons à jour le rôle et rechargeons Postgres. Étant donné que on_role_change et on_reload se dupliquent effectivement, Patroni n’appellera qu’on_role_change.
- Ajout du support des paramètres de connexion
gssencmodeetchannel_binding(Alexander Kukushkin)
PostgreSQL 12 a introduit les paramètres de connexion gssencmode et 13 channel_binding, qui peuvent désormais être utilisés si définis dans la section postgresql.authentication.
- Gérer le renommage de
wal_keep_segmentsenwal_keep_size(Alexander Kukushkin)
En cas de mauvaise configuration (wal_keep_segments sur 13 et wal_keep_size sur les versions antérieures), Patroni ajustera automatiquement la configuration.
- Utilisez
pg_rewindavec--restore-target-walsur 13 si possible (Alexander Kukushkin)
Sur PostgreSQL 13, Patroni vérifie si restore_command est configuré et indique à pg_rewind de l’utiliser.
Nouvelles fonctionnalités
- Prise en charge implémentée de Patroni sur RAFT pur (Alexander Kukushkin)
Cela permet de faire fonctionner Patroni sans dépendances tierces, comme etcd, Consul ou Zookeeper. Pour assurer une haute disponibilité, vous devez exécuter soit trois nœuds Patroni, soit deux nœuds Patroni et un nœud avec patroni_raft_controller. Pour plus d’informations, consultez la documentation .
- Prise en charge implémentée du protocole etcd v3 via gPRC-gateway (Alexander Kukushkin)
etcd 3.0 a été publié il y a plus de quatre ans, et etcd 3.4 désactive par défaut la version v2. Il existe également des chances que la version v2 soit entièrement supprimée d’etcd ; c’est pourquoi nous avons mis en œuvre la prise en charge d’etcd v3 dans Patroni. Pour commencer à l’utiliser, vous devez créer explicitement la section etcd3 dans le fichier de configuration de Patroni.
- Prise en charge de plusieurs répliques synchrones (Krishna Sarabu)
Il permet d’exécuter un cluster avec plus d’une réplique synchrone. Le nombre maximal de répliques synchrones est contrôlé par le nouveau paramètre synchronous_node_count. Il est défini par défaut à 1 et n’a aucun effet lorsque le paramètre synchronous_mode
est défini sur off.
Ajout de la possibilité d’appeler le script
pre_promote(Sergey Dudoladov)Contrairement aux callbacks, le script
pre_promoteest appelé de manière synchrone après l’acquisition du verrou de leader, mais avant la promotion de PostgreSQL. Si le script échoue ou renvoie un code de sortie non nul, le nœud actuel libère le verrou de leader.Ajout de la prise en charge des répertoires de configuration (Floris van Nee)
Les fichiers YAML du répertoire sont chargés et appliqués dans l’ordre alphabétique.
- Validation avancée des paramètres PostgreSQL (Alexander Kukushkin)
En cas de non-pris en charge du paramètre spécifique par la version actuelle de PostgreSQL ou lorsque sa valeur est incorrecte, Patroni supprimera entièrement le paramètre ou tentera de corriger sa valeur.
- Réveiller le thread principal lorsque le point de contrôle forcé après promotion est terminé (Alexander Kukushkin)
Les répliques attendent une indication de point de contrôle via la clé membre du leader dans le DCS. Cette clé est normalement mise à jour une seule fois par boucle HA. Sans réveiller le thread principal, les répliques devront attendre jusqu’à loop_wait secondes de plus que nécessaire.
- Utilisation de la vue
pg_stat_wal_receiverà partir de la version 9.6 (Alexander Kukushkin)
La vue contient les valeurs à jour de primary_conninfo et primary_slot_name, tandis que le contenu de recovery.conf pourrait être périmé.
Amélioration de la gestion des adresses IPv6 dans le fichier de configuration Patroni (Mateusz Kowalski)
L’adresse IPv6 est censée être placée entre crochets, alors que Patroni s’attendait à la recevoir sans crochets. Ces formats sont désormais tous pris en charge.
Paramètre de configuration Consul
service_tagsajouté (Robert Edström)
Ils sont utiles pour la découverte de services dynamiques, par exemple par des équilibreurs de charge.
- Prise en charge SSL implémentée pour Zookeeper (Kostiantyn Nemchenko)
Il nécessite kazoo>=2.6.0.
- Option de méthode d’amorçage personnalisée implémentée (
no_params) (Kostiantyn Nemchenko)
Il permet d’appeler wal-g, pgBackRest et d’autres outils de sauvegarde sans les encapsuler dans des scripts shell.
- Déplacer les fichiers WAL et les espaces de table après un échec de l’initialisation (Feike Steenbergen)
Lors de l’exécution de reinit, Patroni supprimait déjà non seulement PGDATA mais aussi le répertoire WAL lié par lien symbolique et les espaces de tables. La méthode move_data_directory() effectuera désormais une opération similaire, à savoir renommer le répertoire WAL et les espaces de tables, puis mettre à jour les liens symboliques dans PGDATA.
Améliorations apportées au support de pg_rewind
- Vérification améliorée de la divergence de la chronologie (Alexander Kukushkin)
Nous n’avons pas besoin de rembobiner lorsque l’emplacement de lecture sur la réplique n’est pas en avance par rapport au point de basculement, ou lorsque la fin de l’enregistrement de point de contrôle sur l’ancien nœud primaire est identique au point de basculement. Pour obtenir la fin de l’enregistrement de point de contrôle, nous utilisons pg_waldump et analysons sa sortie.
- Essayer de récupérer le WAL manquant si
pg_rewinden signale la perte (Alexander Kukushkin)
Il se peut que le segment WAL requis pour pg_rewind n’existe plus dans le répertoire pg_wal, ce qui empêche pg_rewind de localiser le point de contrôle antérieur au point de divergence. À partir de PostgreSQL 13, pg_rewind peut utiliser restore_command pour récupérer les WAL manquants. Pour les versions antérieures de PostgreSQL, Patroni analyse les erreurs d’une tentative de rewind échouée et tente de récupérer les WAL manquants en appelant restore_command de manière autonome.
- Détecter une nouvelle timeline dans le cluster de secours et déclencher le rewind ou la réinitialisation si nécessaire (Alexander Kukushkin)
Le cluster standby_cluster
est déconnecté du cluster primaire et ne connaît donc pas immédiatement les élections de leader ni les changements de timeline. Afin de détecter ce fait, le standby_leader vérifie périodiquement l’existence de nouveaux fichiers d’historique dans pg_wal.
- Raccourcir et améliorer la présentation de la sortie du journal d’historique (Alexander Kukushkin)
Lorsque Patroni tente de déterminer la nécessité de pg_rewind, il peut écrire le contenu du fichier d’historique provenant du serveur primaire dans les journaux. Le fichier d’historique grandit à chaque basculement ou basculement planifié, et finit par occuper trop de lignes, dont la plupart ne sont pas utiles. Au lieu d’afficher les données brutes, Patroni n’affichera que 3 lignes précédant la timeline actuelle de la réplique et 2 lignes suivant.
Améliorations apportées à K8s
- Supprimer le module python kubernetes (Alexander Kukushkin)
Le client Python officiel pour Kubernetes contient une grande quantité de code généré automatiquement et est donc très lourd. Patroni n’utilise qu’une petite partie des points d’entrée de l’API Kubernetes, et la mise en œuvre de leur prise en charge n’a pas été difficile.
- Permettre de contourner le service kubernetes (Alexander Kukushkin)
Lorsqu’il est exécuté sur K8s, Patroni communique généralement avec l’API K8s via le service kubernetes
, dont l’adresse est exposée dans la variable d’environnement KUBERNETES_SERVICE_HOST. Comme tout autre service, le service kubernetes
est géré par kube-proxy, qui, selon la configuration, dépend soit d’un programme en espace utilisateur, soit de iptables pour le routage du trafic. En ignorant le composant intermédiaire et en se connectant directement aux nœuds maîtres K8s, il devient possible d’implémenter une stratégie de réessai améliorée et de réduire les risques de dégradation de PostgreSQL lors de la mise à jour des nœuds maîtres K8s.
- Synchronisation des boucles HA de tous les pods d’un cluster Patroni (Alexander Kukushkin)
Ne pas le faire augmentait le délai de détection des défaillances de ttl à ttl + loop_wait.
- Remplir
referencesetnodenamedans les adresses des sous-ensembles sur K8s (Alexander Kukushkin)
Certains équilibreurs de charge dépendent de ces informations.
- Correction possible des conditions de course dans
update_leader()(Alexander Kukushkin)
La mise à jour concurrente du ConfigMap ou de l’endpoint leader effectuée en dehors de Patroni peut entraîner l’échec de l’appel update_leader(). Dans ce cas, Patroni vérifie à nouveau que le nœud actuel détient toujours le verrou leader, puis répète la mise à jour.
- Interdire explicitement le patching de configurations inexistantes (Alexander Kukushkin)
Pour les clusters DCS autres que kubernetes
, l’appel PATCH échoue avec une exception en raison de cluster.config étant None, mais sur Kubernetes, il créait sans problème l’annotation de configuration et empêchait l’écriture de la configuration d’amorçage après l’achèvement de l’amorçage.
- Corriger un bug dans pause (Alexander Kukushkin)
Les répliques supprimaient primary_conninfo et redémarraient PostgreSQL lorsque la clé du leader était absente, mais elles ne devraient rien faire.
Améliorations de l’API REST
- Reporter l’établissement de la connexion TLS jusqu’à ce que le thread worker ait démarré (Alexander Kukushkin, Ben Harris)
Si la négociation TLS a été effectuée dans le thread d’API et que le client n’a envoyé aucune donnée, le thread d’API était bloqué (risque de violation de service).
- Vérifier
basic-authindépendamment du certificat client dans l’API REST (Alexander Kukushkin)
Précédemment, seul le certificat client était validé. Effectuer deux vérifications de manière indépendante est un cas d’utilisation absolument valable.
- Écrire un double
CRLFaprès les en-têtes HTTP de la requêteOPTIONS(Sergey Burladyan)
HAProxy était satisfait avec un seul CRLF, tandis que la vérification de santé de Consul signalait une connexion interrompue et une fin inattendue du flux.
GET /clusteraffichait des informations obsolètes sur les membres Zookeeper (Alexander Kukushkin)
Le point de terminaison utilisait la vue interne du cluster de Patroni. Pour Patroni lui-même, cela n’avait pas d’impact, mais lorsqu’il est exposé à l’extérieur, il est nécessaire de fournir des informations à jour, en particulier le retard de réplication.
- Contrôle de santé corrigé pour le cluster de secours (Alexander Kukushkin)
Le GET /standby-leader d’un maître et le GET /master d’un standby_leader répondaient incorrectement avec 200.
- Implémenté
DELETE /switchover(Alexander Kukushkin)
L’appel d’API REST supprime le basculement planifié.
- Créé les points de terminaison
/readinesset/liveness(Alexander Kukushkin)
Ils peuvent être utiles pour supprimer les pods « non sains » des adresses de sous-ensembles lorsque le service Kubernetes est utilisé avec des sélecteurs d’étiquettes.
- Contrôles de santé améliorés de l’API REST
GET /replicaetGET /async(Krishna Sarabu, Alexander Kukushkin)
Les vérifications prennent désormais en charge un mot-clé facultatif ?lag=<max-lag> et ne renvoient un code 200 que si le décalage est inférieur à la valeur fournie. En cas d’utilisation de cette fonctionnalité, veuillez noter que les informations sur la position du WAL sur le leader sont mises à jour uniquement toutes les loop_wait secondes !
- Ajout du support des en-têtes HTTP définis par l’utilisateur dans la réponse de l’API REST (Yogesh Sharma)
Cette fonctionnalité peut être utile si des requêtes sont effectuées depuis un navigateur.
Améliorations apportées à patronictl
- Ne tentez pas d’appeler un leader inexistant dans
patronictl pause(Alexander Kukushkin)
Lors de la mise en pause d’un cluster sans leader sur K8s, patronictl affichait des avertissements indiquant que le membre « None » n’était pas accessible.
- Gérer le cas où le membre
conn_urlest manquant (Alexander Kukushkin)
Sur K8s, il se peut que le pod ne dispose pas des annotations nécessaires car Patroni n’est pas encore en cours d’exécution. Cela faisait échouer patronictl .
- Ajout de la possibilité d’afficher la topologie du cluster en ASCII (Maxim Fedotov, Alexander Kukushkin)
Il est très utile d’obtenir un aperçu du cluster avec une réplication en cascade.
- Implémenter
patronictl flush switchover(Alexander Kukushkin)
Avant cela, patronictl flush ne supportait que l’annulation des redémarrages planifiés.
Correctifs de bogues
- Erreur d’attribut lors de l’amorçage du cluster avec un PGDATA existant (Krishna Sarabu)
Lors de la tentative de création/mise à jour de la clé /history, Patroni tentait d’accéder à l’objet ClusterConfig qui n’avait pas encore été créé dans le DCS.
- Gestion améliorée des exceptions dans Consul (Alexander Kukushkin)
Exception non gérée dans la méthode touch_member() a provoqué l’arrêt complet du processus Patroni.
- Forcer
synchronous_commit=localpour le scriptpost_init(Alexander Kukushkin)
Patroni effectuait déjà cette opération lors de la création des utilisateurs (replication, rewind), mais l’oubli dans le cas de post_init était une erreur. En conséquence, si le script ne l’effectuait pas en interne de manière autonome, l’amorçage dans synchronous_mode
n’était pas capable de s’achever.
- Augmentation de
maxsizedans le gestionnaire de pool Consul (ponvenkates)
Avec le size=1 par défaut, certaines avertissements ont été générés.
- Patroni signalait incorrectement que PostgreSQL était en cours d’exécution (Alexander Kukushkin)
L’état n’a pas été mis à jour lorsque, par exemple, Postgres a planté en raison d’une erreur de disque plein.
- Insérer
*danspgpassà la place des valeurs absentes ou vides (Alexander Kukushkin)
Si, par exemple, standby_cluster.port n’est pas spécifié, le fichier pgpass a été incorrectement généré.
- Ignorer la création de slot de réplication physique sur le nœud leader en présence de caractères spéciaux (Krishna Sarabu)
Patroni semblait créer une fente inactif (lorsque slots est défini) pour le nœud leader lorsque le nom contenait des caractères spéciaux tels que ‘-’ (par exemple, “abc-us-1”).
- Éviter de supprimer un
pg_hba.confintrouvable dans l’amorçage personnalisé (Krishna Sarabu)
Patroni échouait si pg_hba.conf se trouvait en dehors du répertoire pgdata après un amorçage personnalisé.
Version 1.6.5
Libéré le 2020-08-23
Nouvelles fonctionnalités
- Délai d’arrêt du maître (Krishna Sarabu)
Le nombre de secondes autorisées à Patroni pour attendre lors de l’arrêt de Postgres. N’est effectif que lorsque synchronous_mode
est activé. Si la valeur est supérieure à 0 et que synchronous_mode
est activé, Patroni envoie SIGKILL au postmaster si l’opération d’arrêt dure plus longtemps que la valeur définie par master_stop_timeout. Définissez cette valeur en fonction de votre compromis entre durabilité et disponibilité. Si le paramètre n’est pas défini ou est défini sur une valeur non positive, master_stop_timeout n’a pas d’effet.
- Ne créez pas de slot physique permanent portant le nom du primaire (Alexander Kukushkin)
Il s’agit d’un problème courant où le nœud primaire recycle les segments WAL tandis que la réplique est hors ligne. Nous disposons désormais d’une solution efficace pour les clusters statiques, comprenant un nombre fixe de nœuds dont les noms ne changent jamais. Il suffit de lister les noms de tous les nœuds dans slots afin que le nœud primaire ne supprime pas le slot lorsque le nœud est hors ligne (non inscrit dans le DCS).
- Premier brouillon du validateur de configuration (Igor Yanchenko)
Utilisez patroni --validate-config patroni.yaml afin de valider la configuration de Patroni.
- Possibilité de configurer la longueur maximale de l’historique des timelines (Krishna Sarabu)
Patroni écrit l’historique des basculements et des basculements planifiés dans la clé /history du DCS. Au fil du temps, la taille de cette clé augmente, mais dans la plupart des cas, seules les dernières lignes sont pertinentes. Le paramètre max_timelines_history permet de spécifier le nombre maximal d’éléments d’historique de timeline à conserver dans le DCS.
- Compatibilité avec Kazoo 2.7.0 (Danyal Prout)
Certains méthodes non publiques de Kazoo ont vu leurs signatures modifiées, mais Patroni en dépendait.
Améliorations apportées à patronictl
- Afficher les balises des membres (Kostiantyn Nemchenko, Alexander Kukushkin)
Les balises sont configurées individuellement pour chaque nœud, et il n’existait aucune méthode simple pour obtenir un aperçu global de celles-ci.
- Améliorer la sortie des membres (Alexander Kukushkin)
Le nom du cluster redondant ne sera plus affiché sur chaque ligne, mais uniquement dans l’en-tête du tableau.
- Échouer si un fichier de configuration est spécifié explicitement mais non trouvé (Kaarel Moppel)
Précédemment, patronictl
ne signalait qu’un message DEBUG.
- Résolu le problème de pod K8s non initialisé entraînant une panne de patronictl (Alexander Kukushkin)
Patroni dépend de certaines annotations de pods sur K8s. Lorsqu’un pod Patroni s’arrête ou démarre, aucune annotation valide n’est encore présente, et patronictl échouait avec une exception.
Améliorations de stabilité
- Appliquer un délai de 1 seconde en cas d’échec de l’appel LIST au serveur d’API K8s (Alexander Kukushkin)
Il est essentiel d’éviter la surcharge des journaux, mais cela contribue également à prévenir la famine du thread principal.
- Réessayer si l’en-tête HTTP
retry-afterest retourné par l’API K8s (Alexander Kukushkin)
Si le serveur d’API Kubernetes est saturé de demandes, il peut demander une nouvelle tentative.
- Nettoyer l’environnement
KUBERNETES_depuis le postmaster (Feike Steenbergen)
Les variables d’environnement KUBERNETES_ ne sont pas obligatoires pour PostgreSQL, mais les exposer au postmaster les rend également accessibles aux serveurs secondaires et aux utilisateurs réguliers de la base de données (par exemple, via pl/perl).
- Nettoyer les espaces de table sur une réinitialisation (Krishna Sarabu)
Lors d’un amorçage, Patroni supprimait uniquement PGDATA tout en laissant les répertoires de tablespace définis par l’utilisateur. Cela entraînait une boucle dans l’amorçage. La solution de contournement précédente consistait à implémenter le script d’amorçage personnalisé custom bootstrap
.
- Exécuter explicitement
CHECKPOINTaprès la promotion (Alexander Kukushkin)
Cela permet de réduire le temps avant que le nouveau serveur primaire ne soit utilisable pour pg_rewind.
- Actualisation intelligente des membres etcd (Alexander Kukushkin)
En cas d’échec de Patroni à exécuter une requête sur tous les membres du cluster Etcd, Patroni vérifiera à nouveau les enregistrements A ou SRV pour détecter des modifications d’adresses IP/hôtes avant de réessayer la prochaine fois.
- Ignorer les valeurs manquantes de
pg_controldata(Feike Steenbergen)
Les valeurs manquent lors de l’utilisation de binaires dont la version ne correspond pas à celle de PGDATA. Patroni tentera tout de même de démarrer PostgreSQL, qui signalera que la version majeure ne correspond pas et s’arrêtera avec une erreur.
Correctifs de bogues
- Désactiver la vérification SSL pour Consul lorsqu’elle est requise (Julien Riou)
À partir d’une certaine version de urllib3, le paramètre cert_reqs doit être explicitement défini sur ssl.CERT_NONE afin de désactiver efficacement la vérification SSL.
- Éviter d’ouvrir une connexion de réplication à chaque cycle de la boucle HA (Alexander Kukushkin)
La régression a été introduite dans la version 1.6.4.
- Appeler le rappel
on_role_changeen cas d’échec du primaire (Alexander Kukushkin)
Dans certains cas, cela peut entraîner la conservation de l’adresse IP virtuelle sur l’ancien nœud primaire. Ce comportement régressif a été introduit à partir de la version 1.4.5.
- Réinitialiser l’état de rembobinage si PostgreSQL a été démarré après un pg_rewind réussi (Alexander Kukushkin)
En raison de ce bogue, Patroni a démarré en mode d’arrêt manuel de PostgreSQL en mode de pause.
- Convertir
recovery_min_apply_delayenmslors de la vérification derecovery.conf
Patroni redémarrait indéfiniment la réplique si recovery_min_apply_delay était configuré sur PostgreSQL antérieur à la version 12.
- Compatibilité avec PyInstaller (Alexander Kukushkin)
PyInstaller permet de figer (packager) des applications Python en exécutables autonomes. La compatibilité a été rompue lors du passage à la méthode spawn au lieu de fork pour multiprocessing.
Version 1.6.4
Sorti le 27 janvier 2020
Nouvelles fonctionnalités
- Implémenté l’option
--waitpourpatronictl reinit(Igor Yanchenko)
patronictl attendra que reinit se termine si l’option --wait est utilisée.
Améliorations supplémentaires du support Windows (Igor Yanchenko, Alexander Kukushkin)
- Tous les scripts shell utilisés pour les tests d’intégration sont réécrits en python
- Le
pg_ctl killsera utilisé pour arrêter postgres sur les systèmes non POSIX - N’essayez pas d’utiliser les sockets Unix
Améliorations de stabilité
- Vérifiez que
unix_socket_directoriesetstats_temp_directoryexistent (Igor Yanchenko)
Lors du démarrage de Patroni et de Postgres, assurez-vous que unix_socket_directories et stats_temp_directory existent ou tentez de les créer. Patroni s’arrêtera si la création échoue.
- Assurez-vous que
postgresql.pgpassse trouve à l’emplacement où Patroni dispose d’un accès en écriture (Igor Yanchenko)
En cas de manque d’accès en écriture, Patroni se terminera avec une exception.
- Désactiver par défaut la vérification Consul
serfHealth(Kostiantyn Nemchenko)
Même en cas de problèmes réseau mineurs, la défaillance de serfHealth entraîne l’invalidation de toutes les sessions associées au nœud. Le clé leader est ainsi perdue bien avant ttl, ce qui provoque des redémarrages inattendus des répliques et éventuellement une désignation de secondaire du primaire.
- Configurez les keepalives TCP pour les connexions vers l’API K8s (Alexander Kukushkin)
En cas de non-réception de données sur la socket après un délai de TTL secondes, celle-ci peut être considérée comme inactive.
- Éviter la journalisation des mots de passe lors de la création d’utilisateurs (Alexander Kukushkin)
Si le mot de passe est rejeté ou si la journalisation est configurée en mode verbeux ou non configurée du tout, il se peut que le mot de passe soit écrit dans les journaux de PostgreSQL. Pour éviter cela, Patroni modifiera log_statement, log_min_duration_statement et log_min_error_statement en des valeurs sûres avant d’effectuer l’opération de création ou de mise à jour de l’utilisateur.
Correctifs de bogues
- Utilisez
restore_commandprovenant de la configuration standby_cluster sur les répliques en cascade (Alexander Kukushkin)
Le standby_leader le faisait déjà depuis le début, dès l’existence de cette fonctionnalité. Ne pas effectuer la même opération sur les répliques pourrait empêcher celles-ci de se synchroniser avec le leader en veille.
- Mettre à jour la timeline signalée par le cluster de secours (Alexander Kukushkin)
En cas de basculement de timeline, le cluster de secours était correctement en réplication depuis le primaire, mais patronictl signalait la vieille timeline.
- Autoriser la définition de certains paramètres de récupération dans custom_conf (Alexander Kukushkin)
Lors de la validation des paramètres de récupération sur une réplique, Patroni ignorera archive_cleanup_command, promote_trigger_file, recovery_end_command, recovery_min_apply_delay et restore_command s’ils ne sont pas définis dans la configuration Patroni mais sont présents dans des fichiers autres que postgresql.auto.conf ou postgresql.conf.
- Améliorer la gestion des paramètres PostgreSQL comportant un point dans leur nom (Alexander Kukushkin)
Ces paramètres peuvent être définis par des extensions où l’unité n’est pas nécessairement une chaîne de caractères. Modifier cette valeur peut nécessiter une redémarrage (par exemple pg_stat_statements.max).
- Améliorer la gestion des exceptions pendant l’arrêt (Alexander Kukushkin)
Pendant l’arrêt, Patroni tente de mettre à jour son état dans le DCS. Si le DCS est inaccessible, une exception peut être levée. Le manque de gestion des exceptions empêchait le thread d’audit de s’arrêter.
Version 1.6.3
Sorti le 2019-12-05
Correctifs de bogues
- Ne pas exposer le mot de passe lors de l’exécution de
pg_rewind(Alexander Kukushkin)
Un bogue a été introduit dans le #1301
- Appliquer les paramètres de connexion spécifiés dans
postgresql.authenticationàpg_basebackupet les méthodes personnalisées de création de réplique (Alexander Kukushkin)
Ils comptaient sur une chaîne de connexion de type URL et les paramètres n’ont donc jamais été pris en compte.
Version 1.6.2
Sorti le 2019-12-05
Nouvelles fonctionnalités
- Implémenté
patroni --version(Igor Yanchenko)
Il affiche la version actuelle de Patroni et quitte.
- Définir l’en-tête
user-agentpour toutes les requêtes HTTP (Alexander Kukushkin)
Patroni communique avec Consul, etcd et l’API Kubernetes via le protocole http. Disposer d’un user-agent spécialement conçu (par exemple : Patroni/1.6.2 Python/3.6.8 Linux) peut s’avérer utile pour le débogage et la surveillance.
- Permettre de configurer le niveau de journalisation pour les traces d’exceptions (Igor Yanchenko)
Si vous définissez log.traceback_level=DEBUG, les traces d’erreur ne seront visibles que lorsque log.level=DEBUG. Le comportement par défaut reste inchangé.
Améliorations de stabilité
- Éviter d’importer tous les modules DCS lors de la recherche du module requis par le fichier de configuration (Alexander Kukushkin)
Il n’est pas nécessaire d’importer les modules etcd, Consul et Kubernetes si l’on n’a besoin que d’un système tel que Zookeeper. Cela permet de réduire la consommation de mémoire et de résoudre le problème des messages INFO Failed to import smth.
- Supprimé le module python
requestsdes exigences explicites (Alexander Kukushkin)
Il n’était utilisé pour rien de critique, mais causait de nombreux problèmes lors du lancement de la nouvelle version de urllib3.
- Améliorer la gestion de
etcd.hostsfourni sous forme de chaîne séparée par des virgules au lieu d’un tableau YAML (Igor Yanchenko)
Précédemment, cela échouait lorsqu’il était écrit au format host1:port1, host2:port2 (le caractère espace après la virgule).
Améliorations de l’ergonomie
- N’obligez pas les utilisateurs à choisir des membres dans une liste vide dans patronictl (Igor Yanchenko)
Si l’utilisateur fournit un nom de cluster incorrect, une exception sera levée plutôt que de demander de choisir un membre dans une liste vide.
- Rendre le message d’erreur plus utile si l’API REST ne peut pas se lier (Igor Yanchenko)
Pour un utilisateur inexpérimenté, il peut être difficile de déterminer ce qui ne va pas à partir de la trace de pile Python.
Correctifs de bogues
- Corriger le calcul de
wal_buffers(Alexander Kukushkin)
L’unité de base a été passée des blocs de 8 ko aux octets à partir de PostgreSQL 11.
- Utilisez
passfiledansprimary_conninfouniquement sur PostgreSQL 10+ (Alexander Kukushkin)
Sur les anciennes versions, aucune garantie n’est assurée quant au bon fonctionnement de passfile, sauf si la dernière version de libpq est installée.
Version 1.6.1
Sorti le 15 novembre 2019
Nouvelles fonctionnalités
- Ajout de la variable d’environnement
PATRONICTL_CONFIG_FILE(msvechla)
Il permet de configurer l’argument --config-file pour patronictl
à partir de l’environnement.
- Implémenter
patronictl history(Alexander Kukushkin)
Il affiche l’historique des basculements et des basculements planifiés.
- Passer
-c statement_timeout=0enPGOPTIONSlors depg_rewind(Alexander Kukushkin)
Il protège contre le cas où statement_timeout sur le serveur est défini sur une valeur faible et une des instructions exécutées par pg_rewind est annulée.
- Autoriser des valeurs plus faibles pour la configuration de PostgreSQL (Soulou)
Patroni n’autorisait pas certains paramètres de configuration PostgreSQL à être définis à une valeur inférieure à des valeurs codées en dur. Les valeurs minimales autorisées sont désormais plus faibles, sans toutefois modifier les valeurs par défaut.
- Autoriser l’authentification basée sur les certificats (Jonathan S. Katz)
Cette fonctionnalité permet l’authentification basée sur les certificats pour les comptes superutilisateur, réplication et rewind, et permet à l’utilisateur de spécifier le sslmode avec lequel il souhaite se connecter.
- Utilisez
passfiledansprimary_conninfoau lieu du mot de passe (Alexander Kukushkin)
Il permet d’éviter de définir les permissions 600 sur postgresql.conf
- Effectuer
pg_ctl reloadindépendamment des modifications de configuration (Alexander Kukushkin)
Il se peut que certains fichiers de configuration ne soient pas gérés par Patroni. Lorsqu’une recharge est effectuée via l’API REST ou en envoyant SIGHUP au processus Patroni, on s’attend généralement à ce que PostgreSQL soit également rechargé. Ce n’était pas le cas auparavant lorsque aucune modification n’avait été apportée à la section postgresql de la configuration Patroni.
- Comparez tous les paramètres de récupération, et non seulement
primary_conninfo(Alexander Kukushkin)
Précédemment, la méthode check_recovery_conf() ne vérifiait que si primary_conninfo avait changé, sans tenir compte de tous les autres paramètres de récupération.
- Permettre d’appliquer certains paramètres de récupération sans redémarrage (Alexander Kukushkin)
À partir de PostgreSQL 12, les paramètres de récupération suivants peuvent être modifiés sans redémarrage : archive_cleanup_command, promote_trigger_file, recovery_end_command et recovery_min_apply_delay. Dans les futures versions de PostgreSQL, cette liste sera étendue, et Patroni la prendra en charge automatiquement.
- Permettre de modifier
use_slotsen ligne (Alexander Kukushkin)
Précédemment, il fallait redémarrer Patroni et supprimer les slots manuellement.
- Supprimez uniquement les variables d’environnement préfixées par
PATRONI_au démarrage de Postgres (Cody Coons)
Il résouda plusieurs problèmes liés à l’exécution de différents wrappers de données étrangères.
Améliorations de stabilité
- Utilisez LIST + WATCH lors de l’utilisation de l’API Kubernetes (Alexander Kukushkin)
Il permet de recevoir efficacement les modifications d’objets (pods, endpoints, configmaps) et réduit la charge sur les nœuds maîtres Kubernetes.
- Améliorer le flux de travail lorsque PGDATA n’est pas vide pendant l’amorçage (Alexander Kukushkin)
Selon le code source de initdb, une variable PGDATA peut être considérée comme vide lorsque seuls lost+found et .dotfiles s’y trouvent. Patroni adopte désormais la même logique. Si PGDATA n’est pas vide, tout en étant invalide du point de vue de pg_controldata, Patroni émet une alerte et s’arrête.
- Éviter d’appeler
os.listdir()à chaque boucle HA (Alexander Kukushkin)
Lorsque le système est sous charge d’E/S, l’exécution de os.listdir() peut prendre quelques secondes (voire plusieurs minutes), ce qui affecte négativement le cycle de haute disponibilité de Patroni. Cela peut même entraîner la disparition de la clé leader du DCS en raison de l’absence de mise à jour. Il existe une méthode plus efficace et moins coûteuse pour vérifier que le répertoire PGDATA n’est pas vide. Nous vérifions désormais la présence du fichier global/pg_control dans PGDATA.
- Quelques améliorations apportées à l’infrastructure de journalisation (Alexander Kukushkin)
Précédemment, il était possible de perdre les dernières lignes de journalisation lors de l’arrêt, car le thread de journalisation était un thread daemon.
- Utiliser la méthode de démarrage multiprocessing
spawnavec Python 3.4+ (Maciej Kowalczyk)
Il s’agit d’un problème connu dans Python
lié à une incompatibilité entre les threads et le multiprocessing. Passer de la méthode par défaut fork à spawn est une solution recommandée. Ne pas le faire peut entraîner un blocage du processus de démarrage du Postmaster, avec Patroni signalant indéfiniment INFO: restarting after failure in progress, alors que PostgreSQL est en réalité en cours d’exécution.
Améliorations de l’API REST
- Permettre de vérifier les certificats clients dans l’API REST (Alexander Kukushkin)
Si verify_client est défini sur required, Patroni vérifie les certificats clients pour toutes les appels d’API REST. Lorsqu’il est défini sur optional, les certificats clients sont vérifiés uniquement pour les points de terminaison d’API REST non sécurisés.
- Renvoyer le code de réponse 503 pour la requête de vérification de santé
GET /replicasi PostgreSQL n’est pas en cours d’exécution (Alexander Anikin)
Postgres peut passer un temps important en phase de récupération avant de commencer à accepter les connexions clientes.
- Implémenter les points d’accès
/historyet/cluster(Alexander Kukushkin)
Le point d’accès /history affiche le contenu de la clé history dans le DCS. Le point d’accès /cluster affiche tous les membres du cluster ainsi que certaines informations de service, telles que les redémarrages planifiés ou les basculements planifiés en attente.
Améliorations apportées au support d’etcd
- Réessayer en cas d’erreur interne RAFT sur etcd (Alexander Kukushkin)
Lors de l’arrêt d’un nœud etcd, celui-ci envoie response code=300, data='etcdserver: server stopped', ce qui provoquait la désactivation du primaire par Patroni.
- Ne pas abandonner trop tôt la tentative de répétition des requêtes etcd (Alexander Kukushkin)
Lorsqu’il y avait des problèmes réseau, Patroni vidait rapidement la liste des nœuds Etcd et abandonnait sans utiliser l’intégralité de retry_timeout, pouvant entraîner une bascule du nœud primaire.
Correctifs de bogues
- Désactiver
synchronous_commitlors de la délivrance de permissions d’exécution à l’utilisateurpg_rewind(kremius)
Si l’amorçage est effectué avec synchronous_mode_strict: true, l’instruction GRANT EXECUTE attendait indéfiniment en raison de la disponibilité de nœuds non synchrones.
- Corriger une fuite mémoire sous Python 3.7 (Alexander Kukushkin)
Patroni utilise ThreadingMixIn pour traiter les requêtes de l’API REST, et Python 3.7 crée par défaut des threads non démon pour chaque requête.
- Corriger les conditions de course dans les actions asynchrones (Alexander Kukushkin)
Il existait un risque que patronictl reinit --force soit écrasé par la tentative de récupération d’un serveur Postgres arrêté. Cela a abouti à une situation où Patroni tentait de démarrer Postgres pendant que basebackup était en cours d’exécution.
- Corriger la condition de course dans la méthode
postmaster_start_time()(Alexander Kukushkin)
Si la méthode est exécutée depuis le thread de l’API REST, elle nécessite la création d’un objet curseur distinct.
- Corriger le problème de non-promotion du standby synchrone dont le nom contenait des lettres majuscules (Alexander Kukushkin)
Nous avons converti le nom en minuscules car PostgreSQL effectuait la même opération lors de la comparaison de application_name avec la valeur de synchronous_standby_names.
- Tuer tous les processus enfants ainsi que le processus de rappel avant de démarrer le nouveau (Alexander Kukushkin)
Ne pas le faire rend difficile l’implémentation de rappels (callbacks) dans bash et peut éventuellement entraîner une situation où deux rappels s’exécutent simultanément.
- Corriger le problème « start failed » (Alexander Kukushkin)
Dans certains cas, l’état de Postgres peut être défini comme « démarrage échoué » même si Postgres est effectivement en cours d’exécution.
Version 1.6.0
Sorti le 2019-08-05
Cette version ajoute la compatibilité avec PostgreSQL 12, permet d’exécuter pg_rewind sans privilèges de superutilisateur sur PostgreSQL 11 et versions ultérieures, et active la prise en charge d’IPv6.
Nouvelles fonctionnalités
- Psycopg2 a été supprimé des dépendances et doit être installé indépendamment (Alexander Kukushkin)
À compter de la version 2.8.0, psycopg2 a été divisé en deux paquets distincts, psycopg2 et psycopg2-binary, pouvant être installés simultanément au même emplacement dans le système de fichiers. Afin de réduire le problème de conflits de dépendances, nous laissons l’utilisateur choisir la méthode d’installation. Plusieurs options sont disponibles ; veuillez consulter la documentation
.
- Compatibilité avec PostgreSQL 12 (Alexander Kukushkin)
À compter de PostgreSQL 12, il n’existe plus de recovery.conf et tous les paramètres de récupération précédents sont convertis en paramètres GUC
. Afin de se protéger contre ALTER SYSTEM SET primary_conninfo ou des configurations similaires, Patroni analysera postgresql.auto.conf et supprimera tous les paramètres de basculement et de récupération présents dans ce fichier. La configuration de Patroni reste compatible avec les versions antérieures. Par exemple, même si restore_command est un GUC, il est possible de le spécifier dans la section postgresql.recovery_conf.restore_command et Patroni l’écrira dans postgresql.conf pour PostgreSQL 12.
- Permettre d’utiliser
pg_rewindsans privilèges de superutilisateur sur PostgreSQL 11 et versions ultérieures (Alexander Kukushkin)
Si vous souhaitez utiliser cette fonctionnalité, définissez username et password dans la section postgresql.authentication.rewind du fichier de configuration Patroni. Pour un cluster existant, vous devrez créer l’utilisateur manuellement et accorder la permission GRANT EXECUTE sur quelques fonctions. Vous trouverez des détails supplémentaires dans la documentation PostgreSQL documentation
.
- Comparer intelligemment les valeurs réelles et souhaitées de
primary_conninfosur les réplicas (Alexander Kukushkin)
Cela peut aider à éviter le redémarrage de la réplique lors de la conversion d’un cluster primaire-secours existant en un cluster géré par Patroni
- Prise en charge d’IPv6 (Alexander Kukushkin)
Deux problèmes majeurs étaient présents. Le service API REST de Patroni écoutait uniquement sur 0.0.0.0 et les adresses IPv6 utilisées dans api_url et conn_url n’étaient pas correctement citées.
- Prise en charge de Kerberos (Ajith Vilas, Alexander Kukushkin)
Il permet d’utiliser l’authentification Kerberos entre les nœuds Postgres au lieu de définir des mots de passe dans le fichier de configuration Patroni
- Gérer
pg_ident.conf(Alexander Kukushkin)
Cette fonctionnalité fonctionne de manière similaire à pg_hba.conf : si postgresql.pg_ident est défini dans le fichier de configuration ou dans le DCS, Patroni écrira sa valeur dans pg_ident.conf, toutefois, si postgresql.parameters.ident_file est défini, Patroni supposera que pg_ident est géré depuis l’extérieur et ne mettra pas à jour le fichier.
Améliorations de l’API REST
- Ajout du point de terminaison
/health(Wilfried Roset)
Il renverra un code d’état HTTP uniquement si PostgreSQL est en cours d’exécution
- Ajout des points d’accès
/read-onlyet/read-write(Julien Riou)
Le point d’accès /read-only permet des lectures équilibrées entre les répliques et le primaire. Le point d’accès /read-write est un alias de /primary, /leader et /master.
- Utilisez
SSLContextpour encapsuler la socket de l’API REST (Julien Riou)
L’utilisation de ssl.wrap_socket() est obsolète et permettait encore des protocoles bientôt obsolètes, tels que TLS 1.1.
Améliorations de la journalisation
- Journalisation en deux étapes (Alexander Kukushkin)
Tous les messages d’enregistrement sont d’abord écrits dans une file en mémoire et ensuite vidés de manière asynchrone vers stderr ou un fichier depuis un thread distinct. La taille maximale de la file est limitée (configurable). Si cette limite est atteinte, Patroni commencera à perdre des messages d’enregistrement, ce qui reste préférable à bloquer la boucle HA.
- Activer la journalisation de débogage pour les appels d’API GET/OPTIONS ainsi que la latence (Jan Tomsa)
Il facilitera le débogage des vérifications de santé effectuées par HAProxy, Consul ou d’autres outils qui déterminent quel nœud est le primaire ou la réplique.
- Journaliser les exceptions capturées dans Retry (Daniel Kucera)
Enregistrez l’exception finale lorsque le nombre d’essais ou le délai d’attente a été atteint. Cela devrait aider à déboguer certains problèmes survenant lors de la communication avec le DCS.
Améliorations apportées à patronictl
- Améliorer les dialogues pour le basculement planifié et le redémarrage (Rafia Sabih)
Les dialogues précédents ne tenaient pas compte des actions planifiées et étaient donc trompeurs.
- Vérifier l’existence du fichier de configuration (Wilfried Roset)
Sois explicite sur le fichier de configuration lorsque le nom de fichier fourni n’existe pas, plutôt que de l’ignorer silencieusement (ce qui peut entraîner une mauvaise compréhension).
- Ajouter une valeur de secours pour
EDITOR(Wilfried Roset)
Lorsque la variable d’environnement EDITOR n’était pas définie, patronictl edit-config échouait avec PatroniCtlException. La nouvelle stratégie consiste à essayer d’abord editor, puis vi, qui devraient être disponibles sur la plupart des systèmes.
Améliorations apportées au support de Consul
- Permet de spécifier le mode de cohérence Consul (Jan Tomsa)
Vous pouvez en savoir plus sur le mode cohérence ici .
- Recharger la configuration de Consul lors d’un signal SIGHUP (Cameron Daniel Kucera, Alexander Kukushkin)
Il est particulièrement utile lorsque quelqu’un modifie la valeur de token.
Correctifs de bogues
- Corriger un cas particulier lors du basculement planifié ou du basculement (Sharoon Thomas)
La variable scheduled_at peut être non définie si l’API REST n’est pas accessible et que le DCS est utilisé comme sauvegarde.
- Activer la confiance pour localhost dans
pg_hba.confpendant l’amorçage personnalisé (Alexander Kukushkin)
Précédemment, il était ouvert uniquement via unix_socket, ce qui provoquait de nombreuses erreurs : FATAL: no pg_hba.conf entry for replication connection from host "127.0.0.1", user "replicator"
- Considérer le nœud synchrone comme sain même lorsque l’ancien leader est en avance (Alexander Kukushkin)
Si le primaire perd l’accès au DCS, il redémarre PostgreSQL en lecture seule, mais il se peut que d’autres nœuds puissent encore accéder à l’ancien primaire via l’API REST. Ce cas de figure entraînait une non-promotion du standby synchrone, car l’ancien primaire signalait une position WAL supérieure à celle du standby synchrone.
- Correctifs de bogues pour le cluster de secours (Alexander Kukushkin)
Permettre l’amorçage d’une réplique dans un cluster de secours lorsque le standby_leader n’est pas accessible, ainsi que quelques autres corrections mineures.
Version 1.5.6
Sorti le 2019-08-03
Nouvelles fonctionnalités
- Prise en charge du cluster etcd via un ensemble de proxys (Alexander Kukushkin)
Il se peut que le cluster etcd ne soit pas accessible directement, mais via un ensemble de proxys. Dans ce cas, Patroni n’effectuera pas la découverte de la topologie etcd, mais effectuera un round-robin sur les hôtes proxy. Ce comportement est contrôlé par etcd.use_proxies.
- Modification du comportement des rappels lors du changement de rôle sur le nœud (Alexander Kukushkin)
Si le rôle a été modifié depuis master ou standby_leader vers replica ou depuis replica vers standby_leader, le rappel on_restart ne sera plus appelé, en faveur du rappel on_role_change.
- Modifier la manière dont PostgreSQL est lancé (Alexander Kukushkin)
Utilisez multiprocessing.Process au lieu d’exécuter le processus lui-même et multiprocessing.Pipe pour transmettre l’identifiant du processus postmaster au processus Patroni. Avant cela, nous utilisions des tubes, ce qui laissait le processus postmaster avec stdin fermé.
Correctifs de bogues
- Corriger le rôle retourné par l’API REST pour le leader en veille (Alexander Kukushkin)
Il renvoyait incorrectement replica au lieu de standby_leader
- Attendre la fin du rappel si celui-ci ne peut pas être interrompu (Julien Tachoires)
Patroni ne dispose pas de suffisamment de privilèges pour terminer le script de rappel en cours d’exécution sous sudo, qui annulait le nouveau script de rappel. Si le script en cours ne peut pas être arrêté, Patroni attendra qu’il se termine, puis exécutera le script de rappel suivant.
- Réduire le temps d’acquisition du verrou par la méthode dcs.get_cluster (Alexander Kukushkin)
En raison du verrou maintenu, la lenteur du DCS affectait les contrôles de santé de l’API REST, provoquant des faux positifs.
- Améliorer le nettoyage du répertoire PGDATA lorsque
pg_wal/`pg_xlog` est un lien symbolique (Julien Tachoires)
Dans ce cas, Patroni supprimera explicitement les fichiers du répertoire cible.
- Supprimer l’utilisation inutile de os.path.relpath (Ants Aasma)
Cela dépend de la possibilité de résoudre le répertoire de travail ; cela échouera si Patroni est lancé dans un répertoire qui est ultérieurement supprimé du système de fichiers.
- Ne pas imposer la version SSL lors de la communication avec etcd (Alexander Kukushkin)
Pour une raison inconnue, les paquets python3-etcd sur Debian et Ubuntu ne sont pas basés sur la dernière version du paquet et imposent donc TLSv1, qui n’est pas pris en charge par etcd v3. Nous avons résolu ce problème du côté de Patroni.
Version 1.5.5
Sorti le 15 février 2019
Cette version introduit la possibilité de réinitialisation automatique de l’ancien maître, améliore la sortie de la commande patronictl list et corrige un certain nombre de bogues.
Nouvelles fonctionnalités
- Ajouter le support des variables d’environnement
PATRONI_ETCD_PROTOCOL,PATRONI_ETCD_USERNAMEetPATRONI_ETCD_PASSWORD(Étienne M)
Avant, il était possible de les configurer uniquement dans le fichier de configuration ou en tant que partie de PATRONI_ETCD_URL, ce qui n’est pas toujours pratique.
- Permettre la réinitialisation automatique de l’ancien maître (Alexander Kukushkin)
Si pg_rewind est désactivé ou ne peut pas être utilisé, le ancien nœud maître pourrait ne pas parvenir à démarrer en tant que nouvelle réplique en raison de timelines divergentes. Dans ce cas, la seule solution consiste à effacer le répertoire de données et à réinitialiser. Ce comportement peut être modifié en définissant postgresql.remove_data_directory_on_diverged_timelines. Lorsqu’il est défini, Patroni effacera automatiquement le répertoire de données et réinitialisera le ancien nœud maître.
- Afficher les informations sur les timelines dans patronictl list (Alexander Kukushkin)
Il aide à détecter les répliques obsolètes. En outre, Host inclura « :{port} » si la valeur du port n’est pas celle par défaut ou s’il y a plus d’un membre en cours d’exécution sur le même hôte.
- Créez un service sans tête associé au point d’extrémité $SCOPE-config (Alexander Kukushkin)
Le point d’accès « config » conserve les informations relatives à la configuration Patroni et PostgreSQL au niveau du cluster, au fichier d’historique, et surtout, il contient la clé initialize. Lorsqu’un nœud maître Kubernetes est redémarré ou mis à jour, les points d’accès sans service sont supprimés. Le service sans adresse IP (headless) empêche cette suppression.
Correctifs de bogues
- Ajuster le délai d’attente en lecture pour la requête bloquante de surveillance du leader (Alexander Kukushkin)
Selon la documentation Consul, le délai d’attente réel de la réponse est augmenté d’un petit délai aléatoire ajouté au délai maximal fourni, afin de répartir les temps de réveil des requêtes concurrentes. Ce délai supplémentaire peut atteindre au maximum wait / 16 en plus de la durée maximale. Dans notre cas, nous ajoutons wait / 15 ou 1 seconde, selon la valeur la plus élevée.
- Utilisez toujours replication=1 lors de la connexion via le protocole de réplication à postgres (Alexander Kukushkin)
À compter de PostgreSQL 10, la ligne dans pg_hba.conf avec database=replication n’accepte plus les connexions comportant le paramètre replication=database.
- Ne pas écrire primary_conninfo dans recovery.conf pour un cluster de secours wal-only (Alexander Kukushkin)
Bien que ni host ni port ne soient définis dans la configuration du standby_cluster
, Patroni plaçait le primary_conninfo dans le recovery.conf, ce qui est inutile et génère de nombreuses erreurs.
Version 1.5.4
Sorti le 15 janvier 2019
Cette version implémente une journalisation flexible et corrige plusieurs bogues.
Nouvelles fonctionnalités
- Améliorations de l’infrastructure de journalisation (Alexander Kukushkin, Lucas Capistrant, Alexander Anikin)
La configuration de journalisation peut être définie non seulement à partir de variables d’environnement, mais également à partir du fichier de configuration Patroni. Cela permet de modifier la configuration de journalisation en temps réel en mettant à jour la configuration et en effectuant un rechargement ou en envoyant un signal SIGHUP au processus Patroni. Par défaut, Patroni écrit les journaux sur stderr, mais il est désormais possible d’écrire les journaux directement dans un fichier et de le faire tourner lorsque sa taille atteint un seuil défini. En outre, la prise en charge d’un format de date personnalisé a été ajoutée, ainsi que la possibilité de paramétrer finement le niveau de journalisation pour chaque module Python.
- Permettre de prendre en compte la timeline actuelle lors des élections de leader (Alexander Kukushkin)
Il se peut que le nœud se considère comme le plus sain, même s’il n’est pas sur la dernière timeline connue. Dans certains cas, il est souhaitable d’éviter de promouvoir un tel nœud, ce qui peut être réalisé en définissant le paramètre check_timeline à true (le comportement par défaut reste inchangé).
- Conditions assouplies concernant les identifiants de superutilisateur
Libpq permet d’ouvrir des connexions sans spécifier explicitement le nom d’utilisateur ni le mot de passe. Selon la situation, il s’appuie soit sur le fichier pgpass, soit sur la méthode d’authentification trust dans pg_hba.conf. Comme pg_rewind utilise également libpq, il fonctionne de la même manière.
- Implémenté la possibilité de configurer l’intervalle d’enregistrement du service Consul et l’intervalle de vérification via des variables d’environnement (Alexander Kukushkin)
L’enregistrement du service dans Consul a été ajouté à partir de la version 1.5.0, mais jusqu’à présent, il n’était possible de l’activer que via patroni.yaml.
Améliorations de la stabilité
- Passez archive_mode à off pendant l’amorçage personnalisé (Alexander Kukushkin)
Nous souhaitons éviter l’archivage des fichiers WAL et des fichiers d’historique jusqu’à ce que le cluster soit pleinement fonctionnel. Il est particulièrement utile que l’amorçage personnalisé implique pg_upgrade.
- Appliquer un délai de cinq secondes lors du chargement de la configuration globale au démarrage (Alexander Kukushkin)
Cela permet d’éviter de surcharger le DCS lors du démarrage initial de Patroni.
- Réduire le nombre de messages d’erreur générés lors de l’arrêt (Alexander Kukushkin)
Ils étaient inoffensifs mais plutôt ennuyeux et parfois effrayants.
- Sécuriser explicitement les permissions en lecture-écriture pour recovery.conf au moment de la création (Lucas Capistrant)
Nous ne souhaitons pas que quiconque d’autre que l’utilisateur Patroni/postgres puisse lire ce fichier, car il contient le nom d’utilisateur et le mot de passe de réplication.
- Rediriger les exceptions HTTPServer vers le journal (Julien Riou)
Par défaut, ces exceptions étaient journalisées sur la sortie standard, ce qui perturbait les journaux réguliers.
Correctifs de bogues
- Suppression du tuyau stderr vers stdout pour le processus pg_ctl (Cody Coons)
Hériter de stderr du processus principal Patroni permet de visualiser tous les journaux Postgres ainsi que tous les journaux Patroni. Cette fonctionnalité est particulièrement utile dans un environnement conteneurisé, où les journaux Patroni et Postgres peuvent être consommés à l’aide d’outils standards (docker logs, kubectl, etc.). En outre, ce changement corrige un bogue empêchant Patroni de capturer le PID du postmaster lorsque Postgres écrit des avertissements sur stderr.
- Définit le délai d’expiration de la désinscription de la vérification de service Consul au format Go time (Pavel Kirillov)
L’enregistrement échouait sans unité de temps explicitement mentionnée.
- Relâcher les contrôles de configuration du cluster standby_cluster (Dmitry Dolgov, Alexander Kukushkin)
Il acceptait uniquement des chaînes de caractères comme valeurs valides, ce qui rendait impossible de spécifier le port sous forme d’entier ou create_replica_methods sous forme de liste.
Version 1.5.3
Sorti le 2018-12-03
Version de compatibilité et de correction de bogues.
- Améliorer la stabilité lors de l’exécution avec python3 contre zookeeper (Alexander Kukushkin)
Le changement de loop_wait provoquait la déconnexion de Patroni de ZooKeeper, sans réconnection ultérieure.
- Corriger les incompatibilités avec PostgreSQL 9.3 (Alexander Kukushkin)
Lors de l’ouverture d’une connexion de réplication, il faut spécifier replication=1, car la version 9.3 ne comprend pas replication=‘database’
- Assurez-vous de rafraîchir la session Consul au moins une fois par boucle HA et améliorez le traitement des exceptions liées aux sessions Consul (Alexander Kukushkin)
Redémarrer l’agent Consul local invalide toutes les sessions associées au nœud. Ne pas appeler la mise à jour de session à temps et ne pas gérer correctement les erreurs de session entraînait une désactivation du primaire.
Version 1.5.2
Sorti le 26 novembre 2018
Version de compatibilité et de correction de bogues.
- Compatibilité avec kazoo-2.6.0 (Alexander Kukushkin)
Afin de garantir que les requêtes soient exécutées avec un délai approprié, Patroni redéfinit la méthode create_connection du module python-kazoo. La dernière version de kazoo a légèrement modifié la manière dont la méthode create_connection est appelée.
- Corriger le plantage de Patroni lorsque le cluster Consul perd son leader (Alexander Kukushkin)
L’incident était dû à une implémentation incorrecte de la méthode touch_member, qui doit renvoyer une valeur booléenne et ne doit pas lever d’exceptions.
Version 1.5.1
Sorti le 2018-11-01
Cette version introduit la prise en charge des slots de réplication permanents, ajoute la prise en charge de pgBackRest et corrige un certain nombre de bogues.
Nouvelles fonctionnalités
- Slots de réplication permanents (Alexander Kukushkin)
Les slots de réplication permanents sont conservés lors d’un basculement ou d’un basculement planifié : Patroni sur le nouveau nœud primaire créera les slots de réplication configurés dès la promotion. Ces slots peuvent être configurés à l’aide de patronictl edit-config. La configuration initiale peut également être définie dans bootstrap.dcs
.
- Ajouter la prise en charge de pgBackRest (Yogesh Sharma)
pgBackRest peut restaurer dans un dossier $PGDATA existant, ce qui permet une restauration rapide car les fichiers non modifiés depuis la dernière sauvegarde sont ignorés. Pour prendre en charge cette fonctionnalité, un nouveau paramètre keep_data a été introduit. Voir la section méthode de création de réplique
pour des exemples supplémentaires.
Correctifs de bogues
- Quelques correctifs de bogues dans le flux « cluster de secours » (Alexander Kukushkin)
Veuillez consulter https://github.com/patroni/patroni/pull/823 pour plus de détails.
- Corriger la vérification de santé de l’API REST lorsque la gestion du cluster est mise en pause et que le DCS n’est pas accessible (Alexander Kukushkin)
La régression a été introduite dans https://github.com/patroni/patroni/commit/90cf930036a9d5249265af15d2b787ec7517cf57
Version 1.5.0
Sorti le 2018-09-20
Cette version permet au cluster HA Patroni de fonctionner en mode veille, introduit un support expérimental de l’exécution sous Windows et propose un nouveau paramètre de configuration pour inscrire le service PostgreSQL dans Consul.
Nouvelles fonctionnalités
- Cluster de secours (Dmitry Dolgov)
Un ou plusieurs nœuds Patroni peuvent former un cluster de secours qui s’exécute en parallèle du cluster primaire (c’est-à-dire dans un autre centre de données) et se compose de nœuds de secours qui se répliquent à partir du maître du cluster primaire. Tous les nœuds PostgreSQL du cluster de secours sont des répliques ; l’une de ces répliques se désigne elle-même pour se répliquer directement à partir du maître distant, tandis que les autres se répliquent à partir d’elle selon une chaîne en cascade. Une description plus détaillée de cette fonctionnalité et quelques exemples de configuration sont disponibles à here .
Inscrire les services dans Consul (Pavel Kirillov, Alexander Kukushkin)
Si le paramètre
register_servicede la configuration Consul est activé, le nœud enregistre un service nomméscopeavec le tagmaster,replicaoustandby-leader.Prise en charge expérimentale de Windows (Pavel Golub)
À partir de maintenant, il est possible d’exécuter Patroni sous Windows, bien que le support Windows soit récent et n’ait pas bénéficié du même niveau de test dans des environnements réels que son équivalent Linux. Nous accueillons vos retours !
Améliorations apportées à patronictl
- Ajouter le drapeau patronictl -k/–insecure et la prise en charge du certificat restapi (Wilfried Roset)
Autrefois, si l’API REST était protégée par des certificats auto-signés, patronictl échouait à les vérifier. Il n’existait aucun moyen de désactiver cette vérification. Il est désormais possible de configurer patronictl pour ignorer complètement la vérification du certificat ou de fournir les certificats de l’autorité de certification et du client dans la section ctl: de la configuration.
- Exclure les membres portant l’étiquette nofailover de la sortie de patronictl switchover/failover (Alexander Anikin)
Précédemment, ces membres étaient incorrectement proposés comme candidats lors d’un basculement planifié ou d’un basculement interactif via patronictl.
Améliorations de stabilité
- Éviter l’analyse des lignes de sortie non au format clé-valeur de pg_controldata (Alexander Anikin)
Dans certains cas, pg_controldata peut produire des lignes sans caractère deux-points. Cela provoquait une erreur dans le code Patroni chargé d’analyser la sortie de pg_controldata, masquant ainsi le problème réel ; ces lignes apparaissent souvent dans un avertissement affiché par pg_controldata avant la sortie régulière, par exemple lorsque la version majeure du binaire ne correspond pas à celle du répertoire de données PostgreSQL.
- Ajouter le nom du membre au message d’erreur lors de l’élection du leader (Jan Mussler)
Pendant l’élection du leader, Patroni se connecte à tous les membres connus du cluster et demande leur état. Cet état est écrit dans le journal de Patroni et inclut le nom du membre. Auparavant, si le membre n’était pas accessible, le message d’erreur ne précisait pas son nom, ne contenant que l’URL.
- Réserver immédiatement la position WAL lors de la création de la fente de réplication (Alexander Kukushkin)
À partir de la version 9.6, la fonction pg_create_physical_replication_slot propose un paramètre booléen supplémentaire immediately_reserve. Lorsqu’il est défini à false, qui est également la valeur par défaut, l’emplacement ne réserve pas la position WAL jusqu’à la réception de la première connexion client, pouvant entraîner la perte de certains segments requis par le client pendant la fenêtre temporelle comprise entre la création de l’emplacement et la connexion initiale.
- Corriger un bug dans la réplication synchrone stricte (Alexander Kukushkin)
Lors de l’exécution avec synchronous_mode_strict: true, dans certains cas, Patroni place \* dans le synchronous_standby_names, ce qui modifie l’état de synchronisation pour la plupart des connexions de réplication en potential. Auparavant, Patroni ne pouvait pas sélectionner de candidat synchrone dans de telles circonstances, car il ne prenait en compte que ceux dont l’état était async.
Version 1.4.6
Sorti le 14 août 2018
Correctifs de bogues et améliorations de stabilité
Cette version corrige un problème critique concernant le point de terminaison de l’API Patroni /master, qui renvoyait un statut 200 pour un nœud non maître. Il s’agit d’un problème de rapport, sans véritable split-brain, mais dans certaines circonstances, les clients pourraient être dirigés vers le nœud en lecture seule.
- Réinitialisation de l’état leader lors d’une désactivation (Alexander Kukushkin, Oleksii Kliukin)
Assurez-vous que le membre du cluster dégradé cesse de répondre avec le code 200 à l’appel d’API /master.
- Ajouter un nouveau champ “cluster_unlocked” à la sortie de l’API (Dmitry Dolgov)
Ce champ indique si le cluster dispose d’un maître en cours d’exécution. Il peut être utilisé lorsque la requête d’un autre nœud n’est pas possible, mais qu’une réplique est accessible.
Version 1.4.5
Sorti le 2018-08-03
Nouvelles fonctionnalités
- Améliorer la journalisation lors de l’application de la nouvelle configuration PostgreSQL (Don Seiler)
Les journaux de Patroni ont modifié les noms et les valeurs des paramètres.
- Compatibilité Python 3.7 (Christoph Berg)
async est un mot-clé réservé dans python3.7
- Passez l’état à « stopped » dans le DCS lors de l’arrêt d’un membre (Tony Sorrentino)
Cela affiche l’état du membre comme « arrêté » dans la commande « patronictl list ».
- Améliorer le message journalisé lorsque postmaster.pid périmé correspond à un processus en cours (Ants Aasma)
L’ancien était au-delà du confusion.
- Implémenter la fonctionnalité de recharge de patronictl (Don Seiler)
Avant cela, il n’était possible de recharger la configuration que par l’appel d’une API REST ou en envoyant le signal SIGHUP au processus Patroni.
- Prendre et appliquer certains paramètres depuis controldata lors du démarrage en tant que réplique (Alexander Kukushkin)
La valeur de max_connections et certaines autres paramètres définis dans la configuration globale peuvent être inférieures à celle réellement utilisée par le serveur primaire ; dans ce cas, la réplique ne peut pas démarrer et doit être corrigée manuellement. Patroni s’occupe désormais de cette situation en lisant et en appliquant la valeur provenant de pg_controldata, en lançant PostgreSQL et en définissant le drapeau pending_restart.
- Si défini, utilisez LD_LIBRARY_PATH lors du démarrage de postgres (Chris Fraser)
Lors du démarrage de Postgres, Patroni transmettait précédemment les variables d’environnement PATH, LC_ALL et LANG si elles étaient définies. Il effectue désormais la même opération avec LD_LIBRARY_PATH. Cela devrait faciliter l’utilisation lorsque PostgreSQL est installé dans un emplacement non standard.
- Renommer create_replica_method en create_replica_methods (Dmitry Dolgov)
Pour préciser qu’il s’agit effectivement d’un tableau. Le nom ancien est toujours pris en charge pour assurer la compatibilité descendante.
Correctifs de bogues et améliorations de stabilité
- Correction de la condition de démarrage de la réplique en raison de pg_rewind en état d’arrêt (Oleksii Kliukin)
Évitez de démarrer la réplique qui a déjà exécuté pg_rewind.
- Répondre avec un statut 200 à la vérification de santé du maître uniquement si l’acquisition du verrou de mise à jour a réussi (Alexander Kukushkin)
Empêcher Patroni de s’auto-déclarer maître sur l’ancien maître (dégradé) si le DCS est partitionné.
- Corriger la compatibilité avec le nouveau module consul (Alexander Kukushkin)
À compter de la version 1.1.0, python-consul a modifié son API interne et utilise désormais list à la place de dict pour passer les paramètres de requête.
- Gérer les exceptions provenant du thread de l’API REST de Patroni lors de l’arrêt (Alexander Kukushkin)
Ces exceptions non traitées ont maintenu PostgreSQL en cours d’exécution à l’arrêt.
- Effectuer la récupération après incident uniquement lorsque PostgreSQL est en tant que maître (Alexander Kukushkin)
Exige pg_controldata pour signaler « in production », « shutting down » ou « in crash recovery ». Dans tous les autres cas, aucune récupération après panne n’est nécessaire.
- Améliorer la gestion des erreurs de configuration (Henning Jacobs, Alexander Kukushkin)
Il est possible de modifier de nombreux paramètres en temps réel (y compris restapi.listen) en mettant à jour le fichier de configuration Patroni et en envoyant un signal SIGHUP au processus Patroni. Cette correction élimine les exceptions obscures du thread ‘restapi’ lorsque certains paramètres reçoivent des valeurs non valides.
Version 1.4.4
Sorti le 22 mai 2018
Améliorations de stabilité
- Corriger la condition de course dans poll_failover_result (Alexander Kukushkin)
Il n’a pas affecté directement le basculement ni le basculement planifié, mais dans certains cas rares, il signalait un succès trop tôt, lorsque l’ancien leader libérait le verrou, entraînant un message « Basculé vers “Aucun” » au lieu de « Basculé vers “nœud-désiré” ».
- Traiter les noms de paramètres Postgres comme insensibles à la casse (Alexander Kukushkin)
La plupart des paramètres Postgres utilisent des noms au format snake_case, mais trois exceptions à cette règle existent : DateStyle, IntervalStyle et TimeZone. Postgres accepte ces paramètres même lorsqu’ils sont écrits avec une casse différente (par exemple, timezone = ‘some/tzn’) ; toutefois, Patroni n’a pas pu trouver de correspondance insensible à la casse pour ces noms dans pg_settings et a ignoré ces paramètres en conséquence.
- Interrompre le démarrage si la connexion à une instance PostgreSQL en cours d’exécution est tentée et que le cluster n’est pas initialisé (Alexander Kukushkin)
Patroni peut s’attacher à une instance Postgres déjà en cours d’exécution. Il est impératif de démarrer Patroni sur le nœud principal avant de procéder aux répliques.
- Corriger le comportement de patronictl scaffold (Alexander Kukushkin)
Passez un objet dict à touch_member au lieu d’une chaîne JSON encodée ; l’implémentation DCS s’occupera du codage.
- Ne pas rétrograder le maître si la mise à jour de la clé leader a échoué en pause (Alexander Kukushkin)
Pendant une maintenance, un DCS peut commencer à refuser les requêtes d’écriture tout en continuant à répondre aux requêtes de lecture. Dans ce cas, Patroni mettait auparavant le nœud maître PostgreSQL en mode lecture seule après avoir échoué à mettre à jour le verrou leader dans le DCS.
- Synchroniser les slots de réplication lorsque Patroni détecte un nouveau processus postmaster (Alexander Kukushkin)
Si PostgreSQL a été redémarré, Patroni doit s’assurer que la liste des slots de réplication correspond à ses attentes.
- Vérifiez le sysid et les slots de réplication synchrones après la reprise de la pause (Alexander Kukushkin)
En mode maintenance, il se peut que le répertoire de données ait été entièrement réécrit ; il est donc nécessaire de s’assurer que Database system identifier appartient toujours à notre cluster et que les slots de réplication sont synchronisés avec les attentes de Patroni.
- Corriger une éventuelle impossibilité de démarrage due à la présence d’un fichier de verrouillage postmaster dans un répertoire de données PostgreSQL (Alexander Kukushkin)
Détecter une réutilisation du PID à partir du fichier de verrou du postmaster. Ce problème est plus susceptible de se produire si vous exécutez Patroni et Postgres dans un conteneur Docker.
Renforcer la protection contre la suppression accidentelle du DCS (Alexander Kukushkin)
Patroni dispose de nombreux mécanismes pour empêcher un basculement dans ce cas et peut aussi restaurer toutes les clés. Toutefois, avant cette modification, la suppression accidentelle de la clé /config désactivait le mode pause pendant un cycle de la boucle HA.
Ne pas quitter lors de la découverte d’un ID système non valide (Oleksii Kliukin)
Ne quittez pas lorsque l’ID système du cluster est vide ou ne passe pas le contrôle de validation. Dans ce cas, le cluster nécessite probablement une réinitialisation ; mentionnez-le dans le message de résultat. Évitez d’arrêter Patroni, faute de quoi la réinitialisation ne pourra pas avoir lieu.
Compatibilité avec Kubernetes 1.10+
- Ajout d’une vérification des sous-ensembles vides (Cody Coons)
Kubernetes 1.10.0+ commence à retourner Endpoints.subsets défini sur None au lieu de \[\].
Améliorations de l’amorçage
- Rendre la suppression de recovery.conf facultative (Brad Nicholson)
Si bootstrap.<custom_bootstrap_method_name>.keep_existing_recovery_conf est définie et configurée sur True, Patroni ne supprimera pas le fichier recovery.conf existant. Cela est utile lors de l’amorçage à partir d’une sauvegarde avec des outils comme pgBackRest, qui génèrent automatiquement le recovery.conf approprié.
- Autoriser des options pour la méthode intégrée basebackup (Oleksii Kliukin)
Il est désormais possible de fournir des options à la méthode intégrée basebackup en définissant la section basebackup dans la configuration, de manière similaire à la manière dont elles sont définies pour les méthodes de création de réplique personnalisées. La différence réside dans le format accepté par la section basebackup : puisque pg_basebackup accepte à la fois des options --key=value et --key, le contenu de la section peut être soit un dictionnaire de paires clé-valeur, soit une liste de dictionnaires à un élément ou simplement des clés (pour les options qui ne prennent pas de valeur). Voir la section méthode de création de réplique
pour des exemples supplémentaires.
Version 1.4.3
Sorti le 2018-03-05
Améliorations de la journalisation
- Rendre le niveau de journalisation configurable via des variables d’environnement (Andy Newton, Keyvan Hedayati)
PATRONI_LOGLEVEL - définit le niveau de journalisation général
PATRONI_REQUESTS_LOGLEVEL - définit le niveau de journalisation pour toutes les requêtes HTTP, par exemple les appels à l’API Kubernetes
Voir la documentation sur le journalisation Python<https://docs.python.org/3.6/library/logging.html#levels> pour obtenir la liste des niveaux de journalisation possibles
Améliorations de stabilité et corrections de bogues
- Ne pas redécouvrir la topologie du cluster etcd lorsqu’une surveillance expirée (Alexander Kukushkin)
Si nous n’avons qu’un seul hôte dans la configuration etcd et que cet hôte précis n’est pas accessible, Patroni tentait de découvrir la topologie du cluster sans jamais y parvenir. Il devrait plutôt passer à l’hôte suivant disponible.
- Écrivez le contenu de bootstrap.pg_hba dans un pg_hba.conf après l’amorçage personnalisé (Alexander Kukushkin)
À présent, il se comporte de manière similaire à l’amorçage habituel avec initdb
- Le mode utilisateur unique attendait une entrée utilisateur et n’a jamais terminé (Alexander Kukushkin)
La régression a été introduite dans https://github.com/patroni/patroni/pull/576
Version 1.4.2
Sorti le 30 janvier 2018
Améliorations apportées à patronictl
- Renommer le basculement planifié en basculement planifié (Alexander Kukushkin)
Les fonctions de basculement et de basculement planifié ont été séparées à partir de la version 1.4, mais patronictl list signalait encore Scheduled failover au lieu de Scheduled switchover.
- Afficher les informations sur les redémarrages en attente (Alexander Kukushkin)
Pour appliquer certains changements de configuration, il peut être nécessaire de redémarrer PostgreSQL. Patroni indiquait déjà ce besoin via l’API REST et lors de l’écriture de l’état du nœud dans le DCS, mais il n’existait aucun moyen simple de le faire apparaître.
- Faire en sorte que show-config fonctionne avec cluster_name provenant du fichier de configuration (Alexander Kukushkin)
Il fonctionne de manière similaire à patronictl edit-config
Améliorations de stabilité
- Ne pas appeler pg_controldata pendant l’amorçage (Alexander Kukushkin)
Pendant l’initialisation avec initdb ou un amorçage personnalisé, il existe une fenêtre temporelle durant laquelle pgdata n’est pas vide, mais pg_controldata n’a pas encore été écrit. Dans ce cas, l’appel à pg_controldata échouait avec des messages d’erreur.
- Gérer les exceptions levées par psutil (Alexander Kukushkin)
La ligne de commande est lue et analysée à chaque appel de la méthode cmdline(). Il se peut que le processus examiné ait déjà disparu, auquel cas l’exception NoSuchProcess est levée.
Améliorations du support Kubernetes
- Ne pas masquer les erreurs provenant de l’API Kubernetes (Alexander Kukushkin)
Un appel à l’API Kubernetes peut échouer pour diverses raisons. Dans certains cas, cet appel doit être réessayé ; dans d’autres, il faut enregistrer le message d’erreur et la trace de la pile d’exceptions. Ce changement facilitera le débogage des problèmes d’autorisations Kubernetes.
- Mettre à jour l’exemple Dockerfile Kubernetes pour installer Patroni à partir de la branche master (Maciej Szulik)
Avant cela, il utilisait feature/k8s, qui est devenu obsolète.
- Ajouter une gestion RBAC appropriée pour exécuter Patroni sur k8s (Maciej Szulik)
Ajoutez le compte de service affecté aux pods du cluster, le rôle qui ne possède que les autorisations nécessaires, et le rôle lié qui associe le compte de service au rôle.
Version 1.4.1
Sorti le 17 janvier 2018
Correctifs apportés à patronictl
- Ne pas afficher le leader actuel dans la liste suggérée des membres vers lesquels effectuer un basculement. (Alexander Kukushkin)
patronictl failover peut encore fonctionner lorsque le cluster dispose d’un leader, qui doit être exclu de la liste des membres vers lesquels un basculement est possible.
- Rendre l’outil patronictl switchover compatible avec l’API ancienne de Patroni (Alexander Kukushkin)
En cas d’échec de l’appel API REST POST /switchover avec le code d’état 501, l’opération sera tentée à nouveau, mais cette fois vers l’endpoint /failover.
Version 1.4
Sorti le 10 janvier 2018
Cette version ajoute le support de Kubernetes en tant que DCS, permettant d’exécuter Patroni en tant qu’agent natif cloud dans Kubernetes sans déploiement supplémentaire d’etcd, Zookeeper ou Consul.
Avis de mise à jour
L’installation de Patroni via pip ne fournira plus automatiquement les dépendances relatives aux systèmes tels que etcd, Zookeeper, Consul ou Kubernetes, ni la prise en charge d’AWS. Pour activer ces fonctionnalités, il est nécessaire de les spécifier explicitement dans la commande pip install, par exemple pip install patroni\[etcd,kubernetes\].
Prise en charge Kubernetes
Implémentez un DCS basé sur Kubernetes. Les métadonnées des endpoints sont utilisées pour stocker la configuration et la clé du leader. Le champ métadonnées dans la définition des pods est utilisé pour stocker les données relatives aux membres. En plus de l’utilisation des endpoints, Patroni prend en charge les ConfigMaps. Vous trouverez davantage d’informations sur cette fonctionnalité dans le chapitre Kubernetes de la documentation
Améliorations de stabilité
- Extraire le processus postmaster dans un objet distinct (Ants Aasma)
Cet objet identifie un processus postmaster en cours d’exécution par son identifiant de processus (pid) et son heure de démarrage, et simplifie la détection (et la résolution) des situations où le postmaster a été redémarré en notre absence ou où le répertoire postgres a disparu du système de fichiers.
- Réduire le nombre de requêtes SELECT effectuées par Patroni à chaque itération du cycle HA (Alexander Kukushkin)
À chaque itération de la boucle HA, Patroni doit connaître l’état de récupération et la position absolue du WAL. À partir de maintenant, Patroni exécutera une seule requête SELECT pour obtenir ces informations, au lieu de deux sur la réplique et trois sur le maître.
- Supprimer la clé leader à l’arrêt uniquement lorsque nous détenons le verrou (Ants Aasma)
Suppression sans condition générant des exceptions inutiles et trompeuses.
Améliorations apportées à patronictl
- Ajouter la commande version à patronictl (Ants Aasma)
Il affichera la version de Patroni installée ainsi que les versions des instances Patroni en cours d’exécution (si le nom du cluster est spécifié).
- Rendre facultatif la spécification de l’argument cluster_name pour certaines commandes patronictl (Alexander Kukushkin, Ants Aasma)
Il fonctionnera si patronictl utilise un fichier de configuration Patroni habituel avec scope défini.
- Affiche les informations concernant le basculement planifié et le mode maintenance (Alexander Kukushkin)
Avant cela, il était possible d’obtenir ces informations uniquement à partir des journaux de Patroni ou directement depuis le DCS.
- Améliorer
patronictl reinit(Alexander Kukushkin)
Parfois, patronictl reinit refusait de poursuivre lorsque Patroni était occupé par d’autres actions, notamment la tentative de démarrage de postgres. patronictl
ne proposait aucune commande pour annuler ces actions longues, et la seule solution (dangereuse) consistait à supprimer manuellement le répertoire de données. La nouvelle implémentation de reinit annule forcément les autres actions longues avant de procéder à la réinitialisation.
- Implémenter le drapeau
--waitdanspatronictl pauseetpatronictl resume(Alexander Kukushkin)
Il fera attendre patronictl jusqu’à ce que l’action demandée soit reconnue par tous les nœuds du cluster. Ce comportement est obtenu en exposant le drapeau pause pour chaque nœud dans le DCS et via l’API REST.
- Renommer
patronictl failoverenpatronictl switchover(Alexander Kukushkin)
L’ancien failover n’était en réalité capable que d’un basculement planifié ; il refusait de s’exécuter dans un cluster ne comportant pas de leader.
- Modifier le comportement de
patronictl failover(Alexander Kukushkin)
Il fonctionnera même s’il n’y a pas de leader, mais dans ce cas, vous devrez spécifier explicitement un nœud qui doit devenir le nouveau leader.
Expose des informations sur la timeline et l’historique
- Exposer la timeline actuelle dans le DCS et via l’API (Alexander Kukushkin)
Stocke les informations concernant la timeline actuelle de chaque membre du cluster. Ces informations sont accessibles via l’API et sont stockées dans le DCS
- Stocker l’historique des promotions dans la clé /history dans le DCS (Alexander Kukushkin)
En outre, stockez l’historique des timelines enrichi de l’horodatage de la promotion correspondante dans la clé /history du DCS et mettez-le à jour à chaque promotion.
Ajouter des points de terminaison pour obtenir des répliques synchrones et asynchrones
- Ajouter de nouveaux points d’accès /sync et /async (Alexander Kukushkin, Oleksii Kliukin)
Ces points d’accès (également accessibles via /synchronous et /asynchronous) renvoient 200 uniquement pour les répliques synchrones et asynchrones respectivement (en excluant celles marquées comme
noloadbalance).
Autoriser plusieurs hôtes pour etcd
- Ajouter un nouveau paramètre
hostsà la configuration etcd (Alexander Kukushkin)
Ce paramètre doit contenir la liste initiale des hôtes utilisés pour découvrir et peupler la liste des membres en cours d’exécution du cluster etcd. Si, pour une raison quelconque, cette liste d’hôtes découverts est épuisée (aucun hôte disponible à partir de cette liste), Patroni reviendra à la liste initiale fournie par le paramètre hosts.
Version 1.3.6
Sorti le 10 novembre 2017
Améliorations de stabilité
- Vérifier l’heure de démarrage du processus lors de la vérification du statut de PostgreSQL. (Ants Aasma)
Après un plantage qui ne nettoie pas postmaster.pid, un nouveau processus peut avoir le même PID, entraînant un résultat faux positif pour is_running(), ce qui provoque diverses anomalies de comportement.
- Arrêtez PostgreSQL avant l’amorçage lorsque le répertoire de données est perdu (ainlolcat)
Lorsque le répertoire de données du maître est supprimé de force, le processus postgres peut rester en vie pendant un certain temps et empêcher la réplique créée à la place de ce maître précédent de démarrer ou de se répliquer. La correction fait en sorte que Patroni mette en cache le PID du postmaster et son heure de démarrage, puis termine proprement l’ancien postmaster s’il est toujours en cours d’exécution après la suppression du répertoire de données correspondant.
- Effectuer une récupération après incident en mode utilisateur unique si le serveur principal PostgreSQL tombe en panne (Alexander Kukushkin)
Il est dangereux de démarrer immédiatement en mode standby et impossible de faire fonctionner pg_rewind si PostgreSQL n’a pas été arrêté correctement. La récupération après incident en mode utilisateur unique ne s’active que si pg_rewind est activé ou s’il n’y a actuellement pas de maître.
Améliorations de Consul
- Permettre de fournir une configuration de datacenter pour Consul (Vilius Okockis, Alexander Kukushkin)
Avant cela, Patroni communiquait toujours avec le datacenter de l’hôte sur lequel il s’exécutait.
- Envoyer toujours un jeton dans l’en-tête HTTP X-Consul-Token (Alexander Kukushkin)
Si consul.token est défini dans la configuration de Patroni, nous l’envoyons toujours dans l’en-tête HTTP ‘X-Consul-Token’. Le module python-consul cherche à rester « cohérent » avec l’API REST de Consul, qui n’accepte pas le jeton en tant que paramètre de requête pour l’API session
, mais fonctionne toutefois avec l’en-tête ‘X-Consul-Token’.
- Ajuster la durée de vie de la session si la valeur fournie est inférieure au minimum autorisé (Stas Fomin, Alexander Kukushkin)
Il se peut que le TTL fourni dans la configuration Patroni soit inférieur au minimum supporté par Consul. Dans ce cas, l’agent Consul échoue à créer une nouvelle session. Sans session, Patroni ne peut pas créer de clés de membre ni de clé de leader dans le magasin de clés de Consul, ce qui entraîne un cluster défaillant.
Autres améliorations
- Définir un format de journal personnalisé via la variable d’environnement
PATRONI_LOGFORMAT(Stas Fomin)
Permet de désactiver les horodatages et d’autres champs similaires dans les journaux de Patroni si ces informations sont déjà ajoutées par le système de journalisation (généralement lorsque Patroni s’exécute en tant que service).
Version 1.3.5
Sorti le 12 octobre 2017
Correction de bogue
- Définir le rôle sur « uninitialized » si le répertoire de données a été supprimé (Alexander Kukushkin)
Si le nœud était en cours d’exécution en tant que maître, il empêchait le basculement.
Amélioration de la stabilité
- Essayez de lancer postmaster en mode utilisateur unique si nous avons tenté et échoué à démarrer postgres (Alexander Kukushkin)
Ce problème survient généralement lorsque le nœud exécutant en tant que maître a été interrompu et que les lignes temporelles sont devenues divergentes. Si recovery.conf définit restore_command, il y a de très fortes chances que PostgreSQL interrompe le démarrage et laisse le controldata inchangé. Cela rend impossible l’utilisation de pg_rewind, qui nécessite une fermeture propre.
Améliorations de Consul
- Permettre de spécifier des contrôles de santé lors de la création d’une session (Alexander Kukushkin)
Si non spécifié, Consul utilise « serfHealth ». D’une part, cela permet une détection rapide d’un maître isolé ; d’autre part, cela empêche Patroni de tolérer des perturbations réseau courtes.
Correction de bogue
- Corriger le watchdog sous Python 3 (Ants Aasma)
Une mauvaise compréhension de l’interface de l’appel ioctl(). Si mutable=False, alors fcntl.ioctl() renvoie effectivement le tampon arg. Cela fonctionnait accidentellement sous Python2 car la comparaison entre int et str ne renvoyait pas d’erreur. La signalisation des erreurs se fait en effet par la levée d’une IOError sous Python2 et d’une OSError sous Python3.
Version 1.3.4
Publié le 2017-09-08
Améliorations apportées à Consul
- Passez le jeton Consul en tant qu’en-tête (Andrew Colin Kissa)
Les en-têtes sont désormais la méthode privilégiée pour transmettre le jeton à l’API consul API .
- Configuration avancée pour Consul (Alexander Kukushkin)
possibilité de spécifier scheme, token, les certificats client et CA détails
.
- Compatibilité avec python-consul-0.7.1 et versions ultérieures ()
Le module python-consul nouvellement introduit a modifié la signature de certaines méthodes
- Le message « Could not take out TTL lock » n’a jamais été journalisé (Alexander Kukushkin)
Pas une erreur critique, mais le manque de journalisation appropriée complique l’investigation en cas de problème.
Utiliser quote_ident pour quote synchronous_standby_names
- Lors de l’écriture de
synchronous_standby_namesdanspostgresql.conf, sa valeur doit être entre guillemets (Alexander Kukushkin)
Si elle n’est pas correctement entre guillemets, PostgreSQL désactive effectivement la réplication synchrone et continue de fonctionner.
Plusieurs correctifs de bogues liés à l’état de pause, principalement liés au watchdog (Alexander Kukushkin)
- Ne pas envoyer de messages de maintien de connexion si le watchdog n’est pas actif
- Éviter d’activer le watchdog en mode pause
- Définir l’état correct de PostgreSQL en mode pause
- Ne pas tenter d’exécuter des requêtes depuis l’API si PostgreSQL est arrêté
Version 1.3.3
Sorti le 2017-08-04
Correctifs de bogues
- la réplication synchrone a été désactivée peu après la promotion, même lorsque synchronous_mode_strict était activé (Alexander Kukushkin)
- créer un fichier
pg_ident.confvide s’il est manquant après une restauration depuis une sauvegarde (Alexander Kukushkin) - ouvrir l’accès dans
pg_hba.confà toutes les bases de données, et non seulement à postgres (Franco Bellagamba)
Version 1.3.2
Sorti le 31 juillet 2017
Correction de bogue
- patronictl edit-config ne fonctionnait pas avec ZooKeeper (Alexander Kukushkin)
Version 1.3.1
Sorti le 28 juillet 2017
Correction de bogue
- le basculement via l’API était défaillant en raison d’un changement apporté à
_MemberStatus(Alexander Kukushkin)
Version 1.3
Sorti le 27 juillet 2017
Version 1.3 ajoute la possibilité d’amorçage personnalisé, améliore considérablement le support de pg_rewind, renforce le support du mode synchrone, ajoute l’édition de configuration à patronictl et implémente le support du watchdog sous Linux. En outre, il s’agit de la première version fonctionnant correctement avec PostgreSQL 10.
Avis de mise à jour
Aucun problème de compatibilité n’est connu avec la nouvelle version de Patroni. La configuration issue de la version 1.2 devrait fonctionner sans modification. Il est possible de procéder à la mise à jour en installant les nouveaux paquets, puis en redémarrant Patroni (ce qui entraîne un redémarrage de PostgreSQL), ou en mettant d’abord Patroni en mode pause , puis en redémarrant Patroni sur tous les nœuds du cluster (Patroni en mode pause ne tentera pas d’arrêter ou de démarrer PostgreSQL), avant de reprendre le mode normal à la fin.
Amorçage personnalisé
- Rendre le processus de bootstrap du cluster configurable (Alexander Kukushkin)
Autoriser l’utilisation de scripts d’amorçage personnalisés au lieu de initdb lors de l’initialisation du premier nœud du cluster. La commande d’amorçage reçoit le nom du cluster et le chemin du répertoire de données. Le cluster résultant peut être configuré pour effectuer une récupération, permettant ainsi de procéder à un amorçage à partir d’une sauvegarde et de réaliser une récupération à un instant donné. Pour une description détaillée de cette fonctionnalité, consulter la page documentation
.
Prise en charge améliorée de pg_rewind
- Décidez de l’exécution de pg_rewind en fonction des différences de timeline par rapport au maître actuel (Alexander Kukushkin)
Précédemment, Patroni disposait d’un ensemble fixe de conditions déclenchant pg_rewind, à savoir lors du démarrage d’un ancien nœud maître, lors d’un basculement planifié vers le nœud désigné pour chaque autre nœud du cluster, ou lorsqu’une réplique portait l’étiquette nofailover. Tous ces cas ont en commun un risque que certaines répliques soient en avance par rapport au nouveau maître. Dans certains cas, pg_rewind ne faisait rien ; dans d’autres, il ne s’exécutait pas lorsque cela était nécessaire. Au lieu de s’appuyer sur cette liste limitée de règles, Patroni compare désormais les positions WAL du maître et de la réplique (en utilisant le protocole de réplication en streaming) afin de déterminer de manière fiable si un rewind est nécessaire pour la réplique.
Mode de réplication synchrone strict
- Améliorer le support de la réplication synchrone en ajoutant le mode strict (James Sewell, Alexander Kukushkin)
Par défaut, lorsque le mode synchrone synchronous_mode
est activé et qu’aucune réplique n’est attachée au maître, Patroni désactive la réplication synchrone afin de maintenir le maître disponible en écriture. L’option synchronous_mode_strict modifie ce comportement : lorsqu’elle est définie, Patroni ne désactive pas la réplication synchrone en l’absence de répliques, ce qui bloque effectivement tous les clients tentant d’écrire des données sur le maître. En plus de la garantie du mode synchrone, qui empêche toute perte de données due à un basculement automatique, le mode strict assure que chaque écriture est soit durablement stockée sur deux nœuds, soit non effectuée du tout si le cluster ne contient qu’un seul nœud.
Édition de la configuration avec patronictl
- Ajouter la modification de configuration à patronictl (Ants Aasma, Alexander Kukushkin)
Ajouter la possibilité à patronictl de modifier la configuration dynamique d’un cluster stockée dans le DCS. La prise en charge permet de spécifier les paramètres/valeurs depuis la ligne de commande, d’inviter l’éditeur défini par la variable d’environnement $EDITOR, ou d’appliquer une configuration à partir d’un fichier YAML.
Prise en charge du watchdog sous Linux
- Implémenter la prise en charge du watchdog pour Linux (Ants Aasma)
Prise en charge du watchdog logiciel Linux afin de redémarrer le nœud sur lequel Patroni ne s’exécute pas ou ne répond pas (par exemple en cas de charge élevée). Le watchdog logiciel Linux redémarre le nœud non réactif. Il est possible de configurer le périphérique watchdog à utiliser (/dev/watchdog par défaut) et le mode (on, automatic, off) depuis la section watchdog de la configuration de Patroni. Vous pouvez obtenir davantage d’informations dans la documentation du watchdog
.
Ajouter la prise en charge de PostgreSQL 10
- Patroni est compatible avec toutes les versions bêta de PostgreSQL 10 publiées à ce jour, et nous prévoyons qu’il le sera également avec PostgreSQL 10 lors de sa sortie.
Améliorations mineures liées à PostgreSQL
- Définir pg_hba.conf via le fichier de configuration Patroni ou la configuration dynamique dans le DCS (Alexander Kukushkin)
Permet de définir le contenu de pg_hba.conf dans la sous-section pg_hba de la section postgresql de la configuration. Cela simplifie la gestion de pg_hba.conf sur plusieurs nœuds, car il suffit de le définir une seule fois dans le DCS au lieu de se connecter à chaque nœud, de le modifier manuellement et de recharger la configuration.
Lorsqu’il est défini, le contenu de cette section remplace entièrement le pg_hba.conf actuel. Patroni l’ignore si le paramètre PostgreSQL hba_file est défini.
- Prise en charge de la connexion via un socket UNIX au cluster PostgreSQL local (Alexander Kukushkin)
Ajoutez l’option use_unix_socket à la section postgresql de la configuration Patroni. Lorsqu’elle est définie à true et que l’option PostgreSQL unix_socket_directories n’est pas vide, permet à Patroni d’utiliser la première valeur de celle-ci pour se connecter au cluster PostgreSQL local. Si unix_socket_directories n’est pas définie, Patroni supposera sa valeur par défaut et omettra complètement le paramètre host dans la chaîne de connexion PostgreSQL.
Prise en charge du changement des identifiants de superutilisateur et de réplication lors du rechargement (Alexander Kukushkin)
Prise en charge du stockage des fichiers de configuration en dehors du répertoire de données PostgreSQL (@jouir)
Ajoutez la directive de configuration postgresql config_dir. Elle est par défaut définie sur le répertoire de données et doit être accessible en écriture par Patroni.
Correctifs de bogues et améliorations de stabilité
- Gérer les exceptions EtcdEventIndexCleared et EtcdWatcherCleared (Alexander Kukushkin)
Rétablissement plus rapide lorsque l’opération watch est terminée par etcd, en évitant les tentatives de réessai inutiles.
- Supprimer l’erreur de rotation due à un échec d’etcd et réduire le bruit dans les journaux (Ants Aasma)
Évitez de tenter immédiatement une nouvelle tentative et de générer des traces de pile dans les journaux lors des échecs de connexion etcd suivants.
- Exporter les variables locales lors du fork des processus PostgreSQL (Oleksii Kliukin)
Éviter l’erreur fatale postmaster became multithreaded during startup dans les locales non anglaises pour PostgreSQL compilé avec NLS.
- Vérifications supplémentaires lors de la suppression de la slot de réplication (Alexander Kukushkin)
Dans certains cas, Patroni est empêché de supprimer la slot de réplication par l’envoyeur WAL.
Tronquer le nom de la slot de réplication à 63 caractères (NAMEDATALEN - 1) pour respecter les règles de nommage de PostgreSQL (Nick Scott)
Corriger une condition de course entraînant l’ouverture de connexions supplémentaires vers le cluster PostgreSQL depuis Patroni (Alexander Kukushkin)
Libérer la clé leader lorsque le nœud redémarre avec un répertoire de données vide (Alex Kerney)
Mettre l’exécuteur asynchrone en état d’occupation lors de l’amorçage sans leader (Alexander Kukushkin)
Une telle omission pourrait entraîner des erreurs indiquant que le nœud appartient à un cluster différent, car Patroni poursuivait son fonctionnement normal tout en étant amorcé par une méthode d’amorçage ne nécessitant pas la présence d’un leader dans le cluster.
Améliorer la méthode de création de réplique WAL-E (Joar Wandborg, Alexander Kukushkin).
- Utilisez csv.DictReader pour analyser les sauvegardes complètes WAL-E, en acceptant les dates ISO avec une séparation entre date et heure par un espace.
- Prise en charge de la récupération de la position actuelle du WAL depuis la réplique afin d’estimer la quantité de WAL à restaurer. Auparavant, le code appelait des fonctions d’information système disponibles uniquement sur le nœud principal.
Version 1.2
Sorti le 13 décembre 2016
Cette version apporte des améliorations importantes dans la gestion de la réplication synchrone, rend le processus de démarrage et le basculement plus fiables, ajoute le support de PostgreSQL 9.6 et corrige de nombreux bogues. En outre, la documentation, y compris ces notes de version, a été déplacée vers .
Réplication synchrone
- Ajouter le support de la réplication synchrone. (Ants Aasma)
Ajoute une nouvelle variable de configuration synchronous_mode
. Lorsqu’elle est activée, Patroni gère synchronous_standby_names afin d’activer la réplication synchrone chaque fois qu’un serveur secondaire sain est disponible. Lorsque le mode synchrone est activé, Patroni ne bascule automatiquement vers un serveur secondaire que s’il était en réplication synchrone au moment de la panne du maître. Cela signifie effectivement qu’aucune transaction visible par l’utilisateur n’est perdue dans ce cas. Consultez la documentation de la fonctionnalité
pour obtenir une description détaillée et les informations sur l’implémentation.
Améliorations de la fiabilité
Ne tentez pas de mettre à jour la position du leader stockée dans la clé
leader optimelorsque PostgreSQL n’est pas 100 % sain. Baissez immédiatement le statut de leader en cas d’échec de la mise à jour de la clé du leader. (Alexander Kukushkin)Exclure les nœuds défaillants de la liste des cibles depuis lesquels cloner la nouvelle réplique. (Alexander Kukushkin)
Implémenter une stratégie de réessai et de délai d’attente pour Consul, similaire à celle utilisée pour etcd. (Alexander Kukushkin)
Faites en sorte que
--dcset--config-files’appliquent à toutes les options de patronictl . (Alexander Kukushkin)Écrivez tous les paramètres PostgreSQL dans postgresql.conf. (Alexander Kukushkin)
Il permet de démarrer PostgreSQL configuré par Patroni avec simplement pg_ctl.
Éviter les exceptions lorsque aucune utilisateur n’est défini dans la configuration. (Kirill Pushkin)
Autoriser la mise en pause d’un cluster défaillant. Avant cette correction, patronictl abandonnait si le nœud sur lequel il tentait d’exécuter la mise en pause était défaillant. (Alexander Kukushkin)
Améliorer la fonctionnalité de surveillance du leader. (Alexander Kukushkin)
Précédemment, les répliques surveillaient toujours la clé du leader (en attendant le délai d’attente ou un changement de la clé du leader). Avec cette modification, elles ne surveillent que lorsque PostgreSQL de la réplique est en état running et non lorsqu’il est arrêté, en cours de démarrage ou de redémarrage.
- Éviter les conditions de course lors de la gestion du signal SIGCHILD en tant que PID 1. (Alexander Kukushkin)
Un état de course pouvait autrefois se produire lors de l’exécution à l’intérieur de conteneurs Docker, car le même processus dans Patroni assurait à la fois la création de nouveaux processus et la gestion du signal SIGCHILD provenant de ceux-ci. Ce changement utilise des fork/exec pour Patroni et laisse le processus PID 1 original chargé de gérer les signaux émis par les enfants.
- Corriger la restauration WAL-E. (Oleksii Kliukin)
Précédemment, la restauration WAL-E utilisait le drapeau no_master pour éviter toute consultation du maître, ce qui faisait que Patroni choisissait toujours la restauration à partir des WAL plutôt que de pg_basebackup. Ce changement rétablit la signification d’origine de no_master, à savoir que la restauration WAL-E par Patroni peut être sélectionnée comme méthode de réplication si le maître n’est pas en cours d’exécution. Ce dernier état est vérifié en examinant la chaîne de connexion transmise à la méthode. En outre, cela rend le mécanisme de réessai plus robuste et gère d’autres détails subtils.
- Implémenter un cache de résolution DNS asynchrone. (Alexander Kukushkin)
Éviter les échecs lorsque le DNS est temporairement indisponible (par exemple, en raison d’un trafic excessif reçu par le nœud).
- Implémenter l’état initial et le délai d’attente pour le démarrage du maître. (Ants Aasma, Alexander Kukushkin)
Précédemment, pg_ctl attendait une expiration du délai avant de considérer sans réserve que PostgreSQL était en cours d’exécution. Cela faisait apparaître PostgreSQL comme en cours d’exécution dans les listes alors qu’il ne l’était pas réellement, entraînant une condition de course qui pouvait provoquer un basculement, une récupération après panne, ou une récupération après panne interrompue par un basculement, avec une réécriture manquante. Cette modification ajoute un paramètre master_start_timeout et introduit un nouvel état dans la boucle principale de haute disponibilité : starting. Lorsque master_start_timeout vaut 0, le basculement est immédiat en cas de panne du maître, dès qu’un candidat au basculement est disponible. Sinon, Patroni attend après avoir tenté de démarrer PostgreSQL sur le maître pendant la durée du délai ; une fois celui-ci expiré, il procède au basculement si possible. Les demandes de basculement manuel seront respectées même pendant la panne du maître, avant l’expiration du délai.
Introduisez le paramètre timeout dans l’endpoint d’API restart et dans la commande patronictl
. Lorsqu’il est défini et que le redémarrage prend plus de temps que le délai d’attente, PostgreSQL est considéré comme défaillant et les autres nœuds deviennent éligibles pour obtenir le verrou de leader.
- Corriger le comportement de
pg_rewinden mode pause. (Ants Aasma)
Éviter un redémarrage inutile en mode pause lorsque Patroni pense devoir effectuer un rewind mais que celui-ci n’est pas possible (par exemple, si pg_rewind est absent). Revenir aux valeurs par défaut de libpq pour superuser (utilisateur système par défaut) si l’authentification superuser est absente dans la section de configuration Patroni associée à pg_rewind.
Exécution sérialisée des rappels. Interrompre le rappel précédent du même type lorsqu’un nouveau rappel est sur le point de s’exécuter. Corrige le problème de création de processus fantômes lors de l’exécution des rappels. (Alexander Kukushkin)
Évitez de promouvoir un ancien maître lorsque la clé leader est définie dans le DCS, mais que la mise à jour de cette clé leader échoue. (Alexander Kukushkin)
Cela évite le problème d’un maître actuel qui continuerait à assumer son rôle lorsqu’il est isolé ensemble avec la minorité de nœuds dans etcd et d’autres systèmes de coordination (DCS) autorisant des lectures « incohérentes ».
Divers
- Ajouter l’option de configuration
post_initlors de l’amorçage. (Alejandro Martínez)
Patroni appellera le script spécifié par cet argument juste après avoir exécuté initdb et lancé PostgreSQL pour un nouveau cluster. Le script reçoit une URL de connexion avec superuser et définit PGPASSFILE pour qu’il pointe vers le fichier .pgpass contenant le mot de passe. Si le script échoue, l’initialisation de Patroni échoue également. Cette fonctionnalité est utile pour ajouter de nouveaux utilisateurs ou créer des extensions dans le nouveau cluster.
- Ajouter la prise en charge de PostgreSQL 9.6. (Alexander Kukushkin)
Utilisez wal_level = replica comme synonyme de hot_standby, en évitant le drapeau pending_restart lorsqu’il passe de l’un à l’autre. (Alexander Kukushkin)
Améliorations de la documentation
Ajouter un diagramme de workflow principal Patroni boucle . (Alejandro Martínez, Alexander Kukushkin)
Améliorer le fichier README en ajoutant le graphique Helm et les liens vers les notes de version. (Lauri Apple)
Déplacer la documentation Patroni vers
Read the Docs. La documentation à jour est disponible sur . (Oleksii Kliukin)

Rend la documentation facilement consultable depuis différents appareils (y compris les smartphones) et consultable par recherche.
- Déplacer le paquet vers la versionnement sémantique. (Oleksii Kliukin)
Patroni suivra le schéma de version majeur.mineur.patch afin d’éviter de publier une nouvelle version mineure pour des correctifs mineurs mais critiques. Seules les notes de version de la version mineure seront publiées, incluant tous les correctifs.
Version 1.1
Sorti le 2016-09-07
Cette version améliore la gestion du cluster Patroni grâce à la mise en place du mode pause, améliore la maintenance grâce à des redémarrages planifiés et conditionnels, renforce la résilience de l’interaction de Patroni avec etcd ou Zookeeper, et améliore considérablement patronictl.
Avis de mise à jour
Lors de la mise à jour à partir de versions inférieures à 1.0, consultez les notes de version de la version 1.0 pour en savoir plus sur le changement des identifiants et du format de configuration.
Mode pause
- Introduire le mode pause pour détacher temporairement Patroni de la gestion d’une instance PostgreSQL (Murat Kabilov, Alexander Kukushkin, Oleksii Kliukin).
Précédemment, il fallait envoyer le signal SIGKILL à Patroni pour l’arrêter sans interrompre PostgreSQL. La nouvelle mode pause détache Patroni du cluster PostgreSQL sans arrêter Patroni lui-même. Ce comportement est similaire au mode maintenance dans Pacemaker. Patroni reste responsable de la mise à jour des clés des membres et du leader dans le DCS, mais il ne lancera, n’arrêtera ni ne redémarrera le serveur PostgreSQL dans le processus. Quelques exceptions existent, par exemple les basculements manuels, les réinitialisations et les redémarrages restent autorisés. Vous pouvez consulter une description détaillée de cette fonctionnalité .
En outre, patronictl prend en charge de nouveaux commandes pause
et resume pour activer ou désactiver le mode pause.
Redémarrages planifiés et conditionnels
- Ajouter des conditions à la commande d’API de redémarrage (Oleksii Kliukin)
Ce changement améliore les redémarrages de Patroni en ajoutant plusieurs conditions pouvant être vérifiées afin d’effectuer le redémarrage. Ces conditions incluent le redémarrage lorsque le rôle PostgreSQL est soit un maître, soit une réplique, la vérification du numéro de version de PostgreSQL, ou encore le redémarrage uniquement lorsque celui-ci est nécessaire pour appliquer des modifications de configuration.
- Ajouter des redémarrages planifiés (Oleksii Kliukin)
Il est désormais possible de planifier un redémarrage à une date ultérieure. Un seul redémarrage planifié par nœud est pris en charge. Il est possible d’annuler un redémarrage planifié s’il n’est plus nécessaire. La combinaison de redémarrages planifiés et conditionnels est prise en charge, permettant par exemple de planifier des mises à jour mineures de PostgreSQL la nuit, en redémarrant uniquement les instances exécutant une version mineure obsolète, sans ajouter de logique spécifique à PostgreSQL dans les scripts d’administration.
- Ajouter la prise en charge des redémarrages conditionnels et planifiés dans patronictl (Murat Kabilov).
patronictl restart prend en charge plusieurs nouvelles options. Il existe également la commande patronictl flush pour supprimer les actions planifiées.
Interaction robuste avec le DCS
- Définir les délais d’attente de Kazoo en fonction de loop_wait (Alexander Kukushkin)
Initialement, les valeurs de ping_timeout et connect_timeout étaient calculées à partir du délai de session négocié. Le paramètre loop_wait de Patroni n’était pas pris en compte. En conséquence, une seule tentative de nouvelle connexion pouvait prendre plus de temps que le délai de session, ce qui forçait Patroni à libérer le verrou et à effectuer une désactivation.
Ce paramétrage réduit les délais de ping et de connexion à la moitié de la valeur de loop_wait, accélérant la détection des problèmes de connexion tout en laissant suffisamment de temps pour tenter de renouveler la tentative de connexion avant de perdre le verrou.
- Mettre à jour la topologie etcd uniquement après la réussite de la requête d’origine (Alexander Kukushkin)
Reportez la mise à jour de la topologie etcd connue par le client jusqu’après la requête initiale. Lors de la récupération de la topologie du cluster, implémentez les délais de nouvelle tentative en fonction du nombre de nœuds connu dans le cluster etcd. Cela fait préférer à notre client l’obtention des résultats de la requête à la mise à jour de la liste des nœuds.
Ces modifications rendent les connexions de Patroni au DCS plus robustes face aux problèmes réseau.
Patronictl, surveillance et configuration
- Renvoyer des informations sur les répliques en streaming via l’API (Feike Steenbergen)
Précédemment, il n’existait aucun moyen fiable de requêter Patroni concernant les instances PostgreSQL qui ne parvenaient pas à diffuser les modifications (par exemple, en raison de problèmes de connexion). Ce changement expose le contenu de pg_stat_replication via l’endpoint /patroni.
- Ajouter la commande scaffold patronictl (Oleksii Kliukin)
Ajoutez une commande permettant de créer une structure de cluster dans etcd. Le cluster est créé avec un sysid et un leader spécifiés par l’utilisateur, et les clés leader ainsi que les clés de membre sont rendues persistantes. Cette commande est utile pour créer des configurations dites « sans maître », dans lesquelles un cluster Patroni composé uniquement de répliques se synchronise à partir d’un nœud maître externe ignorant l’existence de Patroni. Par la suite, il est possible de supprimer la clé leader, ce qui permet de promouvoir l’un des nœuds Patroni et de remplacer le maître initial par un cluster HA basé sur Patroni.
- Ajouter l’option de configuration
bin_dirpour localiser les binaires PostgreSQL (Ants Aasma)
Il est utile de pouvoir spécifier explicitement l’emplacement des binaires PostgreSQL lorsque l’on utilise des distributions Linux prenant en charge l’installation de plusieurs versions de PostgreSQL en même temps.
- Permet de remplacer le chemin du fichier de configuration à l’aide de
custom_confde (Alejandro Martínez)
Permet de spécifier des chemins de fichiers de configuration personnalisés, qui ne seront pas gérés par Patroni, détails .
Correctifs de bogues et améliorations du code
- Rendre Patroni compatible avec le schéma de nouvelle version de PostgreSQL 10 et versions ultérieures (Feike Steenbergen)
Assurez-vous que Patroni comprend les numéros de version à deux chiffres lors de redémarrages conditionnels basés sur la version de PostgreSQL.
- Utilisez pkgutil pour trouver les modules DCS (Alexander Kukushkin)
Utilisez le module Python dédié au lieu de parcourir manuellement les répertoires pour localiser les modules DCS.
- Appeler toujours le rappel on_start au démarrage de Patroni (Alexander Kukushkin)
Précédemment, Patroni ne lançait aucune fonction de rappel lors de la connexion à un nœud déjà en cours d’exécution avec le rôle correct. Étant donné que les fonctions de rappel sont souvent utilisées pour acheminer les connexions clientes, cela pouvait entraîner l’échec de l’enregistrement du nœud en cours d’exécution dans le schéma de routage des connexions. Avec cette correction, Patroni appelle la fonction de rappel on_start même lorsqu’il se connecte à un nœud déjà en cours d’exécution.
- Ne supprimez pas les slots de réplication actifs (Murat Kabilov, Oleksii Kliukin)
Évitez de supprimer des slots de réplication physique actifs sur le maître. PostgreSQL ne peut pas les supprimer de toute façon. Ce changement permet d’exécuter des répliques ou consommateurs non gérés par Patroni sur le maître.
- Fermer les connexions Patroni au démarrage de l’instance PostgreSQL (Alexander Kukushkin)
Forcer Patroni à fermer toutes les connexions anciennes lors du démarrage d’un nœud PostgreSQL. Évite le piège de réutiliser des connexions anciennes si le postmaster a été tué avec SIGKILL.
- Remplacer les caractères non valides lors de la construction des noms de slot à partir des noms de membre (Ants Aasma)
Assurez-vous que les noms de bascule ne respectant pas les règles de nommage des slots ne provoquent pas l’échec de la création du slot ou du démarrage du serveur de secours. Remplacez les traits d’union dans les noms de slots par des traits de soulignement, et remplacez tous les autres caractères non autorisés dans les noms de slots par leurs codepoints Unicode.
Version 1.0
Sorti le 2016-07-05
Cette version introduit la configuration dynamique globale, qui permet de modifier dynamiquement les paramètres de configuration de PostgreSQL et de Patroni pour l’ensemble du cluster HA. Elle inclut également de nombreux correctifs.
Avis de mise à jour
Lors de la mise à jour à partir de la version v0.90 ou inférieure, mettez à jour toutes les répliques avant le maître. Comme nous ne stockons plus les identifiants de réplication dans le DCS, une ancienne réplique ne pourra pas se connecter au nouveau maître.
Configuration dynamique
- Implémenter la configuration globale dynamique (Alexander Kukushkin)
Introduire un nouvel endpoint d’API REST /config afin de fournir les paramètres de configuration de PostgreSQL et de Patroni qui doivent être définis globalement pour l’ensemble du cluster HA (maître et toutes les répliques). Ces paramètres sont définis dans le DCS et, dans de nombreuses situations, peuvent être appliqués sans interrompre PostgreSQL ou Patroni. Patroni définit un indicateur spécial appelé « pending restart », visible via l’API, lorsqu’une ou plusieurs valeurs nécessitent un redémarrage de PostgreSQL. Dans ce cas, le redémarrage doit être effectué manuellement via l’API.
Un signal SIGHUP envoyé à Patroni ou une requête POST vers /reload entraîne la relecture du fichier de configuration.
Consultez la configuration Patroni pour les détails sur les paramètres pouvant être modifiés et l’ordre de traitement des sources de configuration.
Le format du fichier de configuration a changé depuis la version 0.90. Patroni reste compatible avec les anciens fichiers de configuration, mais afin de bénéficier des paramètres d’amorçage, celui-ci doit être mis à jour. Les utilisateurs sont invités à procéder à cette mise à jour en se référant à la page de documentation de la configuration dynamique .
Configuration plus flexible*
- Rendre la configuration PostgreSQL et le nom de la base de données auxquelles Patroni se connecte configurables (Misja Hoebe)
Introduire les paramètres de configuration database et config_base_name. Parmi d’autres fonctionnalités, cela permet d’exécuter Patroni avec PipelineDB et d’autres dérivés de PostgreSQL.
- Ajouter la possibilité de configurer certains paramètres de Patroni via des variables d’environnement (Alexander Kukushkin)
Celles-ci incluent la portée, le nom du nœud et l’espace de noms, ainsi que les secrets, ce qui facilite l’exécution de Patroni dans un environnement dynamique, par exemple Kubernetes. Veuillez vous référer à la documentation des variables d’environnement pris en charge pour plus de détails.
Mettez à jour le conteneur Docker intégré de Patroni pour tirer parti de la configuration basée sur les variables d’environnement (Feike Steenbergen).
Ajouter le support Zookeeper à l’image Docker Patroni (Alexander Kukushkin)
Séparer les options de configuration de Zookeeper et d’Exhibitor (Alexander Kukushkin)
Faire que patronictl réutilise le code de Patroni pour lire la configuration (Alexander Kukushkin)
Cela permet à patronictl de tirer parti de la configuration basée sur l’environnement.
- Définir le nom de l’application sur le nom du nœud dans primary_conninfo (Alexander Kukushkin)
Cela simplifie l’identification et la configuration de la réplication synchrone pour un nœud donné.
Améliorations apportées à la stabilité, à la sécurité et à l’ergonomie
- Réinitialiser le sysid et ne pas appeler pg_controldata pendant la restauration d’une sauvegarde en cours (Alexander Kukushkin)
Ce changement réduit le bruit généré par les vérifications de santé de l’API Patroni pendant l’initialisation longue de ce nœud à partir de la sauvegarde.
- Corriger plusieurs cas limites de pg_rewind (Alexander Kukushkin)
Évitez d’exécuter pg_rewind si le cluster source n’est pas le maître.
En outre, évitez de supprimer le répertoire de données lors d’un rewind infructueux, sauf si le paramètre nouveau remove_data_directory_on_rewind_failure est défini sur true. Par défaut, il est false.
- Supprimer les mots de passe de la chaîne de connexion de réplication dans le DCS (Alexander Kukushkin)
Précédemment, Patroni utilisait toujours les identifiants de réplication extraits de l’URL PostgreSQL dans le DCS. Ce comportement a maintenant été modifié afin de prendre les identifiants depuis la configuration de Patroni. Les secrets (nom d’utilisateur et mot de passe de réplication) ne sont plus exposés dans le DCS.
- Corriger la mécanique asynchrone autour de l’appel de démotion (Alexander Kukushkin)
La commande Demote s’exécute désormais entièrement de manière asynchrone, sans bloquer les interactions avec le DCS.
- Forcer patronictl à toujours envoyer l’en-tête d’autorisation si celui-ci est configuré (Alexander Kukushkin)
Cela permet à patronictl d’émettre des requêtes « protégées », c’est-à-dire des redémarrages ou une réinitialisation, lorsque Patroni est configuré pour exiger une autorisation pour ces opérations.
- Gérer correctement l’exception SystemExit (Alexander Kukushkin)
Évite les problèmes liés à l’arrêt incorrect de Patroni lors de la réception du signal SIGTERM
- Exemples de modèles HAProxy pour confd (Alexander Kukushkin)
Génère et modifie dynamiquement la configuration HAProxy à partir de l’état Patroni dans le DCS à l’aide de confide
Améliorer et restructurer la documentation afin de la rendre plus accessible aux nouveaux utilisateurs (Lauri Apple)
L’API doit indiquer role=master lors de l’exécution de pg_ctl stop (Alexander Kukushkin)
Rend les appels de rappel plus fiables, en particulier dans le cas d’arrêt d’un cluster. En outre, introduit l’option pg_ctl_timeout pour définir le délai d’attente des appels de démarrage, d’arrêt et de redémarrage via pg_ctl.
- Corriger la logique de réessai dans etcd (Alexander Kukushkin)
Rendre les nouvelles tentatives plus prévisibles et plus robustes.
- Rendre le code Zookeeper plus résilient aux perturbations réseau courtes (Alexander Kukushkin)
Réduisez les délais d’attente de connexion pour rendre les tentatives de connexion à Zookeeper plus fréquentes.
Version 0.90
Sorti le 27 avril 2016
Cette version ajoute la prise en charge de Consul, introduit une nouvelle balise noloadbalance, modifie le comportement de la balise clonefrom, améliore la gestion de pg_rewind et améliore le programme de contrôle patronictl.
Prise en charge de Consul
- Implémenter le support Consul (Alexander Kukushkin)
Patroni fonctionne avec Consul, en plus d’etcd et de Zookeeper. Les paramètres de connexion peuvent être configurés dans le fichier YAML.
Nouvelles et améliorées : balises
- Implémenter l’étiquette noloadbalance (Alexander Kukushkin)
Ce tag fait que Patroni indique toujours au chargeur de trafic que la réplique n’est pas disponible.
- Modifier l’implémentation de l’étiquette clonefrom (Alexander Kukushkin)
Précédemment, un nom de nœud devait être fourni à l’option clonefrom, ce qui forçait une réplique étiquetée à se baser sur un nœud spécifique. La nouvelle implémentation rend clonefrom une balise booléenne : si elle est définie à true, la réplique devient candidate pour être utilisée comme source de clonage par d’autres répliques. Lorsque plusieurs candidates sont présentes, la réplique choisit aléatoirement l’une d’entre elles.
Améliorations de stabilité et de sécurité
- Plusieurs améliorations de fiabilité (Alexander Kukushkin)
Supprime certaines erreurs erronées, améliore la stabilité du basculement, corrige certains cas limites liés à la lecture des données depuis le DCS, ainsi que les opérations d’arrêt, de démotion et de réattache du ancien leader.
Améliorer le script système pour éviter de tuer les processus enfants de Patroni lors de l’arrêt (Jan Keirse, Alexander Kukushkin)
Auparavant, lors de l’arrêt de Patroni, systemd envoyait également un signal à PostgreSQL. Comme Patroni tentait lui aussi d’arrêter PostgreSQL, des demandes d’arrêt différentes étaient envoyées : l’arrêt intelligent, puis l’arrêt rapide. Les réplicas se déconnectaient alors trop tôt et l’ancien primaire ne pouvait plus rejoindre le cluster après sa rétrogradation. Correctif de Jan, fondé sur les recherches préalables d’Alexander.
Éliminer certains cas où l’ancien maître n’arrivait pas à exécuter pg_rewind avant de se réjoindre en tant que réplique (Oleksii Kliukin)
Précédemment, nous ne lançions pg_rewind que si l’ancien maître avait planté. Modifiez ce comportement pour exécuter pg_rewind en permanence sur l’ancien maître, à condition que pg_rewind soit présent dans le système. Cela corrige le cas où le maître est arrêté avant que les répliques n’aient pu récupérer les dernières modifications (par exemple, pendant un arrêt « smart »).
De nombreuses améliorations apportées aux tests unitaires et d’acceptation, en particulier, permettent désormais le support de Zookeeper et de Consul (Alexander Kukushkin).
Rendre Travis CI plus rapide et implémenter le support de l’exécution des tests contre Zookeeper (Exhibitor) et Consul (Alexander Kukushkin)
Les tests unitaires et les tests d’acceptation s’exécutent automatiquement contre etcd, Zookeeper et Consul à chaque validation ou demande de fusion.
- Effacez les variables d’environnement avant d’appeler les commandes PostgreSQL depuis Patroni (Feike Steenbergen)
Cela empêche la possibilité de lire les variables d’environnement système en se connectant au cluster PostgreSQL géré par Patroni.
Modifications de configuration et de contrôle
- Unifier patronictl et la configuration Patroni (Feike Steenbergen)
patronictl peut utiliser le même fichier de configuration que Patroni lui-même.
- Activer la lecture de la configuration par Patroni depuis les variables d’environnement (Oleksii Kliukin)
Cela simplifie la génération automatique de la configuration pour Patroni, ou la fusion d’une configuration unique provenant de différentes sources.
Inclure l’identifiant du système de base de données dans les informations renvoyées par l’API (Feike Steenbergen)
Implémenter delete_cluster pour tous les DCS disponibles (Alexander Kukushkin)
Active la prise en charge de systèmes DCS autres qu’etcd dans patronictl.
Version 0.80
Sorti le 14 mars 2016
Cette version introduit la prise en charge de la réplication en cascade et simplifie la gestion de Patroni grâce à la mise en place de basculages planifiés. Il est possible d’utiliser des versions antérieures de Patroni (en particulier la 0.78) combinées à celle-ci afin de migrer vers la nouvelle version. Notez que les fonctionnalités liées au basculement planifié et à la réplication en cascade ne fonctionneront qu’avec Patroni 0.80 et versions ultérieures.
Réplication en cascade
- Ajouter la prise en charge des balises replicatefrom et clonefrom pour le nœud Patroni (Oleksii Kliukin).
La balise replicatefrom permet à une réplique d’utiliser un nœud arbitraire comme source, pas nécessairement le maître. La balise clonefrom fait de même pour la sauvegarde initiale. Ensemble, elles permettent à Patroni de prendre entièrement en charge la réplication en cascade.
- Ajouter le support pour exécuter les méthodes de réplication afin d’initialiser la réplique même en l’absence de connexion de réplication active (Oleksii Kliukin).
Cela est utile pour créer des répliques à partir des instantanés stockés sur S3 ou FTP. Une méthode de réplication ne nécessitant pas de connexion de réplication active doit indiquer no_master: true dans la configuration YAML. Ces scripts seront toutefois exécutés dans l’ordre si une connexion de réplication est présente.
Patronictl, améliorations de l’API et du DCS
- Implémenter des basculements planifiés (Feike Steenbergen).
Les basculements peuvent être planifiés pour avoir lieu à une heure future donnée, à l’aide de patronictl ou d’appels à l’API.
Ajouter la prise en charge des paramètres dbuser et password dans patronictl (Feike Steenbergen).
Ajouter la version de PostgreSQL à la sortie de vérification de santé (Feike Steenbergen).
Améliorer le support de Zookeeper dans patronictl (Oleksandr Shulgin)
Migrer vers python-etcd 0,43 (Alexander Kukushkin)
Configuration
- Ajouter un script de configuration système d’exemple pour Patroni (Jan Keirse).
- Corriger le problème de Patroni ignorant le nom d’utilisateur superutilisateur spécifié dans le fichier de configuration pour les connexions à la base de données (Alexander Kukushkin).
- Corriger la gestion du signal CTRL-C en créant un identifiant de session et un groupe de processus séparés pour le postmaster lancé par Patroni (Alexander Kukushkin).
Tests
- Ajouter des tests d’acceptation avec behave afin de vérifier des scénarios réels de fonctionnement de Patroni (Alexander Kukushkin, Oleksii Kliukin).
Les tests peuvent être lancés manuellement à l’aide de la commande behave. Ils sont également lancés automatiquement pour les demandes de fusion et après chaque validation.
Les notes de version pour certaines versions antérieures sont disponibles sur la page GitHub du projet project’s github page .
20 - Guidelines pour les contributions
Discussion
Si vous avez une question, recherchez une aide interactive pour dépanner ou souhaitez discuter avec d’autres utilisateurs Patroni, rejoignez-nous sur le canal #patroni dans PostgreSQL Slack .
Signalement de bogues
Avant de signaler un bogue, assurez-vous d’en reproduire l’incident avec la dernière version de Patroni ! Veuillez également vérifier soigneusement si le problème n’existe pas déjà dans notre Suivi des problèmes .
Exécution des tests
Conditions requises pour exécuter les tests behave :
- Les paquets PostgreSQL incluant les modules contrib doivent être installés.
- Les binaires PostgreSQL doivent être disponibles dans votre
PATH. Vous devrez peut-être les ajouter au chemin en utilisant quelque chose commePATH=/usr/lib/postgresql/11/bin:\$PATH python -m behave. - Si vous souhaitez effectuer des tests avec des DCS externes (par exemple, etcd, Consul ou Zookeeper), vous devrez installer les paquets correspondants et faire fonctionner les services associés, qui doivent accepter les connexions non chiffrées/non protégées sur localhost et le port par défaut. Dans le cas d’Etcd ou de Consul, le jeu de tests behave peut les démarrer s’ils sont disponibles dans le
PATH.
Installer les dépendances :
Une fois toutes les dépendances installées, vous pouvez exécuter les différentes suites de tests :
Test avec tox
Pour exécuter les tests tox, vous devez installer une seule dépendance (en plus de Python).
Si vous souhaitez exécuter les tests behave, vous devez également disposer de Docker installé.
La configuration Tox dans tox.ini dispose d’« environments » permettant d’exécuter les tâches suivantes :
- lint : analyse de code Python avec
flake8 - test : tests unitaires pour tous les interpréteurs Python disponibles avec
pytest, génération de rapports XML ou HTML si un TTY est détecté - dep : détection des conflits de dépendances de paquets à l’aide de
pipdeptree - type : vérification statique des types avec
pyright - black : formatage du code avec
black - docker-build : construction de l’image Docker utilisée pour l’environnement
behave - docker-cmd : exécution d’une commande arbitraire avec l’image précédente
- docker-behave-etcd : exécution de tox pour les tests behave avec l’image précédente
- py*behave : exécution de behave avec les interpréteurs Python disponibles (sans Docker, bien que ce soit ce qui soit appelé à l’intérieur des conteneurs Docker)
- docs : génération de la documentation avec
sphinx
Exécution de tox
Pour exécuter la liste d’environnements par défaut (dep, lint, test et docs), exécutez simplement :
Les variables d’environnement test peuvent être exécutées avec l’étiquette `test` :
Les tests Docker behave peuvent être exécutés avec l’étiquette `behave` :
De même, docs porte l’étiquette docs.
Tous les autres environnements peuvent être exécutés avec leurs noms respectifs :
Il est également possible de sélectionner des listes d’environnement partielles à l’aide de factors. Par exemple, si vous souhaitez exécuter toutes les environnements pour Python 3.10 :
Cela équivaut à exécuter tous les environnements listés ci-dessous :
Vous pouvez lister toutes les combinaisons d’environnements configurées avec tox (≥ v4) comme suit
Les variables d’environnement test et docs tenteront d’ouvrir les fichiers de sortie HTML une fois la tâche terminée, si tox est exécuté depuis un terminal actif. Cette fonction est destinée à faciliter le travail du développeur exécutant cet environnement localement. Elle tentera d’exécuter open sur macOS et xdg-open sur Linux. Pour utiliser une commande différente, définissez la variable d’environnement OPEN_CMD avec le nom ou le chemin de la commande. Si cette étape échoue, cela n’empêchera pas l’exécution globale de la tâche. Pour désactiver cette fonctionnalité, définissez la variable d’environnement OPEN_CMD sur la commande no-op :.
Tests Behave
Les tests Behave avec -m behave construiront des images Docker basées sur les versions 11 à 16 de PG_MAJOR, puis exécuteront tous les tests Behave. Cette opération peut prendre beaucoup de temps, il est donc recommandé de limiter la portée à une version spécifique de PostgreSQL ou à un ensemble spécifique de fonctionnalités ou d’étapes.
Pour spécifier la version de postgres, indiquez le nom complet de l’environnement de build de l’image dépendante que vous souhaitez utiliser, suivi du nom de l’environnement behave. Par exemple, pour utiliser Postgres 14 :
Si, en revanche, vous souhaitez tester une fonctionnalité spécifique, vous pouvez passer des arguments positionnels à behave. Cela exécutera la scénario de test de fonctionnalité watchdog behave avec toutes les versions de Postgres.
Bien sûr, vous pouvez combiner les deux.
Contribution d’une demande de fusion
- Fork le dépôt, développez et testez vos modifications de code.
- Mettez à jour la documentation utilisateur.
- Soumettez une requête de fusion avec une description claire de l’objectif des modifications. Liez une issue existante si nécessaire.
Vous recevrez un retour sur votre demande de tirage dès que possible.
Bon hacking avec Patroni ;-)