Vue imprimable multi-pages de cette section. .
Guide des opérations
- 1: Guides d'authentification
- 2: Options de configuration
- 3: Modèle de sécurité du transport
- 4: Guide de clustering
- 5: Exécuter des clusters etcd dans des conteneurs
- 6: Exécuter des clusters etcd en tant que StatefulSet Kubernetes
- 7: Modes de défaillance
- 8: Récupération après sinistre
- 9: etcd gateway
- 10: Proxie gRPC
- 11: Recommandations matérielles
- 12: Maintenance
- 13: Surveillance d’etcd
- 14: Performances
- 15: Conception de la reconfiguration à l'exécution
- 16: Reconfiguration en cours d'exécution
- 17: Plateformes prises en charge
- 18: Gestion des versions
- 19: Corruption des données
1 - Guides d'authentification
1.1 - Authentification
auth,user,role pour l’authentification :
Note :
Il s’agit simplement d’un squelette qui doit être complété et mis à jour avec des informations supplémentaires sur l’authentification. Le texte ci-dessus n’est qu’un exemple de code.
1.2 - Contrôle d'accès basé sur les rôles
Aperçu
L’authentification a été ajoutée à etcd 2.1. L’API v3 d’etcd a légèrement modifié l’API et l’interface utilisateur de la fonctionnalité d’authentification afin de mieux s’adapter au nouveau modèle de données. Ce guide vise à aider les utilisateurs à configurer une authentification basique et un contrôle d’accès basé sur les rôles dans etcd v3.
Utilisateurs et rôles spéciaux
Il existe un utilisateur spécial, root, et un rôle spécial, root.
Utilisateur root
L’utilisateur root, qui dispose d’un accès complet à etcd, doit être créé avant d’activer l’authentification. L’idée derrière l’utilisateur root est d’assurer des opérations administratives : gestion des rôles et des utilisateurs ordinaires. L’utilisateur root doit posséder le rôle root et est autorisé à modifier tout élément à l’intérieur d’etcd.
Rôle root
Le rôle root peut être attribué à tout utilisateur, en plus de l’utilisateur racine. Un utilisateur disposant du rôle root dispose à la fois d’un accès en lecture-écriture global et des autorisations pour mettre à jour la configuration d’authentification du cluster. En outre, le rôle root accorde les privilèges nécessaires à la maintenance générale du cluster, notamment la modification de la composition du cluster, la défragmentation du magasin et la prise d’instantanés.
Travail avec les utilisateurs
Le sous-commande user pour etcdctl gère toutes les opérations relatives aux comptes utilisateurs.
Une liste des utilisateurs peut être obtenue avec :
Créer un utilisateur est aussi simple que
La création d’un nouvel utilisateur demande de saisir un nouveau mot de passe. Le mot de passe peut être fourni depuis l’entrée standard lorsque l’option --interactive=false est utilisée. --new-user-password peut également être utilisé pour fournir le mot de passe.
La création d’un utilisateur qui ne peut pas être authentifié avec un mot de passe est également possible, comme indiqué ci-dessous :
Un tel utilisateur ne peut être authentifié que par TLS Common Name .
etcd ne prend pas en charge l’authentification avec un mot de passe vide via --user username:. Par exemple, un utilisateur créé avec un mot de passe vide, tel que etcdctl user add anonymous:'', ne peut pas s’authentifier par des requêtes username/password et les requêtes telles que etcdctl --user anonymous: get foo échouent avec user name is empty.
Les rôles peuvent être attribués ou retirés à un utilisateur avec :
Les paramètres de l’utilisateur peuvent être inspectés à l’aide de :
Et le mot de passe d’un utilisateur peut être modifié avec
Changer le mot de passe provoquera une nouvelle demande de mot de passe. Le mot de passe peut être fourni depuis l’entrée standard lorsque l’option --interactive=false est utilisée.
Supprimez un compte avec :
Travail avec les rôles
Le sous-commande role pour etcdctl gère toutes les opérations relatives aux contrôles d’accès pour des rôles spécifiques, tels qu’ils ont été attribués à des utilisateurs individuels.
Lister les rôles avec :
Créez un nouveau rôle avec :
Un rôle n’a pas de mot de passe ; il définit simplement un nouvel ensemble de droits d’accès.
Les rôles ont accès à une clé unique ou à une plage de clés.
La plage peut être spécifiée sous la forme d’un intervalle [clé_de_depart, clé_de_fin) où la clé_de_depart doit être strictement inférieure à la clé_de_fin selon un ordre alphabétique.
L’accès peut être accordé en lecture, écriture ou les deux, comme dans les exemples suivants :
Pour voir ce qui est accordé, nous pouvons consulter le rôle à tout moment :
La révocation des autorisations s’effectue de la même manière logique :
Comme pour supprimer un rôle entièrement :
Activer l’authentification
Les étapes minimales pour activer l’authentification sont les suivantes. L’administrateur peut configurer les utilisateurs et les rôles avant ou après l’activation de l’authentification, selon son choix.
Assurez-vous que l’utilisateur racine est créé :
Activer l’authentification :
Après cela, etcd fonctionne avec l’authentification activée. Pour la désactiver pour une raison quelconque, utilisez la commande inverse :
Portée de sécurité de l’authentification
Lorsque l’authentification est activée avec etcdctl auth enable, elle protège les opérations de l’API gRPC V3 (get, put, delete, surveillance, etc.).
Les points de terminaison HTTP /metrics et /health fonctionnent sur un gestionnaire distinct et ne sont pas protégés par l’authentification RBAC V3. Ce design permet à Prometheus et aux équilibreurs de charge de récupérer les métriques sans nécessiter d’authentification gRPC, tout en maintenant la protection des données clé-valeur.
Pour sécuriser ces points de visualisation :
- Activez le mTLS avec
--cert-file,--key-fileet--client-cert-auth - Ou liez les métriques à une interface privée en utilisant
--listen-metrics-urls - Ou utilisez des règles de réseau policies/firewall pour restreindre l’accès
Utilisation de etcdctl pour l’authentification
etcdctl prend en charge un indicateur similaire à curl pour l’authentification.
Le mot de passe peut être fourni à partir d’une invite :
Le mot de passe peut également être fourni via une option de ligne de commande --password :
Sinon, toutes les commandes etcdctl restent identiques. Les utilisateurs et rôles peuvent toujours être créés et modifiés, mais nécessitent une authentification par un utilisateur disposant du rôle root.
Utilisation du nom commun TLS
À compter de la version v3.2, si un serveur etcd est lancé avec l’option --client-cert-auth=true, le champ Common Name (CN) du certificat TLS du client sera utilisé comme utilisateur etcd. Dans ce cas, le nom commun sert à authentifier l’utilisateur, et le client n’a pas besoin de mot de passe. Notez que si les deux conditions suivantes sont remplies : 1. --client-cert-auth=true est fourni et le CN est fourni par le client, et 2. le nom d’utilisateur et le mot de passe sont fournis par le client, l’authentification basée sur le nom d’utilisateur et le mot de passe est prioritaire. Notez que cette fonctionnalité ne peut pas être utilisée avec gRPC-proxy ni avec gRPC-gateway. Cela est dû au fait que gRPC-proxy termine la connexion TLS provenant de son client, si bien que tous les clients partagent un certificat du proxy. gRPC-gateway utilise une connexion TLS interne pour transformer une requête HTTP en requête gRPC, ce qui entraîne la même limitation. Par conséquent, les clients ne peuvent pas transmettre correctement leur CN au serveur. gRPC-proxy provoquera une erreur et s’arrêtera si le certificat fourni a un CN non vide. gRPC-proxy renvoie une erreur indiquant que le client possède un CN non vide dans son certificat.
Remarques sur la force du mot de passe
Les API etcdctl et etcd n’imposent aucune longueur de mot de passe particulière lors de la création d’un utilisateur ou de la mise à jour de son mot de passe. Il incombe à l’administrateur d’appliquer ces exigences. Pour réduire les risques liés aux mots de passe faibles, utilisez l’authentification fondée sur le nom commun TLS
ainsi que des utilisateurs créés avec l’option --no-password.
2 - Options de configuration
Vous pouvez configurer etcd à l’aide des éléments suivants :
- Options en ligne de commande
- Variables d’environnement : chaque option a une variable d’environnement correspondante
dont le nom est identique, mais préfixé par
ETCD_et écrit en majuscules et [en notation snake case][]. Par exemple,--some-flagseraETCD_SOME_FLAG. - Fichier de configuration
Avertissement : Si vous mélangez des options de configuration, les règles suivantes s’appliquent.
- Les indicateurs en ligne de commande ont la priorité sur les variables d’environnement.
- Si vous fournissez un fichier de configuration, tous les indicateurs en ligne de commande et les variables d’environnement sont ignorés.
Drapeaux de ligne de commande
Les indicateurs sont présentés ci-dessous selon le format --flag-name DEFAULT_VALUE.
La liste des indicateurs fournie ci-dessous peut ne pas être à jour en raison des modifications en cours de développement. Pour obtenir la liste des indicateurs disponibles, exécutez etcd --help ou consultez l’aide de [etcd][].
Remarque : Pour plus de détails concernant les indicateurs nouveaux, mis à jour ou obsolètes de la version 3.7, consultez [CHANGELOG-3.7.md][changelog].
[journal des modifications] : https://github.com/etcd-io/etcd/blob/main/CHANGELOG/CHANGELOG-3.7.md
membre
Clusterisation
Sécurité
Auth
Analyse de performances et surveillance
Journalisation
Remarque : Plusieurs indicateurs --experimental-* ont été promus ou renommés dans la version 3.7.
Veillez à remplacer les indicateurs obsolètes par leurs équivalents stables indiqués ci-dessous.
Traçage distribué
v2 Proxy
Remarque : les indicateurs seront obsolètes à partir de la version v3.6.
Fonctionnalités
Portes fonctionnelles
Fonctionnalités non sécurisées
Avertissement : l’utilisation de fonctionnalités non sécurisées peut compromettre les garanties offertes par le protocole de consensus !
Fichier de configuration
Un fichier de configuration etcd est constitué d’une carte YAML dont les clés sont les noms de drapeaux en ligne de commande et les valeurs sont les valeurs des drapeaux.
Pour utiliser ce fichier, indiquez le chemin du fichier comme valeur du drapeau --config-file ou de la variable d’environnement ETCD_CONFIG_FILE.
Pour un exemple, voir l’exemple [etcd.conf.yml ][].
Les champs de durée tels que --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration et --downgrade-check-time acceptent
des chaînes lisibles (par exemple 10m, 5s) comme options de ligne de commande, mais
dans un fichier de configuration, ils n’acceptent que des valeurs entières représentant
des nanosecondes. Il s’agit d’une limitation connue de la bibliothèque standard Go
,
où time.Duration est désérialisé comme un entier simple.
Par exemple, pour définir un intervalle de notification de progression de 10 minutes dans un fichier de configuration :
3 - Modèle de sécurité du transport
etcd prend en charge le chiffrement TLS automatique ainsi que l’authentification par certificats clients pour les communications clients vers serveur, ainsi que pour les communications entre pairs (serveur vers serveur / cluster). Notez qu’etcd n’active pas par défaut l’authentification basée sur RBAC ni la fonctionnalité d’authentification au niveau du transport afin de réduire les obstacles pour les utilisateurs débutants avec la base de données. En outre, modifier cette valeur par défaut constituerait une modification incompatible pour le projet, établie depuis 2013. Un cluster etcd qui n’active pas les fonctionnalités de sécurité peut exposer ses données à tout client.
Pour démarrer, disposez tout d’abord d’un certificat CA et d’une paire de clés signées pour un membre. Il est recommandé de créer et de signer une nouvelle paire de clés pour chaque membre d’un cluster.
Pour plus de commodité, l’outil cfssl propose une interface simplifiée pour la génération de certificats, et nous fournissons un exemple utilisant cet outil ici . En alternative, consultez ce guide pour générer des paires de clés auto-signées .
La liste des indicateurs fournie ci-dessous peut ne pas être à jour en raison des modifications en cours de développement. Pour obtenir la liste des indicateurs disponibles, exécutez etcd --help ou consultez l’aide de [etcd][].
Configuration de base
etcd prend plusieurs options de configuration liées aux certificats, soit par des drapeaux en ligne de commande, soit par des variables d’environnement :
Communication client-serveur :
--cert-file=<path> : Certificat utilisé pour les connexions SSL/TLS vers etcd. Lorsque cette option est définie, advertise-client-urls peut utiliser le schéma HTTPS.
--key-file=<path> : Clé du certificat. Doit être non chiffrée.
--client-cert-auth : Lorsque cette option est définie, etcd vérifie que toutes les requêtes HTTPS entrantes incluent un certificat client signé par l’autorité de certification fiable. Les requêtes ne fournissant pas de certificat client valide échoueront. Si authentification
est activée, le certificat fournit les identifiants pour le nom d’utilisateur indiqué dans le champ Common Name.
--trusted-ca-file=<path>: Autorité de certification de confiance.
--auto-tls : Utilisez des certificats auto-signés générés automatiquement pour les connexions TLS avec les clients.
Communication entre pairs (serveur vers serveur / cluster) :
Les options de pair fonctionnent de la même manière que les options client-serveur :
--peer-cert-file=<path> : Certificat utilisé pour les connexions SSL/TLS entre pairs. Ce certificat sera utilisé à la fois pour écouter sur l’adresse de pair et pour envoyer des requêtes aux autres pairs.
--peer-key-file=<path> : Clé du certificat. Doit être non chiffrée.
--peer-client-cert-auth : Lorsqu’il est défini, etcd vérifie que toutes les requêtes entrantes de pair provenant du cluster sont accompagnées de certificats clients valides signés par l’autorité de certification fournie.
--peer-trusted-ca-file=<path>: Autorité de certification de confiance.
--peer-auto-tls : Utilisez des certificats auto-signés générés automatiquement pour les connexions TLS entre pairs.
Si un certificat client-serveur ou un certificat pair est fourni, la clé doit également être définie. Toutes ces options de configuration sont également disponibles via les variables d’environnement, ETCD_CA_FILE, ETCD_PEER_CA_FILE et ainsi de suite.
Options communes :
--cipher-suites : Liste séparée par des virgules des suites de chiffrement TLS prises en charge entre le serveur/client et les pairs (vide, automatiquement rempli par Go).
--tls-min-version=<version> Définit la version minimale TLS prise en charge par etcd.
--tls-max-version=<version> Définit la version TLS maximale prise en charge par etcd. Si ce paramètre n’est pas défini, la version maximale prise en charge par Go sera utilisée.
Usage de clé et extendedKeyUsage du certificat TLS
Lors de la génération de certificats X.509 pour sécuriser le transport etcd,
les certificats doivent inclure les champs keyUsage et extendedKeyUsage appropriés selon leur rôle.
etcd s’appuie sur les bibliothèques crypto/tls et crypto/x509 de Go pour la vérification des certificats,
qui imposent ces utilisations lors de la négociation TLS.
Le tableau suivant résume les utilisations recommandées pour les rôles de certificat courants :
| Rôle du certificat | keyUsage | extendedKeyUsage |
|---|---|---|
| Serveur (client vers serveur) | digitalSignature, keyEncipherment | serverAuth |
| Client | digitalSignature, keyEncipherment | clientAuth |
| Pair (serveur vers serveur) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Notes :
- Lorsque
--peer-client-cert-authest activé, les certificats de pair sont utilisés pour établir une TLS mutuelle entre les membres etcd, ce qui impose l’utilisation deserverAuthet declientAuth. - Les certificats clients utilisés avec
--client-cert-authdoivent inclureclientAuth.
Exemple 1 : Sécurité du transport client-serveur avec HTTPS
Pour cela, préparez un certificat d’autorité de certification (ca.crt) et une paire de clés signées (server.crt, server.key).
Configurons etcd pour fournir une sécurité de transport HTTPS simple étape par étape :
Cela devrait démarrer correctement, et il sera possible de tester la configuration en utilisant HTTPS avec etcd :
La commande doit indiquer que la négociation a réussi. Étant donné que nous utilisons des certificats auto-signés avec notre propre autorité de certification, il est nécessaire de transmettre l’autorité de certification à curl en utilisant l’option --cacert. Une autre possibilité consisterait à ajouter le certificat de l’autorité de certification au répertoire des certificats fiables du système (généralement situé dans /etc/pki/tls/certs ou /etc/ssl/certs).
Utilisateurs OSX 10.9+ : curl 7.30.0 sous OSX 10.9+ ne comprend pas les certificats passés en ligne de commande.
Au lieu de cela, importez directement le certificat dummy ca.crt dans la clé, ou ajoutez le drapeau -k à curl pour ignorer les erreurs.
Pour tester sans le drapeau -k, exécutez open ./tests/fixtures/ca/ca.crt et suivez les invites.
Veuillez supprimer ce certificat après le test !
Si une solution de contournement existe, faites-le nous savoir.
Exemple 2 : Authentification client-serveur avec des certificats clients HTTPS
Pour l’instant, nous avons donné au client etcd la capacité de vérifier l’identité du serveur et de garantir la sécurité du transport. Nous pouvons toutefois également utiliser des certificats clients pour empêcher l’accès non autorisé à etcd.
Les clients fourniront leurs certificats au serveur, qui vérifiera que le certificat est signé par l’autorité de certification fournie et décidera s’il convient de traiter la requête.
Les mêmes fichiers mentionnés dans le premier exemple sont nécessaires pour cela, ainsi qu’une paire de clés pour le client (client.crt, client.key) signée par la même autorité de certification.
Essayez maintenant la même requête quʼau-dessus sur ce serveur :
La requête doit être rejetée par le serveur :
Pour y parvenir, nous devons fournir au serveur un certificat client signé par l’autorité de certification :
La sortie doit inclure :
Et également la réponse du serveur :
Spécifiez les suites de chiffrement à bloquer suites de chiffrement TLS faibles .
L’établissement de la mainshaking TLS échouerait lorsque le client Hello est demandé avec des suites de chiffrement non valides.
Par exemple :
Ensuite, les requêtes clientes doivent préciser l’un des suites de chiffrement spécifiées sur le serveur :
Exemple 3 : Sécurité du transport et certificats clients dans un cluster
etcd prend en charge le même modèle que ci-dessus pour la communication entre pairs, ce qui signifie la communication entre les membres d’un cluster etcd.
En supposant que nous disposons de notre ca.crt et de deux membres équipés de leurs propres paires de clés (member1.crt & member1.key, member2.crt & member2.key) signées par cette autorité de certification, nous lançons etcd comme suit :
Les membres etcd formeront un cluster et toutes les communications entre les membres du cluster seront chiffrées et authentifiées à l’aide des certificats clients. La sortie d’etcd indiquera que les adresses auxquelles il se connecte utilisent HTTPS.
Exemple 4 : Sécurité de transport auto-signée automatique
Lorsque vous spécifiez ClientAutoTLS et PeerAutoTLS, la période de validité du certificat client et du certificat pair automatiquement générés par etcd est limitée à 1 an. Vous pouvez utiliser le drapeau –self-signed-cert-validity pour définir la période de validité du certificat en années.
Dans les cas où une encryption de la communication est requise, mais pas une authentification, etcd prend en charge le chiffrement de ses messages à l’aide de certificats auto-signés générés automatiquement. Cela simplifie le déploiement, car il n’est pas nécessaire de gérer séparément les certificats et les clés en dehors d’etcd.
Configurez etcd pour utiliser des certificats auto-signés pour les connexions clientes et entre pairs à l’aide des indicateurs --auto-tls et --peer-auto-tls :
Les certificats auto-signés ne vérifient pas l’identité, donc curl renverra une erreur :
Pour désactiver la vérification de la chaîne de certificats, exécutez curl avec le drapeau -k :
Notes relatives au DNS SRV
Depuis la version 3.1.0 (sauf 3.2.9), le démarrage par découverte SRV authentifie ServerName à l’aide d’un nom de domaine racine provenant du drapeau --discovery-srv. Ceci vise à prévenir les attaques de type « homme du milieu » basées sur les certificats, en exigeant que le certificat possède un nom de domaine racine correspondant dans son champ Nom alternatif du sujet (SAN). Par exemple, etcd --discovery-srv=etcd.local n’authentifiera les pairs ou clients que si les certificats fournis incluent etcd.local comme entrée dans le champ Nom alternatif du sujet (SAN).
Notes sur le proxy etcd
Le proxy etcd termine le TLS provenant de son client si la connexion est sécurisée, puis utilise sa propre clé/certificat spécifiés dans --peer-key-file et --peer-cert-file pour communiquer avec les membres etcd.
Le proxy communique avec les membres etcd à l’aide des --advertise-client-urls et --advertise-peer-urls d’un membre donné. Il achemine les requêtes clientes vers les URL de client annoncées des membres etcd, et synchronise la configuration initiale du cluster à l’aide des URL de pair annoncées des membres etcd.
Lorsqu’une authentification client est activée pour un membre etcd, l’administrateur doit s’assurer que le certificat pair spécifié dans l’option --peer-cert-file du proxy est valide pour cette authentification. Le certificat pair du proxy doit également être valide pour l’authentification pair si l’authentification pair est activée.
Notes sur l’authentification TLS
Depuis v3.2.0 , les certificats TLS sont rechargés à chaque connexion client . Cela est utile pour remplacer des certificats expirés sans arrêter les serveurs etcd ; cela peut être réalisé en écrasant les anciens certificats par de nouveaux. Le rechargement des certificats à chaque connexion ne devrait pas entraîner un surcroît de charge important, mais pourrait être amélioré à l’avenir grâce à une couche de mise en mémoire tampon. Des exemples de tests sont disponibles ici .
Depuis v3.2.0
, le serveur refuse les certificats pairs entrants comportant une IP incorrecte SAN
. Par exemple, si le certificat pair contient des adresses IP dans le champ Nom alternatif du sujet (SAN), le serveur authentifie un pair uniquement lorsque l’adresse IP distante correspond à l’une de ces adresses. Ceci vise à empêcher les points de terminaison non autorisés de rejoindre le cluster. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP réelle du pair B est 10.138.0.2, et non 10.138.0.27. Lorsque le pair B tente de rejoindre le cluster, le pair A rejette B avec l’erreur x509: certificate is valid for 10.138.0.27, not 10.138.0.2, car l’adresse IP distante de B ne correspond pas à celle figurant dans le champ Nom alternatif (SAN).
Depuis v3.2.0
, server résout le TLS DNSNames lors de la vérification SAN
. Par exemple, si le certificat pair ne contient que des noms DNS (aucune adresse IP) dans le champ Nom alternatif du sujet (SAN), le serveur authentifie un pair uniquement lorsque les résolutions inverses (dig b.com) de ces noms DNS correspondent à l’adresse IP distante. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2. Lorsque le pair B tente de rejoindre le cluster, le pair A recherche l’hôte entrant b.com afin d’obtenir la liste des adresses IP (par exemple dig b.com). Il rejette B si la liste ne contient pas l’adresse IP 10.138.0.2, avec l’erreur tls: 10.138.0.2 does not match any of DNSNames ["b.com"].
Depuis v3.2.2
, le serveur accepte les connexions si l’IP correspond, sans vérifier les entrées DNS
. Par exemple, si le certificat du pair contient des adresses IP et des noms DNS dans le champ Nom alternatif du sujet (SAN), et que l’adresse IP distante correspond à l’une de ces adresses IP, le serveur accepte simplement la connexion sans vérifier davantage les noms DNS. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2 et que invalid.domain est un hôte non valide. Lorsque le pair B tente de rejoindre le cluster, le pair A authentifie B avec succès, car le champ Nom alternatif du sujet (SAN) contient une adresse IP correspondante valide. Pour plus de détails, consultez issue#8206
.
Depuis v3.2.5
, server prend en charge la recherche inverse sur les noms DNS avec caractères génériques SAN
. Par exemple, si le certificat pair ne contient que des noms DNS (aucune adresse IP) dans le champ Subject Alternative Name (SAN), le serveur effectue d’abord une recherche inverse de l’adresse IP distante pour obtenir la liste des noms associés à cette adresse (par exemple, nslookup IPADDR). Ensuite, il accepte la connexion si ces noms correspondent à un nom du certificat pair (par correspondance exacte ou avec caractère générique). Si aucune correspondance n’est trouvée, le serveur effectue une recherche directe pour chaque entrée DNS du certificat pair (par exemple, recherche de example.default.svc lorsque l’entrée est *.example.default.svc), et accepte la connexion uniquement si les adresses résolues par l’hôte correspondent à l’adresse IP distante du certificat pair. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2. Lorsque le pair B tente de rejoindre le cluster, le pair A effectue une recherche inverse de l’IP 10.138.0.2 afin d’obtenir la liste des noms d’hôte. Il effectue ensuite une correspondance exacte ou avec caractère générique entre les noms d’hôte et les noms DNS du certificat du pair B dans le champ Nom alternatif du sujet (SAN). Si aucune recherche inverse ni forward n’a abouti, une erreur "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"] est renvoyée. Pour plus de détails, voir issue#8268
.
v3.3.0
ajoute le drapeau etcd --peer-cert-allowed-cn
pour prendre en charge l’authentification CN (Common Name)-based pour les connexions inter-membres
. Le démarrage TLS de Kubernetes consiste à générer des certificats dynamiques pour les membres et autres composants du système (par exemple, serveur API, kubelet, etc.). Maintenir des autorités de certification (CA) différentes pour chaque composant permet un contrôle d’accès plus strict sur le cluster etcd, mais peut s’avérer fastidieux. Lorsque le drapeau –peer-cert-allowed-cn est spécifié, un nœud ne peut se joindre qu’avec un nom commun correspondant, même avec des CA partagées. La correspondance est une comparaison exacte de chaîne par rapport au champ Common Name (CN) du certificat — aucune prise en charge des caractères génériques ou des correspondances par préfixe. Pour le filtrage basé sur le nom d’hôte utilisant –peer-cert-allowed-hostname ou –client-cert-allowed-hostname, la correspondance utilise x509.Certificate.VerifyHostname() de Go, qui prend en charge à la fois les noms d’hôte exacts et les entrées génériques (par exemple, *.example.com). Par exemple, chaque membre d’un cluster à 3 nœuds est configuré avec des demandes de signature de certificat (CSRs) (avec cfssl) comme suit :
Ensuite, seuls les pairs possédant un nom commun identique seront authentifiés si --peer-cert-allowed-cn etcd.local est fourni. Les nœuds présentant des CN différents dans les demandes de signature de certificat (CSR) ou un --peer-cert-allowed-cn différent seront rejetés :
Chaque processus doit être lancé avec :
v3.2.19
et v3.3.4
corrigent le rechargement TLS lorsque le champ SAN du certificat ne contient que des adresses IP, sans nom de domaine
. Par exemple, un membre est configuré avec les CSR suivantes (avec cfssl) :
En Go, le serveur appelle (*tls.Config).GetCertificate pour recharger le TLS uniquement si le champ (*tls.Config).Certificates du serveur n’est pas vide, ou si (*tls.ClientHelloInfo).ServerName n’est pas vide et que le client fournit un SNI valide. Auparavant, etcd remplissait toujours (*tls.Config).Certificates lors de la première négociation TLS client, en le rendant non vide. Le client était donc toujours censé fournir un SNI correspondant afin de réussir la vérification TLS et de déclencher le rechargement des ressources TLS via (*tls.Config).GetCertificate.
Toutefois, un certificat dont le champ SAN ne contient aucun nom de domaine, mais uniquement des adresses IP
demanderait *tls.ClientHelloInfo avec un champ ServerName vide, ce qui empêcherait le rechargement TLS lors de la première négociation TLS ; cela pose problème lorsque des certificats expirés doivent être remplacés en ligne.
Maintenant, (*tls.Config).Certificates est créé vide lors de la première poignée de main TLS client, d’abord pour déclencher (*tls.Config).GetCertificate, puis pour peupler le reste des certificats à chaque nouvelle connexion TLS, même lorsque le SNI client est vide (par exemple, lorsque le certificat ne contient que des adresses IP).
Notes pour la liste blanche d’hôtes
L’indicateur etcd --host-whitelist spécifie les noms d’hôte acceptables provenant des requêtes HTTP clients. La politique d’origine des clients protège contre les attaques de type « rebinding DNS »
ciblant des serveurs etcd non sécurisés. En effet, tout site web peut simplement créer un nom DNS autorisé et rediriger ce nom vers "localhost" (ou toute autre adresse). Ainsi, tous les points de terminaison HTTP du serveur etcd écoutant sur "localhost" deviennent accessibles, exposant le serveur aux attaques de rebinding DNS. Pour plus de détails, consultez CVE-2018-5702
.
Politique d’origine du client fonctionne comme suit :
- Si la connexion cliente est sécurisée via HTTPS, autoriser n’importe quel nom d’hôte.
- Si la connexion cliente n’est pas sécurisée et que
"HostWhitelist"n’est pas vide, autoriser uniquement les requêtes HTTP dont le champ Host figure dans la liste blanche.
Notez que la politique d’origine du client est appliquée, qu’une authentification soit activée ou non, pour des contrôles plus stricts.
Par défaut, etcd --host-whitelist et embed.Config.HostWhitelist sont définis sur vide afin d’autoriser tous les noms d’hôte. Notez qu’en spécifiant des noms d’hôte, les adresses de boucle locale ne sont pas ajoutées automatiquement. Pour autoriser les interfaces de boucle locale, ajoutez-les manuellement à la liste blanche (par exemple "localhost", "127.0.0.1", etc.).
Questions fréquemment posées
Je constate une erreur d’alerte SSLv3 handshake lors de l’utilisation de l’authentification client TLS ?
Le paquet crypto/tls de golang vérifie l’utilisation autorisée de la clé publique du certificat avant de l’utiliser.
Pour utiliser la clé publique du certificat à des fins d’authentification client, il faut ajouter clientAuth à Extended Key Usage lors de la création de la clé publique du certificat.
Voici comment procéder :
Ajoutez la section suivante à OpenSSL.cnf :
Lors de la création du certificat, veillez à le référencer dans le drapeau -extensions :
Avec l’authentification par certificat pair, j’obtiens « le certificat est valide pour 127.0.0.1, pas pour $MY_IP »
Assurez-vous de signer les certificats avec un nom sujet correspondant à l’adresse IP publique du membre. L’outil etcd-ca, par exemple, propose une option --ip= pour sa commande new-cert.
Le certificat doit être signé pour le nom DNS complet (FQDN) du membre dans son champ « Sujet », utilisez les noms alternatifs du sujet (SAN courts, IP) pour ajouter l’adresse IP. L’outil etcd-ca propose l’option --domain= pour sa commande new-cert, et OpenSSL peut également générer it
.
etcd chiffre-t-il les données stockées sur les disques ?
No. etcd ne chiffre pas les données clé/valeur stockées sur les disques. Si un utilisateur doit chiffrer les données stockées dans etcd, plusieurs options sont disponibles :
- Faire chiffrer et déchiffrer les données par les applications clientes
- Utiliser une fonctionnalité du système de stockage sous-jacent pour chiffrer les données stockées, comme dm-crypt
J’ai un avertissement dans les journaux indiquant que « le répertoire X existe sans les permissions recommandées -rwx—— »
Lorsque etcd crée certains répertoires nouveaux, il définit les permissions des fichiers à 700 afin de limiter au maximum l’accès non autorisé. Toutefois, si l’utilisateur a déjà créé un répertoire selon ses préférences, etcd utilise ce répertoire existant et affiche un message d’avertissement si les permissions diffèrent de 700.
4 - Guide de clustering
Aperçu
Lancer un cluster etcd de manière statique exige que chaque membre connaisse un autre membre du cluster. Dans certains cas, les adresses IP des membres du cluster peuvent être inconnues à l’avance. Dans ces situations, le cluster etcd peut être initialisé à l’aide d’un service de découverte.
Une fois qu’un cluster etcd est en cours d’exécution, l’ajout ou la suppression de membres s’effectue via la reconfiguration en temps réel runtime reconfiguration . Pour mieux comprendre la conception sous-jacente à la reconfiguration en temps réel, nous recommandons de lire le document de conception de la configuration en temps réel .
Ce guide traite des mécanismes suivants pour amorcer un cluster etcd :
Chaque mécanisme de mise en place initiale sera utilisé pour créer un cluster etcd composé de trois machines avec les détails suivants :
| Nom | Adresse | Nom d’hôte |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Statique
Comme nous connaissons les membres du cluster, leurs adresses et la taille du cluster avant de commencer, nous pouvons utiliser une configuration de bootstrap hors ligne en définissant le drapeau initial-cluster. Chaque machine recevra soit les variables d’environnement suivantes, soit les arguments en ligne de commande :
Notez que les URL spécifiées dans initial-cluster sont les URL de pair annoncées, c’est-à-dire qu’elles doivent correspondre à la valeur de initial-advertise-peer-urls sur les nœuds respectifs.
Si vous lancez plusieurs clusters (ou créez et détruyez un seul cluster) avec la même configuration à des fins de test, il est fortement recommandé d’attribuer à chaque cluster un identifiant initial-cluster-token unique. En procédant ainsi, etcd peut générer des identifiants de cluster et de membre uniques pour chaque cluster, même s’ils ont exactement la même configuration. Cela protège etcd contre les interactions entre clusters, qui pourraient endommager les clusters.
etcd écoute sur listen-client-urls
pour accepter le trafic client. Le membre etcd annonce les URL spécifiées dans advertise-client-urls
aux autres membres, aux proxies et aux clients. Vérifiez que les advertise-client-urls sont accessibles depuis les clients prévus. Une erreur courante consiste à définir advertise-client-urls sur localhost ou à laisser la valeur par défaut si les clients distants doivent accéder à etcd.
Sur chaque machine, lancez etcd avec ces indicateurs :
Les paramètres de ligne de commande commençant par --initial-cluster seront ignorés lors des exécutions ultérieures de etcd. N’hésitez pas à supprimer les variables d’environnement ou les indicateurs de ligne de commande après le processus d’initialisation. Si des modifications de configuration sont nécessaires ultérieurement (par exemple, l’ajout ou la suppression de membres dans le cluster), consultez le guide configuration en temps réel
.
TLS
etcd prend en charge la communication chiffrée via le protocole TLS. Les canaux TLS peuvent être utilisés pour la communication interne chiffrée entre pairs au sein du cluster ainsi que pour le trafic client chiffré. Cette section présente des exemples de configuration d’un cluster avec TLS pour les pairs et les clients. Des informations supplémentaires sur la prise en charge TLS par etcd sont disponibles dans le guide de sécurité .
Certificats auto-signés
Un cluster utilisant des certificats auto-signés chiffrer le trafic et authentifier ses connexions. Pour démarrer un cluster avec des certificats auto-signés, chaque membre du cluster doit disposer d’une paire de clés unique (member.crt, member.key) signée par un certificat CA partagé du cluster (ca.crt) pour les connexions entre pairs et les connexions clients. Les certificats peuvent être générés en suivant l’exemple de configuration TLS
d’etcd.
Sur chaque machine, etcd sera lancé avec ces indicateurs :
Certificats automatiques
Si le cluster nécessite une communication chiffrée mais ne requiert pas de connexions authentifiées, etcd peut être configuré pour générer automatiquement ses clés. Lors de l’initialisation, chaque membre crée son propre jeu de clés en fonction de ses adresses IP et hôtes annoncés.
Sur chaque machine, etcd sera lancé avec ces indicateurs :
Cas d’erreur
Dans l’exemple suivant, nous n’avons pas inclus notre nouvel hôte dans la liste des nœuds énumérés. Si c’est un nouveau cluster, le nœud doit être ajouté à la liste des membres initiaux du cluster.
Dans cet exemple, nous tentons de mapper un nœud (infra0) sur une adresse différente (127.0.0.1:2380) de celle qui est énumérée dans la liste du cluster (10.0.1.10:2380). Si ce nœud doit écouter sur plusieurs adresses, toutes ces adresses doivent être indiquées dans la directive de configuration “initial-cluster”.
Si un pair est configuré avec un ensemble différent d’arguments de configuration et tente de rejoindre ce cluster, etcd signalera une incompatibilité d’ID de cluster et quittera.
Découverte
Dans plusieurs cas, les adresses IP des pairs du cluster ne sont pas connues à l’avance. C’est fréquent lors de l’utilisation de fournisseurs de cloud ou lorsque le réseau utilise DHCP. Dans ces situations, au lieu de spécifier une configuration statique, utilisez un cluster etcd existant pour amorcer un nouveau cluster. Ce processus s’appelle la « découverte ».
Deux méthodes peuvent être utilisées pour la découverte :
- service de découverte etcd
- enregistrements DNS SRV
etcd discovery
Pour mieux comprendre la conception du protocole du service de découverte, nous recommandons de lire la documentation du protocole du service de découverte documentation .
Durée de vie d’une URL de découverte
Une URL de découverte identifie un cluster etcd unique. Au lieu de réutiliser une URL de découverte existante, chaque instance etcd partage une nouvelle URL de découverte pour amorcer le nouveau cluster.
En outre, les URL de découverte doivent être utilisées UNIQUEMENT pour le démarrage initial d’un cluster. Pour modifier la composition du cluster une fois qu’il est déjà en cours d’exécution, consultez le guide reconfiguration en temps réel .
Service de découverte etcd personnalisé
La découverte utilise un cluster existant pour amorcer son démarrage. Si vous utilisez un cluster etcd privé, créez une URL comme suit :
En définissant la clé size à l’URL, une URL de découverte est créée avec une taille de cluster attendue de 3.
L’URL à utiliser dans ce cas sera https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 et les membres etcd utiliseront le répertoire https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 pour s’enregistrer au moment de leur démarrage.
Chaque membre doit avoir un drapeau de nom différent spécifié. Hostname ou machine-id peut être un choix pertinent. Sinon, la découverte échouera en raison d’un nom en double.
Nous lançons maintenant etcd avec les drapeaux pertinents pour chaque membre :
Cela obligera chaque membre à s’enregistrer auprès du service de découverte etcd personnalisé et à démarrer le cluster une fois que toutes les machines auront été enregistrées.
Service de découverte publique etcd
Si aucun cluster existant n’est disponible, utilisez le service de découverte publique hébergé sur discovery.etcd.io. Pour créer une URL de découverte privée à l’aide de l’endpoint « new », utilisez la commande :
Cela créera le cluster avec une taille initiale de 3 membres. Si aucune taille n’est spécifiée, une valeur par défaut de 3 est utilisée.
Chaque membre doit disposer d’un indicateur de nom différent, faute de quoi la découverte échouera en raison de noms en double. Hostname ou machine-id peut être un bon choix.
Nous lançons maintenant etcd avec les drapeaux pertinents pour chaque membre :
Cela obligera chaque membre à s’enregistrer auprès du service de découverte et à démarrer le cluster une fois que tous les membres auront été enregistrés.
Utilisez la variable d’environnement ETCD_DISCOVERY_PROXY pour obliger etcd à utiliser un proxy HTTP afin de se connecter au service de découverte.
Cas d’erreur et d’avertissement
Erreurs du serveur de découverte
Avertissements
Il s’agit d’un avertissement inoffensif indiquant que l’URL de découverte sera ignorée sur cette machine.
Découverte DNS
Les enregistrements SRV DNS
peuvent être utilisés comme mécanisme de découverte.
L’option --discovery-srv peut être utilisée pour définir le nom de domaine DNS où les enregistrements SRV de découverte sont situés.
La configuration --discovery-srv example.com entraîne la recherche des enregistrements SRV dans l’ordre indiqué :
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Si _etcd-server-ssl._tcp.example.com est trouvé, etcd tentera le processus d’amorçage via TLS.
Afin d’aider les clients à découvrir le cluster etcd, les enregistrements DNS SRV suivants sont recherchés dans l’ordre indiqué :
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Si _etcd-client-ssl._tcp.example.com est présent, les clients tenteront de communiquer avec le cluster etcd via SSL/TLS.
Si etcd utilise TLS, l’enregistrement SRV de découverte (par exemple example.com) doit être inclus dans les SAN DNS du certificat SSL en plus de l’hôte, faute de quoi le cluster échouera avec des messages d’erreur similaires aux suivants :
Si etcd utilise TLS sans autorité de certification personnalisée, le domaine de découverte (par exemple, example.com) doit correspondre au domaine de l’enregistrement SRV (par exemple, infra1.example.com). Cela permet de limiter les attaques visant à falsifier des enregistrements SRV afin de les faire pointer vers un domaine différent ; le domaine cible aurait alors un certificat valide selon la PKI, mais serait contrôlé par un tiers inconnu.
L’option -discovery-srv-name configure en outre un suffixe dans le nom SRV interrogé lors de la découverte.
Utilisez cette option pour distinguer plusieurs clusters etcd situés sous le même domaine.
Par exemple, si discovery-srv=example.com et -discovery-srv-name=foo sont définis, les requêtes DNS SRV suivantes sont effectuées :
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
Créer des enregistrements DNS SRV
Initialiser le cluster etcd à l’aide du DNS
Les membres d’un cluster etcd peuvent annoncer des noms de domaine ou des adresses IP ; le processus d’initialisation résoudra les enregistrements A DNS.
À compter de la version 3.2 (la version 3.1 affiche des avertissements), --listen-peer-urls et --listen-client-urls rejettent les noms de domaine pour la liaison sur l’interface réseau.
L’adresse résolue dans --initial-advertise-peer-urls doit correspondre à l’une des adresses résolues figurant dans les cibles SRV. Le membre etcd lit l’adresse résolue afin de déterminer s’il appartient au cluster défini dans les enregistrements SRV.
Le cluster peut également amorcer son démarrage à l’aide d’adresses IP au lieu de noms de domaine :
Depuis la version 3.1.0 (sauf la version 3.2.9), lorsque etcd --discovery-srv=example.com est configuré avec TLS, le serveur n’authentifie les pairs ou clients que si les certificats fournis comportent comme entrée dans le champ Nom alternatif du sujet (SAN) le domaine racine example.com. Voir Notes sur le DNS SRV
.
Passerelle
Le passerelle etcd est un proxy TCP simple qui achemine les données réseau vers le cluster etcd. Veuillez consulter le guide gateway pour plus d’informations.
Proxy
Lorsque le drapeau --proxy est défini, etcd s’exécute en mode proxy proxy mode
. Ce mode proxy ne prend en charge que l’API etcd v2 ; aucune mise en œuvre de l’API v3 n’est prévue. En revanche, pour la prise en charge de l’API v3, un nouveau proxy doté de fonctionnalités améliorées sera disponible après la sortie d’etcd 3.0.
Pour configurer un cluster etcd avec des proxys de l’API v2, veuillez consulter le document clustering de la version 2.3 d’etcd.
5 - Exécuter des clusters etcd dans des conteneurs
Le guide suivant explique comment exécuter etcd avec Docker en utilisant le processus de bootstrap statique static bootstrap process .
Docker
Afin d’exposer l’API etcd aux clients situés en dehors de l’hôte Docker, utilisez l’adresse IP hôte du conteneur. Voir docker inspect
pour plus de détails sur la manière d’obtenir l’adresse IP. En alternative, spécifiez le drapeau --net=host à la commande docker run afin de passer outre la mise du conteneur dans une pile réseau séparée.
Exécution d’un nœud unique etcd
Utilisez l’adresse IP hôte lors de la configuration d’etcd :
Configurez un volume Docker pour stocker les données etcd :
Exécutez la dernière version d’etcd (v3.7.0 au moment de la rédaction) :
Lister le membre du cluster :
Exécution d’un cluster etcd à 3 nœuds
Pour exécuter etcdctl en utilisant la version 3 de l’API :
Infrastructure physique
Pour provisionner un cluster etcd à 3 nœuds sur du matériel physique, les exemples présents dans le répertoire baremetal peuvent être utiles.
Montage d’un volume de certificat
Le conteneur de version d’étcd ne contient pas de certificats racines par défaut. Pour utiliser HTTPS avec des certificats approuvés par une autorité racine (par exemple, pour la découverte), montez un répertoire de certificats dans le conteneur etcd :
6 - Exécuter des clusters etcd en tant que StatefulSet Kubernetes
Ci-dessous montre comment effectuer le processus de bootstrap statique comme un StatefulSet Kubernetes .
Exemple de manifeste
Ce manifeste contient un service et un statefulset pour déployer un cluster etcd statique dans Kubernetes.
Si vous copiez le contenu du manifeste dans un fichier nommé etcd.yaml, vous pouvez l’appliquer à un cluster à l’aide de cette commande.
Une fois appliqué, attendez que les pods soient prêts.
Le conteneur utilisé dans l’exemple inclut etcdctl et peut être appelé directement à l’intérieur des pods.
Pour déployer avec un certificat auto-signé, reportez-vous aux en-têtes de configuration commentés commençant par ## TLS afin de trouver les valeurs que vous pouvez décommenter. Des instructions supplémentaires pour générer un certificat avec cert-manager sont fournies dans une section ci-dessous.
Génération des certificats
Dans cette section, nous utilisons Helm pour installer un opérateur appelé cert-manager .
Avec cert-manager installé dans le cluster, des certificats auto-signés peuvent être générés directement dans le cluster. Ces certificats générés sont placés dans un objet secret pouvant être attaché en tant que fichiers dans des conteneurs.
Voici la commande Helm pour installer cert-manager.
Voici une configuration d’Issuer de cluster exemple pour la génération de certificats auto-signés.
Ce manifeste crée des objets Certificate pour les certificats client et serveur, en faisant référence à l’objet ClusterIssuer « selfsigned ». Les dnsNames doivent constituer une liste exhaustive des noms d’hôte valides pour les certificats créés par cert-manager.
7 - Modes de défaillance
Les défaillances sont fréquentes dans un déploiement à grande échelle de machines. Une machine défaillante est une machine dont le matériel ou le logiciel présente une anomalie. Plusieurs machines peuvent défaillir simultanément en cas de panne de courant ou de problèmes réseau. Plusieurs types de défaillances peuvent également survenir en même temps ; il est presque impossible d’énumérer toutes les situations de défaillance possibles.
Dans cette section, nous recensons les types d’pannes et discutons de la manière dont etcd est conçu pour y résister. La plupart des utilisateurs, sinon tous, peuvent associer une panne particulière à un type de panne spécifique. Pour se préparer aux rares pannes irréversibles , il est toujours recommandé de sauvegarder le cluster etcd.
Échec mineur des suiveurs
Lorsque moins de la moitié des suiveurs échouent, le cluster etcd peut continuer à accepter des requêtes et à progresser sans interruption majeure. Par exemple, deux échecs de suiveurs n’affectent pas le fonctionnement d’un cluster etcd à cinq membres. Toutefois, les clients perdent la connectivité avec les membres défaillants. Les bibliothèques clientes doivent masquer ces interruptions aux utilisateurs pour les requêtes en lecture en se reconnectant automatiquement à d’autres membres. Les opérateurs doivent s’attendre à une augmentation de la charge système sur les autres membres en raison des reconnexions.
Défaillance du leader
Lorsqu’un leader échoue, le cluster etcd élit automatiquement un nouveau leader. L’élection n’a pas lieu instantanément après l’échec du leader. Elle prend environ un délai d’élection, car le modèle de détection des échecs repose sur un délai d’attente.
Pendant l’élection du leader, le cluster ne peut pas traiter d’écritures. Les requêtes d’écriture envoyées pendant l’élection sont mises en attente jusqu’à l’élection d’un nouveau leader.
Les écritures déjà envoyées au vieux leader mais non encore validées peuvent être perdues. Le nouveau leader peut réécrire n’importe quelle entrée non validée provenant du leader précédent. Du point de vue de l’utilisateur, certaines requêtes d’écriture peuvent expirer après une nouvelle élection de leader. Toutefois, aucune écriture validée n’est jamais perdue.
Le nouveau leader étend automatiquement les délais de tous les bails. Ce mécanisme garantit qu’un bail ne sera pas expiré avant le TTL accordé, même s’il a été accordé par le leader ancien.
Défaillance majoritaire
Lorsque la majorité des membres du cluster échoue, le cluster etcd échoue et ne peut plus accepter d’écritures.
Le cluster etcd ne peut être mis en récupération qu’après la disponibilité de la majorité des membres. Si la majorité des membres ne peut revenir en ligne, l’opérateur doit alors lancer la récupération après sinistre pour restaurer le cluster.
Dès qu’une majorité des membres fonctionne, le cluster etcd élit automatiquement un nouveau leader et redevient sain. Le nouveau leader étend automatiquement les délais de tous les bails. Ce mécanisme garantit qu’aucun bail n’expire en raison d’une indisponibilité du serveur.
Partition réseau
Une partition réseau est similaire à une défaillance mineure d’un suiveur ou à une défaillance du leader. Une partition réseau divise le cluster etcd en deux parties ; l’une dispose d’une majorité de membres, l’autre d’une minorité. Le côté majoritaire devient le cluster disponible, tandis que le côté minoritaire devient indisponible. Il n’y a pas de « split-brain » dans etcd car les membres du cluster sont explicitement added/removed et chaque modification est approuvée par la majorité actuelle des membres.
Si le leader se trouve du côté majoritaire, alors, du point de vue de la majorité, la défaillance correspond à une défaillance d’un suiveur minoritaire. Si le leader se trouve du côté minoritaire, il s’agit d’une défaillance du leader. Le leader du côté minoritaire cède son rôle, et le côté majoritaire élit un nouveau leader.
Une fois que la partition réseau est résolue, le côté minoritaire reconnaît automatiquement le leader provenant du côté majoritaire et restaure son état.
Échec du démarrage
Le démarrage initial d’un cluster réussit uniquement si tous les membres requis démarrent correctement. Si une erreur survient pendant le démarrage initial, supprimez les répertoires de données sur tous les membres, puis redémarrez le cluster avec un nouveau cluster-token ou un nouveau jeton de découverte.
Bien sûr, il est possible de récupérer un cluster initialisé qui a échoué, tout comme on récupère un cluster en cours d’exécution. Toutefois, la récupération de ce cluster prend presque toujours plus de temps et de ressources que le démarrage d’un nouveau cluster, car aucune donnée n’a besoin d’être récupérée.
8 - Récupération après sinistre
etcd est conçu pour résister aux pannes de machines. Un cluster etcd se rétablit automatiquement après des pannes temporaires (par exemple, redémarrages de machine) et tolère jusqu’à (N-1)/2 pannes permanentes pour un cluster composé de N membres. Lorsqu’un membre subit une panne permanente, qu’elle soit due à une défaillance matérielle ou à une corruption du disque, il perd accès au cluster. Si le cluster perd définitivement plus de (N-1)/2 membres, il subit une panne catastrophique, perdant irrévocablement son quorum. Une fois le quorum perdu, le cluster ne peut plus atteindre de consensus et ne peut donc plus accepter de mises à jour.
Pour récupérer après une panne catastrophique, etcd v3 fournit des fonctionnalités d’instantané et de restauration afin de recréer le cluster sans perte de données clés v3. Pour récupérer les clés v2, reportez-vous au guide d’administration v2 .
Instantané de l’espace de clés
La récupération d’un cluster nécessite tout d’abord un instantané de l’espace de clés provenant d’un membre etcd. Un instantané peut être pris à partir d’un membre en cours d’exécution à l’aide de la commande etcdctl snapshot save ou en copiant le fichier member/snap/db depuis un répertoire de données etcd. Par exemple, la commande suivante crée un instantané de l’espace de clés servi par $ENDPOINT dans le fichier snapshot.db :
Notez qu’effectuer l’instantané à partir du fichier member/snap/db peut entraîner la perte de données non encore écrites, mais présentes dans le répertoire wal (write-ahead-log).
État d’un instantané
Pour comprendre quelle révision et quel hachage contient un instantané donné, vous pouvez utiliser la commande etcdutl snapshot status :
Restauration d’un cluster
Différence de révision
Lorsque vous restaurez un cluster, les clients existants peuvent percevoir une révision qui remonte de plusieurs centaines ou milliers d’unités. Cela est dû au fait qu’un instantané donné ne contient que l’historique des données jusqu’au moment où il a été pris, alors que l’état actuel du cluster peut déjà être plus avancé.
Cela pose particulièrement problème lors de l’exécution de Kubernetes avec etcd, où les contrôleurs et les opérateurs peuvent utiliser ce qu’on appelle informers, qui agissent comme des caches locaux et reçoivent des notifications de mise à jour via des surveillance. Le retour à une révision antérieure peut ne pas actualiser correctement ces caches, entraînant un comportement imprévisible et incohérent dans les contrôleurs.
Lors de la restauration à partir d’un instantané dans le cadre de : consommateurs connus de l’API de surveillance, copies locales mises en cache des données etcd ou de l’utilisation générale de Kubernetes, il est fortement recommandé de procéder à la restauration en utilisant les « augmentations de révision » ci-dessous.
Restauration à partir d’un instantané
Pour restaurer un cluster, il suffit d’un seul fichier d’instantané « db ». La restauration d’un cluster avec etcdutl snapshot restore crée de nouveaux répertoires de données etcd ; tous les membres doivent restaurer à l’aide du même instantané. La restauration écrase certaines métadonnées de l’instantané (en particulier l’ID de membre et l’ID de cluster) ; le membre perd alors son identité antérieure. Cette écrasement des métadonnées empêche le nouveau membre de rejoindre involontairement un cluster existant. Par conséquent, pour démarrer un cluster à partir d’un instantané, la restauration doit démarrer un nouveau cluster logique.
Une restauration simple peut être exécutée comme suit :
Vérifications d’intégrité
L’intégrité de l’instantané peut être vérifiée de manière facultative au moment de la restauration. Si l’instantané est pris avec etcdctl snapshot save, il contient un hachage d’intégrité qui est vérifié par etcdutl snapshot restore. Si l’instantané est copié depuis le répertoire de données, aucun hachage d’intégrité n’est présent, et sa restauration ne sera possible qu’en utilisant --skip-hash-check.
Restauration avec augmentation de la révision
Afin de garantir que les révisions ne diminuent jamais après une restauration, vous pouvez utiliser l’option --bump-revision. Cette option prend un entier sur 64 bits, qui indique le nombre de révisions à ajouter à la révision actuelle de l’instantané. Étant donné qu’une écriture dans etcd augmente la révision de un, vous pouvez couvrir un instantané datant d’une semaine en augmentant la révision de 1'000'000'000, à condition que etcd fonctionne avec moins de 1500 écritures par seconde.
Dans le contexte des contrôleurs Kubernetes, il est également important de marquer toutes les révisions, y compris la mise à jour, comme compactées à l’aide de --mark-compacted. Cela garantit que toutes les surveillance sont terminées et qu’etcd ne répond pas aux requêtes concernant les révisions survenues après la prise de l’instantané — ce qui invalide effectivement les caches d’informateurs.
Un appel complet peut avoir l’aspect suivant :
Restauration avec membre mis à jour
Les membres d’un cluster etcd sont stockés dans etcd lui-même et maintenus grâce à l’algorithme de consensus Raft. Lorsque le quorum est entièrement perdu, vous devrez peut-être reconsidérer l’emplacement et la manière dont le nouveau cluster est constitué, par exemple sur un ensemble entièrement nouveau de membres.
Lors de la restauration à partir d’un instantané, vous pouvez fournir directement la nouvelle configuration d’appartenance dans la base de données comme suit :
Cela garantit que le cluster nouvellement construit ne se connecte qu’aux autres membres restaurés ayant le jeton donné, et non aux membres plus anciens qui pourraient encore être actifs et tenter de se connecter.
En revanche, lors du démarrage d’etcd, vous pouvez fournir --force-new-cluster afin de remplacer l’appartenance au cluster tout en conservant les données d’application existantes. Notez que cette opération est fortement déconseillée, car elle provoquera un arrêt brutal si d’autres membres du cluster précédent sont encore actifs. Veillez à sauvegarder régulièrement des instantanés.
Exemple bout en bout
Prenez un instantané à partir d’un cluster en cours d’exécution à l’aide de :
En continuant de l’exemple précédent, la commande suivante crée de nouveaux répertoires de données etcd (m1.etcd, m2.etcd, m3.etcd) pour un cluster à trois membres :
Ensuite, démarrez etcd avec les nouveaux répertoires de données :
Le cluster etcd restauré doit maintenant être disponible et servir l’espace de clés depuis l’instantané.
À partir de etcd v3.6, les utilisateurs ne peuvent utiliser que etcdctl pour créer un instantané des données, mais doivent utiliser etcdutl pour restaurer les données à partir d’un instantané. Si --data-dir n’est pas spécifié, la valeur par défaut de --data-dir est <name>.etcd (où <name> correspond à la valeur de --name). Par exemple, si --data-dir n’a pas été fourni et que les membres sont nommés m1, m2 et m3, les répertoires --data-dir seront m1.etcd, m2.etcd et m3.etcd.
9 - etcd gateway
Qu’est-ce que la passerelle etcd
Le passerelle etcd est un proxy TCP simple qui achemine les données réseau vers le cluster etcd. La passerelle est sans état et transparente ; elle n’inspecte ni les requêtes clients ni les réponses du cluster. Elle ne termine pas les connexions TLS, ne réalise pas d’échanges TLS à la place de ses clients, ni ne vérifie si la connexion est sécurisée.
La passerelle prend en charge plusieurs points d’accès serveur etcd et fonctionne selon une politique de rotation simple. Elle ne route que vers les points d’accès disponibles et masque les échecs à ses clients. D’autres politiques de réessai, telles que la rotation pondérée, pourraient être prises en charge à l’avenir.
Quand utiliser la passerelle etcd
Chaque application qui accède à etcd doit d’abord connaître l’adresse d’un point de terminaison client du cluster etcd. Si plusieurs applications sur le même serveur accèdent au même cluster etcd, chaque application doit tout de même connaître les points de terminaison clients annoncés du cluster etcd. Si le cluster etcd est reconfiguré pour utiliser des points de terminaison différents, chaque application peut également devoir mettre à jour sa liste de points de terminaison. Cette reconfiguration à grande échelle est à la fois fastidieuse et sujette aux erreurs.
Le passerelle etcd résout ce problème en agissant comme un point d’accès local stable. Une configuration typique de passerelle etcd fait en sorte que chaque machine exécute une passerelle écoutant sur une adresse locale, et que chaque application etcd se connecte à sa passerelle locale. Le résultat est que seule la passerelle doit mettre à jour ses points de terminaison, et non chaque application individuellement.
En résumé, pour propager automatiquement les modifications des points d’accès du cluster, la passerelle etcd s’exécute sur chaque machine hébergeant plusieurs applications qui accèdent au même cluster etcd.
Quand ne pas utiliser la passerelle etcd
- Amélioration des performances
La passerelle n’est pas conçue pour améliorer les performances du cluster etcd. Elle ne propose ni mise en cache, ni regroupement ou regroupement par lots des opérations de surveillance. L’équipe etcd développe actuellement un proxy de mise en cache conçu pour améliorer l’évolutivité du cluster.
- Exécution sur un système de gestion de cluster
Les systèmes de gestion de cluster avancés comme Kubernetes prennent en charge nativement la découverte de services. Les applications peuvent accéder à un cluster etcd à l’aide d’un nom DNS ou d’une adresse IP virtuelle gérée par le système. Par exemple, kube-proxy est équivalent à une passerelle etcd.
Démarrer la passerelle etcd
Considérez un cluster etcd avec les points de terminaison statiques suivants :
| Nom | Adresse | Nom d’hôte | Port |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Démarrez la passerelle etcd pour utiliser ces points de terminaison statiques avec la commande :
En revanche, si vous utilisez le DNS pour la découverte de service, envisagez les entrées SRV DNS :
Démarrez la passerelle etcd pour récupérer les points d’accès à partir des entrées DNS SRV avec la commande :
Drapeaux de configuration
etcd cluster
–endpoints
- Liste séparée par des virgules des cibles serveur etcd vers lesquelles les connexions clients sont acheminées.
- Valeur par défaut :
127.0.0.1:2379 - Le port doit être inclus.
- Exemple incorrect :
https://127.0.0.1:2379(la passerelle ne termine pas le TLS). Notez que la passerelle ne vérifie pas le schéma HTTP ni n’inspecte les requêtes, elle ne fait que les acheminer vers les points de terminaison indiqués.
–discovery-srv
- Domaine DNS utilisé pour amorcer les points d’accès du cluster via des enregistrements SRV.
- Par défaut : (non défini)
Réseau
–listen-addr
- Interface et port d’écoute pour accepter les requêtes clients.
- Valeur par défaut :
127.0.0.1:23790
–retry-delay
- Durée du délai avant de réessayer la connexion aux points de terminaison défaillants.
- Valeur par défaut : 1m0s
- Exemple non valide : “123” (unité de temps attendue au format)
Sécurité
–insecure-discovery
- Accepter les enregistrements SRV qui sont non sécurisés ou susceptibles d’attaques d’homme-du-milieu.
- Valeur par défaut :
false
–trusted-ca-file
- Chemin vers le fichier CA TLS du client pour le cluster etcd, utilisé pour vérifier les points de terminaison retournés par la découverte SRV. Notez qu’il n’est utilisé QUE pour l’authentification des points de terminaison découverts, et non pour établir des connexions de transfert de données. La passerelle ne termine jamais de connexions TLS ni ne crée de connexions TLS en lieu et place de ses clients.
- Par défaut : (non défini)
10 - Proxie gRPC
Le proxy gRPC est un proxy inverse etcd sans état fonctionnant au niveau du protocole gRPC (L7). Le proxy est conçu pour réduire la charge de traitement totale imposée au cluster etcd principal. Pour assurer une évolutivité horizontale, il regroupe les requêtes d’API de surveillance et de bail. Pour protéger le cluster contre les clients abusifs, il met en mémoire tampon les requêtes portant sur des plages de clés.
Le proxy gRPC prend en charge plusieurs points d’entrée de serveur etcd. Au démarrage du proxy, il choisit aléatoirement un point d’entrée de serveur etcd à utiliser. Ce point d’entrée traite toutes les requêtes jusqu’à ce que le proxy détecte une défaillance. Si le proxy gRPC détecte une défaillance d’un point d’entrée, il bascule vers un autre point d’entrée, si disponible, afin de masquer les défaillances à ses clients. D’autres politiques de réessai, telles que le round-robin pondéré, pourraient être prises en charge à l’avenir.
API de surveillance évolutif
Le proxy gRPC regroupe plusieurs observateurs clients (c-watchers) sur la même clé ou plage en un seul observateur (s-watcher) connecté à un serveur etcd. Le proxy diffuse tous les événements provenant du s-watcher à ses c-watchers.
En supposant que N clients effectuent une surveillance sur la même clé, un proxy gRPC peut réduire la charge de surveillance sur le serveur etcd de N à 1. Les utilisateurs peuvent déployer plusieurs proxies gRPC afin de répartir davantage la charge du serveur.
Dans l’exemple suivant, trois clients effectuent une surveillance sur la clé A. Le proxy gRPC regroupe les trois observateurs, créant un seul observateur attaché au serveur etcd.
Limitations
Pour effectuer une coalescence efficace de plusieurs observateurs clients en un seul observateur, le proxy gRPC effectue une coalescence des nouveaux c-watchers vers un s-watcher existant lorsque cela est possible. Ce s-watcher coalescé peut être hors synchronisation avec le serveur etcd en raison de retards réseau ou d’événements mis en mémoire tampon non livrés. Lorsque la révision de surveillance n’est pas précisée, le proxy gRPC ne garantit pas que le c-watcher commencera à surveiller à partir de la révision la plus récente du magasin. Par exemple, si un client surveille à partir d’un serveur etcd avec la révision 1000, cet observateur commencera à la révision 1000. Si un client surveille à partir du proxy gRPC, il peut commencer à surveiller à partir de la révision 990.
Des limitations similaires s’appliquent à l’annulation. Lorsqu’un observateur est annulé, la révision du serveur etcd peut être supérieure à la révision de la réponse d’annulation.
Ces deux limitations ne devraient pas poser de problème pour la plupart des cas d’utilisation. À l’avenir, des options supplémentaires pourraient être disponibles afin de forcer l’observateur à contourner le proxy gRPC pour des réponses de révision plus précises.
API bail évolutif
Pour maintenir ses bails actifs, un client doit établir au moins une connexion gRPC avec un serveur etcd afin d’envoyer des signaux d’activité périodiques. Si une charge de travail etcd implique une activité de bail importante répartie sur de nombreux clients, ces connexions peuvent entraîner une utilisation excessive du processeur. Pour réduire le nombre total de connexions sur le cluster principal, le proxy prend en charge la fusion des connexions de bail.
En supposant que N clients mettent à jour des bails, un unique proxy gRPC réduit la charge des flux sur le serveur etcd de N à 1. Les déploiements peuvent inclure des proxies gRPC supplémentaires afin de répartir davantage les flux sur plusieurs proxies.
Dans l’exemple suivant, trois clients mettent à jour trois bails indépendants (L1, L2 et L3). Le proxy gRPC fusionne les trois flux de bail client (c-streams) en un seul flux de renouvellement de bail (s-stream) associé à un serveur etcd. Le proxy transfère les battements de cœur de bail côté client provenant des flux c vers le flux s, puis renvoie les réponses aux flux c correspondants.
Protection contre les clients abusifs
Le proxy gRPC met en mémoire tampon les réponses aux requêtes lorsqu’il ne compromet pas les exigences de cohérence. Cela peut protéger le serveur etcd contre les clients abusifs exécutant des boucles serrées.
Démarrer le proxy gRPC etcd
Considérez un cluster etcd avec les points de terminaison statiques suivants :
| Nom | Adresse | Nom d’hôte |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Démarrez le proxy gRPC etcd pour utiliser ces points de terminaison statiques avec la commande :
Le proxy gRPC etcd démarre et écoute sur le port 2379. Il achemine les requêtes clientes vers l’un des trois points de terminaison fournis ci-dessus.
Envoi de requêtes via le proxy :
Synchronisation des points de terminaison client et résolution de noms
Le proxy prend en charge l’enregistrement de ses points d’accès pour la découverte, en écrivant sur un point d’accès défini par l’utilisateur. Cela sert deux objectifs. Premièrement, cela permet aux clients de synchroniser leurs points d’accès avec un ensemble de points d’accès du proxy afin d’assurer une haute disponibilité. Deuxièmement, il agit comme un fournisseur de points d’accès pour etcd gRPC naming .
Inscrivez le ou les proxy en précisant un préfixe défini par l’utilisateur :
Le proxy répertoriera tous ses membres dans la liste des membres :
Cela permet aux clients de découvrir automatiquement les points d’accès du proxy via Sync :
Notez qu’en cas de configuration d’un proxy sans préfixe de résolveur,
L’API de liste des membres du grpc-proxy retourne son propre advertise-client-url :
Espace de noms
Supposons qu’une application exige un contrôle total sur l’ensemble de l’espace de clés, mais que le cluster etcd soit partagé avec d’autres applications. Pour permettre à toutes les applications de fonctionner sans se perturber mutuellement, le proxy peut partitionner l’espace de clés etcd de manière à ce que les clients perçoivent un accès à l’espace de clés complet. Lorsque le proxy reçoit le drapeau --namespace, toutes les requêtes clientes entrant dans le proxy sont traduites afin d’ajouter un préfixe défini par l’utilisateur aux clés. Les accès au cluster etcd se font sous ce préfixe, et les réponses du proxy suppriment ce préfixe ; pour le client, il semble qu’aucun préfixe n’existe.
Pour nommer un proxy, lancez-le avec --namespace :
Les accès au proxy sont désormais transparentement préfixés sur le cluster etcd :
Terminaison TLS
Met fin au TLS d’un cluster etcd sécurisé en utilisant le proxy gRPC en exposant un point d’accès local non chiffré.
Pour le tester, démarrez un cluster etcd à membre unique avec un client HTTPS :
Vérifiez que le port client est configuré pour servir HTTPS :
Ensuite, démarrez un proxy gRPC sur localhost:12379 en vous connectant au point d’extrémité etcd https://localhost:2379 à l’aide des certificats clients :
Enfin, testez la terminaison TLS en insérant une clé dans le proxy via http :
Métriques et état de santé
Le proxy gRPC expose les points de terminaison /health et Prometheus /metrics pour les membres etcd définis par --endpoints. Une alternative consiste à définir une URL supplémentaire qui répondra à la fois aux points de terminaison /metrics et /health avec le drapeau --metrics-addr.
Problème connu
L’interface principale du proxy sert à la fois HTTP2 et HTTP/1.1.. Si le proxy est configuré avec TLS comme indiqué dans l’exemple ci-dessus, l’utilisation d’un client tel que cURL contre l’interface d’écoute nécessite de définir explicitement le protocole à HTTP/1.1 dans la requête afin de retourner /metrics ou /health. En utilisant le drapeau --metrics-addr, l’interface secondaire n’aura pas cette exigence.
11 - Recommandations matérielles
etcd fonctionne généralement correctement avec des ressources limitées à des fins de développement ou de test ; il est courant de développer avec etcd sur un ordinateur portable ou une machine cloud peu coûteuse. Toutefois, lors de l’exécution de clusters etcd en production, certaines recommandations matérielles sont utiles pour une administration appropriée. Ces suggestions ne sont pas des règles strictes ; elles constituent un bon point de départ pour un déploiement productif robuste. Comme toujours, les déploiements doivent être testés avec des charges simulées avant d’être mis en production.
Processeurs
Peu de déploiements etcd nécessitent une grande capacité CPU. Les clusters typiques ont besoin de deux à quatre cœurs pour fonctionner correctement. Les déploiements etcd très chargés, qui servent des milliers de clients ou des dizaines de milliers de requêtes par seconde, sont généralement limités par la CPU, car etcd peut servir les requêtes depuis la mémoire. De tels déploiements nécessitent généralement huit à seize cœurs dédiés.
Mémoire
etcd présente une empreinte mémoire relativement faible, mais ses performances dépendent néanmoins d’une quantité suffisante de mémoire. Un serveur etcd met en cache de manière agressive les données clé-valeur et consacre la majeure partie de sa mémoire restante à la surveillance des observateurs. En général, 8 Go sont suffisants. Pour les déploiements intensifs comportant des milliers d’observateurs et des millions de clés, allouez entre 16 Go et 64 Go de mémoire selon les besoins.
Disques
Les disques rapides constituent le facteur le plus critique pour les performances et la stabilité du déploiement etcd.
Un disque lent augmentera la latence des requêtes etcd et pourrait compromettre la stabilité du cluster. Étant donné que le protocole de consensus d’etcd dépend du stockage persistant des métadonnées dans un journal, une majorité des membres du cluster etcd doit écrire chaque requête sur le disque. En outre, etcd effectue également des points de contrôle incrémentiels de son état sur le disque afin de tronquer ce journal. Si ces écritures prennent trop de temps, les battements de cœur pourraient expirer et déclencher une élection, ce qui affaiblit la stabilité du cluster. En général, pour déterminer si un disque est suffisamment rapide pour etcd, un outil de benchmark tel que fio peut être utilisé. Lisez ici pour un exemple.
etcd est très sensible à la latence d’écriture disque. Une capacité d’au moins 50 IOPS séquentielles (par exemple, un disque dur 7200 RPM) est généralement requise. Pour les clusters fortement sollicités, une capacité de 500 IOPS séquentielles (par exemple, un SSD local typique ou un périphérique de bloc virtuel à haute performance) est recommandée. Notez que la plupart des fournisseurs de cloud publient des IOPS concurrents plutôt que séquentiels ; les IOPS concurrents publiés peuvent être jusqu’à 10 fois supérieurs aux IOPS séquentiels. Pour mesurer les IOPS séquentiels réels, nous recommandons d’utiliser un outil de benchmark disque tel que diskbench ou fio .
etcd nécessite uniquement une bande passante disque modeste, mais une bande passante disque plus élevée permet des temps de récupération plus rapides lorsque membre défaillant doit rattraper le cluster. En général, 10MB/s peut récupérer 100 Mo de données en 15 secondes. Pour les clusters de grande taille, 100MB/s ou supérieur est recommandé pour récupérer 1 Go de données en 15 secondes.
Lorsqu’il est possible, sauvegardez le stockage d’etcd avec un SSD. Un SSD offre généralement des latences d’écriture plus faibles et une variation moindre qu’un disque dur rotatif, ce qui améliore la stabilité et la fiabilité d’etcd. Si vous utilisez un disque dur rotatif, choisissez les disques les plus rapides disponibles (15 000 tr/min). L’utilisation du RAID 0 est également une méthode efficace pour augmenter la vitesse du disque, que ce soit pour les disques rotatifs ou les SSD. Avec au moins trois membres dans le cluster, les variantes de RAID avec miroir et/ou parité sont inutiles ; la réplication cohérente d’etcd assure déjà une haute disponibilité.
Réseau
Les déploiements etcd à plusieurs membres bénéficient d’un réseau rapide et fiable. Afin que etcd soit à la fois cohérent et tolérant aux partitions, un réseau instable présentant des coupures de partition entraînera une disponibilité médiocre. Une faible latence garantit que les membres etcd peuvent communiquer rapidement. Un débit élevé permet de réduire le temps de récupération d’un membre etcd défaillant. Un réseau 1GbE est suffisant pour les déploiements courants de etcd. Pour les grands clusters etcd, un réseau 10GbE réduit le temps moyen de récupération.
Déployez les membres etcd au sein d’un même centre de données lorsque cela est possible, afin d’éviter les surcharges de latence et de réduire la probabilité d’événements de partitionnement. Si un domaine de défaillance dans un autre centre de données est nécessaire, choisissez un centre de données plus proche de celui déjà en place. Veuillez également consulter la documentation tuning pour plus d’informations sur le déploiement à travers des centres de données.
Exemples de configurations matériels
Voici quelques exemples de configurations matériels sur les environnements AWS et GCE. Comme mentionné précédemment, mais doit être souligné malgré tout, les administrateurs doivent tester un déploiement etcd avec une charge de travail simulée avant de le mettre en production.
Notez que ces configurations supposent que ces machines sont entièrement dédiées à etcd. Exécuter d’autres applications en parallèle sur ces machines peut entraîner des conflits de ressources et provoquer une instabilité du cluster.
Petit cluster
Un petit cluster gère moins de 100 clients, moins de 200 requêtes par seconde et stocke au plus 100 Mo de données.
Exemple de charge de travail d’application : un cluster Kubernetes à 50 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS concurrents max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56,25 |
| GCE | n1-standard-2 + 50Go PD SSD | 2 | 7,5 | 1500 | 25 |
Cluster de taille moyenne
Un cluster de taille moyenne prend en charge moins de 500 clients, moins de 1 000 requêtes par seconde et stocke au plus 500 Mo de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 250 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS concurrents max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93,75 |
| GCE | n1-standard-4 + 150Go PD SSD | 4 | 15 | 4500 | 75 |
Grand cluster
Un cluster important sert moins de 1 500 clients, moins de 10 000 requêtes par seconde, et stocke au plus 1 Go de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 1 000 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS simultanés max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250Go PD SSD | 8 | 30 | 7500 | 125 |
cluster xLarge
Un cluster xLarge prend en charge plus de 1 500 clients, plus de 10 000 requêtes par seconde et stocke plus de 1 Go de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 3 000 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS simultanés max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16 000 | 250 |
| GCE | n1-standard-16 + 500Go PD SSD | 16 | 60 | 15 000 | 250 |
12 - Maintenance
Aperçu
Un cluster etcd nécessite une maintenance périodique pour rester fiable. Selon les besoins d’une application etcd, cette maintenance peut généralement être automatisée et effectuée sans interruption de service ni dégradation significative des performances.
Toute maintenance etcd gère les ressources de stockage consommées par l’espace de clés etcd. Une gestion insuffisante de la taille de l’espace de clés est protégée par des quotas d’espace de stockage ; si un membre etcd manque d’espace, un quota déclenchera des alarmes à l’échelle du cluster, mettant le système en mode maintenance à opérations limitées. Pour éviter de manquer d’espace pour les écritures dans l’espace de clés, l’historique de l’espace de clés etcd doit être compacté. L’espace de stockage lui-même peut être récupéré en défragmentant les membres etcd. Enfin, des sauvegardes périodiques d’instantanés de l’état des membres etcd permettent de récupérer toute perte logique de données ou corruption involontaire causée par une erreur opérationnelle.
Rétention du journal Raft
etcd --snapshot-count définit le nombre d’entrées Raft appliquées à conserver en mémoire avant le compactage. Lorsque --snapshot-count est atteint, le serveur persiste d’abord les données d’instantané sur le disque, puis tronque les anciennes entrées. Lorsqu’un suiveur lent demande des journaux antérieurs à un index compacté, le leader envoie un instantané, forçant ainsi le suiveur à écraser son état.
Une valeur plus élevée de --snapshot-count conserve davantage d’entrées Raft en mémoire jusqu’à l’instantané, entraînant ainsi une utilisation mémoire accrue et récurrente
. Comme le leader conserve les dernières entrées Raft plus longtemps, un suiveur lent dispose de plus de temps pour se synchroniser avant que le leader ne prenne un instantané. --snapshot-count représente un compromis entre une utilisation mémoire plus élevée et une meilleure disponibilité des suiveurs lents.
Depuis la version 3.2, la valeur par défaut de --snapshot-count a passé de 10 000 à 100 000
.
Sur le plan des performances, un nombre supérieur à 100 000 pour --snapshot-count peut affecter le débit d’écriture. Un plus grand nombre d’objets en mémoire peut ralentir la phase de marquage du ramasse-miettes de runtime.scanobject
, et une récupération mémoire peu fréquente rend l’allocation plus lente. Les performances varient selon les charges de travail et les environnements système. Toutefois, en général, un compactage trop fréquent affecte la disponibilité du cluster et le débit d’écriture. Un compactage trop rare est également préjudiciable, car il exerce une pression excessive sur le ramasse-miettes Go. Voir Comprendre les aspects de performance d’etcd et de Raft
pour plus de résultats de recherche.
Compactage de l’historique : base de données clé-valeur API v3
Depuis que etcd conserve une historique exacte de son espace de clés, cette historique doit être régulièrement compactée afin d’éviter une dégradation des performances et une épuisement éventuel de l’espace de stockage. La compactation de l’historique de l’espace de clés supprime toutes les informations relatives aux clés remplacées avant une révision donnée de l’espace de clés. L’espace utilisé par ces clés devient alors disponible pour de nouvelles écritures dans l’espace de clés.
L’espace de clés peut être compacté automatiquement selon la politique de rétention des historiques à fenêtre temporelle de etcd, ou manuellement via etcdctl. La méthode etcdctl offre un contrôle fin du processus de compactage, tandis que la compactage automatique convient aux applications qui nécessitent l’historique des clés pendant une durée déterminée.
Un compactage initié par etcdctl fonctionne comme suit :
Les révisions antérieures à la révision de compactage deviennent inaccessibles :
Compaction automatique
etcd peut être défini pour effectuer automatiquement le compactage de l’espace de clés à l’aide des options --auto-compaction-mode et --auto-compaction-retention. Deux modes de compactage sont disponibles : periodic (par défaut) et revision.
Compactage périodique
Le compactage périodique conserve une fenêtre temporelle de l’historique de l’espace de clés :
La valeur de rétention précise la quantité d’historique à conserver. Un enregistrement ne sera pas compacté avant environ cette durée écoulée depuis sa création. Cela garantit que les observateurs lents peuvent encore rattraper leur retard dans la fenêtre de rétention.
Lorsque la période de rétention est supérieure à 1 heure, etcd effectue une compaction toutes les heures tout en maintenant la fenêtre complète de rétention. Lorsque la période de rétention est égale ou inférieure à 1 heure, etcd effectue une compaction à intervalle égal à la période de rétention.
Par exemple, avec --auto-compaction-retention=10h, etcd attend 10 heures pour le premier compactage, puis compacte toutes les heures par la suite :
Les valeurs recommandées dépendent du cas d’utilisation :
- Mises à jour fréquentes des mêmes clés : une période courte, telle que
1hou30m - Mises à jour peu fréquentes : une période plus longue, telle que
24h,48h, ou72h - Valeur par défaut générale :
10h
Compactage de révision
Le compactage par révision conserve un nombre fixe de révisions :
etcd vérifie toutes les 5 minutes et effectue une compaction sur "latest revision" - 1000. Par exemple, lorsque la dernière révision est 30000, elle effectue une compaction à la révision 29000.
défragmentation
Après avoir compacté l’espace de clés, la base de données backend peut présenter une fragmentation interne. Toute fragmentation interne correspond à de l’espace libre pour la base de données backend mais qui continue de consommer de l’espace de stockage. La compactation des anciennes révisions fragmente internement etcd en laissant des espaces vides dans la base de données backend. L’espace fragmenté est disponible pour etcd mais non disponible pour le système de fichiers hôte. Autrement dit, la suppression des données d’application ne libère pas l’espace sur le disque.
Le processus de défragmentation libère cet espace de stockage au système de fichiers. La défragmentation est effectuée au niveau du membre, afin d’éviter des pics de latence affectant l’ensemble du cluster.
Pour défragmenter un membre etcd, utilisez la commande etcdctl defrag :
Notez que la défragmentation d’un membre en cours d’exécution bloque le système en lecture et écriture pendant la reconstruction de ses états
Notez que la demande de défragmentation n’est pas répliquée au sein du cluster. Autrement dit, la demande n’est appliquée qu’au nœud local. Spécifiez tous les membres dans l’option --endpoints ou l’option --cluster pour trouver automatiquement tous les membres du cluster.
Exécutez les opérations de défragmentation pour tous les points d’accès du cluster associé au point d’accès par défaut :
Pour défragmenter directement un répertoire de données etcd lorsque etcd n’est pas en cours d’exécution, utilisez la commande :
Quota d’espace
La quota d’espace dans etcd garantit un fonctionnement fiable du cluster. Sans quota d’espace, etcd peut connaître des performances médiocres si l’espace de clés devient trop volumineux, ou simplement manquer d’espace de stockage, entraînant un comportement imprévisible du cluster. Si la base de données backend de l’espace de clés de tout membre dépasse la quota d’espace, etcd déclenche une alarme à l’échelle du cluster, qui met le cluster en mode maintenance, acceptant uniquement les lectures et suppressions de clés. Le cluster ne peut reprendre un fonctionnement normal qu’après avoir libéré suffisamment d’espace dans l’espace de clés, défragmenté la base de données backend et effacé l’alarme de quota d’espace.
Par défaut, etcd définit une quota d’espace conservateur adapté à la plupart des applications, mais il peut être configuré en ligne de commande, en octets :
La quota d’espace peut être déclenchée par une boucle :
Supprimer les données d’espace de clés excessives et défragmenter la base de données du backend ramènera le cluster dans les limites du quota :
La métrique etcd_mvcc_db_total_size_in_use_in_bytes indique l’utilisation réelle de la base de données après un compactage de l’historique, tandis que etcd_debugging_mvcc_db_total_size_in_bytes affiche la taille de la base de données incluant l’espace libre en attente de défragmentation. Cette dernière n’augmente que lorsque la première est proche d’elle, ce qui signifie qu’une fois que ces deux métriques sont proches du quota, un compactage de l’historique est nécessaire pour éviter de déclencher la limite d’espace.
etcd_debugging_mvcc_db_total_size_in_bytes est renommé en etcd_mvcc_db_total_size_in_bytes à compter de la version 3.4.
Il est possible de recevoir une erreur ErrGRPCNoSpace pour une requête Put/Txn/LeaseGrant, tout en voyant la requête d’écriture réussir en arrière-plan, car etcd vérifie la limite d’espace à la couche API et à la couche Apply, et la couche Apply ne lèvera que l’alarme NOSPACE sans bloquer la transaction.
Sauvegarde d’instantané
Effectuer des instantanés du cluster etcd de manière régulière constitue une sauvegarde durable pour un espace de clés etcd. En prenant des instantanés périodiques de la base de données backend d’un membre etcd, un cluster etcd peut être restauré à un instant donné dans un état connu comme étant valide.
Un instantané est pris avec etcdctl :
13 - Surveillance d’etcd
Chaque serveur etcd fournit des informations de surveillance locales sur son port client via des points de terminaison HTTP. Les données de surveillance sont utiles à la fois pour le contrôle de santé du système et le débogage du cluster.
Point d’entrée de débogage
Si --log-level=debug est défini, le serveur etcd exporte des informations de débogage sur son port client sous le chemin /debug. Prenez garde à la définition de --log-level=debug, car cela entraînera une dégradation des performances et une journalisation verbose.
Le point de terminaison /debug/pprof est le point de terminaison standard de profilage du runtime Go. Il peut être utilisé pour profiler l’utilisation du processeur, de la mémoire, des verrous et des goroutines. Par exemple, voici comment obtenir les 10 fonctions où etcd consacre le plus de temps :
go tool pprof
Le point de terminaison /debug/requests permet d’obtenir des traces gRPC et des statistiques de performance via un navigateur web. Par exemple, voici une requête Range pour la clé abc :
Point d’extrémité des métriques
Chaque serveur etcd exporte des métriques sous le chemin /metrics sur son port client, et éventuellement sur les emplacements indiqués par --listen-metrics-urls.
Les métriques peuvent être récupérées avec curl :
Vérification de santé
Depuis la version 3.3.0, outre la réponse à l’endpoint /metrics, toutes les localisations spécifiées par --listen-metrics-urls répondent également à l’endpoint /health. Cela peut être utile si l’endpoint standard est configuré avec une authentification TLS mutuelle (client), mais qu’un équilibreur de charge ou un service de surveillance doit tout de même accéder à la vérification de santé.
Depuis la version 3.4, deux nouveaux points d’entrée /livez et /readyz ont été ajoutés.
- le point de terminaison
/livezindique si le processus est actif ou s’il nécessite un redémarrage. - le point de terminaison
/readyzindique si le processus est prêt à servir le trafic.
Les détails de conception des points de terminaison sont documentés dans le KEP .
Chaque point de terminaison inclut plusieurs vérifications de santé individuelles, et vous pouvez utiliser le paramètre verbose pour afficher les détails des vérifications et leur état, par exemple
et vous verriez une réponse similaire à
L’API HTTP prend également en charge l’exclusion de vérifications spécifiques, par exemple
Prometheus
Exécuter un service de surveillance Prometheus est la méthode la plus simple pour ingérer et enregistrer les métriques d’etcd.
Tout d’abord, installez Prometheus :
Configurez l’extracteur Prometheus pour cibler les points d’accès du cluster etcd :
Configurez le gestionnaire Prometheus :
Prometheus récupérera désormais les métriques etcd toutes les 10 secondes.
Alerting
Il existe un ensemble d’alertes par défaut pour les clusters etcd v3 destinées à Prometheus .
Notez que les étiquettes job peuvent nécessiter un ajustement pour répondre à un besoin particulier. Les règles ont été rédigées pour s’appliquer à un seul cluster, il est donc recommandé de choisir des étiquettes uniques par cluster.
Grafana
Grafana dispose d’un support intégré pour Prometheus ; ajoutez simplement une source de données Prometheus :
Ensuite, importez le modèle de tableau de bord par défaut etcd dashboard template
et personnalisez-le. Par exemple, si le nom de la source de données Prometheus est my-etcd, les valeurs du champ datasource dans le JSON doivent également être my-etcd.
Tableau de bord d’exemple :
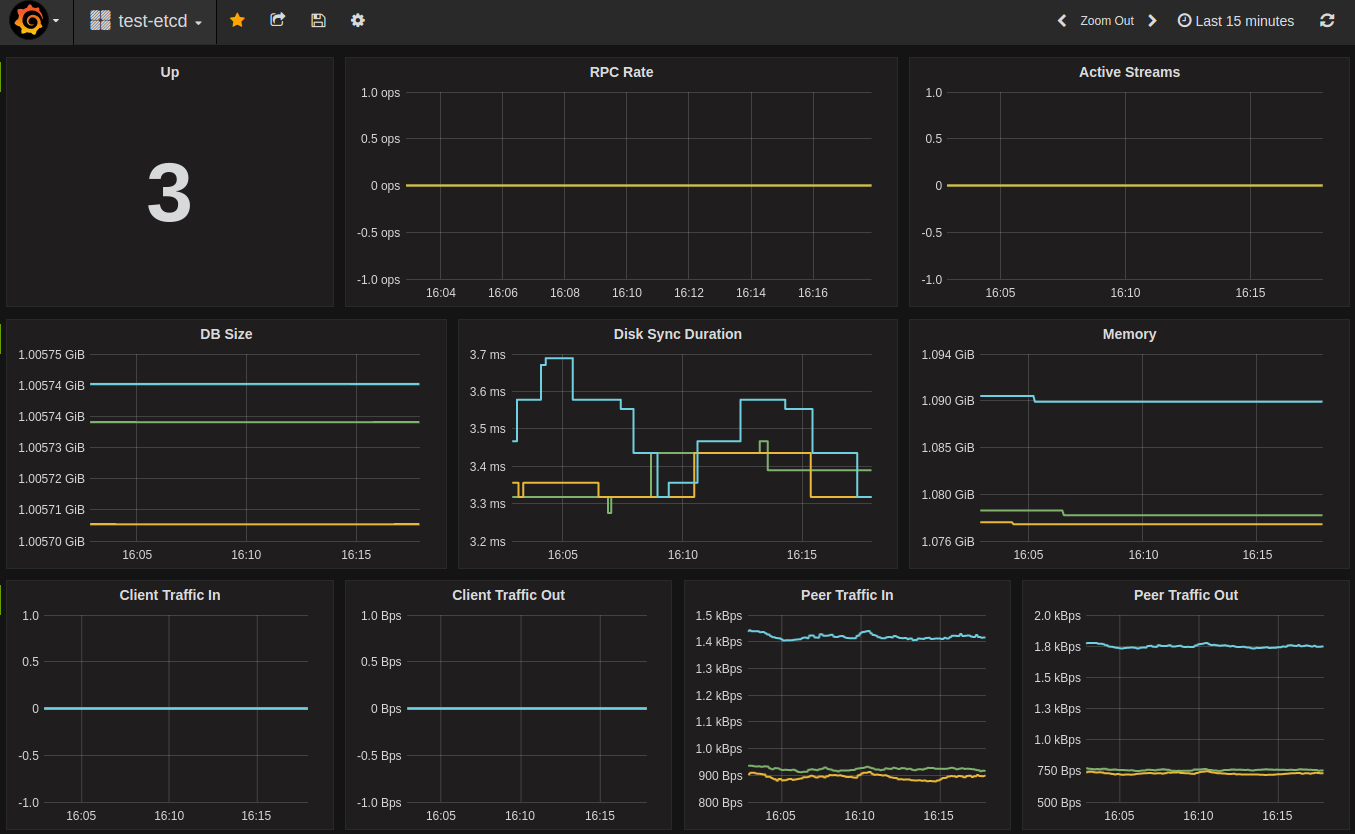
Traçage distribué
À partir de la version 3.5, etcd prend en charge le traçage distribué à l’aide de OpenTelemetry .
Cette fonctionnalité est encore expérimentale et peut être modifiée à tout moment.
Pour activer cette fonctionnalité expérimentale, passez le paramètre --experimental-enable-distributed-tracing=true au serveur etcd, ainsi que le drapeau --experimental-distributed-tracing-sampling-rate=<number> pour choisir le nombre d’échantillons à collecter par million de spans ; le taux d’échantillonnage par défaut est 0.
Configurez le traçage distribué en lançant le serveur etcd avec les indicateurs facultatifs suivants :
--experimental-distributed-tracing-address- (Facultatif) - « localhost:4317 » - Adresse du collecteur de traçage.--experimental-distributed-tracing-service-name- (Facultatif) - « etcd » - Nom du service de traçage distribué, doit être identique sur toutes les instances etcd.--experimental-distributed-tracing-instance-id- (Facultatif) - Identifiant d’instance ; bien qu’optionnel, il est fortement recommandé de le définir, et doit être unique par instance etcd.
Avant d’activer le traçage distribué, assurez-vous d’avoir un point de terminaison OpenTelemetry. Si cette adresse diffère de la valeur par défaut, remplacez-la à l’aide du drapeau --experimental-distributed-tracing-address. En raison des différentes manières de faire fonctionner OpenTelemetry, consultez la documentation du collector
pour en savoir plus.
Un surcroît de charge ressource existe, comme pour tout signal d’observabilité ; selon nos mesures initiales, cette surcharge pourrait s’élever entre 2 % et 4 % de la charge CPU.
14 - Performances
Comprendre les performances
etcd offre des performances stables et élevées de manière soutenue. Deux facteurs définissent les performances : la latence et le débit. La latence correspond au temps nécessaire pour accomplir une opération. Le débit correspond au nombre total d’opérations effectuées durant une période donnée. En général, la latence moyenne augmente lorsque le débit global augmente, lorsque etcd accepte des requêtes clientes concurrentes. Dans des environnements cloud courants, comme une instance standard n-4 sur Google Compute Engine (GCE) ou un type de machine équivalent sur AWS, un cluster etcd composé de trois membres exécute une requête en moins d’une milliseconde en charge légère, et peut traiter plus de 30 000 requêtes par seconde en charge lourde.
etcd utilise l’algorithme de consensus Raft pour répliquer les requêtes entre les membres et parvenir à un accord. Les performances du consensus, en particulier la latence de validation, sont limitées par deux contraintes physiques : la latence d’E/S réseau et la latence d’E/S disque. Le temps minimal pour finaliser une requête etcd correspond au temps de trajet aller-retour (RTT) réseau entre les membres, plus le temps que fdatasync met à valider les données dans un stockage permanent. Le RTT au sein d’un centre de données peut atteindre plusieurs centaines de microsecondes. Un RTT typique aux États-Unis est d’environ 50 ms, et peut s’élever à 400 ms entre les continents. La latence typique de fdatasync pour un disque rotatif est d’environ 10 ms. Pour les SSD, la latence est souvent inférieure à 1 ms. Pour améliorer le débit, etcd regroupe plusieurs requêtes ensemble et les soumet à Raft. Cette politique de regroupement permet à etcd d’atteindre un haut débit même sous une charge importante.
D’autres sous-systèmes influencent les performances globales d’etcd. Chaque requête etcd sérialisée doit passer par le moteur de stockage MVCC basé sur boltdb, ce qui prend généralement quelques dizaines de microsecondes. de manière périodique, etcd effectue un instantané incrémental de ses requêtes récemment appliquées, qu’il fusionne avec l’instantané précédent sur disque. Ce processus peut entraîner une pointe de latence. Bien que cela ne pose généralement pas de problème sur les SSD, cela peut doubler la latence observée sur les disques durs. De même, les compactages en cours peuvent affecter les performances d’etcd. Heureusement, l’impact est souvent négligeable, car le compactage est progressif, évitant ainsi toute concurrence pour les ressources avec les requêtes régulières. Le système RPC, gRPC, fournit à etcd une API bien définie et extensible, mais introduit également une latence supplémentaire, notamment pour les lectures locales.
Benchmarks
Le benchmark de la performance d’etcd peut être effectué à l’aide de l’outil en ligne de commande benchmark fourni avec etcd.
Pour des mesures de performance de base, nous considérons un cluster etcd composé de trois membres avec la configuration matérielle suivante :
- Google Cloud Compute Engine
- 3 machines de 8 vCPU + 16 Go de mémoire + 50 Go de SSD
- 1 machine (client) de 16 vCPU + 30 Go de mémoire + 50 Go de SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
Avec cette configuration, etcd peut écrire approximativement :
| Nombre de clés | Taille de la clé en octets | Taille de la valeur en octets | Nombre de connexions | Nombre de clients | Serveur etcd cible | Débit d’écriture moyen (QPS) | Latence moyenne par requête | RSS moyen du serveur |
|---|---|---|---|---|---|---|---|---|
| 10 000 | 8 | 256 | 1 | 1 | leader uniquement | 583 | 1,6 ms | 48 Mo |
| 100 000 | 8 | 256 | 100 | 1 000 | leader uniquement | 44 341 | 22 ms | 124 Mo |
| 100 000 | 8 | 256 | 100 | 1 000 | tous les membres | 50 104 | 20 ms | 126 Mo |
Commandes d’exemple :
Les requêtes de lecture linéarisable passent par un quorum de membres du cluster pour atteindre un consensus afin d’obtenir les données les plus récentes. Les requêtes de lecture sérialisable sont moins coûteuses que les lectures linéarisables, car elles sont servies par n’importe quel membre etcd unique, plutôt que par un quorum de membres, au prix d’une possible lecture de données obsolètes. etcd peut effectuer des lectures :
| Nombre de requêtes | Taille de la clé en octets | Taille de la valeur en octets | Nombre de connexions | Nombre de clients | Cohérence | Débit moyen en lectures (QPS) | Latence moyenne par requête |
|---|---|---|---|---|---|---|---|
| 10 000 | 8 | 256 | 1 | 1 | Linéarisable | 1 353 | 0,7 ms |
| 10 000 | 8 | 256 | 1 | 1 | Sériealisable | 2 909 | 0,3 ms |
| 100 000 | 8 | 256 | 100 | 1 000 | Linéarisable | 141 578 | 5,5 ms |
| 100 000 | 8 | 256 | 100 | 1 000 | Sériealisable | 185 758 | 2,2 ms |
Commandes d’exemple :
Nous recommandons d’exécuter le test de charge lors de la mise en place d’un cluster etcd pour la première fois dans un nouvel environnement afin de vérifier que le cluster atteint des performances adéquates ; la latence du cluster et le débit peuvent être sensibles aux légères différences d’environnement.
15 - Conception de la reconfiguration à l'exécution
La reconfiguration à l’exécution est l’une des fonctionnalités les plus complexes et sujettes aux erreurs dans un système distribué, en particulier dans un système fondé sur le consensus comme etcd.
Lisez la suite pour en savoir plus sur la conception des commandes de reconfiguration en cours d’exécution d’etcd et sur la manière dont nous avons résolu ces problèmes.
Les modifications de configuration en deux phases maintiennent le cluster en sécurité
Dans etcd, toute reconfiguration en cours d’exécution doit suivre deux phases pour des raisons de sécurité. Par exemple, pour ajouter un membre, il faut d’abord informer le cluster de la nouvelle configuration, puis démarrer le nouveau membre.
Phase 1 - Informer le cluster de la nouvelle configuration
Pour ajouter un membre à un cluster etcd, effectuez un appel d’API afin de demander l’ajout d’un nouveau membre au cluster. C’est la seule méthode permettant d’ajouter un nouveau membre à un cluster existant. L’appel d’API se termine lorsque le cluster a accepté le changement de configuration.
Phase 2 - Démarrer un nouveau membre
Pour rejoindre le nouveau membre etcd au cluster existant, précisez le bon initial-cluster et définissez initial-cluster-state sur existing. Lorsque le membre démarre, il contacte d’abord le cluster existant et vérifie que la configuration actuelle du cluster correspond à celle attendue spécifiée dans initial-cluster. Lorsque le nouveau membre démarre correctement, le cluster atteint la configuration attendue.
En divisant le processus en deux phases distinctes, les utilisateurs sont obligés de préciser explicitement les modifications apportées au membre du cluster. Cela accorde en réalité plus de flexibilité aux utilisateurs et simplifie la compréhension du comportement. Par exemple, si une tentative est faite d’ajouter un nouveau membre ayant le même ID qu’un membre existant dans un cluster etcd, l’action échoue immédiatement lors de la première phase, sans affecter le cluster en cours d’exécution. Une protection similaire est mise en place pour empêcher l’ajout accidentel de nouveaux membres. Si un nouveau membre etcd tente de rejoindre le cluster avant que le cluster n’ait accepté le changement de configuration, il ne sera pas accepté par le cluster.
Sans le workflow explicite concernant l’appartenance au cluster, etcd serait vulnérable aux modifications imprévues de l’appartenance au cluster. Par exemple, si etcd est exécuté sous un système d’initialisation tel que systemd, il serait redémarré après avoir été supprimé via l’API d’appartenance, puis tenterait de se réjoindre au cluster au démarrage. Ce cycle se reproduirait chaque fois qu’un membre est supprimé via l’API et que systemd est configuré pour redémarrer etcd après un échec, ce qui est inattendu.
Nous considérons que la reconfiguration à l’exécution doit être une opération rare. Nous avons choisi de la rendre explicite et pilotée par l’utilisateur afin d’assurer la sécurité de la configuration et de maintenir le cluster toujours en fonctionnement sans heurt, sous un contrôle explicite.
Perte permanente du quorum nécessite un nouveau cluster
Si un cluster perd définitivement la majorité de ses membres, un nouveau cluster devra être lancé à partir d’un répertoire de données ancien afin de restaurer l’état précédent.
Il est tout à fait possible de forcer la suppression des membres défaillants du cluster existant afin de procéder à une récupération. Toutefois, nous avons choisi de ne pas prendre en charge cette méthode, car elle contourne la phase normale de validation du consensus, ce qui est dangereux. Si le membre à supprimer n’est pas réellement défaillant ou n’a pas été supprimé de manière forcée par d’autres membres du même cluster, etcd se retrouvera avec un cluster divergent présentant le même clusterID. Cela constitue un risque très important et difficile à debug/fix par la suite.
Avec un déploiement correct, la probabilité de perte définitive de la majorité est très faible. Mais il s’agit d’un problème suffisamment grave pour mériter une attention particulière. Nous recommandons vivement de lire la documentation de récupération après sinistre et de préparer une stratégie de récupération face à une perte définitive de la majorité avant de mettre etcd en production.
N’utilisez pas de service de découverte publique pour la reconfiguration en cours d’exécution
Le service de découverte publique ne doit être utilisé que pour amorcer un cluster. Pour ajouter un membre à un cluster existant, utilisez l’API de reconfiguration en temps d’exécution.
Le service de découverte est conçu pour amorcer un cluster etcd dans un environnement cloud, lorsque les adresses IP de tous les membres ne sont pas connues à l’avance. Une fois le cluster amorcé avec succès, les adresses IP de tous les membres sont connues. Techniquement, le service de découverte ne devrait plus être nécessaire.
Il semble que l’utilisation du service de découverte public soit un moyen pratique de procéder à une reconfiguration en cours d’exécution, puisque le service de découverte possède déjà toutes les informations de configuration du cluster. Toutefois, compter sur le service de découverte public entraîne des difficultés :
introduit des dépendances externes pour l’ensemble du cycle de vie du cluster, et non seulement au moment du démarrage. En cas de problème de réseau entre le cluster et le service de découverte publique, le cluster en sera affecté.
Le service de découverte public doit refléter la configuration d’exécution correcte du cluster tout au long de son cycle de vie. Il doit proposer des mécanismes de sécurité pour éviter les actions non autorisées, ce qui est difficile.
Le service de découverte public doit gérer des dizaines de milliers de configurations de cluster. Le backend de notre service de découverte public n’est pas prêt à supporter cette charge.
Pour disposer d’un service de découverte qui prend en charge la reconfiguration en temps réel, le meilleur choix est de mettre en place le vôtre en interne.
16 - Reconfiguration en cours d'exécution
etcd dispose d’un support pour la reconfiguration incrémentielle en temps d’exécution, ce qui permet aux utilisateurs de mettre à jour la composition du cluster en cours d’exécution.
Les requêtes de reconfiguration ne peuvent être traitées que lorsque la majorité des membres du cluster sont fonctionnels. Il est fortement recommandé de toujours disposer d’un cluster de taille supérieure à deux en production. Il est dangereux de supprimer un membre d’un cluster à deux membres. La majorité d’un cluster à deux membres est également de deux. En cas d’échec pendant le processus de suppression, le cluster pourrait ne pas être en mesure de progresser et nécessiterait un redémarrage suite à une défaillance de la majorité .
Pour mieux comprendre la conception sous-jacente à la reconfiguration en temps réel, veuillez lire le document de reconfiguration en temps réel .
Cas d’utilisation de la reconfiguration
Cette section explique certaines raisons courantes de reconfiguration d’un cluster. La plupart de ces raisons consistent simplement en des combinaisons d’ajout ou de suppression d’un membre, telles qu’expliquées ci-dessous sous Opérations de reconfiguration du cluster .
Mise à jour ou mise à niveau de plusieurs machines
Si plusieurs membres d’un cluster doivent être déplacés en raison d’une maintenance planifiée (mise à jour matérielle, coupure réseau, etc.), il est recommandé de modifier les membres un par un.
Il est sûr de supprimer le leader, mais un bref temps d’indisponibilité survient pendant le processus d’élection. Si le cluster contient plus de 50 Mo de données v2, il est recommandé de migrer le répertoire de données du membre .
Modifier la taille du cluster
L’augmentation de la taille du cluster peut améliorer la tolérance aux pannes et les performances de lecture. Comme les clients peuvent lire depuis n’importe quel membre, l’augmentation du nombre de membres accroît le débit global des lectures sérialisées.
Réduire la taille du cluster peut améliorer les performances d’écriture du cluster, au prix d’une résilience réduite. Les écritures dans le cluster sont répliquées sur la majorité des membres avant d’être considérées comme validées. Réduire la taille du cluster diminue la taille de la majorité, et chaque écriture est ainsi validée plus rapidement.
Remplacer une machine défaillante
Si une machine tombe en panne à cause d’une défaillance matérielle, d’une corruption du répertoire de données ou d’une autre situation critique, elle doit être remplacée dès que possible. Les machines ayant cessé de fonctionner sans avoir été retirées affectent négativement le quorum et réduisent la tolérance à une défaillance supplémentaire.
Pour remplacer la machine, suivez les instructions pour supprimer le membre du cluster, puis ajouter un nouveau membre à sa place. Si le cluster contient plus de 50 Mo, il est recommandé de migrer le répertoire de données du membre défaillant s’il est toujours accessible.
Redémarrer le cluster après une défaillance majoritaire
Si la majorité du cluster est perdue ou si tous les nœuds ont changé d’adresse IP, une intervention manuelle est nécessaire pour effectuer une récupération en toute sécurité. Les étapes fondamentales du processus de récupération consistent à créer un nouveau cluster à partir des anciennes données , forcer un seul membre à agir en tant que leader, puis utiliser la configuration en temps réel pour ajouter les nouveaux membres à ce nouveau cluster un par un.
Récupérer un cluster suite à une défaillance de la majorité
Si un membre spécifique est perdu, cela revient à remplacer une machine défaillante. Les étapes sont décrites dans Remplacer une machine défaillante .
Opérations de reconfiguration du cluster
Étant donné ces cas d’utilisation, les opérations concernées peuvent être décrites pour chacune.
Avant toute modification, une majorité simple (quorum) des membres etcd doit être disponible. Il s’agit essentiellement de la même exigence que pour toute écriture dans etcd.
Toutes les modifications apportées au cluster doivent être effectuées séquentiellement :
- Pour mettre à jour les peerURLs d’un seul membre, effectuez une opération de mise à jour
- Pour remplacer un membre sain, supprimez l’ancien membre puis ajoutez un nouveau membre
- Pour passer de 3 à 5 membres, effectuez deux opérations d’ajout
- Pour passer de 5 à 3 membres, effectuez deux opérations de suppression
Tous ces exemples utilisent l’outil en ligne de commande etcdctl fourni avec etcd. Pour modifier l’appartenance sans etcdctl, utilisez l’API membres HTTP v2
ou l’API membres gRPC v3
.
Mettre à jour un membre
Mettre à jour les URL client d’annonce
Pour mettre à jour les URL d’annonce client d’un membre, redémarrez simplement ce membre en spécifiant les URL client mises à jour via le drapeau (--advertise-client-urls) ou la variable d’environnement (ETCD_ADVERTISE_CLIENT_URLS). Le membre redémarré publiera automatiquement les URL mises à jour. Une URL client incorrectement mise à jour n’affecte pas la santé du cluster etcd.
Mettre à jour les URL d’annonce des pairs
Pour mettre à jour les URL d’annonce des pairs d’un membre, mettez à jour explicitement celles-ci à l’aide de la commande member, puis redémarrez le membre. Cette action supplémentaire est nécessaire car la mise à jour des URL de pair modifie la configuration globale du cluster et peut affecter l’intégrité du cluster etcd.
Pour mettre à jour les URL d’annonce du pair, commencez par trouver l’ID du membre cible. Pour lister tous les membres avec etcdctl :
Cet exemple va update l’identifiant de membre a8266ecf031671f3 et modifier sa valeur peerURLs en http://10.0.1.10:2380 :
Supprimer un membre
Supposons que l’ID du membre à supprimer soit a8266ecf031671f3. Utilisez la commande remove pour effectuer la suppression :
Le membre cible s’arrête lui-même à ce stade et imprime la suppression dans le journal :
Il est sûr de supprimer le leader, mais le cluster sera inactif pendant la période nécessaire à l’élection d’un nouveau leader. Cette durée correspond normalement au délai d’élection plus la durée du processus de vote.
Ajouter un nouveau membre
Ajouter un membre est un processus en deux étapes :
- Ajoutez le nouveau membre au cluster au moyen de l’API HTTP des membres
, de l’API gRPC des membres
ou de la commande
etcdctl member add. - Démarrez le nouveau membre avec la nouvelle configuration du cluster, y compris la liste actualisée des membres (membres existants + nouveau membre).
etcdctl ajoute un nouveau membre au cluster en spécifiant le nom
du membre et les URL de pair annoncés
:
etcdctl a informé le cluster du nouveau membre et a affiché les variables d’environnement nécessaires pour le démarrer correctement. Désormais, lancez le processus etcd nouveau avec les drapeaux appropriés pour le nouveau membre :
Le nouveau membre s’exécutera en tant que partie du cluster et commencera immédiatement à se synchroniser avec le reste du cluster.
Lorsque vous ajoutez plusieurs membres, la meilleure pratique consiste à configurer un seul membre à la fois et à vérifier qu’il démarre correctement avant d’ajouter de nouveaux membres. Si vous ajoutez un nouveau membre à un cluster à un seul nœud, le cluster ne peut pas progresser avant que le nouveau membre ne démarre, car il faut deux membres pour atteindre la majorité nécessaire à l’atteinte du consensus. Ce comportement ne se produit que durant la période où etcdctl member add informe le cluster du nouveau membre et où ce dernier établit avec succès une connexion au membre existant.
Ajouter un nouveau membre apprenant
À partir de la version v3.4, etcd prend en charge l’ajout d’un nouveau membre en tant que membre apprenant / membre non votant. La motivation et la conception sont décrites dans le document design doc . Afin de rendre le processus d’ajout d’un nouveau membre plus sûr, et de réduire la durée d’indisponibilité du cluster lors de l’ajout du nouveau membre, il est recommandé de faire rejoindre le nouveau membre au cluster en tant que membre apprenant jusqu’à ce qu’il soit à jour. Ce processus peut être décrit comme une séquence en trois étapes :
Ajoutez le nouveau membre comme apprenant au moyen de l’API gRPC des membres ou de la commande
etcdctl member add --learner.Démarrez le nouveau membre avec la configuration mise à jour du cluster, incluant la liste des membres mis à jour (membres existants + le nouveau membre). Cette étape est identique à celle précédente.
Promouvoir le membre apprenant nouvellement ajouté en membre votant via l’API gRPC members ou la commande
etcdctl member promote. Le serveur etcd valide la requête de promotion afin d’assurer sa sécurité opérationnelle. Un membre apprenant ne peut être promu en membre votant qu’après avoir rattrapé le journal Raft du leader. Si un membre apprenant n’a pas encore rattrapé le journal Raft du leader, la requête de promotion échoue (voir la section [cas d’erreur lors de la promotion d’un membre] pour plus de détails). Dans ce cas, l’utilisateur doit attendre puis réessayer ultérieurement.
Dans la version 3.4, le serveur etcd limite le nombre de membres apprenants qu’un cluster peut avoir à un seul. La principale considération est de limiter la charge supplémentaire imposée au leader en raison de la propagation des données du leader vers le membre apprenant.
Utilisez etcdctl member add avec le drapeau --learner pour ajouter un nouveau membre au cluster en tant que membre apprenant.
Après avoir lancé le nouveau processus etcd pour le membre apprenant nouvellement ajouté, utilisez etcdctl member promote pour promouvoir le membre apprenant en membre ayant voix délibérative.
Cas d’erreur lors de l’ajout de membres
Dans le cas suivant, un nouvel hôte n’est pas inclus dans la liste des nœuds énumérés. Si c’est un nouveau cluster, le nœud doit être ajouté à la liste des membres initiaux du cluster.
Dans ce cas, indiquez une adresse différente (10.0.1.14:2380) de celle utilisée pour rejoindre le cluster (10.0.1.13:2380) :
Si etcd démarre en utilisant le répertoire de données d’un membre supprimé, etcd s’arrête automatiquement s’il se connecte à tout membre actif du cluster :
Cas d’erreur lors de l’ajout d’un membre apprenant
Impossible d’ajouter un membre apprenant à un cluster si celui-ci possède déjà 1 membre apprenant (v3.4).
Cas d’erreur lors de la promotion d’un membre apprenant
Un membre apprenant ne peut être promu en membre votant que s’il est synchronisé avec le leader.
Promouvoir un membre qui n’est pas un membre apprenant échouera.
Promouvoir un membre qui n’existe pas dans le cluster échouera.
Mode de vérification stricte de la configuration (-strict-reconfig-check)
Comme indiqué ci-dessus, la meilleure pratique pour ajouter de nouveaux membres consiste à configurer un seul membre à la fois et à vérifier qu’il démarre correctement avant d’ajouter d’autres nouveaux membres. Cette approche progressive est très importante, car si les nouveaux membres ne sont pas correctement configurés (par exemple, si les URL de pair sont incorrectes), le cluster peut perdre son quorum. La perte de quorum se produit car les nouveaux membres sont pris en compte dans le quorum, même s’ils ne sont pas accessibles depuis les autres membres existants. Une perte de quorum peut également survenir en cas de problème de connectivité ou de problème opérationnel.
Pour éviter ce problème, etcd met à disposition une option -strict-reconfig-check. Si cette option est passée à etcd, celui-ci rejette les demandes de reconfiguration lorsque le nombre de membres démarrés sera inférieur à un quorum du cluster reconfiguré.
Activé par défaut.
17 - Plateformes prises en charge
Support tiers
etcd s’exécute sur différentes plates-formes, mais les garanties qu’il fournit dépendent du niveau de prise en charge de la plate-forme :
- Niveau 1 : entièrement pris en charge par les mainteneurs [etcd][] ; etcd est garanti pour passer tous les tests, y compris les tests fonctionnels et de robustesse.
- Niveau 2 : etcd est garanti pour passer les tests d’intégration et les tests bout en bout, mais pas nécessairement les tests fonctionnels ou de robustesse.
- Niveau 3 : etcd est garanti pour être compilé, peut être légèrement testé (ou non), et doit donc être considéré comme instable.
Prise en charge actuelle
Le tableau suivant répertorie les plateformes actuellement prises en charge ainsi que leur niveau de prise en charge correspondant pour etcd :
| Architecture | Système d’exploitation | Niveau de support | Responsables |
|---|---|---|---|
| AMD64 | Linux | 1 | [mainteneurs etcd][] |
| ARM64 | Linux | 1 | [mainteneurs etcd][] |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Les plateformes non listées ne sont pas prises en charge.
Prise en charge d’une nouvelle plateforme
Souhaitez-vous contribuer à etcd en tant que « mainteneur officiel » d’une nouvelle plateforme ? En plus d’engager votre soutien à la plateforme, vous devez configurer une intégration continue (CI) d’etcd répondant aux exigences suivantes, selon le niveau de support :
| intégration continue etcd | Niveau 1 | Niveau 2 | Niveau 3 |
|---|---|---|---|
| La construction réussit | ✓ | ✓ | ✓ |
| Les tests unitaires réussissent | ✓ | ✓ | |
| Les tests d’intégration et bout-en-bout réussissent | ✓ | ✓ | |
| Les tests de robustesse réussissent | ✓ |
Pour un exemple de configuration du CI de niveau 2 pour ARM64, consultez [PR etcd #12928][].
Plateformes non prises en charge
Pour éviter d’exécuter accidentellement un serveur etcd sur une plateforme non prise en charge, etcd affiche un message d’avertissement et s’arrête immédiatement, sauf si la variable d’environnement ETCD_UNSUPPORTED_ARCH est définie sur l’architecture cible.
Systèmes 32 bits__ etcd présente des problèmes connus sur les systèmes 32 bits en raison d’un bogue dans le runtime Go.
Pour plus d’informations, consultez l’issue Go #599 et la note sur le bogue du paquet
18 - Gestion des versions
Ce document décrit les versions prises en charge par le projet etcd.
Versioning des services et versions prises en charge
Les versions d’etcd sont exprimées sous la forme x.y.z, où x représente la version majeure, y la version mineure et z la version de correctif, conformément à la terminologie Semantic Versioning . Les nouvelles versions mineures peuvent ajouter des fonctionnalités supplémentaires à l’API.
Le projet etcd maintient des branches de version pour la version actuelle et les versions précédentes. Par exemple, lorsque v3.5 est la version actuelle, v3.4 est prise en charge. Lorsque v3.6 est publiée, v3.4 n’est plus pris en charge.
Les correctifs applicables, y compris les correctifs de sécurité, peuvent être appliqués en retour à ces deux branches de version, selon leur gravité et leur faisabilité. Les versions correctives sont créées à partir de ces branches lorsque nécessaire.
Les responsables du projet Maintainers détiennent cette décision.
Vous pouvez vérifier la version du cluster etcd en cours d’exécution avec etcdctl :
Versionning de l’API
Les réponses de l’API v3 ne doivent pas changer après la version 3.0.0, mais de nouvelles fonctionnalités seront ajoutées au fil du temps.
19 - Corruption des données
etcd dispose d’une détection automatique des corruption de données intégrée afin d’éviter que l’état du membre ne diverge.
Activation détection corruption données
Détection de corruption de données possible à l’aide de :
- Vérification initiale, activée avec le drapeau
--experimental-initial-corrupt-check. - Vérification périodique de :
- Hachage de la révision compactée, activée avec le drapeau
--experimental-compact-hash-check-enabled. - Hachage de la dernière révision, activée avec le drapeau
--experimental-corrupt-check-time.
- Hachage de la révision compactée, activée avec le drapeau
La vérification initiale sera exécutée lors du démarrage du membre etcd. Le membre comparera son état persistant avec celui des autres membres et quittera l’exécution s’il détecte une incohérence.
Les deux vérifications périodiques seront exécutées par le leader du cluster dans un cluster déjà en cours d’exécution. Le leader comparera son état persistant aux autres membres et déclenchera une alarme CORRUPT en cas de désaccord. Les deux vérifications ont le même objectif, mais il est recommandé de les activer toutes les deux afin d’équilibrer performance et temps de détection.
- Vérification de hachage de la révision compactée – nécessite une compactage régulière, coût minimal sur la performance, gère les suiveurs lents.
- Vérification de hachage de la dernière révision – coût élevé sur la performance, ne gère pas les suiveurs lents ni les compactages fréquents.
Vérification du hachage de révision compactée
Lorsqu’il est activé à l’aide du drapeau --experimental-compact-hash-check-enabled, la vérification est exécutée toutes les minutes.
Cette fréquence peut être ajustée à l’aide du drapeau --experimental-compact-hash-check-time selon le format suivant : 1m - toutes les minutes, 1h - toutes les heures.
Cette vérification étend le compactage afin d’effectuer également le calcul d’un checksum pouvant être comparé entre les membres du cluster.
Elle ne provoque pas de balayage supplémentaire de la base de données, ce qui la rend très peu coûteuse, mais nécessite un compactage régulier dans le cluster.
Vérification du hachage de la dernière révision
Activé à l’aide du drapeau --experimental-corrupt-check-time, nécessite de préciser une période d’exécution au format : 1m - toutes les minutes, 1h - toutes les heures.
La période recommandée est de quelques heures en raison du coût élevé en performance.
L’exécution d’un contrôle nécessite le calcul d’un somme de contrôle en analysant l’intégralité du contenu etcd à la révision indiquée.
Restauration d’un membre corrompu
Il existe trois façons de restaurer un membre corrompu :
- Purger l’état persistant du membre
- Remplacer le membre
- Restaurer tout le cluster
Une fois que le membre corrompu est restauré, l’alarme CORRUPT peut être supprimée.
Purger l’état persistant d’un membre
L’état des membres peut être supprimé en procédant comme suit :
- Arrêt de l’instance etcd.
- Sauvegarde du répertoire de données etcd.
- Déplacement du sous-répertoire
snapdepuis le répertoire de données etcd. - Démarrage de
etcdavec--initial-cluster-state=existinget la liste des membres du cluster indiquée dans--initial-cluster.
Le membre etcd est censé télécharger un instantané à jour depuis le leader.
Remplacer le membre
Un membre peut être remplacé par :
- Arrêt de l’instance etcd.
- Sauvegarde du répertoire de données etcd.
- Suppression du répertoire de données.
- Suppression du membre du cluster en exécutant
etcdctl member remove. - Ajout du membre à nouveau en exécutant
etcdctl member add. - Démarrage de
etcdavec--initial-cluster-state=existinget la liste des membres du cluster indiquée dans--initial-cluster.
Restaurer l’intégralité du cluster
Un cluster peut être restauré en sauvegardant un instantané depuis le leader actuel et en le restorant sur tous les membres.
Exécutez etcdctl snapshot save contre le leader et suivez procédure de restauration d’un cluster
.