Vue imprimable multi-pages de cette section. .
Apprentissage
1 - Modèle de données
etcd est conçu pour stocker de manière fiable des données peu fréquemment mises à jour et fournir des requêtes de surveillance fiables. etcd expose les versions antérieures des paires clé-valeur afin de prendre en charge des instantanés à faible coût et les événements de historique de surveillance (« requêtes de voyage dans le temps »). Un modèle de données persistant, à plusieurs versions et contrôlant la concurrence s’adapte parfaitement à ces cas d’utilisation.
etcd stocke les données dans un magasin clé-valeur multiversion persistent . Le magasin clé-valeur préserve la version précédente d’une paire clé-valeur lorsque sa valeur est remplacée par de nouvelles données. Le magasin clé-valeur est effectivement immuable ; ses opérations ne mettent pas à jour la structure in situ, mais génèrent toujours une nouvelle structure mise à jour. Toutes les versions antérieures des clés restent accessibles et surveillables après modification. Pour empêcher que le magasin de données ne croisse indéfiniment au fil du temps et ne conserve des anciennes versions, le magasin peut être compacté afin de supprimer les versions les plus anciennes des données remplacées.
Vue logique
La vue logique du magasin est un espace binaire plat de clés. L’espace de clés dispose d’un index trié par ordre lexical sur les chaînes d’octets, ce qui rend les requêtes de plage peu coûteuses.
L’espace clé maintient plusieurs révisions. Lors de la création du magasin, la révision initiale est 1. Chaque opération mutative atomique (par exemple, une opération de transaction peut contenir plusieurs opérations) crée une nouvelle révision dans l’espace clé. Toutes les données détenues par les révisions précédentes restent inchangées. Les anciennes versions des clés peuvent toujours être consultées via les révisions antérieures. De même, les révisions sont indexées ; parcourir les révisions via des observateurs est efficace. Si le magasin est compacté pour économiser de l’espace, les révisions antérieures à la révision de compactage seront supprimées. Les révisions augmentent de manière monotone au cours de la durée de vie d’un cluster.
La durée de vie d’une clé s’étend sur une génération, depuis sa création jusqu’à sa suppression. Chaque clé peut avoir une ou plusieurs générations. La création d’une clé incrémente la version de cette clé, qui commence à 1 si la clé n’existe pas à la révision courante. La suppression d’une clé génère un jeton de suppression (tombstone), mettant fin à la génération courante de la clé en réinitialisant sa version à 0. Chaque modification d’une clé incrémente sa version ; ainsi, les versions augmentent de manière monotone au sein d’une génération de clé. Une fois un compactage effectué, toute génération terminée avant la révision de compactage est supprimée, ainsi que toutes les valeurs définies avant la révision de compactage, à l’exception de la dernière.
Vue physique
etcd stocke les données physiques sous forme de paires clé-valeur dans un arbre b+ persistant b+tree . Chaque révision de l’état du magasin ne contient que les différences par rapport à sa révision précédente, afin d’optimiser l’efficacité. Une seule révision peut correspondre à plusieurs clés dans l’arbre.
La clé d’une paire clé-valeur est un triplet (major, sub, type). Le champ major est la révision du magasin contenant la clé. Le champ sub permet de distinguer les clés au sein de la même révision. Le champ type est un suffixe facultatif pour des valeurs spéciales (par exemple, t si la valeur contient une suppression logique). La valeur de la paire clé-valeur contient la modification par rapport à la révision précédente, donc une différence par rapport à la révision précédente. L’arbre B+ est trié par clé selon l’ordre lexical par octets. Les recherches par plage sur les deltas de révision sont rapides ; cela permet de trouver rapidement les modifications entre deux révisions spécifiques. Le compactage supprime les paires clé-valeur obsolètes.
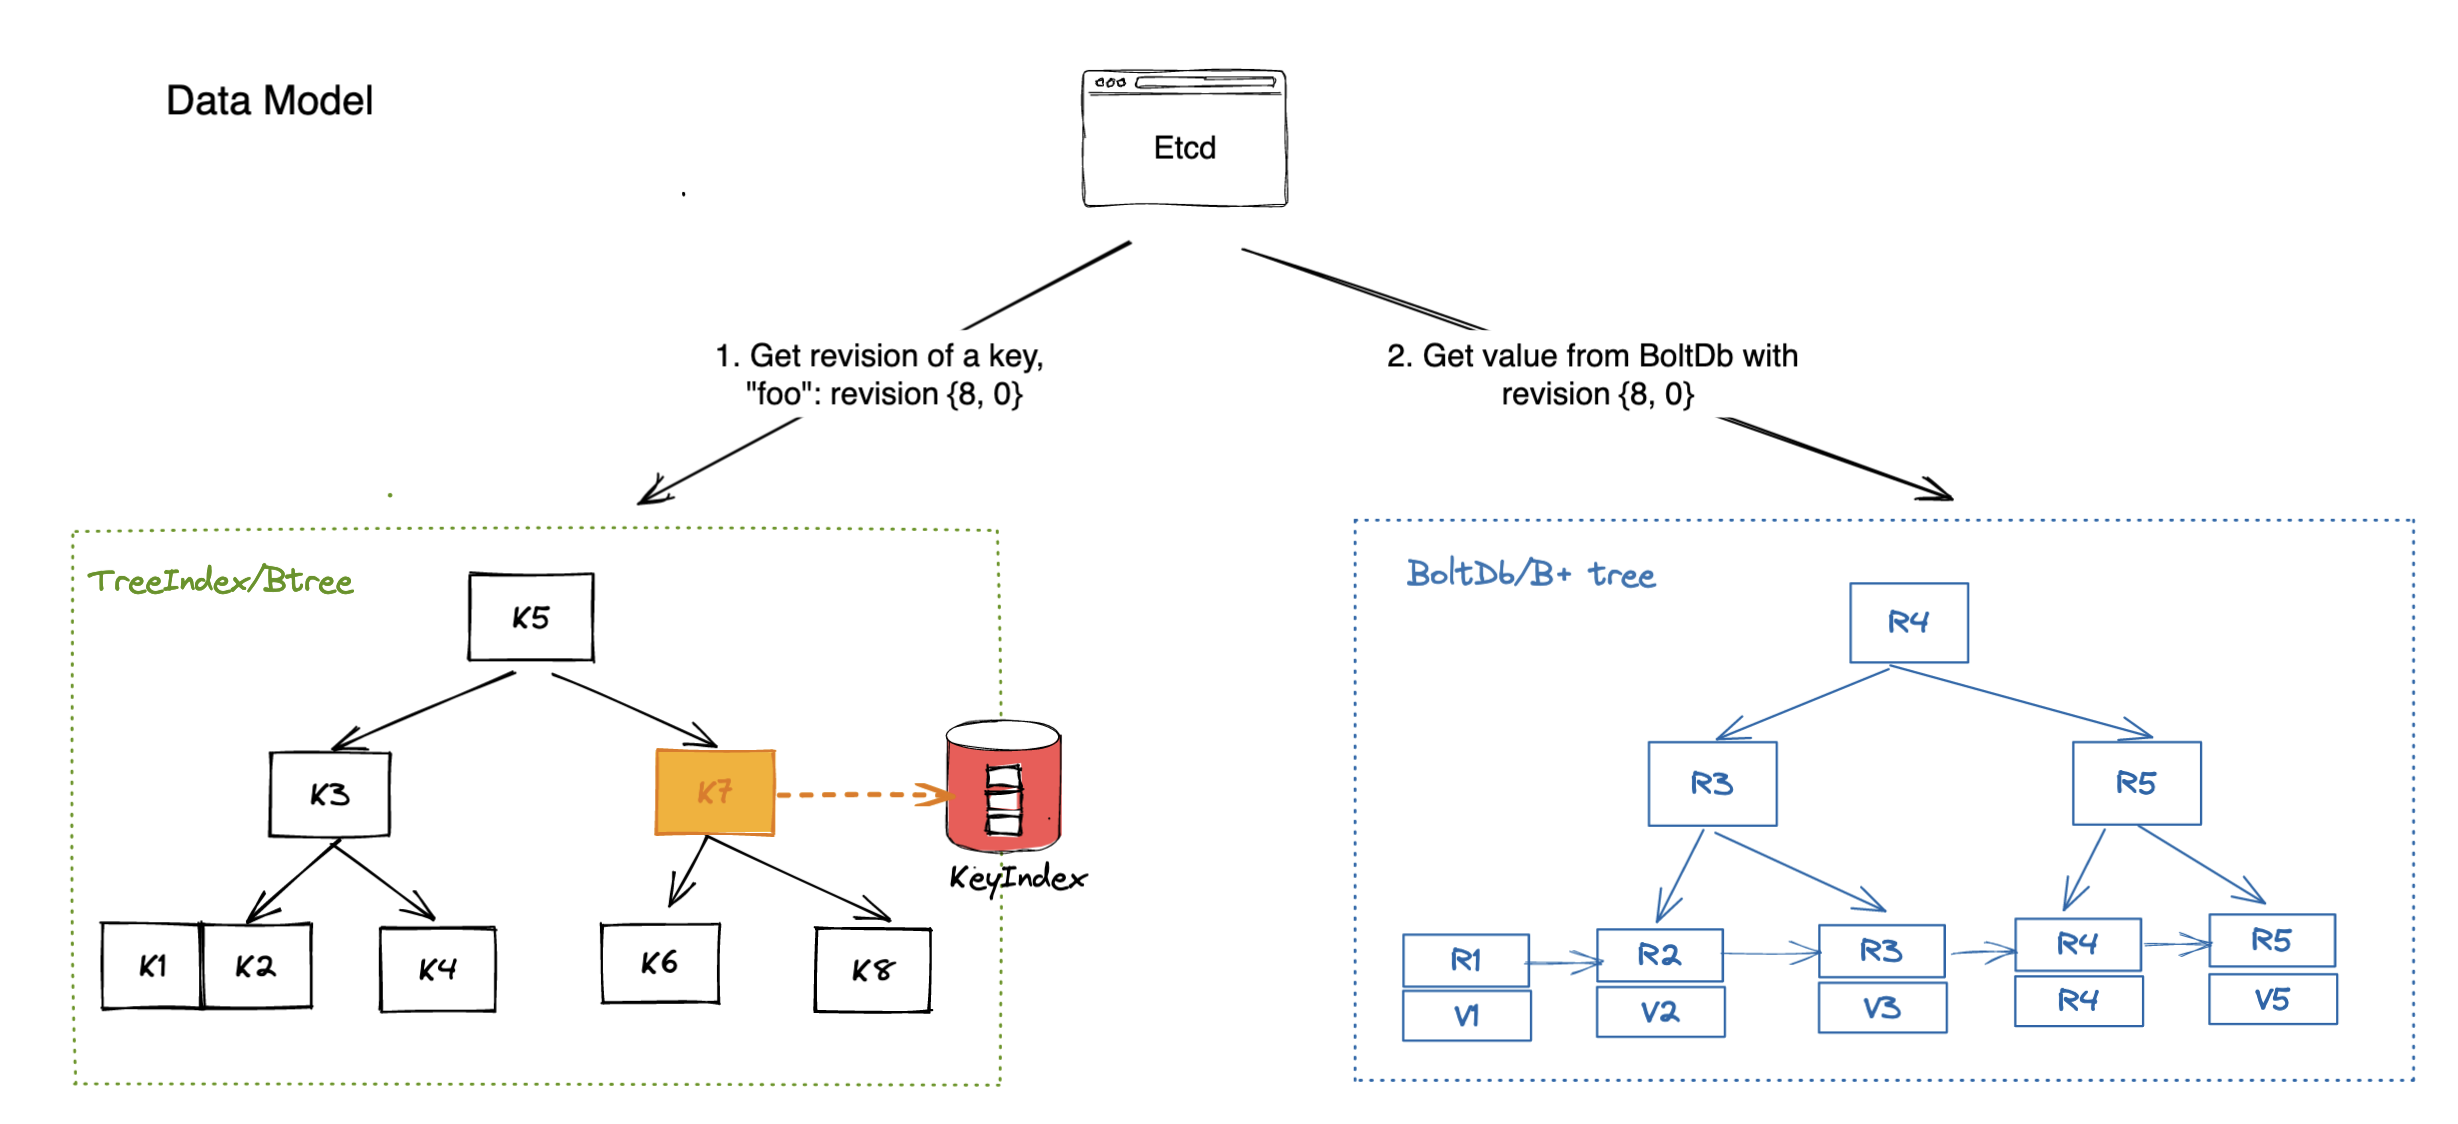
etcd maintient également un index secondaire en mémoire btree afin d’accélérer les requêtes portant sur une plage de clés. Les clés de l’index btree correspondent aux clés du magasin exposées à l’utilisateur. La valeur est un pointeur vers la modification du b+tree persistant. Le compactage supprime les pointeurs inutilisés.
Ensemble, etcd obtient les informations de révision à partir de l’arbre b, puis utilise la révision comme clé pour récupérer la valeur à partir de l’arbre b+ (comme illustré ci-dessous).
2 - etcd conception client
Conception du client etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Introduction
Le serveur etcd a démontré sa robustesse au fil de nombreuses années de tests d’injection d’erreurs. La logique d’application la plus complexe est déjà gérée par le serveur etcd et ses magasins de données (par exemple, la gestion de l’appartenance au cluster est transparente pour les clients, les propositions étant acheminées au leader au niveau du protocole Raft). Bien que les composants du serveur soient corrects, leur interaction avec les clients nécessite un ensemble différent de protocoles complexes afin de garantir leur correction et une haute disponibilité en cas de défaillance. Idéalement, le serveur etcd fournit une vue logique unique d’un cluster composé de plusieurs machines physiques, et le client implémente un basculement automatique entre les réplicas. Ce document décrit les choix architecturaux du client ainsi que leurs détails d’implémentation.
Glossaire
clientv3 : client Go officiel pour l’API etcd v3.
clientv3-grpc1.0 : Implémentation cliente officielle, avec grpc-go v1.0.x
, utilisée dans la dernière version etcd v3.1.
clientv3-grpc1.7 : Implémentation cliente officielle, avec grpc-go v1.7.x
, utilisée dans les versions les plus récentes d’etcd v3.2 et v3.3.
clientv3-grpc1.23 : Implémentation cliente officielle, avec grpc-go v1.23.x
, utilisée dans la dernière version etcd v3.4.
Balancer : équilibreur de charge client etcd qui implémente un mécanisme de réessai et de basculement. Le client etcd doit équilibrer automatiquement la charge entre plusieurs points d’accès.
Endpoints : une liste d’adresses d’extrémités du serveur etcd auxquelles les clients peuvent se connecter. En général, 3 ou 5 adresses client d’un cluster etcd.
Endpoint fixe : Lorsqu’il est configuré avec plusieurs endpoints, le chargeur de client <= v3.3 sélectionne un seul endpoint pour établir une connexion TCP, afin de limiter le nombre total de connexions ouvertes vers le cluster etcd. En v3.4, le chargeur effectue un balancement round-robin sur les endpoints fixés pour chaque requête, ce qui permet une répartition plus équilibrée de la charge.
Connexion client : connexion TCP établie avec un serveur etcd, via gRPC Dial.
Connexion sous-jacente : interface gRPC SubConn. Chaque connexion sous-jacente contient une liste d’adresses. Le chargeur de charge crée une SubConn à partir d’une liste d’adresses résolues. Une connexion cliente gRPC peut être associée à plusieurs SubConn (par exemple, example.com se résout en 10.10.10.1 et 10.10.10.2 de deux connexions sous-jacentes). Le chargeur de charge d’etcd v3.4 utilise un résolveur interne pour établir une connexion sous-jacente pour chaque point de terminaison.
Déconnexion transitoire : lorsque le serveur gRPC retourne une erreur de statut code Unavailable
.
Exigences client
Exactitude. Les requêtes peuvent échouer en cas de défaillance du serveur. Toutefois, les garanties de cohérence ne sont jamais violées : propriétés d’ordre global, écriture jamais corrompue, sémantique au plus une fois pour les opérations modifiables, la surveillance ne perçoit jamais d’événements partiels, et ainsi de suite.
Vivacité. Les serveurs peuvent tomber en panne ou se déconnecter brièvement. Les clients doivent pouvoir progresser dans les deux cas. Les clients doivent ne jamais bloquer en attendant qu’un serveur revienne en ligne, sauf si configuré pour ce faire. Idéalement, les clients détectent les serveurs indisponibles à l’aide de la ping HTTP/2 et basculent vers d’autres nœuds avec des messages d’erreur clairs.
Efficacité. Les clients doivent fonctionner efficacement avec un usage minimal des ressources : les connexions TCP précédentes doivent être fermées correctement après un changement de point de terminaison. Le mécanisme de basculement doit prévoir efficacement le prochain réplica à connecter, sans tenter inutilement de se reconnecter aux nœuds défaillants.
Portabilité. Le client officiel doit être clairement documenté et son implémentation doit être applicable à d’autres liaisons de langage. La gestion des erreurs entre les différentes liaisons de langage doit être cohérente. Étant donné qu’etcd s’engage pleinement en faveur de gRPC, l’implémentation doit être étroitement alignée sur les objectifs de conception à long terme de gRPC (par exemple, une politique de réessai paramétrable doit être compatible avec gRPC retry ). Les mises à jour entre deux versions du client doivent être non disruptives.
Aperçu du client
Le client etcd implémente les composants suivants :
- équilibreur de charge qui établit des connexions gRPC vers un cluster etcd,
- client API qui envoie des appels RPC à un serveur etcd, et
- gestionnaire d’erreurs qui détermine s’il faut réessayer une requête échouée ou basculer vers un autre point de terminaison.
Les langages peuvent différer quant à la manière d’établir une connexion initiale (par exemple, configurer TLS), à la manière d’encoder et d’envoyer des messages Protocol Buffer au serveur, à la gestion des appels RPC en flux, et ainsi de suite. Toutefois, les erreurs renvoyées par le serveur etcd seront identiques. La gestion des erreurs et la politique de nouvelle tentative doivent donc être identiques.
Par exemple, le serveur etcd peut retourner "rpc error: code = Unavailable desc = etcdserver: request timed out", qui correspond à une erreur transitoire nécessitant une nouvelle tentative. Ou bien retourner rpc error: code = InvalidArgument desc = etcdserver: key is not provided, ce qui signifie que la requête était invalide et ne doit pas être réessayée. Le client Go peut analyser les erreurs à l’aide de google.golang.org/grpc/status.FromError, et le client Java à l’aide de io.grpc.Status.fromThrowable.
clientv3-grpc1.0 : Vue d’ensemble du chargeur de charge
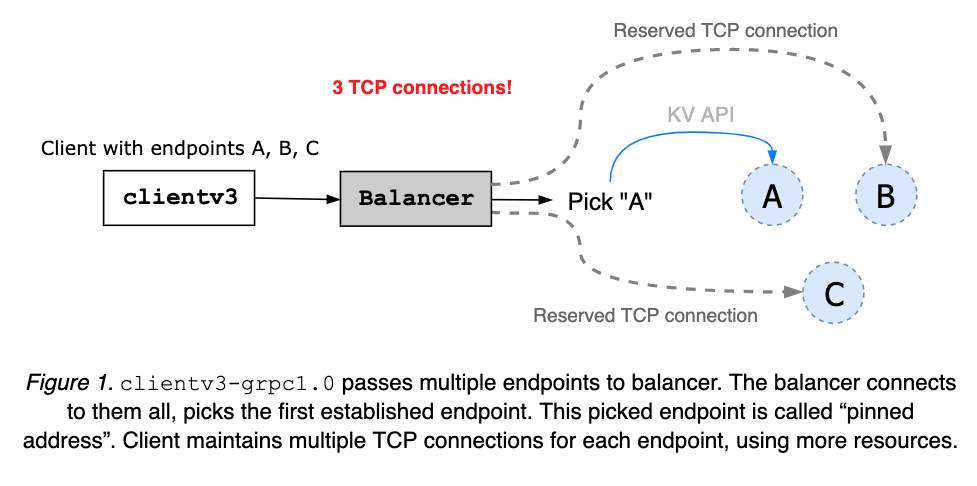
clientv3-grpc1.0 maintient plusieurs connexions TCP lorsqu’il est configuré avec plusieurs points d’accès etcd. Il sélectionne alors une adresse et l’utilise pour envoyer toutes les requêtes clientes. L’adresse fixe est conservée jusqu’à la fermeture de l’objet client (voir Figure 1). Lorsque le client reçoit une erreur, il choisit aléatoirement une autre adresse et réessaie.
clientv3-grpc1.0 : Limitation du chargeur d’équilibre
clientv3-grpc1.0 ouvrir plusieurs connexions TCP peut accélérer le basculement du chargeur mais nécessite plus de ressources. Le chargeur ne comprend pas l’état de santé des nœuds ni l’appartenance au cluster. Il est donc possible que le chargeur reste bloqué sur un nœud défaillant ou isolé.
clientv3-grpc1.7 : Vue d’ensemble du chargeur de charge
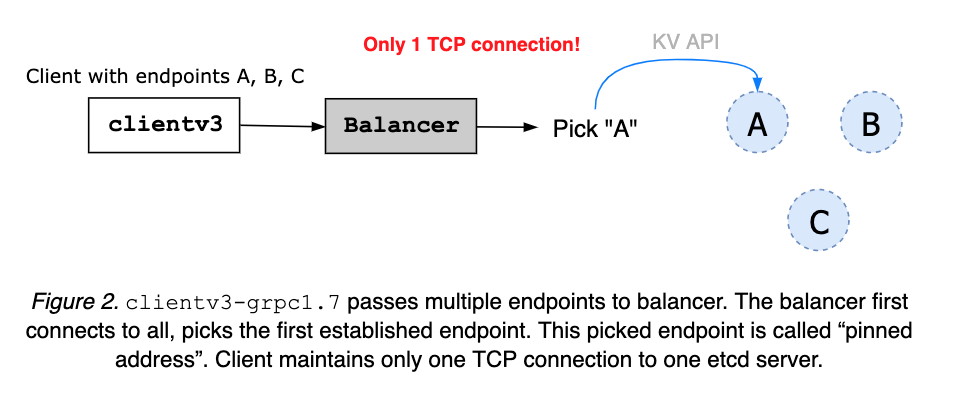
clientv3-grpc1.7 ne maintient qu’une seule connexion TCP vers un serveur etcd sélectionné. Lorsqu’il est fourni avec plusieurs points d’accès du cluster, le client tente d’établir une connexion avec chacun d’eux. Dès qu’une connexion est active, le chargeur de charge fixe l’adresse, en fermant les autres (voir Figure 2). L’adresse fixée doit être conservée jusqu’à la fermeture de l’objet client. Une erreur, provenant d’une panne du serveur ou du réseau client, est transmise au gestionnaire d’erreurs du client (voir Figure 3).
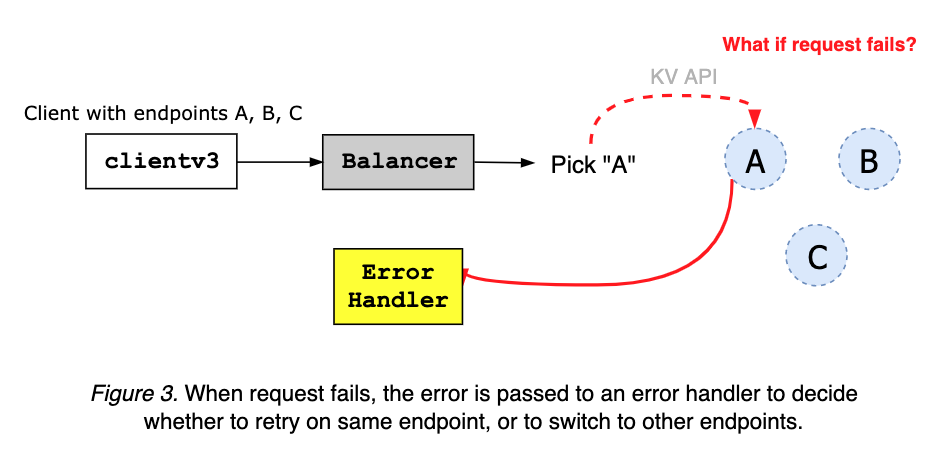
Le gestionnaire d’erreurs client prend une erreur provenant du serveur gRPC, et décide de procéder à une nouvelle tentative sur le même point de terminaison ou de passer à d’autres adresses, en fonction du code d’erreur et du message (voir Figure 4 et Figure 5).
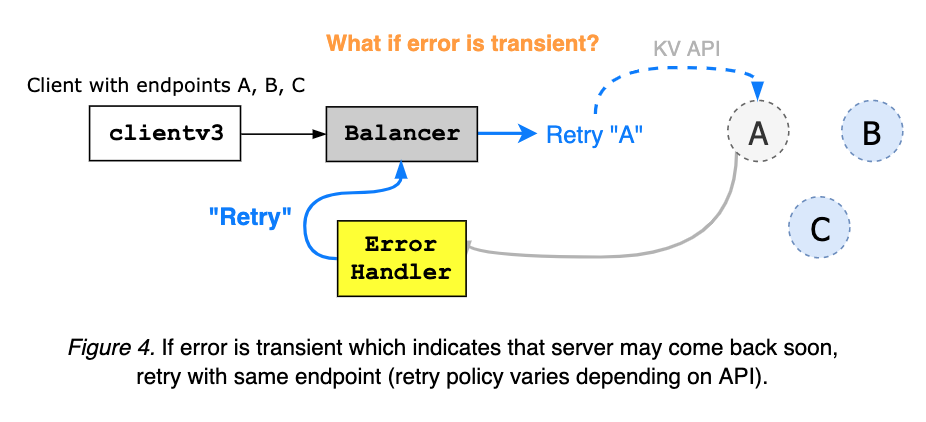
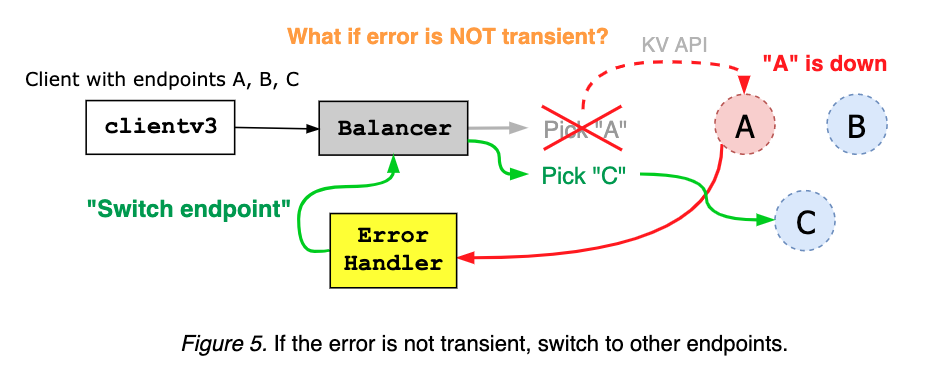
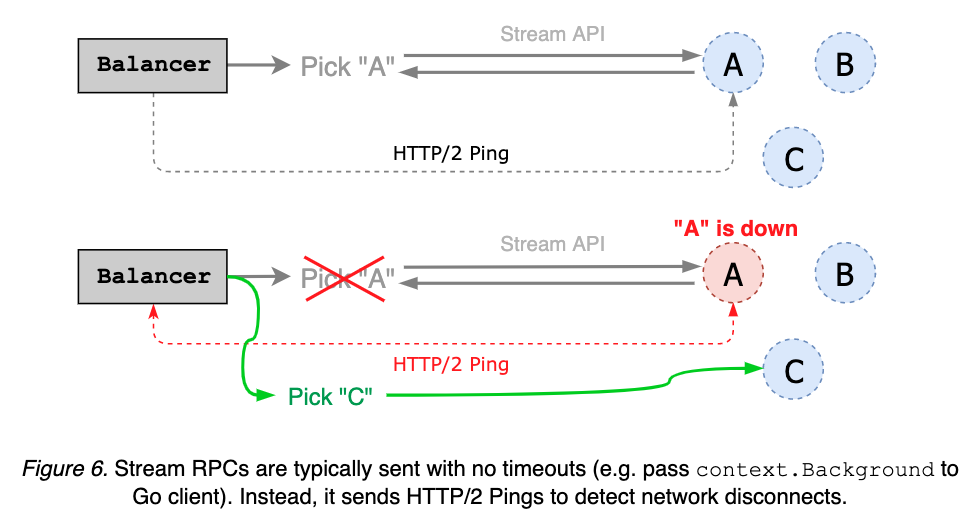
Les appels RPC en flux, tels que Surveillance et KeepAlive, sont souvent demandés sans délai d’attente. À la place, le client peut envoyer des ping HTTP/2 périodiques pour vérifier l’état d’un point d’accès fixe ; si le serveur ne répond pas au ping, l’équilibreur de charge bascule vers d’autres points d’accès (voir Figure 6).
clientv3-grpc1.7 : Limitation du chargeur d’équilibre
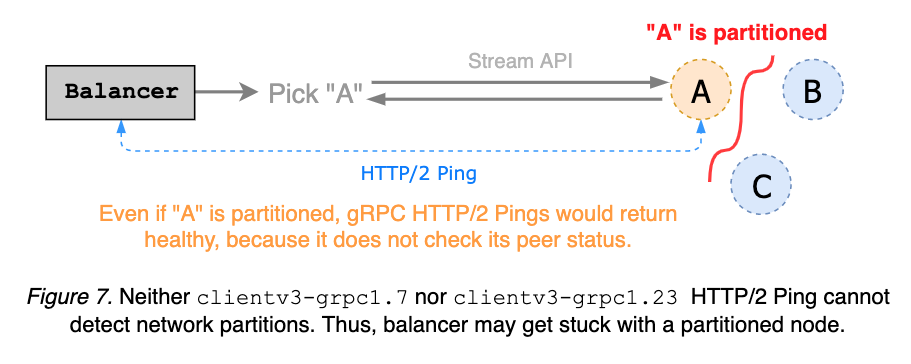
clientv3-grpc1.7 équilibre les envois de keepalives HTTP/2 pour détecter les déconnexions provenant des requêtes en streaming. Il s’agit d’un mécanisme de ping simple basé sur un serveur gRPC, qui ne tient pas compte de l’appartenance au cluster, et ne peut donc pas détecter les partitions réseau. Comme un serveur gRPC partitionné peut continuer à répondre aux pings clients, l’équilibreur peut rester bloqué sur un nœud partitionné. Idéalement, le ping de keepalive doit détecter la partition et déclencher un basculement de point de terminaison avant l’expiration de la requête (voir etcd#8673
et Figure 7).
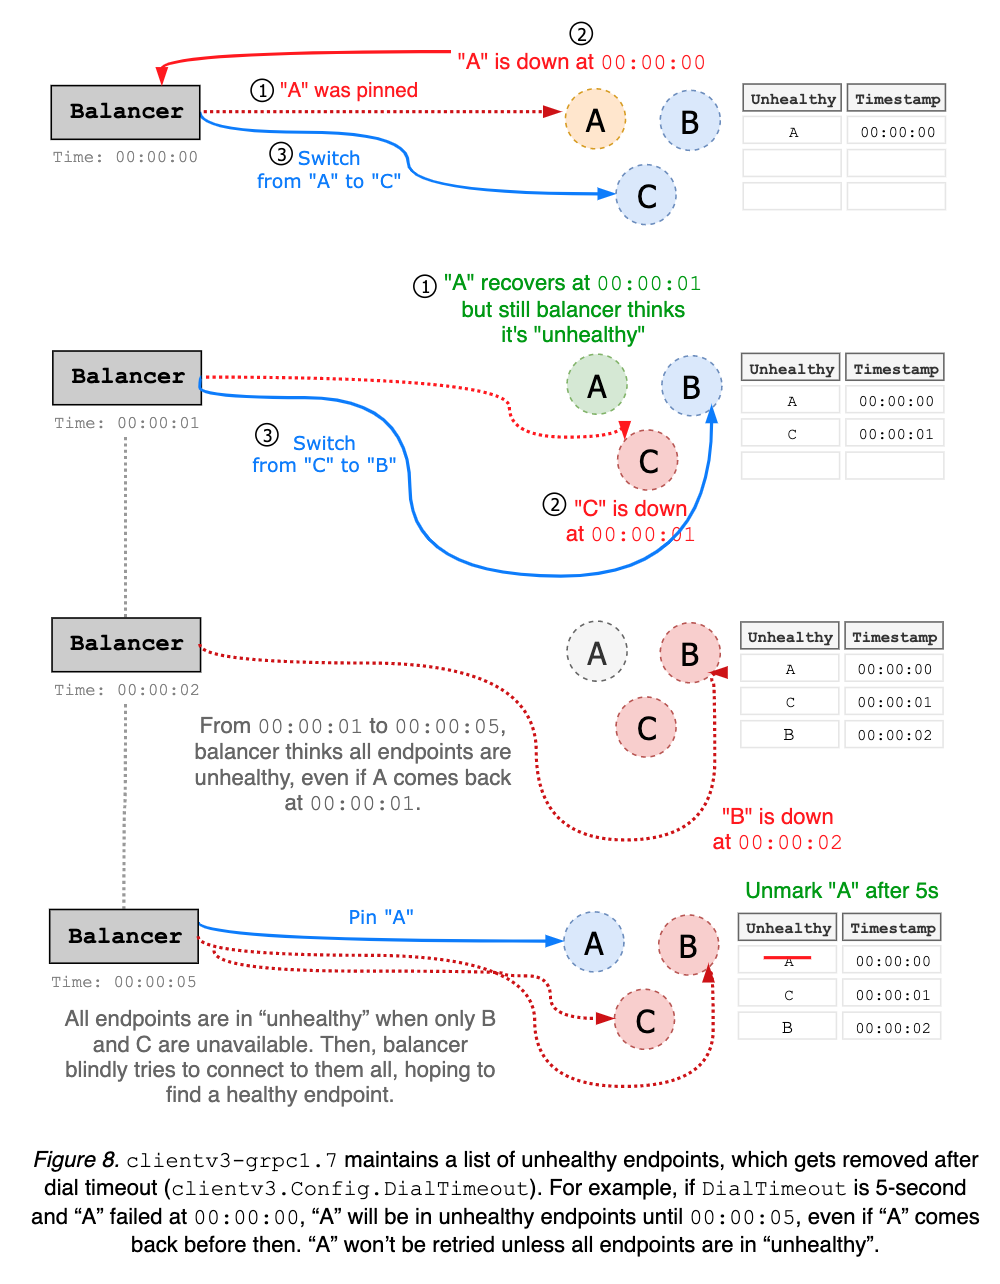
clientv3-grpc1.7 balancer maintient une liste d’extrémités défaillantes. Les adresses déconnectées sont ajoutées à la liste « défaillantes » et considérées comme indisponibles jusqu’après la durée d’attente, qui est codée en dur comme le délai de connexion avec une valeur par défaut de 5 secondes. Le balancer peut produire des faux positifs concernant les extrémités défaillantes. Par exemple, l’extrémité A peut revenir juste après avoir été bannie, mais rester indisponible pendant les 5 secondes suivantes (voir Figure 8).
clientv3-grpc1.0 a connu les mêmes problèmes mentionnés ci-dessus.
Le chargeur gRPC Go a déjà effectué la migration vers l’interface de nouveau chargeur. Par exemple, l’implémentation du chargeur sous-jacent utilisée par clientv3-grpc1.7 utilise le nouveau chargeur gRPC et tente de rester cohérente avec les comportements du chargeur ancien. Bien que sa compatibilité ait été maintenue de manière raisonnable, le client etcd a toujours souffert de modifications subtiles cassantes
. En outre, les mainteneurs gRPC recommandent de ne pas s’appuyer sur l’interface ancienne du chargeur
. En général, pour bénéficier d’un meilleur support de la part des projets upstream, il est préférable de rester synchronisé avec les dernières versions de gRPC. De plus, de nouvelles fonctionnalités, telles que la politique de nouvelle tentative, ne seront peut-être pas reportées sur la branche gRPC 1.7. Par conséquent, le serveur etcd ainsi que le client doivent migrer vers les versions les plus récentes de gRPC.
clientv3-grpc1.23 : Aperçu du chargeur de charge
clientv3-grpc1.7 est si étroitement lié à l’ancienne interface gRPC qu’une mise à jour de n’importe quelle dépendance gRPC a perturbé le comportement des clients. La majeure partie des efforts de développement et de débogage a été consacrée à la correction de ces changements de comportement des clients. En conséquence, son implémentation est devenue excessivement complexe, fondée sur des hypothèses erronées concernant les connectivités serveur.
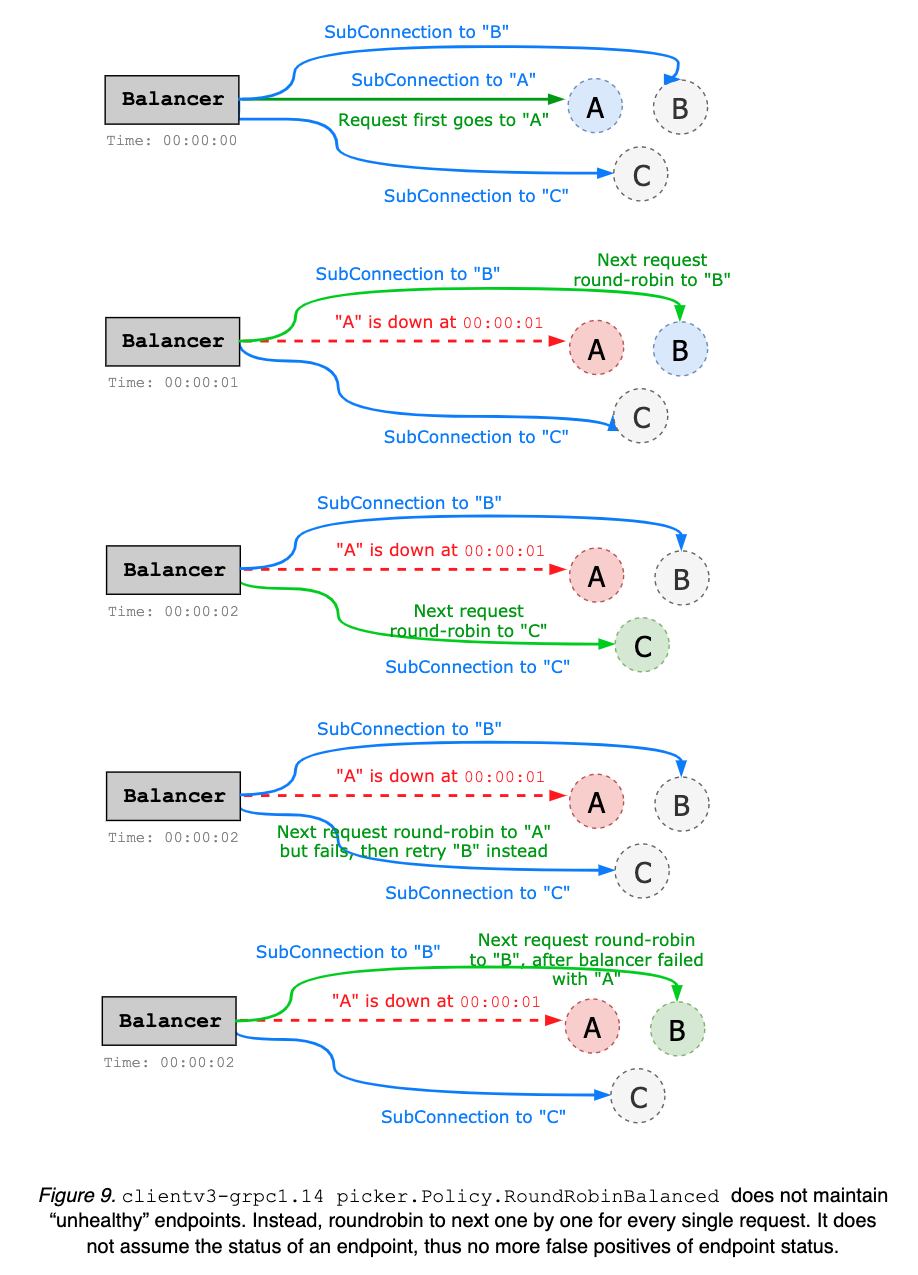
L’objectif principal de clientv3-grpc1.23 est de simplifier la logique de basculement du chargeur ; plutôt que de maintenir une liste d’extrémités défaillantes, qui pourrait être périmée, il suffit de procéder à un roundrobin vers l’extrémité suivante chaque fois que le client se déconnecte de l’extrémité actuelle. Il ne suppose pas l’état des extrémités. Ainsi, il n’est plus nécessaire de suivre de manière complexe l’état (voir Figure 8 et ci-dessus). La mise à jour vers clientv3-grpc1.23 ne devrait poser aucun problème ; toutes les modifications ont été internes tout en préservant toutes les compatibilités descendantes.
En interne, lorsqu’il reçoit plusieurs points de terminaison, clientv3-grpc1.23 crée plusieurs sous-connexions (une sous-connexion par point de terminaison), tandis que clientv3-grpc1.7 n’établit qu’une seule connexion vers un point de terminaison fixe (voir Figure 9). Par exemple, dans un cluster de 5 nœuds, le chargeur clientv3-grpc1.23 nécessiterait 5 connexions TCP, tandis que clientv3-grpc1.7 n’en nécessite qu’une seule. En conservant une pool de connexions TCP, clientv3-grpc1.23 peut consommer davantage de ressources mais offre un chargeur plus flexible avec de meilleures performances de basculement. La politique de répartition par défaut est le round robin, mais elle peut être facilement étendue pour prendre en charge d’autres types de chargeurs (par exemple, puissance de deux, sélection du leader, etc.). clientv3-grpc1.23 utilise le groupe de résolution gRPC et implémente la politique de sélection du chargeur, afin de déléguer le travail de répartition complexe au gRPC amont. En revanche, clientv3-grpc1.7 gère manuellement chaque connexion gRPC et le basculement du chargeur, ce qui complique l’implémentation. clientv3-grpc1.23 implémente la répétition dans la chaîne d’intercepteurs gRPC, qui gère automatiquement les erreurs internes gRPC et permet des politiques de répétition plus avancées, comme le backoff, tandis que clientv3-grpc1.7 interprète manuellement les erreurs gRPC pour les répétitions.
clientv3-grpc1.23 : Limitation du chargeur de trafic
Les améliorations peuvent être apportées en mettant en mémoire tampon l’état de chaque point de terminaison. Par exemple, le chargeur peut interroger à l’avance chaque serveur afin de maintenir une liste de candidats sains, et utiliser ces informations lors d’un routage par rotation. Ou bien, en cas de déconnexion, le chargeur peut privilégier les points de terminaison sains. Cela peut compliquer l’implémentation du chargeur, ce qui peut être traité dans des versions ultérieures.
Ping de keepalive côté client ne prend toujours pas en compte les partitions réseau. Une requête en streaming peut bloquer sur un nœud partitionné. Une solution avancée de vérification de santé doit être mise en œuvre pour comprendre l’appartenance au cluster (voir etcd#8673 pour plus de détails).
Actuellement, la logique de nouvelle tentative est gérée manuellement en tant qu’intercepteur. Cela pourrait être simplifié grâce à les nouvelles tentatives officielles gRPC .
3 - etcd design membre apprenant
etcd Membre apprenant
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Contexte
La reconfiguration du membership a été l’un des plus grands défis opérationnels. Examinons les défis courants.
1. Nouveau membre de cluster surcharge le leader
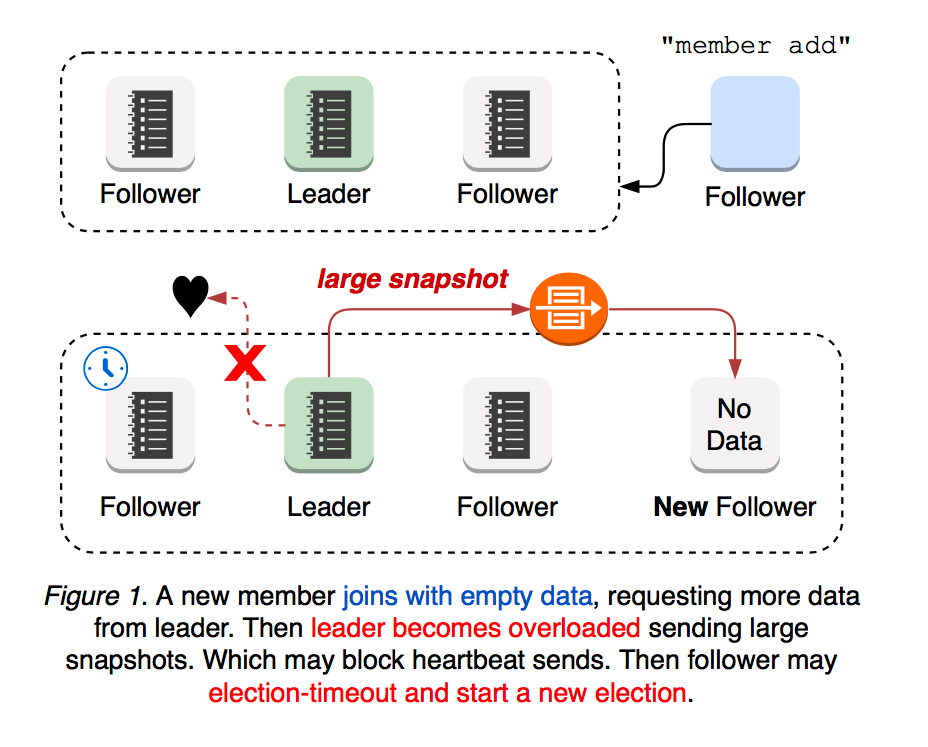
Un membre etcd nouvellement joint démarre sans données, ce qui entraîne un plus grand nombre de mises à jour provenant du leader jusqu’à ce qu’il rattrape la log du leader. Le réseau du leader est alors plus susceptible d’être surchargé, bloquant ou perdant les battements de cœur envoyés aux suiveurs. Dans ce cas, un suiveur peut atteindre son délai d’élection et déclencher une nouvelle élection de leader. Ainsi, un cluster comportant un nouveau membre est plus vulnérable à une élection de leader. À la fois l’élection de leader et la propagation ultérieure des mises à jour vers le nouveau membre sont sujettes à provoquer des périodes d’indisponibilité du cluster (voir Figure 1).
2. Scénarios de partition réseau
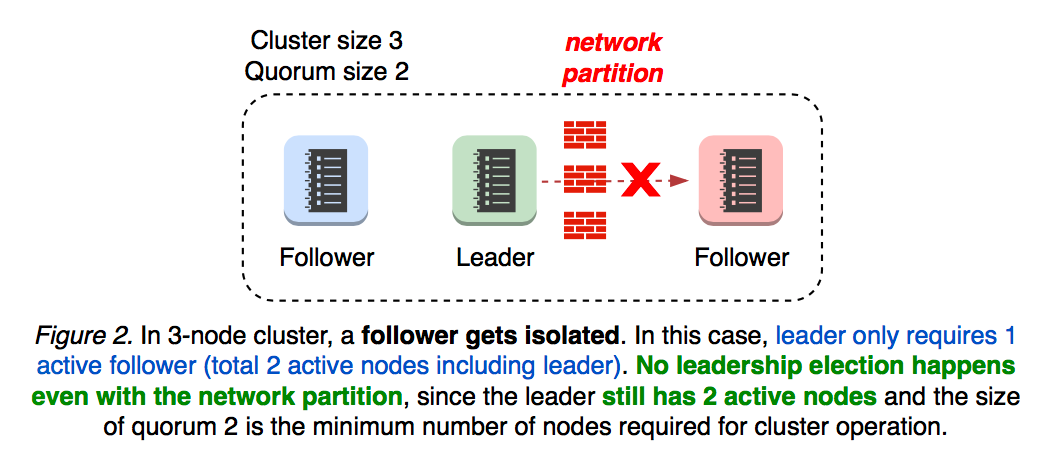
Que se passe-t-il en cas de partition réseau ? Cela dépend de la partition du leader. Si le leader conserve toujours un quorum actif, le cluster continue de fonctionner (voir Figure 2).
2.1 Isolement du leader
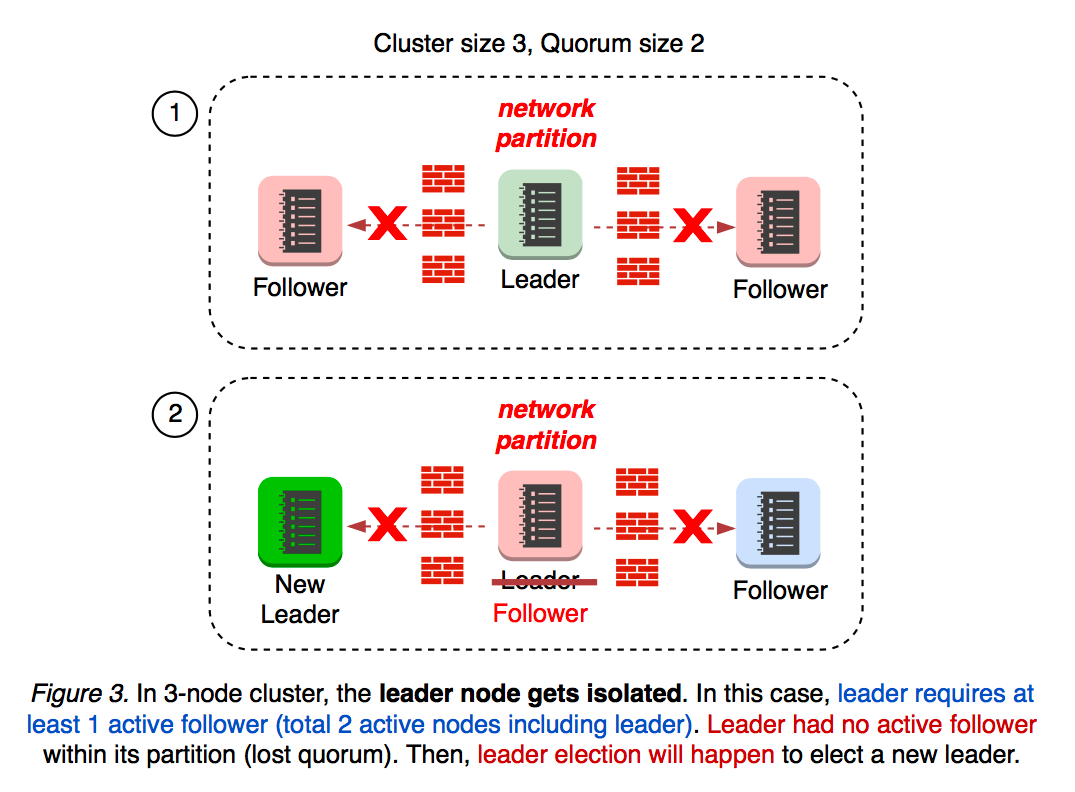
Que se passe-t-il si le leader devient isolé du reste du cluster ? Le leader surveille l’évolution de chaque suiveur. Lorsque le leader perd la connectivité avec le quorum, il redevient suiveur, ce qui affecte la disponibilité du cluster (voir Figure 3).
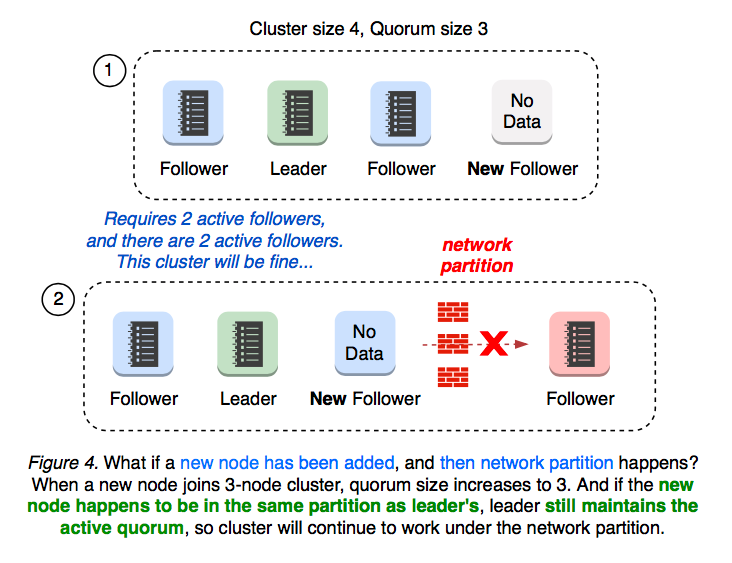
Lorsqu’un nouveau nœud est ajouté à un cluster de 3 nœuds, la taille du cluster devient 4 et la taille du quorum devient 3. Que se passe-t-il si un nouveau nœud rejoint le cluster, puis qu’une partition réseau se produit ? Cela dépend de la partition dans laquelle se trouve le nouveau membre après la partition.
2.2 Fractionnement du cluster 3+1
Si le nouveau nœud se trouve accidentellement dans la même partition que le leader, ce dernier conserve toujours un quorum actif de 3. Aucune élection de leader n’a lieu, et la disponibilité du cluster n’est pas affectée (voir Figure 4).
2.3 Fractionnement du cluster 2+2
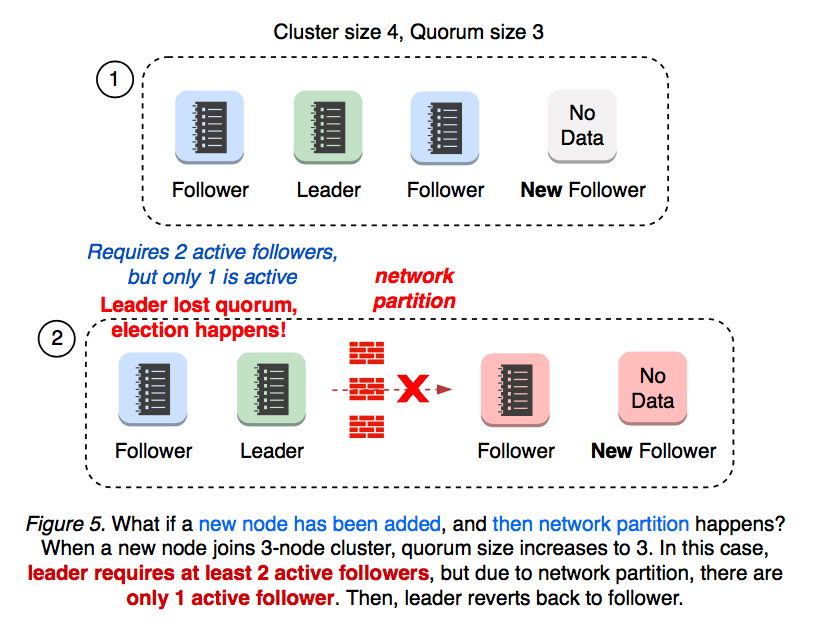
Si le cluster est partitionné en deux parties de deux, aucune des partitions ne conserve le quorum de 3. Dans ce cas, une élection de leader a lieu (voir Figure 5).
2.4 Quorum perdu
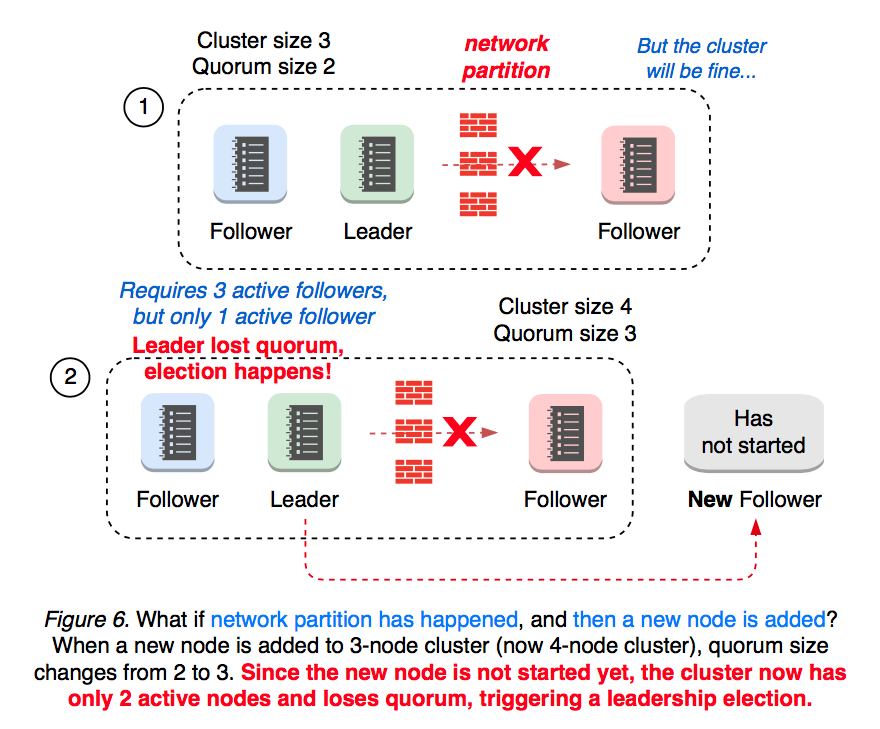
Que se passe-t-il si une partition réseau se produit en premier, puis qu’un nouveau membre est ajouté ? Un cluster à 3 nœuds déjà partitionné dispose déjà d’un suiveur déconnecté. Lorsqu’un nouveau membre est ajouté, le quorum passe de 2 à 3. Ce cluster dispose désormais de seulement 2 nœuds actifs sur 4, perd donc son quorum et déclenche une nouvelle élection de leader (voir Figure 6).
Étant donné que l’opération d’ajout d’un membre peut modifier la taille du quorum, il est toujours recommandé de supprimer d’abord le membre pour remplacer un nœud défaillant.
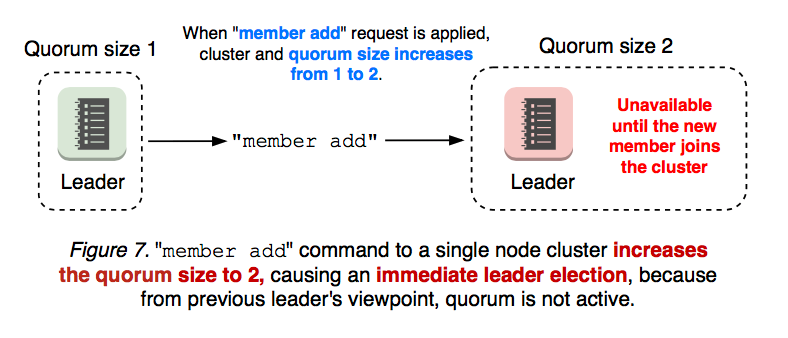
Ajouter un nouveau membre à un cluster à 1 nœud modifie la taille du quorum à 2, provoquant immédiatement une élection du leader lorsque le leader précédent constate que le quorum n’est pas actif. Cela est dû au fait que l’opération « member add » est une procédure en deux étapes, où l’utilisateur doit d’abord appliquer la commande « member add », puis démarrer le processus du nouveau nœud (voir Figure 7).
3. Mauvaises configurations du cluster
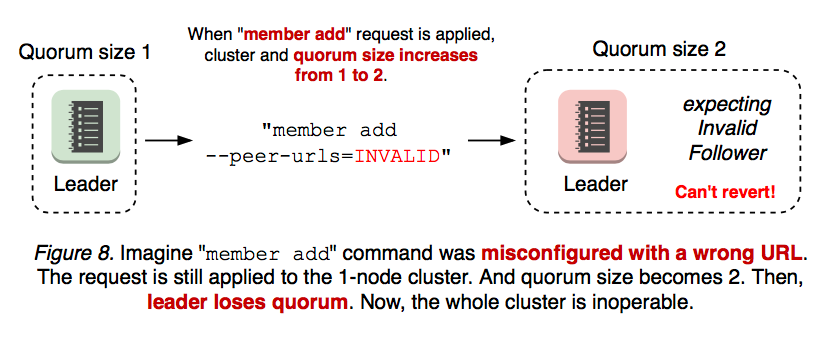
Un cas encore plus critique survient lorsque le membre ajouté est mal configuré. La reconfiguration du membre est un processus en deux étapes : « etcdctl member add » et le démarrage d’un processus serveur etcd avec l’URL de pair donnée. Autrement dit, la commande « member add » est appliquée indépendamment de l’URL, même lorsque la valeur de l’URL est invalide. Si la première étape est exécutée avec des URLs invalides, la deuxième étape ne peut même pas démarrer le nouvel etcd. Une fois que le cluster a perdu son quorum, il n’existe aucune possibilité de revenir en arrière sur le changement de configuration (voir Figure 8).
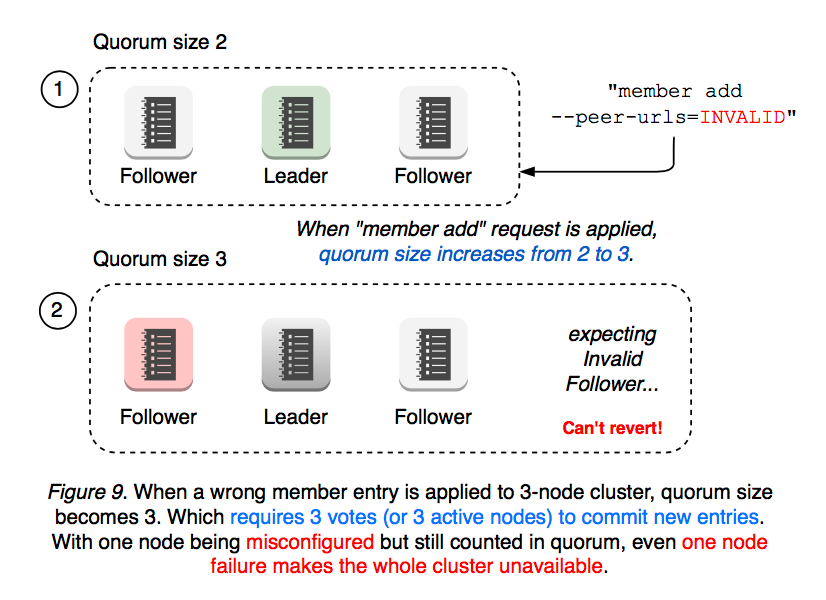
La même règle s’applique à un cluster à plusieurs nœuds. Par exemple, si deux membres du cluster sont hors ligne (l’un est défaillant, l’autre mal configuré) et deux membres sont opérationnels, il faut désormais au moins 3 votes pour modifier la composition du cluster (voir Figure 9).
Comme indiqué ci-dessus, une simple mauvaise configuration peut faire basculer l’ensemble du cluster dans un état inopératoire. Dans un tel cas, un opérateur doit recréer manuellement le cluster en utilisant le drapeau etcd --force-new-cluster. Étant donné qu’etcd est devenu un service critique pour Kubernetes, toute interruption, aussi brève soit-elle, peut avoir un impact significatif sur les utilisateurs. Que pouvons-nous faire de mieux pour simplifier ces opérations ? Entre autres, l’élection du leader est essentielle à la disponibilité du cluster : pouvons-nous rendre la reconfiguration de la composition du cluster moins disruptive en ne modifiant pas la taille du quorum ? Un nouveau membre peut-il rester inactif, ne demandant au leader que les mises à jour minimales, jusqu’à ce qu’il soit à jour ? La mauvaise configuration de la composition du cluster peut-elle toujours être annulée et gérée de manière plus sécurisée (une commande d’ajout de membre erronée ne devrait jamais faire échouer le cluster) ? Un utilisateur doit-il s’inquiéter de la topologie réseau lors de l’ajout d’un nouveau membre ? L’API d’ajout de membre peut-elle fonctionner indépendamment de l’emplacement des nœuds et des partitions réseau en cours ?
Membre apprenant Raft
Afin de réduire les lacunes de disponibilité décrites dans la section précédente, Raft §4.2.1 introduit un nouvel état de nœud appelé « membre apprenant », qui rejoint le cluster en tant que membre non votant jusqu’à ce qu’il ait rattrapé les journaux du leader.
Fonctionnalités de la version 3.4
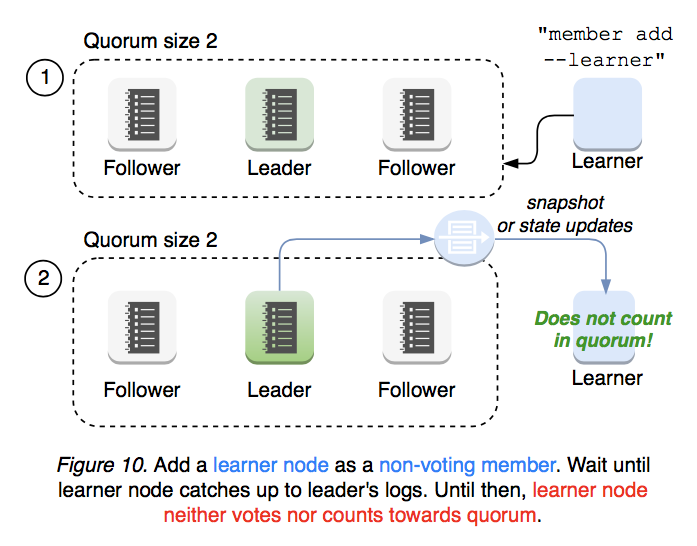
Un opérateur doit effectuer le minimum de travail possible pour ajouter un nouveau membre apprenant. Utilisez la commande member add --learner pour ajouter un nouveau membre apprenant, qui rejoint le cluster en tant que membre non votant tout en recevant toutes les données du leader (voir Figure 10).
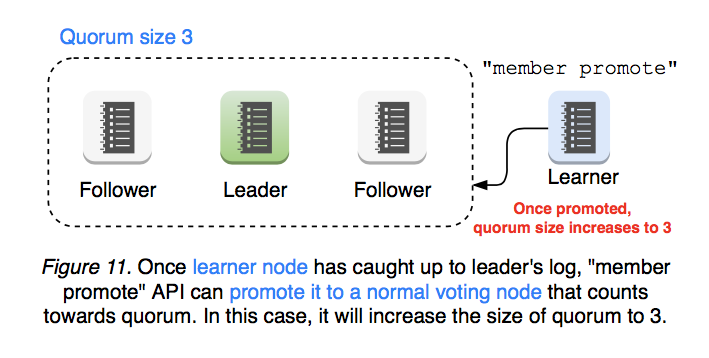
Lorsqu’un membre apprenant a rattrapé l’avancement du leader, il peut être promu en membre votant à l’aide de l’API member promote, qui contribue alors au quorum (voir Figure 11).
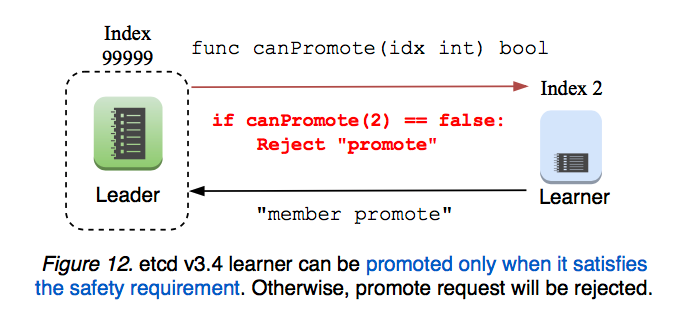
Le serveur etcd valide la demande de promotion afin d’assurer sa sécurité opérationnelle. Un membre apprenant ne peut être promu en membre votant qu’après avoir rattrapé le journal du leader (voir Figure 12).
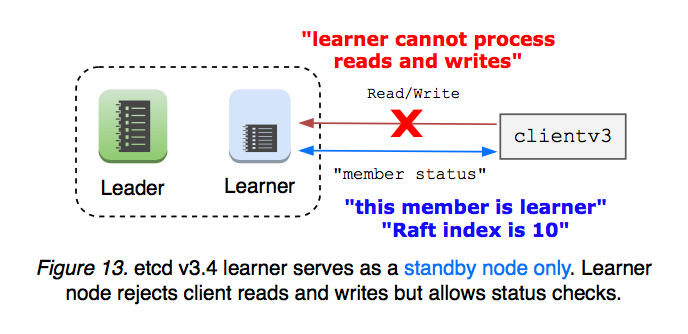
Le membre apprenant ne sert quasiment qu’à titre de nœud de secours jusqu’à sa promotion : la direction ne peut pas être transférée vers un membre apprenant. Le membre apprenant rejette les lectures et écritures clients (le chargeur de requêtes client ne doit pas acheminer les requêtes vers un membre apprenant). Cela signifie qu’un membre apprenant n’a pas besoin d’émettre de requêtes d’index de lecture au leader. Cette limitation simplifie l’implémentation initiale du membre apprenant dans la version v3.4 (voir Figure 13).
En outre, etcd limite le nombre total de membres apprenants qu’un cluster peut avoir, afin d’éviter de surcharger le leader avec la réplication des journaux. Un membre apprenant ne se promeut jamais lui-même. Bien qu’etcd fournisse des informations sur l’état du membre apprenant et des vérifications de sécurité, l’opérateur du cluster doit prendre la décision finale quant à la promotion d’un membre apprenant ou non.
Fonctionnalités proposées pour les versions futures
État apprenant uniquement et par défaut : Définir l’état par défaut d’un nouveau membre sur apprenant améliore considérablement la sécurité de la reconfiguration du groupe de membres, car un membre apprenant ne modifie pas la taille du quorum. Une mauvaise configuration reste toujours réversible sans perdre le quorum.
Promotion automatique des membres votants : Dès qu’un membre apprenant a rattrapé les journaux du leader, le cluster peut promouvoir automatiquement ce membre apprenant. etcd impose que l’utilisateur définisse certains seuils, et dès que ces conditions sont remplies, le membre apprenant se promeut lui-même en membre votant. Du point de vue de l’utilisateur, la commande « member add » fonctionnera de la même manière qu’aujourd’hui, mais avec une sécurité renforcée par la fonctionnalité de membre apprenant.
Passer un membre apprenant en nœud de basculement de secours : un membre apprenant rejoint en tant que nœud de secours et est automatiquement promu lorsque la disponibilité du cluster est compromise.
Rendre le membre apprenant en lecture seule : un membre apprenant peut servir de nœud en lecture seule qui ne sera jamais promu. En mode de cohérence faible, le membre apprenant reçoit uniquement des données du leader et ne traite jamais d’écritures. Servir les lectures localement, sans surcharge de consensus, réduit considérablement la charge imposée au leader, mais peut entraîner la lecture de données périmées. En mode de cohérence forte, le membre apprenant demande l’index de lecture au leader afin de servir les données les plus récentes, mais continue de rejeter les écritures.
Membre apprenant vs. Fabricant de miroir
etcd implémente une fonctionnalité de « mirror maker » à l’aide de l’API de surveillance pour relayer continuellement les créations et mises à jour de clés vers un cluster distinct. La mise en miroir présente généralement une surcharge de latence faible une fois la synchronisation initiale terminée. Les membres apprenants et la mise en miroir se recouvrent en ce sens qu’ils peuvent tous deux être utilisés pour répliquer des données existantes en lecture seule. Toutefois, la mise en miroir ne garantit pas la linéarité. En cas de déconnexion réseau, des valeurs de clés antérieures peuvent avoir été supprimées, et les clients sont censés vérifier les réponses de surveillance pour s’assurer de l’ordre correct. Par conséquent, aucune garantie d’ordre n’est assurée dans un miroir. Utilisez la mise en miroir pour une latence minimale (par exemple, entre centres de données) au prix de la cohérence. Utilisez les membres apprenants pour conserver toutes les données historiques et leur ordre.
Annexe : Implémentation du membre apprenant dans la version 3.4
Exposer le type de nœud “Learner” à l’API “MemberAdd”.
Le client etcd ajoute un indicateur à l’API « MemberAdd » pour un nœud membre apprenant. Le gestionnaire du serveur etcd applique l’entrée de changement d’appartenance avec le type pb.ConfChangeAddLearnerNode. Dès que la commande a été appliquée, un serveur rejoint le cluster avec l’indicateur etcd --initial-cluster-state=existing. Ce nœud membre apprenant ne peut ni voter ni être compté dans le quorum.
Le serveur etcd ne doit pas transférer le leadership à un membre apprenant, car celui-ci peut encore être en retard et ne compte pas dans le quorum. Le serveur etcd limite le nombre de membres apprenants qu’un cluster peut avoir à un seul : plus il y a de membres apprenants, plus le leader doit propager de données. Les clients peuvent interagir avec un nœud membre apprenant, mais celui-ci rejette toutes les requêtes sauf les lectures sérialisables et l’API d’état du membre. Ceci vise à simplifier l’implémentation initiale. À l’avenir, un membre apprenant pourra être étendu en serveur en lecture seule qui miroir continuellement les données du cluster. Le chargeur de requêtes client doit fournir une fonction d’aide pour exclure l’endpoint d’un membre apprenant. Sinon, une requête envoyée à un membre apprenant peut échouer. L’appel client de synchronisation du membre doit tenir compte du type de nœud membre apprenant. Il en va de même pour l’appel de mise à jour des points d’accès clients.
Les réponses de MemberList et MemberStatus doivent indiquer quel nœud est le membre apprenant.
Ajouter l’API “MemberPromote”.
En interne dans Raft, un deuxième appel MemberAdd au nœud membre apprenant le promeut en membre votant. Le leader suit l’avancement de chaque suiveur et membre apprenant. Si le membre apprenant n’a pas terminé son message d’instantané, rejeter la demande de promotion. Accepter la demande de promotion uniquement si et seulement si : le nœud membre apprenant est dans un état sain, et le membre apprenant est synchronisé avec le leader ou l’écart est inférieur au seuil (par exemple, le nombre d’entrées à répliquer vers le membre apprenant est inférieur à 1/10 du nombre d’entrées de l’instantané, ce qui signifie qu’il est peu probable que, même après la promotion, le leader doive envoyer un nouvel instantané au membre apprenant). Toute cette logique est codée en dur dans le paquet etcdserver et n’est pas configurable.
Référence
- Problème GitHub original : etcd#9161
- Cas d’utilisation : etcd#3715
- Cas d’utilisation : etcd#8888
- Cas d’utilisation : etcd#10114
4 - etcd conception de l'authentification v3
Pourquoi ne pas réutiliser le système d’authentification v2 ?
Le protocole v3 utilise gRPC comme transport, à la place d’une interface RESTful comme dans la v2. Ce nouveau protocole offre l’opportunité d’améliorer et d’évoluer la conception de la v2. Par exemple, l’authentification v3 repose sur une authentification basée sur la connexion, contrairement à l’authentification par requête plus lente de la v2. En outre, les sémantiques de l’authentification v2 s’avèrent souvent peu pratiques en pratique lorsqu’il s’agit d’assurer la cohérence, ce qui sera expliqué dans les sections suivantes. Pour la v3, une description et une implémentation clairement définies du mécanisme d’authentification corrigent les déficiences du système d’authentification v2.
Exigences fonctionnelles
- Authentification par connexion, pas par requête
- Authentification basée sur l’identifiant utilisateur et le mot de passe implémentée pour l’API gRPC
- L’authentification doit être actualisée après tout changement de stratégie d’authentification
- Sa fonctionnalité doit être aussi simple et utile que celle de la version v2
- La version v3 propose un espace de clés plat, contrairement à la structure hiérarchique de la version v2. La vérification des autorisations sera assurée par correspondance d’intervalle.
- Elle doit offrir des garanties de cohérence plus fortes que celles de la version v2 pour l’authentification
Modifications principales requises
- Un client doit établir une connexion dédiée uniquement à l’authentification avant d’envoyer des requêtes authentifiées
- Ajouter les informations de permission (identifiant utilisateur et révision autorisée) aux commandes Raft (
etcdserverpb.InternalRaftRequest) - Chaque requête est vérifiée pour les autorisations au niveau de la couche machine d’état, plutôt qu’au niveau de l’API
Consistance des métadonnées de permission
Les métadonnées relatives à l’authentification doivent également être stockées et gérées dans le stockage contrôlé par le protocole Raft d’etcd, comme les autres données stockées dans etcd. Cela est nécessaire pour ne pas compromettre la disponibilité et la cohérence de l’ensemble du cluster. Si la lecture ou l’écriture des métadonnées (par exemple, les informations de permission) nécessitait l’accord de chaque nœud (plus qu’un quorum), la défaillance d’un seul nœud pourrait bloquer l’ensemble du cluster. Exiger l’accord de tous les nœuds simultanément signifie que la vérification des requêtes ordinaires read/write ne peut pas être accomplie si un membre du cluster est hors ligne, même si le cluster dispose d’un quorum disponible. Ce schéma unanime dégrade finalement la disponibilité du cluster ; un consensus basé sur le quorum issu de Raft suffit, car l’accord découle d’un ordre cohérent.
Le mécanisme d’authentification dans le protocole etcd v2 comporte une difficulté car la cohérence des métadonnées devrait fonctionner comme indiqué ci-dessus, mais ne fonctionne pas : chaque vérification de permission est traitée par le membre etcd qui reçoit la requête cliente (server/etcdserver/api/v2http/client.go), y compris les membres suiveurs. Il est donc possible que la vérification soit basée sur des métadonnées obsolètes.
Ce délai signifie qu’une modification de configuration d’authentification ne peut pas être immédiatement reflétée après l’exécution de la commande etcdctl. Il n’existe donc aucun moyen de savoir pendant combien de temps les métadonnées obsolètes restent actives. En pratique, le changement de configuration est immédiatement pris en compte après l’exécution de la commande. Toutefois, dans certains cas de forte charge, l’état incohérent peut être prolongé, ce qui peut entraîner des situations contre-intuitives pour les utilisateurs et les développeurs. Une solution de contournement est nécessaire, comme this .
Des permissions incohérentes sont dangereuses pour les requêtes linéarisées
Un état d’authentification incohérent est particulièrement critique pour les écritures. Même si un opérateur désactive les écritures pour un utilisateur, si l’écriture n’est ordonnée qu’au regard du magasin clé-valeur et non du système d’authentification, il est possible que l’écriture aboutisse avec succès. Sans ordonnancement simultané sur le magasin d’authentification et le magasin clé-valeur, le système sera vulnérable aux attaques par permission obsolète.
Par conséquent, la logique de vérification des autorisations doit être ajoutée à la machine d’état d’etcd. Chaque machine d’état doit vérifier les requêtes en fonction de ses informations d’autorisation lors de l’étape apply (de sorte que les informations d’authentification ne soient pas périmées).
Conception et mise en œuvre
Authentification
Au départ, un client doit établir une connexion gRPC uniquement pour authentifier son identifiant utilisateur et son mot de passe. Un serveur etcd répondra par une réponse d’authentification. Cette réponse sera un jeton d’authentification en cas de succès, ou une erreur en cas d’échec. Le client peut utiliser son jeton d’authentification pour présenter ses identifiants à etcd lors de requêtes API.
La connexion cliente utilisée pour demander le jeton d’authentification est généralement abandonnée ; elle ne peut pas transporter les informations d’authentification du nouveau jeton. Cela est dû au fait que gRPC ne permet pas d’ajouter des informations d’authentification par appel RPC après la création de la connexion (appel à grpc.Dial()). Par conséquent, un client ne peut pas attribuer un jeton à sa connexion s’il l’obtient via cette connexion. Le client doit établir une nouvelle connexion pour utiliser le jeton.
Notes sur l’implémentation de l’appel RPC Authenticate()
Authenticate() génère un jeton d’authentification à partir d’un nom d’utilisateur et d’un mot de passe fournis. etcd enregistre et vérifie un mot de passe configuré et un mot de passe fourni à l’aide du package bcrypt de Go. Par conception, le mécanisme de vérification des mots de passe de bcrypt est coûteux en termes de calcul, nécessitant près de 100 ms sur un serveur x64 ordinaire. Par conséquent, effectuer cette vérification dans la phase apply de la machine d’état entraînerait des problèmes de performance : le cluster etcd ne pourrait servir qu’approximativement 10 Authenticate() requêtes par seconde.
Pour des performances optimales, le mécanisme d’authentification v3 vérifie les mots de passe au niveau de l’API etcd, où cette vérification peut être parallélisée en dehors de raft. Toutefois, cela peut entraîner des failles potentielles de permission time-of-check/time-of-use (TOCTOU) :
- le client A envoie une requête
Authenticate() - le niveau de l’API traite la partie de vérification du mot de passe de
Authenticate() - un autre client B envoie une requête de
ChangePassword()et le serveur la traite - le niveau de la machine d’état traite la partie obtenir un numéro de révision pour le
Authenticate()provenant de A - le serveur retourne un succès au client A
- le client A est désormais authentifié avec un mot de passe obsolète
Pour éviter une telle situation, la couche API effectue une vérification du numéro de version basée sur le numéro de révision du magasin d’authentification. Lors de la vérification du mot de passe, la couche API enregistre le numéro de révision du magasin d’authentification. Après une vérification réussie du mot de passe, la couche API compare le numéro de révision enregistré avec le numéro de révision le plus récent. Si les numéros diffèrent, cela signifie qu’un autre utilisateur a mis à jour les métadonnées d’authentification. Dans ce cas, elle réessaie la vérification. Grâce à ce mécanisme, la vérification réussie du mot de passe basée sur un mot de passe obsolète peut être évitée.
Résolution d’un jeton au niveau de l’API
Après s’être authentifié avec Authenticate(), un client peut établir une connexion gRPC comme il le ferait sans authentification. En plus du processus d’initialisation existant, le client doit associer le jeton à la connexion nouvellement créée. grpc.WithPerRPCCredentials() fournit la fonctionnalité nécessaire à cette opération.
Chaque requête authentifiée provenant du client dispose d’un jeton. Ce jeton peut être obtenu avec grpc.metadata.FromIncomingContext() côté serveur. Le serveur peut déterminer qui émet la requête et à quel moment l’utilisateur a été autorisé. Ces informations seront renseignées par la couche API dans l’en-tête (etcdserverpb.RequestHeader.Username et etcdserverpb.RequestHeader.AuthRevision) d’une entrée de journal Raft (etcdserverpb.InternalRaftRequest).
Vérification de la permission dans la machine à états
Les informations d’authentification dans etcdserverpb.RequestHeader sont vérifiées lors de l’étape d’application de la machine à états. Cette étape vérifie que l’utilisateur dispose des autorisations nécessaires pour accéder aux clés demandées, selon la dernière révision du magasin d’authentification.
Deux types de jetons : simples et JWT
Il existe deux types de jetons : simples et JWT. Le jeton simple n’est pas conçu pour les cas d’utilisation en production. Ses jetons ne sont pas signés cryptographiquement, et les serveurs doivent suivre de manière étatique la correspondance entre jetons et utilisateurs ; il est destiné à des tests en développement. Les jetons JWT doivent être utilisés pour les déploiements en production, car ils sont signés et vérifiés cryptographiquement. Du point de vue de l’implémentation, le JWT est sans état. Son jeton peut inclure des métadonnées, notamment le nom d’utilisateur et la révision, de sorte que les serveurs n’aient pas à mémoriser la correspondance entre les jetons et les métadonnées.
Un problème connu#18437 concerne les jetons simples. Dans les serveurs etcd, les jetons sont résolus au niveau de l’API et les jetons simples sont étatiques. Ce processus n’est pas protégé par une vérification linéarisable, ce qui signifie qu’un membre etcd peut ne pas avoir terminé le traitement d’une requête d’authentification précédente avant de recevoir la suivante. Dans de tels cas, le membre peut renvoyer une erreur « jeton d’authentification invalide » au client. Ce problème est généralement rare sur un nœud disposant de conditions réseau favorables, mais peut survenir en cas de latence importante. En tant que contournement, les applications peuvent implémenter un mécanisme de nouvelle tentative pour gérer cette erreur.
Définition directe des jetons JWT
En plus du flux RPC standard Authenticate(), etcd prend en charge la définition de jetons JWT directement au niveau du client. Cela permet aux applications de gérer l’intégralité du cycle de vie des jetons JWT en dehors d’etcd, y compris la génération, la validation et le renouvellement.
Cas d’utilisation et flux de travail
Cette approche est utile lorsque :
- Un système de gestion des jetons indépendant (en dehors d’etcd) gère la génération et le cycle de vie des jetons JWT
- Les applications reçoivent des jetons JWT pré-signés via un mécanisme externe (par exemple, des variables d’environnement, un service de configuration)
- Le cycle de vie des jetons doit être géré entièrement par l’application cliente et non par la génération automatique de jetons d’etcd
Le flux de travail typique est :
- Une autorité externe (non etcd) génère un jeton JWT signé qui inclut le nom d’utilisateur et d’autres revendications
- L’application reçoit le jeton pré-signé et configure le client etcd avec celui-ci
- Le client soumet le jeton JWT directement avec les requêtes (sans appeler
Authenticate()) - Le serveur etcd valide la signature du jeton à l’aide de sa clé publique configurée et accorde l’accès en fonction du nom d’utilisateur contenu dans le jeton
- Avant l’expiration du jeton, l’application obtient un nouveau jeton auprès de l’autorité externe
- L’application crée un nouveau client avec le jeton mis à jour (la mise à jour du jeton nécessite la recréation du client)
Comment il diffère de l’authentification standard
Lors de l’utilisation du flux standard Authenticate() :
- Le client appelle
Authenticate()avec le nom d’utilisateur et le mot de passe - etcd génère et renvoie un jeton
- Le client utilise automatiquement ce jeton pour les requêtes ultérieures
- La mise à jour du jeton nécessite d’appeler à nouveau
Authenticate()
Lorsque les jetons JWT sont définis directement :
- Le client est initialisé avec un jeton JWT pré-signé
- Le client ne fait pas appel à
Authenticate() - Le jeton est utilisé directement dans toutes les requêtes
- L’application cliente est responsable d’obtenir de nouveaux jetons avant l’expiration et de gérer le cycle de vie du client
AuthStatus sans jeton valide
Pour prendre en charge les applications qui gèrent elles-mêmes leurs jetons JWT, l’API RPC AuthStatus a été conçue afin de permettre aux clients de déterminer si l’authentification est activée et de récupérer la révision actuelle de authRevision. Cela est essentiel dans les scénarios de récupération où un jeton a expiré et où le client a besoin de la dernière révision afin d’obtenir un nouveau jeton valide auprès de son fournisseur externe de jetons.
Sans cette fonctionnalité, un jeton expiré pourrait empêcher un client d’accéder au authRevision actuel, entraînant un blocage dans lequel aucun nouveau jeton ne peut être généré.
Remarques sur la différence entre les modèles KVS et les modèles de système de fichiers
etcd v3 est un système de stockage clé-valeur (KVS), et non un système de fichiers. Les autorisations peuvent donc être attribuées aux utilisateurs sous la forme d’un nom de clé exact ou d’une plage de clés, comme ["start key", "end key"). Cela signifie qu’il est possible d’accorder des autorisations pour une clé inexistante. Les utilisateurs doivent veiller à ne pas accorder involontairement des autorisations. Dans un système similaire à un système de fichiers (par exemple Chubby ou ZooKeeper), une structure de données analogue à un inode peut contenir les informations d’autorisation. Il n’est alors pas possible d’accorder une autorisation à une clé inexistante (à l’exception du cas des bits sticky).
Le modèle etcd v3 nécessite plusieurs recherches de métadonnées, contrairement aux systèmes de fichiers. Le coût maximal de recherche correspond à la somme des clés et intervalles accordés par l’utilisateur. Ce coût ne peut être évité, car l’espace de clés plat du v3 diffère entièrement du modèle de système de fichiers Unix (où chaque inode inclut des métadonnées de permissions). En pratique, ce coût ne pose pas de problème sérieux, car les métadonnées sont suffisamment petites pour bénéficier du cache.
5 - etcd API
Ce document a pour objectif de présenter une vue d’ensemble des principes fondamentaux de l’API v3 d’etcd. Il ne doit pas être confondu avec l’API etcd v2, dépréciée à partir d’etcd v3.5. Il ne prétend pas être exhaustif, mais vise à se concentrer sur les idées de base nécessaires à la compréhension d’etcd, sans les distractions des appels d’API moins courants. Toutes les API etcd sont définies dans des services gRPC , qui catégorisent les appels de procédure distante (RPC) compris par le serveur etcd. Une liste complète de toutes les RPC etcd est documentée au format markdown dans le listing des API gRPC .
Services gRPC
Chaque requête d’API envoyée à un serveur etcd est un appel de procédure à distance gRPC. Les appels RPC dans etcd sont catégorisés selon leur fonctionnalité en services.
Les services importants pour la gestion de l’espace clé de etcd incluent :
- KV - Crée, met à jour, récupère et supprime des paires clé-valeur.
- Watch - Surveille les modifications apportées aux clés.
- Lease - Primitives pour consommer les messages de maintien de connexion client.
Les services qui gèrent le cluster lui-même incluent :
- Auth - Mécanisme d’authentification basée sur les rôles pour authentifier les utilisateurs.
- Cluster - Fournit des informations sur les membres et des fonctionnalités de configuration.
- Maintenance - Prend des instantanés de récupération, défait les fragments du magasin et retourne des informations d’état par membre.
Requêtes et réponses
Toutes les requêtes RPC dans etcd suivent le même format. Chaque RPC dispose d’une fonction Name qui prend NameRequest en argument et renvoie NameResponse en réponse. Par exemple, voici la description de la requête RPC Range :
En-tête de réponse
Toutes les réponses de l’API etcd incluent un en-tête de réponse qui contient des métadonnées du cluster pour la réponse :
- Cluster_ID - l’identifiant du cluster générant la réponse.
- Member_ID - l’identifiant du membre générant la réponse.
- Revision - la révision du magasin clé-valeur lors de la génération de la réponse.
- Raft_Term - le terme Raft du membre lors de la génération de la réponse.
Une application peut lire le champ Cluster_ID ou Member_ID pour s’assurer qu’elle communique avec le cluster (membre) prévu.
Les applications peuvent utiliser le champ Revision pour connaître la dernière révision du magasin clé-valeur. Cela est particulièrement utile lorsque les applications spécifient une révision historique afin d’effectuer une time travel query et souhaitent connaître la dernière révision au moment de la requête.
Les applications peuvent utiliser Raft_Term pour détecter quand le cluster termine une nouvelle élection de leader.
API clé-valeur
L’API Clé-Valeur manipule des paires clé-valeur stockées dans etcd. La majorité des requêtes adressées à etcd sont généralement des requêtes clé-valeur.
Primitives système
Paire clé-valeur
Une paire clé-valeur est l’unité minimale manipulable par l’API clé-valeur. Chaque paire clé-valeur possède un certain nombre de champs, définis au format protobuf :
- Clé - clé sous forme d’octets. Une clé vide n’est pas autorisée.
- Valeur - valeur sous forme d’octets.
- Version - version de la clé. Une suppression réinitialise la version à zéro, et toute modification de la clé augmente sa version.
- Révision_Création - révision de la dernière création sur la clé.
- Révision_Modification - révision de la dernière modification sur la clé.
- Bail - identifiant du bail attaché à la clé. Si le bail est égal à zéro, aucun bail n’est attaché à la clé.
En plus de la clé et de sa valeur, etcd attache des métadonnées de révision supplémentaires au message de clé. Ces informations de révision ordonnent les clés selon leur date de création et de modification, ce qui est utile pour gérer la concurrence dans la synchronisation distribuée. Les verrous partagés distribués du client etcd verrous partagés distribués utilisent la révision de création pour attendre la possession du verrou. De même, la révision de modification est utilisée pour détecter les conflits sur l’ensemble de lecture du mémoire transactionnelle logicielle et attendre les mises à jour du élection du leader .
Révisions
etcd maintient un compteur 64 bits valable pour l’ensemble du cluster, appelé révision du magasin, qui est incrémenté à chaque modification de l’espace clé. La révision sert d’horloge logique globale, ordonnant séquentiellement toutes les mises à jour du magasin. Le changement représenté par une nouvelle révision est incrémental ; les données associées à une révision sont celles qui ont modifié le magasin. En interne, une nouvelle révision signifie écrire les modifications dans l’arbre B+ du backend, indexées par la révision incrémentée.
Les révisions prennent davantage de valeur lorsqu’on considère le backend contrôle de concurrence à plusieurs versions d’etcd. Le modèle MVCC signifie que le magasin clé-valeur peut être consulté à partir de révisions passées, car les anciennes versions des clés sont conservées. La politique de conservation de cet historique peut être configurée par les administrateurs du cluster afin de gérer finement le stockage ; en général, etcd supprime les anciennes révisions des clés selon un horaire. Un cluster etcd typique conserve les données obsolètes des clés pendant plusieurs heures. Cela permet également une gestion fiable des déconnexions longues des clients, et non seulement des perturbations réseau transitoires : les observateurs reprennent simplement à partir de la dernière révision historique observée. De même, pour lire dans le magasin à un instant précis, les requêtes de lecture peuvent être étiquetées avec une révision afin de retourner les clés selon une vue de l’espace des clés au moment où cette révision a été validée.
Plages de clés
Le modèle de données etcd indexe toutes les clés dans un espace binaire plat. Cela diffère des autres systèmes de magasin clé-valeur qui organisent les clés selon une structure hiérarchique en répertoires. Au lieu de lister les clés par répertoire, les clés sont listées par intervalles de clés [a, b).
Ces intervalles sont souvent appelés « plages » dans etcd. Les opérations sur les plages sont plus puissantes que les opérations sur les répertoires. Comme un magasin hiérarchique, les plages permettent les recherches par clé unique via [a, a+1) (par exemple, [‘a’, ‘a\x00’) recherche ‘a’) et les recherches par répertoire en codant les clés selon leur profondeur dans l’arborescence. En plus de ces opérations, les plages peuvent également encoder des préfixes ; par exemple, la plage ['a', 'b') recherche toutes les clés dont le préfixe est la chaîne ‘a’.
Par convention, les plages pour une requête sont indiquées par les champs key et range_end. Le champ key est la première clé de la plage et doit être non vide. Le champ range_end est la clé suivant la dernière clé de la plage. Si range_end n’est pas fourni ou est vide, la plage est définie comme ne contenant que la clé fournie. Si range_end est égal à key plus un (par exemple, “aa”+1 == “ab”, “a\xff”+1 == “b”), alors la plage représente toutes les clés ayant pour préfixe la clé. Si les deux champs key et range_end sont égaux à ‘\0’, la plage représente toutes les clés. Si range_end est égal à ‘\0’, la plage correspond à toutes les clés supérieures ou égales à la clé fournie.
Plage
Les clés sont récupérées depuis le magasin clé-valeur à l’aide de l’appel d’API Range, qui prend un RangeRequest :
- Clé, PlageFin - Plage de clés à récupérer.
- Limite - nombre maximal de clés retournées pour la requête. Si la limite est définie à 0, elle est traitée comme sans limite.
- Révision - instantané du magasin clé-valeur à utiliser pour la plage. Si la révision est inférieure ou égale à zéro, la plage concerne le dernier magasin clé-valeur. Si la révision est compactée, la réponse renvoie ErrCompacted.
- OrdreTri - ordre de tri pour les requêtes triées.
- CibleTri - champ du magasin clé-valeur à trier.
- Sérialisable - active les lectures locales sérialisables pour la requête de plage. Par défaut, Range est linéarisable ; elle reflète le consensus actuel du cluster. Pour de meilleures performances et disponibilité, au prix de lectures potentiellement obsolètes, une requête de plage sérialisable est servie localement sans nécessiter de consensus avec les autres nœuds du cluster.
- ClésUniquement - ne retourne que les clés, et non les valeurs.
- ComptageUniquement - ne retourne que le nombre de clés dans la plage.
- MinRévisionMod - borne inférieure des révisions de modification des clés ; filtre les révisions inférieures.
- MaxRévisionMod - borne supérieure des révisions de modification des clés ; filtre les révisions supérieures.
- MinRévisionCréation - borne inférieure des révisions de création des clés ; filtre les révisions inférieures.
- MaxRévisionCréation - borne supérieure des révisions de création des clés ; filtre les révisions supérieures.
Le client reçoit un message RangeResponse de l’appel Range :
- Kvs - la liste des paires clé-valeur correspondant à la requête de plage. Lorsque
Count_Onlyest défini,Kvsest vide. - More - indique s’il reste des clés à renvoyer dans la plage demandée si
limitest défini. - Count - le nombre total de clés satisfaisant la requête de plage.
Pour les plages de clés importantes où le tamponnage de la réponse complète est indésirable, consultez RangeStream .
RangeStream
RangeStream retourne le même jeu de résultats que Range, mais le serveur fractionne la réponse en une séquence de morceaux et la diffuse au client. Cela évite de stocker entièrement de grandes plages en mémoire côté serveur ou côté client. RangeStream accepte les mêmes RangeRequest que Range.
Le client reçoit un flux de messages RangeStreamResponse à partir de l’appel RangeStream :
Remplissage des champs par tranches :
- Kvs - chaque tranche contient une tranche disjointe du résultat. En concaténant les
kvsde chaque tranche dans l’ordre de leur arrivée, on obtient le même ensemble de clés qu’une unique requêteRange. - Header, More, Count - renseignés uniquement dans la dernière tranche, et uniquement lorsque le flux se termine sans erreur. Les tranches précédentes laissent ces champs à zéro. Appliquer
proto.Mergesur lerange_responsede chaque tranche donne unRangeResponseéquivalent à ce queRangeaurait retourné.
Si le flux se termine avec une erreur, aucun morceau ne contient de header, more ou count valide.
Chaque morceau du flux est servi en référence à la même révision. Si la requête ne définit pas Revision, le serveur capture la dernière révision validée au moment du démarrage du flux et la réutilise pour le reste du flux.
RangeStream ne prend pas en charge les ordres de tri personnalisés ni les filtres de révision (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Les requêtes utilisant l’un ou l’autre retournent Unimplemented. RangeStream n’est également pas pris en charge par le proxy gRPC etcd.
Il existe deux méthodes courantes pour consommer un RangeStream :
- Traitez chaque tranche indépendamment. Adapté aux scénarios à haute performance où le client souhaite décoder et agir sur les clés au fur et à mesure de leur arrivée, plutôt que de collecter l’ensemble du résultat d’abord. Le client itère les tranches et traite
kvsde chacune, puis litheader,moreoucountde la dernière tranche après la fin propre du flux. - Assemblez une seule réponse. Adapté lorsque le client souhaite obtenir un résultat équivalent à une requête unaire
Range. Le client fusionne chaquerange_responsede tranche en un seulRangeResponse(par exemple, à l’aide deproto.Merge). Le résultat fusionné contient l’intégralité dekvs, ainsi queheader,moreetcountprovenant de la dernière tranche. Le client Go fournitclientv3.GetStreamToGetResponsecomme aide pour ce schéma.
Mettre
Les clés sont stockées dans le magasin clé-valeur en émettant un appel à Put, qui prend un PutRequest :
- Clé - le nom de la clé à insérer dans le magasin clé-valeur.
- Valeur - la valeur, en octets, à associer à la clé dans le magasin clé-valeur.
- Bail - l’identifiant de bail à associer à la clé dans le magasin clé-valeur. Une valeur de bail égale à 0 indique l’absence de bail.
- Préc_Kv - lorsque défini, renvoie les données de la paire clé-valeur précédente à la mise à jour effectuée par cette
Putrequête. - Ignorer_Valeur - lorsque défini, met à jour la clé sans modifier sa valeur actuelle. Retourne une erreur si la clé n’existe pas.
- Ignorer_Bail - lorsque défini, met à jour la clé sans modifier son bail actuel. Retourne une erreur si la clé n’existe pas.
Le client reçoit un message PutResponse de l’appel Put :
- Prev_Kv - la paire clé-valeur écrasée par
Put, siPrev_Kva été défini dansPutRequest.
Supprimer une plage
Les plages de clés sont supprimées à l’aide de l’appel DeleteRange, qui prend un DeleteRangeRequest :
- Clé, PlageFin — Plage de clés à supprimer.
- ValeurPrécédente — si définie, retourne le contenu des paires clé-valeur supprimées.
Le client reçoit un message DeleteRangeResponse de l’appel DeleteRange :
- Supprimé - nombre de clés supprimées.
- Prev_Kv - liste de toutes les paires clé-valeur supprimées par l’opération
DeleteRange.
Transaction
Une transaction est une construction atomique If/Then/Else sur le magasin clé-valeur. Elle fournit une primitive pour regrouper des requêtes dans des blocs atomiques (c’est-à-dire then/else), dont l’exécution est protégée (c’est-à-dire if) en fonction du contenu du magasin clé-valeur. Les transactions peuvent être utilisées pour protéger les clés contre des mises à jour concurrentes non désirées, pour mettre en œuvre des opérations compare-and-swap, et pour développer des contrôles de concurrence de niveau supérieur.
Une transaction peut traiter atomiquement plusieurs requêtes en une seule requête. Pour les modifications du magasin clé-valeur, cela signifie que la révision du magasin n’est incrémentée qu’une seule fois pour la transaction, et que tous les événements générés par la transaction auront la même révision. Toutefois, les modifications apportées à la même clé plusieurs fois au sein d’une même transaction sont interdites.
Toutes les transactions sont protégées par une conjonction de comparaisons, similaire à une instruction If. Chaque comparaison vérifie une seule clé dans le magasin. Elle peut vérifier l’absence ou la présence d’une valeur, la comparer à une valeur donnée, ou vérifier la révision ou la version d’une clé. Deux comparaisons différentes peuvent s’appliquer à la même clé ou à des clés différentes. Toutes les comparaisons sont appliquées de manière atomique ; si toutes les comparaisons sont vraies, la transaction est considérée comme réussie et etcd applique le bloc de requête then / success, sinon elle est considérée comme échouée et applique le bloc de requête else / failure.
Chaque comparaison est encodée sous la forme d’un message Compare :
- Résultat - le type d’opération de comparaison logique (par exemple, égal, inférieur à, etc.).
- Cible - le champ clé-valeur à comparer. Soit la version de la clé, la révision de création, la révision de modification ou la valeur.
- Clé - la clé pour la comparaison.
- Cible_Union - les données spécifiées par l’utilisateur pour la comparaison.
Après le traitement du bloc de comparaison, la transaction applique un bloc de requêtes. Un bloc est une liste de messages RequestOp :
- Request_Range - une
RangeRequest. - Request_Put - une
PutRequest. Les clés doivent être uniques. Elle ne peut pas partager de clés avec d’autres opérations Put ou Delete. - Request_Delete_Range - une
DeleteRangeRequest. Elle ne peut pas partager de clés avec des requêtes Put ou Delete.
Ensemble, une transaction est émise par un appel API Txn, qui prend un TxnRequest :
- Compare - Une liste de prédicats représentant une conjonction de termes servant à protéger la transaction.
- Success - Une liste de requêtes à traiter si toutes les évaluations des tests Compare retournent true.
- Failure - Une liste de requêtes à traiter si l’une quelconque des évaluations des tests Compare retourne false.
Le client reçoit un message TxnResponse de l’appel Txn :
- Réussi - Indique si
Comparea été évalué à true ou false. - Réponses - Liste des réponses correspondant aux résultats de l’application du bloc
Successsi réussi est true, ou du blocFailuresi réussi est false.
La liste Responses correspond aux résultats de la liste RequestOp appliquée, chaque réponse étant encodée sous la forme d’un ResponseOp :
Le ResponseHeader inclus dans chaque réponse interne ne doit en aucun cas être interprété.
Si les clients doivent obtenir la dernière révision, ils doivent toujours vérifier le ResponseHeader au niveau supérieur dans TxnResponse.
API de surveillance
L’API Watch fournit une interface basée sur des événements pour surveiller de manière asynchrone les modifications apportées aux clés. Une surveillance etcd attend les modifications apportées aux clés en surveillant continuellement à partir d’une révision donnée, actuelle ou historique, et diffuse les mises à jour des clés vers le client.
Événements
Chaque modification de chaque clé est représentée par des messages Event. Un message Event fournit à la fois les données de la mise à jour et le type de mise à jour :
- Type - Le type d’événement. Un type PUT indique que de nouvelles données ont été stockées pour la clé. Un type DELETE indique que la clé a été supprimée.
- KV - La paire clé-valeur associée à l’événement. Un événement PUT contient la paire clé-valeur actuelle. Un événement PUT avec kv.Version=1 indique la création d’une clé. Un événement DELETE contient la clé supprimée, dont la révision de modification est définie sur la révision de la suppression.
- Prev_KV - La paire clé-valeur de la clé à la révision immédiatement antérieure à l’événement. Pour économiser la bande passante, cette information n’est renseignée que si la surveillance a explicitement activé cette fonctionnalité.
Surveillance des flux
Les surveillance sont des requêtes à exécution longue et utilisent des flux gRPC pour transmettre les données d’événements. Un flux de surveillance est bidirectionnel : le client écrit dans le flux pour établir des surveillance et lit pour recevoir les événements de surveillance. Un seul flux de surveillance peut multiplexer plusieurs surveillance distinctes en étiquetant les événements avec des identifiants propres à chaque surveillance. Cette multiplexion permet de réduire la charge mémoire et le surcroît de connexion sur le cluster central etcd.
Pour en savoir plus sur les garanties relatives aux événements de surveillance, veuillez consulter garanties de l’API etcd .
Un client crée une surveillance en envoyant un WatchCreateRequest sur un flux renvoyé par Watch :
- Clé, PlageFin - La plage de clés à surveiller.
- RévisionDébut - Une révision facultative à partir de laquelle commencer la surveillance de manière inclusive. Si elle n’est pas fournie, la diffusion en continu des événements suit la révision indiquée dans l’en-tête de réponse de création de surveillance. L’historique complet des événements peut être surveillé à partir de la dernière révision de compactage.
- NotificationProgression - Lorsqu’elle est définie, la surveillance reçoit périodiquement une réponse de surveillance sans événements, si aucun événement récent n’est disponible. Cela est utile lorsque les clients souhaitent récupérer un observateur déconnecté à partir d’une révision connue récente. Le serveur etcd détermine la fréquence d’envoi des notifications en fonction de la charge actuelle du serveur.
- Filtres - Liste des types d’événements à filtrer côté serveur.
- ValeurPrécédente - Lorsqu’elle est définie, la surveillance reçoit les données clé-valeur antérieures à l’événement. Cela est utile pour connaître les données qui ont été écrasées.
En réponse à un WatchCreateRequest ou si un nouvel événement est détecté pour une surveillance déjà établie, le client reçoit un WatchResponse :
- Watch_ID - l’identifiant de la surveillance correspondant à la réponse.
- Créé - défini à true si la réponse correspond à une requête de création de surveillance. Le client doit stocker l’identifiant et s’attendre à recevoir des événements pour cette surveillance sur le flux. Tous les événements envoyés à l’observateur créé auront le même watch_id.
- Annulé - défini à true si la réponse correspond à une requête d’annulation de surveillance. Aucun événement supplémentaire ne sera envoyé à l’observateur annulé.
- Révision_Compactée - défini à la révision historique minimale disponible dans etcd si un observateur tente de surveiller à une révision compactée. Cela se produit lorsqu’un observateur est créé à une révision compactée ou lorsque l’observateur ne parvient pas à suivre l’évolution du magasin clé-valeur. L’observateur sera annulé ; la création de nouvelles surveillances avec la même start_revision échouera.
- Événements - une liste d’événements nouveaux, dans l’ordre, correspondant à l’identifiant de surveillance donné.
Si le client souhaite cesser de recevoir des événements pour une surveillance, il émet un WatchCancelRequest :
- Watch_ID - l’ID de la surveillance à annuler afin qu’aucun événement supplémentaire ne soit transmis.
API bail
Les bails sont un mécanisme de détection de la disponibilité des clients. Le cluster accorde des bails avec une durée de vie. Un bail expire si le cluster etcd ne reçoit pas de keepAlive dans le délai TTL imparti.
Pour lier les bails au magasin clé-valeur, chaque clé peut être associée à au plus un bail. Lorsqu’un bail expire ou est révoqué, toutes les clés associées à ce bail sont supprimées. Chaque clé supprimée génère un événement de suppression dans l’historique des événements.
Obtention des bails
Les bails sont obtenus via l’appel d’API LeaseGrant, qui prend un LeaseGrantRequest :
- TTL - le délai d’expiration conseillé, en secondes.
- ID - l’identifiant demandé pour le bail. Si l’ID est défini à 0, etcd choisira un identifiant.
Le client reçoit un LeaseGrantResponse de l’appel LeaseGrant :
- ID - l’identifiant du bail pour le bail accordé.
- TTL - est le délai d’expiration, en secondes, sélectionné par le serveur pour le bail.
- ID - l’identifiant du bail à révoquer. Lorsque le bail est révoqué, toutes les clés associées sont supprimées.
Keep alives
Les bails sont actualisés à l’aide d’un flux bidirectionnel créé à l’aide de l’appel d’API LeaseKeepAlive. Lorsque le client souhaite actualiser un bail, il envoie un LeaseKeepAliveRequest sur le flux :
- ID - l’identifiant du bail dont il faut maintenir la validité.
Le flux de maintien de connexion répond avec un LeaseKeepAliveResponse :
- ID - le bail qui a été actualisé avec un nouveau délai de validité.
- TTL - le nouveau délai de validité, en secondes, restant pour le bail.
6 - etcd fichiers de stockage persistant
Ce document explique le format de stockage persistant d’etcd : nomenclature, contenu et outils permettant aux développeurs d’en inspecter le contenu. À l’avenir, ce document devrait être mis à jour pour refléter les évolutions du modèle de stockage. Il s’adresse aux développeurs d’etcd afin de les aider dans leurs besoins de récupération de données.
Prérequis
Les articles suivants fournissent des informations de fond utiles pour ce document :
- Vue d’ensemble du modèle de données etcd
- Vue d’ensemble de Raft (notamment la section « 5.3 Réplication des journaux »).
Aperçu
Fichiers en attente prolongée
| Nom de fichier | Objectif général |
|---|---|
./member/snap/db | bbolt b+tree qui stocke toutes les données appliquées, les informations d'autorisation d'appartenance et les métadonnées. Il est au courant de l'index du dernier journal WAL appliqué ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | Instantanés périodiques de l’ancien magasin v2, contenant :
À compter de etcd v3, le contenu est redondant par rapport au contenu des fichiers /snap/db. Périodiquement (30s), ces fichiers sont supprimés, et les derniers |
/member/snap/000000000007a178.snap.db | Un instantané bbolt téléchargé depuis le leader etcd si la réplica était trop en retard. Possède le même type de contenu que le fichier ( Le fichier est utilisé dans deux scénarios :
Le fichier n'est pas supprimé une fois la récupération terminée (le contenu entier est donc copié dans le fichier ./member/snap/db). Périodiquement (30s), les fichiers sont purgés.
Ici aussi, |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Journaux d'écriture de Raft, contenant les transactions récentes acceptées par Raft, ainsi que des instantanés périodiques ou des enregistrements CRC. Les fichiers récents Si les instantanés sont trop espacés, il peut y avoir plus de |
./member/wal/0.tmp (or .../1.tmp) | Espace préalloué pour le prochain fichier de journalisation d'avance. Utilisé pour éviter que Raft ne reste bloqué en raison d'un manque de capacité des journaux WAL, sans possibilité de déclencher une alarme. |
Fichiers temporaires
Pendant le traitement interne d’etcd, il est possible de rencontrer plusieurs fichiers à durée de vie courte :
| Fichier | Objectif général |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | Les fichiers d'instantané sont renommés en « broken » lorsqu'ils ne peuvent pas être chargés. L'essai de charger le fichier le plus récent a lieu lorsque etcd est démarré. Ou lors des commandes de sauvegarde/restauration d'etcdctl. |
./member/snap/tmp071677638 (random suffix) | Fichier temporaire (bbolt) créé sur les réplicas en réponse à la demande de snapshot du leader, afin de répondre à la demande du leader de restaurer le stockage à partir de l'instantané fourni. Après une récupération réussie (complète) du contenu, le fichier est renommé en : Voir etcd/issues/12837. Corrigé dans etcd 3.5. |
/member/snap/db.tmp.071677638 (random suffix) | Un fichier temporaire contenant une copie du contenu du backend (/member/snap/db), pendant le processus de défragmentation. Une fois le processus réussi, le fichier est renommé en /member/snap/db, remplaçant ainsi le backend original. Au démarrage du serveur etcd, ces fichiers sontsupprimés. |
bbolt arbre B+ : member/snap/db
Ce fichier contient le contenu principal d’etcd, appliqué à un point spécifique du journal Raft (voir consistent_index ).
Organisation physique
Le stockage bolt est physiquement organisé sous la forme d’un arbre b+tree . Les pages physiques de l’arbre b+ ne sont jamais modifiées in situ[^1]. À la place, leur contenu est copié vers une nouvelle page (récupérée à partir de la liste des pages libres), et la page ancienne est ajoutée à la liste des pages libres dès qu’aucune transaction ouverte ne peut plus y accéder. Grâce à ce processus, une transaction RO ouverte voit un état cohérent de l’historique du stockage. Une transaction RW est exclusive et bloque toutes les autres transactions RW. Les grandes valeurs sont stockées sur plusieurs pages continues. Le processus de récupération de pages combiné à la nécessité d’attribuer des zones contiguës de pages de tailles différentes peut entraîner une fragmentation croissante du stockage bbolt.
Le fichier bbolt ne se réduit jamais automatiquement. Seul le processus de défragmentation permet de réécrire le fichier dans un nouveau fichier disposant d’une certaine réserve de pages libres à la fin et dont la taille a été tronquée.
Organisation logique
Le stockage bbolt est divisé en compartiments. Dans chaque compartiment, des clés (paires byte[]->byte[] valeurs) sont stockées dans l’ordre lexicographique. La liste ci-dessous représente les compartiments utilisés par etcd (à partir de la version 3.5) ainsi que les clés en usage.
| Bucket | Clé | Valeur d'exemple | Description |
|---|---|---|---|
| alarme | rpcpb.Alarm :
{MemberID, Alarme : NONE|NOSPACE|CORRUPT} | nil | Indique que des problèmes ont été diagnostiqués sur l'un des membres. |
| auth | "authRevision" | "" (vide) ou BigEndian.PutUint64 | Tout changement de rôles ou d'utilisateurs incrémente ce champ à la validation de la transaction. La valeur n'est utilisée que pour le verrouillage optimiste durant le processus d'autorisation. |
| authRoles | [roleName] en tant que chaîne | authpb.Role sérialisé | |
| authUsers | [userName] en tant que chaîne | authpb.User sérialisé | |
| cluster | "clusterVersion" | "3.5.0" (chaîne) | mineur version du consensus-agréé de la version de stockage commun. |
| "désinstaller" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | Persiste l'intention configurée par la requête la plus récente : Depuis la version v3.5 | |
| clé | [révisionId] encodée à l'aide de bytesToRev{principal,sous} Les suppressions de paires clé-valeur sont sérialisées avec un « t » à la fin (comme une « sépulture ») | mvccpb.KeyValue protocole encodé (key, create_rev, mod_rev, version, value, lease id) | |
| bail | leasepb.Lease protocole marshalled (ID, TTL, RemainingTTL) | Remarque : LeaseCheckpoint étend uniquement RemainingTTL. Le TTL provient uniquement de l'origine de Grant. Note2 : les TTL sont conservés en secondes (à partir de la valeur « now » non définie). Un serveur pris dans une boucle de redémarrage ne libère pas les baux !!! | |
| membres | [memberId] en hexadécimal sous forme de chaîne : "8e9e05c52164694d" | Chaîne JSON sérialisée du type membre :{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | Informations d'appartenance au cluster convenues. |
| membres_supprimés | [memberId] en hexadécimal sous forme de chaîne : "8e9e05c52164694d" | []byte("removed") | Identifiants de tous les membres supprimés. Utilisé pour vérifier qu'un membre supprimé n'est jamais réajouté sous le même identifiant. Le champ est actuellement (3.4) lu à partir du magasin V2 et jamais à partir de V3. Voir https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64 octets (BigEndian) | Représente le décalage de la dernière entrée WAL appliquée au stockage Bolt DB. |
| "scheduledCompactRev" | bytesToRevencodés {main,sub}. (16 octets) | Utilisé pour réinitialiser le compactage si un incident s'est produit après une demande de compactage. | |
| "finishedCompactRev" | bytesToRevencodés {main,sub}. (16 octets) | Révision à laquelle le magasin a été récemment compacté (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Depuis etcd 3.5 | ||
| "term" | Depuis etcd 3.5 | ||
| "version-stockage" |
Outils
bbolt
bbolt dispose d’un outil en ligne de commande permettant d’inspecter le contenu du fichier.
Exemples d’utilisation :
Lister tous les buckets dans le fichier bbolt donné :
Lire une paire clé/valeur particulière :
etcd-dump-db
etcd-dump-db peut être utilisé pour lister le contenu du backend v3 d’etcd (bbolt).
Voir d’autres exemples dans : https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL : journal d’écriture anticipée
Le journal d’écriture anticipée (Write ahead log) est un stockage persistant Raft utilisé pour stocker les propositions. Le leader stocke d’abord la proposition dans son journal, puis la réplique simultanément aux suiveurs à l’aide du protocole Raft. Chaque suiveur persiste la proposition dans son WAL avant de confirmer la réplication au leader.
Le journal WAL utilisé dans etcd diffère du modèle Raft canonique en deux sens :
- Il persiste non seulement les entrées indexées, mais aussi les instantanés Raft (légers) et l’état dur. Ainsi, l’état Raft complet du membre peut être récupéré à partir du journal WAL seul.
- Il est en écriture seule. Les entrées ne sont pas remplacées in situ, mais une entrée ajoutée ultérieurement dans le fichier (avec le même index) remplace la précédente.
Noms de fichiers
Les fichiers de journal WAL sont nommés selon le motif suivant :
Exemple : ./member/wal/0000000000000010-00000000000bf1e6.wal
Ainsi, les noms de fichiers contiennent des chaînes codées en hexadécimal :
- Numéro séquentiel du fichier de journal WAL
- Index de la première entrée ou instantané dans le fichier. En particulier, le premier fichier « 0000000000000000-0000000000000000.wal » contient l’enregistrement initial d’instantané avec l’index=0.
Contenu physique
Le fichier de journal WAL contient une séquence de “Frames ”. Chaque trame contient :
- LittleEndian [^2] entier non signé 64 bits encodé qui contient la longueur de la structure walpb.Record (3).
- Remplissage : un certain nombre d’octets nuls, de manière à ce que la taille totale du cadre soit alignée (modulo 8)
- Données marshallées walpb.Record
:
- type - énumération entière codée déterminant l’interprétation du champ de données ci-dessous
- data - selon le type, généralement une donnée protocole marshallée
- crc - somme de contrôle RC-32 de tous les champs « data » combinés (sans type) dans tous les enregistrements du journal sur cette réplica particulière depuis la création du journal WAL. Veuillez noter que la somme de contrôle prend en compte TOUS les enregistrements (même ceux qui n’ont pas été validés par Raft).
Les fichiers sont « coupés » (un nouveau fichier est créé) lorsque le fichier actuel dépasse 64*10^6 octets.
Contenu logique
Les fichiers de journalisation anticipée dans la couche logique contiennent :
Raftpb.Entry:propositions récentes répliquées par le leader Raft. Certaines de ces propositions sont considérées comme « validées », tandis que d’autres peuvent être logiquement remplacées.Raftpb.HardState(term,commit,vote):information périodique (très fréquente) sur l’index d’une entrée de journal qui est « validée » (répliquée sur la majorité des serveurs), garantissant ainsi qu’elle ne sera pas modifiée ou remplacée, et pouvant être appliquée aux backends (v2, v3). Elle contient également un « terme » (indicateur indiquant s’il y a eu des modifications liées à une élection) et un vote — le membre pour lequel la réplique actuelle a voté durant le terme en cours.walpb.Snapshot(term, index):instantanés périodiques de l’état Raft (aucun contenu de base de données, uniquement l’index du journal d’instantané et le terme Raft)- Le contenu du magasin V2 est stocké dans des fichiers *.store séparés.
- Le contenu du magasin V3 est conservé dans le fichier bbolt, et devient un instantané implicite dès que les entrées y sont appliquées.
- enregistrement de somme de contrôle crc32 (au début de chaque fichier), utilisé pour reprendre le contrôle CRC pour le reste du fichier.
etcdserverpb.Metadata(node_id, cluster_id)- identification du cluster et de la réplica représentés par le journal.
Chaque fichier de journal WAL est construit à partir de (dans l’ordre) :
CRC-32 (valeur CRC calculée sur tous les fichiers précédents, 0 pour le premier fichier).
Cadre de métadonnées (identifiants du cluster et de la réplica)
Uniquement pour le premier fichier WAL :
- Trame d’instantané vide (Index : 0, Terme : 0). L’objectif de cette trame est de maintenir l’invariant selon lequel toutes les entrées sont « précédées » par un instantané.
Pour le fichier WAL non initial (2e+ fichier) :
* Trame HardState.
- Mélange d’entrées, d’états durs et d’enregistrements d’instantané
Le journal WAL peut contenir plusieurs entrées pour l’index identique. Une telle situation peut survenir dans les cas décrits dans la figure 7 du document Raft . Le journal WAL d’etcd est uniquement ajouté, les entrées sont donc remplacées en ajoutant une nouvelle entrée portant le même index.
En particulier lors de la lecture du WAL, la logique remplace les anciennes entrées par les nouvelles . Ainsi, seule la dernière version des entrées dont entry.index <= HardState.commit peut être considérée comme définitive. Les entrées dont l’index est supérieur à HardState.commit sont sujettes à modification.
Les « termes » dans le journal WAL sont censés être monotones.
Les « indexes » dans le journal WAL sont censés :
- démarre à partir d’un instantané
- croît séquentiellement à partir de cet instantané tant qu’il reste dans le même « terme »
- si le terme change, l’index peut diminuer, mais uniquement jusqu’à une nouvelle valeur supérieure à celle de HardState.commit
- un nouvel instantané peut avoir lieu avec un index quelconque supérieur ou égal à HardState.commit, ce qui ouvre une nouvelle séquence pour les index
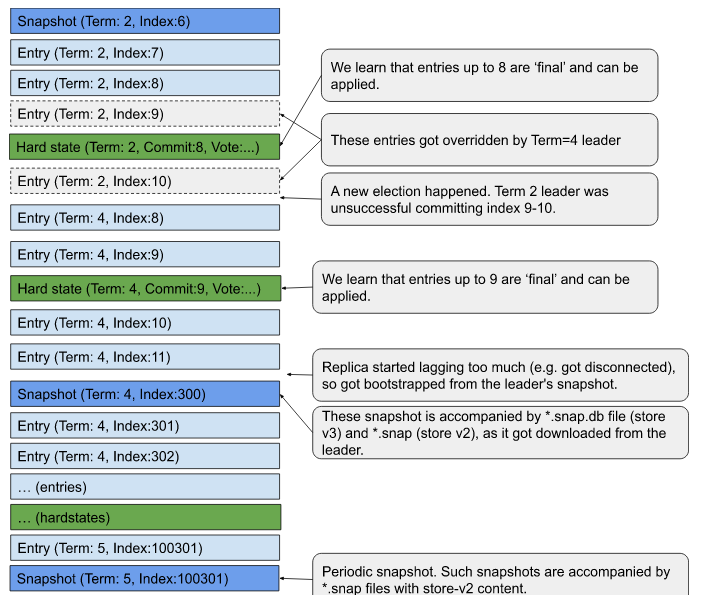
Outils
etcd-dump-logs
Les journaux WAL d’etcd peuvent être lus à l’aide de l’outil etcd-dump-logs :
Prenez note que :
- Outil qui affiche uniquement les entrées, et non toutes les enregistrements WAL (instantanés, HardStates) présents dans les fichiers de journal WAL.
- L’outil applique automatiquement des « substitutions » aux entrées. Si une entrée est remplacée (par une entrée plus récente au même index), l’outil n’affiche que la valeur finale.
- L’outil affiche également les entrées non validées (issues de la fin du LOG), sans information sur HardState.commitIndex, de sorte qu’il n’est pas possible de savoir si les entrées sont définitives ou non.
Instantanés de (Store V2) : membre/snap/{term}-{index}.snap
Noms de fichiers :
membre/snap/{term}-{index}.snap
Les noms de fichiers sont générés ici
("%016x-%016x.snap") et utilisent deux composants encodés en hexadécimal :
- term -> Terme Raft (période entre les élections) au moment de l’émission de l’instantané
- index -> Index de la dernière proposition appliquée au moment de l’émission de l’instantané
Création
Les fichiers *.snap sont créés par la méthode Snapshotter.SaveSnap .
Il existe 2 déclencheurs contrôlant la création de ces fichiers :
- Un nouveau fichier est créé toutes les –snapshotCount= propositions appliquées environ (100'000 par défaut). Cette valeur est approximative : les propositions peuvent arriver par lots, la création d’un instantané n’est envisagée qu’à la fin du lot et le processus est finalement planifié de manière asynchrone. Le nom de l’option (–snapshotCount) est assez trompeur : elle contrôle la différence de valeur d’index entre le dernier index d’instantané et le dernier index de proposition appliquée.
- Raft demande au réplica de restaurer à partir de l’instantané. Pendant qu’un réplica reçoit l’instantané via le message msgSnap, il le sauvegarde également (de manière légère) dans le journal WAL. Cela garantit que dans la queue du journal WAL se trouve toujours un instantané valide suivi d’entrées. Cela supprime ainsi tout risque de discontinuité dans les journaux WAL.
Actuellement, les fichiers sont approximativement [^3] associés 1 à 1 aux journaux WAL. Avec le décommissionnement du store v2, nous prévoyons que les fichiers ne seront plus écrits du tout (optionnel : 3.5.x, obligatoire : 3.6.x).
Contenu
Le fichier contient un proto snapdb.snapshot
(uint32 crc, bytes data) marshallé,
qui se trouve dans le champ ‘data’ et contient Raftpb.Snapshot :
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Enfin, les données imbriquées contiennent un contenu store v2 sérialisé au format JSON.
En particulier, il y a :
- Terme
- Index
- Données d’appartenance :
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Version du stockage : /0/version- > 3.5.0
Outils
protoc
La commande suivante vous permet de visualiser le contenu du fichier lorsqu’elle est exécutée depuis le répertoire racine d’etcd :
De même, vous pouvez extraire le champ ‘data’ et le décoder en tant que ‘Raftpb.Snapshot
'
Exemple de contenu du magasin sérialisé JSON version 2 dans les fichiers *.snap d’etcd 3.4 :
Modifications
Cette section est réservée à la description des modifications apportées aux formats de fichier introduits entre différentes versions d’etcd.
[^1] : Les pages de métadonnées situées au début du fichier bbolt sont modifiées in situ.
[^2] : Incohérent, car la majorité des uint sont écrits en big endian
[^3] : L’instantané initial (index : 0) au début du journal WAL n’est pas associé à un fichier *.snap. Les anciens fichiers *.snap (ou journaux WAL) peuvent être supprimés.
7 - etcd Garanties de l'API
etcd est un magasin clé-valeur cohérent et durable. Le magasin clé-valeur est exposé via des [services gRPC]. etcd garantit les plus fortes garanties de cohérence et de durabilité pour un système distribué. Cette spécification énumère les garanties d’API offertes par etcd.
API à prendre en compte
- APIs KV
- APIs de surveillance
- APIs de bail
- Octroyer
- [Révoquer]
- Maintien de vie
L’API KV permet de lire et de manipuler directement le magasin de paires clé-valeur. L’API surveillance permet de s’abonner aux modifications apportées au magasin de paires clé-valeur. L’API bail permet d’attribuer une durée de vie à une clé.
Les API KV et surveillance permettent d’accéder non seulement aux versions les plus récentes des clés, mais aussi aux versions antérieures, dans une fenêtre continue d’historique limitée par une opération de compactage.
L’appel à l’API KV a un effet immédiat, tandis que l’API Surveillance peut renvoyer avec un délai non borné. Dans un cluster etcd correctement fonctionnel, vous devez vous attendre à ce que les événements de surveillance apparaissent avec un délai de 10 ms après leur occurrence. Toutefois, aucun délai maximal n’est garanti, et les événements dans des clusters défaillants pourraient ne jamais arriver.
API clé-valeur
etcd garantit la durabilité et la sérialisation stricte pour toutes les appels d’API de type clé-valeur. Il s’agit de la garantie d’isolation la plus forte des systèmes de bases de données transactionnelles distribuées.
Durabilité
Toutes les opérations terminées sont durables. Toutes les données accessibles sont également des données durables. Une lecture ne renverra jamais de données qui n’ont pas été rendues durables.
Sérialisation stricte
Les opérations du service KV sont atomiques et s’effectuent dans un ordre total, conforme à l’ordre temporel réel de ces opérations. L’ordre total est implicite grâce à la [révision]. En savoir plus sur la [sérialisation stricte].
Pour les transactions sans transactions imbriquées, l’ordre d’exécution des opérations est garanti identique à celui de sa liste d’opérations, ce qui signifie des réponses GET stables au sein de la transaction. Pour les transactions avec des transactions imbriquées, l’ordre d’exécution n’est pas spécifié.
La sérialisation stricte implique d’autres garanties plus faibles qui pourraient être plus faciles à comprendre :
Atomicité
Toutes les requêtes d’API sont atomiques ; une opération s’effectue entièrement ou pas du tout. Pour les requêtes de surveillance, tous les événements générés par une seule opération figurent dans une seule réponse de surveillance. La surveillance ne peut jamais observer des événements partiels pour une seule opération.
Atomicité
Du point de vue du client, la linéarisation offre des propriétés utiles qui facilitent le raisonnement. Il s’agit d’une description claire extraite du article original
: Linearizability provides the illusion that each operation applied by concurrent processes takes effect instantaneously at some point between its invocation and its response.
Par exemple, considérons un client effectuant une écriture au point de temps 1 (t1). Un client effectuant une lecture à t2 (avec t2 > t1) doit recevoir une valeur au moins aussi récente que l’écriture précédente, terminée à t1. Toutefois, la lecture pourrait ne se terminer qu’à t3. La linéarisation garantit que la lecture retourne la valeur la plus récente. Sans garantie de linéarisation, la valeur retournée, actuelle à t2 au moment où la lecture a commencé, pourrait être « obsolète » à t3, car une écriture concurrente pourrait avoir eu lieu entre t2 et t3.
etcd garantit la linéarité pour toutes les autres opérations par défaut.
La linéarité comporte toutefois un coût, car les requêtes linéarisées doivent passer par le processus de consensus Raft. Pour obtenir des latences plus faibles et un débit plus élevé pour les requêtes en lecture, les clients peuvent configurer le mode de cohérence d’une requête sur serializable, qui peut accéder à des données obsolètes par rapport au quorum, mais élimine la pénalité de performance liée à la dépendance des accès linéarisés au consensus actif.
API de surveillance
Les surveillance garantissent les événements suivants :
- Ordre – les événements sont ordonnés par révision. Un événement ne peut jamais apparaître sur une surveillance s’il précède dans le temps un événement déjà publié. Pour les transactions sans transactions imbriquées, l’ordre des événements générés est garanti identique à celui de la liste des opérations. Pour les transactions avec transactions imbriquées, l’ordre des événements générés n’est pas spécifié.
- Unicité – un événement ne peut jamais apparaître deux fois sur une surveillance.
- Fiabilité – une séquence d’événements ne peut jamais omettre de sous-séquence d’événements dans la fenêtre d’historique disponible. Si des événements sont ordonnés dans le temps comme a < b < c, alors si la surveillance reçoit les événements a et c, elle est garantie de recevoir b tant que b reste dans la fenêtre d’historique disponible.
- Atomicité – une liste d’événements est garantie d’englober des révisions complètes. Les mises à jour effectuées dans la même révision sur plusieurs clés ne seront jamais divisées entre plusieurs listes d’événements.
- Reprise possible – une surveillance interrompue peut être reprise en établissant une nouvelle surveillance à partir de la dernière révision reçue dans un événement de surveillance avant la rupture, à condition que cette révision soit dans la fenêtre d’historique.
- Marquable – les événements de notification de progression garantissent que tous les événements jusqu’à une révision ont déjà été livrés.
etcd ne garantit pas la linéarité pour les opérations de surveillance. Les utilisateurs doivent vérifier la révision des événements de surveillance afin de garantir un ordre correct par rapport aux autres opérations.
API bail
etcd fournit un mécanisme de bail . Le cas d’utilisation principal d’un bail est la mise en œuvre de mécanismes de coordination distribuée, tels que des verrous distribués. Le mécanisme de bail est simple : un bail peut être créé à l’aide de l’API grant, attaché à une clé à l’aide de l’API put, révoqué à l’aide de l’API revoke, et expirera selon le temps de vie (TTL) défini par l’horloge murale. Toutefois, les utilisateurs doivent être conscients de les propriétés importantes des API et de leur utilisation afin d’implémenter correctement des mécanismes de coordination distribuée.
etcd définitions spécifiques
Opération terminée
Une opération etcd est considérée comme terminée lorsqu’elle est validée par consensus, et donc « exécutée » — stockée de manière permanente — par le moteur de stockage etcd. Le client sait qu’une opération est terminée lorsqu’il reçoit une réponse du serveur etcd. Notez que le client peut ignorer l’état d’une opération s’il expiré, ou s’il y a une interruption réseau entre le client et le membre etcd. etcd peut également annuler des opérations lors d’une élection de leader. etcd ne renvoie pas de réponses abort aux requêtes en cours des clients dans cet événement.
révision
Une opération etcd qui modifie le magasin de valeurs associées à des clés est attribuée une révision unique strictement croissante. Une opération transactionnelle peut modifier le magasin de valeurs associées à des clés plusieurs fois, mais une seule révision lui est attribuée. L’attribut révision d’une paire clé-valeur modifiée par l’opération a la même valeur que la révision de l’opération. La révision peut être utilisée comme horloge logique pour le magasin de valeurs associées à des clés. Une paire clé-valeur ayant une révision plus élevée est modifiée après une paire clé-valeur ayant une révision plus faible. Deux paires clé-valeur ayant la même révision sont modifiées par une opération « simultanément ».
8 - etcd par rapport aux autres magasins clé-valeur
Le nom « etcd » provient de deux idées : le dossier unix « /etc » et les systèmes « d »istribués. Le dossier « /etc » est un emplacement destiné au stockage des données de configuration d’un système unique, tandis qu’etcd stocke les informations de configuration pour des systèmes distribués à grande échelle. Ainsi, un « d »istribué « /etc » devient « etcd ».
etcd est conçu comme une base commune pour les systèmes distribués à grande échelle. Il s’agit de systèmes qui ne tolèrent jamais une opération en split-brain et sont prêts à sacrifier la disponibilité pour atteindre cet objectif. etcd stocke les métadonnées de manière cohérente et résistante aux pannes. Un cluster etcd vise à offrir un stockage clé-valeur avec une stabilité, une fiabilité, une évolutivité et des performances de niveau supérieur.
Les systèmes distribués utilisent etcd comme magasin clé-valeur cohérent pour la gestion de configuration, la découverte de services et la coordination de travaux distribués. De nombreuses organisations utilisent etcd pour mettre en œuvre des systèmes de production tels que des planificateurs de conteneurs, des services de découverte de services et des stockages de données distribués. Les modèles distribués courants utilisant etcd incluent l’élection de leader , les verrous distribués et la surveillance de la disponibilité des machines.
Cas d’utilisation
- Container Linux by CoreOS : Les applications exécutées sur Container Linux bénéficient de mises à jour automatiques du noyau Linux, sans interruption de service. Container Linux utilise locksmith pour coordonner les mises à jour. Locksmith implémente un sémaphore distribué sur etcd afin de garantir qu’un sous-ensemble seulement d’un cluster est redémarré à tout moment donné.
- Kubernetes stocke les données de configuration dans etcd pour la découverte de services et la gestion du cluster ; la cohérence d’etcd est essentielle pour planifier correctement et faire fonctionner les services. Le serveur d’API Kubernetes persiste l’état du cluster dans etcd. Il utilise l’API de surveillance d’etcd pour surveiller le cluster et déployer des modifications critiques de configuration.
Tableau comparatif
Peut-être que etcd semble déjà être une solution adaptée, mais comme pour toute décision technologique, agissez avec prudence. Veuillez noter que cette documentation a été rédigée par l’équipe etcd. Bien que l’objectif idéal soit une comparaison impartiale des technologies et fonctionnalités, l’expertise et les biais des auteurs favorisent clairement etcd. Utilisez uniquement selon les indications.
Le tableau ci-dessous constitue une référence rapide pratique pour repérer facilement les différences entre etcd et ses alternatives les plus populaires. Des commentaires et détails supplémentaires pour chaque colonne figurent dans les sections suivant le tableau.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Primitives de concurrence | appels RPC verrou , appels RPC élection , verrous en ligne de commande , élections en ligne de commande , recettes en go | recettes curator externes en Java | API native de verrouillage | Rare , le cas échéant |
| Lectures linéarisables | Oui | Non | Oui | Parfois |
| Contrôle multiversion de concurrence | Oui | Non | Non | Parfois |
| Transactions | Comparaisons de champs, lecture, écriture | Vérifications de version, écriture | Comparaison de champ, verrouillage, lecture, écriture | Style SQL |
| Notification de modifications | Intervalles historiques et actuels de clés | Clés et répertoires actuels | Clés et préfixes actuels | Déclencheurs (parfois) |
| Permissions utilisateur | Basées sur les rôles | ACLs | ACLs | Variables (par table GRANT , par base rôles ) |
| API HTTP/JSON | Oui | Non | Oui | Rarement |
| Réconfiguration du groupe d’hôtes | Oui | >3.5.0 | Oui | Oui |
| Taille maximale de base de données fiable | Plusieurs gigaoctets | Centaines de mégaoctets (parfois plusieurs gigaoctets) | Centaines de mégaoctets | Teraoctets+ |
| Latence minimale de linéarisation en lecture | RTT réseau | Pas de linéarisation en lecture | RTT + fsync | Barrières horaires (atomiques, NTP) |
ZooKeeper
ZooKeeper résout le même problème qu’etcd : la coordination des systèmes distribués et le stockage des métadonnées. Toutefois, etcd bénéficie de l’expérience acquise grâce à l’analyse du design et de l’implémentation de ZooKeeper. Les enseignements tirés de ZooKeeper ont certainement influencé la conception d’etcd, lui permettant de prendre en charge des systèmes à grande échelle comme Kubernetes. Les améliorations apportées par etcd par rapport à ZooKeeper incluent :
- Reconfiguration dynamique de l’appartenance au cluster
- Lecture/écriture stable sous charge élevée
- Modèle de données à contrôle de concurrence multiversion
- Surveillance fiable des clés, sans jamais ignorer silencieusement les événements
- Primitives de bail déconnectant les connexions des sessions
- API pour verrous partagés distribués sûrs
En outre, etcd prend en charge une large gamme de langages et de frameworks directement. Alors que Zookeeper utilise son propre protocole RPC personnalisé, Jute, qui est unique à Zookeeper et limite les liaisons de langages prises en charge
, le protocole client d’etcd est basé sur gRPC
, un cadre RPC populaire offrant des liaisons pour go, C++, Java et bien d’autres. De même, gRPC peut être sérialisé en JSON sur HTTP, si bien que des utilitaires de ligne de commande généraux comme curl peuvent interagir avec lui. Étant donné que les systèmes peuvent choisir parmi diverses options, ils sont construits autour d’etcd avec des outils natifs plutôt qu’autour d’etcd avec un ensemble fixe et unique de technologies.
Lorsqu’il s’agit d’évaluer les fonctionnalités, le support et la stabilité, les nouvelles applications souhaitant utiliser Zookeeper comme magasin de clés cohérent devraient privilégier etcd.
Consul
Consul est un cadre complet de découverte de services. Il propose des vérifications de santé intégrées, une détection de défaillances et des services DNS. En outre, Consul expose un magasin de clés-valeurs via des API HTTP RESTful. Tel qu’il en est dans Consul 1.0 , le système de stockage ne se met pas à l’échelle aussi efficacement que d’autres systèmes comme etcd ou Zookeeper pour les opérations sur les clés-valeurs ; les systèmes nécessitant des millions de clés subiront des latences élevées et une pression mémoire importante. L’API de clés-valeurs manque notamment de fonctionnalités telles que les clés à plusieurs versions, les transactions conditionnelles et les surveillance fiables en continu.
etcd et Consul résolvent des problèmes différents. Si vous recherchez un magasin de clés-valeurs distribué et cohérent, etcd est une meilleure option que Consul. Si vous recherchez une découverte de services complète au sein d’un cluster, etcd ne possède pas suffisamment de fonctionnalités ; optez pour Kubernetes, Consul ou SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
À la fois etcd et les bases de données NewSQL (par exemple, Cockroach , TiDB , Google Spanner ) offrent des garanties fortes de cohérence des données avec une haute disponibilité. Toutefois, les paramètres de conception de système sensiblement différents entraînent des API client et des caractéristiques de performance sensiblement différentes.
Les bases de données NewSQL sont conçues pour s’étendre horizontalement à travers des centres de données. Ces systèmes partitionnent généralement les données entre plusieurs groupes de réplication cohérents (shards), potentiellement distants, et stockent des jeux de données de l’ordre du téraoctet et plus. Ce type d’évolutivité les rend peu adaptés à la coordination distribuée, en raison de latences élevées dues à l’attente des horloges et de la prévision d’updates avec des graphes de dépendances majoritairement localisés. Les données sont organisées en tables, incluant des fonctionnalités de requête de style SQL avec des sémantiques plus riches que celles d’etcd, mais au prix d’une complexité accrue pour le traitement, la planification et l’optimisation des requêtes.
En résumé, choisissez etcd pour stocker des métadonnées ou coordonner des applications distribuées. Si vous devez stocker plusieurs gigaoctets de données ou si des requêtes SQL complètes sont nécessaires, privilégiez une base de données NewSQL.
Utilisation d’etcd pour les métadonnées
etcd réplique toutes les données au sein d’un seul groupe de réplication cohérent. Pour stocker jusqu’à quelques Go de données avec un ordre cohérent, il s’agit de la méthode la plus efficace. Chaque modification de l’état du cluster, qui peut affecter plusieurs clés, est attribuée un identifiant unique global, appelé révision dans etcd, issu d’un compteur strictement croissant permettant de raisonner sur l’ordre. Étant donné qu’il n’existe qu’un seul groupe de réplication, la requête de modification n’a besoin de passer que par le protocole Raft pour être validée. En limitant le consensus à un seul groupe de réplication, etcd obtient une cohérence distribuée avec un protocole simple tout en atteignant une latence faible et un débit élevé.
La réplication sous-jacente à etcd ne peut pas être mise à l’échelle horizontalement en raison de l’absence de fractionnement des données. À l’inverse, les bases de données NewSQL fractionnent généralement les données sur plusieurs groupes de réplication cohérents, stockant des jeux de données de l’ordre du téraoctet et plus. Toutefois, pour attribuer à chaque modification un identifiant global unique et croissant, chaque requête doit passer par un protocole de coordination supplémentaire entre les groupes de réplication. Cette étape de coordination supplémentaire peut potentiellement entraîner des conflits sur l’identifiant global, obligeant les requêtes ordonnées à se réessayer. Le résultat est une approche plus complexe, généralement moins performante qu’etcd pour un ordre strict.
Si une application traite principalement des métadonnées ou de l’ordre des métadonnées, par exemple pour coordonner des processus, choisissez etcd. Si l’application nécessite un grand magasin de données étendu sur plusieurs centres de données et ne dépend pas fortement des propriétés d’ordre global fort, choisissez une base de données NewSQL.
Utilisation d’etcd pour la coordination distribuée
etcd propose des primitives de coordination distribuée telles que les surveillance d’événements, les bails, les élections et les verrous partagés distribués, directement intégrées (notez que, dans le cas du verrou partagé distribué, les utilisateurs doivent être conscients de ses propriétés non évidentes. Les détails sont décrits ci-dessous). Ces primitives sont à la fois maintenues et soutenues par les développeurs etcd ; laisser ces primitives aux bibliothèques externes revient à éviter la responsabilité du développement de logiciels distribués fondamentaux, ce qui laisse le système incomplet. Les bases de données NewSQL s’attendent généralement à ce que ces primitives de coordination soient développées par des tiers. De même, ZooKeeper dispose d’une bibliothèque de recettes de coordination séparée et indépendante library . Consul, qui propose une API native de verrouillage, va jusqu’à s’excuser en disant que c’est « not a bulletproof method ».
En théorie, il est possible de construire ces primitives sur n’importe quel système de stockage offrant une cohérence forte. Toutefois, les algorithmes sont souvent subtils ; il est facile de concevoir un algorithme de verrouillage qui semble fonctionner, pour qu’il cesse soudainement de fonctionner à cause d’un effet de myriade et d’un décalage de temporisation. En outre, d’autres primitives prises en charge par etcd, telles que la mémoire transactionnelle, dépendent du modèle de données MVCC d’etcd ; une cohérence forte simple ne suffit pas.
Pour la coordination distribuée, le choix d’etcd peut aider à éviter les problèmes opérationnels et économiser des efforts ingénierie.
Remarques sur l’utilisation du verrouillage et du bail
etcd fournit des API de verrouillage basées sur le mécanisme de bail , qui repose sur le mécanisme de bail et son implémentation dans etcd . L’idée fondamentale du mécanisme de bail est la suivante : un serveur accorde à un client demandeur un jeton, appelé bail. Lorsqu’un bail est accordé, le serveur lui associe un délai d’expiration (TTL). Lorsque le serveur détecte que le temps écoulé dépasse le TTL, il retire le bail. Tant qu’un client détient un bail non retiré, il peut affirmer qu’il détient l’accès à une ressource associée à ce bail. Dans le cas d’etcd, la ressource est une clé dans l’espace de clés etcd. etcd fournit des API de verrouillage selon ce schéma. Toutefois, les API de verrouillage ne peuvent pas être utilisées seules comme mécanisme d’exclusion mutuelle. Elles sont appelées API de verrouillage pour des raisons historiques . Elles peuvent toutefois être utilisées comme mécanisme d’optimisation de l’exclusion mutuelle, comme décrit ci-dessous.
L’aspect le plus important du mécanisme de bail est que le délai d’expiration (TTL) est défini comme un intervalle de temps physique. Le serveur et le client mesurent le passage du temps à l’aide de leurs propres horloges. Cela permet une situation où le serveur révoque le bail, mais le client continue de prétendre en être le propriétaire.
Comment le mécanisme de bail garantit-il l’exclusion mutuelle du mécanisme de verrouillage ? En réalité, le mécanisme de bail lui-même ne garantit pas l’exclusion mutuelle. Le fait de détenir un bail ne garantit pas que son détenteur détient un verrou sur la ressource.
Dans le cas de la gestion des accès mutuels aux clés d’etcd lui-même via un verrou etcd, l’exclusion mutuelle est mise en œuvre selon le mécanisme de validation du numéro de version (appelé parfois compare and swap dans d’autres systèmes comme Consul). Dans les RPCs d’etcd tels que Put ou Txn, il est possible de spécifier des conditions requises concernant le numéro de révision et l’ID de bail pour les opérations. Si ces conditions ne sont pas satisfaites, l’opération peut échouer. Grâce à ce mécanisme, etcd fournit un verrouillage distribué aux clients. Cela signifie qu’un client sait qu’il acquiert un verrou sur une clé lorsque sa requête est exécutée avec succès par le cluster etcd.
Dans la littérature sur le verrouillage distribué, des conceptions similaires sont décrites :
- Dans le papier Chubby , le concept de séquenceur est introduit. Nous interprétons que ce séquenceur est presque identique à la combinaison du numéro de révision et de l’ID de bail d’etcd.
- Dans Comment réaliser un verrouillage distribué , Martin Kleppmann a introduit l’idée de jeton de clôture. Les auteurs interprètent que ce jeton de clôture correspond au numéro de révision dans le cas d’etcd.
- Dans Utilisations pratiques des horloges synchronisées dans les systèmes distribués , on trouve une description selon laquelle Thor implémente un mécanisme de verrouillage distribué basé sur la validation du numéro de version et du bail.
Pourquoi etcd et d’autres systèmes proposent-ils des bails, alors qu’ils offrent une exclusion mutuelle basée sur la validation du numéro de version ? Les bails fournissent une mécanique d’optimisation visant à réduire le nombre de requêtes abandonnées.
Notez qu’en ce qui concerne les clés etcd, elles peuvent être verrouillées de manière efficace grâce aux mécanismes de bail et de validation du numéro de version. Si les utilisateurs doivent protéger des ressources n’ayant pas de lien avec etcd, ces ressources doivent fournir un mécanisme de validation du numéro de version ainsi qu’une cohérence entre les réplicas, comme le font les clés etcd. La fonction de verrouillage propre à etcd ne peut pas être utilisée pour protéger des ressources externes.
9 - Glossaire
Ce document définit les différents termes utilisés dans la documentation, la ligne de commande et le code source d’etcd.
Alarme
Le serveur etcd déclenche une alarme chaque fois que le cluster nécessite une intervention opérationnelle pour rester fiable.
Authentification
L’authentification gère les autorisations d’accès des utilisateurs aux ressources etcd.
Client
Un client se connecte au cluster etcd pour émettre des requêtes de service, telles que la récupération de paires clé-valeur, l’écriture de données ou la surveillance des mises à jour.
cluster
Un cluster se compose de plusieurs membres.
Le nœud de chaque membre suit le protocole de consensus Raft pour répliquer les journaux. Le cluster reçoit des propositions des membres, les valide et les applique au magasin local.
compactage
Le compactage supprime l’historique des événements et les clés obsolètes antérieures à une révision donnée. Il permet de libérer de l’espace de stockage dans la base de données backend d’etcd.
Élection
Le cluster etcd organise des élections parmi ses membres afin de choisir un leader, conformément au protocole de consensus Raft.
Point de terminaison
Une URL pointant vers un service ou une ressource etcd.
Clé
Identifiant défini par l’utilisateur pour le stockage et la récupération de valeurs définies par l’utilisateur dans etcd.
Plage de clés
Un ensemble de clés contenant soit une clé individuelle, soit un intervalle lexicographique pour toutes les clés x telles que a < x <= b, soit toutes les clés supérieures à une clé donnée.
espace de clés
L’ensemble de toutes les clés dans un cluster etcd.
bail
Contrat renouvelable à courte durée qui supprime les clés associées à celui-ci à l’expiration.
membre
Un serveur etcd logique participant au service d’un cluster etcd.
Révision de modification
La première révision à contenir la dernière écriture sur une clé donnée.
Pair
Le pair est un autre membre du même cluster.
Proposition
Une proposition est une demande (par exemple, une demande d’écriture, une demande de modification de configuration) qui doit passer par le protocole Raft.
quorum
Nombre de membres actifs nécessaires pour atteindre un consensus afin de modifier l’état du cluster. etcd exige une majorité de membres pour atteindre le quorum.
révision
Compteur global sur 64 bits, initialisé à 1 et incrémenté à chaque modification de l’espace de clés.
Rôle
Unité de permissions sur un ensemble de plages de clés, pouvant être attribuée à un ensemble d’utilisateurs pour le contrôle d’accès.
instantané
Une sauvegarde instantanée de l’état du cluster etcd.
Stockage
Le stockage physique sous-jacent à l’espace de clés du cluster.
Terme
Un terme est un entier strictement croissant associé à chaque élection de leader dans l’algorithme Raft. Pour un terme donné, il ne peut y avoir qu’un seul leader élu, et le terme est incrémenté lors d’un changement de leader.
Transaction
Opération en série exécutée de manière atomique. Toutes les clés modifiées au sein d’une transaction partagent la même révision de modification.
Version de la clé
Le nombre d’écritures effectuées sur une clé depuis sa création, à compter de 1. La version d’une clé inexistante ou supprimée est 0.
observateur
Un client ouvre un observateur pour surveiller les mises à jour sur une plage de clés donnée.