Vue imprimable multi-pages de cette section. .
etcd 3.7 Documentation
- 1: Tâches
- 2: Démarrage rapide
- 3: Exemple
- 4: Installer
- 5: Portes fonctionnelles
- 6: FAQ
- 7: Bibliothèques et outils
- 8: Métriques
- 9: Signalement de bogues
- 10: Optimisation
- 11: Internes
- 12: Apprentissage
- 13: Guide du développeur
- 13.1: Protocole du service de découverte
- 13.2: Mettre en place un cluster local
- 13.3: Interaction avec etcd
- 13.4: Pourquoi utiliser une passerelle gRPC
- 13.5: Découverte et nommage gRPC
- 13.6: Intégration d'etcd dans une application Go
- 13.7: Limites système
- 13.8: etcd features
- 13.9: Référence de l'API
- 13.10: Référence API : concurrence
- 14: Guide des opérations
- 14.1: Guides d'authentification
- 14.1.1: Authentification
- 14.1.2: Contrôle d'accès basé sur les rôles
- 14.2: Options de configuration
- 14.3: Modèle de sécurité du transport
- 14.4: Guide de clustering
- 14.5: Exécuter des clusters etcd dans des conteneurs
- 14.6: Exécuter des clusters etcd en tant que StatefulSet Kubernetes
- 14.7: Modes de défaillance
- 14.8: Récupération après sinistre
- 14.9: etcd gateway
- 14.10: Proxie gRPC
- 14.11: Recommandations matérielles
- 14.12: Maintenance
- 14.13: Surveillance d’etcd
- 14.14: Performances
- 14.15: Conception de la reconfiguration à l'exécution
- 14.16: Reconfiguration en cours d'exécution
- 14.17: Plateformes prises en charge
- 14.18: Gestion des versions
- 14.19: Corruption des données
- 14.1: Guides d'authentification
- 15: Benchmarks
- 16: Mise à jour
- 16.1: Mise à jour des clusters etcd et des applications
- 16.2: Mettre à jour etcd de la version v3.5 à la version v3.6
- 16.3: Mettre à jour etcd de 3.4 à 3.5
- 16.4: Mettre à jour etcd de 3.3 à 3.4
- 16.5: Mettre à jour etcd de la version v3.6 à la version v3.7
- 16.6: Mettre à jour etcd de 3.2 vers 3.3
- 16.7: Mettre à jour etcd de 3.1 vers 3.2
- 16.8: Mettre à jour etcd de la version 3.0 à la 3.1
- 16.9: Mettre à jour etcd de la version 2.3 à la 3.0
- 17: Rétrogradation
- 18: Tri
etcd est un magasin clé-valeur distribué à cohérence forte. Ces guides traitent de l’installation et de l’exploitation d’etcd, de la mise en œuvre d’applications basées sur ses API, de sa conception, de la mesure des performances, ainsi que de la mise à jour ou de la rétrogradation des clusters dans la branche de version 3.7.
Commencez par Démarrage rapide pour un cluster local à membre unique, Installation pour les chemins d’installation pris en charge, ou Guide des opérations pour les déploiements en production.
1 - Tâches
1.1 - Tâches de l'opérateur
1.1.1 - Comment configurer un cluster étcd de démonstration
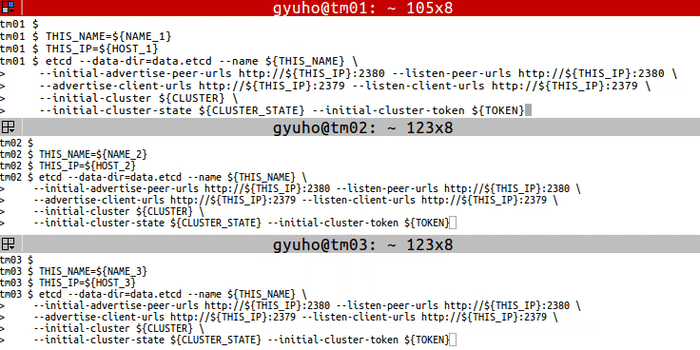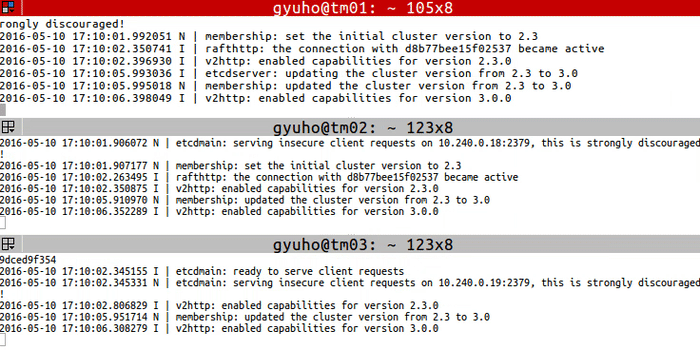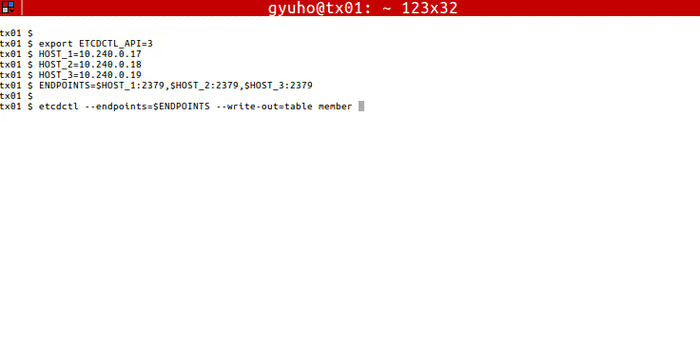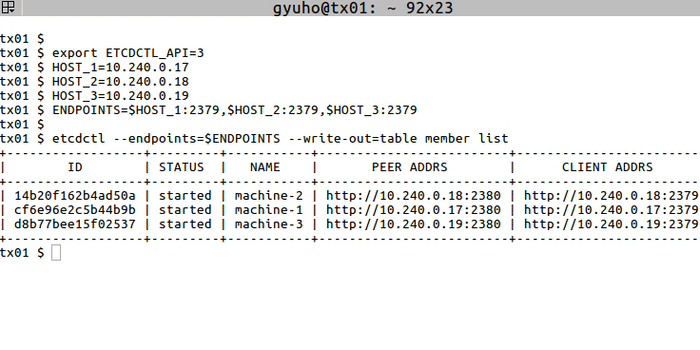
Sur chaque nœud etcd, précisez les membres du cluster :
Exécutez ceci sur chaque machine :
Ou utilisez notre service de découverte public :
etcd est maintenant prêt ! Pour vous connecter à etcd avec etcdctl :
1.1.2 - Comment effectuer l'élection du leader dans un cluster etcd
Prérequis
Conduire l’élection du leader
La commande etcdctl est utilisée pour effectuer des élections de leader dans un cluster etcd. Elle garantit qu’un seul client peut devenir leader à la fois.
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
Options
--endpoints : $ENDPOINTS
Adresse de chaque membre du cluster etcd.
election-namechaîne de caractères
Identifiant sous forme de chaîne pour l’élection. Tous les participants en compétition pour la direction doivent utiliser le même nom d’élection.
leader-namechaîne de caractères
Valeur de proposition du nouveau leader.
Exemple
1.1.3 - Comment vérifier l'état du cluster
Prérequis
- Installer
etcdetetcdctl
Vérifier l’état global
endpoint status pour vérifier l’état global de chaque point de terminaison spécifié dans le drapeau --endpoints :
Options
Vérifier l’état de santé
endpoint health pour vérifier l’état de santé de chaque point de terminaison spécifié dans le drapeau --endpoints :
Options
Vérifier le hachage KV
endpoint hashkv pour vérifier le hachage de l’historique des paires clé-valeur de chaque point de terminaison spécifié dans le drapeau --endpoints :
Options
Options héritées des commandes parentes
Exemples
1.1.4 - Comment sauvegarder la base de données
Prérequis
Effectuer un instantané d’une base de données
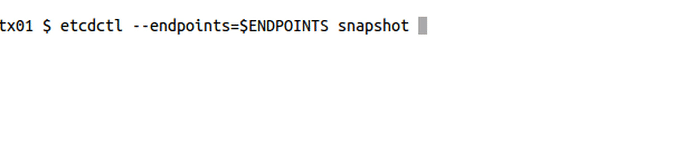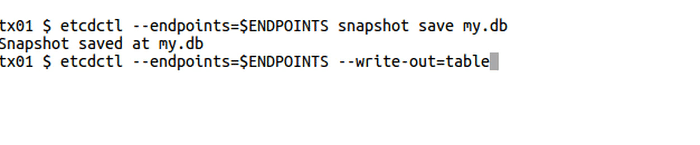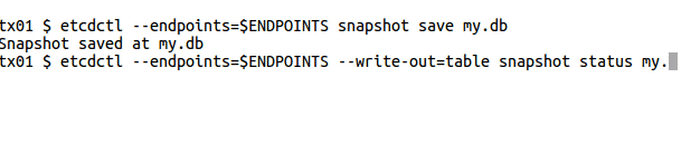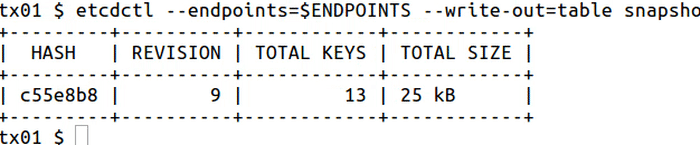
snapshot pour sauvegarder un instantané du stockage etcd à un instant donné :
Options globales
etcdctl
Un instantané ne peut être demandé qu’à un nœud etcd, donc le drapeau --endpoints ne doit contenir qu’un seul point de terminaison.
etcdutl
Exemple
1.1.5 - Comment ajouter et supprimer des membres
member pour ajouter, supprimer ou mettre à jour le membre :
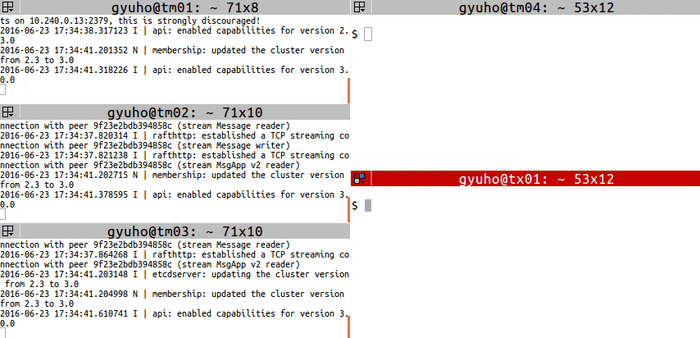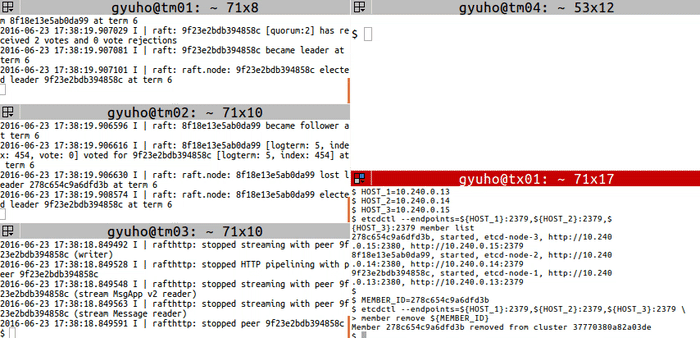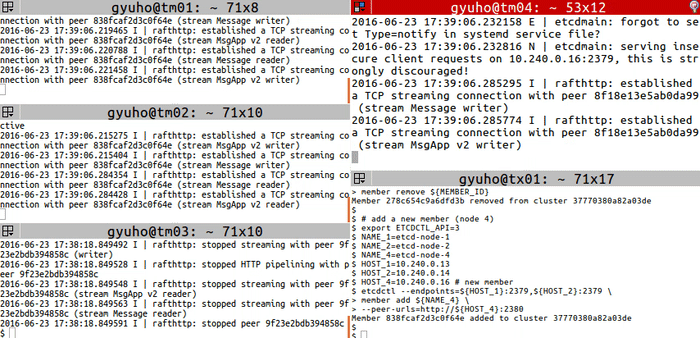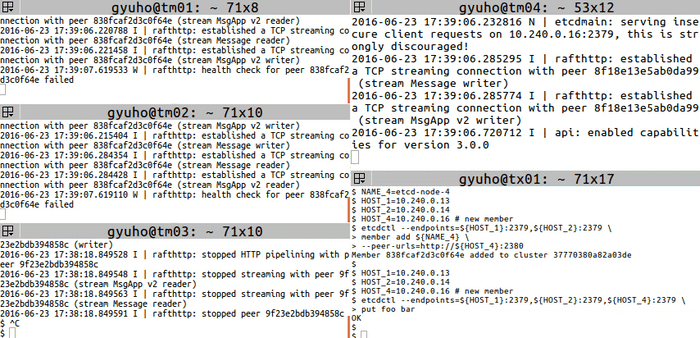
Ensuite, remplacez un membre avec les commandes member remove et member add :
Ensuite, démarrez le nouveau membre avec le drapeau --initial-cluster-state existing :
1.2 - Tâches de développement
1.2.1 - Lecture depuis etcd
Prérequis
- Installer
etcdctl
Procédure
Utilisez la sous-commande get pour lire depuis etcd :
où :
fooest la clé demandéeHello World!est la valeur récupérée
Or, pour une sortie formatée :
où write-out="json" fait que la valeur est sortie au format JSON (notez que la clé n’est pas renvoyée).
1.2.2 - Écriture dans etcd
Prérequis
- Installer
etcdctl
Procédure
Utilisez la sous-commande put pour écrire une paire clé-valeur :
où :
fooest le nom de la clé"Hello World!"est la valeur délimitée par des guillemets
1.2.3 - Comment obtenir des clés par préfixe
Prérequis
Obtenir les clés par préfixe
Options globales
Options
Exemple
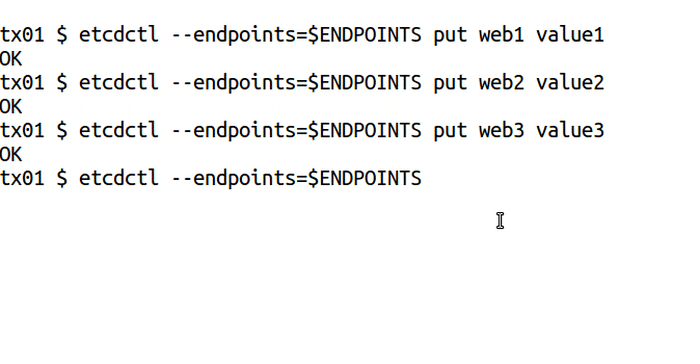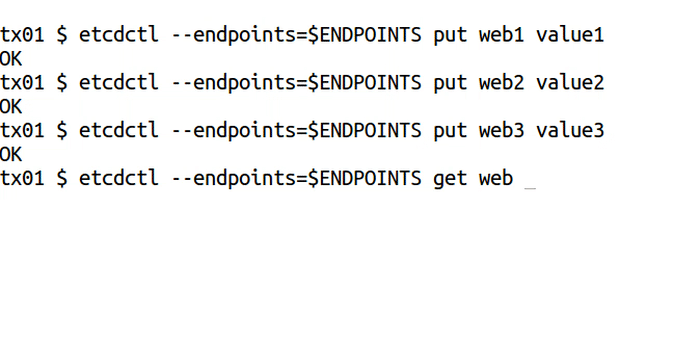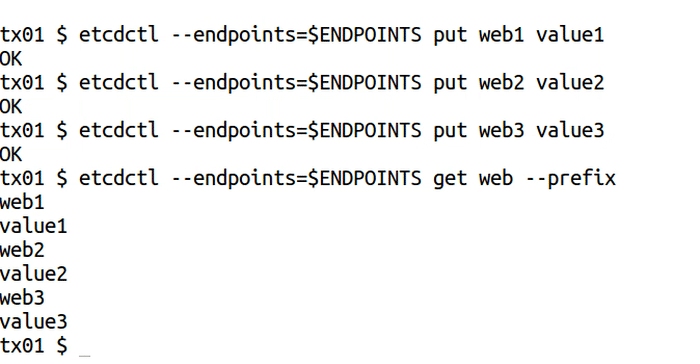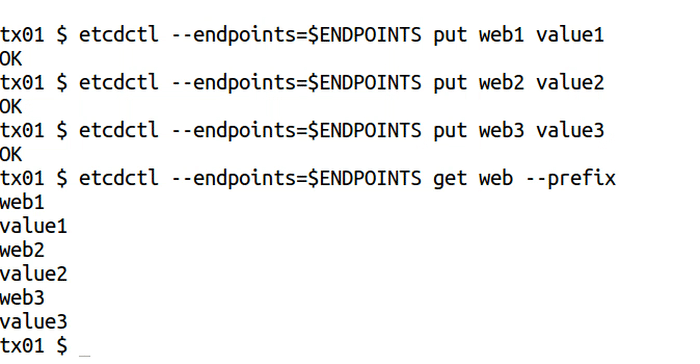
1.2.4 - Comment supprimer des clés
Prérequis
- Installer
etcdetetcdctl
Ajouter ou supprimer des clés
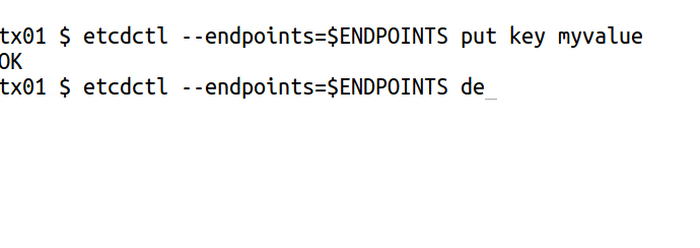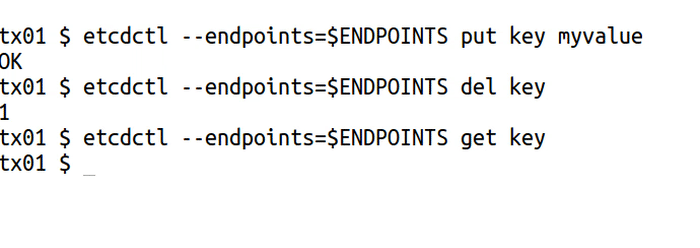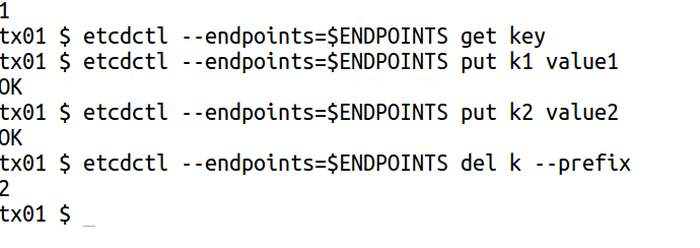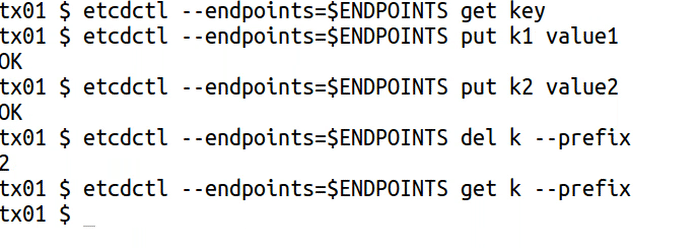
del pour supprimer la clé spécifiée ou la plage de clés :
Options
Options héritées des commandes parentes
Exemples
1.2.5 - Comment effectuer plusieurs écritures dans une transaction
Prérequis
- Installer
etcdetetcdctl. - Un cluster
etcden cours d’exécution.
Terminologie
Voici les définitions de quelques termes clés utilisés dans l’exemple Example ci-dessous.
| Termes | Définition |
|---|---|
| etcdctl | Outil en ligne de commande pour interagir avec le serveur etcd. |
txn
command | txn command est une abréviation de « transaction ». Il lit plusieurs requêtes etcd depuis l’entrée standard et les applique comme une transaction atomique unique. Une transaction se compose d’une liste de conditions, d’une liste de requêtes à appliquer si toutes les conditions sont vraies, et d’une liste de requêtes à appliquer si au moins une condition est fausse. Consultez etcdctl key-value commands
pour plus d’informations. |
compare | La clause compare au sein d’une transaction (txn) sert de vérification conditionnelle déterminant si les opérations de la transaction doivent s’exécuter. Elle garantit que les modifications ne sont appliquées que si l’état actuel du magasin clé-valeur correspond aux conditions attendues, assurant ainsi la cohérence des données et évitant les conflits dans les environnements concurrents. Pour voir la structure de la commande, consultez la section Effectuer une transaction
ci-dessous. |
Transactions
txn pour traiter toutes les requêtes dans une seule transaction :
Les transactions dans etcd permettent d’exécuter plusieurs opérations de manière atomique, garantissant que toutes les opérations sont appliquées ou que aucune ne l’est. Cela est essentiel pour maintenir la cohérence des données lors de mises à jour liées. En savoir plus sur les transactions dans la documentation de l’API .
Exemple
Considérons un scénario dans lequel vous souhaitez mettre à jour l’e-mail et le numéro de téléphone d’un utilisateur dans une seule transaction. Cela garantit que les deux mises à jour sont appliquées ensemble.
0. Variables et indicateurs utilisés
| Variables |
|---|
/users/{<user_id>/email : clé etcd représentant l’adresse e-mail d’un utilisateur. |
/users/<user_id>/phone : clé etcd représentant le numéro de téléphone d’un utilisateur. |
| Drapeaux |
--interactive
: Drapeau permettant d’entrer manuellement les données de transaction |
1. Configurer les données initiales
Tout d’abord, créez un utilisateur avec quelques données initiales.
2. Effectuer une transaction
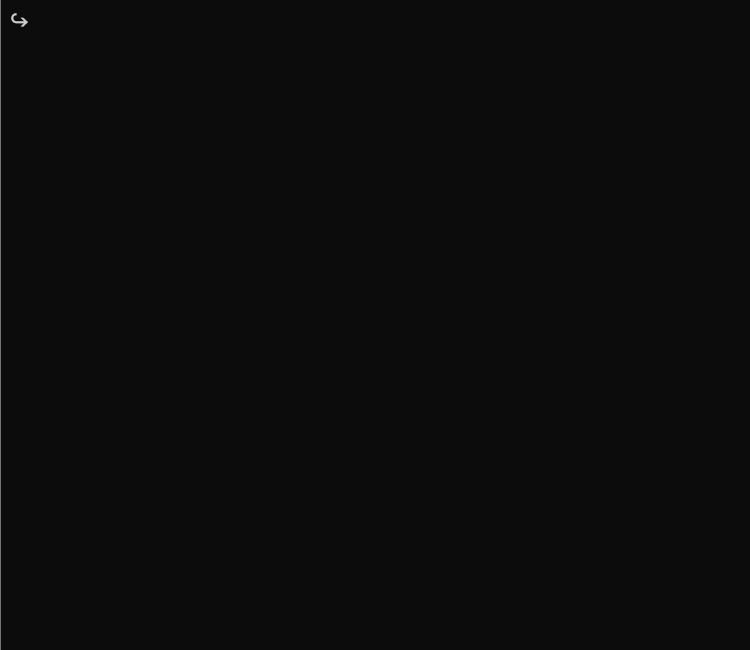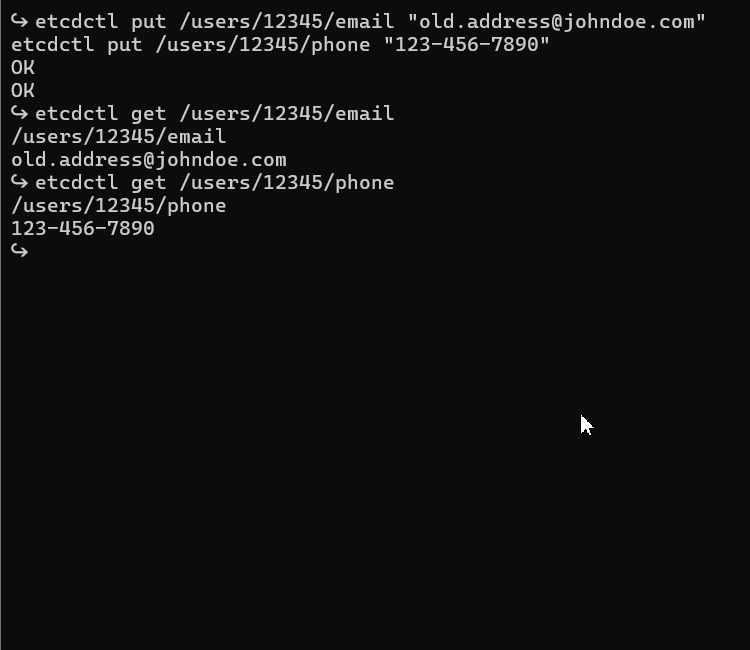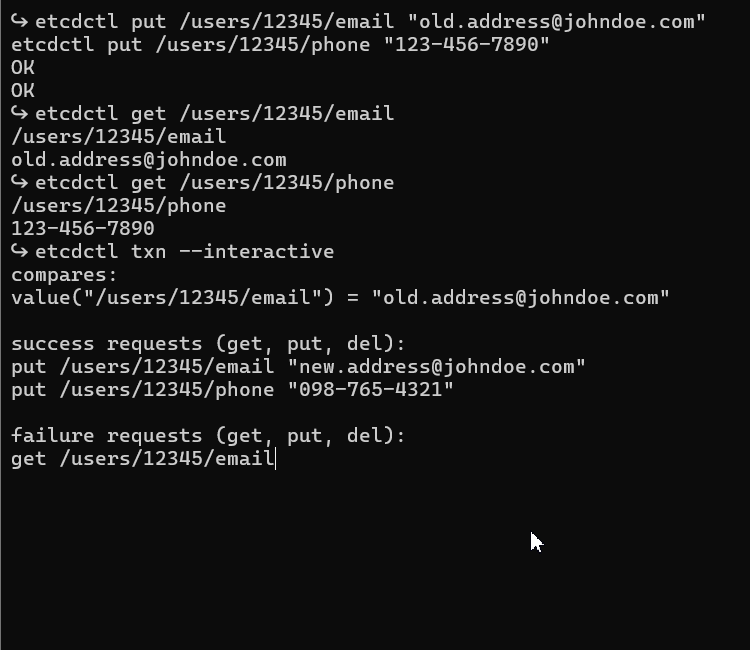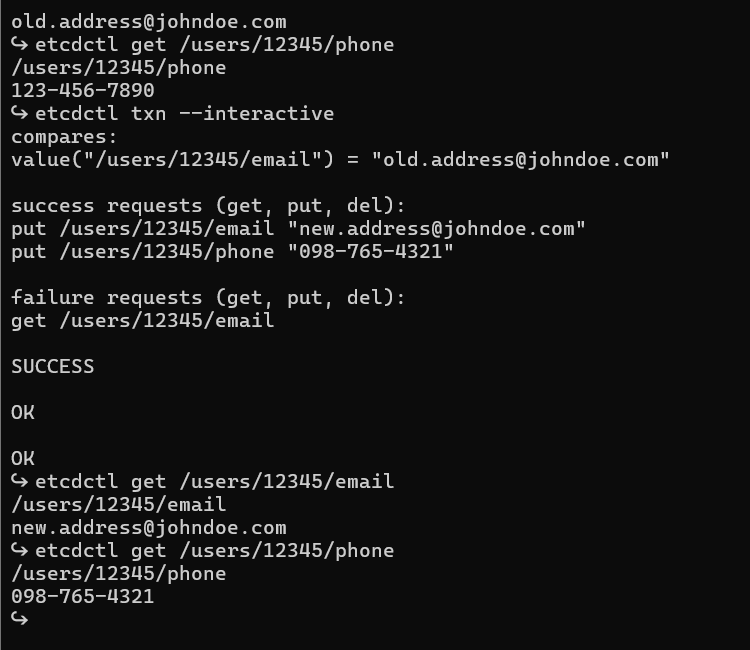
Mettez à jour l’e-mail et le numéro de téléphone de l’utilisateur dans une seule transaction.
- Comparaison : Vérifiez que l’e-mail actuel correspond à “old.address@johndoe.com ”. Cela garantit que la transaction ne s’effectue que si les données sont telles qu’attendu.
- Succès : Si la comparaison est vraie, mettez à jour à la fois l’e-mail et le numéro de téléphone.
- Échec : Si la comparaison échoue, récupérez l’e-mail actuel afin de comprendre pourquoi la transaction n’a pas pu s’effectuer.
Considérations importantes
- Atomicité : La transaction garantit que la mise à jour de l’e-mail et du numéro de téléphone s’effectue ensemble. Si la condition initiale (comparaison) n’est pas remplie, aucune mise à jour n’est appliquée.
- Consistance : L’utilisation des transactions assure la cohérence des données, notamment lors de mises à jour multiples liées.
- Éviter plusieurs opérations put sur la même clé : Ne pas effectuer plusieurs mises à jour pour la même clé au sein d’une même transaction, car cela peut entraîner des résultats imprévus. Chaque clé ne doit être mise à jour qu’une seule fois par transaction.
1.2.6 - Comment surveiller des clés
Prérequis
- Installer
etcdetetcdctl
Surveillance des clés
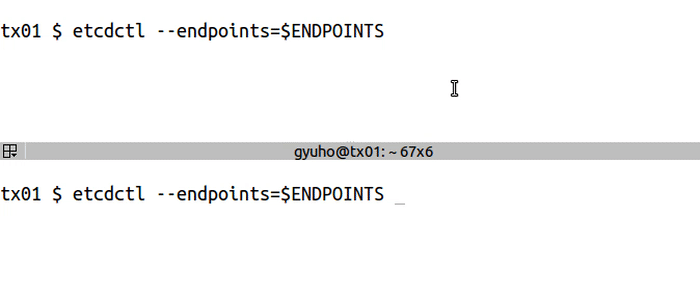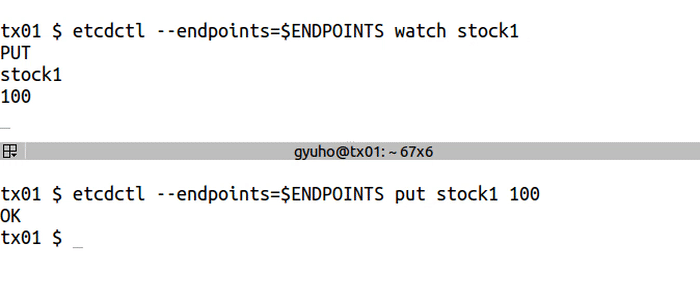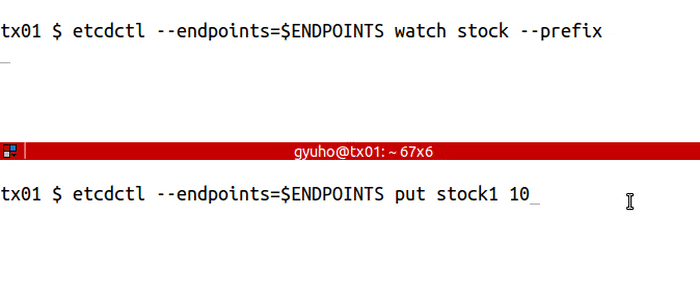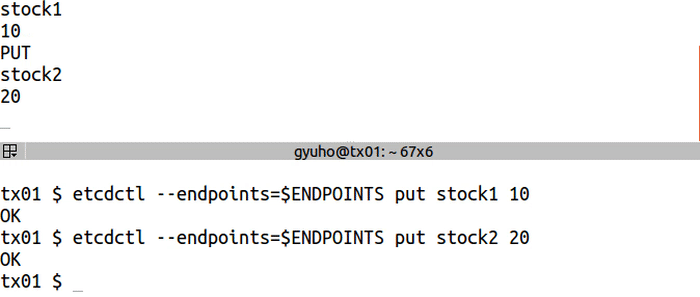
watch pour être notifié des modifications futures :
Options
Options héritées des commandes parentes
Exemples
1.2.7 - Comment créer un bail
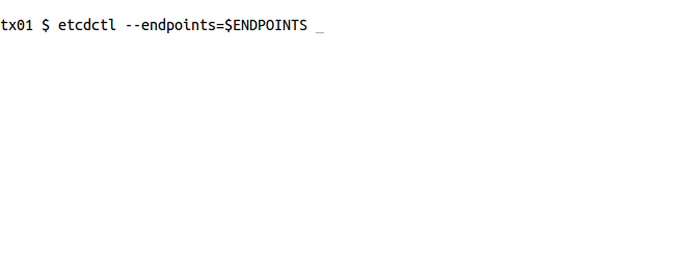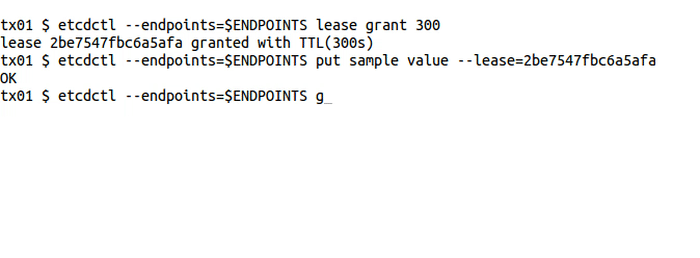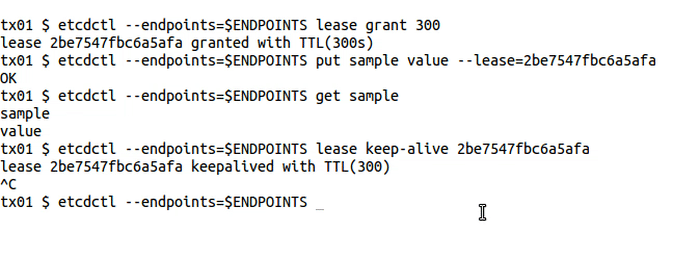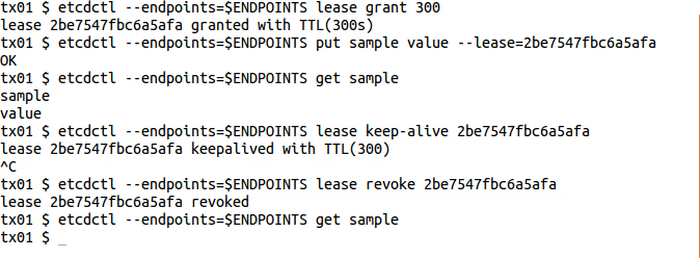
lease pour écrire avec un TTL :
1.2.8 - Comment créer des verrous
LOCK acquiert un verrou distribué portant un nom donné. Une fois le verrou acquis, il reste détenu jusqu’à la terminaison d’etcdctl.
Prérequis
- Installer
etcdetetcdctl
Création d’un verrou
lock pour verrouillage distribué :
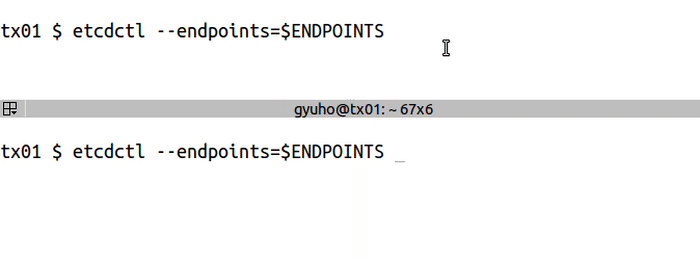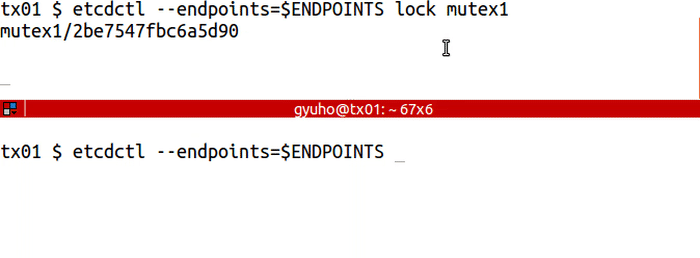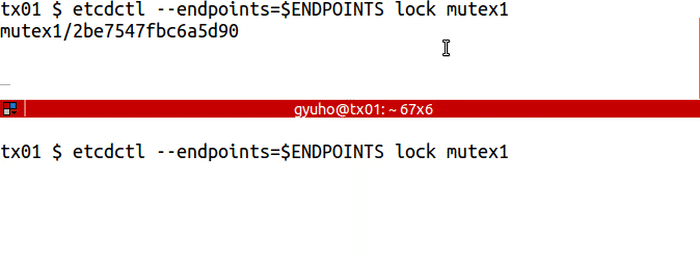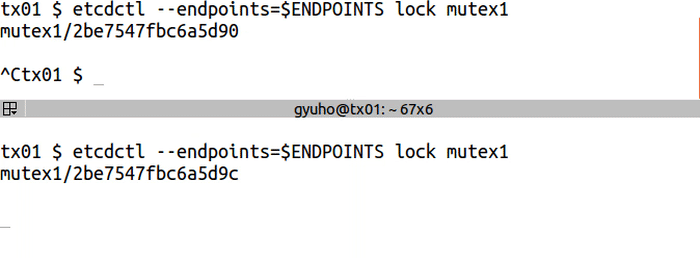
Options
- endpoints - définit une liste séparée par des virgules d’adresses machine du cluster.
- ttl - durée d’expiration en secondes de la session de verrouillage.
2 - Démarrage rapide
Suivez ces instructions pour installer, exécuter et tester localement un cluster à membre unique de etcd :
Installez etcd à partir de binaires précompilés ou du code source. Pour plus de détails, consultez Installation .
AvertissementImportant : Veillez à effectuer la dernière étape des instructions d’installation afin de vérifier que
etcdest dans votre chemin.Démarrer
etcd:NoteRemarque : La sortie produite par
etcdest logs — des journaux de niveau info peuvent être ignorés.Depuis un autre terminal, utilisez
etcdctlpour définir une clé :Depuis le même terminal, récupérez la clé :
Que faire ensuite ?
Découvrez d’autres méthodes de configuration et d’utilisation d’etcd dans les pages suivantes :
Si vous êtes développeur :
- Explorez l’API gRPC API .
- Recherchez des liaisons de langage et des outils .
Si vous êtes opérateur ou administrateur :
- Mettez en place un cluster multi-machine .
- Apprenez à [configurer][] etcd.
- Utilisez TLS pour sécuriser un cluster etcd .
- Optimisez etcd .
3 - Exemple
Cette série d’exemples illustre les procédures de base pour travailler avec un cluster etcd.
Auth
auth,user,role pour l’authentification :
4 - Installer
Exigences
Avant d’installer etcd, consultez les pages suivantes :
- [Plateformes prises en charge][]
- [Recommandations matérielles][]
Installer les binaires préconstruits
La méthode la plus simple pour installer etcd consiste à utiliser des binaires pré-construits :
Téléchargez le fichier archive compressé pour votre plateforme depuis Releases , en choisissant une version v3.7.0 ou ultérieure.
Décompressez le fichier archive. Cela crée un répertoire contenant les binaires.
Ajoutez les binaires exécutables à votre chemin d’accès. Par exemple, renommez et/ou déplacez les binaires vers un répertoire de votre chemin d’accès (comme
/usr/local/bin), ou ajoutez le répertoire créé à l’étape précédente à votre chemin d’accès.À partir d’un shell, vérifiez que
etcdest dans votre chemin d’accès :
Générer à partir du code source
Si vous avez Go version 1.21+ , vous pouvez compiler etcd à partir de son code source en suivant ces étapes :
Téléchargez le dépôt etcd sous forme de fichier zip et décompressez-le, ou clonez le dépôt à l’aide de la commande suivante.
Pour construire à partir de
main@HEAD, omettre le drapeau-b v3.7.0.Changer de répertoire :
Exécutez le script de compilation :
Les binaires se trouvent dans le répertoire
bin.Ajoutez le chemin complet du répertoire
binà votre variable d’environnement PATH, par exemple :Vérifiez que
etcdest dans votre chemin :
Installation via les paquets du système
Avertissement : les installations d’etcd via les gestionnaires de paquets du système d’exploitation peuvent fournir des versions obsolètes, car elles ne sont ni automatiquement maintenues ni officiellement prises en charge par le projet etcd. Utilisez donc les paquets du système avec précaution.
Il existe plusieurs façons d’installer etcd sur différents systèmes d’exploitation, et voici quelques exemples de la manière dont cela peut être réalisé.
macOS (Homebrew)
- Mettre à jour Homebrew :
- Installer etcd :
- Vérifier l’installation
Linux
Bien qu’il soit possible d’installer etcd via les dépôts officiels et les gestionnaires de paquets de nombreuses distributions Linux majeures, les versions publiées peuvent être fortement obsolètes. L’installation de cette manière est donc fortement déconseillée.
La méthode recommandée pour installer etcd sous Linux consiste soit à utiliser des binaires pré-construits pré-construits , soit à utiliser Homebrew.
Homebrew sous Linux
[Homebrew peut fonctionner sous Linux] et peut fournir des versions récentes des logiciels.
Prérequis
Mettre à jour Homebrew :
Procédure
Installation à l’aide de
brew:
Résultat
Vérifiez l’installation en obtenant la version :
Docker
etcd utilise gcr.io/etcd-development/etcd
comme registre conteneur principal, et quay.io/coreos/etcd
comme secondaire.
Pour exécuter etcd à l’aide de Docker :
Installation dans le cadre de l’installation de Kubernetes
- [Exécuter etcd en tant que StatefulSet Kubernetes][]
Vérification d’installation
Pour une vérification de cohérence un peu plus poussée de votre installation, consultez Quickstart .
5 - Portes fonctionnelles
Cette page présente un aperçu des diverses options de fonctionnalité qu’un administrateur peut spécifier sur etcd.
Voir étapes du fonctionnement pour une explication des étapes d’une fonctionnalité.
Aperçu
Les portes fonctionnelles sont un ensemble de paires clé=valeur qui décrivent les fonctionnalités d’etcd.
Vous pouvez activer ou désactiver ces fonctionnalités à l’aide du drapeau de ligne de commande --feature-gates sur etcd.
etcd vous permet d’activer ou de désactiver un ensemble de fonctionnalités expérimentales.
Utilisez le drapeau -h pour afficher la liste complète des fonctionnalités expérimentales.
Pour définir les fonctionnalités expérimentales, utilisez le drapeau --feature-gates avec une liste de paires fonctionnalité=valeur en ligne de commande :
Ou spécifiez feature-gates dans le fichier de configuration YAML :
Modification de la structure embed.EtcdServer
En 3.6, le champ ServerFeatureGate est ajouté à embed.Config, et doit remplacer les champs expérimentaux ci-dessous :
Portes d’activation pour les fonctionnalités Alpha ou Beta
Les tableaux suivants résumé les portes de fonctionnalité que vous pouvez activer sur etcd.
| Fonctionnalité | Valeur par défaut | Étape | Détails |
|---|---|---|---|
| CompactHashCheck | false | Alpha | Active la vérification de corruption des données avant de servir tout trafic client/peer. |
| InitialCorruptCheck | false | Alpha | Active la vérification périodique par le leader des hachages de compactage des suiveurs. |
| LeaseCheckpoint | false | Alpha | Active l’envoi de points de contrôle réguliers par le leader aux autres membres afin d’éviter la réinitialisation du TTL restant lors d’un changement de leader. |
| LeaseCheckpointPersist | false | Alpha | Active la persistance du TTL restant afin d’éviter une auto-renouvellement indéfini des bails longs. |
| SetMemberLocalAddr | false | Alpha | Active l’utilisation de la première adresse locale non boucle spécifiée dans initial-advertise-peer-urls comme adresse locale lors de la communication avec un pair. |
| StopGRPCServiceOnDefrag | false | Alpha | Active l’arrêt du service gRPC etcd lors de la défragmentation afin de ne plus servir les requêtes clients. |
| TxnModeWriteWithSharedBuffer | true | Beta | Active l’utilisation d’un tampon partagé lors des opérations de vérification en lecture seule dans les transactions d’écriture. |
Utilisation d’une fonctionnalité
Stades des fonctionnalités
Une fonctionnalité peut être à l’étape Alpha, Beta, GA ou Deprecated. Une fonctionnalité Alpha signifie :
- Désactivé par défaut.
- Peut présenter des bugs. L’activation de cette fonctionnalité peut exposer des bugs.
- Le support de cette fonctionnalité peut être supprimé à tout moment sans préavis.
- L’API peut évoluer de manière incompatible dans une version logicielle ultérieure sans préavis.
- Recommandé pour une utilisation uniquement dans des clusters de test à durée limitée, en raison de risques accrus de bugs et du manque de support à long terme.
Une fonctionnalité Beta signifie :
- Activé par défaut.
- La fonctionnalité est bien testée. Son activation est considérée comme sûre.
- Le support de la fonctionnalité globale ne sera pas supprimé, bien que les détails puissent évoluer.
- Recommandé uniquement pour des utilisations non critiques pour l’activité car il existe un risque de découverte de bogues difficiles à détecter grâce à une adoption plus large.
N’hésitez pas à essayer les fonctionnalités Beta et à nous faire part de vos retours ! Une fois sorties de la phase bêta, il se peut qu’il ne soit plus pratique pour nous d’apporter davantage de modifications.
Une fonctionnalité General Availability (GA) est également appelée fonctionnalité stable. Cela signifie :
- La fonctionnalité est toujours activée ; vous ne pouvez pas la désactiver.
- La porte de fonction correspondante n’est plus nécessaire.
- Les versions stables des fonctionnalités apparaîtront dans les logiciels publiés pendant de nombreuses versions ultérieures.
Une fonctionnalité Deprecated signifie :
- La porte de fonctionnalité n’est plus utilisée.
- La fonctionnalité a atteint le stade GA ou a été supprimée.
6 - FAQ
etcd, général
Qu’est-ce qu’etcd ?
etcd est un magasin clé-valeur distribué cohérent. Principalement utilisé comme service de coordination indépendant dans les systèmes distribués. Conçu pour stocker de petites quantités de données pouvant tenir entièrement en mémoire.
Comment prononce-t-on etcd ?
etcd se prononce /ˈɛtsiːdiː/ et signifie « répertoire etc distribué ».
Les clients doivent-ils envoyer des requêtes au leader etcd ?
Raft est basé sur un leader ; le leader gère toutes les requêtes clients nécessitant un consensus au sein du cluster. Toutefois, le client n’a pas besoin de savoir quel nœud est le leader. Toute requête nécessitant un consensus envoyée à un suiveur est automatiquement redirigée vers le leader. Les requêtes ne nécessitant pas de consensus (par exemple, les lectures sérialisées) peuvent être traitées par n’importe quel membre du cluster.
Configuration
Quelle est la différence entre listen-<client,peer>-urls, advertise-client-urls et initial-advertise-peer-urls ?
listen-client-urls et listen-peer-urls spécifient les adresses locales auxquelles le serveur etcd se lie pour accepter les connexions entrantes. Pour écouter sur un port pour toutes les interfaces, spécifiez 0.0.0.0 comme adresse IP d’écoute.
advertise-client-urls et initial-advertise-peer-urls spécifient les adresses que les clients etcd ou d’autres membres etcd doivent utiliser pour contacter le serveur etcd. Les adresses annoncées doivent être accessibles depuis les machines distantes. Ne pas annoncer d’adresses telles que localhost ou 0.0.0.0 dans une configuration de production, car ces adresses sont inaccessibles depuis les machines distantes.
Pourquoi la modification de --listen-peer-urls ou --initial-advertise-peer-urls ne met-elle pas à jour les URL de pair annoncées dans etcdctl member list ?
Les URL de pair annoncées par un membre proviennent de --initial-advertise-peer-urls lors du démarrage initial du cluster. Modifier les URL d’écoute ou les pairs à annoncer initiaux après le démarrage du membre n’affecte pas les URL de pair annoncées, car les modifications doivent passer par le quorum afin d’éviter une partition de la configuration d’appartenance. Utilisez etcdctl member update pour mettre à jour les URL de pair d’un membre.
Déploiement
Exigences système
Étant donné qu’etcd écrit des données sur le disque, ses performances dépendent fortement de la performance du disque. Un disque SSD est donc fortement recommandé. Pour évaluer si un disque est suffisamment rapide pour etcd, une possibilité consiste à utiliser un outil de benchmark disque tel que fio . Pour un exemple de mise en œuvre, consultez ici . Afin d’éviter une dégradation des performances ou une surcharge involontaire du magasin clé-valeur, etcd impose une quota de taille de stockage configurable, fixé par défaut à 2 Go. Pour éviter l’échange ou la pénurie de mémoire, la machine doit disposer d’au moins autant de RAM que le quota. Une taille maximale de 8 Go est suggérée pour les environnements normaux, et etcd émet un avertissement au démarrage si la valeur configurée dépasse cette limite. Chez CoreOS, un cluster etcd est généralement déployé sur des machines dédiées CoreOS Container Linux dotées d’un processeur à deux cœurs, de 2 Go de RAM et d’un SSD de 80 Go au minimum. Notez que les performances dépendent intrinsèquement de la charge ; testez avant un déploiement en production. Consultez les recommandations sur le matériel .
L’environnement de production le plus stable est le système d’exploitation Linux avec l’architecture amd64 ; consultez plateforme prise en charge pour plus d’informations.
Pourquoi un nombre impair de membres dans un cluster ?
Un cluster etcd nécessite une majorité de nœuds, un quorum, pour s’accorder sur les mises à jour de l’état du cluster. Pour un cluster composé de n membres, le quorum est égal à (n/2)+1. Pour tout cluster de taille impaire, l’ajout d’un nœud augmente toujours le nombre de nœuds nécessaires au quorum. Bien qu’ajouter un nœud à un cluster de taille impaire semble améliorer la situation en augmentant le nombre de machines, la tolérance aux pannes est en réalité moindre, car exactement le même nombre de nœuds peut tomber en panne sans perdre le quorum, tout en augmentant le nombre de nœuds susceptibles de tomber en panne. Si le cluster se trouve dans un état où il ne peut plus tolérer de pannes supplémentaires, ajouter un nœud avant de supprimer des nœuds est dangereux, car si le nouveau nœud ne parvient pas à s’enregistrer dans le cluster (par exemple, en raison d’une mauvaise configuration de l’adresse), le quorum sera perdu de manière permanente.
Quelle est la taille maximale d’un cluster ?
Théoriquement, il n’existe aucune limite rigide. Toutefois, un cluster etcd devrait normalement comporter au plus sept nœuds. Google Chubby lock service , similaire à etcd et largement déployé au sein de Google depuis de nombreuses années, recommande de fonctionner avec cinq nœuds. Un cluster etcd à cinq membres peut tolérer deux défaillances de membres, ce qui suffit dans la plupart des cas. Bien qu’un cluster plus grand offre une meilleure tolérance aux pannes, les performances d’écriture dégradent en raison de la réplication des données sur un plus grand nombre de machines.
Qu’est-ce que la tolérance aux pannes ?
Un cluster etcd fonctionne tant qu’un quorum de membres peut être établi. Si le quorum est perdu à cause de pannes réseau transitoires (par exemple, des partitions), etcd reprend automatiquement et en toute sécurité une fois la réseau restauré et le quorum rétabli ; Raft garantit la cohérence du cluster. En cas de perte de courant, etcd persiste le journal Raft sur le disque ; etcd rejoue le journal jusqu’au point de panne et reprend sa participation au cluster. En cas de panne matérielle permanente, le nœud peut être retiré du cluster par reconfiguration en temps réel .
Il est recommandé d’avoir un nombre impair de membres dans un cluster. Un cluster de taille impaire tolère autant de défaillances qu’un cluster de taille paire, mais avec moins de nœuds. Cette différence apparaît en comparant des clusters de taille paire et impaire :
| Taille du cluster | Majorité | Tolérance aux pannes |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
| 8 | 5 | 3 |
| 9 | 5 | 4 |
Ajouter un membre pour porter la taille du cluster à un nombre pair ne procure pas de tolérance aux pannes supplémentaire. De même, lors d’une partition réseau, un nombre impair de membres garantit qu’il y aura toujours une partition majoritaire capable de continuer à fonctionner et de servir de source de vérité lorsque la partition prendra fin.
etcd fonctionne-t-il dans des déploiements inter-régions ou inter-centres de données ?
Déployer etcd sur plusieurs régions améliore la tolérance aux pannes d’etcd, car les membres sont répartis dans des domaines de défaillance distincts. Le coût est une latence accrue pour les requêtes de consensus dues au franchissement des limites des centres de données. Étant donné qu’etcd repose sur un quorum de membres pour atteindre le consensus, la latence liée au franchissement des centres de données sera plus marquée, car au moins la majorité des membres du cluster doivent répondre aux requêtes de consensus. En outre, les données du cluster doivent être répliquées sur tous les pairs, ce qui entraîne également un coût en bande passante.
En cas de latences plus élevées, la configuration par défaut d’etcd peut entraîner des élections fréquentes ou des timeouts de battement de cœur. Consultez tuning pour ajuster les délais d’attente dans les déploiements à haute latence.
Opération
Comment sauvegarder un cluster etcd ?
etcdctl fournit une commande snapshot pour créer des instantanés. Consultez la section sauvegarde
pour plus de détails.
Dois-je ajouter un membre avant de supprimer un membre défaillant ?
Lors du remplacement d’un nœud etcd, il est essentiel de supprimer d’abord le membre, puis d’ajouter son remplaçant.
etcd utilise un consensus distribué fondé sur un modèle de quorum ; (n/2)+1 membres, soit une majorité, doivent être d’accord sur une proposition avant qu’elle ne puisse être validée dans le cluster. Ces propositions incluent les mises à jour clé-valeur et les modifications de membre. Ce modèle élimine totalement toute possibilité d’incohérence de type split brain. Le désavantage est que la perte permanente du quorum est catastrophique.
Application à la gestion des membres : si un cluster de 3 membres compte 1 membre hors service, il peut encore progresser, car le quorum est de 2 et 2 membres restent actifs. Toutefois, l’ajout d’un membre à un cluster de 3 membres porte le quorum à 3, puisque 3 voix sont nécessaires pour obtenir la majorité parmi 4 membres. Ce membre supplémentaire n’améliore donc pas la tolérance aux pannes : le cluster reste à 1 panne de nœud de devenir irrécupérable.
En outre, ce nouveau membre est risqué, car il se peut qu’il soit mal configuré ou incapable de rejoindre le cluster. Dans ce cas, il n’existe aucun moyen de récupérer le quorum, car le cluster dispose de deux membres hors ligne et deux membres en ligne, mais nécessite trois votes pour modifier la configuration des membres afin d’annuler l’ajout incorrect de membre. Par défaut, etcd rejette les tentatives d’ajout de membre qui pourraient entraîner une telle situation.
D’un autre côté, si le membre défaillant est supprimé de l’appartenance au cluster en premier lieu, le nombre de membres passe à 2 et le quorum reste à 2. Une fois cette suppression effectuée, l’ajout d’un nouveau membre maintient également le quorum à 2. Ainsi, même si le nouveau nœud ne peut pas être mis en service, il reste possible de supprimer ce nouveau membre via le quorum sur les membres encore actifs.
Pourquoi etcd ne prend-il pas en charge mes modifications d’appartenance ?
etcd définit strict-reconfig-check afin de rejeter les demandes de reconfiguration qui entraîneraient une perte de quorum. Abandonner le quorum est réellement risqué (en particulier lorsque le cluster est déjà défaillant). Bien qu’il puisse être tentant de désactiver la vérification du quorum en cas de perte de quorum pour ajouter un nouveau membre, cela pourrait entraîner une incohérence complète du cluster. Pour de nombreuses applications, cela aggraverait encore le problème (“corruption de géométrie disque” étant un exemple parmi les plus effrayants).
Pourquoi etcd perd-il son leader en cas de pics de latence disque ?
Cela est intentionnel ; la latence du disque fait partie de la disponibilité du leader. Supposons qu’un leader de cluster mette une minute à écrire sur disque une mise à jour du journal Raft, alors que le cluster etcd a un délai d’élection de une seconde. Même si le leader peut traiter les messages réseau dans l’intervalle d’élection (par exemple, envoyer des messages de cœur), il est effectivement indisponible car il ne peut pas engager de nouvelles propositions ; il attend le disque lent. Si le cluster perd fréquemment son leader en raison de latences disque, essayez tuning les paramètres du disque ou les paramètres temporels d’etcd.
Que signifie l’avertissement etcd « request ignored (cluster ID mismatch) » ?
Chaque nouveau cluster etcd génère un nouvel identifiant de cluster basé sur la configuration initiale du cluster et une valeur initial-cluster-token fournie par l’utilisateur. En disposant d’identifiants de cluster uniques, etcd est protégé contre les interactions entre clusters qui pourraient corrompre le cluster.
Ce avertissement se produit généralement après avoir supprimé un ancien cluster, puis réutilisé certaines adresses de pair pour le nouveau cluster. Si un processus etcd de l’ancien cluster est toujours en cours d’exécution, il tentera de contacter le nouveau cluster. Le nouveau cluster détectera une incompatibilité d’ID de cluster, ignorerait la requête et émettrait cet avertissement. Ce message d’avertissement est souvent résolu en veillant à ce que les adresses de pair entre des clusters distincts soient disjointes.
Que signifie « mvcc : espace de base de données dépassé » et comment le corriger ?
Le modèle de données contrôle de concurrence multiversion
d’etcd conserve l’historique complet de l’espace de clés. Sans effectuer régulièrement un compactage de cet historique (par exemple en définissant --auto-compaction), etcd finira par épuiser l’espace de stockage. Si etcd manque d’espace de stockage, il déclenche une alarme de quota d’espace afin de protéger le cluster contre des écritures ultérieures. Tant que cette alarme est active, etcd répond aux requêtes d’écriture par l’erreur mvcc: database space exceeded.
Pour récupérer après l’alarme de quota d’espace faible :
- Compacter l’historique d’etcd.
- Défragmenter chaque point de terminaison etcd.
- Désarmer l’alarme.
Que signifie l’avertissement etcd “etcdserver/api/v3rpc: transport : http2Server.HandleStreams a échoué à lire le cadre : lecture tcp 127.0.0.1:2379->127.0.0.1:43020 : lecture : connexion réinitialisée par la partie distante” ?
Il s’agit d’un avertissement côté gRPC lorsque le serveur reçoit un drapeau TCP RST alors que les flux côté client sont fermés prématurément. Par exemple, un client ferme sa connexion alors que le serveur gRPC n’a pas encore traité tous les cadres HTTP/2 dans la file d’attente TCP. Une partie des données peut avoir été perdue côté serveur, mais cela est acceptable tant que la connexion cliente a déjà été fermée.
Seules les anciennes versions de gRPC
journalisent cet avertissement. À partir de v3.2.13, etcd le journalise par défaut au niveau DEBUG
; il n’est donc visible que lorsque l’option --log-level=debug est activée.
Performances
Comment puis-je effectuer des tests de charge sur etcd ?
Essayez l’outil benchmark . Les résultats actuels du benchmark sont disponibles pour comparaison.
Que signifie l’avertissement etcd « apply entries took too long » ?
Une fois qu’une majorité des membres etcd a accepté de valider une requête, chaque serveur etcd applique la requête à son magasin de données et persiste le résultat sur le disque. Même avec un disque mécanique lent ou un disque réseau virtualisé, tel qu’EBS d’Amazon ou PD de Google, l’application d’une requête devrait normalement prendre moins de 50 millisecondes. Si la durée moyenne d’application dépasse 100 millisecondes, etcd émettra un avertissement indiquant que les entrées mettent trop de temps à être appliquées.
Ce problème est généralement dû à un disque lent. Le disque pourrait subir une contention entre etcd et d’autres applications, ou être trop lent en soi (par exemple, un disque virtuel partagé). Pour écarter la possibilité qu’un disque lent soit à l’origine de cet avertissement, surveillez backend_commit_duration_seconds (la durée p99 doit être inférieure à 25 ms) afin de vérifier que le disque est suffisamment rapide. Si le disque est trop lent, attribuer un disque dédié à etcd ou utiliser un disque plus rapide résout généralement le problème.
La deuxième cause la plus fréquente est la famine de CPU. Si la surveillance de l’utilisation du CPU de la machine révèle une utilisation élevée, il se peut qu’il ne reste pas assez de capacité de calcul pour etcd. Déplacer etcd vers une machine dédiée, augmenter l’isolation des ressources du processus via cgroups, ou ajuster la priorité du processus serveur etcd à un niveau supérieur peut généralement résoudre le problème.
Les requêtes utilisateur coûteuses qui accèdent à trop de clés (par exemple, la récupération de l’intégralité de l’espace de clés) peuvent également entraîner des latences d’application élevées. Toutefois, accéder à moins de quelques centaines de clés par requête devrait toujours être performant.
Si aucune des suggestions ci-dessus ne permet de supprimer les avertissements, veuillez ouvrir un problème en incluant des journaux détaillés, des informations de surveillance, des métriques et éventuellement des informations sur la charge de travail.
Que signifie l’avertissement etcd « failed to send out heartbeat on time » ?
etcd utilise un protocole de consensus basé sur un leader pour assurer une réplication de données cohérente et l’exécution du journal. Les membres du cluster élisent un seul leader, tous les autres membres deviennent des suiveurs. Le leader élis par périodicité doit envoyer régulièrement des signaux de vie à ses suiveurs afin de maintenir son leadership. Les suiveurs détectent une panne du leader s’ils ne reçoivent aucun signal de vie dans l’intervalle d’élection et déclenchent alors une nouvelle élection. Si un leader ne parvient pas à envoyer ses signaux de vie à temps, mais qu’il est toujours en cours d’exécution, l’élection est erronée et probablement due à un manque de ressources. Pour détecter ces défaillances douces, si le leader saute deux intervalles de signal de vie, etcd émettra un avertissement indiquant qu’il a échoué à envoyer un signal de vie à temps.
Ce problème est généralement dû à un disque lent. Avant que le leader n’envoie des messages de battement de cœur accompagnés de métadonnées, celui-ci peut nécessiter de persister ces métadonnées sur le disque. Le disque peut subir une contention entre etcd et d’autres applications, ou être trop lent (par exemple, un disque virtuel partagé). Pour éliminer la possibilité qu’un disque lent soit à l’origine de cet avertissement, surveillez wal_fsync_duration_seconds (la durée p99 doit être inférieure à 10 ms) afin de confirmer que le disque est suffisamment rapide. Si le disque est trop lent, affecter un disque dédié à etcd ou utiliser un disque plus rapide résout généralement le problème. Pour déterminer si un disque est assez rapide pour etcd, un outil de benchmark tel que fio peut être utilisé. Consultez ici pour un exemple.
La deuxième cause la plus fréquente est la famine de CPU. Si la surveillance de l’utilisation du CPU de la machine révèle une utilisation élevée, il se peut qu’il ne reste pas assez de capacité de calcul pour etcd. Déplacer etcd vers une machine dédiée, augmenter l’isolation des ressources du processus à l’aide de cgroups, ou ajuster la priorité du processus serveur etcd à un niveau supérieur peut généralement résoudre le problème.
Un réseau lent peut également provoquer ce problème. Si les métriques réseau entre les machines etcd indiquent des latences élevées ou un taux élevé de pertes de paquets, il se peut qu’il ne reste pas assez de capacité réseau pour etcd. Déplacer les membres etcd vers un réseau moins congestionné résout généralement le problème. Toutefois, si le cluster etcd est déployé entre plusieurs centres de données, des latences élevées entre les membres sont normales. Dans de tels déploiements, ajustez la configuration heartbeat-interval pour qu’elle corresponde approximativement au temps de trajet aller-retour entre les machines, et configurez election-timeout de manière à ce qu’elle soit au moins égale à 5 × heartbeat-interval. Consultez la documentation de réglage
pour plus de détails.
Si aucune des suggestions ci-dessus ne permet de supprimer les avertissements, veuillez ouvrir un problème en incluant des journaux détaillés, des informations de surveillance, des métriques et éventuellement des informations sur la charge de travail.
Que signifie l’avertissement etcd « la sauvegarde instantanée prend plus de x secondes pour se terminer » ?
etcd envoie un instantané de son magasin clé-valeur complet pour rafraîchir les suiveurs lents et effectuer des sauvegardes . Des délais de transfert d’instantané lents augmentent le temps de récupération après panne (MTTR) ; si le cluster reçoit des données à haut débit, les suiveurs lents peuvent entrer en blocage actif en nécessitant un nouvel instantané avant d’avoir terminé la réception d’un instantané précédent. Pour détecter les performances lentes d’instantané, etcd émet un avertissement lorsque l’envoi d’un instantané prend plus de trente secondes et dépasse le temps de transfert attendu pour une connexion 1 Gbps.
7 - Bibliothèques et outils
Notez que les bibliothèques et outils tiers (non hébergés sur https://github.com/etcd-io ) mentionnés ci-dessous ne sont pas testés ni entretenus par l’équipe etcd. Avant de les utiliser, les utilisateurs sont invités à les lire et à les examiner.
Outils
- etcdctl - Client en ligne de commande pour etcd
- etcd-dump - Utilitaire en ligne de commande pour sauvegarder/restaurer etcd.
- etcd-fs - Système de fichiers FUSE pour etcd
- etcddir - Synchronisation en temps réel entre etcd et un répertoire local. Fonctionne sous Windows et Linux.
- etcd-browser - Éditeur web de magasin clé-valeur pour etcd utilisant AngularJS
- etcd-lock - Implémentation d’élection de maître et de verrouillage lecture/écriture distribué utilisant etcd - Prend en charge la version 2
- etcd-console - Éditeur web de magasin clé-valeur pour etcd utilisant PHP
- etcd-viewer - Éditeur/visualiseur de magasin clé-valeur etcd écrit en Java
- etcdtool - Export/Import/Edit répertoire etcd en tant que JSON/YAML/TOML et validation du répertoire à l’aide d’un schéma JSON
- etcdloadtest - Client de test de charge en ligne de commande pour etcd 3.0 et versions ultérieures
- etcd-tui - Une interface utilisateur moderne en mode terminal (TUI) pour interagir avec votre base de données etcd. Parcourez les clés, affichez les valeurs, filtrez les données et gérez votre cluster etcd directement depuis votre terminal.
- etcdfinder - Une interface web moderne et ultra-rapide pour etcd, avec recherche instantanée. Prend en charge à la fois etcd v2 et v3.
- lucas - Un visualiseur de paires clé-valeur basé sur web pour les clusters etcd3.0+ de Kubernetes.
- etcd-manager - Outil graphique et client moderne, efficace, multiplateforme et gratuit pour etcd 3.x. Disponible pour Windows, Linux et Mac.
- etcd-backup-restore - Utilitaire permettant de sauvegarder et de restaurer de manière périodique et incrémentielle etcd.
- etcd-druid - Opérateur Kubernetes permettant de déployer des clusters etcd et de gérer les opérations de gestion de jour 2.
- etcdadm - Outil en ligne de commande pour gérer un cluster etcd.
- etcd-defrag - Outil de défragmentation etcd plus facile à utiliser et plus intelligent.
- etcdhelper - Plugin pour la plateforme IntelliJ pour etcd.
Bibliothèques
Les sections ci-dessous listent les bibliothèques clientes etcd par langage.
Go
- etcd/client/v3 - le client Go officiellement maintenu pour la version v3
- go-etcd - le client officiel déprécié. Peut être utile pour les versions plus anciennes (<2.0.0) d’etcd.
- encWrapper - encWrapper est une enveloppe de chiffrement pour l’API Keys du client etcd/KV.
Java
- coreos/jetcd - Prise en charge de la version 3
- justinsb/jetcd
- cdancy/etcd-rest - Utilise jclouds pour offrir une implémentation complète de l’API version 2.
- IBM/etcd-java
Scala
- maciej/etcd-client - Prise en charge de la version 2. Client entièrement asynchrone basé sur Akka HTTP
- eiipii/etcdhttpclient - Prise en charge de la version 2. Client HTTP asynchrone basé sur Netty et les futures Scala.
- mingchuno/etcd4s - Prise en charge de la version 3 via gRPC, avec prise en charge optionnelle d’Akka Stream.
Perl
- hexfusion/perl-net-etcd - Prise en charge de l’API HTTP du passerelle gRPC v3
- robn/p5-etcd - Prise en charge de la version 2
Python
- kragniz/python-etcd3 - Client pour la version 3
- jplana/python-etcd - Prise en charge de la version 2
- russellhaering/txetcd - Bibliothèque Python Twisted
- cholcombe973/autodock - Outil d’automatisation du déploiement Docker
- lisael/aioetcd - Client basé sur des coroutines asyncio (Python 3.4+) (Prise en charge de la version 2)
- txaio-etcd - Bibliothèque cliente asynchrone pour etcd v3 uniquement, pour Twisted (actuellement) et asyncio (à venir)
- dims/etcd3-gateway - Bibliothèque d’API etcd v3 utilisant la passerelle HTTP grpc
- aioetcd3 - API etcd v3 pour asyncio (Python 3.6+)
- Revolution1/etcd3-py - Client Python pour etcd v3 (python2.7 et python3.5+), utilisant gRPC-JSON-Gateway
Nœud
- mixer/etcd3 - Prise en charge de la version 3
- stianeikeland/node-etcd - Prise en charge de la version 2 (avec CoffeeScript)
- lavagetto/nodejs-etcd - Prise en charge de la version 2
- deedubs/node-etcd-config - Prise en charge de la version 2
Ruby
- iconara/etcd-rb
- jpfuentes2/etcd-ruby
- ranjib/etcd-ruby - Prise en charge de la version 2
- davissp14/etcdv3-ruby - Prise en charge de la version 3
C
- apache/celix/etcdlib - Prise en charge de la version 2
- jdarcy/etcd-api - Prise en charge de la version 2
- shafreeck/cetcd - Prise en charge de la version 2
C++
- edwardcapriolo/etcdcpp - Prise en charge de la version 2
- suryanathan/etcdcpp - Prise en charge de la version 2 (avec attentes)
- nokia/etcd-cpp-api - Prise en charge de la version 2
- etcd-cpp-apiv3/etcd-cpp-apiv3 - Prise en charge de la version 3
Clojure
- aterreno/etcd-clojure
- dwwoelfel/cetcd - Prise en charge de la version 2
- rthomas/clj-etcd - Prise en charge de la version 2
Erlang
- marshall-lee/etcd.erl - Prise en charge de la version 2
- zhongwencool/eetcd - Prise en charge de la version 3+ (GRPC uniquement)
Élixir
- team-telnyx/etcdex - Prise en charge des versions v3+ (GRPC uniquement)
.NET
- wangjia184/etcdnet - Prise en charge de la version 2
- drusellers/etcetera
- shubhamranjan/dotnet-etcd - Prise en charge de la version 3+ (GRPC uniquement)
- SimplifyNet/Etcd.Microsoft.Extensions.Configuration
PHP
- linkorb/etcd-php
- activecollab/etcd
- ouqiang/etcd-php - Client pour la passerelle gRPC v3
Haskell
R
Nim
Tcl
- efrecon/etcd-tcl - Prise en charge des versions v2, à l’exception de wait.
Rust
- jimmycuadra/rust-etcd - Prise en charge de la version 2
Gradle
- gradle-etcd-rest-plugin - Prise en charge de la version 2
Lua
- api7/lua-resty-etcd - Prise en charge des versions v2 et v3 (API HTTP via passerelle gRPC)
Outils de déploiement
Intégrations Chef
Recettes Chef
Libérations BOSH
Projets utilisant etcd
- Utilisateurs Raft etcd - projets utilisant l’implémentation de la bibliothèque Raft d’etcd.
- Apache APISIX - une passerelle API qui utilise etcd comme magasin de configuration.
- apache/celix - une implémentation de la spécification OSGi adaptée au C et au C++
- binocarlos/yoda - etcd + ZeroMQ
- blox/blox - une collection de projets open source pour la gestion et l’orchestration de conteneurs avec AWS ECS
- calavera/active-proxy - proxy HTTP configuré avec etcd
- chain/chain - logiciel conçu pour fonctionner et se connecter à des réseaux de blockchains permissionnées hautement évolutifs
- derekchiang/etcdplus - Un ensemble de primitives de synchronisation distribuée basées sur etcd
- go-discover - Découverte de services en Go
- gleicon/goreman - Branche du clone Go Foreman avec prise en charge d’etcd
- garethr/hiera-etcd - Backend Puppet Hiera utilisant etcd
- mattn/etcd-vim - Définir et lire des clés depuis l’intérieur de vim
- mattn/etcdenv - Shebang « env » avec intégration à etcd
- kelseyhightower/confd - Gérer les fichiers de configuration d’applications locales à l’aide de modèles et de données provenant d’etcd
- configdb - Une abstraction relationnelle REST au-dessus de backends de bases de données arbitraires, destinée au stockage de configurations et d’inventaires.
- kubernetes/kubernetes - Gestionnaire de cluster conteneurs développé par Google.
- mailgun/vulcand - Proxy HTTP utilisant etcd comme backend de configuration.
- duedil-ltd/discodns - Serveur DNS simple utilisant etcd comme base de données pour les noms et les enregistrements.
- skynetservices/skydns - Serveur DNS conforme aux RFC
- xordataexchange/crypt - Stocker en toute sécurité des valeurs dans etcd à l’aide du chiffrement GPG
- spf13/viper - Bibliothèque de configuration Go, lit les valeurs depuis les variables d’environnement, les drapeaux pflags, les fichiers et etcd, avec chiffrement facultatif
- lytics/metafora - Bibliothèque Go de tâches distribuées
- ryandoyle/nss-etcd - Module NSS GNU libc pour résoudre les noms à partir d’etcd.
- Gru - Orchestration simplifiée avec Go
- Vitess - Vitess est un système de clustering de bases de données pour le dimensionnement horizontal de MySQL.
- lclarkmichalek/etcdhcp - Serveur DHCP utilisant etcd pour la persistance et la coordination.
- openstack/networking-vpp - Un pilote de réseau qui programme le plan de données FD.io VPP afin de fournir le réseau virtuel cloud OpenStack
- OpenStack - Les services OpenStack peuvent s’appuyer sur etcd comme service de base.
- CoreDNS - CoreDNS est un serveur DNS qui chaîne des plugins, membre du CNCF et de Kubernetes
- Uber M3 - M3 : plateforme open source à grande échelle pour les métriques, développée par Uber, compatible Prometheus
- Rook - Orchestration du stockage pour Kubernetes
- Patroni - Modèle pour la haute disponibilité de PostgreSQL avec ZooKeeper, etcd ou Consul
- Trillian - Trillian implémente un arbre de Merkle dont le contenu est fourni par une couche de stockage de données, afin de permettre une évolutivité à des arbres extrêmement volumineux.
- purpleidea/mgmt - Gestion de configuration distribuée, événementielle et parallèle de nouvelle génération !
- Portworx/kvdb - Le kvdb interne destiné au stockage de la configuration du cluster Portworx.
- Apache Pulsar - Apache Pulsar est une plateforme de messagerie et de diffusion en continu open source, distribuée, conçue pour le cloud.
8 - Métriques
etcd utilise Prometheus pour le reporting des métriques. Ces métriques peuvent être utilisées pour la surveillance en temps réel et le débogage. etcd ne persiste pas ses métriques ; si un membre est redémarré, les métriques seront réinitialisées.
La manière la plus simple de consulter les métriques disponibles consiste à utiliser cURL sur le point de terminaison des métriques /metrics. Le format est décrit dans la documentation Prometheus
.
Suivez le document de démarrage rapide de Prometheus pour mettre en place un serveur Prometheus afin de collecter les métriques etcd.
Le nommage des métriques suit les bonnes pratiques Prometheus
recommandées. Un nom de métrique porte un préfixe etcd ou etcd_debugging en tant qu’espace de noms, ainsi qu’un préfixe de sous-système (par exemple wal et etcdserver).
etcd espace de noms métriques
Les métriques sous le préfixe etcd sont destinées à la surveillance et à l’alerte. Il s’agit de métriques stables de haut niveau. Tout changement apporté à ces métriques sera mentionné dans les notes de version.
Les métriques liées à etcd2 sont documentées dans le guide des métriques v2 .
Serveur
Ces métriques décrivent l’état du serveur etcd. Pour détecter les interruptions ou les problèmes en vue du dépannage, les métriques du serveur de chaque cluster etcd en production doivent être surveillées de près.
Toutes ces métriques sont préfixées par etcd_server_
| Nom | Description | Type |
|---|---|---|
| has_leader | Indique si un leader existe. 1 signifie qu’il existe, 0 qu’il n’existe pas. | Gauge |
| leader_changes_seen_total | Nombre de changements de leader observés. | Counter |
| proposals_committed_total | Nombre total de propositions de consensus validées. | Gauge |
| proposals_applied_total | Nombre total de propositions de consensus appliquées. | Gauge |
| proposals_pending | Nombre actuel de propositions en attente. | Gauge |
| proposals_failed_total | Nombre total de propositions défaillantes observées. | Counter |
has_leader indique si le membre dispose d’un leader. Si un membre ne dispose pas de leader, il est entièrement indisponible. Si aucun membre du cluster ne dispose de leader, l’ensemble du cluster est entièrement indisponible.
leader_changes_seen_total compte le nombre de changements de leader observés par le membre depuis son démarrage. Un nombre élevé de changements de leader affecte fortement les performances d’etcd. Cela indique également qu’un leader est instable, probablement à cause de problèmes de connectivité réseau ou d’une charge excessive sur le cluster etcd.
proposals_committed_total enregistre le nombre total de propositions de consensus validées. Ce compteur doit augmenter au fil du temps si le cluster est sain. Plusieurs membres sains d’un cluster etcd peuvent avoir un nombre différent de propositions validées à un instant donné. Cette différence peut être due à une récupération après le démarrage, à un retard par rapport au leader, ou au fait d’être le leader et donc d’avoir le plus grand nombre de validations. Il est important de surveiller cette métrique sur tous les membres du cluster ; un retard important et persistant entre un membre et son leader indique que ce membre est lent ou défaillant.
proposals_applied_total enregistre le nombre total de propositions de consensus appliquées. Le serveur etcd applique chaque proposition validée de manière asynchrone. La différence entre proposals_committed_total et proposals_applied_total devrait généralement être faible (de quelques milliers, même sous charge élevée). Si cette différence continue de croître, cela indique que le serveur etcd est surchargé. Cela peut se produire lors de l’application de requêtes coûteuses, comme des requêtes de plage importantes ou des opérations de transaction volumineuses.
proposals_pending indique le nombre de propositions en attente de validation. Une augmentation du nombre de propositions en attente suggère une charge élevée des clients ou un membre incapable de valider les propositions.
proposals_failed_total sont généralement liés à deux problèmes : des défaillances temporaires liées à une élection du leader ou une interruption prolongée causée par la perte du quorum dans le cluster.
Disque
Ces métriques décrivent l’état des opérations sur le disque.
Toutes ces métriques sont préfixées par etcd_disk_.
| Nom | Description | Type |
|---|---|---|
| wal_fsync_duration_seconds | Les distributions de latence de fsync appelées par le WAL | Histogramme |
| backend_commit_duration_seconds | Les distributions de latence de commit appelées par le backend | Histogramme |
Un wal_fsync est appelé lorsque etcd persiste ses entrées de journal sur le disque avant de les appliquer.
Un backend_commit est appelé lorsque etcd effectue le commit d’un instantané incrémentiel de ses modifications les plus récentes sur le disque.
Des latences élevées des opérations sur le disque (wal_fsync_duration_seconds ou backend_commit_duration_seconds) indiquent souvent des problèmes de disque. Cela peut entraîner une latence élevée des requêtes ou rendre le cluster instable.
Réseau
Ces métriques décrivent l’état du réseau.
Toutes ces métriques sont préfixées par etcd_network_
| Nom | Description | Type |
|---|---|---|
| peer_sent_bytes_total | Nombre total d’octets envoyés au pair dont l’ID est To. | Compteur(À) |
| peer_received_bytes_total | Nombre total d’octets reçus du pair dont l’ID est From. | Compteur(De) |
| peer_sent_failures_total | Nombre total d’échecs d’envoi provenant du pair dont l’ID est To. | Compteur(À) |
| peer_received_failures_total | Nombre total d’échecs de réception provenant du pair dont l’ID est From. | Compteur(De) |
| peer_round_trip_time_seconds | Histogramme du temps de trajet aller-retour entre pairs. | Histogramme(À) |
| client_grpc_sent_bytes_total | Nombre total d’octets envoyés aux clients gRPC. | Compteur |
| client_grpc_received_bytes_total | Nombre total d’octets reçus par les clients gRPC. | Compteur |
peer_sent_bytes_total compte le nombre total d’octets envoyés à un pair spécifique. En général, le membre leader envoie plus de données que les autres membres, car il est chargé de transmettre les données répliquées.
peer_received_bytes_total compte le nombre total d’octets reçus d’un pair spécifique. En général, les membres suiveurs reçoivent des données uniquement du membre leader.
Requêtes gRPC
Ces métriques sont exposées via go-grpc-prometheus .
métriques de débogage de l’espace de noms etcd
Les métriques sous le préfixe etcd_debugging sont destinées au débogage. Elles sont très dépendantes de l’implémentation et instables. Elles pourraient être modifiées ou supprimées sans avertissement dans de nouvelles versions d’etcd. Certaines de ces métriques pourraient être déplacées vers le préfixe etcd lorsqu’elles deviendront plus stables.
instantané
| Nom | Description | Type |
|---|---|---|
| snapshot_save_total_duration_seconds | Les distributions de latence totale de l’appel save effectué par snapshot | Histogramme |
Une durée d’instantané anormalement élevée (snapshot_save_total_duration_seconds) indique des problèmes de disque et pourrait entraîner une instabilité du cluster.
Métriques fournies par Prometheus
La bibliothèque cliente Prometheus fournit un certain nombre de métriques dans les espaces de noms go et process. Quelques-unes sont particulièrement intéressantes.
| Nom | Description | Type |
|---|---|---|
| process_open_fds | Nombre de descripteurs de fichiers ouverts. | Gauge |
| process_max_fds | Nombre maximal de descripteurs de fichiers ouverts. | Gauge |
Les métriques relatives au processus, telles que process_open_fds et process_max_fds, ne sont pas prises en charge sur les systèmes Darwin (macOS) pour l’instant.
Une utilisation importante des descripteurs de fichiers (process_open_fds) (c’est-à-dire proche de la limite de descripteurs de fichiers du processus, process_max_fds) indique un problème potentiel d’épuisement des descripteurs de fichiers. Si les descripteurs de fichiers sont épuisés, etcd peut planter car il ne pourra pas créer de nouveaux fichiers WAL.
Liste générée des métriques
9 - Signalement de bogues
Si une partie du projet etcd présente des bogues ou des erreurs de documentation, veuillez nous en informer en ouvrant une demande . Nous prenons très au sérieux les bogues et les erreurs, et considérons qu’aucun problème n’est trop petit. Avant de créer un rapport de bogue, veuillez vérifier qu’une demande signalant le même problème n’existe pas déjà.
Pour que le rapport de bogues soit précis et facile à comprendre, veuillez essayer de rédiger des rapports de bogues qui sont :
Spécifique. Inclure autant de détails que possible : version utilisée, environnement, configuration, etc. Si le bug est lié à l’exécution du serveur etcd, veuillez joindre le journal d’etcd (le journal de démarrage avec la configuration d’etcd est particulièrement important).
Reproductible. Incluez les étapes permettant de reproduire le problème. Nous comprenons que certains problèmes peuvent être difficiles à reproduire ; veuillez inclure les étapes qui pourraient mener au problème. Si possible, joignez le répertoire de données etcd affecté ainsi que la trace d’empilement (stack strace) au rapport de bogues.
Isolé. Essayez de reproduire le bug en minimisant les dépendances. Un nombre trop élevé de dépendances dans un rapport de bug ralentit considérablement la résolution. Le débogage des systèmes externes qui dépendent d’etcd est hors sujet, mais nous sommes heureux de fournir des indications dans la bonne direction ou d’aider à utiliser etcd lui-même.
Unique. Ne pas dupliquer le rapport de bogues existant.
Étendu. Un seul bogue par rapport. Ne pas faire de suivi avec un autre bogue dans un même rapport.
Il peut être utile de lire l’article d’Elika Etemad sur la rédaction de bons rapports de bogues avant de créer un rapport.
Nous pouvons demander des informations supplémentaires pour localiser un bogue. Un rapport de bogue en double sera fermé.
Questions fréquemment posées
Comment obtenir une trace de pile
Comment obtenir la version d’etcd
Comment obtenir la configuration et les journaux d’état d’etcd lorsqu’il s’exécute en tant que service systemd « etcd2.service »
En raison d’un bogue upstream dans systemd, journald peut manquer les dernières lignes de journal lorsque ses processus se terminent. Si journalctl indique que etcd s’est arrêté sans message d’erreur ou d’incident critique, essayez sudo journalctl -f -t etcd2 afin d’obtenir la totalité du journal.
10 - Optimisation
Les paramètres par défaut d’etcd devraient fonctionner correctement pour les installations sur un réseau local où la latence réseau moyenne est faible. Toutefois, lors de l’utilisation d’etcd sur plusieurs centres de données ou sur des réseaux à forte latence, il se peut que les paramètres d’intervalle de battement et de délai d’élection nécessitent une adaptation.
Le réseau n’est pas la seule source de latence. Chaque requête et réponse peut être affectée par des disques lents sur le leader et le suiveur. Chacun de ces délais d’attente représente le temps total écoulé entre la requête et la réponse réussie de l’autre machine.
Paramètres de temps
Le protocole de consensus distribué sous-jacent repose sur deux paramètres temporels distincts pour garantir qu’un nœud peut transférer la direction si un autre stagne ou devient hors ligne. Le premier paramètre s’appelle l’Intervalle de battement. Il correspond à la fréquence à laquelle le leader informe les suiveurs qu’il est toujours en fonction.
Pour les bonnes pratiques, ce paramètre doit être réglé autour du temps de trajet aller-retour entre les membres. Par défaut, etcd utilise un intervalle de battement de 100ms.
Le deuxième paramètre est le Délai d’élection. Ce délai indique combien de temps un suiveur attend sans recevoir de battement de cœur avant de tenter de devenir leader lui-même. Par défaut, etcd utilise un délai d’élection 1000ms.
Ajuster ces valeurs constitue un compromis. La valeur de l’intervalle de battement doit être d’environ le maximum du temps de trajet moyen (RTT) entre les membres, généralement comprise entre 0,5 et 1,5 fois le temps de trajet. Si l’intervalle de battement est trop faible, etcd enverra des messages inutiles, ce qui augmente la consommation de ressources CPU et réseau. À l’inverse, un intervalle de battement trop élevé entraîne un délai d’élection élevé. Un délai d’élection plus élevé prolonge le temps nécessaire à la détection d’une panne du leader. La méthode la plus simple pour mesurer le temps de trajet (RTT) consiste à utiliser l’utilitaire PING .
Le délai d’élection doit être réglé en fonction de l’intervalle de battement et du temps de trajet moyen entre les membres. Les délais d’élection doivent être au moins dix fois supérieurs au temps de trajet pour tenir compte des variations du réseau. Par exemple, si le temps de trajet entre les membres est de 10 ms, le délai d’élection doit être d’au moins 100 ms.
La limite supérieure du délai d’élection est de 50000 ms (50 s), qui ne doit être utilisée qu’en cas de déploiement d’un cluster etcd distribué à l’échelle mondiale. Un délai de trajet aller-retour raisonnable pour les États-Unis continentaux est de 130 ms, et le délai entre les États-Unis et le Japon est d’environ 350 à 400 ms. Si le réseau présente des performances inégales ou des pertes régulières de paquets delays/loss, il se peut qu’une ou deux tentatives soient nécessaires pour envoyer correctement un paquet. Ainsi, 5 s constitue une limite supérieure raisonnable pour le délai de trajet global. Étant donné que le délai d’élection doit être d’un ordre de grandeur supérieur au délai de diffusion, dans le cas d’un cluster réparti à l’échelle mondiale avec un délai d’environ 5 s, une durée maximale de 50 secondes devient raisonnable.
L’intervalle de battement et la durée d’élection doivent être identiques pour tous les membres d’un cluster. Définir des valeurs différentes pour les membres etcd peut perturber la stabilité du cluster.
Les valeurs par défaut peuvent être remplacées en ligne de commande :
Les valeurs sont indiquées en millisecondes.
Instantanés
etcd ajoute toutes les modifications de clés à un fichier journal. Ce journal s’étend indéfiniment et constitue un historique linéaire complet de chaque modification apportée aux clés. Un historique complet fonctionne bien pour les clusters peu utilisés, mais les clusters fortement utilisés doivent maintenir un grand journal.
Pour éviter d’avoir un journal très volumineux, etcd effectue des instantanés périodiques. Ces instantanés permettent à etcd de compacter le journal en enregistrant l’état actuel du système et en supprimant les anciens journaux.
Optimisation des instantanés
La création d’instantanés avec le backend V2 peut être coûteuse, les instantanés ne sont donc créés qu’après un nombre donné de modifications apportées à etcd. Par défaut, un instantané est effectué après chaque 10 000 modifications. Si l’utilisation mémoire ou disque d’etcd est trop élevée, essayez de réduire le seuil d’instantané en définissant la commande suivante en ligne de commande :
Disque
Un cluster etcd est très sensible aux latences disque. Étant donné qu’etcd doit persister les propositions dans son journal, l’activité disque provoquée par d’autres processus peut entraîner de longues latences fsync. En conséquence, etcd peut manquer des battements, provoquant des délais d’attente des requêtes et une perte temporaire du leader. Un serveur etcd peut parfois fonctionner de manière stable aux côtés de ces processus lorsqu’il bénéficie d’une priorité disque élevée.
Sur Linux, la priorité du disque d’etcd peut être configurée avec ionice :
Réseau
Si le leader etcd traite un grand nombre de requêtes clientes concurrentes, il peut retarder le traitement des requêtes de pair suiveur en raison de la congestion du réseau. Cela se manifeste par des messages d’erreur de tampon d’envoi sur les nœuds suiveurs :
Ces erreurs peuvent être résolues en priorisant le trafic pair de etcd par rapport au trafic client. Sur Linux, le trafic pair peut être priorisé en utilisant le mécanisme de contrôle du trafic :
Pour annuler tc, exécutez :
CPU
Comme etcd est très sensible à la latence, les performances peuvent être optimisées davantage sur les systèmes Linux en définissant le régulateur CPU sur le mode performance ou conservateur.
Sous Linux, le gouverneur du processeur peut être configuré en mode performance :
11 - Internes
11.1 - Protocole du service de découverte
Le protocole de service de découverte aide un nouveau membre etcd à découvrir tous les autres membres du cluster pendant la phase d’initialisation, en utilisant un jeton de découverte partagé et une liste d’extrémités.
Le protocole de service de découverte n’est utilisé que pendant la phase d’amorçage du cluster, et ne peut pas être utilisé pour la reconfiguration en temps réel ou la surveillance du cluster.
Le protocole utilise un nouveau jeton de découverte pour initialiser un unique cluster etcd. Souvenez-vous qu’un jeton de découverte ne peut représenter qu’un seul cluster etcd. Dès que le protocole de découverte associé à ce jeton est lancé, même s’il échoue en cours de route, il ne doit pas être utilisé pour initialiser un autre cluster etcd.
Le reste de cet article explique le processus de découverte à l’aide d’exemples correspondant à un cluster de découverte auto-hébergé.
Notez que ce document ne concerne que la découverte v3. Consultez le document précédent pour plus de détails sur la découverte v2 .
Flot de protocole
L’idée du protocole de découverte consiste à utiliser un cluster etcd interne pour coordonner le démarrage d’un nouveau cluster. Tout d’abord, tous les nouveaux membres interagissent avec le service de découverte et contribuent à générer la liste de membres attendue. Ensuite, chaque nouveau membre démarre son serveur en utilisant cette liste, ce qui permet d’obtenir la même fonctionnalité que l’option -initial-cluster.
Dans le flux d’exemple suivant, nous allons lister chaque étape du protocole à l’aide de la commande etcdctl afin de faciliter la compréhension, et nous supposons que l’hôte http://example.com:2379 héberge un cluster etcd pour le service de découverte.
Par convention, le protocole de découverte etcd utilise le préfixe de clé /_etcd/registry.
Création d’un nouveau jeton de découverte
Générez un jeton unique qui identifiera le nouveau cluster. Ce jeton sera utilisé comme préfixe unique dans l’espace de clés de découverte aux étapes suivantes. Une méthode simple consiste à utiliser uuidgen :
Spécification de la taille attendue du cluster
Le jeton de découverte attend une taille de cluster qui doit être précisée. Cette taille est utilisée par le service de découverte pour savoir quand il a trouvé tous les membres qui formeront initialement le cluster.
En général, la taille du cluster est de 3, 5 ou 7. Consultez taille optimale du cluster pour plus de détails.
Mise en marche des processus etcd
Définissez le jeton de découverte ${UUID} sur le drapeau --discovery-token, et définissez les points d’accès du cluster etcd qui prend en charge le service de découverte sur le drapeau --discovery-endpoints. Cela activera la découverte v3 pour amorcer le cluster etcd.
Chaque processus etcd suivra les étapes internes suivantes si les indicateurs --discovery-token et --discovery-endpoints sont fournis.
Si le service de découverte active l’authentification par certificat client, configurez les indicateurs suivants. Leur utilisation suit exactement le même schéma que l’utilisation de etcdctl pour communiquer avec un cluster etcd.
Si le service de découverte active l’authentification basée sur les rôles, configurez les indicateurs suivants. Leur utilisation suit exactement le même schéma que l’utilisation de etcdctl pour communiquer avec un cluster etcd.
Les valeurs par défaut de temps ou de délai d’attente peuvent également être modifiées à l’aide des drapeaux suivants, qui s’utilisent exactement de la même manière que etcdctl pour communiquer avec un cluster etcd.
S’enregistrer lui-même
La première action entreprise par chaque processus etcd consiste à s’inscrire dans le cluster nouvellement créé en tant que membre. Cela se fait en créant l’ID de membre comme clé dans la clé de registre complète.
Vérification du statut
Il vérifie la taille attendue du cluster et l’état d’inscription, puis détermine l’action suivante.
Si le nombre de membres enregistrés reste insuffisant, l’attente sera poursuivie jusqu’à l’apparition d’autres membres.
Si le nombre de membres enregistrés est supérieur à la taille attendue N, le système considère les N premiers membres enregistrés comme la liste des membres du cluster. Si le membre lui-même figure dans cette liste, la procédure de découverte réussit, et il récupère tous les pairs à partir de la liste des membres. Sinon, la procédure de découverte échoue, car le cluster est plein.
Le membre peut vérifier l’état du cluster même avant de s’être enregistré. Il peut donc échouer rapidement si le cluster est plein.
En attente de tous les membres
Le processus d’attente continue à surveiller le préfixe de clé /_etcd/registry/${UUID}/members jusqu’à la découverte de tous les membres.
11.2 - Conventions de journalisation
etcd utilise la bibliothèque zap pour la journalisation de la sortie de l’application, catégorisée en niveaux. Le niveau d’un message de journalisation est déterminé selon les conventions suivantes :
Les journaux DebugLevel sont généralement volumineux et sont habituellement désactivés en production.
- Exemples :
- Envoyer un message normal à un pair distant
- Écrire une entrée de journal sur le disque
- Exemples :
InfoLevel est la priorité de journalisation par défaut.
- Exemples :
- Configuration au démarrage
- Effectuer un instantané
- Ajouter un nouveau nœud au cluster
- Ajouter un nouvel utilisateur au sous-système d’authentification
- Exemples :
Les journaux de niveau Warn sont plus importants que ceux de niveau Info, mais ne nécessitent pas de revue humaine individuelle.
- Exemples :
- Échec de l’envoi d’un message Raft à un pair distant
- Échec de réception d’un message de battement de cœur dans le délai d’élection configuré
- Exemples :
Les journaux ErrorLevel sont de haute priorité. Si une application fonctionne correctement, elle ne doit générer aucun journal de niveau erreur.
- Exemples :
- Échec de l’allocation d’espace disque pour le WAL
- Exemples :
PanicLevel enregistre un message, puis provoque un arrêt anormal.
- Exemples :
- Échec du codage des messages Raft
- Exemples :
FatalLevel enregistre un message, puis appelle os.Exit(1).
- Exemples :
- Échec de la sauvegarde de l’instantané Raft
- Exemples :
11.3 - Modules Go
Le projet etcd (à partir de la version 3.5) est organisé en plusieurs modules golang hébergés dans un référentiel unique .
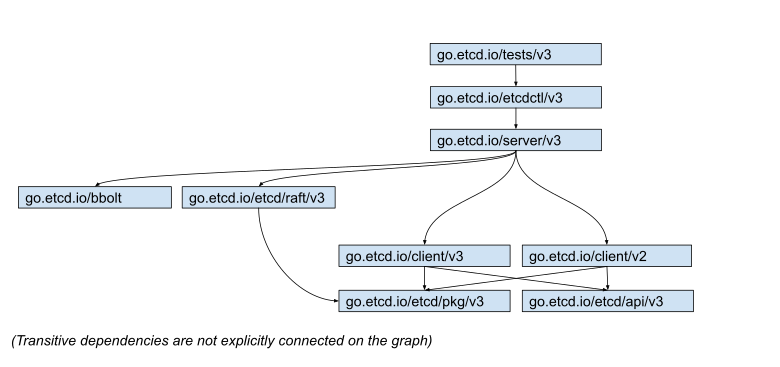
Les modules suivants sont disponibles :
go.etcd.io/etcd/api/v3 - contient les définitions d’API (protos et bibliothèques générées à partir de protos) qui définissent le protocole de communication entre les clients et le serveur etcd.
go.etcd.io/etcd/pkg/v3 - ensemble de packages d’utilitaires utilisés par etcd sans être spécifiques à etcd lui-même. Un package doit être placé ici uniquement s’il pourrait éventuellement être déplacé vers son propre dépôt à l’avenir. Évitez d’ajouter ici du code qui a de nombreux dépendances, car celles-ci deviendraient automatiquement des dépendances de la bibliothèque cliente (que nous souhaitons garder légère).
go.etcd.io/etcd/client/v3 - bibliothèque cliente utilisée pour contacter etcd sur le réseau (grpc). Recommandée pour toute utilisation nouvelle d’etcd.
go.etcd.io/etcd/client/v2 - bibliothèque cliente héritée utilisée pour contacter etcd via le protocole HTTP. Dépréciée. Tout usage nouveau doit dépendre de la bibliothèque /v3.
go.etcd.io/etcd/raft/v3 - implémentation du protocole de consensus distribué. Doit ne pas contenir de code spécifique à etcd.
go.etcd.io/etcd/server/v3 - implémentation etcd. Le code de ce package est interne à etcd et ne doit pas être utilisé par des projets externes. La structure du package et l’API peuvent évoluer au sein des versions mineures.
go.etcd.io/etcd/etcdctl/v3 - un outil en ligne de commande permettant d’accéder à etcd et de le gérer.
go.etcd.io/etcd/tests/v3 - un module qui contient tous les tests d’intégration de etcd. Remarque : Tous les tests unitaires (rapides et n’exigeant pas de dépendances entre modules) doivent être conservés dans les modules locaux au code testé.
go.etcd.io/bbolt - implémentation d’un arbre b persistant. Hébergé dans un dépôt séparé : https://github.com/etcd-io/bbolt .
Opérations
- Tous les modules etcd doivent être publiés en versions identiques, par exemple :
go.etcd.io/etcd/client/v3@v3.5.10doit dépendre dego.etcd.io/etcd/api/v3@v3.5.10.
La mise à jour cohérente des versions peut être effectuée à l’aide de :
Les modules publiés doivent être étiquetés conformément aux règles https://golang.org/ref/mod#vcs-version , c’est-à-dire que chaque module doit recevoir sa propre étiquette. La mise en étiquette peut être effectuée à l’aide de :
Tous les modules etcd doivent dépendre des mêmes versions des dépendances sous-jacentes. Cela peut être vérifié à l’aide de :
Les fichiers go.mod ne doivent pas contenir de dépendances non utilisées et doivent respecter le format
go mod tidy. Cette vérification est effectuée par :Pour déclencher des actions sur tous les modules (par exemple, formater automatiquement tous les fichiers), veuillez use/expand exécuter le script suivant :
Avenir
En tant qu’indicateur principal, nous souhaitons évaluer les modules etcd selon le modèle suivant :
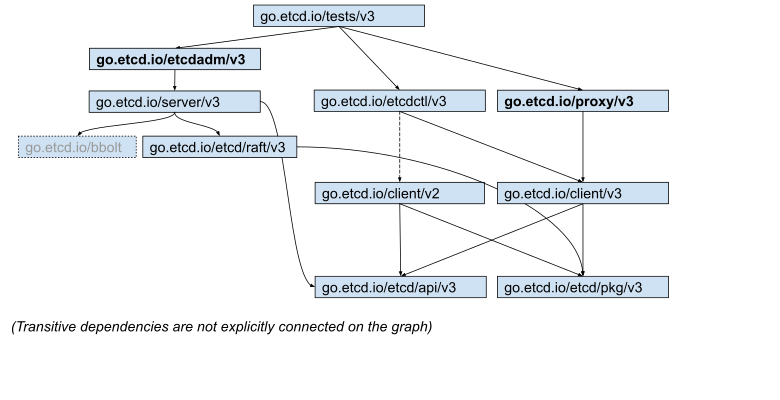
Cela suppose :
- Séparation de etcdmigrate/etcdadm à partir de la binaire etcdctl. Grâce à cela, etcdctl deviendrait clairement un wrapper en ligne de commande autour de l’API client réseau, tandis que etcdmigrate/etcdadm prendrait en charge les opérations physiques directes sur les fichiers de stockage etcd.
- Séparation de etcd-proxy à partir de la binaire ./etcd, car elle contient un code plus expérimental et donc des risques et des dépendances supplémentaires.
- Dépréciation du support du protocole v2.
12 - Apprentissage
12.1 - Modèle de données
etcd est conçu pour stocker de manière fiable des données peu fréquemment mises à jour et fournir des requêtes de surveillance fiables. etcd expose les versions antérieures des paires clé-valeur afin de prendre en charge des instantanés à faible coût et les événements de historique de surveillance (« requêtes de voyage dans le temps »). Un modèle de données persistant, à plusieurs versions et contrôlant la concurrence s’adapte parfaitement à ces cas d’utilisation.
etcd stocke les données dans un magasin clé-valeur multiversion persistent . Le magasin clé-valeur préserve la version précédente d’une paire clé-valeur lorsque sa valeur est remplacée par de nouvelles données. Le magasin clé-valeur est effectivement immuable ; ses opérations ne mettent pas à jour la structure in situ, mais génèrent toujours une nouvelle structure mise à jour. Toutes les versions antérieures des clés restent accessibles et surveillables après modification. Pour empêcher que le magasin de données ne croisse indéfiniment au fil du temps et ne conserve des anciennes versions, le magasin peut être compacté afin de supprimer les versions les plus anciennes des données remplacées.
Vue logique
La vue logique du magasin est un espace binaire plat de clés. L’espace de clés dispose d’un index trié par ordre lexical sur les chaînes d’octets, ce qui rend les requêtes de plage peu coûteuses.
L’espace clé maintient plusieurs révisions. Lors de la création du magasin, la révision initiale est 1. Chaque opération mutative atomique (par exemple, une opération de transaction peut contenir plusieurs opérations) crée une nouvelle révision dans l’espace clé. Toutes les données détenues par les révisions précédentes restent inchangées. Les anciennes versions des clés peuvent toujours être consultées via les révisions antérieures. De même, les révisions sont indexées ; parcourir les révisions via des observateurs est efficace. Si le magasin est compacté pour économiser de l’espace, les révisions antérieures à la révision de compactage seront supprimées. Les révisions augmentent de manière monotone au cours de la durée de vie d’un cluster.
La durée de vie d’une clé s’étend sur une génération, depuis sa création jusqu’à sa suppression. Chaque clé peut avoir une ou plusieurs générations. La création d’une clé incrémente la version de cette clé, qui commence à 1 si la clé n’existe pas à la révision courante. La suppression d’une clé génère un jeton de suppression (tombstone), mettant fin à la génération courante de la clé en réinitialisant sa version à 0. Chaque modification d’une clé incrémente sa version ; ainsi, les versions augmentent de manière monotone au sein d’une génération de clé. Une fois un compactage effectué, toute génération terminée avant la révision de compactage est supprimée, ainsi que toutes les valeurs définies avant la révision de compactage, à l’exception de la dernière.
Vue physique
etcd stocke les données physiques sous forme de paires clé-valeur dans un arbre b+ persistant b+tree . Chaque révision de l’état du magasin ne contient que les différences par rapport à sa révision précédente, afin d’optimiser l’efficacité. Une seule révision peut correspondre à plusieurs clés dans l’arbre.
La clé d’une paire clé-valeur est un triplet (major, sub, type). Le champ major est la révision du magasin contenant la clé. Le champ sub permet de distinguer les clés au sein de la même révision. Le champ type est un suffixe facultatif pour des valeurs spéciales (par exemple, t si la valeur contient une suppression logique). La valeur de la paire clé-valeur contient la modification par rapport à la révision précédente, donc une différence par rapport à la révision précédente. L’arbre B+ est trié par clé selon l’ordre lexical par octets. Les recherches par plage sur les deltas de révision sont rapides ; cela permet de trouver rapidement les modifications entre deux révisions spécifiques. Le compactage supprime les paires clé-valeur obsolètes.
etcd maintient également un index secondaire en mémoire btree afin d’accélérer les requêtes portant sur une plage de clés. Les clés de l’index btree correspondent aux clés du magasin exposées à l’utilisateur. La valeur est un pointeur vers la modification du b+tree persistant. Le compactage supprime les pointeurs inutilisés.
Ensemble, etcd obtient les informations de révision à partir de l’arbre b, puis utilise la révision comme clé pour récupérer la valeur à partir de l’arbre b+ (comme illustré ci-dessous).
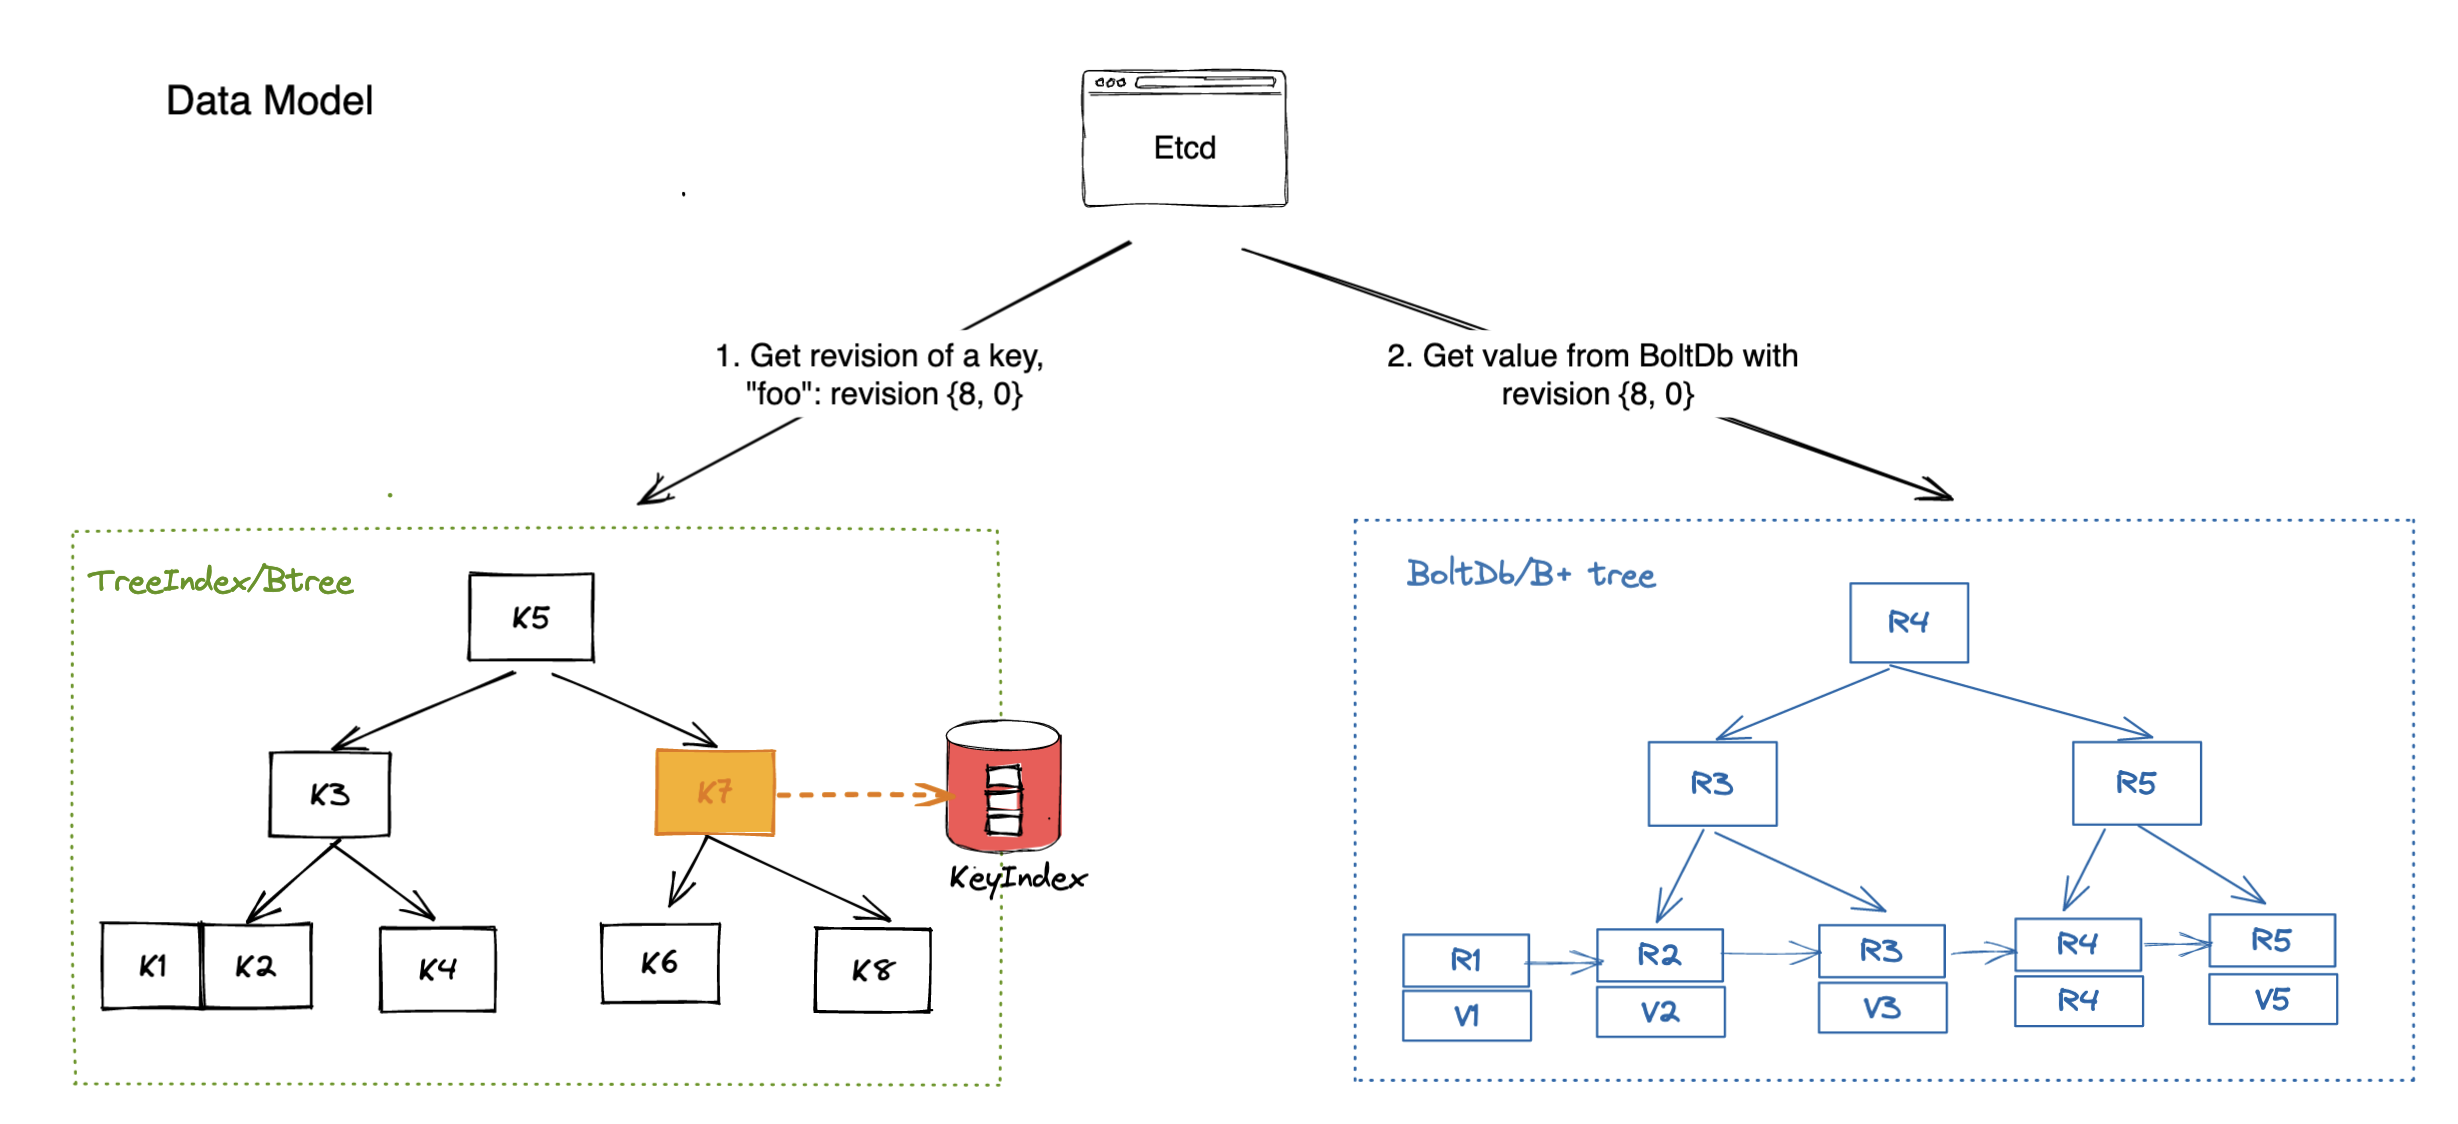
12.2 - etcd conception client
Conception du client etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Introduction
Le serveur etcd a démontré sa robustesse au fil de nombreuses années de tests d’injection d’erreurs. La logique d’application la plus complexe est déjà gérée par le serveur etcd et ses magasins de données (par exemple, la gestion de l’appartenance au cluster est transparente pour les clients, les propositions étant acheminées au leader au niveau du protocole Raft). Bien que les composants du serveur soient corrects, leur interaction avec les clients nécessite un ensemble différent de protocoles complexes afin de garantir leur correction et une haute disponibilité en cas de défaillance. Idéalement, le serveur etcd fournit une vue logique unique d’un cluster composé de plusieurs machines physiques, et le client implémente un basculement automatique entre les réplicas. Ce document décrit les choix architecturaux du client ainsi que leurs détails d’implémentation.
Glossaire
clientv3 : client Go officiel pour l’API etcd v3.
clientv3-grpc1.0 : Implémentation cliente officielle, avec grpc-go v1.0.x
, utilisée dans la dernière version etcd v3.1.
clientv3-grpc1.7 : Implémentation cliente officielle, avec grpc-go v1.7.x
, utilisée dans les versions les plus récentes d’etcd v3.2 et v3.3.
clientv3-grpc1.23 : Implémentation cliente officielle, avec grpc-go v1.23.x
, utilisée dans la dernière version etcd v3.4.
Balancer : équilibreur de charge client etcd qui implémente un mécanisme de réessai et de basculement. Le client etcd doit équilibrer automatiquement la charge entre plusieurs points d’accès.
Endpoints : une liste d’adresses d’extrémités du serveur etcd auxquelles les clients peuvent se connecter. En général, 3 ou 5 adresses client d’un cluster etcd.
Endpoint fixe : Lorsqu’il est configuré avec plusieurs endpoints, le chargeur de client <= v3.3 sélectionne un seul endpoint pour établir une connexion TCP, afin de limiter le nombre total de connexions ouvertes vers le cluster etcd. En v3.4, le chargeur effectue un balancement round-robin sur les endpoints fixés pour chaque requête, ce qui permet une répartition plus équilibrée de la charge.
Connexion client : connexion TCP établie avec un serveur etcd, via gRPC Dial.
Connexion sous-jacente : interface gRPC SubConn. Chaque connexion sous-jacente contient une liste d’adresses. Le chargeur de charge crée une SubConn à partir d’une liste d’adresses résolues. Une connexion cliente gRPC peut être associée à plusieurs SubConn (par exemple, example.com se résout en 10.10.10.1 et 10.10.10.2 de deux connexions sous-jacentes). Le chargeur de charge d’etcd v3.4 utilise un résolveur interne pour établir une connexion sous-jacente pour chaque point de terminaison.
Déconnexion transitoire : lorsque le serveur gRPC retourne une erreur de statut code Unavailable
.
Exigences client
Exactitude. Les requêtes peuvent échouer en cas de défaillance du serveur. Toutefois, les garanties de cohérence ne sont jamais violées : propriétés d’ordre global, écriture jamais corrompue, sémantique au plus une fois pour les opérations modifiables, la surveillance ne perçoit jamais d’événements partiels, et ainsi de suite.
Vivacité. Les serveurs peuvent tomber en panne ou se déconnecter brièvement. Les clients doivent pouvoir progresser dans les deux cas. Les clients doivent ne jamais bloquer en attendant qu’un serveur revienne en ligne, sauf si configuré pour ce faire. Idéalement, les clients détectent les serveurs indisponibles à l’aide de la ping HTTP/2 et basculent vers d’autres nœuds avec des messages d’erreur clairs.
Efficacité. Les clients doivent fonctionner efficacement avec un usage minimal des ressources : les connexions TCP précédentes doivent être fermées correctement après un changement de point de terminaison. Le mécanisme de basculement doit prévoir efficacement le prochain réplica à connecter, sans tenter inutilement de se reconnecter aux nœuds défaillants.
Portabilité. Le client officiel doit être clairement documenté et son implémentation doit être applicable à d’autres liaisons de langage. La gestion des erreurs entre les différentes liaisons de langage doit être cohérente. Étant donné qu’etcd s’engage pleinement en faveur de gRPC, l’implémentation doit être étroitement alignée sur les objectifs de conception à long terme de gRPC (par exemple, une politique de réessai paramétrable doit être compatible avec gRPC retry ). Les mises à jour entre deux versions du client doivent être non disruptives.
Aperçu du client
Le client etcd implémente les composants suivants :
- équilibreur de charge qui établit des connexions gRPC vers un cluster etcd,
- client API qui envoie des appels RPC à un serveur etcd, et
- gestionnaire d’erreurs qui détermine s’il faut réessayer une requête échouée ou basculer vers un autre point de terminaison.
Les langages peuvent différer quant à la manière d’établir une connexion initiale (par exemple, configurer TLS), à la manière d’encoder et d’envoyer des messages Protocol Buffer au serveur, à la gestion des appels RPC en flux, et ainsi de suite. Toutefois, les erreurs renvoyées par le serveur etcd seront identiques. La gestion des erreurs et la politique de nouvelle tentative doivent donc être identiques.
Par exemple, le serveur etcd peut retourner "rpc error: code = Unavailable desc = etcdserver: request timed out", qui correspond à une erreur transitoire nécessitant une nouvelle tentative. Ou bien retourner rpc error: code = InvalidArgument desc = etcdserver: key is not provided, ce qui signifie que la requête était invalide et ne doit pas être réessayée. Le client Go peut analyser les erreurs à l’aide de google.golang.org/grpc/status.FromError, et le client Java à l’aide de io.grpc.Status.fromThrowable.
clientv3-grpc1.0 : Vue d’ensemble du chargeur de charge
clientv3-grpc1.0 maintient plusieurs connexions TCP lorsqu’il est configuré avec plusieurs points d’accès etcd. Il sélectionne alors une adresse et l’utilise pour envoyer toutes les requêtes clientes. L’adresse fixe est conservée jusqu’à la fermeture de l’objet client (voir Figure 1). Lorsque le client reçoit une erreur, il choisit aléatoirement une autre adresse et réessaie.
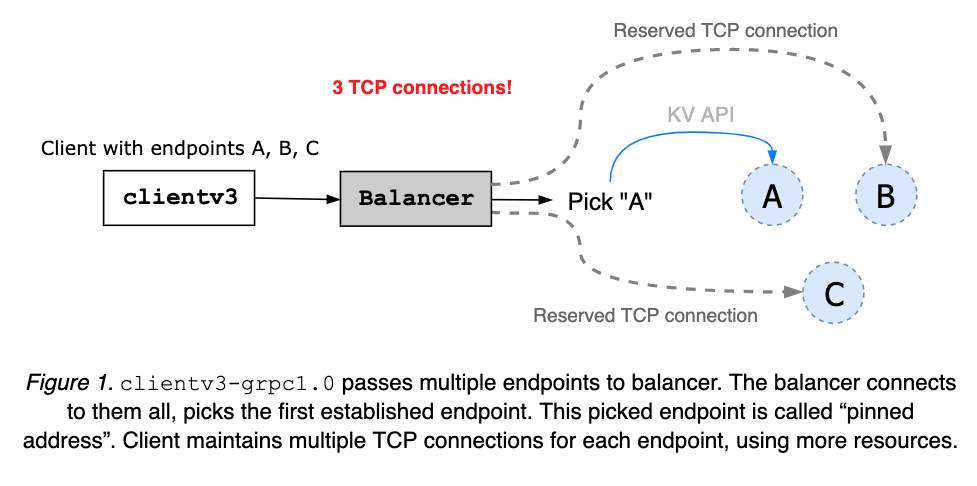
clientv3-grpc1.0 : Limitation du chargeur d’équilibre
clientv3-grpc1.0 ouvrir plusieurs connexions TCP peut accélérer le basculement du chargeur mais nécessite plus de ressources. Le chargeur ne comprend pas l’état de santé des nœuds ni l’appartenance au cluster. Il est donc possible que le chargeur reste bloqué sur un nœud défaillant ou isolé.
clientv3-grpc1.7 : Vue d’ensemble du chargeur de charge
clientv3-grpc1.7 ne maintient qu’une seule connexion TCP vers un serveur etcd sélectionné. Lorsqu’il est fourni avec plusieurs points d’accès du cluster, le client tente d’établir une connexion avec chacun d’eux. Dès qu’une connexion est active, le chargeur de charge fixe l’adresse, en fermant les autres (voir Figure 2). L’adresse fixée doit être conservée jusqu’à la fermeture de l’objet client. Une erreur, provenant d’une panne du serveur ou du réseau client, est transmise au gestionnaire d’erreurs du client (voir Figure 3).
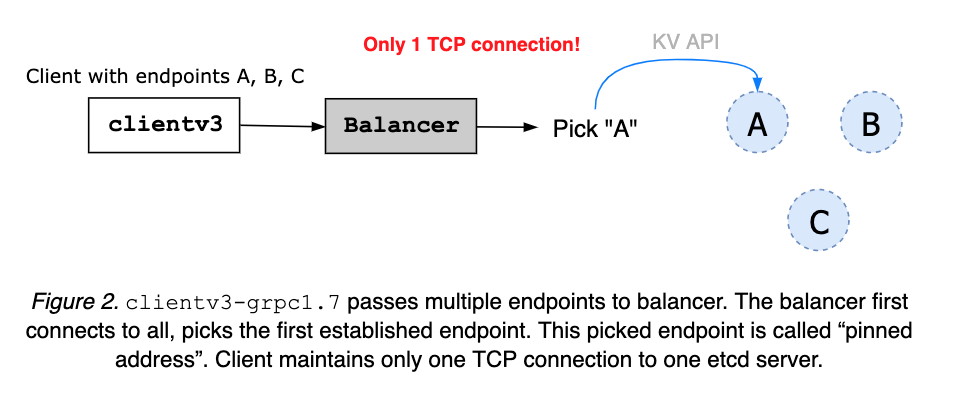
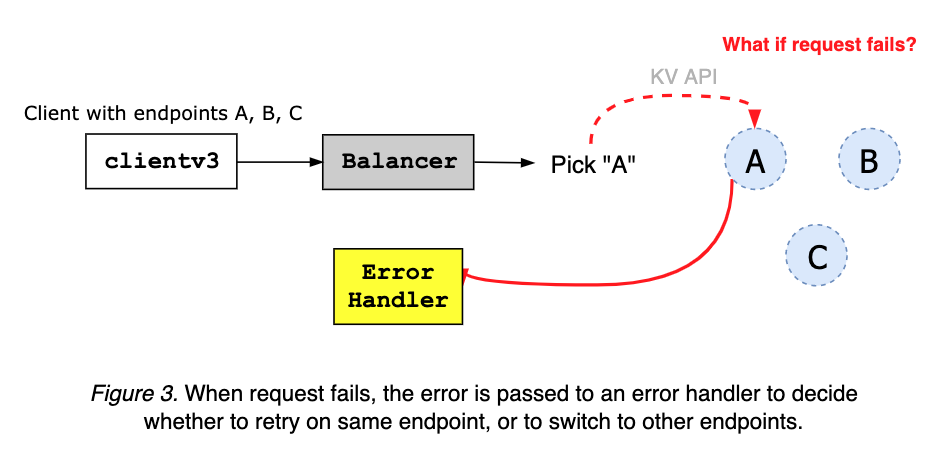
Le gestionnaire d’erreurs client prend une erreur provenant du serveur gRPC, et décide de procéder à une nouvelle tentative sur le même point de terminaison ou de passer à d’autres adresses, en fonction du code d’erreur et du message (voir Figure 4 et Figure 5).
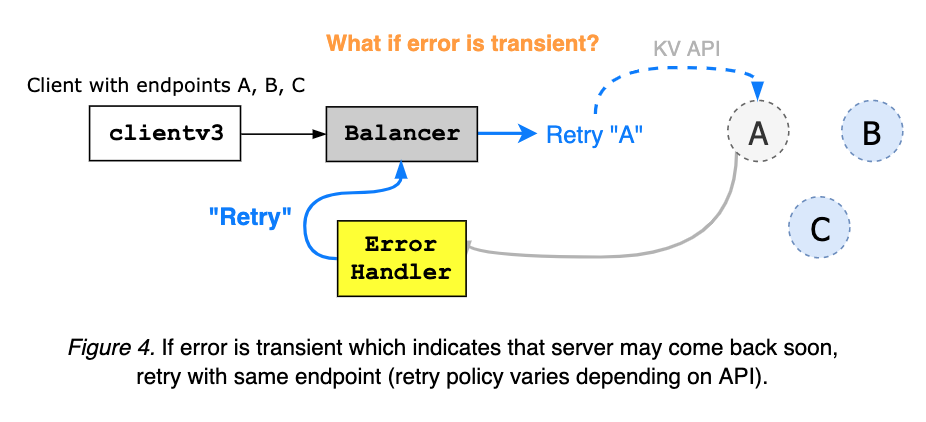
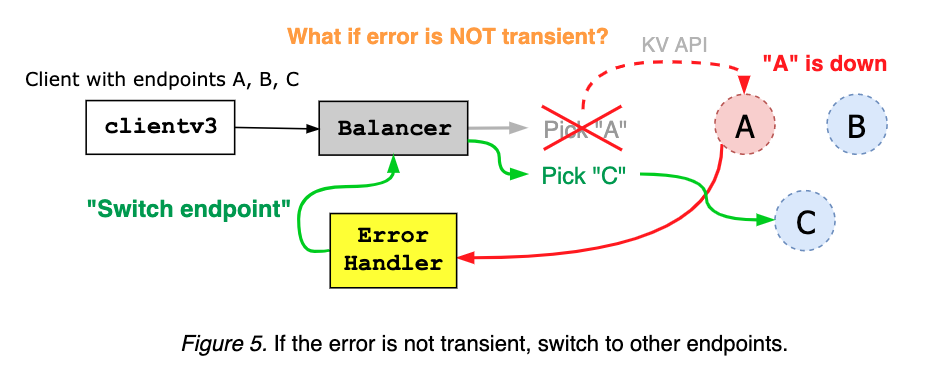
Les appels RPC en flux, tels que Surveillance et KeepAlive, sont souvent demandés sans délai d’attente. À la place, le client peut envoyer des ping HTTP/2 périodiques pour vérifier l’état d’un point d’accès fixe ; si le serveur ne répond pas au ping, l’équilibreur de charge bascule vers d’autres points d’accès (voir Figure 6).
clientv3-grpc1.7 : Limitation du chargeur d’équilibre
clientv3-grpc1.7 équilibre les envois de keepalives HTTP/2 pour détecter les déconnexions provenant des requêtes en streaming. Il s’agit d’un mécanisme de ping simple basé sur un serveur gRPC, qui ne tient pas compte de l’appartenance au cluster, et ne peut donc pas détecter les partitions réseau. Comme un serveur gRPC partitionné peut continuer à répondre aux pings clients, l’équilibreur peut rester bloqué sur un nœud partitionné. Idéalement, le ping de keepalive doit détecter la partition et déclencher un basculement de point de terminaison avant l’expiration de la requête (voir etcd#8673
et Figure 7).
clientv3-grpc1.7 balancer maintient une liste d’extrémités défaillantes. Les adresses déconnectées sont ajoutées à la liste « défaillantes » et considérées comme indisponibles jusqu’après la durée d’attente, qui est codée en dur comme le délai de connexion avec une valeur par défaut de 5 secondes. Le balancer peut produire des faux positifs concernant les extrémités défaillantes. Par exemple, l’extrémité A peut revenir juste après avoir été bannie, mais rester indisponible pendant les 5 secondes suivantes (voir Figure 8).
clientv3-grpc1.0 a connu les mêmes problèmes mentionnés ci-dessus.
Le chargeur gRPC Go a déjà effectué la migration vers l’interface de nouveau chargeur. Par exemple, l’implémentation du chargeur sous-jacent utilisée par clientv3-grpc1.7 utilise le nouveau chargeur gRPC et tente de rester cohérente avec les comportements du chargeur ancien. Bien que sa compatibilité ait été maintenue de manière raisonnable, le client etcd a toujours souffert de modifications subtiles cassantes
. En outre, les mainteneurs gRPC recommandent de ne pas s’appuyer sur l’interface ancienne du chargeur
. En général, pour bénéficier d’un meilleur support de la part des projets upstream, il est préférable de rester synchronisé avec les dernières versions de gRPC. De plus, de nouvelles fonctionnalités, telles que la politique de nouvelle tentative, ne seront peut-être pas reportées sur la branche gRPC 1.7. Par conséquent, le serveur etcd ainsi que le client doivent migrer vers les versions les plus récentes de gRPC.
clientv3-grpc1.23 : Aperçu du chargeur de charge
clientv3-grpc1.7 est si étroitement lié à l’ancienne interface gRPC qu’une mise à jour de n’importe quelle dépendance gRPC a perturbé le comportement des clients. La majeure partie des efforts de développement et de débogage a été consacrée à la correction de ces changements de comportement des clients. En conséquence, son implémentation est devenue excessivement complexe, fondée sur des hypothèses erronées concernant les connectivités serveur.
L’objectif principal de clientv3-grpc1.23 est de simplifier la logique de basculement du chargeur ; plutôt que de maintenir une liste d’extrémités défaillantes, qui pourrait être périmée, il suffit de procéder à un roundrobin vers l’extrémité suivante chaque fois que le client se déconnecte de l’extrémité actuelle. Il ne suppose pas l’état des extrémités. Ainsi, il n’est plus nécessaire de suivre de manière complexe l’état (voir Figure 8 et ci-dessus). La mise à jour vers clientv3-grpc1.23 ne devrait poser aucun problème ; toutes les modifications ont été internes tout en préservant toutes les compatibilités descendantes.
En interne, lorsqu’il reçoit plusieurs points de terminaison, clientv3-grpc1.23 crée plusieurs sous-connexions (une sous-connexion par point de terminaison), tandis que clientv3-grpc1.7 n’établit qu’une seule connexion vers un point de terminaison fixe (voir Figure 9). Par exemple, dans un cluster de 5 nœuds, le chargeur clientv3-grpc1.23 nécessiterait 5 connexions TCP, tandis que clientv3-grpc1.7 n’en nécessite qu’une seule. En conservant une pool de connexions TCP, clientv3-grpc1.23 peut consommer davantage de ressources mais offre un chargeur plus flexible avec de meilleures performances de basculement. La politique de répartition par défaut est le round robin, mais elle peut être facilement étendue pour prendre en charge d’autres types de chargeurs (par exemple, puissance de deux, sélection du leader, etc.). clientv3-grpc1.23 utilise le groupe de résolution gRPC et implémente la politique de sélection du chargeur, afin de déléguer le travail de répartition complexe au gRPC amont. En revanche, clientv3-grpc1.7 gère manuellement chaque connexion gRPC et le basculement du chargeur, ce qui complique l’implémentation. clientv3-grpc1.23 implémente la répétition dans la chaîne d’intercepteurs gRPC, qui gère automatiquement les erreurs internes gRPC et permet des politiques de répétition plus avancées, comme le backoff, tandis que clientv3-grpc1.7 interprète manuellement les erreurs gRPC pour les répétitions.
clientv3-grpc1.23 : Limitation du chargeur de trafic
Les améliorations peuvent être apportées en mettant en mémoire tampon l’état de chaque point de terminaison. Par exemple, le chargeur peut interroger à l’avance chaque serveur afin de maintenir une liste de candidats sains, et utiliser ces informations lors d’un routage par rotation. Ou bien, en cas de déconnexion, le chargeur peut privilégier les points de terminaison sains. Cela peut compliquer l’implémentation du chargeur, ce qui peut être traité dans des versions ultérieures.
Ping de keepalive côté client ne prend toujours pas en compte les partitions réseau. Une requête en streaming peut bloquer sur un nœud partitionné. Une solution avancée de vérification de santé doit être mise en œuvre pour comprendre l’appartenance au cluster (voir etcd#8673 pour plus de détails).
Actuellement, la logique de nouvelle tentative est gérée manuellement en tant qu’intercepteur. Cela pourrait être simplifié grâce à les nouvelles tentatives officielles gRPC .
12.3 - etcd design membre apprenant
etcd Membre apprenant
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Contexte
La reconfiguration du membership a été l’un des plus grands défis opérationnels. Examinons les défis courants.
1. Nouveau membre de cluster surcharge le leader
Un membre etcd nouvellement joint démarre sans données, ce qui entraîne un plus grand nombre de mises à jour provenant du leader jusqu’à ce qu’il rattrape la log du leader. Le réseau du leader est alors plus susceptible d’être surchargé, bloquant ou perdant les battements de cœur envoyés aux suiveurs. Dans ce cas, un suiveur peut atteindre son délai d’élection et déclencher une nouvelle élection de leader. Ainsi, un cluster comportant un nouveau membre est plus vulnérable à une élection de leader. À la fois l’élection de leader et la propagation ultérieure des mises à jour vers le nouveau membre sont sujettes à provoquer des périodes d’indisponibilité du cluster (voir Figure 1).
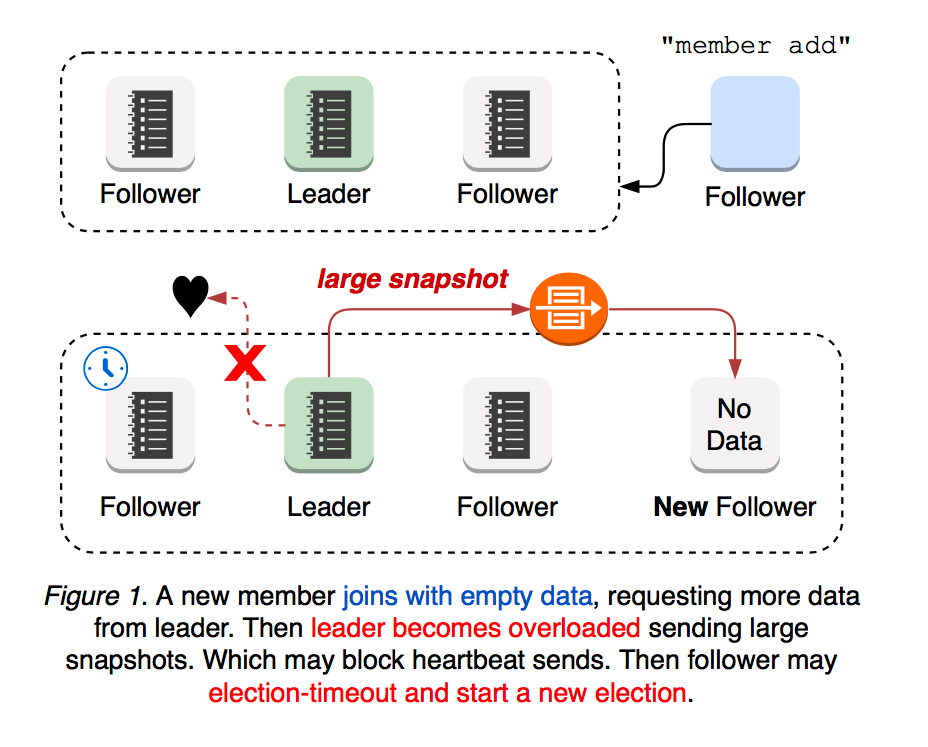
2. Scénarios de partition réseau
Que se passe-t-il en cas de partition réseau ? Cela dépend de la partition du leader. Si le leader conserve toujours un quorum actif, le cluster continue de fonctionner (voir Figure 2).
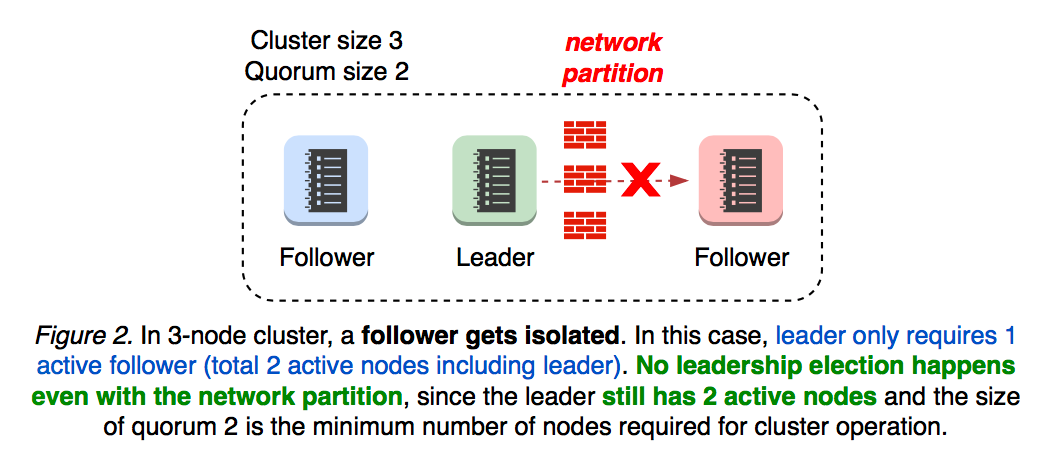
2.1 Isolement du leader
Que se passe-t-il si le leader devient isolé du reste du cluster ? Le leader surveille l’évolution de chaque suiveur. Lorsque le leader perd la connectivité avec le quorum, il redevient suiveur, ce qui affecte la disponibilité du cluster (voir Figure 3).
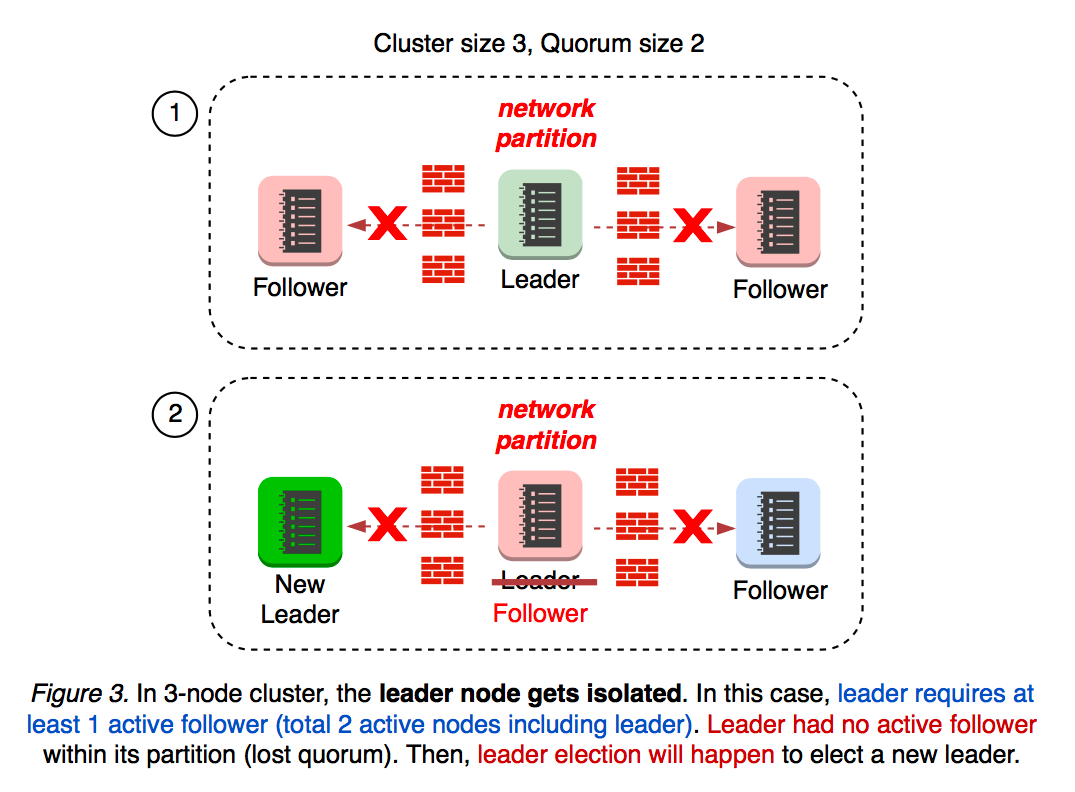
Lorsqu’un nouveau nœud est ajouté à un cluster de 3 nœuds, la taille du cluster devient 4 et la taille du quorum devient 3. Que se passe-t-il si un nouveau nœud rejoint le cluster, puis qu’une partition réseau se produit ? Cela dépend de la partition dans laquelle se trouve le nouveau membre après la partition.
2.2 Fractionnement du cluster 3+1
Si le nouveau nœud se trouve accidentellement dans la même partition que le leader, ce dernier conserve toujours un quorum actif de 3. Aucune élection de leader n’a lieu, et la disponibilité du cluster n’est pas affectée (voir Figure 4).
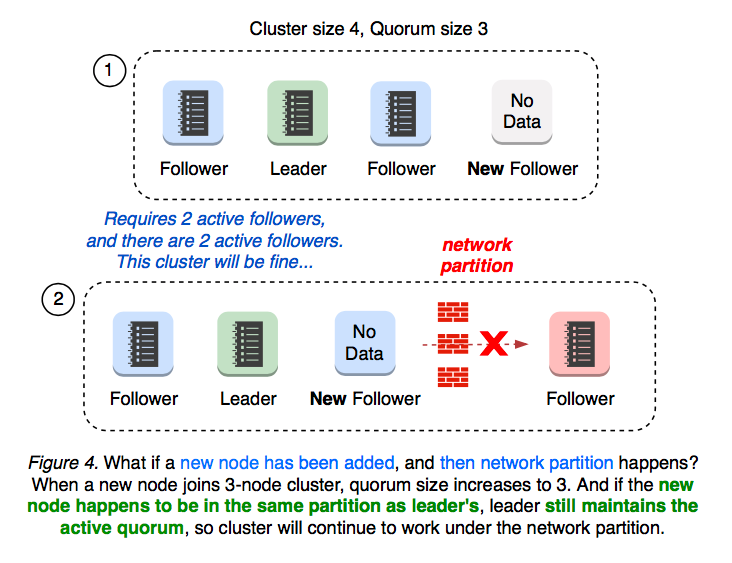
2.3 Fractionnement du cluster 2+2
Si le cluster est partitionné en deux parties de deux, aucune des partitions ne conserve le quorum de 3. Dans ce cas, une élection de leader a lieu (voir Figure 5).
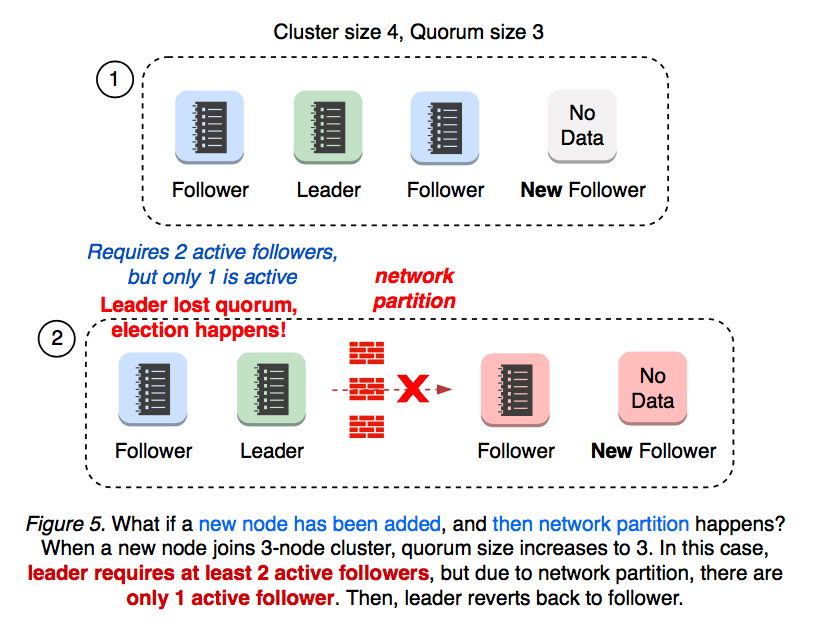
2.4 Quorum perdu
Que se passe-t-il si une partition réseau se produit en premier, puis qu’un nouveau membre est ajouté ? Un cluster à 3 nœuds déjà partitionné dispose déjà d’un suiveur déconnecté. Lorsqu’un nouveau membre est ajouté, le quorum passe de 2 à 3. Ce cluster dispose désormais de seulement 2 nœuds actifs sur 4, perd donc son quorum et déclenche une nouvelle élection de leader (voir Figure 6).
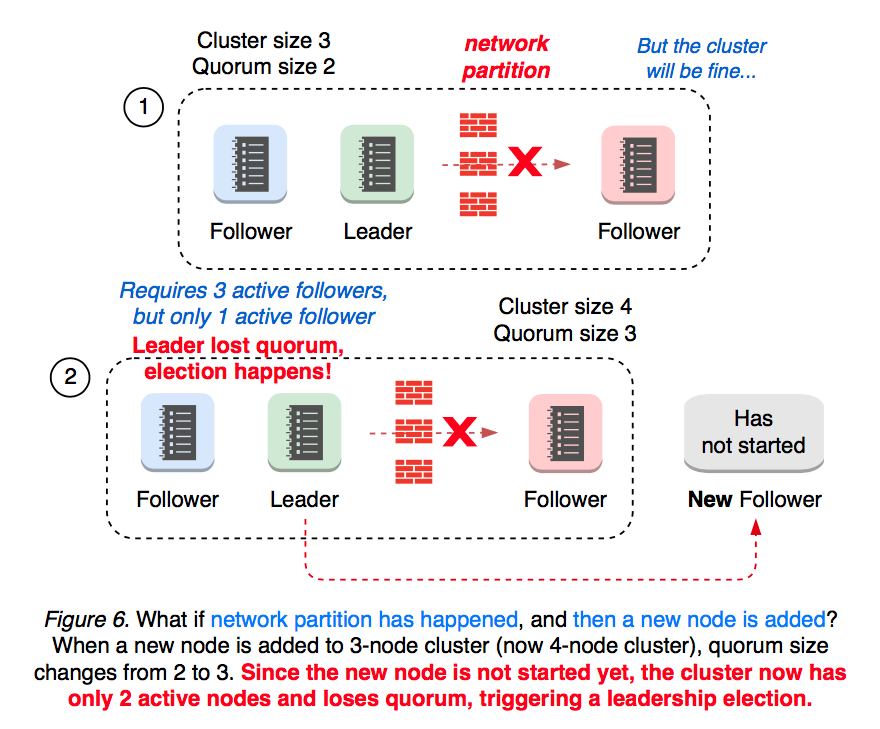
Étant donné que l’opération d’ajout d’un membre peut modifier la taille du quorum, il est toujours recommandé de supprimer d’abord le membre pour remplacer un nœud défaillant.
Ajouter un nouveau membre à un cluster à 1 nœud modifie la taille du quorum à 2, provoquant immédiatement une élection du leader lorsque le leader précédent constate que le quorum n’est pas actif. Cela est dû au fait que l’opération « member add » est une procédure en deux étapes, où l’utilisateur doit d’abord appliquer la commande « member add », puis démarrer le processus du nouveau nœud (voir Figure 7).
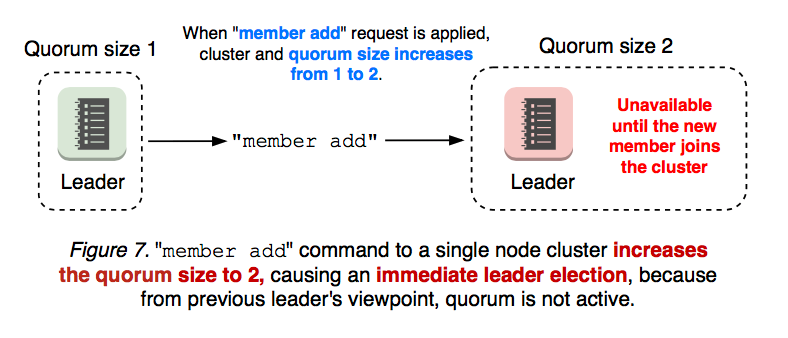
3. Mauvaises configurations du cluster
Un cas encore plus critique survient lorsque le membre ajouté est mal configuré. La reconfiguration du membre est un processus en deux étapes : « etcdctl member add » et le démarrage d’un processus serveur etcd avec l’URL de pair donnée. Autrement dit, la commande « member add » est appliquée indépendamment de l’URL, même lorsque la valeur de l’URL est invalide. Si la première étape est exécutée avec des URLs invalides, la deuxième étape ne peut même pas démarrer le nouvel etcd. Une fois que le cluster a perdu son quorum, il n’existe aucune possibilité de revenir en arrière sur le changement de configuration (voir Figure 8).
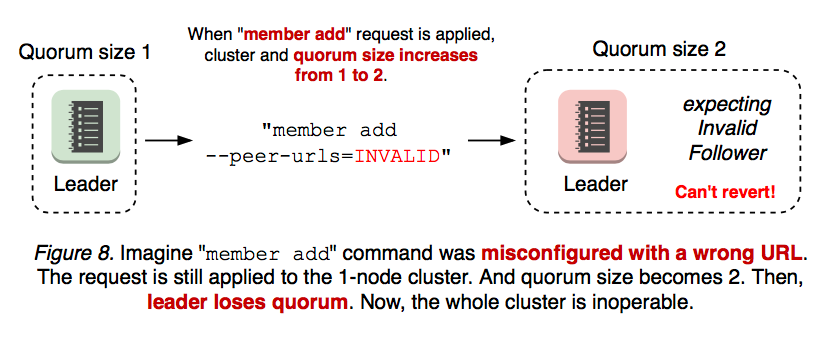
La même règle s’applique à un cluster à plusieurs nœuds. Par exemple, si deux membres du cluster sont hors ligne (l’un est défaillant, l’autre mal configuré) et deux membres sont opérationnels, il faut désormais au moins 3 votes pour modifier la composition du cluster (voir Figure 9).
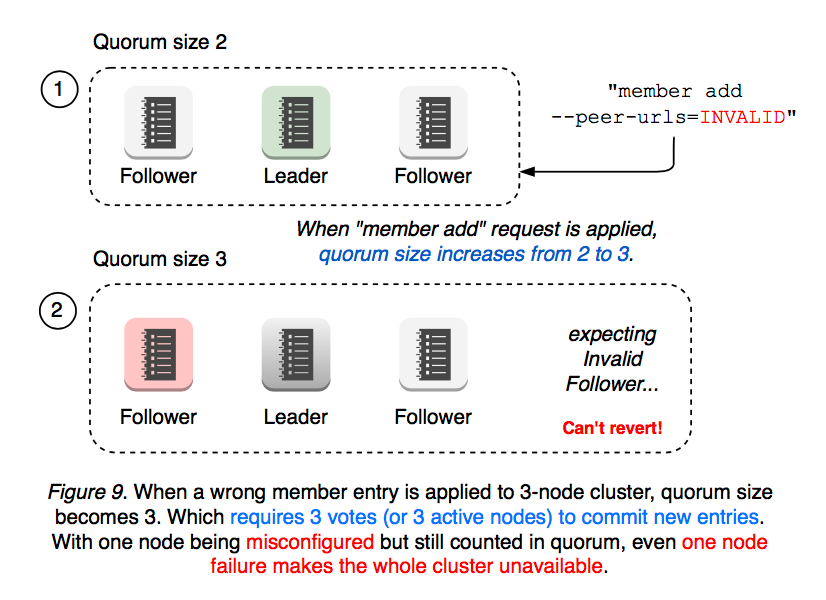
Comme indiqué ci-dessus, une simple mauvaise configuration peut faire basculer l’ensemble du cluster dans un état inopératoire. Dans un tel cas, un opérateur doit recréer manuellement le cluster en utilisant le drapeau etcd --force-new-cluster. Étant donné qu’etcd est devenu un service critique pour Kubernetes, toute interruption, aussi brève soit-elle, peut avoir un impact significatif sur les utilisateurs. Que pouvons-nous faire de mieux pour simplifier ces opérations ? Entre autres, l’élection du leader est essentielle à la disponibilité du cluster : pouvons-nous rendre la reconfiguration de la composition du cluster moins disruptive en ne modifiant pas la taille du quorum ? Un nouveau membre peut-il rester inactif, ne demandant au leader que les mises à jour minimales, jusqu’à ce qu’il soit à jour ? La mauvaise configuration de la composition du cluster peut-elle toujours être annulée et gérée de manière plus sécurisée (une commande d’ajout de membre erronée ne devrait jamais faire échouer le cluster) ? Un utilisateur doit-il s’inquiéter de la topologie réseau lors de l’ajout d’un nouveau membre ? L’API d’ajout de membre peut-elle fonctionner indépendamment de l’emplacement des nœuds et des partitions réseau en cours ?
Membre apprenant Raft
Afin de réduire les lacunes de disponibilité décrites dans la section précédente, Raft §4.2.1 introduit un nouvel état de nœud appelé « membre apprenant », qui rejoint le cluster en tant que membre non votant jusqu’à ce qu’il ait rattrapé les journaux du leader.
Fonctionnalités de la version 3.4
Un opérateur doit effectuer le minimum de travail possible pour ajouter un nouveau membre apprenant. Utilisez la commande member add --learner pour ajouter un nouveau membre apprenant, qui rejoint le cluster en tant que membre non votant tout en recevant toutes les données du leader (voir Figure 10).
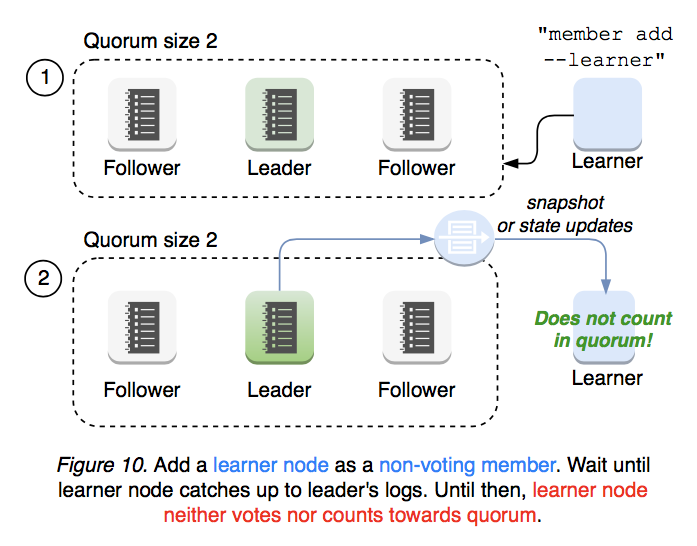
Lorsqu’un membre apprenant a rattrapé l’avancement du leader, il peut être promu en membre votant à l’aide de l’API member promote, qui contribue alors au quorum (voir Figure 11).
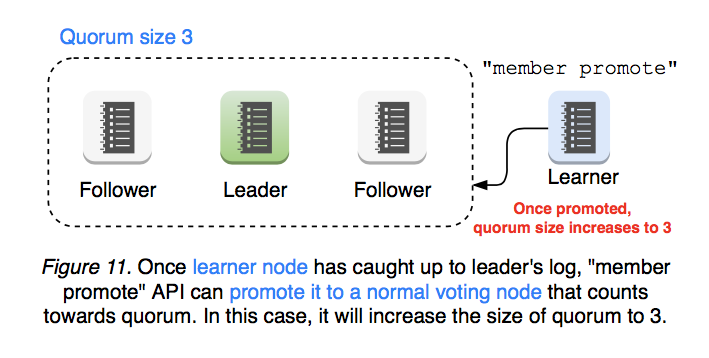
Le serveur etcd valide la demande de promotion afin d’assurer sa sécurité opérationnelle. Un membre apprenant ne peut être promu en membre votant qu’après avoir rattrapé le journal du leader (voir Figure 12).
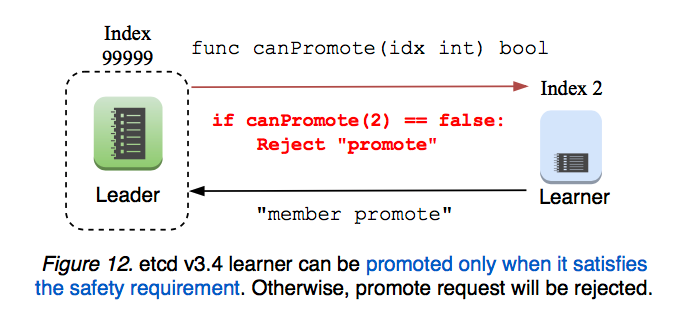
Le membre apprenant ne sert quasiment qu’à titre de nœud de secours jusqu’à sa promotion : la direction ne peut pas être transférée vers un membre apprenant. Le membre apprenant rejette les lectures et écritures clients (le chargeur de requêtes client ne doit pas acheminer les requêtes vers un membre apprenant). Cela signifie qu’un membre apprenant n’a pas besoin d’émettre de requêtes d’index de lecture au leader. Cette limitation simplifie l’implémentation initiale du membre apprenant dans la version v3.4 (voir Figure 13).
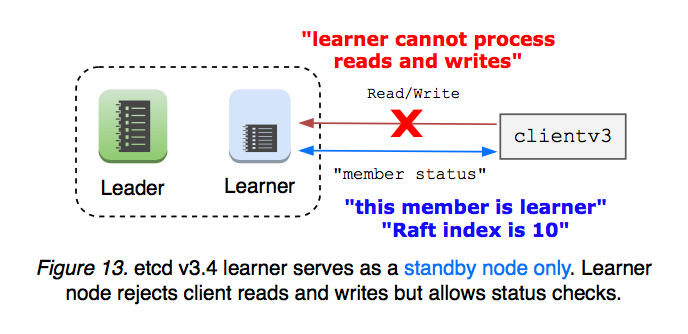
En outre, etcd limite le nombre total de membres apprenants qu’un cluster peut avoir, afin d’éviter de surcharger le leader avec la réplication des journaux. Un membre apprenant ne se promeut jamais lui-même. Bien qu’etcd fournisse des informations sur l’état du membre apprenant et des vérifications de sécurité, l’opérateur du cluster doit prendre la décision finale quant à la promotion d’un membre apprenant ou non.
Fonctionnalités proposées pour les versions futures
État apprenant uniquement et par défaut : Définir l’état par défaut d’un nouveau membre sur apprenant améliore considérablement la sécurité de la reconfiguration du groupe de membres, car un membre apprenant ne modifie pas la taille du quorum. Une mauvaise configuration reste toujours réversible sans perdre le quorum.
Promotion automatique des membres votants : Dès qu’un membre apprenant a rattrapé les journaux du leader, le cluster peut promouvoir automatiquement ce membre apprenant. etcd impose que l’utilisateur définisse certains seuils, et dès que ces conditions sont remplies, le membre apprenant se promeut lui-même en membre votant. Du point de vue de l’utilisateur, la commande « member add » fonctionnera de la même manière qu’aujourd’hui, mais avec une sécurité renforcée par la fonctionnalité de membre apprenant.
Passer un membre apprenant en nœud de basculement de secours : un membre apprenant rejoint en tant que nœud de secours et est automatiquement promu lorsque la disponibilité du cluster est compromise.
Rendre le membre apprenant en lecture seule : un membre apprenant peut servir de nœud en lecture seule qui ne sera jamais promu. En mode de cohérence faible, le membre apprenant reçoit uniquement des données du leader et ne traite jamais d’écritures. Servir les lectures localement, sans surcharge de consensus, réduit considérablement la charge imposée au leader, mais peut entraîner la lecture de données périmées. En mode de cohérence forte, le membre apprenant demande l’index de lecture au leader afin de servir les données les plus récentes, mais continue de rejeter les écritures.
Membre apprenant vs. Fabricant de miroir
etcd implémente une fonctionnalité de « mirror maker » à l’aide de l’API de surveillance pour relayer continuellement les créations et mises à jour de clés vers un cluster distinct. La mise en miroir présente généralement une surcharge de latence faible une fois la synchronisation initiale terminée. Les membres apprenants et la mise en miroir se recouvrent en ce sens qu’ils peuvent tous deux être utilisés pour répliquer des données existantes en lecture seule. Toutefois, la mise en miroir ne garantit pas la linéarité. En cas de déconnexion réseau, des valeurs de clés antérieures peuvent avoir été supprimées, et les clients sont censés vérifier les réponses de surveillance pour s’assurer de l’ordre correct. Par conséquent, aucune garantie d’ordre n’est assurée dans un miroir. Utilisez la mise en miroir pour une latence minimale (par exemple, entre centres de données) au prix de la cohérence. Utilisez les membres apprenants pour conserver toutes les données historiques et leur ordre.
Annexe : Implémentation du membre apprenant dans la version 3.4
Exposer le type de nœud “Learner” à l’API “MemberAdd”.
Le client etcd ajoute un indicateur à l’API « MemberAdd » pour un nœud membre apprenant. Le gestionnaire du serveur etcd applique l’entrée de changement d’appartenance avec le type pb.ConfChangeAddLearnerNode. Dès que la commande a été appliquée, un serveur rejoint le cluster avec l’indicateur etcd --initial-cluster-state=existing. Ce nœud membre apprenant ne peut ni voter ni être compté dans le quorum.
Le serveur etcd ne doit pas transférer le leadership à un membre apprenant, car celui-ci peut encore être en retard et ne compte pas dans le quorum. Le serveur etcd limite le nombre de membres apprenants qu’un cluster peut avoir à un seul : plus il y a de membres apprenants, plus le leader doit propager de données. Les clients peuvent interagir avec un nœud membre apprenant, mais celui-ci rejette toutes les requêtes sauf les lectures sérialisables et l’API d’état du membre. Ceci vise à simplifier l’implémentation initiale. À l’avenir, un membre apprenant pourra être étendu en serveur en lecture seule qui miroir continuellement les données du cluster. Le chargeur de requêtes client doit fournir une fonction d’aide pour exclure l’endpoint d’un membre apprenant. Sinon, une requête envoyée à un membre apprenant peut échouer. L’appel client de synchronisation du membre doit tenir compte du type de nœud membre apprenant. Il en va de même pour l’appel de mise à jour des points d’accès clients.
Les réponses de MemberList et MemberStatus doivent indiquer quel nœud est le membre apprenant.
Ajouter l’API “MemberPromote”.
En interne dans Raft, un deuxième appel MemberAdd au nœud membre apprenant le promeut en membre votant. Le leader suit l’avancement de chaque suiveur et membre apprenant. Si le membre apprenant n’a pas terminé son message d’instantané, rejeter la demande de promotion. Accepter la demande de promotion uniquement si et seulement si : le nœud membre apprenant est dans un état sain, et le membre apprenant est synchronisé avec le leader ou l’écart est inférieur au seuil (par exemple, le nombre d’entrées à répliquer vers le membre apprenant est inférieur à 1/10 du nombre d’entrées de l’instantané, ce qui signifie qu’il est peu probable que, même après la promotion, le leader doive envoyer un nouvel instantané au membre apprenant). Toute cette logique est codée en dur dans le paquet etcdserver et n’est pas configurable.
Référence
- Problème GitHub original : etcd#9161
- Cas d’utilisation : etcd#3715
- Cas d’utilisation : etcd#8888
- Cas d’utilisation : etcd#10114
12.4 - etcd conception de l'authentification v3
Pourquoi ne pas réutiliser le système d’authentification v2 ?
Le protocole v3 utilise gRPC comme transport, à la place d’une interface RESTful comme dans la v2. Ce nouveau protocole offre l’opportunité d’améliorer et d’évoluer la conception de la v2. Par exemple, l’authentification v3 repose sur une authentification basée sur la connexion, contrairement à l’authentification par requête plus lente de la v2. En outre, les sémantiques de l’authentification v2 s’avèrent souvent peu pratiques en pratique lorsqu’il s’agit d’assurer la cohérence, ce qui sera expliqué dans les sections suivantes. Pour la v3, une description et une implémentation clairement définies du mécanisme d’authentification corrigent les déficiences du système d’authentification v2.
Exigences fonctionnelles
- Authentification par connexion, pas par requête
- Authentification basée sur l’identifiant utilisateur et le mot de passe implémentée pour l’API gRPC
- L’authentification doit être actualisée après tout changement de stratégie d’authentification
- Sa fonctionnalité doit être aussi simple et utile que celle de la version v2
- La version v3 propose un espace de clés plat, contrairement à la structure hiérarchique de la version v2. La vérification des autorisations sera assurée par correspondance d’intervalle.
- Elle doit offrir des garanties de cohérence plus fortes que celles de la version v2 pour l’authentification
Modifications principales requises
- Un client doit établir une connexion dédiée uniquement à l’authentification avant d’envoyer des requêtes authentifiées
- Ajouter les informations de permission (identifiant utilisateur et révision autorisée) aux commandes Raft (
etcdserverpb.InternalRaftRequest) - Chaque requête est vérifiée pour les autorisations au niveau de la couche machine d’état, plutôt qu’au niveau de l’API
Consistance des métadonnées de permission
Les métadonnées relatives à l’authentification doivent également être stockées et gérées dans le stockage contrôlé par le protocole Raft d’etcd, comme les autres données stockées dans etcd. Cela est nécessaire pour ne pas compromettre la disponibilité et la cohérence de l’ensemble du cluster. Si la lecture ou l’écriture des métadonnées (par exemple, les informations de permission) nécessitait l’accord de chaque nœud (plus qu’un quorum), la défaillance d’un seul nœud pourrait bloquer l’ensemble du cluster. Exiger l’accord de tous les nœuds simultanément signifie que la vérification des requêtes ordinaires read/write ne peut pas être accomplie si un membre du cluster est hors ligne, même si le cluster dispose d’un quorum disponible. Ce schéma unanime dégrade finalement la disponibilité du cluster ; un consensus basé sur le quorum issu de Raft suffit, car l’accord découle d’un ordre cohérent.
Le mécanisme d’authentification dans le protocole etcd v2 comporte une difficulté car la cohérence des métadonnées devrait fonctionner comme indiqué ci-dessus, mais ne fonctionne pas : chaque vérification de permission est traitée par le membre etcd qui reçoit la requête cliente (server/etcdserver/api/v2http/client.go), y compris les membres suiveurs. Il est donc possible que la vérification soit basée sur des métadonnées obsolètes.
Ce délai signifie qu’une modification de configuration d’authentification ne peut pas être immédiatement reflétée après l’exécution de la commande etcdctl. Il n’existe donc aucun moyen de savoir pendant combien de temps les métadonnées obsolètes restent actives. En pratique, le changement de configuration est immédiatement pris en compte après l’exécution de la commande. Toutefois, dans certains cas de forte charge, l’état incohérent peut être prolongé, ce qui peut entraîner des situations contre-intuitives pour les utilisateurs et les développeurs. Une solution de contournement est nécessaire, comme this .
Des permissions incohérentes sont dangereuses pour les requêtes linéarisées
Un état d’authentification incohérent est particulièrement critique pour les écritures. Même si un opérateur désactive les écritures pour un utilisateur, si l’écriture n’est ordonnée qu’au regard du magasin clé-valeur et non du système d’authentification, il est possible que l’écriture aboutisse avec succès. Sans ordonnancement simultané sur le magasin d’authentification et le magasin clé-valeur, le système sera vulnérable aux attaques par permission obsolète.
Par conséquent, la logique de vérification des autorisations doit être ajoutée à la machine d’état d’etcd. Chaque machine d’état doit vérifier les requêtes en fonction de ses informations d’autorisation lors de l’étape apply (de sorte que les informations d’authentification ne soient pas périmées).
Conception et mise en œuvre
Authentification
Au départ, un client doit établir une connexion gRPC uniquement pour authentifier son identifiant utilisateur et son mot de passe. Un serveur etcd répondra par une réponse d’authentification. Cette réponse sera un jeton d’authentification en cas de succès, ou une erreur en cas d’échec. Le client peut utiliser son jeton d’authentification pour présenter ses identifiants à etcd lors de requêtes API.
La connexion cliente utilisée pour demander le jeton d’authentification est généralement abandonnée ; elle ne peut pas transporter les informations d’authentification du nouveau jeton. Cela est dû au fait que gRPC ne permet pas d’ajouter des informations d’authentification par appel RPC après la création de la connexion (appel à grpc.Dial()). Par conséquent, un client ne peut pas attribuer un jeton à sa connexion s’il l’obtient via cette connexion. Le client doit établir une nouvelle connexion pour utiliser le jeton.
Notes sur l’implémentation de l’appel RPC Authenticate()
Authenticate() génère un jeton d’authentification à partir d’un nom d’utilisateur et d’un mot de passe fournis. etcd enregistre et vérifie un mot de passe configuré et un mot de passe fourni à l’aide du package bcrypt de Go. Par conception, le mécanisme de vérification des mots de passe de bcrypt est coûteux en termes de calcul, nécessitant près de 100 ms sur un serveur x64 ordinaire. Par conséquent, effectuer cette vérification dans la phase apply de la machine d’état entraînerait des problèmes de performance : le cluster etcd ne pourrait servir qu’approximativement 10 Authenticate() requêtes par seconde.
Pour des performances optimales, le mécanisme d’authentification v3 vérifie les mots de passe au niveau de l’API etcd, où cette vérification peut être parallélisée en dehors de raft. Toutefois, cela peut entraîner des failles potentielles de permission time-of-check/time-of-use (TOCTOU) :
- le client A envoie une requête
Authenticate() - le niveau de l’API traite la partie de vérification du mot de passe de
Authenticate() - un autre client B envoie une requête de
ChangePassword()et le serveur la traite - le niveau de la machine d’état traite la partie obtenir un numéro de révision pour le
Authenticate()provenant de A - le serveur retourne un succès au client A
- le client A est désormais authentifié avec un mot de passe obsolète
Pour éviter une telle situation, la couche API effectue une vérification du numéro de version basée sur le numéro de révision du magasin d’authentification. Lors de la vérification du mot de passe, la couche API enregistre le numéro de révision du magasin d’authentification. Après une vérification réussie du mot de passe, la couche API compare le numéro de révision enregistré avec le numéro de révision le plus récent. Si les numéros diffèrent, cela signifie qu’un autre utilisateur a mis à jour les métadonnées d’authentification. Dans ce cas, elle réessaie la vérification. Grâce à ce mécanisme, la vérification réussie du mot de passe basée sur un mot de passe obsolète peut être évitée.
Résolution d’un jeton au niveau de l’API
Après s’être authentifié avec Authenticate(), un client peut établir une connexion gRPC comme il le ferait sans authentification. En plus du processus d’initialisation existant, le client doit associer le jeton à la connexion nouvellement créée. grpc.WithPerRPCCredentials() fournit la fonctionnalité nécessaire à cette opération.
Chaque requête authentifiée provenant du client dispose d’un jeton. Ce jeton peut être obtenu avec grpc.metadata.FromIncomingContext() côté serveur. Le serveur peut déterminer qui émet la requête et à quel moment l’utilisateur a été autorisé. Ces informations seront renseignées par la couche API dans l’en-tête (etcdserverpb.RequestHeader.Username et etcdserverpb.RequestHeader.AuthRevision) d’une entrée de journal Raft (etcdserverpb.InternalRaftRequest).
Vérification de la permission dans la machine à états
Les informations d’authentification dans etcdserverpb.RequestHeader sont vérifiées lors de l’étape d’application de la machine à états. Cette étape vérifie que l’utilisateur dispose des autorisations nécessaires pour accéder aux clés demandées, selon la dernière révision du magasin d’authentification.
Deux types de jetons : simples et JWT
Il existe deux types de jetons : simples et JWT. Le jeton simple n’est pas conçu pour les cas d’utilisation en production. Ses jetons ne sont pas signés cryptographiquement, et les serveurs doivent suivre de manière étatique la correspondance entre jetons et utilisateurs ; il est destiné à des tests en développement. Les jetons JWT doivent être utilisés pour les déploiements en production, car ils sont signés et vérifiés cryptographiquement. Du point de vue de l’implémentation, le JWT est sans état. Son jeton peut inclure des métadonnées, notamment le nom d’utilisateur et la révision, de sorte que les serveurs n’aient pas à mémoriser la correspondance entre les jetons et les métadonnées.
Un problème connu#18437 concerne les jetons simples. Dans les serveurs etcd, les jetons sont résolus au niveau de l’API et les jetons simples sont étatiques. Ce processus n’est pas protégé par une vérification linéarisable, ce qui signifie qu’un membre etcd peut ne pas avoir terminé le traitement d’une requête d’authentification précédente avant de recevoir la suivante. Dans de tels cas, le membre peut renvoyer une erreur « jeton d’authentification invalide » au client. Ce problème est généralement rare sur un nœud disposant de conditions réseau favorables, mais peut survenir en cas de latence importante. En tant que contournement, les applications peuvent implémenter un mécanisme de nouvelle tentative pour gérer cette erreur.
Définition directe des jetons JWT
En plus du flux RPC standard Authenticate(), etcd prend en charge la définition de jetons JWT directement au niveau du client. Cela permet aux applications de gérer l’intégralité du cycle de vie des jetons JWT en dehors d’etcd, y compris la génération, la validation et le renouvellement.
Cas d’utilisation et flux de travail
Cette approche est utile lorsque :
- Un système de gestion des jetons indépendant (en dehors d’etcd) gère la génération et le cycle de vie des jetons JWT
- Les applications reçoivent des jetons JWT pré-signés via un mécanisme externe (par exemple, des variables d’environnement, un service de configuration)
- Le cycle de vie des jetons doit être géré entièrement par l’application cliente et non par la génération automatique de jetons d’etcd
Le flux de travail typique est :
- Une autorité externe (non etcd) génère un jeton JWT signé qui inclut le nom d’utilisateur et d’autres revendications
- L’application reçoit le jeton pré-signé et configure le client etcd avec celui-ci
- Le client soumet le jeton JWT directement avec les requêtes (sans appeler
Authenticate()) - Le serveur etcd valide la signature du jeton à l’aide de sa clé publique configurée et accorde l’accès en fonction du nom d’utilisateur contenu dans le jeton
- Avant l’expiration du jeton, l’application obtient un nouveau jeton auprès de l’autorité externe
- L’application crée un nouveau client avec le jeton mis à jour (la mise à jour du jeton nécessite la recréation du client)
Comment il diffère de l’authentification standard
Lors de l’utilisation du flux standard Authenticate() :
- Le client appelle
Authenticate()avec le nom d’utilisateur et le mot de passe - etcd génère et renvoie un jeton
- Le client utilise automatiquement ce jeton pour les requêtes ultérieures
- La mise à jour du jeton nécessite d’appeler à nouveau
Authenticate()
Lorsque les jetons JWT sont définis directement :
- Le client est initialisé avec un jeton JWT pré-signé
- Le client ne fait pas appel à
Authenticate() - Le jeton est utilisé directement dans toutes les requêtes
- L’application cliente est responsable d’obtenir de nouveaux jetons avant l’expiration et de gérer le cycle de vie du client
AuthStatus sans jeton valide
Pour prendre en charge les applications qui gèrent elles-mêmes leurs jetons JWT, l’API RPC AuthStatus a été conçue afin de permettre aux clients de déterminer si l’authentification est activée et de récupérer la révision actuelle de authRevision. Cela est essentiel dans les scénarios de récupération où un jeton a expiré et où le client a besoin de la dernière révision afin d’obtenir un nouveau jeton valide auprès de son fournisseur externe de jetons.
Sans cette fonctionnalité, un jeton expiré pourrait empêcher un client d’accéder au authRevision actuel, entraînant un blocage dans lequel aucun nouveau jeton ne peut être généré.
Remarques sur la différence entre les modèles KVS et les modèles de système de fichiers
etcd v3 est un système de stockage clé-valeur (KVS), et non un système de fichiers. Les autorisations peuvent donc être attribuées aux utilisateurs sous la forme d’un nom de clé exact ou d’une plage de clés, comme ["start key", "end key"). Cela signifie qu’il est possible d’accorder des autorisations pour une clé inexistante. Les utilisateurs doivent veiller à ne pas accorder involontairement des autorisations. Dans un système similaire à un système de fichiers (par exemple Chubby ou ZooKeeper), une structure de données analogue à un inode peut contenir les informations d’autorisation. Il n’est alors pas possible d’accorder une autorisation à une clé inexistante (à l’exception du cas des bits sticky).
Le modèle etcd v3 nécessite plusieurs recherches de métadonnées, contrairement aux systèmes de fichiers. Le coût maximal de recherche correspond à la somme des clés et intervalles accordés par l’utilisateur. Ce coût ne peut être évité, car l’espace de clés plat du v3 diffère entièrement du modèle de système de fichiers Unix (où chaque inode inclut des métadonnées de permissions). En pratique, ce coût ne pose pas de problème sérieux, car les métadonnées sont suffisamment petites pour bénéficier du cache.
12.5 - etcd API
Ce document a pour objectif de présenter une vue d’ensemble des principes fondamentaux de l’API v3 d’etcd. Il ne doit pas être confondu avec l’API etcd v2, dépréciée à partir d’etcd v3.5. Il ne prétend pas être exhaustif, mais vise à se concentrer sur les idées de base nécessaires à la compréhension d’etcd, sans les distractions des appels d’API moins courants. Toutes les API etcd sont définies dans des services gRPC , qui catégorisent les appels de procédure distante (RPC) compris par le serveur etcd. Une liste complète de toutes les RPC etcd est documentée au format markdown dans le listing des API gRPC .
Services gRPC
Chaque requête d’API envoyée à un serveur etcd est un appel de procédure à distance gRPC. Les appels RPC dans etcd sont catégorisés selon leur fonctionnalité en services.
Les services importants pour la gestion de l’espace clé de etcd incluent :
- KV - Crée, met à jour, récupère et supprime des paires clé-valeur.
- Watch - Surveille les modifications apportées aux clés.
- Lease - Primitives pour consommer les messages de maintien de connexion client.
Les services qui gèrent le cluster lui-même incluent :
- Auth - Mécanisme d’authentification basée sur les rôles pour authentifier les utilisateurs.
- Cluster - Fournit des informations sur les membres et des fonctionnalités de configuration.
- Maintenance - Prend des instantanés de récupération, défait les fragments du magasin et retourne des informations d’état par membre.
Requêtes et réponses
Toutes les requêtes RPC dans etcd suivent le même format. Chaque RPC dispose d’une fonction Name qui prend NameRequest en argument et renvoie NameResponse en réponse. Par exemple, voici la description de la requête RPC Range :
En-tête de réponse
Toutes les réponses de l’API etcd incluent un en-tête de réponse qui contient des métadonnées du cluster pour la réponse :
- Cluster_ID - l’identifiant du cluster générant la réponse.
- Member_ID - l’identifiant du membre générant la réponse.
- Revision - la révision du magasin clé-valeur lors de la génération de la réponse.
- Raft_Term - le terme Raft du membre lors de la génération de la réponse.
Une application peut lire le champ Cluster_ID ou Member_ID pour s’assurer qu’elle communique avec le cluster (membre) prévu.
Les applications peuvent utiliser le champ Revision pour connaître la dernière révision du magasin clé-valeur. Cela est particulièrement utile lorsque les applications spécifient une révision historique afin d’effectuer une time travel query et souhaitent connaître la dernière révision au moment de la requête.
Les applications peuvent utiliser Raft_Term pour détecter quand le cluster termine une nouvelle élection de leader.
API clé-valeur
L’API Clé-Valeur manipule des paires clé-valeur stockées dans etcd. La majorité des requêtes adressées à etcd sont généralement des requêtes clé-valeur.
Primitives système
Paire clé-valeur
Une paire clé-valeur est l’unité minimale manipulable par l’API clé-valeur. Chaque paire clé-valeur possède un certain nombre de champs, définis au format protobuf :
- Clé - clé sous forme d’octets. Une clé vide n’est pas autorisée.
- Valeur - valeur sous forme d’octets.
- Version - version de la clé. Une suppression réinitialise la version à zéro, et toute modification de la clé augmente sa version.
- Révision_Création - révision de la dernière création sur la clé.
- Révision_Modification - révision de la dernière modification sur la clé.
- Bail - identifiant du bail attaché à la clé. Si le bail est égal à zéro, aucun bail n’est attaché à la clé.
En plus de la clé et de sa valeur, etcd attache des métadonnées de révision supplémentaires au message de clé. Ces informations de révision ordonnent les clés selon leur date de création et de modification, ce qui est utile pour gérer la concurrence dans la synchronisation distribuée. Les verrous partagés distribués du client etcd verrous partagés distribués utilisent la révision de création pour attendre la possession du verrou. De même, la révision de modification est utilisée pour détecter les conflits sur l’ensemble de lecture du mémoire transactionnelle logicielle et attendre les mises à jour du élection du leader .
Révisions
etcd maintient un compteur 64 bits valable pour l’ensemble du cluster, appelé révision du magasin, qui est incrémenté à chaque modification de l’espace clé. La révision sert d’horloge logique globale, ordonnant séquentiellement toutes les mises à jour du magasin. Le changement représenté par une nouvelle révision est incrémental ; les données associées à une révision sont celles qui ont modifié le magasin. En interne, une nouvelle révision signifie écrire les modifications dans l’arbre B+ du backend, indexées par la révision incrémentée.
Les révisions prennent davantage de valeur lorsqu’on considère le backend contrôle de concurrence à plusieurs versions d’etcd. Le modèle MVCC signifie que le magasin clé-valeur peut être consulté à partir de révisions passées, car les anciennes versions des clés sont conservées. La politique de conservation de cet historique peut être configurée par les administrateurs du cluster afin de gérer finement le stockage ; en général, etcd supprime les anciennes révisions des clés selon un horaire. Un cluster etcd typique conserve les données obsolètes des clés pendant plusieurs heures. Cela permet également une gestion fiable des déconnexions longues des clients, et non seulement des perturbations réseau transitoires : les observateurs reprennent simplement à partir de la dernière révision historique observée. De même, pour lire dans le magasin à un instant précis, les requêtes de lecture peuvent être étiquetées avec une révision afin de retourner les clés selon une vue de l’espace des clés au moment où cette révision a été validée.
Plages de clés
Le modèle de données etcd indexe toutes les clés dans un espace binaire plat. Cela diffère des autres systèmes de magasin clé-valeur qui organisent les clés selon une structure hiérarchique en répertoires. Au lieu de lister les clés par répertoire, les clés sont listées par intervalles de clés [a, b).
Ces intervalles sont souvent appelés « plages » dans etcd. Les opérations sur les plages sont plus puissantes que les opérations sur les répertoires. Comme un magasin hiérarchique, les plages permettent les recherches par clé unique via [a, a+1) (par exemple, [‘a’, ‘a\x00’) recherche ‘a’) et les recherches par répertoire en codant les clés selon leur profondeur dans l’arborescence. En plus de ces opérations, les plages peuvent également encoder des préfixes ; par exemple, la plage ['a', 'b') recherche toutes les clés dont le préfixe est la chaîne ‘a’.
Par convention, les plages pour une requête sont indiquées par les champs key et range_end. Le champ key est la première clé de la plage et doit être non vide. Le champ range_end est la clé suivant la dernière clé de la plage. Si range_end n’est pas fourni ou est vide, la plage est définie comme ne contenant que la clé fournie. Si range_end est égal à key plus un (par exemple, “aa”+1 == “ab”, “a\xff”+1 == “b”), alors la plage représente toutes les clés ayant pour préfixe la clé. Si les deux champs key et range_end sont égaux à ‘\0’, la plage représente toutes les clés. Si range_end est égal à ‘\0’, la plage correspond à toutes les clés supérieures ou égales à la clé fournie.
Plage
Les clés sont récupérées depuis le magasin clé-valeur à l’aide de l’appel d’API Range, qui prend un RangeRequest :
- Clé, PlageFin - Plage de clés à récupérer.
- Limite - nombre maximal de clés retournées pour la requête. Si la limite est définie à 0, elle est traitée comme sans limite.
- Révision - instantané du magasin clé-valeur à utiliser pour la plage. Si la révision est inférieure ou égale à zéro, la plage concerne le dernier magasin clé-valeur. Si la révision est compactée, la réponse renvoie ErrCompacted.
- OrdreTri - ordre de tri pour les requêtes triées.
- CibleTri - champ du magasin clé-valeur à trier.
- Sérialisable - active les lectures locales sérialisables pour la requête de plage. Par défaut, Range est linéarisable ; elle reflète le consensus actuel du cluster. Pour de meilleures performances et disponibilité, au prix de lectures potentiellement obsolètes, une requête de plage sérialisable est servie localement sans nécessiter de consensus avec les autres nœuds du cluster.
- ClésUniquement - ne retourne que les clés, et non les valeurs.
- ComptageUniquement - ne retourne que le nombre de clés dans la plage.
- MinRévisionMod - borne inférieure des révisions de modification des clés ; filtre les révisions inférieures.
- MaxRévisionMod - borne supérieure des révisions de modification des clés ; filtre les révisions supérieures.
- MinRévisionCréation - borne inférieure des révisions de création des clés ; filtre les révisions inférieures.
- MaxRévisionCréation - borne supérieure des révisions de création des clés ; filtre les révisions supérieures.
Le client reçoit un message RangeResponse de l’appel Range :
- Kvs - la liste des paires clé-valeur correspondant à la requête de plage. Lorsque
Count_Onlyest défini,Kvsest vide. - More - indique s’il reste des clés à renvoyer dans la plage demandée si
limitest défini. - Count - le nombre total de clés satisfaisant la requête de plage.
Pour les plages de clés importantes où le tamponnage de la réponse complète est indésirable, consultez RangeStream .
RangeStream
RangeStream retourne le même jeu de résultats que Range, mais le serveur fractionne la réponse en une séquence de morceaux et la diffuse au client. Cela évite de stocker entièrement de grandes plages en mémoire côté serveur ou côté client. RangeStream accepte les mêmes RangeRequest que Range.
Le client reçoit un flux de messages RangeStreamResponse à partir de l’appel RangeStream :
Remplissage des champs par tranches :
- Kvs - chaque tranche contient une tranche disjointe du résultat. En concaténant les
kvsde chaque tranche dans l’ordre de leur arrivée, on obtient le même ensemble de clés qu’une unique requêteRange. - Header, More, Count - renseignés uniquement dans la dernière tranche, et uniquement lorsque le flux se termine sans erreur. Les tranches précédentes laissent ces champs à zéro. Appliquer
proto.Mergesur lerange_responsede chaque tranche donne unRangeResponseéquivalent à ce queRangeaurait retourné.
Si le flux se termine avec une erreur, aucun morceau ne contient de header, more ou count valide.
Chaque morceau du flux est servi en référence à la même révision. Si la requête ne définit pas Revision, le serveur capture la dernière révision validée au moment du démarrage du flux et la réutilise pour le reste du flux.
RangeStream ne prend pas en charge les ordres de tri personnalisés ni les filtres de révision (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Les requêtes utilisant l’un ou l’autre retournent Unimplemented. RangeStream n’est également pas pris en charge par le proxy gRPC etcd.
Il existe deux méthodes courantes pour consommer un RangeStream :
- Traitez chaque tranche indépendamment. Adapté aux scénarios à haute performance où le client souhaite décoder et agir sur les clés au fur et à mesure de leur arrivée, plutôt que de collecter l’ensemble du résultat d’abord. Le client itère les tranches et traite
kvsde chacune, puis litheader,moreoucountde la dernière tranche après la fin propre du flux. - Assemblez une seule réponse. Adapté lorsque le client souhaite obtenir un résultat équivalent à une requête unaire
Range. Le client fusionne chaquerange_responsede tranche en un seulRangeResponse(par exemple, à l’aide deproto.Merge). Le résultat fusionné contient l’intégralité dekvs, ainsi queheader,moreetcountprovenant de la dernière tranche. Le client Go fournitclientv3.GetStreamToGetResponsecomme aide pour ce schéma.
Mettre
Les clés sont stockées dans le magasin clé-valeur en émettant un appel à Put, qui prend un PutRequest :
- Clé - le nom de la clé à insérer dans le magasin clé-valeur.
- Valeur - la valeur, en octets, à associer à la clé dans le magasin clé-valeur.
- Bail - l’identifiant de bail à associer à la clé dans le magasin clé-valeur. Une valeur de bail égale à 0 indique l’absence de bail.
- Préc_Kv - lorsque défini, renvoie les données de la paire clé-valeur précédente à la mise à jour effectuée par cette
Putrequête. - Ignorer_Valeur - lorsque défini, met à jour la clé sans modifier sa valeur actuelle. Retourne une erreur si la clé n’existe pas.
- Ignorer_Bail - lorsque défini, met à jour la clé sans modifier son bail actuel. Retourne une erreur si la clé n’existe pas.
Le client reçoit un message PutResponse de l’appel Put :
- Prev_Kv - la paire clé-valeur écrasée par
Put, siPrev_Kva été défini dansPutRequest.
Supprimer une plage
Les plages de clés sont supprimées à l’aide de l’appel DeleteRange, qui prend un DeleteRangeRequest :
- Clé, PlageFin — Plage de clés à supprimer.
- ValeurPrécédente — si définie, retourne le contenu des paires clé-valeur supprimées.
Le client reçoit un message DeleteRangeResponse de l’appel DeleteRange :
- Supprimé - nombre de clés supprimées.
- Prev_Kv - liste de toutes les paires clé-valeur supprimées par l’opération
DeleteRange.
Transaction
Une transaction est une construction atomique If/Then/Else sur le magasin clé-valeur. Elle fournit une primitive pour regrouper des requêtes dans des blocs atomiques (c’est-à-dire then/else), dont l’exécution est protégée (c’est-à-dire if) en fonction du contenu du magasin clé-valeur. Les transactions peuvent être utilisées pour protéger les clés contre des mises à jour concurrentes non désirées, pour mettre en œuvre des opérations compare-and-swap, et pour développer des contrôles de concurrence de niveau supérieur.
Une transaction peut traiter atomiquement plusieurs requêtes en une seule requête. Pour les modifications du magasin clé-valeur, cela signifie que la révision du magasin n’est incrémentée qu’une seule fois pour la transaction, et que tous les événements générés par la transaction auront la même révision. Toutefois, les modifications apportées à la même clé plusieurs fois au sein d’une même transaction sont interdites.
Toutes les transactions sont protégées par une conjonction de comparaisons, similaire à une instruction If. Chaque comparaison vérifie une seule clé dans le magasin. Elle peut vérifier l’absence ou la présence d’une valeur, la comparer à une valeur donnée, ou vérifier la révision ou la version d’une clé. Deux comparaisons différentes peuvent s’appliquer à la même clé ou à des clés différentes. Toutes les comparaisons sont appliquées de manière atomique ; si toutes les comparaisons sont vraies, la transaction est considérée comme réussie et etcd applique le bloc de requête then / success, sinon elle est considérée comme échouée et applique le bloc de requête else / failure.
Chaque comparaison est encodée sous la forme d’un message Compare :
- Résultat - le type d’opération de comparaison logique (par exemple, égal, inférieur à, etc.).
- Cible - le champ clé-valeur à comparer. Soit la version de la clé, la révision de création, la révision de modification ou la valeur.
- Clé - la clé pour la comparaison.
- Cible_Union - les données spécifiées par l’utilisateur pour la comparaison.
Après le traitement du bloc de comparaison, la transaction applique un bloc de requêtes. Un bloc est une liste de messages RequestOp :
- Request_Range - une
RangeRequest. - Request_Put - une
PutRequest. Les clés doivent être uniques. Elle ne peut pas partager de clés avec d’autres opérations Put ou Delete. - Request_Delete_Range - une
DeleteRangeRequest. Elle ne peut pas partager de clés avec des requêtes Put ou Delete.
Ensemble, une transaction est émise par un appel API Txn, qui prend un TxnRequest :
- Compare - Une liste de prédicats représentant une conjonction de termes servant à protéger la transaction.
- Success - Une liste de requêtes à traiter si toutes les évaluations des tests Compare retournent true.
- Failure - Une liste de requêtes à traiter si l’une quelconque des évaluations des tests Compare retourne false.
Le client reçoit un message TxnResponse de l’appel Txn :
- Réussi - Indique si
Comparea été évalué à true ou false. - Réponses - Liste des réponses correspondant aux résultats de l’application du bloc
Successsi réussi est true, ou du blocFailuresi réussi est false.
La liste Responses correspond aux résultats de la liste RequestOp appliquée, chaque réponse étant encodée sous la forme d’un ResponseOp :
Le ResponseHeader inclus dans chaque réponse interne ne doit en aucun cas être interprété.
Si les clients doivent obtenir la dernière révision, ils doivent toujours vérifier le ResponseHeader au niveau supérieur dans TxnResponse.
API de surveillance
L’API Watch fournit une interface basée sur des événements pour surveiller de manière asynchrone les modifications apportées aux clés. Une surveillance etcd attend les modifications apportées aux clés en surveillant continuellement à partir d’une révision donnée, actuelle ou historique, et diffuse les mises à jour des clés vers le client.
Événements
Chaque modification de chaque clé est représentée par des messages Event. Un message Event fournit à la fois les données de la mise à jour et le type de mise à jour :
- Type - Le type d’événement. Un type PUT indique que de nouvelles données ont été stockées pour la clé. Un type DELETE indique que la clé a été supprimée.
- KV - La paire clé-valeur associée à l’événement. Un événement PUT contient la paire clé-valeur actuelle. Un événement PUT avec kv.Version=1 indique la création d’une clé. Un événement DELETE contient la clé supprimée, dont la révision de modification est définie sur la révision de la suppression.
- Prev_KV - La paire clé-valeur de la clé à la révision immédiatement antérieure à l’événement. Pour économiser la bande passante, cette information n’est renseignée que si la surveillance a explicitement activé cette fonctionnalité.
Surveillance des flux
Les surveillance sont des requêtes à exécution longue et utilisent des flux gRPC pour transmettre les données d’événements. Un flux de surveillance est bidirectionnel : le client écrit dans le flux pour établir des surveillance et lit pour recevoir les événements de surveillance. Un seul flux de surveillance peut multiplexer plusieurs surveillance distinctes en étiquetant les événements avec des identifiants propres à chaque surveillance. Cette multiplexion permet de réduire la charge mémoire et le surcroît de connexion sur le cluster central etcd.
Pour en savoir plus sur les garanties relatives aux événements de surveillance, veuillez consulter garanties de l’API etcd .
Un client crée une surveillance en envoyant un WatchCreateRequest sur un flux renvoyé par Watch :
- Clé, PlageFin - La plage de clés à surveiller.
- RévisionDébut - Une révision facultative à partir de laquelle commencer la surveillance de manière inclusive. Si elle n’est pas fournie, la diffusion en continu des événements suit la révision indiquée dans l’en-tête de réponse de création de surveillance. L’historique complet des événements peut être surveillé à partir de la dernière révision de compactage.
- NotificationProgression - Lorsqu’elle est définie, la surveillance reçoit périodiquement une réponse de surveillance sans événements, si aucun événement récent n’est disponible. Cela est utile lorsque les clients souhaitent récupérer un observateur déconnecté à partir d’une révision connue récente. Le serveur etcd détermine la fréquence d’envoi des notifications en fonction de la charge actuelle du serveur.
- Filtres - Liste des types d’événements à filtrer côté serveur.
- ValeurPrécédente - Lorsqu’elle est définie, la surveillance reçoit les données clé-valeur antérieures à l’événement. Cela est utile pour connaître les données qui ont été écrasées.
En réponse à un WatchCreateRequest ou si un nouvel événement est détecté pour une surveillance déjà établie, le client reçoit un WatchResponse :
- Watch_ID - l’identifiant de la surveillance correspondant à la réponse.
- Créé - défini à true si la réponse correspond à une requête de création de surveillance. Le client doit stocker l’identifiant et s’attendre à recevoir des événements pour cette surveillance sur le flux. Tous les événements envoyés à l’observateur créé auront le même watch_id.
- Annulé - défini à true si la réponse correspond à une requête d’annulation de surveillance. Aucun événement supplémentaire ne sera envoyé à l’observateur annulé.
- Révision_Compactée - défini à la révision historique minimale disponible dans etcd si un observateur tente de surveiller à une révision compactée. Cela se produit lorsqu’un observateur est créé à une révision compactée ou lorsque l’observateur ne parvient pas à suivre l’évolution du magasin clé-valeur. L’observateur sera annulé ; la création de nouvelles surveillances avec la même start_revision échouera.
- Événements - une liste d’événements nouveaux, dans l’ordre, correspondant à l’identifiant de surveillance donné.
Si le client souhaite cesser de recevoir des événements pour une surveillance, il émet un WatchCancelRequest :
- Watch_ID - l’ID de la surveillance à annuler afin qu’aucun événement supplémentaire ne soit transmis.
API bail
Les bails sont un mécanisme de détection de la disponibilité des clients. Le cluster accorde des bails avec une durée de vie. Un bail expire si le cluster etcd ne reçoit pas de keepAlive dans le délai TTL imparti.
Pour lier les bails au magasin clé-valeur, chaque clé peut être associée à au plus un bail. Lorsqu’un bail expire ou est révoqué, toutes les clés associées à ce bail sont supprimées. Chaque clé supprimée génère un événement de suppression dans l’historique des événements.
Obtention des bails
Les bails sont obtenus via l’appel d’API LeaseGrant, qui prend un LeaseGrantRequest :
- TTL - le délai d’expiration conseillé, en secondes.
- ID - l’identifiant demandé pour le bail. Si l’ID est défini à 0, etcd choisira un identifiant.
Le client reçoit un LeaseGrantResponse de l’appel LeaseGrant :
- ID - l’identifiant du bail pour le bail accordé.
- TTL - est le délai d’expiration, en secondes, sélectionné par le serveur pour le bail.
- ID - l’identifiant du bail à révoquer. Lorsque le bail est révoqué, toutes les clés associées sont supprimées.
Keep alives
Les bails sont actualisés à l’aide d’un flux bidirectionnel créé à l’aide de l’appel d’API LeaseKeepAlive. Lorsque le client souhaite actualiser un bail, il envoie un LeaseKeepAliveRequest sur le flux :
- ID - l’identifiant du bail dont il faut maintenir la validité.
Le flux de maintien de connexion répond avec un LeaseKeepAliveResponse :
- ID - le bail qui a été actualisé avec un nouveau délai de validité.
- TTL - le nouveau délai de validité, en secondes, restant pour le bail.
12.6 - etcd fichiers de stockage persistant
Ce document explique le format de stockage persistant d’etcd : nomenclature, contenu et outils permettant aux développeurs d’en inspecter le contenu. À l’avenir, ce document devrait être mis à jour pour refléter les évolutions du modèle de stockage. Il s’adresse aux développeurs d’etcd afin de les aider dans leurs besoins de récupération de données.
Prérequis
Les articles suivants fournissent des informations de fond utiles pour ce document :
- Vue d’ensemble du modèle de données etcd
- Vue d’ensemble de Raft (notamment la section « 5.3 Réplication des journaux »).
Aperçu
Fichiers en attente prolongée
| Nom de fichier | Objectif général |
|---|---|
./member/snap/db | bbolt b+tree qui stocke toutes les données appliquées, les informations d'autorisation d'appartenance et les métadonnées. Il est au courant de l'index du dernier journal WAL appliqué ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap | Instantanés périodiques de l’ancien magasin v2, contenant :
À compter de etcd v3, le contenu est redondant par rapport au contenu des fichiers /snap/db. Périodiquement (30s), ces fichiers sont supprimés, et les derniers |
/member/snap/000000000007a178.snap.db | Un instantané bbolt téléchargé depuis le leader etcd si la réplica était trop en retard. Possède le même type de contenu que le fichier ( Le fichier est utilisé dans deux scénarios :
Le fichier n'est pas supprimé une fois la récupération terminée (le contenu entier est donc copié dans le fichier ./member/snap/db). Périodiquement (30s), les fichiers sont purgés.
Ici aussi, |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal | Journaux d'écriture de Raft, contenant les transactions récentes acceptées par Raft, ainsi que des instantanés périodiques ou des enregistrements CRC. Les fichiers récents Si les instantanés sont trop espacés, il peut y avoir plus de |
./member/wal/0.tmp (or .../1.tmp) | Espace préalloué pour le prochain fichier de journalisation d'avance. Utilisé pour éviter que Raft ne reste bloqué en raison d'un manque de capacité des journaux WAL, sans possibilité de déclencher une alarme. |
Fichiers temporaires
Pendant le traitement interne d’etcd, il est possible de rencontrer plusieurs fichiers à durée de vie courte :
| Fichier | Objectif général |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken | Les fichiers d'instantané sont renommés en « broken » lorsqu'ils ne peuvent pas être chargés. L'essai de charger le fichier le plus récent a lieu lorsque etcd est démarré. Ou lors des commandes de sauvegarde/restauration d'etcdctl. |
./member/snap/tmp071677638 (random suffix) | Fichier temporaire (bbolt) créé sur les réplicas en réponse à la demande de snapshot du leader, afin de répondre à la demande du leader de restaurer le stockage à partir de l'instantané fourni. Après une récupération réussie (complète) du contenu, le fichier est renommé en : Voir etcd/issues/12837. Corrigé dans etcd 3.5. |
/member/snap/db.tmp.071677638 (random suffix) | Un fichier temporaire contenant une copie du contenu du backend (/member/snap/db), pendant le processus de défragmentation. Une fois le processus réussi, le fichier est renommé en /member/snap/db, remplaçant ainsi le backend original. Au démarrage du serveur etcd, ces fichiers sontsupprimés. |
bbolt arbre B+ : member/snap/db
Ce fichier contient le contenu principal d’etcd, appliqué à un point spécifique du journal Raft (voir consistent_index ).
Organisation physique
Le stockage bolt est physiquement organisé sous la forme d’un arbre b+tree . Les pages physiques de l’arbre b+ ne sont jamais modifiées in situ[^1]. À la place, leur contenu est copié vers une nouvelle page (récupérée à partir de la liste des pages libres), et la page ancienne est ajoutée à la liste des pages libres dès qu’aucune transaction ouverte ne peut plus y accéder. Grâce à ce processus, une transaction RO ouverte voit un état cohérent de l’historique du stockage. Une transaction RW est exclusive et bloque toutes les autres transactions RW. Les grandes valeurs sont stockées sur plusieurs pages continues. Le processus de récupération de pages combiné à la nécessité d’attribuer des zones contiguës de pages de tailles différentes peut entraîner une fragmentation croissante du stockage bbolt.
Le fichier bbolt ne se réduit jamais automatiquement. Seul le processus de défragmentation permet de réécrire le fichier dans un nouveau fichier disposant d’une certaine réserve de pages libres à la fin et dont la taille a été tronquée.
Organisation logique
Le stockage bbolt est divisé en compartiments. Dans chaque compartiment, des clés (paires byte[]->byte[] valeurs) sont stockées dans l’ordre lexicographique. La liste ci-dessous représente les compartiments utilisés par etcd (à partir de la version 3.5) ainsi que les clés en usage.
| Bucket | Clé | Valeur d'exemple | Description |
|---|---|---|---|
| alarme | rpcpb.Alarm :
{MemberID, Alarme : NONE|NOSPACE|CORRUPT} | nil | Indique que des problèmes ont été diagnostiqués sur l'un des membres. |
| auth | "authRevision" | "" (vide) ou BigEndian.PutUint64 | Tout changement de rôles ou d'utilisateurs incrémente ce champ à la validation de la transaction. La valeur n'est utilisée que pour le verrouillage optimiste durant le processus d'autorisation. |
| authRoles | [roleName] en tant que chaîne | authpb.Role sérialisé | |
| authUsers | [userName] en tant que chaîne | authpb.User sérialisé | |
| cluster | "clusterVersion" | "3.5.0" (chaîne) | mineur version du consensus-agréé de la version de stockage commun. |
| "désinstaller" | JSON:{
"target-version": "3.4.0"
"enabled": true/false
} | Persiste l'intention configurée par la requête la plus récente : Depuis la version v3.5 | |
| clé | [révisionId] encodée à l'aide de bytesToRev{principal,sous} Les suppressions de paires clé-valeur sont sérialisées avec un « t » à la fin (comme une « sépulture ») | mvccpb.KeyValue protocole encodé (key, create_rev, mod_rev, version, value, lease id) | |
| bail | leasepb.Lease protocole marshalled (ID, TTL, RemainingTTL) | Remarque : LeaseCheckpoint étend uniquement RemainingTTL. Le TTL provient uniquement de l'origine de Grant. Note2 : les TTL sont conservés en secondes (à partir de la valeur « now » non définie). Un serveur pris dans une boucle de redémarrage ne libère pas les baux !!! | |
| membres | [memberId] en hexadécimal sous forme de chaîne : "8e9e05c52164694d" | Chaîne JSON sérialisée du type membre :{
"id":10276657743932975437,
"peerURLs":[
"http://localhost:2380"],
"name":"default",
"clientURLs": ["http://localhost:2379"]
} | Informations d'appartenance au cluster convenues. |
| membres_supprimés | [memberId] en hexadécimal sous forme de chaîne : "8e9e05c52164694d" | []byte("removed") | Identifiants de tous les membres supprimés. Utilisé pour vérifier qu'un membre supprimé n'est jamais réajouté sous le même identifiant. Le champ est actuellement (3.4) lu à partir du magasin V2 et jamais à partir de V3. Voir https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64 octets (BigEndian) | Représente le décalage de la dernière entrée WAL appliquée au stockage Bolt DB. |
| "scheduledCompactRev" | bytesToRevencodés {main,sub}. (16 octets) | Utilisé pour réinitialiser le compactage si un incident s'est produit après une demande de compactage. | |
| "finishedCompactRev" | bytesToRevencodés {main,sub}. (16 octets) | Révision à laquelle le magasin a été récemment compacté (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Depuis etcd 3.5 | ||
| "term" | Depuis etcd 3.5 | ||
| "version-stockage" |
Outils
bbolt
bbolt dispose d’un outil en ligne de commande permettant d’inspecter le contenu du fichier.
Exemples d’utilisation :
Lister tous les buckets dans le fichier bbolt donné :
Lire une paire clé/valeur particulière :
etcd-dump-db
etcd-dump-db peut être utilisé pour lister le contenu du backend v3 d’etcd (bbolt).
Voir d’autres exemples dans : https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL : journal d’écriture anticipée
Le journal d’écriture anticipée (Write ahead log) est un stockage persistant Raft utilisé pour stocker les propositions. Le leader stocke d’abord la proposition dans son journal, puis la réplique simultanément aux suiveurs à l’aide du protocole Raft. Chaque suiveur persiste la proposition dans son WAL avant de confirmer la réplication au leader.
Le journal WAL utilisé dans etcd diffère du modèle Raft canonique en deux sens :
- Il persiste non seulement les entrées indexées, mais aussi les instantanés Raft (légers) et l’état dur. Ainsi, l’état Raft complet du membre peut être récupéré à partir du journal WAL seul.
- Il est en écriture seule. Les entrées ne sont pas remplacées in situ, mais une entrée ajoutée ultérieurement dans le fichier (avec le même index) remplace la précédente.
Noms de fichiers
Les fichiers de journal WAL sont nommés selon le motif suivant :
Exemple : ./member/wal/0000000000000010-00000000000bf1e6.wal
Ainsi, les noms de fichiers contiennent des chaînes codées en hexadécimal :
- Numéro séquentiel du fichier de journal WAL
- Index de la première entrée ou instantané dans le fichier. En particulier, le premier fichier « 0000000000000000-0000000000000000.wal » contient l’enregistrement initial d’instantané avec l’index=0.
Contenu physique
Le fichier de journal WAL contient une séquence de “Frames ”. Chaque trame contient :
- LittleEndian [^2] entier non signé 64 bits encodé qui contient la longueur de la structure walpb.Record (3).
- Remplissage : un certain nombre d’octets nuls, de manière à ce que la taille totale du cadre soit alignée (modulo 8)
- Données marshallées walpb.Record
:
- type - énumération entière codée déterminant l’interprétation du champ de données ci-dessous
- data - selon le type, généralement une donnée protocole marshallée
- crc - somme de contrôle RC-32 de tous les champs « data » combinés (sans type) dans tous les enregistrements du journal sur cette réplica particulière depuis la création du journal WAL. Veuillez noter que la somme de contrôle prend en compte TOUS les enregistrements (même ceux qui n’ont pas été validés par Raft).
Les fichiers sont « coupés » (un nouveau fichier est créé) lorsque le fichier actuel dépasse 64*10^6 octets.
Contenu logique
Les fichiers de journalisation anticipée dans la couche logique contiennent :
Raftpb.Entry:propositions récentes répliquées par le leader Raft. Certaines de ces propositions sont considérées comme « validées », tandis que d’autres peuvent être logiquement remplacées.Raftpb.HardState(term,commit,vote):information périodique (très fréquente) sur l’index d’une entrée de journal qui est « validée » (répliquée sur la majorité des serveurs), garantissant ainsi qu’elle ne sera pas modifiée ou remplacée, et pouvant être appliquée aux backends (v2, v3). Elle contient également un « terme » (indicateur indiquant s’il y a eu des modifications liées à une élection) et un vote — le membre pour lequel la réplique actuelle a voté durant le terme en cours.walpb.Snapshot(term, index):instantanés périodiques de l’état Raft (aucun contenu de base de données, uniquement l’index du journal d’instantané et le terme Raft)- Le contenu du magasin V2 est stocké dans des fichiers *.store séparés.
- Le contenu du magasin V3 est conservé dans le fichier bbolt, et devient un instantané implicite dès que les entrées y sont appliquées.
- enregistrement de somme de contrôle crc32 (au début de chaque fichier), utilisé pour reprendre le contrôle CRC pour le reste du fichier.
etcdserverpb.Metadata(node_id, cluster_id)- identification du cluster et de la réplica représentés par le journal.
Chaque fichier de journal WAL est construit à partir de (dans l’ordre) :
CRC-32 (valeur CRC calculée sur tous les fichiers précédents, 0 pour le premier fichier).
Cadre de métadonnées (identifiants du cluster et de la réplica)
Uniquement pour le premier fichier WAL :
- Trame d’instantané vide (Index : 0, Terme : 0). L’objectif de cette trame est de maintenir l’invariant selon lequel toutes les entrées sont « précédées » par un instantané.
Pour le fichier WAL non initial (2e+ fichier) :
* Trame HardState.
- Mélange d’entrées, d’états durs et d’enregistrements d’instantané
Le journal WAL peut contenir plusieurs entrées pour l’index identique. Une telle situation peut survenir dans les cas décrits dans la figure 7 du document Raft . Le journal WAL d’etcd est uniquement ajouté, les entrées sont donc remplacées en ajoutant une nouvelle entrée portant le même index.
En particulier lors de la lecture du WAL, la logique remplace les anciennes entrées par les nouvelles . Ainsi, seule la dernière version des entrées dont entry.index <= HardState.commit peut être considérée comme définitive. Les entrées dont l’index est supérieur à HardState.commit sont sujettes à modification.
Les « termes » dans le journal WAL sont censés être monotones.
Les « indexes » dans le journal WAL sont censés :
- démarre à partir d’un instantané
- croît séquentiellement à partir de cet instantané tant qu’il reste dans le même « terme »
- si le terme change, l’index peut diminuer, mais uniquement jusqu’à une nouvelle valeur supérieure à celle de HardState.commit
- un nouvel instantané peut avoir lieu avec un index quelconque supérieur ou égal à HardState.commit, ce qui ouvre une nouvelle séquence pour les index
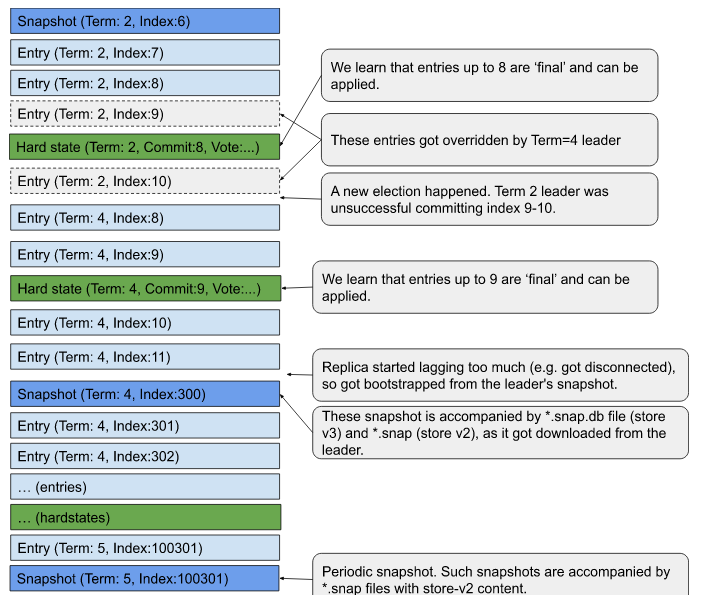
Outils
etcd-dump-logs
Les journaux WAL d’etcd peuvent être lus à l’aide de l’outil etcd-dump-logs :
Prenez note que :
- Outil qui affiche uniquement les entrées, et non toutes les enregistrements WAL (instantanés, HardStates) présents dans les fichiers de journal WAL.
- L’outil applique automatiquement des « substitutions » aux entrées. Si une entrée est remplacée (par une entrée plus récente au même index), l’outil n’affiche que la valeur finale.
- L’outil affiche également les entrées non validées (issues de la fin du LOG), sans information sur HardState.commitIndex, de sorte qu’il n’est pas possible de savoir si les entrées sont définitives ou non.
Instantanés de (Store V2) : membre/snap/{term}-{index}.snap
Noms de fichiers :
membre/snap/{term}-{index}.snap
Les noms de fichiers sont générés ici
("%016x-%016x.snap") et utilisent deux composants encodés en hexadécimal :
- term -> Terme Raft (période entre les élections) au moment de l’émission de l’instantané
- index -> Index de la dernière proposition appliquée au moment de l’émission de l’instantané
Création
Les fichiers *.snap sont créés par la méthode Snapshotter.SaveSnap .
Il existe 2 déclencheurs contrôlant la création de ces fichiers :
- Un nouveau fichier est créé toutes les –snapshotCount= propositions appliquées environ (100'000 par défaut). Cette valeur est approximative : les propositions peuvent arriver par lots, la création d’un instantané n’est envisagée qu’à la fin du lot et le processus est finalement planifié de manière asynchrone. Le nom de l’option (–snapshotCount) est assez trompeur : elle contrôle la différence de valeur d’index entre le dernier index d’instantané et le dernier index de proposition appliquée.
- Raft demande au réplica de restaurer à partir de l’instantané. Pendant qu’un réplica reçoit l’instantané via le message msgSnap, il le sauvegarde également (de manière légère) dans le journal WAL. Cela garantit que dans la queue du journal WAL se trouve toujours un instantané valide suivi d’entrées. Cela supprime ainsi tout risque de discontinuité dans les journaux WAL.
Actuellement, les fichiers sont approximativement [^3] associés 1 à 1 aux journaux WAL. Avec le décommissionnement du store v2, nous prévoyons que les fichiers ne seront plus écrits du tout (optionnel : 3.5.x, obligatoire : 3.6.x).
Contenu
Le fichier contient un proto snapdb.snapshot
(uint32 crc, bytes data) marshallé,
qui se trouve dans le champ ‘data’ et contient Raftpb.Snapshot :
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Enfin, les données imbriquées contiennent un contenu store v2 sérialisé au format JSON.
En particulier, il y a :
- Terme
- Index
- Données d’appartenance :
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Version du stockage : /0/version- > 3.5.0
Outils
protoc
La commande suivante vous permet de visualiser le contenu du fichier lorsqu’elle est exécutée depuis le répertoire racine d’etcd :
De même, vous pouvez extraire le champ ‘data’ et le décoder en tant que ‘Raftpb.Snapshot
'
Exemple de contenu du magasin sérialisé JSON version 2 dans les fichiers *.snap d’etcd 3.4 :
Modifications
Cette section est réservée à la description des modifications apportées aux formats de fichier introduits entre différentes versions d’etcd.
[^1] : Les pages de métadonnées situées au début du fichier bbolt sont modifiées in situ.
[^2] : Incohérent, car la majorité des uint sont écrits en big endian
[^3] : L’instantané initial (index : 0) au début du journal WAL n’est pas associé à un fichier *.snap. Les anciens fichiers *.snap (ou journaux WAL) peuvent être supprimés.
12.7 - etcd Garanties de l'API
etcd est un magasin clé-valeur cohérent et durable. Le magasin clé-valeur est exposé via des [services gRPC]. etcd garantit les plus fortes garanties de cohérence et de durabilité pour un système distribué. Cette spécification énumère les garanties d’API offertes par etcd.
API à prendre en compte
- APIs KV
- APIs de surveillance
- APIs de bail
- Octroyer
- [Révoquer]
- Maintien de vie
L’API KV permet de lire et de manipuler directement le magasin de paires clé-valeur. L’API surveillance permet de s’abonner aux modifications apportées au magasin de paires clé-valeur. L’API bail permet d’attribuer une durée de vie à une clé.
Les API KV et surveillance permettent d’accéder non seulement aux versions les plus récentes des clés, mais aussi aux versions antérieures, dans une fenêtre continue d’historique limitée par une opération de compactage.
L’appel à l’API KV a un effet immédiat, tandis que l’API Surveillance peut renvoyer avec un délai non borné. Dans un cluster etcd correctement fonctionnel, vous devez vous attendre à ce que les événements de surveillance apparaissent avec un délai de 10 ms après leur occurrence. Toutefois, aucun délai maximal n’est garanti, et les événements dans des clusters défaillants pourraient ne jamais arriver.
API clé-valeur
etcd garantit la durabilité et la sérialisation stricte pour toutes les appels d’API de type clé-valeur. Il s’agit de la garantie d’isolation la plus forte des systèmes de bases de données transactionnelles distribuées.
Durabilité
Toutes les opérations terminées sont durables. Toutes les données accessibles sont également des données durables. Une lecture ne renverra jamais de données qui n’ont pas été rendues durables.
Sérialisation stricte
Les opérations du service KV sont atomiques et s’effectuent dans un ordre total, conforme à l’ordre temporel réel de ces opérations. L’ordre total est implicite grâce à la [révision]. En savoir plus sur la [sérialisation stricte].
Pour les transactions sans transactions imbriquées, l’ordre d’exécution des opérations est garanti identique à celui de sa liste d’opérations, ce qui signifie des réponses GET stables au sein de la transaction. Pour les transactions avec des transactions imbriquées, l’ordre d’exécution n’est pas spécifié.
La sérialisation stricte implique d’autres garanties plus faibles qui pourraient être plus faciles à comprendre :
Atomicité
Toutes les requêtes d’API sont atomiques ; une opération s’effectue entièrement ou pas du tout. Pour les requêtes de surveillance, tous les événements générés par une seule opération figurent dans une seule réponse de surveillance. La surveillance ne peut jamais observer des événements partiels pour une seule opération.
Atomicité
Du point de vue du client, la linéarisation offre des propriétés utiles qui facilitent le raisonnement. Il s’agit d’une description claire extraite du article original
: Linearizability provides the illusion that each operation applied by concurrent processes takes effect instantaneously at some point between its invocation and its response.
Par exemple, considérons un client effectuant une écriture au point de temps 1 (t1). Un client effectuant une lecture à t2 (avec t2 > t1) doit recevoir une valeur au moins aussi récente que l’écriture précédente, terminée à t1. Toutefois, la lecture pourrait ne se terminer qu’à t3. La linéarisation garantit que la lecture retourne la valeur la plus récente. Sans garantie de linéarisation, la valeur retournée, actuelle à t2 au moment où la lecture a commencé, pourrait être « obsolète » à t3, car une écriture concurrente pourrait avoir eu lieu entre t2 et t3.
etcd garantit la linéarité pour toutes les autres opérations par défaut.
La linéarité comporte toutefois un coût, car les requêtes linéarisées doivent passer par le processus de consensus Raft. Pour obtenir des latences plus faibles et un débit plus élevé pour les requêtes en lecture, les clients peuvent configurer le mode de cohérence d’une requête sur serializable, qui peut accéder à des données obsolètes par rapport au quorum, mais élimine la pénalité de performance liée à la dépendance des accès linéarisés au consensus actif.
API de surveillance
Les surveillance garantissent les événements suivants :
- Ordre – les événements sont ordonnés par révision. Un événement ne peut jamais apparaître sur une surveillance s’il précède dans le temps un événement déjà publié. Pour les transactions sans transactions imbriquées, l’ordre des événements générés est garanti identique à celui de la liste des opérations. Pour les transactions avec transactions imbriquées, l’ordre des événements générés n’est pas spécifié.
- Unicité – un événement ne peut jamais apparaître deux fois sur une surveillance.
- Fiabilité – une séquence d’événements ne peut jamais omettre de sous-séquence d’événements dans la fenêtre d’historique disponible. Si des événements sont ordonnés dans le temps comme a < b < c, alors si la surveillance reçoit les événements a et c, elle est garantie de recevoir b tant que b reste dans la fenêtre d’historique disponible.
- Atomicité – une liste d’événements est garantie d’englober des révisions complètes. Les mises à jour effectuées dans la même révision sur plusieurs clés ne seront jamais divisées entre plusieurs listes d’événements.
- Reprise possible – une surveillance interrompue peut être reprise en établissant une nouvelle surveillance à partir de la dernière révision reçue dans un événement de surveillance avant la rupture, à condition que cette révision soit dans la fenêtre d’historique.
- Marquable – les événements de notification de progression garantissent que tous les événements jusqu’à une révision ont déjà été livrés.
etcd ne garantit pas la linéarité pour les opérations de surveillance. Les utilisateurs doivent vérifier la révision des événements de surveillance afin de garantir un ordre correct par rapport aux autres opérations.
API bail
etcd fournit un mécanisme de bail . Le cas d’utilisation principal d’un bail est la mise en œuvre de mécanismes de coordination distribuée, tels que des verrous distribués. Le mécanisme de bail est simple : un bail peut être créé à l’aide de l’API grant, attaché à une clé à l’aide de l’API put, révoqué à l’aide de l’API revoke, et expirera selon le temps de vie (TTL) défini par l’horloge murale. Toutefois, les utilisateurs doivent être conscients de les propriétés importantes des API et de leur utilisation afin d’implémenter correctement des mécanismes de coordination distribuée.
etcd définitions spécifiques
Opération terminée
Une opération etcd est considérée comme terminée lorsqu’elle est validée par consensus, et donc « exécutée » — stockée de manière permanente — par le moteur de stockage etcd. Le client sait qu’une opération est terminée lorsqu’il reçoit une réponse du serveur etcd. Notez que le client peut ignorer l’état d’une opération s’il expiré, ou s’il y a une interruption réseau entre le client et le membre etcd. etcd peut également annuler des opérations lors d’une élection de leader. etcd ne renvoie pas de réponses abort aux requêtes en cours des clients dans cet événement.
révision
Une opération etcd qui modifie le magasin de valeurs associées à des clés est attribuée une révision unique strictement croissante. Une opération transactionnelle peut modifier le magasin de valeurs associées à des clés plusieurs fois, mais une seule révision lui est attribuée. L’attribut révision d’une paire clé-valeur modifiée par l’opération a la même valeur que la révision de l’opération. La révision peut être utilisée comme horloge logique pour le magasin de valeurs associées à des clés. Une paire clé-valeur ayant une révision plus élevée est modifiée après une paire clé-valeur ayant une révision plus faible. Deux paires clé-valeur ayant la même révision sont modifiées par une opération « simultanément ».
12.8 - etcd par rapport aux autres magasins clé-valeur
Le nom « etcd » provient de deux idées : le dossier unix « /etc » et les systèmes « d »istribués. Le dossier « /etc » est un emplacement destiné au stockage des données de configuration d’un système unique, tandis qu’etcd stocke les informations de configuration pour des systèmes distribués à grande échelle. Ainsi, un « d »istribué « /etc » devient « etcd ».
etcd est conçu comme une base commune pour les systèmes distribués à grande échelle. Il s’agit de systèmes qui ne tolèrent jamais une opération en split-brain et sont prêts à sacrifier la disponibilité pour atteindre cet objectif. etcd stocke les métadonnées de manière cohérente et résistante aux pannes. Un cluster etcd vise à offrir un stockage clé-valeur avec une stabilité, une fiabilité, une évolutivité et des performances de niveau supérieur.
Les systèmes distribués utilisent etcd comme magasin clé-valeur cohérent pour la gestion de configuration, la découverte de services et la coordination de travaux distribués. De nombreuses organisations utilisent etcd pour mettre en œuvre des systèmes de production tels que des planificateurs de conteneurs, des services de découverte de services et des stockages de données distribués. Les modèles distribués courants utilisant etcd incluent l’élection de leader , les verrous distribués et la surveillance de la disponibilité des machines.
Cas d’utilisation
- Container Linux by CoreOS : Les applications exécutées sur Container Linux bénéficient de mises à jour automatiques du noyau Linux, sans interruption de service. Container Linux utilise locksmith pour coordonner les mises à jour. Locksmith implémente un sémaphore distribué sur etcd afin de garantir qu’un sous-ensemble seulement d’un cluster est redémarré à tout moment donné.
- Kubernetes stocke les données de configuration dans etcd pour la découverte de services et la gestion du cluster ; la cohérence d’etcd est essentielle pour planifier correctement et faire fonctionner les services. Le serveur d’API Kubernetes persiste l’état du cluster dans etcd. Il utilise l’API de surveillance d’etcd pour surveiller le cluster et déployer des modifications critiques de configuration.
Tableau comparatif
Peut-être que etcd semble déjà être une solution adaptée, mais comme pour toute décision technologique, agissez avec prudence. Veuillez noter que cette documentation a été rédigée par l’équipe etcd. Bien que l’objectif idéal soit une comparaison impartiale des technologies et fonctionnalités, l’expertise et les biais des auteurs favorisent clairement etcd. Utilisez uniquement selon les indications.
Le tableau ci-dessous constitue une référence rapide pratique pour repérer facilement les différences entre etcd et ses alternatives les plus populaires. Des commentaires et détails supplémentaires pour chaque colonne figurent dans les sections suivant le tableau.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Primitives de concurrence | appels RPC verrou , appels RPC élection , verrous en ligne de commande , élections en ligne de commande , recettes en go | recettes curator externes en Java | API native de verrouillage | Rare , le cas échéant |
| Lectures linéarisables | Oui | Non | Oui | Parfois |
| Contrôle multiversion de concurrence | Oui | Non | Non | Parfois |
| Transactions | Comparaisons de champs, lecture, écriture | Vérifications de version, écriture | Comparaison de champ, verrouillage, lecture, écriture | Style SQL |
| Notification de modifications | Intervalles historiques et actuels de clés | Clés et répertoires actuels | Clés et préfixes actuels | Déclencheurs (parfois) |
| Permissions utilisateur | Basées sur les rôles | ACLs | ACLs | Variables (par table GRANT , par base rôles ) |
| API HTTP/JSON | Oui | Non | Oui | Rarement |
| Réconfiguration du groupe d’hôtes | Oui | >3.5.0 | Oui | Oui |
| Taille maximale de base de données fiable | Plusieurs gigaoctets | Centaines de mégaoctets (parfois plusieurs gigaoctets) | Centaines de mégaoctets | Teraoctets+ |
| Latence minimale de linéarisation en lecture | RTT réseau | Pas de linéarisation en lecture | RTT + fsync | Barrières horaires (atomiques, NTP) |
ZooKeeper
ZooKeeper résout le même problème qu’etcd : la coordination des systèmes distribués et le stockage des métadonnées. Toutefois, etcd bénéficie de l’expérience acquise grâce à l’analyse du design et de l’implémentation de ZooKeeper. Les enseignements tirés de ZooKeeper ont certainement influencé la conception d’etcd, lui permettant de prendre en charge des systèmes à grande échelle comme Kubernetes. Les améliorations apportées par etcd par rapport à ZooKeeper incluent :
- Reconfiguration dynamique de l’appartenance au cluster
- Lecture/écriture stable sous charge élevée
- Modèle de données à contrôle de concurrence multiversion
- Surveillance fiable des clés, sans jamais ignorer silencieusement les événements
- Primitives de bail déconnectant les connexions des sessions
- API pour verrous partagés distribués sûrs
En outre, etcd prend en charge une large gamme de langages et de frameworks directement. Alors que Zookeeper utilise son propre protocole RPC personnalisé, Jute, qui est unique à Zookeeper et limite les liaisons de langages prises en charge
, le protocole client d’etcd est basé sur gRPC
, un cadre RPC populaire offrant des liaisons pour go, C++, Java et bien d’autres. De même, gRPC peut être sérialisé en JSON sur HTTP, si bien que des utilitaires de ligne de commande généraux comme curl peuvent interagir avec lui. Étant donné que les systèmes peuvent choisir parmi diverses options, ils sont construits autour d’etcd avec des outils natifs plutôt qu’autour d’etcd avec un ensemble fixe et unique de technologies.
Lorsqu’il s’agit d’évaluer les fonctionnalités, le support et la stabilité, les nouvelles applications souhaitant utiliser Zookeeper comme magasin de clés cohérent devraient privilégier etcd.
Consul
Consul est un cadre complet de découverte de services. Il propose des vérifications de santé intégrées, une détection de défaillances et des services DNS. En outre, Consul expose un magasin de clés-valeurs via des API HTTP RESTful. Tel qu’il en est dans Consul 1.0 , le système de stockage ne se met pas à l’échelle aussi efficacement que d’autres systèmes comme etcd ou Zookeeper pour les opérations sur les clés-valeurs ; les systèmes nécessitant des millions de clés subiront des latences élevées et une pression mémoire importante. L’API de clés-valeurs manque notamment de fonctionnalités telles que les clés à plusieurs versions, les transactions conditionnelles et les surveillance fiables en continu.
etcd et Consul résolvent des problèmes différents. Si vous recherchez un magasin de clés-valeurs distribué et cohérent, etcd est une meilleure option que Consul. Si vous recherchez une découverte de services complète au sein d’un cluster, etcd ne possède pas suffisamment de fonctionnalités ; optez pour Kubernetes, Consul ou SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
À la fois etcd et les bases de données NewSQL (par exemple, Cockroach , TiDB , Google Spanner ) offrent des garanties fortes de cohérence des données avec une haute disponibilité. Toutefois, les paramètres de conception de système sensiblement différents entraînent des API client et des caractéristiques de performance sensiblement différentes.
Les bases de données NewSQL sont conçues pour s’étendre horizontalement à travers des centres de données. Ces systèmes partitionnent généralement les données entre plusieurs groupes de réplication cohérents (shards), potentiellement distants, et stockent des jeux de données de l’ordre du téraoctet et plus. Ce type d’évolutivité les rend peu adaptés à la coordination distribuée, en raison de latences élevées dues à l’attente des horloges et de la prévision d’updates avec des graphes de dépendances majoritairement localisés. Les données sont organisées en tables, incluant des fonctionnalités de requête de style SQL avec des sémantiques plus riches que celles d’etcd, mais au prix d’une complexité accrue pour le traitement, la planification et l’optimisation des requêtes.
En résumé, choisissez etcd pour stocker des métadonnées ou coordonner des applications distribuées. Si vous devez stocker plusieurs gigaoctets de données ou si des requêtes SQL complètes sont nécessaires, privilégiez une base de données NewSQL.
Utilisation d’etcd pour les métadonnées
etcd réplique toutes les données au sein d’un seul groupe de réplication cohérent. Pour stocker jusqu’à quelques Go de données avec un ordre cohérent, il s’agit de la méthode la plus efficace. Chaque modification de l’état du cluster, qui peut affecter plusieurs clés, est attribuée un identifiant unique global, appelé révision dans etcd, issu d’un compteur strictement croissant permettant de raisonner sur l’ordre. Étant donné qu’il n’existe qu’un seul groupe de réplication, la requête de modification n’a besoin de passer que par le protocole Raft pour être validée. En limitant le consensus à un seul groupe de réplication, etcd obtient une cohérence distribuée avec un protocole simple tout en atteignant une latence faible et un débit élevé.
La réplication sous-jacente à etcd ne peut pas être mise à l’échelle horizontalement en raison de l’absence de fractionnement des données. À l’inverse, les bases de données NewSQL fractionnent généralement les données sur plusieurs groupes de réplication cohérents, stockant des jeux de données de l’ordre du téraoctet et plus. Toutefois, pour attribuer à chaque modification un identifiant global unique et croissant, chaque requête doit passer par un protocole de coordination supplémentaire entre les groupes de réplication. Cette étape de coordination supplémentaire peut potentiellement entraîner des conflits sur l’identifiant global, obligeant les requêtes ordonnées à se réessayer. Le résultat est une approche plus complexe, généralement moins performante qu’etcd pour un ordre strict.
Si une application traite principalement des métadonnées ou de l’ordre des métadonnées, par exemple pour coordonner des processus, choisissez etcd. Si l’application nécessite un grand magasin de données étendu sur plusieurs centres de données et ne dépend pas fortement des propriétés d’ordre global fort, choisissez une base de données NewSQL.
Utilisation d’etcd pour la coordination distribuée
etcd propose des primitives de coordination distribuée telles que les surveillance d’événements, les bails, les élections et les verrous partagés distribués, directement intégrées (notez que, dans le cas du verrou partagé distribué, les utilisateurs doivent être conscients de ses propriétés non évidentes. Les détails sont décrits ci-dessous). Ces primitives sont à la fois maintenues et soutenues par les développeurs etcd ; laisser ces primitives aux bibliothèques externes revient à éviter la responsabilité du développement de logiciels distribués fondamentaux, ce qui laisse le système incomplet. Les bases de données NewSQL s’attendent généralement à ce que ces primitives de coordination soient développées par des tiers. De même, ZooKeeper dispose d’une bibliothèque de recettes de coordination séparée et indépendante library . Consul, qui propose une API native de verrouillage, va jusqu’à s’excuser en disant que c’est « not a bulletproof method ».
En théorie, il est possible de construire ces primitives sur n’importe quel système de stockage offrant une cohérence forte. Toutefois, les algorithmes sont souvent subtils ; il est facile de concevoir un algorithme de verrouillage qui semble fonctionner, pour qu’il cesse soudainement de fonctionner à cause d’un effet de myriade et d’un décalage de temporisation. En outre, d’autres primitives prises en charge par etcd, telles que la mémoire transactionnelle, dépendent du modèle de données MVCC d’etcd ; une cohérence forte simple ne suffit pas.
Pour la coordination distribuée, le choix d’etcd peut aider à éviter les problèmes opérationnels et économiser des efforts ingénierie.
Remarques sur l’utilisation du verrouillage et du bail
etcd fournit des API de verrouillage basées sur le mécanisme de bail , qui repose sur le mécanisme de bail et son implémentation dans etcd . L’idée fondamentale du mécanisme de bail est la suivante : un serveur accorde à un client demandeur un jeton, appelé bail. Lorsqu’un bail est accordé, le serveur lui associe un délai d’expiration (TTL). Lorsque le serveur détecte que le temps écoulé dépasse le TTL, il retire le bail. Tant qu’un client détient un bail non retiré, il peut affirmer qu’il détient l’accès à une ressource associée à ce bail. Dans le cas d’etcd, la ressource est une clé dans l’espace de clés etcd. etcd fournit des API de verrouillage selon ce schéma. Toutefois, les API de verrouillage ne peuvent pas être utilisées seules comme mécanisme d’exclusion mutuelle. Elles sont appelées API de verrouillage pour des raisons historiques . Elles peuvent toutefois être utilisées comme mécanisme d’optimisation de l’exclusion mutuelle, comme décrit ci-dessous.
L’aspect le plus important du mécanisme de bail est que le délai d’expiration (TTL) est défini comme un intervalle de temps physique. Le serveur et le client mesurent le passage du temps à l’aide de leurs propres horloges. Cela permet une situation où le serveur révoque le bail, mais le client continue de prétendre en être le propriétaire.
Comment le mécanisme de bail garantit-il l’exclusion mutuelle du mécanisme de verrouillage ? En réalité, le mécanisme de bail lui-même ne garantit pas l’exclusion mutuelle. Le fait de détenir un bail ne garantit pas que son détenteur détient un verrou sur la ressource.
Dans le cas de la gestion des accès mutuels aux clés d’etcd lui-même via un verrou etcd, l’exclusion mutuelle est mise en œuvre selon le mécanisme de validation du numéro de version (appelé parfois compare and swap dans d’autres systèmes comme Consul). Dans les RPCs d’etcd tels que Put ou Txn, il est possible de spécifier des conditions requises concernant le numéro de révision et l’ID de bail pour les opérations. Si ces conditions ne sont pas satisfaites, l’opération peut échouer. Grâce à ce mécanisme, etcd fournit un verrouillage distribué aux clients. Cela signifie qu’un client sait qu’il acquiert un verrou sur une clé lorsque sa requête est exécutée avec succès par le cluster etcd.
Dans la littérature sur le verrouillage distribué, des conceptions similaires sont décrites :
- Dans le papier Chubby , le concept de séquenceur est introduit. Nous interprétons que ce séquenceur est presque identique à la combinaison du numéro de révision et de l’ID de bail d’etcd.
- Dans Comment réaliser un verrouillage distribué , Martin Kleppmann a introduit l’idée de jeton de clôture. Les auteurs interprètent que ce jeton de clôture correspond au numéro de révision dans le cas d’etcd.
- Dans Utilisations pratiques des horloges synchronisées dans les systèmes distribués , on trouve une description selon laquelle Thor implémente un mécanisme de verrouillage distribué basé sur la validation du numéro de version et du bail.
Pourquoi etcd et d’autres systèmes proposent-ils des bails, alors qu’ils offrent une exclusion mutuelle basée sur la validation du numéro de version ? Les bails fournissent une mécanique d’optimisation visant à réduire le nombre de requêtes abandonnées.
Notez qu’en ce qui concerne les clés etcd, elles peuvent être verrouillées de manière efficace grâce aux mécanismes de bail et de validation du numéro de version. Si les utilisateurs doivent protéger des ressources n’ayant pas de lien avec etcd, ces ressources doivent fournir un mécanisme de validation du numéro de version ainsi qu’une cohérence entre les réplicas, comme le font les clés etcd. La fonction de verrouillage propre à etcd ne peut pas être utilisée pour protéger des ressources externes.
12.9 - Glossaire
Ce document définit les différents termes utilisés dans la documentation, la ligne de commande et le code source d’etcd.
Alarme
Le serveur etcd déclenche une alarme chaque fois que le cluster nécessite une intervention opérationnelle pour rester fiable.
Authentification
L’authentification gère les autorisations d’accès des utilisateurs aux ressources etcd.
Client
Un client se connecte au cluster etcd pour émettre des requêtes de service, telles que la récupération de paires clé-valeur, l’écriture de données ou la surveillance des mises à jour.
cluster
Un cluster se compose de plusieurs membres.
Le nœud de chaque membre suit le protocole de consensus Raft pour répliquer les journaux. Le cluster reçoit des propositions des membres, les valide et les applique au magasin local.
compactage
Le compactage supprime l’historique des événements et les clés obsolètes antérieures à une révision donnée. Il permet de libérer de l’espace de stockage dans la base de données backend d’etcd.
Élection
Le cluster etcd organise des élections parmi ses membres afin de choisir un leader, conformément au protocole de consensus Raft.
Point de terminaison
Une URL pointant vers un service ou une ressource etcd.
Clé
Identifiant défini par l’utilisateur pour le stockage et la récupération de valeurs définies par l’utilisateur dans etcd.
Plage de clés
Un ensemble de clés contenant soit une clé individuelle, soit un intervalle lexicographique pour toutes les clés x telles que a < x <= b, soit toutes les clés supérieures à une clé donnée.
espace de clés
L’ensemble de toutes les clés dans un cluster etcd.
bail
Contrat renouvelable à courte durée qui supprime les clés associées à celui-ci à l’expiration.
membre
Un serveur etcd logique participant au service d’un cluster etcd.
Révision de modification
La première révision à contenir la dernière écriture sur une clé donnée.
Pair
Le pair est un autre membre du même cluster.
Proposition
Une proposition est une demande (par exemple, une demande d’écriture, une demande de modification de configuration) qui doit passer par le protocole Raft.
quorum
Nombre de membres actifs nécessaires pour atteindre un consensus afin de modifier l’état du cluster. etcd exige une majorité de membres pour atteindre le quorum.
révision
Compteur global sur 64 bits, initialisé à 1 et incrémenté à chaque modification de l’espace de clés.
Rôle
Unité de permissions sur un ensemble de plages de clés, pouvant être attribuée à un ensemble d’utilisateurs pour le contrôle d’accès.
instantané
Une sauvegarde instantanée de l’état du cluster etcd.
Stockage
Le stockage physique sous-jacent à l’espace de clés du cluster.
Terme
Un terme est un entier strictement croissant associé à chaque élection de leader dans l’algorithme Raft. Pour un terme donné, il ne peut y avoir qu’un seul leader élu, et le terme est incrémenté lors d’un changement de leader.
Transaction
Opération en série exécutée de manière atomique. Toutes les clés modifiées au sein d’une transaction partagent la même révision de modification.
Version de la clé
Le nombre d’écritures effectuées sur une clé depuis sa création, à compter de 1. La version d’une clé inexistante ou supprimée est 0.
observateur
Un client ouvre un observateur pour surveiller les mises à jour sur une plage de clés donnée.
13 - Guide du développeur
13.1 - Protocole du service de découverte
Le protocole de service de découverte aide un nouveau membre etcd à découvrir tous les autres membres du cluster pendant la phase d’initialisation, en utilisant une URL de découverte partagée.
Le protocole de service de découverte n’est utilisé que pendant la phase d’amorçage du cluster, et ne peut pas être utilisé pour la reconfiguration en temps réel ou la surveillance du cluster.
Le protocole utilise un nouveau jeton de découverte pour initialiser un unique cluster etcd. Souvenez-vous qu’un jeton de découverte ne peut représenter qu’un seul cluster etcd. Dès que le protocole de découverte associé à ce jeton est lancé, même s’il échoue en cours de route, il ne doit pas être utilisé pour initialiser un autre cluster etcd.
Le reste de cet article détaille le processus de découverte à l’aide d’exemples correspondant à un cluster de découverte auto-hébergé. Le service public de découverte, discovery.etcd.io, fonctionne de la même manière, mais avec une couche d’interface améliorée qui masque les URL complexes, génère automatiquement des UUID et met en place certaines protections contre les requêtes excessives. Au cœur de ce service public, un cluster etcd est toujours utilisé comme magasin de données, comme décrit dans ce document.
Flot de protocole
L’idée du protocole de découverte consiste à utiliser un cluster etcd interne pour coordonner le démarrage d’un nouveau cluster. Tout d’abord, tous les nouveaux membres interagissent avec le service de découverte et contribuent à générer la liste de membres attendue. Ensuite, chaque nouveau membre démarre son serveur en utilisant cette liste, ce qui permet d’obtenir la même fonctionnalité que l’option -initial-cluster.
Dans l’exemple de workflow suivant, nous allons présenter chaque étape du protocole au format curl afin de faciliter la compréhension.
Par convention, le protocole de découverte etcd utilise le préfixe de clé _etcd/registry. Si http://example.com héberge un cluster etcd pour le service de découverte, l’URL complète de l’espace de clés de découverte sera http://example.com/v2/keys/_etcd/registry. Nous utiliserons cette URL comme préfixe dans l’exemple.
Création d’un nouveau jeton de découverte
Générez un jeton unique qui identifiera le nouveau cluster. Ce jeton sera utilisé comme préfixe unique dans l’espace de clés de découverte aux étapes suivantes. Une méthode simple consiste à utiliser uuidgen :
Spécification de la taille attendue du cluster
Le jeton de découverte attend une taille de cluster qui doit être précisée. Cette taille est utilisée par le service de découverte pour savoir quand il a trouvé tous les membres qui formeront initialement le cluster.
En général, la taille du cluster est de 3, 5 ou 7. Consultez taille optimale du cluster pour plus de détails.
Mise en marche des processus etcd
Étant donné l’URL de découverte, utilisez-la comme indicateur -discovery et lancez les processus etcd. Chaque processus etcd suivra automatiquement les étapes suivantes en interne s’il reçoit l’indicateur -discovery.
S’enregistrer lui-même
La première étape pour le processus etcd consiste à s’inscrire dans l’URL de découverte en tant que membre. Cela se fait en créant l’ID de membre comme clé dans l’URL de découverte.
Vérification du statut
Il vérifie la taille attendue du cluster et l’état d’inscription à l’URL de découverte, puis détermine l’action suivante.
Si le nombre de membres enregistrés reste insuffisant, l’attente sera poursuivie jusqu’à la réapparition de membres sortis.
Si le nombre de membres enregistrés est supérieur à la taille attendue N, le système considère les N premiers membres enregistrés comme la liste des membres du cluster. Si le membre lui-même figure dans cette liste, la procédure de découverte réussit et il récupère tous les pairs à partir de la liste des membres. Sinon, la procédure de découverte échoue, car le cluster est plein.
Dans l’implémentation etcd, le membre peut vérifier l’état du cluster même avant de s’enregistrer. Il peut donc échouer rapidement si le cluster est plein.
En attente de tous les membres
Le processus d’attente est décrit en détail dans la documentation de l’API etcd .
Il continue d’attendre jusqu’à la découverte de tous les membres.
Service de découverte publique
CoreOS Inc. héberge un service de découverte public à https://discovery.etcd.io/ , qui offre plusieurs fonctionnalités pratiques pour faciliter l’utilisation.
Préfixe de masquage de clé
Le service de découverte publique redirigera https://discovery.etcd.io/${UUID} vers le cluster etcd derrière pour la clé située à /v2/keys/_etcd/registry. Il masque le préfixe de clé d’enregistrement afin d’obtenir une URL de découverte plus courte et plus lisible.
Obtenir un nouveau jeton
Le processus de génération dans le service suit les étapes allant de Création d’un jeton de découverte à Spécification de la taille attendue du cluster .
Vérifier l’état de découverte
L’état de ce jeton de découverte, y compris les machines qui ont été enregistrées, peut être vérifié en demandant la valeur de l’UUID.
Dépôt open source
Le dépôt est situé à https://github.com/coreos/discovery.etcd.io .. Il peut être utilisé pour créer un service de découverte personnalisé.
13.2 - Mettre en place un cluster local
Pour les déploiements de test et de développement, la méthode la plus rapide et la plus simple consiste à configurer un cluster local. Pour un déploiement en production, reportez-vous à la section clustering .
Cluster autonome local
Démarrage d’un cluster
Exécutez la commande suivante pour déployer un cluster etcd en tant que cluster autonome :
Si le binaire etcd n’est pas présent dans le répertoire de travail courant, il se peut qu’il se trouve soit à $GOPATH/bin/etcd, soit à /usr/local/bin/etcd. Exécutez la commande en conséquence.
Le membre etcd en cours d’exécution écoute sur localhost:2379 pour les requêtes clientes.
Interaction avec le cluster
Utilisez etcdctl pour interagir avec le cluster en cours d’exécution :
Stockez une paire clé-valeur exemple dans le cluster :
Si OK est affiché, la sauvegarde de la paire clé-valeur a réussi.
Récupérer la valeur de
foo:Si
barest retourné, l’interaction avec le cluster etcd fonctionne comme prévu.
Cluster local à plusieurs membres
Démarrage d’un cluster
Un Procfile situé à la racine du dépôt git d’etcd est fourni pour configurer facilement un cluster local à plusieurs membres. Pour démarrer un cluster à plusieurs membres, accédez à la racine de l’arborescence source d’etcd et exécutez les étapes suivantes :
Installer
goremanpour contrôler les applications basées sur Procfile :Démarrez un cluster avec
goremanen utilisant le Procfile par défaut d’etcd :Les membres démarrent. Ils écoutent respectivement sur
localhost:2379,localhost:22379etlocalhost:32379les requêtes clientes.
Interaction avec le cluster
Utilisez etcdctl pour interagir avec le cluster en cours d’exécution :
Affichez la liste des membres :
La liste des membres etcd s’affiche comme suit :
Stockez une paire clé-valeur exemple dans le cluster :
Si OK est affiché, la sauvegarde de la paire clé-valeur a réussi.
Test de tolérance aux pannes
Pour tester la tolérance aux pannes d’etcd, arrêtez un membre et tentez de récupérer la clé.
Identifiez le nom du processus du membre à arrêter.
Le
Procfileliste les propriétés du cluster à plusieurs membres. Par exemple, considérez le membre dont le nom de processus estetcd2.Arrêtez le membre :
Stockez une clé :
Récupérez la clé stockée à l’étape précédente :
Récupérer une clé depuis un membre arrêté :
La commande doit afficher une erreur due à un échec de connexion :
Redémarrez le membre arrêté :
Obtenez la clé depuis le membre redémarré :
Redémarrer le membre rétablit la connexion.
etcdctlpourra désormais récupérer la clé avec succès. Pour en savoir plus sur l’interaction avec etcd, consultez la section interaction avec etcd .
13.3 - Interaction avec etcd
Les utilisateurs interagissent généralement avec etcd en définissant ou en récupérant la valeur d’une clé. Cette section décrit comment effectuer ces opérations à l’aide d’etcdctl, un outil en ligne de commande pour interagir avec le serveur etcd. Les concepts décrits ici s’appliquent également aux API gRPC ou aux API des bibliothèques clientes.
La version de l’API utilisée par etcdctl pour communiquer avec etcd peut être définie à 2 ou 3 via la variable d’environnement ETCDCTL_API. Par défaut, etcdctl sur la branche master (3.4) utilise l’API v3, tandis que les versions antérieures (3.3 et antérieures) utilisent par défaut l’API v2.
Notez qu’une clé créée à l’aide de l’API v2 ne pourra pas être interrogée via l’API v3. Une requête v3 etcdctl get d’une clé v2 se terminera avec le code 0 et sans données de clé ; il s’agit du comportement attendu.
Rechercher les versions
La version d’etcdctl et la version de l’API serveur peuvent être utiles pour identifier les commandes appropriées à utiliser pour effectuer diverses opérations sur etcd.
Voici la commande permettant de trouver les versions :
Écrire une clé
Les applications stockent des clés dans le cluster etcd en écrivant sur des clés. Chaque clé stockée est répliquée sur tous les membres du cluster etcd via le protocole Raft afin d’assurer la cohérence et la fiabilité.
Voici la commande permettant de définir la valeur de la clé foo à bar :
Un clé peut également être définie pour une durée déterminée en lui associant un bail.
Voici la commande permettant de définir la valeur de la clé foo1 à bar1 pendant 10 s.
L’identifiant de bail 1234abcd dans la commande ci-dessus fait référence à l’identifiant retourné lors de la création du bail de 10 s. Cet identifiant peut ensuite être associé à une clé.
Lire les clés
Les applications peuvent lire les valeurs des clés d’un cluster etcd. Les requêtes peuvent lire une seule clé ou une plage de clés.
Supposons que le cluster etcd ait stocké les clés suivantes :
Voici la commande pour lire la valeur de la clé foo :
Voici la commande pour lire la valeur de la clé foo au format hexadécimal :
Voici la commande pour lire uniquement la valeur de la clé foo :
Voici la commande pour parcourir les clés allant de foo à foo3 :
foo3 est exclu car la plage se situe dans l’intervalle demi-ouvert [foo, foo3), en excluant foo3.
Voici la commande permettant de parcourir toutes les clés ayant pour préfixe foo :
Voici la commande pour parcourir toutes les clés ayant pour préfixe foo, en limitant le nombre de résultats à 2 :
Voici la commande permettant de parcourir toutes les clés préfixées par foo en utilisant l’API RPC RangeStream
. Le résultat est identique à un appel unaire Range :
--stream ne prend pas en charge --order, --sort-by ni les filtres de révision.
Lire les versions antérieures des clés
Les applications peuvent souhaiter lire des versions obsolètes d’une clé. Par exemple, une application peut souhaiter revenir à une configuration ancienne en accédant à une version antérieure d’une clé. En outre, une application peut souhaiter obtenir une vue cohérente sur plusieurs clés au fil de plusieurs requêtes en accédant à l’historique des clés.
Étant donné qu’une modification apportée au magasin clé-valeur d’un cluster etcd incrémente la révision globale du cluster etcd, une application peut lire des clés obsolètes en fournissant une révision etcd antérieure.
Supposons qu’un cluster etcd dispose déjà des clés suivantes :
Voici un exemple pour accéder aux versions antérieures des clés :
Lire les clés dont la valeur en octets est supérieure ou égale à celle de la clé spécifiée
Les applications peuvent souhaiter lire des clés dont la valeur en octets est supérieure ou égale à celle de la clé spécifiée.
Supposons qu’un cluster etcd dispose déjà des clés suivantes :
Voici la commande permettant de lire les clés dont la valeur d’octet est supérieure ou égale à celle de la clé b :
Supprimer des clés
Les applications peuvent supprimer une clé ou une plage de clés d’un cluster etcd.
Supposons qu’un cluster etcd dispose déjà des clés suivantes :
Voici la commande pour supprimer la clé foo :
Voici la commande permettant de supprimer les clés comprises entre foo et foo9 :
Voici la commande permettant de supprimer la clé zoo avec la paire clé-valeur supprimée renvoyée :
Voici la commande permettant de supprimer les clés dont le préfixe est zoo :
Voici la commande permettant de supprimer les clés dont la valeur d’octet est supérieure ou égale à celle de la clé b :
Surveillance des modifications de clé
Les applications peuvent surveiller une clé ou une plage de clés afin de détecter toute mise à jour.
Voici la commande pour surveiller la clé foo :
Voici la commande pour surveiller la clé foo au format hexadécimal :
Voici la commande pour effectuer une surveillance sur une plage de clés de foo à foo9 :
Voici la commande pour surveiller les clés ayant le préfixe foo :
Voici la commande pour effectuer une surveillance sur plusieurs clés foo et zoo :
Surveillance des modifications historiques des clés
Les applications peuvent souhaiter surveiller les modifications historiques de clés dans etcd. Par exemple, une application peut souhaiter recevoir toutes les modifications d’une clé ; si l’application reste connectée à etcd, alors watch est suffisant. Toutefois, si l’application ou etcd échoue, une modification peut survenir pendant l’indisponibilité, et l’application ne recevra pas la mise à jour en temps réel. Pour garantir que la mise à jour soit livrée, l’application doit pouvoir surveiller les modifications historiques des clés. Pour cela, une application peut spécifier une révision historique lors d’une surveillance, tout comme lors de la lecture d’une version antérieure de clés.
Supposons que nous ayons terminé la séquence d’opérations suivante :
Voici un exemple de surveillance des modifications historiques :
Voici un exemple de surveillance uniquement à partir du dernier changement historique :
Progression de la surveillance
Les applications peuvent souhaiter vérifier l’avancement d’une surveillance afin de déterminer à quel point le flux de surveillance est à jour. Par exemple, si une surveillance est utilisée pour mettre à jour un cache, il peut être utile de savoir si le cache est périmé par rapport à la révision obtenue à partir d’une lecture en quorum.
Les requêtes de progression peuvent être émises à l’aide de la commande « progress » dans une session de surveillance interactive afin de demander au serveur etcd d’envoyer une mise à jour de notification de progression dans le flux de surveillance :
Le numéro de révision dans la réponse de notification de progression est la révision du nœud local du serveur etcd auquel le flux de surveillance est connecté. Si ce nœud est isolé et n’appartient pas au quorum, cette révision de notification de progression peut être inférieure à la révision retournée par une lecture effectuée en quorum contre un nœud serveur etcd non isolé.
Révisions compactées
Comme nous l’avons mentionné, etcd conserve des révisions afin que les applications puissent lire des versions antérieures des clés. Toutefois, afin d’éviter de accumuler une quantité illimitée d’historique, il est important de compacter les révisions passées. Une fois la compaction effectuée, etcd supprime les révisions historiques, libérant ainsi des ressources pour une utilisation future. Toutes les données obsolètes dont la révision est antérieure à la révision compactée deviendront indisponibles.
Voici la commande pour compacter les révisions :
La révision actuelle du serveur etcd peut être obtenue en utilisant la commande get sur une clé quelconque (existante ou non) au format JSON. L’exemple ci-dessous montre la requête pour mykey, qui n’existe pas sur le serveur etcd :
Accorder des bails
Les applications peuvent accorder des bails pour des clés depuis un cluster etcd. Lorsqu’une clé est associée à un bail, sa durée de vie est liée à celle du bail, qui à son tour est régulée par une durée de vie (TTL). Chaque bail a une valeur minimale de durée de vie (TTL) spécifiée par l’application au moment de l’accord. La valeur réelle de TTL du bail est au moins égale à la durée minimale et est choisie par le cluster etcd. Dès qu’une durée de vie (TTL) d’un bail a expiré, le bail expire et toutes les clés associées sont supprimées.
Voici la commande pour accorder un bail :
Révoquer les bails
Les applications révoquent les bails par identifiant de bail. La révocation d’un bail supprime toutes les clés associées.
Supposons que nous ayons terminé la séquence d’opérations suivante :
Voici la commande pour révoquer le même bail :
Maintenir les bails actifs
Les applications peuvent maintenir un bail actif en actualisant périodiquement son TTL afin qu’il ne expire pas.
Supposons que nous ayons terminé la séquence d’opérations suivante :
Voici la commande permettant de maintenir le bail actif :
Obtenir les informations sur le bail
Les applications peuvent souhaiter connaître les informations relatives aux bails, afin de les renouveler ou de vérifier s’ils existent encore ou ont expiré. Les applications peuvent également souhaiter connaître les clés auxquelles un bail particulier est associé.
Supposons que nous ayons terminé la séquence d’opérations suivante :
Voici la commande permettant d’obtenir des informations sur le bail :
Voici la commande permettant d’obtenir des informations sur le bail ainsi que les clés associées au bail :
13.4 - Pourquoi utiliser une passerelle gRPC
etcd v3 utilise gRPC comme protocole de messagerie. Le projet etcd inclut un client Go basé sur gRPC ainsi qu’une utilitaire en ligne de commande, etcdctl , pour communiquer avec un cluster etcd via gRPC. Pour les langages ne disposant pas de prise en charge gRPC, etcd fournit une passerelle gRPC en JSON. Cette passerelle fournit un proxy RESTful qui traduit les requêtes HTTP/JSON en messages gRPC.
Utilisation de la passerelle gRPC
La passerelle accepte une correspondance JSON
pour les définitions de messages du protocole buffer de etcd
. Notez que les champs key et value sont définis comme des tableaux d’octets et doivent donc être encodés en base64 dans le JSON. Les exemples suivants utilisent curl, mais tout client HTTP/JSON devrait fonctionner de la même manière.
Notes
Point de terminaison de passerelle gRPC a changé depuis etcd v3.3 :
- etcd v3.2 ou antérieure utilise uniquement
[CLIENT-URL]/v3alpha/*. - etcd v3.3 utilise
[CLIENT-URL]/v3beta/*tout en conservant[CLIENT-URL]/v3alpha/*. - etcd v3.4 utilise
[CLIENT-URL]/v3/*tout en conservant[CLIENT-URL]/v3beta/*.[CLIENT-URL]/v3alpha/*est obsolète.
- etcd v3.5 ou ultérieure utilise uniquement
[CLIENT-URL]/v3/*.[CLIENT-URL]/v3beta/*est obsolète.
Le passerelle gRPC ne prend pas en charge l’authentification par le nom commun TLS.
Mettre et obtenir des clés
Utilisez les services /v3/kv/range et /v3/kv/put pour lire et écrire des clés :
Surveillance des clés
Utilisez le service /v3/watch pour surveiller les clés :
Transactions
Émettre une transaction avec /v3/kv/txn :
Authentification
Mettez en place une authentification avec le service /v3/auth :
Authentifiez-vous auprès d’etcd pour obtenir un jeton d’authentification en utilisant /v3/auth/authenticate :
Définissez l’en-tête Authorization sur le jeton d’authentification pour récupérer une clé à l’aide des identifiants d’authentification :
Réponses d’erreur
La passerelle gRPC traduit les états gRPC en codes d’état HTTP et un corps d’erreur au format JSON. À compter d’etcd v3.6, la mise à jour vers grpc-gateway v2 a modifié la gestion des erreurs (voir la note gestion des erreurs
dans le guide de migration v2), et le comportement de la passerelle est désormais conforme à google.rpc.Status (code, message, détails) tel que décrit dans modèle d’erreur d’API de Google
. Historiquement, les versions antérieures de grpc-gateway incluaient également un champ de niveau supérieur error, mais ce champ n’est plus pris en charge à partir d’etcd v3.6 et des versions ultérieures.
Les clients doivent considérer le code d’état HTTP comme l’indicateur principal de succès ou d’échec. Si une requête échoue, les clients doivent s’appuyer sur le champ message comme source principale d’information d’erreur et utiliser tout détail supplémentaire pour obtenir un contexte plus précis.
Swagger
Les définitions d’API Swagger générées peuvent être trouvées dans rpc.swagger.json .
13.5 - Découverte et nommage gRPC
etcd fournit un résolveur gRPC afin de prendre en charge un système de noms alternatif qui récupère les points d’accès depuis etcd pour la découverte de services gRPC. Le mécanisme sous-jacent repose sur la surveillance des mises à jour des clés préfixées par le nom du service.
Notez que cette fonctionnalité est expérimentale car elle dépend du paquet google.golang.org/grpc/resolver , qui reste expérimental dans grpc-go.
Utilisation de la découverte etcd avec go-grpc
Le client etcd fournit un résolveur gRPC permettant de résoudre les points d’accès gRPC à l’aide d’un backend etcd. Le résolveur est initialisé avec un client etcd :
Gestion des points de terminaison de service
Le résolveur etcd traite toutes les clés situées sous le préfixe de la cible de résolution suivant un “/” (par exemple, “foo/bar/my-service/”)
dont les valeurs sont encodées au format JSON (historiquement go-grpc naming.Update) comme des points de terminaison de service potentiels.
Les points de terminaison sont ajoutés au service en créant de nouvelles clés et supprimés du service en supprimant des clés.
Ajout d’un point de terminaison
De nouveaux points de terminaison peuvent être ajoutés au service via etcdctl :
La méthode endpoints.Manager du client etcd peut également enregistrer de nouveaux points d’accès avec une clé correspondant à Addr :
Pour activer l’équilibrage de charge en boucle (round-robin) lors de la connexion à un service disposant de plusieurs points d’accès, vous pouvez configurer votre connexion avec le chargeur de charge interne gRPC en boucle :
Suppression d’un point de terminaison
Les hôtes peuvent être supprimés du service via etcdctl :
La méthode endpoints.Manager du client etcd prend également en charge la suppression des points de terminaison :
Inscrire un point de terminaison avec un bail
Inscrire un point de terminaison avec un bail garantit que, si l’hôte ne peut pas maintenir un signal de cœur (par exemple, en cas de panne matérielle), il sera retiré du service :
En Go :
Mise à jour atomique des points de terminaison
Si l’on souhaite modifier plusieurs points de terminaison dans une seule transaction, endpoints.Manager peut être utilisé directement :
13.6 - Intégration d'etcd dans une application Go
embed pour exécuter un serveur etcd dans votre applicationLe paquet go etcd embed fournit un moyen simple d’intégrer un serveur etcd directement dans votre application.
Pour plus de détails, consultez la documentation du paquet embed .
13.7 - Limites système
Limite de taille de requête
etcd est conçu pour gérer des paires clé-valeur de petite taille, typiques des métadonnées. Les requêtes plus grandes fonctionnent, mais peuvent augmenter la latence des autres requêtes. Par défaut, la taille maximale de toute requête est de 1,5 MiB. Cette limite est configurable via le drapeau --max-request-bytes du serveur etcd.
Limite de taille du stockage
La limite par défaut de taille de stockage est de 2 GiB, configurable à l’aide du drapeau --quota-backend-bytes. Une taille maximale de 8 GiB est recommandée pour les environnements normaux, et etcd émet un avertissement au démarrage si la valeur configurée la dépasse.
13.8 - etcd features
Ce document présente un aperçu des fonctionnalités d’etcd afin d’aider les utilisateurs à mieux comprendre ces fonctionnalités et le processus de mise hors service associé. Si vous souhaitez en savoir plus sur la manière dont les fonctionnalités sont développées dans etcd, veuillez consulter ces guides de développement .
Les fonctionnalités d’etcd sont classées en trois états : expérimentales, stables et non sécurisées. Vous pouvez obtenir la liste des fonctionnalités en exécutant etcd --help.
Expérimental
Afin d’obtenir un retour rapide, toute nouvelle fonctionnalité est généralement ajoutée en tant que fonctionnalité expérimentale. Une fonctionnalité expérimentale peut être identifiée en examinant le nom du drapeau, qui doit comporter le préfixe --experimental. Veuillez prendre en compte les points suivants lors de l’utilisation d’une fonctionnalité expérimentale :
- Elle peut contenir des bogues en raison d’un manque de tests utilisateurs. Son activation peut ne pas fonctionner comme prévu.
- Elle est désactivée par défaut.
- Le support de cette fonctionnalité peut être supprimé à tout moment sans préavis.
- Elle peut être supprimée dans la prochaine version mineure ou majeure sans respecter la politique de dépréciation des fonctionnalités , sauf si elle devient stable.
- L’équipe du projet apprécierait que les utilisateurs signalent tout problème lié aux fonctionnalités expérimentales. Toutefois, ces problèmes peuvent être priorisés plus bassement que ceux liés aux fonctionnalités stables.
- Un indicateur de fonctionnalité expérimentale est déprécié lorsqu’il atteint l’état stable. Les utilisateurs doivent adopter l’indicateur stable dès que possible.
Stable
Ce stade est le plus courant pour les fonctionnalités dans etcd. Une fonctionnalité stable est caractérisée comme suit :
- Prise en charge dans le cadre des versions prises en charge d’etcd.
- Peut être activée par défaut.
- La suppression du support doit respecter la politique de dépréciation de fonctionnalité .
Non sécurisé
Les fonctionnalités non sécurisées sont rares et listées dans la section Unsafe feature: de la documentation d’utilisation d’etcd. Par défaut, elles sont désactivées. Elles doivent être utilisées avec précaution, conformément à la documentation. Une fonctionnalité non sécurisée peut être supprimée dans la prochaine version mineure ou majeure sans respecter la politique de dépréciation des fonctionnalités.
Dépréciation de fonctionnalité
Expérimental
Une fonctionnalité expérimentale est dépréciée lorsqu’elle atteint l’étape stable.
- La documentation de la fonctionnalité expérimentale affichera un message de dépréciation accompagné d’une recommandation visant à utiliser un indicateur de fonctionnalité stable associé. Par exemple,
DEPRECATED. Use <feature-name> instead. - Une fonctionnalité dépréciée sera supprimée dans la version suivante.
Stable
Lorsque le projet évolue, une fonctionnalité stable peut parfois devoir être dépréciée et supprimée. Lorsque cela se produit,
- la documentation de la fonctionnalité affichera un message d’avertissement avant la version planifiée de dépréciation. Par exemple,
To be deprecated in <release>.. Si une nouvelle fonctionnalité est déjà prévue pour remplacer la fonctionnalitéTo be deprecated, la documentation indiquera également ce fait. Par exemple,Use <feature-name> instead.. - La fonctionnalité sera dépréciée lors de la version planifiée. À ce moment-là, la documentation de la fonctionnalité affichera un message de dépréciation accompagné d’une recommandation d’utilisation d’une fonctionnalité stable associée. Par exemple,
DEPRECATED. Use <feature-name> instead.. - Une fonctionnalité dépréciée sera supprimée lors de la version suivante.
13.9 - Référence de l'API
Cette référence d’API est générée automatiquement à partir des fichiers nommés .proto.
service Auth (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| AuthEnable | AuthEnableRequest | AuthEnableResponse | AuthEnable active l’authentification. |
| AuthDisable | AuthDisableRequest | AuthDisableResponse | AuthDisable désactive l’authentification. |
| AuthStatus | AuthStatusRequest | AuthStatusResponse | AuthStatus affiche l’état de l’authentification. |
| Authenticate | AuthenticateRequest | AuthenticateResponse | Authenticate traite une requête d’authentification. |
| UserAdd | AuthUserAddRequest | AuthUserAddResponse | UserAdd ajoute un nouvel utilisateur. Le nom d’utilisateur ne peut pas être vide. |
| UserGet | AuthUserGetRequest | AuthUserGetResponse | UserGet obtient les informations détaillées d’un utilisateur. |
| UserList | AuthUserListRequest | AuthUserListResponse | UserList obtient la liste de tous les utilisateurs. |
| UserDelete | AuthUserDeleteRequest | AuthUserDeleteResponse | UserDelete supprime un utilisateur spécifié. |
| UserChangePassword | AuthUserChangePasswordRequest | AuthUserChangePasswordResponse | UserChangePassword modifie le mot de passe d’un utilisateur spécifié. |
| UserGrantRole | AuthUserGrantRoleRequest | AuthUserGrantRoleResponse | UserGrant accorde un rôle à un utilisateur spécifié. |
| UserRevokeRole | AuthUserRevokeRoleRequest | AuthUserRevokeRoleResponse | UserRevokeRole retire un rôle à un utilisateur spécifié. |
| RoleAdd | AuthRoleAddRequest | AuthRoleAddResponse | RoleAdd ajoute un nouveau rôle. Le nom de rôle ne peut pas être vide. |
| RoleGet | AuthRoleGetRequest | AuthRoleGetResponse | RoleGet obtient les informations détaillées sur un rôle. |
| RoleList | AuthRoleListRequest | AuthRoleListResponse | RoleList obtient la liste de tous les rôles. |
| RoleDelete | AuthRoleDeleteRequest | AuthRoleDeleteResponse | RoleDelete supprime un rôle spécifié. |
| RoleGrantPermission | AuthRoleGrantPermissionRequest | AuthRoleGrantPermissionResponse | RoleGrantPermission accorde une permission sur une clé ou une plage spécifique à un rôle spécifié. |
| RoleRevokePermission | AuthRoleRevokePermissionRequest | AuthRoleRevokePermissionResponse | RoleRevokePermission retire une permission sur une clé ou une plage spécifique à un rôle spécifié. |
service Cluster (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| MemberAdd | MemberAddRequest | MemberAddResponse | MemberAdd ajoute un membre au cluster. |
| MemberRemove | MemberRemoveRequest | MemberRemoveResponse | MemberRemove supprime un membre existant du cluster. |
| MemberUpdate | MemberUpdateRequest | MemberUpdateResponse | MemberUpdate met à jour la configuration du membre. |
| MemberList | MemberListRequest | MemberListResponse | MemberList liste tous les membres du cluster. |
| MemberPromote | MemberPromoteRequest | MemberPromoteResponse | MemberPromote promeut un membre de type apprenant Raft (non votant) en membre votant Raft. |
service KV (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| Range | RangeRequest | RangeResponse | Range récupère les clés dans la plage depuis le magasin clé-valeur. |
| Put | PutRequest | PutResponse | Put insère la clé donnée dans le magasin clé-valeur. Une requête Put incrémente la révision du magasin clé-valeur et génère un événement dans l’historique des événements. |
| DeleteRange | DeleteRangeRequest | DeleteRangeResponse | DeleteRange supprime la plage donnée depuis le magasin clé-valeur. Une requête de suppression incrémente la révision du magasin clé-valeur et génère un événement de suppression dans l’historique des événements pour chaque clé supprimée. |
| Txn | TxnRequest | TxnResponse | Txn traite plusieurs requêtes dans une seule transaction. Une requête Txn incrémente la révision du magasin clé-valeur et génère des événements avec la même révision pour chaque requête terminée. Il est interdit de modifier la même clé plusieurs fois au sein d’une même transaction. |
| Compact | CompactionRequest | CompactionResponse | Compact compresse l’historique des événements dans le magasin clé-valeur etcd. Le magasin clé-valeur doit être régulièrement compacté, sinon l’historique des événements continuera de croître indéfiniment. |
service Lease (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| LeaseGrant | LeaseGrantRequest | LeaseGrantResponse | LeaseGrant crée un bail qui expire si le serveur ne reçoit pas de demande de maintien de vie dans un délai défini. Toutes les clés associées au bail expireront et seront supprimées si le bail expire. Chaque clé expirée génère un événement de suppression dans l’historique des événements. |
| LeaseRevoke | LeaseRevokeRequest | LeaseRevokeResponse | LeaseRevoke révoque un bail. Toutes les clés associées au bail expireront et seront supprimées. |
| LeaseKeepAlive | LeaseKeepAliveRequest | LeaseKeepAliveResponse | LeaseKeepAlive maintient le bail actif en transmettant en continu des demandes de maintien de vie du client vers le serveur et des réponses de maintien de vie du serveur vers le client. |
| LeaseTimeToLive | LeaseTimeToLiveRequest | LeaseTimeToLiveResponse | LeaseTimeToLive récupère les informations relatives au bail. |
| LeaseLeases | LeaseLeasesRequest | LeaseLeasesResponse | LeaseLeases liste tous les bails existants. |
service Maintenance (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| Alarme | AlarmRequest | AlarmResponse | Alarme active, désactive et interroge les alarmes relatives à l’intégrité du cluster. |
| Statut | StatusRequest | StatusResponse | Statut obtient l’état du membre. |
| Défragmentation | DefragmentRequest | DefragmentResponse | Défragmentation défragmente la base de données du membre backend afin de récupérer de l’espace de stockage. |
| Hachage | HashRequest | HashResponse | Hachage calcule le hachage de l’espace de clés backend entier, y compris les clés, les bails et les autres compartiments dans le stockage. Conçu uniquement à des fins de test ! Ne pas compter sur cette fonctionnalité en production avec des transactions en cours, car l’opération Hachage ne détient pas de verrous MVCC. Utilisez plutôt l’API “HashKV” pour vérifier la cohérence du compartiment “key”. |
| HachageKV | HashKVRequest | HashKVResponse | HachageKV calcule le hachage de toutes les clés MVCC jusqu’à une révision donnée. Il ne parcourt que le compartiment “key” dans le stockage backend. |
| Instantané | SnapshotRequest | SnapshotResponse | Instantané envoie un instantané de l’ensemble du backend depuis un membre vers un client via un flux. |
| Transfert du leader | MoveLeaderRequest | MoveLeaderResponse | Transfert du leader demande au nœud leader actuel de transférer son leadership au destinataire. |
| Mise à jour vers une version inférieure | DowngradeRequest | DowngradeResponse | Mise à jour vers une version inférieure demande une mise à jour vers une version inférieure, vérifie la faisabilité ou annule la mise à jour vers une version inférieure sur la version du cluster. Prise en charge depuis etcd 3.5. |
service Watch (api/etcdserverpb/rpc.proto)
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| Surveillance | WatchRequest | WatchResponse | La surveillance observe les événements survenus ou survenant. Les entrées et sorties sont des flux ; le flux d’entrée sert à créer et annuler des observateurs, tandis que le flux de sortie envoie les événements. Une seule requête RPC de surveillance peut surveiller plusieurs plages de clés, en diffusant les événements de plusieurs surveillance simultanément. L’historique complet des événements peut être surveillé à partir de la dernière révision de compactage. |
message AlarmMember (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| memberID | memberID est l’identifiant du membre associé à l’alarme déclenchée. | uint64 |
| alarm | alarm est le type d’alarme qui a été déclenchée. | AlarmType |
message AlarmRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action est le type de requête d’alarme à émettre. L’action peut être GET pour obtenir les états d’alarme, ACTIVATE pour activer une alarme, ou DEACTIVATE pour désactiver une alarme activée. | AlarmAction |
| memberID | memberID est l’identifiant du membre associé à l’alarme. Si memberID est 0, la requête d’alarme concerne tous les membres. | uint64 |
| alarm | alarm est le type d’alarme à prendre en compte pour cette requête. | AlarmType |
message AlarmResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| alarms | alarms est une liste d’alertes associées à la requête d’alerte. | (slice de) AlarmMember |
message AuthDisableRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message AuthDisableResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthEnableRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message AuthEnableResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthRoleAddRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name est le nom du rôle à ajouter au système d’authentification. | string |
message AuthRoleAddResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthRoleDeleteRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | chaîne de caractères |
message AuthRoleDeleteResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthRoleGetRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | chaîne de caractères |
message AuthRoleGetResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| header | ResponseHeader | |
| perm | (tranche de) authpb.Permission |
message AuthRoleGrantPermissionRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name est le nom du rôle auquel la permission sera accordée. | string |
| perm | perm est la permission à accorder au rôle. | authpb.Permission |
message AuthRoleGrantPermissionResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthRoleListRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message AuthRoleListResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (tranche de) string |
message AuthRoleRevokePermissionRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string | |
| key | bytes | |
| range_end | bytes |
message AuthRoleRevokePermissionResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthStatusRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message AuthStatusResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| enabled | bool | |
| authRevision | authRevision est la révision actuelle du magasin d’authentification | uint64 |
message AuthUserAddRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string | |
| options | authpb.UserAddOptions | |
| hashedPassword | string |
message AuthUserAddResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthUserChangePasswordRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name est le nom de l’utilisateur dont le mot de passe est modifié. | string |
| password | password est le nouveau mot de passe de l’utilisateur. Notez que ce champ sera supprimé au niveau de l’API. | string |
| hashedPassword | hashedPassword est le nouveau mot de passe de l’utilisateur. Notez que ce champ sera initialisé au niveau de l’API. | string |
message AuthUserChangePasswordResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthUserDeleteRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name est le nom de l’utilisateur à supprimer. | string |
message AuthUserDeleteResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthUserGetRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string |
message AuthUserGetResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (tranche de) string |
message AuthUserGrantRoleRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| user | user est le nom de l’utilisateur auquel il faut attribuer un rôle donné. | string |
| role | role est le nom du rôle à attribuer à l’utilisateur. | string |
message AuthUserGrantRoleResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthUserListRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message AuthUserListResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| users | (tranche de) string |
message AuthUserRevokeRoleRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| role | string |
message AuthUserRevokeRoleResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message AuthenticateRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string |
message AuthenticateResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| token | le jeton est un jeton autorisé pouvant être utilisé dans les RPC suivants | string |
message CompactionRequest (api/etcdserverpb/rpc.proto)
CompactionRequest compacte le magasin clé-valeur jusqu’à une révision donnée. Toutes les clés obsolètes dont la révision est inférieure à la révision de compactage seront supprimées.
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| révision | révision est la révision du magasin clé-valeur pour l’opération de compactage. | int64 |
| physique | physique est défini afin que l’appel RPC attende que le compactage soit physiquement appliqué à la base de données locale, de sorte que les entrées compactées soient totalement supprimées de la base de données arrière. | bool |
message CompactionResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message Compare (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| result | result est l’opération de comparaison logique pour cette comparaison. | CompareResult |
| target | target est le champ clé-valeur à inspecter pour la comparaison. | CompareTarget |
| key | key est la clé concernée par l’opération de comparaison. | bytes |
| target_union | oneof | |
| version | version est la version de la clé donnée. | int64 |
| create_revision | create_revision est la révision de création de la clé donnée. | int64 |
| mod_revision | mod_revision est la dernière révision de modification de la clé donnée. | int64 |
| value | value est la valeur de la clé donnée, en bytes. | bytes |
| lease | lease est l’identifiant du bail associé à la clé donnée. | int64 |
| range_end | range_end compare la cible donnée à toutes les clés de la plage [key, range_end). Voir RangeRequest pour plus de détails sur les plages de clés. | bytes |
message DefragmentRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message DefragmentResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message DeleteRangeRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key est la première clé à supprimer dans la plage. | bytes |
| range_end | range_end est la clé suivant la dernière clé à supprimer dans la plage [key, range_end). Si range_end n’est pas fourni, la plage est définie comme ne contenant que la clé fournie. Si range_end est supérieure d’un bit à la clé fournie, la plage correspond à toutes les clés ayant le préfixe (la clé fournie). Si range_end est ‘\0’, la plage correspond à toutes les clés supérieures ou égales à la clé fournie. | bytes |
| prev_kv | Si prev_kv est défini, etcd récupère les paires clé-valeur précédentes avant leur suppression. Les paires clé-valeur précédentes seront renvoyées dans la réponse de suppression. | bool |
message DeleteRangeResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| deleted | deleted est le nombre de clés supprimées par la requête de suppression par plage. | int64 |
| prev_kvs | si prev_kv est défini dans la requête, les paires clé-valeur précédentes seront renvoyées. | (slice de) mvccpb.KeyValue |
message DowngradeInfo (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| enabled | enabled indique si le cluster est activé pour une mise à jour inverse. | bool |
| targetVersion | targetVersion est la version cible de la mise à jour inverse. | string |
message DowngradeRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action est le type de demande de rétrogradation à émettre. L’action peut VALIDER la version cible, DOWNGRADE le cluster vers une version antérieure, ou CANCELLER le travail de rétrogradation en cours. | DowngradeAction |
| version | version est la version cible de la rétrogradation. | string |
message DowngradeResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version est la version actuelle du cluster. | string |
message DowngradeVersionTestRequest (api/etcdserverpb/rpc.proto)
DowngradeVersionTestRequest n’est utilisé que à des fins de test. La version indiquée dans cette requête sera lue comme la version des enregistrements WAL. Si la version cible du downgrade est inférieure à cette version, alors le downgrade (en ligne) ou la migration (hors ligne) n’est pas sécurisé, et ne doit donc pas être autorisé.
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ver | string |
message HashKVRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| révision | révision est la révision du magasin clé-valeur pour l’opération de hachage. | int64 |
message HashKVResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash est la valeur de hachage calculée à partir des clés MVCC du membre répondant jusqu’à une révision donnée. | uint32 |
| compact_revision | compact_revision est la révision compactée du magasin clé-valeur au moment où le hachage commence. | int64 |
| hash_revision | hash_revision est la révision jusqu’à laquelle le hachage est calculé. | int64 |
message HashRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message HashResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash est la valeur de hachage calculée à partir du backend des données clé-valeur du membre répondant. | uint32 |
message LeaseCheckpoint (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du bail à sauvegarder. | int64 |
| remaining_TTL | remaining_TTL est le temps restant avant l’expiration du bail. | int64 |
message LeaseCheckpointRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| checkpoints | (slice de) LeaseCheckpoint |
message LeaseCheckpointResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message LeaseGrantRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| TTL | TTL est le délai d’expiration conseillé en secondes. Un bail expiré retourne -1. | int64 |
| ID | ID est l’identifiant demandé pour le bail. Si ID est défini à 0, le concessionnaire choisit un identifiant. | int64 |
message LeaseGrantResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID est l’identifiant de bail pour le bail accordé. | int64 |
| TTL | TTL est le délai de vie (time-to-live) choisi par le serveur, en secondes. | int64 |
| error | string |
message LeaseKeepAliveRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du bail à maintenir actif. | int64 |
message LeaseKeepAliveResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID est l’identifiant du bail issu de la requête de maintien. | int64 |
| TTL | TTL est le nouveau délai de validité du bail. | int64 |
message LeaseLeasesRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message LeaseLeasesResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| leases | (tranche de) LeaseStatus |
message LeaseRevokeRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du bail à révoquer. Lorsque l’identifiant est révoqué, toutes les clés associées seront supprimées. | int64 |
message LeaseRevokeResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message LeaseStatus (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | int64 |
message LeaseTimeToLiveRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du bail. | int64 |
| keys | keys vaut true pour interroger toutes les clés associées à ce bail. | bool |
message LeaseTimeToLiveResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID est l’identifiant du bail issu de la requête de renouvellement. | int64 |
| TTL | TTL est le temps restant en secondes pour le bail ; le bail expirera en moins de TTL+1 secondes. | int64 |
| grantedTTL | GrantedTTL est le délai initial accordé en secondes lors de la création ou du renouvellement du bail. | int64 |
| keys | keys est la liste des clés associées à ce bail. | (slice de) bytes |
message Member (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du membre pour ce membre. | uint64 |
| name | name est le nom lisible par l’humain du membre. Si le membre n’est pas démarré, le nom sera une chaîne vide. | string |
| peerURLs | peerURLs est la liste des URL que le membre expose au cluster pour la communication. | (slice de) string |
| clientURLs | clientURLs est la liste des URL que le membre expose aux clients pour la communication. Si le membre n’est pas démarré, clientURLs sera vide. | (slice de) string |
| isLearner | isLearner indique si le membre est un membre apprenant Raft. | bool |
message MemberAddRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| peerURLs | peerURLs est la liste des URL que le membre ajouté utilisera pour communiquer avec le cluster. | (slice de) chaîne |
| isLearner | isLearner indique si le membre ajouté est un membre apprenant Raft. | bool |
message MemberAddResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| member | member contient les informations du membre ajouté. | Member |
| members | members est la liste de tous les membres après l’ajout du nouveau membre. | (slice de) Member |
message MemberListRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| linearizable | bool |
message MemberListResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| membres | membres est une liste de tous les membres associés au cluster. | (liste de) Membre |
message MemberPromoteRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du membre à promouvoir. | uint64 |
message MemberPromoteResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| membres | membres est une liste de tous les membres après la promotion du membre. | (liste de) Member |
message MemberRemoveRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du membre à supprimer. | uint64 |
message MemberRemoveResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| membres | membres est une liste de tous les membres après suppression du membre. | (liste de) Member |
message MemberUpdateRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID est l’identifiant du membre à mettre à jour. | uint64 |
| peerURLs | peerURLs est la nouvelle liste d’URLs que le membre utilisera pour communiquer avec le cluster. | (slice de) string |
message MemberUpdateResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| membres | membres est une liste de tous les membres après mise à jour du membre. | (liste de) Member |
message MoveLeaderRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| targetID | targetID est l’identifiant du nœud du nouveau leader. | uint64 |
message MoveLeaderResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
message PutRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key est la clé, sous forme d’octets, à insérer dans le magasin clé-valeur. | bytes |
| value | value est la valeur, sous forme d’octets, à associer à la clé dans le magasin clé-valeur. | bytes |
| lease | lease est l’identifiant de bail à associer à la clé dans le magasin clé-valeur. Une valeur de bail égale à 0 indique l’absence de bail. | int64 |
| prev_kv | Si prev_kv est défini, etcd récupère la paire clé-valeur précédente avant de la modifier. La paire clé-valeur précédente est renvoyée dans la réponse de mise à jour. | bool |
| ignore_value | Si ignore_value est défini, etcd met à jour la clé en utilisant sa valeur actuelle. Retourne une erreur si la clé n’existe pas. | bool |
| ignore_lease | Si ignore_lease est défini, etcd met à jour la clé en utilisant son bail actuel. Retourne une erreur si la clé n’existe pas. | bool |
message PutResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| prev_kv | Si prev_kv est défini dans la requête, la paire clé-valeur précédente sera renvoyée. | mvccpb.KeyValue |
message RangeRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key est la première clé de la plage. Si range_end n’est pas fourni, la requête ne recherche que key. | bytes |
| range_end | range_end est la borne supérieure de la plage demandée [key, range_end). Si range_end est ‘\0’, la plage comprend toutes les clés >= key. Si range_end est key plus un (par exemple, “aa”+1 == “ab”, “a\xff”+1 == “b”), la requête retourne toutes les clés ayant key comme préfixe. Si key et range_end sont tous deux ‘\0’, la requête retourne toutes les clés. | bytes |
| limit | limit est une limite sur le nombre de clés retournées par la requête. Si limit est défini à 0, il n’y a pas de limite. | int64 |
| revision | revision est le point dans le temps du magasin clé-valeur à utiliser pour la plage. Si revision est inférieur ou égal à zéro, la plage porte sur le magasin clé-valeur le plus récent. Si la révision a été compactée, la réponse renvoie ErrCompacted. | int64 |
| sort_order | sort_order est l’ordre des résultats triés retournés. | SortOrder |
| sort_target | sort_target est le champ clé-valeur à utiliser pour le tri. | SortTarget |
| serializable | serializable définit la requête de plage pour utiliser des lectures locales sérialisables. Les requêtes de plage sont linéarisables par défaut ; les requêtes linéarisables ont une latence plus élevée et un débit plus faible que les requêtes sérialisables, mais reflètent le consensus actuel du cluster. Pour de meilleures performances, au prix de lectures potentiellement obsolètes, une requête de plage sérialisable est servie localement sans nécessiter de consensus avec les autres nœuds du cluster. | bool |
| keys_only | keys_only, lorsqu’il est défini, retourne uniquement les clés et non les valeurs. | bool |
| count_only | count_only, lorsqu’il est défini, retourne uniquement le nombre de clés dans la plage. | bool |
| min_mod_revision | min_mod_revision est la borne inférieure des révisions de modification des clés retournées ; toutes les clés ayant une révision de modification inférieure sont filtrées. | int64 |
| max_mod_revision | max_mod_revision est la borne supérieure des révisions de modification des clés retournées ; toutes les clés ayant une révision de modification supérieure sont filtrées. | int64 |
| min_create_revision | min_create_revision est la borne inférieure des révisions de création des clés retournées ; toutes les clés ayant une révision de création inférieure sont filtrées. | int64 |
| max_create_revision | max_create_revision est la borne supérieure des révisions de création des clés retournées ; toutes les clés ayant une révision de création supérieure sont filtrées. | int64 |
message RangeResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| kvs | kvs est la liste des paires clé-valeur correspondant à la requête de plage. kvs est vide lorsque le comptage est demandé. | (slice de) mvccpb.KeyValue |
| more | more indique s’il reste d’autres clés à renvoyer dans la plage demandée. | bool |
| count | count est défini sur le nombre réel de clés présentes dans la plage lorsqu’une requête de comptage est effectuée. Contrairement à Kvs, il n’est pas affecté par les limites ni les filtres (par exemple, Min/Max, Création/Modification, Révisions) et reflète le comptage complet dans la plage spécifiée. | int64 |
message RequestOp (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request | request est une union de types de requête acceptés par une transaction. | oneof |
| request_range | RangeRequest | |
| request_put | PutRequest | |
| request_delete_range | DeleteRangeRequest | |
| request_txn | TxnRequest |
message ResponseHeader (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| cluster_id | cluster_id est l’identifiant du cluster qui a envoyé la réponse. | uint64 |
| member_id | member_id est l’identifiant du membre qui a envoyé la réponse. | uint64 |
| revision | revision est la révision du magasin clé-valeur au moment où la requête a été appliquée, et elle est non définie (donc 0) en cas d’appels n’interagissant pas avec le magasin clé-valeur. Pour les réponses de progression de surveillance, le champ header.revision indique la progression. Tous les événements futurs reçus sur ce flux sont garantis d’avoir un numéro de révision strictement supérieur au numéro de révision header.revision. | int64 |
| raft_term | raft_term est le terme Raft au moment où la requête a été appliquée. | uint64 |
message ResponseOp (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| response | response est une union de types de réponse retournés par une transaction. | oneof |
| response_range | RangeResponse | |
| response_put | PutResponse | |
| response_delete_range | DeleteRangeResponse | |
| response_txn | TxnResponse |
message SnapshotRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message SnapshotResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | header contient les informations actuelles du magasin clé-valeur. Le premier header dans le flux d’instantané indique le moment précis de l’instantané. | ResponseHeader |
| remaining_bytes | remaining_bytes est le nombre d’octets de données binaires à envoyer après ce message | uint64 |
| blob | blob contient le morceau suivant de l’instantané dans le flux d’instantané. | bytes |
| version | version locale du serveur qui a créé l’instantané. Dans un cluster avec des binaires de versions différentes, chaque cluster peut renvoyer un résultat différent. Indique quelle version du serveur etcd doit être utilisée pour restaurer l’instantané. | string |
message StatusRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message StatusResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version est la version du protocole du cluster utilisée par le membre répondant. | string |
| dbSize | dbSize est la taille de la base de données du backend physiquement allouée, en octets, du membre répondant. | int64 |
| leader | leader est l’identifiant du membre que le membre répondant considère comme leader actuel. | uint64 |
| raftIndex | raftIndex est l’index de validation Raft actuel du membre répondant. | uint64 |
| raftTerm | raftTerm est le terme Raft actuel du membre répondant. | uint64 |
| raftAppliedIndex | raftAppliedIndex est l’index appliqué Raft actuel du membre répondant. | uint64 |
| errors | errors contient les informations et l’état d’alarme/santé. | (slice de) string |
| dbSizeInUse | dbSizeInUse est la taille de la base de données du backend logiquement utilisée, en octets, du membre répondant. | int64 |
| isLearner | isLearner indique si le membre est un membre apprenant Raft. | bool |
| storageVersion | storageVersion est la version du fichier de base de données. Elle peut être mise à jour avec un délai par rapport à la version cible du cluster. | string |
| dbSizeQuota | dbSizeQuota est la limite de stockage etcd configurée en octets (valeur passée à l’instance etcd par le drapeau –quota-backend-bytes) | int64 |
| downgradeInfo | downgradeInfo indique s’il existe un processus de rétrogradation. | DowngradeInfo |
message TxnRequest (api/etcdserverpb/rpc.proto)
Du papier Google PaxosDB : Notre implémentation repose sur une primitive puissante que nous appelons MultiOp. Toutes les autres opérations sur la base de données, à l’exception de l’itération, sont implémentées comme un appel unique à MultiOp. Un MultiOp est appliqué de manière atomique et se compose de trois composants : 1. Une liste de tests appelée garde. Chaque test dans la garde vérifie une entrée unique dans la base de données. Il peut vérifier l’absence ou la présence d’une valeur, ou comparer avec une valeur donnée. Deux tests différents dans la garde peuvent s’appliquer à la même ou à des entrées différentes dans la base de données. Tous les tests de la garde sont appliqués, et MultiOp retourne les résultats. Si tous les tests sont vrais, MultiOp exécute l’opération t op (voir l’élément 2 ci-dessous), sinon il exécute l’opération f op (voir l’élément 3 ci-dessous). 2. Une liste d’opérations sur la base de données appelée t op. Chaque opération de la liste est soit une opération d’insertion, de suppression ou de recherche, et s’applique à une seule entrée de la base de données. Deux opérations différentes de la liste peuvent s’appliquer à la même ou à des entrées différentes dans la base de données. Ces opérations sont exécutées si la garde évalue à vrai. 3. Une liste d’opérations sur la base de données appelée f op. Comme t op, mais exécutée si la garde évalue à faux.
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| compare | compare est une liste de prédicats représentant une conjonction de termes. Si les comparaisons réussissent, les requêtes réussies seront traitées dans l’ordre, et la réponse contiendra leurs réponses respectives dans l’ordre. Si les comparaisons échouent, les requêtes échouées seront traitées dans l’ordre, et la réponse contiendra leurs réponses respectives dans l’ordre. | (liste de) Compare |
| success | success est une liste de requêtes qui seront appliquées lorsque compare évalue à true. | (liste de) RequestOp |
| failure | failure est une liste de requêtes qui seront appliquées lorsque compare évalue à false. | (liste de) RequestOp |
message TxnResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| succeeded | succeeded est défini à true si la comparaison a été évaluée à true, ou à false sinon. | bool |
| responses | responses est une liste de réponses correspondant aux résultats de l’application de succès si succeeded est true, ou d’échec si succeeded est false. | (slice de) ResponseOp |
message WatchCancelRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| watch_id | watch_id est l’identifiant de l’observateur à annuler afin qu’aucun événement supplémentaire ne soit transmis. | int64 |
message WatchCreateRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key est la clé à enregistrer pour la surveillance. | bytes |
| range_end | range_end est la fin de la plage [key, range_end) à surveiller. Si range_end n’est pas fourni, seule la clé spécifiée est surveillée. Si range_end est égal à ‘\0’, toutes les clés supérieures ou égales à la clé spécifiée sont surveillées. Si range_end est supérieure d’un bit à la clé donnée, toutes les clés ayant le préfixe (la clé donnée) sont surveillées. | bytes |
| start_revision | start_revision est une révision facultative à partir de laquelle commencer la surveillance (inclusivement). Aucune valeur de start_revision signifie « maintenant ». | int64 |
| progress_notify | progress_notify est défini afin que le serveur etcd envoie périodiquement une réponse de surveillance sans événements à l’observateur si aucun événement récent n’a eu lieu. Cela est utile lorsque les clients souhaitent récupérer un observateur déconnecté à partir d’une révision connue récente. Le serveur etcd peut décider de la fréquence à laquelle il envoie les notifications en fonction de la charge actuelle. | bool |
| filters | filters filtre les événements côté serveur avant leur envoi à l’observateur. | (slice de) FilterType |
| prev_kv | Si prev_kv est défini, l’observateur créé reçoit la paire clé-valeur précédente avant l’événement. Si la paire clé-valeur précédente a déjà été compactée, rien n’est retourné. | bool |
| watch_id | Si watch_id est fourni et non nul, il sera attribué à cet observateur. Étant donné que la création d’un observateur dans etcd n’est pas une opération synchrone, cela permet d’assurer un ordre correct lors de la création de plusieurs observateurs sur le même flux. La création d’un observateur avec un ID déjà utilisé sur le flux provoque une erreur. | int64 |
| fragment | fragment permet de diviser de grandes révisions en plusieurs réponses de surveillance. | bool |
message WatchProgressRequest (api/etcdserverpb/rpc.proto)
Demande que le statut d’avancement du flux de surveillance soit envoyé dans le flux de réponse de surveillance dès que possible.
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
message WatchRequest (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request_union | request_union est une requête visant à créer un nouvel observateur ou à annuler un observateur existant. | oneof |
| create_request | WatchCreateRequest | |
| cancel_request | WatchCancelRequest | |
| progress_request | WatchProgressRequest |
message WatchResponse (api/etcdserverpb/rpc.proto)
| Champ | Description | Type |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| watch_id | watch_id est l’identifiant de l’observateur correspondant à la réponse. | int64 |
| created | created est défini à true si la réponse correspond à une requête de création d’observateur. Le client doit enregistrer l’identifiant d’observateur et s’attendre à recevoir des événements pour l’observateur créé depuis le même flux. Tous les événements envoyés à l’observateur créé seront associés au même watch_id. | bool |
| canceled | canceled est défini à true si la réponse correspond à une requête d’annulation d’observateur ou si la révision de départ a déjà été compactée. Aucun événement supplémentaire ne sera envoyé à l’observateur annulé. | bool |
| compact_revision | compact_revision est défini à l’index minimum si un observateur tente de surveiller à une révision compactée. Cela se produit lorsqu’un observateur est créé à une révision compactée ou lorsque l’observateur ne parvient pas à suivre l’évolution du magasin clé-valeur. Le client doit traiter l’observateur comme annulé et ne pas tenter de créer un nouvel observateur avec la même révision de départ. | int64 |
| cancel_reason | cancel_reason indique la raison de l’annulation de l’observateur. | string |
| fragment | fragment est défini à true si une réponse de surveillance importante a été divisée en plusieurs réponses. | bool |
| events | (slice de) mvccpb.Event |
message Event (api/mvccpb/kv.proto)
| Champ | Description | Type |
|---|---|---|
| type | type est le type d’événement. Si type est un PUT, cela indique que de nouvelles données ont été stockées pour la clé. Si type est un DELETE, cela indique que la clé a été supprimée. | EventType |
| kv | kv contient le KeyValue associé à l’événement. Un événement PUT contient la paire clé-valeur actuelle. Un événement PUT avec kv.Version=1 indique la création d’une clé. Un événement DELETE/EXPIRE contient la clé supprimée, avec sa révision de modification définie à la révision de la suppression. | KeyValue |
| prev_kv | prev_kv contient la paire clé-valeur avant l’événement. | KeyValue |
message KeyValue (api/mvccpb/kv.proto)
| Champ | Description | Type |
|---|---|---|
| key | key est la clé sous forme d’octets. Une clé vide n’est pas autorisée. | octets |
| create_revision | create_revision est la révision de la dernière création sur cette clé. | int64 |
| mod_revision | mod_revision est la révision de la dernière modification sur cette clé. | int64 |
| version | version est la version de la clé. Une suppression réinitialise la version à zéro, et toute modification de la clé augmente sa version. | int64 |
| value | value est la valeur stockée par la clé, sous forme d’octets. | octets |
| lease | lease est l’ID du bail associé à la clé. Lorsque le bail associé expire, la clé sera supprimée. Si lease vaut 0, aucun bail n’est associé à la clé. | int64 |
message Lease (server/lease/leasepb/lease.proto)
| Champ | Description | Type |
|---|---|---|
| ID | int64 | |
| TTL | int64 | |
| RemainingTTL | int64 |
message LeaseInternalRequest (server/lease/leasepb/lease.proto)
| Champ | Description | Type |
|---|---|---|
| LeaseTimeToLiveRequest | etcdserverpb.LeaseTimeToLiveRequest |
message LeaseInternalResponse (server/lease/leasepb/lease.proto)
| Champ | Description | Type |
|---|---|---|
| LeaseTimeToLiveResponse | etcdserverpb.LeaseTimeToLiveResponse |
message Permission (api/authpb/auth.proto)
Les autorisations constituent une entité unique
| Champ | Description | Type |
|---|---|---|
| permType | Type | |
| key | bytes | |
| range_end | bytes |
message Role (api/authpb/auth.proto)
Le rôle est une entrée unique dans le bac authRoles
| Champ | Description | Type |
|---|---|---|
| name | bytes | |
| keyPermission | (tranche de) Permission |
message User (api/authpb/auth.proto)
Utilisateur est une entrée unique dans le bucket authUsers
| Champ | Description | Type |
|---|---|---|
| name | bytes | |
| password | bytes | |
| roles | (tranche de) string | |
| options | UserAddOptions |
message UserAddOptions (api/authpb/auth.proto)
| Champ | Description | Type |
|---|---|---|
| no_password | bool |
13.10 - Référence API : concurrence
Cette référence d’API est générée automatiquement à partir des fichiers nommés .proto.
service Lock (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
Le service de verrouillage expose des fonctionnalités de verrouillage côté client sous forme d’une interface gRPC.
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| Lock | LockRequest | LockResponse | Lock acquiert un verrou partagé distribué sur un verrou nommé donné. En cas de succès, elle retourne une clé unique qui reste existante tant que le verrou est détenu par l’appelant. Cette clé peut être utilisée conjointement avec des transactions afin de garantir en toute sécurité que les mises à jour sur etcd ne s’effectuent qu’en tenant le verrou. Le verrou est détenu jusqu’à ce que Unlock soit appelé sur la clé ou que le bail associé au propriétaire expire. |
| Unlock | UnlockRequest | UnlockResponse | Unlock prend une clé retournée par Lock et libère la possession du verrou. Le prochain appelant de Lock en attente du verrou est alors réveillé et obtient la possession du verrou. |
message LockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Champ | Description | Type |
|---|---|---|
| name | name est l’identifiant de la verrouille partagée distribuée à acquérir. | bytes |
| lease | lease est l’ID du bail qui sera attaché à la possession du verrou. Si le bail expire ou est révoqué et qu’il détient actuellement le verrou, celui-ci est automatiquement libéré. Les appels à Lock avec le même bail seront traités comme une seule acquisition ; verrouiller deux fois avec le même bail est sans effet. | int64 |
message LockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| key | key est une clé qui existera dans etcd pendant toute la durée où l’appelant du verrou détient le verrou. Les utilisateurs ne doivent pas modifier cette clé, sinon le verrou peut présenter un comportement indéfini. | bytes |
message UnlockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Champ | Description | Type |
|---|---|---|
| key | key est la clé d’acquisition du verrou octroyée par Lock. | bytes |
message UnlockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
service Election (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
Le service d’élection expose des fonctionnalités d’élection côté client sous forme d’une interface gRPC.
| Méthode | Type de requête | Type de réponse | Description |
|---|---|---|---|
| Campaign | CampaignRequest | CampaignResponse | Campaign attend d’acquérir le leadership lors d’une élection, en retournant une clé de leader représentant le leadership si l’opération réussit. Cette clé de leader peut ensuite être utilisée pour publier de nouvelles valeurs dans l’élection, protéger transactionnellement les requêtes d’API en fonction du maintien du leadership, ou se retirer de l’élection. |
| Proclaim | ProclaimRequest | ProclaimResponse | Proclaim met à jour la valeur publiée par le leader avec une nouvelle valeur. |
| Leader | LeaderRequest | LeaderResponse | Leader retourne la proclamation actuelle de l’élection, le cas échéant. |
| Observe | LeaderRequest | LeaderResponse | Observe diffuse les proclamations d’élection dans l’ordre, telles qu’elles sont émises par les leaders élus. |
| Resign | ResignRequest | ResignResponse | Resign libère le leadership de l’élection afin que d’autres candidats puissent acquérir le leadership. |
message CampaignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| name | name est l’identifiant de l’élection pour la campagne. | bytes |
| lease | lease est l’ID du bail associé à la direction de l’élection. Si le bail expire ou est révoqué avant la démission de la direction, la direction est transférée au prochain candidat, le cas échéant. | int64 |
| value | value est la valeur déclarée initiale définie lorsque le candidat remporte l’élection. | bytes |
message CampaignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| leader | leader décrit les ressources utilisées pour la détention du rôle de leader lors de l’élection. | LeaderKey |
message LeaderKey (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| name | name est l’identifiant d’élection correspondant à la clé de leadership. | bytes |
| key | key est une clé opaque représentant la possession de l’élection. Si la clé est supprimée, le leadership est perdu. | bytes |
| rev | rev est la révision de création de la clé. Elle peut être utilisée pour vérifier la possession d’une élection au cours de transactions en testant que la révision de création de la clé correspond à rev. | int64 |
| lease | lease est l’ID du bail du leader de l’élection. | int64 |
message LeaderRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| name | name est l’identifiant d’élection pour les informations de leadership. | bytes |
message LeaderResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| kv | kv est la paire clé-valeur représentant la mise à jour récente du leader. | mvccpb.KeyValue |
message ProclaimRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| leader | leader est la détenue du leadership lors de l’élection. | LeaderKey |
| value | value est une mise à jour destinée à remplacer la valeur actuelle du leader. | bytes |
message ProclaimResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
message ResignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| leader | leader est la prise de leadership à abandonner par démission. | LeaderKey |
message ResignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Champ | Description | Type |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
message Event (api/mvccpb/kv.proto)
| Champ | Description | Type |
|---|---|---|
| type | type est le type d’événement. Si type est un PUT, cela indique que de nouvelles données ont été stockées pour la clé. Si type est un DELETE, cela indique que la clé a été supprimée. | EventType |
| kv | kv contient la paire clé-valeur pour l’événement. Un événement PUT contient la paire clé-valeur actuelle. Un événement PUT avec kv.Version=1 indique la création d’une clé. Un événement DELETE/EXPIRE contient la clé supprimée, avec sa révision de modification définie à la révision de la suppression. | KeyValue |
| prev_kv | prev_kv contient la paire clé-valeur avant l’événement. | KeyValue |
message KeyValue (api/mvccpb/kv.proto)
| Champ | Description | Type |
|---|---|---|
| key | key est la clé sous forme d’octets. Une clé vide n’est pas autorisée. | octets |
| create_revision | create_revision est la révision de la dernière création sur cette clé. | int64 |
| mod_revision | mod_revision est la révision de la dernière modification sur cette clé. | int64 |
| version | version est la version de la clé. Une suppression réinitialise la version à zéro, et toute modification de la clé augmente sa version. | int64 |
| value | value est la valeur stockée par la clé, sous forme d’octets. | octets |
| bail | bail est l’ID du bail associé à la clé. Lorsque le bail associé expire, la clé sera supprimée. Si bail est 0, aucun bail n’est associé à la clé. | int64 |
14 - Guide des opérations
14.1 - Guides d'authentification
14.1.1 - Authentification
auth,user,role pour l’authentification :
Note :
Il s’agit simplement d’un squelette qui doit être complété et mis à jour avec des informations supplémentaires sur l’authentification. Le texte ci-dessus n’est qu’un exemple de code.
14.1.2 - Contrôle d'accès basé sur les rôles
Aperçu
L’authentification a été ajoutée à etcd 2.1. L’API v3 d’etcd a légèrement modifié l’API et l’interface utilisateur de la fonctionnalité d’authentification afin de mieux s’adapter au nouveau modèle de données. Ce guide vise à aider les utilisateurs à configurer une authentification basique et un contrôle d’accès basé sur les rôles dans etcd v3.
Utilisateurs et rôles spéciaux
Il existe un utilisateur spécial, root, et un rôle spécial, root.
Utilisateur root
L’utilisateur root, qui dispose d’un accès complet à etcd, doit être créé avant d’activer l’authentification. L’idée derrière l’utilisateur root est d’assurer des opérations administratives : gestion des rôles et des utilisateurs ordinaires. L’utilisateur root doit posséder le rôle root et est autorisé à modifier tout élément à l’intérieur d’etcd.
Rôle root
Le rôle root peut être attribué à tout utilisateur, en plus de l’utilisateur racine. Un utilisateur disposant du rôle root dispose à la fois d’un accès en lecture-écriture global et des autorisations pour mettre à jour la configuration d’authentification du cluster. En outre, le rôle root accorde les privilèges nécessaires à la maintenance générale du cluster, notamment la modification de la composition du cluster, la défragmentation du magasin et la prise d’instantanés.
Travail avec les utilisateurs
Le sous-commande user pour etcdctl gère toutes les opérations relatives aux comptes utilisateurs.
Une liste des utilisateurs peut être obtenue avec :
Créer un utilisateur est aussi simple que
La création d’un nouvel utilisateur demande de saisir un nouveau mot de passe. Le mot de passe peut être fourni depuis l’entrée standard lorsque l’option --interactive=false est utilisée. --new-user-password peut également être utilisé pour fournir le mot de passe.
La création d’un utilisateur qui ne peut pas être authentifié avec un mot de passe est également possible, comme indiqué ci-dessous :
Un tel utilisateur ne peut être authentifié que par TLS Common Name .
etcd ne prend pas en charge l’authentification avec un mot de passe vide via --user username:. Par exemple, un utilisateur créé avec un mot de passe vide, tel que etcdctl user add anonymous:'', ne peut pas s’authentifier par des requêtes username/password et les requêtes telles que etcdctl --user anonymous: get foo échouent avec user name is empty.
Les rôles peuvent être attribués ou retirés à un utilisateur avec :
Les paramètres de l’utilisateur peuvent être inspectés à l’aide de :
Et le mot de passe d’un utilisateur peut être modifié avec
Changer le mot de passe provoquera une nouvelle demande de mot de passe. Le mot de passe peut être fourni depuis l’entrée standard lorsque l’option --interactive=false est utilisée.
Supprimez un compte avec :
Travail avec les rôles
Le sous-commande role pour etcdctl gère toutes les opérations relatives aux contrôles d’accès pour des rôles spécifiques, tels qu’ils ont été attribués à des utilisateurs individuels.
Lister les rôles avec :
Créez un nouveau rôle avec :
Un rôle n’a pas de mot de passe ; il définit simplement un nouvel ensemble de droits d’accès.
Les rôles ont accès à une clé unique ou à une plage de clés.
La plage peut être spécifiée sous la forme d’un intervalle [clé_de_depart, clé_de_fin) où la clé_de_depart doit être strictement inférieure à la clé_de_fin selon un ordre alphabétique.
L’accès peut être accordé en lecture, écriture ou les deux, comme dans les exemples suivants :
Pour voir ce qui est accordé, nous pouvons consulter le rôle à tout moment :
La révocation des autorisations s’effectue de la même manière logique :
Comme pour supprimer un rôle entièrement :
Activer l’authentification
Les étapes minimales pour activer l’authentification sont les suivantes. L’administrateur peut configurer les utilisateurs et les rôles avant ou après l’activation de l’authentification, selon son choix.
Assurez-vous que l’utilisateur racine est créé :
Activer l’authentification :
Après cela, etcd fonctionne avec l’authentification activée. Pour la désactiver pour une raison quelconque, utilisez la commande inverse :
Portée de sécurité de l’authentification
Lorsque l’authentification est activée avec etcdctl auth enable, elle protège les opérations de l’API gRPC V3 (get, put, delete, surveillance, etc.).
Les points de terminaison HTTP /metrics et /health fonctionnent sur un gestionnaire distinct et ne sont pas protégés par l’authentification RBAC V3. Ce design permet à Prometheus et aux équilibreurs de charge de récupérer les métriques sans nécessiter d’authentification gRPC, tout en maintenant la protection des données clé-valeur.
Pour sécuriser ces points de visualisation :
- Activez le mTLS avec
--cert-file,--key-fileet--client-cert-auth - Ou liez les métriques à une interface privée en utilisant
--listen-metrics-urls - Ou utilisez des règles de réseau policies/firewall pour restreindre l’accès
Utilisation de etcdctl pour l’authentification
etcdctl prend en charge un indicateur similaire à curl pour l’authentification.
Le mot de passe peut être fourni à partir d’une invite :
Le mot de passe peut également être fourni via une option de ligne de commande --password :
Sinon, toutes les commandes etcdctl restent identiques. Les utilisateurs et rôles peuvent toujours être créés et modifiés, mais nécessitent une authentification par un utilisateur disposant du rôle root.
Utilisation du nom commun TLS
À compter de la version v3.2, si un serveur etcd est lancé avec l’option --client-cert-auth=true, le champ Common Name (CN) du certificat TLS du client sera utilisé comme utilisateur etcd. Dans ce cas, le nom commun sert à authentifier l’utilisateur, et le client n’a pas besoin de mot de passe. Notez que si les deux conditions suivantes sont remplies : 1. --client-cert-auth=true est fourni et le CN est fourni par le client, et 2. le nom d’utilisateur et le mot de passe sont fournis par le client, l’authentification basée sur le nom d’utilisateur et le mot de passe est prioritaire. Notez que cette fonctionnalité ne peut pas être utilisée avec gRPC-proxy ni avec gRPC-gateway. Cela est dû au fait que gRPC-proxy termine la connexion TLS provenant de son client, si bien que tous les clients partagent un certificat du proxy. gRPC-gateway utilise une connexion TLS interne pour transformer une requête HTTP en requête gRPC, ce qui entraîne la même limitation. Par conséquent, les clients ne peuvent pas transmettre correctement leur CN au serveur. gRPC-proxy provoquera une erreur et s’arrêtera si le certificat fourni a un CN non vide. gRPC-proxy renvoie une erreur indiquant que le client possède un CN non vide dans son certificat.
Remarques sur la force du mot de passe
Les API etcdctl et etcd n’imposent aucune longueur de mot de passe particulière lors de la création d’un utilisateur ou de la mise à jour de son mot de passe. Il incombe à l’administrateur d’appliquer ces exigences. Pour réduire les risques liés aux mots de passe faibles, utilisez l’authentification fondée sur le nom commun TLS
ainsi que des utilisateurs créés avec l’option --no-password.
14.2 - Options de configuration
Vous pouvez configurer etcd à l’aide des éléments suivants :
- Options en ligne de commande
- Variables d’environnement : chaque option a une variable d’environnement correspondante
dont le nom est identique, mais préfixé par
ETCD_et écrit en majuscules et [en notation snake case][]. Par exemple,--some-flagseraETCD_SOME_FLAG. - Fichier de configuration
Avertissement : Si vous mélangez des options de configuration, les règles suivantes s’appliquent.
- Les indicateurs en ligne de commande ont la priorité sur les variables d’environnement.
- Si vous fournissez un fichier de configuration, tous les indicateurs en ligne de commande et les variables d’environnement sont ignorés.
Drapeaux de ligne de commande
Les indicateurs sont présentés ci-dessous selon le format --flag-name DEFAULT_VALUE.
La liste des indicateurs fournie ci-dessous peut ne pas être à jour en raison des modifications en cours de développement. Pour obtenir la liste des indicateurs disponibles, exécutez etcd --help ou consultez l’aide de [etcd][].
Remarque : Pour plus de détails concernant les indicateurs nouveaux, mis à jour ou obsolètes de la version 3.7, consultez [CHANGELOG-3.7.md][changelog].
[journal des modifications] : https://github.com/etcd-io/etcd/blob/main/CHANGELOG/CHANGELOG-3.7.md
membre
Clusterisation
Sécurité
Auth
Analyse de performances et surveillance
Journalisation
Remarque : Plusieurs indicateurs --experimental-* ont été promus ou renommés dans la version 3.7.
Veillez à remplacer les indicateurs obsolètes par leurs équivalents stables indiqués ci-dessous.
Traçage distribué
v2 Proxy
Remarque : les indicateurs seront obsolètes à partir de la version v3.6.
Fonctionnalités
Portes fonctionnelles
Fonctionnalités non sécurisées
Avertissement : l’utilisation de fonctionnalités non sécurisées peut compromettre les garanties offertes par le protocole de consensus !
Fichier de configuration
Un fichier de configuration etcd est constitué d’une carte YAML dont les clés sont les noms de drapeaux en ligne de commande et les valeurs sont les valeurs des drapeaux.
Pour utiliser ce fichier, indiquez le chemin du fichier comme valeur du drapeau --config-file ou de la variable d’environnement ETCD_CONFIG_FILE.
Pour un exemple, voir l’exemple [etcd.conf.yml ][].
Les champs de durée tels que --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration et --downgrade-check-time acceptent
des chaînes lisibles (par exemple 10m, 5s) comme options de ligne de commande, mais
dans un fichier de configuration, ils n’acceptent que des valeurs entières représentant
des nanosecondes. Il s’agit d’une limitation connue de la bibliothèque standard Go
,
où time.Duration est désérialisé comme un entier simple.
Par exemple, pour définir un intervalle de notification de progression de 10 minutes dans un fichier de configuration :
14.3 - Modèle de sécurité du transport
etcd prend en charge le chiffrement TLS automatique ainsi que l’authentification par certificats clients pour les communications clients vers serveur, ainsi que pour les communications entre pairs (serveur vers serveur / cluster). Notez qu’etcd n’active pas par défaut l’authentification basée sur RBAC ni la fonctionnalité d’authentification au niveau du transport afin de réduire les obstacles pour les utilisateurs débutants avec la base de données. En outre, modifier cette valeur par défaut constituerait une modification incompatible pour le projet, établie depuis 2013. Un cluster etcd qui n’active pas les fonctionnalités de sécurité peut exposer ses données à tout client.
Pour démarrer, disposez tout d’abord d’un certificat CA et d’une paire de clés signées pour un membre. Il est recommandé de créer et de signer une nouvelle paire de clés pour chaque membre d’un cluster.
Pour plus de commodité, l’outil cfssl propose une interface simplifiée pour la génération de certificats, et nous fournissons un exemple utilisant cet outil ici . En alternative, consultez ce guide pour générer des paires de clés auto-signées .
La liste des indicateurs fournie ci-dessous peut ne pas être à jour en raison des modifications en cours de développement. Pour obtenir la liste des indicateurs disponibles, exécutez etcd --help ou consultez l’aide de [etcd][].
Configuration de base
etcd prend plusieurs options de configuration liées aux certificats, soit par des drapeaux en ligne de commande, soit par des variables d’environnement :
Communication client-serveur :
--cert-file=<path> : Certificat utilisé pour les connexions SSL/TLS vers etcd. Lorsque cette option est définie, advertise-client-urls peut utiliser le schéma HTTPS.
--key-file=<path> : Clé du certificat. Doit être non chiffrée.
--client-cert-auth : Lorsque cette option est définie, etcd vérifie que toutes les requêtes HTTPS entrantes incluent un certificat client signé par l’autorité de certification fiable. Les requêtes ne fournissant pas de certificat client valide échoueront. Si authentification
est activée, le certificat fournit les identifiants pour le nom d’utilisateur indiqué dans le champ Common Name.
--trusted-ca-file=<path>: Autorité de certification de confiance.
--auto-tls : Utilisez des certificats auto-signés générés automatiquement pour les connexions TLS avec les clients.
Communication entre pairs (serveur vers serveur / cluster) :
Les options de pair fonctionnent de la même manière que les options client-serveur :
--peer-cert-file=<path> : Certificat utilisé pour les connexions SSL/TLS entre pairs. Ce certificat sera utilisé à la fois pour écouter sur l’adresse de pair et pour envoyer des requêtes aux autres pairs.
--peer-key-file=<path> : Clé du certificat. Doit être non chiffrée.
--peer-client-cert-auth : Lorsqu’il est défini, etcd vérifie que toutes les requêtes entrantes de pair provenant du cluster sont accompagnées de certificats clients valides signés par l’autorité de certification fournie.
--peer-trusted-ca-file=<path>: Autorité de certification de confiance.
--peer-auto-tls : Utilisez des certificats auto-signés générés automatiquement pour les connexions TLS entre pairs.
Si un certificat client-serveur ou un certificat pair est fourni, la clé doit également être définie. Toutes ces options de configuration sont également disponibles via les variables d’environnement, ETCD_CA_FILE, ETCD_PEER_CA_FILE et ainsi de suite.
Options communes :
--cipher-suites : Liste séparée par des virgules des suites de chiffrement TLS prises en charge entre le serveur/client et les pairs (vide, automatiquement rempli par Go).
--tls-min-version=<version> Définit la version minimale TLS prise en charge par etcd.
--tls-max-version=<version> Définit la version TLS maximale prise en charge par etcd. Si ce paramètre n’est pas défini, la version maximale prise en charge par Go sera utilisée.
Usage de clé et extendedKeyUsage du certificat TLS
Lors de la génération de certificats X.509 pour sécuriser le transport etcd,
les certificats doivent inclure les champs keyUsage et extendedKeyUsage appropriés selon leur rôle.
etcd s’appuie sur les bibliothèques crypto/tls et crypto/x509 de Go pour la vérification des certificats,
qui imposent ces utilisations lors de la négociation TLS.
Le tableau suivant résume les utilisations recommandées pour les rôles de certificat courants :
| Rôle du certificat | keyUsage | extendedKeyUsage |
|---|---|---|
| Serveur (client vers serveur) | digitalSignature, keyEncipherment | serverAuth |
| Client | digitalSignature, keyEncipherment | clientAuth |
| Pair (serveur vers serveur) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Notes :
- Lorsque
--peer-client-cert-authest activé, les certificats de pair sont utilisés pour établir une TLS mutuelle entre les membres etcd, ce qui impose l’utilisation deserverAuthet declientAuth. - Les certificats clients utilisés avec
--client-cert-authdoivent inclureclientAuth.
Exemple 1 : Sécurité du transport client-serveur avec HTTPS
Pour cela, préparez un certificat d’autorité de certification (ca.crt) et une paire de clés signées (server.crt, server.key).
Configurons etcd pour fournir une sécurité de transport HTTPS simple étape par étape :
Cela devrait démarrer correctement, et il sera possible de tester la configuration en utilisant HTTPS avec etcd :
La commande doit indiquer que la négociation a réussi. Étant donné que nous utilisons des certificats auto-signés avec notre propre autorité de certification, il est nécessaire de transmettre l’autorité de certification à curl en utilisant l’option --cacert. Une autre possibilité consisterait à ajouter le certificat de l’autorité de certification au répertoire des certificats fiables du système (généralement situé dans /etc/pki/tls/certs ou /etc/ssl/certs).
Utilisateurs OSX 10.9+ : curl 7.30.0 sous OSX 10.9+ ne comprend pas les certificats passés en ligne de commande.
Au lieu de cela, importez directement le certificat dummy ca.crt dans la clé, ou ajoutez le drapeau -k à curl pour ignorer les erreurs.
Pour tester sans le drapeau -k, exécutez open ./tests/fixtures/ca/ca.crt et suivez les invites.
Veuillez supprimer ce certificat après le test !
Si une solution de contournement existe, faites-le nous savoir.
Exemple 2 : Authentification client-serveur avec des certificats clients HTTPS
Pour l’instant, nous avons donné au client etcd la capacité de vérifier l’identité du serveur et de garantir la sécurité du transport. Nous pouvons toutefois également utiliser des certificats clients pour empêcher l’accès non autorisé à etcd.
Les clients fourniront leurs certificats au serveur, qui vérifiera que le certificat est signé par l’autorité de certification fournie et décidera s’il convient de traiter la requête.
Les mêmes fichiers mentionnés dans le premier exemple sont nécessaires pour cela, ainsi qu’une paire de clés pour le client (client.crt, client.key) signée par la même autorité de certification.
Essayez maintenant la même requête quʼau-dessus sur ce serveur :
La requête doit être rejetée par le serveur :
Pour y parvenir, nous devons fournir au serveur un certificat client signé par l’autorité de certification :
La sortie doit inclure :
Et également la réponse du serveur :
Spécifiez les suites de chiffrement à bloquer suites de chiffrement TLS faibles .
L’établissement de la mainshaking TLS échouerait lorsque le client Hello est demandé avec des suites de chiffrement non valides.
Par exemple :
Ensuite, les requêtes clientes doivent préciser l’un des suites de chiffrement spécifiées sur le serveur :
Exemple 3 : Sécurité du transport et certificats clients dans un cluster
etcd prend en charge le même modèle que ci-dessus pour la communication entre pairs, ce qui signifie la communication entre les membres d’un cluster etcd.
En supposant que nous disposons de notre ca.crt et de deux membres équipés de leurs propres paires de clés (member1.crt & member1.key, member2.crt & member2.key) signées par cette autorité de certification, nous lançons etcd comme suit :
Les membres etcd formeront un cluster et toutes les communications entre les membres du cluster seront chiffrées et authentifiées à l’aide des certificats clients. La sortie d’etcd indiquera que les adresses auxquelles il se connecte utilisent HTTPS.
Exemple 4 : Sécurité de transport auto-signée automatique
Lorsque vous spécifiez ClientAutoTLS et PeerAutoTLS, la période de validité du certificat client et du certificat pair automatiquement générés par etcd est limitée à 1 an. Vous pouvez utiliser le drapeau –self-signed-cert-validity pour définir la période de validité du certificat en années.
Dans les cas où une encryption de la communication est requise, mais pas une authentification, etcd prend en charge le chiffrement de ses messages à l’aide de certificats auto-signés générés automatiquement. Cela simplifie le déploiement, car il n’est pas nécessaire de gérer séparément les certificats et les clés en dehors d’etcd.
Configurez etcd pour utiliser des certificats auto-signés pour les connexions clientes et entre pairs à l’aide des indicateurs --auto-tls et --peer-auto-tls :
Les certificats auto-signés ne vérifient pas l’identité, donc curl renverra une erreur :
Pour désactiver la vérification de la chaîne de certificats, exécutez curl avec le drapeau -k :
Notes relatives au DNS SRV
Depuis la version 3.1.0 (sauf 3.2.9), le démarrage par découverte SRV authentifie ServerName à l’aide d’un nom de domaine racine provenant du drapeau --discovery-srv. Ceci vise à prévenir les attaques de type « homme du milieu » basées sur les certificats, en exigeant que le certificat possède un nom de domaine racine correspondant dans son champ Nom alternatif du sujet (SAN). Par exemple, etcd --discovery-srv=etcd.local n’authentifiera les pairs ou clients que si les certificats fournis incluent etcd.local comme entrée dans le champ Nom alternatif du sujet (SAN).
Notes sur le proxy etcd
Le proxy etcd termine le TLS provenant de son client si la connexion est sécurisée, puis utilise sa propre clé/certificat spécifiés dans --peer-key-file et --peer-cert-file pour communiquer avec les membres etcd.
Le proxy communique avec les membres etcd à l’aide des --advertise-client-urls et --advertise-peer-urls d’un membre donné. Il achemine les requêtes clientes vers les URL de client annoncées des membres etcd, et synchronise la configuration initiale du cluster à l’aide des URL de pair annoncées des membres etcd.
Lorsqu’une authentification client est activée pour un membre etcd, l’administrateur doit s’assurer que le certificat pair spécifié dans l’option --peer-cert-file du proxy est valide pour cette authentification. Le certificat pair du proxy doit également être valide pour l’authentification pair si l’authentification pair est activée.
Notes sur l’authentification TLS
Depuis v3.2.0 , les certificats TLS sont rechargés à chaque connexion client . Cela est utile pour remplacer des certificats expirés sans arrêter les serveurs etcd ; cela peut être réalisé en écrasant les anciens certificats par de nouveaux. Le rechargement des certificats à chaque connexion ne devrait pas entraîner un surcroît de charge important, mais pourrait être amélioré à l’avenir grâce à une couche de mise en mémoire tampon. Des exemples de tests sont disponibles ici .
Depuis v3.2.0
, le serveur refuse les certificats pairs entrants comportant une IP incorrecte SAN
. Par exemple, si le certificat pair contient des adresses IP dans le champ Nom alternatif du sujet (SAN), le serveur authentifie un pair uniquement lorsque l’adresse IP distante correspond à l’une de ces adresses. Ceci vise à empêcher les points de terminaison non autorisés de rejoindre le cluster. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP réelle du pair B est 10.138.0.2, et non 10.138.0.27. Lorsque le pair B tente de rejoindre le cluster, le pair A rejette B avec l’erreur x509: certificate is valid for 10.138.0.27, not 10.138.0.2, car l’adresse IP distante de B ne correspond pas à celle figurant dans le champ Nom alternatif (SAN).
Depuis v3.2.0
, server résout le TLS DNSNames lors de la vérification SAN
. Par exemple, si le certificat pair ne contient que des noms DNS (aucune adresse IP) dans le champ Nom alternatif du sujet (SAN), le serveur authentifie un pair uniquement lorsque les résolutions inverses (dig b.com) de ces noms DNS correspondent à l’adresse IP distante. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2. Lorsque le pair B tente de rejoindre le cluster, le pair A recherche l’hôte entrant b.com afin d’obtenir la liste des adresses IP (par exemple dig b.com). Il rejette B si la liste ne contient pas l’adresse IP 10.138.0.2, avec l’erreur tls: 10.138.0.2 does not match any of DNSNames ["b.com"].
Depuis v3.2.2
, le serveur accepte les connexions si l’IP correspond, sans vérifier les entrées DNS
. Par exemple, si le certificat du pair contient des adresses IP et des noms DNS dans le champ Nom alternatif du sujet (SAN), et que l’adresse IP distante correspond à l’une de ces adresses IP, le serveur accepte simplement la connexion sans vérifier davantage les noms DNS. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2 et que invalid.domain est un hôte non valide. Lorsque le pair B tente de rejoindre le cluster, le pair A authentifie B avec succès, car le champ Nom alternatif du sujet (SAN) contient une adresse IP correspondante valide. Pour plus de détails, consultez issue#8206
.
Depuis v3.2.5
, server prend en charge la recherche inverse sur les noms DNS avec caractères génériques SAN
. Par exemple, si le certificat pair ne contient que des noms DNS (aucune adresse IP) dans le champ Subject Alternative Name (SAN), le serveur effectue d’abord une recherche inverse de l’adresse IP distante pour obtenir la liste des noms associés à cette adresse (par exemple, nslookup IPADDR). Ensuite, il accepte la connexion si ces noms correspondent à un nom du certificat pair (par correspondance exacte ou avec caractère générique). Si aucune correspondance n’est trouvée, le serveur effectue une recherche directe pour chaque entrée DNS du certificat pair (par exemple, recherche de example.default.svc lorsque l’entrée est *.example.default.svc), et accepte la connexion uniquement si les adresses résolues par l’hôte correspondent à l’adresse IP distante du certificat pair. Par exemple, la demande de signature de certificat (CSR) du pair B (avec cfssl) est :
Lorsque l’adresse IP distante du pair B est 10.138.0.2. Lorsque le pair B tente de rejoindre le cluster, le pair A effectue une recherche inverse de l’IP 10.138.0.2 afin d’obtenir la liste des noms d’hôte. Il effectue ensuite une correspondance exacte ou avec caractère générique entre les noms d’hôte et les noms DNS du certificat du pair B dans le champ Nom alternatif du sujet (SAN). Si aucune recherche inverse ni forward n’a abouti, une erreur "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"] est renvoyée. Pour plus de détails, voir issue#8268
.
v3.3.0
ajoute le drapeau etcd --peer-cert-allowed-cn
pour prendre en charge l’authentification CN (Common Name)-based pour les connexions inter-membres
. Le démarrage TLS de Kubernetes consiste à générer des certificats dynamiques pour les membres et autres composants du système (par exemple, serveur API, kubelet, etc.). Maintenir des autorités de certification (CA) différentes pour chaque composant permet un contrôle d’accès plus strict sur le cluster etcd, mais peut s’avérer fastidieux. Lorsque le drapeau –peer-cert-allowed-cn est spécifié, un nœud ne peut se joindre qu’avec un nom commun correspondant, même avec des CA partagées. La correspondance est une comparaison exacte de chaîne par rapport au champ Common Name (CN) du certificat — aucune prise en charge des caractères génériques ou des correspondances par préfixe. Pour le filtrage basé sur le nom d’hôte utilisant –peer-cert-allowed-hostname ou –client-cert-allowed-hostname, la correspondance utilise x509.Certificate.VerifyHostname() de Go, qui prend en charge à la fois les noms d’hôte exacts et les entrées génériques (par exemple, *.example.com). Par exemple, chaque membre d’un cluster à 3 nœuds est configuré avec des demandes de signature de certificat (CSRs) (avec cfssl) comme suit :
Ensuite, seuls les pairs possédant un nom commun identique seront authentifiés si --peer-cert-allowed-cn etcd.local est fourni. Les nœuds présentant des CN différents dans les demandes de signature de certificat (CSR) ou un --peer-cert-allowed-cn différent seront rejetés :
Chaque processus doit être lancé avec :
v3.2.19
et v3.3.4
corrigent le rechargement TLS lorsque le champ SAN du certificat ne contient que des adresses IP, sans nom de domaine
. Par exemple, un membre est configuré avec les CSR suivantes (avec cfssl) :
En Go, le serveur appelle (*tls.Config).GetCertificate pour recharger le TLS uniquement si le champ (*tls.Config).Certificates du serveur n’est pas vide, ou si (*tls.ClientHelloInfo).ServerName n’est pas vide et que le client fournit un SNI valide. Auparavant, etcd remplissait toujours (*tls.Config).Certificates lors de la première négociation TLS client, en le rendant non vide. Le client était donc toujours censé fournir un SNI correspondant afin de réussir la vérification TLS et de déclencher le rechargement des ressources TLS via (*tls.Config).GetCertificate.
Toutefois, un certificat dont le champ SAN ne contient aucun nom de domaine, mais uniquement des adresses IP
demanderait *tls.ClientHelloInfo avec un champ ServerName vide, ce qui empêcherait le rechargement TLS lors de la première négociation TLS ; cela pose problème lorsque des certificats expirés doivent être remplacés en ligne.
Maintenant, (*tls.Config).Certificates est créé vide lors de la première poignée de main TLS client, d’abord pour déclencher (*tls.Config).GetCertificate, puis pour peupler le reste des certificats à chaque nouvelle connexion TLS, même lorsque le SNI client est vide (par exemple, lorsque le certificat ne contient que des adresses IP).
Notes pour la liste blanche d’hôtes
L’indicateur etcd --host-whitelist spécifie les noms d’hôte acceptables provenant des requêtes HTTP clients. La politique d’origine des clients protège contre les attaques de type « rebinding DNS »
ciblant des serveurs etcd non sécurisés. En effet, tout site web peut simplement créer un nom DNS autorisé et rediriger ce nom vers "localhost" (ou toute autre adresse). Ainsi, tous les points de terminaison HTTP du serveur etcd écoutant sur "localhost" deviennent accessibles, exposant le serveur aux attaques de rebinding DNS. Pour plus de détails, consultez CVE-2018-5702
.
Politique d’origine du client fonctionne comme suit :
- Si la connexion cliente est sécurisée via HTTPS, autoriser n’importe quel nom d’hôte.
- Si la connexion cliente n’est pas sécurisée et que
"HostWhitelist"n’est pas vide, autoriser uniquement les requêtes HTTP dont le champ Host figure dans la liste blanche.
Notez que la politique d’origine du client est appliquée, qu’une authentification soit activée ou non, pour des contrôles plus stricts.
Par défaut, etcd --host-whitelist et embed.Config.HostWhitelist sont définis sur vide afin d’autoriser tous les noms d’hôte. Notez qu’en spécifiant des noms d’hôte, les adresses de boucle locale ne sont pas ajoutées automatiquement. Pour autoriser les interfaces de boucle locale, ajoutez-les manuellement à la liste blanche (par exemple "localhost", "127.0.0.1", etc.).
Questions fréquemment posées
Je constate une erreur d’alerte SSLv3 handshake lors de l’utilisation de l’authentification client TLS ?
Le paquet crypto/tls de golang vérifie l’utilisation autorisée de la clé publique du certificat avant de l’utiliser.
Pour utiliser la clé publique du certificat à des fins d’authentification client, il faut ajouter clientAuth à Extended Key Usage lors de la création de la clé publique du certificat.
Voici comment procéder :
Ajoutez la section suivante à OpenSSL.cnf :
Lors de la création du certificat, veillez à le référencer dans le drapeau -extensions :
Avec l’authentification par certificat pair, j’obtiens « le certificat est valide pour 127.0.0.1, pas pour $MY_IP »
Assurez-vous de signer les certificats avec un nom sujet correspondant à l’adresse IP publique du membre. L’outil etcd-ca, par exemple, propose une option --ip= pour sa commande new-cert.
Le certificat doit être signé pour le nom DNS complet (FQDN) du membre dans son champ « Sujet », utilisez les noms alternatifs du sujet (SAN courts, IP) pour ajouter l’adresse IP. L’outil etcd-ca propose l’option --domain= pour sa commande new-cert, et OpenSSL peut également générer it
.
etcd chiffre-t-il les données stockées sur les disques ?
No. etcd ne chiffre pas les données clé/valeur stockées sur les disques. Si un utilisateur doit chiffrer les données stockées dans etcd, plusieurs options sont disponibles :
- Faire chiffrer et déchiffrer les données par les applications clientes
- Utiliser une fonctionnalité du système de stockage sous-jacent pour chiffrer les données stockées, comme dm-crypt
J’ai un avertissement dans les journaux indiquant que « le répertoire X existe sans les permissions recommandées -rwx—— »
Lorsque etcd crée certains répertoires nouveaux, il définit les permissions des fichiers à 700 afin de limiter au maximum l’accès non autorisé. Toutefois, si l’utilisateur a déjà créé un répertoire selon ses préférences, etcd utilise ce répertoire existant et affiche un message d’avertissement si les permissions diffèrent de 700.
14.4 - Guide de clustering
Aperçu
Lancer un cluster etcd de manière statique exige que chaque membre connaisse un autre membre du cluster. Dans certains cas, les adresses IP des membres du cluster peuvent être inconnues à l’avance. Dans ces situations, le cluster etcd peut être initialisé à l’aide d’un service de découverte.
Une fois qu’un cluster etcd est en cours d’exécution, l’ajout ou la suppression de membres s’effectue via la reconfiguration en temps réel runtime reconfiguration . Pour mieux comprendre la conception sous-jacente à la reconfiguration en temps réel, nous recommandons de lire le document de conception de la configuration en temps réel .
Ce guide traite des mécanismes suivants pour amorcer un cluster etcd :
Chaque mécanisme de mise en place initiale sera utilisé pour créer un cluster etcd composé de trois machines avec les détails suivants :
| Nom | Adresse | Nom d’hôte |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Statique
Comme nous connaissons les membres du cluster, leurs adresses et la taille du cluster avant de commencer, nous pouvons utiliser une configuration de bootstrap hors ligne en définissant le drapeau initial-cluster. Chaque machine recevra soit les variables d’environnement suivantes, soit les arguments en ligne de commande :
Notez que les URL spécifiées dans initial-cluster sont les URL de pair annoncées, c’est-à-dire qu’elles doivent correspondre à la valeur de initial-advertise-peer-urls sur les nœuds respectifs.
Si vous lancez plusieurs clusters (ou créez et détruyez un seul cluster) avec la même configuration à des fins de test, il est fortement recommandé d’attribuer à chaque cluster un identifiant initial-cluster-token unique. En procédant ainsi, etcd peut générer des identifiants de cluster et de membre uniques pour chaque cluster, même s’ils ont exactement la même configuration. Cela protège etcd contre les interactions entre clusters, qui pourraient endommager les clusters.
etcd écoute sur listen-client-urls
pour accepter le trafic client. Le membre etcd annonce les URL spécifiées dans advertise-client-urls
aux autres membres, aux proxies et aux clients. Vérifiez que les advertise-client-urls sont accessibles depuis les clients prévus. Une erreur courante consiste à définir advertise-client-urls sur localhost ou à laisser la valeur par défaut si les clients distants doivent accéder à etcd.
Sur chaque machine, lancez etcd avec ces indicateurs :
Les paramètres de ligne de commande commençant par --initial-cluster seront ignorés lors des exécutions ultérieures de etcd. N’hésitez pas à supprimer les variables d’environnement ou les indicateurs de ligne de commande après le processus d’initialisation. Si des modifications de configuration sont nécessaires ultérieurement (par exemple, l’ajout ou la suppression de membres dans le cluster), consultez le guide configuration en temps réel
.
TLS
etcd prend en charge la communication chiffrée via le protocole TLS. Les canaux TLS peuvent être utilisés pour la communication interne chiffrée entre pairs au sein du cluster ainsi que pour le trafic client chiffré. Cette section présente des exemples de configuration d’un cluster avec TLS pour les pairs et les clients. Des informations supplémentaires sur la prise en charge TLS par etcd sont disponibles dans le guide de sécurité .
Certificats auto-signés
Un cluster utilisant des certificats auto-signés chiffrer le trafic et authentifier ses connexions. Pour démarrer un cluster avec des certificats auto-signés, chaque membre du cluster doit disposer d’une paire de clés unique (member.crt, member.key) signée par un certificat CA partagé du cluster (ca.crt) pour les connexions entre pairs et les connexions clients. Les certificats peuvent être générés en suivant l’exemple de configuration TLS
d’etcd.
Sur chaque machine, etcd sera lancé avec ces indicateurs :
Certificats automatiques
Si le cluster nécessite une communication chiffrée mais ne requiert pas de connexions authentifiées, etcd peut être configuré pour générer automatiquement ses clés. Lors de l’initialisation, chaque membre crée son propre jeu de clés en fonction de ses adresses IP et hôtes annoncés.
Sur chaque machine, etcd sera lancé avec ces indicateurs :
Cas d’erreur
Dans l’exemple suivant, nous n’avons pas inclus notre nouvel hôte dans la liste des nœuds énumérés. Si c’est un nouveau cluster, le nœud doit être ajouté à la liste des membres initiaux du cluster.
Dans cet exemple, nous tentons de mapper un nœud (infra0) sur une adresse différente (127.0.0.1:2380) de celle qui est énumérée dans la liste du cluster (10.0.1.10:2380). Si ce nœud doit écouter sur plusieurs adresses, toutes ces adresses doivent être indiquées dans la directive de configuration “initial-cluster”.
Si un pair est configuré avec un ensemble différent d’arguments de configuration et tente de rejoindre ce cluster, etcd signalera une incompatibilité d’ID de cluster et quittera.
Découverte
Dans plusieurs cas, les adresses IP des pairs du cluster ne sont pas connues à l’avance. C’est fréquent lors de l’utilisation de fournisseurs de cloud ou lorsque le réseau utilise DHCP. Dans ces situations, au lieu de spécifier une configuration statique, utilisez un cluster etcd existant pour amorcer un nouveau cluster. Ce processus s’appelle la « découverte ».
Deux méthodes peuvent être utilisées pour la découverte :
- service de découverte etcd
- enregistrements DNS SRV
etcd discovery
Pour mieux comprendre la conception du protocole du service de découverte, nous recommandons de lire la documentation du protocole du service de découverte documentation .
Durée de vie d’une URL de découverte
Une URL de découverte identifie un cluster etcd unique. Au lieu de réutiliser une URL de découverte existante, chaque instance etcd partage une nouvelle URL de découverte pour amorcer le nouveau cluster.
En outre, les URL de découverte doivent être utilisées UNIQUEMENT pour le démarrage initial d’un cluster. Pour modifier la composition du cluster une fois qu’il est déjà en cours d’exécution, consultez le guide reconfiguration en temps réel .
Service de découverte etcd personnalisé
La découverte utilise un cluster existant pour amorcer son démarrage. Si vous utilisez un cluster etcd privé, créez une URL comme suit :
En définissant la clé size à l’URL, une URL de découverte est créée avec une taille de cluster attendue de 3.
L’URL à utiliser dans ce cas sera https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 et les membres etcd utiliseront le répertoire https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 pour s’enregistrer au moment de leur démarrage.
Chaque membre doit avoir un drapeau de nom différent spécifié. Hostname ou machine-id peut être un choix pertinent. Sinon, la découverte échouera en raison d’un nom en double.
Nous lançons maintenant etcd avec les drapeaux pertinents pour chaque membre :
Cela obligera chaque membre à s’enregistrer auprès du service de découverte etcd personnalisé et à démarrer le cluster une fois que toutes les machines auront été enregistrées.
Service de découverte publique etcd
Si aucun cluster existant n’est disponible, utilisez le service de découverte publique hébergé sur discovery.etcd.io. Pour créer une URL de découverte privée à l’aide de l’endpoint « new », utilisez la commande :
Cela créera le cluster avec une taille initiale de 3 membres. Si aucune taille n’est spécifiée, une valeur par défaut de 3 est utilisée.
Chaque membre doit disposer d’un indicateur de nom différent, faute de quoi la découverte échouera en raison de noms en double. Hostname ou machine-id peut être un bon choix.
Nous lançons maintenant etcd avec les drapeaux pertinents pour chaque membre :
Cela obligera chaque membre à s’enregistrer auprès du service de découverte et à démarrer le cluster une fois que tous les membres auront été enregistrés.
Utilisez la variable d’environnement ETCD_DISCOVERY_PROXY pour obliger etcd à utiliser un proxy HTTP afin de se connecter au service de découverte.
Cas d’erreur et d’avertissement
Erreurs du serveur de découverte
Avertissements
Il s’agit d’un avertissement inoffensif indiquant que l’URL de découverte sera ignorée sur cette machine.
Découverte DNS
Les enregistrements SRV DNS
peuvent être utilisés comme mécanisme de découverte.
L’option --discovery-srv peut être utilisée pour définir le nom de domaine DNS où les enregistrements SRV de découverte sont situés.
La configuration --discovery-srv example.com entraîne la recherche des enregistrements SRV dans l’ordre indiqué :
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Si _etcd-server-ssl._tcp.example.com est trouvé, etcd tentera le processus d’amorçage via TLS.
Afin d’aider les clients à découvrir le cluster etcd, les enregistrements DNS SRV suivants sont recherchés dans l’ordre indiqué :
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Si _etcd-client-ssl._tcp.example.com est présent, les clients tenteront de communiquer avec le cluster etcd via SSL/TLS.
Si etcd utilise TLS, l’enregistrement SRV de découverte (par exemple example.com) doit être inclus dans les SAN DNS du certificat SSL en plus de l’hôte, faute de quoi le cluster échouera avec des messages d’erreur similaires aux suivants :
Si etcd utilise TLS sans autorité de certification personnalisée, le domaine de découverte (par exemple, example.com) doit correspondre au domaine de l’enregistrement SRV (par exemple, infra1.example.com). Cela permet de limiter les attaques visant à falsifier des enregistrements SRV afin de les faire pointer vers un domaine différent ; le domaine cible aurait alors un certificat valide selon la PKI, mais serait contrôlé par un tiers inconnu.
L’option -discovery-srv-name configure en outre un suffixe dans le nom SRV interrogé lors de la découverte.
Utilisez cette option pour distinguer plusieurs clusters etcd situés sous le même domaine.
Par exemple, si discovery-srv=example.com et -discovery-srv-name=foo sont définis, les requêtes DNS SRV suivantes sont effectuées :
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
Créer des enregistrements DNS SRV
Initialiser le cluster etcd à l’aide du DNS
Les membres d’un cluster etcd peuvent annoncer des noms de domaine ou des adresses IP ; le processus d’initialisation résoudra les enregistrements A DNS.
À compter de la version 3.2 (la version 3.1 affiche des avertissements), --listen-peer-urls et --listen-client-urls rejettent les noms de domaine pour la liaison sur l’interface réseau.
L’adresse résolue dans --initial-advertise-peer-urls doit correspondre à l’une des adresses résolues figurant dans les cibles SRV. Le membre etcd lit l’adresse résolue afin de déterminer s’il appartient au cluster défini dans les enregistrements SRV.
Le cluster peut également amorcer son démarrage à l’aide d’adresses IP au lieu de noms de domaine :
Depuis la version 3.1.0 (sauf la version 3.2.9), lorsque etcd --discovery-srv=example.com est configuré avec TLS, le serveur n’authentifie les pairs ou clients que si les certificats fournis comportent comme entrée dans le champ Nom alternatif du sujet (SAN) le domaine racine example.com. Voir Notes sur le DNS SRV
.
Passerelle
Le passerelle etcd est un proxy TCP simple qui achemine les données réseau vers le cluster etcd. Veuillez consulter le guide gateway pour plus d’informations.
Proxy
Lorsque le drapeau --proxy est défini, etcd s’exécute en mode proxy proxy mode
. Ce mode proxy ne prend en charge que l’API etcd v2 ; aucune mise en œuvre de l’API v3 n’est prévue. En revanche, pour la prise en charge de l’API v3, un nouveau proxy doté de fonctionnalités améliorées sera disponible après la sortie d’etcd 3.0.
Pour configurer un cluster etcd avec des proxys de l’API v2, veuillez consulter le document clustering de la version 2.3 d’etcd.
14.5 - Exécuter des clusters etcd dans des conteneurs
Le guide suivant explique comment exécuter etcd avec Docker en utilisant le processus de bootstrap statique static bootstrap process .
Docker
Afin d’exposer l’API etcd aux clients situés en dehors de l’hôte Docker, utilisez l’adresse IP hôte du conteneur. Voir docker inspect
pour plus de détails sur la manière d’obtenir l’adresse IP. En alternative, spécifiez le drapeau --net=host à la commande docker run afin de passer outre la mise du conteneur dans une pile réseau séparée.
Exécution d’un nœud unique etcd
Utilisez l’adresse IP hôte lors de la configuration d’etcd :
Configurez un volume Docker pour stocker les données etcd :
Exécutez la dernière version d’etcd (v3.7.0 au moment de la rédaction) :
Lister le membre du cluster :
Exécution d’un cluster etcd à 3 nœuds
Pour exécuter etcdctl en utilisant la version 3 de l’API :
Infrastructure physique
Pour provisionner un cluster etcd à 3 nœuds sur du matériel physique, les exemples présents dans le répertoire baremetal peuvent être utiles.
Montage d’un volume de certificat
Le conteneur de version d’étcd ne contient pas de certificats racines par défaut. Pour utiliser HTTPS avec des certificats approuvés par une autorité racine (par exemple, pour la découverte), montez un répertoire de certificats dans le conteneur etcd :
14.6 - Exécuter des clusters etcd en tant que StatefulSet Kubernetes
Ci-dessous montre comment effectuer le processus de bootstrap statique comme un StatefulSet Kubernetes .
Exemple de manifeste
Ce manifeste contient un service et un statefulset pour déployer un cluster etcd statique dans Kubernetes.
Si vous copiez le contenu du manifeste dans un fichier nommé etcd.yaml, vous pouvez l’appliquer à un cluster à l’aide de cette commande.
Une fois appliqué, attendez que les pods soient prêts.
Le conteneur utilisé dans l’exemple inclut etcdctl et peut être appelé directement à l’intérieur des pods.
Pour déployer avec un certificat auto-signé, reportez-vous aux en-têtes de configuration commentés commençant par ## TLS afin de trouver les valeurs que vous pouvez décommenter. Des instructions supplémentaires pour générer un certificat avec cert-manager sont fournies dans une section ci-dessous.
Génération des certificats
Dans cette section, nous utilisons Helm pour installer un opérateur appelé cert-manager .
Avec cert-manager installé dans le cluster, des certificats auto-signés peuvent être générés directement dans le cluster. Ces certificats générés sont placés dans un objet secret pouvant être attaché en tant que fichiers dans des conteneurs.
Voici la commande Helm pour installer cert-manager.
Voici une configuration d’Issuer de cluster exemple pour la génération de certificats auto-signés.
Ce manifeste crée des objets Certificate pour les certificats client et serveur, en faisant référence à l’objet ClusterIssuer « selfsigned ». Les dnsNames doivent constituer une liste exhaustive des noms d’hôte valides pour les certificats créés par cert-manager.
14.7 - Modes de défaillance
Les défaillances sont fréquentes dans un déploiement à grande échelle de machines. Une machine défaillante est une machine dont le matériel ou le logiciel présente une anomalie. Plusieurs machines peuvent défaillir simultanément en cas de panne de courant ou de problèmes réseau. Plusieurs types de défaillances peuvent également survenir en même temps ; il est presque impossible d’énumérer toutes les situations de défaillance possibles.
Dans cette section, nous recensons les types d’pannes et discutons de la manière dont etcd est conçu pour y résister. La plupart des utilisateurs, sinon tous, peuvent associer une panne particulière à un type de panne spécifique. Pour se préparer aux rares pannes irréversibles , il est toujours recommandé de sauvegarder le cluster etcd.
Échec mineur des suiveurs
Lorsque moins de la moitié des suiveurs échouent, le cluster etcd peut continuer à accepter des requêtes et à progresser sans interruption majeure. Par exemple, deux échecs de suiveurs n’affectent pas le fonctionnement d’un cluster etcd à cinq membres. Toutefois, les clients perdent la connectivité avec les membres défaillants. Les bibliothèques clientes doivent masquer ces interruptions aux utilisateurs pour les requêtes en lecture en se reconnectant automatiquement à d’autres membres. Les opérateurs doivent s’attendre à une augmentation de la charge système sur les autres membres en raison des reconnexions.
Défaillance du leader
Lorsqu’un leader échoue, le cluster etcd élit automatiquement un nouveau leader. L’élection n’a pas lieu instantanément après l’échec du leader. Elle prend environ un délai d’élection, car le modèle de détection des échecs repose sur un délai d’attente.
Pendant l’élection du leader, le cluster ne peut pas traiter d’écritures. Les requêtes d’écriture envoyées pendant l’élection sont mises en attente jusqu’à l’élection d’un nouveau leader.
Les écritures déjà envoyées au vieux leader mais non encore validées peuvent être perdues. Le nouveau leader peut réécrire n’importe quelle entrée non validée provenant du leader précédent. Du point de vue de l’utilisateur, certaines requêtes d’écriture peuvent expirer après une nouvelle élection de leader. Toutefois, aucune écriture validée n’est jamais perdue.
Le nouveau leader étend automatiquement les délais de tous les bails. Ce mécanisme garantit qu’un bail ne sera pas expiré avant le TTL accordé, même s’il a été accordé par le leader ancien.
Défaillance majoritaire
Lorsque la majorité des membres du cluster échoue, le cluster etcd échoue et ne peut plus accepter d’écritures.
Le cluster etcd ne peut être mis en récupération qu’après la disponibilité de la majorité des membres. Si la majorité des membres ne peut revenir en ligne, l’opérateur doit alors lancer la récupération après sinistre pour restaurer le cluster.
Dès qu’une majorité des membres fonctionne, le cluster etcd élit automatiquement un nouveau leader et redevient sain. Le nouveau leader étend automatiquement les délais de tous les bails. Ce mécanisme garantit qu’aucun bail n’expire en raison d’une indisponibilité du serveur.
Partition réseau
Une partition réseau est similaire à une défaillance mineure d’un suiveur ou à une défaillance du leader. Une partition réseau divise le cluster etcd en deux parties ; l’une dispose d’une majorité de membres, l’autre d’une minorité. Le côté majoritaire devient le cluster disponible, tandis que le côté minoritaire devient indisponible. Il n’y a pas de « split-brain » dans etcd car les membres du cluster sont explicitement added/removed et chaque modification est approuvée par la majorité actuelle des membres.
Si le leader se trouve du côté majoritaire, alors, du point de vue de la majorité, la défaillance correspond à une défaillance d’un suiveur minoritaire. Si le leader se trouve du côté minoritaire, il s’agit d’une défaillance du leader. Le leader du côté minoritaire cède son rôle, et le côté majoritaire élit un nouveau leader.
Une fois que la partition réseau est résolue, le côté minoritaire reconnaît automatiquement le leader provenant du côté majoritaire et restaure son état.
Échec du démarrage
Le démarrage initial d’un cluster réussit uniquement si tous les membres requis démarrent correctement. Si une erreur survient pendant le démarrage initial, supprimez les répertoires de données sur tous les membres, puis redémarrez le cluster avec un nouveau cluster-token ou un nouveau jeton de découverte.
Bien sûr, il est possible de récupérer un cluster initialisé qui a échoué, tout comme on récupère un cluster en cours d’exécution. Toutefois, la récupération de ce cluster prend presque toujours plus de temps et de ressources que le démarrage d’un nouveau cluster, car aucune donnée n’a besoin d’être récupérée.
14.8 - Récupération après sinistre
etcd est conçu pour résister aux pannes de machines. Un cluster etcd se rétablit automatiquement après des pannes temporaires (par exemple, redémarrages de machine) et tolère jusqu’à (N-1)/2 pannes permanentes pour un cluster composé de N membres. Lorsqu’un membre subit une panne permanente, qu’elle soit due à une défaillance matérielle ou à une corruption du disque, il perd accès au cluster. Si le cluster perd définitivement plus de (N-1)/2 membres, il subit une panne catastrophique, perdant irrévocablement son quorum. Une fois le quorum perdu, le cluster ne peut plus atteindre de consensus et ne peut donc plus accepter de mises à jour.
Pour récupérer après une panne catastrophique, etcd v3 fournit des fonctionnalités d’instantané et de restauration afin de recréer le cluster sans perte de données clés v3. Pour récupérer les clés v2, reportez-vous au guide d’administration v2 .
Instantané de l’espace de clés
La récupération d’un cluster nécessite tout d’abord un instantané de l’espace de clés provenant d’un membre etcd. Un instantané peut être pris à partir d’un membre en cours d’exécution à l’aide de la commande etcdctl snapshot save ou en copiant le fichier member/snap/db depuis un répertoire de données etcd. Par exemple, la commande suivante crée un instantané de l’espace de clés servi par $ENDPOINT dans le fichier snapshot.db :
Notez qu’effectuer l’instantané à partir du fichier member/snap/db peut entraîner la perte de données non encore écrites, mais présentes dans le répertoire wal (write-ahead-log).
État d’un instantané
Pour comprendre quelle révision et quel hachage contient un instantané donné, vous pouvez utiliser la commande etcdutl snapshot status :
Restauration d’un cluster
Différence de révision
Lorsque vous restaurez un cluster, les clients existants peuvent percevoir une révision qui remonte de plusieurs centaines ou milliers d’unités. Cela est dû au fait qu’un instantané donné ne contient que l’historique des données jusqu’au moment où il a été pris, alors que l’état actuel du cluster peut déjà être plus avancé.
Cela pose particulièrement problème lors de l’exécution de Kubernetes avec etcd, où les contrôleurs et les opérateurs peuvent utiliser ce qu’on appelle informers, qui agissent comme des caches locaux et reçoivent des notifications de mise à jour via des surveillance. Le retour à une révision antérieure peut ne pas actualiser correctement ces caches, entraînant un comportement imprévisible et incohérent dans les contrôleurs.
Lors de la restauration à partir d’un instantané dans le cadre de : consommateurs connus de l’API de surveillance, copies locales mises en cache des données etcd ou de l’utilisation générale de Kubernetes, il est fortement recommandé de procéder à la restauration en utilisant les « augmentations de révision » ci-dessous.
Restauration à partir d’un instantané
Pour restaurer un cluster, il suffit d’un seul fichier d’instantané « db ». La restauration d’un cluster avec etcdutl snapshot restore crée de nouveaux répertoires de données etcd ; tous les membres doivent restaurer à l’aide du même instantané. La restauration écrase certaines métadonnées de l’instantané (en particulier l’ID de membre et l’ID de cluster) ; le membre perd alors son identité antérieure. Cette écrasement des métadonnées empêche le nouveau membre de rejoindre involontairement un cluster existant. Par conséquent, pour démarrer un cluster à partir d’un instantané, la restauration doit démarrer un nouveau cluster logique.
Une restauration simple peut être exécutée comme suit :
Vérifications d’intégrité
L’intégrité de l’instantané peut être vérifiée de manière facultative au moment de la restauration. Si l’instantané est pris avec etcdctl snapshot save, il contient un hachage d’intégrité qui est vérifié par etcdutl snapshot restore. Si l’instantané est copié depuis le répertoire de données, aucun hachage d’intégrité n’est présent, et sa restauration ne sera possible qu’en utilisant --skip-hash-check.
Restauration avec augmentation de la révision
Afin de garantir que les révisions ne diminuent jamais après une restauration, vous pouvez utiliser l’option --bump-revision. Cette option prend un entier sur 64 bits, qui indique le nombre de révisions à ajouter à la révision actuelle de l’instantané. Étant donné qu’une écriture dans etcd augmente la révision de un, vous pouvez couvrir un instantané datant d’une semaine en augmentant la révision de 1'000'000'000, à condition que etcd fonctionne avec moins de 1500 écritures par seconde.
Dans le contexte des contrôleurs Kubernetes, il est également important de marquer toutes les révisions, y compris la mise à jour, comme compactées à l’aide de --mark-compacted. Cela garantit que toutes les surveillance sont terminées et qu’etcd ne répond pas aux requêtes concernant les révisions survenues après la prise de l’instantané — ce qui invalide effectivement les caches d’informateurs.
Un appel complet peut avoir l’aspect suivant :
Restauration avec membre mis à jour
Les membres d’un cluster etcd sont stockés dans etcd lui-même et maintenus grâce à l’algorithme de consensus Raft. Lorsque le quorum est entièrement perdu, vous devrez peut-être reconsidérer l’emplacement et la manière dont le nouveau cluster est constitué, par exemple sur un ensemble entièrement nouveau de membres.
Lors de la restauration à partir d’un instantané, vous pouvez fournir directement la nouvelle configuration d’appartenance dans la base de données comme suit :
Cela garantit que le cluster nouvellement construit ne se connecte qu’aux autres membres restaurés ayant le jeton donné, et non aux membres plus anciens qui pourraient encore être actifs et tenter de se connecter.
En revanche, lors du démarrage d’etcd, vous pouvez fournir --force-new-cluster afin de remplacer l’appartenance au cluster tout en conservant les données d’application existantes. Notez que cette opération est fortement déconseillée, car elle provoquera un arrêt brutal si d’autres membres du cluster précédent sont encore actifs. Veillez à sauvegarder régulièrement des instantanés.
Exemple bout en bout
Prenez un instantané à partir d’un cluster en cours d’exécution à l’aide de :
En continuant de l’exemple précédent, la commande suivante crée de nouveaux répertoires de données etcd (m1.etcd, m2.etcd, m3.etcd) pour un cluster à trois membres :
Ensuite, démarrez etcd avec les nouveaux répertoires de données :
Le cluster etcd restauré doit maintenant être disponible et servir l’espace de clés depuis l’instantané.
À partir de etcd v3.6, les utilisateurs ne peuvent utiliser que etcdctl pour créer un instantané des données, mais doivent utiliser etcdutl pour restaurer les données à partir d’un instantané. Si --data-dir n’est pas spécifié, la valeur par défaut de --data-dir est <name>.etcd (où <name> correspond à la valeur de --name). Par exemple, si --data-dir n’a pas été fourni et que les membres sont nommés m1, m2 et m3, les répertoires --data-dir seront m1.etcd, m2.etcd et m3.etcd.
14.9 - etcd gateway
Qu’est-ce que la passerelle etcd
Le passerelle etcd est un proxy TCP simple qui achemine les données réseau vers le cluster etcd. La passerelle est sans état et transparente ; elle n’inspecte ni les requêtes clients ni les réponses du cluster. Elle ne termine pas les connexions TLS, ne réalise pas d’échanges TLS à la place de ses clients, ni ne vérifie si la connexion est sécurisée.
La passerelle prend en charge plusieurs points d’accès serveur etcd et fonctionne selon une politique de rotation simple. Elle ne route que vers les points d’accès disponibles et masque les échecs à ses clients. D’autres politiques de réessai, telles que la rotation pondérée, pourraient être prises en charge à l’avenir.
Quand utiliser la passerelle etcd
Chaque application qui accède à etcd doit d’abord connaître l’adresse d’un point de terminaison client du cluster etcd. Si plusieurs applications sur le même serveur accèdent au même cluster etcd, chaque application doit tout de même connaître les points de terminaison clients annoncés du cluster etcd. Si le cluster etcd est reconfiguré pour utiliser des points de terminaison différents, chaque application peut également devoir mettre à jour sa liste de points de terminaison. Cette reconfiguration à grande échelle est à la fois fastidieuse et sujette aux erreurs.
Le passerelle etcd résout ce problème en agissant comme un point d’accès local stable. Une configuration typique de passerelle etcd fait en sorte que chaque machine exécute une passerelle écoutant sur une adresse locale, et que chaque application etcd se connecte à sa passerelle locale. Le résultat est que seule la passerelle doit mettre à jour ses points de terminaison, et non chaque application individuellement.
En résumé, pour propager automatiquement les modifications des points d’accès du cluster, la passerelle etcd s’exécute sur chaque machine hébergeant plusieurs applications qui accèdent au même cluster etcd.
Quand ne pas utiliser la passerelle etcd
- Amélioration des performances
La passerelle n’est pas conçue pour améliorer les performances du cluster etcd. Elle ne propose ni mise en cache, ni regroupement ou regroupement par lots des opérations de surveillance. L’équipe etcd développe actuellement un proxy de mise en cache conçu pour améliorer l’évolutivité du cluster.
- Exécution sur un système de gestion de cluster
Les systèmes de gestion de cluster avancés comme Kubernetes prennent en charge nativement la découverte de services. Les applications peuvent accéder à un cluster etcd à l’aide d’un nom DNS ou d’une adresse IP virtuelle gérée par le système. Par exemple, kube-proxy est équivalent à une passerelle etcd.
Démarrer la passerelle etcd
Considérez un cluster etcd avec les points de terminaison statiques suivants :
| Nom | Adresse | Nom d’hôte | Port |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Démarrez la passerelle etcd pour utiliser ces points de terminaison statiques avec la commande :
En revanche, si vous utilisez le DNS pour la découverte de service, envisagez les entrées SRV DNS :
Démarrez la passerelle etcd pour récupérer les points d’accès à partir des entrées DNS SRV avec la commande :
Drapeaux de configuration
etcd cluster
–endpoints
- Liste séparée par des virgules des cibles serveur etcd vers lesquelles les connexions clients sont acheminées.
- Valeur par défaut :
127.0.0.1:2379 - Le port doit être inclus.
- Exemple incorrect :
https://127.0.0.1:2379(la passerelle ne termine pas le TLS). Notez que la passerelle ne vérifie pas le schéma HTTP ni n’inspecte les requêtes, elle ne fait que les acheminer vers les points de terminaison indiqués.
–discovery-srv
- Domaine DNS utilisé pour amorcer les points d’accès du cluster via des enregistrements SRV.
- Par défaut : (non défini)
Réseau
–listen-addr
- Interface et port d’écoute pour accepter les requêtes clients.
- Valeur par défaut :
127.0.0.1:23790
–retry-delay
- Durée du délai avant de réessayer la connexion aux points de terminaison défaillants.
- Valeur par défaut : 1m0s
- Exemple non valide : “123” (unité de temps attendue au format)
Sécurité
–insecure-discovery
- Accepter les enregistrements SRV qui sont non sécurisés ou susceptibles d’attaques d’homme-du-milieu.
- Valeur par défaut :
false
–trusted-ca-file
- Chemin vers le fichier CA TLS du client pour le cluster etcd, utilisé pour vérifier les points de terminaison retournés par la découverte SRV. Notez qu’il n’est utilisé QUE pour l’authentification des points de terminaison découverts, et non pour établir des connexions de transfert de données. La passerelle ne termine jamais de connexions TLS ni ne crée de connexions TLS en lieu et place de ses clients.
- Par défaut : (non défini)
14.10 - Proxie gRPC
Le proxy gRPC est un proxy inverse etcd sans état fonctionnant au niveau du protocole gRPC (L7). Le proxy est conçu pour réduire la charge de traitement totale imposée au cluster etcd principal. Pour assurer une évolutivité horizontale, il regroupe les requêtes d’API de surveillance et de bail. Pour protéger le cluster contre les clients abusifs, il met en mémoire tampon les requêtes portant sur des plages de clés.
Le proxy gRPC prend en charge plusieurs points d’entrée de serveur etcd. Au démarrage du proxy, il choisit aléatoirement un point d’entrée de serveur etcd à utiliser. Ce point d’entrée traite toutes les requêtes jusqu’à ce que le proxy détecte une défaillance. Si le proxy gRPC détecte une défaillance d’un point d’entrée, il bascule vers un autre point d’entrée, si disponible, afin de masquer les défaillances à ses clients. D’autres politiques de réessai, telles que le round-robin pondéré, pourraient être prises en charge à l’avenir.
API de surveillance évolutif
Le proxy gRPC regroupe plusieurs observateurs clients (c-watchers) sur la même clé ou plage en un seul observateur (s-watcher) connecté à un serveur etcd. Le proxy diffuse tous les événements provenant du s-watcher à ses c-watchers.
En supposant que N clients effectuent une surveillance sur la même clé, un proxy gRPC peut réduire la charge de surveillance sur le serveur etcd de N à 1. Les utilisateurs peuvent déployer plusieurs proxies gRPC afin de répartir davantage la charge du serveur.
Dans l’exemple suivant, trois clients effectuent une surveillance sur la clé A. Le proxy gRPC regroupe les trois observateurs, créant un seul observateur attaché au serveur etcd.
Limitations
Pour effectuer une coalescence efficace de plusieurs observateurs clients en un seul observateur, le proxy gRPC effectue une coalescence des nouveaux c-watchers vers un s-watcher existant lorsque cela est possible. Ce s-watcher coalescé peut être hors synchronisation avec le serveur etcd en raison de retards réseau ou d’événements mis en mémoire tampon non livrés. Lorsque la révision de surveillance n’est pas précisée, le proxy gRPC ne garantit pas que le c-watcher commencera à surveiller à partir de la révision la plus récente du magasin. Par exemple, si un client surveille à partir d’un serveur etcd avec la révision 1000, cet observateur commencera à la révision 1000. Si un client surveille à partir du proxy gRPC, il peut commencer à surveiller à partir de la révision 990.
Des limitations similaires s’appliquent à l’annulation. Lorsqu’un observateur est annulé, la révision du serveur etcd peut être supérieure à la révision de la réponse d’annulation.
Ces deux limitations ne devraient pas poser de problème pour la plupart des cas d’utilisation. À l’avenir, des options supplémentaires pourraient être disponibles afin de forcer l’observateur à contourner le proxy gRPC pour des réponses de révision plus précises.
API bail évolutif
Pour maintenir ses bails actifs, un client doit établir au moins une connexion gRPC avec un serveur etcd afin d’envoyer des signaux d’activité périodiques. Si une charge de travail etcd implique une activité de bail importante répartie sur de nombreux clients, ces connexions peuvent entraîner une utilisation excessive du processeur. Pour réduire le nombre total de connexions sur le cluster principal, le proxy prend en charge la fusion des connexions de bail.
En supposant que N clients mettent à jour des bails, un unique proxy gRPC réduit la charge des flux sur le serveur etcd de N à 1. Les déploiements peuvent inclure des proxies gRPC supplémentaires afin de répartir davantage les flux sur plusieurs proxies.
Dans l’exemple suivant, trois clients mettent à jour trois bails indépendants (L1, L2 et L3). Le proxy gRPC fusionne les trois flux de bail client (c-streams) en un seul flux de renouvellement de bail (s-stream) associé à un serveur etcd. Le proxy transfère les battements de cœur de bail côté client provenant des flux c vers le flux s, puis renvoie les réponses aux flux c correspondants.
Protection contre les clients abusifs
Le proxy gRPC met en mémoire tampon les réponses aux requêtes lorsqu’il ne compromet pas les exigences de cohérence. Cela peut protéger le serveur etcd contre les clients abusifs exécutant des boucles serrées.
Démarrer le proxy gRPC etcd
Considérez un cluster etcd avec les points de terminaison statiques suivants :
| Nom | Adresse | Nom d’hôte |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Démarrez le proxy gRPC etcd pour utiliser ces points de terminaison statiques avec la commande :
Le proxy gRPC etcd démarre et écoute sur le port 2379. Il achemine les requêtes clientes vers l’un des trois points de terminaison fournis ci-dessus.
Envoi de requêtes via le proxy :
Synchronisation des points de terminaison client et résolution de noms
Le proxy prend en charge l’enregistrement de ses points d’accès pour la découverte, en écrivant sur un point d’accès défini par l’utilisateur. Cela sert deux objectifs. Premièrement, cela permet aux clients de synchroniser leurs points d’accès avec un ensemble de points d’accès du proxy afin d’assurer une haute disponibilité. Deuxièmement, il agit comme un fournisseur de points d’accès pour etcd gRPC naming .
Inscrivez le ou les proxy en précisant un préfixe défini par l’utilisateur :
Le proxy répertoriera tous ses membres dans la liste des membres :
Cela permet aux clients de découvrir automatiquement les points d’accès du proxy via Sync :
Notez qu’en cas de configuration d’un proxy sans préfixe de résolveur,
L’API de liste des membres du grpc-proxy retourne son propre advertise-client-url :
Espace de noms
Supposons qu’une application exige un contrôle total sur l’ensemble de l’espace de clés, mais que le cluster etcd soit partagé avec d’autres applications. Pour permettre à toutes les applications de fonctionner sans se perturber mutuellement, le proxy peut partitionner l’espace de clés etcd de manière à ce que les clients perçoivent un accès à l’espace de clés complet. Lorsque le proxy reçoit le drapeau --namespace, toutes les requêtes clientes entrant dans le proxy sont traduites afin d’ajouter un préfixe défini par l’utilisateur aux clés. Les accès au cluster etcd se font sous ce préfixe, et les réponses du proxy suppriment ce préfixe ; pour le client, il semble qu’aucun préfixe n’existe.
Pour nommer un proxy, lancez-le avec --namespace :
Les accès au proxy sont désormais transparentement préfixés sur le cluster etcd :
Terminaison TLS
Met fin au TLS d’un cluster etcd sécurisé en utilisant le proxy gRPC en exposant un point d’accès local non chiffré.
Pour le tester, démarrez un cluster etcd à membre unique avec un client HTTPS :
Vérifiez que le port client est configuré pour servir HTTPS :
Ensuite, démarrez un proxy gRPC sur localhost:12379 en vous connectant au point d’extrémité etcd https://localhost:2379 à l’aide des certificats clients :
Enfin, testez la terminaison TLS en insérant une clé dans le proxy via http :
Métriques et état de santé
Le proxy gRPC expose les points de terminaison /health et Prometheus /metrics pour les membres etcd définis par --endpoints. Une alternative consiste à définir une URL supplémentaire qui répondra à la fois aux points de terminaison /metrics et /health avec le drapeau --metrics-addr.
Problème connu
L’interface principale du proxy sert à la fois HTTP2 et HTTP/1.1.. Si le proxy est configuré avec TLS comme indiqué dans l’exemple ci-dessus, l’utilisation d’un client tel que cURL contre l’interface d’écoute nécessite de définir explicitement le protocole à HTTP/1.1 dans la requête afin de retourner /metrics ou /health. En utilisant le drapeau --metrics-addr, l’interface secondaire n’aura pas cette exigence.
14.11 - Recommandations matérielles
etcd fonctionne généralement correctement avec des ressources limitées à des fins de développement ou de test ; il est courant de développer avec etcd sur un ordinateur portable ou une machine cloud peu coûteuse. Toutefois, lors de l’exécution de clusters etcd en production, certaines recommandations matérielles sont utiles pour une administration appropriée. Ces suggestions ne sont pas des règles strictes ; elles constituent un bon point de départ pour un déploiement productif robuste. Comme toujours, les déploiements doivent être testés avec des charges simulées avant d’être mis en production.
Processeurs
Peu de déploiements etcd nécessitent une grande capacité CPU. Les clusters typiques ont besoin de deux à quatre cœurs pour fonctionner correctement. Les déploiements etcd très chargés, qui servent des milliers de clients ou des dizaines de milliers de requêtes par seconde, sont généralement limités par la CPU, car etcd peut servir les requêtes depuis la mémoire. De tels déploiements nécessitent généralement huit à seize cœurs dédiés.
Mémoire
etcd présente une empreinte mémoire relativement faible, mais ses performances dépendent néanmoins d’une quantité suffisante de mémoire. Un serveur etcd met en cache de manière agressive les données clé-valeur et consacre la majeure partie de sa mémoire restante à la surveillance des observateurs. En général, 8 Go sont suffisants. Pour les déploiements intensifs comportant des milliers d’observateurs et des millions de clés, allouez entre 16 Go et 64 Go de mémoire selon les besoins.
Disques
Les disques rapides constituent le facteur le plus critique pour les performances et la stabilité du déploiement etcd.
Un disque lent augmentera la latence des requêtes etcd et pourrait compromettre la stabilité du cluster. Étant donné que le protocole de consensus d’etcd dépend du stockage persistant des métadonnées dans un journal, une majorité des membres du cluster etcd doit écrire chaque requête sur le disque. En outre, etcd effectue également des points de contrôle incrémentiels de son état sur le disque afin de tronquer ce journal. Si ces écritures prennent trop de temps, les battements de cœur pourraient expirer et déclencher une élection, ce qui affaiblit la stabilité du cluster. En général, pour déterminer si un disque est suffisamment rapide pour etcd, un outil de benchmark tel que fio peut être utilisé. Lisez ici pour un exemple.
etcd est très sensible à la latence d’écriture disque. Une capacité d’au moins 50 IOPS séquentielles (par exemple, un disque dur 7200 RPM) est généralement requise. Pour les clusters fortement sollicités, une capacité de 500 IOPS séquentielles (par exemple, un SSD local typique ou un périphérique de bloc virtuel à haute performance) est recommandée. Notez que la plupart des fournisseurs de cloud publient des IOPS concurrents plutôt que séquentiels ; les IOPS concurrents publiés peuvent être jusqu’à 10 fois supérieurs aux IOPS séquentiels. Pour mesurer les IOPS séquentiels réels, nous recommandons d’utiliser un outil de benchmark disque tel que diskbench ou fio .
etcd nécessite uniquement une bande passante disque modeste, mais une bande passante disque plus élevée permet des temps de récupération plus rapides lorsque membre défaillant doit rattraper le cluster. En général, 10MB/s peut récupérer 100 Mo de données en 15 secondes. Pour les clusters de grande taille, 100MB/s ou supérieur est recommandé pour récupérer 1 Go de données en 15 secondes.
Lorsqu’il est possible, sauvegardez le stockage d’etcd avec un SSD. Un SSD offre généralement des latences d’écriture plus faibles et une variation moindre qu’un disque dur rotatif, ce qui améliore la stabilité et la fiabilité d’etcd. Si vous utilisez un disque dur rotatif, choisissez les disques les plus rapides disponibles (15 000 tr/min). L’utilisation du RAID 0 est également une méthode efficace pour augmenter la vitesse du disque, que ce soit pour les disques rotatifs ou les SSD. Avec au moins trois membres dans le cluster, les variantes de RAID avec miroir et/ou parité sont inutiles ; la réplication cohérente d’etcd assure déjà une haute disponibilité.
Réseau
Les déploiements etcd à plusieurs membres bénéficient d’un réseau rapide et fiable. Afin que etcd soit à la fois cohérent et tolérant aux partitions, un réseau instable présentant des coupures de partition entraînera une disponibilité médiocre. Une faible latence garantit que les membres etcd peuvent communiquer rapidement. Un débit élevé permet de réduire le temps de récupération d’un membre etcd défaillant. Un réseau 1GbE est suffisant pour les déploiements courants de etcd. Pour les grands clusters etcd, un réseau 10GbE réduit le temps moyen de récupération.
Déployez les membres etcd au sein d’un même centre de données lorsque cela est possible, afin d’éviter les surcharges de latence et de réduire la probabilité d’événements de partitionnement. Si un domaine de défaillance dans un autre centre de données est nécessaire, choisissez un centre de données plus proche de celui déjà en place. Veuillez également consulter la documentation tuning pour plus d’informations sur le déploiement à travers des centres de données.
Exemples de configurations matériels
Voici quelques exemples de configurations matériels sur les environnements AWS et GCE. Comme mentionné précédemment, mais doit être souligné malgré tout, les administrateurs doivent tester un déploiement etcd avec une charge de travail simulée avant de le mettre en production.
Notez que ces configurations supposent que ces machines sont entièrement dédiées à etcd. Exécuter d’autres applications en parallèle sur ces machines peut entraîner des conflits de ressources et provoquer une instabilité du cluster.
Petit cluster
Un petit cluster gère moins de 100 clients, moins de 200 requêtes par seconde et stocke au plus 100 Mo de données.
Exemple de charge de travail d’application : un cluster Kubernetes à 50 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS concurrents max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56,25 |
| GCE | n1-standard-2 + 50Go PD SSD | 2 | 7,5 | 1500 | 25 |
Cluster de taille moyenne
Un cluster de taille moyenne prend en charge moins de 500 clients, moins de 1 000 requêtes par seconde et stocke au plus 500 Mo de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 250 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS concurrents max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93,75 |
| GCE | n1-standard-4 + 150Go PD SSD | 4 | 15 | 4500 | 75 |
Grand cluster
Un cluster important sert moins de 1 500 clients, moins de 10 000 requêtes par seconde, et stocke au plus 1 Go de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 1 000 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS simultanés max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250Go PD SSD | 8 | 30 | 7500 | 125 |
cluster xLarge
Un cluster xLarge prend en charge plus de 1 500 clients, plus de 10 000 requêtes par seconde et stocke plus de 1 Go de données.
Exemple de charge de travail d’application : un cluster Kubernetes de 3 000 nœuds
| Fournisseur | Type | vCPUs | Mémoire (Go) | IOPS simultanés max | Bande passante disque (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16 000 | 250 |
| GCE | n1-standard-16 + 500Go PD SSD | 16 | 60 | 15 000 | 250 |
14.12 - Maintenance
Aperçu
Un cluster etcd nécessite une maintenance périodique pour rester fiable. Selon les besoins d’une application etcd, cette maintenance peut généralement être automatisée et effectuée sans interruption de service ni dégradation significative des performances.
Toute maintenance etcd gère les ressources de stockage consommées par l’espace de clés etcd. Une gestion insuffisante de la taille de l’espace de clés est protégée par des quotas d’espace de stockage ; si un membre etcd manque d’espace, un quota déclenchera des alarmes à l’échelle du cluster, mettant le système en mode maintenance à opérations limitées. Pour éviter de manquer d’espace pour les écritures dans l’espace de clés, l’historique de l’espace de clés etcd doit être compacté. L’espace de stockage lui-même peut être récupéré en défragmentant les membres etcd. Enfin, des sauvegardes périodiques d’instantanés de l’état des membres etcd permettent de récupérer toute perte logique de données ou corruption involontaire causée par une erreur opérationnelle.
Rétention du journal Raft
etcd --snapshot-count définit le nombre d’entrées Raft appliquées à conserver en mémoire avant le compactage. Lorsque --snapshot-count est atteint, le serveur persiste d’abord les données d’instantané sur le disque, puis tronque les anciennes entrées. Lorsqu’un suiveur lent demande des journaux antérieurs à un index compacté, le leader envoie un instantané, forçant ainsi le suiveur à écraser son état.
Une valeur plus élevée de --snapshot-count conserve davantage d’entrées Raft en mémoire jusqu’à l’instantané, entraînant ainsi une utilisation mémoire accrue et récurrente
. Comme le leader conserve les dernières entrées Raft plus longtemps, un suiveur lent dispose de plus de temps pour se synchroniser avant que le leader ne prenne un instantané. --snapshot-count représente un compromis entre une utilisation mémoire plus élevée et une meilleure disponibilité des suiveurs lents.
Depuis la version 3.2, la valeur par défaut de --snapshot-count a passé de 10 000 à 100 000
.
Sur le plan des performances, un nombre supérieur à 100 000 pour --snapshot-count peut affecter le débit d’écriture. Un plus grand nombre d’objets en mémoire peut ralentir la phase de marquage du ramasse-miettes de runtime.scanobject
, et une récupération mémoire peu fréquente rend l’allocation plus lente. Les performances varient selon les charges de travail et les environnements système. Toutefois, en général, un compactage trop fréquent affecte la disponibilité du cluster et le débit d’écriture. Un compactage trop rare est également préjudiciable, car il exerce une pression excessive sur le ramasse-miettes Go. Voir Comprendre les aspects de performance d’etcd et de Raft
pour plus de résultats de recherche.
Compactage de l’historique : base de données clé-valeur API v3
Depuis que etcd conserve une historique exacte de son espace de clés, cette historique doit être régulièrement compactée afin d’éviter une dégradation des performances et une épuisement éventuel de l’espace de stockage. La compactation de l’historique de l’espace de clés supprime toutes les informations relatives aux clés remplacées avant une révision donnée de l’espace de clés. L’espace utilisé par ces clés devient alors disponible pour de nouvelles écritures dans l’espace de clés.
L’espace de clés peut être compacté automatiquement selon la politique de rétention des historiques à fenêtre temporelle de etcd, ou manuellement via etcdctl. La méthode etcdctl offre un contrôle fin du processus de compactage, tandis que la compactage automatique convient aux applications qui nécessitent l’historique des clés pendant une durée déterminée.
Un compactage initié par etcdctl fonctionne comme suit :
Les révisions antérieures à la révision de compactage deviennent inaccessibles :
Compaction automatique
etcd peut être défini pour effectuer automatiquement le compactage de l’espace de clés à l’aide des options --auto-compaction-mode et --auto-compaction-retention. Deux modes de compactage sont disponibles : periodic (par défaut) et revision.
Compactage périodique
Le compactage périodique conserve une fenêtre temporelle de l’historique de l’espace de clés :
La valeur de rétention précise la quantité d’historique à conserver. Un enregistrement ne sera pas compacté avant environ cette durée écoulée depuis sa création. Cela garantit que les observateurs lents peuvent encore rattraper leur retard dans la fenêtre de rétention.
Lorsque la période de rétention est supérieure à 1 heure, etcd effectue une compaction toutes les heures tout en maintenant la fenêtre complète de rétention. Lorsque la période de rétention est égale ou inférieure à 1 heure, etcd effectue une compaction à intervalle égal à la période de rétention.
Par exemple, avec --auto-compaction-retention=10h, etcd attend 10 heures pour le premier compactage, puis compacte toutes les heures par la suite :
Les valeurs recommandées dépendent du cas d’utilisation :
- Mises à jour fréquentes des mêmes clés : une période courte, telle que
1hou30m - Mises à jour peu fréquentes : une période plus longue, telle que
24h,48h, ou72h - Valeur par défaut générale :
10h
Compactage de révision
Le compactage par révision conserve un nombre fixe de révisions :
etcd vérifie toutes les 5 minutes et effectue une compaction sur "latest revision" - 1000. Par exemple, lorsque la dernière révision est 30000, elle effectue une compaction à la révision 29000.
défragmentation
Après avoir compacté l’espace de clés, la base de données backend peut présenter une fragmentation interne. Toute fragmentation interne correspond à de l’espace libre pour la base de données backend mais qui continue de consommer de l’espace de stockage. La compactation des anciennes révisions fragmente internement etcd en laissant des espaces vides dans la base de données backend. L’espace fragmenté est disponible pour etcd mais non disponible pour le système de fichiers hôte. Autrement dit, la suppression des données d’application ne libère pas l’espace sur le disque.
Le processus de défragmentation libère cet espace de stockage au système de fichiers. La défragmentation est effectuée au niveau du membre, afin d’éviter des pics de latence affectant l’ensemble du cluster.
Pour défragmenter un membre etcd, utilisez la commande etcdctl defrag :
Notez que la défragmentation d’un membre en cours d’exécution bloque le système en lecture et écriture pendant la reconstruction de ses états
Notez que la demande de défragmentation n’est pas répliquée au sein du cluster. Autrement dit, la demande n’est appliquée qu’au nœud local. Spécifiez tous les membres dans l’option --endpoints ou l’option --cluster pour trouver automatiquement tous les membres du cluster.
Exécutez les opérations de défragmentation pour tous les points d’accès du cluster associé au point d’accès par défaut :
Pour défragmenter directement un répertoire de données etcd lorsque etcd n’est pas en cours d’exécution, utilisez la commande :
Quota d’espace
La quota d’espace dans etcd garantit un fonctionnement fiable du cluster. Sans quota d’espace, etcd peut connaître des performances médiocres si l’espace de clés devient trop volumineux, ou simplement manquer d’espace de stockage, entraînant un comportement imprévisible du cluster. Si la base de données backend de l’espace de clés de tout membre dépasse la quota d’espace, etcd déclenche une alarme à l’échelle du cluster, qui met le cluster en mode maintenance, acceptant uniquement les lectures et suppressions de clés. Le cluster ne peut reprendre un fonctionnement normal qu’après avoir libéré suffisamment d’espace dans l’espace de clés, défragmenté la base de données backend et effacé l’alarme de quota d’espace.
Par défaut, etcd définit une quota d’espace conservateur adapté à la plupart des applications, mais il peut être configuré en ligne de commande, en octets :
La quota d’espace peut être déclenchée par une boucle :
Supprimer les données d’espace de clés excessives et défragmenter la base de données du backend ramènera le cluster dans les limites du quota :
La métrique etcd_mvcc_db_total_size_in_use_in_bytes indique l’utilisation réelle de la base de données après un compactage de l’historique, tandis que etcd_debugging_mvcc_db_total_size_in_bytes affiche la taille de la base de données incluant l’espace libre en attente de défragmentation. Cette dernière n’augmente que lorsque la première est proche d’elle, ce qui signifie qu’une fois que ces deux métriques sont proches du quota, un compactage de l’historique est nécessaire pour éviter de déclencher la limite d’espace.
etcd_debugging_mvcc_db_total_size_in_bytes est renommé en etcd_mvcc_db_total_size_in_bytes à compter de la version 3.4.
Il est possible de recevoir une erreur ErrGRPCNoSpace pour une requête Put/Txn/LeaseGrant, tout en voyant la requête d’écriture réussir en arrière-plan, car etcd vérifie la limite d’espace à la couche API et à la couche Apply, et la couche Apply ne lèvera que l’alarme NOSPACE sans bloquer la transaction.
Sauvegarde d’instantané
Effectuer des instantanés du cluster etcd de manière régulière constitue une sauvegarde durable pour un espace de clés etcd. En prenant des instantanés périodiques de la base de données backend d’un membre etcd, un cluster etcd peut être restauré à un instant donné dans un état connu comme étant valide.
Un instantané est pris avec etcdctl :
14.13 - Surveillance d’etcd
Chaque serveur etcd fournit des informations de surveillance locales sur son port client via des points de terminaison HTTP. Les données de surveillance sont utiles à la fois pour le contrôle de santé du système et le débogage du cluster.
Point d’entrée de débogage
Si --log-level=debug est défini, le serveur etcd exporte des informations de débogage sur son port client sous le chemin /debug. Prenez garde à la définition de --log-level=debug, car cela entraînera une dégradation des performances et une journalisation verbose.
Le point de terminaison /debug/pprof est le point de terminaison standard de profilage du runtime Go. Il peut être utilisé pour profiler l’utilisation du processeur, de la mémoire, des verrous et des goroutines. Par exemple, voici comment obtenir les 10 fonctions où etcd consacre le plus de temps :
go tool pprof
Le point de terminaison /debug/requests permet d’obtenir des traces gRPC et des statistiques de performance via un navigateur web. Par exemple, voici une requête Range pour la clé abc :
Point d’extrémité des métriques
Chaque serveur etcd exporte des métriques sous le chemin /metrics sur son port client, et éventuellement sur les emplacements indiqués par --listen-metrics-urls.
Les métriques peuvent être récupérées avec curl :
Vérification de santé
Depuis la version 3.3.0, outre la réponse à l’endpoint /metrics, toutes les localisations spécifiées par --listen-metrics-urls répondent également à l’endpoint /health. Cela peut être utile si l’endpoint standard est configuré avec une authentification TLS mutuelle (client), mais qu’un équilibreur de charge ou un service de surveillance doit tout de même accéder à la vérification de santé.
Depuis la version 3.4, deux nouveaux points d’entrée /livez et /readyz ont été ajoutés.
- le point de terminaison
/livezindique si le processus est actif ou s’il nécessite un redémarrage. - le point de terminaison
/readyzindique si le processus est prêt à servir le trafic.
Les détails de conception des points de terminaison sont documentés dans le KEP .
Chaque point de terminaison inclut plusieurs vérifications de santé individuelles, et vous pouvez utiliser le paramètre verbose pour afficher les détails des vérifications et leur état, par exemple
et vous verriez une réponse similaire à
L’API HTTP prend également en charge l’exclusion de vérifications spécifiques, par exemple
Prometheus
Exécuter un service de surveillance Prometheus est la méthode la plus simple pour ingérer et enregistrer les métriques d’etcd.
Tout d’abord, installez Prometheus :
Configurez l’extracteur Prometheus pour cibler les points d’accès du cluster etcd :
Configurez le gestionnaire Prometheus :
Prometheus récupérera désormais les métriques etcd toutes les 10 secondes.
Alerting
Il existe un ensemble d’alertes par défaut pour les clusters etcd v3 destinées à Prometheus .
Notez que les étiquettes job peuvent nécessiter un ajustement pour répondre à un besoin particulier. Les règles ont été rédigées pour s’appliquer à un seul cluster, il est donc recommandé de choisir des étiquettes uniques par cluster.
Grafana
Grafana dispose d’un support intégré pour Prometheus ; ajoutez simplement une source de données Prometheus :
Ensuite, importez le modèle de tableau de bord par défaut etcd dashboard template
et personnalisez-le. Par exemple, si le nom de la source de données Prometheus est my-etcd, les valeurs du champ datasource dans le JSON doivent également être my-etcd.
Tableau de bord d’exemple :
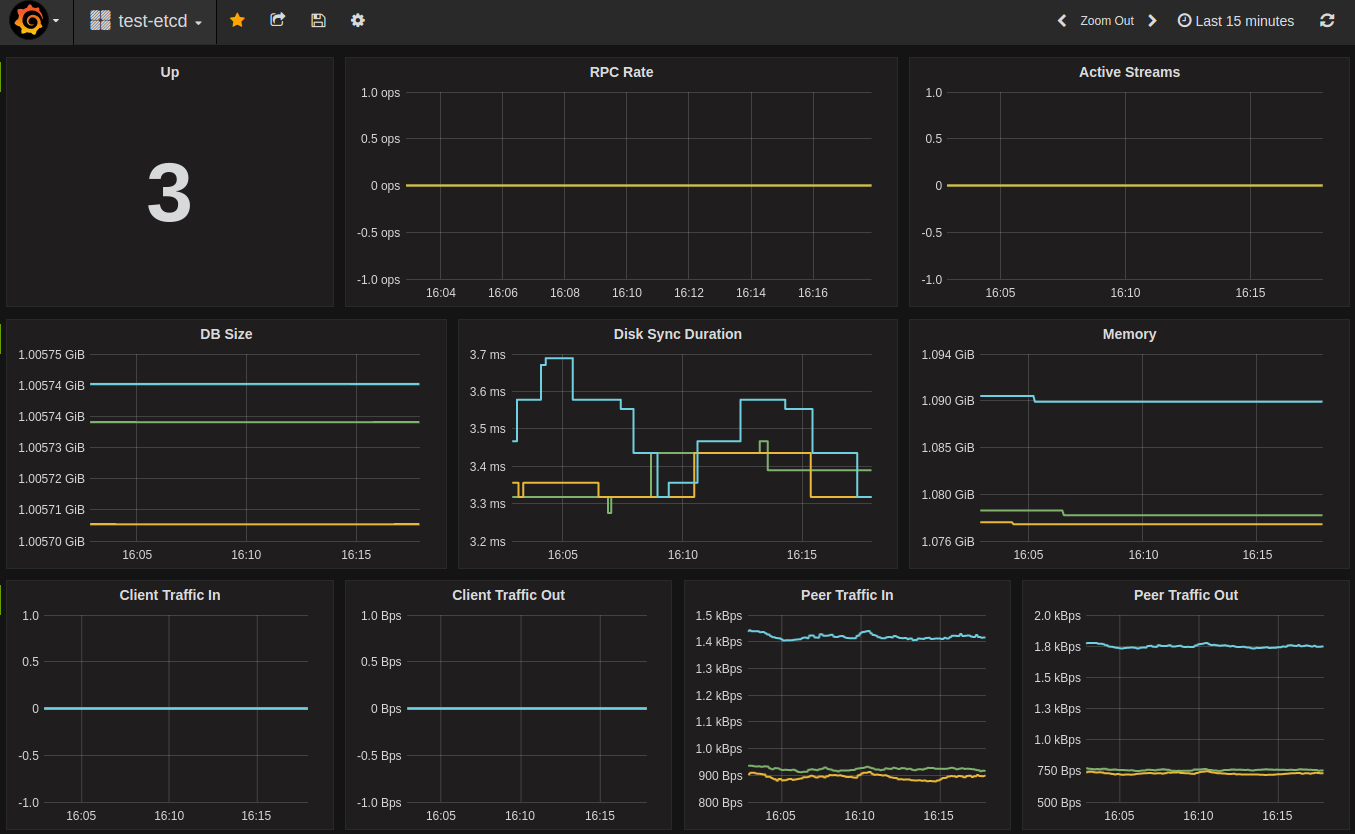
Traçage distribué
À partir de la version 3.5, etcd prend en charge le traçage distribué à l’aide de OpenTelemetry .
Cette fonctionnalité est encore expérimentale et peut être modifiée à tout moment.
Pour activer cette fonctionnalité expérimentale, passez le paramètre --experimental-enable-distributed-tracing=true au serveur etcd, ainsi que le drapeau --experimental-distributed-tracing-sampling-rate=<number> pour choisir le nombre d’échantillons à collecter par million de spans ; le taux d’échantillonnage par défaut est 0.
Configurez le traçage distribué en lançant le serveur etcd avec les indicateurs facultatifs suivants :
--experimental-distributed-tracing-address- (Facultatif) - « localhost:4317 » - Adresse du collecteur de traçage.--experimental-distributed-tracing-service-name- (Facultatif) - « etcd » - Nom du service de traçage distribué, doit être identique sur toutes les instances etcd.--experimental-distributed-tracing-instance-id- (Facultatif) - Identifiant d’instance ; bien qu’optionnel, il est fortement recommandé de le définir, et doit être unique par instance etcd.
Avant d’activer le traçage distribué, assurez-vous d’avoir un point de terminaison OpenTelemetry. Si cette adresse diffère de la valeur par défaut, remplacez-la à l’aide du drapeau --experimental-distributed-tracing-address. En raison des différentes manières de faire fonctionner OpenTelemetry, consultez la documentation du collector
pour en savoir plus.
Un surcroît de charge ressource existe, comme pour tout signal d’observabilité ; selon nos mesures initiales, cette surcharge pourrait s’élever entre 2 % et 4 % de la charge CPU.
14.14 - Performances
Comprendre les performances
etcd offre des performances stables et élevées de manière soutenue. Deux facteurs définissent les performances : la latence et le débit. La latence correspond au temps nécessaire pour accomplir une opération. Le débit correspond au nombre total d’opérations effectuées durant une période donnée. En général, la latence moyenne augmente lorsque le débit global augmente, lorsque etcd accepte des requêtes clientes concurrentes. Dans des environnements cloud courants, comme une instance standard n-4 sur Google Compute Engine (GCE) ou un type de machine équivalent sur AWS, un cluster etcd composé de trois membres exécute une requête en moins d’une milliseconde en charge légère, et peut traiter plus de 30 000 requêtes par seconde en charge lourde.
etcd utilise l’algorithme de consensus Raft pour répliquer les requêtes entre les membres et parvenir à un accord. Les performances du consensus, en particulier la latence de validation, sont limitées par deux contraintes physiques : la latence d’E/S réseau et la latence d’E/S disque. Le temps minimal pour finaliser une requête etcd correspond au temps de trajet aller-retour (RTT) réseau entre les membres, plus le temps que fdatasync met à valider les données dans un stockage permanent. Le RTT au sein d’un centre de données peut atteindre plusieurs centaines de microsecondes. Un RTT typique aux États-Unis est d’environ 50 ms, et peut s’élever à 400 ms entre les continents. La latence typique de fdatasync pour un disque rotatif est d’environ 10 ms. Pour les SSD, la latence est souvent inférieure à 1 ms. Pour améliorer le débit, etcd regroupe plusieurs requêtes ensemble et les soumet à Raft. Cette politique de regroupement permet à etcd d’atteindre un haut débit même sous une charge importante.
D’autres sous-systèmes influencent les performances globales d’etcd. Chaque requête etcd sérialisée doit passer par le moteur de stockage MVCC basé sur boltdb, ce qui prend généralement quelques dizaines de microsecondes. de manière périodique, etcd effectue un instantané incrémental de ses requêtes récemment appliquées, qu’il fusionne avec l’instantané précédent sur disque. Ce processus peut entraîner une pointe de latence. Bien que cela ne pose généralement pas de problème sur les SSD, cela peut doubler la latence observée sur les disques durs. De même, les compactages en cours peuvent affecter les performances d’etcd. Heureusement, l’impact est souvent négligeable, car le compactage est progressif, évitant ainsi toute concurrence pour les ressources avec les requêtes régulières. Le système RPC, gRPC, fournit à etcd une API bien définie et extensible, mais introduit également une latence supplémentaire, notamment pour les lectures locales.
Benchmarks
Le benchmark de la performance d’etcd peut être effectué à l’aide de l’outil en ligne de commande benchmark fourni avec etcd.
Pour des mesures de performance de base, nous considérons un cluster etcd composé de trois membres avec la configuration matérielle suivante :
- Google Cloud Compute Engine
- 3 machines de 8 vCPU + 16 Go de mémoire + 50 Go de SSD
- 1 machine (client) de 16 vCPU + 30 Go de mémoire + 50 Go de SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
Avec cette configuration, etcd peut écrire approximativement :
| Nombre de clés | Taille de la clé en octets | Taille de la valeur en octets | Nombre de connexions | Nombre de clients | Serveur etcd cible | Débit d’écriture moyen (QPS) | Latence moyenne par requête | RSS moyen du serveur |
|---|---|---|---|---|---|---|---|---|
| 10 000 | 8 | 256 | 1 | 1 | leader uniquement | 583 | 1,6 ms | 48 Mo |
| 100 000 | 8 | 256 | 100 | 1 000 | leader uniquement | 44 341 | 22 ms | 124 Mo |
| 100 000 | 8 | 256 | 100 | 1 000 | tous les membres | 50 104 | 20 ms | 126 Mo |
Commandes d’exemple :
Les requêtes de lecture linéarisable passent par un quorum de membres du cluster pour atteindre un consensus afin d’obtenir les données les plus récentes. Les requêtes de lecture sérialisable sont moins coûteuses que les lectures linéarisables, car elles sont servies par n’importe quel membre etcd unique, plutôt que par un quorum de membres, au prix d’une possible lecture de données obsolètes. etcd peut effectuer des lectures :
| Nombre de requêtes | Taille de la clé en octets | Taille de la valeur en octets | Nombre de connexions | Nombre de clients | Cohérence | Débit moyen en lectures (QPS) | Latence moyenne par requête |
|---|---|---|---|---|---|---|---|
| 10 000 | 8 | 256 | 1 | 1 | Linéarisable | 1 353 | 0,7 ms |
| 10 000 | 8 | 256 | 1 | 1 | Sériealisable | 2 909 | 0,3 ms |
| 100 000 | 8 | 256 | 100 | 1 000 | Linéarisable | 141 578 | 5,5 ms |
| 100 000 | 8 | 256 | 100 | 1 000 | Sériealisable | 185 758 | 2,2 ms |
Commandes d’exemple :
Nous recommandons d’exécuter le test de charge lors de la mise en place d’un cluster etcd pour la première fois dans un nouvel environnement afin de vérifier que le cluster atteint des performances adéquates ; la latence du cluster et le débit peuvent être sensibles aux légères différences d’environnement.
14.15 - Conception de la reconfiguration à l'exécution
La reconfiguration à l’exécution est l’une des fonctionnalités les plus complexes et sujettes aux erreurs dans un système distribué, en particulier dans un système fondé sur le consensus comme etcd.
Lisez la suite pour en savoir plus sur la conception des commandes de reconfiguration en cours d’exécution d’etcd et sur la manière dont nous avons résolu ces problèmes.
Les modifications de configuration en deux phases maintiennent le cluster en sécurité
Dans etcd, toute reconfiguration en cours d’exécution doit suivre deux phases pour des raisons de sécurité. Par exemple, pour ajouter un membre, il faut d’abord informer le cluster de la nouvelle configuration, puis démarrer le nouveau membre.
Phase 1 - Informer le cluster de la nouvelle configuration
Pour ajouter un membre à un cluster etcd, effectuez un appel d’API afin de demander l’ajout d’un nouveau membre au cluster. C’est la seule méthode permettant d’ajouter un nouveau membre à un cluster existant. L’appel d’API se termine lorsque le cluster a accepté le changement de configuration.
Phase 2 - Démarrer un nouveau membre
Pour rejoindre le nouveau membre etcd au cluster existant, précisez le bon initial-cluster et définissez initial-cluster-state sur existing. Lorsque le membre démarre, il contacte d’abord le cluster existant et vérifie que la configuration actuelle du cluster correspond à celle attendue spécifiée dans initial-cluster. Lorsque le nouveau membre démarre correctement, le cluster atteint la configuration attendue.
En divisant le processus en deux phases distinctes, les utilisateurs sont obligés de préciser explicitement les modifications apportées au membre du cluster. Cela accorde en réalité plus de flexibilité aux utilisateurs et simplifie la compréhension du comportement. Par exemple, si une tentative est faite d’ajouter un nouveau membre ayant le même ID qu’un membre existant dans un cluster etcd, l’action échoue immédiatement lors de la première phase, sans affecter le cluster en cours d’exécution. Une protection similaire est mise en place pour empêcher l’ajout accidentel de nouveaux membres. Si un nouveau membre etcd tente de rejoindre le cluster avant que le cluster n’ait accepté le changement de configuration, il ne sera pas accepté par le cluster.
Sans le workflow explicite concernant l’appartenance au cluster, etcd serait vulnérable aux modifications imprévues de l’appartenance au cluster. Par exemple, si etcd est exécuté sous un système d’initialisation tel que systemd, il serait redémarré après avoir été supprimé via l’API d’appartenance, puis tenterait de se réjoindre au cluster au démarrage. Ce cycle se reproduirait chaque fois qu’un membre est supprimé via l’API et que systemd est configuré pour redémarrer etcd après un échec, ce qui est inattendu.
Nous considérons que la reconfiguration à l’exécution doit être une opération rare. Nous avons choisi de la rendre explicite et pilotée par l’utilisateur afin d’assurer la sécurité de la configuration et de maintenir le cluster toujours en fonctionnement sans heurt, sous un contrôle explicite.
Perte permanente du quorum nécessite un nouveau cluster
Si un cluster perd définitivement la majorité de ses membres, un nouveau cluster devra être lancé à partir d’un répertoire de données ancien afin de restaurer l’état précédent.
Il est tout à fait possible de forcer la suppression des membres défaillants du cluster existant afin de procéder à une récupération. Toutefois, nous avons choisi de ne pas prendre en charge cette méthode, car elle contourne la phase normale de validation du consensus, ce qui est dangereux. Si le membre à supprimer n’est pas réellement défaillant ou n’a pas été supprimé de manière forcée par d’autres membres du même cluster, etcd se retrouvera avec un cluster divergent présentant le même clusterID. Cela constitue un risque très important et difficile à debug/fix par la suite.
Avec un déploiement correct, la probabilité de perte définitive de la majorité est très faible. Mais il s’agit d’un problème suffisamment grave pour mériter une attention particulière. Nous recommandons vivement de lire la documentation de récupération après sinistre et de préparer une stratégie de récupération face à une perte définitive de la majorité avant de mettre etcd en production.
N’utilisez pas de service de découverte publique pour la reconfiguration en cours d’exécution
Le service de découverte publique ne doit être utilisé que pour amorcer un cluster. Pour ajouter un membre à un cluster existant, utilisez l’API de reconfiguration en temps d’exécution.
Le service de découverte est conçu pour amorcer un cluster etcd dans un environnement cloud, lorsque les adresses IP de tous les membres ne sont pas connues à l’avance. Une fois le cluster amorcé avec succès, les adresses IP de tous les membres sont connues. Techniquement, le service de découverte ne devrait plus être nécessaire.
Il semble que l’utilisation du service de découverte public soit un moyen pratique de procéder à une reconfiguration en cours d’exécution, puisque le service de découverte possède déjà toutes les informations de configuration du cluster. Toutefois, compter sur le service de découverte public entraîne des difficultés :
introduit des dépendances externes pour l’ensemble du cycle de vie du cluster, et non seulement au moment du démarrage. En cas de problème de réseau entre le cluster et le service de découverte publique, le cluster en sera affecté.
Le service de découverte public doit refléter la configuration d’exécution correcte du cluster tout au long de son cycle de vie. Il doit proposer des mécanismes de sécurité pour éviter les actions non autorisées, ce qui est difficile.
Le service de découverte public doit gérer des dizaines de milliers de configurations de cluster. Le backend de notre service de découverte public n’est pas prêt à supporter cette charge.
Pour disposer d’un service de découverte qui prend en charge la reconfiguration en temps réel, le meilleur choix est de mettre en place le vôtre en interne.
14.16 - Reconfiguration en cours d'exécution
etcd dispose d’un support pour la reconfiguration incrémentielle en temps d’exécution, ce qui permet aux utilisateurs de mettre à jour la composition du cluster en cours d’exécution.
Les requêtes de reconfiguration ne peuvent être traitées que lorsque la majorité des membres du cluster sont fonctionnels. Il est fortement recommandé de toujours disposer d’un cluster de taille supérieure à deux en production. Il est dangereux de supprimer un membre d’un cluster à deux membres. La majorité d’un cluster à deux membres est également de deux. En cas d’échec pendant le processus de suppression, le cluster pourrait ne pas être en mesure de progresser et nécessiterait un redémarrage suite à une défaillance de la majorité .
Pour mieux comprendre la conception sous-jacente à la reconfiguration en temps réel, veuillez lire le document de reconfiguration en temps réel .
Cas d’utilisation de la reconfiguration
Cette section explique certaines raisons courantes de reconfiguration d’un cluster. La plupart de ces raisons consistent simplement en des combinaisons d’ajout ou de suppression d’un membre, telles qu’expliquées ci-dessous sous Opérations de reconfiguration du cluster .
Mise à jour ou mise à niveau de plusieurs machines
Si plusieurs membres d’un cluster doivent être déplacés en raison d’une maintenance planifiée (mise à jour matérielle, coupure réseau, etc.), il est recommandé de modifier les membres un par un.
Il est sûr de supprimer le leader, mais un bref temps d’indisponibilité survient pendant le processus d’élection. Si le cluster contient plus de 50 Mo de données v2, il est recommandé de migrer le répertoire de données du membre .
Modifier la taille du cluster
L’augmentation de la taille du cluster peut améliorer la tolérance aux pannes et les performances de lecture. Comme les clients peuvent lire depuis n’importe quel membre, l’augmentation du nombre de membres accroît le débit global des lectures sérialisées.
Réduire la taille du cluster peut améliorer les performances d’écriture du cluster, au prix d’une résilience réduite. Les écritures dans le cluster sont répliquées sur la majorité des membres avant d’être considérées comme validées. Réduire la taille du cluster diminue la taille de la majorité, et chaque écriture est ainsi validée plus rapidement.
Remplacer une machine défaillante
Si une machine tombe en panne à cause d’une défaillance matérielle, d’une corruption du répertoire de données ou d’une autre situation critique, elle doit être remplacée dès que possible. Les machines ayant cessé de fonctionner sans avoir été retirées affectent négativement le quorum et réduisent la tolérance à une défaillance supplémentaire.
Pour remplacer la machine, suivez les instructions pour supprimer le membre du cluster, puis ajouter un nouveau membre à sa place. Si le cluster contient plus de 50 Mo, il est recommandé de migrer le répertoire de données du membre défaillant s’il est toujours accessible.
Redémarrer le cluster après une défaillance majoritaire
Si la majorité du cluster est perdue ou si tous les nœuds ont changé d’adresse IP, une intervention manuelle est nécessaire pour effectuer une récupération en toute sécurité. Les étapes fondamentales du processus de récupération consistent à créer un nouveau cluster à partir des anciennes données , forcer un seul membre à agir en tant que leader, puis utiliser la configuration en temps réel pour ajouter les nouveaux membres à ce nouveau cluster un par un.
Récupérer un cluster suite à une défaillance de la majorité
Si un membre spécifique est perdu, cela revient à remplacer une machine défaillante. Les étapes sont décrites dans Remplacer une machine défaillante .
Opérations de reconfiguration du cluster
Étant donné ces cas d’utilisation, les opérations concernées peuvent être décrites pour chacune.
Avant toute modification, une majorité simple (quorum) des membres etcd doit être disponible. Il s’agit essentiellement de la même exigence que pour toute écriture dans etcd.
Toutes les modifications apportées au cluster doivent être effectuées séquentiellement :
- Pour mettre à jour les peerURLs d’un seul membre, effectuez une opération de mise à jour
- Pour remplacer un membre sain, supprimez l’ancien membre puis ajoutez un nouveau membre
- Pour passer de 3 à 5 membres, effectuez deux opérations d’ajout
- Pour passer de 5 à 3 membres, effectuez deux opérations de suppression
Tous ces exemples utilisent l’outil en ligne de commande etcdctl fourni avec etcd. Pour modifier l’appartenance sans etcdctl, utilisez l’API membres HTTP v2
ou l’API membres gRPC v3
.
Mettre à jour un membre
Mettre à jour les URL client d’annonce
Pour mettre à jour les URL d’annonce client d’un membre, redémarrez simplement ce membre en spécifiant les URL client mises à jour via le drapeau (--advertise-client-urls) ou la variable d’environnement (ETCD_ADVERTISE_CLIENT_URLS). Le membre redémarré publiera automatiquement les URL mises à jour. Une URL client incorrectement mise à jour n’affecte pas la santé du cluster etcd.
Mettre à jour les URL d’annonce des pairs
Pour mettre à jour les URL d’annonce des pairs d’un membre, mettez à jour explicitement celles-ci à l’aide de la commande member, puis redémarrez le membre. Cette action supplémentaire est nécessaire car la mise à jour des URL de pair modifie la configuration globale du cluster et peut affecter l’intégrité du cluster etcd.
Pour mettre à jour les URL d’annonce du pair, commencez par trouver l’ID du membre cible. Pour lister tous les membres avec etcdctl :
Cet exemple va update l’identifiant de membre a8266ecf031671f3 et modifier sa valeur peerURLs en http://10.0.1.10:2380 :
Supprimer un membre
Supposons que l’ID du membre à supprimer soit a8266ecf031671f3. Utilisez la commande remove pour effectuer la suppression :
Le membre cible s’arrête lui-même à ce stade et imprime la suppression dans le journal :
Il est sûr de supprimer le leader, mais le cluster sera inactif pendant la période nécessaire à l’élection d’un nouveau leader. Cette durée correspond normalement au délai d’élection plus la durée du processus de vote.
Ajouter un nouveau membre
Ajouter un membre est un processus en deux étapes :
- Ajoutez le nouveau membre au cluster au moyen de l’API HTTP des membres
, de l’API gRPC des membres
ou de la commande
etcdctl member add. - Démarrez le nouveau membre avec la nouvelle configuration du cluster, y compris la liste actualisée des membres (membres existants + nouveau membre).
etcdctl ajoute un nouveau membre au cluster en spécifiant le nom
du membre et les URL de pair annoncés
:
etcdctl a informé le cluster du nouveau membre et a affiché les variables d’environnement nécessaires pour le démarrer correctement. Désormais, lancez le processus etcd nouveau avec les drapeaux appropriés pour le nouveau membre :
Le nouveau membre s’exécutera en tant que partie du cluster et commencera immédiatement à se synchroniser avec le reste du cluster.
Lorsque vous ajoutez plusieurs membres, la meilleure pratique consiste à configurer un seul membre à la fois et à vérifier qu’il démarre correctement avant d’ajouter de nouveaux membres. Si vous ajoutez un nouveau membre à un cluster à un seul nœud, le cluster ne peut pas progresser avant que le nouveau membre ne démarre, car il faut deux membres pour atteindre la majorité nécessaire à l’atteinte du consensus. Ce comportement ne se produit que durant la période où etcdctl member add informe le cluster du nouveau membre et où ce dernier établit avec succès une connexion au membre existant.
Ajouter un nouveau membre apprenant
À partir de la version v3.4, etcd prend en charge l’ajout d’un nouveau membre en tant que membre apprenant / membre non votant. La motivation et la conception sont décrites dans le document design doc . Afin de rendre le processus d’ajout d’un nouveau membre plus sûr, et de réduire la durée d’indisponibilité du cluster lors de l’ajout du nouveau membre, il est recommandé de faire rejoindre le nouveau membre au cluster en tant que membre apprenant jusqu’à ce qu’il soit à jour. Ce processus peut être décrit comme une séquence en trois étapes :
Ajoutez le nouveau membre comme apprenant au moyen de l’API gRPC des membres ou de la commande
etcdctl member add --learner.Démarrez le nouveau membre avec la configuration mise à jour du cluster, incluant la liste des membres mis à jour (membres existants + le nouveau membre). Cette étape est identique à celle précédente.
Promouvoir le membre apprenant nouvellement ajouté en membre votant via l’API gRPC members ou la commande
etcdctl member promote. Le serveur etcd valide la requête de promotion afin d’assurer sa sécurité opérationnelle. Un membre apprenant ne peut être promu en membre votant qu’après avoir rattrapé le journal Raft du leader. Si un membre apprenant n’a pas encore rattrapé le journal Raft du leader, la requête de promotion échoue (voir la section [cas d’erreur lors de la promotion d’un membre] pour plus de détails). Dans ce cas, l’utilisateur doit attendre puis réessayer ultérieurement.
Dans la version 3.4, le serveur etcd limite le nombre de membres apprenants qu’un cluster peut avoir à un seul. La principale considération est de limiter la charge supplémentaire imposée au leader en raison de la propagation des données du leader vers le membre apprenant.
Utilisez etcdctl member add avec le drapeau --learner pour ajouter un nouveau membre au cluster en tant que membre apprenant.
Après avoir lancé le nouveau processus etcd pour le membre apprenant nouvellement ajouté, utilisez etcdctl member promote pour promouvoir le membre apprenant en membre ayant voix délibérative.
Cas d’erreur lors de l’ajout de membres
Dans le cas suivant, un nouvel hôte n’est pas inclus dans la liste des nœuds énumérés. Si c’est un nouveau cluster, le nœud doit être ajouté à la liste des membres initiaux du cluster.
Dans ce cas, indiquez une adresse différente (10.0.1.14:2380) de celle utilisée pour rejoindre le cluster (10.0.1.13:2380) :
Si etcd démarre en utilisant le répertoire de données d’un membre supprimé, etcd s’arrête automatiquement s’il se connecte à tout membre actif du cluster :
Cas d’erreur lors de l’ajout d’un membre apprenant
Impossible d’ajouter un membre apprenant à un cluster si celui-ci possède déjà 1 membre apprenant (v3.4).
Cas d’erreur lors de la promotion d’un membre apprenant
Un membre apprenant ne peut être promu en membre votant que s’il est synchronisé avec le leader.
Promouvoir un membre qui n’est pas un membre apprenant échouera.
Promouvoir un membre qui n’existe pas dans le cluster échouera.
Mode de vérification stricte de la configuration (-strict-reconfig-check)
Comme indiqué ci-dessus, la meilleure pratique pour ajouter de nouveaux membres consiste à configurer un seul membre à la fois et à vérifier qu’il démarre correctement avant d’ajouter d’autres nouveaux membres. Cette approche progressive est très importante, car si les nouveaux membres ne sont pas correctement configurés (par exemple, si les URL de pair sont incorrectes), le cluster peut perdre son quorum. La perte de quorum se produit car les nouveaux membres sont pris en compte dans le quorum, même s’ils ne sont pas accessibles depuis les autres membres existants. Une perte de quorum peut également survenir en cas de problème de connectivité ou de problème opérationnel.
Pour éviter ce problème, etcd met à disposition une option -strict-reconfig-check. Si cette option est passée à etcd, celui-ci rejette les demandes de reconfiguration lorsque le nombre de membres démarrés sera inférieur à un quorum du cluster reconfiguré.
Activé par défaut.
14.17 - Plateformes prises en charge
Support tiers
etcd s’exécute sur différentes plates-formes, mais les garanties qu’il fournit dépendent du niveau de prise en charge de la plate-forme :
- Niveau 1 : entièrement pris en charge par les mainteneurs [etcd][] ; etcd est garanti pour passer tous les tests, y compris les tests fonctionnels et de robustesse.
- Niveau 2 : etcd est garanti pour passer les tests d’intégration et les tests bout en bout, mais pas nécessairement les tests fonctionnels ou de robustesse.
- Niveau 3 : etcd est garanti pour être compilé, peut être légèrement testé (ou non), et doit donc être considéré comme instable.
Prise en charge actuelle
Le tableau suivant répertorie les plateformes actuellement prises en charge ainsi que leur niveau de prise en charge correspondant pour etcd :
| Architecture | Système d’exploitation | Niveau de support | Responsables |
|---|---|---|---|
| AMD64 | Linux | 1 | [mainteneurs etcd][] |
| ARM64 | Linux | 1 | [mainteneurs etcd][] |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Les plateformes non listées ne sont pas prises en charge.
Prise en charge d’une nouvelle plateforme
Souhaitez-vous contribuer à etcd en tant que « mainteneur officiel » d’une nouvelle plateforme ? En plus d’engager votre soutien à la plateforme, vous devez configurer une intégration continue (CI) d’etcd répondant aux exigences suivantes, selon le niveau de support :
| intégration continue etcd | Niveau 1 | Niveau 2 | Niveau 3 |
|---|---|---|---|
| La construction réussit | ✓ | ✓ | ✓ |
| Les tests unitaires réussissent | ✓ | ✓ | |
| Les tests d’intégration et bout-en-bout réussissent | ✓ | ✓ | |
| Les tests de robustesse réussissent | ✓ |
Pour un exemple de configuration du CI de niveau 2 pour ARM64, consultez [PR etcd #12928][].
Plateformes non prises en charge
Pour éviter d’exécuter accidentellement un serveur etcd sur une plateforme non prise en charge, etcd affiche un message d’avertissement et s’arrête immédiatement, sauf si la variable d’environnement ETCD_UNSUPPORTED_ARCH est définie sur l’architecture cible.
Systèmes 32 bits__ etcd présente des problèmes connus sur les systèmes 32 bits en raison d’un bogue dans le runtime Go.
Pour plus d’informations, consultez l’issue Go #599 et la note sur le bogue du paquet
14.18 - Gestion des versions
Ce document décrit les versions prises en charge par le projet etcd.
Versioning des services et versions prises en charge
Les versions d’etcd sont exprimées sous la forme x.y.z, où x représente la version majeure, y la version mineure et z la version de correctif, conformément à la terminologie Semantic Versioning . Les nouvelles versions mineures peuvent ajouter des fonctionnalités supplémentaires à l’API.
Le projet etcd maintient des branches de version pour la version actuelle et les versions précédentes. Par exemple, lorsque v3.5 est la version actuelle, v3.4 est prise en charge. Lorsque v3.6 est publiée, v3.4 n’est plus pris en charge.
Les correctifs applicables, y compris les correctifs de sécurité, peuvent être appliqués en retour à ces deux branches de version, selon leur gravité et leur faisabilité. Les versions correctives sont créées à partir de ces branches lorsque nécessaire.
Les responsables du projet Maintainers détiennent cette décision.
Vous pouvez vérifier la version du cluster etcd en cours d’exécution avec etcdctl :
Versionning de l’API
Les réponses de l’API v3 ne doivent pas changer après la version 3.0.0, mais de nouvelles fonctionnalités seront ajoutées au fil du temps.
14.19 - Corruption des données
etcd dispose d’une détection automatique des corruption de données intégrée afin d’éviter que l’état du membre ne diverge.
Activation détection corruption données
Détection de corruption de données possible à l’aide de :
- Vérification initiale, activée avec le drapeau
--experimental-initial-corrupt-check. - Vérification périodique de :
- Hachage de la révision compactée, activée avec le drapeau
--experimental-compact-hash-check-enabled. - Hachage de la dernière révision, activée avec le drapeau
--experimental-corrupt-check-time.
- Hachage de la révision compactée, activée avec le drapeau
La vérification initiale sera exécutée lors du démarrage du membre etcd. Le membre comparera son état persistant avec celui des autres membres et quittera l’exécution s’il détecte une incohérence.
Les deux vérifications périodiques seront exécutées par le leader du cluster dans un cluster déjà en cours d’exécution. Le leader comparera son état persistant aux autres membres et déclenchera une alarme CORRUPT en cas de désaccord. Les deux vérifications ont le même objectif, mais il est recommandé de les activer toutes les deux afin d’équilibrer performance et temps de détection.
- Vérification de hachage de la révision compactée – nécessite une compactage régulière, coût minimal sur la performance, gère les suiveurs lents.
- Vérification de hachage de la dernière révision – coût élevé sur la performance, ne gère pas les suiveurs lents ni les compactages fréquents.
Vérification du hachage de révision compactée
Lorsqu’il est activé à l’aide du drapeau --experimental-compact-hash-check-enabled, la vérification est exécutée toutes les minutes.
Cette fréquence peut être ajustée à l’aide du drapeau --experimental-compact-hash-check-time selon le format suivant : 1m - toutes les minutes, 1h - toutes les heures.
Cette vérification étend le compactage afin d’effectuer également le calcul d’un checksum pouvant être comparé entre les membres du cluster.
Elle ne provoque pas de balayage supplémentaire de la base de données, ce qui la rend très peu coûteuse, mais nécessite un compactage régulier dans le cluster.
Vérification du hachage de la dernière révision
Activé à l’aide du drapeau --experimental-corrupt-check-time, nécessite de préciser une période d’exécution au format : 1m - toutes les minutes, 1h - toutes les heures.
La période recommandée est de quelques heures en raison du coût élevé en performance.
L’exécution d’un contrôle nécessite le calcul d’un somme de contrôle en analysant l’intégralité du contenu etcd à la révision indiquée.
Restauration d’un membre corrompu
Il existe trois façons de restaurer un membre corrompu :
- Purger l’état persistant du membre
- Remplacer le membre
- Restaurer tout le cluster
Une fois que le membre corrompu est restauré, l’alarme CORRUPT peut être supprimée.
Purger l’état persistant d’un membre
L’état des membres peut être supprimé en procédant comme suit :
- Arrêt de l’instance etcd.
- Sauvegarde du répertoire de données etcd.
- Déplacement du sous-répertoire
snapdepuis le répertoire de données etcd. - Démarrage de
etcdavec--initial-cluster-state=existinget la liste des membres du cluster indiquée dans--initial-cluster.
Le membre etcd est censé télécharger un instantané à jour depuis le leader.
Remplacer le membre
Un membre peut être remplacé par :
- Arrêt de l’instance etcd.
- Sauvegarde du répertoire de données etcd.
- Suppression du répertoire de données.
- Suppression du membre du cluster en exécutant
etcdctl member remove. - Ajout du membre à nouveau en exécutant
etcdctl member add. - Démarrage de
etcdavec--initial-cluster-state=existinget la liste des membres du cluster indiquée dans--initial-cluster.
Restaurer l’intégralité du cluster
Un cluster peut être restauré en sauvegardant un instantané depuis le leader actuel et en le restorant sur tous les membres.
Exécutez etcdctl snapshot save contre le leader et suivez procédure de restauration d’un cluster
.
15 - Benchmarks
Benchmarks
Les benchmarks etcd seront publiés régulièrement et suivis pour chaque version ci-dessous :
Benchmarks d’utilisation mémoire
Il enregistre l’utilisation mémoire attendue dans différents scénarios.
15.1 - Benchmark de l'utilisation de la mémoire de stockage
Deux composants du stockage etcd consomment de la mémoire physique. Le processus etcd alloue un index en mémoire afin d’accélérer la recherche des clés. La mémoire tampon de pages, gérée par le système d’exploitation, stocke les données récemment accessibles sur disque pour une réutilisation rapide.
L’index en mémoire stocke toutes les clés dans une structure de données arbre B , accompagnées de pointeurs vers les données sur disque (les valeurs). Chaque clé dans l’arbre B peut contenir plusieurs pointeurs, chacun faisant référence à une version différente de sa valeur. La consommation mémoire théorique de l’index en mémoire peut donc être approximée par la formule :
N * (c1 + avg_key_size) + N * (avg_versions_of_key) * (c2 + size_of_pointer)
où c1 représente la surcharge liée aux métadonnées de clé et c2 la surcharge liée aux métadonnées de version.
Le graphique montre la structure détaillée de l’arbre B en mémoire.
La mémoire du cache Page cache est gérée par le système d’exploitation et n’est pas traitée en détail dans ce document.
Environnement de test
Version etcd
Type de machine GCE n1-standard-2
- 7,5 Go de mémoire
- 2x processeurs
Utilisation mémoire de l’index en mémoire
Dans ce test, nous ne mesurons que la consommation mémoire de l’index en mémoire. L’objectif est de déterminer c1 et c2 mentionnés ci-dessus, afin de comprendre la limite maximale de consommation mémoire du stockage.
Nous calculons la consommation de mémoire à l’aide de Go runtime.ReadMemStats. Nous déterminons la différence entre le nombre total d’octets alloués avant la création de l’index et après sa création. Cette méthode ne reflète pas parfaitement la consommation de mémoire de l’index en mémoire mais permet toutefois d’observer le profil de consommation approximatif.
| N | versions | taille de clé | utilisation mémoire |
|---|---|---|---|
| 100K | 1 | 64 octets | 22 Mo |
| 100K | 5 | 64 octets | 39 Mo |
| 1M | 1 | 64 octets | 218 Mo |
| 1M | 5 | 64 octets | 432 Mo |
| 100K | 1 | 256 octets | 41 Mo |
| 100K | 5 | 256 octets | 65 Mo |
| 1M | 1 | 256 octets | 409 Mo |
| 1M | 5 | 256 octets | 506 Mo |
En fonction du résultat, nous pouvons calculer c1=120bytes, c2=30bytes. Nous n’avons besoin que de deux jeux de données pour calculer c1 et c2, car ce sont les seules variables inconnues dans la formule. Les valeurs c1=120bytes et c2=30bytes correspondent à la moyenne des 4 jeux de c1 et c2 que nous avons calculés. La surcharge liée aux métadonnées clés reste encore relativement importante (50 %) pour des paires clé-valeur de petite taille. Toutefois, il s’agit d’une amélioration significative par rapport au vieux magasin, qui présentait au moins une surcharge de 1000 %.
Utilisation mémoire globale
La consommation mémoire globale indique la quantité de mémoire RSS utilisée par etcd, y compris le stockage. La taille des valeurs devrait avoir très peu d’impact sur la consommation mémoire globale d’etcd, car les valeurs sont conservées sur disque et seules les valeurs fréquemment utilisées sont conservées en mémoire, gérées par le cache de pages du système d’exploitation.
| N | versions | taille clé | taille valeur | utilisation mémoire |
|---|---|---|---|---|
| 100K | 1 | 64 octets | 256 octets | 40 Mo |
| 100K | 5 | 64 octets | 256 octets | 89 Mo |
| 1M | 1 | 64 octets | 256 octets | 470 Mo |
| 1M | 5 | 64 octets | 256 octets | 880 Mo |
| 100K | 1 | 64 octets | 1 Ko | 102 Mo |
| 100K | 5 | 64 octets | 1 Ko | 164 Mo |
| 1M | 1 | 64 octets | 1 Ko | 587 Mo |
| 1M | 5 | 64 octets | 1 Ko | 836 Mo |
En fonction des résultats, nous savons que la taille des valeurs n’a pas d’impact significatif sur la consommation mémoire. Une légère augmentation est observée en raison de données supplémentaires conservées dans le cache de page du système d’exploitation.
15.2 - Benchmark de l'utilisation mémoire de la surveillance
Les fonctionnalités de surveillance sont en développement actif, et leur utilisation mémoire peut évoluer au cours de ce développement. Nous ne prévoyons pas d’augmentation significative au-delà des valeurs indiquées ci-dessous.
Un objectif principal d’etcd est de prendre en charge un très grand nombre d’observateurs effectuant une surveillance massivement étendue. etcd vise à supporter O(10k) clients, O(100K) flux de surveillance (O(10) flux par client) et O(10M) surveillance totale (O(100) surveillance par flux). La mémoire consommée par chaque surveillance individuelle représente la plus grande partie de l’utilisation globale d’etcd, et constitue donc le point focal des optimisations actuelles et futures.
Trois composants liés de la surveillance etcd consomment de la mémoire physique : chaque grpc.Conn, chaque flux de surveillance et chaque instance d’activité de surveillance. grpc.Conn maintient la connexion TCP réelle et l’état de connexion gRPC associé. Chaque grpc.Conn consomme environ 10 ko de mémoire, et peut avoir plusieurs flux de surveillance attachés.
Chaque flux de surveillance est une connexion HTTP2 indépendante qui consomme une autre quantité de mémoire O(10 ko). Plusieurs surveillance peuvent partager un même flux de surveillance.
La surveillance est la structure réelle qui suit les modifications apportées au magasin clé-valeur. Chaque surveillance ne doit consommer que < 1 Ko.
La consommation mémoire théorique de la surveillance peut être approximée par la formule suivante :
memory = c1 * number_of_conn + c2 * avg_number_of_stream_per_conn + c3 * avg_number_of_watch_stream
Environnement de test
Version etcd
Type de machine GCE n1-standard-2
- 7,5 Go de mémoire
- 2x processeurs
Utilisation mémoire globale
La consommation mémoire globale indique la quantité de RSS consommée par etcd, incluant les observateurs clients. Bien que le résultat puisse varier jusqu’à 10 %, il reste significatif, car l’objectif est de comprendre l’usage mémoire approximatif et le schéma d’allocation.
À partir des résultats du benchmark, nous pouvons estimer approximativement que c1 = 17kb, c2 = 18kb et c3 = 350bytes. Ainsi, chaque connexion cliente supplémentaire consomme 17 ko de mémoire, chaque flux supplémentaire consomme 18 ko de mémoire, et chaque surveillance supplémentaire n’entraîne qu’une augmentation de 350 octets. Un serveur etcd unique peut maintenir des millions de surveillance avec quelques gigaoctets de mémoire dans un cas normal.
| clients | flux par client | surveillance par flux | surveillance totale | utilisation mémoire |
|---|---|---|---|---|
| 1k | 1 | 1 | 1k | 50Mo |
| 2k | 1 | 1 | 2k | 90Mo |
| 5k | 1 | 1 | 5k | 200Mo |
| 1k | 10 | 1 | 10k | 217Mo |
| 2k | 10 | 1 | 20k | 417Mo |
| 5k | 10 | 1 | 50k | 980Mo |
| 1k | 50 | 1 | 50k | 1001Mo |
| 2k | 50 | 1 | 100k | 1960Mo |
| 5k | 50 | 1 | 250k | 4700Mo |
| 1k | 50 | 10 | 500k | 1171Mo |
| 2k | 50 | 10 | 1M | 2371Mo |
| 5k | 50 | 10 | 2.5M | 5710Mo |
| 1k | 50 | 100 | 5M | 2380Mo |
| 2k | 50 | 100 | 10M | 4672Mo |
| 5k | 50 | 100 | 25M | OOM |
15.3 - Benchmarking d'etcd v3
Machines physiques
Type de machine GCE n1-highcpu-2
- 1 disque SSD local dédiqué monté sous /var/lib/etcd
- 1 disque lent dédié pour le système d’exploitation
- 1,8 Go de mémoire
- 2 processeurs
- version etcd 2.2.0
etcd cluster
1 membre etcd en mode démonstration v3
Test
Utilisez l’outil de benchmark etcd v3 .
Performances
lecture d’une seule clé
| taille de la clé en octets | nombre de clients | QPS de lecture | latence au 90e percentile (ms) |
|---|---|---|---|
| 256 | 1 | 2716 | 0,4 |
| 256 | 64 | 16623 | 6,1 |
| 256 | 256 | 16622 | 21,7 |
Les performances sont presque identiques à celles obtenues avec un gestionnaire de serveur vide.
lecture d’une seule clé après mise
| taille de la clé en octets | nombre de clients | QPS de lecture | latence au 90e percentile (ms) |
|---|---|---|---|
| 256 | 1 | 2269 | 0,5 |
| 256 | 64 | 13582 | 8,6 |
| 256 | 256 | 13262 | 47,5 |
La performance avec un gestionnaire de serveur vide n’est pas affectée par une opération put. Le dégradé de performance doit donc être dû au package de stockage.
15.4 - Benchmarking etcd v2.2.0-rc-memory
Machine physique
Type de machine GCE n1-standard-2
- 1 disque SSD local dédié monté sous /var/lib/etcd
- 1 disque lent dédié pour le système d’exploitation
- 7,5 Go de mémoire
- 2 processeurs
etcd
Test
Démarrez un cluster etcd composé de 3 membres, chacun utilisant 2 cœurs.
La longueur du nom de clé est toujours de 64 octets, ce qui constitue une longueur raisonnable pour une clé moyenne.
Utilisation maximale mémoire
- etcd peut utiliser une mémoire maximale si un suiveur est défaillant et que le leader continue d’envoyer des instantanés.
max RSSest la consommation mémoire maximale enregistrée sur 3 exécutions.
| taille valeur (octets) | nombre de clés | taille données (Mo) | RSS maximal (Mo) | débit maximal RSS/data sur le leader |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
Seuil de taille des données
- Lorsque etcd atteint le seuil de taille des données, il peut déclencher facilement une élection de leader et rejeter une partie des propositions.
- Dans la plupart des cas, le cluster etcd fonctionne correctement s’il ne dépasse pas ce seuil. Si le fonctionnement est dégradé en raison d’une ressource insuffisante, réduisez la taille des données.
| taille en octets | limitation sur le nombre de clés | seuil de taille de données suggéré (Mo) | mémoire RSS consommée (Mo) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
15.5 - Benchmarking etcd v2.2.0-rc
Machine physique
Type de machine GCE n1-highcpu-2
- 1 disque SSD local dédié monté sous /var/lib/etcd
- 1 disque lent dédié pour le système d’exploitation
- 1,8 Go de mémoire
- 2 processeurs
etcd cluster
3 membres etcd 2.2.0-rc, chacun exécuté sur une seule machine.
Versions détaillées :
En outre, nous utilisons 3 membres etcd 2.1.0 en phase alpha pour constituer le cluster et obtenir des performances de base. La tête du commit d’etcd est située à c7146bd5 , identique à celle utilisée dans benchmark etcd 2.1 .
Test
Initialisez une autre machine et utilisez l’outil de benchmark HTTP hey pour envoyer des requêtes à chaque membre etcd. Consultez le guide de manipulation du benchmark pour des instructions détaillées.
Performances
lecture d’une seule clé
| taille de la clé en octets | nombre de clients | serveur etcd cible | débit de lecture (QPS) | latence au 90e percentile (ms) |
|---|---|---|---|---|
| 64 | 1 | seul leader | 2804 (-5%) | 0,4 (+0 %) |
| 64 | 64 | seul leader | 17816 (+0 %) | 5,7 (-6%) |
| 64 | 256 | seul leader | 18667 (-6%) | 20,4 (+2 %) |
| 256 | 1 | seul leader | 2181 (-15%) | 0,5 (+25 %) |
| 256 | 64 | seul leader | 17435 (-7%) | 6,0 (+9 %) |
| 256 | 256 | seul leader | 18180 (-8%) | 21,3 (+3 %) |
| 64 | 64 | tous les serveurs | 46965 (-4%) | 2,1 (+0 %) |
| 64 | 256 | tous les serveurs | 55286 (-6%) | 7,4 (+6 %) |
| 256 | 64 | tous les serveurs | 46603 (-6%) | 2,1 (+5 %) |
| 256 | 256 | tous les serveurs | 55291 (-6%) | 7,3 (+4 %) |
écriture d’une seule clé
| taille de la clé en octets | nombre de clients | serveur etcd cible | débit d’écriture QPS | latence au 90e percentile (ms) |
|---|---|---|---|---|
| 64 | 1 | seul leader | 76 (+22%) | 19,4 (-15%) |
| 64 | 64 | seul leader | 2461 (+45%) | 31,8 (-32%) |
| 64 | 256 | seul leader | 4275 (+1%) | 69,6 (-10%) |
| 256 | 1 | seul leader | 64 (+20%) | 16,7 (-30%) |
| 256 | 64 | seul leader | 2385 (+30%) | 31,5 (-19%) |
| 256 | 256 | seul leader | 4353 (-3%) | 74,0 (+9%) |
| 64 | 64 | tous les serveurs | 2005 (+81%) | 49,8 (-55%) |
| 64 | 256 | tous les serveurs | 4868 (+35%) | 81,5 (-40%) |
| 256 | 64 | tous les serveurs | 1925 (+72%) | 47,7 (-59%) |
| 256 | 256 | tous les serveurs | 4975 (+36%) | 70,3 (-36%) |
explication des modifications de performance
Le QPS de lecture est généralement réduit de 5 à 8 % dans la plupart des scénarios. La raison en est que etcd enregistre des métriques pour chaque opération de stockage. Ces métriques sont importantes pour la surveillance et le débogage, ce qui rend cette réduction acceptable.
Le QPS d’écriture vers le leader augmente de 20 à 30 %. Cela est dû à la déconnexion de la boucle principale Raft et de la boucle d’application des entrées, ce qui empêche leurs blocages mutuels.
Le débit d’écriture QPS sur tous les serveurs augmente de 30 à 80 % car le suiveur peut recevoir plus tôt l’index de validation le plus récent et valider les propositions plus rapidement.
15.6 - Benchmarking d'etcd v2.2.0
Machines physiques
Type de machine GCE n1-highcpu-2
- 1 disque SSD local dédié monté en répertoire de données etcd
- 1 disque lent dédié pour le système d’exploitation
- 1,8 Go de mémoire
- 2 processeurs
etcd cluster
3 membres etcd 2.2.0, chacun exécuté sur une machine unique.
Versions détaillées :
Test
Initialisez une autre machine, en dehors du cluster etcd, puis exécutez l’outil de benchmark HTTP hey avec un correctif de réutilisation de connexion
pour envoyer des requêtes à chaque membre du cluster etcd. Consultez les instructions de benchmark
pour obtenir le correctif et les étapes permettant de reproduire nos procédures.
Les performances sont calculées à partir des résultats de 100 itérations de benchmark.
Performances
Performance de lecture d’une clé unique
| taille de la clé en octets | nombre de clients | serveur etcd cible | débit moyen de lecture (QPS) | écart-type du débit de lecture (QPS) | latence moyenne au 90e percentile (ms) | écart-type de la latence |
|---|---|---|---|---|---|---|
| 64 | 1 | seul leader | 2303 | 200 | 0,49 | 0,06 |
| 64 | 64 | seul leader | 15048 | 685 | 7,60 | 0,46 |
| 64 | 256 | seul leader | 14508 | 434 | 29,76 | 1,05 |
| 256 | 1 | seul leader | 2162 | 214 | 0,52 | 0,06 |
| 256 | 64 | seul leader | 14789 | 792 | 7,69 | 0,48 |
| 256 | 256 | seul leader | 14424 | 512 | 29,92 | 1,42 |
| 64 | 64 | tous les serveurs | 45752 | 2048 | 2,47 | 0,14 |
| 64 | 256 | tous les serveurs | 46592 | 1273 | 10,14 | 0,59 |
| 256 | 64 | tous les serveurs | 45332 | 1847 | 2,48 | 0,12 |
| 256 | 256 | tous les serveurs | 46485 | 1340 | 10,18 | 0,74 |
Performance d’écriture pour une clé unique
| taille de la clé en octets | nombre de clients | serveur etcd cible | débit moyen d’écriture QPS | écart-type du débit d’écriture QPS | latence moyenne au 90e percentile (ms) | écart-type de la latence |
|---|---|---|---|---|---|---|
| 64 | 1 | leader uniquement | 55 | 4 | 24,51 | 13,26 |
| 64 | 64 | leader uniquement | 2139 | 125 | 35,23 | 3,40 |
| 64 | 256 | leader uniquement | 4581 | 581 | 70,53 | 10,22 |
| 256 | 1 | leader uniquement | 56 | 4 | 22,37 | 4,33 |
| 256 | 64 | leader uniquement | 2052 | 151 | 36,83 | 4,20 |
| 256 | 256 | leader uniquement | 4442 | 560 | 71,59 | 10,03 |
| 64 | 64 | tous les serveurs | 1625 | 85 | 58,51 | 5,14 |
| 64 | 256 | tous les serveurs | 4461 | 298 | 89,47 | 36,48 |
| 256 | 64 | tous les serveurs | 1599 | 94 | 60,11 | 6,43 |
| 256 | 256 | tous les serveurs | 4315 | 193 | 88,98 | 7,01 |
Améliorations des performances
Comme etcd enregistre désormais des métriques pour chaque appel d’API, la performance en QPS de lecture semble légèrement diminuer dans la plupart des scénarios. Ce léger impact sur les performances a été jugé acceptable en échange de la richesse des informations de surveillance et de débogage fournies.
Le taux de requêtes d’écriture QPS vers les leaders du cluster semble avoir légèrement augmenté. Cela est dû au fait que la boucle principale et les boucles d’entrée ont été déconnectées dans la logique Raft d’etcd, éliminant plusieurs blocages entre elles.
Le QPS d’écriture vers tous les membres semble avoir augmenté de manière significative, car les suiveurs reçoivent désormais l’index de validation le plus récent plus rapidement, et traitent les propositions de validation plus rapidement.
15.7 - Test de performance d'etcd v2.1.0
Machines physiques
Type de machine GCE n1-highcpu-2
- 1 disque SSD local dédié monté sous /var/lib/etcd
- 1 disque lent dédié pour le système d’exploitation
- 1,8 Go de mémoire
- 2 processeurs
- version etcd 2.1.0 alpha
etcd cluster
3 membres etcd, chacun exécuté sur une machine unique
Test
Initialisez une autre machine et utilisez l’outil de benchmark HTTP hey pour envoyer des requêtes à chaque membre etcd. Consultez le guide de manipulation du benchmark pour des instructions détaillées.
Performances
lecture d’une seule clé
| taille de la clé en octets | nombre de clients | serveur etcd cible | QPS de lecture | Latence au 90e percentile (ms) |
|---|---|---|---|---|
| 64 | 1 | seul leader | 1534 | 0,7 |
| 64 | 64 | seul leader | 10125 | 9,1 |
| 64 | 256 | seul leader | 13892 | 27,1 |
| 256 | 1 | seul leader | 1530 | 0,8 |
| 256 | 64 | seul leader | 10106 | 10,1 |
| 256 | 256 | seul leader | 14667 | 27,0 |
| 64 | 64 | tous les serveurs | 24200 | 3,9 |
| 64 | 256 | tous les serveurs | 33300 | 11,8 |
| 256 | 64 | tous les serveurs | 24800 | 3,9 |
| 256 | 256 | tous les serveurs | 33000 | 11,5 |
écriture d’une seule clé
| taille de la clé en octets | nombre de clients | serveur etcd cible | débit d’écriture (QPS) | latence au 90e percentile (ms) |
|---|---|---|---|---|
| 64 | 1 | seul leader | 60 | 21,4 |
| 64 | 64 | seul leader | 1 742 | 46,8 |
| 64 | 256 | seul leader | 3 982 | 90,5 |
| 256 | 1 | seul leader | 58 | 20,3 |
| 256 | 64 | seul leader | 1 770 | 47,8 |
| 256 | 256 | seul leader | 4 157 | 105,3 |
| 64 | 64 | tous les serveurs | 1 028 | 123,4 |
| 64 | 256 | tous les serveurs | 3 260 | 123,8 |
| 256 | 64 | tous les serveurs | 1 033 | 121,5 |
| 256 | 256 | tous les serveurs | 3 061 | 119,3 |
16 - Mise à jour
16.1 - Mise à jour des clusters etcd et des applications
Cette section contient les documents spécifiques à la mise à jour des clusters etcd et des applications.
Politique de mise à jour
Avant la mise à jour, notez qu’etcd ne prend en charge que les deux cas de mise à jour suivants :
- Mise à jour correctif : Mise à jour entre des versions correctives du même numéro de version mineure (par exemple, 3.7.0 → 3.7.1).
- Mise à jour mineure : Mise à jour d’une version mineure à la fois (par exemple, 3.6 → 3.7). Les mises à jour qui sautent une version mineure ne sont pas prises en charge et risquent de échouer. Mettez à jour vers la dernière version correctif avant de passer à la version mineure suivante.
Mise à jour d’un cluster etcd v3.x
- Mise à niveau d’etcd de la version 3.0 vers la 3.1
- Mise à niveau d’etcd de la version 3.1 vers la 3.2
- Mise à niveau d’etcd de la version 3.2 vers la 3.3
- Mise à niveau d’etcd de la version 3.3 vers la 3.4
- Mise à niveau d’etcd de la version 3.4 vers la 3.5
- Mise à niveau d’etcd de la version 3.5 vers la 3.6
- Mise à niveau d’etcd de la version 3.6 vers la 3.7
Mise à niveau depuis etcd v2.3
16.2 - Mettre à jour etcd de la version v3.5 à la version v3.6
Dans le cas général, la mise à niveau de etcd v3.5 vers v3.6 peut être une mise à niveau progressive sans interruption de service :
- un à un, arrêtez les processus etcd v3.5 et remplacez-les par des processus etcd v3.6
- après avoir lancé tous les processus v3.6, les nouvelles fonctionnalités de la version v3.6 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Mise à jour 3.5
Avant de mettre à jour vers la version 3.6, assurez-vous que tous vos membres 3.5 sont mis à jour vers la version 3.5.32 ou ultérieure
. Les correctifs 3.5.24 à 3.5.26 corrigent plusieurs blocages potentiels liés à la mise à jour ; 3.5.32
ajoute --v2-deprecation=write-only-skip-check et étend etcdutl check v2store afin d’inspecter les enregistrements WAL ainsi que l’instantané v2.
Magasin V2
Si le drapeau --enable-v2 n’est pas configuré ou est défini à false, aucune action supplémentaire n’est requise.
Si --enable-v2 est configuré, exécutez la commande etcdutl check v2store pour vérifier si le v2store contient des données non liées aux membres (données personnalisées). Si aucune donnée personnalisée n’est présente, le drapeau peut être supprimé en toute sécurité. Sinon, consultez le guide de migration v2
pour plus de détails.
Drapeaux ajoutés
Drapeaux supprimés
Drapeaux obsolètes
Le drapeau etcd --experimental-bootstrap-defrag-threshold-megabytes a été déprécié.
Le drapeau etcd --experimental-compaction-batch-limit a été déprécié.
Le drapeau etcd --experimental-compact-hash-check-time a été déprécié.
Le drapeau etcd --experimental-compaction-sleep-interval a été déprécié.
Le drapeau etcd --experimental-corrupt-check-time a été déprécié.
Le drapeau etcd --experimental-enable-distributed-tracing a été déprécié.
Le drapeau etcd --experimental-distributed-tracing-address a été déprécié.
Le drapeau etcd --experimental-distributed-tracing-instance-id a été déprécié.
Le drapeau etcd --experimental-distributed-tracing-sampling-rate a été déprécié.
Le drapeau etcd --experimental-distributed-tracing-service-name a été déprécié.
Le drapeau etcd --experimental-downgrade-check-time a été déprécié.
Le drapeau etcd --experimental-max-learners a été déprécié.
Le drapeau etcd --experimental-memory-mlock a été déprécié.
Le drapeau etcd --experimental-peer-skip-client-san-verification a été déprécié.
Le drapeau etcd --experimental-snapshot-catchup-entries a été déprécié.
Le drapeau etcd --experimental-warning-apply-duration a été déprécié.
Le drapeau etcd --experimental-warning-unary-request-duration a été déprécié.
Le drapeau etcd --experimental-watch-progress-notify-interval a été déprécié.
Drapeaux équivalents des fonctionnalités v3.5
drapeau équivalent pour la fonctionnalité etcd --experimental-compact-hash-check-enabled=true
drapeau équivalent pour la fonctionnalité etcd --experimental-initial-corrupt-check=true
drapeau équivalent pour la fonctionnalité etcd --experimental-enable-lease-checkpoint=true
drapeau équivalent pour la fonctionnalité etcd --experimental-enable-lease-checkpoint-persist=true
drapeau équivalent pour la fonctionnalité etcd --experimental-stop-grpc-service-on-defrag=true
drapeau équivalent pour la fonctionnalité etcd --experimental-txn-mode-write-with-shared-buffer=false
Drapeaux avec de nouvelles valeurs par défaut
Drapeau par défaut par défaut etcd --snapshot-count=100000
Drapeau par défaut etcd --v2-deprecation='not-yet'
Drapeau par défaut etcd --discovery-fallback='proxy'
Différence entre les métriques Prometheus
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.6, le cluster en cours d’exécution doit être la version 3.5 ou ultérieure. Si la version est antérieure à 3.5, veuillez mettre à jour vers la version 3.5 avant de procéder à la mise à jour vers la version 3.6.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, téléchargez la sauvegarde d’instantané
. Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour annuler
la mise à jour et revenir à la version existante de etcd. Veuillez noter que la snapshot commande ne sauvegarde que les données v3.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version v3.6. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Annuler
Avant de mettre à jour votre cluster etcd, créez et téléchargez une sauvegarde sous forme d’instantané de votre cluster etcd. Cet instantané peut être utilisé pour restaurer le cluster dans son état antérieur à la mise à jour si nécessaire. Si les utilisateurs rencontrent des problèmes pendant la mise à jour, ils doivent d’abord identifier et résoudre la cause racine. Si le cluster est toujours dans un état mixte — où au moins un membre reste sur la version v3.5 —, il est possible de remplacer le binaire ou l’image par la version v3.5 antérieure, ou de restaurer directement le cluster à l’aide de l’instantané. Dans cet état mixte, le cluster continue de fonctionner en tant que cluster v3.5, permettant ainsi un retour arrière sans suivre un processus formel de rétrogradation.
Toutefois, une fois que tous les membres ont été mis à jour vers la version v3.6, le cluster est considéré comme entièrement mis à jour et la récupération à l’aide des binaires n’est plus possible. Dans ce cas, la seule option de récupération consiste à restaurer à partir de l’instantané pris avant la mise à jour. Si les utilisateurs souhaitent revenir à la version d’origine après une mise à jour complète, ils doivent suivre le guide officiel de rétrogradation afin d’assurer la cohérence et éviter toute corruption des données.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.5 composé de 3 membres, en cours d’exécution sur une machine locale.
Étape 1 : vérifier les exigences de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.5.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Le leader etcd est garanti pour avoir les données d’application les plus récentes ; récupérez donc l’instantané depuis le leader :
Étape 3 : arrêter un serveur etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 4 : redémarrer le serveur etcd avec la même configuration
Redémarrez le serveur etcd avec la même configuration, mais avec le binaire etcd mis à jour.
Le nouvel etcd v3.6 publiera ses informations dans le cluster. À ce stade, le cluster continue de fonctionner selon le protocole v3.5, qui constitue la version la plus basse commune.
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.889+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"bf9071f4639c75cc","from":"3.0","to":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.894+0530","caller":"etcdserver/server.go:1686","msg":"published local member to cluster through raft","local-member-id":"bf9071f4639c75cc","local-member-attributes":"{Name:node1 ClientURLs:[http://127.0.0.1:2379]}","cluster-id":"59a05384c9b79ee","publish-timeout":"7s"}
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec la nouvelle binaire etcd v3.6 :
Les membres non mis à jour afficheront des avertissements tels que les suivants jusqu’à ce que tout le cluster soit mis à jour.
Cela est attendu et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.6 :
Étape 5 : répéter l’étape 3 et l’étape 4 pour les membres restants
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version v3.6 :
Membre 1 :
{"level":"info","ts":"2025-03-01T04:58:32.375+0530","caller":"etcdserver/server.go:2149","msg":"updating cluster version using v3 API","from":"3.5","to":"3.6"}{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"etcdserver/server.go:2164","msg":"cluster version is updated","cluster-version":"3.6"}
Membre 2 :
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"91bc3c398fb3c146","from":"3.5","to":"3.6"}
Membre 3 :
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"fd422379fda50e48","from":"3.5","to":"3.6"}
16.3 - Mettre à jour etcd de 3.4 à 3.5
Dans le cas général, la mise à niveau de etcd 3.4 vers 3.5 peut être effectuée sans interruption de service, en mode mise à niveau progressive :
- un par un, arrêtez les processus etcd v3.4 et remplacez-les par des processus etcd v3.5
- après avoir lancé tous les processus v3.5, les nouvelles fonctionnalités de la version v3.5 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
Si votre cluster a l’authentification activée, la mise à niveau progressive à partir d’une version 3.4 ou antérieure n’est pas prise en charge, car la version 3.5 modifie le format des entrées WAL liées à l’authentification .
Changements importants dans la version 3.5.
Métriques Prometheus etcd_debugging_mvcc_db_total_size_in_bytes obsolètes
v3.5 a promu les métriques Prometheus etcd_debugging_mvcc_db_total_size_in_bytes à etcd_mvcc_db_total_size_in_bytes, afin de favoriser la surveillance du stockage etcd. La version v3.5 déconseille complètement etcd_debugging_mvcc_db_total_size_in_bytes.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Métriques Prometheus etcd_debugging_mvcc_put_total obsolètes
v3.5 a promu les métriques Prometheus etcd_debugging_mvcc_put_total à etcd_mvcc_put_total, afin de favoriser la surveillance du stockage etcd. La version v3.5 déconseille complètement etcd_debugging_mvcc_put_total.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Métriques Prometheus etcd_debugging_mvcc_delete_total obsolètes
v3.5 a promu les métriques Prometheus etcd_debugging_mvcc_delete_total à etcd_mvcc_delete_total, afin de favoriser la surveillance du stockage etcd. La version v3.5 déconseille complètement etcd_debugging_mvcc_delete_total.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Métriques Prometheus etcd_debugging_mvcc_txn_total obsolètes
v3.5 a promu les métriques Prometheus etcd_debugging_mvcc_txn_total à etcd_mvcc_txn_total, afin de favoriser la surveillance du stockage etcd. La version v3.5 déconseille complètement etcd_debugging_mvcc_txn_total.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Métriques Prometheus etcd_debugging_mvcc_range_total obsolètes
v3.5 a promu les métriques Prometheus etcd_debugging_mvcc_range_total à etcd_mvcc_range_total, afin de favoriser la surveillance du stockage etcd. La version v3.5 déconseille complètement etcd_debugging_mvcc_range_total.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Déprécié etcd --logger capnslog
La version 3.4 utilise par défaut --logger=zap afin de prendre en charge plusieurs sorties de journalisation et la journalisation structurée.
etcd --logger=capnslog a été obsolète à partir de la version 3.5, et --logger=zap est désormais la valeur par défaut.
v3.4 ajoute la prise en charge de etcd --logger=zap pour la journalisation structurée et plusieurs sorties de journal. La motivation principale est de favoriser la surveillance automatisée d’etcd, plutôt que d’analyser les journaux serveur lorsqu’il commence à présenter des anomalies. Les développements futurs viseront à réduire au minimum la quantité de logs générés par etcd, et à faciliter sa surveillance grâce aux métriques et aux alertes. etcd --logger=capnslog sera déprécié à partir de v3.5.
Obsolète etcd --log-output
v3.4 a renommé etcd --log-output en --log-outputs
afin de prendre en charge plusieurs sorties de journalisation.
etcd --log-output a été déprécié à partir de la version 3.5.
Déprécié le drapeau etcd --debug (maintenant --log-level=debug)
Le drapeau etcd --debug a été déprécié.
Déprécié etcd --log-package-levels
Le drapeau etcd --log-package-levels pour capnslog a été déprécié.
Maintenant, etcd --logger=zap est la valeur par défaut.
Obsolète [CLIENT-URL]/config/local/log
L’endpoint /config/local/log est déprécié à partir de la version 3.5, tout comme le drapeau etcd --log-package-levels.
Modifié les points d’accès HTTP de la passerelle gRPC (obsolète /v3beta)
Avant
Après
/v3beta a été supprimé dans la version 3.5.
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.5, le cluster en cours d’exécution doit être la version 3.4 ou ultérieure. Si la version est antérieure à 3.4, veuillez mettre à jour vers la version 3.4 avant de procéder à la mise à jour vers la version 3.5.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, téléchargez l’instantané de sauvegarde
. Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour rétrograder
vers la version existante de etcd. Veuillez noter que la snapshot commande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version 3.5. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 dont la taille dépasse 50 Mo, chaque membre nouvellement mis à jour peut prendre jusqu’à deux minutes pour rattraper le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.5, le cluster sera mis à jour vers la v3.5, et un retour en arrière depuis cet état finalisé est impossible. Toutefois, si un seul membre reste en version v3.4, le cluster et ses opérations restent “v3.4”, et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v3.4 sur tous les membres.
Veuillez télécharger la sauvegarde d’instantané afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.4 à trois membres en cours d’exécution sur une machine locale.
Étape 1 : vérifier les exigences de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.4.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Le leader etcd est garanti pour avoir les données d’application les plus récentes ; récupérez donc l’instantané depuis le leader :
Étape 3 : arrêter un serveur etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 4 : redémarrer le serveur etcd avec la même configuration
Redémarrez le serveur etcd avec la même configuration, mais avec le binaire etcd mis à jour.
Le nouvel etcd v3.5 publiera ses informations dans le cluster. À ce stade, le cluster continue de fonctionner selon le protocole v3.4, qui constitue la version la plus basse commune.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.4"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Vérifiez que chaque membre, puis l’intégralité du cluster, deviennent sains avec la nouvelle binaire etcd v3.5 :
Les membres non mis à jour afficheront des avertissements tels que les suivants jusqu’à ce que tout le cluster soit mis à jour.
Cela est attendu et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.5 :
Étape 5 : répéter l’étape 3 et l’étape 4 pour les membres restants
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.5 :
Membre 1 :
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.5"}
Membre 2 :
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
Membre 3 :
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
16.4 - Mettre à jour etcd de 3.3 à 3.4
Dans le cas général, la mise à niveau de etcd 3.3 vers 3.4 peut s’effectuer sans interruption de service, par mise à niveau progressive :
- un par un, arrêtez les processus etcd v3.3 et remplacez-les par des processus etcd v3.4
- après avoir lancé tous les processus v3.4, les nouvelles fonctionnalités de la version v3.4 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
Changements importants dans la version 3.4.
Rendre ETCDCTL_API=3 etcdctl par défaut
ETCDCTL_API=3 est désormais la valeur par défaut.
Rendre etcd --enable-v2=false par défaut
etcd --enable-v2=false
est désormais la valeur par défaut.
Cela signifie qu’à moins que etcd --enable-v2=true ne soit spécifié, le serveur etcd v3.4 n’acceptera pas les requêtes de l’API v2.
Si l’API v2 était utilisée, assurez-vous d’activer l’API v2 dans la version 3.4 :
D’autres API HTTP fonctionneront toujours (par exemple [CLIENT-URL]/metrics, [CLIENT-URL]/health, passerelle gRPC v3).
Déprécié les indicateurs etcd --ca-file et etcd --peer-ca-file
Les indicateurs --ca-file et --peer-ca-file sont obsolètes ; ils ont été dépréciés depuis la version v2.1.
Note : la configuration de ce paramètre active automatiquement l’authentification par certificat client, quel que soit la valeur définie pour --client-cert-auth.
Erreur grpc.ErrClientConnClosing obsolète
grpc.ErrClientConnClosing a été déprécié dans gRPC >= 1.10
.
Exiger grpc.WithBlock pour la connexion client
Le nouveau chargeur de client
utilise un résolveur asynchrone pour transmettre les points de terminaison à la fonction gRPC dial. En conséquence, le client v3.4 exige l’option grpc.WithBlock pour attendre que la connexion sous-jacente soit active.
Dépréciation des métriques Prometheus etcd_debugging_mvcc_db_total_size_in_bytes
v3.4 promeut les métriques Prometheus etcd_debugging_mvcc_db_total_size_in_bytes vers etcd_mvcc_db_total_size_in_bytes, afin d’encourager la surveillance du stockage etcd.
etcd_debugging_mvcc_db_total_size_in_bytes est toujours fourni dans la version 3.4 pour des raisons de compatibilité descendante. Il sera complètement obsolète dans la version 3.5.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Dépréciation des métriques Prometheus etcd_debugging_mvcc_put_total
v3.4 promeut les métriques Prometheus etcd_debugging_mvcc_put_total vers etcd_mvcc_put_total, afin d’encourager la surveillance du stockage etcd.
etcd_debugging_mvcc_put_total est toujours fourni dans la version 3.4 pour des raisons de compatibilité descendante. Il sera complètement obsolète dans la version 3.5.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Dépréciation des métriques Prometheus etcd_debugging_mvcc_delete_total
v3.4 promeut les métriques Prometheus etcd_debugging_mvcc_delete_total vers etcd_mvcc_delete_total, afin d’encourager la surveillance du stockage etcd.
etcd_debugging_mvcc_delete_total est toujours fourni dans la version 3.4 pour des raisons de compatibilité descendante. Il sera complètement obsolète dans la version 3.5.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Dépréciation des métriques Prometheus etcd_debugging_mvcc_txn_total
v3.4 promeut les métriques Prometheus etcd_debugging_mvcc_txn_total vers etcd_mvcc_txn_total, afin d’encourager la surveillance du stockage etcd.
etcd_debugging_mvcc_txn_total est toujours fourni dans la version 3.4 pour des raisons de compatibilité descendante. Il sera complètement obsolète dans la version 3.5.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Dépréciation des métriques Prometheus etcd_debugging_mvcc_range_total
v3.4 promeut les métriques Prometheus etcd_debugging_mvcc_range_total vers etcd_mvcc_range_total, afin d’encourager la surveillance du stockage etcd.
etcd_debugging_mvcc_range_total est toujours fourni dans la version 3.4 pour des raisons de compatibilité descendante. Il sera complètement obsolète dans la version 3.5.
Notez que les métriques de l’espace de noms etcd_debugging_* sont marquées comme expérimentales. Au fur et à mesure que nous améliorons le guide de surveillance, certaines métriques pourraient être promues.
Dépréciation du drapeau etcd --log-output (maintenant --log-outputs)
Renommez etcd --log-output en --log-outputs
pour prendre en charge plusieurs sorties de journalisation. etcd --logger=capnslog ne prend pas en charge plusieurs sorties de journalisation.
etcd --log-output sera obsolète à partir de la version 3.5. etcd --logger=capnslog sera obsolète à partir de la version 3.5.
v3.4 ajoute la prise en charge de etcd --logger=zap --log-outputs=stderr pour la journalisation structurée et plusieurs sorties de journal. La motivation principale est de favoriser la surveillance automatisée d’etcd, plutôt que d’analyser les journaux serveur après une panne. Les développements futurs viseront à réduire au minimum la quantité de logs générés par etcd, et à faciliter sa surveillance grâce aux métriques et aux alertes. etcd --logger=capnslog sera déprécié à partir de v3.5.
Changé le type de champ log-outputs dans etcd --config-file en []string
À présent que log-outputs (ancien nom de champ log-output) accepte plusieurs écritures, le champ du fichier YAML de configuration etcd log-outputs doit être modifié en type []string comme indiqué ci-dessous :
Renommé embed.Config.LogOutput en embed.Config.LogOutputs
Renommé embed.Config.LogOutput en embed.Config.LogOutputs
afin de prendre en charge plusieurs sorties de journalisation. Et modifié le type de embed.Config.LogOutput de string en []string
afin de prendre en charge plusieurs sorties de journalisation.
v3.5 déconseille capnslog
**v3.5 déprécalera le drapeau etcd --log-package-levels pour capnslog ; etcd --logger=zap --log-outputs=stderr sera la valeur par défaut. v3.5 déprécalera l’endpoint [CLIENT-URL]/config/local/log.
Dépréciation du drapeau etcd --debug (maintenant --log-level=debug)
La version 3.4 déconseille l’utilisation du drapeau etcd --debug
. À la place, utilisez le drapeau etcd --log-level=debug.
Champ pkg/transport.TLSInfo.CAFile obsolète
Champ pkg/transport.TLSInfo.CAFile obsolète.
Modifié embed.Config.SnapCount en embed.Config.SnapshotCount
Pour rester cohérent avec le nom du drapeau etcd --snapshot-count, le champ embed.Config.SnapCount a été renommé en embed.Config.SnapshotCount :
Modifié etcdserver.ServerConfig.SnapCount en etcdserver.ServerConfig.SnapshotCount
Pour rester cohérent avec le nom du drapeau etcd --snapshot-count, le champ etcdserver.ServerConfig.SnapCount a été renommé en etcdserver.ServerConfig.SnapshotCount :
Signature de fonction modifiée dans le package wal
Modifié les signatures de fonction wal pour prendre en charge le journalisateur structuré.
Modifié le type IntervalTree dans le package pkg/adt
pkg/adt.IntervalTree est désormais défini comme un interface.
Obsolète embed.Config.SetupLogging
embed.Config.SetupLogging a été supprimé afin d’éviter une configuration incorrecte de la journalisation, et est désormais configuré automatiquement.
Modifié les points d’entrée HTTP de la passerelle gRPC (remplacé /v3beta par /v3)
Avant
Après
Les requêtes vers les points de terminaison /v3beta seront redirigées vers /v3, et /v3beta sera supprimé dans la version 3.5.
Balises d’image conteneur obsolètes
latest et les balises de version mineure sont obsolètes :
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.4, le cluster en cours d’exécution doit être la version 3.3 ou ultérieure. Si la version est antérieure à 3.3, veuillez mettre à jour vers la version 3.3 avant de procéder à la mise à jour vers la version 3.4.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, téléchargez la sauvegarde d’instantané
. Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour rétrograder
vers la version existante de etcd. Veuillez noter que la snapshot commande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version 3.4. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 dont la taille dépasse 50 Mo, chaque membre nouvellement mis à jour peut prendre jusqu’à deux minutes pour rattraper le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.4, le cluster sera mis à jour vers la version v3.4, et un retour en arrière depuis cet état finalisé est impossible. Toutefois, si un seul membre reste en version v3.3, le cluster et ses opérations restent “v3.3”, et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v3.3 sur tous les membres.
Veuillez télécharger la sauvegarde d’instantané afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.3 composé de 3 membres, en cours d’exécution sur une machine locale.
Étape 1 : vérifier les exigences de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.3.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Le leader etcd est garanti pour avoir les données d’application les plus récentes ; récupérez donc l’instantané depuis le leader :
Étape 3 : arrêter un serveur etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 4 : redémarrer le serveur etcd avec la même configuration
Redémarrez le serveur etcd avec la même configuration, mais avec le binaire etcd mis à jour.
Le nouvel etcd v3.4 publiera ses informations dans le cluster. À ce stade, le cluster continue de fonctionner selon le protocole v3.3, qui constitue la version la plus basse commune.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.3"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.3"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec le binaire etcd v3.4 nouvellement installé :
Les membres non mis à jour afficheront des avertissements tels que les suivants jusqu’à ce que tout le cluster soit mis à jour.
Cela est attendu et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.4 :
Étape 5 : répéter l’étape 3 et l’étape 4 pour les membres restants
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.4 :
Membre 1 :
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.4"}
Membre 2 :
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
Membre 3 :
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
16.5 - Mettre à jour etcd de la version v3.6 à la version v3.7
Dans le cas général, la mise à niveau de etcd v3.6 vers v3.7 peut être une mise à niveau progressive sans interruption de service :
- un à un, arrêtez les processus etcd v3.6 et remplacez-les par des processus etcd v3.7
- après avoir lancé tous les processus v3.7, les nouvelles fonctionnalités de la version v3.7 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Mise à jour 3.6
Avant de procéder à la mise à niveau vers 3.7, assurez-vous que tous vos membres 3.6 ont été mis à jour vers 3.6.11 ou une version ultérieure. Les correctifs 3.6 antérieurs peuvent ne pas être compatibles avec une mise à niveau progressive vers 3.7.
Magasin V2
Le magasin v2 a été entièrement supprimé dans la version 3.7. L’API HTTP v2 (--enable-v2), l’émission v2 sur v3 (--experimental-enable-v2v3), le service de découverte v2, le paquet client/v2 et le chargement des fichiers d’instantané v2 ont tous disparu. Consultez les références aux modifications rétroactives dans CHANGELOG-3.7
.
Si vous effectuez une mise à jour à partir d’un cluster 3.6, ces indicateurs sont déjà absents et aucune action n’est requise. Si vous migrez depuis une version antérieure avec des données v2 personnalisées, suivez le guide de migration v2 avant la mise à jour.
Refactorisation Go
La version 3.7 contient des refontes internes importantes qui n’affectent pas les mises à jour normales, mais qui méritent d’être prises en compte lors de la mise à jour d’intégrations personnalisées :
- Migration de
gogo/protobufversgoogle.golang.org/protobufstandard (suivi dans #14533 ). - Migration des bibliothèques de journalisation et d’étiquetage dépréciées
go-grpc-middlewarev1 vers les intercepteurs v2 (#20420 ). - Les intercepteurs gRPC OpenTelemetry ont été mis à jour vers
otelgrpcv0.61.0, remplaçant les composants dépréciésUnaryServerInterceptoretStreamServerInterceptorparNewServerHandler(#20017 ).
Si vous intégrez etcd en tant que bibliothèque, effectuez la compilation contre l’API clientv3, ou dépendez de packages internes, examinez le CHANGELOG
avant de procéder à la mise à jour.
Drapeaux supprimés
Toutes les options --experimental-* obsolètes ont été supprimées dans la version 3.7 (#19959
). Dans la version 3.6, chacune de ces options a été remplacée soit par une option non expérimentale du même nom, soit par une entrée --feature-gates. Si vous avez encore l’une de ces options définie, remplacez-la par l’équivalent de la version 3.6 avant de passer à la version 3.7, sinon le processus de la version 3.7 ne pourra pas démarrer.
Reportez-vous au guide de mise à jour v3.5 vers v3.6
pour la correspondance de chaque indicateur supprimé vers son équivalent non expérimental ou à --feature-gates entrée.
Drapeaux ajoutés
Aucun.
Drapeaux avec de nouvelles valeurs par défaut
Aucun.
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.7, le cluster en cours d’exécution doit être la version 3.6.11 ou ultérieure. Si le cluster utilise une version mineure antérieure, veuillez d’abord mettre à jour vers la version 3.6 ; etcd ne prend en charge la mise à jour que d’une version mineure à la fois.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, téléchargez la sauvegarde d’instance, instantané de sauvegarde . Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour annuler la mise à jour et revenir à la version précédente de etcd.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster est considéré comme mis à jour uniquement lorsque tous ses membres ont été mis à jour vers la version v3.7. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Annuler
Avant de mettre à jour votre cluster etcd, créez et téléchargez une sauvegarde sous forme d’instantané de votre cluster etcd. Cet instantané peut être utilisé pour restaurer le cluster dans son état antérieur à la mise à jour si nécessaire. Si des utilisateurs rencontrent des problèmes pendant la mise à jour, ils doivent d’abord identifier et résoudre la cause racine. Si le cluster est toujours dans un état mixte, où au moins un membre reste sur la version v3.6, il est possible de remplacer le binaire ou l’image par la version v3.6 antérieure, ou de restaurer directement le cluster à l’aide de l’instantané. Dans cet état mixte, le cluster continue de fonctionner en tant que cluster v3.6, permettant ainsi un retour arrière sans suivre un processus formel de rétrogradation.
Toutefois, une fois que tous les membres ont été mis à jour vers la version 3.7, le cluster est considéré comme entièrement mis à jour et la restauration à une version antérieure à l’aide des binaires n’est plus possible. Dans ce cas, les seules options de récupération sont de restaurer à partir de l’instantané pris avant la mise à jour ou de suivre le guide officiel de désinstallation en cas de problème lors de la mise à jour.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.6 composé de trois membres, exécuté sur une machine locale. La sortie ci-dessous provient d’une exécution réelle contre etcd v3.6.12 et etcd v3.7.0-rc.0 sur un hôte unique utilisant trois ports de boucle locale.
Étape 1 : vérifier les exigences de mise à jour
Le cluster est-il sain et en cours d’exécution avec la version 3.6.11 ou ultérieure ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Le leader etcd est garanti pour avoir les données d’application les plus récentes ; récupérez donc l’instantané depuis le leader :
Étape 3 : arrêter un serveur etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue. Le leader transfère son rôle avant de s’arrêter :
Étape 4 : redémarrer le serveur etcd avec la même configuration
Redémarrez le serveur etcd avec la même configuration, mais avec le binaire etcd mis à jour.
Le nouvel etcd v3.7 publiera ses informations dans le cluster. À ce stade, le cluster continue de fonctionner selon le protocole v3.6, qui constitue la version la plus basse commune.
{"level":"info","ts":"2026-06-02T07:01:58.920780+0300","caller":"membership/cluster.go:296","msg":"set cluster version from store","cluster-version":"3.6"}
{"level":"info","ts":"2026-06-02T07:01:58.979186+0300","caller":"etcdserver/server.go:1828","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","cluster-id":"7dee9ba76d59ed53","publish-timeout":"7s"}
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec la nouvelle binaire etcd v3.7 :
Les membres non mis à jour et le membre mis à jour vont générer des messages concernant l’état à version mixte jusqu’à ce que l’intégralité du cluster soit mis à jour. Cela est attendu et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.7.
Étape 5 : répéter l’étape 3 et l’étape 4 pour les membres restants
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version v3.7 :
{"level":"info","ts":"2026-06-02T07:02:36.054783+0300","caller":"etcdserver/server.go:2311","msg":"updating cluster version using v3 API","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059345+0300","caller":"membership/cluster.go:593","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059409+0300","caller":"etcdserver/server.go:2326","msg":"cluster version is updated","cluster-version":"3.7"}
16.6 - Mettre à jour etcd de 3.2 vers 3.3
Dans le cas général, la mise à niveau de etcd 3.2 vers 3.3 peut être effectuée sans interruption de service, par mise à niveau progressive :
- un par un, arrêtez les processus etcd v3.2 et remplacez-les par des processus etcd v3.3
- après avoir lancé tous les processus v3.3, les nouvelles fonctionnalités de la version v3.3 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
si vous activez l’authentification et utilisez des bails (avec une durée de vie courte), il y a de fortes chances de rencontrer un problème
entraînant une incohérence des données. Il est fortement recommandé de mettre à jour vers 3.2.31 ou ultérieur avant toute mise à jour vers 3.3, afin de corriger ce problème. En outre, si un utilisateur sans autorisation envoie une requête LeaseRevoke à un nœud 3.3 pendant la mise à jour, cela peut encore provoquer une corruption des données. Il est donc préférable de s’assurer que votre environnement ne contient pas d’appels anormaux avant la mise à jour ; consultez #11691
pour plus de détails.
Changements importants marquants dans 3.3.
Changement du type de valeur du drapeau etcd --auto-compaction-retention en string
Modifié le drapeau --auto-compaction-retention en acceptant des valeurs de type chaîne
avec une granularité plus fine
. À présent que --auto-compaction-retention accepte des valeurs de type chaîne, le champ du fichier YAML de configuration etcd auto-compaction-retention doit être modifié en string type. Auparavant, --config-file etcd.config.yaml pouvait inclure le champ auto-compaction-retention: 24, désormais il doit être auto-compaction-retention: "24" ou auto-compaction-retention: "24h". Si configuré comme --auto-compaction-mode periodic --auto-compaction-retention "24h", la valeur de durée pour le drapeau --auto-compaction-retention doit être valide pour la fonction time.ParseDuration
en Go.
Modifié etcdserver.EtcdServer.ServerConfig en *etcdserver.EtcdServer.ServerConfig
etcdserver.EtcdServer a modifié le type de son champ membre *etcdserver.ServerConfig en etcdserver.ServerConfig. Et etcdserver.NewServer prend désormais etcdserver.ServerConfig, plutôt que *etcdserver.ServerConfig.
Avant et après (par exemple k8s.io/kubernetes/test/e2e_node/services/etcd.go )
Ajout de la structure embed.Config.LogOutput
Notez que ce champ a été renommé en embed.Config.LogOutputs dans le type []string à partir de la version 3.4. Consultez le guide de mise à jour vers la version 3.4
pour plus de détails.
Champ LogOutput est ajouté à embed.Config :
Avant que les avertissements du serveur gRPC ne soient journalisés dans etcdserver.
À compter de la version 3.3, les journaux du serveur gRPC sont désactivés par défaut.
Notez que la méthode embed.Config.SetupLogging a été dépréciée à partir de la version v3.4. Consultez le guide de mise à jour vers la version v3.4
pour plus de détails.
Définissez le champ embed.Config.Debug sur true pour activer les journaux du serveur gRPC.
Modifié la réponse de l’endpoint /health
Précédemment, [endpoint]:[client-port]/health renvoyait une valeur JSON marshalisée manuellement. La version 3.3 définit désormais la structure etcdhttp.Health
.
Notez qu’à partir des versions v3.3.0-rc.0, v3.3.0-rc.1 et v3.3.0-rc.2, les champs etcdhttp.Health ont un type booléen avec des champs "health" et "errors". Afin de garantir la compatibilité descendante, nous avons reverti le champ "health" vers le type string et supprimé le champ "errors". Les informations de santé supplémentaires seront fournies via des API séparées.
Modifié les points d’entrée HTTP de la passerelle gRPC (remplacé /v3alpha par /v3beta)
Avant
Après
Les requêtes vers les points de terminaison /v3alpha seront redirigées vers /v3beta, et /v3alpha sera supprimé dans la version 3.4.
Modifié les limites de taille maximale des requêtes
3.3 permet désormais des limites de taille de requête personnalisées pour le serveur et le côté client. Dans les versions précédentes (v3.2.10, v3.2.11), la taille de réponse du client était limitée à 4 MiB.
Les limites de requêtes côté serveur peuvent être configurées à l’aide du drapeau --max-request-bytes :
Ou configurez le champ embed.Config.MaxRequestBytes :
Si non spécifié, la limite côté serveur est par défaut de 1,5 MiB.
Les limites de requêtes côté client doivent être configurées en fonction des limites côté serveur.
Si non spécifié, la limite d’envoi côté client est par défaut fixée à 2 MiB (1,5 MiB + surcharge gRPC) et la limite de réception à math.MaxInt32. Voir clientv3 godoc
pour plus de détails.
Modifiées les signatures des fonctions d’enveloppe du client gRPC brut
3.3 modifie les signatures de fonction du wrapper client gRPC clientv3. Ce changement était nécessaire pour prendre en charge les options personnalisées grpc.CallOptionsur les limites de taille de message
.
Avant et après
Changé le type d’erreur de l’API clientv3 Snapshot
Précédemment, l’API clientv3 Snapshot renvoyait des erreurs de type [grpc/*status.statusError] brutes. La version 3.3 les traduit désormais en types d’erreurs publiques correspondants, afin de maintenir une cohérence avec les autres API.
Avant
Après
Changé la sortie de la commande etcdctl lease timetolive
Précédemment, la commande lease timetolive LEASE_ID sur un bail expiré affichait -1s pour le nombre de secondes restantes. La version 3.3 affiche désormais des messages plus clairs.
Avant
Après
Modifié les imports golang.org/x/net/context
clientv3 a déprécié golang.org/x/net/context. Si un projet intègre golang.org/x/net/context dans d’autres codes (par exemple, du code généré par etcd pour les protocoles buffer) et importe github.com/coreos/etcd/clientv3, une version de Go 1.9 ou ultérieure est requise pour la compilation.
Avant
Après
Modifié la dépendance gRPC
3.3 exige désormais grpc/grpc-go
v1.7.5.
Obsolète grpclog.Logger
grpclog.Logger a été obsolète en faveur de grpclog.LoggerV2 . clientv3.Logger est désormais grpclog.LoggerV2.
Avant
Après
Obsolète grpc.ErrClientConnTimeout
Précédemment, l’erreur grpc.ErrClientConnTimeout était renvoyée en cas de délai d’attente lors de la connexion client. La version 3.3 renvoie désormais context.DeadlineExceeded (voir #8504
).
Avant
Après
Changement du registre conteneur officiel
etcd utilise désormais gcr.io/etcd-development/etcd
comme registre conteneur principal, et quay.io/coreos/etcd
comme secondaire.
Avant
Après
Mises à jour à partir de la version v3.3.14
v3.3.14 a dû intégrer certaines fonctionnalités de la version 3.4, tout en cherchant à minimiser les différences entre les implémentations du chargeur de client. Cette version corrige “kube-apiserver 1.13.x refuse de fonctionner lorsque le premier serveur etcd n’est pas disponible” (kubernetes#72102) .
grpc.ErrClientConnClosing a été déprécié dans gRPC >= 1.10
.
Le nouveau chargeur de client
utilise un résolveur asynchrone pour transmettre les points de terminaison à la fonction de connexion gRPC. En conséquence, v3.3.14
ou une version ultérieure nécessite l’option grpc.WithBlock pour attendre que la connexion sous-jacente soit active.
Veuillez consulter CHANGELOG pour obtenir la liste complète des modifications.
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.3, le cluster en cours d’exécution doit être la version 3.2 ou ultérieure. Si la version est antérieure à 3.2, veuillez mettre à jour vers la version 3.2 avant de procéder à la mise à jour vers la version 3.3.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, sauvegardez les données etcd
. Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour rétrograder
vers la version existante de etcd. Veuillez noter que la snapshotcommande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster est considéré comme mis à jour uniquement lorsque tous ses membres ont été mis à jour vers la version 3.3. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 dont la taille dépasse 50 Mo, chaque membre nouvellement mis à jour peut prendre jusqu’à deux minutes pour rattraper le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.3, le cluster sera mis à jour vers la v3.3, et un retour en arrière depuis cet état finalisé est impossible. Si toutefois un seul membre reste en version v3.2, le cluster et ses opérations restent “v3.2”, et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v3.2 sur tous les membres.
Veuillez sauvegarder le répertoire de données de tous les membres etcd afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.2 composé de 3 membres, en cours d’exécution sur une machine locale.
1. Vérifier les prérequis de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.2.x ?
2. Arrêtez le processus etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Il est recommandé de procéder à un sauvegarde des données etcd à cette étape afin de disposer d’un chemin de retour en cas de problème :
3. Lancement d’un binaire etcd v3.3 en mode drop-in et démarrage du nouveau processus etcd
Le nouvel etcd v3.3 publiera ses informations dans le cluster :
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec la nouvelle binaire etcd v3.3 :
Les membres mis à jour émettront des avertissements similaires au suivant jusqu’à ce que l’intégralité du cluster soit mis à jour. C’est normal et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.3 :
4. Répétez l’étape 2 à l’étape 3 pour tous les autres membres
5. Terminer
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.3 :
16.7 - Mettre à jour etcd de 3.1 vers 3.2
Dans le cas général, la mise à niveau de etcd 3.1 vers 3.2 peut être effectuée sans interruption de service, par mise à niveau progressive :
- un par un, arrêtez les processus etcd v3.1 et remplacez-les par des processus etcd v3.2
- après avoir lancé tous les processus v3.2, les nouvelles fonctionnalités de la version v3.2 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
Changements importants marquants dans 3.2.
Changé la valeur par défaut de snapshot-count
Une valeur plus élevée de --snapshot-count conserve davantage d’entrées Raft en mémoire jusqu’à l’instantané, entraînant ainsi une utilisation mémoire plus élevée et récurrente de . Comme le leader conserve les dernières entrées Raft plus longtemps, un suiveur lent dispose de plus de temps pour se synchroniser avant que le leader ne prenne un instantané. --snapshot-count représente un compromis entre une utilisation mémoire plus élevée et une meilleure disponibilité des suiveurs lents.
Depuis la version 3.2, la valeur par défaut de --snapshot-count a passé de 10 000 à 100 000
.
Changement de dépendance gRPC (>=3.2.10)
3.2.10 ou ultérieure exige désormais grpc/grpc-go
v1.7.5 (les versions antérieures à 3.2.9 exigent v1.2.1).
Obsolète grpclog.Logger
grpclog.Logger a été obsolète en faveur de grpclog.LoggerV2 . clientv3.Logger est désormais grpclog.LoggerV2.
Avant
Après
Obsolète grpc.ErrClientConnTimeout
Précédemment, l’erreur grpc.ErrClientConnTimeout était renvoyée en cas de délai d’attente lors de la connexion client. La version 3.2 renvoie désormais context.DeadlineExceeded (voir #8504
).
Avant
Après
Modifié les limites de taille de requête maximale (>=3.2.10)
3.2.10 et 3.2.11 permettent de définir des limites personnalisées de taille de requête côté serveur. À partir de la version 3.2.12, il est possible de définir des limites personnalisées de taille de requête côté serveur et côté client. Dans les versions antérieures (v3.2.10, v3.2.11), la taille des réponses côté client était limitée à 4 MiB.
Les limites de requêtes côté serveur peuvent être configurées à l’aide du drapeau --max-request-bytes :
Ou configurez le champ embed.Config.MaxRequestBytes :
Si non spécifié, la limite côté serveur est par défaut de 1,5 MiB.
Les limites de requêtes côté client doivent être configurées en fonction des limites côté serveur.
Si non spécifié, la limite d’envoi côté client est par défaut fixée à 2 MiB (1,5 MiB + surcharge gRPC) et la limite de réception à math.MaxInt32. Voir clientv3 godoc
pour plus de détails.
Modifié les enveloppes client gRPC brutes
3.2.12 ou versions ultérieures modifient les signatures de fonction du wrapper client gRPC clientv3. Ce changement était nécessaire pour prendre en charge les options grpc.CallOptionsur les limites de taille des messages
.
Avant et après
Modifié l’API clientv3.Lease.TimeToLive
Précédemment, l’API clientv3.Lease.TimeToLive renvoyait lease.ErrLeaseNotFound en cas d’ID de bail inexistant. La version 3.2 renvoie désormais TTL=-1 dans sa réponse, sans erreur (voir #7305
).
Avant
Après
Déplacé clientv3.NewFromConfigFile vers clientv3.yaml.NewConfig
clientv3.NewFromConfigFile est déplacé vers yaml.NewConfig.
Avant
Après
Changement apporté à --listen-peer-urls et --listen-client-urls
3.2 refuse désormais les noms de domaine pour --listen-peer-urls et --listen-client-urls (3.1 n’affichait que des avertissements), car un nom de domaine n’est pas valide pour le lien d’interface réseau. Assurez-vous que ces URL sont correctement formatées en tant que scheme://IP:port.
Consultez issue #6336 pour plus de contextes.
Liste de vérification pour la mise à jour du serveur
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.2, le cluster en cours d’exécution doit être la version 3.1 ou ultérieure. Si la version est antérieure à 3.1, veuillez mettre à jour vers la version 3.1 avant de procéder à la mise à jour vers la version 3.2.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, sauvegardez les données etcd
. Si une erreur survient durant la mise à jour, il sera possible d’utiliser cette sauvegarde pour rétrograder
vers la version existante de etcd. Veuillez noter que la snapshotcommande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version 3.2. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui détermine la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 dont la taille dépasse 50 Mo, chaque membre nouvellement mis à jour peut prendre jusqu’à deux minutes pour rattraper le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.2, le cluster sera mis à jour vers la version v3.2, et le retour en arrière depuis cet état finalisé est impossible. Si toutefois un seul membre reste en version v3.1, le cluster et ses opérations restent “v3.1”, et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v3.1 sur tous les membres.
Veuillez sauvegarder le répertoire de données de tous les membres etcd afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd v3.1 composé de 3 membres, en cours d’exécution sur une machine locale.
1. Vérifier les prérequis de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.1.x ?
2. Arrêtez le processus etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Il est recommandé de procéder à un sauvegarde des données etcd à cette étape afin de disposer d’un chemin de retour en cas de problème :
3. Lancer le binaire etcd v3.2 en mode drop-in et démarrer le nouveau processus etcd
Le nouvel etcd v3.2 publiera ses informations dans le cluster :
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec la nouvelle binaire etcd v3.2 :
Les membres mis à jour émettront des avertissements similaires au suivant jusqu’à ce que l’intégralité du cluster soit mis à jour. C’est normal et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.2 :
4. Répétez l’étape 2 à l’étape 3 pour tous les autres membres
5. Terminer
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.2 :
16.8 - Mettre à jour etcd de la version 3.0 à la 3.1
Dans le cas général, la mise à niveau d’etcd 3.0 vers 3.1 peut être effectuée sans interruption de service, par mise à niveau progressive :
- un nœud à la fois, arrêtez les processus etcd v3.0 et remplacez-les par des processus etcd v3.1
- après avoir lancé tous les processus v3.1, les nouvelles fonctionnalités de la version v3.1 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
Surveillance
Les métriques suivantes issues de la version 3.0.x ont été dépréciées en faveur de go-grpc-prometheus :
etcd_grpc_requests_totaletcd_grpc_requests_failed_totaletcd_grpc_active_streamsetcd_grpc_unary_requests_duration_seconds
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.1, le cluster en cours d’exécution doit être la version 3.0 ou ultérieure. Si la version est antérieure à 3.0, veuillez mettre à jour vers la version 3.0 avant de procéder à la mise à jour vers la version 3.1.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, sauvegardez les données etcd
. Si une erreur survient lors de la mise à jour, il sera possible d’utiliser cette sauvegarde pour rétrograder
vers la version existante de etcd. Veuillez noter que la snapshotcommande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version 3.1. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui détermine la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 dont la taille dépasse 50 Mo, chaque membre nouvellement mis à jour peut prendre jusqu’à deux minutes pour rattraper le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.1, le cluster sera mis à jour vers la v3.1, et un retour en arrière depuis cet état finalisé est impossible. Toutefois, si un seul membre reste en version v3.0, le cluster et ses opérations restent “v3.0”, et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v3.0 sur tous les membres.
Veuillez sauvegarder le répertoire de données de tous les membres etcd afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple montre comment mettre à jour un cluster etcd à 3 membres, version 3.0, en cours d’exécution sur une machine locale.
1. Vérifier les prérequis de mise à jour
Le cluster est-il sain et en cours d’exécution sous la version 3.0.x ?
2. Arrêtez le processus etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Il est recommandé de procéder à un sauvegarde des données etcd à cette étape afin de disposer d’un chemin de retour en cas de problème :
3. Lancement d’un binaire etcd v3.1 en mode drop-in et démarrage du nouveau processus etcd
Le nouvel etcd v3.1 publiera ses informations dans le cluster :
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec le binaire etcd v3.1 nouvellement installé :
Les membres mis à jour émettront des avertissements similaires au suivant jusqu’à ce que l’intégralité du cluster soit mis à jour. C’est normal et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.1 :
4. Répétez l’étape 2 à l’étape 3 pour tous les autres membres
5. Terminer
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.1 :
16.9 - Mettre à jour etcd de la version 2.3 à la 3.0
Dans le cas général, la mise à niveau de etcd 2.3 vers 3.0 peut s’effectuer sans interruption de service, par mise à niveau progressive :
- un par un, arrêtez les processus etcd v2.3 et remplacez-les par des processus etcd v3.0
- après avoir lancé tous les processus v3.0, les nouvelles fonctionnalités de la version 3.0 sont disponibles pour le cluster
Avant de lancer la mise à jour , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour
Lorsque on migre depuis la version v2 sans données v3
, le serveur etcd v3.2+ provoque une panne lorsqu’il restaure à partir d’un instantané existant mais qu’aucun fichier v3 ETCD_DATA_DIR/member/snap/db n’est présent. Cela se produit lorsque le serveur a été migré depuis la version v2 sans données v3 précédentes. Cela empêche également la perte accidentelle de données v3 (par exemple, le fichier db pourrait avoir été déplacé). etcd exige que la migration post-v3 ne puisse avoir lieu qu’avec des données v3 présentes. N’effectuez pas la mise à jour vers des versions v3 plus récentes tant que le serveur v3.0 ne contient pas de données v3.
Exigences de mise à jour
Pour mettre à jour un déploiement etcd existant vers la version 3.0, le cluster en cours d’exécution doit être la version 2.3 ou ultérieure. Si la version est antérieure à 2.3, veuillez mettre à jour vers 2.3 avant de procéder à la mise à jour vers la version 3.0.
En outre, pour garantir une mise à niveau progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état de santé du cluster à l’aide de la commande etcdctl cluster-health avant de poursuivre.
Préparation
Avant de mettre à jour etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour dans l’environnement de production.
Avant de commencer, sauvegardez le répertoire de données etcd . Si une erreur survient durant la mise à jour, il sera possible d’utiliser cette sauvegarde pour revenir à une version antérieure d’etcd .
Versions mixtes
Lors d’une mise à jour, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster n’est considéré comme mis à jour qu’une fois que tous ses membres ont été mis à jour vers la version 3.0. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui contrôle la version signalée et les fonctionnalités prises en charge.
Limitations
Il peut falloir jusqu’à 2 minutes pour que le membre nouvellement mis à jour rattrape le cluster existant lorsque la taille totale des données dépasse 50 Mo. Vérifiez la taille d’un instantané récent pour estimer la taille totale des données. Autrement dit, il est préférable d’attendre 2 minutes entre chaque mise à jour de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour, et nous serons heureux de leur fournir des conseils sur la procédure.
Rétrogradation
Si tous les membres ont été mis à jour vers la version v3.0, le cluster sera mis à jour vers la version v3.0, et le retour à une version antérieure à partir de cet état finalisé est impossible. Si toutefois un seul membre reste en version v2.3, le cluster et ses opérations restent au niveau « v2.3 », et il est possible, depuis cet état de cluster mixte, de revenir à l’utilisation d’une binaire etcd v2.3 sur tous les membres.
Veuillez sauvegarder le répertoire de données de tous les membres etcd afin de permettre la désinstallation du cluster, même après son mise à jour complète.
Procédure de mise à jour
Cet exemple détaille la mise à jour d’un cluster etcd v2.3 à trois membres fonctionnant sur une machine locale.
1. Vérifier les prérequis de mise à jour.
Le cluster est-il sain et en cours d’exécution sous la version v.2.3.x ?
2. Arrêtez le processus etcd existant
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Il est recommandé de procéder à une sauvegarde du répertoire de données etcd afin de disposer d’un chemin de retour en cas de problème :
3. Lancement d’un binaire etcd v3.0 en mode drop-in et démarrage du nouveau processus etcd
Le nouvel etcd v3.0 publiera ses informations dans le cluster :
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec la nouvelle binaire etcd v3.0 :
Les membres mis à jour émettront des avertissements similaires au suivant jusqu’à ce que l’intégralité du cluster soit mis à jour. C’est normal et cessera une fois que tous les membres du cluster etcd auront été mis à jour vers la version 3.0 :
4. Répétez l’étape 2 à l’étape 3 pour tous les autres membres
5. Terminer
Lorsque tous les membres sont mis à jour, le cluster signalera avec succès la mise à jour vers la version 3.0 :
Considérations complémentaires
- Les variables d’environnement etcdctl ont été mises à jour. Si
ETCDCTL_API=2 etcdctl cluster-healthfonctionne correctement mais queETCDCTL_API=3 etcdctl endpoints healthrenvoieError: grpc: timed out when dialing, veillez à utiliser les nouveaux noms de variables .
Problèmes connus
- etcd < v3.1 ne fonctionne pas correctement s’il est compilé avec Go > v1.7. Consultez Problème 6951 pour plus d’informations.
- Si une erreur telle que
transport: http2Client.notifyError got notified that the client transport was broken unexpected EOF.apparaît dans les journaux du serveur etcd, assurez-vous qu’etcd est une version précompilée ou bien compilée avec (etcd v3.1+ & go v1.7+) ou (etcd <v3.1 & go v1.6.x). - L’ajout d’un membre v3 à un cluster v2.3 pendant une mise à jour n’est pas pris en charge et peut provoquer des paniques. Consultez Problème 7249 pour plus d’informations. Les versions mixtes de membres etcd ne sont autorisées que pendant la migration vers v3. Terminez les mises à jour avant d’effectuer toute modification de la configuration du cluster.
17 - Rétrogradation
17.1 - Réduction de version des clusters etcd et des applications
Cette section contient les documents spécifiques à la rétrogradation des clusters etcd et des applications.
Réduction de la version d’un cluster etcd v3.x
17.2 - Rétrogradation d'etcd de la version v3.7 à la v3.6
Dans le cas général, la rétrogradation de etcd v3.7 vers v3.6 peut se faire sans interruption de service, par mise à jour progressive :
- un à un, arrêtez les processus etcd v3.7 et remplacez-les par des processus etcd v3.6
- après avoir activé la remontée de version, les nouvelles fonctionnalités de la v3.7 ne sont plus disponibles pour le cluster
Avant de effectuer une mise vers une version antérieure , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour vers une version antérieure
Différences notables entre v3.7 et v3.6 :
Différence entre les drapeaux
La version 3.7 n’introduit aucune nouvelle option, aussi un processus v3.6 accepte toutes les options d’une configuration v3.7, et aucune modification de configuration n’est requise lors d’une mise à jour rétrograde.
La différence est basée sur les versions v3.7.0-rc.0 et v3.6.13. La différence réelle dépendra de votre version de correctif ; vérifiez d’abord avec diff <(etcd-3.7/bin/etcd -h | grep \\-\\-) <(etcd-3.6/bin/etcd -h | grep \\-\\-).
Les indicateurs --experimental-* obsolètes, supprimés à partir de la version v3.7, existent encore dans la version v3.6, mais ne les réinstallez pas après une mise à jour rétrograde ; utilisez leurs équivalents non expérimentaux ou les entrées --feature-gates, qui fonctionnent sur les deux versions.
Différence entre les métriques Prometheus
Liste de vérification pour la mise à jour vers une version antérieure du serveur
Exigences de mise à jour vers une version antérieure
Pour garantir une mise à jour descendante progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de procéder à une mise vers une version antérieure d’etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour vers l’environnement de production.
Avant de commencer, téléchargez l’instantané de sauvegarde . Si une erreur survient lors de la rétrogradation, il sera possible d’utiliser cette sauvegarde pour annuler la mise à jour et revenir à la version existante de etcd.
Avant de commencer, téléchargez la dernière version de etcd v3.6.
Versions mixtes
Lors d’une mise à jour vers une version inférieure, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster est considéré comme mis à jour vers une version inférieure une fois que la mise à jour vers une version inférieure est activée par etcdctl downgrade enable 3.6. Internement, la version globale du cluster est définie sur la version cible de la mise à jour vers une version inférieure, ce qui contrôle la version signalée et les fonctionnalités prises en charge.
Annuler
Avant de procéder à la mise à jour inférieure de votre cluster etcd, créez et téléchargez une sauvegarde sous forme d’instantané de votre cluster etcd. Cet instantané peut être utilisé pour restaurer le cluster dans son état antérieur à la mise à jour, le cas échéant. Si des utilisateurs rencontrent des problèmes pendant la mise à jour inférieure, ils doivent d’abord identifier et résoudre la cause racine.
Si la désinstallation a commencé après l’exécution de etcdctl downgrade enable, et que le cluster est toujours dans un état de version mixte, où au moins un membre reste sur la version v3.7, les utilisateurs peuvent annuler le processus de mise à jour en cours en exécutant etcdctl downgrade cancel, puis en redémarrant tous les membres mis à jour avec les binaires d’origine v3.7.
Une fois que tous les membres ont été rétrogradés vers la version v3.6, le cluster est considéré comme entièrement rétrogradé. Si les utilisateurs souhaitent revenir à la version d’origine après avoir achevé un rétrogradation complète, ils doivent suivre le guide officiel d’mise à jour afin d’assurer la cohérence et d’éviter toute corruption des données.
Procédure de rétrogradation
Cet exemple montre comment effectuer une mise à jour vers une version antérieure d’un cluster etcd à 3 membres en version v3.7, exécuté sur une machine locale. La sortie ci-dessous provient d’une exécution réelle contre etcd v3.7.0-rc.0 et etcd v3.6.13 sur un seul hôte, utilisant trois ports de boucle, sur un cluster qui a été mis à jour depuis v3.6.13 peu de temps auparavant.
Étape 1 : vérifier les conditions de rétrogradation
Le cluster est-il sain et en cours d’exécution sous la version 3.7.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’un chemin de retour en cas de problème :
Étape 3 : valider la version cible de la mise à jour vers une version antérieure
Validez la version cible de la rétrogradation avant d’activer la rétrogradation :
- Nous ne supportons que le retour arrière d’une version mineure à la fois. Par exemple, le passage de la version v3.7 à la version v3.5 n’est pas autorisé.
- Veuillez ne pas passer à l’étape suivante tant que la validation n’est pas réussie.
Étape 4 : activer la remontée de version
Après avoir activé la désinstallation, le cluster commencera à fonctionner avec le protocole v3.6, qui est la version cible de la désinstallation. En outre, etcd migrera automatiquement le schéma vers la version cible de la désinstallation, ce qui se produit généralement très rapidement. Vérifiez que la version de stockage de tous les serveurs a bien été migrée vers la v3.6 en consultant l’état des points de terminaison avant de passer à l’étape suivante.
Une fois la désinstallation autorisée, le cluster continuera à fonctionner avec le protocole v3.6, même si tous les serveurs exécutent encore le binaire v3.7, à moins que la désinstallation ne soit annulée à l’aide de etcdctl downgrade cancel
Étape 5 : arrêter un serveur etcd existant
Avant d’arrêter le serveur, vérifiez s’il est le leader. Nous recommandons de mettre hors service le leader en dernier. Si le serveur à arrêter est le leader, vous pouvez réduire une partie de la durée d’indisponibilité en move-leader vers un autre serveur avant d’arrêter ce serveur.
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 6 : redémarrer le serveur etcd avec la même configuration
Redémarrez le serveur etcd avec la même configuration, mais en utilisant le binaire etcd v3.6.
Vérifiez que chaque membre, puis l’ensemble du cluster, devient sain avec le binaire etcd v3.6 :
Contrairement à la version 3.5, le point d’extrémité d’état de la version 3.6 indique bien les informations de rétrogradation, de sorte que les membres rétrogradés continuent à afficher DOWNGRADE ENABLED comme true et leur version de stockage jusqu’à la fin de la rétrogradation.
Étape 7 : répéter étape 5 et étape 6 pour les membres restants
Lorsque tous les membres sont désactivés, la désactivation est automatiquement terminée et DOWNGRADE ENABLED est réinitialisé à false. Vérifiez l’état de santé et le statut du cluster, puis confirmez que la version mineure de tous les membres et la version de stockage sont v3.6 :
Dans le journal du leader, vous devriez être en mesure de voir un message similaire au suivant :
17.3 - Rétrogradation d'etcd de la version 3.5 à la 3.4
Dans le cas général, la rétrogradation de etcd 3.5 vers 3.4 peut s’effectuer sans interruption de service, en mode rolling :
- un par un, arrêtez les processus etcd 3.5 et remplacez-les par des processus etcd 3.4
- après avoir lancé des processus 3.4, les nouvelles fonctionnalités de 3.5 ne sont plus disponibles pour le cluster
Avant de effectuer une mise vers une version antérieure , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour vers une version antérieure
content/enhttps://etcd.io/docs/v3.5/op-guide/authentication/rbac.md
Si votre cluster a activé l’authentification, la mise à jour rétrograde depuis la version 3.5 n’est pas prise en charge, car la version 3.5 modifie le format des entrées WAL liées à l’authentification . Vous pouvez suivre les instructions d’authentification pour désactiver l’authentification, puis supprimer tous les utilisateurs.
Changements importants ayant pour effet de rupture entre 3.5 et 3.4 :
Différence entre les drapeaux
Si vous utilisez l’un des drapeaux suivants dans vos configurations 3.5, veillez à les supprimer, les renommer ou modifier leur valeur par défaut lors de la mise à jour vers la version 3.4.
La différence est basée sur les versions 3.5.14 et 3.4.33. La différence réelle dépend de votre version de correctif ; vérifiez d’abord avec diff <(etcd-3.5/bin/etcd -h | grep \\-\\-) <(etcd-3.4/bin/etcd -h | grep \\-\\-).
etcd --logger zap
3.4 est par défaut --logger=capnslog tandis que 3.5 est par défaut --logger=zap.
Si vous souhaitez continuer à utiliser zap, il doit être spécifié explicitement.
Différence entre les métriques Prometheus
Liste de vérification pour la mise à jour vers une version antérieure du serveur
Exigences de mise à jour vers une version antérieure
Pour garantir une mise à jour descendante progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
La version 3.4 vers laquelle effectuer la rétrogradation doit être supérieure ou égale à 3.4.32.
Préparation
Avant de procéder à une mise vers une version antérieure d’etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour vers l’environnement de production.
Avant de commencer, téléchargez la sauvegarde d’instantané
. Si une erreur survient lors de la rétrogradation, il sera possible d’utiliser cette sauvegarde pour annuler
la mise à jour et revenir à la version étcd existante. Veuillez noter que la snapshot commande ne sauvegarde que les données v3. Pour les données v2, consultez sauvegarde du magasin de données v2
.
Avant de commencer, téléchargez la dernière version d’etcd 3.4, et vérifiez que sa version est supérieure ou égale à 3.4.32.
Versions mixtes
Lors d’une opération de rétrogradation, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster est considéré comme rétrogradé dès qu’un de ses membres est rétrogradé à la version 3.4. Internement, les membres etcd négocient entre eux afin de déterminer la version globale du cluster, qui détermine la version signalée et les fonctionnalités prises en charge.
Limitations
Note : Si le cluster ne contient que des données v3 et aucune donnée v2, il n’est pas soumis à cette limitation.
Si le cluster sert un jeu de données v2 d’une taille supérieure à 50 Mo, chaque membre nouvellement rétrogradé peut prendre jusqu’à deux minutes pour se synchroniser avec le cluster existant. Vérifiez la taille d’un instantané récent afin d’estimer la taille totale des données. Autrement dit, il est préférable d’attendre deux minutes entre chaque rétrogradation de membre.
Pour une taille totale de données bien plus importante, de 100 Mo ou plus, ce processus unique peut prendre encore plus de temps. Les administrateurs de clusters etcd très volumineux de cette ampleur peuvent librement contacter l’équipe etcd avant la mise à jour inférieure, et nous serons heureux de leur fournir des conseils sur la procédure.
Annuler
Si un membre a été rétrogradé à la version 3.4, la version du cluster sera rétrogradée à 3.4, et les opérations seront compatibles avec “3.4”. Vous devrez suivre les instructions Mettre à jour etcd de 3.4 vers 3.5 pour effectuer un retour en arrière.
Veuillez télécharger la sauvegarde d’instantané afin de permettre la remontée du cluster, même après qu’il ait été entièrement rétrogradé.
Procédure de rétrogradation
Cet exemple montre comment effectuer une mise à jour vers une version antérieure d’un cluster etcd 3.5 composé de 3 membres, en cours d’exécution sur une machine locale.
Étape 1 : vérifier les conditions de rétrogradation
Le cluster est-il sain et en cours d’exécution avec la version 3.5.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Étape 3 : arrêter un serveur etcd existant
Avant d’arrêter le serveur, vérifiez s’il est leader
Si le serveur à arrêter est le leader, vous pouvez réduire la durée d’indisponibilité en move-leader vers un autre serveur avant d’arrêter ce serveur.
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 4 : redémarrer le serveur etcd avec la même configuration + --next-cluster-version-compatible
Redémarrez le serveur etcd avec la même configuration, mais avec le nouveau binaire etcd et --next-cluster-version-compatible.
Le nouvel etcd 3.4 publiera ses informations dans le cluster. À ce stade, le cluster commencera à fonctionner selon le protocole 3.4, qui constitue la version commune la plus basse.
Vérifiez que chaque membre, puis l’intégralité du cluster, deviennent sains avec la nouvelle binaire etcd 3.4 :
Les membres non mis à jour logueront des informations semblables aux suivantes
Étape 5 : répéter l’étape 3 et l’étape 4 pour les membres restants
Lorsque tous les membres sont rétrogradés, vérifiez l’état de santé et la version du cluster :
17.4 - Rétrogradation d'etcd de la version v3.6 à la v3.5
Dans le cas général, la rétrogradation de etcd v3.6 vers v3.5 peut s’effectuer sans interruption de service, en mode rolling :
- un à un, arrêtez les processus etcd v3.6 et remplacez-les par des processus etcd v3.5
- après avoir activé la rétrogradation, les nouvelles fonctionnalités de la version v3.6 ne sont plus disponibles pour le cluster
Avant de effectuer une mise vers une version antérieure , lisez le reste du présent guide afin de vous préparer.
Listes de vérification pour la mise à jour vers une version antérieure
Changements importants marquants de la version v3.6 à la v3.5 :
Différence entre les drapeaux
Si vous utilisez l’un des drapeaux suivants dans vos configurations v3.6, veillez à les supprimer, les renommer ou modifier leur valeur par défaut lors de la mise à jour vers la version v3.5.
La différence est basée sur les versions v3.6.0 et v3.5.18. La différence réelle dépend de votre version de correctif ; vérifiez d’abord avec diff <(etcd-3.6/bin/etcd -h | grep \\-\\-) <(etcd-3.5/bin/etcd -h | grep \\-\\-).
Différence entre les métriques Prometheus
Liste de vérification pour la mise à jour vers une version antérieure du serveur
Exigences de mise à jour vers une version antérieure
Pour garantir une mise à jour descendante progressive sans incident, le cluster en cours d’exécution doit être sain. Vérifiez l’état du cluster à l’aide de la commande etcdctl endpoint health avant de poursuivre.
Préparation
Avant de procéder à une mise vers une version antérieure d’etcd, testez toujours les services dépendants d’etcd dans un environnement de préproduction avant de déployer la mise à jour vers l’environnement de production.
Avant de commencer, téléchargez l’instantané de sauvegarde . Si une erreur survient lors de la rétrogradation, il sera possible d’utiliser cette sauvegarde pour annuler la mise à jour et revenir à la version existante de etcd.
Avant de commencer, téléchargez la dernière version de etcd v3.5.
Versions mixtes
Lors d’une mise à jour vers une version inférieure, un cluster etcd prend en charge des versions mixtes de membres et fonctionne selon le protocole de la version commune la plus basse. Le cluster est considéré comme mis à jour vers une version inférieure une fois que la mise à jour vers une version inférieure est activée par etcdctl downgrade enable 3.5. Internement, la version globale du cluster est définie sur la version cible de la mise à jour vers une version inférieure, ce qui contrôle la version signalée et les fonctionnalités prises en charge.
Annuler
Avant de procéder à la mise à jour inférieure de votre cluster etcd, créez et téléchargez une sauvegarde sous forme d’instantané de votre cluster etcd. Cet instantané peut être utilisé pour restaurer le cluster dans son état antérieur à la mise à jour si nécessaire. Si des utilisateurs rencontrent des problèmes lors de la mise à jour inférieure, ils doivent d’abord identifier et résoudre la cause racine.
Si la désinstallation a commencé après l’exécution de etcdctl downgrade enabled, et que le cluster est toujours dans un état mixte — où au moins un membre reste sur la version v3.6 —, les utilisateurs peuvent annuler le processus de mise à jour en cours en exécutant etcdctl downgrade cancel, puis en redémarrant tous les membres mis à jour avec les binaires d’origine v3.6.
Une fois que tous les membres ont été rétrogradés vers la version v3.5, le cluster est considéré comme entièrement rétrogradé. Si les utilisateurs souhaitent revenir à la version d’origine après avoir achevé un rétrogradation complète, ils doivent suivre le guide officiel d’mise à jour afin d’assurer la cohérence et d’éviter toute corruption des données.
Procédure de rétrogradation
Cet exemple montre comment effectuer une mise à jour inverse d’un cluster etcd v3.6 à trois membres fonctionnant sur une machine locale.
Étape 1 : vérifier les conditions de rétrogradation
Le cluster est-il sain et en cours d’exécution sous la version 3.6.x ?
Étape 2 : télécharger la sauvegarde instantané depuis le leader
Téléchargez l’instantané de sauvegarde afin de disposer d’une voie de retour en cas de problème.
Étape 3 : valider la version cible de la mise à jour vers une version antérieure
Validez la version cible de la rétrogradation avant d’activer la rétrogradation :
- Nous ne supportons que le retour arrière d’une version mineure à la fois. Par exemple, le retour arrière de la version v3.6 vers la v3.4 n’est pas autorisé.
- Veuillez ne pas passer à l’étape suivante tant que la validation n’est pas réussie.
Étape 4 : activer la remontée de version
Après avoir activé la désactivation de la version, le cluster commencera à fonctionner avec le protocole v3.5, qui est la version cible de la désactivation. En outre, etcd migrera automatiquement le schéma vers la version cible de la désactivation, ce qui se produit généralement très rapidement. Vérifiez que la version de stockage de tous les serveurs a été migrée vers v3.5 en consultant l’état des points de terminaison avant de passer à l’étape suivante.
Une fois la désinstallation autorisée, le cluster continuera à fonctionner avec le protocole v3.5, même si tous les serveurs exécutent encore le binaire v3.6, à moins que la désinstallation ne soit annulée à l’aide de etcdctl downgrade cancel
Étape 5 : arrêter un serveur etcd existant
Avant d’arrêter le serveur, vérifiez s’il est le leader. Nous recommandons de mettre à jour le leader en dernier.
Si le serveur à arrêter est le leader, vous pouvez réduire la durée d’indisponibilité en move-leader vers un autre serveur avant d’arrêter ce serveur.
Lorsque chaque processus etcd est arrêté, les autres membres du cluster enregistrent des erreurs attendues. Cela est normal, car la connexion avec un membre du cluster a été (temporairement) interrompue :
Étape 6 : redémarrer le serveur etcd avec la même configuration (sans les indicateurs supprimés ou remplacés dans la version 3.5)
Redémarrez le serveur etcd avec la même configuration, mais avec le binaire etcd mis à jour.
Vérifiez que chaque membre, puis l’intégralité du cluster, deviennent sains avec la nouvelle binaire etcd v3.5 :
Vous verrez que DOWNGRADE ENABLED est false pour le serveur v3.5, car les informations de rétrogradation ne sont pas implémentées dans le point de terminaison d’état de la v3.5 ; la rétrogradation reste toutefois activée pour le cluster à ce stade.
Étape 7 : répéter étape 5 et étape 6 pour les membres restants
Lorsque tous les membres sont rétrogradés, vérifiez l’état et la santé du cluster, puis confirmez que la version mineure de tous les membres est v3.5 et que la version de stockage est vide :
Dans le journal du leader, vous devriez être en mesure de voir un message similaire au suivant :
18 - Tri
18.1 - Guidelines de tri des problèmes
Objectif
Accélérer la gestion des problèmes.
Les problèmes liés à etcd sont répertoriés sur https://github.com/etcd-io/etcd/issues
et sont identifiés par des étiquettes. Par exemple, un problème identifié
comme un bogue sera éventuellement étiqueté area/bug . Les nouveaux problèmes
apparaissent initialement sans étiquette, mais les responsables etcd et les contributeurs actifs
ajoutent des étiquettes en fonction de leurs constatations. La liste détaillée des étiquettes est disponible sur
https://github.com/kubernetes/kubernetes/labels
Voici quelques recherches prédéfinies sur les problèmes, pour plus de commodité :
Portée
Ces directives servent de document principal pour trier les problèmes reçus dans etcd. Tous sont invités à aider à la gestion des problèmes et des demandes de tirage, mais le travail et les responsabilités décrits dans ce document sont destinés aux mainteneurs et contributeurs actifs de etcd.
Vérifier qu’un problème est un bogue
Vérifiez si le problème est bien un bogue. Si ce n’est pas le cas, ajoutez un commentaire avec vos constatations et fermez l’issue mineure. Pour une issue non mineure, attendez de recevoir une réponse du rapporteur d’incident et vérifiez s’il y a une objection. Si le rapporteur d’incident ne répond pas dans les 30 jours, fermez l’issue. Si le problème ne peut pas être reproduit ou s’il nécessite des informations supplémentaires, laissez un commentaire pour le rapporteur d’incident.
Problèmes inactifs
Les problèmes qui manquent d’informations fournies par le rapporteur doivent être fermés si ce dernier ne fournit pas d’informations dans les 60 jours.
Problèmes en double
Si un problème est en double, ajoutez un commentaire indiquant cette situation, accompagné d’une référence vers le problème original, puis clôturez-le.
Problèmes qui n’appartiennent pas à etcd
Parfois, des problèmes sont signalés qui appartiennent en réalité à d’autres projets utilisant etcd. Par exemple, des problèmes liés à grpc ou golang. Ces problèmes doivent être traités en demandant au signalement de créer une issue dans le projet approprié. Fermer l’issue, sauf si un mainteneur et le signaleur estiment nécessaire de la laisser ouverte pour des raisons de suivi.
Vérifier que les étiquettes importantes sont présentes
Assurez-vous que l’issue dispose des étiquettes correspondant aux domaines auxquels elle appartient, que les assignataires appropriés sont ajoutés et que l’échéance est définie. Si l’une de ces étiquettes est manquante, ajoutez-la. Si les étiquettes ne peuvent pas être attribuées en raison de privilèges limités ou si l’étiquette correcte ne peut pas être déterminée, cela ne pose pas de problème ; contactez les responsables si nécessaire.
Poke le propriétaire de l’issue si nécessaire
Si une issue dont le propriétaire est un développeur n’a pas de demande de fusion (PR) créée en 30 jours, contactez le propriétaire de l’issue et demandez une PR ou la libération de la propriété si nécessaire.
18.2 - Gestion des demandes de tirage
Objectif
Accélérer la gestion des PR.
Les demandes de fusion etcd sont listées sur https://github.com/etcd-io/etcd/pulls
Une demande de fusion peut avoir divers étiquettes, un délai d’achèvement, un validateur, etc. La liste détaillée des étiquettes est disponible sur
https://github.com/kubernetes/kubernetes/labels
Voici quelques exemples de recherches sur PR pour plus de commodité :
Portée
Ces directives servent de document principal pour la gestion des demandes de tirage (PR) dans etcd. Tous sont invités à aider à la gestion des PR, mais le travail et les responsabilités décrits dans ce document s’adressent principalement aux mainteneurs et contributeurs actifs de etcd.
Gérer les demandes de tirage inactives
Poke le propriétaire de la PR si les commentaires de relecture ne sont pas traités en 15 jours. Si le propriétaire de la PR ne répond pas en 90 jours, mettez à jour la PR avec un nouveau commit si possible. Sinon, une PR inactif doit être fermée après 180 jours.
Interroger le réviseur si nécessaire
Les relecteurs sont réactifs de manière ponctuelle, mais étant donné que chacun est occupé, accordez-leur un délai après la demande de relecture si la réponse rapide n’est pas fournie. Si aucune réponse n’est donnée dans les 10 jours, n’hésitez pas à les contacter en ajoutant un commentaire dans la demande de fusion, en envoyant un courriel ou un message sur Slack.
Vérifier que les étiquettes importantes sont présentes
Assurez-vous que les revueurs appropriés sont ajoutés à la demande de fusion (PR). Vérifiez également qu’une étiquette de livrable (milestone) est définie. Si l’une de ces étiquettes ou toute autre étiquette importante est manquante, ajoutez-la. Si aucune étiquette correcte ne peut être déterminée, laissez un commentaire pour inviter les responsables à intervenir selon le besoin.