Dies ist die mehrseitige Druckansicht dieses Abschnitts. .
Patroni 4.1.5 Dokumentation
- 1: Watchdog-Unterstützung
- 2: Pausen/fortsetzen-Modus für den_Cluster
- 3: Integration mit anderen Tools
- 4: Sicherheitshinweise
- 5: HA-Multi-Datacenter
Betrieb von Patroni auf Systemen mit begrenztem Arbeitsspeicher und Python 3.11+
Wenn Sie Patroni auf einem System mit strengen Speichergrenzen betreiben, beispielsweise mit vm.overcommit_memory=2 (für PostgreSQL empfohlen), und Python 3.11 oder neuer verwenden, kann unerwartetes Verhalten auftreten:
- Patroni scheint ordnungsgemäß zu funktionieren
- PostgreSQL läuft weiter
- Die REST API von Patroni reagiert nicht mehr
- Das Betriebssystem meldet, dass Patroni auf dem REST API-Port lauscht
- Die Patroni-Protokolle erscheinen normal; einmalig können jedoch folgende Meldungen auftreten:
Exception ignored in thread started by: <object repr() failed>,MemoryError - Die Kernel-Protokolle können Meldungen wie
not enough memory for the allocationenthalten
Dieses Verhalten wird durch einen Fehler in Python 3.11+ verursacht. Bei strengen Speichergrenzen kann der Start eines neuen Threads auf unbestimmte Zeit hängen bleiben, wenn nicht genügend freier Arbeitsspeicher verfügbar ist.
Empfohlene Lösung
Neuere Patroni-Versionen (4.1.1+, 4.0.8+) verringern die Auswirkungen dieses Problems, indem sie alle erforderlichen Threads früh beim Start erzeugen, bevor das System unter Speicherdruck gerät.
Weitere Empfehlungen (Linux, glibc)
Beim Betrieb mit vm.overcommit_memory=2 (für PostgreSQL empfohlen) empfehlen wir außerdem, Patroni mit den folgenden Umgebungsvariablen zu starten:
MALLOC_ARENA_MAX=1- verringert den von glibc für Anwendungen mit mehreren Threads reservierten virtuellen SpeicherPG_MALLOC_ARENA_MAX=- setzt den Wert vonMALLOC_ARENA_MAXfür PostgreSQL-Prozesse zurück, die Patroni startet.
Zusätzlich können Sie folgende Patroni-Konfigurationsparameter anpassen:
thread_stack_size- Stackgröße der von Patroni gestarteten Threads. Ein niedrigerer Wert verringert den Speicherbedarf des Patroni-Prozesses. Patroni setzt standardmäßig512kB. Erhöhen Siethread_stack_size, wenn Patroni aufgrund von Stackproblemen abstürzt; andernfalls reicht der Standardwert aus.thread_pool_size- Größe des Threadpools, den Patroni für asynchrone Aufgaben und die REST API-Kommunikation mit anderen Mitgliedern bei der Wahl des führenden Knotens oder bei Failsafe-Prüfungen verwendet. Der Standardwert ist5und reicht für Cluster mit drei Knoten aus.restapi.thread_pool_size- Größe des Threadpools zur Bearbeitung von REST API-Anfragen. Der Standardwert ist5und erlaubt bis zu fünf parallele REST API-Anfragen. Anfragen mit SQL-Abfragen werden jedoch praktisch nacheinander verarbeitet, da nur eine Datenbankverbindung verwendet wird. Eine Erhöhung dieses Wertes bringt daher üblicherweise keinen Vorteil.
Patroni ist eine Vorlage für PostgreSQL-Lösungen zur Hochverfügbarkeit (HA) auf Basis von Python. Für eine möglichst breite Einsetzbarkeit unterstützt Patroni verschiedene verteilte Konfigurationsspeicher wie ZooKeeper , etcd , Consul oder Kubernetes . Datenbankentwickler, DBAs, DevOps-Fachleute und SREs, die PostgreSQL mit HA schnell in Rechenzentren oder anderswo bereitstellen möchten, finden darin hoffentlich ein hilfreiches Werkzeug.
Wir nennen Patroni eine „Vorlage“, weil es keineswegs ein universelles oder sofort einsatzbereites Replikationssystem ist. Es hat seine Besonderheiten und Einschränkungen. Setzen Sie es mit Bedacht ein. Es gibt viele Möglichkeiten, PostgreSQL hochverfügbar zu betreiben; eine Übersicht bietet die PostgreSQL-Dokumentation .
Derzeit unterstützte PostgreSQL-Versionen: 9.3 bis 18.
Hinweis für Citus-Anwender: Ab Version 3.0 integriert sich Patroni gut mit der Postgres-Datenbankerweiterung Citus . Weitere Informationen zur gemeinsamen Nutzung der Patroni-Hochverfügbarkeit mit einem verteilten Citus-Cluster finden Sie auf der Seite zur Citus-Unterstützung in der Patroni-Dokumentation.
Hinweis für Kubernetes-Anwender: Patroni kann direkt auf Kubernetes laufen. Lesen Sie dazu das Kapitel Kubernetes der Patroni-Dokumentation.
1 - Watchdog-Unterstützung
Das gleichzeitige Ausführen mehrerer PostgreSQL-Server als primäre Server kann zu Datenverlusten aufgrund von unterschiedlichen Zeitlinien führen. Diese Situation wird auch als “Split-Brain”-Problem bezeichnet. Um das Split-Brain-Problem zu vermeiden, muss Patroni sicherstellen, dass PostgreSQL keine Transaktionsbestätigungen akzeptiert, nachdem der Schlüssel für den primären Server in der DCS abgelaufen ist. Unter normalen Umständen versucht Patroni, dies durch das Stoppen von PostgreSQL zu erreichen, falls der Update-Vorgang für den primären Schlüssel aus irgendeinem Grund fehlschlägt. Dies kann jedoch aus verschiedenen Gründen fehlschlagen:
- Patroni ist aufgrund eines Fehlers, eines Zustands mit unzureichendem Arbeitsspeicher oder durch versehentliches Abschalten durch einen Systemadministrator abgestürzt.
- Das Herunterfahren von PostgreSQL ist zu langsam.
- Patroni kann aufgrund hoher Systemlast, durch den Hypervisor pausierte VM oder anderer Infrastrukturprobleme nicht ausgeführt werden.
Um ein korrektes Verhalten unter diesen Bedingungen zu gewährleisten, unterstützt Patroni Überwachungsgeräte. Überwachungsgeräte sind Software- oder Hardware-Mechanismen, die das gesamte System zurücksetzen, wenn sie innerhalb eines bestimmten Zeitrahmens kein “Keepalive”-Heartbeat erhalten. Dies bietet eine zusätzliche Schutzschicht, falls die üblichen Patroni-Split-Brain-Schutzmechanismen ausfallen.
Patroni wird versuchen, den Watchdog vor der Beförderung von PostgreSQL zum Primärserver zu aktivieren. Falls die Aktivierung des Watchdogs fehlschlägt und der Watchdog-Modus required ist, wird der Knoten ablehnen, Leader zu werden. Bei der Entscheidung, an der Leader-Wahl teilzunehmen, wird Patroni auch überprüfen, ob die Watchdog-Konfiguration es zulassen würde, Leader zu werden. Nach der Demotion von PostgreSQL (z.B. aufgrund eines manuellen Failovers) wird Patroni den Watchdog erneut deaktivieren. Der Watchdog wird auch während der pausierten Zustands von Patroni deaktiviert.
Standardmäßig wird Patroni den Watchdog so einrichten, dass er 5 Sekunden vor TTL abläuft. Mit der standardmäßigen Konfiguration von loop_wait=10 und ttl=30 erhält der HA-Loop mindestens 15 Sekunden (ttl - safety_margin - loop_wait) zur Abschließung, bevor der Systemzustand durch eine zwingende Neustart verloren geht. Standardmäßig wird der Zugriff auf das DCS nach 10 Sekunden ablaufen. Dies bedeutet, dass wenn das DCS nicht verfügbar ist, z.B. aufgrund von Netzwerkproblemen, Patroni und PostgreSQL mindestens 5 Sekunden (ttl - safety_margin - loop_wait - retry_timeout) haben, um in einen Zustand zu gelangen, in dem alle Clientverbindungen beendet sind.
Der Sicherheitsabstand ist die Zeit, die Patroni für den Zeitraum zwischen dem Aktualisieren des Leiterschlüssels und dem Senden von “Keepalive”-Signalen reserviert. Patroni wird versuchen, sofort nach der Bestätigung des Aktualisierens des Leiterschlüssels ein “Keepalive”-Signal zu senden. Wenn der Patroni-Prozess über einen längeren Zeitraum genau zum richtigen Zeitpunkt angehalten wird, kann das “Keepalive”-Signal verzögert werden, ohne dass der “Watchdog” ausgelöst wird. Dies führt zu einem Zeitraum, in dem der “Watchdog” nicht ausgelöst wird, bevor der Leiterschlüssel abläuft, wodurch die Garantie ungültig wird. Um sicherzustellen, dass der “Watchdog” unter allen Umständen ausgelöst wird, sollten Sie den “Watchdog” so konfigurieren, dass er nach der Hälfte der TTL-Zeit abläuft, indem Sie safety_margin auf -1 setzen, um die “Watchdog”-Timeout-Zeit auf ttl // 2 zu setzen. Wenn Sie diese Garantie benötigen, sollten Sie möglicherweise ttl erhöhen und/oder loop_wait und retry_timeout verringern.
Derzeit werden “Watchdogs” ausschließlich über die Linux-Watchdog-Geräte-Schnittstelle unterstützt.
Einrichtung eines Software-Überwachers unter Linux
Die Standard-Patroni-Konfiguration versucht, /dev/watchdog unter Linux zu verwenden, falls dies für Patroni zugänglich ist. Für die meisten Anwendungsfälle ist die Verwendung eines Software-Überwachers, der in den Linux-Kernel integriert ist, ausreichend sicher.
Um den Software-Überwacher zu aktivieren, führen Sie die folgenden Befehle als Root aus, bevor Sie Patroni starten:
Für Tests kann es hilfreich sein, das Neustarten zu deaktivieren, indem man soft_noboot=1 zur Befehlszeile von modprobe hinzufügt. In diesem Fall protokolliert der Watchdog lediglich eine Zeile im Kernel-Ring-Puffer, die über dmesg sichtbar ist.
Patroni protokolliert Informationen über den Watchdog, wenn dieser erfolgreich aktiviert wurde.
2 - Pausen/fortsetzen-Modus für den_Cluster
Das Ziel
Unter bestimmten Umständen muss Patroni vorübergehend die Verwaltung des Clusters aufgeben, während der Clusterstatus in DCS erhalten bleibt. Mögliche Anwendungsfälle sind ungewöhnliche Aktivitäten im Cluster, wie z. B. größere Versions-Upgrades oder die Wiederherstellung von Daten. Während dieser Aktivitäten werden die Knoten oft gestartet und gestoppt, aus Gründen, die Patroni nicht kennt. Einige Knoten können sogar vorübergehend als primäre Knoten fungieren, was die Annahme verletzt, dass nur ein primärer Knoten aktiv ist. Daher muss Patroni in der Lage sein, sich vom laufenden Cluster zu trennen und eine ähnliche Funktion wie der Wartigungsmodus in Pacemaker zu implementieren.
Die Implementierung
Wenn Patroni im angehaltenen Modus läuft, ändert es den Zustand von PostgreSQL nicht, außer in folgenden Fällen:
- Für jeden Knoten wird der Member-Schlüssel in DCS mit den aktuellen Informationen über den Cluster aktualisiert. Dadurch führt Patroni dazu, nur Leseabfragen auf einem Member-Knoten auszuführen, wenn dieser ausgeführt wird.
- Für den primären Postgres-Server mit dem Leader-Lock aktualisiert Patroni den Lock. Wenn der Knoten mit dem Leader-Lock nicht mehr der primäre Server ist (d. h. er wird manuell abgewickelt), gibt Patroni den Lock frei, anstatt den Knoten wieder aufzuwerten.
- Manuelle, nicht geplante Neustarts, manuelle, nicht geplante Failover/Umschaltung und Reinitialisierung sind erlaubt. Geplante Aktionen sind nicht erlaubt. Eine manuelle Umschaltung ist nur dann erlaubt, wenn der zu schaltende Knoten angegeben ist.
- Wenn Patroni “parallele” primäre Server erkennt, gibt es eine Warnmeldung aus, aber es wird der primäre Server ohne Leader-Lock nicht abgewickelt.
- Wenn kein Leader-Lock im Cluster vorhanden ist, erhält der laufende Primär den Lock. Wenn es mehr als einen Primär-Knoten gibt, gewinnt der erste Primär, der den Lock erhält. Wenn es keine Primär-Knoten gibt, versucht Patroni, keine Replik zu befördern. Es gibt eine Ausnahme: Wenn kein Leader-Lock vorhanden ist, weil der alte Primär sich manuell befördert hat, kann nur der im Anforderung zur Beförderung genannte Knoten den Leader-Lock erhalten. Wenn der neue Leader-Lock gewährt wird (d. h. nach manueller Beförderung einer Replik), stellt Patroni sicher, dass die Replik, die zuvor vom vorherigen Leader verwendet wurden, auf den neuen umgeschaltet werden.
- Wenn Postgres gestoppt wird, versucht Patroni, es nicht zu starten. Wenn Patroni gestoppt wird, versucht es nicht, die Postgres-Instanz zu stoppen, die es verwaltet.
- Patroni versucht nicht, Replikations-Slots zu entfernen, die nicht den anderen Cluster-Mitgliedern entsprechen oder nicht in der Konfiguration der permanenten Slots aufgeführt sind.
Benutzerhandbuch
patronictl unterstützt die Befehle pause und resume .
Es ist auch möglich, eine Anfrage an den Schlüssel {namespace}/{cluster}/config mit dem Wert {"pause": true/false/null} auszugeben, die den Typ PATCH hat.
3 - Integration mit anderen Tools
Patroni kann sich in andere Tools in Ihrer Umgebung integrieren. In diesem Abschnitt finden Sie eine Liste von Beispielen, die zwar keine vollständige Liste darstellen, aber Ihnen Ideen geben können, wie Patroni mit anderen Tools zusammenarbeiten kann.
Barman
Patroni liefert eine Anwendung namens patroni_barman, die über Logik verfügt, um mit pg-backup-api zu kommunizieren, sodass Sie Barman-Operationen entfernt durchführen können.
Diese Anwendung verfügt derzeit über mehrere Unterkommandos: recover und config-switch.
patroni_barman recover
Das Unterkommando recover kann als benutzerdefinierte Bootstrap-Methode oder als benutzerdefinierte Replikat-Erstellungsmethode verwendet werden. Weitere Informationen hierzu finden Sie in replica_imaging_and_bootstrap
.
patroni_barman config-switch
Das Unterkommando config-switch ist als on_role_change-Callback in Patroni vorgesehen. Als Beispiel nehmen wir an, dass Sie WALs von Ihrem aktuellen Primärserver auf Ihren Barman-Host streamen. Im Falle eines Failovers im Cluster möchten Sie möglicherweise den WAL-Stream von dem neuen Primärserver starten. Dies erreichen Sie, indem Sie patroni_barman config-switch als on_role_change-Callback verwenden.
Dieser Unterbefehl basiert auf dem barman config-switch-Befehl, der dafür verantwortlich ist, die Konfiguration eines Barman-Servers durch Anwenden eines vordefinierten Modells auf ihn zu überschreiben. Dieser Befehl ist seit Barman 3.10 verfügbar. Weitere Einzelheiten finden Sie in der Barman-Dokumentation.
Dies ist ein Beispiel dafür, wie Sie Patroni konfigurieren können, um ein Konfigurationsmodell anzuwenden, falls dieser Patroni-Knoten zur Primärserver-Instanz befördert wird:
patroni_barman config-switch erfordert, dass sowohl Barman als auch pg-backup-api auf dem Barman-Host konfiguriert sind, damit ein entfernter barman config-switch über die Backup-API ausgeführt werden kann. Außerdem erfordert es, dass vorab konfigurierte Barman-Modelle angewendet werden. Das obige Beispiel verwendet eine Teilmenge der verfügbaren Parameter. Weitere Informationen erhalten Sie durch Ausführen von patroni_barman config-switch --help und durch Konsultation der Barman-Dokumentation.
4 - Sicherheitshinweise
Ein Patroni-Cluster verfügt über zwei Schnittstellen, die vor unbefugtem Zugriff geschützt werden müssen: das verteilte Konfigurationsspeicher (DCS) und die Patroni REST-API.
Schutz des DCS
Sowohl Patroni als auch patronictl speichern und abrufen Daten von/zum DCS.
Obwohl der DCS keine sensiblen Informationen enthält, ermöglicht er die Änderung einiger Konfigurationen von Patroni/Postgres. Daher sollte der DCS selbst daher als erstes geschützt werden.
Die Details zum Schutz hängen vom verwendeten Typ des DCS ab. Die Authentifizierungs- und Verschlüsselungsparameter (Token/Basic-Auth/Client-Zertifikate) für die unterstützten DCS-Typen sind in den Einstellungen beschrieben.
Die allgemeine Empfehlung ist, TLS für alle DCS-Kommunikationen zu aktivieren.
Schutz der REST-API
Der Schutz der REST-API ist eine komplexere Aufgabe.
Die Patroni-REST-API wird von Patroni selbst während des Leader-Wettbewerbs verwendet, von dem Tool patronictl zur Durchführung von Failover, Switchover, Reinitialisierung, Neustart oder Neuladung, von HAProxy oder einem anderen Load-Balancer zur Durchführung von HTTP-Health Checks und natürlich auch für Monitoring verwendet.
Aus Sicherheitsperspektive enthält die REST-API sichere (GET Anfragen, nur Informationen abrufen) und unsichere (PUT, POST, PATCH und DELETE Anfragen, Zustandsänderungen an Knoten vornehmen) Endpunkte.
Die unsicheren Endpunkte können durch HTTP-Basic-Auth geschützt werden, indem die Parameter restapi.authentication.username und restapi.authentication.password gesetzt werden. Es gibt keine Möglichkeit, die sicheren Endpunkte zu schützen, ohne TLS zu aktivieren.
Wenn TLS für die REST-API aktiviert und ein PKI eingerichtet ist, ist eine gegenseitige Authentifizierung zwischen API-Server und API-Client für alle Endpunkte möglich.
Die Parameter im Abschnitt restapi ermöglichen die TLS-Client-Authentifizierung beim Server. Je nach Wert des Parameters verify_client erfordert der API-Server eine erfolgreiche Überprüfung des Clientzertifikats für sowohl sichere als auch unsichere API-Aufrufe (verify_client: required), nur für unsichere API-Aufrufe (verify_client: optional), oder für keine API-Aufrufe (verify_client: none).
Die Parameter im Abschnitt ctl ermöglichen die TLS-Server-Authentifizierung beim Client (dem Tool patronictl
, das dieselbe Konfiguration wie Patroni verwendet). Setzen Sie insecure: true, um die Überprüfung des Serverzertifikats durch den Client zu deaktivieren. Weitere Details zu den TLS-Client-Parametern finden Sie in settings
.
Den Schutz der PostgreSQL-Datenbank vor unbefugtem Zugriff liegt außerhalb des Umfangs dieses Dokuments und wird in https://www.postgresql.org/docs/current/client-authentication.html behandelt.
5 - HA-Multi-Datacenter
Die Hochverfügbarkeit eines PostgreSQL-Clusters, der in mehreren Rechenzentren bereitgestellt wird, basiert auf Replikation, die synchron oder asynchron erfolgen kann (siehe Replikationsmodi ).
In beiden Fällen ist es wichtig, die folgenden Konzepte klar zu verstehen:
- PostgreSQL kann nur als primärer oder sekundärer Knoten betrieben werden, wenn es den Schlüssel besitzt und diesen aktualisieren kann.
- Sie sollten eine ungerade Anzahl von etcd-, ZooKeeper- oder Consul-Knoten betreiben: 3 oder 5!
Synchrones Replikation
Um einen mehrere Rechenzentrum (DC) umfassenden Cluster zu haben, der automatisch einen Ausfall einer Zone tolerieren kann, sind mindestens 3 erforderlich.
Das Architekturdiagramm hätte folgende Gestalt:
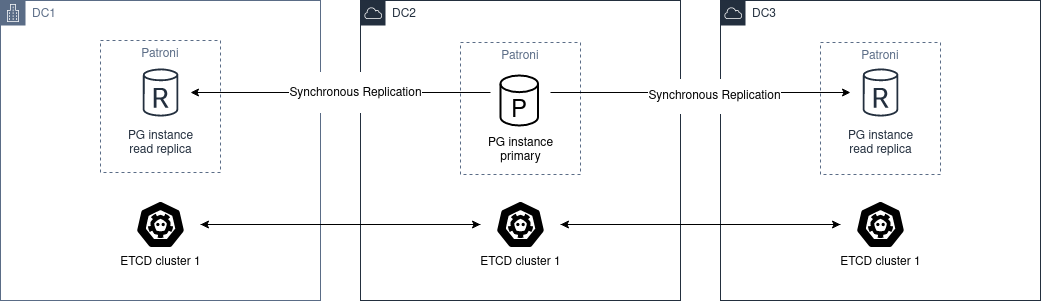
Sie müssen einen Cluster aus etcd, ZooKeeper oder Consul über verschiedene Rechenzentrum (DC) hinweg bereitstellen, wobei mindestens 3 Knoten erforderlich sind, jeweils ein Knoten pro Zone.
Bezüglich PostgreSQL müssen Sie mindestens 2 Knoten in unterschiedlichen Rechenzentrum (DC) bereitstellen. Anschließend müssen Sie synchronous_mode: true in der globalen dynamic configuration
festlegen.
Dies aktiviert die synchrone Replikation, und der Primärknoten wählt einen der Knoten als synchron aus.
Asynchrone Replikation
Mit nur zwei Datenzentren ist es besser, zwei unabhängige etcd-Clustern zu haben und einen Patroni Standby-Cluster im zweiten Datenzentrum auszuführen. Falls das erste Standort down geht, kann der standby_cluster MANUALLY promoviert werden.
Das Architekturdiagramm wäre folgendes:
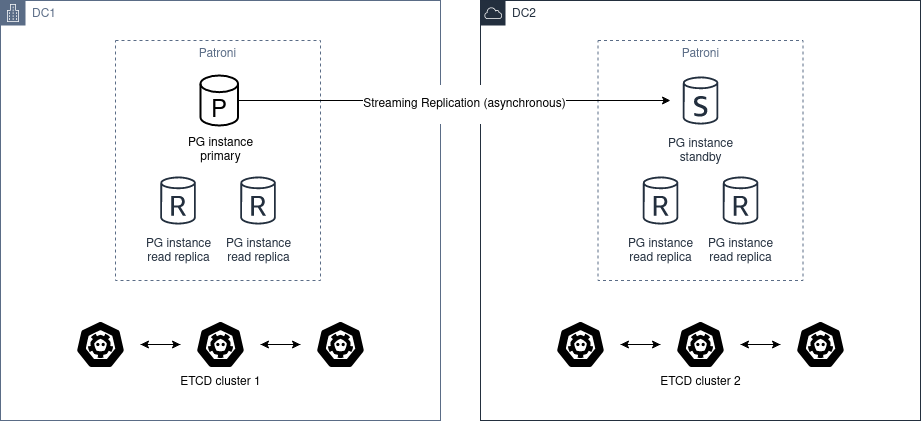
Automatische Erhöhung des Status ist nicht möglich, da DC2 niemals in der Lage sein wird, den Zustand von DC1 zu ermitteln.
Sie sollten pg_ctl promote in diesem Szenario nicht verwenden, Sie müssen die gesunde Clusterkonfiguration manuell erhöhen, indem Sie den standby_cluster
Abschnitt aus der dynamischen Konfiguration
entfernen.
Wenn das Quellcluster noch aktiv läuft und Sie den Standby-Cluster erhöhen, erzeugen Sie eine Split-Brain-Situation.
In der Regel gibt es nur zwei Möglichkeiten, um zur “ursprünglichen” Situation zurückzukehren:
- Fügen Sie den standby_cluster-Abschnitt wieder hinzu, um
pg_rewindauszulösen; jedoch musspg_rewindordnungsgemäß funktionieren, dass der Cluster mitdata page checksumsinitialisiert werden muss (die--data-checksums-Option fürinitdb), und/oderwal_log_hintsaufongesetzt werden muss, aber es besteht immer noch die Möglichkeit, dasspg_rewindaufgrund anderer Faktoren fehlschlägt. - Erstellen Sie den Standby-Cluster von Grund auf neu.
Bevor Sie den Standby-Cluster erhöhen, müssen Sie sicherstellen, dass das Quellcluster heruntergefahren ist (STONITH). Wenn DC1 wiederherstellt, muss das Cluster in einen Standby-Cluster umgewandelt werden.
Bevor Sie dies jedoch tun, können Sie die Datenbank manuell überprüfen und alle Änderungen extrahieren, die zwischen dem Zeitpunkt festgestellt wurden, an dem die Verbindung zwischen DC1 und DC2 nicht mehr funktioniert, und dem Zeitpunkt, an dem Sie den Cluster in DC1 manuell gestoppt haben, stattgefunden haben.
Nachdem Sie diese Änderungen extrahiert haben, können Sie diese auch manuell auf den Cluster in DC2 anwenden.